首页 文章 精选 留言 我的

精选列表

搜索[表单设计器],共10000篇文章
优秀的个人博客,低调大师

Spark SQL程序设计(2)

读取JSON数据 {"age":"45","gender":"M","occupation":"7","userID":"4","zipcode":"02460"} {"age":"1","gender":"F","occupation":"10","userID":"1","zipcode":"48067"} scala> val jsondf=spark.read.textfile("//user.json") 生成另外一个json文件 scala> josndf.write.mode("overwrite").json("//user2.json") 查看DF scala>userDF.show(4) scala> userDF.printSchema root |-- age: string (nullable = true) |-- gender: string (nullable = true) |-- occupation: string (nullable = true) |-- userID: string (nullable = true) |-- zipcode: string (nullable = true) 修改DF/DS元信息

优秀的个人博客,低调大师

PouchContainer CRI的设计与实现

1. CRI简介 在每个Kubernetes节点的最底层都有一个程序负责具体的容器创建删除工作,Kubernetes会对其接口进行调用,从而完成容器的编排调度。我们将这一层软件称之为容器运行时(Container Runtime),大名鼎鼎的Docker就是其中的代表。 当然,容器运行时并非只有Docker一种,包括CoreOS的rkt,hyper.sh的runV,Google的gvisor,以及本文的主角PouchContainer,都包含了完整的容器操作,能够用来创建特性各异的容器。不同的容器运行时有着各自独特的优点,能够满足不同用户的需求,因此Kubernetes支持多种容器运行时势在必行。 最初,Kubernetes原生内置了对Docker的调用接口,之后社区又在Kubernetes 1.3中集成了rkt的接口,使其成为了Doc

优秀的个人博客,低调大师

Spark SQL程序设计(1)

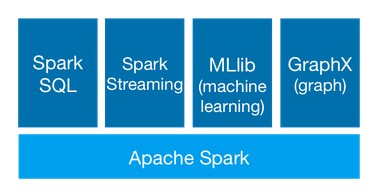
Spark SQL编写流程 1. SparkSession对象 封装了spark sql执行环境信息,是所有Spark SQL程序的唯一入口 sparkSession中包含 sparkContext和sqlContext两个对象,不用再自己创建sparkContext 2. 创建DataFrame或Dataset Spark SQL支持各种数据源 3. 在DataFrame或Dataset之上进行transformation和action Spark SQL提供了多种transformation和action函数 4. 返回结果 保存到HDFS中,或直接打印出来 val spark=SparkSession.build .master("local") .appName("appName") .getOrCreate() // 注意,后面所有程序片段总的spark变量均值SparkSession // 将RDD隐式转换为DataFrame import spark.implicits._ DataFrame与Dataset 1. DataFrame=Dataset[Row] row表示一行数据,例如Row=["1",23,44] RDD /DataFream/Dataset 之间可以相互转化 2. DataFream 内部数据无类型统一为row DataFream是一种特殊的Dataset 3. Dataset 内部数据有类型,需要用户自己设定 Spark SQL数据源 RDD->DataFrame:反射方式 1.定义case class ,作为RDD的schema 2. 直接通过RDD.toDF,将RDD转为DataFream import org.apache.spark.sql.SparkSession import org.apache.spark.sql.Row case class User(userID:Long,gennder:String, age: Int, occupation: String, zipcode: String) val userRdd=sc.textFile("//") val userRDD=usrRdd.map(_.split("::")).map(p=>User(p(0).ToLong,p(1).ToStringp(2).toInt, p(3), p(4))) val userDF=userRDD.toDF() userDF.count() json->DataFrame val userjson=spark.read.format("json").load("//user.json") //一行json数据要在一行 userjson.take(10) val userjson=spark.read.json("") userjson.take(10) text->DataSet val userDS=spark.read.textFile("").map(_.split(":")) RDD、DataFrame与Dataset的关系 val ds = df.as[Person] // DataFrame -> Dataset val df2 = ds.toDF() / Dataset -> DataFrame val rdd1 = ds.rdd // Dataset -> RDD val rdd2 = df.rdd // DataFrame -> RDD

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册