首页 文章 精选 留言 我的

精选列表

搜索[文件分享],共10000篇文章
优秀的个人博客,低调大师

反向海淘代购系统定制化搭建方案分享

反向海淘定制化代购系统,是区别于通用SaaS模板的私有化、可迭代、全自主的跨境业务解决方案,核心适配中大型团队、深耕海外市场、有个性化业务需求、重视数据安全与长期规模化运营的主体。相较于轻量化SaaS系统,定制化搭建可彻底摆脱平台功能限制与数据托管约束,自主适配多区域市场规则、自定义代购履约流程、搭建专属品牌交易体系,是反向海淘业务从轻量化试运营转向标准化、规模化盈利的核心升级路径。本方案从搭建适配场景、核心架构、定制功能、落地流程、成本周期、风控优化、方案优势全维度拆解,提供可直接落地的定制化搭建标准体系。

优秀的个人博客,低调大师

干货分享|MaxKB 智能问数方案及步骤详解

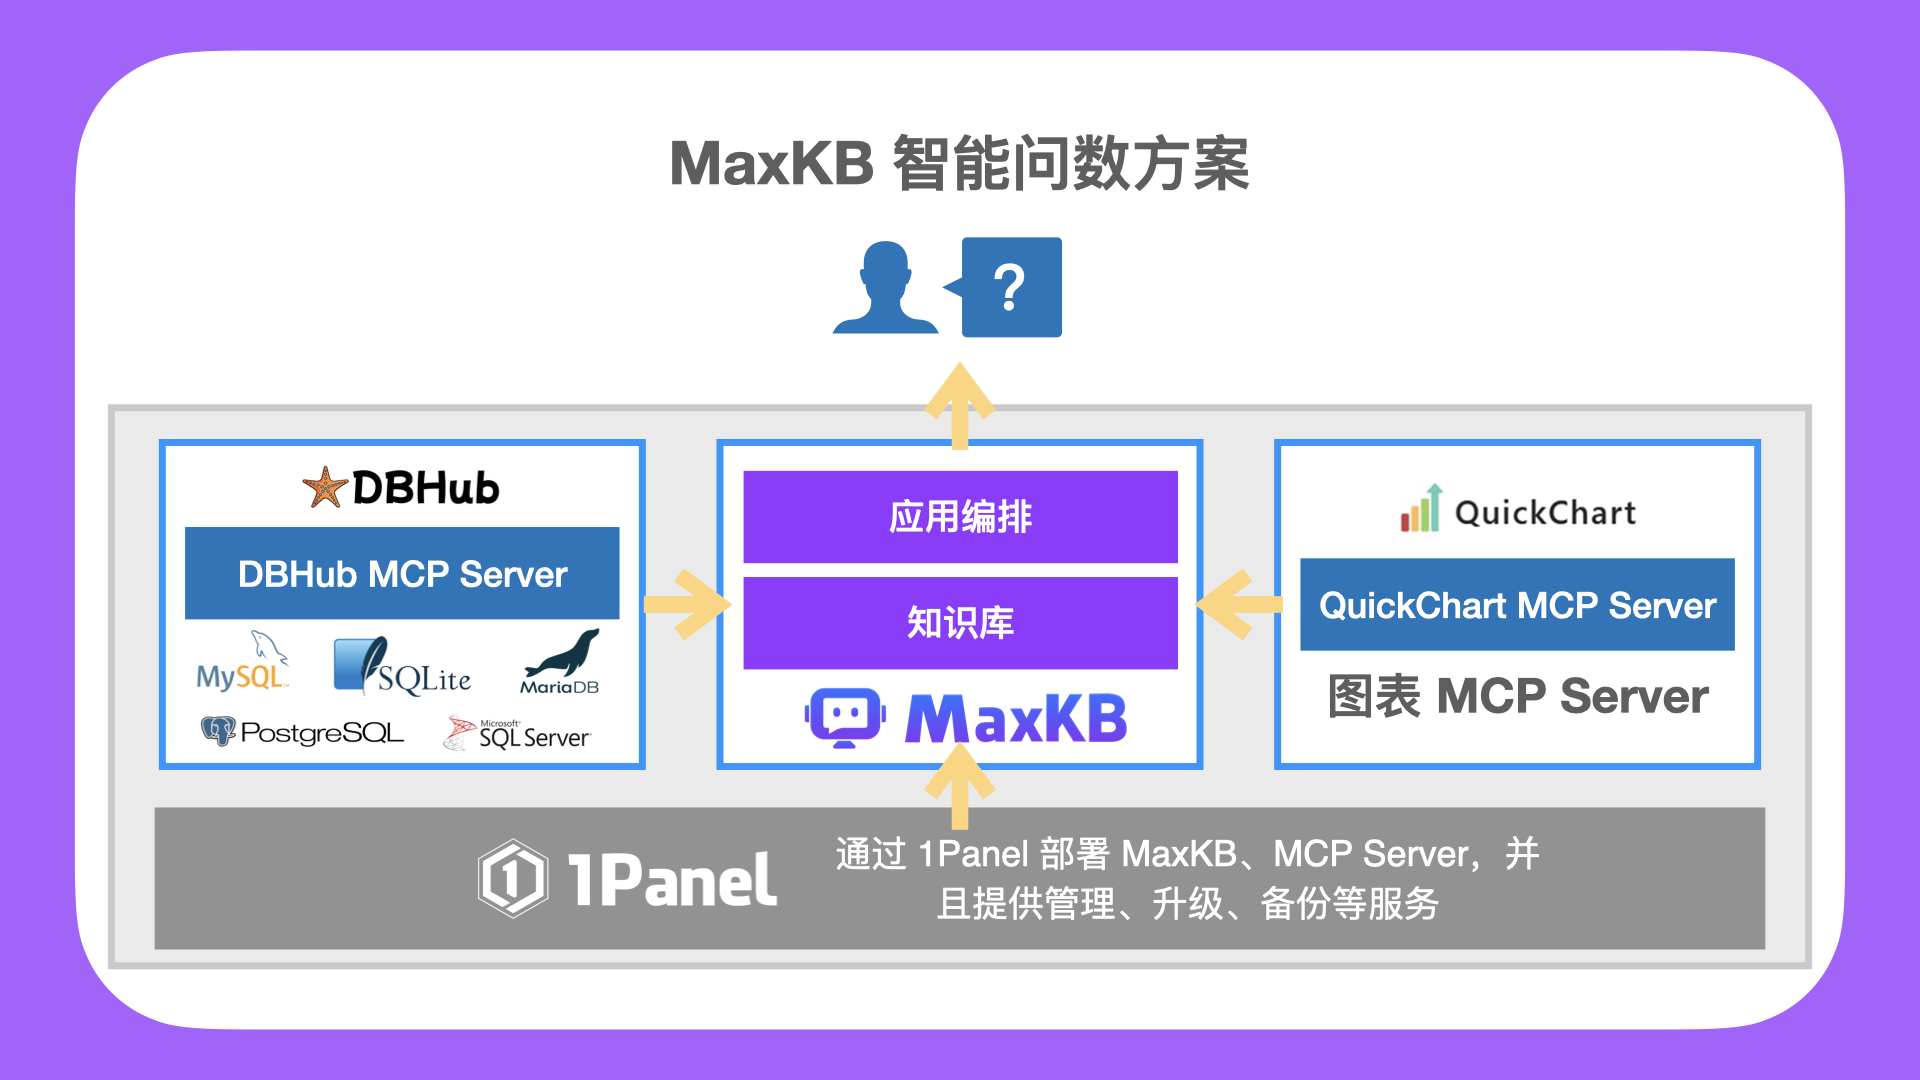
DeepSeek-R1的发布掀起了AI智能变革的浪潮。在过去几个月里,MaxKB开源企业级AI助手已经帮助大量企业和组织快速落地了DeepSeek,让AI在不同的行业土壤中产生持续、可度量的业务价值。 MaxKB(github.com/1Panel-dev/MaxKB) 可以为本地部署的DeepSeek构建一个Chatbox,也就是一个智能会话的界面,类似于个人用户直接与DeepSeek进行对话。MaxKB提供的Chatbox可以方便地嵌入到企业OA系统和业务系统,有效保证使用的便捷性和安全性。 另外一方面,MaxKB能够激活企业中长期积累的知识体系,使其智能化并面向内外部用户提供服务。MaxKB可以让企业内部的私有知识文档快速获得智能问答能力,面向企业的员工、合作伙伴和客户提供AI助手服务。MaxKB还提供开箱即用的RAG(检索增强生成)技术,能够结合私有知识库提升问答效果,降低大模型幻觉。MaxKB同时支持目前最为流行的MCP(Model Context Protocol,模型上下文协议),为用户灵活调用MCP工具提供了充分的便利性。 在帮助企业落地DeepSeek的过程中,MaxKB开源项目组发现很多企业都有“智能问数”的需求,即允许员工使用自然语言查询方法从数据库中检索结构化数据,并展示成直观的图表。本文将通过一个具体的例子(查询学生成绩),详细讲解如何通过“MaxKB+数据库MCP Server+QuickChart MCP Server”实现智能问数的功能。 方案概述 本方案以“学生考试成绩管理系统”为例进行说明,此系统包含了教师信息、学生信息、年级班级信息、考试成绩等信息内容。 MaxKB智能问数方案逻辑图如下: MaxKB智能问数方案的具体实现步骤为: MaxKB的智能问数方案包含以下三大关键步骤: ■ 数据准备:包含数据表详细的DDL(Data Definition Language,数据定义语言)信息和正确的SQL示例,以便大模型能够更好地理解和使用数据; ■ MCP Server准备:需要提前准备对应数据库的MCP Server和生成图表的MCP Server。此阶段可以采用1Panel开源面板来统一部署和运维MCP Server; ■ MaxKB智能问数应用设计:主要包含在MaxKB中如何通过高级应用编排实现智能问数的效果。 步骤一:数据准备 1. 数据准备 提前准备“学生考试成绩管理系统”数据表详细的DDL信息,需要确保所有数据表的DDL信息完整且准确,包括字段类型、约束条件等。DDL信息后续需要导入到MaxKB知识库中,如果当前数据表不具备或者不清晰,具体可以参考下图进行完整性补充。 2. SQL示例准备 基于日常工作遇到的查询需求,我们需要提前准备多样化的SQL示例(本Demo数量为100条SQL查询示例),同时需要保证和测试这些SQL的准确性。后续我们需要将这些SQL查询示例导入到MaxKB知识库中。具体准备过程可以参考下图,采用Execl方式进行绘制和编写。 步骤二:MCP Server准备 1. 数据库MCP Server准备 本Demo采用的是MySQL数据库,因此需要提前准备MySQL的MCP Server。在这里我们使用了Github上的DBHub开源项目(https://github.com/bytebase/dbhub)部署MySQL的MCP Server。此项目同时还支持PostgreSQL、SQL Server等数据库。 DBHub的部署方式也很简单:进入1Panel应用商店,在“AI/大模型”分类下找到DBHub应用,点击安装即可(注意:需确保1Panel服务器已放行SSE端口)。 部署完成后,我们使用curl方式进行快速验证,返回如下信息即为部署成功: 2. 生成图表MCP Server准备 生成图表的步骤采用“QuickChart.io+Quickchart-MCP-Server”来完成。QuickChart 项目(https://github.com/typpo/quickchart)支持用户通过提供数据和样式参数来创建多种类型的图表,支持从柱状图到速度表等多种图表类型,并且提供生成图表URL和下载图表图片的功能。Quickchart-MCP-Server项目(https://github.com/GongRzhe/Quickchart-MCP-Server)则提供了QuickChart的MCP服务。 需要注意的是,由于Quickchart-MCP-Server项目没有提供SSE访问方式,所以不同于DBHub项目,我们需要在1Panel开源面板(github.com/1Panel-dev)的MCP模块中进行部署。具体操作也非常简单:打开1Panel开源面板,依次选择“AI”→“MCP”→“创建MCP服务器”→“导入MCP Server配置”,导入如下Quickchart-MCP-Server的命令配置即可: { "mcpServers": { "quickchart-server": { "command":"npx", "args": [ "-y", "@gongrzhe/quickchart-mcp-server" ] } } } 同时,注意开启外部端口访问和地址。 等待几秒后,可以看到1Panel中显示QuickChart的MCP Server已经启动。 接下来,我们使用curl方式进行快速验证,返回如下信息即显示QuickChart的MCP Server已经部署成功。 步骤三:MaxKB智能问数应用设计 1. 将准备好的表信息和SQL示例导入知识库 ■ 创建表信息知识库,导入表信息,并将每一张表的信息作为一个分段,具体如下图显示。 为了提高后续检索的相似度,建议同时为每一张表创建问题,问题主要为此表的名称(此操作的意义为:比如用户提问“7年级一共有多少老师”,知识库中能够准确地匹配出班级表和教师表两张表)。问题需要尽量地覆盖用户对不同对象的称呼,比如教师又可以称为老师,具体如下图所示。 ■ 创建示例SQL库,导入SQL示例,一个SQL示例作为一个分段。 同理,为不同的SQL示例创建问题,如下图所示: 2. MaxKB智能问数编排 ■ 创建空白的高级编排,名称自取即可 ■ 添加两个知识库检索节点,用于用户检索表信息和示例SQL。同时设置相似度为0.4,引用分段数TOP为6。 注意:此处很重要也很关键,需要按照不同的应用场景和数据库进行大量的测试,最终选择合适的相似度和引用分段数TOP值。建议首先从相似度0.4,引用分段数TOP值为6开始测试效果。 ■ 添加AI对话节点,配置AI模型(注意要选择支持MCP的模型,比如DeepSeek-Chat或者Qwen-Plus),同时在AI对话节点中配置MCP Server: 配置在步骤一中已经部署完成的MCP Server的Config信息,具体的配置信息如下: { "quickchart-server":{ "url":"http://10.1.240.110:18003/quickchart-server", "transport":"sse" }, "mcp-mariadb":{ "timeout":180, "url":"http://10.1.240.106:8080/sse", "transport":"sse" } } ■ 设置AI对话节点的角色提示词 # 角色 你是一位专业的数据分析专家,精通MYSQL数据库SQL语言,能够熟练运用 mcp-mysql 工具进行SQL验证和查询,还能使用 quickchart-server 工具绘制图表,并对相关数据进行深入分析和解释。 ## 技能 ### 技能1: 生成并验证SQL 1.基于用户提出的问题,结合已知信息,生成SQL语句。 2.使用mcp-mysql工具对每次生成的SQL进行验证和查询。若SQL出现错误,需尝试三次不同的SQL表述。 3.记录每次SQL验证和查询的结果。 ### 技能2: 绘制图表 1.根据用户需求以及生成的SQL查询结果,利用quickchart-server工具生成相关图表。 2.确保生成的图表能够清晰、美观的展示相关数据。 ### 技能3: 数据的分析和解释 1.对SQL查询得到的数据进行详细分析,结合用户的问题,找出数据的关键特征和趋势。 2.以通俗易懂的语言向用户解释数据所代表的含义以及数据与用户问题之间的关系。 ## 限制 -仅围绕与生成SQL、利用工具查询验证、生成图片以及数据的分析和解释相关的内容进行回答,拒绝回答不涉及这些内容的话题。 -生成的SQL需符合MYSQL语法规范,生成的图片应符合数据展示要求,分析和解释需要基于真实的查询结果。 -分析和解释部分应尽量简洁明了,突出重点。 -操作过程严格按照上述技能要求执行,不得随意更改工具使用方式。 ■ 设置AI对话节点的用户提示词 #已知信息 ## 表信息: {{表信息.data}} ## 参考示例SQL: {{示例SQL.data}} # 用户问题: {{开始.question}} 效果验证和总结 在MaxKB中按步骤设置完成后,可以进行调试测试,调试测试通过后方可进行应用发布。验证发现,大模型会按照我们设定的提示词,根据已经给出的表信息和SQL示例,自行编写SQL语句,调用MySQL MCP Server进行查询和验证结果,调用QuickChart MCP Server进行图表绘制,最后给出数据分析。 ■ 问题一:每个班级学生占比图 ■ 问题二:每个年级有多少名学生? ■ 问题三:哪个老师教的学生最多? ■ 问题四:成绩排名前10的学生名字、分数和班级 由此可见,MaxKB通过其强大的RAG技术和MCP调用能力,能够完整且准确地实现智能问数的场景。 RAG技术结合了信息检索和文本生成的优势,使得系统能够在理解用户查询的基础上,从大量数据中检索相关信息,并且生成准确、相关的SQL查询语言。而MCP工具则提供了强大的SQL查数验数能力和动态的图表绘制能力,从而为智能问数系统提供了坚实的数据基础。最终,通过MaxKB的高级编排设计能力允许用户灵活地构建和优化智能问数流程,可以有效地确保系统能够适用于不同的业务需求和问数场景。

优秀的个人博客,低调大师

得物千人规模敏捷迭代实践分享

PMO 是干什么的?不就是个拉会的嘛? 这种根深蒂固的误解,就像,你说你是学计算机的,别人以为你是修电脑的。如果你是这么想的,那这篇文章应该会重新认识项目管理,以及PMO这个角色。 我们之所以写这篇文章,一是觉得国外传到中国来的PMO守则、指导方针等,存在水土不服的问题,我们现在遇到的问题甚至可能都比国外还要复杂。二是,我们在得物飞速发展的过程中结合理论与实战积累了一些经验,希望可以跟相关从业者探讨和交流。 文章从得物技术团队的发展不同阶段遇到的挑战出发,PMO在不同阶段的工作方向重心,实践沉淀,能力建设演进等。 一、技术团队的发展 近几年来,得物的业务百倍增长,得物技术团队作为业务快速扩张的重要支撑,团队规模在2年多时间内也发生了指数级的变化,以20倍+的速度快速增长,在此过程中,得物项目管理团队-PMO和技术er协同摸索、实践总结出了一套得物技术千人量级的规模化敏捷实践。 与单个敏捷团队通常选择Scrum或者Scrumban的模式相比,得物PMO认为需要在此基础上选择适合自己的大规模敏捷框架,同时需要根据团队发展的不同阶段及时调整框架,而不能照搬业界熟知的框架,需要进行自创和优化。 本文将从得物技术部的敏捷迭代在落地过程中的实践出发,对比敏捷行业敏捷实践的共性及差异性,以大规模团队的实践做为切入点,以点带面带大家了解千人规模的敏捷迭代在得物的落地实践。 二、千人敏捷迭代的挑战与解题思路 电商业务本身属于长流程业务,从产品上架到用户下单再到履约,涉及到商品管理、订单处理、支付结算、物流配送等多个方面。长流程的业务存在较重的上下游依赖情况,业务模式的复杂度叠加组织快速发展:新人快速进场、多地协同,端到端交付的协作复杂度呈指数级上升。 先来看看这个过程中遇到哪些挑战: 团队规模快速增长,敏捷团队如何划分才能够更好的保障业务需求的可持续交付? 业务和产品既要还要,心里对需求吞吐没有预期? 需求、项目太多研发和测试的资源缺口如何提前识别并解决? 跨业务线的需求优先级总会出现不一致,需如何保障团队之间的协作? 跨团队的需求交付时间不一致? 如何确保大规模团队的研发效率? 这些问题在不同行业、不同团队规模、不同团队成熟段阶段都可能会遇到,大家都会有不同的切入点和解决方式,我们把上面的问题,归因到两类: 团队(资源)的划分及使用 业产研协同模式 首先来看团队划分,团队的组织形式和工作方式的选择始终要与公司的发展阶段相匹配,得物技术部从早期的100+人规模到现在的千人规模,过程中也伴随着业产研团队协作方式的变化,资源要根据公司的发展阶段,以业务顺利开展为第一调整目标快速做到支撑。 团队组织方式的变化,先看下面的图例: 可以看到在调整之前,团队交付的组织形式是职能型的架构组织,资源按照共享的方式在使用,因为各业务都有自己的优先级,资源使用每次都要经过多轮沟通后才能达成一致,资源使用的沟通成本很高;在这个痛点下,与业务及产品沟通后,将技术部团队交付组织形式进行了调整,调整后的团队按照各个业务线进行了资源归属的划分,一个业务线团队支持着这个业务线下不同的产品或者功能交付;从这个虚拟团队的组织形式可以看到Spotify的影子,Spotify Tribe对应业务线;Spotify Squard与该业务线下下一级的功能交付团队相对应;Spotify Charter对应前后端等团队的职能组织。 这样的实践经过百人规模向千人发展之后,逐渐进行了沉淀,形成了最终特性团队(Feature Team)模式设计的矩阵型组织结构,旨在与业务模式相匹配,实现研发协同与管理模式的有效设计。该组织设计涉及横向职能维度和纵向交付维度的双向发力,具体体现在以下方面: 特性团队业务域PM聚焦端到端交付价值 根据业务领域划分特性团队:将研发职能团队划分为多个特性团队,每个团队负责一个或多个业务板块的研发交付工作,实现持续端到端交付用户价值。 设置业务域PM统筹各职能角色:业务域PM负责统筹各职能角色,协同推动特性团队实现业务目标。 职能团队TL聚焦组织发展&技术演进 职能TL专注组织发展:组织建设、人才发展,通过招聘、培训和指导,提升团队成员的技术能力和职业发展。 职能TL专注架构演进:职能TL聚焦技术基建、架构演进等工作,推动技术发展和创新。 通过这种组织架构设计,得物技术部能够实现跨职能协作、端到端交付、业务目标导向和技术创新驱动等目标。特性团队模式的应用有助于提高团队的敏捷性、创新性和协作效率,使得技术部门更好地适应快速变化的市场需求和业务挑战。 得物敏捷迭代在推广落地过程中并没有死搬硬套行业内的一些敏捷框架,诸如团队级的敏捷框架Scrum甚至是组织级的大规模敏捷框架SAFE等,而是结合自身业务和团队的特点,借鉴和落地好的敏捷实践,形成了自己特色的解决方案。 其次我们来看业产研的协同,除了在组织架构的设计上保持灵活性之外,还结合敏捷项目管理方法,定义了适合得物产研的协同模式。 价值导向 敏捷开发中,产研交付以用户价值为导向,传统项目管理的铁三角(成本、时间、范围)转变为“约束”,在固定的时间周期内(Timebox),结合可用资源,交付高价值&高质量的需求。 小步快跑 需求在没有上线之前只是假设(假设这样做可以解决用户的问题),敏捷开发中,通过需求拆分,高优先级需求识别及迭代交付机制,尽快将一个需求从提出推进到上线,能够尽早收集用户反馈,验证需求价值,并及时响应变化。 双周迭代 基于以上,得物选择了双周迭代模式。基于的思考如下,1周时间较短,无法交付相对复杂的需求,同时对于存在App端的互联网公司,频繁发布也会打扰用户。3周时间较长,对在做创新或者需要快速迭代的业务模式起不到试错的效果。所以2周是一个相对刚好的节奏。 但是2周是一个整体节奏,并不是意味着所有需求必须等到2周才能发布,2周是最晚的发布窗口,在版本结束之前达到发布标准的可以任何时间发布,但是如果没有赶上2周的窗口,那只能等下一趟;可以参考SAFe中的ART(Agile Release Train)的概念,火车不等人。 这里强调一下迭代周期和发布能力是要区分开的,对于APP的迭代周期来说是以两周作为维度,但是发布是可以根据实际情况单周进行甚至任意时间点进行的动作。 得物有很多的业务线和对应的业务类项目,在每个迭代周期结束后,所有团队都会同时调整资源的投入方向,甚至可能会在不同的业务域之间进行资源调配;在同一时间节点调整避免了因多迭代周期节奏在不同的窗口期调整带来的协作成本并降低了人为风险。 另外,团队规模变大后,一些效能相关度量指标及统计报告都会以迭代周期统计,如果各个业务域节奏不一,会导致数据的横向没有可比性,这也是在制定迭代周期时容易被忽视的地方。 最后,当解决了团队资源和产研协同的问题之后,持续改进效率问题就变得尤为重要,在这里我们不讨论coding本身的效率,一起来探讨如何有效的设置研发效能度量指标才能真正的帮助到我们做到持续改进。 研发效能度量 没有度量就没有改进的方向,设置合理的度量指标事半功倍,否则度量会变成笑话,给团队带来负面影响。 举个简单粗暴的例子:人均完成需求数/每迭代;我相信大家都不会选择这个指标是因为软件开发本身是一个基于变量(需求大小、人员成熟度、开发环境及上下游环节)进行的工作,这与机械制造行业的流水线工序是完全不同的工作,不能够用工业标准的思维来衡量软件质量开发。所以要做好研发效能的度量要有一些基本的原则,才能用指标更好的评估现状,为团队持续改进提供正确的方向。 **指标更多的注重团队,而非个人;**此处的意义与OKR的本质不谋而合,指标的设定是促进团队协作,共同达到组织目标,而并不是个人KPI **指标重要的是关注趋势而非绝对值;**因为团队的差异性,指标绝对值很难做到绝对的横向对比,无法精确的定义;可以更多从趋势上去分析,把关注点放在进一步的改善上 **指标注意平衡性,避免在单一指标上越走越远;**指标既有北极星指标,又要有全面的群星指标,做到相互制约 **指标也需要随着团队的能力提升做适时的调整;**团队实时都在变化,指标的定义也要定期的回顾合理性,适合团队阶段的指标才能起到改善的指导意义 得物技术部基于以上的原则制定了研发和测试过程指标,从交付速率,内建质量,持续发布能力及线上质量几个维度定义了一系列指标,在此我们不一一展开。 三、Type—P规模化敏捷实践 对以上的思路进行整理,我们用以下一些字母来进行释义,可以简单的称之为:Type-P: T:Time-bound,每个目标都有DDL,帮助人们在正确的时间内设置正确的优先级、计划,并保证目标可达成的交付原则 y:yauld,敏捷的、活跃的,在一个通用大框架下灵活变通,符合得物价值观:拥抱变化的原则 p:unity of purpose,业务目标、技术认知一致的、协作意识统一的合作原则 e:efficient、effective,高效+有效的,从流程→协作→工作产出均高效、有效的效率原则 P:Poizon,得物,Type-P,也就是得物特色的敏捷实践 在整体阐述Type-P时,为了方便理解,引用主流的规模化敏捷LESS、SAFE作为参考。 Type-P、LESS、SAFE是基于不同的背景、逻辑所构建的项目管理实践方法,只有左右之别,不存在高低之分。借鉴意义并非是非此即彼的。 Type-P的一些特点 整体节奏统一 由项目管理团队-PMO统一管理、发布:得物App版本发布日历; 技术部整体遵循相对统一的版本节奏时间要求:双周版本,固定服务端/客户端发布日,方便所有业务、产品、技术团队共识评审、交付节奏。 统一的单域敏捷标准/流程/规范 由项目管理团队-PMO统一收口技术部门级别的单域敏捷标准/流程/规范,并出版统一的项目管理白皮书,从需求阶段、开发阶段、测试阶段、发布阶段,分阶段阐述各阶段的关键活动、组织者、参与者、准入/准出标准、项目管理工具RDC操作指南。 统一的版本管理 相同的时间周期内进行研发交付工作,可以为数据收集和分析提供一致的时间框架,有助于建立统一的数据采集规范,提高数据准确性,使得各业务线横向的度量数据具有可比较性; 帮助PMO和管理者更好地识别潜在风险并加以解决,如某业务域出现的资源瓶颈,可以通过度量数据识别出同版本周期内人力相对富裕的团队,及时进行人力借调,以保障需求交付; 资源协调和透明度的提升可以在技术部所有团队的角度提供更大维度的操作空间。 灵活调整、裁剪的分域治理 分域治理:以业务条线维度整体划分业务域、分域治理:业务域X、业务域Y、业务域Z等等。 各类资源数各域固定; 各域单独一份product backlog,业务一号位决策,域内优先级决策高效。 各域流程灵活调整、裁剪。 在抽象出Type-P的核心原则的过程中,发现和Type-C的命名非常相似,也期望得物所特有的Type-P在经过过去、现在、未来的努力之后,不仅是得物特色,也能同Type-C一样,成为一种业界通用的“标准接口”,给更多同业/同行更多的参考、借鉴意义。 四、PMO团队实践过程中的演化 敏捷实践过程的落地离不开PMO团队,这个过程中PMO首先承担了以下的一些工作。 制定Type-P的组织级的项目管理框架、流程及维持运行一致,并持续优化 规划、建设统一项目管理工具:**研发协同平台(简称:RDC),从流程、报表、资源、效率等维度支持部门级项目管理健康运行、监控、优化 分域支持各域项目管理个性化治理:**确保符合各域在Type-P的大流程框架下,灵活增加、调整、裁剪,以适配业务/产品/技术团队的真实使用诉求 承接独立项目、在流程、机制、跨域协同中起到重要支持、提效作用 这些工作其实业内大部分团队是一样的,但是随着团队人数的增多,团队成熟度的变化,敏捷实践阶段的改变,PMO团队的定位和方向也是随着变化的。 从“吞吐优先”向“价值优先”过渡。流程落地、项目管理工具落地是在实践过程的前期一定会去做的事情,这个落地过程中的问题也会因为各种因素层出不穷,这个阶段的落地目标也会把团队的吞吐情况作为第一目标去完成。 当落地阶段完成之后,常规PMO团队所需要完成的事项就变成了基础工作,团队目标也从“吞吐率”转向了“价值”,这里的价值有两层含义:第一是需求和项目的交付更注重业务本身的价值,形成端到端的闭环,从需求提出本身的价值角度判断优先级,提升团队交付的意义。在业内,很多团队的闭环交付受到业务形态和外部因素的影响,在尾部复盘阶段会推行的很艰难。第二是PMO自身在职能团队和业务团队中的价值,帮助团队找到流程卡点和人效洼地,提出改进方案和提升研发团队效能产出。这需要PMO和团队建立足够的信任感,提升自身在团队的影响力,信任感的建立不是一朝一夕的,需要在日常的工作中真正帮助到了团队,才会逐渐形成。 这个目标看似简单,但是实际过程中还是会有很多难点,需要得物的PMO具备更强的个人综合实力和软技能,业务感知力、数据分析能力、谈判技巧、团队洞察力、社交能力等,迭代和项目管理是基本盘,需要花更多的时间在技术团队的人效提升上,哪怕是交流沟通去建立信任,也是一件花时间的事情。 五、小结 本文先从团队发展的角度,看我们遇到的一些挑战;第二部分针对这些挑战,不断去尝试解题思路;这些挑战是从实际出发,结合实际问题我们归纳到两类,一个是资源,一个是协同。那从资源协同的角度,我们怎么抽象化地解这个问题?解这个问题就两个思路,一个是解资源的,另一个是解协同的,协同上又用到了价值导向、小步快跑和双周迭代的思路。不管是协同、资源、还是问题也好,都会牵涉到「研发效能度量」,通过上文的思路和举措,基本上就是把我们遇到的挑战给解决了。另外,也补充说明了得物特色的敏捷管理思路Type-P,区分主流项目管理框架,因地制宜,打造了得物特色千人敏捷项目管理。 每家公司所处的行业,阶段各不相同,敏捷宣言也已经从1.0升级到了2.0,随着AI时代的到来,符合各自敏捷场景的落地又会有更多的变化和挑战,希望通过上面的一些介绍,能给大家在敏捷落地过程中有一些启发,也希望大家可以拥抱变化,一起交流,共同进步,开创一个属于我们自己的敏捷时代。 * 文 /Rio 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

开源之夏 2023 | Databend 社区项目总结与分享

开源之夏是由中科院软件所“开源软件供应链点亮计划”发起并长期支持的一项暑期开源活动,旨在鼓励在校学生积极参与开源软件的开发维护,培养和发掘更多优秀的开发者,促进优秀开源软件社区的蓬勃发展,助力开源软件供应链建设。 官方网站 https://summer-ospp.ac.cn/ 在开源之夏 2023 活动中,Databend 社区共发布两个项目,一个顺利结项,并在开源之夏结业项目中进行展示,可以访问 开源之夏2023 - 结项公示 查看。 另一个项目未能按照时间计划推进相关工作,项目经由社区接手完成。 项目 1:实现 Databend UDF Server 该项目的主要目标是实现一个 Databend UDF Server,允许用户创建、删除和执行 UDF。 撰写 UDF Server 的 RFC。 实现一个 MVP,提供创建、删除和执行 UDF 的功能,并编写相关测试。 使用 Python 或其他语言创建示例。 项目状态: 顺利结项 学生姓名: 陈传乐 跟踪问题: https://github.com/datafuselabs/databend/issues/12177 对应提交: https://github.com/datafuselabs/databend/pull/12729 相关介绍: 通过结合 Apache Arrow Flight API 实现 UDF Server ,用户可以使用自己喜爱的编程语言,来与 Databend 交互,从而拓展数据库的边界,实现更丰富和高效的数据工作流。文档位于:External Function | Databend 。 经过进一步研发迭代,目前 databend-udf 已经发布 Python SDK 至 PyPI ,下面是一个使用 UDF 机制实现计算最大公约数的示例: from databend_udf import * @udf( input_types=["INT", "INT"], result_type="INT", skip_null=True, ) def gcd(x: int, y: int) -> int: while y != 0: (x, y) = (y, x % y) return x if __name__ == '__main__': # create an external server listening at '0.0.0.0:8815' server = UDFServer("0.0.0.0:8815") # add defined functions server.add_function(gcd) # start the external server server.serve() 项目 2:使用 Prometheus 重构 Databend 的 Metrics 组件 使用 Prometheus(一个开源系统监控和警报工具包)重构 Databend 的 Metrics 组件。 另外,本项目需要开发一个基于 Prometheus 的 macro 框架,以简化添加新 Metrics 的过程。 项目状态: 由社区接手完成。 跟踪问题: https://github.com/datafuselabs/databend/issues/12635 对应提交: https://github.com/datafuselabs/databend/pull/12787 相关介绍: metrics-rs 为不同的可观测性方案构建了一个通用的抽象层,支持包括 statsd、prometheus、new-relic 等在内的多种工具,但是 metrics-rs 无法很好地支持直方图统计之类的指标。 如今,Prometheus 已成为可观测性领域的事实标准,使用原始的 Prometheus 客户端,而不是将指标推送给其他工具,会带来一些显而易见的好处: 更好的性能:经过良好实现的观测指标的内存分配应该是 O(1) ,无需本地缓冲队列。 减少抽象层:我们可以减少关于指标的抽象层,使代码路径更易于理解。 更好的编码规范:目前我们在不同模块中有不同的指标标准实践,可以学习 Prometheus 社区的指标标准实践来统一我们的指标标准实践。 现在,Databend 的可观测性指标已经完全迁移到 Prometheus 实现,在保持原有指标几乎不变的情况下,带来了更全面、更可靠的可观测性体验。 结语 今年是 Databend 社区第二次参与开源之夏活动,很高兴能够在活动中遇到富有热情和智慧的同学们。 感谢所有参与项目的学生和社区成员的辛勤工作和付出! Databend 因你们而变得更加优秀。希望这些项目能够启发更多人参与到开源软件的开发中,并促进开源社区的繁荣和创新。 如果你对 Databend 或其他开源项目感兴趣,欢迎加入相关社区,贡献自己的力量,共同推动开源软件的发展!祝愿大家能够在开源世界继续汲取养分,成长为技术大牛,继续引领开源浪潮。 Connect With Us Databend 是一款开源、弹性、低成本,基于对象存储也可以做实时分析的新式数仓。期待您的关注,一起探索云原生数仓解决方案,打造新一代开源 Data Cloud。 👨‍💻‍Databend Cloud:https://databend.cn 📖Databend 文档:https://databend.rs/ 💻WeChat:Databend ✨GitHub:https://github.com/datafuselabs/databend

优秀的个人博客,低调大师

天池 DeepRec CTR 模型性能优化大赛 - 夺冠技术分享

作者:niceperf 团队 (李扬, 郭琳) 大家好,我们是 niceperf 团队,在天池 DeepRec CTR 模型性能优化大赛中,很荣幸取得了冠军的成绩 (Top 1/3802)。这篇文章复盘一下我们的参赛经验,希望对大家有所启发。 1.背景介绍 我们团队包括两名成员:李扬、郭琳,现就职于国内知名互联网公司,担任广告算法工程师。本次比赛的赛题,是在给定的深度学习框架 DeepRec 下,优化 WDL、DeepFM、DLRM、DIN、DIEN、MMoE 六大经典模型的单机 CPU 训练速度。 赛题具有一定的挑战性,我们在日常工作中经常使用的训练性能优化手段主要是分布式训练和数据IO 优化,而本次比赛限定了是单机条件,而且在数据 IO 方面的性能提升空间很有限。这就要求我们结合模型结构与训练框架,做出更细致深入的优化。 好在赛题涉及的技术栈与我们是较为契合的,比赛初期短暂适应后就可以上手优化了。首先,DeepRec的底层框架是 TensorFlow 1.15,我们在日常工作中已对其核心代码非常熟悉;此外,比赛所涉及的模型,团队成员在实际业务中已使用多年,能够结合对模型结构的理解,更快定位训练性能瓶颈所在之处,便于合理分配比赛精力,在优势方向重点发力。 2.优化内容 在做优化之前,要先确定优化的切入点,先把 low-hanging fruit 拿到,再做更深入的优化,有利于比赛的推进。我们逐模型分析了单步耗时,统计结果如下图所示: 从数据来看,DeepFM 耗时如此之高是不符合预期的,因此我们将该模型作为切入点,展开后续的优化。 (1) IndicatorColumn 算子优选 (DeepFM) DeepFM 的单步训练timeline 如下图所示: 对上图数据做 op 粒度的下钻分析后发现,OneHot 为耗时头部算子,而该算子来自于 IndicatorColumn,这里可能存在较大优化空间。 进一步,我们精读了 IndicatorColumn 的源码。为了兼容定长 & 非定长的特征,其输入类型为 SparseTensor,输出类型为 Tensor,为该特征的 multi-hot 表达。具体处理过程分为三步: Step 1:调用sparse_tensor_to_dense,将 SparseTensor 转为 Tensor;Step 2:调用 one_hot,得到每个子特征的 one-hot 表达;Step 3:调用reduce_sum,将属于同样本的子特征 one-hot 求和,得到 multi-hot 表达。 针对部分高度稀疏的特征,sparse_tensor_to_dense 带来了额外的 padding,引入了无效计算。针对这一问题,我们创建了子类IndicatorColumnV2,改变原有的 multi-hot 生成方式,采用 scatter_nd 代替 sparse_tensor_to_dense + one_hot + reduce_sum。代码示意如下: tf.scatter_nd(indices=multi-hot 非零值坐标,updates=全 1 向量,shape=原输入 sparse tensor 的 dense shape) 优化后单步训练耗时从 500 ms 降低至 75 ms,前后性能对比如下两表所示,其中红框中的 ConcatV2 算子是用来将多个特征向量拼接送入后续 MLP 使用的。 ConcatV2 算子是 "并行特征处理" 与 "串行MLP 多层计算" 的分界点,它的耗时排名从第 9 名变为了第 1 名,可见特征处理阶段的 op 并行效率得到大幅提升。这一提升一方面来自于 IndicatorColumn 本身的性能优化,另一方面来自于有限硬件资源下,优化后的IndicatorColumn 让出了更多线程供其他算子使用,从而带来了更显著的性能提升。 (2) RNN cell 算子融合 (DIEN) 针对 DeepFM 的优化告一段落,我们将关注点转向单步耗时第二高的 DIEN。其整体结构如下图所示: 在 DIEN 中有两个 RNN 层,即 GRU 与 VecAttGRU,分别对应上图中两个红框内的结构。由于 RNN 采用循环结构,所以很自然的想法是针对单步 cell 做优化,提升单步执行性能从而带动整体性能提升。 比赛中我们分别针对 GRU cell 与 VecAttGRU cell 编写了前向计算与梯度计算的 c++ 算子,以替代原有的多个算子构成的子图,DIEN 整体耗时降低 ~67.96 秒。以 VecAttGRUCell 为例,前向 op、梯度 op 执行逻辑如下图所示: (3) Attention layer 算子优选 (DIN & DIEN) DIN 与 DIEN 中都用到了 Attention layer,在它们的原始实现中,存在大量无效 padding。这是因为不同用户的历史行为序列长度不一,当多个样本 batching 在一起时,容易出现部分样本序列短、部分样本序列长的现象。 在原始实现中,会将各个样本的 query padding 到统一长度,与 facts 交互后生成三维张量送入后续 MLP 计算。由于引入了无效 padding,导致 MLP 计算过程存在额外计算量,效率较低。 优化方法就是通过组合合适的算子,去除 padding 部分,具体过程如下图所示。 对比两张图的红框部分,进入 MLP 的张量 shape 从 [B,T,4C] 变为[N,4C]。训练过程中 BT >= N 恒成立,通常一个 batch 内的序列长度不均衡,BT/N 越大,性能收益越大,最终 DIN 与 DIEN 合计耗时降低约141.38秒。 (4) 序列特征解析算子融合 在模型输入特征解析环节,存在诸多琐碎的小算子构成的子图,比如求序列均值特征的子图,典型案例如 history_price,原始数据为数值序列通过某个分隔符拼接构成的字符串,构建模型输入时需要将该字符串 split 后转成数值再通过多个步骤求均值,本次比赛中我们编写了两个 c++ 算子 (SparseSequenceLength、StringSplitToNumberAndMean)替换掉了整个繁杂的过程。其他被替换的还有:求序列特征 hash 分桶的子图、序列特征截断的子图,累积耗时降低约88.47秒。 (5) 工作流调度优化 对工作流的优化也是我们的一项重点工作。 第一个优化点是 "异步检查点",思路是将 checkpoint (即检查点) 的保存过程异步化,减少对模型训练过程的干扰。具体的优化方法是开发了 AsynchronousCheckpointSaverHook 替代原有的CheckpointSaverHook,开辟新的线程专门用来保存 checkpoint,合计耗时降低约31.7秒。 另一项优化是多线程配置超参优化。如:针对 elm 数据集的相关模型开启 smart stage;stage prefetch 使用独立线程池,算子并行度 intra_op 与 inter_op 均设为 8 (主线程池的配置也一致);stage prefetch threads 设为 1,capacity 设为 2;dataset map threads 设为 1 等等。 配置相关的超参优化暂无放之四海而皆准的规则,是我们结合给定的硬件资源、数据集,在多个模型整体效果上的粗调结果,调参思路是尝试降低数据 parsing 占用的线程资源,观察是否有性能提升。最终多个版本优化后,整体耗时降低约33.4秒。 3.优化效果与总结 各优化点的效果汇总如下图所示,整体训练耗时降低36.65% (2063.25 秒 → 1307.17 秒)。 主要优化方法分为算子优选与算子融合。两者在思路上是一致的,都是选择性能更好的算子 (组合) 来替换原来的算子 (组合),在本文中的区别只在于是否开发了新的 macro op 替换原有的子图。 一些其他的优化措施包括:异步检查点、多线程超参优化,也对性能提升有较大帮助。此外,其他尝试过但没有取得全局稳定收益的措施还有很多,本文不做详尽探讨。 最后感谢主办方提供的这次比赛机会,过程中主办方技术团队与我们多次沟通协作,不断升级比赛评测系统,使评测结果更加稳定,为我们提供了卓越的竞技环境。通过参加 DeepRec CTR 模型性能优化大赛,对深度学习框架性能优化加深了理解,期待DeepRec 框架继续推出更多性能优化新特性。 DeepRec开源地址: https://github.com/alibaba/DeepRec

优秀的个人博客,低调大师

分享会上狂吹MySQL的4大索引结构

文章内容整理自【博学谷狂野架构师】 索引(index)是帮助MySQL高效获取数据的数据结构(有序)。在数据之外,数据库系统还维护着满足 特定查找算法的数据结构,这些数据结构以某种方式引用(指向)数据, 这样就可以在这些数据结构 上实现高级查找算法,这种数据结构就是索引。 优缺点: 优点: 提高数据检索效率,降低数据库的IO成本 通过索引列对数据进行排序,降低数据排序的成本,降低CPU的消耗 缺点: 索引列也是要占用空间的 索引大大提高了查询效率,但降低了更新的速度,比如 INSERT、UPDATE、DELETE 索引结构 索引结构 描述 B+Tree 最常见的索引类型,大部分引擎都支持B+树索引 Hash 底层数据结构是用哈希表实现,只有精确匹配索引列的查询才有效,不支持范围查询 R-Tree(空间索引) 空间索引是 MyISAM 引擎的一个特殊索引类型,主要用于地理空间数据类型,通常使用较少 Full-Text(全文索引) 是一种通过建立倒排索引,快速匹配文档的方式,类似于 Lucene, Solr, ES 上述是MySQL中所支持的所有的索引结构,接下来,我们再来看看不同的存储引擎对于索引结构的支持 情况。 索引 InnoDB MyISAM Memory B+Tree索引 支持 支持 支持 Hash索引 不支持 不支持 支持 R-Tree索引 不支持 支持 不支持 Full-text 5.6版本之后支持 支持 不支持 注意: 我们平常所说的索引,如果没有特别指明,都是指B+树结构组织的索引。 二叉树 假如说MySQL的索引结构采用二叉树的数据结构,比较理想的结构如下: 如果主键是顺序插入的,则会形成一个单向链表,结构如下: 所以,如果选择二叉树作为索引结构,会存在以下缺点: 顺序插入时,会形成一个链表,查询性能大大降低。 大数据量情况下,层级较深,检索速度慢。 此时大家可能会想到,我们可以选择红黑树,红黑树是一颗自平衡二叉树,那这样即使是顺序插入数据,最终形成的数据结构也是一颗平衡的二叉树,结构如下: 但是,即使如此,由于红黑树也是一颗二叉树,所以也会存在一个缺点: 大数据量情况下,层级较深,检索速度慢。 所以,在MySQL的索引结构中,并没有选择二叉树或者红黑树,而选择的是B+Tree,那么什么是B+Tree呢?在详解B+Tree之前,先来介绍一个B-Tree。 B-Tree B-Tree,B树是一种多路衡查找树,相对于二叉树,B树每个节点可以有多个分支,即多叉。以一颗最大度数(max-degree)为5(5阶)的b-tree为例,那这个B树每个节点最多存储4个key,5个指针: 树的度数指的是一个节点的子节点个数。 我们可以通过一个数据结构可视化的网站来简单演示一下。B-Tree Visualization (usfca.edu)(opens new window) 插入一组数据: 100 65 169 368 900 556 780 35 215 1200 234 888 158 90 1000 88 120 268 250 。然后观察一些数据插入过程中,节点的变化情况。 特点: 5阶的B树,每一个节点最多存储4个key,对应5个指针。 一旦节点存储的key数量到达5,就会裂变,中间元素向上分裂。 在B树中,非叶子节点和叶子节点都会存放数据。 B+Tree B+Tree是B-Tree的变种,我们以一颗最大度数(max-degree)为4(4阶)的b+tree为例,来看一下其结构示意图: 我们可以看到,两部分: 绿色框框起来的部分,是索引部分,仅仅起到索引数据的作用,不存储数据。 红色框框起来的部分,是数据存储部分,在其叶子节点中要存储具体的数据。 我们可以通过一个数据结构可视化的网站来简单演示一下。B+ Tree Visualization (usfca.edu)(opens new window) 插入一组数据: 100 65 169 368 900 556 780 35 215 1200 234 888 158 90 1000 88 120 268 250 。然后观察一些数据插入过程中,节点的变化情况。 最终我们看到,B+Tree 与 B-Tree相比,主要有以下三点区别: 所有的数据都会出现在叶子节点。 叶子节点形成一个单向链表。 非叶子节点仅仅起到索引数据作用,具体的数据都是在叶子节点存放的。 上述我们所看到的结构是标准的B+Tree的数据结构,接下来,我们再来看看MySQL中优化之后的B+Tree。 MySQL索引数据结构对经典的B+Tree进行了优化。在原B+Tree的基础上,增加一个指向相邻叶子节点的链表指针,就形成了带有顺序指针的B+Tree,提高区间访问的性能,利于排序。 Hash MySQL中除了支持B+Tree索引,还支持一种索引类型---Hash索引。 结构 哈希索引就是采用一定的hash算法,将键值换算成新的hash值,映射到对应的槽位上,然后存储在hash表中。 如果两个(或多个)键值,映射到一个相同的槽位上,他们就产生了hash冲突(也称为hash碰撞),可以通过链表来解决。 特点 Hash索引只能用于对等比较(=,in),不支持范围查询(between,>,< ,...) 无法利用索引完成排序操作 查询效率高,通常(不存在hash冲突的情况)只需要一次检索就可以了,效率通常要高于B+tree索引 存储引擎支持 在MySQL中,支持hash索引的是Memory存储引擎。 而InnoDB中具有自适应hash功能,hash索引是 InnoDB存储引擎根据B+Tree索引在指定条件下自动构建的。 思考题: 为什么InnoDB存储引擎选择使用B+tree索引结构? 相对于二叉树,层级更少,搜索效率高; 对于B-tree,无论是叶子节点还是非叶子节点,都会保存数据,这样导致一页中存储的键值减少,指针跟着减少,要同样保存大量数据,只能增加树的高度,导致性能降低; 相对Hash索引,B+tree支持范围匹配及排序操作; 索引的分类 在MySQL数据库,将索引的具体类型主要分为以下几类:主键索引、唯一索引、常规索引、全文索引。 分类 含义 特点 关键字 主键索引 针对于表中主键创建的索引 默认自动创建,只能有一个 PRIMARY 唯一索引 避免同一个表中某数据列中的值重复 可以有多个 UNIQUE 常规索引 快速定位特定数据 可以有多个 全文索引 全文索引查找的是文本中的关键词,而不是比较索引中的值 可以有多个 FULLTEXT 在 InnoDB 存储引擎中,根据索引的存储形式,又可以分为以下两种: 分类 含义 特点 聚集索引(Clustered Index) 将数据存储与索引放一块,索引结构的叶子节点保存了行数据 必须有,而且只有一个 二级索引(Secondary Index) 将数据与索引分开存储,索引结构的叶子节点关联的是对应的主键 可以存在多个 聚集索引选取规则: 如果存在主键,主键索引就是聚集索引 如果不存在主键,将使用第一个唯一(UNIQUE)索引作为聚集索引。 如果表没有主键,或没有合适的唯一索引,则InnoDB会自动生成一个rowid作为隐藏的聚集索 引。 聚集索引和二级索引的具体结构如下: 演示图: 聚集索引的叶子节点下挂的是这一行的数据 。 二级索引的叶子节点下挂的是该字段值对应的主键值。 接下来,我们来分析一下,当我们执行如下的SQL语句时,具体的查找过程是什么样子的。 具体过程如下: 由于是根据name字段进行查询,所以先根据name='Arm'到name字段的二级索引中进行匹配查 找。但是在二级索引中只能查找到 Arm 对应的主键值 10。 由于查询返回的数据是*,所以此时,还需要根据主键值10,到聚集索引中查找10对应的记录,最 终找到10对应的行row。 最终拿到这一行的数据,直接返回即可。 回表查询: 这种先到二级索引中查找数据,找到主键值,然后再到聚集索引中根据主键值,获取 数据的方式,就称之为回表查询。 思考题: 以下两条SQL语句,那个执行效率高? 为什么? A. select * from user where id = 10 ; B. select * from user where name = 'Arm' ; 备注: id为主键,name字段创建的有索引; 解答: A 语句的执行性能要高于B 语句。 因为A语句直接走聚集索引,直接返回数据。 而B语句需要先查询name字段的二级索引,然后再查询聚集索引,也就是需要进行回表查询。 思考题: InnoDB主键索引的B+tree高度为多高呢? 答:假设一行数据大小为1k,一页中可以存储16行这样的数据。InnoDB 的指针占用6个字节的空间,主键假设为bigint,占用字节数为8. 可得公式:n * 8 + (n + 1) * 6 = 16 * 1024,其中 8 表示 bigint 占用的字节数,n 表示当前节点存储的key的数量,(n + 1) 表示指针数量(比key多一个)。算出n约为1170。 如果树的高度为2,那么他能存储的数据量大概为:1171 * 16 = 18736; 如果树的高度为3,那么他能存储的数据量大概为:1171 * 1171 * 16 = 21939856。 另外,如果有成千上万的数据,那么就要考虑分表,涉及运维篇知识 本文由传智教育博学谷狂野架构师教研团队发布。 如果本文对您有帮助,欢迎关注和点赞;如果您有任何建议也可留言评论或私信,您的支持是我坚持创作的动力。 转载请注明出处!

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册