首页 文章 精选 留言 我的

精选列表

搜索[团队协作工具],共10000篇文章
优秀的个人博客,低调大师

OpenCL任务调度基础介绍 | 京东物流技术团队

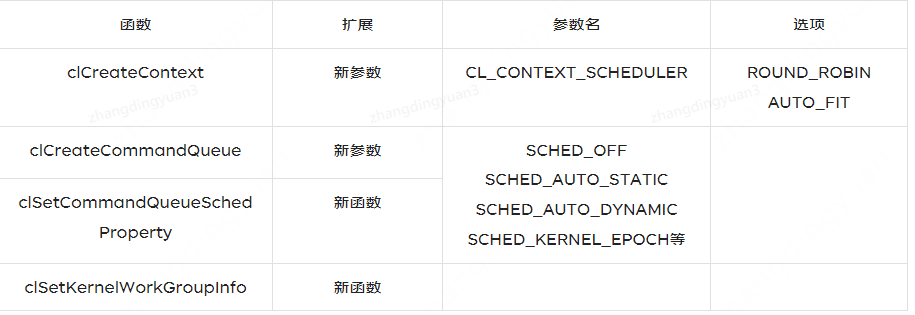
当前,科学计算需求急剧增加,基于CPU-GPU异构系统的异构计算在科学计算领域得到了广泛应用,OpenCL由于其跨平台特性在异构计算领域渐为流行,其调度困难的问题也随之暴露,传统的OpenCL任务调度需要在编码阶段确定调度方案,这种人工调度难度高、适应性差、效率低下、且存在资源竞争问题。MultiCL通过扩展OpenCL标准使得命令队列和设备解耦,实现了自适应调度,并为不同程度的开发人员提供了不同的调度方法,缓解了OpenCL的调度难题。 1 OpenCL基本介绍 OpenCL是第一个面向异构系统通用目的并行编程的开放式、免费标准,适用于跨CPU、GPU和其他处理器的异构混合编程。OpenCL通过创建一个高效的、底层的编程接口,实现了独立于硬件、操作系统和应用程序的并行计算生态系统的基础层。OpenCL用于协调主机和支持OpenCL标准的异构计算设备间的并行计算,并且具有明确的跨平台编程语言。 OpenCL是在异构系统上进行编程的行业标准。OpenCL不仅仅是一种编程语言,更是用于异构系统编程的行业标准框架。相较于CUDA,OpenCL程序可在不同供应商的硬件上移植,具有良好的功能可移植性。但是由于OpenCL作为一个底层通用框架,为程序员开放了大量硬件细节,这样的好处是编程人员提供了大量的程序优化空间,但是也造成了OpenCL程序不具备良好的性能可移植性,即相同程序在移植过程中会造成极大的性能差异。同时对于程序员而言,任务的划分以及调度完全由编程人员指定,编程人员难以感知和预测整体系统的运行状态和负载情况,使得程序难以达到最优效率。 OpenCL架构为了实现跨平台的异构计算,包含以下部分: OpenCL平台层:OpenCL平台层允许主机程序发现OpenCL设备并调用该设备参与计算,并为特定设备或设备组创建上下文。 OpenCL运行时:OpenCL运行时允许主机程序在上下文创建后对其进行操作,OpenCL运行时为OpenCL程序提供了软件支持。 OpenCL编译器:OpenCL编译器根据内核和设备扩展信息将内核文件编译为可执行文件。编译器支持基于并行扩展的ISO C99(ISO/IEC 9899:1999-Programming languages)语言的子集。OpenCL编译器可根据即时编译和二进制加载两种方式创建可执行文件。 OpenCL架构可分为平台模型、执行模型、存储模型和编程模型。 2 MultiCL OpenCL标准要求开发人员在程序编码阶段就确定OpenCL程序的调度方案,使OpenCL面临调度难度高、适应性差、资源竞争、效率低下等问题。为了解决上述问题Ashwin M等人在SunCL基础上进一步开发的OpenCL任务级并行调度框架,该框架提供了跨厂商的OpenCL运行时支持。MultiCL实现了上下文级别的全队列调度和针对特定命令队列的本地调度功能,作者以此为基础实现了OpenCL任务的动态调度。 OpenCL内核调度策略取决于编程模型,开发者必须事先明确程序中所包含的内核调度的方案,为了实现OpenCL的自适应任务调度,Ashwin M等人对OpenCL API进行了扩展。表1描述了MultiCL的扩展属性。 表1 MultiCL扩展属性 为了表达全局队列调度机制,MultiCL框架扩展了一个新的上下文属性CL_CONTEXT_SCHEDULER,该扩展属性实现了上下文级别的OpenCL自适应调度,采用CL_CONTEXT_SCHEDULER创建的上下文,该上下文关联的命令队列与OpenCL设备解耦合,即创建OpenCL命令队列是不用指定OpenCL设备,从上下文层面解决了OpenCL内核调度需要在编码阶段完成的问题。OpenCL上下文属性包含两个参数,分别对应了两种全局调度策略:循环调度(ROUND_ROBIN)和自适应调度(AUTO_FIT)。循环调度是在触发调度程序时,将命令队列调度到下一个可用设备上,在实际运行过程中,由于GPU设备支持多内核同时执行,该方案调度时选择计算资源充足的设备进行调度,这种方法会有最小的调度开销,但是并不总是选择最佳的队列-设备映射。自动调度策略是MultiCL框架提出的基于内核预执行的动态调度策略,MultiCL框架将根据动态调度策略选择最佳的队列-设备映射。 同时为了实现本地调度策略,对OpenCL API命令调度队列属性进行了扩展,添加了SCHEDAUTO或SCHEDOFF,分别确定特定的队列是选择自动调度模式还是手动调度模式。MultiCL框架给用户提供了选项,用户可以选用SCHED_OFF标志手动指定调度方案,用户也可以在创建命令队列时添加SCHED_AUTO标志来实现自动调度,其中包括静态调度(SCHED_AUTO_STATIC)和动态调度(SCHED_AUTO_DYNAMIC)。针对命令队列属性的修改旨在作为调度的微调参数,针对不同程度的OpenCL开发人员,制定了不同程度的调度策略。对于具有丰富经验的开发人员,可以直接忽略MultiCL框架提供的命令队列参数,选择手动调度所有队列,便于开发人员根据异构系统底层特点实现任务划分和内核优化,对于中等级别的开发人员,对底层架构有一定了解,可根据OpenCL内核的负载类型(例如:SCHED_IO_BOUND, SCHED_COMPUTE_BOUND等)选择命令队列属性作为系统的调度提示,便于MultiCL框架根据OpenCL内核类型提示构建微型内核和进行调度,对于初级开发人员,则可以采用MultiCL框架提供的自适应动态调度,由MultiCL运行时决定内核调度方案,该方式会带来一定的运行时开销。 MultiCL扩展的clSetCommandQueueSchedProperty命令用于标记调度程序区域,并可以在需要时设置更多调度程序标志,例如使用以下属性:SCHED_COMPUTE_BOUND,SCHED_MEM_BOUND,SCHED_IO_BOUND或SCHED_ITERATIVE指定队列中的预期计算类型,与clCreateCommandQueue的扩展参数相对应,该函数便于调度方案优化。OpenCL内核启动命令的参数包括命令队列,内核对象和内核的启动配置。MultiCL为了自动调度的方便,实现了新的OpenCL API命令clSetKernelWorkGroupInfo,用于设定内核配置参数,MultiCL框架在OpenCL内核调度命令加入命令队列前就可以获取内核的工作组和工作组中工作项信息,便于MultiCL框架进行内核调度。 MultiCL运行时设计如图1所示。 使用SCHED_OFF标志创建的用户命令队列将静态映射到所选设备(由开发人员在编码阶段指定映射方案),而使用SCHED_AUTO标志创建的命令队列将由MultiCL自动调度。MultiCL框架将OpenCL内核启动命令加入队列后,如果该命令队列是SCHED_OFF标志创建的命令队列,则采用静态调度方案,MultiCL运行时保留了SunCL运行时静态调度方案的部分,给开发人员保留了静态硬编码调度的功能。如果该命令队列是以SCHED_AUTO标志创建的,则交由自适应调度器映射到设备池中某一设备。上述调度过程包含了设备静态分析(在clGetPlatformIds读取设备信息阶段进行),内核静态分析(clBuildProgram,clCreateProgramWithSource构建程序阶段进行),内核动态分析(clEnqueue*命令阶段)和设备映射。MultiCL动态调度模块通过独立线程与OpenCL程序执行并发执行,利用OpenCL初始化阶段开销隐藏MultiCL运行时内核分析和设备分析带来的开销。 图1 MultiCL运行时结构图 MultiCL动态调度包含三个主要的运行时模块:设备分析器、内核分析器和任务调度器。 设备分析器,用于收集和分析设备的性能(内存,计算能力和I/O); 内核分析器,分析和预测内核在不同设备上的执行时间; 任务调度器,将SCHED_AUTO标记的命令队列中的任务调度到设备上。上述三个运行时模块在MultiCL对OpenCL标准扩展的基础上实现了OpenCL任务的动态调度。设备分析器和内核分析器分别对OpenCL设备和内核进行分析,判断OpenCL设备与内核的契合程度,为任务调度器提供数据基础。 设备分析器是在OpenCL clGetPlatformIds命令调用期间执行的设备概要分析器。设备分析器从设备概要文件中检索OpenCL设备的概要信息。如果文件中不存在该设备的概要信息,则MultiCL运行时将运行数据带宽和指令吞吐量基准测试,并将测得的指标作为静态信息存入设备概要文件中。基准测试源于SHOC基准测试NVIDIA SDK,这些基准测试是MultiCL运行时的一部分。仅当系统配置发生更改时(例如,在系统中添加新设备或从中删除设备)时,才需要再次运行基准测试。 内核分析器通过性能建模或性能预测技术来估计内核执行时间。MultiCL为了减少内核分析器所带来的时间开销,采用每个设备运行一次微型内核,并将相应的执行时间存储为内核配置文件的一部分。该微型内核由微型仿真技术创建,并将其调度到系统中的每一个参与计算的设备上运行,该内核划分单个工作组工作项,并记录该微型内核在每个设备上的相对性能。这种方式会给当前程序带来潜在的运行时开销,但是MultiCL采用的微型内核在运行时优化后,实验验证其运行时开销很小,有时可以忽略不计。同时该方式也能较为准确的反映内核在不同设备上的运行差异。微型内核创建发生在OpenCL clCreateProgramWithSource和clBuildProgram命令期间。MultiCL运行时拦截clCreateProgramWithSource调用,并为每个内核创建一个迷你内核对象,通过拦截clBuildProgram调用,将带有新微型内核的程序构建为单独的二进制文件。尽管此方法使OpenCL的构建时间增加了一倍,但作者认为这是初始设置成本,不会改变程序的实际运行时间。 任务调度器将获取每一个OpenCL命令队列,并将关联的命令队列添加到就绪队列池中进行调度。MultiCL仅通过概要设备信息文件和内核配置文件得到任务映射方案。MultiCL运行时读取每个队列的聚合内核配置文件,任务调度器采用使命令队列内核执行时间最短的策略来确定理想的队列-设备映射,最大限度地减少并发执行时间。动态调度方法保证了理想的内核-设备映射,同时OpenCL平台下的设备数量不多,因此调度产生的开销可以忽略不计。调度程序将命令队列映射到设备后,该队列将从队列池中删除。 3 总结 OpenCL首次提出了面向异构系统通用目的并行编程的开放式标准,适用于跨CPU、GPU和其他处理器的异构混合编程。而MultiCL通过对OpenCL标准的扩展,以在上下文全级别和命令队列本地级别进行静态和动态调度。MultiCL是一个运行时系统,通过设备分析器,内核分析器和任务调度器完成了OpenCL的动态调度,同时保留了OpenCL本身由开发人员指定的静态调度方法,MultiCL运行时优化使开发人员能够专注于应用程序级别的数据和任务分解,而不是设备级别的体系结构详细信息和设备调度,极大减轻了OpenCL开发难度,为以后的任务调度研究提供了良好的软件支持。但是,MultiCL也引入了预执行开销,降低了程序执行效率,同时其预执行评估方案难以反映内核实际运行状态,尚待进一步优化。 作者:京东物流靳紫薇 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

| 京东云技术团队

使用场景: 开发中会碰到一些耗时较长或者不需要立即得到执行结果的逻辑,比如消息推送、商品同步等都可以使用异步方法,这时我们可以用到@Async。但是直接使用 @Async 会有风险,当我们没有指定线程池时,他会默认使用其Spring自带的 SimpleAsyncTaskExecutor 线程池,会不断的创建线程,当并发大的时候会严重影响性能。所以可以将异步指定线程池使用 简介: @Async是Spring的注解,可以加在类或方法上。通俗的来讲,如果加上了这个注解,那么该类或者该方法在使用时将会进行异步处理,也就是创建一个线程来实现这个类或者方法,实现多线程。 线程池的执行顺序: 两种使用方式: 第一种: 使用的是Spring默认的线程池SimpleAsyncTaskExecutor。 接入步骤: 1.需要在@SpringBootApplication启动类或者@configure注解类上 添加注解@EnableAsync启动多线程注解。 2.在需要异步执行的方法上添加@Async注解。 默认的线程池配置: 如果需要修改默认的配置可以在yaml或者properties中添加,修改默认配置: 执行后会打印出你的执行线程名称: 第二种:(推荐使用) 自定义线程池,执行异步。 自定义线程池有如下模式,我们只介绍最后一种: 重新实现接口AsyncConfigurer; 继承AsyncConfigurerSupport; 配置由自定义的TaskExecutor替代内置的任务执行器。 然后添加注解到对应的方法上并指定线程池:asyncExecutor 指定线程池的名称为自定义的线程池名称。 查看日志: 注意事项: 查到了@Async失效的几个原因: 注解@Async的方法不是public方法; 注解@Async的返回值只能为void或Future; 注解@Async方法使用static修饰也会失效; 启动类没加@EnableAsync注解; 调用方和@Async不能在一个类中; 在Async方法上标注@Transactional是没用的,但在Async方法调用的方法上标注@Transcational是有效的; 作者:京东零售郭春元 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

MYSQL 事务的底层原理 | 京东物流技术团队

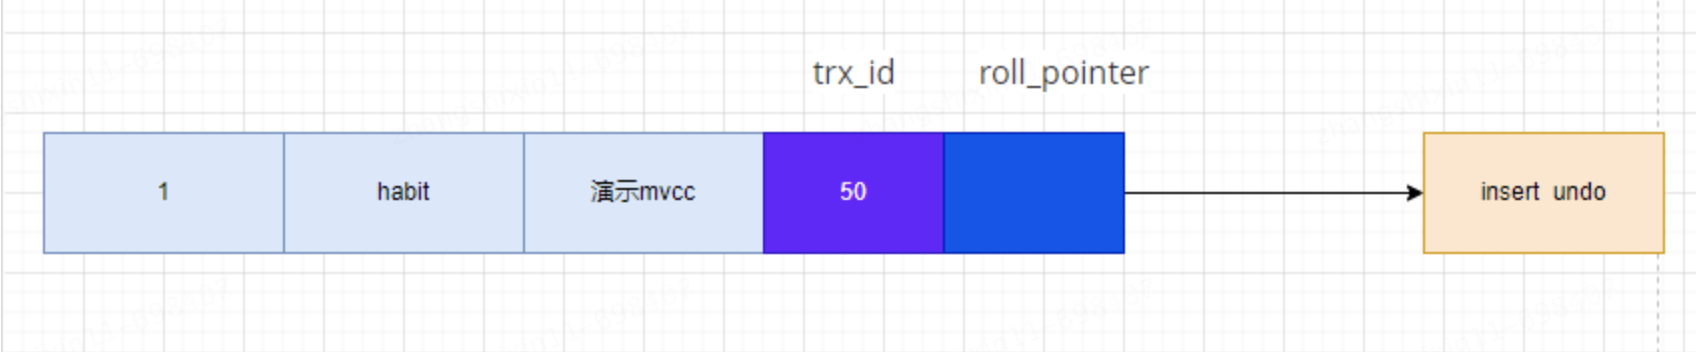
事务的底层原理 在事务的实现机制上,MySQL 采用的是 WAL:Write-ahead logging,预写式日志,机制来实现的。 在使用 WAL 的系统中,所有的修改都先被写入到日志中,然后再被应用到系统中。通常包含 redo 和 undo 两部分信息。 为什么需要使用 WAL,然后包含 redo 和 undo 信息呢?举个例子,如果一个系统直接将变更应用到系统状态中,那么在机器掉电重启之后系统需要知道操作是成功了,还是只有部分成功或者是失败了。如果使用了 WAL,那么在重启之后系统可以通过比较日志和系统状态来决定是继续完成操作还是撤销操作。 redo log 称为重做日志,每当有操作时,在数据变更之前将操作写入 redo log,这样当发生掉电之类的情况时系统可以在重启后继续操作。 undo log 称为撤销日志,当一些变更执行到一半无法完成时,可以根据撤销日志恢复到变更之间的状态。 MySQL 中用 redo log 来在系统 Crash 重启之类的情况时修复数据,而 undo log 来保证事务的原子性。 事务 id 一个事务可以是一个只读事务,或者是一个读写事务:可以通过 START TRANSACTION READ ONLY 语句开启一个只读事务。 在只读事务中不可以对普通的表进行增、删、改操作,但可以对用户临时表做增、删、改操作。 可以通过 START TRANSACTION READ WRITE 语句开启一个读写事务,或者使用 BEGIN、START TRANSACTION 语句开启的事务默认也算是读写事务。 在读写事务中可以对表执行增删改查操作。 如果某个事务执行过程中对某个表执行了增、删、改操作,那么 InnoDB 存储引擎就会给它分配一个独一无二的事务 id,针对 MySQL 5.7 分配方式如下: 对于只读事务来说,只有在它第一次对某个用户创建的临时表执行增、删、改操作时才会为这个事务分配一个事务 id,否则的话是不分配事务 id 的。 对于读写事务来说,只有在它第一次对某个表执行增、删、改操作时才会为这个事务分配一个事务 id,否则的话也是不分配事务 id 的。 有的时候虽然开启了一个读写事务,但是在这个事务中全是查询语句,并没有执行增、删、改的语句,那也就意味着这个事务并不会被分配一个事务 id。 这个事务 id 本质上就是一个数字,它的分配策略和隐藏列 row_id 的分配策略大抵相同,具体策略如下: 服务器会在内存中维护一个全局变量,每当需要为某个事务分配一个事务 id 时,就会把该变量的值当作事务 id 分配给该事务,并且把该变量自增 1。 每当这个变量的值为 256 的倍数时,就会将该变量的值刷新到系统表空间的页号为 5 的页面中一个称之为 Max Trx ID 的属性处,这个属性占用 8 个字节的存 储空间。 当系统下一次重新启动时,会将上边提到的 Max Trx ID 属性加载到内存中,将该值加上 256 之后赋值给全局变量,因为在上次关机时该全局变量的值可能大于Max Trx ID 属性值。 这样就可以保证整个系统中分配的事务 id 值是一个递增的数字。先被分配 id 的事务得到的是较小的事务 id,后被分配 id 的事务得到的是较大的事务 id。 mvcc 全称 Multi-Version Concurrency Control,即多版本并发控制,主要是为了提高数据库的并发性能。 同一行数据平时发生读写请求时,会上锁阻塞住。但 MVCC 用更好的方式去处理读写请求,做到在发生读写请求冲突时不用加锁。 这个读是指的快照读,而不是当前读,当前读是一种加锁操作,是悲观锁。 MVCC 原理 在事务并发执行遇到的问题如下: 脏读:如果一个事务读到了另一个未提交事务修改过的数据,那就意味着发生了脏读; 不可重复读:如果一个事务只能读到另一个已经提交的事务修改过的数据,并且其他事务每对该数据进行一次修改并提交后,该事务都能查询得到最新值,那就意味着发生了不可重复读; 幻读:如果一个事务先根据某些条件查询出一些记录,之后另一个事务又向表中插入了符合这些条件的记录,原先的事务再次按照该条件查询时,能把另一个事务插入的记录也读出来,那就意味着发生了幻读,幻读强调的是一个事务按照某个相同条件多次读取记录时,后读取时读到了之前没有读到的记录,幻读只是重点强调了读取到了之前读取没有获取到的记录。 MySQL 在 REPEATABLE READ 隔离级别下,是可以很大程度避免幻读问题的发生的。 版本链 对于使用 InnoDB 存储引擎的表来说,它的聚簇索引记录中都包含两个必要的隐藏列: trx_id:每次一个事务对某条聚簇索引记录进行改动时,都会把该事务的事务 id 赋值给 trx_id 隐藏列; roll_pointer:每次对某条聚簇索引记录进行改动时,都会把旧的版本写入到 undo 日志中,然后这个隐藏列就相当于一个指针,可以通过它来找到该记录修 改前的信息; 演示 -- 创建表 CREATE TABLE mvcc_test ( id INT, name VARCHAR(100), domain varchar(100), PRIMARY KEY (id) ) Engine=InnoDB CHARSET=utf8; -- 添加数据 INSERT INTO mvcc_test VALUES(1, 'habit', '演示mvcc'); 假设插入该记录的事务 id=50,那么该条记录的展示如图:  假设之后两个事务 id 分别为 70、90 的事务对这条记录进行 UPDATE 操作。 trx_id=70 trx_id=90 begin   begin   update mvcc_test set name='habit_trx_id_70_01' where id=1  update mvcc_test set name='habit_trx_id_70_02' where id=1  commit   update mvcc_test set name='habit_trx_id_90_01' where id=1  update mvcc_test set name='habit_trx_id_90_02' where id=1  commit 每次对记录进行改动,都会记录一条 undo 日志,每条 undo 日志也都有一个 roll_pointer 属性,可以将这些 undo 日志都连起来,串成一个链表。  对该记录每次更新后,都会将旧值放到一条 undo 日志中,就算是该记录的一个旧版本,随着更新次数的增多,所有的版本都会被 roll_pointer 属性连接成一个链表,把这个链表称之为版本链,版本链的头节点就是当前记录最新的值。另外,每个版本中还包含生成该版本时对应的事务 id。于是可以利用这个记录的版本链来控制并发事务访问相同记录的行为,那么这种机制就被称之为:多版本并发控制,即 MVCC。 ReadView 对于使用 READ UNCOMMITTED 隔离级别的事务来说,由于可以读到未提交事务修改过的记录,所以直接读取记录的最新版本就好了。 对于使用 SERIALIZABLE 隔离级别的事务来说,InnoDB 使用加锁的方式来访问记录。 对于使用 READ COMMITTED 和 REPEATABLE READ 隔离级别的事务来说,都必须保证读到已经提交了的事务修改过的记录,也就是说假如另一个事务已经修改了记录但是尚未提交,是不能直接读取最新版本的记录的,核心问题就是:READ COMMITTED 和 REPEATABLE READ 隔离级别在不可重复读和幻读上的区别是从哪里来的,其实结合前面的知识,这两种隔离级别关键是需要判断一下版本链中的哪个版本是当前事务可见的。 为此,InnoDB 提出了一个 ReadView 的概念,这个 ReadView 中主要包含 4 个比较重要的内容: m_ids:表示在生成 ReadView 时当前系统中活跃的读写事务的事务id 列表; min_trx_id:表示在生成 ReadView 时当前系统中活跃的读写事务中最小的事务 id,也就是 m_ids 中的最小值; max_trx_id:表示在生成 ReadView 时系统中应该分配给下一个事务的 id 值,注:max_trx_id 并不是 m_ids 中的最大值,事务 id 是递增分配的。比方说现在有 id 为 1,2,3 这三个事务,之后 id 为 3 的事务提交了。那么一个新的读事务在生成 ReadView 时,m_ids 就包括 1 和 2,min_trx_id 的值就是 1,max_trx_id 的值就是 4; creator_trx_id:表示生成该 ReadView 的事务的事务 id; 有了这个 ReadView,这样在访问某条记录时,只需要按照下边的步骤判断记录的某个版本是否可见: 如果被访问版本的 trx_id 属性值与 ReadView 中的 creator_trx_id 值相同,意味着当前事务在访问它自己修改过的记录,所以该版本可以被当前事务访问; 如果被访问版本的 trx_id 属性值小于 ReadView 中的 min_trx_id 值,表明生成该版本的事务在当前事务生成 ReadView 前已经提交,所以该版本可以被当前事务访问; 如果被访问版本的 trx_id 属性值大于或等于 ReadView 中的 max_trx_id 值,表明生成该版本的事务在当前事务生成 ReadView 后才开启,所以该版本不可以被当前事务访问; 如果被访问版本的 trx_id 属性值在 ReadView 的 min_trx_id 和 max_trx_id之间 min_trx_id < trx_id < max_trx_id,那就需要判断一下 trx_id 属性值是不是在 m_ids 列表中,如果在,说明创建 ReadView 时生成该版本的事务还是活跃的,该版本不可以被访问;如果不在,说明创建 ReadView 时生成该版本的事务已经被提交,该版本可以被访问; 如果某个版本的数据对当前事务不可见的话,那就顺着版本链找到下一个版本的数据,继续按照上边的步骤判断可见性,依此类推,直到版本链中的最后一个版本。如果最后一个版本也不可见的话,那么就意味着该条记录对该事务完全不可见,查询结果就不包含该记录; 在 MySQL 中,READ COMMITTED 和 REPEATABLE READ 隔离级别的一个非常大的区别就是它们生成 ReadView 的时机不同。 还是以表 mvcc_test 为例,假设现在表 mvcc_test 中只有一条由事务 id 为 50 的事务插入的一条记录,接下来看一下 READ COMMITTED 和 REPEATABLE READ 所谓的生成 ReadView 的时机不同到底不同在哪里。 READ COMMITTED: 每次读取数据前都生成一个 ReadView; 比方说现在系统里有两个事务id 分别为 70、90 的事务在执行: -- T 70 UPDATE mvcc_test SET name = 'habit_trx_id_70_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_70_02' WHERE id = 1; 此时表 mvcc_test 中 id 为 1 的记录得到的版本链表如下所示:  假设现在有一个使用 READ COMMITTED 隔离级别的事务开始执行: -- 使用 READ COMMITTED 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' 这个 SELECE1 的执行过程如下: 在执行 SELECT 语句时会先生成一个 ReadView,ReadView 的 m_ids 列表的内容就是[70, 90],min_trx_id 为 70,max_trx_id 为 91,creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,在 m_ids 列表内,所以不符合可见性要求第 4 条:如果被访问版本的 trx_id 属性值在 ReadView 的 min_trx_id 和 max_trx_id之间 min_trx_id < trx_id < max_trx_id,那就需要判断一下trx_id 属性值是不是在 m_ids 列表中,如果在,说明创建 ReadView 时生成该版本的事务还是活跃的,该版本不可以被访问;如果不在,说明创建 ReadView 时生成该版本的事务已经被提交,该版本可以被访问。根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_01,该版本的 trx_id 值也为 70,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit,该版本的 trx_id 值为 50,小于 ReadView 中的 min_trx_id 值,所以这个版本是符合要求的第 2 条:如果被访问版本的 trx_id 属性值小于 ReadView 中的 min_trx_id 值,表明生成该版本的事务在当前事务生成 ReadView 前已经提交,所以该版本可以被当前事务访问。最后返回的版本就是这条列 name 为 habit 的记录。 之后,把事务 id 为 70 的事务提交一下,然后再到事务 id 为 90 的事务中更新一下表 mvcc_test 中 id 为 1 的记录: -- T 90 UPDATE mvcc_test SET name = 'habit_trx_id_90_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_90_02' WHERE id = 1; 此时表 mvcc 中 id 为 1 的记录的版本链就长这样:  然后再到刚才使用 READ COMMITTED 隔离级别的事务中继续查找这个 id 为 1 的记录,如下: -- 使用 READ COMMITTED 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 均未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' -- SELECE2:Transaction 70 提交,Transaction 90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit_trx_id_70_02' 这个SELECE2 的执行过程如下: 在执行 SELECT 语句时又会单独生成一个 ReadView,该 ReadView 的 m_ids 列表的内容就是[90],min_trx_id 为90,max_trx_id 为 91,creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_90_02,该版本的 trx_id 值为 90,在 m_ids 列表内,所以不符合可见性要求,根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_90_01,该版本的 trx_id 值为 90,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,小于 ReadView 中的 min_trx_id 值 90,所以这个版本是符合要求的,最后返回这个版本中列 name 为 habit_trx_id_70_02 的记录。 以此类推,如果之后事务 id 为 90 的记录也提交了,再次在使用 READ COMMITTED 隔离级别的事务中查询表 mvcc_test 中 id 值为 1 的记录时,得到的结果就是 habit_trx_id_90_02 了。 总结:使用 READ COMMITTED 隔离级别的事务在每次查询开始时都会生成一个独立的 ReadView。 REPEATABLE READ:在第一次读取数据时生成一个 ReadView; 对于使用 REPEATABLE READ 隔离级别的事务来说,只会在第一次执行查询语句时生成一个 ReadView,之后的查询就不会重复生成了。 比方说现在系统里有两个事务id 分别为 70、90 的事务在执行: -- T 70 UPDATE mvcc_test SET name = 'habit_trx_id_70_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_70_02' WHERE id = 1; 此时表 mvcc_test 中 id 为 1 的记录得到的版本链表如下所示:  假设现在有一个使用 REPEATABLE READ 隔离级别的事务开始执行: -- 使用 REPEATABLE READ 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列name 的值为'habit' 这个 SELECE1 的执行过程如下: 在执行 SELECT 语句时会先生成一个 ReadView,ReadView 的 m_ids 列表的内容就是[70, 90],min_trx_id 为 70,max_trx_id 为 91,creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,在 m_ids 列表内,所以不符合可见性要求,根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_01,该版本的 trx_id 值也为 70,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit,该版本的 trx_id 值为 50,小于 ReadView 中的 min_trx_id 值,所以这个版本是符合要求的,最后返回的就是这条列name 为 habit 的记录。 之后,把事务 id 为 70 的事务提交一下,然后再到事务 id 为 90 的事务中更新一下表 mvcc_test 中 id 为 1 的记录: -- 使用 REPEATABLE READ 隔离级别的事务 BEGIN; UPDATE mvcc_test SET name = 'habit_trx_id_90_01' WHERE id = 1; UPDATE mvcc_test SET name = 'habit_trx_id_90_02' WHERE id = 1; 此刻,表 mvcc_test 中 id 为 1 的记录的版本链就长这样:  然后再到刚才使用 REPEATABLE READ 隔离级别的事务中继续查找这个 id 为 1 的记录,如下: -- 使用 REPEATABLE READ 隔离级别的事务 BEGIN; -- SELECE1:Transaction 70、90 均未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' -- SELECE2:Transaction 70 提交,Transaction 90 未提交 SELECT * FROM mvcc_test WHERE id = 1; -- 得到的列 name 的值为'habit' 这个 SELECE2 的执行过程如下: 因为当前事务的隔离级别为 REPEATABLE READ,而之前在执行 SELECE1 时已经生成过 ReadView 了,所以此时直接复用之前的 ReadView,之前的 ReadView的 m_ids 列表的内容就是[70, 90],min_trx_id 为 70,max_trx_id 为 91, creator_trx_id 为 0。 然后从版本链中挑选可见的记录,从图中可以看出,最新版本的列 name 的内容是 habit_trx_id_90_02,该版本的 trx_id 值为 90,在 m_ids 列表内,所以不符合可见性要求,根据 roll_pointer 跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_90_01,该版本的 trx_id 值为 90,也在 m_ids 列表内,所以也不符合要求,继续跳到下一个版本。 下一个版本的列 name 的内容是 habit_trx_id_70_02,该版本的 trx_id 值为 70,而 m_ids 列表中是包含值为 70 的事务 id 的,所以该版本也不符合要求,同理下一个列 name 的内容是 habit_trx_id_70_01 的版本也不符合要求。继续跳到下一个版本。 下一个版本的列 name 的内容是 habit,该版本的 trx_id 值为 50,小于 ReadView 中的 min_trx_id 值 70,所以这个版本是符合要求的,最后返回给用户的版本就是这条列 name 为 habit 的记录。 也就是说两次 SELECT 查询得到的结果是重复的,记录的列 name 值都是 habit,这就是可重复读的含义。如果之后再把事务 id 为 90 的记录提交了,然后再到刚才使用 REPEATABLE READ 隔离级别的事务中继续查找这个 id 为 1 的记录,得到的结果还是 habit。 MVCC 下的幻读解决和幻读现象 REPEATABLE READ 隔离级别下 MVCC 可以解决不可重复读问题,那么幻读呢?MVCC 是怎么解决的?幻读是一个事务按照某个相同条件多次读取记录时,后读取时读到了之前没有读到的记录,而这个记录来自另一个事务添加的新记录。 可以想想,在 REPEATABLE READ 隔离级别下的事务 T1 先根据某个搜索条件读取到多条记录,然后事务 T2 插入一条符合相应搜索条件的记录并提交,然后事务 T1 再根据相同搜索条件执行查询。结果会是什么?按照 ReadView 中的比较规则中的第 3 条和第 4 条不管事务 T2 比事务 T1 是否先开启,事务 T1 都是看不到 T2 的提交的。 但是,在 REPEATABLE READ 隔离级别下 InnoDB 中的 MVCC 可以很大程度地避免幻读现象,而不是完全禁止幻读。怎么回事呢?来看下面的情况:  首先在事务 T1 中执行:select * from mvcc_test where id = 30; 这个时候是找不到 id = 30 的记录的。 在事务 T2 中,执行插入语句:insert into mvcc_test values(30,'luxi','luxi'); 此时回到事务 T1,执行: update mvcc_test set domain='luxi_t1' where id=30; select * from mvcc_test where id = 30; 事务T1 很明显出现了幻读现象。 在 REPEATABLE READ 隔离级别下,T1 第一次执行普通的 SELECT 语句时生成了一个 ReadView,之后 T2 向 mvcc_test 表中新插入一条记录并提交。 ReadView 并不能阻止 T1 执行 UPDATE 或者 DELETE 语句来改动这个新插入的记录,由于 T2 已经提交,因此改动该记录并不会造成阻塞,但是这样一来,这条新记录的 trx_id 隐藏列的值就变成了 T1 的事务 id。之后 T1 再使用普通的 SELECT 语句去查询这条记录时就可以看到这条记录了,也就可以把这条记录返回给客户端。因为这个特殊现象的存在,可以认为 MVCC 并不能完全禁止幻读。 mvcc 总结 从上边的描述中可以看出来,所谓的 MVCC(Multi-Version Concurrency Control ,多版本并发控制)指的就是在使用 READ COMMITTD、REPEATABLE READ 这两种隔离级别的事务在执行普通的 SELECT 操作时访问记录的版本链的过程,这样子可以使不同事务的读写、写读操作并发执行,从而提升系统性能。 READ COMMITTD、REPEATABLE READ 这两个隔离级别的一个很大不同就是:生成 ReadView 的时机不同,READ COMMITTD 在每一次进行普通 SELECT 操作前都会生成一个 ReadView,而 REPEATABLE READ 只在第一次进行普通 SELECT 操作前生成一个 ReadView,之后的查询操作都重复使用这个 ReadView 就好了,从而基本上可以避免幻读现象。 InnoDB 的 Buffer Pool 对于使用 InnoDB 作为存储引擎的表来说,不管是用于存储用户数据的索引,包括:聚簇索引和二级索引,还是各种系统数据,都是以页的形式存放在表空间中的,而所谓的表空间只不过是 InnoDB 对文件系统上一个或几个实际文件的抽象,也就是说数据还是存储在磁盘上的。 但是磁盘的速度慢,所以 InnoDB 存储引擎在处理客户端的请求时,当需要访问某个页的数据时,就会把完整的页的数据全部加载到内存中,即使只需要访问一个页的一条记录,那也需要先把整个页的数据加载到内存中。将整个页加载到内存中后就可以进行读写访问了,在进行完读写访问之后并不着急把该页对应的内存空间释放掉,而是将其缓存起来,这样将来有请求再次访问该页面时,就可以省去磁盘 IO 的开销了。 Buffer Pool InnoDB 为了缓存磁盘中的页,在 MySQL 服务器启动的时候就向操作系统申请了一片连续的内存,这块连续内存叫做:Buffer Pool,中文名:缓冲池。 默认情况下 Buffer Pool 只有 128M 大小。 查看该值:show variables like 'innodb_buffer_pool_size'; 可以在启动服务器的时候配置 innodb_buffer_pool_size 参数的值,它表示 Buffer Pool 的大小,配置如下: [server] innodb_buffer_pool_size = 268435456 其中,268435456 的单位是字节,也就是指定 Buffer Pool 的大小为 256M,Buffer Pool 也不能太小,最小值为 5M,当小于该值时会自动设置成 5M。 启动 MySQL 服务器的时候,需要完成对 Buffer Pool 的初始化过程,就是先向操作系统申请 Buffer Pool 的内存空间,然后把它划分成若干对控制块和缓 存页。但是此时并没有真实的磁盘页被缓存到 Buffer Pool 中,之后随着程序的运行,会不断的有磁盘上的页被缓存到 Buffer Pool 中。 在 Buffer Pool 中会创建多个缓存页,默认的缓存页大小和在磁盘上默认的页大小是一样的,都是 16KB。 那么怎么知道该页在不在 Buffer Pool 中呢? 在查找数据的时候,先通过哈希表中查找 key 是否在哈希表中,如果在证明 Buffer Pool 中存在该缓存也信息,如果不存在证明不存该缓存也信息,则通过读取磁盘加载该页信息放到 Buffer Pool 中,哈希表中的 key 是通过表空间号+ 页号作组成的,value 是 Buffer Pool 的缓存页。 flush 链表的管理 如果修改了 Buffer Pool 中某个缓存页的数据,那它就和磁盘上的页不一致了,这样的缓存页也被称为:脏页。最简单的做法就是每发生一次修改就立即同步到磁盘上对应的页上,但是频繁的往磁盘中写数据会严重的影响程序的性能。所以每次修改缓存页后,并不着急把修改同步到磁盘上,而是在未来的某个时间进行同步。 但是如果不立即同步到磁盘的话,那之后再同步的时候怎么知道 Buffer Pool 中哪些页是脏页,哪些页从来没被修改过呢?总不能把所有的缓存页都同步到磁盘上吧,如果 Buffer Pool 被设置的很大,那一次性同步会非常慢。 所以,需要再创建一个存储脏页的链表,凡是修改过的缓存页对应的控制块都会作为一个节点加入到一个链表中,因为这个链表节点对应的缓存页都是需要被刷新到磁盘上的,所以也叫 flush 链表。 刷新脏页到磁盘 后台有专门的线程每隔一段时间负责把脏页刷新到磁盘,这样可以不影响用户线程处理正常的请求。 从 flush 链表中刷新一部分页面到磁盘,后台线程也会定时从 flush 链表中刷新一部分页面到磁盘,刷新的速率取决于当时系统是不是很繁忙。这种刷新页面的方式被称之为:BUF_FLUSH_LIST。 redo 日志 redo 日志的作用 InnoDB 存储引擎是以页为单位来管理存储空间的,增删改查操作其实本质上都是在访问页面,包括:读页面、写页面、创建新页面等操作。在真正访问页面之前,需要把在磁盘上的页缓存到内存中的 Buffer Pool 之后才可以访问。但是在事务的时候又强调过一个称之为持久性的特性,就是说对于一个已经提交的事务,在事务提交后即使系统发生了崩溃,这个事务对数据库中所做的更改也不能丢失。 如果只在内存的 Buffer Pool 中修改了页面,假设在事务提交后突然发生了某个故障,导致内存中的数据都失效了,那么这个已经提交了的事务对数据库中所做的更改也就跟着丢失了,这是所不能忍受的。那么如何保证这个持久性呢?一个很简单的做法就是在事务提交完成之前把该事务所修改的所有页面都刷新到磁盘,但是这个简单粗暴的做法有些问题: 刷新一个完整的数据页太浪费了;有时候仅仅修改了某个页面中的一个字节,但是在 InnoDB 中是以页为单位来进行磁盘 IO 的,也就是说在该事务提交时不得不将一个完整的页面从内存中刷新到磁盘,一个页面默认是16KB 大小,只修改一个字节就要刷新 16KB 的数据到磁盘上显然是太浪费了。 随机 IO 刷起来比较慢;一个事务可能包含很多语句,即使是一条语句也可能修改许多页面,该事务修改的这些页面可能并不相邻,这就意味着在将某个事务修改的 Buffer Pool 中的页面刷新到磁盘时,需要进行很多的随机 IO,随机 IO 比顺序 IO 要慢,尤其对于传统的机械硬盘来说。 只是想让已经提交了的事务对数据库中数据所做的修改永久生效,即使后来系统崩溃,在重启后也能把这种修改恢复出来。其实没有必要在每次事务提交时就把该事务在内存中修改过的全部页面刷新到磁盘,只需要把修改了哪些东西记录一下就好,比方说:某个事务将系统表空间中的第 5 号页面中偏移量为 5000 处的那个字节的值 0 改成 5 只需要记录一下:将第 5 号表空间的 5 号页面的偏移量为 5000 处的值更新为:5。 这样在事务提交时,把上述内容刷新到磁盘中,即使之后系统崩溃了,重启之后只要按照上述内容所记录的步骤重新更新一下数据页,那么该事务对数据库中所做的修改又可以被恢复出来,也就意味着满足持久性的要求。因为在系统崩溃重启时需要按照上述内容所记录的步骤重新更新数据页,所以上述内容也被称之为:重做日志,即:redo log。与在事务提交时将所有修改过的内存中的页面刷新到磁盘中相比,只将该事务执行过程中产生的 redo log 刷新到磁盘的好处如下: redo log 占用的空间非常小存储表空间 ID、页号、偏移量以及需要更新的值所需的存储空间是很小的; redo log 是顺序写入磁盘的在执行事务的过程中,每执行一条语句,就可能产生若干条 redo log,这些日志是按照产生的顺序写入磁盘的,也就是使用顺序 IO; redo log 的写入过程 InnoDB 为了更好的进行系统崩溃恢复,把一次原子操作生成的 redo log 都放在了大小为 512 字节的块(block)中。 为了解决磁盘速度过慢的问题而引入了 Buffer Pool。同理,写入 redo log 时也不能直接写到磁盘上,实际上在服务器启动时就向操作系统申请了一大片称之为 redo log buffer 的连续内存空间,即:redo log 缓冲区,也可以简称:log buffer。这片内存空间被划分成若干个连续的 redo log block,可以通过启动参数innodb_log_buffer_size 来指定 log buffer 的大小,该启动参数的默认值为:16MB。 向 log buffer 中写入 redo log 的过程是顺序的,也就是先往前边的 block 中写,当该 block 的空闲空间用完之后再往下一个 block 中写。 redo log 刷盘时机 log buffer 什么时候会写入到磁盘呢? log buffer 空间不足时,如果不停的往这个有限大小的 log buffer 里塞入日志,很快它就会被填满。InnoDB 认为如果当前写入 log buffer 的 redo log 量已 经占满了 log buffer 总容量的大约一半左右,就需要把这些日志刷新到磁盘上。 事务提交时,必须要把修改这些页面对应的 redo log 刷新到磁盘。 后台有一个线程,大约每秒都会刷新一次 log buffer 中的 redo log 到磁盘。 正常关闭服务器时等等。 undo 日志 事务需要保证原子性,也就是事务中的操作要么全部完成,要么什么也不做。但是偏偏有时候事务执行到一半会出现一些情况,比如: 情况一:事务执行过程中可能遇到各种错误,比如服务器本身的错误,操作系统错误,甚至是突然断电导致的错误。 情况二:程序员可以在事务执行过程中手动输入 ROLLBACK 语句结束当前的事务的执行。 这两种情况都会导致事务执行到一半就结束,但是事务执行过程中可能已经修改了很多东西,为了保证事务的原子性,需要把东西改回原先的样子,这个过程就称之为回滚,即:rollback,这样就可以造成这个事务看起来什么都没做,所以符合原子性要求。 每当要对一条记录做改动时,都需要把回滚时所需的东西都给记下来。 比方说: 插入一条记录时,至少要把这条记录的主键值记下来,之后回滚的时候只需要把这个主键值对应的记录删掉。 删除了一条记录,至少要把这条记录中的内容都记下来,这样之后回滚时再把由这些内容组成的记录插入到表中。 修改了一条记录,至少要把修改这条记录前的旧值都记录下来,这样之后回滚时再把这条记录更新为旧值。 这些为了回滚而记录的这些东西称之为撤销日志,即:undo log。这里需要注意的一点是,由于查询操作并不会修改任何用户记录,所以在查询操作执行时,并不需要记录相应的 undo log。 undo 日志的格式 为了实现事务的原子性,InnoDB 存储引擎在实际进行增、删、改一条记录时,都需要先把对应的 undo 日志记下来。一般每对一条记录做一次改动,就对应着一条 undo 日志,但在某些更新记录的操作中,也可能会对应着 2 条 undo 日志。 一个事务在执行过程中可能新增、删除、更新若干条记录,也就是说需要记录很多条对应的 undo 日志,这些 undo 日志会被从 0 开始编号,也就是说根据生成的顺序分别被称为第 0 号 undo 日志、第 1 号 undo 日志、...、第 n 号 undo 日志等,这个编号也被称之为 undo no。 这些 undo 日志是被记录到类型为 FIL_PAGE_UNDO_LOG 的页面中。这些页面可以从系统表空间中分配,也可以从一种专门存放 undo 日志的表空间,也就是所谓的 undo tablespace 中分配。 作者:京东物流 张士欣 来源:京东云开发者社区 自圆其说Tech 转载请注明来源

优秀的个人博客,低调大师

微前端无界机制浅析 | 京东物流技术团队

简介 随着项目的发展,前端SPA应用的规模不断加大、业务代码耦合、编译慢,导致日常的维护难度日益增加。同时前端技术的发展迅猛,导致功能扩展吃力,重构成本高,稳定性低。 为了能够将前端模块解耦,通过相关技术调研,最终选择了无界微前端框架作为物流客服系统解耦支持。为了更好的使用无界微前端框架,我们对其运行机制进行了相关了解,以下是对无界运行机制的一些认识。 基本用法 主应用配置 import WujieVue from 'wujie-vue2'; const { setupApp, preloadApp, bus } = WujieVue; /*设置缓存*/ setupApp({ }); /*预加载*/ preloadApp({ name: 'vue2' }) <WujieVue width="100%" height="100%" name="vue2" :url="vue2Url" :sync="true" :alive="true"></WujieVue 具体实践详细介绍参考: http://3.cn/1GyPHN-i/shendeng  https://wujie-micro.github.io/doc/guide/start.html 无界源码解析 1 源码包目录结构 packages 包里包含无界框架核心代码wujie-core和对应不同技术栈应用包 examples 使用案例,main-xxx对应该技术栈主应用的使用案例,其他代表子应用的使用案例 2 wujie-vue2组件 该组件默认配置了相关参数,简化了无界使用时的一些配置项,作为一个全局组件被主引用使用 这里使用wujie-vue2示例,其他wujie-react,wujie-vue3大家可自行阅读,基本作用和wujie-vue2相同都是用来简化无界配置,方便快速使用 import Vue from "vue"; import { bus, preloadApp, startApp as rawStartApp, destroyApp, setupApp } from "wujie"; const wujieVueOptions = { name: "WujieVue", props: { /*传入配置参数*/ }, data() { return { startAppQueue: Promise.resolve(), }; }, mounted() { bus.$onAll(this.handleEmit); this.execStartApp(); }, methods: { handleEmit(event, ...args) { this.$emit(event, ...args); }, async startApp() { try { // $props 是vue 2.2版本才有的属性,所以这里直接全部写一遍 await rawStartApp({ name: this.name, url: this.url, el: this.$refs.wujie, loading: this.loading, alive: this.alive, fetch: this.fetch, props: this.props, attrs: this.attrs, replace: this.replace, sync: this.sync, prefix: this.prefix, fiber: this.fiber, degrade: this.degrade, plugins: this.plugins, beforeLoad: this.beforeLoad, beforeMount: this.beforeMount, afterMount: this.afterMount, beforeUnmount: this.beforeUnmount, afterUnmount: this.afterUnmount, activated: this.activated, deactivated: this.deactivated, loadError: this.loadError, }); } catch (error) { console.log(error); } }, execStartApp() { this.startAppQueue = this.startAppQueue.then(this.startApp); }, destroy() { destroyApp(this.name); }, }, beforeDestroy() { bus.$offAll(this.handleEmit); }, render(c) { return c("div", { style: { width: this.width, height: this.height, }, ref: "wujie", }); }, }; const WujieVue = Vue.extend(wujieVueOptions); WujieVue.setupApp = setupApp; WujieVue.preloadApp = preloadApp; WujieVue.bus = bus; WujieVue.destroyApp = destroyApp; WujieVue.install = function (Vue) { Vue.component("WujieVue", WujieVue); }; export default WujieVue; 3 入口defineWujieWebComponent和StartApp 首先从入口文件index看起,defineWujieWebComponent import { defineWujieWebComponent } from "./shadow"; // 定义webComponent容器 defineWujieWebComponent(); // 定义webComponent 存在shadow.ts 文件中 export function defineWujieWebComponent() { class WujieApp extends HTMLElement { connectedCallback(){ if (this.shadowRoot) return; const shadowRoot = this.attachShadow({ mode: "open" }); const sandbox = getWujieById(this.getAttribute(WUJIE_DATA_ID)); patchElementEffect(shadowRoot, sandbox.iframe.contentWindow); sandbox.shadowRoot = shadowRoot; } disconnectedCallback() { const sandbox = getWujieById(this.getAttribute(WUJIE_DATA_ID)); sandbox?.unmount(); } } customElements?.define("wujie-app", WujieApp); } startApp方法 startApp(options) { const newSandbox = new WuJie({ name, url, attrs, degradeAttrs, fiber, degrade, plugins, lifecycles }); const { template, getExternalScripts, getExternalStyleSheets } = await importHTML({ url, html, opts: { fetch: fetch || window.fetch, plugins: newSandbox.plugins, loadError: newSandbox.lifecycles.loadError, fiber, }, }); const processedHtml = await processCssLoader(newSandbox, template, getExternalStyleSheets); await newSandbox.active({ url, sync, prefix, template: processedHtml, el, props, alive, fetch, replace }); await newSandbox.start(getExternalScripts); return newSandbox.destroy; 4 实例化 4-1, wujie (sandbox.ts) // wujie class wujie { constructor(options) { /** iframeGenerator在 iframe.ts中**/ this.iframe = iframeGenerator(this, attrs, mainHostPath, appHostPath, appRoutePath); if (this.degrade) { // 降级模式 const { proxyDocument, proxyLocation } = localGenerator(this.iframe, urlElement, mainHostPath, appHostPath); this.proxyDocument = proxyDocument; this.proxyLocation = proxyLocation; } else { // 非降级模式 const { proxyWindow, proxyDocument, proxyLocation } = proxyGenerator(); this.proxy = proxyWindow; this.proxyDocument = proxyDocument; this.proxyLocation = proxyLocation; } this.provide.location = this.proxyLocation; addSandboxCacheWithWujie(this.id, this); } } 4-2.非降级Proxygenerator 非降级模式window、document、location代理 window代理拦截,修改this指向 export function proxyGenerator( iframe: HTMLIFrameElement, urlElement: HTMLAnchorElement, mainHostPath: string, appHostPath: string ): { proxyWindow: Window; proxyDocument: Object; proxyLocation: Object; } { const proxyWindow = new Proxy(iframe.contentWindow, { get: (target: Window, p: PropertyKey): any => { // location进行劫持 /*xxx*/ // 修正this指针指向 return getTargetValue(target, p); }, set: (target: Window, p: PropertyKey, value: any) => { checkProxyFunction(value); target[p] = value; return true; }, /**其他方法属性**/ }); // proxy document const proxyDocument = new Proxy( {}, { get: function (_fakeDocument, propKey) { const document = window.document; const { shadowRoot, proxyLocation } = iframe.contentWindow.__WUJIE; const rawCreateElement = iframe.contentWindow.__WUJIE_RAW_DOCUMENT_CREATE_ELEMENT__; const rawCreateTextNode = iframe.contentWindow.__WUJIE_RAW_DOCUMENT_CREATE_TEXT_NODE__; // need fix /* 包括元素创建,元素选择操作等 createElement,createTextNode, documentURI,URL,querySelector,querySelectorAll documentElement,scrollingElement ,forms,images,links等等 */ // from shadowRoot if (propKey === "getElementById") { return new Proxy(shadowRoot.querySelector, { // case document.querySelector.call apply(target, ctx, args) { if (ctx !== iframe.contentDocument) { return ctx[propKey]?.apply(ctx, args); } return target.call(shadowRoot, `[id="${args[0]}"]`); }, }); } }, } ); // proxy location const proxyLocation = new Proxy( {}, { get: function (_fakeLocation, propKey) { const location = iframe.contentWindow.location; if ( propKey === "host" || propKey === "hostname" || propKey === "protocol" || propKey === "port" || propKey === "origin" ) { return urlElement[propKey]; } /** 拦截相关propKey, 返回对应lication内容 propKey =="href","reload","replace" **/ return getTargetValue(location, propKey); }, set: function (_fakeLocation, propKey, value) { // 如果是跳转链接的话重开一个iframe if (propKey === "href") { return locationHrefSet(iframe, value, appHostPath); } iframe.contentWindow.location[propKey] = value; return true; } } ); return { proxyWindow, proxyDocument, proxyLocation }; } 4-3,降级模式localGenerator export function localGenerator( ){ // 代理 document Object.defineProperties(proxyDocument, { createElement: { get: () => { return function (...args) { const element = rawCreateElement.apply(iframe.contentDocument, args); patchElementEffect(element, iframe.contentWindow); return element; }; }, }, }); // 普通处理 const { modifyLocalProperties, modifyProperties, ownerProperties, shadowProperties, shadowMethods, documentProperties, documentMethods, } = documentProxyProperties; modifyProperties .filter((key) => !modifyLocalProperties.includes(key)) .concat(ownerProperties, shadowProperties, shadowMethods, documentProperties, documentMethods) .forEach((key) => { Object.defineProperty(proxyDocument, key, { get: () => { const value = sandbox.document?.[key]; return isCallable(value) ? value.bind(sandbox.document) : value; }, }); }); // 代理 location const proxyLocation = {}; const location = iframe.contentWindow.location; const locationKeys = Object.keys(location); const constantKey = ["host", "hostname", "port", "protocol", "port"]; constantKey.forEach((key) => { proxyLocation[key] = urlElement[key]; }); Object.defineProperties(proxyLocation, { href: { get: () => location.href.replace(mainHostPath, appHostPath), set: (value) => { locationHrefSet(iframe, value, appHostPath); }, }, reload: { get() { warn(WUJIE_TIPS_RELOAD_DISABLED); return () => null; }, }, }); return { proxyDocument, proxyLocation }; } 实例化化主要是建立起js运行时的沙箱iframe, 通过非降级模式下proxy和降级模式下对document,location,window等全局操作属性的拦截修改将其和对应的js沙箱操作关联起来  5 importHTML入口文件解析 importHtml方法(entry.ts) export default function importHTML(params: { url: string; html?: string; opts: ImportEntryOpts; }): Promise<htmlParseResult> { /*xxxx*/ const getHtmlParseResult = (url, html, htmlLoader) => (html ? Promise.resolve(html) : fetch(url).then( /** 使用fetch Api 加载子应用入口**/ (response) => response.text(), (e) => { embedHTMLCache[url] = null; loadError?.(url, e); return Promise.reject(e); } ) ).then((html) => { const assetPublicPath = getPublicPath(url); const { template, scripts, styles } = processTpl(htmlLoader(html), assetPublicPath); return { template: template, assetPublicPath, getExternalScripts: () => getExternalScripts( scripts .filter((script) => !script.src || !isMatchUrl(script.src, jsExcludes)) .map((script) => ({ ...script, ignore: script.src && isMatchUrl(script.src, jsIgnores) })), fetch, loadError, fiber ), getExternalStyleSheets: () => getExternalStyleSheets( styles .filter((style) => !style.src || !isMatchUrl(style.src, cssExcludes)) .map((style) => ({ ...style, ignore: style.src && isMatchUrl(style.src, cssIgnores) })), fetch, loadError ), }; }); if (opts?.plugins.some((plugin) => plugin.htmlLoader)) { return getHtmlParseResult(url, html, htmlLoader); // 没有html-loader可以做缓存 } else { return embedHTMLCache[url] || (embedHTMLCache[url] = getHtmlParseResult(url, html, htmlLoader)); } } importHTML结构如图: 注意点: 通过Fetch url加载子应用资源,这里也是需要子应用支持跨域设置的原因 6 CssLoader和样式加载优化 export async function processCssLoader( sandbox: Wujie, template: string, getExternalStyleSheets: () => StyleResultList ): Promise<string> { const curUrl = getCurUrl(sandbox.proxyLocation); /** css-loader */ const composeCssLoader = compose(sandbox.plugins.map((plugin) => plugin.cssLoader)); const processedCssList: StyleResultList = getExternalStyleSheets().map(({ src, ignore, contentPromise }) => ({ src, ignore, contentPromise: contentPromise.then((content) => composeCssLoader(content, src, curUrl)), })); const embedHTML = await getEmbedHTML(template, processedCssList); return sandbox.replace ? sandbox.replace(embedHTML) : embedHTML; }  7 子应用active active方法主要用于做 子应用激活, 同步路由,动态修改iframe的fetch, 准备shadow, 准备子应用注入 7-1, active方法(sandbox.ts) public async active(options){ /** options的检查 **/ // 处理子应用自定义fetch // TODO fetch检验合法性 const iframeWindow = this.iframe.contentWindow; iframeWindow.fetch = iframeFetch; this.fetch = iframeFetch; // 处理子应用路由同步 if (this.execFlag && this.alive) { // 当保活模式下子应用重新激活时,只需要将子应用路径同步回主应用 syncUrlToWindow(iframeWindow); } else { // 先将url同步回iframe,然后再同步回浏览器url syncUrlToIframe(iframeWindow); syncUrlToWindow(iframeWindow); } // inject template this.template = template ?? this.template; /* 降级处理 */ if (this.degrade) { return; } if (this.shadowRoot) { this.el = renderElementToContainer(this.shadowRoot.host, el); if (this.alive) return; } else { // 预执行无容器,暂时插入iframe内部触发Web Component的connect // rawDocumentQuerySelector.call(iframeWindow.document, "body") 相当于Document.prototype.querySelector('body') const iframeBody = rawDocumentQuerySelector.call(iframeWindow.document, "body") as HTMLElement; this.el = renderElementToContainer(createWujieWebComponent(this.id), el ?? iframeBody); } await renderTemplateToShadowRoot(this.shadowRoot, iframeWindow, this.template); this.patchCssRules(); // inject shadowRoot to app this.provide.shadowRoot = this.shadowRoot; } 7-2,createWujieWebComponent, renderElementToContainer, renderTemplateToShadowRoot // createWujieWebComponent export function createWujieWebComponent(id: string): HTMLElement { const contentElement = window.document.createElement("wujie-app"); contentElement.setAttribute(WUJIE_DATA_ID, id); contentElement.classList.add(WUJIE_IFRAME_CLASS); return contentElement; } /** * 将准备好的内容插入容器 */ export function renderElementToContainer( element: Element | ChildNode, selectorOrElement: string | HTMLElement ): HTMLElement { const container = getContainer(selectorOrElement); if (container && !container.contains(element)) { // 有 loading 无需清理,已经清理过了 if (!container.querySelector(`div[${LOADING_DATA_FLAG}]`)) { // 清除内容 clearChild(container); } // 插入元素 if (element) { // rawElementAppendChild = HTMLElement.prototype.appendChild; rawElementAppendChild.call(container, element); } } return container; } /** * 将template渲染到shadowRoot */ export async function renderTemplateToShadowRoot( shadowRoot: ShadowRoot, iframeWindow: Window, template: string ): Promise<void> { const html = renderTemplateToHtml(iframeWindow, template); // 处理 css-before-loader 和 css-after-loader const processedHtml = await processCssLoaderForTemplate(iframeWindow.__WUJIE, html); // change ownerDocument shadowRoot.appendChild(processedHtml); const shade = document.createElement("div"); shade.setAttribute("style", WUJIE_SHADE_STYLE); processedHtml.insertBefore(shade, processedHtml.firstChild); shadowRoot.head = shadowRoot.querySelector("head"); shadowRoot.body = shadowRoot.querySelector("body"); // 修复 html parentNode Object.defineProperty(shadowRoot.firstChild, "parentNode", { enumerable: true, configurable: true, get: () => iframeWindow.document, }); patchRenderEffect(shadowRoot, iframeWindow.__WUJIE.id, false); } /** * 将template渲染成html元素 */ function renderTemplateToHtml(iframeWindow: Window, template: string): HTMLHtmlElement { const sandbox = iframeWindow.__WUJIE; const { head, body, alive, execFlag } = sandbox; const document = iframeWindow.document; let html = document.createElement("html"); html.innerHTML = template; // 组件多次渲染,head和body必须一直使用同一个来应对被缓存的场景 if (!alive && execFlag) { html = replaceHeadAndBody(html, head, body); } else { sandbox.head = html.querySelector("head"); sandbox.body = html.querySelector("body"); } const ElementIterator = document.createTreeWalker(html, NodeFilter.SHOW_ELEMENT, null, false); let nextElement = ElementIterator.currentNode as HTMLElement; while (nextElement) { patchElementEffect(nextElement, iframeWindow); const relativeAttr = relativeElementTagAttrMap[nextElement.tagName]; const url = nextElement[relativeAttr]; if (relativeAttr) nextElement.setAttribute(relativeAttr, getAbsolutePath(url, nextElement.baseURI || "")); nextElement = ElementIterator.nextNode() as HTMLElement; } if (!html.querySelector("head")) { const head = document.createElement("head"); html.appendChild(head); } if (!html.querySelector("body")) { const body = document.createElement("body"); html.appendChild(body); } return html; } /* // 保存原型方法 // 子应用的Document.prototype已经被改写了 export const rawElementAppendChild = HTMLElement.prototype.appendChild; export const rawElementRemoveChild = HTMLElement.prototype.removeChild; export const rawHeadInsertBefore = HTMLHeadElement.prototype.insertBefore; export const rawBodyInsertBefore = HTMLBodyElement.prototype.insertBefore; export const rawAddEventListener = Node.prototype.addEventListener; export const rawRemoveEventListener = Node.prototype.removeEventListener; export const rawWindowAddEventListener = window.addEventListener; export const rawWindowRemoveEventListener = window.removeEventListener; export const rawAppendChild = Node.prototype.appendChild; export const rawDocumentQuerySelector = window.__POWERED_BY_WUJIE__ ? window.__WUJIE_RAW_DOCUMENT_QUERY_SELECTOR__ : Document.prototype.querySelector; */  8 子应用启动执行start start 开始执行子应用,运行js,执行无界js插件列表 public async start(getExternalScripts: () => ScriptResultList): Promise<void> { this.execFlag = true; // 执行脚本 const scriptResultList = await getExternalScripts(); const iframeWindow = this.iframe.contentWindow; // 标志位,执行代码前设置 iframeWindow.__POWERED_BY_WUJIE__ = true; // 用户自定义代码前 const beforeScriptResultList: ScriptObjectLoader[] = getPresetLoaders("jsBeforeLoaders", this.plugins); // 用户自定义代码后 const afterScriptResultList: ScriptObjectLoader[] = getPresetLoaders("jsAfterLoaders", this.plugins); // 同步代码 const syncScriptResultList: ScriptResultList = []; // async代码无需保证顺序,所以不用放入执行队列 const asyncScriptResultList: ScriptResultList = []; // defer代码需要保证顺序并且DOMContentLoaded前完成,这里统一放置同步脚本后执行 const deferScriptResultList: ScriptResultList = []; scriptResultList.forEach((scriptResult) => { if (scriptResult.defer) deferScriptResultList.push(scriptResult); else if (scriptResult.async) asyncScriptResultList.push(scriptResult); else syncScriptResultList.push(scriptResult); }); // 插入代码前 beforeScriptResultList.forEach((beforeScriptResult) => { this.execQueue.push(() => this.fiber ? requestIdleCallback(() => insertScriptToIframe(beforeScriptResult, iframeWindow)) : insertScriptToIframe(beforeScriptResult, iframeWindow) ); }); // 同步代码 syncScriptResultList.concat(deferScriptResultList).forEach((scriptResult) => { /**xxxxx**/ }); // 异步代码 asyncScriptResultList.forEach((scriptResult) => { scriptResult.contentPromise.then((content) => { this.fiber ? requestIdleCallback(() => insertScriptToIframe({ ...scriptResult, content }, iframeWindow)) : insertScriptToIframe({ ...scriptResult, content }, iframeWindow); }); }); //框架主动调用mount方法 this.execQueue.push(this.fiber ? () => requestIdleCallback(() => this.mount()) : () => this.mount()); //触发 DOMContentLoaded 事件 const domContentLoadedTrigger = () => { eventTrigger(iframeWindow.document, "DOMContentLoaded"); eventTrigger(iframeWindow, "DOMContentLoaded"); this.execQueue.shift()?.(); }; this.execQueue.push(this.fiber ? () => requestIdleCallback(domContentLoadedTrigger) : domContentLoadedTrigger); // 插入代码后 afterScriptResultList.forEach((afterScriptResult) => { /**xxxxx**/ }); //触发 loaded 事件 const domLoadedTrigger = () => { eventTrigger(iframeWindow.document, "readystatechange"); eventTrigger(iframeWindow, "load"); this.execQueue.shift()?.(); }; this.execQueue.push(this.fiber ? () => requestIdleCallback(domLoadedTrigger) : domLoadedTrigger); // 由于没有办法准确定位是哪个代码做了mount,保活、重建模式提前关闭loading if (this.alive || !isFunction(this.iframe.contentWindow.__WUJIE_UNMOUNT)) removeLoading(this.el); this.execQueue.shift()(); // 所有的execQueue队列执行完毕,start才算结束,保证串行的执行子应用 return new Promise((resolve) => { this.execQueue.push(() => { resolve(); this.execQueue.shift()?.(); }); }); } // getExternalScripts export function getExternalScripts( scripts: ScriptObject[], fetch: (input: RequestInfo, init?: RequestInit) => Promise<Response> = defaultFetch, loadError: loadErrorHandler, fiber: boolean ): ScriptResultList { // module should be requested in iframe return scripts.map((script) => { const { src, async, defer, module, ignore } = script; let contentPromise = null; // async if ((async || defer) && src && !module) { contentPromise = new Promise((resolve, reject) => fiber ? requestIdleCallback(() => fetchAssets(src, scriptCache, fetch, false, loadError).then(resolve, reject)) : fetchAssets(src, scriptCache, fetch, false, loadError).then(resolve, reject) ); // module || ignore } else if ((module && src) || ignore) { contentPromise = Promise.resolve(""); // inline } else if (!src) { contentPromise = Promise.resolve(script.content); // outline } else { contentPromise = fetchAssets(src, scriptCache, fetch, false, loadError); } return { ...script, contentPromise }; }); } // 加载assets资源 // 如果存在缓存则从缓存中获取 const fetchAssets = ( src: string, cache: Object, fetch: (input: RequestInfo, init?: RequestInit) => Promise<Response>, cssFlag?: boolean, loadError?: loadErrorHandler ) => cache[src] || (cache[src] = fetch(src) .then((response) => { /**status > 400按error处理**/ return response.text(); }) })); // insertScriptToIframe export function insertScriptToIframe( scriptResult: ScriptObject | ScriptObjectLoader, iframeWindow: Window, rawElement?: HTMLScriptElement ) { const { src, module, content, crossorigin, crossoriginType, async, callback, onload } = scriptResult as ScriptObjectLoader; const scriptElement = iframeWindow.document.createElement("script"); const nextScriptElement = iframeWindow.document.createElement("script"); const { replace, plugins, proxyLocation } = iframeWindow.__WUJIE; const jsLoader = getJsLoader({ plugins, replace }); let code = jsLoader(content, src, getCurUrl(proxyLocation)); // 内联脚本处理 if (content) { // patch location if (!iframeWindow.__WUJIE.degrade && !module) { code = `(function(window, self, global, location) { ${code} }).bind(window.__WUJIE.proxy)( window.__WUJIE.proxy, window.__WUJIE.proxy, window.__WUJIE.proxy, window.__WUJIE.proxyLocation, );`; } } else { // 外联自动触发onload onload && (scriptElement.onload = onload as (this: GlobalEventHandlers, ev: Event) => any); src && scriptElement.setAttribute("src", src); crossorigin && scriptElement.setAttribute("crossorigin", crossoriginType); } // esm 模块加载 module && scriptElement.setAttribute("type", "module"); scriptElement.textContent = code || ""; // 执行script队列检测 nextScriptElement.textContent = "if(window.__WUJIE.execQueue && window.__WUJIE.execQueue.length){ window.__WUJIE.execQueue.shift()()}"; const container = rawDocumentQuerySelector.call(iframeWindow.document, "head"); if (/^<!DOCTYPE html/i.test(code)) { error(WUJIE_TIPS_SCRIPT_ERROR_REQUESTED, scriptResult); return !async && container.appendChild(nextScriptElement); } container.appendChild(scriptElement); // 调用回调 callback?.(iframeWindow); // 执行 hooks execHooks(plugins, "appendOrInsertElementHook", scriptElement, iframeWindow, rawElement); // 外联转内联调用手动触发onload content && onload?.(); // async脚本不在执行队列,无需next操作 !async && container.appendChild(nextScriptElement); } 9 子应用销毁 /** 销毁子应用 */ public destroy() { this.bus.$clear(); // thi.xxx = null; // 清除 dom if (this.el) { clearChild(this.el); this.el = null; } // 清除 iframe 沙箱 if (this.iframe) { this.iframe.parentNode?.removeChild(this.iframe); } // 删除缓存 deleteWujieById(this.id); }  主应用,无界,子应用之间的关系 主应用创建自定义元素和创建iframe元素 无界将子应用解析后的html,css加入到自定义元素,进行元素和样式隔离 同时建立iframe代理,将iframe和自定义元素shadowDom进行关联, 将子应用中的js放入iframe执行,iframe中js执行的结果被代理到修改shadowDom结构和数据  作者:京东物流张燕燕、刘海鼎 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

基于Effect的组件设计 | 京东云技术团队

Effect的概念起源 从输入输出的角度理解Effect https://link.excalidraw.com/p/readonly/KXAy7d2DlnkM8X1yps6L 编程中的Effect起源于函数式编程中纯函数的概念 纯函数是指在相同的输入下,总是产生相同的输出,并且没有任何副作用(side effect)的函数。 副作用是指函数执行过程中对函数外部环境进行的可观察的改变,比如修改全局变量、打印输出、写入文件等。 前端的典型副作用场景是 浏览器环境中在window上注册变量 副作用引入了不确定性,使得程序的行为难以预测和调试。为了处理那些需要进行副作用的操作,函数式编程引入了Effect的抽象概念。 它可以表示诸如读取文件、写入数据库、发送网络请求、DOM渲染等对外部环境产生可观察改变的操作。通过将这些操作包装在Effect中,函数式编程可以更好地控制和管理副作用,使得代码更具可预测性和可维护性。 实际工作中我们也是从React的useEffect开始直接使用Effect的说法 React: useEffect useEffect is a React Hook that lets you synchronize a component with an external system. import { useState, useEffect } from 'react'; // 模拟异步事件 function getMsg() { return new Promise((resolve) => { setTimeout(() => { resolve('React') }, 1000) }) } export default function Hello() { const [msg, setMsg] = useState('World') useEffect(() => { getMsg().then((msg) => { setMsg(msg) }) const timer = setInterval(() => { console.log('test interval') }) return () => { // 清除异步事件 clearTimeout(timer) } }, []) return ( <h1>Hello { msg }</h1> ); } Effect中处理异步事件,并在此处消除异步事件的副作用clearTimeout(timer),避免闭包一直无法被销毁 Vue: watcher 运行期自动依赖收集 示例 <script setup> import { ref } from 'vue' const msg = ref('World!') setTimeout(() => { msg.value = 'Vue' }, 1000) </script> <template> <h1>Hello {{ msg }}</h1> </template> _createElementVNode("h1", null, _toDisplayString(msg.value), 1 /* TEXT */) runtime的render期间通过msg.value对msg产生了引用,此时产生了一个watch effect:msg的watchlist中多了一个render的watcher,在msg变化的时候 render会通过watcher重新执行 Svelte: $ 编译器依赖收集 示例 suffix的值依赖name,在name变化之后,suffix值也更新 <script> let name = 'world'; $: suffix = name + '!' setTimeout(() => { name = 'svelte' }, 1000) </script> <h1>Hello {suffix}</h1> // 编译后部分代码 function instance($$self, $$props, $$invalidate) { let suffix let name = 'world' setTimeout(() => { $$invalidate(1, (name = 'svelte')) }, 1000) // 更新关系 $$self.$$.update = () => { if ($$self.$$.dirty & /*name*/ 2) { $: $$invalidate(0, (suffix = name + '!')) } } return [suffix, name] } Effect分类 React先介绍了两种典型的Effect 渲染逻辑中可以获取 props 和 state,并对它们进行转换,然后返回您希望在屏幕上看到的 JSX。渲染代码必须是纯的,就像数学公式一样,它只应该计算结果,而不做其他任何事情。 事件处理程序是嵌套在组件内部的函数,它们执行操作而不仅仅做计算。事件处理程序可以更新输入字段、提交HTTP POST请求以购买产品或将用户导航到另一个页面。它包含由用户特定操作(例如按钮点击或输入)引起的 “副作用”(它们改变程序的状态)。 Consider a ChatRoom component that must connect to the chat server whenever it’s visible on the screen. Connecting to a server is not a pure calculation (it’s a side effect) so it can’t happen during rendering. However, there is no single particular event like a click that causes ChatRoom to be displayed. 考虑一个ChatRoom组件,每当它在屏幕上可见时都必须连接到聊天服务器。连接到服务器不是一个纯粹的计算(它是一个副作用),因此不能在渲染期间发生(渲染必须是纯函数)。然而,并没有单个特定的事件(如点击)会触发ChatRoom的展示 Effects let you specify side effects that are caused by rendering itself, rather than by a particular event. Sending a message in the chat is an event because it is directly caused by the user clicking a specific button. However, setting up a server connection is an Effect because it should happen no matter which interaction caused the component to appear. Effects run at the end of a commit after the screen updates. This is a good time to synchronize the React components with some external system (like network or a third-party library). Effect 允许指定由渲染本身引起的副作用,而不是由特定事件引起的副作用。在聊天中发送消息是一个事件,因为它直接由用户点击特定按钮引起。然而不管是任何交互触发的组件展示,设置服务器连接都是一个Effect。Effect会在页面更新后的commit结束时运行。这是与某个外部系统(如网络或第三方库)同步React组件的好时机 以下Effect尽量达到不重不漏,不重的意义是他们之间是相互独立的,每个模块可以独立实现,这样可以在系统设计的初期可以将业务Model建设和Effect处理分离,甚至于将Effects提取成独立的utils 渲染 生命周期 组件被初始化、更新、卸载的时候我们需要做一些业务逻辑处理,例如:组件初始化时调用接口更新数据 React react基于自己的fiber结构,通过闭包完成状态的管理,不会建立值和渲染过程的绑定关系,通过在commit之后执行Effect达到值的状态更新等副作用操作,因此声明周期需要自己模拟实现 import { useState, useEffect } from 'react'; export default function Hello() { const [msg, setMsg] = useState('World') // dependency是空 因此只会在第一次执行 声明周期上可以理解为onMounted useEffect(() => { // 异步事件 const timer = setTimeout(() => { // setMsg会触发重渲染 https://react.dev/learn/render-and-commit setMsg('React') }, 1000) return () => { // 卸载时/重新执行Effect前 清除异步事件 clearTimeout(timer) } // 如果dependency有值 则每次更新如果dependency不一样就会执行Effect }, []) return ( <h1>Hello { msg }</h1> ); } <script setup> import { onMounted, onUnmounted, onUpdated, ref } from 'vue' const msg = ref('Hello World!') // 挂载 onMounted(async () => { function getValue() { return Promise.resolve('hello, vue') } const value = await getValue() msg.value = value }) onUpdated(() => {}) // 更新 onUnmounted(() => {}) // 卸载 </script> <template> <h1>{{ msg }}</h1> <input v-model="msg"> </template> <script> import { onMount, onDestroy, beforeUpdate } from 'svelte' let name = 'world' $: suffix = name + '!' onMount(() => { setTimeout(() => { name = 'svelte' }, 1000) }) beforeUpdate(() => {}) // 更新 onDestroy(() => {}) // 卸载/销毁 </script> <h1>Hello {suffix}</h1> Action 用户行为 对应React中提到的两个典型Effect中的 事件处理程序 在不考虑跳出应用(location.href='xxx')的情况下,我们的行为都只能改变当前应用的状态,不管是输入、选择还是触发异步事件的提交,网络相关的副作用在下节讨论 点击/输入 <!-- 原生 要求onClick是全局变量 --> <div onclick="onClick"/> <!-- React --> <div onClick={onClick}/> <!-- Vue --> <div @click="onClick"/> <!-- Svelte --> <div on:click="onClick"/> 滑动输入、键盘输入等 <!-- React view和model的关系需要自己处理 --> <input value={value} onChange={val => setValue(val)} placeholder="enter your name" /> <!-- Vue 通过指令自动建立view和model的绑定关系 --> <input v-model="name" placeholder="enter your name" /> <!-- Svelte --> <input bind:value={name} placeholder="enter your name" /> 所谓的MVVM即是视图和模型的绑定关系通过框架(v-mode,bind:valuel)完成,所以需要自己处理绑定关系的React不是MVVM 滚动 同上 Network 网络请求 基础:XMLHttpRequest,Fetch NPM包:Axios,useSwr Storage 存储 任何存储行为都是副作用:POST请求、变量赋值、local存储、cookie设置、URL参数设置 Remote 缓存/数据库,同上 网络请求 Local 内存 局部变量 闭包 React的函数式组件中的useState的值的变更 全局变量 window 浏览器环境初始化完成之后,我们的context中就会有window全局变量,修改window的属性会使同一个页面环境中的所有内容都被影响(微前端的window隔离方案除外) LocalStorage 兼容localStorage存储和 原生APP存储;返回Promise 其实也可以兼容从接口获取、存储数据 export function getItem(key) { const now = Date.now(); if (window.XWebView) { window.XWebView.callNative( 'JDBStoragePlugin', 'getItem', JSON.stringify({ key, }), `orange_${now}`, '-1', ); } else { setTimeout(() => { window[`orange_${now}`]( JSON.stringify({ status: '0', data: { result: 'success', data: localStorage.getItem(key), }, }), ); }, 0); } return new Promise((resolve, reject) => { window[`orange_${now}`] = (result) => { try { const obj = JSON.parse(result); const { status, data } = obj; if (status === '0' && data && data.result === 'success') { resolve(data.data); } else { reject(result); } } catch (e) { reject(e); } window[`orange_${now}`] = undefined; }; }); } export function setItem(key, value = BABEL_CHANNEL) { const now = Date.now(); if (window.XWebView) { window.XWebView.callNative( 'JDBStoragePlugin', 'setItem', JSON.stringify({ key, value, }), `orange_${now}`, '-1', ); } else { setTimeout(() => { window[`orange_${now}`]( JSON.stringify({ status: '0', data: { result: 'success', data: localStorage.setItem(key, value), }, }), ); }, 0); } return new Promise((resolve, reject) => { window[`orange_${now}`] = (result) => { console.log('MKT ~ file: storage.js:46 ~ returnnewPromise ~ result:', result); try { const obj = JSON.parse(result); const { status, data } = obj; if (status === '0' && data && data.result === 'success') { resolve(data.data); } else { reject(result); } } catch (e) { reject(e); } window[`orange_${now}`] = undefined; }; }); } Cookie https://www.npmjs.com/package/js-cookie  URL 参见地址栏参数 举个栗子🌰 组件诉求 1. 支持分页 2. 支持搜索 3. 已选择的门店需要回显,但是已选择的门店只能分页获取,无法全部获取 4. 需要知道用户移除了哪些选项,增加了哪些选项 5. 支持服务端全选 组件Effect分析 业务组件可以视load-data为纯函数,因为loda-data的调用不会影响外部业务组件,清晰的Effects归属可以降低业务的复杂度,最大程度上降低组件的耦合 用户在组件内的行为(除了确定之外)产生的Effect只对组件自身产生影响,提升了组件的内聚  组件模型设计 组件list兼容搜索和下拉场景 const { result: list, hasNext } = await this.loadData(param).catch(() => ({ hasNext: false, result: [] })) const lastRemove = this.remove // 本次新增之前移除的内容 if (param.pageNo === 1 && !param.search) { this.list = list } else { // 建立新值的索引 接口返回的信息是无状态属性的(选中与否) const map = list.reduce((pre, cur) => { pre[cur.id] = Object.assign(cur, { from: param.search }) return pre }, {}) // 此处应该遍历list 而不是 this.list this.list = this.list.map(item => { const diff = map[item.id] // 找到之前已经有的数据 就从map中移动到之前list的位置做替换 if (diff) delete map[item.id] return diff || item // 剩余的值补充到最后面 }).concat(Object.values(map)) } const value = diffBy(this.last.add.concat(this.remote, this.local, this.checked), lastRemove) this.value = value  接口返回选中的值通过checked-by-remote纯函数的依赖反转实现惰性计算 业务组件默认选中的值通过checked-by-local纯函数的依赖反转实现惰性计算 增加或者移除的值通过相应的diff计算出来 Reactivity极大提升了Model的表达能力 { computed: { /** * 接口返回已选中的数据且不能在已移除的数据中, 否则上次移除的数据会被自动选中 */ remote() { return diffBy(this.list.filter(this.checkedByRemote || emptyFilter).map(it => it.id), this.last.remove) }, /** * 本地默认选中 且不是从remote选中的 且不是上次选中的 */ local() { return diffBy(this.list.filter(this.checkedByLocal || emptyFilter).map(it => it.id), this.remote, this.last.add) }, // 用户选择的 checked() { return diffBy(this.value, this.remote, this.last.add, this.local) }, // 1. 本地有接口没有的 是新增,this.value中已包含了last.add 2. 需要新增的且不在上次本地移除的范围内:上次移除的可能不在this.remote范围内 add() { return diffBy(this.value, this.remote, this.last.remove) }, // 1. 接口有本地没有的 是移除 2. 需要移除的 且 不在上次本地新增的范围内 remove() { return this.last.remove.concat(diffBy(this.remote, this.value, this.last.remove)) } }, } 参考资料 面向 Model 编程的前端架构设计 https://mp.weixin.qq.com/s/g4hnfirDmyeuXAdEt-zk9w Synchronizing with Effects https://react.dev/learn/synchronizing-with-effects 作者:京东零售 刘威 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

深入理解线段树 | 京东物流技术团队

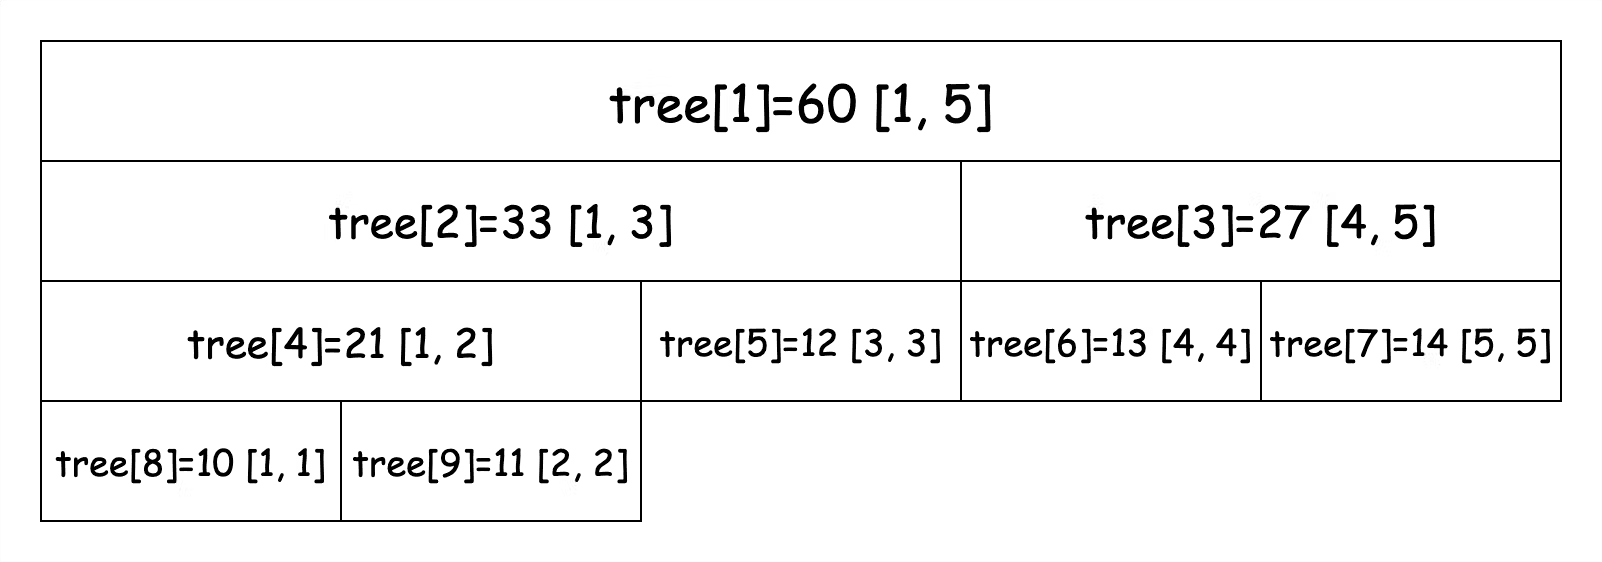
线段树(Segment Tree)是常用的维护区间信息的数据结构,它可以在 O(logn) 的时间复杂度下实现单点修改、区间修改、区间查询(区间求和、区间最大值或区间最小值)等操作,常用来解决 RMQ 问题。 RMQ(Range Minimum/Maximum Query) 问题是指:对于长度为 n 的数列 A,回答若干询问 RMQ(A, i, j) 其中 i, j <= n,返回数列 A 中下标在 i, j 里的最小(大)值。也就是说:RMQ问题是指求区间最值的问题。通常该类型题目的解法有递归分治、动态规划、线段树和单调栈/单调队列。 这篇内容断断续续写了两周,随着练习对线段树的理解不断深入,慢慢地学习下来也不觉得它有多么困难,更多的体会还是熟能生巧,虽然它起初看上去确实代码量大一些,但是我觉得只要大家放平心态,循序渐进的掌握下文中的三部分,也没什么难的。 1. 线段树 线段树会将每个长度不为 1 的区间划分成左右两个区间来递归求解,通过合并左右两区间的信息来求得当前区间的信息。 比如,我们将一个大小为 5 的数组 nums = {10, 11, 12, 13, 14} 转换成线段树,并规定线段树的根节点编号为 1。用数组 tree[] 来保存线段树的节点,tree[i] 表示线段树上编号为 i 的节点,图示如下: 图示中每个节点展示了区间和以及区间范围,tree[i] 左子树节点为 tree[2i],右子树节点为 tree[2i + 1]。如果 tree[i] 记录的区间为 [a, b] 的话,那么左子树节点记录的区间为 [a, mid],右子树节点记录的区间为 [mid + 1, b],其中 mid = (a + b) / 2。 现在我们已经对线段树有了基本的认识,接下来我们看看区间查询和单点修改的代码实现。 区间查询和单点修改线段树 首先,我们定义线段树的节点: /** * 定义线段树节点 */ class Node { /** * 区间和 或 区间最大/最小值 */ int val; int left; int right; public Node(int left, int right) { this.left = left; this.right = right; } } 注意其中的 val 字段保存的是区间的和。定义完树的节点,我们来看一下建树的逻辑,注意代码中的注释,我们为线段树分配的节点数组大小为原数组大小的 4 倍,这是考虑到数组转换成满二叉树的最坏情况。 public SegmentTree(int[] nums) { this.nums = nums; tree = new Node[nums.length * 4]; // 建树,注意表示区间时使用的是从 1 开始的索引值 build(1, 1, nums.length); } /** * 建树 * * @param pos 当前节点编号 * @param left 当前节点区间下界 * @param right 当前节点区间上界 */ private void build(int pos, int left, int right) { // 创建节点 tree[pos] = new Node(left, right); // 递归结束条件 if (left == right) { // 赋值 tree[pos].val = nums[left - 1]; return; } // 如果没有到根节点,则继续递归 int mid = left + right >> 1; build(pos << 1, left, mid); build(pos << 1 | 1, mid + 1, right); // 当前节点的值是左子树和右子树节点的和 pushUp(pos); } /** * 用于向上回溯时修改父节点的值 */ private void pushUp(int pos) { tree[pos].val = tree[pos << 1].val + tree[pos << 1 | 1].val; } 我们在建树时,表示区间并不是从索引 0 开始,而是从索引 1 开始,这样才能保证在计算左子树节点索引时为 2i,右子树节点索引为 2i + 1。 build()方法执行时,我们会先在对应的位置上创建节点而不进行赋值,只有在递归到叶子节点时才赋值,此时区间大小为 1,节点值即为当前区间的值。之后非叶子节点值都是通过pushUp()方法回溯加和当前节点的两个子节点值得出来的。 接下来我们看修改区间中的值,线段树对值的更新方法,关注其中的注释: /** * 修改单节点的值 * * @param pos 当前节点编号 * @param numPos 需要修改的区间中值的位置 * @param val 修改后的值 */ private void update(int pos, int numPos, int val) { // 找到该数值所在线段树中的叶子节点 if (tree[pos].left == numPos && tree[pos].right == numPos) { tree[pos].val = val; return; } // 如果不是当前节点那么需要判断是去左或右去找 int mid = tree[pos].left + tree[pos].right >> 1; if (numPos <= mid) { update(pos << 1, numPos, val); } else { update(pos << 1 | 1, numPos, val); } // 叶子节点的值修改完了,需要回溯更新所有相关父节点的值 pushUp(pos); } 修改方法比较简单,当叶子节点值更新完毕时,我们仍然需要调用pushUp()方法对所有相关父节点值进行更新。 接下来我们看查找对应区间和的方法: /** * 查找对应区间的值 * * @param pos 当前节点 * @param left 要查询的区间的下界 * @param right 要查询的区间的上界 */ private int query(int pos, int left, int right) { // 如果我们要查找的区间把当前节点区间全部包含起来 if (left <= tree[pos].left && tree[pos].right <= right) { return tree[pos].val; } int res = 0; int mid = tree[pos].left + tree[pos].right >> 1; // 根据区间范围去左右节点分别查找求和 if (left <= mid) { res += query(pos << 1, left, right); } if (right > mid) { res += query(pos << 1 | 1, left, right); } return res; } 该方法也比较简单,需要判断区间范围是否需要对向左子节点和右子节点的分别查找计算。 现在表示区间和的线段树已经讲解完毕了,为了方便大家学习和看代码,我把全量的代码在这里贴出来: public class SegmentTree { /** * 定义线段树节点 */ static class Node { /** * 区间和 或 区间最大/最小值 */ int val; int left; int right; public Node(int left, int right) { this.left = left; this.right = right; } } Node[] tree; int[] nums; public SegmentTree(int[] nums) { this.nums = nums; tree = new Node[nums.length * 4]; // 建树,注意表示区间时使用的是从 1 开始的索引值 build(1, 1, nums.length); } /** * 建树 * * @param pos 当前节点编号 * @param left 当前节点区间下界 * @param right 当前节点区间上界 */ private void build(int pos, int left, int right) { // 创建节点 tree[pos] = new Node(left, right); // 递归结束条件 if (left == right) { // 赋值 tree[pos].val = nums[left - 1]; return; } // 如果没有到根节点,则继续递归 int mid = left + right >> 1; build(pos << 1, left, mid); build(pos << 1 | 1, mid + 1, right); // 当前节点的值是左子树和右子树节点的和 pushUp(pos); } /** * 修改单节点的值 * * @param pos 当前节点编号 * @param numPos 需要修改的区间中值的位置 * @param val 修改后的值 */ private void update(int pos, int numPos, int val) { // 找到该数值所在线段树种的叶子节点 if (tree[pos].left == numPos && tree[pos].right == numPos) { tree[pos].val = val; return; } // 如果不是当前节点那么需要判断是去左或右去找 int mid = tree[pos].left + tree[pos].right >> 1; if (numPos <= mid) { update(pos << 1, numPos, val); } else { update(pos << 1 | 1, numPos, val); } // 叶子节点的值修改完了,需要回溯更新所有相关父节点的值 pushUp(pos); } /** * 用于向上回溯时修改父节点的值 */ private void pushUp(int pos) { tree[pos].val = tree[pos << 1].val + tree[pos << 1 | 1].val; } /** * 查找对应区间的值 * * @param pos 当前节点 * @param left 要查询的区间的下界 * @param right 要查询的区间的上界 */ private int query(int pos, int left, int right) { // 如果我们要查找的区间把当前节点区间全部包含起来 if (left <= tree[pos].left && tree[pos].right <= right) { return tree[pos].val; } int res = 0; int mid = tree[pos].left + tree[pos].right >> 1; // 根据区间范围去左右节点分别查找求和 if (left <= mid) { res += query(pos << 1, left, right); } if (right > mid) { res += query(pos << 1 | 1, left, right); } return res; } } 如果要创建表示区间最大值或最小值的线段树,建树的逻辑不变,只需要将**pushUp()方法和query()**方法修改成计算最大值或最小值的逻辑即可。 2. 线段树的区间修改与懒惰标记 如果我们不仅对单点进行修改,也对区间进行修改,那么在区间修改时就需要将当前区间值及包含当前区间的子区间值都修改一遍,这样所产生的开销是没办法接受的,因此在这里我们会使用一种懒惰标记的方法来帮助我们避免这种即时开销。 简单来说,懒惰标记是通过延迟对节点信息的更改,从而减少可能不必要的操作次数。每次执行修改时,我们通过打标记的方法表明该节点对应的区间在某一次操作中被更改,但不更新该节点的子节点的信息。实质性的修改则在下一次**“即将访问(update 或 query)”到带有懒惰标记节点的子节点**时才进行。 我们通过在节点类中添加 add 字段记录懒惰标记,它表示的是该区间的子区间值需要“变化的大小”(一定好好好的理解),并通过 pushDown 方法“累加”到当前区间的两个子节点区间值中。 只要不访问到当前区间的子区间,那么子区间值始终都不会变化,相当于子区间值的变化量被当前节点通过 add 字段“持有” pushDown 方法区别于我们上文中提到的 pushUp 方法,前者是将当前节点值累计的懒惰标记值同步到子节点中,而后者是完成子节点修改后,回溯修改当前子节点的父节点值,我们能够根据 Down 和 Up 来更好的理解这两个方法的作用方向和修改范围。 下面我们一起来看看过程和具体的代码,节点类如下,增加 add 字段: static class Node { int left; int right; int val; int add; public Node(int left, int right) { this.left = left; this.right = right; } } 区间修改 建树的流程与我们上述的一致,就不在这里赘述了,我们主要关注区间修改的过程,还是以如下初始的线段树为例,此时各个节点的 add 均为 0: 接下来我们修改区间 [3, 5] 且区间内每个值变化量为 1,过程如下: 先遍历节点 1,发现 [3, 5] 区间不能将 [1, 5] 区间完全包含,不进行修改,继续遍历节点 2。节点 2 依然没有被区间 [3, 5] 包含,需要继续遍历节点 5,发现该节点被区间完全包含,进行修改并添加懒惰标记值,如下图所示: 完成这一步骤后需要向上回溯修改 tree[2] 节点的值: 现在 [3, 5] 区间中 3 已经完成修改,还有 4, 5 没有被修改,我们需要在右子树中继续递归查找,发现 tree[3] 中区间被我们要修改的区间 [3, 5] 完全包含,那么需要将这个节点进行修改并懒惰标记,如下,注意这里虽然 tree[3] 节点有两个子节点,但是因为我们没有访问到它的子节点所以无需同步 add 值到各个子节点中: 同样,完成这一步骤也需要向上回溯修改父节点的值: 到现在我们的区间修改就已经完成了,根据这个过程代码示例如下: /** * 修改区间的值 * * @param pos 当前节点编号 * @param left 要修改区间的下界 * @param right 要修改区间的上界 * @param val 区间内每个值的变化量 */ public void update(int pos, int left, int right, int val) { // 如果该区间被要修改的区间包围的话,那么需要将该区间所有的值都修改 if (left <= tree[pos].left && tree[pos].right <= right) { tree[pos].val += (tree[pos].right - tree[pos].left + 1) * val; // 懒惰标记 tree[pos].add += val; return; } // 该区间没有被包围的话,需要修改节点的信息 pushDown(pos); int mid = tree[pos].left + tree[pos].right >> 1; // 如果下界在 mid 左边,那么左子树需要修改 if (left <= mid) { update(pos << 1, left, right, val); } // 如果上界在 mid 右边,那么右子树也需要修改 if (right > mid) { update(pos << 1 | 1, left, right, val); } // 修改完成后向上回溯修改父节点的值 pushUp(pos); } private void pushDown(int pos) { // 根节点 和 懒惰标记为 0 的情况不需要再向下遍历 if (tree[pos].left != tree[pos].right && tree[pos].add != 0) { int add = tree[pos].add; // 计算累加变化量 tree[pos << 1].val += add * (tree[pos << 1].right - tree[pos << 1].left + 1); tree[pos << 1 | 1].val += add * (tree[pos << 1 | 1].right - tree[pos << 1 | 1].left + 1); // 子节点懒惰标记累加 tree[pos << 1].add += add; tree[pos << 1 | 1].add += add; // 懒惰标记清 0 tree[pos].add = 0; } } private void pushUp(int pos) { tree[pos].val = tree[pos << 1].val + tree[pos << 1 | 1].val; } 区间查询 tree[3] 节点是有懒惰标记 1 的,如果我们此时查询区间 [5, 5] 的值,就需要在递归经过 tree[3] 节点时,进行 pushDown 懒惰标记计算,将 tree[6] 和 tree[7] 的节点值进行修改,结果如下: 最终我们会获取到结果值为 15,区间查询过程的示例代码如下: public int query(int pos, int left, int right) { if (left <= tree[pos].left && tree[pos].right <= right) { // 当前区间被包围 return tree[pos].val; } // 懒惰标记需要下传修改子节点的值 pushDown(pos); int res = 0; int mid = tree[pos].left + tree[pos].right >> 1; if (left <= mid) { res += query(pos << 1, left, right); } if (right > mid) { res += query(pos << 1 | 1, left, right); } return res; } 同样,为了方便大家学习,我把全量代码也列出来,我认为学习线段树的区间修改比较重要的点是理解 add 字段表示的含义和 pushDown 方法的作用时机,而且需要注意只有线段树中的某个区间被我们要修改的区间全部包含时(update 和 query 方法的条件判断),才进行值修改并懒惰标记,否则该区间值只在 pushUp 方法回溯时被修改。 public class SegmentTree2 { static class Node { int left; int right; int val; int add; public Node(int left, int right) { this.left = left; this.right = right; } } Node[] tree; int[] nums; public SegmentTree2(int[] nums) { this.tree = new Node[nums.length * 4]; this.nums = nums; build(1, 1, nums.length); } private void build(int pos, int left, int right) { tree[pos] = new Node(left, right); // 递归结束条件 if (left == right) { tree[pos].val = nums[left - 1]; return; } int mid = left + right >> 1; build(pos << 1, left, mid); build(pos << 1 | 1, mid + 1, right); // 回溯修改父节点的值 pushUp(pos); } /** * 修改区间的值 * * @param pos 当前节点编号 * @param left 要修改区间的下界 * @param right 要修改区间的上界 * @param val 区间内每个值的变化量 */ public void update(int pos, int left, int right, int val) { // 如果该区间被要修改的区间包围的话,那么需要将该区间所有的值都修改 if (left <= tree[pos].left && tree[pos].right <= right) { tree[pos].val += (tree[pos].right - tree[pos].left + 1) * val; // 懒惰标记 tree[pos].add += val; return; } // 该区间没有被包围的话,需要修改节点的信息 pushDown(pos); int mid = tree[pos].left + tree[pos].right >> 1; // 如果下界在 mid 左边,那么左子树需要修改 if (left <= mid) { update(pos << 1, left, right, val); } // 如果上界在 mid 右边,那么右子树也需要修改 if (right > mid) { update(pos << 1 | 1, left, right, val); } // 修改完成后向上回溯修改父节点的值 pushUp(pos); } public int query(int pos, int left, int right) { if (left <= tree[pos].left && tree[pos].right <= right) { // 当前区间被包围 return tree[pos].val; } // 懒惰标记需要下传修改子节点的值 pushDown(pos); int res = 0; int mid = tree[pos].left + tree[pos].right >> 1; if (left <= mid) { res += query(pos << 1, left, right); } if (right > mid) { res += query(pos << 1 | 1, left, right); } return res; } private void pushDown(int pos) { // 根节点 和 懒惰标记为 0 的情况不需要再向下遍历 if (tree[pos].left != tree[pos].right && tree[pos].add != 0) { int add = tree[pos].add; // 计算累加变化量 tree[pos << 1].val += add * (tree[pos << 1].right - tree[pos << 1].left + 1); tree[pos << 1 | 1].val += add * (tree[pos << 1 | 1].right - tree[pos << 1 | 1].left + 1); // 子节点懒惰标记 tree[pos << 1].add += add; tree[pos << 1 | 1].add += add; // 懒惰标记清 0 tree[pos].add = 0; } } private void pushUp(int pos) { tree[pos].val = tree[pos << 1].val + tree[pos << 1 | 1].val; } } 3. 线段树动态开点 线段树的动态开点其实不难理解,它与我们上述直接创建好线段树所有节点不同,动态开点的线段树在最初只创建一个根节点代表整个区间,其他节点只在需要的时候被创建,节省出了空间。当然,我们因此也不能再使用pos << 1和pos << 1 | 1来寻找当前节点的左右子节点,取而代之的是在节点中使用 left 和 right 记录左右子节点在 tree[] 中的位置,这一点需要注意: static class Node { // left 和 right 不再表示区间范围而是表示左右子节点在 tree 中的索引位置 int left, right; int val; int add; } 我们以区间 [1, 5] 为例,创建区间 [5, 5] 为 14 的过程图示如下: 我们可以发现,会先创建默认的根节点 tree[1],之后创建出上图中 tree[2] 和 tree[3] 节点,而此时并没有找到区间 [5, 5],那么需要继续创建上图中的 tree[4] 和 tree[5] 节点(与直接创建出所有节点不同,如果是直接创建好所有节点的话它们的位置应该在 tree[6] 和 tree[7]),现在 tree[5] 节点表示的区间符合我们要找的条件,可以进行赋值和 pushUp 操作了,与直接创建出所有节点相比,动态开点少创建了 4 个节点,也就是图中标红的四个节点我们是没有创建的。 由于每次操作都可能创建并访问全新的一系列节点,因此 m 次单点操作后节点的空间复杂度是 O(mlogn),如果我们采用线段树动态开点解题的话,空间要开的尽可能大,Java 在 128M 可以开到 5e6 个节点以上。 结合图示大家应该能理解动态开点的过程了~~(不明白就自己画一遍)~~,下面我们看下具体的代码: /** * 修改区间的值 * * @param pos 当前节点的索引值 * @param left 当前线段树节点表示的范围下界 * @param right 当前线段树节点表示的范围上界 * @param l 要修改的区间下界 * @param r 要修改的区间上界 * @param val 区间值变化的大小 */ public void update(int pos, int left, int right, int l, int r, int val) { // 当前区间被要修改的区间全部包含 if (l <= left && right <= r) { tree[pos].val += (right - left + 1) * val; tree[pos].add += val; return; } lazyCreate(pos); pushDown(pos, right - left + 1); int mid = left + right >> 1; if (l <= mid) { update(tree[pos].left, left, mid, l, r, val); } if (r > mid) { update(tree[pos].right, mid + 1, right, l, r, val); } pushUp(pos); } // 为该位置创建节点 private void lazyCreate(int pos) { if (tree[pos] == null) { tree[pos] = new Node(); } // 创建左子树节点 if (tree[pos].left == 0) { tree[pos].left = ++count; tree[tree[pos].left] = new Node(); } // 创建右子树节点 if (tree[pos].right == 0) { tree[pos].right = ++count; tree[tree[pos].right] = new Node(); } } private void pushDown(int pos, int len) { if (tree[pos].left != 0 && tree[pos].right != 0 && tree[pos].add != 0) { // 计算左右子树的值 tree[tree[pos].left].val += (len - len / 2) * tree[pos].add; tree[tree[pos].right].val += len / 2 * tree[pos].add; // 子节点懒惰标记 tree[tree[pos].left].add += tree[pos].add; tree[tree[pos].right].add += tree[pos].add; tree[pos].add = 0; } } private void pushUp(int pos) { tree[pos].val = tree[tree[pos].left].val + tree[tree[pos].right].val; } 整体的逻辑并不难,新增的 lazyCreate 方法是动态开点的逻辑,需要注意的是执行区间更新时我们方法的参数中多了 left 和 right 表示当前节点区间范围的参数,因为我们现在的节点中只保存了左右子节点的位置,而没有区间信息,所以我们需要在参数中携带才行,否则我们没有办法判断当前区间和要找的区间是否匹配。 我还是将全量代码放在下面,方便大家学习: public class SegmentTree3 { static class Node { // left 和 right 不再表示区间范围而是表示左右子节点在 tree 中的索引位置 int left, right; int val; int add; } // 记录当前节点数 int count; Node[] tree; public SegmentTree3() { count = 1; tree = new Node[(int) 5e6]; tree[count] = new Node(); } public int query(int pos, int left, int right, int l, int r) { if (l <= left && right <= r) { return tree[pos].val; } lazyCreate(pos); pushDown(pos, right - left + 1); int res = 0; int mid = left + right >> 1; if (l <= mid) { res += query(tree[pos].left, left, mid, l, r); } if (r > mid) { res += query(tree[pos].right, mid + 1, right, l, r); } return res; } /** * 修改区间的值 * * @param pos 当前节点的索引值 * @param left 当前线段树节点表示的范围下界 * @param right 当前线段树节点表示的范围上界 * @param l 要修改的区间下界 * @param r 要修改的区间上界 * @param val 区间值变化的大小 */ public void update(int pos, int left, int right, int l, int r, int val) { // 当前区间被要修改的区间全部包含 if (l <= left && right <= r) { tree[pos].val += (right - left + 1) * val; tree[pos].add += val; return; } lazyCreate(pos); pushDown(pos, right - left + 1); int mid = left + right >> 1; if (l <= mid) { update(tree[pos].left, left, mid, l, r, val); } if (r > mid) { update(tree[pos].right, mid + 1, right, l, r, val); } pushUp(pos); } // 为该位置创建节点 private void lazyCreate(int pos) { if (tree[pos] == null) { tree[pos] = new Node(); } // 创建左子树节点 if (tree[pos].left == 0) { tree[pos].left = ++count; tree[tree[pos].left] = new Node(); } // 创建右子树节点 if (tree[pos].right == 0) { tree[pos].right = ++count; tree[tree[pos].right] = new Node(); } } private void pushDown(int pos, int len) { if (tree[pos].left != 0 && tree[pos].right != 0 && tree[pos].add != 0) { // 计算左右子树的值 tree[tree[pos].left].val += (len - len / 2) * tree[pos].add; tree[tree[pos].right].val += len / 2 * tree[pos].add; // 子节点懒惰标记 tree[tree[pos].left].add += tree[pos].add; tree[tree[pos].right].add += tree[pos].add; tree[pos].add = 0; } } private void pushUp(int pos) { tree[pos].val = tree[tree[pos].left].val + tree[tree[pos].right].val; } } 巨人的肩膀 【宫水三叶】一题三解 :「递归分治」&「线段树」&「单调栈」 线段树浅谈 线段树什么的不是简简单单嘛,我教你!:基础篇 OI-wiki 线段树 维基百科:线段树 【RMQ 专题】关于 RMQ 的若干解法(内含彩蛋) 【宫水三叶】一题双解 :「差分」&「线段树」(附区间求和目录) 【宫水三叶】一题三解 :「模拟」&「线段树(动态开点)」&「分块 + 位运算(分桶)」 作者:京东物流 王奕龙 来源:京东云开发者社区 自猿其说 Tech 转载请注明来源

优秀的个人博客,低调大师

深入理解树状数组 | 京东物流技术团队

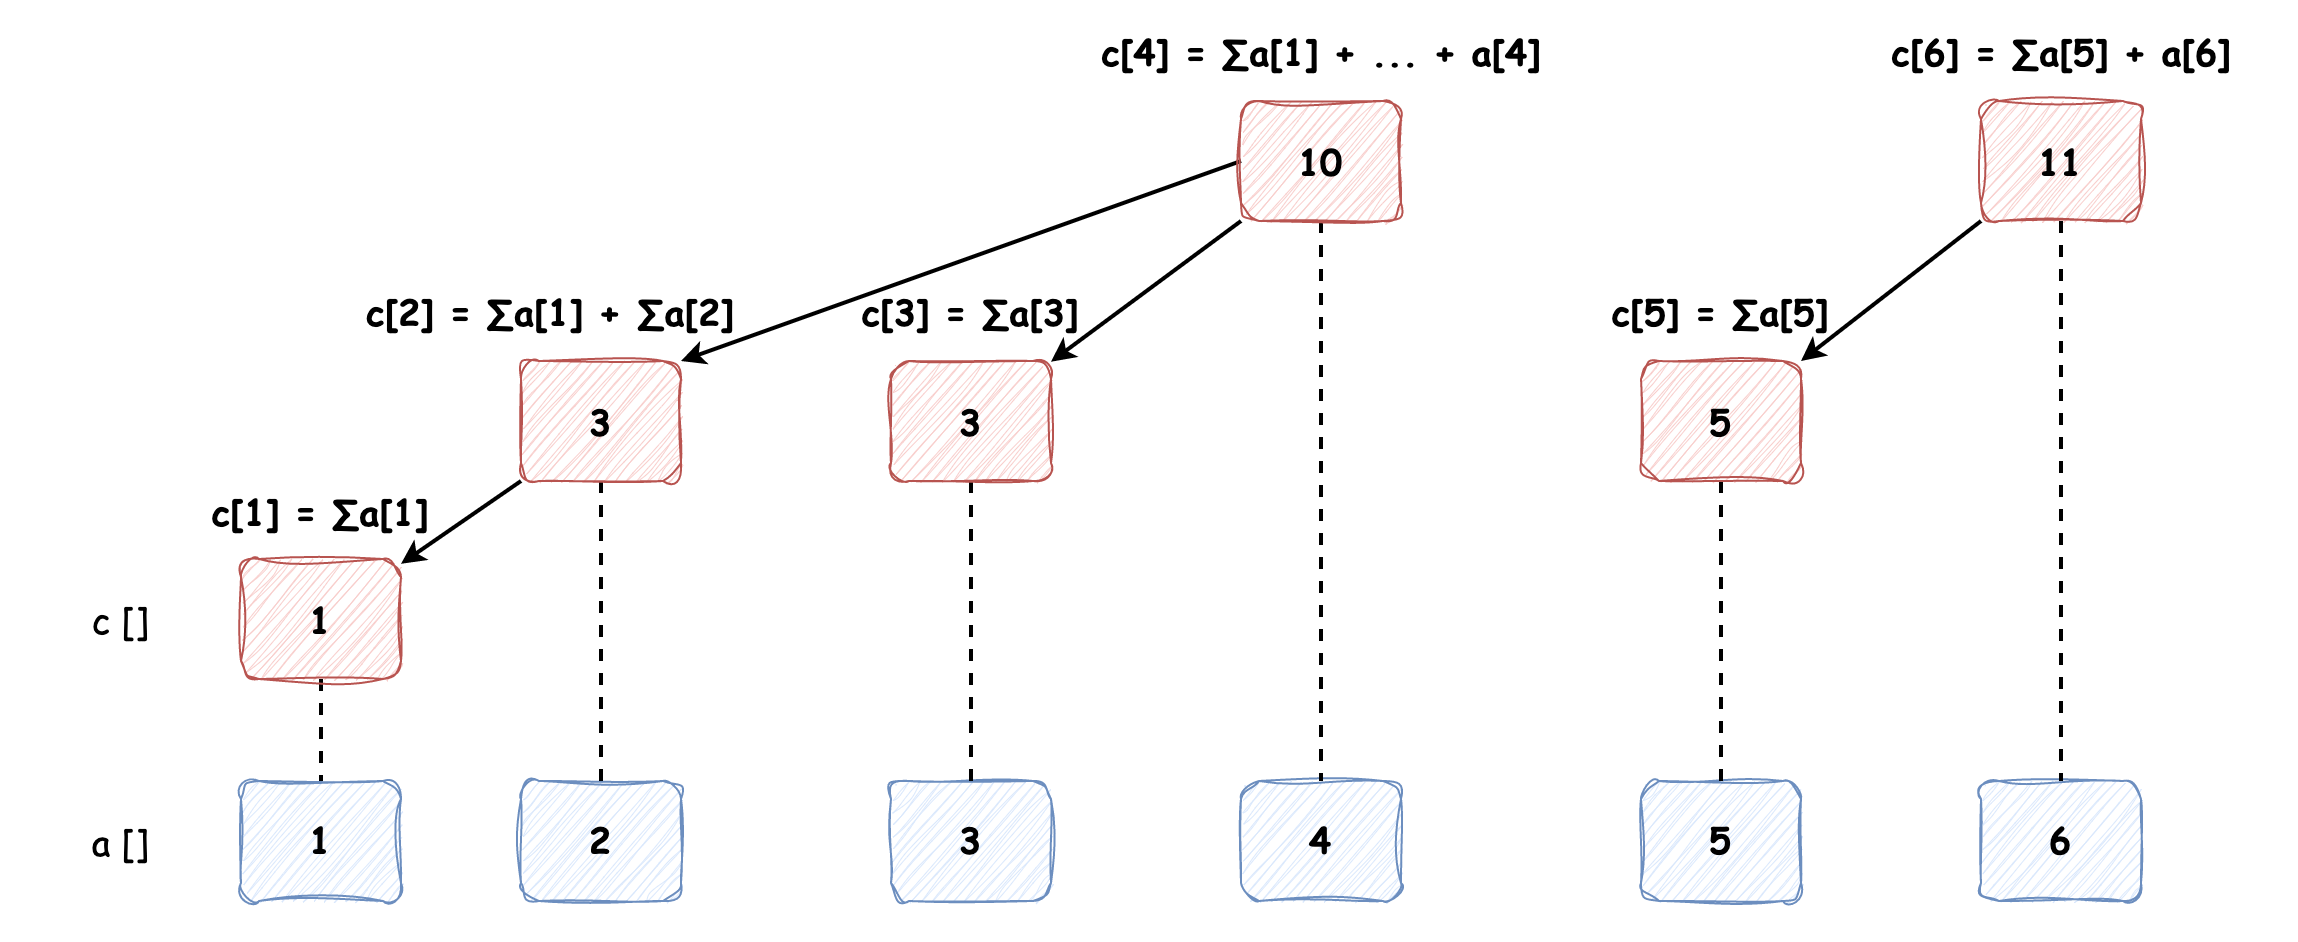
树状数组 树状数组(BIT, Binary Indexed Tree)是简洁优美的数据结构,它能在很少的代码量下支持单点修改和区间查询,我们先以a[] {1, 2, 3, 4, 5, 6}数组为例建立树状数组看一下树状数组的样子: 可以发现:不是所有节点都是连接在一起的,c[1], c[2], c[3], c[4] 和 c[5], c[6] 分别构成了两棵树;奇数索引位置的节点只管辖一个数组元素(我们例子中以 1 为起始索引)。那么这个树状数组是怎么计算和推导出来的呢? 管辖的区间 树状数组的每个元素会管辖多少个数组元素?也就是说每个元素的区间长度是多少?我们从上图中已经知道了奇数的树状数组元素只管辖一个元素,区间为 c[x] = [x, x],那么我们只需再研究下偶数元素管辖的区间长度即可。 c[y] 所管辖的区间长度为 2k,其中 k 为 y 的 2 进制表示中最低位 1 后面所有 0 的数量;c[y] 所管辖的区间为:[y - 2k+ 1, y] 我们以 c[4] 为例,它管辖多少个元素呢?4 的 2 进制表示为 0100,最低位 1 后面 0 的数量为 2,即 k = 2,那么 2k= 22= 4,所以它管辖的区间长度为 4,也就是 4 个数组元素,区间为 [4 - 4 + 1, 4] = [1, 4]。 父节点是谁? 现在我们知道每个元素所管辖的区间范围了,那么我们怎么才能知道它的父节点是谁呢?就比如说我们现在得到了 c[1] 元素,我们想知道它的父节点,要怎么计算呢? c[x] 的父节点为 c[x + lowbit(x)] 怎么回事?其中的**lowbit(x)**是什么东西?其实它的值和 2k一致,其中 k 为 x 的 2 进制表示中最低位 1 后面所有 0 的数量,熟悉不熟悉?这个 lowbit(x) 和我们上文中计算该元素所管辖区间长度的值一致!这不就简单了! lowbit(x) 的计算方法:lowbit(x) = x & -x 我们以计算 c[2] 为例,lowbit(2) = 2 & -2,其中 2 的 2 进制表示为 0010,-2 的 2 进行表示为 1110,它的计算方法为将 2 的所有非符号位二进制全部取反后再加 1,即 1101 + 1 = 1110,执行 & 运算后结果为 0010,十进制表示为 2,与 21值一致。lowbit 的计算用代码表示为: int lowbit(int x) { return x & -x; } 我们以 c[1] 节点为例计算下它的父节点是谁,lowbit(1) = 1 & -1 = 0001 & 1111 = 0001 = 1,那么它的父节点为 c[1 + 1] = c[2],与图上表示的一致。 现在我们已经知道如何通过计算来创建树状数组了, 接下来我们要看下它的应用。 区间查询 区间查询我们先讨论计算前 N 项和的方法,比如我们现在要查询前 6 项和,我们来看下它查询的过程: 从 c[6] 开始找子节点,有 c[6] 管辖的区间为 [5, 6],那么再往下找需要找 c[4],它的区间为 [1, 4],计算这两个节点的和即可。 那么从 c[6] 跳到 c[4] 是如何计算出来的呢?我们可以通过 c[6] 区间的下界减 1 来得到,转换成公式表示即为 x - lowbit(x) = 6 - 2 = 4,当它跳到 c[4] 时发现已经满足求和条件,不再向下跳而结束查找,而且我们可以通过计算 4 - lowbit(4) = 4 - 4 = 0 ,可以发现当 x - lowbit(x) = 0 时为结束查找的条件。我们用代码来表示为: int query(int x) { int res = 0; for (int i = x; i > 0; i -= lowbit(i)) { res += c[i]; } return res; } 那么我们计算区间 [3, 6] 的和该如何计算呢?我们从图中可以发现,先计算出[1, 6] 和 [1, 2] 的和,再使用前者减去后者即为所得,用代码表示为: int query(int left, int right) { return query(right) - query(left - 1); } 单点修改 如果我们要修改 a[x] 的值,我们仅需要修改所有管辖了 a[x] 的 c[y] 即可,而 a[x] 可能会被多个 c[y] 管辖,这些所有的 c[y] 节点该如何确定呢?我们可以回头再去看看前面的树状数组配图,比如我们要修改 a[1] 的值,那么我们需要修改 c[1], c[2] 和 c[4] ,能不能发现它是在不断的跳父节点修改?所以,如果我们要修改数组中某个元素的值,树状数组的更新则是不断地更新父节点值。好,我们直接上代码吧: // 将 index 索引处的值更新为 num void update(int index, int num) { a[index] = num; add(index, num - a[index]); } // 更新 c[index] 的值,变化差值为 val void add(int index, int val) { for (int i = index; i <= c.length; i += lowbit(i)) { c[i] += val; } } 建树 好了,区间查询和单点修改我们都讲完了,但是从头到尾我们还没说过树状数组是怎么建立的呢。我们可以想一下,c 数组初始化时每个索引处的值都为 0,建树仅需要将 a 数组中所有值都在树状数组中执行单点修改即可: public BinaryIndexedTree(int[] a) { this.a = a; this.c = new int[a.length + 1]; for (int i = 0; i < a.length; i++) { add(i + 1, a[i]); } } 到这里我们基本上已经将树状数组讲解完毕了,它的全量代码如下: public class BinaryIndexedTree { int[] a; int[] c; public BinaryIndexedTree(int[] a) { this.a = a; this.c = new int[a.length + 1]; for (int i = 0; i < a.length; i++) { add(i + 1, a[i]); } } // 将 index 索引处的值更新为 num void update(int index, int num) { a[index] = num; add(index, num - a[index]); } // 更新 c[index] 的值,变化差值为 val void add(int index, int val) { for (int i = index; i < c.length; i += lowbit(i)) { c[i] += val; } } int query(int left, int right) { return query(right) - query(left - 1); } // 查询前缀和的方法 int query(int x) { int res = 0; for (int i = x; i > 0; i -= lowbit(i)) { res += c[i]; } return res; } int lowbit(int x) { return x & -x; } } 巨人的肩膀 树状数组(简单介绍) 负数的二进制表示方法(正数:原码、负数:补码) 树状数组 算法学习笔记(2) : 树状数组 维基百科 - 树状数组 关于各类「区间和」问题如何选择解决方案(含模板) 算法学习笔记(19): 离散化 作者:京东物流 王奕龙 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

全场景流量验证系统 | 京东物流技术团队

本文介绍了一种基于线上流量实现对重构系统进行功能和性能验证的实践方案。针对线上流量如何拦截、如何录制、如何存储、如何回放以及如何发压均作了详细说明,为具有类似需求的读者提供了一种可供参考的思路。 1 业务背景 随着百川项目的启动,中台需要对订单流量收口,将ECLP、各BP的接单入口全部切换至百川统一接单系统。且各个接单入口调用方式各异,有JOS请求(外部商家)、JSF请求(如TC),也有MQ异步消息(如POP)。为了确保各系统平稳切量,最大程度降低切量风险,需要在切量前做充分的流量验证(包括功能验证和性能验证)。为此,设计了一套全场景流量验证系统,支持基于线上流量的AB验证(功能验证)、压测(性能验证),为各业务线接单切量工作提供了可靠的基础支撑。 2 名词解释 引流:把各个接单入口所在系统的线上流量引入到流量验证系统。 录制:复制线上流量并做持久化存储。 回放:把录制的流量打到待验证系统。 切量:把接单流量从ECLP等老的接单系统切换到新的百川统一接单系统中。 AB验证:线上流量同时打到正式环境和AB环境,对两个环境的结果做对比分析,验证AB环境的正确性。 3 设计思路 如何引流? 可以在业务系统中引入流量代理的方式实现引流。 如何录制? 考虑需要支持大数据量以及复合查询,选择使用ES作为持久化存储方案。 如何回放? 为避免对各业务系统Jar包依赖,选择使用JSF泛化调用实现流量回放。 是否有类似的系统可用? 月光宝盒(jcase):由京东零售开发的一款流量录制回放系统。其支持流量录制、回放功能,但是并不能满足一些个性化的需求,比如按自定义业务规则录制、切量控制等。 4 系统设计 4.1 总体设计 流量代理:通过拦截、过滤、上报将流量引流到验证系统中。 录制服务:接收流量代理引入的线上流量并做持久化存储。 回放引擎:使用录制的线上流量请求待验证目标接口。 压测引擎:使用录制的线上流量向待验证目标接口实现多线程发压。 4.2 详细设计 4.2.1 流量代理 1)通用流量代理 在业务系统中引入流量代理,通过流量代理拦截(JSF Filter或AOP)线上流量,并将流量通过异步MQ方式上报给录制服务做持久化存储。 2)JOS流量代理 外部商家通过HTTP方式调用JOS平台,JOS平台内部转JSF调用接单服务。为使外部商家无感,发布一个和业务系统接口完全相同的JSF服务(虚服务),不同的是提供一个新的别名,通过JOS平台配置切换到新的别名,这样就把JOS流量引入到了录制代理,然后再由录制代理通过异步MQ方式将流量上报给录制服务做持久化存储。 4.2.2 流量存储 录制的流量持久化存储到ES,按照[接口:方法]维度创建录制任务,同一个录制任务下的记录主键均以录制任务编号为前缀,后缀为数字递增,最大后缀(缓存到Redis中)即该录制任务下录制的记录总数。 属性名 示例值 示例值 id RT7625109167934456_1 主键标识 recordData {"args":[{"fakeNo":"fakeNo001"}],"argsType":["cn.jdl.baichuan.router.replay.contract.domain.fake.FlowFakeRequest"],"attachments":{"traceId":"8112206384546625","type":"1"},"clazzName":"cn.jdl.baichuan.router.replay.contract.service.RouterFlowFakeService","methodName":"match","resultObj":true} 录制的body体 recordTaskNo RT7625109167934456 所属录制任务编号 timestamp 1636719778929 时间戳 4.2.3 流量回放 支持单条、批量、按录制任务维度批量回放。回放调用采用JSF泛化调用方式,避免了对业务系统Jar包的依赖。 流量回放的同时,支持配置对比服务,对比服务接收入参以及新老接口的出参结果,可以对新老接口处理结果进行对比分析,以验证新接口功能的正确性。 4.2.4 流量压测 为了实现发压的效果,需要采用多机、多线程并发的方式请求目标接口。但是多机、多线程共用了同一份录制数据作为压力数据源。因此,在真正发压之前,需要为每个执行线程分配好数据,各个线程只取自己的数据,互不干扰。 发压策略(主从架构,Master分配,Slave执行) 压测引擎采用主从架构,压力机分主从节点,主节点负责接收压测请求并分配压测任务;从节点负责执行压测任务。 数据分配策略(按量平均,余数轮询,滑动窗口) 1)计算窗口 按录制任务中录制总量,平均分配到各个线程,余数再按轮询方式分配给每个线程,分完为止,这样可以确定出每个线程分配的记录条数(窗口大小); 2)按窗口滑动 将所有录制任务从左到右水平平铺,每个线程按照自己窗口大小从左到右依次占用录制记录。 5 业务实践 5.1 切量验证 以仓配POP接单接口切换为例,我们需要用新的订单中心替换原来的ECLP-SO系统。在正式切换之前,仍然由ECLP-SO系统提供线上接单服务,但同时会通过流量验证系统录制线上流量并回放到新的订单中心。通过对比新老系统对相同接单请求的处理结果,验证新的订单中心的接单功能。经过充分功能验证后才会将接单流量切换到新的订单中心,从而极大降低了切量的风险。 5.2 需求迭代 产品校验服务是产品中心对外提供的一个核心接口,接口逻辑复杂,每一次需求迭代上线都面临极大挑战。即便是经过了测试环境、预发环境验证,依然不能百分百保证上线后对线上业务没有影响。毕竟测试环境、预发环境的验证请求参数单一且有限,无法反映线上请求的多样性和复杂性。因此,产品中心接入了流量验证系统,每次有新的需求迭代上线前,首先录制线上流量,使用线上真实流量在预发环境进行充分验证后再做上线操作。这样极大降低了由于验证不充分,导致线上业务受损的几率,为线上业务提供了一层安全保障,提高了线上系统稳定性。 作者:京东物流 朱永昌 来源:京东云开发者社区自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

MySQL事务死锁问题排查 | 京东云技术团队

一、背景 在预发环境中,由消息驱动最终触发执行事务来写库存,但是导致MySQL发生死锁,写库存失败。 com.mysql.jdbc.exceptions.jdbc4.MySQLTransactionRollbackException: rpc error: code = Aborted desc = Deadlock found when trying to get lock; try restarting transaction (errno 1213) (sqlstate 40001) (CallerID: ): Sql: "/* uag::omni_stock_rw;xx.xx.xx.xx:xxxxx;xx.xx.xx.xx:xxxxx;xx.xx.xx.xx:xxxxx;enable */ insert into stock_info(tenant_id, sku_id, store_id, available_num, actual_good_num, order_num, created, modified, SAVE_VERSION, stock_id) values (:vtg1, :vtg2, :_store_id0, :vtg4, :vtg5, :vtg6, now(), now(), :vtg7, :__seq0) /* vtgate:: keyspace_id:e267ed155be60efe */", BindVars: {__seq0: "type:INT64 value:\"29332459\" "_store_id0: "type:INT64 value:\"50650235\" "vtg1: "type:INT64 value:\"71\" "vtg2: "type:INT64 value:\"113817631\" "vtg3: "type:INT64 value:\"50650235\" "vtg4: "type:FLOAT64 value:\"1000.000\" "vtg5: "type:FLOAT64 value:\"1000.000\" "vtg6: "type:INT64 value:\"0\" "vtg7: "type:INT64 value:\"20937611645\" "} 初步排查,在同一时刻有两条请求进行写库存的操作。 时间前后相差1s,但最终执行结果是,这两个事务相互死锁,均失败。 事务定义非常简单,伪代码描述如下: start transaction // 1、查询数据 data = select for update(tenantId, storeId, skuId); if (data == null) { // 插入数据 insert(tenantId, storeId, skuId); } else { // 更新数据 update(tenantId, storeId, skuId); } end transaction 该数据库表的索引结构如下: 索引类型 索引组成列 PRIMARY KEY (`stock_id`) UNIQUE KEY (`sku_id`,`store_id`) 所使用的数据库引擎为Innodb,隔离级别为RR[Repeatable Read]可重复读。 二、分析思路 首先了解下Innodb引擎中有关于锁的内容 2.1 Innodb中的锁 2.1.1 行级锁 在Innodb引擎中,行级锁的实现方式有以下三种: 名称 描述 Record Lock 锁定单行记录,在隔离级别RC和RR下均支持。 Gap Lock 间隙锁,锁定索引记录间隙(不包含查询的记录),锁定区间为左开右开,仅在RR隔离级别下支持。 Next-Key Lock 临键锁,锁定查询记录所在行,同时锁定前面的区间,故区间为左开右闭,仅在RR隔离级别下支持。 同时,在Innodb中实现了标准的行锁,按照锁定类型又可分为两类: 名称 符号 描述 共享锁 S 允许事务读一行数据,阻止其他事务获得相同的数据集的排他锁。 排他锁 X 允许事务删除或更新一行数据,阻止其他事务获得相同数据集的共享锁和排他锁。 简言之,当某个事物获取了共享锁后,其他事物只能获取共享锁,若想获取排他锁,必须要等待共享锁释放;若某个事物获取了排他锁,则其余事物无论获取共享锁还是排他锁,都需要等待排他锁释放。如下表所示: 将获取的锁(下)\已获取的锁(右) 共享锁S 排他锁X 共享锁S 兼容 不兼容 排他锁X 不兼容 不兼容  2.1.2 RR隔离级别下加锁示例 假如现在有这样一张表user,下面将针对不同的查询请求逐一分析加锁情况。user表定义如下: CREATE TABLE `user` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '主键ID', `user_id` bigint(20) DEFAULT NULL COMMENT '用户id', `mobile_num` bigint(20) NOT NULL COMMENT '手机号', PRIMARY KEY (`id`), UNIQUE KEY `IDX_USER_ID` (`user_id`), KEY `IDX_MOBILE_NUM` (`mobile_num`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 COMMENT='用户信息表' 其中主键id与user_id为唯一索引,user_name为普通索引。 假设该表中现有数据如下所示: id user_id mobile_num 1 1 3 5 5 6 8 8 7 9 9 9  下面将使用select ... for update 语句进行查询,分别针对唯一索引、普通索引来进行举例。 1、唯一索引等值查询 select * from user where id = 5 for update select * from user where user_id = 5 for update 在这两条SQL中,Innodb执行查询过程时,会如何加锁呢? 我们都知道Innodb默认的索引数据结构为B+树,B+树的叶子结点包含指向下一个叶子结点的指针。在查询过程中,会按照B+树的搜索方式来进行查找,其底层原理类似二分查找。故在加锁过程中会按照以下两条原则进行加锁: 1. 只会对满足查询目标附近的区间加锁,并不是对搜索路径中的所有区间都加锁。本例中对搜索id=5或者user_id=5时,最终可以定位到满足该搜索条件的区域(1,5]。 2. 加锁时,会以Next key Lock为加锁单位。那按照1满足的区域进行加Next key Lock锁(左开右闭),同时因为id=5或者user_id=5存在,所以该Next key Lock会退化为Record Lock,故只对id=5或user_id=5这个索引行加锁。  如果查询的id不存在,例如: select * from user where id = 6 for update 按照上面两条原则,首先按照满足查询目标条件附近区域加锁,所以最终会找到的区间为(5,8]。因为id=6这条记录并不存在,所以Next key Lock(5, 8]最终会退化为Gap Lock,即对索引(5,8)加间隙锁。 2、唯一索引范围查询 select * from user where id >= 4 and id <8 for update 同理,在范围查询中,会首先匹配左值id=4,此时会对区间(1,5]加Next key Lock,因为id=4不存在,所以锁退化为 Gap Lock(1,5);接着会往后继续查找id=8的记录,直到找到第一个不满足的区间,即Next key Lock(8, 9],因为8不在范围内,所以锁退化为Gap Lock(8, 9)。故该范围查询最终会锁的区域为(1, 9) 3、非唯一索引等值查询 对非唯一索引查询时,与上述的加锁方式稍有区别。除了要对包含查询值区间内加Next key Lock之外,还要对不满足查询条件的下一个区间加Gap Lock,也就是需要加两把锁。 select * from user where mobile_num = 6 for update 需要对索引(3, 6]加Next key Lock,因为此时是非唯一索引,那么也就有可能有多个6存在,所以此时不会退化为Record Lock;此外还要对不满足该查询条件的下一个区间加Gap Lock,也就是对索引(6,7)加锁。故总体来看,对索引加了(3,6]Next key Lock和(6, 7) Gap Lock。 若非唯一索引不命中时,如下: select * from user where mobile_num = 8 for update 那么需要对索引(7, 9]加Next key Lock,又因为8不存在,所以锁退化为Gap Lock (7, 9) 4、非唯一索引范围查询 select * from user where mobile_num >= 6 and mobile_num < 8 for update 首先先匹配mobile_num=6,此时会对索引(3, 6]加Next Key Lock,虽然此时非唯一索引存在,但是不会退化为Record Lock;其次再看后半部分的查询mobile_num=8,需要对索引(7, 9]加Next key Lock,又因为8不存在,所以退化为Gap Lock (7, 9)。最终,需要对索引行加Next key Lock(3, 6] 和 Gap Lock(7, 9)。 2.1.3 意向锁(Intention Locks) Innodb为了支持多粒度锁定,引入了意向锁。意向锁是一种表级锁,用于表明事务将要对某张表某行数据操作而进行的锁定。同样,意向锁也分为类:共享意向锁(IS)和排他意向锁(IX)。 名称 符号 描述 共享意向锁 IS 表明事务将要对表的个别行设置共享锁 排他意向锁 IX 表明事务将要对表的个别行设置排他锁 例如select ... lock in shared mode会设置共享意向锁IS;select ... for update会设置排他意向锁IX 设置意向锁时需要按照以下两条原则进行设置: 1. 当事务需要申请行的共享锁S时,必须先对表申请共享意向IS锁或更强的锁 2. 当事务需要申请行的排他锁X时,必须先对表申请排他意向IX锁 表级锁兼容性矩阵如下表: 将获取的锁(下)/已获取的锁(右) X IX S IS X 冲突 冲突 冲突 冲突 IX 冲突 兼容 冲突 兼容 S 冲突 冲突 兼容 兼容 IS 冲突 兼容 兼容 兼容 如果请求锁的事务与现有锁兼容,则会将锁授予该事务,但如果与现有锁冲突,则不会授予该事务。事务等待,直到冲突的现有锁被释放。 意向锁的目的就是为了说明事务正在对表的一行进行锁定,或将要对表的一行进行锁定。在意向锁概念中,除了对全表加锁会导致意向锁阻塞外,其余情况意向锁均不会阻塞任何请求! 2.1.4 插入意向锁 插入意向锁是一种特殊的意向锁,同时也是一种特殊的“Gap Lock”,是在Insert操作之前设置的Gap Lock。 如果此时有多个事务执行insert操作,恰好需要插入的位置都在同一个Gap Lock中,但是并不是在Gap Lock的同一个位置时,此时的插入意向锁彼此之间不会阻塞。 2.2 过程分析 回到本文的问题上来,本文中有两个事务执行同样的动作,分别为先执行select ... for update获取排他锁,其次判断若为空,则执行insert动作,否则执行update动作。伪代码描述如下: start transaction // 1、查询数据 data = select for update(tenantId, storeId, skuId); if (data == null) { // 插入数据 insert(tenantId, storeId, skuId); } else { // 更新数据 update(tenantId, storeId, skuId); } end transaction 现在对这两个事务所执行的动作进行逐一分析,如下表所示: 时间点 事务A 事务B 潜在动作 1 开始事务 开始事务  2 执行select ... for update操作  事务A申请到IX 事务A申请到X,Gap Lock 3  执行select ... for update操作 事务B申请到IX,与事务A的IX不冲突。 事务B申请到Gap Lock,Gap Lock可共存。 4 执行insert操作  事务A先申请插入意向锁IX,与事务B的Gap Lock冲突,等待事务B的Gap Lock释放。 5  执行insert操作 事务B先申请插入意向锁IX,与事务A的Gap Lock冲突,等待事务A的Gap Lock释放。 6   死锁检测器检测到死锁 详细分析: 时间点1,事务A与事务B开始执行事务 时间点2,事务A执行select ... for update操作,执行该操作时首先需要申请意向排他锁IX作用于表上,接着申请到了排他锁X作用于区间,因为查询的值不存在,故Next key Lock退化为Gap Lock。 时间点3,事务B执行select ... for update操作,首先申请意向排他锁IX,根据2.1.3节表级锁兼容矩阵可以看到,意向锁之间是相互兼容的,故申请IX成功。由于查询值不存在,故可以申请X的Gap Lock,而Gap Lock之间是可以共存的,不论是共享还是排他。这一点可以参考Innodb关于Gap Lock的描述,关键描述本文粘贴至此: Gap locks can co-exist. A gap lock taken by one transaction does not prevent another transaction from taking a gap lock on the same gap. There is no difference between shared and exclusive gap locks. They do not conflict with each other, and they perform the same function. 时间点4,事务A执行insert操作前,首先会申请插入意向锁,但此时事务B已经拥有了插入区间的排他锁,根据2.1.3节表级锁兼容矩阵可知,在已有X锁情况下,再次申请IX锁是冲突的,需要等待事务B对X Gap Lock释放。 时间点5,事务B执行insert操作前,也会首先申请插入意向锁,此时事务A也对插入区间拥有X Gap Lock,因此需要等待事务A对X锁进行释放。 时间点6,事务A与事务B均在等待对方释放X锁,后被MySQL的死锁检测器检测到后,报Dead Lock错误。 思考:假如select ... for update 查询的数据存在时,会是什么样的过程呢?过程如下表: 时间点 事务A 事务B 潜在动作 1 开始事务 开始事务  2 执行select ... for update操作  事务A申请到IX 事务A申请到X行锁,因数据存在故锁退化为Record Lock。 3  执行select ... for update操作 事务B申请到IX,与事务A的IX不冲突。 事务B想申请目标行的Record Lock,此时需要等待事务A释放该锁资源。 4 执行update操作  事务A先申请插入意向锁IX,此时事务B仅仅拥有IX锁资源,兼容,不冲突。然后事务A拥有X的Record Lock,故执行更新。 5 commit  事务A提交,释放IX与X锁资源。 6  执行select ... for update操作 事务B事务B此时获取到X Record Lock。 7  执行update操作 事务B拥有X Record Lock执行更新 8  commit 事务B释放IX与X锁资源 也就是当查询数据存在时,不会出现死锁问题。 三、解决方法 1、在事务开始之前,采用CAS+分布式锁来控制并发写请求。分布式锁key可以设置为store_skuId_version 2、事务过程可以改写为: start transaction // RR级别下,读视图 data = select from table(tenantId, storeId, skuId) if (data == null) { // 可能出现写并发 insert } else { data = select for update(tenantId, storeId, skuId) update } end transaction 虽然解决了插入数据不存在时会出现的死锁问题,但是可能存在并发写的问题,第一个事务获得锁会首先插入成功,第二个事务等待第一个事务提交后,插入数据,因为数据存在了所以报错回滚。 3、调整事务隔离级别为RC,在RC下没有next key lock(注意,此处并不准确,RC会有少部分情况加Next key lock),故此时仅仅会有record lock,所以事务2进行select for update时需要等待事务1提交。 参考文献 [1] Innodb锁官方文档:https://dev.mysql.com/doc/refman/5.7/en/innodb-locking.html [2] https://blog.csdn.net/qq_43684538/article/details/131450395 [3] https://www.jianshu.com/p/027afd6345d5 [4] https://www.cnblogs.com/micrari/p/8029710.html 若有错误,还望批评指正 作者:京东零售 刘哲 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

代码层面探索前端性能 | 京东云技术团队

前言 最近在做性能优化,具体优化手段,网上铺天盖地,这里就不重复了。 性能优化可分为以下几个维度:代码层面、构建层面、网络层面。 本文主要是从代码层面探索前端性能,主要分为以下 4 个小节。 使用 CSS 替代 JS 深度剖析 JS 前端算法 计算机底层 使用 CSS 替代 JS 这里主要从动画和 CSS 组件两个方面介绍。 CSS 动画 CSS2 出来之前,哪怕要实现一个很简单的动画,都要通过 JS 实现。比如下面红色方块的水平移动: 对应 JS 代码: let redBox = document.getElementById('redBox') let l = 10 setInterval(() => { l+=3 redBox.style.left = `${l}px` }, 50) 1998 年的 CSS2 规范,定义了一些动画属性,但由于受当时浏览器技术限制,这些特性并没有得到广泛的支持和应用。 直到 CSS3 的推出,CSS 动画得到了更全面地支持。同时,CSS3 还引入了更多的动画效果,使得 CSS 动画在今天的 Web 开发中得到了广泛的应用。 那么 CSS3 都能实现什么动画,举几个例子: 过渡(Transition)- 过渡是 CSS3 中常用的动画效果之一,通过对一个元素的某些属性进行变换,使元素在一段时间内从一个状态平滑地过渡到另一个状态。 动画(Animation)- 动画是 CSS3 中另一个常用的动画效果,其用于为一个元素添加一些复杂的动画效果,可以通过关键帧(@keyframes)来定义一串动画序列。 变换(Transform)- 变换是 CSS3 中用于实现 2D/3D 图形变换效果的一种技术,包括旋转、缩放、移动、斜切等效果。 把上面的例子改写成 CSS 代码如下: #redBox { animation: mymove 5s infinite; } @keyframes mymove { from {left: 0;} to {left: 200px;} } 同样的效果,用样式就能实现,何乐而不为呢。 需要指出的是,CSS 的动画仍在不断发展和改进,随着新的浏览器特性和 CSS 版本的出现,CSS 动画的特性也在不断地增加和优化,以满足日益复杂的动画需求和更好的用户体验。 CSS 组件 在一些知名的组件库中,有些组件的大部分 props 是通过修改 CSS 样式实现的,比如 Vant 的Space组件。 Props 功能 CSS 样式 direction 间距方向 flex-direction: column; align 对齐方式 align-items: xxx; fill 是否让 Space 变为一个块级元素,填充整个父元素 display: flex; wrap 是否自动换行 flex-wrap: wrap; 再比如 Ant Design 的Space组件。 Props 功能 CSS 样式 align 对齐方式 align-items: xxx; direction 间距方向 flex-direction: column; size 间距大小 gap: xxx; wrap 是否自动换行 flex-wrap: wrap; 这类组件完全可以封装成 SCSS 的 mixin 实现(LESS 也一样),既能减少项目的构建体积(两个库的 Space 组件 gzip 后的大小分别为 5.4k 和 22.9k),又能提高性能。 查看组件库某个组件的体积,可访问连接。 比如下面的 space mixin: /* * 间距 * size: 间距大小,默认是 8px * align: 对齐方式,默认是 center,可选 start、end、baseline、center * direction: 间距方向,默认是 horizontal,可选 horizontal、vertical * wrap: 是否自动换行,仅在 horizontal 时有效,默认是 false */ @mixin space($size: 8px, $direction: horizontal, $align: center, $wrap: false) { display: inline-flex; gap: $size; @if ($direction == 'vertical') { flex-direction: column; } @if ($align == 'center') { align-items: center; } @if ($align == 'start') { align-items: flex-start; } @if ($align == 'end') { align-items: flex-end; } @if ($align == 'baseline') { align-items: baseline; } @if ($wrap == true) { @if $direction == 'horizontal' { flex-wrap: wrap; } } } 类似的组件还有 Grid、Layout 等。 再说下图标,下面是 Ant Design 图标组件的第一屏截图,有很多仅用 HTML + CSS 就可以轻松实现。 实现思路: 优先考虑只使用样式实现 仅靠样式满足不了,就先增加一个标签,通过这个标签和它的两个伪元素 ::before 和 ::after 实现 一个标签实在不够,再考虑增加额外的标签 比如实现一个支持四个方向的实心三角形,仅用几行样式就可以实现(上面截图是 4 个图标): /* 三角形 */ @mixin triangle($borderWidth: 10, $shapeColor: #666, $direction: up) { width: 0; height: 0; border: if(type-of($borderWidth) == 'number', #{$borderWidth} + 'px', #{$borderWidth}) solid transparent; $doubleBorderWidth: 2 * $borderWidth; $borderStyle: if(type-of($doubleBorderWidth) == 'number', #{$doubleBorderWidth} + 'px', #{$doubleBorderWidth}) solid #{$shapeColor}; @if($direction == 'up') { border-bottom: $borderStyle; } @if($direction == 'down') { border-top: $borderStyle; } @if($direction == 'left') { border-right: $borderStyle; } @if($direction == 'right') { border-left: $borderStyle; } } 总之,能用 CSS 实现的就不用 JS,不仅性能好,而且还跨技术栈,甚至跨端。 深度剖析 JS 介绍完了 CSS,再来看 JS,主要从基本语句和框架源码两个方面深入。 if-else 语句的优化 先了解下 CPU 是如何执行条件语句的。参考如下代码: const a = 2 const b = 10 let c if (a > 3) { c = a + b } else { c = 2 * a } CPU 执行流程如下: 我们看到,在执行到指令 0102 时候,由于不满足 a > 3 这个条件,就直接跳转到 0104 这个指令去执行了;而且,计算机很聪明,如果它在编译期间发现 a 永远不可能大于 3,它就会直接删除 0103 这条指令,然后,0104 这条指令就变成了下一条指令,直接顺序执行,也就是编译器的优化。 那么回到正题,假如有以下代码: function check(age, sex) { let msg = '' if (age > 18) { if (sex === 1) { msg = '符合条件' } else { msg = ' 不符合条件' } } else { msg = '不符合条件' } } 逻辑很简单,就是筛选出 age > 18 并且 sex == 1 的人,代码一点儿问题都没有,但是太啰嗦,站在 CPU 的角度来看,需要执行两次跳转操作,当 age > 18 时,就进入内层的 if-else 继续判断,也就意味着再次跳转。 其实我们可以直接优化下这个逻辑(通常我们也是这样做的,但是可能知其然而不知其所以然): function check(age, sex){ if (age > 18 && sex ==1) return '符合条件' return '不符合条件' } 所以,逻辑能提前结束就提前结束,减少 CPU 的跳转。 Switch 语句的优化 其实 switch 语句和 if-else 语句的区别不大,只不过写法不同而已,但是,switch 语句有个特殊的优化,那就是数组。 参考以下代码: function getPrice(level) { if (level > 10) return 100 if (level > 9) return 80 if (level > 6) return 50 if (level > 1) return 20 return 10 } 我们改成 switch 语句: function getPrice(level) { switch(level) case 10: return 100 case 9: return 80 case 8: case 7: case 6: return 50 case 5: case 4: case 3: case 2: case 1: return 20 default: return 10 } 看着没啥区别,其实编译器会把它优化成一个数组,其中数组的下标为 0 到 10,不同下标对应的价格就是 return 的数值,也就是: 而我们又知道,数组是支持随机访问的,速度极快,所以,编译器对 switch 的这个优化就会大大提升程序的运行效率,这可比一条一条执行命令快多了。 那么,我还写个毛的 if-else 语句啊,我直接全部写 switch 不就行了? 不行!因为编译器对 switch 的优化是有条件的,它要求你的 code 必须是紧凑的,也就是连续的。 这是为什么呢?因为我要用数组来优化你啊,你如果不是紧凑的,比如你的 code 是 1、50、51、101、110,我就要创建一个长度 110 的数组来存放你,只有这几个位置有用,岂不是浪费空间! 所以,我们在使用 switch 的时候,尽量保证_code 是紧凑的数字类型_的。 循环语句的优化 其实循环语句跟条件语句类似,只不过写法不同而已,循环语句的优化点是以减少指令为主。 我们先来看一个中二的写法: function findUserByName(users) { let user = null for (let i = 0; i < users.length; i++) { if (users[i].name === '张三') { user = users[i] } } return user } 如果数组长度是 10086,第一个人就叫张三,那后面 10085 次遍历不就白做了,真拿 CPU 不当人啊。 你直接这样写不就行了: function findUserByName(users) { for (let i = 0; i < users.length; i++) { if (users[i].name === '章三') return users[i] } } 这样写效率高,可读性强,也符合我们上述的_逻辑能提前结束就提前结束_这个观点。CPU 直接感谢你全家。 其实,这里还有一点可以优化的地方,就是我们的数组长度可以提取出来,不必每次都访问,也就是这样: function findUserByName(users) { let length = users.length for (let i = 0; i < length; i++) { if (users[i].name === '章三') return users[i] } } 这看起来好像有点吹毛求疵了,确实是,但是如果考虑到性能的话,还是有点用的。比如有的集合的 size() 函数,不是简单的属性访问,而是每次都需要计算一次,这种场景就是一次很大的优化了,因为省了很多次函数调用的过程,也就是省了很多个 call 和 return 指令,这无异是提高了代码的效率的。尤其是在循环语句这种容易量变引起质变的情况下,差距就是从这个细节拉开的。 函数调用过程参考: 对应代码如下: let a = 10 let b = 11 function sum (a, b) { return a + b } 说完了几个基础语句,再来看下我们经常使用的框架内部,很多地方的性能都值得探索。 diff 算法 Vue 和 React 中都使用了虚拟 DOM,当执行更新时,要对比新旧虚拟 DOM。如果没有任何优化,直接严格 diff 两颗树,时间复杂度是 O(n^3),根本不可用。所以 Vue 和 React 必须使用 diff 算法优化虚拟 DOM: Vue2 - 双端比较: 类似上面的图: 定义 4 个变量,分别为:oldStartIdx、oldEndIdx、newStartIdx 和 newEndIdx 判断 oldStartIdx 和 newStartIdx 是否相等 判断 oldEndIdx 和 newEndIdx 是否相等 判断 oldStartIdx 和 newEndIdx 是否相等 判断 oldEndIdx 和 newStartIdx 是否相等 同时 oldStartIdx 和 newStartIdx 向右移动;oldEndIdx 和 newEndIdx 向左移动 Vue3 - 最长递增子序列: 整个过程是基于 Vue2 的双端比较再次进行优化。比如上面这个截图: 先进行双端比较,发现前面两个节点(A 和 B)和最后一个节点(G)是一样的,不需要移动 找到最长递增子序列 C、D、E(新旧 children 都包含的,最长的顺序没有发生变化的一组节点) 把子序列当成一个整体,内部不用进行任何操作,只需要把 F 移动到它的前面,H 插入到它的后面即可 React - 仅右移: 上面截图的比较过程如下: 遍历 Old 存下对应下标 Map 遍历 New,b 的下标从 1 变成了 0,不动(是左移不是右移) c 的下标从 2 变成了 1,不动(也是左移不是右移) a 的下标从 0 变成了 2,向右移动,b、c 下标都减 1 d 和 e 位置没变,不需要移动 总之,不管用什么算法,它们的原则都是: 只比较同一层级,不跨级比较 Tag 不同则删掉重建(不再去比较内部的细节) 子节点通过 key 区分(key 的重要性) 最后也都成功把时间复杂度降低到了 O(n),才可以被我们实际项目使用。 setState 真的是异步吗 很多人都认为 setState 是异步的,但是请看下面的例子: clickHandler = () => { console.log('--- start ---') Promise.resolve().then(() => console.log('promise then')) this.setState({val: 1}, () => {console.log('state...', this.state.val)}) console.log('--- end ---') } render() { return <div onClick={this.clickHandler}>setState</div> } 实际打印结果: 如果是异步的话,state 的打印应该在微任务 Promise 后执行。 为了解释清这个原因,必须先了解 JSX 里的事件机制。 JSX 里的事件,比如 onClick={() => {}},其实叫合成事件,区别于我们常说的自定义事件: // 自定义事件 document.getElementById('app').addEventListener('click', () => {}) 合成事件都是绑定在 root 根节点上,有前置和后置操作,拿上面的例子举例: function fn() { // fn 是合成事件函数,内部事件同步执行 // 前置 clickHandler() // 后置,执行 setState 的 callback } 可以想象有函数 fn,里面的事件都是同步执行的,包括 setState。fn 执行完,才开始执行异步事件,即 Promise.then,符合打印的结果。 那么 React 为什么要这么做呢? 因为要考虑性能,如果要多次修改 state,React 会先合并这些修改,合并完只进行一次 DOM 渲染,避免每次修改完都渲染 DOM。 所以 setState_本质是同步_,日常说的“异步”是不严谨的。 前端算法 讲完了我们的日常开发,再来说说算法在前端中的应用。 友情提示:算法一般都是针对大数据量而言,区别于日常开发。 能用值类型就不用引用类型 先来看一道题。 求 1-10000 之间的所有对称数,例如:0, 1, 2, 11, 22, 101, 232, 1221... 思路 1 - 使用数组反转、比较:数字转换为字符串,再转换为数组;数组 reverse,再 join 为字符串;前后字符串进行对比。 function findPalindromeNumbers1(max) { const res = [] if (max <= 0) return res for (let i = 1; i <= max; i++) { // 转换为字符串,转换为数组,再反转,比较 const s = i.toString() if (s === s.split('').reverse().join('')) { res.push(i) } } return res } 思路 2 - 字符串头尾比较:数字转换为字符串;字符串头尾字符比较。 function findPalindromeNumbers2(max) { const res = [] if (max <= 0) return res for (let i = 1; i <= max; i++) { const s = i.toString() const length = s.length // 字符串头尾比较 let flag = true let startIndex = 0 // 字符串开始 let endIndex = length - 1 // 字符串结束 while (startIndex < endIndex) { if (s[startIndex] !== s[endIndex]) { flag = false break } else { // 继续比较 startIndex++ endIndex-- } } if (flag) res.push(res) } return res } 思路 3 - 生成翻转数:使用 % 和 Math.floor 生成翻转数;前后数字进行对比(全程操作数字,没有字符串类型)。 function findPalindromeNumbers3(max) { const res = [] if (max <= 0) return res for (let i = 1; i <= max; i++) { let n = i let rev = 0 // 存储翻转数 // 生成翻转数 while (n > 0) { rev = rev * 10 + n % 10 n = Math.floor(n / 10) } if (i === rev) res.push(i) } return res } 性能分析:越来越快 思路 1- 看似是 O(n),但数组转换、操作都需要时间,所以慢 思路 2 VS 思路3 - 操作数字更快(电脑原型就是计算器) 总之,尽量不要转换数据结构,尤其数组这种有序结构,尽量不要用内置 API,如 reverse,不好识别复杂度,数字操作最快,其次是字符串。 尽量用“低级”代码 还是直接上一道题。 输入一个字符串,切换其中字母的大小写 如,输入字符串 12aBc34,输出字符串 12AbC34 思路 1 - 使用正则表达式。 function switchLetterCase(s) { let res = '' const length = s.length if (length === 0) return res const reg1 = /[a-z] const reg2 = /[A-Z] for (let i = 0; i < length; i++) { const c = s[i] if (reg1.test(c)) { res += c.toUpperCase() } else if (reg2.test(c)) { res += c.toLowerCase() } else { res += c } } return res } 思路 2 - 通过 ASCII 码判断。 function switchLetterCase2(s) { let res = '' const length = s.length if (length === 0) return res for (let i = 0; i < length; i++) { const c = s[i] const code = c.charCodeAt(0) if (code >= 65 && code <= 90) { res += c.toLowerCase() } else if (code >= 97 && code <= 122) { res += c.toUpperCase() } else { res += c } } return res } 性能分析:前者使用了正则,慢于后者 所以,尽量用“低级”代码,慎用语法糖、高级 API 或者正则表达式。 计算机底层 最后说一些前端需要了解的计算机底层。 从“内存”读数据 我们通常说的:从内存中读数据,就是把数据读入寄存器中,但是我们的数据不是直接从内存读入寄存器的,而是先读入一个高速缓存中,然后才读入寄存器的。 寄存器是在 CPU 内的,也是 CPU 的一部分,所以 CPU 从寄存器读写数据非常快。 这是为啥呢?因为从内存中读数据太慢了。 你可以这么理解:CPU 先把数据读入高速缓存中,以备使用,真正使用的时候,就从高速缓存中读入寄存器;当寄存器使用完毕后,就把数据写回到高速缓存中,然后高速缓存再在合适的时机将数据写入到存储器。 CPU 运算速度非常快,而从内存读数据非常慢,如果每次都从内存中读写数据,那么势必会拖累 CPU 的运算速度,可能执行 100s,有 99s 都在读取数据。为了解决这个问题,我们就在 CPU 和存储器之间放了个高速缓存,而 CPU 和高速缓存之间的读写速度是很快的,CPU 只管和高速缓存互相读写数据,而不管高速缓存和存储器之间是怎么同步数据的。这样就解决了内存读写慢的问题。 二进制的位运算 灵活运用二进制的位运算不仅能提高速度,熟练使用二进制还能节省内存。 假如给定一个数 n,怎么判断 n 是不是 2 的 n 次方呢? 很简单啊,直接求余就行了。 function isPowerOfTwo(n) { if (n <= 0) return false let temp = n while (temp > 1) { if (temp % 2 != 0) return false temp /= 2 } return true } 嗯,代码没毛病,不过不够好,看下面代码: function isPowerOfTwo(n) { return (n > 0) && ((n & (n - 1)) == 0) } 大家可以用 console.time 和 console.timeEnd 对比下运行速度便知。 我们可能还会看到一些源码里面有很多 flag 变量,对这些 flag 进行按位与或按位或运算来检测标记,从而判断是否开启了某个功能。他为什么不直接用布尔值呢?很简单,这样效率高还节省内存。 比如 Vue3 源码中的这段代码,不仅用到了按位与和按位或,还用到了左移: export const enum ShapeFlags { ELEMENT = 1, FUNCTIONAL_COMPONENT = 1 << 1, STATEFUL_COMPONENT = 1 << 2, TEXT_CHILDREN = 1 << 3, ARRAY_CHILDREN = 1 << 4, SLOTS_CHILDREN = 1 << 5, TELEPORT = 1 << 6, SUSPENSE = 1 << 7, COMPONENT_SHOULD_KEEP_ALIVE = 1 << 8, COMPONENT_KEPT_ALIVE = 1 << 9, COMPONENT = ShapeFlags.STATEFUL_COMPONENT | ShapeFlags.FUNCTIONAL_COMPONENT } if (shapeFlag & ShapeFlags.ELEMENT || shapeFlag & ShapeFlags.TELEPORT) { ... } if (hasDynamicKeys) { patchFlag |= PatchFlags.FULL_PROPS } else { if (hasClassBinding) { patchFlag |= PatchFlags.CLASS } if (hasStyleBinding) { patchFlag |= PatchFlags.STYLE } if (dynamicPropNames.length) { patchFlag |= PatchFlags.PROPS } if (hasHydrationEventBinding) { patchFlag |= PatchFlags.HYDRATE_EVENTS } } 结语 文章从代码层面讲解了前端的性能,有深度维度的: JS 基础知识深度剖析 框架源码 也有广度维度的: CSS 动画、组件 算法 计算机底层 希望能让大家拓宽前端性能的视野,如果对文章感兴趣,欢迎留言讨论~~~ 作者:京东零售杨进军 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

后端服务之应用预热 | 京东云技术团队

一 背景 C端服务应用升级和重启,导致耗时瞬时抖动,业务超时,应用监控报警,上游感知明显,导致用户体验变差。 二 应用升级重启导致抖动的原因 1 C端服务应用升级和重启的冷启动阶段,它需要重新加载和初始化各种资源,例如数据库连接、缓存数据等,导致耗时瞬时飙升。 2 应用重启后,本地缓存失效,应用需要重新加载数据,导致耗时变长。 3 应用重启后,有大量请求堆积,导致系统负载增加,线程处理不及时,导致系统响应变慢。 三 解决方案 1 停服时,先下线JSF接口,再升级应用,待应用启动成功后,JSF服务接口延迟注册到注册中心。 2 JSF开启预热功能,是服务提供者重启后,JSF上线后,消费者与服务者建立链接后,调用方客户端先放设置比例的小部分流量过来到升级重启的实例,在预热周期内,逐步到100% 3 在应用升级流程编排中,结合流量回放,编排流程,在流量回放后再操作JSF上线,实现略复杂,依赖基础运维 方案1,方案2实现简单,预热效果也比较好,使用的是JSF的预热功能,以下效果对比的实现来自方案2的JSF预热功能。 四 采用JSF开启预热功能效果对比 1 服务提供者配置预热周期 预热初始权重:consumer连接到provider后,provider的初始权重(provider端权重会在预热周期内会逐渐恢复到正常权重,一般是100)  2 未开启预热容器实例整体升级重启监控: 应用部署在3个机房,所以看到3次抖动,可以看到TP999最高的机房达到了近25s。  开启预热后整体实例升级重启效果: 应用部署在3个机房,所以看到3次抖动,可以看到TP999最高的机房降到了2.5s,降幅达10倍。  3 未开启预热,单实例应用重启监控 max达到了20s,TP999到达了18s  开启预热后,单实例应用重启监控 max降到了2s,TP999将到了1.5s左右,降幅达10倍,TPS在配置的预热周期内(60s)呈现线性增长  五 注意事项 依赖服务调用方升级JSF到1.7.6版本及以上,推动所有调用方升级JSF 可根据应用的启动时间和特性,调整应用匹配的预热周期,达到相对预热效果最好的状态。至于是否有必要结合流量回放和流程编排实现预热,需结合自己的业务情况和实现成本考虑。 作者:京东科技 张石磊 来源:京东云开发者社区 转载请注明来源

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册