首页 文章 精选 留言 我的

精选列表

搜索[团队协作工具],共10000篇文章
优秀的个人博客,低调大师

现代 CPU 技术发展 | 京东云技术团队

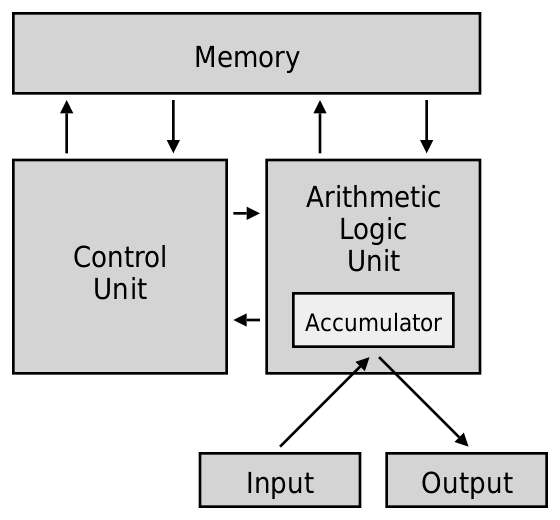
介绍 这篇文章主要是介绍CPU技术的发展,包括最近几十年CPU性能提升和半导体工艺发展,当前技术发展方向。希望可以帮助软件开发者理解CPU指令集和组成运行原理、CPU性能提升的现状和瓶颈、CPU技术发展方向会如何影响软件开发/设计的框架和编程思想。 提示:因为是面向软件开发者,所以会忽略掉一些电路设计、制造工艺等底层的硬件知识。同时也不会特别深入的介绍每个知识点,只是提供一个概览。 CPU 指令集和运行原理 当前使用最广泛的指令集是x86、ARM、RISC-V,指令集对于CPU性能和软件开发有多大的影响,指令集的发展方向是什么。现代CPU内部微架构、流水线是如何设计的,为什么CPU的控制单元和缓存相比GPU复杂很多。 CPU 性能提升和未来方向 近些年CPU性能提升遇到了功耗墙的问题导致提升速度放缓,为什么以前的优化技术都遇到了瓶颈,同时当前有哪些新的技术方向用于提高CPU的性能。 CPU 技术方向对软件开发技术的影响 软件最终会在CPU上运行,更好的利用CPU提供的能力进行编程才能带来更好的性能。一部分CPU优化技术是内部微架构调整对软件开发者是透明的,例如时钟频率和IPC的提升。但是另一些优化技术需要软件开发者进行优化,例如多核心、SIMD、DSA等。这些需要软件开发者改造的技术会如何影响编程语言和系统框架的设计,从而影响软件开发者的编程方式。 CPU 结构和原理 计算机结构 1945 年冯诺依曼提出了一种计算机实现的结构设计,现代的计算机和CPU基本上依然是基于冯诺依曼结构的思想进行实现。冯诺依曼结构定义了计算机的5个组成部分,分别是内存、控制单元、运算单元、输入、输出: 模块 功能 内存 内存是一个存储器。操作指令和数据以二进制的形式存储在内存中。 控制单元 控制单元是一个协调者。控制单元按照程序指令顺序从内存中读取指令进行执行,将指令发送到运算单元进行计算。同时控制单元也会协调内存和输入/输出设备之间的数据传输。 运算单元 计算单元包含加减乘除等计算器。运算单元根据控制单元发送的指令,从内存中读取数据进行计算,计算完成后重新写回到内存中。 输入/输出 输入/输出设备主要是外部的一些设备进行数据交换。输入设备将数据和指令输入到计算机中,常见的输入设备有键盘、鼠标。计算机处理后将数据输出到外部设备中,常见的输出设备有显示器。 提示:还有一种不同的架构是哈佛架构,它是一种程序指令和数据分开的计算机结构。现在L1缓存中就是使用哈佛架构的思想将指令和数据缓存分开存储。 CPU 结构 现代CPU虽然使用冯诺依曼架构思想进行设计,但是经过几十年技术的发展非常复杂。因为内存不属于CPU内部结构,现代CPU主要分为4个组成部分,分别是高速缓存、控制单元、运算单元、寄存器。这里先简单介绍一下各个组成部分的功能,后面流水线实现的部分会更详细的介绍。 高速缓存 高速缓存将内存中更频繁使用的程序指令和数据保存在高速缓存中,避免每次都从内存读取降低数据读写延迟。 多级缓存- 现代CPU通常有2-3级缓存,离CPU更近的缓存速度更快但是容量更低。 控制单元 控制单元是CPU中最复杂的部分,负责调度和协调其他部分进行运行。调度流水线执行、异常处理等。 流水线调度- 分支预测、高速缓存读写、指令读取、指令解码、指令调度执行、乱序执行、指令发射、更新寄存器 异常处理- 处理 CPU 运行时的各种异常 运算单元 运算单元包含大量的运算器执行计算任务,包括逻辑运算、分支、内存读写单元。 ALU- 算数逻辑单元负责整数加减乘除和位运算 FPU- 浮点单元负责浮点数运算 Branch- 分支单元用于分支判断,当 CPU 支持分支预测时还需要更新分支预测缓存和分支预测错误回滚执行 SIMD- 向量单元负责向量运算 内存读写- 内存单元负责内存读写,从缓存中读取数据或将数据写回缓存 寄存器 寄存器用于保持运行时的临时数据和CPU自身的一些状态值。 通用寄存器- 用于存储临时数据,局部变量/函数参数/返回值等数据 PC- 程序计数器存储下一条指令的地址 IP- 指令指针用于存储当前执行的指令地址 SP- 堆栈指针用于存储栈的地址 指令集架构 ISA(指令集架构)是一种处理器基本功能和指令集架构规范。它定义了CPU硬件可以执行的所有操作指令,指令的编解码格式、指令类型、寄存器、内存寻址、异常处理、权限级别等内容。编译器和CPU选择一种指令集规范作为标准进行实现,这样可以保证任意符合指令集规范编译的代码都可以相同指令集规范的CPU上正常运行。ISA主要有指令集、寄存器、内存模型、异常中断处理等规范定义。 指令集架构规范组成 指令集- 支持的操作指令、指令的编解码格式、指令长度 寄存器- 支持的寄存器类型、寄存器数量 内存模型- 支持的内存访问方式、内存寻址方式、内存一致性规则 异常/中断处理- 定义了处理器如何处理异常和终端事件 指令集 指令集定义了处理器可以执行的所有操作指令和指令的编解码格式。目前常见的指令集主要分为两种类型,复杂指令集和精简指令集。复杂指令集CISC主要是以x86为代表,精简指令集RISC主要是以ARM/RISC-V为代表。 x86 x86指令集架构最早使用在Intel在1978年推出8086处理器,指令集专利由Intel和AMD拥有。目前主要是在PC/笔记本和服务器市场使用,x86的优势在于软件生态/兼容性和高性能,劣势在高能耗和开放性: 特点 说明 软件生态 发展时间最久技术最成熟,积累了大量的技术和软件。一直很注重兼容性帮助它占有了更多的市场份额,但是兼容性也限制了技术升级和大量的历史包袱需要兼容增加了复杂性 性能高 高性能场景占有大部分的份额 能耗高 同样性能下x86相比RISC指令集需要更多的能耗,限制了在低功耗设备上使用 开放性低 专利主要由Intel所有,其它厂商授权使用 芯片厂商 Intel、AMD 主要领域 80%+ PC/笔记本、90%服务器市场 x86 指令集发展 x86包含多个扩展指令集,指令长度至少8位可变长度。以下是x86指令集的一些重要版本更新: 特性 年份 说明 16 位 1978 Intel 在 1978 年推出16位指令集使用在8086处理器 32 位 1985 Intel 公司推出了 x86 指令集的32位扩展,可支持 32 位软件运行 64 位 2003 AMD 公司推出了 x86 指令集的64位扩展,可支持 64 位软件运行 SSE 1999 Intel 推出了 第一代 SIMD 指令集扩展SSE,可支持固定 128 位数据的向量计算 AVX 2011 Intel 推出了 第二代 SIMD 指令集扩展AVX,可以支持 256-512 位数据的向量计算 x86s 2023 Intel 推出的纯 64 位架构的白皮书,希望可以减少对于 16、32 位的支持降低兼容性包袱 ARM ARM指令集架构是英国 ARM 公司开发的一种RISC指令集架构,指令集专利由ARM公司拥有。ARM诞生于1980年代,当时的处理器都是基于CISC设计复杂度高、功耗大,ARM公司希望使用精简的指令集实现低功耗和高性能,可以应用在嵌入式设备和移动设备中。 因为ARM有非常好的能效优势,目前主要是使用在追求功耗比的嵌入式和移动设备。ARM设备几乎占据所有的手机和Pad市场。在笔记本市场因为苹果切换到ARM,同时高通和INVIDIA开始布局ARM桌面端芯片未来也会推动ARM份额的提升,目前已经占据了15%+的笔记本市场份额。近年ARM性能和芯片设计水平逐渐提高,ARM在服务器市场的份额逐渐提升。 不过ARM也有和x86同样的问题就是开放性,导致ARM受到了RISC-V的挑战。ARM指令集专利属于ARM公司,同时ARM公司对使用指令集会有一些限制。 特点 说明 软件生态 手机/Pad移动设备和 Mac 系统比较完善,但是Windows平台还是会有兼容性问题使用率很低 性能高 峰值性能相比x86竞品性能略低,不过近年也在高速发展 能耗低 因为ARM追求低功耗比的设计,同时大量低功耗设备厂商的硬/软件优化,能耗比一直领先 开放性中 专利由ARM所有。虽然比x86开放性会好一些,但也导致部分厂商开始尝试完全开源的RISC-V。同时由于RISC-V的竞争,ARM也适当放宽了对于自定义指令集的限制 芯片厂商 Apple、高通、华为、联发科 主要领域 几乎所有移动设备、14%笔记本市场、7%服务器市场、嵌入式 ARM 指令集发展 ARM包含多个扩展指令集,指令长度为固定32位。以下是ARM的一些重要版本更新: 指令集 版本 说明 32 位 Armv1 1985 年 ARM 推出了32位架构的指令集 NEON Armv7 2004 年 ARM 推出了第一代 SIMD 指令集扩展NEON,可支持固定 128 位数据的向量计算 硬件虚拟化 Armv7 可支持在同一台物理机上运行多个虚拟机的硬件虚拟化扩展 64 位 Armv8 2011 年推出了64位扩展,可支持 64 位软件运行,有31个 64 位通用寄存器 SSE Armv8.2 2014 年 ARM 推出了第二代 SIMD 指令集扩展SSE,可支持可变长度 128-2048 位数据的向量计算 RISC-V RISC-V架构是2010年由加州大学伯克利分校发起的开源RISC指令集架构标准。RISC-V有以下几个优势: 精简设计- 设计非常简单,相比x86和ARM指令集设计更加精简,降低了复杂度和指令数量。 模块化设计- 采用模块化设计思想。提供精简的基础指令集实现基础能力,其它包括浮点、SIMD、原子操作、位运算等指令都是通过扩展指令集提供。芯片设计厂商可以基于自身需求将各种指令集扩展模块进行组合应用到不同的场景。 开源-x86/ARM都需要授权才能使用,RISC-V完全开源可以免费使用不用担心版权和专利费的问题。 RISC-V的优势在于更先进的设计和开源,劣势在软件生态和芯片厂商的设计能力还需要进步: 特点 说明 软件生态 比较弱。目前更多是用在一些嵌入式设备或协处理器中,操作系统、软件开发、用户级软件还在起步阶段 性能中 峰值性能相比x86/ARM性能差一些,更多是因为x86/ARM芯片厂商的技术更成熟 能耗中 和ARM差不多,更多是因为ARM芯片厂商的技术更成熟 开放性高 由于开源吸引了大量芯片设计厂商的加入,支持添加自定义指令集,不过也导致了一些生态兼容性问题 芯片厂商 主要是新型芯片设计商,所以设计能力上相比差一些 主要领域 1%处理器市场、嵌入式、协处理器(手机上目前已经有不少使用RISC-V指令集设计的协处理器) RISC-V 指令集 RISC-V有3个基础指令集和多个扩展指令集,指令长度为固定32位。以下是RISI-V常见的指令集: 指令集 类型 说明 RV32I 基础指令集 32位整数指令集,包含 32 个 32 位的通用寄存器 RV32E 基础指令集 低功耗嵌入式32位整数指令集,包含 16 个 32 位的通用寄存器 RV64I 基础指令集 64位整数指令集,包含 32 个 64 位的通用寄存器 F/D/Q 浮点扩展指令集 单精度 32 位、双精度 64 位、四倍精度 128 位 M 整数扩展指令集 整数乘法除法指令集 A 原子操作扩展指令集 原子操作指令集 B 位操作扩展指令集 位操作指令集 P SIMD 扩展指令集 固定长度的SIMD 运算 V 向量运算扩展指令集 可变长度的向量运算 C 压缩指令扩展指令集 可将指令长度压缩位 16 位用于低功耗场景 RISC-V 寄存器 RISC-V 汇编语言 指令编码格式 指令集规范定义了指令的二进制格式。以ARM指令集为例,编译器在编译时按照指令集规范将每一个汇编指令编码成32位的二进制指令,CPU在运行时通过解码器按照指令集规范将二进制指令解码成特定的指令进行执行。 x86指令集更复杂,ARM和RISC-V更精简。x86使用可变长度指令,至少8位+,同时x86支持更多的内存寻址模式。ARM使用固定32位指令,至少少数几种内存寻址模式。 ARM指令编码格式 指令集对比 复杂指令集和精简指令集 x86是复杂指令集,主要是因为x86指令数量多、复杂指令、内存寻址方式多、指令长度不同等原因,导致硬件设计实现更复杂。使用复杂指令集主要是行业早期技术限制和兼容性原因导致的: 原因 说明 编译器技术落后 程序大多数都是以汇编语言或二进制码进行编写。提供一条复杂高级指令执行多个指令操作,可以使程序开发更加便利。 内存紧张 程序需要加载到内存中执行,内存不足导致需要尽可能降低程序的二进制大小减少内存占用。复杂指令是可变长度,大部分指令的二进制位数更短,只有复杂指令会使用更长的二进制位数,这样可以增加指令的存储密度降低大小。 通用寄存器少 由于晶体管的成本导致通用寄存器数量很少,指令会更多的直接访问内存。导致更多的指令支持内存寻址,内存寻址方式更复杂。 兼容性 不断增加新的指令,同时还需要完全兼容老的指令,导致指令数量越来越多。 以上这些原因导致早期使用CSIC将更多的复杂性转移到CPU处理,导致CPU设计复杂成本高。之后随着半导体技术的发展可以集成更多晶体管和内存以及编译器技术的发展可以更好的生成机器代码,1979年开始行业逐渐发现CISC有以下这些缺点: 原因 说明 通用寄存器数量少 更多的使用寄存器可以减少对内存的访问同时指令执行平均周期差异小也有利于流水线执行。 实现复杂度高 指令数量多/复杂指令,导致处理器实现复杂成本更高。同时也会增加编译器的复杂度 不利于流水线的设计 处理器流水线技术可以使处理器同一个周期内并行执行多个指令和操作流程,例如指令解码/内存读写/计算。指令长度不同和复杂指令会使解码器更复杂,指令执行周期差异大也不利于流水线并行执行 指令使用率低 程序的常用指令只占整个指令集的20%,造成了很多浪费 能效高 由于复杂度高需要使用更多的晶体管和复杂度,导致产生更多的功耗无法应付低功耗场景 以上这些缺点推动了新的指令集都使用RISC设计更有利于提高处理器的性能和能效。但是Intel因为兼容性和软件生态的考虑选择继续使用x86。经过这些年处理器技术的发展,x86也做了非常多的技术改进提高性能,不过由于兼容性约束指令集很难缓慢的进行改进。 x86的一些技术改进: 降低指令复杂度- 持续减少对一些老旧指令的兼容减少指令数量 内部使用精简指令集的设计- 由于半导体工艺的发展芯片可以集成更多晶体管提高性能。增加了通用寄存器的数量、内部将复杂指令解码为多条简单指令用于流水线执行。 更多技术支持- 提供了很多基于Intel平台的指令集扩展和开发框架,操作系统和软件开发者可以利用这些技术提高性能。 指令差异 以下面的汇编为例。RISC指令集必须将内存数据加载到寄存器以后才能计算,CISC指令集可以支持指令内存寻址。所以RISC会生成更多的指令数量。 CISC mov eax, [num1] ; 将num1的值加载到寄存器EAX中 add eax, [num2] ; 在寄存器EAX中执行加法操作 mov [result], eax ; 将结果存储到内存地址result处 RISC lw num1, [num1] ; 将num1的值加载到寄存器R0中 lw num2, [num2] ; 将num2的值加载到寄存器R1中 add r0, r1 ; 在寄存器R0中执行加法操作 sw r0, [result] ; 将结果存储到内存地址result处 指令集架构实现对比 因为ARM和RISC-V都是精简指令集设计上很接近,所以使用x86-64和ARM64来对比实现上的一些细节。 特性 x86-64 ARM64 影响 指令位数 长度不同,至少8位 固定32位 可变长度导致解码器和指令读取复杂度更高 指令数量 几千个 几百个 ARM 主要是使用频率高的基础指令和少量指令扩展。x86除了基础指令还包含大量的复杂指令,同时为了兼容性需要支持很多老旧不再使用的指令 指令执行时间 简单指令大部分相同 基本相同 ARM大部分基础指令执行时间都在一个时钟周期。x86因为包含复杂指令执行时间不太一样,复杂指令可能会解码成多条微指令执行 通用寄存器数量 16 31 通用寄存器数量越多,可以将更多的临时数据存放在寄存器中减少对内存的读取提高性能 内存读写方式 寄存器、内存模式 寄存器操作 x86 很多指令都可以直接操作内存。ARM 必须使用LOAD/STORE将内存读取到寄存器或寄存器写入到内存中。不过现代流水线设计x86也会解码为多条微指令类似ARM的处理器方式 编译器复杂度 中 高 x86复杂度高导致编译器实现更复杂 CPU复杂度 高 中 x86指令数量更多/长度不同/复杂指令会导致CPU复杂度更高 程序二进制大小 中 高 对于x86的一条复杂指令,ARM可能会生成多条简单指令。所以 ARM 密度更低,指令二进制会更大导致程序更大一些 其他 CPU 遇到不支持的指令如何处理 指令集通常包含基础指令集和扩展指令集,基础指令集是使用最频繁的指令,扩展指令集是用于一些特定场景的指令集,例如64位和SIMD支持。通常CPU核心只会支持一部分扩展指令集,因为支持更多指令可能会增加额外的计算单元和寄存器,这会导致耗费更多的晶体管增加成本和功耗。同时一些使用频率低/成本高的扩展指令只用在部分追求高性能的场景。以下是两种情况: 不支持部分扩展指令集:Intel酷睿12系列开始不再支持AVX-512向量扩展,只有在更高级的至强处理器才支持。AVX-512需要多个512位寄存器,多个支持512位向量运算的计算单元。移除AVX-512指令扩展可以节省晶体管数量降低功耗或者将这些晶体管用于其他能力。 大小核差异化处理:高通骁龙8gen2处理器,大核只支持64位,小核支持32/64位。CPU继续支持32位应用运行,32位应用可以继续在小核上运行。但是同时支持32/64位也会增加CPU的复杂度增加成本和功耗,所以在8gen3处理器中已经完全移除了对32位的支持。 当CPU遇到不支持的指令如何处理,通常CPU会采用几种处理方式: 抛出异常- 直接抛出异常停止执行。 模拟执行- 解码成更简单的指令进行模拟执行,但是可能会导致性能降低。 x86 和 ARM 的性能 当前总体来看能耗比ARM更优秀,高性能场景x86使用率更高。但是指令集对于CPU性能和功耗的影响会越来越小,制造工艺、使用场景、兼容性等因素也会导致x86和ARM平台的性能差异。 特性 x86-64 ARM64 影响 制造工艺 最新 7nm 最新 3nm Intel半导体工艺制程一直落后于台积电,ARM 芯片大多使用台积电最新工艺制造 使用场景 PC、服务器 移动设备、笔记本、嵌入式 x86面向高性能设计有更强大的散热能力,追求更高的峰值性能对于能耗的关注不够。ARM设备更多是面向低功耗的移动设备,续航和散热能力都有限,包括CPU、操作系统、设备都会使用面向高能效的设计。例如ARM会使用SOC、大小核、统一内存等有利于高能效的设计,操作系统基于高能效对CPU进行调度。 兼容性 兼容性负担重 兼容性负担轻 ARM平台最新的处理器已经不再32位,x86依然需要支持32位、部分16位模式、大量陈旧指令和模式 随着ARM逐渐开始在高性能电脑和处理器市场占据更多的份额,也在不断的提升CPU性能。x86逐渐减少兼容性包袱同时也更加关注能效比。可能未来我们可以更清晰的理解指令集架构导致的性能和能耗差异。 小结 现代指令集架构也在互相借鉴,指令集之间的差异越来越小。x86CPU 内部会将复杂指令解码成多个简单指令执行有利于超标量 CPU 指令级并行,ARM也添加更多的指令以支持更多场景,RISC-V的设计者认为ARMv8借鉴了很多RISC-V的设计。 二进制翻译技术的使用也越来越多。MacOS提供Rosetta 2软件支持x86程序在ARM芯片上运行,虽然将x86指令转换成ARM指令会导致一定的性能损耗和兼容性问题(部分指令不支持),但是可以帮助大部分x86程序在ARM平台上正常运行。同时Windows On ARM也支持x86程序在ARM芯片上仿真执行。 同时从指令集版本升级特性也能看出,近些年指令集的变更主要是在提高向量运算指令应对越来越多的AI和多媒体场景,其他指令改进很少。 处理器技术发展 处理器技术的发展主要是提高处理器的运行性能。对于如何提高处理器的性能,我们先用一个简单的公式来度量处理器的性能: 程序执行耗时 = 指令数 / CPI / 时钟频率 指令数- 程序执行需要的指令总数 CPI- 处理器平均每个时钟周期可以执行的指令数量(多核心也会增加CPI) 时钟频率- 处理器一秒钟可以执行的周期次数 因为指令数量无法控制,所以只能通过提高CPI和时钟频率来提升处理器的性能。接下来我们来了解处理器通过哪些技术来提高CPI和时钟频率。 半导体工艺、时钟频率、能耗、晶体管数量 功耗、时钟频率、性能 当前提升处理器性能遇到的最大的挑战就是功耗墙。电流通过晶体管会带来热量,太高的功耗导致处理器温度过高无法运行,同时移动设备电池技术发展也非常缓慢。我们先来看看处理器动态功耗计算公式,即处理器晶体管开关切换过程中产生的能耗: 功耗 = 晶体管数量 * 电容 * 电压^2 * 时钟频率 提示:这里只是一种简单的功耗工时,还需要考虑半导体制造工艺和漏电造成的影响。 从功耗公式可以看出功耗和晶体管数量、电容、电压、时钟频率成正比,增加晶体管数量和提高频率都会增加处理器的功耗。 早期半导体工艺发展通过不断降低晶体管的尺寸可以减少电容的大小、以及降低晶体管开关切换时间,芯片可以使用更低的电压运行,通常每次工艺提升可以使电压降低15%。处理器制造商可以不断在芯片上增加晶体管数量以及提高时钟频率,同时控制功耗的增长速度。 半导体工艺发展带来的提升 增加晶体管数量- 在同样尺寸的芯片中集成更多数量的晶体管,这些增加的晶体管可以用于增加缓存大小、控制单元等模块提高处理器的性能。同时也推动了 SOC 芯片的发展,在芯片内集成多核心、GPU 等单元。 提高时钟频率- 提高时钟频率可以使处理器执行的更快 降低电压- 使用更低的电压进行运行,在同样的性能下可以降低能耗。同时更好的晶体管设计可以降低漏电。 技术定律 登纳德缩放定律:1974年罗伯特·登纳德发现,由于晶体管尺寸变小,在固定的芯片面积上增加晶体管的数量不会增加功耗。 摩尔定律:1965年戈登·摩尔预测,由于晶体管尺寸逐渐变小,同样面积的芯片上晶体管数量每隔一年翻一番,1975 年改为每隔两年翻一番。 功耗墙 从2004年开始登纳德缩放定律失效。缩短晶体管栅长本来能降低电压、提高晶体管开关频率,但在栅长缩短到65nm左右时,晶体管开关频率增加导致芯片功耗和温度急剧上升。同时,栅长缩短导致漏电流急剧增加,这些电能也会转化为热量。目前大概40%的功耗是由于漏电导致的,即使晶体管处于关闭状态也会增加漏电能耗。早期每一代新工艺至少可以让晶体管栅长缩小30%,虽然现在半导体制造商继续使用现有工艺节点乘以0.7作为下一代的节点名称,例如 10nm、7nm、5nm、3nm,然而栅长缩小尺寸已远远达不到这个要求,需要二十年左右才能使晶体管数量翻一番。同时每一代新技术节点的制造成本越来越高,每代制造成本相比前一代高几倍。 小结 由于功耗墙的限制,相同电压和电容条件下增加晶体管数量提高核心数量相比增加时钟频率带来的功耗影响更小。同时晶体管尺寸减少速度变缓,增加晶体管数量可能需要增加芯片的面积,但是增加芯片的面积会导致生产良率更低成本更高。处理器设计不再追求单核时钟周期快速提升,朝着多核心方向发展通过增加核心数提高指令吞吐量并行执行提高性能。 提示:以功耗公式来计算,1GHz=10亿。Intel 2006 年推出的Core 2 E6700处理器时钟频率2.66 GHz、2个核心、2.9亿个晶体管。所以增加1个核心带来的功耗提高比增加时钟频率1GHz低。 CPU能效曲线 更高的性能需要更高的时钟频率和电压运行,导致能效急剧提升 时钟频率发展 处理器时钟频率提升幅度逐渐放缓 半导体工艺发展 半导体工艺发展主要是依赖光刻技术进步以及更优秀的晶体管设计,下面简单列一下最近10年半导体工艺发展的重要节点: 32nm-2010年Intel量产了首批32nm处理器第二代酷睿处理器,使用了林本坚发明的沉浸式光刻技术。 22nm-2011年Intel首先在 22 纳米工艺节点上使用了胡正明发明的FinFET(鳍式场效晶体管)晶体管。FinFET减少50%+漏电并提高了性能。目前使用在22nm节点以下的半导体芯片中。 5nm-2020年台积电使用ASML的新一代EUV光刻机,为苹果生产了第一个5nm处理器A14。相比7nm工艺密度提高80%、速度提高15、能耗降低30%。 3nm-2022年台积电开始量产3nm芯片。 2nm-2025年台积电计划开始量产2nm芯片,使用GAAFET(围栅场效晶体管)代替FinFET晶体管。GAAFET可以降低漏电、降低尺寸和提高性能。 FinFET、GAAFET 晶体管栅长发展 虽然晶体管制造技术节点在不断降低,但是栅长缩小速度越来越慢 指令级并行:微架构和 IPC 提升 IPC提升主要是提高指令的吞吐量,通过优化处理器流水线的微架构,提高一个周期可以执行的指令数量。 流水线介绍 在理解流水线之前我们先看简单了解一下程序执行的步骤。通常一个程序指令可能会经历五个执行步骤: 读取指令- 根据PC寄存器的地址,从内存中读取下一条执行指令到CPU中。 解码指令- 将二进制指令解码成具体需要执行的指令,复杂指令可能需要解码为多条指令。 执行指令- 调用执行单元进行运算。 读写内存数据- 从内存中读写计算的数据。 写寄存器- 将运算完的数据写会寄存器。 早期的CPU设计只能按照程序指令的顺序进行执行,每个指令都需要经过这五个执行步骤。如果每个步骤需要200ps的话,一个时钟周期需要1000ps并且只能执行1个指令。3个指令需要3000ps。之后就诞生了流水线技术,通过在一个时钟周期内执行多条不同指令的不同步骤,提高流水线的吞吐量实现指令集并行。虽然不能降低单个指令的耗时,但是可以降低多条指令的总耗时。 五级流水线优化执行 理想情况下三条指令在每个周期都执行多个不同的步骤,降低了三条执行执行的总耗时 一个时钟周期的耗时取决于这个周期内最长耗时的操作 现代流水线设计 现代CPU核心中的流水线设计很复杂,也会导致CPU中的控制单元占比很大。现代CPU流水线设计主要为了让运算单元每个周期都可以满负载执行,通常有10级流水线,加入了更多的功能模块用于增加流水线的吞吐量提高IPC。流水线通常分为前端和后端,前端主要负责读取指令和解码指令,后端主要负责调度发射指令和执行指令。接下来我们通过下图的流水线示例来了解现代CPU中的流水线设计,参考了当前主流的CPU性能核心的微架构实现。 提示:Intel最早在2004年推出了30+级流水线的CPU,但是流水线数量太长会导致微架构设计非常复杂,同时分支预测失败惩罚更高。这些原因导致目前CPU通常使用10级左右的流水线。 读取指令 读取指令将内存中的指令读取到CPU中的指令缓冲区中,相关的优化是为了降低读取指令延迟和读取更多指令到CPU中,提高流水线的吞吐量。 多指令读取 由于从内存中读取程序指令延迟比较长,现代CPU会按照PC寄存器的地址一次性读取多条后面需要执行的程序指令CPU中,减少后续流水线空闲时间。将指令放在指令缓冲区中,等待解码器的使用。 分支预测 由于一次性读取多条程序指令,会遇到一个问题就是当分支判断的时候由于分支还未执行无法知道后续分支执行的方向。通过添加分支预测单元提前预测分支可能的执行方向读取后续需要执行的程序指令。 分支预测分为动态分支预测和静态分支预测。高性能CPU核心都会使用动态分支预测的方式,分支预测成功率可以达到80%-90%。分支预测错误会导致分支预测惩罚需要回滚错误分支的指令执行,通常会导致10+个周期的流水线惩罚。 静态分支预测和动态分支预测 类型 实现方式 优点 缺点 详情 静态分支预测 编译器 实现简单、成本低 预测准确性比较差 在编译器中插入相关分支预测判断 动态分支预测 CPU 预测成功率高 成本高、增加功耗 一种简单实现:在每个分支执行完成的时候,将分支结果保存到缓存中进行统计。分支预测执行判断时,根据之前这个分支的执行结果选择概率更高的执行方向。 L1 指令缓存 为了避免每次从内存中读取指令延迟比较长,将读取过的指令存入缓存中。经常使用的指令就可以直接从缓存中读取,但是L1缓存由于读取性能的限制容量有限,通常只有几十KB,在缓存缺失的时候可能会从内存中读取指令导致流水线卡顿。 TLB 缓存 由于CPU访问内存时,会将程序空间的虚拟地址映射为物理内存地址,这个映射过程有一定的耗时。通过加入TLB缓冲区将转换后的映射加入到缓存中,下次读取程序指令地址时就可以直接读取无需再进行地址转换。 解码指令 解码指令将指令缓冲区中的指令按照顺序微码为多个微操作放入微操作队列中,相关的优化是为了降低解码耗时和同时解码更多的指令。 预解码 将指令缓冲区中几十个字节的指令解析成多个单独的程序指令,后续再发送到解码器提高解码效率。特别是对于x86指令由于指令长度不同,预解码阶段会更加复杂。 多解码器 解码器将程序指令解码成CPU微操作指令。现代CPU核心中通常会添加多个解码器用于提高解码性能,通常会有3-10个解码器单个时钟周期可以解码多条指令。 x86平台的复杂指令可能会生成多条微操作,所以x86处理器通常包含一个复杂指令解码器,专门用于解码复杂指令。x86处理器的解码器通常比ARM更少,A17 Pro的高性能核有9个解码器,Intel i9 14900K的高性能核心只有6个解码器其中包含1个复杂指令解码器。 微指令缓存 x86平台由于复杂指令的存在,解码指令效率更低。通常会加入额外的微指令缓存,将已经解码的指令微操作映射保存到缓存中,下次可以直接读取无需再解码。 发射指令 多发射 一个周期内发射多个指令到运算单元,提高运算单元的吞吐量。有两种实现多发射的调度方式,静态调度和动态调度。现代CPU高性能核心使用动态调度一个周期可以发射6-10个指令。 静态调度和动态调度 类型 实现方式 优点 缺点 详情 静态调度 编译器 实现成本更低 性能提升一般 编译器对指令的执行顺序进行调整 动态调度 CPU 性能更好 成本高、增加功耗 CPU实时对指令进行调度和发射 动态调度 多发射调度主要是为了提高指令发射的效率,同一个时钟周期发射出更多的指令到计算单元,让计算单元持续处于高负载运算状态中提高吞吐量。一个时钟周期内将不同的指令发射到不同的计算单元,但是需要解决流水线冒险带来的挑战,通常存在三种类型的流水线冒险: 数据冒险- 当前指令必须依赖前面一条正在执行的指令的计算结果,例如依赖前一条加法指令的计算结果,需要等待前一个指令将结果写入到寄存器中。 控制冒险- 当前指令必须依赖前面一条正在执行的指令的分支判断结果,通常使用分支预测方式进行解决。 结构冒险- 当前指令因为硬件资源限制导致无法执行,例如多个指令需要同时使用同一个寄存器,多个指令需要同时使用某个加法计算单元。 流水线调度过程中需要解决流水线冒险的问题,现代CPU微架构设计会通过ROB(重排序缓冲区)对执行进行动态调度,ROB越大可以保存的指令数越多性能越好: 寄存器重命名- 现代CPU内核中通常有更多的物理寄存器数量,超过指令集中定义的寄存器数量。需要对寄存器进行重命名放置到不同的寄存器中提高指令级并行,例如两条指令都使用同一个寄存器可以放置到不同的寄存器中进行处理。 指令重排序- 因为需要同时发射多条指令提高吞吐量,所以需要对指令的执行顺序进行调整导致乱序执行。但是会保证最终的执行结果符合原本的预期。 数据预读取- 提前将后面程序指令需要使用的内存数据加载到缓存中,避免缓存缺失导致的延时。 分支预测惩罚- 流水线执行过程中会将分支预测相关的指令执行结果暂时保存,等待最终分支预测正确时才会执行完成。如果分支预测错误需要回滚这些错误预测的指令。 指令发射- 将对应的指令发射到计算单元 执行指令 多执行 一个时钟周期可以并行执行不同的计算单元,只要当前计算单元有空闲。 计算单元缓冲区 将指令和指令数据发射到计算单元的缓冲区中等待执行,当计算单元空闲时即可开始执行。 增加计算单元 增加更多的整数运算、浮点运算、分支判断和内存读写单元数量,一个时钟周期可以执行更多的运算和内存读写操作。现代CPU性能核心通常有10+个算数单元和多个内存加载单元。 L1/L2 数据缓存 通过L1、L2缓存读取内存数据,将常用的数据保存到高速缓存中,提高下一次读取的性能。 主流 CPU 核心的微架构设计 现代CPU通常使用大小核设计,性能核有更复杂的流水线设计性能更好,能效核流水线设计更简单性能会差一些。 Intel Intel最新的桌面级别处理器Core i9 14900K使用了8个Raptor Cove性能核和16个Gracemont能效核。 Raptor Cove性能核 Gracemont 能效核 Apple Apple最新的A17 Pro处理器使用了2个性能核和4个能效核。 性能核 能效核 ARM 高通最新的8 Gen 3处理器使用了1个X4超大核,5个A710性能核,2个A520能效核。 X4 超大核 A720 性能核 A520 能效核 小结 CPU核心微架构通过加入更多的流水线单元提高IPC,这些优化单元都需要消耗额外的晶体管数量增加能耗,同时IPC更高的核心会使用更高的时钟频率运行。在20世纪90年代流水线技术的发展带来了处理器性能的快速提升,但是随着功耗墙的限制,高性能核心在性能上比能效核心快几倍,但是在功耗上可能有几十到上百倍的消耗。CPU技术发展不再追求大幅提高IPC来提高性能,而是转向对晶体管更好的利用追求能耗比。 从现代CPU的微架构设计中也能看到,不同指令集的CPU在微架构上也有很多相似之处,更多的差异在解码单元对于不同指令的解码。 提示:IPC高的核心需要使用更高的时钟频率进行执行,主要是因为IPC高的核心有更复杂流水线设计和更积极的流水线调度避免流水线停顿,所以提高时钟频率可以提升性能。IPC低的核心会遇到更多的流水线停顿,提高频率也会导致很多周期流水线处于停顿等待内存读取或分支计算完成造成浪费。 数据级并行:SIMD 和 GPU SIMD SIMD(Single instruction, multiple data)单指令多数据,是一种通过单个指令同时进行多个数据运算的方式,主要是用于音视频、图像处理、向量运算这些计算场景。通过增加运算单元位宽、计算单元数量数量、寄存器位宽可以同时进行更多数据的运算,普通指令单个周期通常只能支持 2个数据的运算,SIMD指令单个周期可以同时几十个数据的运算。同时一次性读取多个内存数据也可以降低多次读取内存数据带来的数据延迟。大部分常见编程语言都提供对SIMD的支持,可以直接进行使用。 很多图像、音视频等场景,通常只需要更低的数据位宽进行运算,SIMD指令可以同时进行更多数据的运算。目前x86平台的SIMD指令发展到最新的AVX-512,运算宽度提升到 512 位,可以单指令执行 512 位的运算。ARM平台的SIMD指令发展到SSE,最高可执行2048位的运算。 例如一个像素值颜色通常使用 RGBA 32 位格式,Red、Green、Blue、Alpha 分别占 8 位。一个 256 位的 SIMD 指令可以同时对 8 个颜色(32 个 8 位)进行运算,普通指令只能进行 2 个 8 位运算。 SIMD虽然带来了性能的提升,但是芯片需要使用更多的晶体管用来支持SIMD指令更高的位宽计算和更多的寄存器数量。同时SIMD指令一次性传输数据量更大、指令复杂度更高、占用更多的寄存器和运算器,也带来了更多的计算功耗。SIMD也需要软件开发者针对特定场景选择使用SIMD指令进行优化才能得到性能提升。 普通运算和 SIMD 运算的区别 GPU 从某种角度讲,SIMD和GPU的运算方式很相似。通过一次性并行处理更多的数据带来性能提升,同时一次性读取大量数据也可以降低内存数据延迟带来的影响。GPU很像同时并行多线程执行SIMD的多核心处理器,只不过相比CPU设计更复杂性能更高,同时GPU的线程数更多、SIMD通道数更多、SIMD单元数量更多。 SIMD 和 GPU 小结 近些年更多AI运算场景增加了对于高性能向量运算的要求。虽然CPU通过添加SIMD指令增加了向量运算的能力,但是CPU本身是用于通用计算设计,CPU中只有小部分用于SIMD运算。虽然类似Pytorch、TensorFlow这些AI训练框架都支持SIMD指令,但是使用SIMD进行大规模AI训练相比GPU性能更低,同时成本更高。SIMD更像是传统CPU运算的一种补充,用于简单的小规模运算场景用于提高性能。 多线程并行:超线程、多核心 超线程 超线程是一种STM(同时多线程)技术,通过在单个CPU核心中模拟运行多个线程提高CPU的多线程并行能力。Intel最早在2002年推出了超线程技术,一个核心同时支持2个线程。利用SMT可以避免处理器中长延时事件导致的暂停,提高计算单元的利用率。 超线程技术通过给每个线程增加一套寄存器和PC单元,多个线程共享流水线中的多发射、动态调度等模块,通过寄存器重命名和动态调用可以在一个周期内执行不同线程的多条指令。减少单个线程中发生类似缓存缺失这样的长延时等待事件,让计算单元一直在执行状态提高性能和吞吐量。 超线程技术会增加流水线调度的复杂度,现代CPU核心通常只支持2个线程的SMT。超线程技术需要依赖流水线的动态调度能力,所以现代CPU中通常只有高性能核心才支持。同时超线程技术虽然可以提高20%-30%的多线程性能,但是会增加7%的能耗和降低单核峰值性能。 超线程调度 粗粒度多线程- 只有流水线发生等待事件长的停顿时才切换线程 细粒度多线程- 每个时钟周期都切换线程 多核心 由于IPC提升和时钟频率提升都因为功耗墙的限制而放缓,现代CPU通过提供更多的物理核心提高多线程并行能力提升指令吞吐量提高性能。通过增加CPU核心数带来的多线程性能提升,带来的能耗增加相比提升IPC、时钟频率更低。现在手机端CPU中也有5-9个核心,PC 级CPU中通常有10-30个核心,服务器CPU中核心数更多。 增加核心数可以复用核心内部的微架构设计,根据CPU的功耗、成本、性能诉求选择核心数量。例如Intel在桌面级酷睿处理器和服务器至强处理器可能会使用同样的核心,只是会增加更多的核心数量。Apple在A系列和M系列芯片也会使用同样的核心。 增加核心数也能带来一定的能耗优势,操作系统内核会根据运算负载动态的调度不同数量的核心进行执行,在运算负载低的时候可以调度更少的核心降低功耗。 大小核 现代CPU中通常还会使用大小核异构架构设计来提升能耗比降低功耗。性能核心用于高性能计算场景最大化执行性能,能耗核心用于日常低负载计算场景降低能耗。相同的核心会使用同样的时钟频率来运行,通常会共享使用L2缓存。大小核的设计也增加了操作系统内核对于多核心调度的难度。 性能核心、能效核心区别 类型 性能 功耗 时钟频率 IPC 性能核 高 高 更高的时钟频率 复杂的流水线设计、IPC 更高 能耗核 中 中 更低的时钟频率 简单的流水线设计、IPC 更低(更少的解码宽度、没有动态调度、更少的计算单元等) 大小核设计 小结 近些年CPU通过增加更多的核心数量提高CPU的多线程并行能力,但是这也带来了一些新的问题限制了核心数一直快速增加。首先CPU核心数更多增加缓存一致性的复杂度会影响性能,操作系统内核如何更好的对更多核心进行调度达到最高的能耗比。 同时对于软件开发者来讲,利用越来越多的核心进行编程会更复杂。编程语言以及开发框架也需要进行调整利用更多的核心。同时对于不同的软件类型,可以利用多线程并行执行的部分也是不一样的。(如果一个程序只有10%的运算工作可以并行执行,即使添加更多核心带来的提升也很有限) 虽然增加核心数带来的能耗增加相比IPC、时钟频率更低,但是依然会增加功耗,功耗墙也是限制核心数增加的限制之一。 高速缓存和内存提升 虽然内存不属于处理器内部的结构,但是处理器运行时会依赖内存中的程序指令和程序数据,所以内存性能对处理器性能的影响很大。因为内存性能提升相比处理器时钟频率提升非常缓慢,当前处理器对内存读写通常需要50-100个时钟周期。关于内存访问速度的提升,一个方向是通过引入多级缓存减少处理器对内存的直接访问,另一个方向是内存自身性能的提升。 引入高速缓存 为了减少处理器对内存的直接访问,现代处理器引入了SDRAM(Synchronous dynamic random-access memory)存储作为处理器的缓存集成在处理器芯片中。SDRAM的优点是访问速度比内存快很多,缺点是功耗高、成本高(1位需要 6-7 个晶体管)、容量低。 处理器对内存的所有访问都通过缓存进行加载,缓存会保存最近使用过的内存数据,这样下次访问这些数据时就可以直接从缓存中返回避免直接从内存中读取。 内存读写过程 以下是一个简单的具有二级缓存的处理器内存读写过程原型,不过现代处理器设计通常会比这个过程更加复杂: 读取 L1- 处理器核心需要读取数据时,将数据内存地址发送给L1缓存。L1缓存检查是否有缓存数据,如果L1缓存中有缓存数据直接返回。如果缓存缺失将数据内存地址发送给L2。 L2-L2缓存检查是否有缓存数据。如果L2缓存中有缓存数据将数据写入L1缓存同时读取到处理器中。如果缓存缺失将数据内存地址发送给内存。 内存- 从内存中读取数据,之后分别写入L2缓存、L1缓存,然后读取到处理器中。 保存 处理器核心将寄存器中的数据保存到内存时,分别写入L1缓存、L2缓存,之后保存到内存中。 缓存提升方向 缓存性能提升方向主要是提高缓存命中率、降低缓存缺失耗时、降低缓存命中耗时,主要是通过以下这些技能进行提升: 增加容量 增加缓存的容量,缓存中可以存储的数据越多,缓存命中率也就越高。功耗和成本会限制容量增长的速度,同时因为增加容量会影响访问速度,所以L1缓存容量增长很慢。 使用多级缓存 现代处理器通常有2-3级缓存,多核处理器每个核心包含一个L1缓存,L2、L3缓存是多个核心共享。读取速度L1 > L2 > L3,容量L3 > L2 > L1,成本L1 > L2 > L3。 这么设计的目的主要是通过局部性原理提高缓存性能。L1缓存关注读取性能,将更常用的内存数据放到容量更小的L1缓存中更快的读取。同时L1缓存设计会将指令和数据分离,提高缓存性能和缓存命中率。L2/L3缓存关注缓存缺失率,将更多的内存数据防止在缓存中减少缓存缺失耗时。 时间局部性- 被引用过一次的内存数据在未来会被多次引用。 空间局部性- 一个内存数据被引用,那么未来它临近的内存地址也会被引用。 现代CPU多级缓存设计 提示:通常L1缓存是单核心独占、L2缓存可能是单核心独占或多核心共享、L3缓存/内存是所有核心共享。通过MESI协议来解决缓存一致性的问题。 多级缓存和内存性能 存储类型 访问速度 容量 功能 L1 1 - 5 时钟周期 64 - 256 KB 指令、数据 - L2 10 - 20 时钟周期 512 KB - 2 MB 数据 A17 Pro 大核16MB L3 20 - 50 时钟周期 12 - 36 MB 数据 - DDR 50 - 100 时钟周期 8 - 64 GB 指令、数据 - 降低缓存命中时间 通过更优秀的缓存涉及,减少缓存命中时的耗时。但是通常减少命中缓存耗时和增加缓存容量通常会有不可调和的矛盾。 缓存预加载 根据前面流水线的介绍,现代处理器通常会对一次性读取内存多条程序指令到放入缓存中,同时也会提前读取后面可能会使用的内存数据到缓存中。但是当提前预加载到缓存中的数据并没有使用到时,会造成额外的功耗浪费。(例如分支预测错误) 优化缓存更新算法 将新的数据写入到缓存时,由于容量限制通常需要替换掉旧的缓存数据。常见的替换算法有LRU算法,使用更好的算法可以提高缓存命中率。 内存性能提升 虽然通过加入多级缓存可以提高内存读写的性能,但是处理器高速缓存的容量很有限,遇到缓存缺失时还是需要直接访问内存。所以对内存的性能提升依然很重要,内存性能提升主要是从以下四个方向进行提升: 读取延迟- 持续减少内存读取延迟,可以降低缓存缺失从内存中读取数据的耗时。 功耗- 由于移动设备等低功耗场景的出现,对内存产生的功耗也有更低的要求。 带宽- 因为内存性能提升很慢,同时现代处理器不断的引入新的协处理器例如GPU、NPU需要进行更多的内存数据传输。增加内存带宽虽然无法降低单次内存读取延迟但是可以同时传输更多的数据。 成本- 更低的成本可以使商品价格更低,同时可以增加更多的内存容量。 更多内存类型 由于内存无法同时满足对延迟、功耗、带宽、成本的要求,现代内存逐渐发展出了多种不同的内存类型。针对不同的计算场景选择使用不同类型的内存,主要是基于处理器对延迟、功耗、带宽、成本的要求进行选择。每一代内存新标准的推出也会逐渐提高延迟、功耗、带宽的性能,同时降低上一代标准的成本。(通常新标准成本更高) 不同内存类型特点 类型 最新标准 延迟 功耗 带宽 最大带宽 面积 成本 使用场景 特点 DDR DDR5 低 中 低 64 Gbps 中 低 PC、服务器 延迟最低 LPDDR LPDDR5X 中 低 中 77 Gbps (8 Gen 3) 小 低 手机、笔记本 功耗最低 GDDR GDDR6X 高 高 高 1008 Gbps(RTX 4090) 大 中 独立显卡 高带宽、功耗最高、延迟最高 HBM HBM3e 高 中 超高 4800 Gbps(H200) 小 高 服务器GPU 带宽最高、成本最高 集成封装工艺提升 现代面向移动场景的处理器通常会将LPDDR内存使用3D集成封装技术直接集成到处理器芯片上。优点是可以减少传输物理距离提高传输性能、降低功耗,缺点是无法灵活更换内存。 内存集成封装到处理器芯片上 小结 近些年高速缓存技术发展逐渐放缓,同时缓存缺失是导致流水线停顿的主要原因之一。由于读取延迟限制了L1缓存容量的提升,L1容量提高很少。半导体工艺发展放缓,晶体管数量增长速度降低以及功耗问题,也降低了L2、L3缓存容量增加的速度。同时高速缓存的引入也给编译器和软件开发者带来了更大的挑战,如何更好的利用局部性原理提高缓存命中率:开发者需要编写缓存命中率更高的代码、编译器需要生成缓存命中率更高的程序指令。 提示:增加缓存容量的成本很高。以A17 Pro芯片为例,总共 190 亿个晶体管,因为包含GPU、NPU等协处理器,CPU使用的晶体管数量不超过 30%。缓存大小L2 20MB + L1 192KB,以一个缓存位需要几个晶体管来计算,缓存大概需要耗费几亿个晶体管。 内存技术每一代新标准在增加带宽、容量和能耗比上都有不错的提升,但是读取延迟降低缓慢很多。内存读取延迟导致的内存墙依然是限制处理器性能的主要因素之一。因为内存墙的限制,现在也有一种存算一体的探索方向,将内存和计算单元集成在一起减少数据传输延迟。 现代处理器核心数越来越多,每个核心都有自己的L1缓存,多个核心需要共享L2缓存、L3缓存、内存数据。多核缓存一致性的复杂度越来越高,额外的开销可能会降低读取延迟和增加功耗,限制多核处理器的性能。 提示:从高速缓存和内存上看,更小的程序体积、更小的内存占用是可以增加程序的运行性能的。 SOC、DSA 和 Chiplet SOC SOC(System on Chip)片上系统是一种将多个不同模块封装在一个芯片中的技术。现代CPU基本上都属于SOC芯片,将CPU、GPU、NPU、WIFI、蓝牙、Modem等模块集成到同一个芯片中。由于半导体技术的发展可以集成在芯片上的晶体管数量越来越多,可以将更多的模块集成到一个芯片中带来集成度、性能、系统单元复用率的提升: 模块 最新标准 提高性能 不同模块集成在同一个芯片上,跨模块间通信更快、功耗更低。手机端SOC通常会将内存封装在SOC芯片上,不同模块可以使用统一内存的方式复用内存,降低内存在不同模块间的传输提高性能。 提高集成度 不同模块集成在同一个芯片上,相比传统多个模块芯片的设计可以复用重复的传输电路或内存等降低成本、降低面积、降低功耗。(例如传统CPU/GPU都有独立内存,封装到SOC中可以复用一个内存即可。) 虽然带来了性能的优势,但是由于SOC集成了更多模块同时需要模块间互联,芯片设计、制造复杂度更高,导致成本也更高。 SOC 组成结构 现代SOC通常由一个CPU单元、多个协处理器(NPU/GPU)、无线模块(WIFI/蓝牙/蜂窝网络)、多媒体单元(ISP、DSP)、内存控制器、I/O 单元组成: 模块 功能 CPU 中央处理器 GPU 图形渲染、高性能运算 NPU 神经网络运算、端测 AI 加速 ISP 相机传感器、拍照/视频图像信号处理、优化画面质量 DSP 音视频/图片硬件编解码 无线 WIFI、蓝牙、蜂窝网络的传输通讯、协议编解码、连接管理 Display Engine 管理屏幕显示、图像数据转换为屏幕格式、图像效果/分辨率优化、帧率调整 内存控制器 内存读写、内存地址映射、内存一致性、统一内存复用 I/O 管理输入/输出设备的 I/O 读写 高通 8 gen 3 Hexagon Processor- AI 模块 FastConnect- WIFI、蓝牙 Apple M3 从M3的设计上可以看出,现代SOC中CPU部分占用的硅面积不超过30% DSA DSA(Domain Specific Architecture)领域特定架构是一种用于特定领域计算的结算机体系。由于CPU是一种追求通用计算的计算机体系结构,对于特定领域计算(音视频、图形、AI 等)的性能和能效比都比较差。DSA通过面向特定领域计算的设计大幅提高性能和能耗比,解决CPU对于特定领域计算的性能劣势。 DSA 设计 现代SOC中的GPU、NPU、DSP就是一种常见的DSA模块。传统CPU通过复杂流水线设计、高速缓存、增加寄存器位数等特性提高CPU的运算性能,但是这会导致大量的晶体管消耗增加成本和能耗。DSA通过减少这些复杂的设计提高晶体管的利用率提高能效,相比CPU执行同样的特定领域运算可以带来的优势:更小的面积、更低的成本、更高的能耗比、更好的性能。 DSA 设计原则 特点 说明 备注 专用存储 使用专用存储器减少数据移动 - 最小化数据类型 使用更小位宽的数据类型来计算、节省存储空间、运算更快 - 更多运算单元或存储器 加入更多运算单元、更大的存储器 - 并行方式 选择更有利于特定领域计算的并行方式 例如 GPU 的并行方式 专用编程语言 使用面向特定领域计算的编程语言/框架进行编程 - Chiplet Chiplet是近几年发展出的一种将不同的功能模块分离成小芯片,并通过先进封装技术组合在一起的新技术。Chiplet主要是为了解决传统SOC遇到的成本高和扩展性问题。 特点 说明 备注 降低成本 不同芯片可以使用不同成本的工艺制造、小芯片可以复用降低设计成本、小芯片面积更小成本更低 - 灵活性、扩展性 根据诉求灵活集成不同的小芯片满足市场需求、3D 封装降低芯片面积 - 不过Chiplet对封装技术的要求很好,不同小芯片间的通信设计也很复杂。目前只有少量的芯片使用了这种方式进行芯片制造。 Meteor Lake Intel2023年推出的Meteor Lake处理器使用Chiplet封装,CPU使用Intel4nm工艺,Graphics使用台积电5nm工艺,SOC、IO使用台积电6nm工艺。 小结 由于CPU通用处理器性能提升放缓和对特性领域计算的能耗比和成本问题,未来也许会加入更多的DSA模块用于提升特定领域计算的性能和能耗比。近些年PC端处理器也在效仿移动端处理器加强DSA单元能力,包括提高核显 GPU 的性能以及加入 NPU。同时Chiplet技术的发展也可以帮助处理器集成更多的DSA单元同时降低成本。 主流 CPU 发展 Intel 处理器发展 CPU 频率 核心数 线程数 指令集 微架构 工艺 晶体管数量 TDP 发行年份 备注 Core i9-14900K 3.2 - 6 GHz 8 + 16 32 x86-64 Raptor Cove + Gracemont 7 nm - 125 - 253W 2023 - Core i9-13900K 3 - 5.8 GHz 8 + 16 32 x86-64 Raptor Cove + Gracemont 7 nm - 125 - 253W 2022 - Core i9-12900K 3.2 - 5.2 GHz 8 + 8 24 x86-64 Golden Cove + Gracemont 7 nm - 125 - 241W 2021 引入大小核混合架构、支持 DDR5 Core i9-11900K 3.5 - 5.3 GHz 8 16 x86-64 Cypress Cove 待确定 10 nm - 95 - 125 W 2021 - Core i7-6700K 4 - 4.2 GHz 4 8 x86-64 Skylake 14 nm - 91 W 2015 - Core i7-4790K 4 - 4.4 GHz 4 8 x86-64 Haswell 22 nm - 88 W 2014 - Core i7-990X 3.4 - 3.7 GHz 6 12 x86-64 Westmere 32 nm 12 亿 130 W 2011 - Core 2 E6700 2.66 GHz 2 2 x86-64 Conroe 65 nm 2.9 亿 65 W 2006 引入双核心 Pentium D Processor 840 3.2 GHz 2 2 x86-64 NetBurst 90 nm 2.3 亿 - 2005 - Pentium 4 Extreme Edition 3.4 GHz 1 2 x86-32 NetBurst 130 nm - 110W 2004 引入超线程 Pentium 4 2.8 GHz 2.8 GHz 1 1 x86-32 NetBurst 130 nm 5500 万 - 2002 - Pentium 3 Processor 1.1 GHz 1.1 GHz 1 1 x86-32 P6 180 nm - 33 W 2000 - Pentium Pro 200 MHz 200 MHz 1 1 x86-32 P6 500 nm 550万 35W 1995 微解码转换、动态调用、乱序执行、推测执行、引入二级缓存、SSE、支持寄存器更名 Pentium 60 MHz 1 1 x86-32 P5 800 nm 310 万 - 1993 - 80486 25 MHz 1 1 x86-32 i486 1 um 100万 - 1989 - 80386 20 MHz 1 1 x86-32 - 1.5 um 27.5万 - 1985 加入6级流水线 80286 12.5 MHz 1 1 x86-16 - 1.5 um 13.4 万 - 1982 - 80186 6 MHz 1 1 x86-16 - 2 um 5.5 万 - 1982 - 8086 5 MHz 1 1 x86-16 - 3 um 2.9 万 2 W 1978 第一个 x86 架构处理器、16 位、引入8个通用寄存器、分段内存 8085 3 MHz 1 1 8085 - 3 um 6500 - 1976 - 8080 2 MHz 1 1 8080 - 6 um 4500 - 1974 不兼容 8008 8008 0.5 MHz 1 1 8008 - 10 um 3500 1 - 2 W 1972 第一个 8 位可编程处理器 最新 CPU 微架构对比 代号 类型 指令集 线程数 解码宽度 ROB 发射宽度 分支预测惩罚 L1 缓存 L2 缓存 SIMD IPC Raptor Cove Intel 性能核 x86-64 2(超线程) 6 512 6 8 48 KB(D)、32 KB(I) 2 MB AVX 512 3.525、4.23(超线程) Gracemont Intel 能效核 x86-64 1 6 256 6 8 32 KB(D)、64 KB(I) 2 MB(共享) AVX 256 2.52 A520 ARM 小核 ARMv9 1 3 0 3 - 64 KB(D)、32 KB(I) 256 KB SVE 0.94 A720 ARM 大核 ARMv9 1 5 192 5 - 64 KB(D)、32 KB(I) 512 KB SVE 3.03 X4 ARM 超大核 ARMv9 1 10 384 10 - 64 KB(D)、64 KB(I) 2 MB SVE 4.4 A17 E Apple 能效核 ARMv8 1 5 224 5 5 128 KB(D) + 64 KB(I) 4 MB(共享) NEON 3.05 A17 P Apple 性能核 ARMv8 1 9 670 9 9 64 KB(D)、128 KB(I) 16 MB(共享) NEON 5.06 对开发者的影响 更多核心数 CPU核心数越来越多,软件开发者需要使用面向多线程的利用更多的核心并行才能提高程序执行的性能。同时也可以导致编程语言、编程范式、框架的一些改变: 多线程编程- 更多的使用到多线程编程利用多核的性能 简化并行编程- 编程语言提供了更多特性简化并行编程,例如async/await函数、结构化并发 异步编程- 更多的跨线程异步调用 非共享内存的并发模型- 可以减少数据竞争、减少线程锁使用、减少线程切换的耗时,Go、Rust、Swift语言都提供了类似的并发模型 UI框架- 传统UI框架都是基于单线程模型设计,UI框架和浏览器需要更好的利用多核心的性能优势。同时非UI操作需要更多考虑多线程的利用减少主线程的消耗 函数式编程- 函数式编程更有利于并行执行变得更流行 SIMD、DSA单元 SOC不断增加更多的DSA单元增加特定领域运算的能耗比,未来可能需要面向更多不同类型的处理器进行编程,不同的处理器会导致编程语言和编程范式的改变。 硬件性能提升放缓 CPU性能提升放缓带给软件的性能提升更少,同时软件自身功能不断增加对于性能的消耗,软件追求更高的性能提升就需要做更多的软件性能优化。 AOT- 类似Java、C#、JS这些传统的解释执行编程语言开始追求AOT编译提高性能,新的编程语言通常也会支持AOT编译 简化内存管理- 简化传统的自动内存管理方式,使用更简单的内存管理方式。例如Rust的所有权更多利用编译器去检查内存安全 值类型- 更多的值类型使用,栈上的值类型性能更好 编译器- 编译器利用静态优化生成性能更好的代码减少运行时消耗,静态类型系统、静态方法派发 相关链接 计算机组成与设计:硬件/软件接口 RISC-V版(原书第2版) 计算机体系结构:量化研究方法(第6版) ARM64体系结构编程与实践 芯片战争 芯片简史 Introducing the Arm architecture Arm A-Profile Architecture Arm A64 Instruction Set Architecture Arm A-profile A64 Instruction Set Architecture AArch64 memory management Snapdragon 8 Gen 3 Mobile Platform Snapdragon X Elite NanoReview Geekbench Intel Core i9-14900K Intel Core i9-10900K Intel Core 2 E6700 Pentium 4 Processor Extreme Edition Intel Pentium III Processor 1.1 GHz Intel Pentium Pro 200 MHz 80486 80386 80286 80186 8086 Intel Processors CPU 微架构设计 作者:京东零售何骁 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

浅谈SQL优化小技巧 | 京东云技术团队

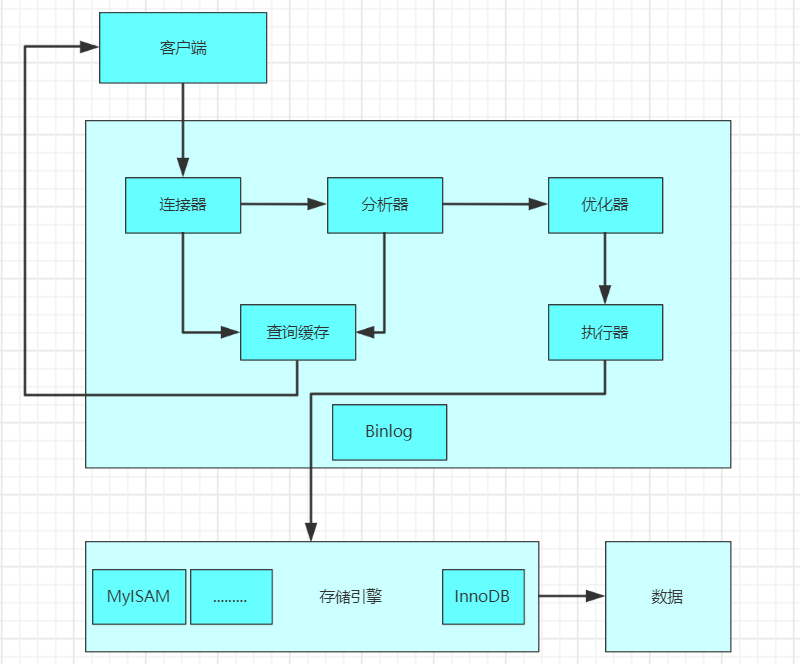
回顾MySQL的执行过程,帮助介绍如何进行sql优化。 (1)客户端发送一条查询语句到服务器; (2)服务器先查询缓存,如果命中缓存,则立即返回存储在缓存中的数据; (3)未命中缓存后,MySQL通过关键字将SQL语句进行解析,并生成一颗对应的解析树,MySQL解析器将使用MySQL语法进行验证和解析。 ​ 例如,验证是否使用了错误的关键字,或者关键字的使用是否正确; (4)预处理是根据一些MySQL规则检查解析树是否合理,比如检查表和列是否存在,还会解析名字和别名,然后预处理器会验证权限; ​ 根据执行计划查询执行引擎,调用API接口调用存储引擎来查询数据; (5)将结果返回客户端,并进行缓存;  SQL语句性能优化常用策略 1、 为 WHERE 及 ORDER BY 涉及的列上建立索引 对查询进行优化,应尽量避免全表扫描,首先应考虑在 WHERE 及 ORDER BY 涉及的列上建立索引。 2、where中使用默认值代替null 应尽量避免在 WHERE 子句中对字段进行 NULL 值判断,创建表时 NULL 是默认值,但大多数时候应该使用 NOT NULL,或者使用一个特殊的值,如 0,-1 作为默认值。 为啥建议where中使用默认值代替null,四个原因: (1)并不是说使用了is null或者 is not null就会不走索引了,这个跟mysql版本以及查询成本都有关; (2)如果mysql优化器发现,走索引比不走索引成本还要高,就会放弃索引,这些条件 !=,<>,is null,is not null经常被认为让索引失效; (3)其实是因为一般情况下,查询的成本高,优化器自动放弃索引的; (4)如果把null值,换成默认值,很多时候让走索引成为可能,同时,表达意思也相对清晰一点; 3、慎用 != 或 <> 操作符。 MySQL 只有对以下操作符才使用索引:<,<=,=,>,>=,BETWEEN,IN,以及某些时候的 LIKE。 所以:应尽量避免在 WHERE 子句中使用 != 或 <> 操作符, 会导致全表扫描。 4、慎用 OR 来连接条件 使用or可能会使索引失效,从而全表扫描; 应尽量避免在 WHERE 子句中使用 OR 来连接条件,否则将导致引擎放弃使用索引而进行全表扫描, 可以使用 UNION 合并查询: select id from t where num=10 union all select id from t where num=20 一个关键的问题是否用到索引。他们的速度只同是否使用索引有关,如果查询需要用到联合索引,用 UNION all 执行的效率更高。多个 OR 的字句没有用到索引,改写成 UNION 的形式再试图与索引匹配。 5、慎用 IN 和 NOT IN IN 和 NOT IN 要慎用,否则会导致全表扫描。对于连续的数值,能用 BETWEEN 就不要用 IN:select id from t where num between 1 and 3。 6、慎用 左模糊like ‘%…’ 模糊查询,程序员最喜欢的就是使用like,like很可能让索引失效。 比如: select id from t where name like‘%abc%’ select id from t where name like‘%abc’ 而select id from t where name like‘abc%’才用到索引。 所以: 首先尽量避免模糊查询,如果必须使用,不采用全模糊查询,也应尽量采用右模糊查询, 即like ‘…%’,是会使用索引的; 左模糊like ‘%…’无法直接使用索引,但可以利用reverse + function index的形式,变化成 like ‘…%’; 全模糊查询是无法优化的,一定要使用的话建议使用搜索引擎,比如 ElasticSearch。 备注:如果一定要用左模糊like ‘%…’检索, 一般建议 ElasticSearch+Hbase架构 7、WHERE条件使用参数会导致全表扫描。 如下面语句将进行全表扫描: select id from t where num=@num 因为SQL只有在运行时才会解析局部变量,但优化程序不能将访问计划的选择推 迟到 运行时; 它必须在编译时进行选择。然而,如果在编译时建立访问计划,变量的值还是未知的,因而无法作为索引选择的输入项。 所以, 可以改为强制查询使用索引: select id from t with(index(索引名)) where num=@num 8、用 EXISTS 代替 IN 是一个好的选择 很多时候用exists 代替in 是一个好的选择: select num from a where num in(select num from b) 用下面的语句替换: select num from a where exists(select 1 from b where num=a.num) 9、索引并不是越多越好 索引固然可以提高相应的 SELECT 的效率,但同时也降低了 INSERT 及 UPDATE 的效。 因为 INSERT 或 UPDATE 时有可能会重建索引,所以怎样建索引需要慎重考虑,视具体情况而定。 一个表的索引数最好不要超过 6 个,若太多则应考虑一些不常使用到的列上建的索引是否有必要。 10、尽量使用数字型字段 (1)因为引擎在处理查询和连接时会逐个比较字符串中每一个字符; (2)而对于数字型而言只需要比较一次就够了; (3)字符会降低查询和连接的性能,并会增加存储开销; 所以:尽量使用数字型字段,若只含数值信息的字段尽量不要设计为字符型,这会降低查询和连接的性能,并会增加存储开销。 11、尽可能的使用 varchar, nvarchar 代替 char, nchar (1)varchar变长字段按数据内容实际长度存储,存储空间小,可以节省存储空间; (2)char按声明大小存储,不足补空格; (3)其次对于查询来说,在一个相对较小的字段内搜索,效率更高; 因为首先变长字段存储空间小,可以节省存储空间,其次对于查询来说,在一个相对较小的字段内搜索效率显然要高些。 14、查询SQL尽量不要使用select *,而是具体字段 最好不要使用返回所有:select * from t ,用具体的字段列表代替 “*”,不要返回用不到的任何字段。 select *的弊端: (1)增加很多不必要的消耗,比如CPU、IO、内存、网络带宽; (2)增加了使用覆盖索引的可能性; (3)增加了回表的可能性; (4)当表结构发生变化时,前端也需要更改; (5)查询效率低; 15、将需要查询的结果预先计算好 将需要查询的结果预先计算好放在表中,查询的时候再Select,而不是查询的时候进行计算。 16、IN后出现最频繁的值放在最前面 如果一定用IN,那么:在IN后面值的列表中,将出现最频繁的值放在最前面,出现得最少的放在最后面,减少判断的次数。 17、尽量使用 EXISTS 代替 select count(1) 来判断是否存在记录。 count 函数只有在统计表中所有行数时使用,而且 count(1) 比 count(*) 更有效率。 18、用批量插入或批量更新 当有一批处理的插入或更新时,用批量插入或批量更新,绝不会一条条记录的去更新。 (1)多条提交 INSERT INTO user (id,username) VALUES(1,'xx'); INSERT INTO user (id,username) VALUES(2,'yy'); (2)批量提交 INSERT INTO user (id,username) VALUES(1,'xx'),(2,'yy'); 默认新增SQL有事务控制,导致每条都需要事务开启和事务提交,而批量处理是一次事务开启和提交,效率提升明显,达到一定量级,效果显著,平时看不出来。 19、将不需要的记录在 GROUP BY 之前过滤掉 提高 GROUP BY 语句的效率,可以通过将不需要的记录在 GROUP BY 之前过滤掉。 下面两个查询返回相同结果,但第二个明显就快了许多。 低效: SELECT JOB, AVG(SAL) FROM EMP GROUP BY JOB HAVING JOB = 'PRESIDENT' OR JOB = 'MANAGER' 高效: SELECT JOB, AVG(SAL) FROM EMP WHERE JOB = 'PRESIDENT' OR JOB = 'MANAGER' GROUP BY JOB 20、避免死锁 在你的存储过程和触发器中访问同一个表时总是以相同的顺序;事务应经可能地缩短,在一个事务中应尽可能减少涉及到的数据量;永远不要在事务中等待用户输入。 21、索引创建规则: 表的主键、外键必须有索引; 数据量超过 300 的表应该有索引; 经常与其他表进行连接的表,在连接字段上应该建立索引; 经常出现在 WHERE 子句中的字段,特别是大表的字段,应该建立索引; 索引应该建在选择性高的字段上; 索引应该建在小字段上,对于大的文本字段甚至超长字段,不要建索引; 复合索引的建立需要进行仔细分析,尽量考虑用单字段索引代替; 正确选择复合索引中的主列字段,一般是选择性较好的字段; 复合索引的几个字段是否经常同时以 AND 方式出现在 WHERE 子句中?单字段查询是否极少甚至没有?如果是,则可以建立复合索引;否则考虑单字段索引; 如果复合索引中包含的字段经常单独出现在 WHERE 子句中,则分解为多个单字段索引; 如果复合索引所包含的字段超过 3 个,那么仔细考虑其必要性,考虑减少复合的字段; 如果既有单字段索引,又有这几个字段上的复合索引,一般可以删除复合索引; 频繁进行数据操作的表,不要建立太多的索引; 删除无用的索引,避免对执行计划造成负面影响; 表上建立的每个索引都会增加存储开销,索引对于插入、删除、更新操作也会增加处理上的开销。 另外,过多的复合索引,在有单字段索引的情况下,一般都是没有存在价值的;相反,还会降低数据增加删除时的性能,特别是对频繁更新的表来说,负面影响更大。 尽量不要对数据库中某个含有大量重复的值的字段建立索引。 22、在写 SQL 语句时,应尽量减少空格的使用 查询缓冲并不自动处理空格,因此,在写 SQL 语句时,应尽量减少空格的使用,尤其是在 SQL 首和尾的空格(因为查询缓冲并不自动截取首尾空格)。 23、每张表都设置一个 ID 做为其主键 我们应该为数据库里的每张表都设置一个 ID 做为其主键,而且最好的是一个 INT 型的(推荐使用 UNSIGNED),并设置上自动增加的 AUTO_INCREMENT 标志。 24、使用explain分析你SQL执行计划 (1)type system:表仅有一行,基本用不到; const:表最多一行数据配合,主键查询时触发较多; eq_ref:对于每个来自于前面的表的行组合,从该表中读取一行。这可能是最好的联接类型,除了const类型; ref:对于每个来自于前面的表的行组合,所有有匹配索引值的行将从这张表中读取; range:只检索给定范围的行,使用一个索引来选择行。当使用=、<>、>、>=、<、<=、IS NULL、<=>、BETWEEN或者IN操作符,用常量比较关键字列时,可以使用range; index:该联接类型与ALL相同,除了只有索引树被扫描。这通常比ALL快,因为索引文件通常比数据文件小; all:全表扫描; 性能排名:system > const > eq_ref > ref > range > index > all。 实际sql优化中,最后达到ref或range级别。 (2)Extra常用关键字 Using index:只从索引树中获取信息,而不需要回表查询; Using where:WHERE子句用于限制哪一个行匹配下一个表或发送到客户。除非你专门从表中索取或检查所有行,如果Extra值不为Using where并且表联接类型为ALL或index,查询可能会有一些错误。需要回表查询。 Using temporary:mysql常建一个临时表来容纳结果,典型情况如查询包含可以按不同情况列出列的GROUP BY和ORDER BY子句时; 25、当只要一行数据时使用 LIMIT 1 当你查询表的有些时候,你已经知道结果只会有一条结果,但因为你可能需要去fetch游标,或是你也许会去检查返回的记录数。 在这种情况下,加上 LIMIT 1 可以增加性能。 这样一来,MySQL 数据库引擎会在找到一条数据后停止搜索,而不是继续往后查少下一条符合记录的数据。 26、将大的DELETE,UPDATE、INSERT 查询变成多个小查询 能写一个几十行、几百行的SQL语句是不是显得逼格很高?然而,为了达到更好的性能以及更好的数据控制,你可以将他们变成多个小查询。 27、合理分表 尽量控制单表数据量的大小,建议控制在500万以内 500万并不是MySQL数据库的限制,过大会造成修改表结构,备份,恢复都会有很大的问题。 可以用历史数据归档(应用于日志数据),分库分表(应用于业务数据)等手段来控制数据量大小。 作者:京东科技 梁发文 来源:京东云开发者社区 转载请注明来源
优秀的个人博客,低调大师

MYSQL EXPLAIN 执行计划 | 京东物流技术团队

EXPLAIN 执行计划 有了慢查询语句后,就要对语句进行分析。一条查询语句在经过 MySQL 查询优化器的各种基于成本和规则的优化会后生成一个所谓的执行计划,这个执行计划展示了接下来具体执行查询的方式,比如多表连接的顺序是什么,对于每个表采用什么访问方法来具体执行查询等等。EXPLAIN 语句来能够查看某个查询语句的具体执行计划,要搞懂 EPLATN 的各个输出项都有什么作用,从而可以有针对性的提升查询语句的性能。 通过使用 EXPLAIN 关键字可以模拟优化器执行 SQL 查询语句,从而知道 MySQL 是如何处理 SQL 语句的。分析查询语句或是表结构的性能瓶颈。 EXPLAIN 可以得到以下结果: 表的读取顺序; 数据读取操作的操作类型; 哪些索引可以使用; 哪些索引被实际使用; 表之间的引用; 每张表有多少行被优化器查询; EXPLAIN 基本语法 执行计划的语法非常简单:在 SQL 查询的前面加上 EXPLAIN 关键字。比如:EXPLAIN select * from tableName; 除了以 SELECT 开头的查询语句,其余的 DELETE、INSERT、UPOATE 语句前边都可以加上 EXPLAIN,用来查看这些语句的执行计划,只不过大多数情况下都会对 SELECT 语句更感兴趣。 EXPLAIN 详解 执行 sql explain SELECT * FROM order_test; 输出结果如图:  每列的含义 id 查询语句一般都以 SELECT 关键字开头,比较简单的查询语句里只有一个 SELECT 关键字,稍微复杂一点的连接查询中也只有一个 SELECT 关键字,比如: explain SELECT * FROM test1 t1 INNER JOIN test2 t2 ON t1.id=t2.id ; 但是下边两种情况下在一条查询语句中会出现多个 SELECT 关键字: 1. 查询中包含子查询的情况:explain SELECT * FROM test1 WHERE id IN(SELECT id FROM test2); 2. 查询中包含 UNION / UNION ALL 语句的情况:EXPLAIN SELECT * FROM test1 UNION ALL SELECT * FROM test2; 查询语句中每出现一个 SELECT 关键字,MySQL 就会为它分配一个唯一的 id 值。这个 id 值就是 EXPLAIN 语句的第一列的值,并且 id 的顺序是按 SELECT 出现的顺序增长的,id 列越大执行优先级越高,id 相同则从上往下执行,id 为 NULL 最后执行。 单 SELECT 关键字 比如下边这个查询中只有一个 SELECT 关键字,所以 EXPLAIN 的结果中也就只有一条 id 列为 1 的记录。  连接查询 对于连接查询来说,一个 SELECT 关键字后边的 FROM 子句中可以跟随多个表,所以在连接查询的执行计划中,每个表都会对应一条记录,但是这些记录的 id 值都是相同的。  可以看到,上述连接查询中参与连接的 test1 和 test2 表分别对应一条记录,但是这两条记录对应的 id 值都是 1,在连接查询的执行计划中,每个表都会对应一条记录,这些记录的 id 列的值是相同的。 包含子查询 对于包含子查询的查询语句来说,就可能涉及多个 SELECT 关键字,所以在包含子查询的查询语句的执行计划中,每个 SELECT 关键字都会对应一个唯一的 id 值。 但是这里需要特别注意,查询优化器可能对涉及子查询的查询语句进行重写,从而转换为连接查询。所以如果我们想知道查询优化器对某个包含子查询的语句是否进行了重写,直接查看执行计划。  可以看到,虽然查询语句是一个子查询,但是执行计划中 test1 和 test2 表对应的记录的 id 值全部是 1,这就表明了查询优化器将子查询转换为了连接查询。 包含 UNION \ UNION ALL 子句 对于包含 UNION 子句的查询语句来说,每个 SELECT 关键字对应一个 id 值也是没错的,不过还是有点儿特别。  这个语句的执行计划的第三条记录是因为 UNION 子句会把多个查询的结果集合并起来并对结果集中的记录进行去重,MySQL 使用的是内部的临时表。UNION 子句是为了把 id 为 1 的查询和 id 为 2 的查询的结果集合并起来并去重,所以在内部创建了一个名为 <union1,2> 的临时表,就是执行计划第三条记录的 table 列的名称,id 为 NULL 表明这个临时表是为了合并两个查询的结果集而创建的。 跟 UNION 对比起来 UNION ALL 就不需要为最终的结果集进行去重,它只是单纯的把多个查询的结果集中的记录合并成一个并返回给用户,所以也就不需要使用临时表。所以在包含 UNION ALL 子句的查询的执行计划中,就没有那个 id 为 NULL 的记录。  select_type 一条大的查询语句里边可以包含若干个 SELECT 关键字,每个 SELECT 关键字代表着一个小的查询语句,而每个 SELECT 关键字的 FROM 子句中都可以包含若干张表,每一张表都对应着执行计划输出中的一条记录,对于在同一个 SELECT 关键字中的表来说,它们的 id 值是相同的。 MySQL 为每一个 SELECT 关键字代表的小查询都定义了一个称之为:select_type 的属性,意思是我们只要知道了某个小查询的 select_type 属性,就知道了这个小查询在整个大查询中扮演了一个什么角色,select_type 取值如下: SIMPLE:简单的 SELECT 查询,不使用 union 及子查询; PRIMARY:最外层的 SELECT 查询; UNION:UNION 中的第二个或随后的 SELECT 查询,不依赖于外部查询的结果集; UNION RESULT:UNION 结果集; SUBQUERY:子查询中的第一个 SELECT 查询,不依赖于外部查询的结果集; DERIVED: 用于 FROM 子句里有子查询的情况,MySQL 会递归执行这些子查询,把结果放在临时表里; SIMPLE 简单的 select 查询,查询中不包含子查询或者 UNION。  连接查询也算是 SIMPLE 类型。  PRIMARY 对于包含 UNION、UNION ALL 或者子查询的大查询来说,它是由几个小查询组成的,其中最左边的那个查询的 select_type 值就是 PRIMARY。 从结果中可以看到,最左边的小查询 SELECT * FROMN test1 对应的是执行计划中的第一条记录,它的 select_type 值就是 PRIMARY。 UNION 对于包含 UNION 或者 UNION ALL 的大查询来说,它是由几个小查询组成的,其中除了最左边的那个小查询以外,其余的查询的 select_type 值就是 UNION。  UNION RESULT MySQL 选择使用临时表来完成 UNION 查询的去重工作,针对该临时表的查询的 select_type 就是 UNION RESULT,如上图。 SUBQUERY 包含在 SELECT 中的子查询,不在 FROM 子句中。  DERIVED 包含在 FROM 子句中的子查询。MySQL 会将结果存放在一个临时表中,也称为派生表。  从执行计划中可以看出, id 为 2 的记录就代表子查询的执行方式,它的 select_type 是 DERIVED ,说明该子查询是以派生表的方式执行的。id 为 1 的记录代表外层查询,注意看它的 table 列显示的是 <derived2>,表示该查询是针对将派生表之后的表进行查询的。 table 不论我们的查询语句有多复杂,里边包含了多少个表,到最后也是需要对每个表进行单表访问的,MySQL 规定 EXPLAIN 语句输出的每条记录都对应着某个单表的访问方法,该条记录的 table 列代表着该表的表名。  只涉及对 test1 表的单表查询,所以 EXPLAIN 输出中只有一条记录,其中的 table 列的值是 test1;  连接查询的执行计划中有两条记录,这两条记录的 table 列分别是 test1和 test2。 partitions 和分区表有关,一般情况下查询语句的执行计划的 partitions 列的值都是NULL。 type 执行计划的一条记录就代表着 MySQL 对某个表的执行查询时的访问方法或访问类型,其中的 type 列就表明了这个访问方法或访问类型是较为重要的一个指标,结果值从最好到最坏依次是:system > const > eq_ref > ref > range > index > ALL。 一般来说,得保证查询至少达到 range 级别,最好能达到 ref。 system 当表中只有一条记录并且该表使用的存储引擎的统计数据是精确的,比如:MyISAM、Memory,那么对该表的访问方法就是 system。  如果改成使用 InnoDB 存储引擎,type 的值就是 all。  const 根据主键或者唯一二级索引列与常数进行等值匹配时,对单表的访问方法就是 const。因为只匹配一行数据,所以很快。  B+ Tree 叶子节点中的记录是按照索引列排序的,对于的聚簇索引来说,它对应的B+树叶子节点中的记录就是按照id列排序的。B+树矮胖,所以这样根据主键值定位一条记录的速度很快。类似的,我们根据唯一二级索引列来定位一条记录的速度也很快的,比如下边这个查询: eq_ref 在连接查询时,如果被驱动表是通过主键或者唯一二级索引列等值匹配的方式进行访问的,如果该主键或者唯一二级索引是联合索引的话,所有的索引列都必须进行等值比较,则对该被驱动表的访问方法就是:eq_ref。  从执行计划的结果中可以看出,MySQL 打算将 test2 作为驱动表,test1 作为被驱动表,重点关注 test1 的访问方法是 eq_ref,表明在访问 test1 表的时候可以通过主键的等值匹配来进行访问。 驱动表与被驱动表:A 表和 B 表 join 连接查询,如果通过 A 表的结果集作为循环基础数据,然后一条一条地通过该结果集中的数据作为过滤条件到 B 表中查询数据,然后合并结果。那么我们称 A 表为驱动表,B 表为被驱动表。 ref 当通过普通的二级索引列与常量进行等值匹配时来查询某个表,那么对该表的访问方法就可能是 ref。 本质上也是一种索引访问,它返回所有匹配某个单独值的行,它可能会找到多个符合条件的行,所以他属于查找和扫描的混合体。 对于这个查询可以选择全表扫描来逐一对比搜索条件是否满足要求,也可以先使用二级索引找到对应记录的 id 值,然后再回表到聚簇索引中查找完整的用户记录。 由于普通二级索引并不限制索引列值的唯一性,所以可能找到多条对应的记录,也就是说使用二级索引来执行查询的代价取决于等值匹配到的二级索引记录条数。 如果匹配的记录较少,则回表的代价还是比较低的,所以 MySQL 可能选择使用索引而不是全表扫描的方式来执行查询。这种搜索条件为二级索引列与常数等值比较,采用二级索引来执行查询的访问方法称为:ref。 对于普通的二级索引来说,通过索引列进行等值比较后可能匹配到多条连续的记录,而不是像主键或者唯一二级索引那样最多只能匹配 1 条记录,所以这种 ref 访问方法比 const 要差些,但是在二级索引等值比较时匹配的记录数较少时的效率还是很高的,如果匹配的二级索引记录太多那么回表的成本就太大了。 对于某个包含多个索引列的二级索引来说,只要是最左边的连续索引列是与常数的等值比较就可能采用 ref 的访问方法。 range 如果使用索引获取某些范围区间的记录,那么就可能使用到 range 访问方法,一般就是在 where 语句中出现了 between、<、>、in 等的查询。 这种范围扫描索引比全表扫描要好,因为它只需要开始于索引的某一点,而结束语另一点,不用扫描全部索引。  这种利用索引(聚簇索引、二级索引)进行范围匹配的访问方法称之为:range。 index 可以使用索引覆盖,但需要扫描全部的索引记录时,该表的访问方法就是:index。  ALL 最熟悉的全表扫描,将遍历全表以找到匹配的行。  possible_keys 和 key 在 EXPLAIN 语句输出的执行计划中,possible_keys 列表示在某个查询语句中,对某个表执行单表查询时可能用到的索引有哪些。key 列表示实际用到的索引有哪些,如果为 NULL,则没有使用索引。  上述执行计划的 possible_keys 列的值表示该查询可能使用到 u_idx_day_status、idx_insert_time 两个索引,然后 key 列的值是 u_idx_day_status,表示经过查询优化器计算使用不同索引的成本后,最后决定使用 u_idx_day_status 来执行查询比较划算。 key_len key_len 列,表示当优化器决定使用某个索引执行查询时,该索引记录的最大长度,计算方式如下: 对于使用固定长度类型的索引列来说,它实际占用的存储空间的最大长度就是该固定值,对于指定字符集的变长类型的索引列来说,如:某个索引列的类型是VARCHAR(100),使用的字符集是 utf8,那么该列实际占用的最大存储空间就是100x3=300个字节; 如果该索引列可以存储 NULL 值,则 key_len 比不可以存储 NULL 值时多 1 个字节; 对于变长字段来说,都会有 2 个字节的空间来存储该变长列的实际长度;  由于 id 列的类型是 bigint,并且不可以存储 NULL 值,所以在使用该列的索引时 key_len 大小就是 8。 对于可变长度的索引列来说。  由于 order_no 列的类型是 VARCHAR(50),所以该列实际最多占用的存储空间就是 50*3 字节,又因为该列是可变长度列,所以 key_len 需要加2,所以最后ken_len 的值就是 152。 执行计划的生成是在 MySQL server 层中的功能,并不是针对具体某个存储引擎的功能,MySQL 在执行计划中输出 key_len 列主要是为了区分某个使用联合索引的查询具体用了几个索引列,而不是为了准确的说明针对某个具体存储引擎存储变长字段的实际长度占用的空间到底是占用几个字节。 key_len 表示索引中使用的字节数,可通过该列计算查询中使用的索引的长度。在不损失精确性的情况下,长度越短越好。 key_len 显示的值为索引字段的最大可能长度,并非实际使用长度,即 key_len 是根据表定义计算而得,不是通过表内检索出的。 注:char 和 varchar 跟字符编码也有密切的联系,比如 latin1 占用 1 个字节,gbk 占用 2 个字节,utf8 占用 3 个字节。 ref 当使用索引列等值查询时,与索引列进行等值匹配的对象信息;  可以看到 ref 列的值是 const,表明在使用 idx_order_no 索引执行查询时,与 order_no 列作等值匹配的对象是一个常数。 复杂的情况。  可以看到对被驱动表 t1 的访问方法是 eg_ref,而对应的 ref 列的值是 test.t2.id,这说明在对被驱动表进行访问时会用到 PRIMARY 索引,也就是聚簇索引与一个列进行等值匹配的条件,与 t2 表的 id 作等值匹配的对象就是 test.t2.id列,格式:数据库名称.表名.字段。 rows 如果查询优化器决定使用全表扫描的方式对某个表执行查询时,执行计划的 rows 列就代表预计需要扫描的行数,如果使用索引来执行查询时,执行计划的 rows 列就代表预计扫描的索引记录行数。  filtered 某个表经过搜索条件过滤后剩余记录条数的百分比;  从执行计划的 key 列中可以看出来,该查询使用 PRIMARY 索引来执行查询,从 rows 列可以看出满足 id>5890 的记录有 5177 条。执行计划的 filtered 列就代表查询优化器预测在这 5177 条记录中,有多少条记录满足其余的搜索条件,也就是 order_note='a' 这个条件的百分比。此处 filtered 列的值是 10.0,说明查询优化器预测在 5177 条记录中有 10.00% 的记录满足 order_note='a' 这个条件。 Extra Extra 列是用来说明一些额外信息的,可以通过这些额外信息来更准确的理解 MySQL 到底将如何执行给定的查询语句。MySQL 提供的额外信息很多,常见的重要值如下: Using index:当我们的查询列表以及搜索条件中只包含属于某个索引的列,也就是在可以使用索引覆盖的情况下,在 Extra 列将会提示该额外信息。  这个查询中只需要用到 u_idx_day_status 而不需要回表操作。 Using where:当我们使用全表扫描来执行对某个表的查询,并且该语句的 WHERE 子句中有针对该表的搜索条件时,在 Extra 列中会提示。  Using where 只是表示 MySQL 使用 where 子句中的条件对记录进行了过滤。 Using index condition:有些搜索条件中虽然出现了索引列,但却不能使用到索引。  其中的 order_no >'z' 可以使用到索引,但是 order_no LIKE '%a' 却无法使用到索引,在以前版本的 MySQL 中,是按照下边步骤来执行这个查询的: 先根据 order_no>'z' 这个条件,从二级索引 idx_order_no 中获取到对应的二级索引记录; 根据上一步骤得到的二级索引记录中的主键值进行回表,找到完整的用户记录再检测该记录是否符合 order_no LIKE '%a' 这个条件,将符合条件的记录加入到最后的结果集; 虽然 order_no LIKE '%a' 不能组成范围区间参与 range 访问方法的执行,但这个条件毕竟只涉及到了 order_no 列,MySQL 把上边的步骤改进了一下。 索引条件下推 先根据 order_no>'z' 这个条件,定位到二级索引 idx_order_no 中对应的二级索引记录; 对于指定的二级索引记录,先不着急回表,而是先检测一下该记录是否满足 order_no LIKE '%a' 这个条件,如果这个条件不满足,则该二级索引记录压根儿就没必要回表; 对于满足 order_no LIKE '%a' 这个条件的二级索引记录执行回表操作,回表操作其实是一个随机 IO 比较耗时; 所以上述修改可以省去很多回表操作的成本,这个改进称之为索引条件下推。 如果在查询语句的执行过程中将要使用索引条件下推这个特性,在 Extra 列中将会显示 Using index condition。 Using temporary:在许多查询的执行过程中,MySQL 可能会借助临时表来完成一些功能,比如去重、排序之类的,比如在执行许多包含 DISTINCT、GROUPBY、UNION 等子句的查询过程中,如果不能有效利用索引来完成查询,MySQL 很有可能寻求通过建立内部的临时表来执行查询。如果查询中使用到了内部的临时表,在执行计划的 Extra 列将会显示 Using temporary。   上边的 GROUP BY 的执行计划的 Extra 列不仅仅包含 Using temporary 提示,还包含 Using filesort 提示,可是查询语句中明明没有写 ORDER BY 子句,这是因为 MySQL 会在包含 GROUP BY 子句的查询中默认添加上 ORDER BY 子句。 如果不想为包含 GROUP BY 子句的查询进行排序,需要显式的写上 ORDER BY NULL。  Using filesort:有一些情况下对结果集中的记录进行排序是可以使用到索引的。  这个查询语句可以利用 idx_order_no 索引直接取出 order_no 列的 10 条记录,然后再进行回表操作。但是很多情况下排序操作无法使用到索引,只能在内存中或者磁盘中进行排序,MySQL 把这种在内存中或者磁盘上进行排序的方式统称为文件排序。如果某个查询需要使用文件排序的方式执行查询,就会在执行计划的Extra 列中显示 Using filesort。  Select tables optimized away:使用某些聚合函数,比如:max、min 来访问存在索引的某个字段是。  作者:京东物流张士欣 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册