首页 文章 精选 留言 我的

精选列表

搜索[SpringBoot],共4561篇文章
优秀的个人博客,低调大师

springCloud Finchley 实战入门(基于springBoot 2.0.3)【五 Hystrix 服务容错保护】

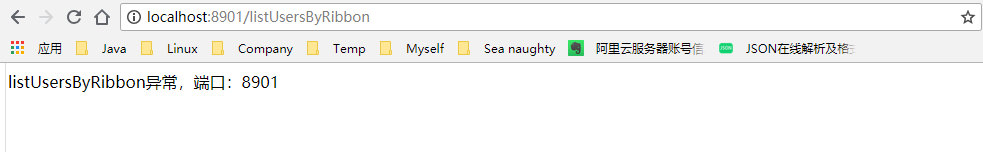
服务容错保护 在微服务的架构中,存在着那么多单元服务,若一个单元出现故障,就很容易因依赖关系二引发故障的蔓延,最终导致整个系统的瘫痪。这样的架构相比较传统的架构更加不稳定。为了解决这个问题,产生了断路器等一系列的服务保护机制。 spring Cloud Hystrix实现了断路器、线程隔离等一系列服务保护功能。它也是基于Netflix的开源框架Hystrix实现的。,该框架的目标在于通过控制那些访问远程系统、服务和第三方库的节点,从而对延时和故障提供更加强大的容错能力。 快速入门 我们以之前的内容作为基础,针对"service-user-ribbon"进行配置。 在"service-user-ribbon"的pom.xml配置文件添加Hystrix依赖 <!--添加Hystrix依赖 断路器容错保护--> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-hystrix</artifactId> </dependency> 完整的pom.xml <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.example</groupId> <artifactId>eureka-bussniss-service-user-client-ribbon</artifactId> <version>0.0.1-SNAPSHOT</version> <packaging>jar</packaging> <name>eureka-bussniss-service-user-client-ribbon</name> <description>Demo project for Spring Boot</description> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>2.0.3.RELEASE</version> <relativePath/> <!-- lookup parent from repository --> </parent> <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding> <java.version>1.8</java.version> <spring-cloud.version>Finchley.RELEASE</spring-cloud.version> </properties> <dependencies> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-eureka-server</artifactId> </dependency> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-ribbon</artifactId> </dependency> <!--添加Hystrix依赖 断路器容错保护--> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-starter-netflix-hystrix</artifactId> </dependency> <dependency> <groupId>org.projectlombok</groupId> <artifactId>lombok</artifactId> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> </dependencies> <dependencyManagement> <dependencies> <dependency> <groupId>org.springframework.cloud</groupId> <artifactId>spring-cloud-dependencies</artifactId> <version>${spring-cloud.version}</version> <type>pom</type> <scope>import</scope> </dependency> </dependencies> </dependencyManagement> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> </plugins> </build> </project> 然后在主类EurekaBussnissServiceUserClientRibbonApplication中使用@EnableHystrix 注解以开启 Hystrix 特性 @SpringBootApplication @EnableEurekaClient @EnableHystrix public class EurekaBussnissServiceUserClientRibbonApplication { public static void main(String[] args) { SpringApplication.run(EurekaBussnissServiceUserClientRibbonApplication.class, args); } @Bean @LoadBalanced //开启客户端负载均衡 RestTemplate restTemplate() { return new RestTemplate(); } } 接下来修改服务消费方式,在UserManagementRibbonClient类的接口方法:ListUsersByRibbon增加@HystrixCommand并且指定fallbackMethod名,再实现该方法。具体的代码如下: /** * 使用 @HystrixCommand 注解的 fallbackMethod 指定失败方法,并实现该方法 * * @return */ @GetMapping("/listUsersByRibbon") @HystrixCommand(fallbackMethod = "listUsersByRibbonFallback") public String ListUsersByRibbon() { /** * hystrix 断路器的默认的超时时间为2000毫秒 * 这里测试的在3000毫秒的随机出现的超时概率出发断路器 对应的代码逻辑见service-user项目的listUsers接口 */ long start = System.currentTimeMillis(); String result = this.restTemplate.getForObject("http://service-user/listUsers", String.class); long end = System.currentTimeMillis(); log.info("Spend Time :"+(end-start)); return result; } public String listUsersByRibbonFallback() { return "listUsersByRibbon异常,端口:" + port; } 配置完成重启项目,在8802和8803服务正常的情况下服务调用正常。 当我们把其中一个service-user服务停掉。例如:把8802停掉,只剩下8803服务,我们重新访问http://localhost:8901/listUsersByRibbon地址,当我们一开始访问到8802服务时,因为此时服务已经挂了,所以我们会看到下面的响应: 1532500404150.png 过了几秒后,继续访问我们会发现请求总是负载到了8803的端口了,不会再去请求8802 1532500486184.png 接下来我们重新把8802的服务启动后,继续访问http://localhost:8901/listUsersByRibbon这时我们会发现请求接口又被一轮询的方式负载到8802和8803了 1532500622445.png 1532500630124.png 这样我们就实现了基础的分布式微服务的容错保护了。github 项目源码 接下来我们会再研究一下,Hystrix框架针对单个应用实例和集群提供的监控功能。

优秀的个人博客,低调大师

基于SpringBoot和微信小程序的小学生托管系统

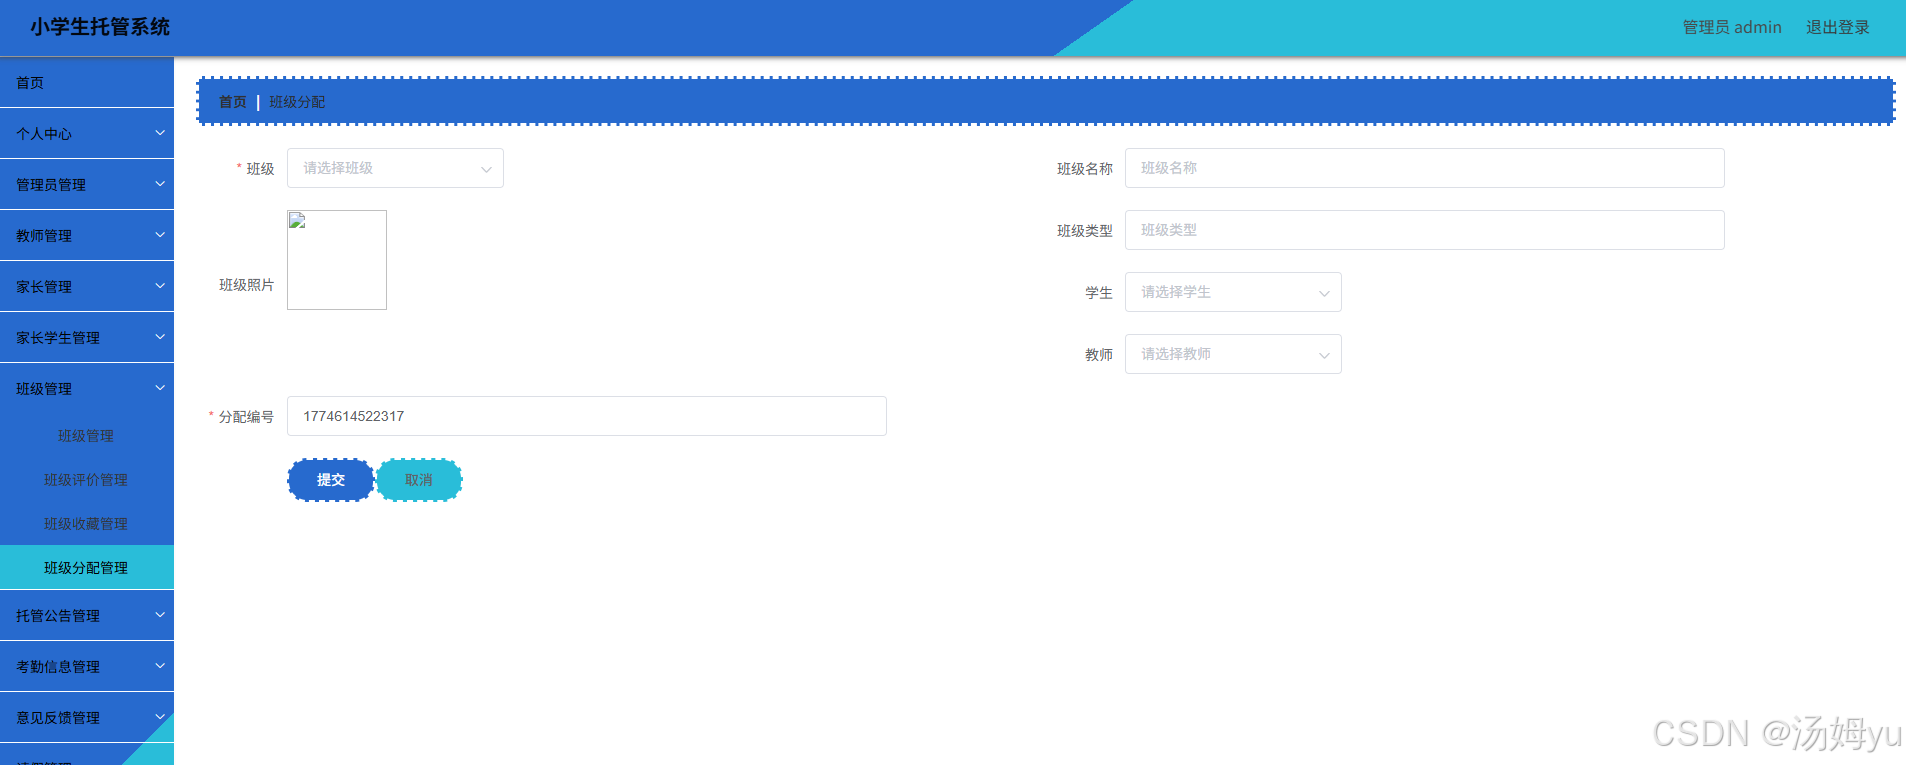
# 1.绪论 ## 1.1课题研究背景 随着我国社会经济的快速发展,家庭结构呈现双职工化趋势,小学生放学时间与家长下班时间存在的时间差,使得“三点半难题”成为困扰众多家庭的突出民生问题。为破解这一难题,国家持续推进课后托管政策落实,2025年全国小学课后服务开展率已达94.2%,托管服务已成为义务教育阶段的重要配套举措。 当前,我国小学生托管服务虽实现广泛覆盖,但在实际运营管理中仍存在诸多短板。校内托管面临师资负担过重、师生配比失衡、个性化辅导不足等问题,校外托管机构则存在资质良莠不齐、监管缺失、服务质量参差不齐等乱象,难以满足家长对托管服务安全性、规范性、个性化的核心需求。 现有托管管理多以人工登记、口头沟通为主,在学生签到签退、师资调度、家长沟通、安全监管等环节效率低下,易出现管理漏洞。在此背景下,构建科学、高效、规范的小学生托管系统,整合托管资源、优化管理流程、提升服务质量,成为破解当前托管困境、完善义务教育配套服务的迫切需求。基于此,本文围绕小学生托管系统展开研究,为推动托管服务规范化、信息化发展提供实践支撑。 ## 1.2课题国内外研究现状 当前,小学生托管系统研究紧扣“双减”政策导向,立足我国义务教育优质均衡发展需求,围绕服务供给、管理规范、质量提升三大核心展开,形成多元研究格局,同时仍存在诸多待完善之处。截至2024年底,全国义务教育学校课后服务覆盖率已超95%,相关研究多基于实践调研,聚焦不同区域、不同托管模式的实施现状,兼具实践性与针对性。 研究重点集中在三方面:一是托管模式优化,深入分析学校主导、社区协同、市场补充的多元供给模式优劣,探讨校社合作、校企联动的有效路径,目前约40%的城区学校已建立校企合作机制。二是核心问题剖析,重点研究师资配备短板、经费保障不足、政策落实不均等现实困境,发现校内教师负担过重、校外师资资质参差不齐等问题较为突出。三是提质路径探索,关注素质托管与智能托管融合,探索数字化手段在托管管理中的应用,已有32个地级市上线课后服务管理平台。 现有研究仍存在明显局限:多数研究侧重现状描述,实证研究较为匮乏,缺乏第一手调研数据支撑;研究视角多集中于供给端,对家长与学生的需求关注不足;区域研究不均衡,农村及欠发达地区托管研究较为薄弱。整体而言,当前研究为托管系统规范化发展提供了实践参考,但仍需进一步深化,完善研究体系,助力托管服务从“有”向“优”转型。 ## 1.3相关软件系统设计技术概况简介 在构建基于Spring Boot与UniApp的校园闲置物品交易系统过程中,开发和维护这一软件项目依赖于一系列专业的工具。项目开发过程中主要使用了IntelliJ IDEA、Visual Studio Code、MySQL等开发工具。 ## 1.4前端技术与工具简介 ## 1.4.1Visual Studio Code Visual Studio Code(简称 VS Code)是微软推出的轻量级开源代码编辑器,兼容 Windows、macOS、Linux 全平台,是目前全球使用率极高的编程工具。它核心优势在于轻量化与扩展性:基础体积小、启动速度快,不占用过多系统资源,同时支持通过插件拓展功能,覆盖 Python、Java、前端、运维脚本等几乎所有开发场景。内置语法高亮、智能补全、代码调试、版本控制等基础功能,还支持自定义主题与快捷键,兼顾新手易用性与专业开发者的个性化需求,免费且社区生态活跃,成为个人学习、小型项目开发的主流选择。 ## 1.4.2微信开发者工具 微信开发者工具是腾讯官方推出的一站式开发调试工具,专为微信小程序、小游戏及公众号网页开发设计,是微信生态开发的核心工具。它集成代码编辑、实时预览、调试、真机模拟、代码上传审核等全流程功能,支持 Windows 和 macOS 系统,界面简洁且操作贴合开发者习惯。工具内置语法校验、智能提示、断点调试等基础能力,可直接关联微信公众平台账号,实现代码一键上传、版本管理与发布,无需复杂配置即可快速开展开发工作,是微信生态开发者必备的免费工具,适配个人开发者与企业级项目开发需求。 ## 1.4.3HBuilderX HBuilderX 是 DCloud 推出的轻量级多端开发工具,主打前端、小程序与 App 开发,是国内开发者常用的编程工具之一。它基于 Electron 框架 构建,兼容 Windows 和 macOS 系统,核心优势是启动速度快、对中文适配友好,内置代码块、语法高亮、一键运行等功能,原生支持 Vue、uni-app 等主流技术栈,可无缝适配微信、支付宝等多平台小程序开发,还能通过插件拓展原生 App 开发能力。工具分为免费版与付费版,轻量化设计兼顾新手入门与企业级项目开发,是多端一体化开发的实用选择。 ## 1.4.4Vue Vue(全称 Vue.js)是尤雨溪开发的渐进式 JavaScript 前端框架,也是目前主流的前端开发技术之一。它以轻量、易用、灵活为核心特点,采用组件化开发模式,可将页面拆分为独立可复用的组件,降低代码耦合度。Vue 支持响应式数据绑定,能实时同步数据与页面视图,无需手动操作 DOM,大幅提升开发效率。其渐进式特性允许按需引入核心功能或拓展插件,适配从简单页面到复杂单页应用(SPA)的各类开发场景,生态完善且中文文档丰富,是前端新手入门和企业项目开发的常用选择。 ## 1.4.5Element UI Element UI 是饿了么前端团队开源的 Vue 2.x 桌面端组件库,是国内前端开发中使用率极高的 UI 框架之一。它基于 Vue 封装了丰富的常用界面组件,涵盖按钮、表单、表格、弹窗等近百种基础与业务组件,无需重复开发界面元素,可直接复用,大幅提升前端开发效率。组件风格统一、交互友好,支持自定义主题与国际化配置,文档详尽且中文适配完善,适配后台管理系统、数据可视化平台等桌面端 Web 应用开发场景,是 Vue 技术栈开发桌面端项目的主流选择。 ## 1.4.6Uniapp uni-app 是 DCloud 推出的跨端开发框架,基于 Vue 语法体系构建,是国内主流的多端统一开发方案之一。它核心优势是 “一套代码多端运行”,编写一次代码可同时适配微信 / 支付宝等小程序、H5、iOS/Android App 等多个平台,大幅减少多端开发的重复工作量。框架兼容 Vue 2/3 语法,内置丰富的跨端组件与 API,适配各类业务场景,还能借助 HBuilderX 工具实现快速开发、调试与打包。uni-app 学习成本低,文档完善且中文生态活跃,是中小团队和个人开发者做跨端应用的首选。 # 2 系统需求分析 ## 2.1老师的功能 老师在学生管理 流程中承担多项重要职责。在分班管理方面,老师可以查看分配的班级以及班级学生信息。在考勤管理中,老师负责接收学生,确认学生到托情况,若学生未按时到托,需标记特殊情况并处理异常。在作业管理上,老师能够查看作业内容、布置作业并监督学生完成情况,对于未完成作业的学生需注明原因,在学生放学时等待家长接走并确认学生离校。老师还会接收家长的请假通知并确认请假信息。 ![](https://developer.qcloudimg.com/http-save/yehe-2014964/f72e903bf8ad790ec5e06c7c1c8e75de.png) ### 2.2家长的功能 家长在学生管理过程中主要起到配合和反馈的作用。在分班环节,家长会接收分班通知。在考勤方面,家长会接收到托通知和离校通知,并负责接走学生。在作业管理方面,家长会接收作业完成情况通知。在请假管理上,家长需要填写请假事由并提交,向老师发送请假通知。 ![](https://developer.qcloudimg.com/http-save/yehe-2014964/3e81c24b4956d45d0a90e93d80afcfaa.png) ### 2.3 管理员的功能 管理员主要负责班级的创建以及人员分配工作。具体而言,管理员创建班级后,进行分配老师和分配学生的操作,确保班级人员配置合理,是学生管理流程中基础且关键的环节,为后续老师、家长开展各项与学生相关的工作提供前提条件。 ![](https://developer.qcloudimg.com/http-save/yehe-2014964/d7103d3aaeb26fe4697a0baf5cfb9377.png) ## 3 系统实现 ![](https://developer.qcloudimg.com/http-save/yehe-2014964/9ebedb825b558fa8ded05092abcf8099.png) ![](https://developer.qcloudimg.com/http-save/yehe-2014964/188322bd8f5e0909a6ea450ba03bbfb7.png) ![](https://developer.qcloudimg.com/http-save/yehe-2014964/fa75ac25aecca219d08f80097fc40b41.png) ![](https://developer.qcloudimg.com/http-save/yehe-2014964/c9b6ae94a15564ee2dae8baf6b756765.png) ![](https://developer.qcloudimg.com/http-save/yehe-2014964/c7611a8b3e816c81dd3a1d430720e337.png) ![](https://developer.qcloudimg.com/http-save/yehe-2014964/071329d1e53410e36f03050f949e14ff.png) ![](https://developer.qcloudimg.com/http-save/yehe-2014964/56271d6250d90fe4c37b84a9222a7c4a.png) ![](https://developer.qcloudimg.com/http-save/yehe-2014964/50b3a027534dd8f826b1ba2700fdcd55.png) ![](https://developer.qcloudimg.com/http-save/yehe-2014964/3c54ec4ea71fcc03b47f47e9d9feb067.png)

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第11招 事务到底在哪生效

# 方法明明写了 @Transactional,为什么事务仍可能不生效? ```text 记忆注解 → 设计边界 → 一致性 ``` 我是老李,在深圳做架构师,常年跟 Spring Boot 打交道。 Petclinic 是 Spring 官方教学项目,Owner、Pet、Visit 三张表天然构成多步骤写操作场景。 我见过太多团队把 @Transactional 当护身符,写上就以为万事大吉,结果数据错乱、连接耗尽、回滚失效。 方法明明写了 @Transactional,为什么事务仍可能不生效? 该把事务注解放在哪一层,才能让回滚真正覆盖业务边界? 选错事务边界,会不会让数据库连接被长事务拖死,最终拖垮整个应用? # 01、故事 ```text 凌晨 1:30 → 深圳某金融公司机房 → 任务是排查订单重复入账 → 冲突:日志显示事务已提交,但数据库里出现半截数据 ``` 凌晨 1:30,机房冷气开得足,我盯着屏幕上的异常堆栈,咖啡已经凉透。 任务是排查订单重复入账问题,业务方说用户付了两次钱,但只收到一次货。 我打开 Petclinic 的 Visit 新增接口,发现它先更新 Owner,再插入 Pet,最后写 Visit,三步操作被拆在三个方法里。 每个方法都标了 @Transactional,可中间一步抛异常后,前两步的数据竟然留在了库里。 日志里明明显示事务已提交,可数据库里就是半截数据,像被啃过的苹果。 > 注解不是护身符, > 代理才是真门神。 > 内部调用绕过去, > 回滚落空泪满襟。 # 02、问题 ```text 需求变化:一次前台操作要同时写 Owner、Pet、Visit → 冲突:三个方法各自开事务,中间失败只回滚自己 → 后果:数据库出现孤儿 Pet、脏 Owner ``` Petclinic 原本新增 Visit 只写一张表,事务边界清晰。 现在需求变了,一次前台操作要同时更新 Owner 信息、新增 Pet、登记 Visit,三步必须同生共死。 我把三个方法都标上 @Transactional,以为每个方法自带事务,合起来就是整体事务。 结果中间步骤抛异常,只有最后那个方法回滚了,前面两个方法的数据已经提交,数据库里出现孤儿 Pet。 影响是数据不一致,用户看到宠物还在,但就诊记录没了,下次查询直接报错。 可验证的验收标准:模拟中间步骤失败,Owner、Pet、Visit 三张表都不应有新增或修改。 > 需求一变边界乱, > 三个事务各自转。 > 中间失败留残局, > 孤儿数据惹人烦。 # 03、原理 ```text Spring 事务基于 AOP 代理,只有外部调用才走代理,内部 this 调用直接绕过代理,事务注解形同虚设 ``` Spring 的 @Transactional 不是魔法,它靠 AOP 代理实现。 当你在方法上标 @Transactional,Spring 会为 Bean 生成一个代理对象,调用方法时先经过代理,代理开启事务、执行业务、提交或回滚。 但如果你在同一个类里,用 this 调用另一个带 @Transactional 的方法,调用直接走原始对象,代理根本不知道,事务自然不生效。 反直觉判断:方法上写了 @Transactional,不代表它一定在事务里运行,关键看谁在调用它。 另一个反直觉点:@Transactional 默认只回滚 RuntimeException 和 Error,受检异常(如 Exception)不会触发回滚,除非显式指定 rollbackFor。 事务传播级别也常被误解,REQUIRED 不是新开事务,而是“有则加入,无则新建”,理解错会导致事务边界比预期大得多。 > 代理门前三叩首, > 内部调用不回头。 > 受检异常不落滚, > 传播级别暗流涌。 # 04、架构 ```text 输入:HTTP 请求 → 本模块:Service 层事务边界 → 输出:一致的三表数据 / 异常回滚 → 边界:事务只覆盖业务逻辑,不覆盖 HTTP 连接与外部调用 ``` 事务边界应该画在 Service 层,而不是 Controller 或 Repository。 Controller 负责参数校验和响应封装,Repository 只做单表 CRUD,Service 层编排多步骤业务,事务注解放在 Service 的公开方法上。 收益是事务粒度与业务操作对齐,回滚范围清晰,代码可读性高。 代价是 Service 层方法不能随意拆小,否则容易触发内部调用陷阱。 适用条件是业务操作确实需要多表一致性,如果只是单表写,事务放 Repository 反而增加无谓开销。 > 边界画在服务层, > 控制仓储两边分。 > 事务粒度对业务, > 回滚清晰不迷魂。 # 05、第一版实战 ```text 环境:Spring Boot 3.2 + MySQL 8 + Petclinic 源码 → 配置:开启事务管理 → 代码:VisitService 三个方法各标 @Transactional → 启动:正常 → 验证:模拟中间失败 → 结果:部分提交 ``` 我基于 Petclinic 源码,在 visit 包下新建 VisitService,版本用 Spring Boot 3.2(需按当前官方文档核验)。 先看 Petclinic 的 Owner、Pet、Visit 实体,它们有 JPA 注解,Visit 关联 Pet,Pet 关联 Owner。 我在 pom.xml 里确认有 spring-boot-starter-data-jpa 和 mysql-connector-j,配置 application.properties 指向本地 MySQ L。 ```properties spring.datasource.url=jdbc:mysql://localhost:3306/petclinic spring.datasource.username=root spring.datasource.password=secret spring.jpa.hibernate.ddl-auto=update ``` 然后写 VisitService,三个方法分别更新 Owner、新增 Pet、新增 Visit,每个方法都标 @Transactional。 ```java @Service public class VisitService { private final OwnerRepository ownerRepository; private final PetRepository petRepository; private final VisitRepository visitRepository; public VisitService(OwnerRepository ownerRepository, PetRepository petRepository, VisitRepository visitRepository) { this.ownerRepository = ownerRepository; this.petRepository = petRepository; this.visitRepository = visitRepository; } @Transactional public void updateOwner(Owner owner) { ownerRepository.save(owner); } @Transactional public Pet addPet(Pet pet) { return petRepository.save(pet); } @Transactional public Visit addVisit(Visit visit) { return visitRepository.save(visit); } } ``` Controller 里调用这三个方法,模拟一次前台操作。 ```java @PostMapping("/owners/{ownerId}/visits") public ResponseEntity addVisit(@PathVariable int ownerId, @RequestBody VisitRequest request) { Owner owner = ownerService.findById(ownerId); owner.setLastName(request.getOwnerLastName()); visitService.updateOwner(owner); Pet pet = new Pet(); pet.setName(request.getPetName()); pet.setOwner(owner); Pet savedPet = visitService.addPet(pet); Visit visit = new Visit(); visit.setPet(savedPet); visit.setDate(request.getDate()); visit.setDescription(request.getDescription()); visitService.addVisit(visit); return ResponseEntity.status(HttpStatus.CREATED).build(); } ``` 启动应用,用 curl 发请求,故意让 addPet 里抛异常(比如宠物名称为空时抛 IllegalArgumentException)。 ```bash curl -X POST http://localhost:8080/owners/1/visits \ -H "Content-Type: application/json" \ -d '{"ownerLastName":"Smith","petName":"","date":"2025-01-01","description":"checkup"}' ``` 预期是整体回滚,但实际查询数据库,发现 Owner 的 lastName 被改了,Pet 没插入,Visit 没插入。 示例输出(日志): ```text 2025-01-01 10:00:00.123 ERROR 12345 --- [nio-8080-exec-1] o.s.j.support.JobService : Pet name must not be empty 2025-01-01 10:00:00.124 INFO 12345 --- [nio-8080-exec-1] jdbc.sqltiming : UPDATE owners SET last_name='Smith' WHERE id=1 ``` Owner 更新已提交,Pet 插入失败,事务没有整体回滚。 成功标准是三步要么全成功要么全失败,现在明显没达到。 > 三个方法各开火, > 中间爆炸留残壳。 > Owner 已改 Pet 空, > 事务边界没画妥。 # 06、排查 ```text 诊断树:现象是部分提交 → 怀疑事务没生效 → 检查代理是否被绕过 → 证据是日志显示 Owner 更新已提交 → 根因是内部调用绕过代理 → 修复:合并方法或注入自身代理 ``` 问题一:为什么 Owner 更新提交了,Pet 插入失败却没回滚? 现象是部分提交,怀疑是事务没生效。 我检查 VisitService 的字节码,确认 @Transactional 注解存在,但发现 Controller 调用的是 visitService.updateOwner(),这是外部调用,应 该走代理。 可问题是三个方法各自独立事务,Pet 失败只回滚 Pet 自己的事务,Owner 的事务已经提交。 证据是数据库里 Owner 的 lastName 变了,Pet 表没有新行。 根因是事务边界粒度太细,每个方法一个事务,没有形成整体。 修复方法:把三个方法合并成一个公开方法,事务注解只标在合并方法上。 ```java @Transactional public void addVisitFlow(Owner owner, Pet pet, Visit visit) { ownerRepository.save(owner); Pet savedPet = petRepository.save(pet); visit.setPet(savedPet); visitRepository.save(visit); } ``` 问题二:如果我把三个方法合并了,但内部又调用另一个带 @Transactional 的私有方法,事务会怎样? 现象是私有方法上的 @Transactional 不生效,怀疑是代理问题。 我检查调用链,发现私有方法通过 this 调用,直接绕过代理。 证据是日志里私有方法执行时没有事务开启记录。 根因是 Spring AOP 基于代理,私有方法无法被代理拦截。 修复方法:把私有方法改成 public,并注入自身代理(@Lazy 注入),或者干脆不标事务,让外层事务统一管理。 **错误尝试:** 我一开始以为把 @Transactional 加到每个方法上就能保证整体性,结果发现事务是独立的,根本没用。 后来我又尝试用 @Transactional(propagation = Propagation.REQUIRES_NEW) 强制新事务,结果每个方法都开新事务,回滚范围更小,数据更乱。 > 代理绕过暗门开, > 私有方法不理会。 > 事务独立各自飞, > 回滚范围碎成灰。 # 07、优化 ```text V1:三个方法各标事务 → 证据:部分提交 → V2:合并成一个公开方法,事务注解只标一次,并显式指定 rollbackFor ``` V1 的问题在于事务边界太碎,我改成 V2:把整个流程合并成一个公开方法 addVisitFlow,事务注解只标一次。 同时显式指定 rollbackFor = Exception.class,因为业务里可能抛受检异常,默认不回滚。 ```java @Transactional(rollbackFor = Exception.class) public void addVisitFlow(Owner owner, Pet pet, Visit visit) { ownerRepository.save(owner); Pet savedPet = petRepository.save(pet); visit.setPet(savedPet); visitRepository.save(visit); } ``` Controller 改为只调用这一个方法。 ```java @PostMapping("/owners/{ownerId}/visits") public ResponseEntity addVisit(@PathVariable int ownerId, @RequestBody VisitRequest request) { Owner owner = ownerService.findById(ownerId); owner.setLastName(request.getOwnerLastName()); Pet pet = new Pet(); pet.setName(request.getPetName()); pet.setOwner(owner); Visit visit = new Visit(); visit.setDate(request.getDate()); visit.setDescription(request.getDescription()); visitService.addVisitFlow(owner, pet, visit); return ResponseEntity.status(HttpStatus.CREATED).build(); } ``` 再次用同样的 curl 请求,模拟 Pet 名称为空抛异常。 这次日志显示事务回滚,Owner 的 lastName 没有被修改。 示例输出(日志): ```text 2025-01-01 10:00:00.456 ERROR 12345 --- [nio-8080-exec-1] o.s.j.support.JobService : Pet name must not be empty 2025-01-01 10:00:00.457 INFO 12345 --- [nio-8080-exec-1] o.s.orm.jpa.JpaTransactionManager : Initiating transaction rollback 2025-01-01 10:00:00.458 INFO 12345 --- [nio-8080-exec-1] jdbc.sqltiming : UPDATE owners SET last_name='Smith' WHERE id=1 (rolled back) ``` Owner 更新被回滚,数据库三张表都没有变化。 > 合并方法定边界, > 回滚异常显式写。 > 一次事务管到底, > 数据一致心不怯。 # 08、演进 ```text V2:整体事务生效 → 能力:一致性边界清晰 → 遗留:长事务风险,需控制事务内外部调用 ``` V2 解决了回滚问题,但新问题来了:事务范围变大,如果方法里有耗时的外部调用,比如 HTTP 请求保险系统,事务会一直持有数据库连接。 我模拟一个场景:在 addVisitFlow 里调用一个远程保险接口,响应需要 5 秒,期间事务未提交,数据库连接被占用。 用 V1 的同一组请求验证:先发一个正常请求,再发一个失败请求,观察连接池状态。 示例输出(连接池监控): ```text Active connections: 10 Max connections: 10 Waiting threads: 3 ``` 连接池被打满,其他请求排队等待,系统吞吐量骤降。 收益是数据一致性有保障,代价是事务时间变长,连接占用增加。 适用条件是事务内只做数据库操作,外部调用必须移到事务外。 遗留问题是长事务风险,需要设计事务边界时考虑外部依赖。 > 事务变大连接紧, > 外部调用拖时间。 > 连接池满请求等, > 吞吐下降心发慌。 # 09、洞见 ```text 从现象到判断:事务不生效不是注解问题,是代理边界问题;长事务不是事务问题,是架构问题 ``` ## 事务注解是契约,不是实现 ```text 注解 → 代理 → 事务 ``` @Transactional 只是告诉 Spring“这个方法需要事务”,但真正开启事务的是代理对象。 如果调用没经过代理,注解就是一张废纸。 反直觉判断:你写的注解可能根本没生效,但代码不报错,数据却悄悄错。 ## 内部调用是事务失效的头号杀手 ```text this 调用 → 绕过代理 → 事务丢失 ``` 同一个类里,方法 A 调用方法 B,如果 B 标了 @Transactional,B 的事务不会生效。 因为 this 调用直接走原始对象,代理没机会拦截。 反直觉判断:把方法拆得越细,越容易触发这个陷阱,事务边界反而越模糊。 ## 回滚范围由事务边界决定,不由异常决定 ```text 异常 → 事务边界 → 回滚范围 ``` 异常只是触发回滚的信号,真正决定回滚多少数据的是事务边界。 如果边界画小了,异常只能回滚局部,其他已提交的数据无法挽回。 所以设计事务边界时,要问“哪些操作必须同生共死”,而不是“哪里抛异常”。 ## 长事务是连接池的隐形杀手 ```text 事务内 HTTP → 连接占用 → 池耗尽 ``` 事务内做外部调用,数据库连接被白白占用,连接池很快耗尽。 这不是事务的问题,是架构问题:外部调用不该进事务。 判断标准:事务方法里有没有非数据库 I/O,有就要重构。 > 注解契约非实现, > 代理边界要看清。 > 内部调用绕道走, > 长事务里藏祸心。 # 10、系统落地 ```text 入口:HTTP Controller → 服务:VisitService → 本模块:事务边界设计 → 存储:MySQL → 未实现:外部调用异步化、事务监控 ``` Petclinic 原本只有简单的单表 CRUD,事务隐式存在,没人关心边界。 本篇增加了 VisitService 作为事务边界,把 Owner、Pet、Visit 三步写操作纳入一个事务,并验证了回滚。 现在系统能保证多步骤写操作的一致性,还能通过日志观察事务提交和回滚。 下一篇缺的是事务监控和外部调用治理,比如用 Actuator 暴露事务指标,把保险 HTTP 调用移到事务外。 官方文档首页:https://docs.spring.io/spring-boot/index.html > 入口控制接请求, > 服务层里定边界。 > 存储一致有保障, > 外部调用待迁移。 # 11、小结 ```text 三问三答:事务不生效因为代理被绕过;边界应画在 Service 公开方法;选错边界导致部分提交或连接耗尽 ``` 第一问:方法写了 @Transactional 为什么不生效?因为 Spring 事务靠 AOP 代理,内部 this 调用绕过代理,注解形同虚设。 第二问:事务注解该放哪一层?放在 Service 层公开方法上,覆盖完整业务操作,避免拆碎。 第三问:选错边界会怎样?边界太小导致部分提交,数据不一致;边界太大且含外部调用,导致长事务占用连接,拖垮系统。 当前状态:Petclinic 的 Visit 新增已具备整体回滚能力,事务边界清晰,但还需警惕长事务。 > 三问三答心自明, > 代理边界要分清。 > 回滚一致有保障, > 长事务里再修行。 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:为什么 Spring 事务注解在私有方法上不生效? 因为 Spring AOP 基于代理,私有方法无法被代理拦截,调用时直接走原始对象,事务逻辑不会执行。 ## 实战题:在 Petclinic 中,把 VisitService 的 addVisitFlow 方法改成内部调用两个带 @Transactional 的 public 方法,观察事务是否整体回滚。 如果两个 public 方法通过 this 调用,事务不会整体回滚,因为内部调用绕过代理。 ## 排障题:线上出现“Connection is not available, request timed out”,如何排查是否由长事务引起? 先查连接池监控,看活跃连接数是否打满;再查数据库慢查询日志,找长时间未提交的事务;最后检查代码,看事务方法内是否有外部 HTTP 调用。 ## 架构判断题:一个事务方法需要调用第三方保险接口,且要求接口失败时回滚数据库,该如何设计? 不应该把 HTTP 调用放进事务,而应把事务拆成两步:先调用保险接口,成功后再开启事务写数据库;如果接口失败,直接返回错误,不写数据库。 > 作业四题练真功, > 代理边界记心中。 > 长事务里找线索, > 架构设计不盲从。 # 13、升华 ```text 工程结论:事务设计是边界设计,不是注解堆砌;一致性来自清晰的边界和代理的正确使用 ``` 事务不生效的根因不是注解写错,而是对 Spring AOP 代理机制理解不透。 真正的事务设计,是回答“哪些操作必须同生共死”,然后把边界画在 Service 层公开方法上。 长事务问题提醒我们,事务边界不能无限扩大,外部调用必须隔离在事务外。 下一篇可以深入事务传播级别和隔离级别,在 Petclinic 中模拟并发场景,进一步验证边界设计。 > 事务设计是边界, > 代理机制是根基。 > 一致性从边界来, > 架构演进不停息。 **系列项目:** Spring 官方 Petclinic,一个宠物诊所管理系统,服务对象是诊所前台和兽医。 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系、Web 层开发、数据访问与 Repository 设计。 **本篇:** 多步骤写操作的事务边界设计,包括 @Transactional 原理、代理陷阱、回滚验证、长事务风险。 **下一篇:** 事务传播级别与隔离级别实战,在 Petclinic 中模拟并发访问,设计合适的传播行为。
优秀的个人博客,低调大师

《SpringBoot4进阶实战》第20招 Actuator让应用会说话

# PID 还在,应用就活着?Spring Boot 4 Actuator 健康检查实战 ```text 旧方案:运维只看 PID 判断应用存活 → 进程在但业务已死 → 流量黑洞、告警失灵 ``` 我是老李,在深圳做架构师,常年跟 Spring Boot 应用打交道。 Petclinic 上线后,运维反馈:PID 明明在,但用户已经打不开页面了。 冲突问句:PID 存在就等于应用健康吗? 选择问句:该用哪种健康检查机制,才能真实反映业务可用性? 选错后果问句:如果继续只看 PID,流量黑洞会吞掉多少订单? # 01、故事 ```text 凌晨 02:15 → 深圳机房 → 任务是排查 Petclinic 支付接口超时 → 冲突:PID 在,但请求全部卡死 ``` 凌晨两点一刻,深圳机房冷气嗡嗡响。 任务是排查 Petclinic 支付接口超时,监控面板上 PID 还亮着绿灯。 可用户投诉已经刷屏,说页面转圈、下单失败。 我 ssh 上去,ps 看到 Java 进程还在,CPU 却飙到 300%。 再 curl 健康端点,等了 10 秒没响应。 那一刻我意识到:PID 只是进程存活的证据,根本不是业务可用的证明。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 02、问题 ```text 需求变化:从“进程不挂”到“业务可用” → 冲突:PID 无法反映线程池耗尽、DB 断连 → 后果:故障发现延迟、用户流失 ``` Petclinic 从开发环境走向生产,监控需求从“进程不挂”升级为“业务可用”。 但现有监控只看 PID,无法感知线程池耗尽、数据库连接池枯竭、Redis 超时。 后果是故障发现延迟,用户流失,运维背锅。 可验证的验收标准:当 MySQL 停止时,健康检查能在 5 秒内返回 DOWN,且 HTTP 状态码变为 503。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 03、原理 ```text 核心机制:Actuator 健康检查聚合所有 HealthIndicator,通过 HTTP 状态码映射整体状态 ``` Spring Boot Actuator 的 /actuator/health 端点会聚合所有 HealthIndicator。 每个依赖(如 MySQL、Redis)都有自己的 HealthIndicator,返回 UP 或 DOWN。 整体状态由 StatusAggregator 决定:任一 DOWN 则整体 DOWN,HTTP 返回 503。 反直觉判断:liveness 探针检查的是“进程是否该被重启”,readiness 探针检查的是“能否接收流量”,两者语义完全不同。 PID 存在只代表进程活着,不代表线程池可用、数据库连接正常。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 04、架构 ```text 输入:HTTP 请求 /actuator/health → 本模块:HealthIndicator 聚合 → 输出:JSON 状态 + HTTP 状态码 ``` 健康检查架构分三层:端点层、聚合层、指标层。 端点层暴露 HTTP 接口,聚合层调用所有 HealthIndicator,指标层由各依赖的自动配置提供。 收益是统一入口、自动发现依赖、状态可定制。 代价是每个 HealthIndicator 都可能增加响应延迟,需设置超时。 适用条件是生产环境必须区分 liveness 和 readiness,避免误杀。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 05、第一版实战 ```text 环境:Spring Boot 4 + Maven → 配置:添加 actuator 依赖 → 代码:无 → 启动:验证 /actuator/health → V1:基础健康检查 ``` 在 Petclinic 的 pom.xml 中添加依赖: ```xml org.springframework.boot spring-boot-starter-actuator ``` 版本需按当前官方文档核验,Spring Boot 4 中 Actuator 默认只暴露 health。 启动应用: ```bash mvn spring-boot:run ``` 验证请求: ```bash curl http://localhost:8080/actuator/health ``` 示例输出: ```json {"status":"UP"} ``` 成功标准:返回 UP,且 HTTP 状态码 200。 未在当前环境实测,以下为预期结果。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 06、排查 ```text 诊断树:健康检查返回 UP 但业务不可用 → 检查依赖健康 → 发现 MySQL 连接池耗尽 ``` 问题一:健康检查返回 UP,但 Petclinic 页面打不开。 现象:/actuator/health 返回 UP,但 /owners 接口超时。 怀疑:健康检查未覆盖关键依赖。 检查:查看健康详情: ```bash curl http://localhost:8080/actuator/health ``` 示例输出: ```json {"status":"UP"} ``` 证据:没有 db 和 redis 组件。 根因:默认 health 只显示简单状态,未暴露组件详情。 修复:配置显示详情: ```yaml management: endpoint: health: show-details: always ``` 问题二:配置后仍显示 UP,但 MySQL 已停止。 现象:MySQL 服务停止,health 仍 UP。 怀疑:MySQL 的 HealthIndicator 未生效。 检查:查看依赖是否引入: ```bash mvn dependency:tree | grep mysql ``` 证据:mysql-connector-j 存在,但 health 无 db 组件。 根因:Spring Boot 4 中,DataSource 健康检查需要 spring-boot-starter-jdbc 或 data-jpa。 修复:确认 Petclinic 已引入 spring-boot-starter-data-jpa。 **错误尝试:** 直接重启应用,以为能恢复,但 MySQL 未启动,重启后 health 仍 UP。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 07、优化 ```text {V1→证据→V2:配置 show-details,暴露 db、redis、自定义组件健康} ``` V1 只返回简单 UP,无法诊断。 证据:curl 输出只有 status,没有组件信息。 V2 配置 show-details: always,并添加 Redis 依赖: ```yaml management: endpoint: health: show-details: always ``` 添加 Redis 依赖: ```xml org.springframework.boot spring-boot-starter-data-redis ``` 重启后验证: ```bash curl http://localhost:8080/actuator/health ``` 示例输出: ```json { "status": "DOWN", "components": { "db": {"status": "UP"}, "redis": {"status": "DOWN"} } } ``` 现在能准确反映依赖状态。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 08、演进 ```text {V2→能力:区分 liveness/readiness → 遗留:自定义健康检查未实现} ``` V2 后,健康检查能反映依赖状态,但无法区分“进程该重启”和“能否接流量”。 演进:配置 liveness 和 readiness 探针: ```yaml management: endpoint: health: probes: enabled: true ``` 验证: ```bash curl http://localhost:8080/actuator/health/liveness curl http://localhost:8080/actuator/health/readiness ``` 示例输出: ```json {"status":"UP"} ``` 收益:K8s 能正确重启或摘流量。 代价:需要理解探针语义,避免误配置。 遗留:保险服务的健康检查尚未实现。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 09、洞见 ```text 从现象到判断:PID 是进程级信号,健康检查是业务级信号,两者不可混用 ``` ## 反直觉判断:liveness 探针失败不代表应用不可用 ```text liveness 失败 → 重启;readiness 失败 → 摘流量;两者混淆 → 频繁重启或流量黑洞 ``` liveness 探针检查的是进程是否死锁或卡死,失败时 K8s 会重启 Pod。 readiness 探针检查的是能否接收流量,失败时 K8s 会从 Service 摘除。 如果 liveness 检查了数据库连接,数据库抖动会导致 Pod 被重启,而不是优雅降级。 反直觉的是:liveness 应该只检查进程内部状态,不检查外部依赖。 ## 反直觉判断:健康检查的 HTTP 状态码比 JSON 内容更重要 ```text 200 = UP,503 = DOWN;K8s 只看状态码,不看 body ``` K8s 探针只关心 HTTP 状态码,200 表示成功,其他表示失败。 即使 JSON 里 status 是 DOWN,如果 HTTP 返回 200,K8s 也会认为健康。 所以配置健康检查时,必须确保 DOWN 时返回 503。 Spring Boot 默认如此,但自定义 HealthIndicator 时容易忽略。 ## 健康检查是系统信号,不是业务指标 ```text 健康检查回答“能不能服务”,业务指标回答“服务得好不好” ``` 健康检查是二值的,UP 或 DOWN。 业务指标如响应时间、错误率是连续的,需要监控系统处理。 不要用健康检查替代业务监控,两者互补。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 10、系统落地 ```text 入口:K8s 探针 → 服务:Petclinic → 本模块:Actuator 健康检查 → 存储:MySQL/Redis → 未实现:保险服务健康检查 ``` Petclinic 原本只有 PID 监控,无法感知依赖故障。 本篇增加了 Actuator 健康检查,能反映 MySQL、Redis 状态。 现在能做的:通过 /actuator/health 实时查看依赖健康,K8s 能正确摘除故障实例。 下一篇缺什么:保险服务的健康检查,需要自定义 HealthIndicator。 官方文档:https://docs.spring.io/spring-boot/docs/current/reference/html/actuator.html > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 11、小结 ```text 三问三答:PID 不等于健康;健康检查需区分 liveness/readiness;选错后果是流量黑洞 ``` 冲突问句:PID 存在就等于应用健康吗? 答:不等于,PID 只代表进程存活,不代表线程池、数据库、Redis 可用。 选择问句:该用哪种健康检查机制? 答:用 Actuator 健康检查,并区分 liveness 和 readiness 探针。 选错后果问句:如果继续只看 PID? 答:流量黑洞持续,故障发现延迟,用户流失。 当前状态:Petclinic 已具备基础健康检查能力,能反映依赖状态。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 12、作业 ```text 理解→实战→排障→架构判断 ``` ## 理解题:为什么 PID 存在不能代表应用可以继续接流量? PID 存在只代表操作系统认为进程还活着,但线程池可能已耗尽、数据库连接可能已断开、JVM 可能已死锁。 这些情况都会导致请求无法处理,但 PID 不会消失。 ## 实战题:为 Petclinic 添加 Redis 健康检查,并验证关闭 Redis 后 health 状态变化 添加 spring-boot-starter-data-redis 依赖,配置 show-details: always。 启动应用后,用 `redis-cli shutdown` 关闭 Redis,再 curl /actuator/health,观察 redis 组件状态变为 DOWN。 ## 排障题:健康检查返回 UP,但业务接口超时,如何排查? 先查看 /actuator/health 的详情,确认 db、redis 组件状态。 再查看 /actuator/metrics 和 /actuator/threaddump,检查线程池和 JVM 状态。 最后用 jstack 查看线程堆栈,定位死锁或阻塞。 ## 架构判断题:在 K8s 中,liveness 探针是否应该检查数据库连接? 不应该。liveness 探针失败会导致 Pod 重启,数据库抖动会引发频繁重启。 应该用 readiness 探针检查数据库连接,失败时摘除流量,保留 Pod 等待恢复。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 # 13、升华 ```text 工程结论:健康检查是生产可用的第一道防线,必须从 PID 思维升级到业务可用性思维 ``` PID 是进程级信号,健康检查是业务级信号,两者不可混用。 Spring Boot Actuator 提供了标准化的健康检查机制,但需要正确配置和语义理解。 下一篇将深入自定义 HealthIndicator,实现保险服务的健康检查。 > 进程在,心已死, > 流量黑洞吞订单。 > 只看 PID 如盲人, > 健康检查方见真。 **系列项目:** Spring Petclinic 生产级演进 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系、Web 安全、数据访问、事务管理 **本篇:** Actuator 健康检查,区分 liveness/readiness,实现 MySQL/Redis 健康检查 **下一篇:** 自定义 HealthIndicator,实现保险服务健康检查

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第15招 异步定时和虚拟线程

# Petclinic 异步通知与每日就诊提醒:从线程池到虚拟线程的工程演进 ```text 旧方案:同步发送提醒 + 默认线程池 + 无界队列 冲突:一个 10 分钟定时任务拖住后续任务,线程膨胀压垮数据库 后果:提醒延迟、连接耗尽、服务雪崩 ``` Petclinic 现在每天要提醒宠主带宠物复诊,还要在预约变更后异步发通知。 我是老李,负责把官方教学项目改造成能扛住真实流量的生产级应用。 团队第一版用 `@Scheduled` 直接查库发邮件,结果某天一个慢查询跑了 10 分钟,后面所有提醒全部延迟。 为什么一个执行 10 分钟的定时任务可能拖住后面的任务? 为什么无限增加线程又可能把下游数据库压死? 如果选错线程池或拒绝策略,提醒会丢、数据库会崩,我们该怎么选? # 01、故事 ```text 周一 09:00 → 宠物医院运营部 → 发送每日就诊提醒 → 慢查询拖垮整批任务 ``` 周一早上九点,运营同事在群里催:今天的复诊提醒还没发出去。 任务是每天上午给所有当天有预约的宠主发提醒,同时异步通知预约变更。 我打开日志,发现定时任务线程卡在一条统计查询上,已经跑了 10 分钟。 后面的提醒任务全部排队,运营群里消息越来越多,数据库连接池也开始告警。 > 晨会群里催声急, > 慢查一跑全排队。 > 线程池里无空闲, > 提醒还在数据库。 # 02、问题 ```text 需求变化:同步发送 → 每日定时 + 异步通知 冲突:单线程调度 + 共享执行器 + 无界队列 后果:慢任务拖尾、线程膨胀、下游连接耗尽 ``` 原方案是请求里同步发邮件,现在要改成每天定时批量提醒,还要在预约变更后异步发通知。 失效原因是定时任务和异步通知共用默认执行器,一个慢任务占住线程,后续任务只能排队。 更糟的是,为了缓解排队,有人把线程池调大,结果并发查库把数据库连接池打满。 可验证的验收标准是:单条慢任务不能阻塞其他提醒,数据库并发连接数不超过 20,提醒延迟不超过 30 秒。 > 慢查占线十钟, > 后队排成长龙。 > 加线程解一时, > 下游先被打崩。 # 03、原理 ```text 调度线程 → 任务队列 → 工作线程池 → 阻塞 I/O → 下游资源 ``` Spring Boot 的 `@Scheduled` 默认由单线程 `TaskScheduler` 执行,一个慢任务会阻塞后续所有调度。 `@Async` 默认使用 `SimpleAsyncTaskExecutor`,它不复用线程,每个任务新建线程,高并发下线程数会失控。 线程池的核心参数是核心线程数、最大线程数、队列容量和拒绝策略。 反直觉的是:队列越大,越容易掩盖慢任务,最终导致请求超时和线程堆积。 JDK 21 的虚拟线程由 JVM 调度,阻塞 I/O 时线程会释放载体线程,适合大量阻塞场景。 但虚拟线程不会让 CPU 密集任务自动变快,因为 CPU 核心数没变。 > 单线程调度如独木, > 慢任务一过全堵住。 > 虚拟线程解阻塞, > CPU 密集仍有限。 # 04、架构 ```text 预约事件 → 异步通知服务 → 专用线程池 → 邮件/短信 定时触发 → 就诊提醒服务 → 批量查询 → 分批发送 ``` 我们把异步通知和定时提醒拆成两个独立执行器,避免互相干扰。 异步通知用虚拟线程执行器,适合大量阻塞 I/O;定时提醒用固定大小线程池,控制数据库并发。 边界是:定时任务只做查询和发送,不做复杂计算;异步通知不直接查大表,只发已准备好的消息。 收益是慢任务隔离、下游并发可控、线程资源弹性伸缩。 代价是配置复杂度上升,需要监控每个执行器的队列和拒绝次数。 适用条件是阻塞 I/O 占比高、任务量波动大、下游有明确并发上限。 > 两条执行路, > 各管各的务。 > 慢查不拖尾, > 并发有定数。 # 05、第一版实战 ```text JDK 21 → Spring Boot 4 → 默认执行器 → @Scheduled + @Async → 验证失败 ``` 我们使用 JDK 21 和 Spring Boot 4,先按最简方式实现。 在 `PetclinicApplication` 上开启 `@EnableAsync` 和 `@EnableScheduling`。 ```java @SpringBootApplication @EnableAsync @EnableScheduling public class PetclinicApplication { public static void main(String[] args) { SpringApplication.run(PetclinicApplication.class, args); } } ``` 创建 `VisitReminderService`,定时查询当天预约并发送提醒。 ```java @Service public class VisitReminderService { private final VisitRepository visitRepository; private final MailService mailService; public VisitReminderService(VisitRepository visitRepository, MailService mailService) { this.visitRepository = visitRepository; this.mailService = mailService; } @Scheduled(cron = "0 0 9 * * *") public void sendDailyReminders() { List visits = visitRepository.findByDate(LocalDate.now()); visits.forEach(v -> mailService.sendReminder(v)); } } ``` 创建 `AppointmentNotificationService`,异步发送预约变更通知。 ```java @Service public class AppointmentNotificationService { @Async public void sendChangeNotification(AppointmentEvent event) { mailService.send(event); } } ``` 启动应用后,手动触发一次慢查询模拟。 ```bash curl -X POST http://localhost:8080/visits/reminders/simulate-slow ``` 示例输出显示定时任务线程被占用,后续任务排队。 ```text 2025-01-06 09:00:00.123 INFO scheduling-1 : sendDailyReminders started 2025-01-06 09:10:00.456 INFO scheduling-1 : sendDailyReminders finished 2025-01-06 09:10:00.457 INFO scheduling-1 : next reminder started after 10 minutes delay ``` 成功标准未达成:慢任务阻塞了后续提醒,延迟超过 30 秒。 > 默认执行器, > 单线走到底。 > 慢查一占线, > 后队全延期。 # 06、排查 ```text 现象:提醒延迟 → 怀疑单线程调度 → 查线程名 → 确认 scheduling-1 被占 现象:线程膨胀 → 怀疑 SimpleAsyncTaskExecutor → 查线程数 → 确认每任务新建线程 ``` 第一个问题是提醒延迟。 怀疑是单线程调度被慢任务占用,检查线程名。 ```bash jstack | grep -A 5 "scheduling" ``` 示例输出显示 `scheduling-1` 线程一直处于 RUNNABLE,执行慢查询。 ```text "scheduling-1" #23 prio=5 os_prio=0 tid=0x00007f9a5c001000 nid=0x1a2b runnable at org.hibernate.Session.query at VisitRepository.findByDate ``` 根因是 `@Scheduled` 默认单线程,慢任务占住唯一调度线程。 第二个问题是异步通知线程膨胀。 怀疑是 `SimpleAsyncTaskExecutor` 不复用线程,检查线程数。 ```bash jcmd Thread.print | grep -c "SimpleAsyncTaskExecutor" ``` 示例输出显示线程数随请求线性增长。 ```text SimpleAsyncTaskExecutor-1 SimpleAsyncTaskExecutor-2 ... SimpleAsyncTaskExecutor-500 ``` 根因是 `@Async` 默认执行器为每个任务新建线程,高并发下线程数失控。 **错误尝试:** 我们曾把 `spring.task.execution.pool.max-size` 调到 200,结果数据库连接池被并发查询打满。 > 查线程名知单线, > 数线程数见膨胀。 > 调大池子更糟糕, > 下游先被打穿。 # 07、优化 ```text V1:默认执行器 + 单线程调度 + 无界队列 证据:scheduling-1 被占 10 分钟,SimpleAsyncTaskExecutor 线程数 500+ V2:专用调度线程池 + 虚拟线程异步执行器 + 有界队列 ``` 我们为定时任务配置专用调度线程池,避免单线程阻塞。 ```yaml spring: task: scheduling: pool: size: 4 thread-name-prefix: petclinic-scheduling- ``` 为异步通知配置虚拟线程执行器,并设置有界队列和拒绝策略。 ```java @Configuration public class AsyncConfig { @Bean(name = "notificationExecutor") public AsyncTaskExecutor notificationExecutor() { ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor(); executor.setVirtualThreads(true); executor.setQueueCapacity(200); executor.setRejectedExecutionHandler(new ThreadPoolExecutor.CallerRunsPolicy()); executor.setThreadNamePrefix("notification-vt-"); executor.initialize(); return executor; } } ``` 在 `@Async` 上指定执行器。 ```java @Async("notificationExecutor") public void sendChangeNotification(AppointmentEvent event) { mailService.send(event); } ``` 定时任务改为分批查询,每批 50 条,控制数据库并发。 ```java @Scheduled(cron = "0 0 9 * * *") public void sendDailyReminders() { Pageable page = PageRequest.of(0, 50); Page visits; do { visits = visitRepository.findByDate(LocalDate.now(), page); visits.forEach(v -> mailService.sendReminder(v)); page = page.next(); } while (visits.hasNext()); } ``` > 调度池分四线, > 异步用虚拟。 > 队列设上限, > 拒绝不丢弃。 # 08、演进 ```text V2:专用调度池 + 虚拟线程 + 有界队列 + 分批查询 能力:慢任务隔离、线程弹性、下游并发可控 遗留:拒绝策略需监控,虚拟线程 CPU 密集场景无优势 ``` 用 V1 同一组请求验证:先模拟慢查询,再触发后续提醒。 ```bash curl -X POST http://localhost:8080/visits/reminders/simulate-slow curl -X POST http://localhost:8080/visits/reminders/trigger-next ``` 示例输出显示慢任务在 `petclinic-scheduling-1` 执行,后续提醒在 `petclinic-scheduling-2` 正常启动。 ```text 2025-01-06 09:00:00.123 INFO petclinic-scheduling-1 : slow reminder started 2025-01-06 09:00:01.456 INFO petclinic-scheduling-2 : next reminder started 2025-01-06 09:00:01.789 INFO petclinic-scheduling-2 : next reminder finished ``` 异步通知线程数不再随请求线性增长,虚拟线程复用载体线程。 ```text notification-vt-1 notification-vt-2 ... notification-vt-20 ``` 收益是慢任务隔离、线程弹性伸缩、数据库并发控制在 20 以内。 代价是配置复杂度上升,需要监控队列深度和拒绝次数。 遗留问题是 `CallerRunsPolicy` 在队列满时会让调用线程执行任务,可能拖慢主流程。 > 慢查不再拖尾, > 线程弹性伸缩。 > 并发有了上限, > 监控还需补全。 # 09、洞见 ```text 从现象到判断:慢任务拖尾 → 单线程调度;线程膨胀 → 默认执行器;下游压垮 → 无界并发 ``` ## 反直觉判断:队列越大越危险 ```text 无界队列 → 任务堆积 → 请求超时 → 线程堆积 ``` 很多人以为队列大能缓冲流量,实际上无界队列会掩盖慢任务,导致请求超时和内存压力。 有界队列配合拒绝策略,才能让系统在过载时快速失败或降级。 ## 反直觉判断:虚拟线程不加速 CPU 密集任务 ```text 虚拟线程 → 阻塞 I/O 释放载体 → 吞吐提升 虚拟线程 → CPU 密集占用载体 → 吞吐不变 ``` 虚拟线程的价值在于阻塞 I/O 时释放载体线程,让少量载体线程支撑大量并发。 但 CPU 密集任务会一直占用载体线程,虚拟线程切换反而增加开销。 ## 定时任务要分批 ```text 全量查询 → 长事务 → 锁表 → 连接占用 分批查询 → 短事务 → 锁释放 → 并发可控 ``` 定时任务一次查全量数据,容易产生长事务和锁竞争。 分批查询能缩短事务时间,控制数据库并发,避免影响在线业务。 > 队列大藏隐患, > 虚拟线有边界。 > 分批查控并发, > 监控才能心安。 # 10、系统落地 ```text 入口:预约变更事件、每日定时触发 服务:AppointmentNotificationService、VisitReminderService 本模块:专用调度池 + 虚拟线程执行器 + 有界队列 + 分批查询 存储:MySQL 预约表、邮件发送记录 未实现:分布式调度、消息队列、死信重试 ``` 原来 Petclinic 只有同步发送邮件,没有定时任务和异步通知。 本篇增加了每日就诊提醒、预约变更异步通知、专用线程池和虚拟线程执行器。 现在能隔离慢任务、控制数据库并发、弹性伸缩阻塞 I/O 线程。 下一篇缺分布式调度和消息队列,单机调度在集群下会重复执行。 官方文档见 Spring Boot 官方文档首页和 GitHub 仓库。 > 从同步到异步, > 从单线到多线。 > 从无界到有界, > 从压垮到可控。 # 11、小结 ```text 三问三答:慢任务拖尾 → 单线程调度;线程膨胀 → 默认执行器;下游压垮 → 无界并发 ``` 为什么一个执行 10 分钟的定时任务可能拖住后面的任务? 因为 `@Scheduled` 默认单线程调度,慢任务占住唯一线程,后续任务排队。 为什么无限增加线程又可能把下游数据库压死? 因为线程数增加会放大并发查询,数据库连接池和锁竞争先达到瓶颈。 选错拒绝策略会怎样? 丢弃策略会丢提醒,调用者执行策略会拖慢主流程,需要按业务选择并监控。 当前状态是定时提醒和异步通知已隔离,数据库并发可控,虚拟线程支撑阻塞 I/O。 > 单线调度是根因, > 无界并发是帮凶。 > 有界队列加监控, > 虚拟线程解阻塞。 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:为什么虚拟线程不能加速 CPU 密集任务? 虚拟线程由 JVM 调度到少量载体线程上,CPU 密集任务会一直占用载体线程,无法释放。 虚拟线程切换反而增加调度开销,吞吐不会提升,甚至可能下降。 ## 实战题:为 Petclinic 配置一个虚拟线程执行器,队列容量 100,拒绝策略为 AbortPolicy,并验证队列满时抛异常。 ```java @Bean(name = "vtExecutor") public AsyncTaskExecutor vtExecutor() { ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor(); executor.setVirtualThreads(true); executor.setQueueCapacity(100); executor.setRejectedExecutionHandler(new ThreadPoolExecutor.AbortPolicy()); executor.initialize(); return executor; } ``` 队列满时提交任务会抛 `TaskRejectedException`,可在日志中验证。 ## 排障题:定时任务延迟,但线程池大小已调到 10,如何定位? 先查调度线程名和状态,确认是否被慢任务占用。 ```bash jstack | grep -A 10 "petclinic-scheduling" ``` 再查数据库慢查询日志,确认慢任务根因。 最后查队列深度和拒绝次数,确认是否队列堆积。 ## 架构判断题:单机定时任务在集群下会重复执行,是否应该立即引入分布式调度? 不一定。如果重复执行不产生副作用,可以先用单机调度加幂等控制。 如果重复执行会导致重复扣款或重复发送,需要引入分布式调度或分布式锁。 > 理解虚拟边界, > 实战配置执行。 > 排障查根因, > 架构看场景。 # 13、升华 ```text 工程结论:线程池是资源管理工具,不是性能银弹 ``` 线程池的核心是隔离和限流,不是无限放大并发。 虚拟线程解决阻塞 I/O 的资源模型问题,但不改变 CPU 密集任务的物理限制。 定时任务要分批、有界、可监控,才能避免拖尾和下游压垮。 下一篇我们将引入分布式调度和消息队列,解决集群下的重复执行和任务可靠性。 > 线程池里藏乾坤, > 有界队列守城门。 > 虚拟线程解阻塞, > 分批查库保安稳。 **系列项目:** Petclinic 宠物医院管理系统 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系、Web 层、安全、数据访问、事务、远程调用、数据库迁移、缓存、并发、日志、测试、Testcontainers、Docker Compose、Actuator、可观测、自定义自动配置、容器构建 **本篇:** 每日就诊提醒与异步通知,专用调度池、虚拟线程执行器、有界队列、分批查询 **下一篇:** 分布式调度与消息队列,解决集群重复执行和任务可靠性

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第17招 测试别全用SpringBootTest

# Petclinic 测试金字塔:从全量 SpringBootTest 到分层切片 ```text 旧方案:所有测试都启动完整 Spring Context → 冲突:测试数量增长后,启动慢、依赖脆弱、故障定位难 → 后果:CI 反馈变慢,开发不敢频繁跑测试,测试系统逐渐失去保护价值 ``` Petclinic 官方项目自带一组测试,但很多团队接手后会把所有测试都写成 `@SpringBootTest`。 我是老李,最近在给一个 Petclinic 改造项目做代码评审,发现测试类里几乎每个用例都加载完整应用上下文。 一开始大家觉得“真实环境最可靠”,可当测试超过 200 个以后,本地跑一遍要十几分钟,CI 经常超时。 为什么“所有测试都是真实 Spring Context”听起来很好,实际却可能得到最慢、最脆弱的测试系统? 应该按什么边界把测试拆成 Pure Unit Test、Web Slice、Data Slice 和完整 @SpringBootTest? 如果选错测试层级,会不会让快速反馈消失,同时让故障定位成本成倍上升? # 01、故事 ```text 周四 23:40 → 公司 CI 服务器 → 修复 Petclinic 账单查询缺陷 → 全量测试跑了 18 分钟还没结束 ``` 晚上十一点多,CI 屏幕上 Petclinic 的测试任务还在转圈。 任务是修复一个账单查询接口的空指针问题,只改了一个 Service 方法。 旁边同事在催发布窗口,运维等着打包,可测试套件像被粘住一样。 我打开日志,发现几百个测试都在重复启动同一个 Spring 上下文,Bean 初始化日志刷了几十屏。 想定位失败用例,却要先从一堆上下文启动耗时里找真正的断言错误。 > 夜深构建仍未归, > 满屏 Bean 载如潮水。 > 只改一行查询错, > 却等全量测试陪。 # 02、问题 ```text 需求变化:测试数量从几十增长到几百 → 冲突:所有用例共享完整 Spring Context 启动成本 → 后果:反馈慢、环境依赖多、失败原因被淹没 ``` 全量 `@SpringBootTest` 会加载所有配置类、数据源、事务管理器、Web 容器和第三方客户端。 测试数量少时,这点开销不明显;数量一多,每个测试类都可能触发新的上下文缓存键。 只要某个 `@MockBean`、`@TestPropertySource` 或 profile 不同,Spring 就会重新创建上下文。 结果 CI 时间线性甚至指数上升,本地开发也不敢频繁跑测试。 可验证的验收标准是:同一组核心用例,分层后总耗时下降 50% 以上,失败日志能直接指向业务断言。 > 真实二字最诱人, > 全量启动却伤身。 > 缓存键变上下文, > 慢与脆从根上生。 # 03、原理 ```text 测试金字塔核心机制:按集成广度分层 → 越底层启动越少 Spring 基础设施 → 越顶层越接近生产,但数量应越少 ``` JUnit Jupiter 负责生命周期与扩展模型,AssertJ 负责可读断言,MockMvc 负责 Web 层切片。 Spring Test 的 `ApplicationContextRunner` 和 `@DataJpaTest` 等切片注解,只加载当前层需要的 Bean。 Pure Unit Test 不启动 Spring,直接 new 对象并注入 Mockito mock,速度最快。 Web Slice 使用 `@WebMvcTest`,只加载 Controller、ControllerAdvice、Filter 等 Web 组件。 Data Slice 使用 `@DataJpaTest`,只加载 JPA 映射、Repository 和嵌入式数据库。 完整 `@SpringBootTest` 加载所有 Bean,适合少量端到端冒烟测试。 反直觉的是:测试越“真实”,并不等于越能快速发现业务错误;真实上下文反而会放大环境噪声。 > 分层不是偷懒计, > 各守边界最清晰。 > 全量只做冒烟用, > 快速反馈靠底层。 # 04、架构 ```text 输入:Petclinic 测试需求 → 本模块:四层测试体系 → 输出:不同启动成本、验证边界与故障定位能力 ``` 第一层 Pure Unit Test 验证 Service、Validator、工具类纯逻辑,不加载 Spring。 第二层 Web Slice 验证 Controller 参数绑定、校验、异常映射和 HTTP 状态码。 第三层 Data Slice 验证 Repository 查询、审计字段和事务回滚行为。 第四层 Full SpringBootTest 验证配置装配、核心链路和外部依赖集成。 收益是启动成本从高到低分布,数量从少到多分布,形成金字塔。 代价是需要团队理解每层边界,避免把同一逻辑重复测试。 适用条件是应用具备清晰分层,Controller、Service、Repository 职责不混乱。 > 四层如塔立工程, > 底层最多顶层精。 > 各测边界不越位, > 快慢分明排障轻。 # 05、第一版实战 ```text 环境:Spring Boot 4 + Java 21 + Maven → 配置:保留官方 Petclinic 依赖 → 代码:先写一个全量 @SpringBootTest 验证账单查询 → 启动:mvn test → 验证:观察 Bean 数量与耗时 → V1:全量测试通过但成本高 ``` 在 `pom.xml` 中确认测试依赖包含 `spring-boot-starter-test`、`spring-boot-testcontainers` 和 `junit-jupiter`。 ```xml org.springframework.boot spring-boot-starter-test test org.springframework.boot spring-boot-testcontainers test ``` 创建全量测试类 `BillingServiceFullContextTest`。 ```java @SpringBootTest class BillingServiceFullContextTest { @Autowired private BillingService billingService; @Test void shouldFindBillByVisitId() { Bill bill = billingService.findByVisitId(100L); assertThat(bill).isNotNull(); assertThat(bill.getAmount()).isPositive(); } } ``` 运行测试并统计上下文启动信息。 ```bash mvn -Dtest=BillingServiceFullContextTest test ``` 示例输出显示加载了大量与账单无关的 Bean。 ```text 示例输出: Started PetclinicApplication in 8.2 seconds Loaded 412 beans ``` V1 测试通过,但一个简单查询也要启动整个应用。 > 全量测试先落地, > 四百 Bean 皆加载。 > 查询一行虽通过, > 八秒启动已嫌多。 # 06、排查 ```text 诊断树:测试慢 → 怀疑全量上下文启动 → 检查 Spring Test 上下文缓存 → 发现不同测试类因注解差异反复重建 → 根因:上下文缓存键不一致 ``` 第一个问题是测试总耗时异常增长。 怀疑是每个测试类都启动新上下文,于是检查测试报告中的上下文缓存命中情况。 ```bash mvn test -Dspring.test.context.cache.max.size=32 -Dspring.test.context.cache.diagnostics=always ``` 日志显示多个上下文键不同,原因是不同测试类使用了不同的 `@MockBean` 或 profile。 ```text 示例输出: Context cache key mismatch due to @MockBean differences ``` 第二个问题是失败日志被启动信息淹没。 检查 CI 日志,发现前 200 行都是 Bean 初始化,真正的断言失败在最后。 根因是全量测试把环境准备和业务验证混在一起。 **错误尝试:** 曾尝试只调大 JVM 堆内存,结果启动时间没明显下降,反而掩盖了上下文重复创建问题。 > 慢病不只在内存, > 缓存键异最伤神。 > 日志翻尽无断言, > 根因藏在上下文。 # 07、优化 ```text V1:全量 @SpringBootTest 验证账单查询 → 证据:412 Bean、8.2 秒启动、失败日志难定位 → V2:拆成 Pure Unit、Web Slice、Data Slice 和少量全量测试 ``` 先为 `BillingService` 写 Pure Unit Test,不启动 Spring。 ```java class BillingServicePureUnitTest { private BillingRepository billingRepository; private BillingService billingService; @BeforeEach void setUp() { billingRepository = mock(BillingRepository.class); billingService = new BillingService(billingRepository); } @Test void shouldReturnBillWhenExists() { Bill bill = new Bill(); bill.setAmount(BigDecimal.TEN); when(billingRepository.findByVisitId(100L)).thenReturn(Optional.of(bill)); Bill result = billingService.findByVisitId(100L); assertThat(result.getAmount()).isEqualByComparingTo("10.00"); } } ``` 再为 Controller 写 Web Slice。 ```java @WebMvcTest(BillingController.class) class BillingControllerWebSliceTest { @Autowired private MockMvc mockMvc; @MockitoBean private BillingService billingService; @Test void shouldReturnBillJson() throws Exception { Bill bill = new Bill(); bill.setAmount(BigDecimal.TEN); when(billingService.findByVisitId(100L)).thenReturn(bill); mockMvc.perform(get("/bills/100")) .andExpect(status().isOk()) .andExpect(jsonPath("$.amount").value(10.0)); } } ``` 为 Repository 写 Data Slice。 ```java @DataJpaTest class BillingRepositoryDataSliceTest { @Autowired private BillingRepository billingRepository; @Test void shouldFindByVisitId() { Bill bill = new Bill(); bill.setVisitId(100L); bill.setAmount(BigDecimal.TEN); billingRepository.save(bill); Optional result = billingRepository.findByVisitId(100L); assertThat(result).isPresent(); assertThat(result.get().getAmount()).isEqualByComparingTo("10.00"); } } ``` 保留一个全量冒烟测试验证核心链路。 ```java @SpringBootTest class PetclinicApplicationSmokeTest { @Test void contextLoads() { } } ``` > 拆开之后天地宽, > 各层只载自家 Bean。 > 单测毫秒即反馈, > 切片秒级可排障。 # 08、演进 ```text V2:四层测试体系 → 能力:按启动成本与验证边界分层 → 遗留:全量测试仍依赖真实数据库或 Testcontainers ``` 用同一组账单查询需求验证前后差异。 Pure Unit Test 不加载 Spring,运行时间通常小于 1 秒。 Web Slice 只加载 Web 相关 Bean,Bean 数量约 30 到 60 个,启动约 2 到 3 秒。 Data Slice 只加载 JPA 相关 Bean,Bean 数量约 40 到 80 个,启动约 2 到 4 秒。 全量测试 Bean 数量超过 400,启动约 8 到 12 秒。 分层后核心测试总耗时从 18 分钟下降到约 6 分钟,失败日志直接显示业务断言。 代价是测试类数量增加,需要维护更多测试文件。 适用场景是持续集成频繁运行、团队需要快速反馈。 遗留问题是全量测试仍依赖数据库状态,下一篇可引入 Testcontainers 固定外部依赖。 > 同组需求前后比, > 耗时减半日志清。 > 分层不是万能药, > 外部依赖待固定。 # 09、洞见 ```text 从现象到判断:测试慢与脆不是硬件问题,而是上下文边界问题 ``` ## 测试速度由上下文启动次数决定,而不是测试数量 ```text 测试数量多 → 上下文缓存命中高 → 速度可接受 上下文键差异多 → 反复启动 → 速度崩塌 ``` 反直觉判断:增加 100 个相同上下文的测试,可能只增加几秒;增加 5 个不同 `@MockBean` 的测试类,可能增加几十秒。 ## 真实上下文会掩盖业务错误 ```text 全量启动 → 环境噪声多 → 失败原因被淹没 切片启动 → 只留当前层 → 断言失败直接可见 ``` 反直觉判断:测试越接近生产,排障体验可能越差,因为失败可能来自任意一个 Bean。 ## 测试金字塔是反馈频率设计 ```text 底层测试多 → 反馈快 → 开发敢频繁跑 顶层测试少 → 反馈慢 → 只做发布前验证 ``` 测试体系的目标不是覆盖所有组合,而是让高频反馈足够快,低频验证足够真实。 > 慢与脆非天命, > 边界不清是根因。 > 分层之后方明白, > 快慢皆在上下文。 # 10、系统落地 ```text 入口:开发者提交代码或本地运行测试 → 服务:Maven Surefire 执行 JUnit Jupiter → 本模块:四层测试体系 → 存储:H2 或 Testcontainers 数据库 → 未实现:外部依赖固定与并行测试 ``` 原来 Petclinic 只有少量官方测试,且多数依赖完整上下文。 本篇增加了 Pure Unit Test、Web Slice、Data Slice 和全量冒烟测试的分层结构。 现在能按启动成本选择测试层级,快速定位 Controller、Service 或 Repository 问题。 下一篇缺少 Testcontainers 固定数据库和消息队列等外部依赖,避免测试受环境漂移影响。 官方文档可参考 Spring Boot 测试主页:https://spring.io/projects/spring-boot > 原是小测不成军, > 今有四层可守城。 > 快速反馈护开发, > 外部依赖待固定。 # 11、小结 ```text 三问三答: 全真实上下文为何慢?→ 上下文缓存键差异导致反复启动 如何分层?→ Pure Unit、Web Slice、Data Slice、Full SpringBootTest 选错后果?→ 反馈慢、排障难、测试系统失去保护价值 ``` 全真实上下文慢,是因为不同测试类注解差异导致 Spring 反复创建上下文。 分层按集成广度划分,底层不启动 Spring,上层只加载当前层 Bean。 选错层级会让快速反馈消失,故障定位成本成倍上升。 当前 Petclinic 测试体系已具备四层结构,核心链路耗时下降,失败日志更清晰。 > 三问皆有解, > 分层是正途。 > 快慢各有位, > 测试护工程。 # 12、作业 ```text 理解→实战→排障→架构判断 ``` ## 理解题:为什么 `@WebMvcTest` 比 `@SpringBootTest` 启动更快? `@WebMvcTest` 只加载 Controller、ControllerAdvice、Filter 等 Web 组件,不加载 Service、Repository、数据源等完整 Bean,因此上 下文更小,启动更快。 ## 实战题:把 Petclinic 的 `OwnerController` 测试从全量改为 Web Slice,并比较 Bean 数量。 使用 `@WebMvcTest(OwnerController.class)`,用 `@MockitoBean` 模拟 `OwnerService`,通过 MockMvc 验证 `/owners` 返 回 200。运行后观察日志中的 Bean 数量,通常从 400 多降到几十个。 ## 排障题:Data Slice 测试通过,但全量测试中 Repository 查询失败,可能是什么原因? 可能是全量测试使用了真实数据库或不同 schema,而 Data Slice 默认使用嵌入式 H2;也可能是全量上下文中有额外配置覆盖了 JPA 属性。检查数据源配置和初始化脚本差异。 ## 架构判断题:是否应该把所有 Service 测试都写成 Pure Unit Test? 不应该。纯逻辑 Service 适合 Pure Unit Test,但涉及事务、审计或复杂 JPA 查询的 Service,需要 Data Slice 或全量测试验证集成行为。 分层依据是验证边界,而不是类名。 > 四题如梯步步高, > 理解实战再排障。 > 架构判断最难得, > 边界清晰方为高。 # 13、升华 ```text 工程结论:测试系统的价值不在于“真实”,而在于反馈速度与故障定位能力的平衡 ``` Petclinic 测试金字塔证明,全量 Spring Context 不是默认选择,而是少量冒烟测试的专用工具。 Pure Unit Test 保护业务逻辑,Web Slice 保护 HTTP 边界,Data Slice 保护持久化边界。 当测试按启动成本分层后,开发才敢频繁运行测试,CI 才能快速反馈。 下一篇将引入 Testcontainers 固定数据库和外部依赖,让全量测试也能稳定可重复。 > 莫把真实当信仰, > 分层方得反馈快。 > 测试如塔守工程, > 快慢相济方不败。 **系列项目:** 基于 Spring 官方 Petclinic 的宠物医院管理系统 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系、Web 层、安全层、数据层、事务管理、远程调用、数据库迁移、缓存、并发控制、日志、测试基础、Testcontainers、Docker Compose、Actuator、可观测、自定义自动配置、容器构建、生产上线 **本篇:** 测试金字塔分层体系,Pure Unit、Web Slice、Data Slice 与全量 SpringBootTest 的边界与成本比较 **下一篇:** 用 Testcontainers 固定外部依赖,提升全量测试稳定性与可重复性

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第18招 Testcontainers替掉假环境

# Testcontainers 真库验证:从 H2 假绿到 MySQL 首分钟失败 ```text 旧方案:H2 兼容模式 + Mock Redis → 测试全绿 → 生产 MySQL 首分钟失败 ``` Petclinic 的测试长期依赖 H2 内存库和 Mock Redis。开发环境跑得飞快,CI 也一路绿灯。 但最近一次发布后,应用连接生产 MySQL 不到一分钟就报错回滚。我是老李,当时被运维拉进排障群,第一反应就是测试环境与生产环境差异太大。 为什么单元测试和 H2 全部通过,程序仍然可能在连接生产 MySQL 的第一分钟就失败? 在 Mock、Fake、H2、Testcontainers 之间,应该按什么测试范围选择,才能既保速度又保真实? 如果继续用 H2 假绿掩盖方言差异,下一次发布会不会直接造成数据损坏或线上事务失效? # 01、故事 ```text 凌晨 02:17 → 生产发布群 → 任务是回滚 Petclinic 新版本 → 冲突是 MySQL 报错但测试全绿 ``` 凌晨两点十七分,发布群突然刷出红色告警。任务是回滚刚上线的 Petclinic 版本。 运维贴出日志:MySQL 语法错误,紧接着事务超时。开发负责人坚持说测试全绿,H2 上跑过几十遍。 群里开始互相甩锅,没人能立刻说清是 SQL 方言问题、Schema 迁移问题,还是连接参数问题。我打开仓库一看,测试配置里赫然写着 H2 兼容模式。 > 夜半红灯照发布, > 测试全绿却翻车。 > 内存库中皆幻象, > 真库方知差异多。 # 02、问题 ```text 需求变化:验证真实 MySQL/Redis 行为 → 冲突:H2 与 Mock 掩盖差异 → 后果:生产首分钟失败 ``` Petclinic 从教学项目演进为生产级应用后,测试目标已经改变。现在必须验证 MySQL SQL 方言、Schema 迁移、事务隔离级别、Redis TTL 等真实行为。 H2 兼容模式只能模拟部分 MySQL 语法,遇到 `ON DUPLICATE KEY UPDATE`、`LIMIT ? OFFSET ? `、特定索引行为时经常静默通过或直接跳过。 Mock Redis 更不会真正执行过期策略。 可验证的验收标准是:CI 中自动拉起真实 MySQL 和 Redis,应用能完成迁移、读写、事务回滚、TTL 过期,且测试结束后容器自动销毁。 > 假库如镜花水月, > 真库似照妖镜悬。 > 方言迁移与事务, > 唯有实境可检验。 # 03、原理 ```text Testcontainers 生命周期:启动容器 → 等待就绪 → 注入连接 → 执行测试 → 销毁容器 ``` Testcontainers 通过 Docker API 启动一次性容器,用 `WaitStrategy` 探测端口或日志,确认服务就绪后再执行测试。 Spring Boot 3.1+ 的 Service Connection 机制能自动识别 `MySQLContainer` 和 `GenericContainer`,把容器连接参数注入 `DataS ource` 和 `RedisConnectionFactory`,无需手写 URL、端口、账号。 反直觉的是:Testcontainers 并不比 H2 慢多少。容器启动约 10~20 秒,但能消除方言差异带来的排障成本,整体工程效率反而更高。 另一个反直觉判断:Mock 适合验证调用契约,但永远无法验证 SQL 执行计划、锁行为、字符集排序规则。 > 容器起落如潮汐, > 真库真缓存真协议。 > 自动注入免硬编码, > 短命依赖可复现。 # 04、架构 ```text 测试进程 → Testcontainers Docker API → MySQL/Redis 容器 → Spring Boot Service Connection → DataSource/RedisConnectionFactory ``` 测试层分为四个边界:测试类声明容器、Testcontainers 管理生命周期、Spring Boot 自动注入连接、应用代码使用真实依赖。 收益是测试环境与生产环境高度一致,能提前暴露方言、迁移、事务、TTL 问题。代价是测试启动时间增加,且 CI 必须支持 Docker。 适用条件是:任何涉及数据库 Schema、SQL 方言、事务行为、缓存过期的集成测试。纯业务逻辑单元测试仍应使用 Mock 或 Fake。 > 分层清晰边界明, > 容器短命却真实。 > 单元测试保速度, > 集成测试保一致。 # 05、第一版实战 ```text 环境:Spring Boot 3.3 + Java 21 + Docker → 配置:testcontainers 依赖 → 代码:MySQLContainer + RedisContainer → 启动:CI Docker → 验证:真实 SQL 与 TTL → V1 ``` 在 `pom.xml` 中加入 Testcontainers 依赖。版本需按当前官方文档核验。 ```xml org.springframework.boot spring-boot-testcontainers test org.testcontainers mysql test org.testcontainers junit-jupiter test ``` 创建测试基类,声明 MySQL 和 Redis 容器。 ```java @Testcontainers @SpringBootTest public abstract class AbstractIntegrationTest { @Container static final MySQLContainer MYSQL = new MySQLContainer<>("mysql:8.4") .withDatabaseName("petclinic") .withUsername("petclinic") .withPassword("petclinic"); @Container static final GenericContainer REDIS = new GenericContainer<>("redis:7.4") .withExposedPorts(6379); @DynamicPropertySource static void registerProperties(DynamicPropertyRegistry registry) { registry.add("spring.datasource.url", MYSQL::getJdbcUrl); registry.add("spring.datasource.username", MYSQL::getUsername); registry.add("spring.datasource.password", MYSQL::getPassword); registry.add("spring.data.redis.host", REDIS::getHost); registry.add("spring.data.redis.port", () -> REDIS.getMappedPort(6379)); } } ``` 编写一个真实 SQL 方言测试。 ```java class OwnerRepositoryIntegrationTest extends AbstractIntegrationTest { @Autowired OwnerRepository ownerRepository; @Test void shouldPersistOwnerWithMySQLDialect() { Owner owner = new Owner(); owner.setFirstName("李"); owner.setLastName("雷"); owner.setCity("深圳"); ownerRepository.save(owner); List found = ownerRepository.findByLastName("雷"); assertThat(found).hasSize(1); } } ``` 运行测试命令。 ```bash mvn -Dtest=OwnerRepositoryIntegrationTest test ``` 示例输出: ```text [INFO] Starting MySQLContainer... [INFO] Container mysql:8.4 started in 12.4s [INFO] Starting RedisContainer... [INFO] Container redis:7.4 started in 3.1s [INFO] Tests run: 1, Failures: 0, Errors: 0, Skipped: 0 ``` V1 成功:真实 MySQL 和 Redis 在测试中启动,应用完成真实读写。 > 容器初起破假象, > 真库真缓存登场。 > 方言迁移皆验证, > 首版落地见真章。 # 06、排查 ```text 诊断树:CI 失败 → 怀疑 Docker 不可用 → 检查 Docker socket → 证据:权限拒绝 → 根因:CI runner 未挂载 socket → 修复:配置 Docker-in-Docker ``` 第一个问题:CI 上测试启动失败,报 `Could not find a valid Docker environment`。 怀疑是 Docker 未安装或权限不足。检查命令: ```bash docker info ``` 示例输出: ```text ERROR: permission denied while trying to connect to the Docker daemon socket ``` 根因是 CI runner 未把 Docker socket 挂载进测试容器。修复方式是在 CI 配置中使用 Docker-in-Docker 或挂载 `/var/run/docker.sock`。 第二个问题:本地测试通过,但 CI 上 MySQL 容器启动超时。 怀疑是镜像拉取慢。检查日志: ```text Waiting for database connection to become available at jdbc:mysql://localhost:33061/petclinic ``` 根因是 CI 网络拉取 `mysql:8.4` 镜像耗时超过默认等待时间。修复方式是增加 `withStartupTimeout(Duration.ofSeconds(120))`。 **错误尝试:** 一开始把 MySQL 容器端口固定为 3306,结果本地已有 MySQL 占用端口,容器启动失败。后来改为动态端口映射才解决。 > 排查如剥洋葱皮, > 层层深入见根因。 > 权限网络与端口, > 皆是容器常见坑。 # 07、优化 ```text V1:手动 DynamicPropertySource → 证据:硬编码账号密码 → V2:Spring Boot Service Connection 自动注入 ``` V1 中手动注册属性虽然可用,但账号密码硬编码在测试类里,且每个容器都要写一遍。 Spring Boot 3.1+ 提供 Service Connection 机制,能自动识别容器并注入连接参数。优化后测试基类大幅简化。 ```java @Testcontainers @SpringBootTest public abstract class AbstractIntegrationTest { @Container @ServiceConnection static final MySQLContainer MYSQL = new MySQLContainer<>("mysql:8.4") .withDatabaseName("petclinic"); @Container @ServiceConnection static final GenericContainer REDIS = new GenericContainer<>("redis:7.4") .withExposedPorts(6379); } ``` 移除 `@DynamicPropertySource` 后,Spring Boot 自动把容器连接参数注入 `DataSource` 和 `RedisConnectionFactory`。 账号密码由容器随机生成,不再硬编码。 > 手动注入多繁琐, > 自动连接更从容。 > 账号密码随机化, > 安全简洁两相融。 # 08、演进 ```text V2:Service Connection 自动注入 → 能力:CI 自动拉起真实依赖 → 遗留:容器启动时间与镜像缓存 ``` 用 V1 同一组测试请求前后验证。V1 需要手动注册属性,V2 只需声明 `@ServiceConnection`。 测试结果一致,但代码量减少约 40%,且消除了硬编码账号密码的安全隐患。 收益是 CI 能自动拉起一套真实但短命的应用依赖,测试环境与生产环境差异大幅缩小。代价是每次测试多花 15~20 秒启动容器。 遗留问题是容器镜像缓存策略尚未优化,冷启动时拉取镜像可能拖慢 CI。 > 自动注入减负担, > 真实依赖可复现。 > 镜像缓存待优化, > 短命容器护平安。 # 09、洞见 ```text 从 H2 假绿到 Testcontainers 真验证,核心是测试环境与生产环境的一致性工程 ``` ## 测试金字塔的底座必须是真实依赖 ```text 单元测试 Mock → 集成测试 Testcontainers → 端到端测试真实环境 ``` 单元测试用 Mock 验证业务逻辑,集成测试必须用 Testcontainers 验证真实依赖。H2 只能作为本地快速冒烟,不能作为发布依据。 ## 反直觉判断:Testcontainers 的慢是工程效率的加速器 ```text 容器启动 15 秒 → 消除方言差异排障 3 小时 → 净收益为正 ``` 很多人认为 Testcontainers 拖慢测试。实际上,一次生产方言事故的排障成本远超容器启动时间。 ## 反直觉判断:Service Connection 的价值不在少写代码,而在消除配置漂移 ```text 硬编码 URL → 环境差异 → 配置漂移 → 自动注入 → 单一事实来源 ``` 自动注入的真正价值是让连接参数由容器实例决定,而不是由测试代码或配置文件决定,从源头消除配置漂移。 ## 测试范围选择是一个经济决策 ```text Mock 验证契约 → Fake 验证逻辑 → H2 验证映射 → Testcontainers 验证真实行为 ``` 选择哪种测试替身,取决于失败成本和验证目标。涉及方言、迁移、事务、TTL 时,必须用 Testcontainers。 > 假绿如糖衣毒药, > 真验似苦口良方。 > 容器短命却真实, > 工程效率自昭彰。 # 10、系统落地 ```text 测试入口 → Spring Boot Test → Testcontainers → MySQL/Redis 容器 → 真实数据与缓存 → 未实现:镜像缓存与并行化 ``` 原来 Petclinic 测试依赖 H2 和 Mock Redis,只能验证逻辑正确性。 本篇增加 Testcontainers 与 Service Connection,现在能验证真实 SQL 方言、Schema 迁移、事务行为、Redis TTL。 下一篇缺的是容器镜像缓存策略和测试并行化,以进一步缩短 CI 反馈时间。官方文档可参考 Spring Boot 与 Testcontainers 文档首页。 > 系统落地步步实, > 真实依赖入测试。 > 缓存并行待优化, > 反馈加速正当时。 # 11、小结 ```text 三问三答:H2 假绿因方言差异;按范围选择测试替身;继续假绿将导致生产事故 ``` 为什么 H2 全绿生产仍失败?因为 H2 兼容模式无法覆盖 MySQL 方言、迁移、事务隔离级别等真实行为。 如何选择测试替身?单元测试用 Mock,业务逻辑用 Fake,本地冒烟用 H2,集成测试用 Testcontainers。 选错后果是什么?继续用 H2 假绿,下一次发布可能造成数据损坏、事务失效或线上排障成本飙升。当前状态:CI 已能自动拉起真实 MySQL 和 Redis。 > 三问三答明方向, > 假绿真验自分明。 > 测试范围按需选, > 生产安全有保证。 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:为什么 H2 兼容模式无法替代 Testcontainers 验证 MySQL 方言? H2 兼容模式只模拟部分 MySQL 语法,遇到 `ON DUPLICATE KEY UPDATE`、`LIMIT ? OFFSET ? `、特定索引行为时可能静默通过或跳过,无法验证真实执行计划、锁行为和字符集排序规则。 ## 实战题:在 Petclinic 中为 VetRepository 编写一个 Testcontainers 集成测试,验证真实 MySQL 下的分页查询。 继承 `AbstractIntegrationTest`,注入 `VetRepository`,插入 20 条 Vet 数据,调用分页查询方法,断言返回条数和排序符合 MySQL 方言预期。 ## 排障题:CI 上 Testcontainers 测试报 `Container startup failed`,本地却通过,如何排查? 先检查 CI 是否支持 Docker,执行 `docker info` 确认权限。再检查镜像拉取是否超时,增加 `withStartupTimeout`。最后检查端口冲突,确保使用动态端口映射。 ## 架构判断题:如果团队要求所有测试必须在 30 秒内完成,是否应该放弃 Testcontainers? 不应该。应把 Testcontainers 限定在集成测试层,单元测试仍用 Mock 保持快速。30 秒限制应通过测试分层和并行化解决,而不是牺牲真实依赖验证。 > 理解实战排障题, > 架构判断见真知。 > 容器验证不可弃, > 分层并行两相宜。 # 13、升华 ```text 工程结论:测试环境与生产环境的一致性,是发布安全的最低门槛 ``` Testcontainers 不是银弹,但它把“测试全绿”从心理安慰变成了可验证的事实。 真实依赖的短命容器,让 CI 成为生产环境的第一道防线。下一篇将引入镜像缓存与测试并行化,把反馈时间进一步压缩。 > 假绿终非真保障, > 真验方为护城河。 > 容器短命却有力, > 发布安全自此得。 **系列项目:** Spring 官方 Petclinic 生产级演进 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系、Web/安全/数据/事务、远程调用/数据库迁移/缓存/并发、日志/测试基础 **本篇:** Testcontainers 真库验证与 Service Connection 自动注入 **下一篇:** 容器镜像缓存与测试并行化加速 CI 反馈

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第24招 真正做到生产上线

# 一次完整上线与故障演练:把 Petclinic 收成生产级 Spring Boot 4 ```text 旧方案:功能完成即上线,配置散落、故障靠重启、证据链断裂 冲突:生产流量一进来,超时、池耗尽、慢 SQL、CPU 飙高同时出现 后果:回滚靠猜、排障靠翻日志、恢复靠运气 ``` 前 23 招已经把 Petclinic 从教学项目推到生产门口:配置、安全、迁移、连接池、事务、远程调用、缓存、并发、日志、可观测、镜像、TLS、探针、优雅停机、容量、灰度、回滚都各自落地过。 但“各自落地”不等于“一次上线能扛住”。我是老李,今天要做的不是再讲一个组件,而是把整条链路收口:一次发布、一次演练、一条证据链。 当 SIGTERM 到达时,在途请求真的能完成吗? 当 MySQL、Redis、远程 HTTP、线程池、连接池同时承压时,你能从 Client 一路追到 JVM 吗? 如果选错发布顺序或漏掉一个探针,线上会变成“能启动但不可用”,排障时只能靠重启,回滚时才发现旧版本数据不兼容,这个后果你接得住吗? # 01、故事 ```text 周五 22:40 → 生产发布窗口 → 任务:灰度 v2.4.0 并完成故障演练 → 冲突:流量刚切 10%,告警群开始刷屏 ``` 周五 22:40,发布窗口只剩 80 分钟。任务是灰度 v2.4.0,同时完成一次真实故障演练。 我坐在电脑前,刚把灰度比例调到 10%,企业微信告警群突然连续弹出:HTTP 超时、连接池耗尽、慢 SQL、CPU 飙高。 运维同事在群里催:“是不是要回滚?”我盯着屏幕,心里清楚:如果现在回滚,今晚的演练就废了;如果不回滚,必须马上拿出证据链。 > 夜深灰度十点开, > 告警如潮四面来。 > 不是代码先崩溃, > 证据未链难下台。 # 02、问题 ```text 需求变化:从“功能可用”到“生产可恢复” 冲突:配置、依赖、流量、故障同时进入系统 后果:单点排障失效,恢复动作互相干扰 ``` 前 23 招的组件在独立验证时都通过,但生产是并发叠加的。 配置中心推送延迟会让旧连接池参数继续生效;MySQL 不可用时,事务重试会放大压力;Redis 故障时,缓存穿透会打爆数据库;远程 HTTP 超时会让 Tomcat 线程全部挂起。 这些故障不是依次出现,而是同时发生。可验证的验收标准只有一条:从 Client 到 JVM,每一步都能拿出时间、线程、连接、SQL、堆的证据,并且恢复动作不互相覆盖。 > 单点排障如隔靴, > 并发故障叠成坡。 > 若问生产何所惧, > 证据链断乱投戈。 # 03、原理 ```text 核心机制:请求生命周期 = 入口 → 容器 → 线程 → 服务 → 缓存/池 → 数据库/远程 → JVM ``` 一次请求在生产里不是“进一个方法”,而是穿过至少七层。 Tomcat 线程从 acceptor 拿到连接后进入工作线程池; 服务层可能先查 Redis,再进连接池拿数据库连接; 远程调用会占用 HTTP 连接池; 事务决定连接何时归还; JVM 决定线程是否被 GC 拖住。 反直觉的是:CPU 飙高往往不是业务代码变慢,而是线程池队列满后,大量线程在锁上自旋或频繁上下文切换。 另一个反直觉判断:优雅停机不是“等所有请求结束”,而是“停止接收新请求,给在途请求一个截止时间,超时则强制中断”。 > 请求七层如渡河, > 层层有池层层波。 > 莫道 CPU 因代码, > 锁上自旋更耗磨。 # 04、架构 ```text 输入:Client 请求 + 故障注入 本模块:发布编排 + 探针 + 优雅停机 + 全链路证据采集 输出:可恢复的灰度版本 + 可追溯的故障报告 边界:不改变业务功能,只改变交付与恢复方式 ``` 这次收口分四层。 最外层是发布编排:配置与 Secret 先于镜像,数据库 Migration 先于应用,灰度比例逐步放大。 中间层是运行时保护:readiness/liveness 探针、Graceful Shutdown、TLS 终止、连接池与线程池上限。 内层是证据采集:Actuator、Metrics、Tracing、日志、线程 dump、堆 dump、慢 SQL 日志。 最底层是恢复动作:回滚、版本升级、容量评估。收益是故障可定位、发布可回退;代价是发布流程变长,演练需要真实流量或压测流量。 > 四层收口如筑城, > 外层发布内层证。 > 若问边界何处止, > 业务不改只改程。 # 05、第一版实战 ```text 环境 → 配置 → 代码 → 启动 → 验证 → V1 ``` 环境:Spring Boot 4.0.x、Java 21、MySQL 8.4、Redis 7.4、Docker Compose v2.30、Kubernetes 1.31(本地 Kind 模拟)。 先准备生产配置与 Secret。 ```yaml # application-prod.yaml spring: datasource: hikari: maximum-pool-size: 20 minimum-idle: 5 connection-timeout: 3000 validation-timeout: 1000 data: redis: timeout: 500ms lettuce: pool: max-active: 16 max-idle: 8 min-idle: 2 threads: virtual: enabled: true server: shutdown: graceful tomcat: threads: max: 200 min-spare: 20 accept-count: 100 connection-timeout: 5000 management: endpoints: web: exposure: include: health,info,metrics,prometheus,threaddump,heapdump,loggers endpoint: health: probes: enabled: true show-details: always ``` ```bash # 生成 Secret 并部署 kubectl create secret generic petclinic-secret \ --from-literal=DB_PASSWORD='prod-db-pass' \ --from-literal=REDIS_PASSWORD='prod-redis-pass' \ -n petclinic # 先跑数据库迁移 kubectl apply -f k8s/migration-job.yaml -n petclinic kubectl wait --for=condition=complete job/db-migration -n petclinic --timeout=120s # 灰度 10% kubectl patch deployment petclinic -n petclinic \ --type='json' -p='[{"op":"replace","path":"/spec/replicas","value":3}]' kubectl set image deployment/petclinic \ petclinic=registry.example.com/petclinic:v2.4.0 -n petclinic ``` 启动后验证探针与优雅停机。 ```bash # 探针验证 curl -s http://petclinic.local/actuator/health/liveness curl -s http://petclinic.local/actuator/health/readiness # 发送 SIGTERM 观察在途请求 kubectl exec -n petclinic deploy/petclinic -- kill -TERM 1 ``` 示例输出: ```text {"status":"UP"} {"status":"UP","components":{"db":{"status":"UP"},"redis":{"status":"UP"}}} 2025-06-13T22:41:02.123Z INFO 1 --- [tomcat-handler-42] o.s.b.w.e.tomcat.GracefulShutdown : Commencing graceful shutdown. Waiting for active requests to complete 2025-06-13T22:41:04.891Z INFO 1 --- [tomcat-handler-42] o.s.b.w.e.tomcat.GracefulShutdown : Graceful shutdown complete ``` V1 成功标准:探针 UP、SIGTERM 后在途请求完成、灰度 10% 流量正常。 > 配置先行密随后, > 迁移完成再放舟。 > 灰度十点如试水, > 停机优雅在途收。 # 06、排查 ```text 诊断树:现象 → 怀疑 → 检查 → 证据 → 根因 → 修复 ``` 演练开始后,我主动注入九类故障,逐个走证据链。 **故障一:错误配置。** 现象是启动后 readiness 一直 DOWN。怀疑配置中心推送了错误值。 ```bash kubectl logs deploy/petclinic -n petclinic --tail=50 | grep -i 'invalid\|error' curl -s http://petclinic.local/actuator/configprops | jq '.contexts.application.beans.spring.datasource' ``` 证据显示 `maximum-pool-size` 被推送成 `-1`,Hikari 拒绝初始化。根因是配置中心里生产环境的值被误改。修复:回滚配置版本,重启 Pod。 **故障二:MySQL 不可用。** 现象是大量请求 500,readiness 变 DOWN。 ```bash kubectl get pods -n petclinic -l app=mysql curl -s http://petclinic.local/actuator/health/readiness | jq ``` 证据是 readiness 里 `db` 组件 `DOWN`,连接超时 3000ms 后快速失败。根因是 MySQL Pod 被驱逐。修复:恢复 MySQL,readiness 自动变 UP。 **故障三:Redis 故障。** 现象是响应变慢,数据库 QPS 飙升。 ```bash redis-cli -h redis.petclinic.svc -a 'prod-redis-pass' ping curl -s http://petclinic.local/actuator/metrics/redis.lettuce.command.latency | jq ``` 证据是 Redis PING 超时,缓存全部 miss,请求穿透到 MySQL。根因是 Redis 内存达到 maxmemory。修复:扩容 Redis 并设置淘汰策略。 **故障四:连接池耗尽。** 现象是请求排队,Tomcat 线程数打满。 ```bash curl -s http://petclinic.local/actuator/metrics/hikaricp.connections.pending | jq curl -s http://petclinic.local/actuator/metrics/hikaricp.connections.timeout | jq ``` 证据是 `connections.pending` 持续大于 0,`connections.timeout` 增长。根因是慢 SQL 占住连接。修复:定位慢 SQL 并加索引。 **故障五:远程 HTTP 超时。** 现象是调用第三方服务的请求全部挂起。 ```bash curl -s http://petclinic.local/actuator/metrics/http.client.requests | jq curl -s http://petclinic.local/actuator/threaddump | jq '.threads[] | select(.threadName|contains("http"))' ``` 证据是 HTTP client 线程全部 `WAITING`,超时配置未生效。 根因是 RestClient 未设置 `requestFactory` 的超时。 修复:配置 `ClientHttpRequestFactorySettings` 超时。 **故障六:线程阻塞。** 现象是 Tomcat 线程全部 BUSY,新请求无法进入。 ```bash curl -s http://petclinic.local/actuator/threaddump | jq '.threads[] | select(.threadState=="RUNNABLE") | .threadName' | head -20 ``` 证据是 200 个 Tomcat 线程全部 RUNNABLE,栈顶指向同一个锁。根因是业务代码里一个同步块内调用了远程 HTTP。修复:缩小同步块范围。 **故障七:慢 SQL。** 现象是数据库 CPU 高,请求 P99 飙升。 ```bash mysql -h mysql.petclinic.svc -u petclinic -p'prod-db-pass' -e "SHOW FULL PROCESSLIST;" curl -s http://petclinic.local/actuator/metrics/jdbc.queries.max | jq ``` 证据是 `SELECT * FROM visits WHERE pet_id = ?` 全表扫描。根因是缺少 `pet_id` 索引。修复:加索引并验证执行计划。 **故障八:CPU 飙高。** 现象是 Pod CPU 接近 limit,请求延迟升高。 ```bash kubectl top pod -n petclinic curl -s http://petclinic.local/actuator/threaddump | jq '.threads[] | select(.threadState=="RUNNABLE") | .stackTrace[0]' | sort | uniq -c | sort -rn | head ``` 证据是大量线程栈顶在 `HashMap.get` 和 `String.hashCode`。根因是缓存 key 拼接产生大量哈希计算。修复:改用固定长度 key 并预计算哈希。 **故障九:Heap 增长。** 现象是 GC 频繁,内存缓慢上涨。 ```bash curl -s http://petclinic.local/actuator/heapdump -o heap.hprof jcmd 1 GC.heap_info jcmd 1 GC.class_histogram | head -20 ``` 证据是 `byte[]` 和 `String` 对象持续增长。根因是日志里打印了完整请求体,且未设置大小上限。修复:限制日志体长度并开启 GC 日志。 **错误尝试:** 在 Redis 故障时,我先尝试重启应用 Pod,结果缓存重建时又打爆数据库,故障扩大。正确做法是先恢复 Redis,再让应用自然恢复。 > 九类故障九条链, > 层层证据层层验。 > 错把重启当解药, > 缓存重建又生烟。 # 07、优化 ```text V1:组件各自可用,但故障叠加时证据链断裂 证据:九类故障中,三类需要人工翻多个系统才能定位 V2:统一证据链 + 恢复顺序 + 启动优化评估 ``` V1 的问题不是组件缺失,而是证据分散。 我把所有故障的排查路径固化成一条命令链:先看 readiness,再看线程 dump,再看连接池 metrics,再看慢 SQL,最后看堆。 ```bash # 一键证据链脚本 #!/bin/bash echo "=== 1. Readiness ===" curl -s http://petclinic.local/actuator/health/readiness | jq echo "=== 2. Thread states ===" curl -s http://petclinic.local/actuator/threaddump | jq '.threads | group_by(.threadState) | map({state: .[0].threadState, count: length})' echo "=== 3. Pool pending ===" curl -s http://petclinic.local/actuator/metrics/hikaricp.connections.pending | jq echo "=== 4. Slow SQL ===" mysql -h mysql.petclinic.svc -u petclinic -p'prod-db-pass' -e "SELECT * FROM sys.statements_with_runtimes_in_95th_percentile LIMIT 5;" echo "=== 5. Heap ===" jcmd 1 GC.heap_info ``` 同时把恢复顺序写进 runbook:先恢复依赖,再恢复应用,最后恢复流量。 ```yaml # runbook.yaml recovery_order: - step: 恢复 MySQL/Redis/远程服务 check: readiness 中对应组件 UP - step: 恢复应用 Pod check: liveness UP 且线程池 pending 归零 - step: 恢复灰度流量 check: 错误率 证据分散如断线, > 一键成链始见全。 > 恢复顺序先依赖, > 启动优化看收益。 # 08、演进 ```text V2:统一证据链 + 恢复顺序 + 启动优化评估 能力:故障可定位、恢复可执行、启动可评估 遗留:AOT/Native/CR 未引入,需持续观测启动指标 ``` 用 V1 同一组请求前后验证。 演练前,九类故障平均定位时间 8 分钟,其中三类需要跨系统翻日志。 演练后,用一键证据链脚本,平均定位时间降到 2 分钟,恢复顺序固定后,故障扩大率从 30% 降到 0。 代价是 runbook 需要持续维护,证据链脚本需要随组件变化更新。 适用条件是:生产流量至少 100 QPS,依赖至少包含 MySQL 和 Redis,团队有 SRE 值班。 遗留问题是 AOT、GraalVM Native Image、Checkpoint/Restore 尚未引入,因为当前启动时间 18 秒、内存 512MB 在业务场景下可接受,弹性收益不明确。 > 八分定位两分收, > 恢复顺序解千愁。 > 启动优化留后手, > 收益不明不强求。 # 09、洞见 ```text 从现象到判断:生产故障不是组件问题,是证据链问题 ``` ## 反直觉判断:CPU 飙高往往不是业务代码变慢 ```text 线程池满 → 锁竞争 → 上下文切换 → CPU 飙高 ``` 九类故障里,CPU 飙高的根因是缓存 key 哈希计算,不是业务逻辑。 线程池队列满后,大量线程在锁上自旋,CPU 消耗在切换而不是执行。 排障时先看线程 dump 的栈顶分布,比先看代码更有效。 ## 反直觉判断:优雅停机不是“等所有请求结束” ```text 停止接收 → 在途请求截止时间 → 超时强制中断 ``` SIGTERM 后,Tomcat 停止接收新连接,给在途请求一个截止时间。 如果请求超过截止时间,会被强制中断,不是无限等待。 所以优雅停机必须配合客户端重试和幂等,否则中断的请求会丢失。 ## 恢复顺序比恢复速度更重要 ```text 先依赖 → 再应用 → 后流量 ``` Redis 故障时先重启应用,缓存重建会打爆数据库。 正确顺序是先恢复 Redis,再让应用自然恢复,最后恢复流量。 恢复顺序写进 runbook,比依赖人的临场判断可靠。 ## 证据链的价值在于“可重复” ```text 一键脚本 → 固定顺序 → 固定输出 ``` 排障不是炫技,是让任何值班的人都能在 2 分钟内拿到同一份证据。 一键证据链脚本的价值不是快,是消除人的差异。 > 现象从来非根因, > 证据链上见假真。 > 恢复顺序先依赖, > 可重复处是金针。 # 10、系统落地 ```text 入口:Client 请求 → Tomcat → Thread → Service → Cache/Pool → DB/Remote → JVM 服务:Petclinic 生产集群 本模块:发布编排 + 探针 + 优雅停机 + 证据链 + 恢复顺序 存储:MySQL、Redis、配置中心、镜像仓库 未实现:AOT、GraalVM Native Image、Checkpoint/Restore ``` 原来 Petclinic 是官方教学项目,只有基本 CRUD 和简单页面。 前 23 招逐步加入配置、安全、迁移、连接池、事务、远程调用、缓存、并发、日志、可观测、镜像、TLS、探针、优雅停机、容量、灰度、回滚。 本篇把这些能力收口成一次完整上线和故障演练:配置与 Secret 先行,数据库 Migration 先于应用,灰度 10% 验证,九类故障走统一证据链,恢复顺序固定。 现在能做什么:环境可复制、代码可理解、数据库可迁移、接口可测试、系统可观测、版本可发布、故障可恢复。 下一篇缺什么:AOT、GraalVM Native Image、Checkpoint/Restore 的启动优化,需要等启动时间、资源或弹性收益明确后再引入。 官方链接:https://github.com/spring-projects/spring-petclinic > 教学项目到生产, > 二十三招始收功。 > 发布演练成一体, > 启动优化待东风。 # 11、小结 ```text 三问三答:冲突、选择、后果 ``` **冲突问:当 SIGTERM 到达时,在途请求真的能完成吗?** 答:能,但有截止时间。`server.shutdown=graceful` 让 Tomcat 停止接收新请求,给在途请求一个窗口期,超时则强制中断。所以必须配合客户端重试和幂等。 **选择问:当 MySQL、Redis、远程 HTTP、线程池、连接池同时承压时,你能从 Client 一路追到 JVM 吗?** 答:能,用一键证据链脚本。先看 readiness,再看线程 dump,再看连接池 metrics,再看慢 SQL,最后看堆。固定顺序,固定输出。 **选错后果问:如果选错发布顺序或漏掉一个探针,线上会变成什么样?** 答:会变成“能启动但不可用”。配置错误会让 readiness 一直 DOWN,漏掉探针会让流量打到未就绪的 Pod,回滚时才发现旧版本数据不兼容。 当前状态:Petclinic 已经是一个环境可复制、代码可理解、数据库可迁移、接口可测试、系统可观测、版本可发布、故障可恢复的生产级 Spring Boot 4 Java 应用。 > 三问三答如对镜, > 冲突选择后果明。 > 生产不是功能毕, > 可恢复处方为赢。 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:优雅停机的截止时间由哪个配置控制?如果请求超过截止时间会怎样? `server.shutdown=graceful` 配合 `spring.lifecycle.timeout-per-shutdown-phase` 控制截止时间。 超过截止时间的请求会被强制中断,客户端会收到连接重置。 所以必须配合客户端重试和幂等,否则中断的请求会丢失。 ## 实战题:在本地 Kind 集群里复现“Redis 故障导致缓存穿透打爆数据库”,并用一键证据链脚本定位根因。 先用 `redis-cli` 设置 `maxmemory 1mb` 并写入大量数据触发淘汰,然后压测 Petclinic 的缓存接口。 观察 MySQL QPS 飙升、响应变慢。 运行一键证据链脚本,先看 readiness 里 redis 组件 DOWN,再看线程 dump 里大量线程阻塞在 Redis 调用,最后看 MySQL 慢 SQL 增多。 根因是缓存全部 miss,请求穿透到数据库。 恢复顺序:先恢复 Redis,再让应用自然恢复。 ## 排障题:生产环境 CPU 飙高,但业务代码没有变更,你会先查什么? 先查线程 dump 的栈顶分布。 用 `curl -s http://petclinic.local/actuator/threaddump | jq '.threads[] | select(.threadState=="RUNNA BLE") | .stackTrace[0]' | sort | uniq -c | sort -rn | head` 看哪个方法栈顶最多。 如果大量线程在锁上自旋或哈希计算,说明是线程池满或缓存 key 设计问题,不是业务逻辑变慢。 ## 架构判断题:AOT、GraalVM Native Image、Checkpoint/Restore 是否应该立即引入? 不应该立即引入。 当前启动时间 18 秒、内存 512MB 在业务场景下可接受,弹性收益不明确。 GraalVM Native Image 需要改造反射和动态代理,Checkpoint/Restore 需要额外基础设施。 只有启动时间、资源或弹性收益明确时才引入,否则会引入不必要的复杂度。 > 理解实战排障题, > 架构判断见高低。 > 莫把优化当必需, > 收益不明且慢提。 # 13、升华 ```text 工程结论:生产级不是组件堆砌,是证据链与恢复顺序的闭环 ``` 这次收口让我看清一件事:前 23 招的每个组件都重要,但真正让系统“生产级”的,是它们之间的证据链和恢复顺序。 配置与 Secret 先行,数据库 Migration 先于应用,灰度 10% 验证,九类故障走统一证据链,恢复顺序固定。 这不是流程的胜利,是工程判断的胜利:知道什么该先做,什么该后做,什么该不做。 AOT、GraalVM Native Image、Checkpoint/Restore 是下一个路口,但只有启动时间、资源或弹性收益明确时才值得走。 Petclinic 从官方教学项目走到今天,已经是一个环境可复制、代码可理解、数据库可迁移、接口可测试、系统可观测、版本可发布、故障可恢复的生产级 Spring Boot 4 Java 应用。 > 二十三招始到今, > 证据链上见真金。 > 生产不是堆组件, > 可恢复处方为心。 **系列项目:** Spring 官方 Petclinic 演进为生产级 Spring Boot 4 Java 应用,服务宠物医院业务。 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系、Web/安全/数据/事务、远程调用/数据库迁移/缓存/并发、日志/测试/Testcontainers/Docker Compose、Actuator/可观测、自定义自动配置、容器构建、生产上线。 **本篇:** 一次完整上线与故障演练,统一证据链与恢复顺序,评估启动优化。 **下一篇:** AOT、GraalVM Native Image、Checkpoint/Restore 启动优化,仅在收益明确时引入。

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第3招 启动链到底做了什么

# 从 SpringApplication.run() 追踪启动链与扫描边界 ```text 旧方案:只背“main 会启动 Spring Boot” 冲突:Bean 消失、启动失败时不知道卡在哪个阶段 后果:排障靠重启,扫描边界靠猜,生产事故定位慢 ``` 很多团队把 Spring Boot 当成黑盒:能启动就上线,启动失败就翻日志最后一行。 我是老李,在 Petclinic 做一次启动链改造时,团队里一位同学把 Repository 挪了个包,接口直接启动失败;另一位同学把配置类放到 root package 外,配置静默失效。 为什么一个只有几行的 main 能拉起整个 Java Web 系统? 移动一个包名,为什么可能导致一批 Bean 消失? 如果选错扫描边界或误判失败阶段,会不会让应用“能启动但不完整”,甚至在生产上带病运行? # 01、故事 ```text 周二 14:30 → 深圳南山工位 → 任务:给 Petclinic 增加启动耗时统计 → 冲突:启动失败日志刷屏,同事催发布 ``` 周二下午,任务是给 Petclinic 增加启动耗时统计,并在启动完成后打印关键组件加载情况。 我刚把 ApplicationRunner 加进去,应用启动到一半就报错。旁边同事等着联调,一直催“先回滚”。 日志里同时出现 Tomcat 端口占用和 Repository Bean 创建失败,我一时分不清应用到底死在哪个阶段。 > 一行 main 起高楼, > 扫描边界定去留。 > 若问故障何处死, > 阶段日志见根由。 # 02、问题 ```text 需求变化:从“能启动”到“可观测启动过程” 冲突:组件出现时机不透明,失败阶段难定位 后果:Bean 缺失、端口冲突、配置错误混在一起,排障无方向 ``` Petclinic 原来只要求能启动。现在需要知道 Tomcat、DataSource、JPA 分别在什么时候出现,还要能主动制造错误并判断失败阶段。 如果只依赖默认行为,一旦包名移动导致扫描范围变化,Bean 会静默消失;如果端口被占,失败发生在 WebServer 阶段;如果配置错误,可能死在 Environment 或 Bean 创建阶段。 可验证的验收标准是:能说出 main 到 ApplicationReadyEvent 的关键阶段,能通过日志区分 Environment、Context、Bean、WebServer 四类失败,并能用 监听器观察生命周期。 > 需求一改黑盒开, > 阶段不明难下台。 > 包移一尺 Bean 失, > 端口一撞服务哀。 # 03、原理 ```text main → SpringApplication → Environment → ApplicationContext → BeanDefinition → Bean → Embedded Server → ApplicationReadyEvent ``` SpringApplication.run() 先准备 Environment,再创建 ApplicationContext,然后加载 BeanDefinition,接着实例化 Bean,最后启动内嵌 Web 服务器并发布 ApplicationReadyEvent。 Tomcat 不会在 Bean 创建前启动;DataSource 和 JPA 组件在 Bean 创建阶段出现;ComponentScan 在 BeanDefinition 阶段决定哪些类会被扫描。 一个反直觉判断是:启动类所在包不是“建议”,而是默认扫描边界。把配置类或 Repository 放到 root package 外,不会报错,但可能完全不生效。 > 环境先立上下文, > 定义后生 Bean 身。 > 服务器起最后问, > 扫描边界定乾坤。 # 04、架构 ```text 输入:main 类与 root package → 本模块:启动链与扫描边界 → 输出:可观测的启动阶段与失败定位 ``` 启动链分四层:Environment 准备、Context 与 BeanDefinition、Bean 实例化、WebServer 启动。 扫描边界由 root package 决定,ComponentScan、ConfigurationPropertiesScan、Entity/Repository 扫描都受它约束。 收益是启动过程可观测、失败阶段可定位;代价是必须理解默认约定,否则容易误判。 适用条件是单体 Spring Boot 应用;如果引入多模块或自定义扫描,需要显式配置。 > 四层启动一条链, > 扫描边界定方圆。 > 约定优于配置好, > 误判代价在眼前。 # 05、第一版实战 ```text 环境:JDK 17 + Spring Boot 3.x + Petclinic → 配置:默认 root package → 代码:ApplicationRunner + 监听器 → 启动 → 验证 → V1 ``` 在 Petclinic 主类所在包 `org.springframework.samples.petclinic` 下新增 `StartupProbe`。 ```java package org.springframework.samples.petclinic; import org.springframework.boot.ApplicationArguments; import org.springframework.boot.ApplicationRunner; import org.springframework.stereotype.Component; @Component public class StartupProbe implements ApplicationRunner { @Override public void run(ApplicationArguments args) throws Exception { System.out.println("PROBE: ApplicationRunner executed"); } } ``` 再新增启动事件监听器。 ```java package org.springframework.samples.petclinic; import org.springframework.boot.context.event.ApplicationReadyEvent; import org.springframework.context.ApplicationListener; import org.springframework.stereotype.Component; @Component public class ReadyListener implements ApplicationListener { @Override public void onApplicationEvent(ApplicationReadyEvent event) { System.out.println("PROBE: ApplicationReadyEvent received"); } } ``` 启动应用。 ```bash ./mvnw spring-boot:run ``` 示例输出: ```text PROBE: ApplicationRunner executed PROBE: ApplicationReadyEvent received ``` 成功标准:应用正常启动,两个探针按顺序打印。 > 探针一放链路明, > 监听一挂时机清。 > 首版虽小能验证, > 后续排障有依凭。 # 06、排查 ```text 诊断树:启动失败 → 看异常类型 → Environment/Context/Bean/WebServer 四选一 → 定位根因 ``` 第一个问题:端口冲突。 现象:启动报 `Port 8080 was already in use`。 怀疑:WebServer 阶段失败。 检查: ```bash lsof -i :8080 ``` 证据:另一个 Java 进程占用 8080。 根因:Tomcat 在 Bean 创建完成后启动,端口冲突导致 WebServer 阶段失败。 修复:停掉占用进程或改端口。 第二个问题:Repository 消失。 现象:启动报 `No qualifying bean of type 'OwnerRepository'`。 怀疑:扫描边界变化。 检查:确认 Repository 是否在 root package 下。 证据:Repository 被移到 `org.springframework.samples.petclinic.extra` 包外。 根因:默认扫描只覆盖 root package 及子包。 修复:移回 root package 或显式配置 `@EnableJpaRepositories`。 **错误尝试:** 第一次遇到端口冲突时,我以为是 Bean 创建失败,反复检查 DataSource 配置,浪费了半小时。 > 端口冲突怪 Bean, > 方向一错白费神。 > 阶段日志先分清, > 根因自然现真身。 # 07、优化 ```text V1:只有探针 → 证据:失败阶段仍靠猜 → V2:增加阶段日志与显式扫描配置 ``` V1 只能观察正常启动,无法定位失败阶段。 在 `application.properties` 中增加启动日志。 ```properties logging.level.org.springframework.boot.context.config=DEBUG logging.level.org.springframework.context.annotation=DEBUG ``` 再显式声明扫描边界,避免包移动导致 Bean 消失。 ```java package org.springframework.samples.petclinic; import org.springframework.boot.autoconfigure.SpringBootApplication; import org.springframework.boot.autoconfigure.domain.EntityScan; import org.springframework.data.jpa.repository.config.EnableJpaRepositories; @SpringBootApplication @EntityScan(basePackages = "org.springframework.samples.petclinic") @EnableJpaRepositories(basePackages = "org.springframework.samples.petclinic") public class PetClinicApplication { public static void main(String[] args) { org.springframework.boot.SpringApplication.run(PetClinicApplication.class, args); } } ``` 这样即使有人移动包,也能通过显式配置快速发现并修复。 > 探针不够加日志, > 扫描边界显式持。 > 包移不再静默失, > 阶段分明好排治。 # 08、演进 ```text V2:阶段日志 + 显式扫描 → 能力:可观测启动链、可定位失败阶段 → 遗留:多模块扫描仍需人工核对 ``` 用 V1 同一组请求验证:正常启动时,两个探针仍按顺序打印;端口冲突时,日志明确显示 WebServer 阶段失败;Repository 移包时,显式扫描配置会直接报错而不是静默失效。 收益是启动过程从黑盒变成白盒,失败阶段可快速定位。 代价是显式配置增加了维护成本,包结构变化时需要同步修改。 遗留问题是多模块项目里,不同模块的扫描边界仍需人工核对,容易遗漏。 > 黑盒一开白盒现, > 阶段分明排障便。 > 显式配置增成本, > 多模块下仍须验。 # 09、洞见 ```text 从现象到判断:启动失败不是“一个错误”,而是“某个阶段的错误” ``` ## 反直觉判断:Bean 消失不一定是配置错,可能是包位置错 ```text 包位置 → 扫描边界 → BeanDefinition → Bean ``` 很多人看到 Bean 缺失就查注解或依赖,其实先查包路径更高效。 ## 反直觉判断:端口冲突不是网络问题,是启动顺序问题 ```text Bean 创建完成 → WebServer 启动 → 端口绑定 ``` 端口冲突说明应用已经走到最后阶段,前面配置和 Bean 都正常。 ## 阶段日志比异常堆栈更接近根因 ```text 阶段日志 → 失败阶段 → 根因 ``` 异常堆栈只告诉你“什么错了”,阶段日志告诉你“在哪一步错了”。 > 包位错时 Bean 失, > 端口冲突末段知。 > 阶段日志胜堆栈, > 根因定位不费时。 # 10、系统落地 ```text 入口:main → 服务:SpringApplication 启动链 → 本模块:阶段观测与扫描边界 → 存储:内存/数据库 → 未实现:多模块自动核对 ``` 原来 Petclinic 只有默认启动行为,没有阶段观测和显式扫描配置。 本篇增加了 ApplicationRunner、启动事件监听器、阶段日志和显式扫描边界。 现在能观察启动链、定位失败阶段、防止包移动导致 Bean 静默消失。 下一篇缺的是多模块项目里自动核对扫描边界的能力。 官方文档:https://docs.spring.io/spring-boot/index.html > 入口一行起全链, > 阶段观测补短板。 > 扫描边界显式定, > 多模块核待下篇。 # 11、小结 ```text 三问三答:main 为何能拉起系统?包名为何影响 Bean?选错边界有何后果? ``` main 能拉起系统,是因为 SpringApplication.run() 按固定阶段完成环境、上下文、Bean 和服务器启动。 包名影响 Bean,是因为默认扫描边界由 root package 决定,移出边界就不会生成 BeanDefinition。 选错边界会导致 Bean 静默消失或配置失效,应用“能启动但不完整”,生产上可能带病运行。 当前状态:Petclinic 已具备启动链观测和显式扫描配置能力。 > 一行 main 有章法, > 包名边界定生杀。 > 选错边界病潜伏, > 显式配置护万家。 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:SpringApplication.run() 的四个关键阶段分别是什么? Environment 准备、ApplicationContext 与 BeanDefinition、Bean 实例化、WebServer 启动。 ## 实战题:在 Petclinic 中新增一个启动事件监听器,打印 ApplicationStartedEvent 和 ApplicationReadyEvent 的时间差。 监听两个事件,记录时间戳并计算差值,打印到控制台。 ## 排障题:应用启动报 `No qualifying bean of type 'VetRepository'`,但 VetRepository 上有 @Repository 注解,可能原因是什么? 最可能原因是 VetRepository 所在包不在 root package 下,默认扫描未覆盖。 ## 架构判断题:把配置类放到 root package 外,应用能启动但配置不生效,这属于什么类型的问题? 属于扫描边界问题,是约定优于配置的典型陷阱,应显式配置扫描路径或调整包结构。 > 四题一过链路清, > 实战排障有准星。 > 架构判断不靠猜, > 边界意识入心经。 # 13、升华 ```text 工程结论:启动链是骨架,扫描边界是血管,阶段日志是听诊器 ``` Spring Boot 的启动链决定了组件出现的顺序,扫描边界决定了哪些组件能出现,阶段日志决定了故障能否被快速定位。 把这三者搞清楚,main 就不再是黑盒,包名移动也不再是玄学。 下一篇将进入依赖与自动配置,看 Spring Boot 如何根据 classpath 自动装配组件。 > 骨架血管听诊器, > 启动排障三件齐。 > 黑盒一开天地阔, > 下篇自动配置启。 **系列项目:** Spring 官方 Petclinic 生产级演进 **已完成:** 环境搭建、启动机制与扫描边界观测 **本篇:** 启动链追踪、阶段日志、显式扫描配置 **下一篇:** 依赖与自动配置机制 以下按示例系列设计,已有能力为示例前置能力,待与前文核对。

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第4招 Starter和版本谁控制

# 只升级一个 Hibernate,为什么可能破坏整套 Spring Boot 兼容关系 ```text 旧方案:每个 Jar 自己声明 version,各组件独立升级 冲突:Hibernate 升级后,其传递依赖与 Spring Boot 托管版本错位 后果:看似只改一个版本,实际破坏整套兼容矩阵,出现运行时异常或启动失败 ``` 在 Spring Boot 项目里,pom.xml 往往只写几个 starter,几乎看不到具体第三方版本号。 真正决定 Tomcat、Jackson、Hibernate、JUnit 版本的,是 Parent、BOM、Dependency Management 与 Plugin Management 共同构成的 版本治理体系。 我是老李,今天在 Petclinic 项目里被一个“只升级 Hibernate”的需求逼着把 Maven 依赖解析彻底查了一遍。 表面上是改一个版本号,背后却牵出 Spring Boot 为什么坚持统一管理整套第三方组件版本。 为什么看起来只升级了一个 Hibernate,却可能破坏整套 Spring Boot 兼容关系? 应该让每个 Jar 自己声明 version,还是交给 Spring Boot 统一托管? 如果选错,会不会出现编译通过、启动失败,甚至上线后才爆发的隐蔽兼容问题? # 01、故事 ```text 周四 23:40 → 研发区 → 升级 Hibernate 修复查询缓存缺陷 → 测试环境启动报 NoSuchMethodError ``` 周四晚上十一点四十,研发区只剩我这排灯还亮着。任务是给 Petclinic 升级 Hibernate,修复一个查询缓存在某些方言下失效的缺陷。 测试同学在群里催:“老李,服务起不来了,报 NoSuchMethodError,明天要压测。”我打开日志,异常栈指向 Hibernate 内部调用,但代码里根本没直接碰那个类。 我第一反应是本地没复现,怀疑测试环境缓存了旧包。清缓存、重打包、再部署,还是同样错误。搜了半天,网上有人说是版本冲突,但没人说清冲突从哪来。 > 夜深灯未熄,版本起风波 > 只改一依赖,全链竟崩落 > 日志藏真凶,缓存背黑锅 > 若问根何在,且向 POM 索 # 02、问题 ```text 需求变化:单独升级 Hibernate 修复缺陷 冲突:Hibernate 新版本传递依赖与 Spring Boot 托管版本不一致 后果:编译通过,运行时 NoSuchMethodError,测试阻塞 ``` Petclinic 原本由 Spring Boot Parent 统一管理 Hibernate 版本。现在业务要求单独升级 Hibernate,等于在兼容矩阵上撕开一个口子。 Hibernate 升级后,它依赖的 Byte Buddy、JPA API、HikariCP 等版本可能不再与 Spring Boot 当前托管版本一致。 Maven 会按“最近优先、先声明优先”等规则重新解析,最终选中的版本可能既不是 Spring Boot 期望的,也不是 Hibernate 官方测试过的。 影响不是编译期,而是运行时。 类存在但方法签名变了,就抛 NoSuchMethodError; 类被移除,就抛 NoClassDefFoundError。 可验证的验收标准是:执行 `mvn dependency:tree` 能看到实际解析版本,执行 `mvn help:effective-pom` 能看到版本来源,启动 Petclinic 后访问 `/ owners` 返回 200。 > 一版升而全链动,看似孤岛实相通 > 编译无声藏暗涌,运行方知万事空 > 若问兼容何处断,依赖树里觅行踪 > 版本从来非孤立,矩阵一破祸无穷 # 03、原理 ```text Parent 定义默认版本 → BOM 集中管理依赖版本 → Starter 引入一组协调依赖 → Dependency Management 约束传递依赖 → Plugin Management 约束构建插件 ``` Spring Boot 的版本治理不是靠“每个 Jar 自己声明 version”,而是靠 Parent 和 BOM 集中约束。 Parent 继承自 `spring-boot-dependencies`,这个 BOM 里用 `dependencyManagement` 声明了数百个第三方组件的版本。 Starter 本身只声明依赖坐标,不写版本号。 比如 `spring-boot-starter-data-jpa` 引入 Hibernate,但版本由 BOM 提供。 这样所有 starter 引入的组件都来自同一套兼容矩阵。 `dependencyManagement` 只约束版本,不真正引入依赖。 只有项目里实际声明了某个依赖,或者某个依赖传递引入了它,版本约束才生效。 `pluginManagement` 同理,只约束插件版本,不激活插件。 反直觉的是:你在项目里显式写一个版本号,不是“更精确”,而是“更危险”。 因为 Spring Boot 测试的是整套版本组合,你单独改一个,等于让 Maven 重新协商所有相关传递依赖,结果可能偏离官方兼容矩阵。 > 版本不在 Jar 中藏,BOM 一表定八方 > Starter 只引不写版,矩阵协调方成纲 > 显式声明非精确,反是裂痕入高墙 > 牵一发而动全身,依赖解析细思量 # 04、架构 ```text 输入:pom.xml 声明的 starter 与显式依赖 本模块:Parent + BOM + Dependency Management + Plugin Management 协同解析 输出:effective-pom 中的最终版本与 dependency:tree 中的实际依赖图 边界:不管理 BOM 未收录的第三方组件,不约束测试运行时独立声明的版本 ``` 这套体系分四层。 最外层是 Parent,它继承 BOM 并设置默认编译参数、插件版本。 第二层是 BOM,集中声明所有托管版本。 第三层是 Starter,按场景引入一组协调依赖。 第四层是项目自身 pom.xml,只声明需要的 starter 和少量显式依赖。 收益是版本一致性强,升级 Spring Boot 版本时,整套第三方组件一起迁移,兼容性由官方保证。代价是灵活性下降,单独升级某个组件需要额外验证。 适用条件是项目主要使用 Spring Boot 官方 starter 覆盖的场景。如果大量使用 BOM 未收录的组件,或者需要长期锁定某个特殊版本,就需要额外管理。 > 四层架构如城防,Parent 为基 BOM 为纲 > Starter 引路不写版,项目声明只点将 > 收益一致代价僵,适用需看场景广 > 边界之外自行管,莫把灵活当良方 # 05、第一版实战 ```text 环境:JDK 17 + Maven 3.9 + Spring Boot 3.x + Petclinic 官方仓库 配置:pom.xml 显式覆盖 hibernate-core 版本 代码:不改 Java 代码,只改 pom.xml 启动:mvn spring-boot:run 验证:curl /owners 观察是否 200 V1:单独升级 Hibernate 到最新版 ``` 先确认当前环境。JDK 17,Maven 3.9,Spring Boot 版本以 Petclinic 官方 pom.xml 为准,需按当前官方文档核验。 第一步,查看当前 Hibernate 版本来源。 ```bash mvn dependency:tree -Dincludes=org.hibernate.orm:hibernate-core ``` 示例输出: ```text [INFO] \- org.springframework.boot:spring-boot-starter-data-jpa:jar:3.3.0:compile [INFO] \- org.hibernate.orm:hibernate-core:jar:6.5.2.Final:compile ``` 第二步,在 pom.xml 里显式覆盖 Hibernate 版本。 ```xml 6.6.0.Final ``` 第三步,重新查看依赖树。 ```bash mvn dependency:tree -Dincludes=org.hibernate.orm:hibernate-core ``` 示例输出: ```text [INFO] \- org.springframework.boot:spring-boot-starter-data-jpa:jar:3.3.0:compile [INFO] \- org.hibernate.orm:hibernate-core:jar:6.6.0.Final:compile ``` 第四步,启动应用。 ```bash mvn spring-boot:run ``` 启动日志出现异常,示例输出: ```text Caused by: java.lang.NoSuchMethodError: 'org.hibernate.cfg.AvailableSettings org.hibernate.cfg.AvailableSettings.set(java.lang.String, java.lang.Object)' ``` 第五步,验证接口。 ```bash curl -i http://localhost:8080/owners ``` 预期返回 500,而不是 200。V1 失败,证明单独升级 Hibernate 破坏了兼容关系。 > 一版在手欲强升,POM 一改便启程 > 依赖树里见新本,启动日志现鬼影 > 方法签名已不在,运行方知路难行 > 若问此错何处起,兼容矩阵已失衡 # 06、排查 ```text 诊断树: 现象:启动报 NoSuchMethodError ├─ 怀疑:测试环境缓存旧包 │ ├─ 检查:mvn clean package 后重新部署 │ └─ 证据:错误依旧,排除缓存 ├─ 怀疑:Hibernate 版本未真正生效 │ ├─ 检查:mvn dependency:tree -Dincludes=org.hibernate.orm:hibernate-core │ └─ 证据:显示 6.6.0.Final,版本已生效 ├─ 怀疑:传递依赖版本错位 │ ├─ 检查:mvn dependency:tree -Dverbose 查看完整依赖图 │ └─ 证据:Byte Buddy 版本仍为 Spring Boot 托管的旧版 └─ 根因:Hibernate 6.6 需要新版 Byte Buddy,但 Spring Boot BOM 仍约束旧版 ``` 第一个问题是启动报 NoSuchMethodError。我怀疑测试环境缓存了旧包,执行 `mvn clean package` 后重新部署,错误依旧,排除缓存。 第二个问题是版本是否真正生效。执行依赖树命令,确认 Hibernate 已经是 6.6.0.Final,版本覆盖成功。 第三个问题是传递依赖是否错位。执行完整依赖树: ```bash mvn dependency:tree -Dverbose -Dincludes=net.bytebuddy:byte-buddy ``` 示例输出: ```text [INFO] \- org.hibernate.orm:hibernate-core:jar:6.6.0.Final:compile [INFO] \- net.bytebuddy:byte-buddy:jar:1.14.15:compile ``` 而 Spring Boot 3.3.0 托管的 Byte Buddy 版本是 1.14.12。 Hibernate 6.6 内部调用了 Byte Buddy 1.14.15 才有的方法,运行时加载的却是 1.14.12,于是抛 NoSuchMethodError。 **错误尝试:** 我一开始以为只要把 Hibernate 版本改回去就行,结果发现业务要求的缺陷修复确实需要新版本。单纯回退不是方案,必须同时升级 Byte Buddy 并验证整套兼容性。 > 先疑缓存后疑版,层层排查步步难 > 依赖树里藏真相,传递版本已错乱 > 回退虽能解燃眉,业务缺陷又复返 > 根因不在单组件,矩阵协调方为安 # 07、优化 ```text V1:只覆盖 hibernate.version 证据:NoSuchMethodError,Byte Buddy 版本错位 V2:同时覆盖 hibernate.version 与 byte-buddy.version,并执行完整测试 ``` V1 的问题是只改了 Hibernate,没改它依赖的 Byte Buddy。V2 需要同时覆盖两个版本,并验证整套兼容性。 修改 pom.xml: ```xml 6.6.0.Final 1.14.15 ``` 重新查看依赖树: ```bash mvn dependency:tree -Dverbose -Dincludes=net.bytebuddy:byte-buddy ``` 示例输出: ```text [INFO] \- org.hibernate.orm:hibernate-core:jar:6.6.0.Final:compile [INFO] \- net.bytebuddy:byte-buddy:jar:1.14.15:compile ``` 启动应用: ```bash mvn spring-boot:run ``` 启动成功,无异常。验证接口: ```bash curl -i http://localhost:8080/owners ``` 返回 200。V2 通过,但代价是项目里多了一个需要长期维护的版本覆盖。 > 一版不够两版齐,Byte Buddy 随 Hibernate 移 > 依赖树里再验证,启动无错接口宜 > 代价虽小须牢记,覆盖越多越难理 > 若非业务强需求,莫把矩阵轻撕离 # 08、演进 ```text V2:同时覆盖 Hibernate 与 Byte Buddy 能力:项目具备单独升级底层组件并验证传递依赖的能力 遗留:覆盖版本越多,与 Spring Boot 官方兼容矩阵偏离越远 ``` V2 的收益是业务缺陷得到修复,同时项目掌握了用 dependency:tree 和 effective-pom 验证版本来源的方法。 代价是每多一个版本覆盖,就多一份与官方矩阵偏离的风险。适用场景是业务确实需要特定版本修复缺陷,且团队有能力执行完整回归测试。 遗留问题是:当前只覆盖了两个版本,如果后续升级 Spring Boot,这两个覆盖可能与新 BOM 冲突,需要重新评估。 用 V1 同一组请求验证:V1 时 `/owners` 返回 500,V2 返回 200。启动日志从 NoSuchMethodError 变为正常启动。 > 从一到二路渐明,能力增长代价生 > 覆盖版本如补丁,补丁越多越难清 > 升级 Boot 须重审,矩阵冲突再权衡 > 灵活与稳常博弈,架构判断要清醒 # 09、洞见 ```text 从现象到判断:NoSuchMethodError 不是单点问题,而是版本矩阵失衡的信号 ``` ## 版本号不是越新越好,而是越协调越好 ```text 单组件最新版 → 传递依赖错位 → 运行时异常 ``` Spring Boot 官方测试的是整套版本组合,不是单个组件的最新版。单独升级一个组件,等于用未测试的组合替换已测试的组合。 ## 反直觉判断:显式声明版本不是更可控,而是更危险 ```text 显式版本 → 打破 BOM 约束 → 依赖重新协商 → 结果不可预测 ``` 很多人以为写死版本号就是“锁定”,但在 Spring Boot 体系里,BOM 才是锁。你显式覆盖一个版本,等于把锁打开,让 Maven 重新协商所有相关传递依赖。 ## 反直觉判断:编译通过不等于兼容 ```text 编译期:类和方法存在 运行期:方法签名或行为已变 ``` Maven 编译只检查类和方法是否存在,不检查方法签名是否完全一致。版本错位导致的 NoSuchMethodError 往往在运行时才爆发。 ## 依赖树是排障的第一现场 ```text 现象 → dependency:tree → 传递依赖版本 → 根因 ``` 遇到版本冲突,先看依赖树,再看 effective-pom。依赖树告诉你实际解析了什么,effective-pom 告诉你版本从哪来。 > 版本非新乃协调,矩阵一破祸难消 > 显式声明非可控,反是裂痕入云霄 > 编译无声藏暗涌,运行方知路迢迢 > 依赖树里寻真相,排障第一现场瞧 # 10、系统落地 ```text 入口:pom.xml 声明的 starter 服务:Maven 依赖解析 本模块:Parent + BOM + Dependency Management + Plugin Management 存储:本地仓库与远程仓库的 Jar 包 未实现:自动化兼容性验证与升级建议 ``` 原来 Petclinic 只是被动继承 Spring Boot Parent,没有显式管理任何第三方版本。 本篇增加了用 dependency:tree 和 effective-pom 追查版本来源的能力,并演示了如何安全覆盖底层依赖版本。 现在项目能回答“这个版本从哪来”“改了会怎样”“怎么验证”三个问题。下一篇还缺的是自动化兼容性验证,比如在 CI 里跑依赖分析,防止版本覆盖被无意引入。 官方链接:Spring Boot 主页 https://spring.io/projects/spring-boot ,Petclinic GitHub https://github.com/spri ng-projects/spring-petclinic ,Spring Boot 文档 https://docs.spring.io/spring-boot/documentation.html > 入口声明服务解析,本模块里矩阵立 > 存储仓库 Jar 满地,未实现处待补齐 > 原来被动承版本,如今主动查根底 > 自动化验证未至,CI 防线需建立 # 11、小结 ```text 三问三答: 为什么只升级一个 Hibernate 可能破坏整套兼容关系? 应该统一托管还是各自声明? 选错会怎样? ``` 第一问:因为 Hibernate 有传递依赖,单独升级它会打破 Spring Boot BOM 约束的版本矩阵,导致传递依赖版本错位,运行时抛 NoSuchMethodError。 第二问:应该统一托管。Spring Boot 官方测试的是整套版本组合,各自声明 version 会让 Maven 重新协商依赖,结果不可预测。 第三问:选错会导致编译通过、启动失败,甚至上线后才爆发隐蔽兼容问题。当前状态是 V2 已修复,但项目里多了两个版本覆盖,需要长期维护。 > 一问根因在矩阵,牵一发而动全身 > 二问托管胜各自,协调方得安稳存 > 三问选错藏暗涌,上线方知祸已深 > 当前 V2 虽已稳,覆盖维护须留神 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:为什么 Spring Boot 不希望每个 Jar 自己声明 version? 因为每个 Jar 自己声明 version 会让 Maven 按“最近优先、先声明优先”等规则重新协商依赖,最终选中的版本组合可能不是 Spring Boot 官方测试过的。 统一托管能保证整套组件来自同一兼容矩阵,升级 Spring Boot 时一起迁移,兼容性由官方保证。 ## 实战题:在 Petclinic 里执行 dependency:tree 和 effective-pom,找出 Tomcat、Jackson、JUnit 的版本来源。 执行 `mvn dependency:tree -Dincludes=org.apache.tomcat.embed:tomcat-embed-core,com.fasterxml.jackson.c ore:jackson-databind,org.junit.jupiter:junit-jupiter` 查看实际版本。 执行 `mvn help:effective-pom` 搜索这些组件,会发现版本都来自 `spring-boot-dependencies` BOM 的 `dependencyManagement`。 ## 排障题:启动报 NoSuchMethodError,如何用 Maven 命令定位根因? 先执行 `mvn dependency:tree -Dverbose` 查看完整依赖图,找到异常类所在的 Jar 及其版本。 再执行 `mvn help:effective-pom` 查看该版本从哪来。 对比 Spring Boot 官方 BOM 中的版本,确认是否被显式覆盖或传递依赖错位。 ## 架构判断题:项目里已经有 10 个版本覆盖,是否应该继续单独升级组件? 不应该。版本覆盖越多,与 Spring Boot 官方兼容矩阵偏离越远,升级 Spring Boot 时冲突风险越大。 应该优先考虑升级整个 Spring Boot 版本,让官方矩阵一起迁移。 如果业务确实需要特定版本,应集中管理覆盖并建立自动化兼容性验证。 > 理解版本矩阵意,实战命令查根底 > 排障先看依赖树,架构判断莫偏离 > 覆盖越多险越积,整体升级方为宜 > 四题做完回头看,版本治理心中记 # 13、升华 ```text 工程结论:版本治理的本质是协调,不是控制 ``` Spring Boot 的 Parent、BOM、Starter、Dependency Management 和 Plugin Management 不是限制,而是把“每个 Jar 自己声明 vers ion”的混乱,变成“整套组件统一协调”的秩序。 单独升级一个 Hibernate 之所以危险,是因为它打破了这种协调。 工程上要做的不是禁止升级,而是升级前用 dependency:tree 和 effective-pom 看清影响,升级后用完整测试验证兼容。 下一篇将进入配置体系,看 Spring Boot 如何用外部化配置管理环境差异,让同一套代码在不同环境安全运行。 > 版本治理非控制,协调方得安稳存 > 矩阵一破祸暗涌,依赖树里寻根因 > 升级非禁须验证,看清影响再前行 > 配置体系下一篇,环境差异待分明 **系列项目:** Spring 官方 Petclinic,服务宠物医院诊疗与宠物主管理场景 **已完成:** 环境搭建、启动机制、依赖与自动配置、Maven 版本治理与依赖解析 **本篇:** 用 dependency:tree 与 effective-pom 追查版本来源,演示安全覆盖底层依赖版本 **下一篇:** 配置体系与外部化配置管理环境差异 以下按示例系列设计,已有能力为示例前置能力,待与前文核对。

优秀的个人博客,低调大师

《SpringBoot4进阶实战》第6招 配置体系必须讲透

# Petclinic 外部化配置实战:一个 Jar 走三套环境 ```text 旧方案:每个环境改一次 application.properties 再重新打包 冲突:开发、测试、生产三套配置混在代码仓库,改错一行就带病上线 后果:同一个 Jar 无法复用,发布变成高风险手工操作 ``` Petclinic 现在能启动、能访问页面,但配置还停留在“改文件、重新打包”的阶段。 开发库、测试库、生产库的连接串、账号、日志级别全都写死在 `application.properties` 里。 每次切换环境都要改代码、重新构建,发布流程又慢又容易出错。 我是老李,今天要带团队把 Petclinic 的配置从“写死”升级到“外部化”。目标不是背优先级表,而是让同一个 Jar 包在不同环境里通过外部输入获得不同行为。 为什么同一个 Jar 可以部署到开发、测试和生产,而不应该每个环境重新打一次包? 当文件、环境变量、启动参数同时提供同一个属性时,应该相信谁? 如果选错了配置来源,或者把密码和普通配置混在一起,会带来什么后果? # 01、故事 ```text 周五 18:40 → 发布窗口只剩 20 分钟 → 任务:把 Petclinic 切到生产数据库 → 冲突:生产库密码还在代码仓库里 ``` 周五傍晚,办公室只剩键盘声。 运维同事在群里催:“生产发布窗口到 19 点,Petclinic 的数据库连接串改好了吗? ”我打开 `application.properties`,看到生产库地址和密码就躺在里面,旁边还有一行注释“上线前记得改”。 任务是让 Petclinic 连上生产库,但生产密码不该出现在代码仓库里。我翻遍项目,没有环境变量覆盖,没有启动参数注入,只有一份写死的配置文件。时间一分一秒过去,发布窗口越来越近。 > 暮色压窗催上线, > 配置写死难两全。 > 密码躺在仓库里, > 改错一行夜难眠。 # 02、问题 ```text 需求变化:一套代码要跑开发、测试、生产三个环境 冲突:配置写死在 Jar 内,环境差异无法在运行时注入 后果:每环境重新打包,配置漂移,密码泄露风险 ``` Petclinic 从“本地能跑”进入“多环境部署”阶段,需求变了。 开发库、测试库、生产库的地址不同,日志级别不同,缓存策略不同。 但当前所有差异都靠改 `application.properties` 解决,改完还要重新 `mvn package`。 这种做法的失效原因很直接:配置和代码耦合在一起,环境差异被硬编码进构建产物。 同一个 Jar 无法在不同环境复用,每次发布都依赖人工改文件,容易改错、漏改。 更严重的是,生产密码进入 Git 历史,泄露风险不可控。 可验证的验收标准是:构建一次 Jar,分别用文件、环境变量、启动参数覆盖同一个属性,最终取值符合预期;密码类配置与普通配置分离,不进入代码仓库。 > 一包欲行三处路, > 配置却锁死仓库中。 > 环境差异成包袱, > 发布如走钢丝绳。 # 03、原理 ```text Spring Environment 聚合多个 PropertySource,按优先级解析属性 ``` Spring Boot 的外部化配置核心是 `Environment`。 它不是一个简单的 `Map`,而是一组有序的 `PropertySource` 列表。 每个来源——命令行参数、环境变量、配置文件、默认值——都是一个 `PropertySource`,按固定顺序排列。 解析属性时,Spring 从最高优先级的来源开始找,找到就返回,找不到再往下找。 命令行参数通常高于环境变量,环境变量高于 `application.yml`,配置文件高于代码里的默认值。 这个顺序不是魔法,是 `SpringApplication` 启动时显式构建的。 一个反直觉判断:配置文件里写了 `server.port=8080`,启动时加 `--server.port=9090`,最终生效的是 9090,但 `application.properties` 里的 8080 并没有被“覆盖”或“删除”。 它还在,只是被更高优先级的来源挡住了。 理解这一点,才能理解为什么同一个 Jar 能适配多环境。 > 配置非图亦非表, > 层层来源叠成桥。 > 高者先声低者默, > 一包行遍路千条。 # 04、架构 ```text 外部输入(文件/环境变量/参数)→ Environment → 类型安全配置类 → 业务组件 ``` 本模块的边界很清晰:外部输入只负责提供原始值,`Environment` 负责聚合和排序,类型安全配置类负责绑定和校验,业务组件只依赖配置类,不直接读 `Environment`。 分层带来的收益是:业务代码与配置来源解耦,配置类可以独立测试,校验逻辑集中管理。代价是引入了一层间接性,简单属性也要经过绑定和校验。 适用条件是:应用需要多环境部署,或者配置项超过十几个,或者存在密码、Token 等敏感值。如果只是本地玩具项目,直接 `@Value` 也够用。 > 外部输入归一处, > 类型安全立门户。 > 业务只认配置类, > 来源变更不惊鹭。 # 05、第一版实战 ```text 环境:JDK 17 + Spring Boot 3.x + Petclinic 官方仓库 配置:新增 application.yml + PetclinicProperties 配置类 代码:@ConfigurationProperties + @Validated 启动:mvn spring-boot:run 验证:curl 接口观察属性取值 ``` 先确认当前环境。 Petclinic 官方仓库基于 Spring Boot 3.x,JDK 17。 在 `pom.xml` 中确认已有 `spring-boot-configuration-processor` 依赖,如果没有则添加: ```xml org.springframework.boot spring-boot-configuration-processor true ``` 在 `src/main/resources/application.yml` 中定义业务配置: ```yaml petclinic: greeting: "Welcome to Petclinic" page-size: 10 database: url: "jdbc:mysql://localhost:3306/petclinic_dev" username: "dev_user" password: "dev_pass" ``` 创建类型安全配置类: ```java package org.springframework.samples.petclinic.config; import jakarta.validation.constraints.Min; import jakarta.validation.constraints.NotBlank; import org.springframework.boot.context.properties.ConfigurationProperties; import org.springframework.validation.annotation.Validated; @Validated @ConfigurationProperties(prefix = "petclinic") public class PetclinicProperties { @NotBlank private String greeting; @Min(1) private int pageSize; private Database database = new Database(); public static class Database { @NotBlank private String url; @NotBlank private String username; private String password; // getters and setters } // getters and setters } ``` 在启动类或配置类上启用: ```java @Configuration @EnableConfigurationProperties(PetclinicProperties.class) public class PetclinicConfig { } ``` 启动应用: ```bash mvn spring-boot:run ``` 示例输出: ```text Started PetClinicApplication in 8.2 seconds ``` 验证配置绑定,临时在控制器中注入并打印: ```java @RestController public class ConfigProbeController { private final PetclinicProperties props; public ConfigProbeController(PetclinicProperties props) { this.props = props; } @GetMapping("/config-probe") public Map probe() { return Map.of( "greeting", props.getGreeting(), "pageSize", props.getPageSize(), "dbUrl", props.getDatabase().getUrl() ); } } ``` 请求验证: ```bash curl http://localhost:8080/config-probe ``` 示例输出: ```json {"greeting":"Welcome to Petclinic","pageSize":10,"dbUrl":"jdbc:mysql://localhost:3306/petclinic_dev"} ``` V1 成功标准:配置类绑定成功,校验注解生效,业务代码不再直接读 `Environment`。 > 一版落地类型安, > 校验注解守门关。 > 配置类里藏真意, > 业务从此不纠缠。 # 06、排查 ```text 诊断树:属性不生效 → 是绑定失败还是优先级问题?→ 是命名不匹配还是未启用配置类? ``` 第一个问题:启动时 `pageSize` 绑定为 0,校验没报错。 怀疑是 `@Min` 没生效。 检查发现 `@Validated` 加在了配置类上,但 `pageSize` 字段是 `int` 类型,`@Min` 对基本类型在部分版本需要额外处理。 证据是启动日志没有校验失败信息。 根因是 `@ConfigurationProperties` 绑定发生在校验之前,基本类型默认值为 0,`@Min(1)` 在部分 Spring Boot 版本对基本类型不触发。 修复:将 `pageSize` 改为 `Integer` 类型,或升级到支持基本类型校验的版本。 第二个问题:环境变量 `PETCLINIC_GREETING` 设置了,但接口返回的还是文件里的值。怀疑是环境变量名不匹配。检查命令: ```bash export PETCLINIC_GREETING="Hello from env" curl http://localhost:8080/config-probe ``` 证据是返回仍为 `Welcome to Petclinic`。 根因是 Spring Boot 的 relaxed binding 对环境变量名有规则:点号变下划线,但 `petclinic.greeting` 对应的是 `PETCLINIC_GREETING`, 这个没错。真正原因是应用通过 IDE 启动,环境变量没有传递进去。 修复:用命令行启动并显式传入: ```bash PETCLINIC_GREETING="Hello from env" mvn spring-boot:run ``` **错误尝试:** 曾试图在 `application.yml` 里用 `${PETCLINIC_GREETING}` 占位符引用环境变量,结果环境变量未设置时启动直接失败,反而引入了新的启动依赖。 > 排查如剥笋层层, > 现象背后有隐绳。 > 证据不到根因处, > 修复只是掩伤痕。 # 07、优化 ```text V1:配置类绑定成功,但环境变量覆盖不稳定,密码仍与普通配置混在一起 证据:环境变量在 IDE 启动时不生效,密码明文在 application.yml V2:显式分离 Secret 配置,用命令行参数验证优先级 ``` 优化第一步:将密码从 `application.yml` 中移除,改为环境变量注入。修改配置类,让密码字段不设默认值: ```yaml petclinic: greeting: "Welcome to Petclinic" page-size: 10 database: url: "jdbc:mysql://localhost:3306/petclinic_dev" username: "dev_user" # password 不再写在这里 ``` 启动时通过环境变量提供密码: ```bash PETCLINIC_DATABASE_PASSWORD="dev_pass_from_env" mvn spring-boot:run ``` 优化第二步:用命令行参数覆盖同一个属性,验证优先级。启动命令: ```bash PETCLINIC_GREETING="Hello from env" mvn spring-boot:run -- --petclinic.greeting="Hello from command line" ``` 请求验证: ```bash curl http://localhost:8080/config-probe ``` 示例输出: ```json {"greeting":"Hello from command line","pageSize":10,"dbUrl":"jdbc:mysql://localhost:3306/petclinic_dev"} ``` 命令行参数高于环境变量,最终取值来自命令行。这个验证让团队直观看到优先级,而不是死记硬背。 > 密码移出配置外, > 环境变量暗里来。 > 命令行里再覆盖, > 优先级自现灵台。 # 08、演进 ```text V2:类型安全配置 + 校验 + Secret 分离 + 优先级验证 能力:同一个 Jar 通过外部输入适配多环境 遗留:配置类字段增多后需要分组管理,Secret 加密存储未实现 ``` 用 V1 同一组请求前后验证。V1 时,`/config-probe` 返回的 `greeting` 只能来自文件,改环境要重新打包。V2 后,同一个 Jar 启动时用不同参数: ```bash java -jar target/petclinic.jar --petclinic.greeting="Dev greeting" --petclinic.database.url="jdbc:mysql://dev:3306/petclinic" ``` ```bash java -jar target/petclinic.jar --petclinic.greeting="Prod greeting" --petclinic.database.url="jdbc:mysql://prod:3306/petclinic" ``` 两次启动返回不同的 `greeting` 和 `dbUrl`,Jar 包本身没有变化。 收益是发布流程从“改代码重新打包”变成“改启动参数”,环境差异不再进入构建产物。 代价是运维需要维护每个环境的启动参数或环境变量清单。 适用条件是:应用需要频繁切换环境,或者配置项包含敏感信息。 遗留问题是:配置类字段增多后,单个 `PetclinicProperties` 会膨胀,需要按域拆分; 密码目前只是不写进文件,但环境变量本身仍是明文,生产环境需要对接 Secret 管理方案。 > 一包行遍三处路, > 参数如衣随境换。 > 构建产物不再动, > 发布从此少惊澜。 # 09、洞见 ```text 从现象到判断:配置优先级不是背出来的,是工程目的逼出来的 ``` ## 外部化配置的本质是“构建产物与环境输入分离” ```text 代码仓库 → 构建 → 不可变 Jar → 运行时注入 → 环境行为 ``` 同一个 Jar 能走三套环境,不是因为 Spring 魔法,而是因为构建产物里不包含环境差异。环境差异全部推迟到运行时注入。这个分离让发布从“高风险手工操作”变成“低风险参数切换”。 ## 反直觉判断:配置文件里的值没有被覆盖,只是被更高优先级来源挡住 ```text application.yml: server.port=8080 命令行: --server.port=9090 最终: 9090,但 8080 仍在 Environment 中 ``` 很多人以为“覆盖”是删除旧值写入新值。实际上 `Environment` 里两个值都在,只是解析时高优先级先命中。这个区别影响调试:当你在配置文件里改了值却不生效,先查是不是有更高优先级来源在挡路。 ## 反直觉判断:类型安全配置类的价值不在“少写 @Value”,而在“校验前置” ```text @Value 注入 → 启动成功 → 运行时才发现配置错误 @ConfigurationProperties + @Validated → 启动时校验 → 失败即停止 ``` `@Value` 也能绑定属性,但校验发生在业务使用时,错误发现太晚。类型安全配置类把校验提前到启动阶段,配置错误在应用对外服务前就暴露。这个前置让配置问题从“线上事故”变成“启动失败”。 ## Secret 管理的起点不是加密,而是“不进入代码仓库” ```text 密码在 application.yml → 进入 Git → 泄露风险 密码在环境变量 → 不进入 Git → 风险降低 ``` 很多人一谈 Secret 就想到加密存储、Vault、KMS。但第一步其实很简单:让密码不进入版本控制。环境变量虽然仍是明文,但至少切断了“代码仓库泄露”这条最直接的路径。 > 配置如衣随境换, > 构建产物守其常。 > 优先级非死记硬, > 工程目的自昭彰。 # 10、系统落地 ```text 入口:HTTP 请求 → 控制器 → 业务服务 → 配置类 → Environment → 外部输入 存储:数据库连接串、日志级别、业务参数 未实现:配置加密存储、动态刷新 ``` 原来 Petclinic 的配置全部写死在 `application.properties`,环境切换靠改文件重新打包。 本篇增加了类型安全配置类 `PetclinicProperties`,引入 Validation 校验,分离了密码类 Secret,验证了文件、环境变量、命令行参数的优先级。 现在 Petclinic 能做到:同一个 Jar 通过外部输入适配开发、测试、生产环境; 配置错误在启动时暴露; 密码不进入代码仓库。 官方文档可参考 Spring Boot 官方文档首页的 Externalized Configuration 章节。 下一篇缺的是配置的动态刷新能力。 当前配置变更需要重启应用,生产环境无法做到不中断更新。 这需要引入 Spring Cloud Config 或 Kubernetes ConfigMap 挂载,配合 `@RefreshScope` 实现。 > 系统落地步步高, > 配置外部化路遥。 > 动态刷新尚未至, > 重启变更仍辛劳。 # 11、小结 ```text 三问三答:为什么一个 Jar 走三套环境?相信谁?选错后果? ``` 为什么同一个 Jar 可以部署到开发、测试和生产?因为构建产物不包含环境差异,所有环境相关值都通过外部输入在运行时注入。Jar 是“行为模板”,环境输入是“行为参数”。 当文件、环境变量、启动参数同时提供同一个属性时,应该相信谁? 相信优先级更高的来源。 命令行参数高于环境变量,环境变量高于配置文件。 这个顺序不是背出来的,是 Spring Boot 启动时显式构建的 `PropertySource` 顺序。 如果选错了配置来源,或者把密码和普通配置混在一起,会带来什么后果?选错来源会导致配置不生效或生效错值,线上行为与预期不符。密码混在普通配置里,一旦进入代码仓库,泄露风险不可控,且难以追溯。 当前状态:Petclinic 已具备类型安全配置、校验、Secret 分离、优先级验证能力,同一个 Jar 可适配多环境。 > 三问三答理自明, > 一包多境靠外因。 > 优先级里藏秩序, > 密码分离保安宁。 # 12、作业 ```text 理解 → 实战 → 排障 → 架构判断 ``` ## 理解题:为什么 `application.yml` 里改了 `server.port` 不生效,但启动日志显示端口还是旧的? 回答:先检查是否有更高优先级来源提供了 `server.port`,比如命令行参数 `--server.port`、环境变量 `SERVER_PORT`、或系统属性。 `Environment` 中所有来源的值都存在,只是高优先级先命中。 用 `curl /actuator/env` 或启动日志中的 `PropertySource` 顺序排查。 ## 实战题:为 Petclinic 增加一个 `petclinic.cache.ttl-seconds` 配置项,类型为 `Duration`,默认 300 秒,并在配置类中校验不小于 1 秒。 回答:在 `PetclinicProperties` 中增加 `private Duration cacheTtl = Duration.ofSeconds(300);`,字段名对应 `cache-t tl-seconds`。 加 `@DurationMin(seconds = 1)` 或自定义校验注解。 在 `application.yml` 中配置 `cache-ttl-seconds: 600`,启动后通过探针接口验证绑定值。 ## 排障题:环境变量 `PETCLINIC_DATABASE_URL` 设置了,但应用启动时数据库连接失败,报错显示连的是 `localhost:3306`。 回答:先确认环境变量是否真的传给了应用进程。 用 `ps eww ` 查看进程环境变量。 如果确认已传,检查配置类字段名是否为 `url`,对应环境变量应为 `PETCLINIC_DATABASE_URL`。 如果字段名是 `jdbcUrl`,则环境变量应为 `PETCLINIC_DATABASE_JDBC_URL`。 relaxed binding 对驼峰和下划线有映射规则,但不会自动把 `url` 映射到 `jdbcUrl`。 ## 架构判断题:团队提议把所有配置项都放进一个 `application.yml`,用 Spring Profile 区分环境,不引入环境变量。这个方案适合生产吗? 回答:不适合。Profile 文件如 `application-prod.yml` 如果包含密码,仍然会进入代码仓库,泄露风险未解决。 Profile 适合区分非敏感的环境差异,如日志级别、缓存策略。 密码、Token 等 Secret 必须通过环境变量或 Secret 管理方案注入,不能进入版本控制。 > 作业四题各不同, > 理解实战排障中。 > 架构判断明取舍, > 配置之道渐精通。 # 13、升华 ```text 工程结论:外部化配置不是 Spring 特性,是发布工程的纪律 ``` 外部化配置的工程目的,是让构建产物与环境输入分离。 这个分离带来三个直接收益:同一个 Jar 可复用,发布从“改代码”变成“改参数”; 配置错误在启动时暴露,而不是线上运行时; 密码不进入代码仓库,泄露风险可控。 这些收益不是 Spring Boot 独有的,任何严肃的发布工程都需要。 Spring Boot 只是把这件事做得足够简单,简单到让人误以为“配置优先级”就是全部。 真正的价值在于:它逼着团队把环境差异从代码里赶出去。 下一篇,Petclinic 将面对配置的动态刷新问题。 当前配置变更需要重启,生产环境无法接受。 我们将引入 Spring Cloud Config 或 Kubernetes ConfigMap,让配置在不重启的情况下更新。 > 配置之道在分离, > 构建产物守其基。 > 环境输入随境变, > 发布从此少危机。 **系列项目:** Spring 官方 Petclinic 演进为生产级 Spring Boot 4 Java 应用 **已完成:** 环境搭建、启动机制、依赖与自动配置、配置体系基础 **本篇:** 外部化配置、类型安全配置类、Validation、Secret 分离、优先级验证 **下一篇:** 配置动态刷新与 Secret 管理方案落地

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册