首页 文章 精选 留言 我的

精选列表

搜索[智能问数],共10000篇文章
优秀的个人博客,低调大师

面试官问:Go 中的参数传递是值传递还是引用传递?

一个程序中,变量分为变量名和变量内容,变量内容的存储一般会被分配到堆和栈上。而在 Go 语言中有两种传递变量的方式值传递和引用传递。其中值传递会直接将变量内容附在变量名上传递,而引用传递会将变量内容的地址附在变量名上传递。 Golang 中是如何做到 如果在面试时有面试官提问你:“Go 的参数是如何传递的?”你会怎么回答呢? 这个问题其实只有一个答案。因为在 Golang 中所有的类型传递都是通过值传递实现的,而不是引用传递,即使是指针的传递也是通过 copy 指针的方式进行。另外对于一些包裹了底层数据的数据结构,其值传递的过程中,复制的也只是实例的指针,而不是底层数据所暴露出来的指针。 下面以 Go 版本 1.8 的 slice 为例来简单了解一下: func makeslice(et *_type, len, cap int) unsafe.Pointer { mem, overflow := math.MulUintptr(et.size, uintptr(cap)) if overflow || mem > maxAlloc || len < 0 || len > cap { // NOTE: Produce a 'len out of range' error instead of a // 'cap out of range' error when someone does make([]T, bignumber). // 'cap out of range' is true too, but since the cap is only being // supplied implicitly, saying len is clearer. // See golang.org/issue/4085. mem, overflow := math.MulUintptr(et.size, uintptr(len)) if overflow || mem > maxAlloc || len < 0 { panicmakeslicelen() } panicmakeslicecap() } return mallocgc(mem, et, true) // 申请内存 } 可以看到 slice 在初始化的过程中调用了 runtime 中的 makeslice 函数,这个函数会将 slice 的地址返回给接受的变量。 type slice struct { array unsafe.Pointer // 底层数组的地址 len int cap int } // 初始化过程 p := make([]int,0) fmt.Printf("变量p的地址%p", &p) fmt.Printf("slice的地址%p\n", p) 上面打印时出现的是的内容,这是因为 Go 内部实现了自动解引用(即 Go 内部实现的解引用操作)。 自动解引用时 receive 会从指针类型转变为值类型。顺带一提自动取引用时 receiver 会从值类型转变为指针类型。 如果未实现自动解引用时会怎样呢?下面是未实现自动解引用的情况: // 当我们打印变量p的时候,实际过程是发生了这样的变化 // 只是猜测,当然发生解引用是一定的 // & 取地址操作符 // * 根据地址取值操作 也称之为解引用运算法,间址运算符 // 1. 获取指针地址 &p // 2. 获取array的地址 &((&p).array) // 3. 获取底层数组实际内容 *&((&p).array) 未实现自动借用的函数传递过程,也是通过复制指针的方式来传递的,内容如下: package main import ( "fmt" ) func change(p1 []int) { fmt.Printf("p1的内存地址是: %p\n", &p1) // p1的内存地址是: 0xc0000a6048 fmt.Printf("函数里接收到slice的内存地址是:%p\n", p1) // 函数里接收到slice的内存地址是:0xc00008c030 p1 = append(p1, 30) } func main() { p := make([]int, 3) // 抛出一个指针 p = append(p, 20) fmt.Printf("p的内存地址是: %p\n", &p) // p的内存地址是: 0xc00009a018 fmt.Printf("slice的内存地址是:%p\n", p) // slice的内存地址是:0xc00008c030 change(p) // 重新生成一份地址p1 指向slice地址 fmt.Printf("修改之后p的内存地址 %p\n", &p) // 修改之后p的内存地址 0xc00009a018 fmt.Printf("修改之后slice的内存地址 %p\n", p) // 修改之后slice的内存地址 0xc00008c030 fmt.Println("修改之后的slice:", p) // 修改之后的slice [0 0 0 20] fmt.Println(*&p) // [0 0 0 20] } 需要注意的是,在函数传递的过程中 copy 的不是 slice 内部指向底层数组的指针,而是在 makeslice 函数所返回的指针。 源码实现 大家在看一些老旧的文章的时候,可能看到过这样的说法:make 返回的是 slice 的实例。但其实这种说法已经过时了,在 Golang 1.2 版本之后 make 返回的就是实例的指针。 github pr 地址:https://github.com/golang/go/commits/dev.boringcrypto.go1.12/src/runtime/slice.go 扩展 其实和 slice 类似的还有 map,chan。 先说 map,map 的官网定义:“Go provides a built-in map type that implements a hash table.Map types are reference types, like pointers or slices.”而 chan 和 map 一样也是一个指针,也就是说二者和 slice 的原理相似。 func makemap(t *maptype, hint int, h *hmap) *hmap { mem, overflow := math.MulUintptr(uintptr(hint), t.bucket.size) if overflow || mem > maxAlloc { hint = 0 } ... } func makechan(t *chantype, size int) *hchan { ... mem, overflow := math.MulUintptr(elem.size, uintptr(size)) if overflow || mem > maxAlloc-hchanSize || size < 0 { panic(plainError("makechan: size out of range")) } ... } 如果平时的使用中不注意,会出现一些不必要的麻烦,如: package main import "fmt" type InfoIns struct { Name string info []string } func NewInfoIns() InfoIns{ return InfoIns{ Name: "", info: nil, } } func (n *InfoIns) SetInfo(info []string){ n.info = info } func main(){ infoIns := NewInfoIns() info := []string{"p1", "p2", "p3"} infoIns.SetInfo(info) info[1] = "p4" fmt.Println(infoIns.info) // [p1 p4 p3] } 这里的InfoIns 在SetInfo之后存的是 info 的地址。一旦 info 在后续有改动 InfoIns 中的内容也随之会被改动。解决的方法是在 SetInfo 的时候重新申请一份地址。 func (n *InfoIns) SetInfo(info []string){ n.info = make([]string, len(info)) copy(n.info, info) } 脚注 借助 Goland 查看 Go 源码的方式:Ctrl+Shift+f 全局搜索,选择 Scope 中的 ALL Place。 推荐阅读 一文聊透 IP 地址的那些事 Golang 常见设计模式之装饰模式

优秀的个人博客,低调大师

面试官问redis分布式锁,如何设计才能让他满意?

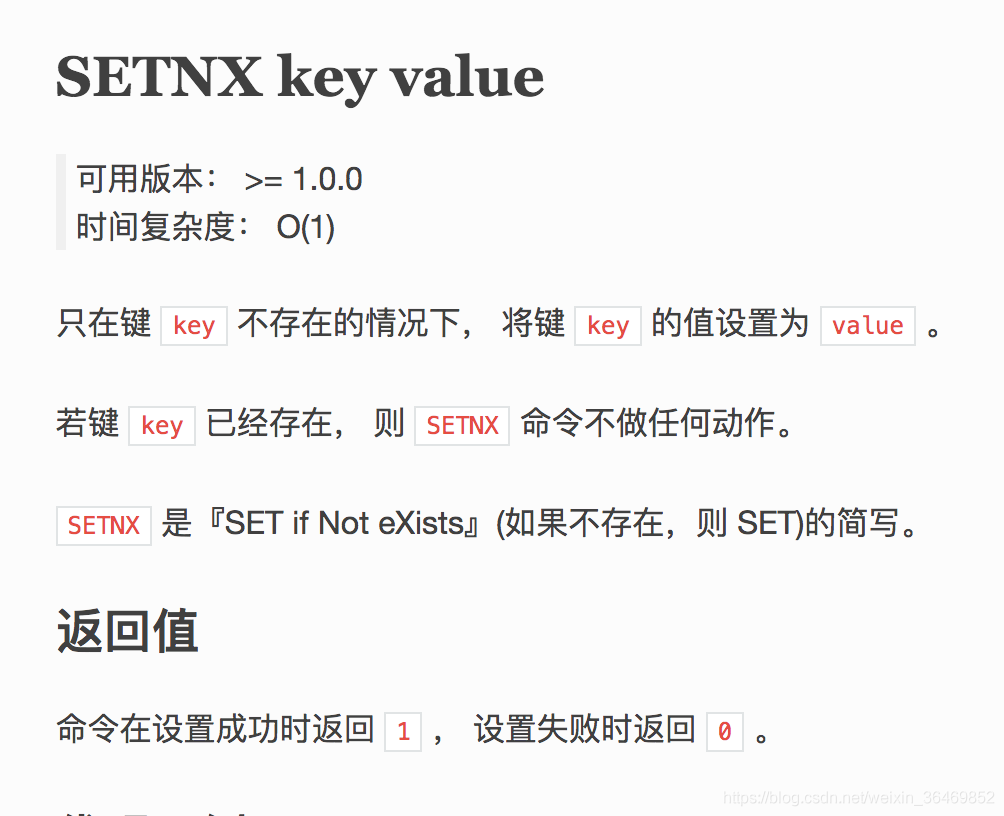
前言 对于分布式锁的问题我也查过很多资料,感觉很多方式实现的并不完善,或者看着云里雾里的,不知所以然,于是就整理了这篇文章,希望对您有用,有写的不对的地方,欢迎留言指正。 首先咱们来聊聊什么是分布式锁,到底解决了什么问题?直接看代码 $stock=$this->getStockFromDb();//查询剩余库存 if($stock>0){ $this->ReduceStockInDb();//在数据库中进行减库存操作 echo"successful"; }else{ echo"库存不足"; } 很简单的一个场景,用户下单,咱们查询商品库存够不够,不够的话直接返回库存不足类似的错误信息,如果库存够的话直接在数据库中库存-1,然后返回成功,在业务逻辑上这段代码是没有什么问题的。 但是,这段代码是存在严重的问题的。 如果库存只剩 1,并且在并发比较高的情况下,比如两个请求同时执行了这段代码,同时查到库存为 1,然后顺利成章的都去数据库执行 stock-1 的操作,这样库存就会变成-1,然后就会引发超卖的现象,刚才说的是两个请求同时执行,如果同时几千个请求打过来,可见造成的损失是非常大的。于是呢有些聪明人就想了个办法,办法如下。 大家都知道 redis 有个 setnx 命令,不知道的话也没关系,我已经帮你查过了 我们把上面的代码优化一下 version-1 $lock_key="lock_key"; $res=$redis->setNx($lock_key,1); if(!$res){ return"error_code"; } $stock=$this->getStockFromDb();//查询剩余库存 if($stock>0){ $this->ReduceStockInDb();//在数据库中进行减库存操作 echo"successful"; }else{ echo"库存不足"; } $redis->delete($lock_key); 第一次请求进来会去 setNx,当然结果是返回 true,因为 lock_key 不存在,然后下面业务逻辑正常进行,任务执行完了之后把lock_key删除掉,这样下一次请求进来重复上述逻辑 第二次请求进来同样会去执行 setNx,结果返回 false,因为lock_key已经存在,然后直接返回错误信息(你双11抢购秒杀产品的时候给你返回的系统繁忙就是这么来的),不执行库存减 1 的操作 有的同学可能有疑惑,咱们不是说高并发的情况下么?要是两个请求同时 setNx 的话获取的结果不都是 true 了,同样会同时去执行业务逻辑,问题不是一样没解决么?但是大家要明白 redis 是单线程的,具备原子性,不同的请求执行 setnx 是顺序执行的,所以这个是不用担心的。 看似问题解决了,其实并不然。 我们这里伪代码写的简单,查询一下库存,然后减1操作而已,但是真实的生产环境中的情况是非常复杂的,在一些极端情况下,程序很可能会报错,崩溃,如果第一次执行加锁了之后程序报错了,那这个锁永远存在,接下来的请求永远也请求不进来了,所以咱们继续优化 version-2 try{//新加入trycatch处理,这样程序万一报错会把锁删除掉 $lock_key="lock_key"; $expire_time=5;//新加入过期时间,这样锁不会一直占有 $res=$redis->setNx($lock_key,1,$expire_time); if(!$res){ return"error_code"; } $stock=$this->getStockFromDb();//查询剩余库存 if($stock>0){ $this->ReduceStockInDb();//在数据库中进行减库存操作 echo"successful"; }else{ echo"库存不足"; } }finally{ $redis->delete($lock_key); } 在setnx的时候给加上过期时间,这样至少不会让锁一直存在成为死锁 做try catch处理,万一程序抛出异常把锁删掉,也是为了解决死锁问题 这次是把死锁问题解决了,但是问题还是存在,大家可以先想一想还存在什么问题再接着往下看。 存在的问题如下 我们的过期时间是5秒钟,万一这个请求执行了6秒钟怎么办?超出的那一秒,跟没有加锁有什么区别?其实不仅仅如此,还有一个更严重的问题存在。比如第二个请求也是执行6秒,那么在第二个请求在超出的那1秒才进来的时候,第一个请求执行完了,当然会删除第二个请求加的锁,如果一直并发都很大的话,锁跟没有加没什么区别。 针对上述问题,最直接的办法是加长过期时间,但是这个不是解决问题的最终办法。把时间设置过长也会产生新的问题,比如各种原因机器崩溃了,需要重启,然后你把锁设置的时间是1年,同时也没有delete掉,难道机器重启了再等一年?另外这样设置固定值的解决方案在计算机当中是不允许的,曾经的“千年虫”问题就是类似的原因导致的 在加超时时间的时候一定要注意一定是一次性加上,保证其原子性,不要先setnx之后,再设置expire_time,这样的话万一在setnx之后那一个瞬间系统挂了,这个锁依然会成为一个永久的死锁 其实上述问题的主要原因在于,请求1会删掉请求2的锁,所以说锁需要保证唯一性。 咱们接着优化 version-3 try{//新加入trycatch处理,这样程序万一报错会把锁删除掉 $lock_key="lock_key"; $expire_time=5;//新加入过期时间,这样锁不会一直占有 $client_id=session_create_id();//对每个请求生成唯一性的id $res=$redis->setNx($lock_key,$client_id,$expire_time); if(!$res){ return"error_code"; } $stock=$this->getStockFromDb();//查询剩余库存 if($stock>0){ $this->ReduceStockInDb();//在数据库中进行减库存操作 echo"successful"; }else{ echo"库存不足"; } }finally{ if($redis->get($lock_key)==$client_id){//在这里加一个判断,保证每次删除的锁是当次请求加的锁,这样避免误删了别的请求加的锁 $redis->delete($lock_key); } } 我们在每个请求生成了唯一client_id,并且把该值写入了lock_key中 在最后删除锁的时候会先判断这个lock_key是否是该请求生成的,如果不是的话则不会删除 但是上面方案还有问题,我们看最后 redis是先进行了get操作判断,然后再删除,是两步操作,并没有保证其原子性,redis的多步操作可以用lua脚本来保证原子性,其实看到lua也不需要感觉太陌生,他就是一种语言而已,在这里的作用是把多个redis操作打包成一个命令去执行,保证了原子性而已 version-4 try{//新加入trycatch处理,这样程序万一报错会把锁删除掉 $lock_key="lock_key"; $expire_time=5;//新加入过期时间,这样锁不会一直占有 $client_id=session_create_id();//对每个请求生成唯一性的id $res=$redis->setNx($lock_key,$client_id,$expire_time); if(!$res){ return"error_code"; } $stock=$this->getStockFromDb();//查询剩余库存 if($stock>0){ $this->ReduceStockInDb();//在数据库中进行减库存操作 echo"successful"; }else{ echo"库存不足"; } }finally{ $script='//此处用lua脚本执行是为了get对比之后再delete的两步操作的原子性 ifredis.call("GET",KEYS[1])==ARGV[1]then returnredis.call("DEL",KEYS[1]) else return0 end '; return$instance->eval($script,[$lock_key,$client_id],1); } 这样封装之后,分布式锁应该就比较完善了。当然我们还可以进一步的优化一下用户体验 现在比如一个请求进来之后,如果请求被锁住,会立即返回给用户请求失败,请重新尝试,我们可以适当的延长一点这个时间,不要立即返回给用户请求失败,这样体验会更好 具体方式为用户请求进来如果遇到了锁,可以适当的等待一些时间之后重试,重试的时候如果锁释放了,则这次请求就可以成功 version-5 $retry_times=3;//重试次数 $usleep_times=5000;//重试间隔时间 try{//新加入trycatch处理,这样程序万一报错会把锁删除掉 $lock_key="lock_key"; $expire_time=5;//新加入过期时间,这样锁不会一直占有 while($retry_times>0){ $client_id=session_create_id();//对每个请求生成唯一性的id $res=$redis->setNx($lock_key,$client_id,$expire_time); if($res){ break; } echo"尝试重新获取锁"; $retry_times--; usleep($usleep_times); } if(!$res){//重试三次之后都没有获取到锁则给用户返回错误信息 return"error_code"; } $stock=$this->getStockFromDb();//查询剩余库存 if($stock>0){ $this->ReduceStockInDb();//在数据库中进行减库存操作 echo"successful"; }else{ echo"库存不足"; } }finally{ $script='//此处用lua脚本执行是为了get对比之后再delete的两步操作的原子性 ifredis.call("GET",KEYS[1])==ARGV[1]then returnredis.call("DEL",KEYS[1]) else return0 end '; return$instance->eval($script,[$lock_key,$client_id],1); } 当然上面的分布式锁还是不够完善的,比如redis主从同步延迟,就会产生问题,像java中redission实现的思想是非常好的,大家感兴趣可以看看源码,今天就聊到这里,感兴趣的朋友可以留言大家一起讨论

优秀的个人博客,低调大师

面试总被问分布式ID怎么办? 滴滴(Tinyid)甩给他

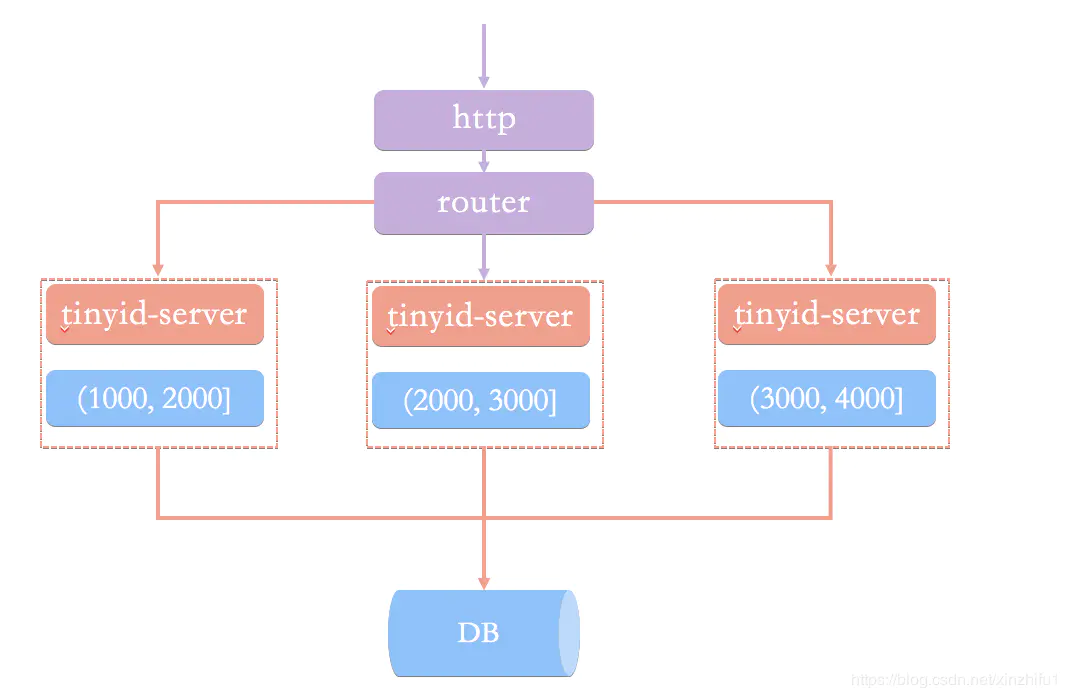
引言 接着《一口气说出 9种 分布式ID生成方式,面试官有点懵了》来继续详细的介绍分布式ID生成器,大家比较感兴趣的美团(Leaf)、滴滴(Tinyid)、百度(uid-generator)三个开源项目,美团(Leaf)已经讲完,详见《9种分布式ID生成之美团(Leaf)实战》,今天结合实战搞一下滴滴开源的(Tinyid)。 Tinyid介绍 Tinyid是滴滴开发的一款分布式ID系统,Tinyid是在美团(Leaf)的leaf-segment算法基础上升级而来,不仅支持了数据库多主节点模式,还提供了tinyid-client客户端的接入方式,使用起来更加方便。但和美团(Leaf)不同的是,Tinyid只支持号段一种模式不支持雪花模式。 Tinyid的特性 全局唯一的long型ID 趋势递增的id 提供 http 和 java-client 方式接入 支持批量获取ID 支持生成1,3,5,7,9...序列的ID 支持多个db的配置 适用场景:只关心ID是数字,趋势递增的系统,可以容忍ID不连续,可以容忍ID的浪费 不适用场景:像类似于订单ID的业务,因生成的ID大部分是连续的,容易被扫库、或者推算出订单量等信息 Tinyid原理 Tinyid是基于号段模式实现,再简单啰嗦一下号段模式的原理:就是从数据库批量的获取自增ID,每次从数据库取出一个号段范围,例如 (1,1000] 代表1000个ID,业务服务将号段在本地生成1~1000的自增ID并加载到内存.。 Tinyid会将可用号段加载到内存中,并在内存中生成ID,可用号段在首次获取ID时加载,如当前号段使用达到一定比例时,系统会异步的去加载下一个可用号段,以此保证内存中始终有可用号段,以便在发号服务宕机后一段时间内还有可用ID。 原理图大致如下图: Tinyid实现 Tinyid的GitHub地址 : https://github.com/didi/tinyid.git Tinyid提供了两种调用方式,一种基于Tinyid-server提供的http方式,另一种Tinyid-client客户端方式。 不管使用哪种方式调用,搭建Tinyid都必须提前建表tiny_id_info、tiny_id_token。 CREATE TABLE `tiny_id_info` ( `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT COMMENT '自增主键', `biz_type` varchar(63) NOT NULL DEFAULT '' COMMENT '业务类型,唯一', `begin_id` bigint(20) NOT NULL DEFAULT '0' COMMENT '开始id,仅记录初始值,无其他含义。初始化时begin_id和max_id应相同', `max_id` bigint(20) NOT NULL DEFAULT '0' COMMENT '当前最大id', `step` int(11) DEFAULT '0' COMMENT '步长', `delta` int(11) NOT NULL DEFAULT '1' COMMENT '每次id增量', `remainder` int(11) NOT NULL DEFAULT '0' COMMENT '余数', `create_time` timestamp NOT NULL DEFAULT '2010-01-01 00:00:00' COMMENT '创建时间', `update_time` timestamp NOT NULL DEFAULT '2010-01-01 00:00:00' COMMENT '更新时间', `version` bigint(20) NOT NULL DEFAULT '0' COMMENT '版本号', PRIMARY KEY (`id`), UNIQUE KEY `uniq_biz_type` (`biz_type`) ) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8 COMMENT 'id信息表'; CREATE TABLE `tiny_id_token` ( `id` int(11) unsigned NOT NULL AUTO_INCREMENT COMMENT '自增id', `token` varchar(255) NOT NULL DEFAULT '' COMMENT 'token', `biz_type` varchar(63) NOT NULL DEFAULT '' COMMENT '此token可访问的业务类型标识', `remark` varchar(255) NOT NULL DEFAULT '' COMMENT '备注', `create_time` timestamp NOT NULL DEFAULT '2010-01-01 00:00:00' COMMENT '创建时间', `update_time` timestamp NOT NULL DEFAULT '2010-01-01 00:00:00' COMMENT '更新时间', PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8 COMMENT 'token信息表'; INSERT INTO `tiny_id_info` (`id`, `biz_type`, `begin_id`, `max_id`, `step`, `delta`, `remainder`, `create_time`, `update_time`, `version`) VALUES (1, 'test', 1, 1, 100000, 1, 0, '2018-07-21 23:52:58', '2018-07-22 23:19:27', 1); INSERT INTO `tiny_id_info` (`id`, `biz_type`, `begin_id`, `max_id`, `step`, `delta`, `remainder`, `create_time`, `update_time`, `version`) VALUES (2, 'test_odd', 1, 1, 100000, 2, 1, '2018-07-21 23:52:58', '2018-07-23 00:39:24', 3); INSERT INTO `tiny_id_token` (`id`, `token`, `biz_type`, `remark`, `create_time`, `update_time`) VALUES (1, '0f673adf80504e2eaa552f5d791b644c', 'test', '1', '2017-12-14 16:36:46', '2017-12-14 16:36:48'); INSERT INTO `tiny_id_token` (`id`, `token`, `biz_type`, `remark`, `create_time`, `update_time`) VALUES (2, '0f673adf80504e2eaa552f5d791b644c', 'test_odd', '1', '2017-12-14 16:36:46', '2017-12-14 16:36:48'); tiny_id_info表是具体业务方号段信息数据表 max_id :号段的最大值 step:步长,即为号段的长度 biz_type:业务类型 号段获取对max_id字段做一次update操作,update max_id= max_id + step,更新成功则说明新号段获取成功,新的号段范围是(max_id ,max_id +step]。 tiny_id_token是一个权限表,表示当前token可以操作哪些业务的号段信息。 修改tinyid-server中 \offline\application.properties 文件配置数据库,由于tinyid支持数据库多master模式,可以配置多个数据库信息。启动 TinyIdServerApplication 测试一下。 datasource.tinyid.primary.driver-class-name=com.mysql.jdbc.Driver datasource.tinyid.primary.url=jdbc:mysql://127.0.0.1:3306/xin-master?autoReconnect=true&useUnicode=true&characterEncoding=UTF-8 datasource.tinyid.primary.username=junkang datasource.tinyid.primary.password=junkang datasource.tinyid.primary.testOnBorrow=false datasource.tinyid.primary.maxActive=10 datasource.tinyid.secondary.driver-class-name=com.mysql.jdbc.Driver datasource.tinyid.secondary.url=jdbc:mysql://localhost:3306/db2?autoReconnect=true&useUnicode=true&characterEncoding=UTF-8 datasource.tinyid.secondary.username=root datasource.tinyid.secondary.password=123456 datasource.tinyid.secondary.testOnBorrow=false datasource.tinyid.secondary.maxActive=10 1、Http方式 tinyid 内部一共提供了四个http接口来获取ID和号段。 package com.xiaoju.uemc.tinyid.server.controller; /** * @author du_imba */ @RestController @RequestMapping("/id/") public class IdContronller { private static final Logger logger = LoggerFactory.getLogger(IdContronller.class); @Autowired private IdGeneratorFactoryServer idGeneratorFactoryServer; @Autowired private SegmentIdService segmentIdService; @Autowired private TinyIdTokenService tinyIdTokenService; @Value("${batch.size.max}") private Integer batchSizeMax; @RequestMapping("nextId") public Response<List<Long>> nextId(String bizType, Integer batchSize, String token) { Response<List<Long>> response = new Response<>(); try { IdGenerator idGenerator = idGeneratorFactoryServer.getIdGenerator(bizType); List<Long> ids = idGenerator.nextId(newBatchSize); response.setData(ids); } catch (Exception e) { response.setCode(ErrorCode.SYS_ERR.getCode()); response.setMessage(e.getMessage()); logger.error("nextId error", e); } return response; } @RequestMapping("nextIdSimple") public String nextIdSimple(String bizType, Integer batchSize, String token) { String response = ""; try { IdGenerator idGenerator = idGeneratorFactoryServer.getIdGenerator(bizType); if (newBatchSize == 1) { Long id = idGenerator.nextId(); response = id + ""; } else { List<Long> idList = idGenerator.nextId(newBatchSize); StringBuilder sb = new StringBuilder(); for (Long id : idList) { sb.append(id).append(","); } response = sb.deleteCharAt(sb.length() - 1).toString(); } } catch (Exception e) { logger.error("nextIdSimple error", e); } return response; } @RequestMapping("nextSegmentId") public Response<SegmentId> nextSegmentId(String bizType, String token) { try { SegmentId segmentId = segmentIdService.getNextSegmentId(bizType); response.setData(segmentId); } catch (Exception e) { response.setCode(ErrorCode.SYS_ERR.getCode()); response.setMessage(e.getMessage()); logger.error("nextSegmentId error", e); } return response; } @RequestMapping("nextSegmentIdSimple") public String nextSegmentIdSimple(String bizType, String token) { String response = ""; try { SegmentId segmentId = segmentIdService.getNextSegmentId(bizType); response = segmentId.getCurrentId() + "," + segmentId.getLoadingId() + "," + segmentId.getMaxId() + "," + segmentId.getDelta() + "," + segmentId.getRemainder(); } catch (Exception e) { logger.error("nextSegmentIdSimple error", e); } return response; } } nextId、nextIdSimple都是获取下一个ID,nextSegmentIdSimple、getNextSegmentId是获取下一个可用号段。区别在于接口是否有返回状态。 nextId: 'http://localhost:9999/tinyid/id/nextId?bizType=test&token=0f673adf80504e2eaa552f5d791b644c' response : { "data": [2], "code": 200, "message": "" } nextId Simple: 'http://localhost:9999/tinyid/id/nextIdSimple?bizType=test&token=0f673adf80504e2eaa552f5d791b644c' response: 3 2、Tinyid-client客户端 如果不想通过http方式,Tinyid-client客户端也是一种不错的选择。 引用 tinyid-server 包 <dependency> <groupId>com.xiaoju.uemc.tinyid</groupId> <artifactId>tinyid-client</artifactId> <version>${tinyid.version}</version> </dependency> 启动 tinyid-server 项目打包后得到 tinyid-server-0.1.0-SNAPSHOT.jar ,设置版本 ${tinyid.version}为0.1.0-SNAPSHOT。 在我们的项目 application.properties 中配置 tinyid-server 服务的请求地址 和 用户身份token tinyid.server=127.0.0.1:9999 tinyid.token=0f673adf80504e2eaa552f5d791b644c``` 在Java代码调用TinyId也很简单,只需要一行代码。 // 根据业务类型 获取单个ID Long id = TinyId.nextId("test"); // 根据业务类型 批量获取10个ID List<Long> ids = TinyId.nextId("test", 10); Tinyid整个项目的源码实现也是比较简单,像与数据库交互更直接用jdbcTemplate实现 [@Override](https://my.oschina.net/u/1162528) public TinyIdInfo queryByBizType(String bizType) { String sql = "select id, biz_type, begin_id, max_id," + " step, delta, remainder, create_time, update_time, version" + " from tiny_id_info where biz_type = ?"; List<TinyIdInfo> list = jdbcTemplate.query(sql, new Object[]{bizType}, new TinyIdInfoRowMapper()); if(list == null || list.isEmpty()) { return null; } return list.get(0); } 总结 两种方式推荐使用Tinyid-client,这种方式ID为本地生成,号段长度(step)越长,支持的qps就越大,如果将号段设置足够大,则qps可达1000w+。而且tinyid-client 对 tinyid-server 访问变的低频,减轻了server端的压力。 整理了几百本各类技术电子书,有需要的同学可以,在我同名公众号回复[ 666 ]自取。技术群快满了,想进的同学可以加我好友,和大佬们一起吹吹技术,期待你的加入。 无论你是刚入行、还是已经有几年经验的程序员,相信这份面试提纲都会给你不少助力,长按二维码关注 『 程序员内点事 』 ,回复 『 offer 』 自行领取,祝大家 offer 拿到手软

优秀的个人博客,低调大师

面试被问Redis和zk两种分布式锁的对比

一、基于数据库实现分布式锁 1. 悲观锁 利用select … where … for update排他锁 注意: 其他附加功能与实现一基本一致,这里需要注意的是“where name=lock ”,name字段必须要走索引,否则会锁表。有些情况下,比如表不大,mysql优化器会不走这个索引,导致锁表问题。 2. 乐观锁 所谓乐观锁与前边最大区别在于基于CAS思想,是不具有互斥性,不会产生锁等待而消耗资源,操作过程中认为不存在并发冲突,只有update version失败后才能觉察到。 我们的抢购、秒杀就是用了这种实现以防止超卖。 通过增加递增的版本号字段实现乐观锁 二、基于缓存(Redis等)实现分布式锁 1、官方叫做 RedLock 算法,是 redis 官方支持的分布式锁算法。 这个分布式锁有 3 个重要的考量点: 1.互斥(只能有一个客户端获取锁) 2.不能死锁 3.容错(只要大部分 redis 节点创建了这把锁就可以) 2、下面是redis分布式锁的各种实现方式和缺点,按照时间的发展排序 1、直接setnx 直接利用setnx,执行完业务逻辑后调用del释放锁,简单粗暴 缺点:如果setnx成功,还没来得及释放,服务挂了,那么这个key永远都不会被获取到 2、setnx设置一个过期时间 为了改正第一个方法的缺陷,我们用setnx获取锁,然后用expire对其设置一个过期时间,如果服务挂了,过期时间一到自动释放 缺点:setnx和expire是两个方法,不能保证原子性,如果在setnx之后,还没来得及expire,服务挂了,还是会出现锁不释放的问题 3、set nx px redis官方为了解决第二种方式存在的缺点,在2.8版本为set指令添加了扩展参数nx和ex,保证了setnx+expire的原子性,使用方法:set key value ex 5 nx 缺点: 如果在过期时间内,事务还没有执行完,锁提前被自动释放,其他的线程还是可以拿到锁 上面所说的那个缺点还会导致当前的线程释放其他线程占有的锁 4、加一个事务id 上面所说的第一个缺点,没有特别好的解决方法,只能把过期时间尽量设置的长一点,并且最好不要执行耗时任务 第二个缺点,可以理解为当前线程有可能会释放其他线程的锁,那么问题就转换为保证线程只能释放当前线程持有的锁。 即setnx的时候将value设为任务的唯一id,释放的时候先get key比较一下value是否与当前的id相同,是则释放,否则抛异常回滚,其实也是变相地解决了第一个问题 缺点:get key和将value与id比较是两个步骤,不能保证原子性 5、set nx px + 事务id + lua 我们可以用lua来写一个getkey并比较的脚本,jedis/luttce/redisson对lua脚本都有很好的支持 缺点:集群环境下,对master节点申请了分布式锁,由于redis的主从同步是异步进行的,master在内存中写入了nx之后直接返回,客户端获取锁成功。 此时master节点挂了,并且数据还没来得及同步,另一个节点被升级为master,这样其他的线程依然可以获取锁。 6、redlock 为了解决上面提到的redis集群中的分布式锁问题,redis的作者antirez的提出了red lock的概念,假设集群中所有的n个master节点完全独立,并且没有主从同步。 此时对所有的节点都去setnx,并且设置一个请求过期时间re和锁的过期时间le,同时re必须小于le(可以理解,不然请求3秒才拿到锁,而锁的过期时间只有1秒也太蠢了)。 此时如果有n / 2 + 1个节点成功拿到锁,此次分布式锁就算申请成功。 缺点:可靠性还没有被广泛验证,并且严重依赖时间,好的分布式系统应该是异步的,并不能以时间为担保,程序暂停、系统延迟等都可能会导致时间错误。 三、基于zookeeper实现的分布式锁 1. 实现方式 ZooKeeper是一个为分布式应用提供一致性服务的开源组件,它内部是一个分层的文件系统目录树结构,规定同一个目录下只能有一个唯一文件名。基于ZooKeeper实现分布式锁的步骤如下: 创建一个目录mylock; 线程A想获取锁就在mylock目录下创建临时顺序节点; 获取mylock目录下所有的子节点,然后获取比自己小的兄弟节点,如果不存在,则说明当前线程顺序号最小,获得锁; 线程B获取所有节点,判断自己不是最小节点,设置监听比自己次小的节点; 线程A处理完,删除自己的节点,线程B监听到变更事件,判断自己是不是最小的节点,如果是则获得锁。 这里推荐一个Apache的开源库Curator,它是一个ZooKeeper客户端,Curator提供的InterProcessMutex是分布式锁的实现,acquire方法用于获取锁,release方法用于释放锁。 优点:具备高可用、可重入、阻塞锁特性,可解决失效死锁问题。 缺点:因为需要频繁的创建和删除节点,性能上不如Redis方式。 2. 两种利用特性实现原理: 1、利用临时节点特性 zookeeper的临时节点有两个特性,一是节点名称不能重复,二是会随着客户端退出而销毁,因此直接将key作为节点名称,能够成功创建的客户端则获取成功,失败的客户端监听成功的节点的删除事件 缺点:所有客户端监听同一个节点,但是同时只有一个节点的事件触发是有效的,造成资源的无效调度 2、利用顺序临时节点特性 zookeeper的顺序临时节点拥有临时节点的特性,同时,在一个父节点下创建创建的子临时顺序节点,会根据节点创建的先后顺序,用一个32位的数字作为后缀。 我们可以用key创建一个根节点,然后每次申请锁的时候在其下创建顺序节点,接着获取根节点下所有的顺序节点并排序,获取顺序最小的节点,如果该节点的名称与当前添加的名称相同。 则表示能够获取锁,否则监听根节点下面的处于当前节点之前的节点的删除事件,如果监听生效,则回到上一步重新判断顺序,直到获取锁。 总结 基于数据库分布式锁实现 优点:直接使用数据库,实现方式简单。 缺点: db操作性能较差,并且有锁表的风险 非阻塞操作失败后,需要轮询,占用cpu资源; 长时间不commit或者长时间轮询,可能会占用较多连接资源 基于redis缓存 redis set px nx + 唯一id + lua脚本 优点:redis本身的读写性能很高,因此基于redis的分布式锁效率比较高 缺点:依赖中间件,分布式环境下可能会有节点数据同步问题,可靠性有一定的影响,如果发生则需要人工介入 基于redis的redlock 优点:可以解决redis集群的同步可用性问题 缺点: 依赖中间件,并没有被广泛验证,维护成本高,需要多个独立的master节点;需要同时对多个节点申请锁,降低了一些效率 锁删除失败 过期时间不好控制 非阻塞,操作失败后,需要轮询,占用cpu资源; 基于zookeeper的分布式锁 优点:不存在redis的超时、数据同步(zookeeper是同步完以后才返回)、主从切换(zookeeper主从切换的过程中服务是不可用的)的问题,可靠性很高 缺点:依赖中间件,保证了可靠性的同时牺牲了一部分效率(但是依然很高)。性能不如redis。 jdk的方式不太推荐。 从理解的难易程度角度(从低到高)数据库 > 缓存 > Zookeeper 从实现的复杂性角度(从低到高)Zookeeper >= 缓存 > 数据库 从性能角度(从高到低)缓存 > Zookeeper >= 数据库 从可靠性角度(从高到低)Zookeeper > 缓存 > 数据库 没有绝对完美的实现方式,具体要选择哪一种分布式锁,需要结合每一种锁的优缺点和业务特点而定。

优秀的个人博客,低调大师

2019年面试官最喜欢问的28道ZooKeeper面试题

前言 ZooKeeper 是一个分布式的,开放源码的分布式应用程序协调服务。它是一个为分布式应用提供一致性服务的软件,提供的功能包括:配置维护、域名服务、分布式同步、组服务等。ZooKeeper 的目标就是封装好复杂易出错的关键服务,将简单易用的接口和性能高效、功能稳定的系统提供给用户。 ZooKeeper 面试题 ZooKeeper 是什么? ZooKeeper 提供了什么? Zookeeper 文件系统 ZAB 协议? 四种类型的数据节点 Znode Zookeeper Watcher 机制 -- 数据变更通知 客户端注册 Watcher 实现 服务端处理 Watcher 实现 客户端回调 Watcher ACL 权限控制机制 Chroot 特性 会话管理 服务器角色 Zookeeper 下 Server 工作状态 数据同步 zookeeper 是如何保证事务的顺序一致性的? 分布式集群中为什么会有 Master? zk 节点宕机如何处理? zookeeper 负载均衡和 nginx 负载均衡区别 Zookeeper 有哪几种几种部署模式? 集群最少要几台机器,集群规则是怎样的? 集群支持动态添加机器吗? Zookeeper 对节点的 watch 监听通知是永久的吗?为什么不是永久的? Zookeeper 的 java 客户端都有哪些? chubby 是什么,和 zookeeper 比你怎么看? 说几个 zookeeper 常用的命令。 ZAB 和 Paxos 算法的联系与区别? Zookeeper 的典型应用场景 ZooKeeper面试题答案解析 1. ZooKeeper 是什么? ZooKeeper 是一个开放源码的分布式协调服务,它是集群的管理者,监视着集群中各个节点的状态根据节点提交的反馈进行下一步合理操作。最终,将简单易用的接口和性能高效、功能稳定的系统提供给用户。分布式应用程序可以基于 Zookeeper 实现诸如数据发布/订阅、负载均衡、命名服务、分布式协调/通知、集群管理、Master 选举、分布式锁和分布式队列等功能。Zookeeper 保证了如下分布式一致性特性:(1)顺序一致性(2)原子性(3)单一视图(4)可靠性(5)实时性(最终一致性)客户端的读请求可以被集群中的任意一台机器处理,如果读请求在节点上注册了监听器,这个监听器也是由所连接的 zookeeper 机器来处理。对于写请求,这些请求会同时发给其他 zookeeper 机器并且达成一致后,请求才会返回成功。因此,随着 zookeeper 的集群机器增多,读请求的吞吐会提高但是写请求的吞吐会下降。有序性是 zookeeper 中非常重要的一个特性,所有的更新都是全局有序的,每个更新都有一个唯一的时间戳,这个时间戳称为 zxid(Zookeeper Transaction Id)。而读请求只会相对于更新有序,也就是读请求的返回结果中会带有这个zookeeper 最新的 zxid。 2. ZooKeeper 提供了什么? (1)文件系统(2)通知机制 3.Zookeeper 文件系统 Zookeeper 提供一个多层级的节点命名空间(节点称为 znode)。与文件系统不同的是,这些节点都可以设置关联的数据,而文件系统中只有文件节点可以存放数据而目录节点不行。Zookeeper 为了保证高吞吐和低延迟,在内存中维护了这个树状的目录结构,这种特性使得 Zookeeper 不能用于存放大量的数据,每个节点的存放数据上限为1M。 4. ZAB 协议? ZAB 协议是为分布式协调服务 Zookeeper 专门设计的一种支持崩溃恢复的原子广播协议。ZAB 协议包括两种基本的模式:崩溃恢复和消息广播。当整个 zookeeper 集群刚刚启动或者 Leader 服务器宕机、重启或者网络故障导致不存在过半的服务器与 Leader 服务器保持正常通信时,所有进程(服务器)进入崩溃恢复模式,首先选举产生新的 Leader 服务器,然后集群中 Follower 服务器开始与新的 Leader 服务器进行数据同步,当集群中超过半数机器与该 Leader服务器完成数据同步之后,退出恢复模式进入消息广播模式,Leader 服务器开始接收客户端的事务请求生成事物提案来进行事务请求处理。 5. 四种类型的数据节点 Znode (1)PERSISTENT-持久节点除非手动删除,否则节点一直存在于 Zookeeper 上(2)EPHEMERAL-临时节点临时节点的生命周期与客户端会话绑定,一旦客户端会话失效(客户端与zookeeper 连接断开不一定会话失效),那么这个客户端创建的所有临时节点都会被移除。(3)PERSISTENT_SEQUENTIAL-持久顺序节点基本特性同持久节点,只是增加了顺序属性,节点名后边会追加一个由父节点维护的自增整型数字。(4)EPHEMERAL_SEQUENTIAL-临时顺序节点基本特性同临时节点,增加了顺序属性,节点名后边会追加一个由父节点维护的自增整型数字。 6. Zookeeper Watcher 机制 -- 数据变更通知 Zookeeper 允许客户端向服务端的某个 Znode 注册一个 Watcher 监听,当服务端的一些指定事件触发了这个 Watcher,服务端会向指定客户端发送一个事件通知来实现分布式的通知功能,然后客户端根据 Watcher 通知状态和事件类型做出业务上的改变。工作机制:(1)客户端注册 watcher(2)服务端处理 watcher(3)客户端回调 watcherWatcher 特性总结:(1)一次性无论是服务端还是客户端,一旦一个 Watcher 被 触 发 ,Zookeeper 都会将其从相应的存储中移除。这样的设计有效的减轻了服务端的压力,不然对于更新非常频繁的节点,服务端会不断的向客户端发送事件通知,无论对于网络还是服务端的压力都非常大。(2)客户端串行执行客户端 Watcher 回调的过程是一个串行同步的过程。(3)轻量3.1、Watcher 通知非常简单,只会告诉客户端发生了事件,而不会说明事件的具体内容。3.2、客户端向服务端注册 Watcher 的时候,并不会把客户端真实的 Watcher 对象实体传递到服务端,仅仅是在客户端请求中使用 boolean 类型属性进行了标记。(4)watcher event 异步发送 watcher 的通知事件从 server 发送到 client 是异步的,这就存在一个问题,不同的客户端和服务器之间通过 socket 进行通信,由于网络延迟或其他因素导致客户端在不通的时刻监听到事件,由于 Zookeeper 本身提供了 ordering guarantee,即客户端监听事件后,才会感知它所监视 znode发生了变化。所以我们使用 Zookeeper 不能期望能够监控到节点每次的变化。Zookeeper 只能保证最终的一致性,而无法保证强一致性。(5)注册 watcher getData、exists、getChildren(6)触发 watcher create、delete、setData(7)当一个客户端连接到一个新的服务器上时,watch 将会被以任意会话事件触发。当与一个服务器失去连接的时候,是无法接收到 watch 的。而当 client 重新连接时,如果需要的话,所有先前注册过的 watch,都会被重新注册。通常这是完全透明的。只有在一个特殊情况下,watch 可能会丢失:对于一个未创建的 znode的 exist watch,如果在客户端断开连接期间被创建了,并且随后在客户端连接上之前又删除了,这种情况下,这个 watch 事件可能会被丢失。 7. 客户端注册 Watcher 实现 (1)调用 getData()/getChildren()/exist()三个 API,传入 Watcher 对象(2)标记请求 request,封装 Watcher 到 WatchRegistration(3)封装成 Packet 对象,发服务端发送 request(4)收到服务端响应后,将 Watcher 注册到 ZKWatcherManager 中进行管理(5)请求返回,完成注册。 8. 服务端处理 Watcher 实现 (1)服务端接收 Watcher 并存储接收到客户端请求,处理请求判断是否需要注册 Watcher,需要的话将数据节点的节点路径和 ServerCnxn(ServerCnxn 代表一个客户端和服务端的连接,实现了 Watcher 的 process 接口,此时可以看成一个 Watcher 对象)存储在WatcherManager 的 WatchTable 和 watch2Paths 中去。(2)Watcher 触发以服务端接收到 setData() 事务请求触发 NodeDataChanged 事件为例:2.1 封装 WatchedEvent将通知状态(SyncConnected)、事件类型(NodeDataChanged)以及节点路径封装成一个 WatchedEvent 对象2.2 查询 Watcher从 WatchTable 中根据节点路径查找 Watcher2.3 没找到;说明没有客户端在该数据节点上注册过 Watcher2.4 找到;提取并从 WatchTable 和 Watch2Paths 中删除对应 Watcher(从这里可以看出 Watcher 在服务端是一次性的,触发一次就失效了)(3)调用 process 方法来触发 Watcher这里 process 主要就是通过 ServerCnxn 对应的 TCP 连接发送 Watcher 事件通知。 9. 客户端回调 Watcher 客户端 SendThread 线程接收事件通知,交由 EventThread 线程回调 Watcher。客户端的 Watcher 机制同样是一次性的,一旦被触发后,该 Watcher 就失效了。 10. ACL 权限控制机制 UGO(User/Group/Others)目前在 Linux/Unix 文件系统中使用,也是使用最广泛的权限控制方式。是一种粗粒度的文件系统权限控制模式。ACL(Access Control List)访问控制列表包括三个方面:权限模式(Scheme)(1)IP:从 IP 地址粒度进行权限控制(2)Digest:最常用,用类似于 username:password 的权限标识来进行权限配置,便于区分不同应用来进行权限控制(3)World:最开放的权限控制方式,是一种特殊的 digest 模式,只有一个权限标识“world:anyone”(4)Super:超级用户授权对象授权对象指的是权限赋予的用户或一个指定实体,例如 IP 地址或是机器灯。权限 Permission(1)CREATE:数据节点创建权限,允许授权对象在该 Znode 下创建子节点(2)DELETE:子节点删除权限,允许授权对象删除该数据节点的子节点(3)READ:数据节点的读取权限,允许授权对象访问该数据节点并读取其数据内容或子节点列表等(4)WRITE:数据节点更新权限,允许授权对象对该数据节点进行更新操作(5)ADMIN:数据节点管理权限,允许授权对象对该数据节点进行 ACL 相关设置操作 11. Chroot 特性 3.2.0 版本后,添加了 Chroot 特性,该特性允许每个客户端为自己设置一个命名空间。如果一个客户端设置了 Chroot,那么该客户端对服务器的任何操作,都将会被限制在其自己的命名空间下。通过设置 Chroot,能够将一个客户端应用于 Zookeeper 服务端的一颗子树相对应,在那些多个应用公用一个 Zookeeper 进群的场景下,对实现不同应用间的相互隔离非常有帮助。欢迎大家关注我的公种浩【程序员追风】,2019年多家公司java面试题整理了1000多道400多页pdf文档,文章都会在里面更新,整理的资料也会放在里面。 12. 会话管理 分桶策略:将类似的会话放在同一区块中进行管理,以便于 Zookeeper 对会话进行不同区块的隔离处理以及同一区块的统一处理。分配原则:每个会话的“下次超时时间点”(ExpirationTime)计算公式:ExpirationTime_ = currentTime + sessionTimeoutExpirationTime = (ExpirationTime_ / ExpirationInrerval + 1) *ExpirationInterval , ExpirationInterval 是指 Zookeeper 会话超时检查时间间隔,默认 tickTime 13. 服务器角色 Leader(1)事务请求的唯一调度和处理者,保证集群事务处理的顺序性(2)集群内部各服务的调度者Follower(1)处理客户端的非事务请求,转发事务请求给 Leader 服务器(2)参与事务请求 Proposal 的投票(3)参与 Leader 选举投票Observer(1)3.0 版本以后引入的一个服务器角色,在不影响集群事务处理能力的基础上提升集群的非事务处理能力(2)处理客户端的非事务请求,转发事务请求给 Leader 服务器(3)不参与任何形式的投票 14. Zookeeper 下 Server 工作状态 服务器具有四种状态,分别是 LOOKING、FOLLOWING、LEADING、OBSERVING。(1)LOOKING:寻 找 Leader 状态。当服务器处于该状态时,它会认为当前集群中没有 Leader,因此需要进入 Leader 选举状态。(2)FOLLOWING:跟随者状态。表明当前服务器角色是 Follower。(3)LEADING:领导者状态。表明当前服务器角色是 Leader。(4)OBSERVING:观察者状态。表明当前服务器角色是 Observer。 15. 数据同步 整个集群完成 Leader 选举之后,Learner(Follower 和 Observer 的统称)回向Leader 服务器进行注册。当 Learner 服务器想 Leader 服务器完成注册后,进入数据同步环节。数据同步流程:(均以消息传递的方式进行)Learner 向 Learder 注册数据同步同步确认Zookeeper 的数据同步通常分为四类:(1)直接差异化同步(DIFF 同步)(2)先回滚再差异化同步(TRUNC+DIFF 同步)(3)仅回滚同步(TRUNC 同步)(4)全量同步(SNAP 同步)在进行数据同步前,Leader 服务器会完成数据同步初始化:peerLastZxid:· 从 learner 服务器注册时发送的 ACKEPOCH 消息中提取 lastZxid(该Learner 服务器最后处理的 ZXID)minCommittedLog:· Leader 服务器 Proposal 缓存队列 committedLog 中最小 ZXIDmaxCommittedLog:· Leader 服务器 Proposal 缓存队列 committedLog 中最大 ZXID直接差异化同步(DIFF 同步)· 场景:peerLastZxid 介于 minCommittedLog 和 maxCommittedLog之间先回滚再差异化同步(TRUNC+DIFF 同步)· 场景:当新的 Leader 服务器发现某个 Learner 服务器包含了一条自己没有的事务记录,那么就需要让该 Learner 服务器进行事务回滚--回滚到 Leader服务器上存在的,同时也是最接近于 peerLastZxid 的 ZXID仅回滚同步(TRUNC 同步)· 场景:peerLastZxid 大于 maxCommittedLog全量同步(SNAP 同步)· 场景一:peerLastZxid 小于 minCommittedLog· 场景二:Leader 服务器上没有 Proposal 缓存队列且 peerLastZxid 不等于 lastProcessZxid 16. zookeeper 是如何保证事务的顺序一致性的? zookeeper 采用了全局递增的事务 Id 来标识,所有的 proposal(提议)都在被提出的时候加上了 zxid,zxid 实际上是一个 64 位的数字,高 32 位是 epoch( 时期; 纪元; 世; 新时代)用来标识 leader 周期,如果有新的 leader 产生出来,epoch会自增,低 32 位用来递增计数。当新产生 proposal 的时候,会依据数据库的两阶段过程,首先会向其他的 server 发出事务执行请求,如果超过半数的机器都能执行并且能够成功,那么就会开始执行。 17. 分布式集群中为什么会有 Master? 在分布式环境中,有些业务逻辑只需要集群中的某一台机器进行执行,其他的机器可以共享这个结果,这样可以大大减少重复计算,提高性能,于是就需要进行leader 选举。 18. zk 节点宕机如何处理? Zookeeper 本身也是集群,推荐配置不少于 3 个服务器。Zookeeper 自身也要保证当一个节点宕机时,其他节点会继续提供服务。如果是一个 Follower 宕机,还有 2 台服务器提供访问,因为 Zookeeper 上的数据是有多个副本的,数据并不会丢失;如果是一个 Leader 宕机,Zookeeper 会选举出新的 Leader。ZK 集群的机制是只要超过半数的节点正常,集群就能正常提供服务。只有在 ZK节点挂得太多,只剩一半或不到一半节点能工作,集群才失效。所以3 个节点的 cluster 可以挂掉 1 个节点(leader 可以得到 2 票>1.5)2 个节点的 cluster 就不能挂掉任何 1 个节点了(leader 可以得到 1 票<=1) 19. zookeeper 负载均衡和 nginx 负载均衡区别 zk 的负载均衡是可以调控,nginx 只是能调权重,其他需要可控的都需要自己写插件;但是 nginx 的吞吐量比 zk 大很多,应该说按业务选择用哪种方式。 20. Zookeeper 有哪几种几种部署模式? 部署模式:单机模式、伪集群模式、集群模式。 21. 集群最少要几台机器,集群规则是怎样的? 集群规则为 2N+1 台,N>0,即 3 台。 22. 集群支持动态添加机器吗? 其实就是水平扩容了,Zookeeper 在这方面不太好。两种方式:全部重启:关闭所有 Zookeeper 服务,修改配置之后启动。不影响之前客户端的会话。逐个重启:在过半存活即可用的原则下,一台机器重启不影响整个集群对外提供服务。这是比较常用的方式。3.5 版本开始支持动态扩容。 23. Zookeeper 对节点的 watch 监听通知是永久的吗?为什么不是永久的? 不是。官方声明:一个 Watch 事件是一个一次性的触发器,当被设置了 Watch的数据发生了改变的时候,则服务器将这个改变发送给设置了 Watch 的客户端,以便通知它们。为什么不是永久的,举个例子,如果服务端变动频繁,而监听的客户端很多情况下,每次变动都要通知到所有的客户端,给网络和服务器造成很大压力。一般是客户端执行 getData(“/节点 A”,true),如果节点 A 发生了变更或删除,客户端会得到它的 watch 事件,但是在之后节点 A 又发生了变更,而客户端又没有设置 watch 事件,就不再给客户端发送。在实际应用中,很多情况下,我们的客户端不需要知道服务端的每一次变动,我只要最新的数据即可。 24. Zookeeper 的 java 客户端都有哪些? java 客户端:zk 自带的 zkclient 及 Apache 开源的 Curator。 25. chubby 是什么,和 zookeeper 比你怎么看? chubby 是 google 的,完全实现 paxos 算法,不开源。zookeeper 是 chubby的开源实现,使用 zab 协议,paxos 算法的变种。 26. 说几个 zookeeper 常用的命令。 常用命令:ls get set create delete 等。 27. ZAB 和 Paxos 算法的联系与区别? 相同点:(1)两者都存在一个类似于 Leader 进程的角色,由其负责协调多个 Follower 进程的运行(2)Leader 进程都会等待超过半数的 Follower 做出正确的反馈后,才会将一个提案进行提交(3)ZAB 协议中,每个 Proposal 中都包含一个 epoch 值来代表当前的 Leader周期,Paxos 中名字为 Ballot不同点:ZAB 用来构建高可用的分布式数据主备系统(Zookeeper),Paxos 是用来构建分布式一致性状态机系统。 28. Zookeeper 的典型应用场景 Zookeeper 是一个典型的发布/订阅模式的分布式数据管理与协调框架,开发人员可以使用它来进行分布式数据的发布和订阅。通过对 Zookeeper 中丰富的数据节点进行交叉使用,配合 Watcher 事件通知机制,可以非常方便的构建一系列分布式应用中年都会涉及的核心功能,如:(1)数据发布/订阅(2)负载均衡(3)命名服务(4)分布式协调/通知(5)集群管理(6)Master 选举(7)分布式锁(8)分布式队列数据发布/订阅介绍数据发布/订阅系统,即所谓的配置中心,顾名思义就是发布者发布数据供订阅者进行数据订阅。目的动态获取数据(配置信息)实现数据(配置信息)的集中式管理和数据的动态更新设计模式Push 模式Pull 模式数据(配置信息)特性(1)数据量通常比较小(2)数据内容在运行时会发生动态更新(3)集群中各机器共享,配置一致如:机器列表信息、运行时开关配置、数据库配置信息等基于 Zookeeper 的实现方式· 数据存储:将数据(配置信息)存储到 Zookeeper 上的一个数据节点· 数据获取:应用在启动初始化节点从 Zookeeper 数据节点读取数据,并在该节点上注册一个数据变更 Watcher· 数据变更:当变更数据时,更新 Zookeeper 对应节点数据,Zookeeper会将数据变更通知发到各客户端,客户端接到通知后重新读取变更后的数据即可。负载均衡zk 的命名服务命名服务是指通过指定的名字来获取资源或者服务的地址,利用 zk 创建一个全局的路径,这个路径就可以作为一个名字,指向集群中的集群,提供的服务的地址,或者一个远程的对象等等。分布式通知和协调对于系统调度来说:操作人员发送通知实际是通过控制台改变某个节点的状态,然后 zk 将这些变化发送给注册了这个节点的 watcher 的所有客户端。对于执行情况汇报:每个工作进程都在某个目录下创建一个临时节点。并携带工作的进度数据,这样汇总的进程可以监控目录子节点的变化获得工作进度的实时的全局情况。zk 的命名服务(文件系统)命名服务是指通过指定的名字来获取资源或者服务的地址,利用 zk 创建一个全局的路径,即是唯一的路径,这个路径就可以作为一个名字,指向集群中的集群,提供的服务的地址,或者一个远程的对象等等。zk 的配置管理(文件系统、通知机制)程序分布式的部署在不同的机器上,将程序的配置信息放在 zk 的 znode 下,当有配置发生改变时,也就是 znode 发生变化时,可以通过改变 zk 中某个目录节点的内容,利用 watcher 通知给各个客户端,从而更改配置。Zookeeper 集群管理(文件系统、通知机制)所谓集群管理无在乎两点:是否有机器退出和加入、选举 master。对于第一点,所有机器约定在父目录下创建临时目录节点,然后监听父目录节点的子节点变化消息。一旦有机器挂掉,该机器与 zookeeper 的连接断开,其所创建的临时目录节点被删除,所有其他机器都收到通知:某个兄弟目录被删除,于是,所有人都知道:它上船了。新机器加入也是类似,所有机器收到通知:新兄弟目录加入,highcount 又有了,对于第二点,我们稍微改变一下,所有机器创建临时顺序编号目录节点,每次选取编号最小的机器作为 master 就好。Zookeeper 分布式锁(文件系统、通知机制)有了 zookeeper 的一致性文件系统,锁的问题变得容易。锁服务可以分为两类,一个是保持独占,另一个是控制时序。对于第一类,我们将 zookeeper 上的一个 znode 看作是一把锁,通过 createznode的方式来实现。所有客户端都去创建 /distribute_lock 节点,最终成功创建的那个客户端也即拥有了这把锁。用完删除掉自己创建的 distribute_lock 节点就释放出锁。对于第二类, /distribute_lock 已经预先存在,所有客户端在它下面创建临时顺序编号目录节点,和选 master 一样,编号最小的获得锁,用完删除,依次方便。Zookeeper 队列管理(文件系统、通知机制)两种类型的队列:(1)同步队列,当一个队列的成员都聚齐时,这个队列才可用,否则一直等待所有成员到达。(2)队列按照 FIFO 方式进行入队和出队操作。第一类,在约定目录下创建临时目录节点,监听节点数目是否是我们要求的数目。第二类,和分布式锁服务中的控制时序场景基本原理一致,入列有编号,出列按编号。在特定的目录下创建 PERSISTENT_SEQUENTIAL 节点,创建成功时Watcher 通知等待的队列,队列删除序列号最小的节点用以消费。此场景下Zookeeper 的 znode 用于消息存储,znode 存储的数据就是消息队列中的消息内容,SEQUENTIAL 序列号就是消息的编号,按序取出即可。由于创建的节点是持久化的,所以不必担心队列消息的丢失问题。 最后欢迎大家一起交流,喜欢文章记得关注我点个赞哟,感谢支持!

优秀的个人博客,低调大师

国内Java面试总是问StringBuffer,StringBuilder区别是啥?档次为什么这么低?

GitHub 6.6k Star 的Java工程师成神之路 ,不来了解一下吗? GitHub 6.6k Star 的Java工程师成神之路 ,真的不来了解一下吗? GitHub 6.6k Star 的Java工程师成神之路 ,真的确定不来了解一下吗? 这是一个知乎上面很火的问题(https://www.zhihu.com/question/50211894),下面是我关于这个问题的回答,截止今天,这个答案收获了500+赞和70+评论。 原答案 这个问题只是开个场,热个身而已啊。 StringBuffer,StringBuilder区别是啥? 什么是线程安全? 如何保证线程安全? 什么是锁?死锁? synchronized的实现原理是什么? 有了synchronized,还要volatile干什么? synchronized的锁优化是怎么回事?(锁粗化?锁

优秀的个人博客,低调大师

精心整理了15道面试官喜欢问的MyBatis面试题

1、什么是 MyBatis?答:MyBatis 是一个可以自定义 SQL、存储过程和高级映射的持久层框架。2、讲下 MyBatis 的缓存答:MyBatis 的缓存分为一级缓存和二级缓存,一级缓存放在 session 里面,默认就有,二级缓存放在它的命名空间里,默认是不打开的,使用二级缓存属性类需要实现 Serializable 序列化接口(可用来保存对象的状态),可在它的映射文件中配置3、Mybatis 是如何进行分页的?分页插件的原理是什么?答:1)Mybatis 使用 RowBounds 对象进行分页,也可以直接编写 sql 实现分页,也可以使用Mybatis 的分页插件。2)分页插件的原理:实现 Mybatis 提供的接口,实现自定义插件,在插件的拦截方法内拦截待执行的 sql,然后重写 sql。举例:select from student,拦截 sql 后重写为:select t. from (select * from student)tlimit 0,104、简述 Mybatis 的插件运行原理,以及如何编写一个插件?答:1)Mybatis 仅可以编写针对 ParameterHandler、ResultSetHandler、StatementHandler、Executor 这 4 种接口的插件,Mybatis 通过动态代理,为需要拦截的接口生成代理对象以实现接口方法拦截功能,每当执行这 4 种接口对象的方法时,就会进入拦截方法,具体就是InvocationHandler 的 invoke()方法,当然,只会拦截那些你指定需要拦截的方法。2)实现 Mybatis 的 Interceptor 接口并复写 intercept()方法,然后在给插件编写注解,指定要拦截哪一个接口的哪些方法即可,记住,别忘了在配置文件中配置你编写的插件。5、Mybatis 动态 sql 是做什么的?都有哪些动态 sql?能简述一下动态 sql 的执行原理不?答:1)Mybatis 动态 sql 可以让我们在 Xml 映射文件内,以标签的形式编写动态 sql,完成逻辑判断和动态拼接 sql 的功能。2)Mybatis 提供了 9 种动态 sql 标签:trim|where|set|foreach|if|choose|when|otherwise|bind。3)其执行原理为,使用 OGNL 从 sql 参数对象中计算表达式的值,根据表达式的值动态拼接 sql,以此来完成动态 sql 的功能。6、#{}和${}的区别是什么?答:1)#{}是预编译处理,${}是字符串替换。2)Mybatis 在处理#{}时,会将 sql 中的#{}替换为?号,调用 PreparedStatement 的 set 方法来赋值;3)Mybatis 在处理${}时,就是把${}替换成变量的值。4)使用#{}可以有效的防止 SQL 注入,提高系统安全性。7、为什么说 Mybatis 是半自动 ORM 映射工具?它与全自动的区别在哪里?答:Hibernate 属于全自动 ORM 映射工具,使用 Hibernate 查询关联对象或者关联集合对象时,可以根据对象关系模型直接获取,所以它是全自动的。而 Mybatis 在查询关联对象或关联集合对象时,需要手动编写 sql 来完成,所以,称之为半自动 ORM 映射工具。8、Mybatis 是否支持延迟加载?如果支持,它的实现原理是什么?答:1)Mybatis 仅支持 association 关联对象和 collection 关联集合对象的延迟加载,association指的就是一对一,collection 指的就是一对多查询。在 Mybatis 配置文件中,可以配置是否启用延迟加载 lazyLoadingEnabled=true|false。2)它的原理是,使用 CGLIB 创建目标对象的代理对象,当调用目标方法时,进入拦截器方法,比如调用 a.getB().getName(),拦截器 invoke()方法发现 a.getB()是 null 值,那么就会单独发送事先保存好的查询关联 B 对象的 sql,把 B 查询上来,然后调用 a.setB(b),于是 a 的对象 b 属性就有值了,接着完成 a.getB().getName()方法的调用。这就是延迟加载的基本原理。9、MyBatis 与 Hibernate 有哪些不同?答:1)Mybatis 和 hibernate 不同,它不完全是一个 ORM 框架,因为 MyBatis 需要程序员自己编写 Sql 语句,不过 mybatis 可以通过 XML 或注解方式灵活配置要运行的 sql 语句,并将java 对象和 sql 语句映射生成最终执行的 sql,最后将 sql 执行的结果再映射生成 java 对象。2)Mybatis 学习门槛低,简单易学,程序员直接编写原生态 sql,可严格控制 sql 执行性能,灵活度高,非常适合对关系数据模型要求不高的软件开发,例如互联网软件、企业运营类软件等,因为这类软件需求变化频繁,一但需求变化要求成果输出迅速。但是灵活的前提是 mybatis 无法做到数据库无关性,如果需要实现支持多种数据库的软件则需要自定义多套 sql 映射文件,工作量大。3)Hibernate 对象/关系映射能力强,数据库无关性好,对于关系模型要求高的软件(例如需求固定的定制化软件)如果用 hibernate 开发可以节省很多代码,提高效率。但是Hibernate 的缺点是学习门槛高,要精通门槛更高,而且怎么设计 O/R 映射,在性能和对象模型之间如何权衡,以及怎样用好 Hibernate 需要具有很强的经验和能力才行。总之,按照用户的需求在有限的资源环境下只要能做出维护性、扩展性良好的软件架构都是好架构,所以框架只有适合才是最好。10、MyBatis 的好处是什么?答:1)MyBatis 把 sql 语句从 Java 源程序中独立出来,放在单独的 XML 文件中编写,给程序的维护带来了很大便利。2)MyBatis 封装了底层 JDBC API 的调用细节,并能自动将结果集转换成 Java Bean 对象,大大简化了 Java 数据库编程的重复工作。3)因为 MyBatis 需要程序员自己去编写 sql 语句,程序员可以结合数据库自身的特点灵活控制 sql 语句,因此能够实现比 Hibernate 等全自动 orm 框架更高的查询效率,能够完成复杂查询。11、简述 Mybatis 的 Xml 映射文件和 Mybatis 内部数据结构之间的映射关系?答:Mybatis 将所有 Xml 配置信息都封装到 All-In-One 重量级对象 Configuration 内部。在Xml 映射文件中,标签会被解析为 ParameterMap 对象,其每个子元素会被解析为 ParameterMapping 对象。标签会被解析为 ResultMap 对象,其每个子元素会被解析为 ResultMapping 对象。每一个、、、标签均会被解析为 MappedStatement 对象,标签内的 sql 会被解析为 BoundSql 对象。12、什么是 MyBatis 的接口绑定,有什么好处?答:接口映射就是在 MyBatis 中任意定义接口,然后把接口里面的方法和 SQL 语句绑定,我们直接调用接口方法就可以,这样比起原来了 SqlSession 提供的方法我们可以有更加灵活的选择和设置.13、接口绑定有几种实现方式,分别是怎么实现的?答:接口绑定有两种实现方式,一种是通过注解绑定,就是在接口的方法上面加上@Select@Update 等注解里面包含 Sql 语句来绑定,另外一种就是通过 xml 里面写 SQL 来绑定,在这种情况下,要指定 xml 映射文件里面的 namespace 必须为接口的全路径名.14、什么情况下用注解绑定,什么情况下用 xml 绑定?答:当 Sql 语句比较简单时候,用注解绑定;当 SQL 语句比较复杂时候,用 xml 绑定,一般用xml 绑定的比较多15、MyBatis 实现一对一有几种方式?具体怎么操作的?答:有联合查询和嵌套查询,联合查询是几个表联合查询,只查询一次,通过在 resultMap 里面配置 association 节点配置一对一的类就可以完成;嵌套查询是先查一个表,根据这个表里面的结果的外键 id,去再另外一个表里面查询数据,也是通过 association 配置,但另外一个表的查询通过 select 属性配置。 喜欢文章记得点个赞,感谢支持!

优秀的个人博客,低调大师

5G四问:网速快百倍 万物皆互联

从去年以来,5G的新闻逐渐增多。尤其是在去年年底,中国公司华为牵头的Polar Code(极化码)方案被3GPP标准组织采纳为5G的控制信道编码方案,更是引发一场关于5G的舆论盛宴。根据工信部公布的消息,目前我国5G研发已经进入第二阶段。我国在5G的愿景、需求、概念和无线技术以及网络架构等方面,取得了一系列成果,主要观点也获得了全球业界广泛认同。一切迹象都在透露着一个基本信息:5G真的要来了。关于5G你知道多少?看完以下几个关于5G的问题,你会对5G有更全面的了解。 什么是5G? 在3G、4G、5G等名词中,“G”是英文“Generation”(第×代)的缩写。换句话说,5G的字面意思就是第5代移动通信技术。 作为下一代移动通信技术,5G对移动互联网和用户体验将是颠覆性的,同时也将带来巨大的商机。目前,包括高通、华为、爱立信、诺基亚、中兴等在内的很多公司,都已开始对5G网络的测试工作。同时,像谷歌、微软、Facebook等科技公司,也都盯上了5G技术带来的商业利益。简而言之,相对于4G,5G的网速将会更快,功耗将会更低。 什么时候能用到5G? 5G概念其实已经提出很多年头,早在2006年高通即开始研发5G。然而,截至目前,业内仍尚未确定最终的5G标准。 按照各界预计,5G的准确定义最快有望在2018年一季度敲定,随后国际电信联盟(ITU)将于2019年制定5G标准。标准中将明确定义,“5G”网络应当是什么样,以及上下行速率等关键性能指标如何。 我国在5G研发起步较早。在2013年,工信部、发改委、科技部就联合成立IMT-2020(5G)推进组,对我国5G愿景与需求、5G频谱问题、5G关键技术、5G标准化等问题展开研究和布局。 根据工信部、中国IMT-2020(5G)推进组工作部署以及三大运营商的5G商用计划,我国将于2017年展开5G网络第二阶段测试,2018年进行大规模试验组网,并在此基础上于2019年启动5G网络建设,最快2020年正式商用。 5G有什么优势? 对用户来说,5G带来最直观的感受,就是上网速度的提升。理论上来说,5G的网速能达到4G的10-100倍,从而实时传输8K分辨率的3D视频,或是在6秒内下载一部3D电影。作为对比,通过4G网络的下载需要6分钟。 5G网络的另一大特点是低时延,这意味着网络对用户命令的响应速度将非常快。在这样的情况下,网站、应用和各种服务的加载都会更快。 其实,5G还有一个更大的用途,那就是5G能够实现“万物互联”! 如果说2G能实现人与人之间的语音通信、短信聊天,3G则可以在2G的基础上实现图片传输,4G包含3G网络能做的一切之外还可实现视频实时传输,那么5G将实现人、机器、手机、交通工具、家用电器等物体的数据交互。 在未来的世界里,几乎所有东西都会被连接到网络。想象一下:清晨醒来,卧室的灯和空调自动开启;来到卫生间,洗脸水已自动调至适合的温度,数码牙刷记录并上传牙齿以及口腔的实时数据;吃过早餐,自动驾驶的汽车让你轻松在城市里移动……这样的场景,在5G时代将有望成为现实。 5G费用会不会更高? 业内普遍认为,5G网络一旦正式商用,有望撬动规模达万亿元的物联网产业。5G将是连接所有行业和生态圈的底层基础设施,是卡位未来的重要武器。 与此同时,5G一出,不少还在使用2G、3G网络的人坐不住了。毕竟4G网速已经很快了,频繁地更新换代会不会造成资源的浪费?更为重要的是,是不是会带来网络资费的大幅提升?好在,这两个问题的答案都是否定的。 专家分析说,如果仅仅是技术进步而没有需求,即便把5G建设起来也没有市场,关键还是有需求的导向。2020年5G商用并不是全国的5G就完全无缝覆盖,它的建设需要一个周期,而且5G商用后4G、3G、2G这些网络也会继续工作一段时间,就像现在很多人用4G,实际上3G网络、2G网络都在工作一样,有一个逐步替换的过程。 专家普遍预计,未来随着5G频率的效率更高,单位流量资费肯定要比现在4G有进一步下降。 作者:任幽 来源:51CTO

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册