首页 文章 精选 留言 我的

精选列表

搜索[智能推荐],共10000篇文章
优秀的个人博客,低调大师

C语言大牛推荐初学者不要犯的17种BUG

C语言的最大特点是:功能强、使用方便灵活。C编译的程序对语法检查并不象其它高级语言那么严格,这就给编程人员留下“灵活的余地”。 但由于这个灵活给程序的调试带来了许多不便,尤其对初学C语言的人来说,经常会出一些连自己都不知道错在哪里的错误。看着有错的程序,不知该如何改起,我们通过对C的学习,积累了一些C编程时常犯的错误,写给各位小伙伴以供参考。 一.书写标识符时,忽略了大小写字母的区别 main(){ int a=5; printf("%d",A);} 编译程序把a和A认为是两个不同的变量名,而显示出错信息。 C认为大写字母和小写字母是两个不同的字符。 习惯上,符号常量名用大写,变量名用小写表示,以增加可读性。 二.忽略了变量的类型,进行了不合法的运算 代码如下: main(){ float a,b; printf("%d",a%b);} %是求余运算,得到a/b的整余数。 整型变量a和b可以进行求余运算,而实型变量则不允许进行“求余”运算。 三.将字符常量与字符串常量混淆 char c; c=”a”; 在这里就混淆了字符常量与字符串常量,字符常量是由一对单引号括起来的单个字符,字符串常量是一对双引号括起来的字符序列。 C规定以“”作字符串结束标志,它是由系统自动加上的,所以字符串“a”实际上包含两个字符:‘a’和‘’,而把它赋给一个字符变量是不行的。 四.忽略了“=”与“==”的区别 在许多高级语言中,用“=”符号作为关系运算符“等于”。如在BASIC程序中可以写 if (a=3) then … 但C语言中,“=”是赋值运算符,“==”是关系运算符。如: if (a==3) a=b; 前者是进行比较,a是否和3相等,后者表示如果a和3相等,把b值赋给a。由于习惯问题,初学者往往会犯这样的错误。 五.忘记加分号 分号是C语句中不可缺少的一部分,语句末尾必须有分号。 a=1 b=2 编译时,编译程序在“a=1”后面没发现分号,就把下一行“b=2”也作为上一行语句的一部分,这就会出现语法错误。 改错时,有时在被指出有错的一行中未发现错误,就需要看一下上一行是否漏掉了分号。 代码如下: { z=x+y; t=z/100; printf("%f",t);} 对于复合语句来说,最后一个语句中最后的分号不能忽略不写(这是和PASCAL不同的)。 六.多加分号 对于一个复合语句,代码如下: { z=x+y; t=z/100; printf("%f",t);}; 复合语句的花括号后不应再加分号,否则将会画蛇添足。又如: if (a%3==0); I++; 本是如果3整除a,则I加1。但由于if (a%3==0)后多加了分号,则if语句到此结束,程序将执行I++语句,不论3是否整除a,I都将自动加1。再如: for (I=0;I<5;I++); {scanf(“%d”,&x); printf(“%d”,x);} 本意是先后输入5个数,每输入一个数后再将它输出。由于for()后多加了一个分号,使循环体变为空语句,此时只能输入一个数并输出它。 七.输入变量时忘记加地址运算符“&” int a,b; scanf(“%d%d”,a,b); 这是不合法的。Scanf函数的作用是:按照a、b在内存的地址将a、b的值存进去。“&a”指a在内存中的地址。 八.输入数据的方式与要求不符 ①scanf(“%d%d”,&a,&b); 输入时,不能用逗号作两个数据间的分隔符,如下面输入不合法: 3,4 输入数据时,在两个数据之间以一个或多个空格间隔,也可用回车键,跳格键tab。 ②scanf(“%d,%d”,&a,&b); C规定:如果在“格式控制”字符串中除了格式说明以外还有其它字符,则在输入数据时应输入与这些字符相同的字符。下面输入是合法的: 3,4 此时不用逗号而用空格或其它字符是不对的。 3 4 3:4 又如: scanf(“a=%d,b=%d”,&a,&b); 输入应如以下形式: a=3,b=4 九.输入字符的格式与要求不一致 在用“%c”格式输入字符时,“空格字符”和“转义字符”都作为有效字符输入。 scanf(“%c%c%c”,&c1,&c2,&c3); 如输入a b c 字符“a”送给c1,字符“ ”送给c2,字符“b”送给c3,因为%c只要求读入一个字符,后面不需要用空格作为两个字符的间隔。 十.输入输出的数据类型与所用格式说明符不一致 例如,a已定义为整型,b定义为实型 a=3;b=4.5; printf(“%f%d ”,a,b); 编译时不给出出错信息,但运行结果将与原意不符。这种错误尤其需要注意。 十一.输入数据时,企图规定精度 scanf(“%7.2f”,&a); 这样做是不合法的,输入数据时不能规定精度。 十二.switch语句中漏写break语句 例如:根据考试成绩的等级打印出百分制数段。 switch(grade) { case ‘A’:printf(“85~100 ”); case ‘B’:printf(“70~84 ”); case ‘C’:printf(“60~69 ”); case ‘D’:printf(“<60 ”); default:printf(“error ”); } 由于漏写了break语句,case只起标号的作用,而不起判断作用。 因此,当grade值为A时,printf函数在执行完第一个语句后接着执行第二、三、四、五个printf函数语句。正确写法应在每个分支后再加上“break;”。 例如 case ‘A’:printf(“85~100 ”);break; 十三.忽视了while和do-while语句在细节上的区别 (1) main() {int a=0,I; scanf(“%d”,&I); while(I<=10) {a=a+I; I++; } printf(“%d”,a); } (2) main() {int a=0,I; scanf(“%d”,&I); do {a=a+I; I++; }while(I<=10); printf(“%d”,a); } 可以看到,当输入I的值小于或等于10时,二者得到的结果相同。而当I>10时,二者结果就不同了。 因为while循环是先判断后执行,而do- while循环是先执行后判断。对于大于10的数while循环一次也不执行循环体,而do-while语句则要执行一次循环体。 十四.定义数组时误用变量 int n; scanf(“%d”,&n); int a[n]; 数组名后用方括号括起来的是常量表达式,可以包括常量和符号常量。即C不允许对数组的大小作动态定义。 十五.在定义数组时将定义的“元素个数”误认为是可使的最大下标值 main() {static int a[10]={1,2,3,4,5,6,7,8,9,10}; printf(“%d”,a[10]); } C语言规定:定义时用a[10],表示a数组有10个元素。其下标值由0开始,所以数组元素a[10]是不存在的。 十六.在不应加地址运算符&的位置加了地址运算符 scanf(“%s”,&str); C语言编译系统对数组名的处理是:数组名代表该数组的起始地址,且scanf函数中的输入项是字符数组名,不必要再加地址符&。应改为: scanf(“%s”,str); 十七.同时定义了形参和函数中的局部变量 int max(x,y) int x,y,z; { z=x>y?x:y; return(z); } 形参应该在函数体外定义,而局部变量应该在函数体内定义。应改为: int max(x,y) int x,y; { int z; z=x>y?x:y; return(z); } -

优秀的个人博客,低调大师

推荐 :手把手教你用Python进行Web抓取(附代码)

作为一名数据科学家,我在工作中所做的第一件事就是网络数据采集。使用代码从网站收集数据,当时对我来说是一个完全陌生的概念,但它是最合理、最容易获取的数据来源之一。经过几次尝试,网络抓取已经成为我的第二天性,也是我几乎每天使用的技能之一。 在本教程中,我将介绍一个简单的例子,说明如何抓取一个网站,我将从Fast Track上收集2018年百强公司的数据: Fast Track: http://www.fasttrack.co.uk/ 使用网络爬虫将此过程自动化,避免了手工收集数据,节省了时间,还可以让所有数据都放在一个结构化文件中。 用Python实现一个简单的网络爬虫的快速示例,您可以在GitHub上找到本教程中所介绍的完整代码。 GitHub链接: https://github.com/kaparker/tutorials/blob/master/pythonscraper/websitescrapefasttrack.py 以下是本文使用Python进行网页抓取的简短教程概述: ●连接到网页 ●使用BeautifulSoup解析html ●循环通过soup对象找到元素 ●执行一些简单的数据清理 ●将数据写入csv 准备开始 在开始使用任何Python应用程序之前,要问的第一个问题是:我需要哪些库? 对于web抓取,有一些不同的库需要考虑,包括: ●Beautiful Soup ●Requests ●Scrapy ●Selenium 在本例中我们使用Beautiful Soup。你可以使用Python包管理器 pip 安装Beautiful Soup: pip install BeautifulSoup4 安装好这些库之后,让我们开始吧! 检查网页 要知道在Python代码中需要定位哪些元素,首先需要检查网页。 要从Tech Track Top 100 companies收集数据,可以通过右键单击感兴趣的元素来检查页面,然后选择检查。这将打开HTML代码,我们可以在其中看到每个字段包含在其中的元素。 Tech Track Top 100 companies链接: http://www.fasttrack.co.uk/league-tables/tech-track-100/league-table/ 右键单击感兴趣的元素并选择“Inspect”,显示html元素。 由于数据存储在一个表中,因此只需几行代码就可以直接获取数据。如果您想练习抓取网站,这是一个很好的例子,也是一个好的开始,但请记住,它并不总是那么简单! 所有100个结果都包含在<tr> 元素的行中,并且这些在一页上都可见。情况并非总是如此,当结果跨越多个页面时,您可能需要更改网页上显示的结果数量,或者遍历所有页面以收集所有信息。 League Table网页上显示了包含100个结果的表。检查页面时,很容易在html中看到一个模式。结果包含在表格中的行中: <table class="tableSorter"> 重复的行<tr> 将通过在Python中使用循环来查找数据并写入文件来保持我们的代码最小化! 附注:可以做的另一项检查是网站上是否发出了HTTP GET请求,该请求可能已经将结果作为结构化响应(如JSON或XML格式)返回。您可以在检查工具的网络选项卡中进行检查,通常在XHR选项卡中进行检查。刷新页面后,它将在加载时显示请求,如果响应包含格式化结构,则使用REST客户端(如Insomnia)返回输出通常更容易。 刷新网页后,页面检查工具的网络选项卡 使用Beautiful Soup解析网页html 现在您已经查看了html的结构并熟悉了将要抓取的内容,是时候开始使用Python了! 第一步是导入将用于网络爬虫的库。我们已经讨论过上面的BeautifulSoup,它有助于我们处理html。我们导入的下一个库是urllib,它连接到网页。最后,我们将输出写入csv,因此我们还需要导入csv 库。作为替代方案,可以在此处使用json库。 # import libraries from bs4 import BeautifulSoup import urllib.request import csv 下一步是定义您正在抓取的网址。如上一节所述,此网页在一个页面上显示所有结果,因此此处给出了地址栏中的完整url: # specify the url urlpage = 'http://www.fasttrack.co.uk/league-tables/tech-track-100/league-table/' 然后我们建立与网页的连接,我们可以使用BeautifulSoup解析html,将对象存储在变量'soup'中: # query the website and return the html to the variable 'page' page = urllib.request.urlopen(urlpage) # parse the html using beautiful soup and store in variable 'soup' soup = BeautifulSoup(page, 'html.parser') 我们可以在这个阶段打印soup变量,它应该返回我们请求网页的完整解析的html。 print(soup) 如果存在错误或变量为空,则请求可能不成功。可以使用urllib.error模块在此时实现错误处理。 搜索html元素 由于所有结果都包含在表中,我们可以使用find 方法搜索表的soup对象。然后我们可以使用find_all 方法查找表中的每一行。 如果我们打印行数,我们应该得到101的结果,100行加上标题。 # find results within table table = soup.find('table', attrs={'class': 'tableSorter'}) results = table.find_all('tr') print('Number of results', len(results)) 因此,我们可以对结果进行循环以收集数据。 打印soup对象的前两行,我们可以看到每行的结构是: <tr> <th>Rank</th> <th>Company</th> <th class="">Location</th> <th>Year end</th> <th class="" style="text-align:right;">Annual sales rise over 3 years</th> <th class="" style="text-align:right;">Latest sales £000s</th> <th class="" style="text-align:right;">Staff</th> <th class="">Comment</th> <!-- <th>FYE</th>--> </tr> <tr> <td>1</td> <td><a href="http://www.fasttrack.co.uk/company_profile/wonderbly-3/"><span>Wonderbly</span></a>Personalised children's books</td> <td>East London</td> <td>Apr-17</td> <td style="text-align:right;">294.27%</td> <td style="text-align:right;">*25,860</td> <td style="text-align:right;">80</td> <td>Has sold nearly 3m customisable children’s books in 200 countries</td> <!-- <td>Apr-17</td>--> </tr> 表格中有8栏:Rank,Company,Location,Year End,Annual Sales Rise,Latest Sales, Staff and Comments,所有这些都是我们可以保存的感兴趣的数据。 网页的所有行的结构都是一致的(对于所有网站来说可能并非总是如此!)。因此,我们可以再次使用find_all 方法将每一列分配给一个变量,那么我们可以通过搜索<td> 元素来写入csv或JSON。 循环遍历元素并保存变量 在Python中,将结果附加到一个列表中是很有用的,然后将数据写到一个文件中。我们应该在循环之前声明列表并设置csv的头文件,如下所示: # create and write headers to a list rows = [] rows.append(['Rank', 'Company Name', 'Webpage', 'Description', 'Location', 'Year end', 'Annual sales rise over 3 years', 'Sales £000s', 'Staff', 'Comments']) print(rows) 这将打印出我们添加到包含标题的列表的第一行。 你可能会注意到表格中有一些额外的字段Webpage和Description不是列名,但是如果你仔细看看我们打印上面的soup变量时的html,那么第二行不仅仅包含公司名称。我们可以使用一些进一步的提取来获取这些额外信息。 下一步是循环结果,处理数据并附加到可以写入csv的rows。 在循环中查找结果: # loop over results for result in results: # find all columns per result data = result.find_all('td') # check that columns have data if len(data) == 0: continue 由于表中的第一行仅包含标题,因此我们可以跳过此结果,如上所示。它也不包含任何<td>元素,因此在搜索元素时,不会返回任何内容。然后,我们可以通过要求数据的长度为非零来检查是否只处理包含数据的结果。 然后我们可以开始处理数据并保存到变量中。 # write columns to variables rank = data[0].getText() company = data[1].getText() location = data[2].getText() yearend = data[3].getText() salesrise = data[4].getText() sales = data[5].getText() staff = data[6].getText() comments = data[7].getText() 以上只是从每个列获取文本并保存到变量。但是,其中一些数据需要进一步清理以删除不需要的字符或提取更多信息。 数据清理 如果我们打印出变量company,该文本不仅包含公司名称,还包含描述。我们然后打印sales,它包含不需要的字符,如脚注符号,最好删除。 print('Company is', company) # Company is WonderblyPersonalised children's books print('Sales', sales) # Sales *25,860 我们希望将company 分为公司名称和描述,我们可以用几行代码实现。再看一下html,对于这个列,有一个 <span> 元素只包含公司名称。此列中还有一个链接指向网站上的另一个页面,其中包含有关该公司的更多详细信息。我们将在稍后使用它! <td><a href="http://www.fasttrack.co.uk/company_profile/wonderbly-3/"><span>Wonderbly</span></a>Personalised children's books</td> 要将company 分成两个字段,我们可以使用find方法保存<span>元素,然后使用strip 或replace 从company 变量中删除公司名称,这样它只留下描述。 要从sales中删除不需要的字符,我们可以再次使用strip和replace 方法! # extract description from the name companyname = data[1].find('span', attrs={'class':'company-name'}).getText() description = company.replace(companyname, '') # remove unwanted characters sales = sales.strip('*').strip('†').replace(',','') 我们要保存的最后一个变量是公司网站。如上所述,第二列包含指向另一个页面的链接,该页面具有每个公司的概述。 每个公司页面都有自己的表格,大部分时间都包含公司网站。 检查公司页面上的url元素 要从每个表中抓取url并将其保存为变量,我们需要使用与上面相同的步骤: ●在fast track网站上找到具有公司页面网址的元素 ●向每个公司页面网址发出请求 ●使用Beautifulsoup解析html ●找到感兴趣的元素 查看一些公司页面,如上面的屏幕截图所示,网址位于表格的最后一行,因此我们可以在最后一行内搜索<a>元素。 # go to link and extract company website url = data[1].find('a').get('href') page = urllib.request.urlopen(url) # parse the html soup = BeautifulSoup(page, 'html.parser') # find the last result in the table and get the link try: tableRow = soup.find('table').find_all('tr')[-1] webpage = tableRow.find('a').get('href') except: webpage = None 也有可能出现公司网站未显示的情况,因此我们可以使用try except条件,以防万一找不到网址。 一旦我们将所有数据保存到变量中,我们可以在循环中将每个结果添加到列表rows。 # write each result to rows rows.append([rank, company, webpage, description, location, yearend, salesrise, sales, staff, comments]) print(rows) 然后可以试着在循环外打印变量,在将其写入文件之前检查它是否符合您的预期! 写入输出文件 如果想保存此数据以进行分析,可以用Python从我们列表中非常简单地实现。 # Create csv and write rows to output file with open('techtrack100.csv','w', newline='') as f_output: csv_output = csv.writer(f_output) csv_output.writerows(rows) 运行Python脚本时,将生成包含100行结果的输出文件,您可以更详细地查看这些结果! 原文发布时间为:2018-11-26 本文作者:Kerry Parker 本文来自云栖社区合作伙伴“数据分析”,了解相关信息可以关注“数据分析”。

优秀的个人博客,低调大师

推荐一个markdown格式转html格式的开源JavaScript库

这个markdown格式转html格式的开源JavaScript库在github上的地址: https://github.com/millerblack/markdown-js 从markdown 格式转成html源代码格式 新建一个以js结尾的文件,将下列内容粘贴进去: var markdown = require( "markdown" ).markdown; console.log( markdown.toHTML( "Hello *World*!" ) ); 用nodejs执行,可以看到markdown格式的字符串: Hello World! 被自动转换成了html格式的字符串: Hello World! 除了nodejs以外,我们还可以在浏览器里使用这个开源库。 新建一个html,将下列源码粘贴进去: <!DOCTYPE html> <html> <body> <textarea id="text-input" oninput="this.editor.update()" rows="6" cols="60">Type **Markdown** here.</textarea> <div id="preview"> </div> <script src="../node_modules/markdown/lib/markdown.js"></script> <script> function Editor(input, preview) { this.update = function () { preview.innerHTML = markdown.toHTML(input.value); }; input.editor = this; this.update(); } var $ = function (id) { return document.getElementById(id); }; new Editor($("text-input"), $("preview")); </script> </body> </html> 用浏览器打开这个html,在顶部输入框里输入markdown代码后,能自动调用这个开源库,转换成html源代码,然后赋给innerHTML, 这样我们在UI上能看到实时的markdown代码转html代码的结果。

优秀的个人博客,低调大师

编写灵活、稳定、高质量的CSS代码的规范(推荐收藏)

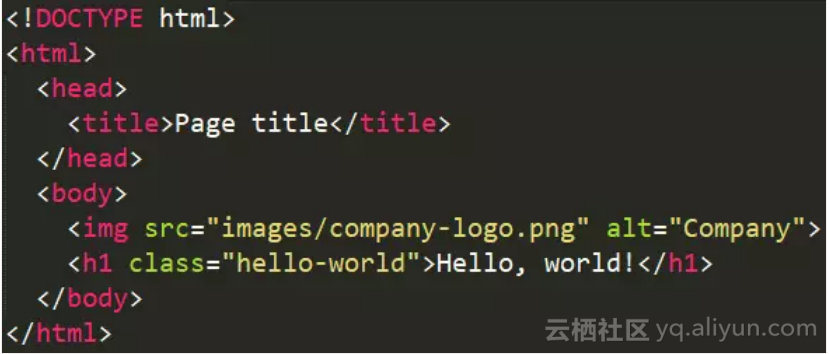
一、唯一定律 无论有多少人共同参与同一项目,一定要确保每一行代码都像是唯一个人编写的。 二、HTML 2.1 语法 (1)用两个空格来代替制表符(tab) -- 这是唯一能保证在所有环境下获得一致展现的方法。 (2)嵌套元素应当缩进一次(即两个空格)。 (3)对于属性的定义,确保全部使用双引号,绝不要使用单引号。 (4)不要在自闭合(self-closing)元素的尾部添加斜线 -- HTML5 规范中明确说明这是可选的。 (5)不要省略可选的结束标签(closing tag)(例如,</li> 或 </body>)。 2.2 Example 三、HTML5 doctype 为每个 HTML 页面的第一行添加标准模式(standard mode)的声明,这样能够确保在每个浏览器中拥有一致的展现。 四、语言属性 根据 HTML5 规范: 强烈建议为 html 根元素指定 lang 属性,从而为文档设置正确的语言。这将有助于语音合成工具确定其所应该采用的发音,有助于翻译工具确定其翻译时所应遵守的规则等等。 五、IE 兼容模式 IE 支持通过特定的 <meta> 标签来确定绘制当前页面所应该采用的 IE 版本。除非有强烈的特殊需求,否则最好是设置为 edge mode,从而通知 IE 采用其所支持的最新的模式。 六、字符编码 通过明确声明字符编码,能够确保浏览器快速并容易的判断页面内容的渲染方式。这样做的好处是,可以避免在 HTML 中使用字符实体标记(character entity),从而全部与文档编码一致(一般采用 UTF-8 编码)。 七、引入 CSS 和 JavaScript 文件 根据 HTML5 规范,在引入 CSS 和 JavaScript 文件时一般不需要指定 type 属性,因为 text/css 和 text/javascript 分别是它们的默认值。 八、实用为王 尽量遵循 HTML 标准和语义,但是不要以牺牲实用性为代价。任何时候都要尽量使用最少的标签并保持最小的复杂度。 九、属性顺序 9.1 从大到小 HTML 属性应当按照以下给出的顺序依次排列,确保代码的易读性。 (1)class (2)id, name (3)data-* (4)src, for, type, href, value (5)title, alt (6)role, aria-* 9.2 Example 9.3 说明 class 用于标识高度可复用组件,因此应该排在首位。id 用于标识具体组件,应当谨慎使用(例如,页面内的书签),因此排在第二位。 十、布尔(boolean)型属性 10.1 注意 (1)布尔型属性可以在声明时不赋值。XHTML 规范要求为其赋值,但是 HTML5 规范不需要。 (2)元素的布尔型属性如果有值,就是 true,如果没有值,就是 false。 (3)如果属性存在,其值必须是空字符串或 [...] 属性的规范名称,并且不要在首尾添加空白符。 简单来说,就是不用赋值。 10.2 Example 十一、减少标签的数量 编写 HTML 代码时,尽量避免多余的父元素。很多时候,这需要迭代和重构来实现。 十二、减少 JavaScript 生成的标签 通过 JavaScript 生成的标签让内容变得不易查找、编辑,并且降低性能。能避免时尽量避免。 编写灵活、稳定、高质量的CSS代码的规范 一、语法 1.1 注意 (1)用两个空格来代替制表符(tab) -- 这是唯一能保证在所有环境下获得一致展现的方法。 (2)为选择器分组时,将单独的选择器单独放在一行。 (3)为了代码的易读性,在每个声明块的左花括号前添加一个空格。 (4)声明块的右花括号应当单独成行。 (5)每条声明语句之后应该插入一个空格。 (6)为了获得更准确的错误报告,每条声明都应该独占一行。 (7)所有声明语句都应当以分号结尾。最后一条声明语句后面的分号是可选的,但是,如果省略这个分号,你的代码可能更易出错。 (8)对于以逗号分隔的属性值,每个逗号后面都应该插入一个空格(例如 ,box-shadow)。 (9)不要在 rgb()、rgba()、hsl()、hsla() 或 rect() 值的内部的逗号后面插入空格。这样利于从多个属性值(既加逗号也加空格)中区分多个颜色值(只加逗号,不加空格)。 (10)对于属性值或颜色参数,省略小于 1 的小数前面的 0 (例如,.5 代替 0.5;-.5px 代替 -0.5px)。 (11)十六进制值应该全部小写,例如,#fff。在扫描文档时,小写字符易于分辨,因为他们的形式更易于区分。 (12)尽量使用简写形式的十六进制值,例如,用 #fff 代替 #ffffff。 (13)为选择器中的属性添加双引号,例如,input[type="text"]。只有在某些情况下是可选的,但是,为了代码的一致性,建议都加上双引号。 (14)避免为 0 值指定单位,例如,用 margin: 0; 代替 margin: 0px;。 1.2 Example 二、声明顺序 2.1 相关属性一组 相关的属性声明应当归为一组,并按照下面的顺序排列: (1)Positioning (2)Box model (3)Typographic (4)Visual 2.2 说明 (1)由于定位(positioning)可以从正常的文档流中移除元素,并且还能覆盖盒模型(box model)相关的样式,因此排在首位。 (2)盒模型排在第二位,因为它决定了组件的尺寸和位置。 (3)其他属性只是影响组件的内部(inside)或者是不影响前两组属性,因此排在后面。 2.3 Example 三、不要使用 @import 3.1 不用原因 与 <link> 标签相比,@import 指令要慢很多,不光增加了额外的请求次数,还会导致不可预料的问题。 3.2替代方法 (1)使用多个 <link> 元素 (2)通过 Sass 或 Less 类似的 CSS 预处理器将多个 CSS 文件编译为一个文件 (3)通过 Rails、Jekyll 或其他系统中提供过 CSS 文件合并功能 3.3 Example 四、媒体查询(Media query)的位置 4.1 相关规则附近 将媒体查询放在尽可能相关规则的附近。不要将他们打包放在一个单一样式文件中或者放在文档底部。如果你把他们分开了,将来只会被大家遗忘。 4.2 Example 五、带前缀的属性 5.1 垂直对齐 当使用特定厂商的带有前缀的属性时,通过缩进的方式,让每个属性的值在垂直方向对齐,这样便于多行编辑。 5.2 Example 六、单行规则声明 6.1 放在一行 对于只包含一条声明的样式,为了易读性和便于快速编辑,建议将语句放在同一行。对于带有多条声明的样式,还是应当将声明分为多行。 6.2 错误检测 这样做的关键因素是为了错误检测 -- 例如,CSS 校验器指出在 100 行有语法错误。如果是单行单条声明,你就不会忽略这个错误;如果是单行多条声明的话,你就要仔细分析避免漏掉错误了。 6.3 Example 七、简写形式的属性声明 7.1 滥用简写 在需要显示地设置所有值的情况下,应当尽量限制使用简写形式的属性声明。常见的滥用简写属性声明的情况如下: (1)padding (2)margin (3)font (4)background (5)border (5)border-radius 7.2 说明 大部分情况下,我们不需要为简写形式的属性声明指定所有值。例如,HTML 的 heading 元素只需要设置上、下边距(margin)的值,因此,在必要的时候,只需覆盖这两个值就可以。过度使用简写形式的属性声明会导致代码混乱,并且会对属性值带来不必要的覆盖从而引起意外的副作用。 7.3 Example 八、Less 和 Sass 中的嵌套 8.1 尽量不嵌套 避免不必要的嵌套。这是因为虽然你可以使用嵌套,但是并不意味着应该使用嵌套。只有在必须将样式限制在父元素内(也就是后代选择器),并且存在多个需要嵌套的元素时才使用嵌套。 8.2 Example 九、Less 和 Sass 中的操作符 为了提高可读性,在圆括号中的数学计算表达式的数值、变量和操作符之间均添加一个空格。 十、注释 10.1 注意 代码是由人编写并维护的。请确保你的代码能够自描述、注释良好并且易于他人理解。好的代码注释能够传达上下文关系和代码目的。不要简单地重申组件或 class 名称。 对于较长的注释,务必书写完整的句子;对于一般性注解,可以书写简洁的短语。 10.2 Example 十一、class 命名 11.1 规范 (1)class 名称中只能出现小写字符和破折号(dashe)(不是下划线,也不是驼峰命名法)。破折号应当用于相关 class 的命名(类似于命名空间)(例如,.btn 和 .btn-danger)。 (2)避免过度任意的简写。.btn 代表 button,但是 .s 不能表达任何意思。 (3)class 名称应当尽可能短,并且意义明确。 (4)使用有意义的名称。使用有组织的或目的明确的名称,不要使用表现形式(presentational)的名称。 (5)基于最近的父 class 或基本(base) class 作为新 class 的前缀。 (6)使用 .js-* class 来标识行为(与样式相对),并且不要将这些 class 包含到 CSS 文件中。 在为 Sass 和 Less 变量命名时也可以参考上面列出的各项规范。 11.2 Example 十二、选择器 12.1 注意 (1)对于通用元素使用 class ,这样利于渲染性能的优化。 (2)对于经常出现的组件,避免使用属性选择器(例如,[class^="..."])。浏览器的性能会受到这些因素的影响。 (3)选择器要尽可能短,并且尽量限制组成选择器的元素个数,建议不要超过 3 。 (4)只有在必要的时候才将 class 限制在最近的父元素内(也就是后代选择器)(例如,不使用带前缀的 class 时 -- 前缀类似于命名空间)。 12.2 Example 十三、代码组织 13.1 注意 (1)以组件为单位组织代码段。 (2)制定一致的注释规范。 (3)使用一致的空白符将代码分隔成块,这样利于扫描较大的文档。 (4)如果使用了多个 CSS 文件,将其按照组件而非页面的形式分拆,因为页面会被重组,而组件只会被移动。 13.2 Example 十四、编辑器配置 14.1 避免代码不同 将你的编辑器按照下面的配置进行设置,以避免常见的代码不一致和差异: (1)用两个空格代替制表符(soft-tab 即用空格代表 tab 符)。 (2)保存文件时,删除尾部的空白符。 (3)设置文件编码为 UTF-8。 (4)在文件结尾添加一个空白行。 原文发布时间为:2018-09-4 本文作者:WEBING 本文来自云栖社区合作伙伴“前端大学”,了解相关信息可以关注“前端大学”。

优秀的个人博客,低调大师

推荐一个小而美的Python代码格式化工具

代码可读性是评判代码质量的标准之一,有一个衡量代码质量的标准是 Martin 提出的 “WFT” 定律,即每分钟爆出 “WTF” 的次数。你在读别人代码或者做 Code Review 的时候有没有 “WTF” 冲动呢? 为了帮助开发者统一代码风格,Python 社区提出了 PEP8 代码编码风格,它并没有强制要求大家必须遵循,Python 官方同时推出了一个检查代码风格是否符合 PEP8 的工具,名字也叫 pep8,后来被重命名为了pycodestyle。 看如下代码: import time, datetime class ListNode: def __init__(self, val): self.val = val self.next = None # in python ne

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册