首页 文章 精选 留言 我的

精选列表

搜索[Agent体系],共10003篇文章
优秀的个人博客,低调大师

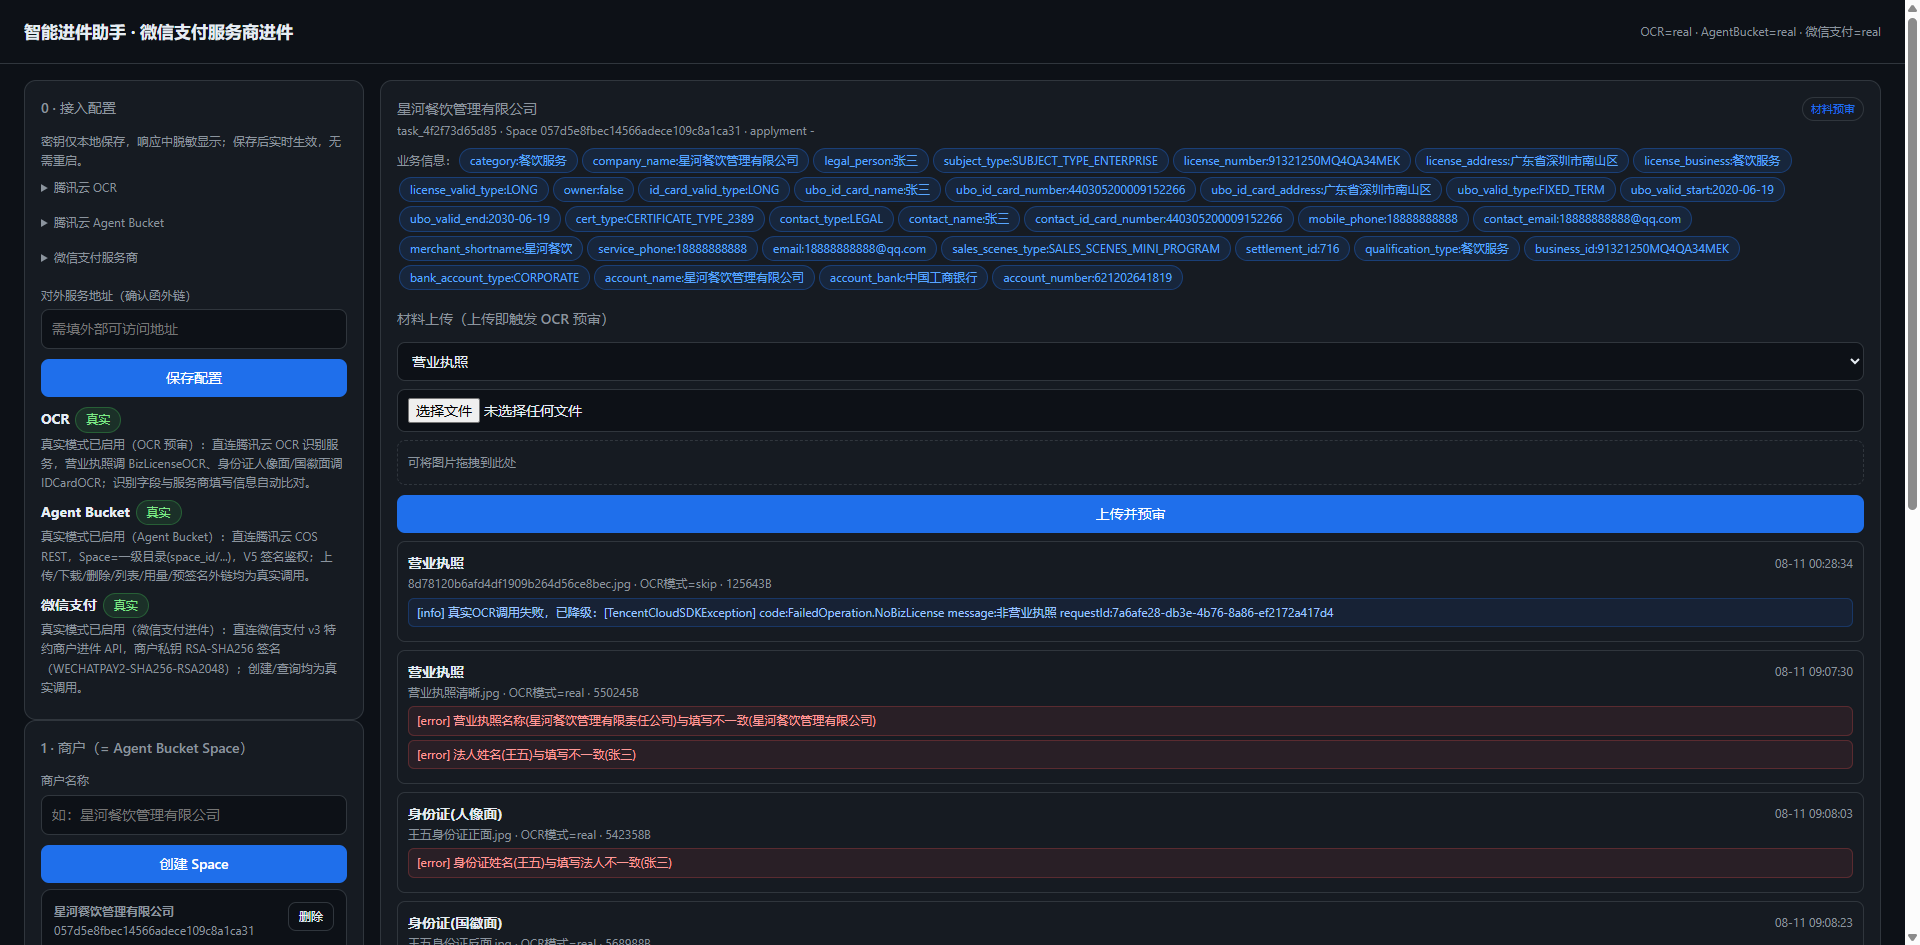
Agent Bucket + OCR + 微信支付特约商户进件:一个多智能体系统的存储底座实践

微信支付服务商替商户发起进件(即特约商户入驻)时,要采集主体、联系人、经营、结算、银行账户五大类信息,字段加起来超过四十个。其中身份证号、银行卡号、手机号属于敏感个人信息,按规定必须用微信支付平台公钥做 RSA 加密后才能上送,明文严禁出现在传输链路里。材料侧还要上传营业执照、法人身份证正反面、结算银行卡照片,商户随手一拍往往单张就有四五兆。

优秀的个人博客,低调大师

Spark 体系架构

最近看到一篇关于Spark架构的博文,作者是 Alexey Grishchenko。看过Alexey博文的同学应该都知道,他对Spark理解地非常深入,读完他的 “spark-architecture” 这篇博文,有种醍醐灌顶的感觉,从JVM内存分配到Spark集群的资源管理,步步深入,感触颇多。因此,在周末的业余时间里,将此文的核心内容译成中文,并在这里与大家分享。如在翻译过程中有文字上的表达纰漏,还请大家指出。 首先来看一张Spark 1.3.0 官方给出的图片,如下: 在这张图中,你会看到很多的术语 ,诸如“executor”, “task”, “cache”, “Worker Node” 等。原作者表示,在他开始学spark的时候,上述图是唯一一张可以找到的图片(Spark 1.3.0),形势很不乐观。更加不幸地是,这张图并没有很好地表达出Spark内在的一些概念。因此,通过不断地学习,作者将自己所学的知识整理成一个系列,而此文仅是其中的一篇。下面进入核心要点。 Spark 内存分配 在你的cluster或是local machine上正常运行的任何Spark程序都是一个JVM进程。对于任何的JVM进程,你都可以使用-Xmx和-Xms配置它的堆大小(heap size)。问题是:这些进程是如何使用它的堆内存(heap memory)以及为何需要它呢?下面围绕这个问题慢慢展开。 首先来看看下面这张Spark JVM堆内存分配图: Heap Size 默认情况下,Spark启动时会初始化512M的JVM 堆内存。处于安全角度以及避免OOM错误,Spark只允许使用90%的的堆内存,该参数可以通过Spark的spark.storage.safetyFraction参数进行控制。 OK,你可能听说Spark是基于内存的工具,它允许你将数据存在内存中。如果你读过作者的 Spark Misconceptions 这篇文章,那么你应该知道Spark其实不是真正的基于内存(in-memory)的工具。它仅仅是在LRU cache (http://en.wikipedia.org/wiki/Cache_algorithms) 过程中使用内存。所以一部分的内存用在数据缓存上,这部分通常占安全堆内存(90%)的60%,该参数也可以通过配置spark.storage.memoryFraction进行控制。因此,如果你想知道在Spark中可以缓存多少数据,你可以通过对所有executor的堆大小求和,然后乘以safetyFraction 和storage.memoryFraction即可,默认情况下是0.9 * 0.6 = 0.54,即总的堆内存的54%可供Spark使用。 Shuffle Memory 接下来谈谈shuffle memory,计算公式是 “Heap Size” spark.shuffle.safetyFraction spark.shuffle.memoryFraction。spark.shuffle.safetyFraction的默认值是 0.8 或80%, spark.shuffle.memoryFraction的默认值是0.2或20%,所以你最后可以用于shuffle的JVM heap 内存大小是 0.8*0.2=0.16,即总heap size的16%。 问题是Spark是如何来使用这部分内存呢?官方的Github上面有更详细的解释(https://github.com/apache/spark/blob/branch-1.3/core/src/main/scala/org/apache/spark/shuffle/ShuffleMemoryManager.scala)。总得来说,Spark将这部分memory 用于Shuffle阶段调用其他的具体task。当shuffle执行之后,有时你需要对数据进行sort。在sort阶段,通常你还需要一个类似缓冲的buffer来存储已经排序好的数据(谨记,不能修改已经LRU cache中的数据,因为这些数据可能会再次使用)。因此,需要一定数量的RAM来存储已经sorted的数据块。如果你没有足够的memory用来排序,该怎么做呢?在wikipedia 搜一下“external sorting” (外排序),仔细研读一下即可。外排序允许你对块对数据块进行分类,然后将最后的结果合并到一起。 unroll Memory 关于RAM最后要讲到”unroll” memory,用于unroll 进程的内存总量计算公式为:spark.storage.unrollFraction spark.storage.memoryFraction spark.storage.safetyFraction。默认情况下是 0.2 0.6 0.9 = 0.108,即10.8%的heap size。 当你需要在内存中将数据块展开的时候使用它。为什么需要 unroll 操作呢?在Spark中,允许以 序列化(serialized )和反序列化(deserialized) 两种方式存储数据,而对于序列化后的数据是无法直接使用的,所以在使用时必须对其进行unroll操作,因此这部分RAM是用于unrolling操作的内存。unroll memory 与storage RAM 是共享的,也就是当你在对数据执行unroll操作时,如果需要内存,而这个时候内存却不够,那么可能会致使撤销存储在 Spark LRU cache中少些数据块。 Spark 集群模式JVM分配 OK,通过上面的讲解,我们应该对Spark进程有了进一步的理解,并且已经知道它是如何利用JVM进程中的内存。现在切换到集群上,以YARN模式为例。 在YARN集群里,它有一个YARN ResourceMananger 守护进程控制着集群资源(也就是memory),还有一系列运行在集群各个节点的YARN Node Managers控制着节点资源的使用。从YARN的角度来看,每个节点可以看做是可分配的RAM池,当你向ResourceManager发送request请求资源时,它会返回一些NodeManager信息,这些NodeManager将会为你提供execution container,而每个execution container 都是一个你发送请求时指定的heap size的JVM进程。JVM的位置是由 YARN ResourceMananger 管理的,你没有控制权限。如果某个节点有64GB的RAM被YARN控制着(可通过设置yarn-site.xml 配置文件中参数 yarn.nodemanager.resource.memory-mb ),当你请求10个4G内存的executors时,这些executors可能运行在同一个节点上,即便你的集群跟大也无济于事。 当以YARN模式启动spark集群时,你可以指定executors的数量(-num-executors 或者 spark.executor.instances 参数),可以指定每个executor 固有的内存大小(-executor-memory 或者 spark.executor.memory),可以指定每个executor使用的cpu核数(-executor-cores 或者 spark.executor.cores),可以指定分配给每个task的core的数量(spark.task.cpus),还可以指定 driver 上使用的内存(-driver-memory 或者 spark.driver.memory)。 当你在集群上执行应用程序时,job程序会被切分成多个stages,每个stage又会被切分成多个task,每个task单独调度,可以把每个executor的JVM进程看做是task执行槽池,每个executor 会给你的task设置 spark.executor.cores/ spark.task.cpus execution个执行槽。例如,在集群的YARN NodeManager中运行有12个节点,每个节点有64G内存和32个CPU核(16个超线程物理core)。每个节点可以启动2个26G内存的executor(剩下的RAM用于系统程序、YARN NM 和DataNode),每个executor有12个cpu核可以用于执行task(剩下的用于系统程序、YARN NM 和DataNode),这样整个集群可以处理 12 machines 2 executors per machine 12 cores per executor / 1 core = 288 个task 执行槽,这意味着你的spark集群可以同时跑288个task,几乎充分利用了所有的资源。整个集群用于缓存数据的内存有0.9 spark.storage.safetyFraction 0.6 spark.storage.memoryFraction 12 machines 2 executors per machine 26 GB per executor = 336.96 GB. 实际上没有那么多,但在大多数情况下,已经足够了。 到这里,大概已经了解了spark是如何使用JVM的内存,并且知道什么是集群的执行槽。而关于task,它是Spark执行的工作单元,并且作为exector JVM 进程中的一个thread执行。这也是为什么Spark job启动时间快的原因,在JVM中启动一个线程比启动一个单独的JVM进程块,而在Hadoop中执行MapReduce应用会启动多个JVM进程。 Spark Partition 下面来谈谈Spark的另一个抽象概念”partition”。在Spark程序运行过程中,所有的数据都会被切分成多个Partion。问题是一个parition是什么并且如何决定partition的数量呢?首先Partition的大小完全依赖于你的数据源。在Spark中,大部分用于读取数据的method都可以指定生成的RDD中Partition数量。当你从hdfs上读取一个文件时,你会使用Hadoop的InputFormat来指定,默认情况下InputFormat返回每个InputSplit都会映射到RDD中的一个Partition上。对于HDFS上的大部分文件,每个数据块都会生成一个InputSplit,大小近似为64 MB/128 MB的数据。近似情况下,HDFS上数据的块边界是按字节来算的(64MB一个块),但是当数据被处理时,它会按记录进行切分。对于文本文件来说切分的字符就是换行符,对于sequence文件,它以块结束等等。比较特殊的是压缩文件,由于整个文件被压缩了,因此不能按行进行切分了,整个文件只有一个inputsplit,这样spark中也会只有一个parition,在处理的时候需要手动对它进行repatition。 本文是对 Alexey Grishchenko 的 Distributed Systems Architecture 系列的第一篇文章核心要点的翻译,原作者的第二篇文章是关于shuffle的,【原文链接】,第三篇文章是关于memory 管理模式的,【原文链接】,极力推荐。 文章转载自 开源中国社区[http://www.oschina.net]

优秀的个人博客,低调大师

详解Kubernetes存储体系

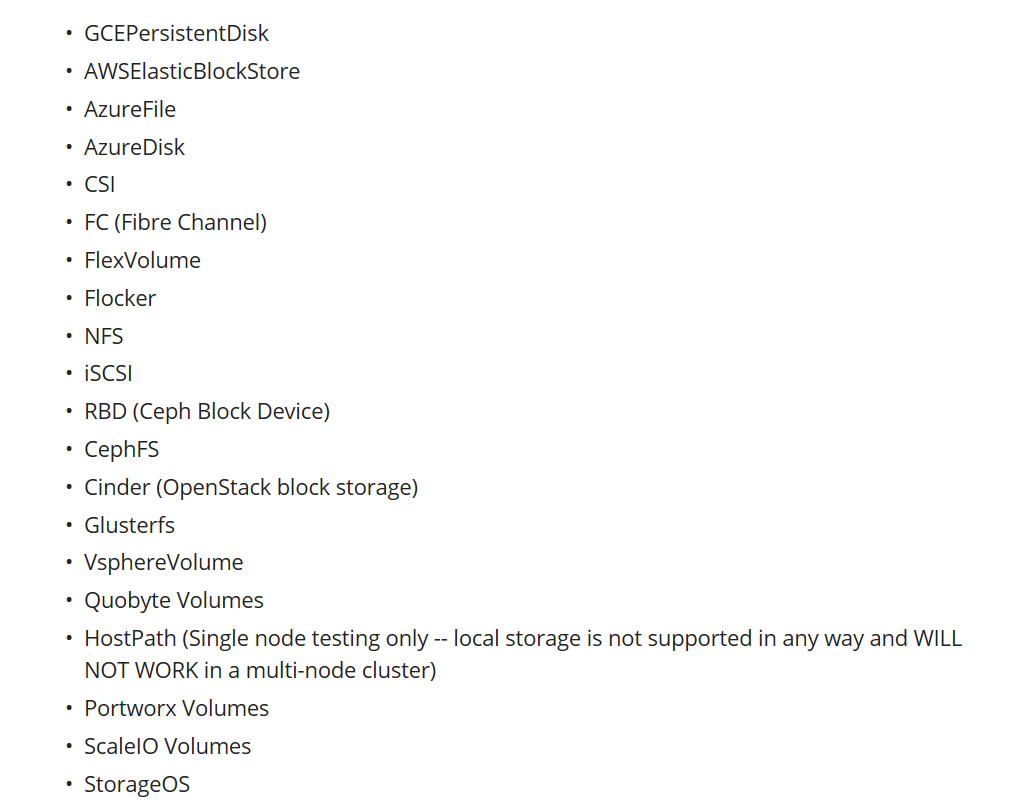
Volume、PV、PVC、StorageClass由来 先思考一个问题,为什么会引入Volume这样一个概念? “ 答案很简单,为了实现数据持久化,数据的生命周期不随着容器的消亡而消亡。 ” 在没有介绍Kubernetes Volume之前,先来回顾下Docker Volume,Docker Volume常用使用方式有两种, volumes通过这种方式, Docker管理宿主机文件系统的一部分,默认位于 /var/lib/docker/volumes目录中,由于在创建时没有创建指定数据卷, docker自身会创建默认数据卷; bind mounts通过这种方式,可以把容器内文件挂载到宿主机任意目录。 既然有了Docker Volume,为啥Kubernetes又搞出了自己的Volume?谷歌的标新立异? “ 答案是否定的,Kubernetes Volume和Docker Volume概念相似,但是又有不同的地方,Kubernetes Volume与Pod的生命周期相同,但与容器的生命周期不相关。当容器终止或重启时,Volume中的数据也不会丢失。当Pod被删除时,Volume才会被清理。并且数据是否丢失取决于Volume的具体类型,比如emptyDir类型的Volume数据会丢失,而持久化类型的数据则不会丢失。另外Kubernetes提供了将近20种Volume类型。 ” 现在有了Kubernetes的Volume,我们就可以完全可以在Yaml编排文件中填写上Volume是字段,如下nfs所示: ....volumes:-name:static-nfsnfs:server:12.18.17.240path:/nfs/data/static 如果你使用ceph作为存储插件,你可以在编排文件中这样定义: volumes:-name:ceph-volcephfs:monitors:-12.18.17.241:6789-12.18.17.242:6789user:adminsecretRef:name:ceph-secretreadOnly:true 当然只要是Kubernetes已经实现的数据卷类型,你都可以按照如上方式进行直接在Yaml编排文件中定义使用。 看到这里其实已经完成了80%的工作,那么为什么还要设计多此一举的PV呢?这个问题先搁置下,后面会有说明。 在没有说明为什么要设计多此一举的PV PVC之前,先来看看什么是PV PVC? “ PV是对持久化存储数据卷的一种描述。 ” PV通常是由运维人员提前在集群里面创建等待使用的一种数据卷。如下所示: apiVersion:v1kind:PersistentVolumemetadata:name:nfsspec:capacity:storage:10GiaccessModes:-ReadWriteManynfs:server:10.244.1.4path:"/nfs" “ PVC描述的是持久化存储的属性,比如大小、读写权限等。 ” PVC通常由开发人员创建,如下所示: apiVersion:v1kind:PersistentVolumeClaimmetadata:name:nfsspec:accessModes:-ReadWriteManyresources:requests:storage:10Gi 而用户创建的PV PVC必须绑定完成之后才能被利用起来。而PV PVC绑定起来的前提是PV中spec中声明字段大小、权限等必须满足PVC的要求。 成功绑定之后,就可以在Pod Yaml编排文件中定义和使用。如下所示: apiVersion:v1kind:Podmetadata:labels:role:webspec:containers:-name:webimage:nginxports:-name:webcontainerPort:80volumeMounts:-name:nfsmountPath:"/usr/share/nginx/html"volumes:-name:nfspersistentVolumeClaim:claimName:nfs 看到这里,我们还会认为仅仅是PV对Volume多了一层抽象,并不见得比直接在Yaml中声明Volume高明多少。仔细思考下,我们为什么能够直接在Yaml中直接定义Volume?因为Kubernetes已经帮助我们实现了这种Volume类型,如果我们有自己的存储类型,而Kubernetes中并没有实现,这种是没有办法直接在Yaml编排文件中直接定义Volume的。这个时候PV PVC面向对象的设计就体现出其价值了。这也是在软件开发领域经常碰到的问题,开源软件无法满足要求,但也没有提供出可扩展的接口,没办法,只能重新造轮子。 我们在开发过程中经常碰到这样一个问题,在Pod中声明一个PVC之后,发现Pod不能被调度成功,原因是因为PVC没有绑定到合适的PV,这个时候要求运维人员创建一个PV,紧接着Pod调度成功。刚才上在介绍PV PVC,它们的创建过程都是手动,如果集群中需要成千上万的PV,那么运维人员岂不累死?在实际操作中,这种方式根本行不通。所以Kubernetes给我们提供了一套自动创建PV的机制Dynamic Provisioning.在没有介绍这套自动创建机制之前,先看看Static Provisioning,什么是Static Provisioning?刚才人工创建PV PVC的方式就是Static Provisioning。你可以在PV PVC编排文件中声明StorageClass,如果没有声明,那么默认为"".具体交互流程如下所示: 静态分配流程 首先由集群管理员事先去规划这个集群中的用户会怎样使用存储,它会先预分配一些存储,也就是预先创建一些 PV;然后用户在提交自己的存储需求(PVC)的时候,Kubernetes内部相关组件会帮助它把PVC PV 做绑定;最后pod使用存储的时候,就可以通过PVC找到相应的PV,它就可以使用了。不足之处也非常清楚,首先繁琐,然后运维人员无法预知开发人员的真实存储需求,比如运维人员创建了多个100Gi的PV存储,但是在实际开发过程中,开发人员只能使用10Gi,这就造成了资源的浪费。当然Kubernetes也为我们提供更好的使用方式,即Dynamic Provisioning它是什么呢? “ Dynamic Provisioning包含了创建某种PV所需要的参数信息,类似于一个创建PV的模板。具体交互流程如下所示: ” Kubernetes集群中的控制器,会结合PVC和StorageClass的信息动态生成用户所需要的PV,将PVC PV进行绑定后,pod就可以使用PV了。通过 StorageClass配置生成存储所需要的存储模板,再结合用户的需求动态创建PV对象,做到按需分配,在没有增加用户使用难度的同时也解放了集群管理员的运维工作。 动态PV使用 Dynamic Provisioning上面提到过,运维人员不再预分配PV,而只是创建一个模板文件,这个模板文件正是StorageClass。下面以NFS为例进行说明,动态PV的整个使用过程。 安装NFS服务 #安装nfsyum-yinstallnfs-utilsrpcbind#开机自启动systemctlenablerpcbindnfs-server#配置nfs文件echo"/nfs/data*(rw,no_root_squash,sync)">/etc/exports 部署置备程序 apiVersion:v1kind:ServiceAccountmetadata:name:nfs-provisioner---kind:ClusterRoleapiVersion:rbac.authorization.k8s.io/v1metadata:name:nfs-provisioner-runnerrules:-apiGroups:[""]resources:["persistentvolumes"]verbs:["get","list","watch","create","delete"]-apiGroups:[""]resources:["persistentvolumeclaims"]verbs:["get","list","watch","update"]-apiGroups:["storage.k8s.io"]resources:["storageclasses"]verbs:["get","list","watch"]-apiGroups:[""]resources:["events"]verbs:["watch","create","update","patch"]-apiGroups:[""]resources:["services","endpoints"]verbs:["get","create","list","watch","update"]-apiGroups:["extensions"]resources:["podsecuritypolicies"]resourceNames:["nfs-provisioner"]verbs:["use"]---kind:ClusterRoleBindingapiVersion:rbac.authorization.k8s.io/v1metadata:name:run-nfs-provisionersubjects:-kind:ServiceAccountname:nfs-provisionernamespace:loggingroleRef:kind:ClusterRolename:nfs-provisioner-runnerapiGroup:rbac.authorization.k8s.io---kind:DeploymentapiVersion:apps/v1metadata:name:nfs-client-provisionerspec:selector:matchLabels:app:nfs-client-provisionerreplicas:1strategy:type:Recreatetemplate:metadata:labels:app:nfs-client-provisionerspec:serviceAccount:nfs-provisionercontainers:-name:nfs-client-provisionerimage:quay.io/external_storage/nfs-client-provisioner:latestimagePullPolicy:IfNotPresentvolumeMounts:-name:nfs-clientmountPath:/persistentvolumesenv:-name:PROVISIONER_NAMEvalue:fuseim.pri/ifs-name:NFS_SERVERvalue:12.18.7.20-name:NFS_PATHvalue:/nfs/datavolumes:-name:nfs-clientnfs:server:12.18.7.20path:/nfs/data 创建StorageClass模板 apiVersion:storage.k8s.io/v1kind:StorageClassmetadata:name:nfs-storageprovisioner:fuseim.pri/ifsreclaimPolicy:Retain 这些参数是通过Kubernetes创建存储的时候,需要指定的一些细节参数。对于这些参数,用户是不需要关心的,像这里provisioner指的是使用nfs的置备程序。ReclaimPolicy就是说动态创建出来的PV,当使用方使用结束、Pod 及 PVC被删除后,这块PV应该怎么处理,我们这个地方写的是Retain,意思就是说当使用方pod PVC被删除之后,这个PV会保留。 提交完成模板文件之后,用户只需要在 Pod yaml文件定义 PVC,即可自动创建 PV和 PVC。 apiVersion:apps/v1kind:StatefulSetmetadata:name:esspec:........template:metadata:labels:app:elasticsearchspec:.........initContainers:........containers:-name:elasticsearchimage:docker.elastic.co/elasticsearch/elasticsearch:7.6.2.......volumeClaimTemplates:-metadata:name:datalabels:app:elasticsearchspec:accessModes:["ReadWriteOnce"]storageClassName:nfs-storageresources:requests:storage:50Gi` Capacity:存储对象的大小; AccessModes:也是用户需要关心的,就是说使用这个PV的方式。它有三种使用方式:ReadWriteOnce是单node读写访问;ReadOnlyMany是多个node只读访问,常见的一种数据共享方式;ReadWriteMany是多个node上读写访问; StorageClassName:StorageClassName这个我们刚才说了,动态Provisioning时必须指定的一个字段,就是说我们要指定到底用哪一个模板文件来生成PV。 Kubernetes存储架构 存储架构图 PV Controller: 负责 PV PVC的绑定、生命周期管理,并根据需求进行数据卷的 Provision Delete操作 AD Controller:负责存储设备的 Attach Detach操作,将设备挂载到目标节点 Volume Manager:管理卷的 Mount Unmount操作、卷设备的格式化以及挂载到一些公用目录上的操作 Volume Plugins:它主要是对上面所有挂载功能的实现。 PV Controller、AD Controller、Volume Manager 主要是进行操作的调用,而具体操作则是由 Volume Plugins实现的。根据源码的位置可将 Volume Plugins分为 In-Tree和 Out-of-Tree两类: In-Tree表示源码是放在 Kubernetes内部的(常见的 NFS、cephfs等),和 Kubernetes一起发布、管理与迭代,缺点是迭代速度慢、灵活性差; Out-of-Tree的 Volume Plugins的代码独立于 Kubernetes,它是由存储 提供商实现的,目前主要有 Flexvolume CSI两种实现机制,可以根据存储类型实现不同的存储插件 Scheduler:实现对 Pod的调度能力,会根据一些存储相关的的定义去做存储相关的调度 动态PV交互流程 Kubernetes挂载Volume过程 用户创建一个包含 PVC的 Pod PV Controller会观察 ApiServer,如果它发现一个 PVC已经创建完毕但仍然是未绑定的状态,它就会试图把一个 PV和 PVC绑定 Provision就是从远端上一个具体的存储介质创建一个 Volume,并且在集群中创建一个 PV对象,然后将此 PV和 PVC进行绑定 Scheduler进行多个维度考量完成后,把 Pod调度到一个合适的 Node Kubelet不断 watch APIServer是否有 Pod要调度到当前所在节点 Pod调度到某个节点之后,它所定义的 PV还没有被挂载( Attach),此时 AD Controller就会调用 VolumePlugin,把远端的 Volume挂载到目标节点中的设备上( /dev/vdb);当 Volum Manager 发现一个 Pod调度到自己的节点上并且 Volume已经完成了挂载,它就会执行 mount操作,将本地设备(也就是刚才得到的 /dev/vdb)挂载到 Pod在节点上的一个子目录中 启动容器,并将已经挂载到本地的 Volume映射到容器中 总结 本文主要扯了如下内容,首先介绍Kubernetes中Volume、PV、PVC、StorageClass由来,然后介绍了StorageClass使用,最后简单介绍了Kubernetes存储架构以及动态存储交互流程。当然还有很多细节逻辑没有提到,如有兴趣,欢迎关注公众号,加我微信,一起讨论! 推荐 深入探究 K8S ConfigMap 和 Secret Kubernetes入门培训(内含PPT) 原创不易,随手关注或者”在看“,诚挚感谢! 本文分享自微信公众号 - 云原生技术爱好者社区(programmer_java)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Spark体系架构必读

最近看到一篇关于Spark架构的博文,作者是 Alexey Grishchenko。看过Alexey博文的同学应该都知道,他对Spark理解地非常深入,读完他的 “spark-architecture” 这篇博文,有种醍醐灌顶的感觉,从JVM内存分配到Spark集群的资源管理,步步深入,感触颇多。因此,在周末的业余时间里,将此文的核心内容译成中文,并在这里与大家分享。如在翻译过程中有文字上的表达纰漏,还请大家指出。 首先来看一张Spark 1.3.0 官方给出的图片,如下: 在这张图中,你会看到很多的术语 ,诸如“executor”, “task”, “cache”, “Worker Node” 等。原作者表示,在他开始学spark的时候,上述图是唯一一张可以找到的图片(Spark 1.3.0),形势很不乐观。更加不幸地是,这张图并没有很好地表达出Spark内在的一些概念。因此,通过不断地学习,作者将自己所学的知识整理成一个系列,而此文仅是其中的一篇。下面进入核心要点。 Spark 内存分配 在你的cluster或是local machine上正常运行的任何Spark程序都是一个JVM进程。对于任何的JVM进程,你都可以使用-Xmx和-Xms配置它的堆大小(heap size)。问题是:这些进程是如何使用它的堆内存(heap memory)以及为何需要它呢?下面围绕这个问题慢慢展开。 首先来看看下面这张Spark JVM堆内存分配图: Heap Size 默认情况下,Spark启动时会初始化512M的JVM 堆内存。处于安全角度以及避免OOM错误,Spark只允许使用90%的的堆内存,该参数可以通过Spark的spark.storage.safetyFraction参数进行控制。 OK,你可能听说Spark是基于内存的工具,它允许你将数据存在内存中。如果你读过作者的Spark Misconceptions这篇文章,那么你应该知道Spark其实不是真正的基于内存(in-memory)的工具。它仅仅是在LRU cache (http://en.wikipedia.org/wiki/Cache_algorithms)过程中使用内存。所以一部分的内存用在数据缓存上,这部分通常占安全堆内存(90%)的60%,该参数也可以通过配置spark.storage.memoryFraction进行控制。因此,如果你想知道在Spark中可以缓存多少数据,你可以通过对所有executor的堆大小求和,然后乘以safetyFraction 和storage.memoryFraction即可,默认情况下是0.9 * 0.6 = 0.54,即总的堆内存的54%可供Spark使用。 Shuffle Memory 接下来谈谈shuffle memory,计算公式是 “Heap Size” * spark.shuffle.safetyFraction * spark.shuffle.memoryFraction。spark.shuffle.safetyFraction的默认值是 0.8 或80%, spark.shuffle.memoryFraction的默认值是0.2或20%,所以你最后可以用于shuffle的JVM heap 内存大小是 0.8*0.2=0.16,即总heap size的16%。 问题是Spark是如何来使用这部分内存呢?官方的Github上面有更详细的解释。 总得来说,Spark将这部分memory 用于Shuffle阶段调用其他的具体task。当shuffle执行之后,有时你需要对数据进行sort。在sort阶段,通常你还需要一个类似缓冲的buffer来存储已经排序好的数据(谨记,不能修改已经LRU cache中的数据,因为这些数据可能会再次使用)。因此,需要一定数量的RAM来存储已经sorted的数据块。如果你没有足够的memory用来排序,该怎么做呢?在wikipedia 搜一下“external sorting” (外排序),仔细研读一下即可。外排序允许你对块对数据块进行分类,然后将最后的结果合并到一起。 unroll Memory 关于RAM最后要讲到”unroll” memory,用于unroll 进程的内存总量计算公式为:spark.storage.unrollFraction * spark.storage.memoryFraction *spark.storage.safetyFraction。默认情况下是 0.2 * 0.6 * 0.9 = 0.108,即10.8%的heap size。 当你需要在内存中将数据块展开的时候使用它。为什么需要 unroll 操作呢?在Spark中,允许以 序列化(serialized )和反序列化(deserialized) 两种方式存储数据,而对于序列化后的数据是无法直接使用的,所以在使用时必须对其进行unroll操作,因此这部分RAM是用于unrolling操作的内存。unroll memory 与storage RAM 是共享的,也就是当你在对数据执行unroll操作时,如果需要内存,而这个时候内存却不够,那么可能会致使撤销存储在 Spark LRU cache中少些数据块。 Spark 集群模式JVM分配 OK,通过上面的讲解,我们应该对Spark进程有了进一步的理解,并且已经知道它是如何利用JVM进程中的内存。现在切换到集群上,以YARN模式为例。 在YARN集群里,它有一个YARN ResourceMananger 守护进程控制着集群资源(也就是memory),还有一系列运行在集群各个节点的YARN Node Managers控制着节点资源的使用。从YARN的角度来看,每个节点可以看做是可分配的RAM池,当你向ResourceManager发送request请求资源时,它会返回一些NodeManager信息,这些NodeManager将会为你提供execution container,而每个execution container 都是一个你发送请求时指定的heap size的JVM进程。JVM的位置是由 YARN ResourceMananger 管理的,你没有控制权限。如果某个节点有64GB的RAM被YARN控制着(可通过设置yarn-site.xml 配置文件中参数 yarn.nodemanager.resource.memory-mb ),当你请求10个4G内存的executors时,这些executors可能运行在同一个节点上,即便你的集群跟大也无济于事。 当以YARN模式启动spark集群时,你可以指定executors的数量(-num-executors 或者 spark.executor.instances 参数),可以指定每个executor 固有的内存大小(-executor-memory 或者 spark.executor.memory),可以指定每个executor使用的cpu核数(-executor-cores 或者 spark.executor.cores),可以指定分配给每个task的core的数量(spark.task.cpus),还可以指定 driver 上使用的内存(-driver-memory 或者spark.driver.memory)。 当你在集群上执行应用程序时,job程序会被切分成多个stages,每个stage又会被切分成多个task,每个task单独调度,可以把每个executor的JVM进程看做是task执行槽池,每个executor 会给你的task设置 spark.executor.cores/ spark.task.cpus execution个执行槽。例如,在集群的YARN NodeManager中运行有12个节点,每个节点有64G内存和32个CPU核(16个超线程物理core)。每个节点可以启动2个26G内存的executor(剩下的RAM用于系统程序、YARN NM 和DataNode),每个executor有12个cpu核可以用于执行task(剩下的用于系统程序、YARN NM 和DataNode),这样整个集群可以处理 12 machines * 2 executors per machine * 12 cores per executor / 1 core = 288 个task 执行槽,这意味着你的spark集群可以同时跑288个task,几乎充分利用了所有的资源。整个集群用于缓存数据的内存有0.9 spark.storage.safetyFraction * 0.6 spark.storage.memoryFraction * 12 machines * 2 executors per machine * 26 GB per executor = 336.96 GB. 实际上没有那么多,但在大多数情况下,已经足够了。 到这里,大概已经了解了spark是如何使用JVM的内存,并且知道什么是集群的执行槽。而关于task,它是Spark执行的工作单元,并且作为exector JVM 进程中的一个thread执行。这也是为什么Spark job启动时间快的原因,在JVM中启动一个线程比启动一个单独的JVM进程块,而在Hadoop中执行MapReduce应用会启动多个JVM进程。 Spark Partition 下面来谈谈Spark的另一个抽象概念”partition”。在Spark程序运行过程中,所有的数据都会被切分成多个Partion。问题是一个parition是什么并且如何决定partition的数量呢?首先Partition的大小完全依赖于你的数据源。在Spark中,大部分用于读取数据的method都可以指定生成的RDD中Partition数量。当你从hdfs上读取一个文件时,你会使用Hadoop的InputFormat来指定,默认情况下InputFormat返回每个InputSplit都会映射到RDD中的一个Partition上。对于HDFS上的大部分文件,每个数据块都会生成一个InputSplit,大小近似为64 MB/128 MB的数据。近似情况下,HDFS上数据的块边界是按字节来算的(64MB一个块),但是当数据被处理时,它会按记录进行切分。对于文本文件来说切分的字符就是换行符,对于sequence文件,它以块结束等等。比较特殊的是压缩文件,由于整个文件被压缩了,因此不能按行进行切分了,整个文件只有一个inputsplit,这样spark中也会只有一个parition,在处理的时候需要手动对它进行repatition。 本文作者:Nclaus 来源:51CTO

优秀的个人博客,低调大师

PostgreSQL体系结构概述

PostgreSQL的物理架构由 共享内存、一系列后台进程和数据文件组成 一、共享内存 共享内存是服务器为数据库缓存和事务日志缓存预留的内存缓存空间 Shared Memory=Shared Buffer + WAL Buffer Shared Buffer的目的是减少磁盘IO ,为了达到这个目的,必须满足以下规则: 当需要快速访问非常大的缓存时(10G、100G等) 如果有很多用户同时使用缓存,需要将内容尽量缩小 频繁访问的磁盘块必须长期放在缓存中 WAL Buffer是用来 临时存储数据库变化的 缓存区域。存储在WAL Buffer中的内容会根据提前定义好的时间点参数要求 写入到磁盘的WAL文件中。 在备份和恢复的场景下,WAL Buffer和WAL文件是极其重要的。 二、进程 ##PostgreSQL有四种进程类型 Postmaster (Daemon) Process(主后台驻留进程) Background Process(后台进程) Backend Process(后端进程) Client Process(客户端进程) 1.Postmaster (Daemon) Process(主后台驻留进程) 主后台驻留进程是PostgreSQL启动时第一个启动的进程。启动时,他会执行恢复、初始化共享内存爱你的运行后台进程操作。 正常运行期间,当有客户端发起链接请求时,它还负责创建后端进程。 pstree -p pid 命令查看进程之间的关系,你会发现Postmaster进程是其他所有进程的父进程 2.Background Process(后台进程) logger 将错误信息写到log日志中 checkpointer 当检查点出现时,将脏内存块写到数据文件 writer 数据文件写进程,周期性的将脏内存块写入文件 wal writer wal写进程,将WAL缓存写入WAL文件 Autovacuum launcher 当自动vacuum被启用时,用来派生autovacuum工作进程。autovacuum进程的作用是在需要时自动对膨胀表执行vacuum操作。 archiver 在归档模式下时,复制WAL文件到特定的路径下。 stats collector 用来收集数据库统计信息,例如会话执行信息统计(使用pg_stat_activity视图)和表使用信息统计(pg_stat_all_tables视图) 3.Backend Process(后端进程) 后端进程用于处理前端用户请求并返回结果。查询运行时需要一些内存结构,就是所谓的本地内存(local memory)。 本地内存涉及的主要参数有: work_mem:用于排序、位图索引、哈希链接和合并链接操作。默认值为4MB。 maintenance_work_mem:用于vacuum和创建索引操作。默认值为64MB。 temp_buffers:用于临时表。默认值为8MB。 4.Client Process(客户端进程) 客户端进程需要和后端进程配合使用,处理每一个客户链接 三、数据分布及文件 数据库 当initdb()命令执行后,template0 , template1 , 和postgres数据库被创建。 template0和template1数据库是创建用户数据库时使用的模版数据库,他们包含系统元数据表。 initdb()刚完成后,template0和template1数据库中的表是一样的。但是template1数据库可以根据用户需要创建对象。 用户数据库是通过克隆template1数据库来创建的; 表空间 initdb()后马上创建pg_default和pg_global表空间。 建表时如果没有指定特定的表空间,表默认被存在pg_default表空间中。 用于管理整个数据库集群的表默认被存储在pg_global表空间中。 pg_default表空间的物理位置为$PGDATA\base目录。 pg_global表空间的物理位置为$PGDATA\global目录。 一个表空间可以被多个数据库同时使用。此时,每一个数据库都会在表空间路径下创建为一个新的子路径。 创建一个用户表空间会在$PGDATA\pg_tblspc目录下面创建一个软连接,连接到表空间制定的目录位置 表 每个表有三个数据文件。 一个文件用于存储数据,文件名是表的OID。 一个文件用于管理表的空闲空间,文件名是OID_fsm。 一个文件用于管理表的块是否可见,文件名是OID_vm。 索引没有_vm文件,只有OID和OID_fsm两个文件

优秀的个人博客,低调大师

漫谈 Typescript 研发体系建设

TypeScript 自问世以来,由于其灵活的设计和强大的 IDE —— vscode 的支持,变得越来越普及。以下附 Github Javascript 与 TypeScript 的 PR 数量趋势图 (黄线:Javascript;蓝线:TypeScript) 我们团队从两年前开始引入 TypeScript。TypeScript 能给项目带来了诸多好处,但也可能带来额外的成本。例如广被嘲讽的 “AnyScript” 问题。 如何避免 TypeScript 的问题,发挥 TypeScript 的优势。笔者也在团队进行了漫长的建设。这篇文章就来聊一聊。 工程篇 提交时类型检查 刚开始引入 TypeScript 时,团队对 TypeScript 的认知参差补齐。为了确保项目中 TypeScript 代码质量以及类型覆盖率。我们在 pre-comm

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册