mybatis mapper.xml 热部署
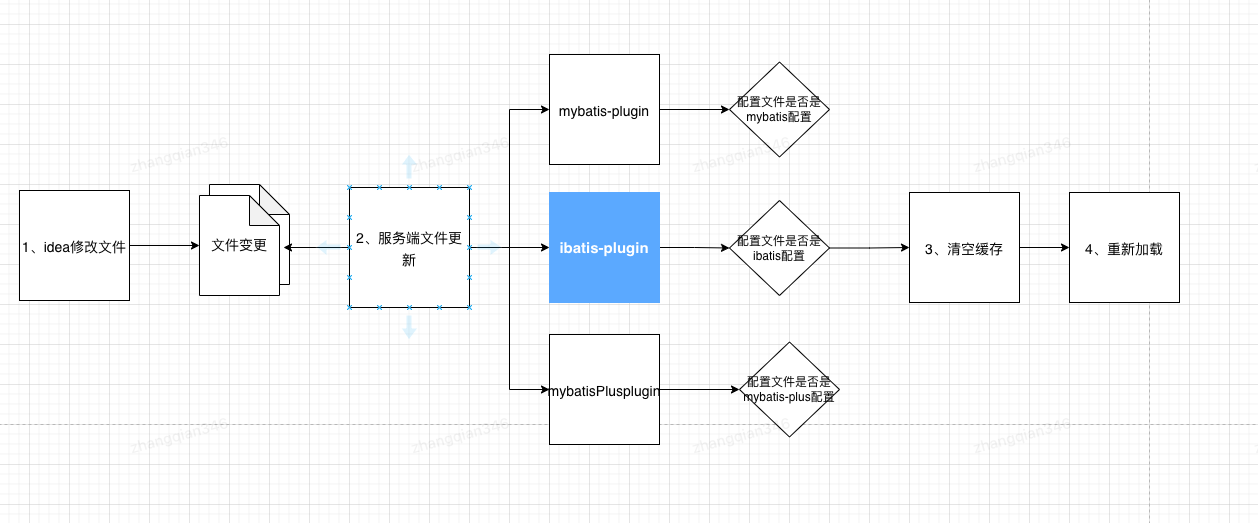
package com.guangeryi.mall.core.utils.mybatis; import com.guangeryi.mall.common.CommonConstant; import com.guangeryi.mall.core.utils.StringUtils; import org.apache.ibatis.binding.MapperProxyFactory; import org.apache.ibatis.session.Configuration; import org.apache.ibatis.session.SqlSessionFactory; import org.apache.logging.log4j.util.Strings; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.beans.BeansException; import org.springframework.beans.factory.DisposableBean; import org.springframework.beans.factory.InitializingBean; import org.springframework.beans.factory.annotation.Value; import org.springframework.context.ApplicationContext; import org.springframework.context.ApplicationContextAware; import org.springframework.context.ConfigurableApplicationContext; import org.springframework.core.io.Resource; import org.springframework.core.io.support.PathMatchingResourcePatternResolver; import org.springframework.stereotype.Component; import java.io.IOException; import java.lang.reflect.Field; import java.util.*; import java.util.concurrent.Executors; import java.util.concurrent.ScheduledExecutorService; import java.util.concurrent.TimeUnit; import java.util.stream.Collectors; @Component public class MyBatisMapperRefresher implements DisposableBean, InitializingBean, ApplicationContextAware { private final Logger logger = LoggerFactory.getLogger(getClass()); /** * 扫描周期,单位秒 */ private int periodSeconds = 5; /** * 初始化完成,延迟扫描时间,单位秒 */ private int initialDelay = 5; /** * 是否启用 */ @Value("${mapper.auto.load}") private boolean enabled; private ConfigurableApplicationContext context = null; private transient Resource[] basePackage = null; private HashMap<String, String> fileMapping = new HashMap<>(); private Set<String> isChangedMapper = new HashSet<>(); private Scanner scanner = null; private ScheduledExecutorService service = null; @Override public void setApplicationContext(ApplicationContext applicationContext) throws BeansException { this.context = (ConfigurableApplicationContext) applicationContext; } @Override public void afterPropertiesSet() throws Exception { if (!enabled) { logger.info("MyBatisMapperRefresher is Disabled"); return; } try { service = Executors.newScheduledThreadPool(1); PathMatchingResourcePatternResolver resolver = new PathMatchingResourcePatternResolver(); basePackage = resolver.getResources("classpath*:xx.xml");// 加载配置xml文件 logger.info("监控以下" + basePackage.length + "个xml文件:"); // 触发文件监听事件 scanner = new Scanner(); scanner.scan(); service.scheduleAtFixedRate(new Task(), MyBatisMapperRefresher.this.initialDelay, MyBatisMapperRefresher.this.periodSeconds, TimeUnit.SECONDS); } catch (Exception e1) { logger.error("can not starter Mybatis xml refresher,exception:{}", e1); } } class Task implements Runnable { @Override public void run() { try { if (scanner.isChanged()) { scanner.reloadXML(); } } catch (Exception ex) { logger.error("MyBatisMapperRefresher,exception:{}", ex); } } } @Override public void destroy() throws Exception { if (service != null) { service.shutdownNow(); } } class Scanner { private Resource[] mapperXmlFiles; public Scanner() { mapperXmlFiles = MyBatisMapperRefresher.this.basePackage; } public void reloadXML() throws Exception { SqlSessionFactory factory = context.getBean(SqlSessionFactory.class); Configuration configuration = factory.getConfiguration(); Set<Class<?>> knownMapperKeys = new HashSet<>(); Field field = configuration.getMapperRegistry().getClass().getDeclaredField("knownMappers"); field.setAccessible(true); Map<Class<?>, MapperProxyFactory<?>> knownMappers = (Map<Class<?>, MapperProxyFactory<?>>) field.get(configuration.getMapperRegistry()); knownMapperKeys.addAll(knownMappers.keySet()); // 移除加载项 removeConfig(configuration, isChangedMapper); Set<String> isChangedMapperTemp = isChangedMapper.stream().map(item -> StringUtils.split(item, CommonConstant.CHAR_SPOT)[0]).collect(Collectors.toSet()); Iterator<Class<?>> classIterator = knownMapperKeys.iterator(); while (classIterator.hasNext()) { Class clazz = classIterator.next(); if (clazz == null || Strings.isEmpty(clazz.getName())) continue; String[] clazzNames = StringUtils.split(clazz.getName(), CommonConstant.CHAR_SPOT); if (isChangedMapperTemp.contains(clazzNames[clazzNames.length - 1])) { knownMappers.remove(clazz); configuration.addMapper(clazz); } } isChangedMapper.clear(); } private void removeConfig(Configuration configuration, Set<String> isChangedMapper) throws Exception { Class<?> classConfig = configuration.getClass(); clearMap(classConfig, configuration, "mappedStatements", isChangedMapper); clearMap(classConfig, configuration, "caches", isChangedMapper); clearMap(classConfig, configuration, "resultMaps", isChangedMapper); clearMap(classConfig, configuration, "parameterMaps", isChangedMapper); clearMap(classConfig, configuration, "keyGenerators", isChangedMapper); clearMap(classConfig, configuration, "sqlFragments", isChangedMapper); clearSet(classConfig, configuration, "loadedResources", isChangedMapper); } private void clearMap(Class<?> classConfig, Configuration configuration, String fieldName, Set<String> isChangedMapper) throws Exception { Set<String> isChangedMapperTemp = isChangedMapper.stream().map(item -> "repository." + StringUtils.split(item, CommonConstant.CHAR_SPOT)[0]).collect(Collectors.toSet()); Field field = classConfig.getDeclaredField(fieldName); field.setAccessible(true); Map mapConfig = (Map) field.get(configuration); Map tempMap = new HashMap(); tempMap.putAll(mapConfig); tempMap.forEach((key, value) -> { if (StringUtils.StringContains((String) key, isChangedMapperTemp)) mapConfig.remove(key); }); } private void clearSet(Class<?> classConfig, Configuration configuration, String fieldName, Set<String> isChangedMapper) throws Exception { Set<String> isChangedMapperTemp = isChangedMapper.stream().map(item -> "repository/" + StringUtils.split(item, CommonConstant.CHAR_SPOT)[0]).collect(Collectors.toSet()); isChangedMapperTemp.addAll(isChangedMapper.stream().map(item -> "repository." + StringUtils.split(item, CommonConstant.CHAR_SPOT)[0]).collect(Collectors.toSet())); Field field = classConfig.getDeclaredField(fieldName); field.setAccessible(true); Set setConfig = (Set) field.get(configuration); Set tempMap = new HashSet<>(); tempMap.addAll(setConfig); tempMap.forEach(item -> { if (StringUtils.StringContains((String) item, isChangedMapperTemp)) setConfig.remove(item); }); } public void scan() throws IOException { if (!fileMapping.isEmpty()) { return; } Resource[] resources = mapperXmlFiles; if (resources != null) { for (int i = 0; i < resources.length; i++) { String multi_key = getValue(resources[i]); String fileName = resources[i].getFilename(); fileMapping.put(fileName, multi_key); logger.info("monitor Mybatis mapper file:{}", resources[i].getFile().getAbsolutePath()); } } } private String getValue(Resource resource) throws IOException { String contentLength = String.valueOf((resource.contentLength())); String lastModified = String.valueOf((resource.lastModified())); return new StringBuilder(contentLength).append(lastModified).toString(); } public boolean isChanged() throws IOException { boolean isChanged = false; Resource[] resources = mapperXmlFiles; if (resources != null) { for (int i = 0; i < resources.length; i++) { String name = resources[i].getFilename(); String value = fileMapping.get(name); String multi_key = getValue(resources[i]); if (!multi_key.equals(value)) { isChanged = true; fileMapping.put(name, multi_key); isChangedMapper.add(name); logger.info("reload Mybatis mapper file:{}", resources[i].getFile().getAbsolutePath()); } } } return isChanged; } } } 希望园友多多提意见...