首页 文章 精选 留言 我的

精选列表

搜索[提高],共10006篇文章
优秀的个人博客,低调大师

Google 表示 Chrome 91 性能提高了 23%

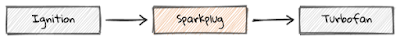
Google 发文表示,通过新的 V8 JavaScript 编译器 Sparkplug 和 short builtins 机制,近日更新的Chrome 91 获得了 23% 的性能提升。 首先,在 Chrome 浏览器中,V8 引擎负责JavaScript 执行。其具有多个编译器,可以在执行 JavaScript 的各个阶段做出不同的取舍。三年前,Google 推出了一个两层编译器系统,由 Ignition 和 Turbofan 组成。Ignition 是一个字节码解释器,其工作是以尽可能少的延迟开始执行 JavaScript;Turbofan 是优化编译器,它根据在 JavaScript 执行过程中收集的信息生成高性能的机器代码, 因此其启动速度比 Ignition 要慢 。 而新的 Sparkplug 编译器在 Ignition 和 Turbofan 之间取得了平衡,它会生成本地机器代码,但不依赖于执行 JavaScript 代码时收集的信息。这让它在快速开始执行的同时,仍能生成相对快速的代码。 此外,通过short builtins 机制,V8 引擎优化了生成的代码在内存中的位置。当 V8 从 JavaScript 生成特定的 CPU 代码时,它会在内存中铺设这些代码。这段生成的代码会经常调用内置函数。对于某些 CPU 来说,调用离生成的代码较远的函数会导致 CPU 内部优化(如分支预测逻辑)失败。因此short builtins 机制会将内置函数复制到与生成代码相同的内存区域。这一变化对新的苹果 M1 芯片的影响尤其大。 最后,据 Chrome 产品经理 Thomas Nattestad 表示,通过Sparkplug 编译器 和 short builtins 机制,Chrome 91 性能提升了 23%,每天可节省超过 17 年的 CPU 时间。

优秀的个人博客,低调大师

如何通过 Serverless 提高 Java 微服务治理效率?

作者 | 王科怀(行松) 来源 | 阿里巴巴云原生公众号 微服务治理面临的挑战 在业务初期,因人手有限,想要快速开发并上线产品,很多团队使用单体的架构来开发。但是随着公司的发展,会不断往系统里面添加新的业务功能,系统越来越庞大,需求不断增加,越来越多的人也会加入到开发团队,代码库也会增速的膨胀,慢慢的单体应用变得越来越臃肿,可维护性和灵活性逐渐降低,维护成本越来越高。 这个时候很多团队会把单体应用架构改为微服务的架构,解决单体应用的问题。但随着微服务越来越多,运维投入会越来越大,需要保证几十甚至几百个服务正常运行与协作,这给运维带来了很大的挑战,下面从软件生命周期的角度来分析这些挑战: 开发测试态 如何实现开发、测试、线上环境隔离? 如何快速调试本地变更? 如何快速部署本地变更? 发布态 如何设计服务发布策略? 如何无损下线旧版本服务? 如何实现对新版本服务灰 度测试? 运行态 线上问题如何排查?有什么工具可以利用呢? 对于服务质量差的节点如何处理? 对于完全不工作的实例我们如何恢复? 面对以上问题,Serverless 应用引擎在这方面都做了哪些工作? Serverless 应用引擎 如上图所示,Serverless 应用引擎(SAE)基于神龙 + ECI + VPC + SLB + NAS 等 IaaS 资源,构建了一个 Kubernetes 集群,在此之上提供了应用管理和微服务治理的一些能力。它可以针对不同应用类型进行托管,比如 Spring Cloud 应用、Dubbo 应用、HSF 应用、Web 应用和多语言应用。并且支持 Cloudtoolkit 插件、云效 RDC / Jenkins 等开发者工具。在 Serverless 应用引擎上,零代码改造就可以把 Java 微服务的应用迁移到 Serverless。 总的来说,Serverless 应用引擎能够提供成本更优、效率更高的一站式应用托管方案,零门槛、零改造、零容器基础,即可享受 Serverless + K8s + 微服务带来的技术红利。 微服务治理实践 1. 开发态实践 1)多环境管理 多租户共有一个注册中心,通过不同的租户对流量进行隔离;更进一步可以通过网络 VPC 进行环境隔离; 提供环境级别的运维操作,比如一键停止和拉起整个环境的功能; 提供环境级别的配置管理; 提供环境级别的网关路由流量管理。 2)云端联调 Serverless 应用引擎(SAE)基于 Alibaba CloudToolkit 插件+ 跳板机可以实现: 本地服务订阅并注册到云端 SAE 内置的注册中心; 本地服务可以和云端 SAE 服务互相调用。 如上图所示,在实现的时候用户需要有一个 ECS 代理服务器,实际注册的是 ECS 代理服务器到 SAE 的注册中心,IDEA 在安装 Cloudtoolkit 插件以后,在启动进程时,会在本地拉起一个通道服务,这个通道服务会连上 ECS 代理服务器,本地所有的请求都会转到 ECS 代理服务器上,云端对服务的调用也会通过 ECS 代理转到本地,这样就可以以最新的代码在本地断点调试,这就是云端联调的实现。 3)构建快速开发体系 代码在本地完成联调以后,要能快速地通过 Maven 插件和 IDEA-plugin,可以很快地一键部署到云端的开发环境。 2. 发布态实践 1)应用发布三板斧 可灰度:应用在发布的过程中,运维平台一定要有发布策略,包括单批、分批、金丝雀等发布策略;同时还要支持流量的灰度;批次间也要允许自动/手动任选。 可观测:发布过程可监控,白屏化实时查看发布的日志和结果,及时定位问题。 可回滚:允许人工介入控制发布流程:异常中止、一键回滚。 通过这三点可以让应用发布做到可灰度、可观测、可回滚。 2)微服务无损下线 在版本更换的过程中,SAE 是如何保证旧版本的微服务流量可以无损地下线掉? 上图是微服务注册和发行的整个流程,图中有服务消费者和服务提供者,服务提供者分别有 B1、B2 两台实例,服务消费者分别有 A1、A2 两台实例。 B1、B2 把自己注册到注册中心,消费者从注册中心刷新服务列表,发现服务提供者 B1、B2,正常情况下,消费者开始调用 B1 或者 B2,服务提供者 B 需要发布新版本,先对其中一个节点进行操作,如 B1,首先停止 Java 进程,服务停止过程又分为主动销毁和被动销毁,主动销毁是准实时的,被动销毁的时间由不同的注册中心决定,最差的情况可能需要一分钟。 如果应用是正常停止,Spring Cloud 和 Dubbo 框架的 ShutdownHook 能正常被执行,这一步的耗时基本上是可以忽略不计的。如果应用是非正常停止,比如说直接 Kill-9 的一个停止,或者是 Docker 镜像构建的时候,Java 进程不是一号进程,且没有把 Kill 信号传递给应用的话,那么服务提供者不会主动去注销节点,它会等待注册中心去发现、被动地去感知服务下线的过程。 当微服务注册中心感知到服务下线以后,会通知服务消费者其中一个服务节点已下线,这里有两种方式:注册中心的推送和消费者的轮巡。注册中心刷新服务列表,感知到提供者已经下线一个节点,这一步对于 Dubbo 框架来说不存在,但对于 Spring Cloud 来说,它最差的刷新时间是 30 秒。等消费者的服务列表更新以后,就不再调用下线节点 B。从第 2 步到第 6 步的过程中,注册中心如果是 Eureka,最差的情况需要消耗两分钟;如果是 Nacos,最差的情况需要消耗 50 秒。 在这个时间内请求都有可能出现问题,所以发布的时候会出现各种报错。 经过上面的分析,在传统的发布流程中,客户端有一个服务端调用报错期,这是由于客户端没有及时感知到服务端下线的实例造成的,这种情况主要是因为服务提供者借助微服务,通知消费者来更新服务提供的列表造成的。 那能否绕过注册中心,服务提供者直接通知服务消费者?答案是肯定的。SAE 做了两件事情,第一,服务提供者在应用发布前,会主动向服务注册中心注销应用,并将应用标记为已下线状态,将原来停止进程阶段的注销变成了 preStop 阶段注销进程。 在接收到服务消费者的请求时,首先会正常处理本次请求,并且通知服务消费者此节点已经下线,在此之后消费者收到通知后,会立即刷新自己的服务列表,在此之后服务消费者就不会再把请求发到服务提供者 B1 的实例上。 通过上面这个方案,就使得下线感知时间大大缩短,从原来的分钟级别做到准实时的,确保你的应用在下线时能够做到业务无损。 3)基于标签的灰度发布 发布策略分为分批发布和灰度发布,如何实现流量的灰度?从上面的架构图中可以看到,在应用发布之前,要配置一个灰度规则,比如按 uid 的取模余值 =20 来作为灰度流量的规则,当应用发布的时候,会对已发布的节点标识为一个灰度的版本,在这样的情况下,当有流量进来时,微服务网关和消费者都会通过配置中心拿到在治理中心配置的灰度规则。 消费者的 Agent 也会从注册中心拉取它所依赖的服务的一些信息,当一个流量进到消费者时,会按照灰度规则来做匹配,如果是灰度的流量,它会转化到灰度的机器上;如果是正常流量,它会转到正常的机器上,这是基于标签实现的灰度发布的具体逻辑。 3. 运行态实践 1)强大的应用监控 & 诊断能力 运行态的实例,服务的运行过程中会出现这样或者那样的问题,怎么去排查和解决它? 排查和解决的前提是必须具有强大的应用监控能力和诊断能力,SAE 集成了云产品 ARMS,能够让跑在上面的 Java 微服务看到应用的调用关系拓扑图,可以定位到你的 MySQL 慢服务方法的调用堆栈,进而定位到代码级别的问题。 比如一个请求响应慢,业务出现问题,它可以定位到是哪个请求、哪个服务、服务的哪行代码出现了问题,这样就能为解决问题带来很多便利。总的来说,就是我们要先有监控报警的能力,才能帮助我们更好地诊断服务运营过程中的问题。 2)故障隔离和服务恢复 上面说到我们通过监控、报警来排查、解决遇到的问题,那我们的系统能否主动去做一些事情呢?SAE 作为一个 Serverless 平台,具备很多自运维的能力,下图中有两个场景: 场景 1:某应用运营过程中,某几台机器由于磁盘满或者宿主机资源争抢,导致 load 很高或网络状态差,客户端出现调用超时或者报错。 面对这种情况,SAE 提供了服务治理能力,即离群摘除,它可以配置,当网络超时严重或者后端服务 5xx 报错达到一定比例时,可以选择把该节点从消费端服务列表中摘除,从而使得有问题的机器不再响应业务的请求,很好地保证业务的 SLA。 场景 2:某应用运行过程中,因突发流量导致内存耗尽,触发 OOM。 这种情况下,通过 SAE 这种 Serverless 应用引擎,节点在配置健康检查以后,节点里的容器是可以重新拉起的,可以做到快速对进程进行恢复。 3)精准容量+限流降级+极致弹性 基于 Serverless Paas 平台 SAE 和其他产品的互动,来达到整个运维态的闭环。 用户在使用的时候,可以运用 PTS 压测工具构造场景,然后得出来一些阈值。比如可以对流量高峰所需要消耗的资源进行预估,这时就可以根据这些阈值设计弹性策略。当业务系统达到请求比例时,就可以按照所设置的弹性策略来扩缩容自己的机器。 扩缩容在时间上,有可能还跟不上处理大批量的请求,这时可以通过和 AHAS 的互动,配置限流降级的能力。当有突发大流量时,首先可以用 AHAS 的能力把一些流量挡在门外,然后同时触发 SAE 上应用的扩容策略去扩容实例,当这些实例扩容完成之后,整个机器的平均负载会下降,流量又重新放进来。从突发大流量到限流降级再到扩容,最后到流量达到正常状态,这就是“精准容量+限流降级+极致弹性”的最佳实践模型。 总结 本文首先按照提出问题、解决问题的思路,阐述微服务在开发、发布和运行态是如何解决问题的;再介绍如何通过 Serverless 产品和其他产品的互动,从而实现精准流量、限流降级和极致弹性。 开发测试态 通过注册中心多租户和网络环境的隔离,并提供环境级别的能力; 通过云端联调技术来快速调式本地变更; 如果 IDE 插件快速部署本地变更。 发布态 运维平台针对应用发布需要具备可灰度、可观测、 可回滚; 通过 MSE agent 能力实现服务无损下线; 通过标签路由提供了线上流量灰度测试的能力。 运行态 建立强大应用监控和诊断能力; 对服务质量差的节点具备离群摘除能力; 对已经不工作的实例通过配置健康检查能够做到实例重启恢复业务; 提供了精准容量+限流降级+极致弹性模型。 作者简介 王科怀,花名:行松,阿里云 SAE 技术研发,负责 SAE 产品 Runtime 层技术架构设计,专注于微服务、Serverless、应用托管领域,基于云原生技术持续打造新一代应用托管平台。 本文整理自【Serverless Live 系列直播】2 月 1 日场 直播回看链接:https://developer.aliyun.com/topic/serverless/practices Serverless 电子书下载 本书亮点: 从架构演进开始,介绍 Serverless 架构及技术选型构建 Serverless 思维; 了解业界流行的 Serverless 架构运行原理; 掌握 10 大 Serverless 真实落地案例,活学活用。 下载链接:https://developer.aliyun.com/topic/download?id=1128

优秀的个人博客,低调大师

如何提高大规模正则匹配的效能

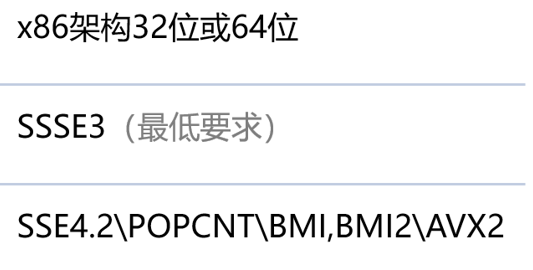
背景 日常工作中会大量应用正则表达式,用正则表达式去定义规则,然后去匹配数据。这里先看两个安全场景下的正则应用需求 场景1,FTP账号被成功暴力破解后数据遭窃取 • 数据源:FTP服务器日志 • 关联逻辑:针对特定账号暴力破解,然后利用该特定账号登录成功,之后利用该特定账号下载大量文件 • 告警内容:FTP账号${user_name}被成功暴力破解后窃取数据 • 告警级别:高危 场景1中,正则表达式用于在日志中匹配多次账户登录的行为上。 场景2,Deep packet inspection (DPI) ,例如过滤网络威胁和违反安全策略的流量等 • 数据源:网络数据包 • 检测规则条件:数据命中规则集 场景2中,正则表达式用于时间序列上的多个数据包之间的安全检测。 其实,场景1中只列举了FTP被攻击的一种方式,FTP攻击还有很多其他手段,所以检测FTP被攻击的正则匹配场景的另一个特征就是整个规则集可能很大;场景2中,利用已知的入侵行为构建模式集合,通过检测网络数据包,发现是否存在不符合安全策略的行为或被攻击的迹象,这需要对数据包的载荷部分进行检测,要求匹配的速度非常快,否则将会影响用户体验。 另一方面,这里用到的正则与传统用法又不太一样,对正则的传统用法是,给定一个文本,用一个或少数几个正则规则,去匹配文本,找出文本中匹配的数据。而现在面对的问题,首先是规则的数量大,上千上万或者超过十万的规则集,如果仍然采用之前的做法,用|分割,或者外层用循环去匹配,那么处理的时间将很长,对资源的消耗也很大,基本不可接受;其次在匹配的时候,待匹配的数据不是一个完整的整体,比如说网络数据包,是一个一个接收的,这是一个流式的形式,传统的正则处理引擎不能很好的处理流式数据,需要缓存一批数据去匹配,这样匹配就不够及时,而且目前正则处理有个很大的问题,如果正则表达式写的不好,那么匹配会很慢。所以,需要一个解决方案来应对以下这些挑战: • 规则数量多 • 匹配速度要快 • 支持流式数据 • 资源消耗不能太大 Hyperscan算子介绍 针对上述正则匹配中遇到的挑战,经过调研和对比测试市面上的主流正则匹配引擎,我们最终选择了Hyperscan。 Hyperscan是Intel开源的高性能正则表达式匹配库,提供了C语言API,目前已经在很多商业项目和开源项目中得到应用。 Hyperscan具备这些特性: • 支持大部分PCRE正则语法(如果使用Chimera库,那将支持所有语法) • 支持流式匹配 • 支持多模匹配 • 采用特定指令集加速匹配 • 易于扩展 • 内部多种引擎结合 Hyperscan在设计之初就是为了更好的处理流式匹配和多模匹配,对流模式的支持极大的方便了正则用户,不再需要用户去维护接收到的数据,无需缓存数据;多模匹配允许把多个正则表达式传入并在同一时间进行匹配。 因为需要特定的指令集,所以Hyperscan对CPU有要求,如下图: CPU最低要支持SSSE3指令集,最下面一行的指令集能加速匹配 和大多数正则引擎类似,Hyperscan也包括编译和匹配阶段,编译是把正则表达式解析然后构建成内部需要的database,后续可以多次使用这个database去匹配;如果是多模匹配,编译时每个正则表达式需要有一个唯一的标识id,id在匹配的时候会用到。编译过程如下图所示: 匹配的时候Hyperscan默认会返回所有命中的结果,这点不像有些正则引擎,指定贪婪的时候返回贪婪的匹配结果,指定懒惰的时候返回懒惰的结果。匹配时如果有命中,那么会以回调函数的形式通知用户在哪个位置命中了哪个正则表达式id。匹配过程如下图所示: Hyperscan的缺点是只能是单机执行,没有分布式能力,其可以解决延迟的问题,但无法解决吞吐的问题,解决吞吐问题,可以依靠主流实时计算框架Flink。Flink 是一个在无界和有界数据流上进行状态计算的框架和分布式处理引擎。无界就是有开始但没有结束的数据,无界的数据流计算即流式计算,有界就是有开始有结束的数据,有界的数据流计算即批处理。 Flink可以用于很多的计算场景中,这里列举了3个,Flink可以处理事件驱动的程序,除了简单事件,Flink还提供了CEP库可以处理复杂事件;Flink还可以作为数据管道,做一些数据清洗筛选、转换等操作,把数据从一个存储系统转移到另一个系统;Flink可以做流或批式数据的分析、指标计算,用于大屏展示等。Flink已经成为业界公认的流式处理的第一选择。 把正则匹配引擎整合到Flink中,借助Flink强大的分布式能力,强强联合,那么将会发挥更大威力。所以提供了这样的解决方案,如下图所示: 该解决方案实现了一个自定义的UDF算子,算子支持指定只匹配输入数据中的某几个字段,算子的输出是待匹配的字段文本,匹配最终状态,包括命中,不命中,错误,超时四种状态,如果是命中的状态,那么还会返回匹配中的正则表达式的id,输出还包括输入原始数据,如果有后续处理,这样不受影响;为了进一步方便用户使用,扩展了一个新的datastream,称之为Hyperscanstream,它把算子封装进了进去,用户在使用时只需要把datastream转换为Hyperscanstream,然后通过调用一个方法就可以使用正则的算子了。整个解决方案以一个独立的jar包提供给用户,这样可以保持原来编写Flink作业的习惯,并且与Flink的核心框架解耦。 数据流转的过程是这样,数据源读取到一条记录后交给下游的Hyperscan算子,Hyperscan算子把数据交给Hyperscan子进程,子进程匹配完成后把结果返回给Hyperscan算子,然后Hyperscan算子把原始记录和匹配的结果传递给后续算子。 算子使用说明 私有化部署 针对私有化部署场景,用法如下,用户首先需要去编辑正则表达式文件,然后用工具把正则表达式编译为database并且序列化为本地文件,如果部署的环境中有HDFS,那么可以把序列化后的文件上传至HDFS,如果没有那就不用上传,然后开发Flink作业,引用序列化的文件去匹配数据。 为什么要有工具编译并序列化这一步呢,编辑完正则表达式,直接在Flink作业中使用不行吗?前面说了,Hyperscan执行包括编译和匹配阶段,如果作业中只引用正则表达式,假设作业设置了并行度为5,那么每个task都需要编译一次,一共需要编译5次,浪费资源;而且编译在hyperscan中是个相对缓慢的动作,所以把编译过程单独出来也为了加速flink作业在尽快执行。编译提前进行也有利于提前知道正则表达式是否有语法错误,或者不支持的情况,而不是作业启动后才知道。 私有化部署时,hyperscan相关依赖程序会提供给用户,依赖程序通过全静态编译而来所以无需再添加依赖,只需机器支持需要的指令集即可。 公司内部使用 使用示例 假设现在要匹配的是HTTP报文中的Host字段和Referer字段,如下图所示: 代码示例如下图: 整个逻辑分为四步,第一步要从数据源构建输入流,第二步把输入流转换为Hyperscanstream,第三步调用hyperscan方法进而使用Hyperscan算子,在第一个参数HyperscanFunction中指定要匹配的是Host和Referer字段,第四步使用匹配返回的结果,返回的结果是Tuple2对象,其中第一个字段Event是原始记录,在本例中就是整个HTTP报文,第二个字段是HyperScanRecord组成的List,HyperScanRecord类中包括匹配的字段,例如本例中Host或Referer,匹配命中的正则表达式id(如果匹配命中的话)和匹配的最终状态。 使用1万条规则集以及不同大小的待匹配样本经过测试,方案达到了期望的性能,测试结果如下图, 使用Hyperscan算子的一些建议,如下图: 前面提到,在不使用himera库时,Hyperscan有部分PCRE语法不支持的情况,在使用时要注意,下图列举了不支持的语法(使用Chimera库将会影响匹配性能) 未来展望 一方面,目前Hyperscan算子在安全、威胁感知的场景中已经得到运用,但希望能在更多场景中进行检验,理论上在所有正则匹配的场景中都能使用,比方说文本审核、内容提取等。 另一方面,也在提升Hyperscan算子易用性,比方说现在的规则发生变化时,需要重启作业才能生效,后续希望能做到规则的动态热加载。

优秀的个人博客,低调大师

FreeBSD 网桥 if_bridge 实现性能提高 5 倍

FreeBSD 在企业网络基础架构中的性能很好,但是网络桥接设备内核代码if_bridge 处会遇到性能瓶颈(if_bridge 可以有效地将 FreeBSD 机器变成交换机)。开发人员研究过程中发现,当前的 if_bridge 实现在单个 BRIDGE_LOCK 互斥锁上有很大的竞争。if_bridge 实现将吞吐量限制为每秒约 370 万个数据包。 在遍历了一些选项之后,开发人员的最终解决方案利用了 FreeBSD 13 (CURRENT)中的epoch (9),通过巧妙地使用并发,epoch (9)允许安全使用受保护的数据结构,而根本不需要获得锁(互斥锁或读写锁)。 最终结果是,新的 if_bridge 实现每秒可以转发约 1860 万个数据包,性能大约提升了 5 倍。 FreeBSD 基金会在博客上介绍了这一改进,在此研究过程中,基金会通过社区赠款提供了资助,详情查看:https://www.freebsdfoundation.org/blog/500-if_bridge-performance-improvement

优秀的个人博客,低调大师

如何使用Git提高研发团队工作效率?

为什么使用Git 随着互联网时代的来临与发展,尤其分布式开发的大力引入,对于开发工程师来说,代码管理变成了头等难题。10多个人或者更多的成员的研发团队如何管理同一份代码,异地办公如何跟同事有效的维护同一份代码?下面直接介绍Git,就不对Git和其他的版本管理工具进行比较了。 Git属于分布式的版本控制系统,它具有以下特点: Git中每个克隆(clone)的版本库都是平等的。你可以从任何一个版本库的克隆来创建属于你自己的版本库,同时你的版本库也可以作为源提供给他人,只要你愿意。 Git的每一次提取操作,实际上都是一次对代码仓库的完整备份。 提交完全在本地完成,无须别人给你授权,你的版本库你作主,并且提交总是会成功。 甚至基于旧版本的改动也可以成功提交,提交会基于旧的版本创建一个新的分支。 Git的提交不会被打断,直到你的工作完全满意了,PUSH给他人或者他人PULL你的版本库,合并会发生在PULL和PUSH过程中,不能自动解决的冲突会提示您手工完成。 冲突解决:在需要的时候才进行合并和冲突解决。 Git版本库统一放在服务器中 可以为 Git 版本库进行授权:谁能创建版本库,谁能向版本库PUSH,谁能够读取(克隆)版本库,即权限配置 团队的成员先将服务器的版本库克隆到本地;并经常的从服务器的版本库拉(PULL)最新的更新; 团队的成员将自己的改动推(PUSH)到服务器的版本库中,当其他人和版本库同步(PULL)时,会自动获取改变 你完全可以在脱离Git服务器所在网络的情况下,如移动办公/出差时,照常使用代码库 你只需要在能够接入Git服务器所在网络时,PULL和PUSH即可完成和服务器同步以及提交 选择适合团队的工作流 分布式工作流程: 同传统的集中式版本控制系统(CVCS)不同,Git 的分布式特性使得开发者间的协作变得更加灵活多样。在集中式系统中,每个开发者就像是连接在集线器上的节点,彼此的工作方式大体相像。而在 Git 中,每个开发者同时扮演着节点和集线器的角色——也就是说,每个开发者既可以将自己的代码贡献到其他的仓库中,同时也能维护自己的公开仓库,让其他人可以在其基础上工作并贡献代码。由此,Git 的分布式协作可以为你的项目和团队衍生出种种不同的工作流程,接下来的章节会介绍几种利用了 Git 的这种灵活性的常见应用方式。我们将讨论每种方式的优点以及可能的缺点;你可以选择使用其中的某一种,或者将它们的特性混合搭配使用。 Git 提供的有以下三种工作流程 集中式工作流 集成管理者工作流 司令官与副官工作流 目前我们团队使用的是最简单的方式,集中式工作流程,随着研发团队的壮大可能会选择使用第二种,下面我们分别介绍下三种工作流 1.集中式工作流 集中式系统中通常使用的是单点协作模型——集中式工作流。一个中心集线器,或者说仓库,可以接受代码,所有人将自己的工作与之同步。若干个开发者则作为节点——也就是中心仓库的消费者——并且与其进行同步。 这意味着如果两个开发者从中心仓库克隆代码下来,同时作了一些修改,那么只有第一个开发者可以顺利地把数据推送回共享服务器。第二个开发者在推送修改之前,必须先将第一个人的工作合并进来,这样才不会覆盖第一个人的修改。这和 Subversion (或任何 CVCS)中的概念一样,而且这个模式也可以很好地运用到 Git 中。如果在公司或者团队中,你已经习惯了使用这种集中式工作流程,完全可以继续采用这种简单的模式。只需要搭建好一个中心仓库,并给开发团队中的每个人推送数据的权限,就可以开展工作了。Git 不会让用户覆盖彼此的修改。例如 John 和 Jessica 同时开始工作。 John完成了他的修改并推送到服务器。接着 Jessica 尝试提交她自己的修改,却遭到服务器拒绝。她被告知她的修改正通过非快进式(non-fast-forward)的方式推送,只有将数据抓取下来并且合并后方能推送。这种模式的工作流程的使用非常广泛,因为大多数人对其很熟悉也很习惯。当然这并不局限于小团队。利用 Git 的分支模型,通过同时在多个分支上工作的方式,即使是上百人的开发团队也可以很好地在单个项目上协作。 2.集成管理者工作流 Git 允许多个远程仓库存在,使得这样一种工作流成为可能:每个开发者拥有自己仓库的写权限和其他所有人仓库的读权限。这种情形下通常会有个代表``官方''项目的权威的仓库。要为这个项目做贡献,你需要从该项目克隆出一个自己的公开仓库,然后将自己的修改推送上去。接着你可以请求官方仓库的维护者拉取更新合并到主项目。维护者可以将你的仓库作为远程仓库添加进来,在本地测试你的变更,将其合并入他们的分支并推送回官方仓库。这一流程的工作方式如下所示: 项目维护者推送到主仓库。 贡献者克隆此仓库,做出修改。 贡献者将数据推送到自己的公开仓库。 贡献者给维护者发送邮件,请求拉取自己的更新。 维护者在自己本地的仓库中,将贡献者的仓库加为远程仓库并合并修改。 维护者将合并后的修改推送到主仓库。 这是 GitHub 和 GitLab 等集线器式(hub-based)工具最常用的工作流程。人们可以容易地将某个项目派生成为自己的公开仓库,向这个仓库推送自己的修改,并为每个人所见。这么做最主要的优点之一是你可以持续地工作,而主仓库的维护者可以随时拉取你的修改。贡献者不必等待维护者处理完提交的更新——每一方都可以按照自己节奏工作。 3.司令官与副官工作流 这其实是多仓库工作流程的变种。一般拥有数百位协作开发者的超大型项目才会用到这样的工作方式,例如著名的 Linux 内核项目。被称为副官(lieutenant)的各个集成管理者分别负责集成项目中的特定部分。所有这些副官头上还有一位称为司令官(dictator)的总集成管理者负责统筹。司令官维护的仓库作为参考仓库,为所有协作者提供他们需要拉取的项目代码。整个流程看起来是这样的 普通开发者在自己的特性分支上工作,并根据master分支进行变基。这里是司令官的master分支。 副官将普通开发者的特性分支合并到自己的master分支中。 司令官将所有副官的master分支并入自己的master分支中。 司令官将集成后的master分支推送到参考仓库中,以便所有其他开发者以此为基础进行变基。 这种工作流程并不常用,只有当项目极为庞杂,或者需要多级别管理时,才会体现出优势。利用这种方式,项目总负责人(即司令官)可以把大量分散的集成工作委托给不同的小组负责人分别处理,然后在不同时刻将大块的代码子集统筹起来,用于之后的整合。 介绍了上面三种工作流,想必你一定有想法使用哪一种了,选择一个适合自己团队的工作流,只要是严格按照这种规则执行的话,相信你的研发团队对于代码的管理一定不会再混乱了,这也会大大提升团队的工作效率。 管理 Git 分支 几乎所有的版本控制系统都以某种形式支持分支。使用分支意味着你可以把你的工作从开发主线上分离开来,以免影响开发主线。在很多版本控制系统中,这是一个略微低效的过程——常常需要完全创建一个源代码目录的副本。对于大项目来说,这样的过程会耗费很多时间。 有人把 Git 的分支模型称为它的``必杀技特性'',也正因为这一特性,使得 Git 从众多版本控制系统中脱颖而出。为何 Git 的分支模型如此出众呢? Git 处理分支的方式可谓是难以置信的轻量,创建新分支这一操作几乎能在瞬间完成,并且在不同分支之间的切换操作也是一样便捷。与许多其它版本控制系统不同,Git 鼓励在工作流程中频繁地使用分支与合并,哪怕一天之内进行许多次。理解和精通这一特性,你便会意识到 Git 是如此的强大而又独特,并且从此真正改变你的开发方式。 Git 创建分支 Git 是怎么创建新分支的呢?很简单,它只是为你创建了一个可以移动的新的指针。比如,创建一个 testing 分支,你需要使用git branch命令: $ git branch testing 这会在当前所在的提交对象上创建一个指针 那么,Git 又是怎么知道当前在哪一个分支上呢?也很简单,它有一个名为HEAD的特殊指针。请注意它和许多其它版本控制系统(如 Subversion 或 CVS)里的HEAD概念完全不同。在 Git 中,它是一个指针,指向当前所在的本地分支。在本例中,你仍然在master分支上。因为git branch命令仅仅创建一个新分支,并不会自动切换到新分支中去。 你可以简单地使用git log命令查看各个分支当前所指的对象。提供这一功能的参数是--decorate。 $ git log --oneline --decoratef30ab (HEAD, master, testing) add feature #32 - ability to add new 34ac2 fixed bug #1328 - stack overflow under certain conditions 98ca9 initial commit of my project 正上,当前master 和testing 分支均指向校验和以f30ab开头的提交对象。 分支切换 要切换到一个已存在的分支,你需要使用git checkout命令。我们现在切换到新创建的testing分支去: $ git checkout testing 这样HEAD就指向testing分支了。 那么,这样的实现方式会给我们带来什么好处呢?现在不妨再提交一次: $ vim test.rb $ git commit -a -m 'made a change' 如上图所示,你的testing分支向前移动了,但是master分支却没有,它仍然指向运行git checkout时所指的对象。这就有意思了,现在我们切换回master分支看看: $ git checkout master 这条命令做了两件事。一是使 HEAD 指回master分支,二是将工作目录恢复成master分支所指向的快照内容。也就是说,你现在做修改的话,项目将始于一个较旧的版本。本质上来讲,这就是忽略testing分支所做的修改,以便于向另一个方向进行开发。 现在我们稍微再做些修改并commit: $ vim test.rb $ git commit -a -m 'made other changes' 现在,这个项目的提交历史已经产生了分叉。因为刚才你创建了一个新分支,并切换过去进行了一些工作,随后又切换回 master 分支进行了另外一些工作。上述两次改动针对的是不同分支:你可以在不同分支间不断地来回切换和工作,并在时机成熟时将它们合并起来。而所有这些工作,你需要的命令只有branch、checkout和commit。 ** Git 合并分支** 接下来咱们举个稍微复杂点的例子,三个分支的分别处理不同的事情,最后合并到一块 首先,我们假设你正在你的项目上工作,并且已经有一些提交, 如下图: 现在,你已经决定要解决你的公司使用的问题追踪系统中的 #53 问题。想要新建一个分支并同时切换到那个分支上,你可以运行一个带有-b参数的git checkout命令: $ git checkout -b iss53 Switched to a new branch "iss53" 它是下面两条命令的简写: $ git branch iss53 $ git checkout iss53 你继续在 #53 问题上工作,并且做了一些提交。在此过程中,iss53分支在不断的向前推进,因为你已经检出到该分支(也就是说,你的HEAD指针指向了iss53分支) $ vim index.html $ git commit -a -m 'added a new footer [issue 53]' 当你在iss53这个分支上正在顺畅的工作,这时候有个特别紧急的问题需要你来修复,那么为了不影响iss53的正常工作,你需要做的是重新切换到master分支上来,在master分支的基础上再创建一个新的分支 hotfix,然后在hotfix分支解决紧急的问题。 $ git checkout -b hotfix Switched to a new branch 'hotfix' $ vim index.html $ git commit -a -m 'fixed the broken email address' [hotfix 1fb7853] fixed the broken email address 1 file changed, 2 insertions(+) 这个时候hotfix分支上的问题彻底解决了,你需要合并到master分支,并且部署上线, 那么你只需要在master分支使用git merge命令就可以了 $ git checkout master $ git merge hotfix Updating f42c576..3a0874c Fast-forward index.html | 2 ++ 1 file changed, 2 insertions(+) 在合并的时候,你应该注意到了"快进(fast-forward)"这个词。由于当前master分支所指向的提交是你当前提交(有关 hotfix 的提交)的直接上游,所以 Git 只是简单的将指针向前移动。换句话说,当你试图合并两个分支时,如果顺着一个分支走下去能够到达另一个分支,那么 Git 在合并两者的时候,只会简单的将指针向前推进(指针右移),因为这种情况下的合并操作没有需要解决的分歧——这就叫做 “快进(fast-forward)”。现在,最新的修改已经在master分支所指向的提交快照中了。 关于这个紧急问题的解决方案发布之后,你准备回到被打断之前时的工作中。然而,你应该先删除hotfix分支,因为你已经不再需要它了, master分支已经指向了同一个位置。你可以使用带-d选项的git branch命令来删除分支: $ git branch -d hotfix Deleted branch hotfix (3a0874c). 现在你可以切换回你正在工作的分支继续你的工作,也就是针对iss53分支 $ git checkout iss53 Switched to branch "iss53" $ vim index.html $ git commit -a -m 'finished the new footer [issue 53]' [iss53 ad82d7a] finished the new footer [issue 53] 1 file changed, 1 insertion(+) 这个时候 #53 问题解决后你就可以把代码合并到master了,操作跟刚才的htofix分支处理方式一样 $ git checkout master Switched to branch 'master' $ git merge iss53 Merge made by the 'recursive' strategy.index.html | 1 + 1 file changed, 1 insertion(+) 但是这和你之前合并hotfix分支的时候看起来有一点不一样。在这种情况下,你的开发历史从一个更早的地方开始分叉开来(diverged)。因为,master分支所在提交并不是iss53分支所在提交的直接祖先,Git 不得不做一些额外的工作。出现这种情况的时候,Git 会使用两个分支的末端所指的快照(C4和C5)以及这两个分支的工作祖先(C2),做一个简单的三方合并。 和之间将分支指针向前推进所不同的是,Git 将此次三方合并的结果做了一个新的快照并且自动创建一个新的提交指向它。这个被称作一次合并提交,它的特别之处在于他有不止一个父提交。 这个时候如何不需要iss53分支的话,你也可以删除iss53分支了 ** 远程分支** 以github为例,目前很多开源项目以及公司的研发项目代码一般都托管在github,那么就出现了远程仓库,远程分支等这些概念。 下面我们从github远程仓库clone下来一份代码 如果你在本地的master分支做了一些工作,然而在同一时间,其他人推送提交到git@github.com:glj1102/git_test.git 并更新了它的master分支,那么你的提交历史将向不同的方向前进。也许,只要你不与 origin 服务器连接,你的origin/master指针就不会移动。 如果要同步你的工作,运行git pull命令。这个命令是抓取远程分支数据到本地分支,并且更新本地数据库,移动origin/master指针指向新的、更新后的位置。同时你也可以执行 git push命令把你本地修改的数据提交到远程分支。 实时跟踪和监控团队代码操作记录 我们使用的是 Worktile + github 来管理团队的,平时团队沟通,任务分配都是通过Worktile来做的,那么 Worktile 与github如何关联的呢? ** Worktile绑定github代码仓储** 在Worktile的后台管理 > 服务管理中找到github,点击添加 下一步会让你选择Worktile的一个聊天群组,之后github的提交记录就会发送到这个群组中: 添加服务之后需要进行一些配置,配置方式有两种,一种是授权模式,选择仓储,选择事件, 另一种是普通模式,这种模式Worktile会生成一个Webhook链接,拿到这个链接可以直接在github仓储中进行Webhook配置: 具体的配置Worktile后台github服务设置中有教程。 ** Worktile接收github发送的操作记录** 根据不配置时选择的事件不同,github会发送不同的记录消息 想了解详情可以点击Worktile了解一下。 总结 通过上面对Git的介绍,对于团队管理者来说,如何使用Git来有效的管理团队代码应该会有最基本的概念,那接下来就需要你真正的花时间来实践了。那么对于Git的命令集网上有很多例子的,下面我这里介绍两本Git的基本入门教程: Git 简易指南 http://www.bootcss.com/p/git-guide/ Git 图解 http://marklodato.github.io/visual-git-guide/index-zh-cn.html 本文作者:龚林杰 文章来源:Worktile技术博客 欢迎访问交流更多关于技术及协作的问题。 文章转载请注明出处。

优秀的个人博客,低调大师

Java提高篇(一):区分引用变量与对象

我们有代码: New A=new New(); 下面是这个New的类: 1 class New 2 { 3 public New() 4 { 5 System.out.println("这是New类当中的构造方法"); 6 } 7 public int age=111; 8 public String name="父类的名字"; 9 public void say(String content) 10 { 11 System.out.println(content); 12 } 13 14 public void great() 15 { 16 System.out.println("yellow"); 17 } 18 } 这样我们就构成了一个对象的创建,但是在很多书上,A被称为了我们新创建的对象,然而实际上并不是。A仅仅是我们所创建的一个引用变量。我们新创建的对象是由这个引用变量指向在堆中的对象,这个对象就包含了很多属性了,比如我们刚刚所创建出来的New类的所有成员方法和成员变量。而A作为一个引用变量,则会储存在栈当中,类似于C++当中的指针,这个指针(引用变量)就会指向堆中的对象。并不是我们传统书上所说的A就是我们的对象。这一点在我们进行多态的理解时,就显得异常重要了。---------------------

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册