首页 文章 精选 留言 我的

精选列表

搜索[Tree-like算法],共10000篇文章
优秀的个人博客,低调大师

leetcode算法题解(Java版)-13-经典反转链表

一、简单二分搜索 题目描述 Given a sorted array and a target value, return the index if the target is found. If not, return the index where it would be if it were inserted in order. You may assume no duplicates in the array. Here are few examples.[1,3,5,6], 5 → 2[1,3,5,6], 2 → 1[1,3,5,6], 7 → 4[1,3,5,6], 0 → 0 思路 题目很简单,二分就能通过 代码 public class Solution { public int searchInsert(int[] A, int target) { //二分查找 int left = 0; int right = A.length-1; while(left<=right){ int mid = (left+right)/2; if(A[mid]==target){ return mid; } else if(A[mid]<target){ left = mid+1; } else{ right = mid-1; } } return left; } } 二、反转链表 题目描述 Reverse a linked list from position m to n. Do it in-place and in one-pass. For example:Given1->2->3->4->5->NULL, m = 2 and n = 4, return1->4->3->2->5->NULL. Note: Given m, n satisfy the following condition:1 ≤ m ≤ n ≤ length of list. 思路 经典的题目,值得反复推敲。设置两个指针,一个指向m的位置,一个指向m之前的那个位置,不断刷新这两个指针的next,达到反转的效果。 注意,这两个指针本身不变化,变化的是他们的next. 这样做,满足了题意中的:do it in-place and in one-place 代码 /** * Definition for singly-linked list. * public class ListNode { * int val; * ListNode next; * ListNode(int x) { * val = x; * next = null; * } * } */ public class Solution { public ListNode reverseBetween(ListNode head, int m, int n) { ListNode dummy = new ListNode(0); dummy.next = head; ListNode start = head; ListNode prestart = dummy; for(int i=1;i<m;i++){ prestart = start; start = start.next; } ListNode tem; for(int i=0;i<n-m;i++){ tem = start.next; start.next = tem.next; tem.next = prestart.next; prestart.next = tem; } return dummy.next; } } 三、深搜 题目描述 Given a collection of integers that might contain duplicates, S, return all possible subsets. Note: Elements in a subset must be in non-descending order. The solution set must not contain duplicate subsets. For example,If S =[1,2,2], a solution is: [ [2], [1], [1,2,2], [2,2], [1,2], [] ] 思路 题目要列出所有不重复的,用所给数组中数字组成的非递减数列。 深搜解决问题:注意到不能有重复的数字,之前好像做过类似的题目,今天又碰到了,也就是要让拿的数字不能和已经拿过的一样。if(start>i&&num[i]==num[i-1] 代码 import java.util.ArrayList; import java.util.Arrays; public class Solution { ArrayList<ArrayList<Integer>> res = new ArrayList<ArrayList<Integer>>(); public ArrayList<ArrayList<Integer>> subsetsWithDup(int[] num) { if(num==null||num.length==0){ return res; } Arrays.sort(num); findAll(num,0,new ArrayList<>()); return res; } public void findAll(int [] num,int start,ArrayList<Integer> list){ res.add(new ArrayList<Integer>(list)); for(int i=start;i<num.length;i++){ if(i>start&&num[i]==num[i-1]){ continue; } list.add(num[i]); findAll(num,i+1,list); list.remove(list.size()-1); } } }

优秀的个人博客,低调大师

leetcode算法题解(Java版)-12-中序遍历

日子又恢复正常了,浪了半个月。。。还是学习的时候感觉好~~ 一、动态规划 题目描述 Given n, how many structurally unique BST's (binary search trees) that store values 1...n? For example,Given n = 3, there are a total of 5 unique BST's. 1 3 3 2 1 \ / / / \ \ 3 2 1 1 3 2 / / \ \ 2 1 2 3 思路 题目看上去像是二叉搜索树的题,实际上是动态规划。给到1~n的数,要找出多少种二叉查找树,对于取值为k的数来说,在它左边的又1~k-1,右边的有k+1~n.所以可以把左子树排列的种数乘右子树的种数得到以这个为根的二叉查找树的个数。 用一个状态数组记录下值。 代码 public class Solution { public int numTrees(int n) { if(n==0){ return 0; } int [] f = new int[n+1]; f[0]=1; for(int i=1;i<=n;i++){//外循环,刷新1,2,3,4.。。n的结果 for(int j=1;j<=i;j++){//小循环,计算各个的值 f[i]+=f[j-1]*f[i-j]; } } return f[n]; } } 二、中序遍历 题目描述 Given a binary tree, return the inorder traversal of its nodes' values. For example:Given binary tree{1,#,2,3}, 1 \ 2 / 3 return[1,3,2]. 思路 二叉树的中序遍历,就是所谓的左-中-右。 递归和非递归方法,直接看代码! 代码 //递归 /** * Definition for binary tree * public class TreeNode { * int val; * TreeNode left; * TreeNode right; * TreeNode(int x) { val = x; } * } */ import java.util.ArrayList; public class Solution { public ArrayList<Integer> inorderTraversal(TreeNode root) { ArrayList<Integer> res=new ArrayList<Integer>(); if(root==null)return res; inorder(root,res); return res; } public static void inorder(TreeNode root, ArrayList<Integer> list){ if(root != null){ inorder(root.left,list); list.add(root.val); inorder(root.right,list); } } } //非递归 /** * Definition for binary tree * public class TreeNode { * int val; * TreeNode left; * TreeNode right; * TreeNode(int x) { val = x; } * } */ import java.util.ArrayList; import java.util.Stack; public class Solution { public ArrayList<Integer> inorderTraversal(TreeNode root) { ArrayList<Integer> res = new ArrayList<>(); Stack<TreeNode> stack = new Stack<>(); TreeNode node = root; if(root==null){ return res; } while(!stack.isEmpty()||node!=null){ while(node!=null){ stack.add(node); node = node.left; } node = stack.pop(); res.add(node.val); node = node.right; } return res; } } 三、深搜 题目描述 Given a string containing only digits, restore it by returning all possible valid IP address combinations. For example:Given"25525511135", return["255.255.11.135", "255.255.111.35"]. (Order does not matter) 思路 深度搜索+回溯的时候剪枝 代码 import java.util.ArrayList; public class Solution { public ArrayList<String> restoreIpAddresses(String s) { ArrayList<String> res =new ArrayList<String>(); ArrayList<String> ip =new ArrayList<String>(); int start = 0 ; dfs(s,res,ip,start); return res; } public void dfs(String s,ArrayList<String> res,ArrayList<String> ip,int start){ if(ip.size()==4&&start==s.length()){ res.add(ip.get(0)+'.'+ip.get(1)+'.'+ip.get(2)+'.'+ip.get(3)); } if(s.length()-start > 3*(4-ip.size())){//剪枝 return ; } if(s.length()-start+1 < 4-ip.size()){//剪枝 return ; } int num = 0 ; for(int i=start;i<start+3&&i<s.length();i++){ num = num*10+(s.charAt(i)-'0'); if(num<0||num>255){ return ; } ip.add(s.substring(start,i+1)); dfs(s,res,ip,i+1); ip.remove(ip.size()-1); if(num==0){//可以添加0,但不允许有前缀为0的 break; } } } }

优秀的个人博客,低调大师

通过KNN算法预测数据所属NBA球员——Python实现

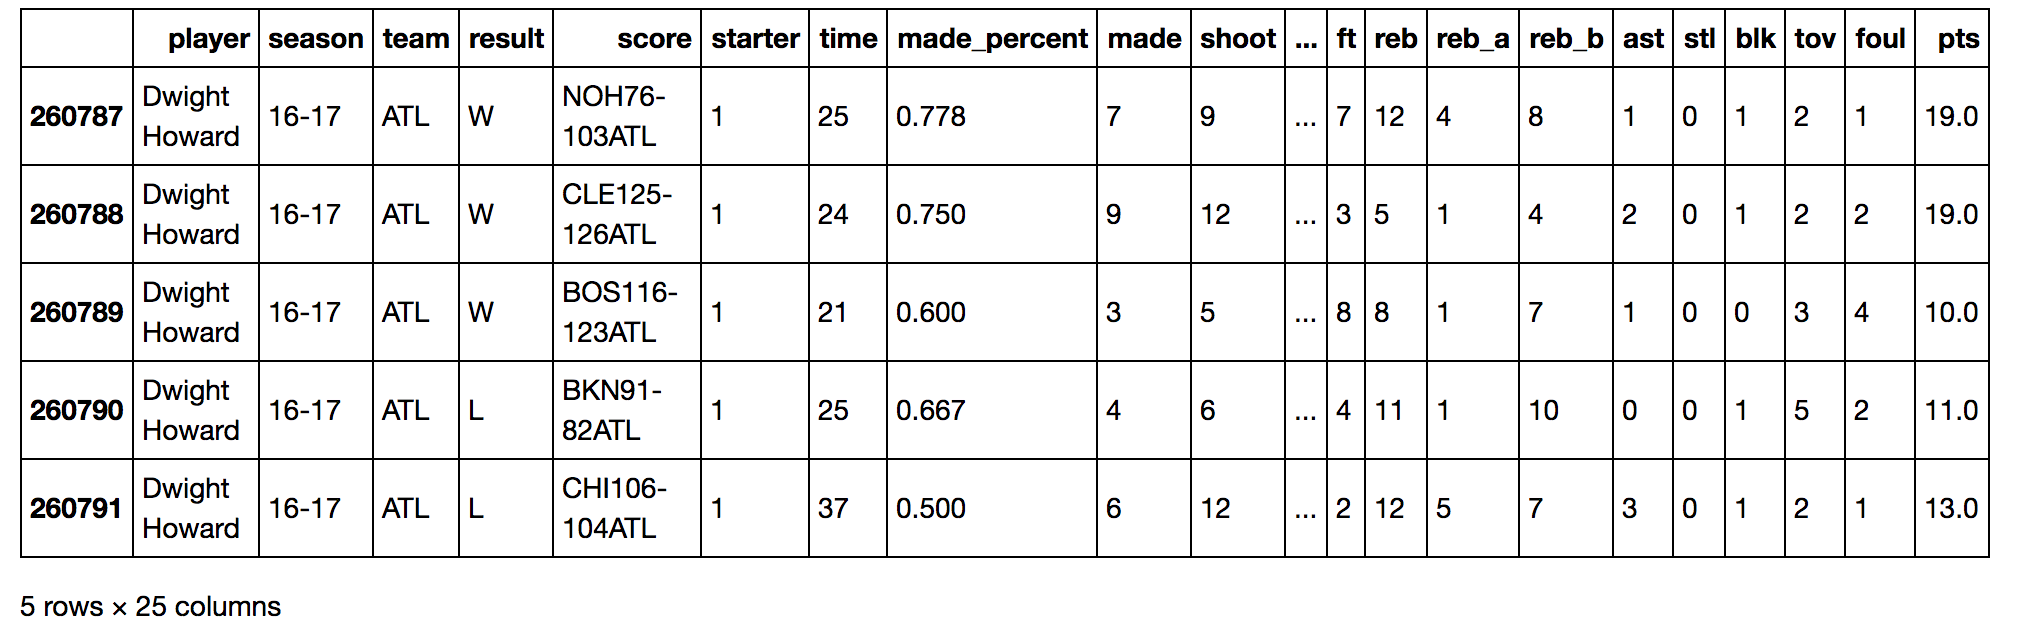
项目介绍 通过得分,篮板,助攻,出场时间四个数据来预测属于哪位球员。 选取了'LeBron James','Chris Paul','James Harden','Kevin Love','Dwight Howard'五位球员单场数据。 数据来源 本文使用数据全部来自于科赛网 ,字段解释如下: 字段 内容 player 球员 pts 得分 reb 篮板 ast 助攻 time 出场时间 season 赛季 项目内容 导入所需包 import pandas as pd import seaborn as sns import matplotlib.pyplot as plt import numpy as np from sklearn.neighbors import KNeighborsClassifier as KNN 导入数据 由于seaborn包作图对中文并不是很友好,我们将原有的字段名都设置为英文。选取我们所需要的五位球员数据命名为data。 #设置主题 sns.set(style="ticks") #导入数据 data = pd.read_csv('/Users/***/Downloads/NBA.zip/player_season.csv',encoding = 'utf-8') #避免seaborn包中文显示为方框问题,改为英文 data.columns = ['player', 'season', 'team', 'result', 'score', 'starter', 'time', 'made_percent', 'made', 'shoot', '3_made_percent', '3_made', '3_shoot', 'ft_percent', 'fta', 'ft', 'reb', u'reb_a', 'reb_b', 'ast', 'stl', 'blk', 'tov', 'foul', 'pts'] data = data.loc[data['player'].isin(['LeBron James','Chris Paul','James Harden','Kevin Love','Dwight Howard'])] data.head() image.png 可视化 其实这一步本身是不需要的,但我们还是想先在训练之前看下不同球员的数据特点。 首先我们通过散点图看5位球员的得分情况 霍华德,哈登,勒夫在进入联盟初期都有一段适应期,都经历了两三个赛季后有较大提升,哈登上升最为明显,从当年的雷霆三少到开始独自带队之后,开启砍分模式,霍华德/勒夫最近几个赛季由于战术地位的下降,数据也开始下滑; 詹姆斯/保罗数据比较稳定,‘出道即巅峰,一巅十五年’说詹姆斯真是没错; 单从得分来看,能看出些差别,但不是很明显,尤其是都步入稳定期之后,差别很小; …… plt.figure(figsize = (15,8)) #设置绘图尺寸 sns.stripplot(x='season', y='pts',data = data ,hue = 'player',jitter=True,size = 5) image.png 接下来我们通过密度图看下5位球员在篮板助攻上的表现: 首先是詹姆斯,在篮板助攻上都有不错的表现,非常全面; 保罗助攻上表现很抢眼,组织能力出色,篮板也不错,4,5个居多 哈登篮板助攻都比较低,还是以得分见长; 勒夫/霍华德两位内线球员都是篮板数据更多,相比于霍华德,勒夫分球能力更强; 霍华德在助攻上有明显的三个区间,最高的那段肯定是在魔术没错了,当年可是能单换詹姆斯的人; …… f, axes = plt.subplots(3, 2, figsize=(8, 12)) player_list = ['LeBron James','Chris Paul','James Harden','Kevin Love','Dwight Howard'] for ax,name,s in zip(axes.flat,player_list,np.linspace(0, 3, 5)): cmap = sns.cubehelix_palette(start=s, light=1, as_cmap=True) x = data[data['player']==name].reb y = data[data['player']==name].ast sns.kdeplot(x, y, cmap=cmap, shade=True, cut=5, ax=ax) ax.set(xlim=(0, 20), ylim=(0, 20)) f.tight_layout() image.png 各项数据看完心里算是有了一个大概,每个球员都有自己的技术特点: 保罗善于传球,所以助攻多; 哈登得分能力强,但篮板助攻都偏低; 霍华德篮板能力强,助攻偏弱; 相比于霍华德,勒夫助攻要更多; 詹姆斯全面,从数据上就可以展现; …… 最后我们16-17赛季的数据作为测试集,其他赛季的数据作为训练集,看看预测准确率能够达到多少~ #取16-17赛季数据作为测试集 data_train = data[data['season']!=u'16-17'] data_test = data[data['season']==u'16-17'] #得分,篮板,助攻,出场时间为特征,球员为标签 train_x = np.array(data_train[['pts','reb','ast','time']]).tolist() train_y = np.array(data_train[['player']]).tolist() test_x = np.array(data_test[['pts','reb','ast','time']]).tolist() test_y = np.array(data_test[['player']]).tolist() #训练模型 neigh = KNN(n_neighbors=10) neigh.fit(train_x, train_y) #使用模型预测,最后与实际结果对计算准确率 m = 0.0 n = 0.0 for x,y in zip(test_x,test_y): if neigh.predict([x])[0] == y[0]: n = n+1 m = m+1 print '预测准确率为:%.2f%%' % (n/m*100) 预测准确率为:49.143% 最后准确率50%不到,马马虎虎~
优秀的个人博客,低调大师

leetcode算法题解(Java版)-10-全排列(递归)

一、二维数据 题目描述 You are given an n x n 2D matrix representing an image. Rotate the image by 90 degrees (clockwise). Follow up:Could you do this in-place? 思路 最简单的方法就是在开一个新二维数组tem,然后实行“旋转操作” 这样,不符合题意!要在同一个数组中进行! 代码 public class Solution { public void rotate(int[][] matrix) { int [][] tem=new int [matrix.length][matrix.length]; for(int i=0;i<tem.length;i++){ for(int j=0;j<tem.length;j++){ tem[j][tem.length-1-i]=matrix[i][j]; } } for(int i=0;i<tem.length;i++){ for(int j=0;j<tem.length;j++){ matrix[i][j]=tem[i][j]; } } } } 思路二 画一条从左上角到右下角的对角线,这时候矩阵被分成了两份,然后将左下角那部分和右上角那部分的处于对称位置的对调。 然后将列水平对称位置对调,即为所求! 听着有点懵的话,不妨在纸上试试。 代码 public class Solution { public void rotate(int[][] matrix) { int len=matrix.length; int tem; for(int i=0;i<len;i++){ for(int j=0;j<i;j++){ tem=matrix[i][j]; matrix[i][j]=matrix[j][i]; matrix[j][i]=tem; } } for(int i=0;i<len;i++){ for(int j=0;j<len/2;j++){ tem=matrix[i][j]; matrix[i][j]=matrix[i][len-1-j]; matrix[i][len-1-j]=tem; } } } } 二、全排列(深搜) 题目描述 Given a collection of numbers, return all possible permutations. For example,[1,2,3]have the following permutations:[1,2,3],[1,3,2],[2,1,3],[2,3,1],[3,1,2], and[3,2,1]. 思路 找全排列,典型的深搜题。 语法点:res.add(new ArrayList<Integer>(list));不要忘了加new ArrayList<Integer>不加就通过不了,虽然不明白为什么要加上。 代码 import java.util.ArrayList; public class Solution { public ArrayList<ArrayList<Integer>> permute(int[] num) { ArrayList<ArrayList<Integer>> res=new ArrayList<>(); int len=num.length; if(num==null||len==0){ return res; } boolean [] visit=new boolean [len]; ArrayList<Integer> list=new ArrayList<>(); dfs(num,list,visit,res); return res; } public void dfs(int [] num,ArrayList<Integer> list,boolean [] visit,ArrayList<ArrayList<Integer>> res){ if(list.size()==num.length){ res.add(new ArrayList<Integer>(list)); return ; } for(int i=0;i<num.length;i++){ if(!visit[i]){ visit[i]=true; list.add(num[i]); dfs(num,list,visit,res); list.remove(list.size()-1); visit[i]=false; } } } } 这道全排列的题,还有扩展,明天接着搞~~

优秀的个人博客,低调大师

leetcode算法题解(Java版)-9-N皇后问题

一、贪心 题目描述 Find the contiguous subarray within an array (containing at least one number) which has the largest sum. For example, given the array[−2,1,−3,4,−1,2,1,−5,4],the contiguous subarray[4,−1,2,1]has the largest sum =6. click to show more practice.More practice: If you have figured out the O(n) solution, try coding another solution using the divide and conquer approach, which is more subtle. 思路 贪心的基本思想就是局部找最优解,然后通过局部的最优解得出来的结果,就是全局的最优解,往往很难证明,但不妨先试一试。 就像这道题,因为要求的是最大的子串和,那显然负数是起到反作用的,所以如果当前和是负的,那就果断舍去,这也是贪心的思路。 这样的解法时间复杂度是O(n)题目中说明了,可以使用分治进一步优化,请看代码二。 代码一 public class Solution { public int maxSubArray(int[] A) { int len=A.length; if(len==0){ return 0; } int sum=A[0]; int max=A[0]; for(int i=1;i<len;i++){ if(sum<0){ sum=0; } sum+=A[i]; if(sum>max){ max=sum; } } return max; } } 代码二 public class Solution { public int div(int [] A,int left,int right){ int mid=(left+right)/2; if(left==right){ return A[left]; } int max1=div(A,left,mid); int max2=div(A,mid+1,right); int max3=-999999;//这里不严谨,但不能用Integer.MIN_VALUE。 //否则max3+max4如果是负数和Integer.MIN_VALUE相加会溢出 int max4=-999999; int tem=0; for(int i=mid;i>=left;i--){ tem+=A[i]; max3=Math.max(max3,tem); } tem=0; for(int i=mid+1;i<=right;i++){ tem+=A[i]; max4=Math.max(max4,tem); } return Math.max(Math.max(max1,max2),max3+max4); } public int maxSubArray(int[] A) { int len=A.length; if(len==0){ return 0; } return div(A,0,len-1); } } 二、N皇后问题 题目描述 Follow up for N-Queens problem. Now, instead outputting board configurations, return the total number of distinct solutions. 思路 经典的老题目了,存储当然是用一个数组map解决:下标表示行号,每个map[i]中存放的数字表示列号。 然后就是写一个判断函数:1.判断行是否重复:这个不需要判定,因为数组下标即使行。2.判断列是否重复,即map[t]!=map[i]。3.判断对角线是否重复:即map[t]-map[i]!=t-i。 代码 public class Solution { public int [] map=new int[30]; public int count=0;//注意!!不能写成public static int count=0; //否则全局静态变量的话,内存地址是一个, //也就是当前测试用例会受到上一个测试用例中count的影响 public int totalNQueens(int n) { backtrack(1,n); return count; } public void backtrack(int t,int n){ if(t>n){ count++; } else{ for(int i=1;i<=n;i++){ map[t]=i; if(valid(t)){ backtrack(t+1,n); } } } } public boolean valid(int t){ for(int i=1;i<t;i++){ if(Math.abs(t-i)==Math.abs(map[t]-map[i])||map[i]==map[t]){ return false; } } return true; } } 三、N皇后问题再度升级 题目描述 The n-queens puzzle is the problem of placing n queens on an n×n chessboard such that no two queens attack each other. Given an integer n, return all distinct solutions to the n-queens puzzle. Each solution contains a distinct board configuration of the n-queens' placement, where'Q'and'.'both indicate a queen and an empty space respectively. For example,There exist two distinct solutions to the 4-queens puzzle: [ [".Q..", // Solution 1 "...Q", "Q...", "..Q."], ["..Q.", // Solution 2 "Q...", "...Q", ".Q.."] ] 思路 和上一道只需要输出个数,这道题也需要把所有的图输出来。只需要改动一个地方就OK。具体的看代码,写的很清楚。 代码 import java.util.ArrayList; public class Solution { public int [] mark=new int [30]; public int count=0; public ArrayList<String[]> resList=new ArrayList<>(); public ArrayList<String[]> solveNQueens(int n) { backtrack(1,n); return resList; } public StringBuilder drawOneLine(int n){ StringBuilder sb=new StringBuilder(); for(int i=0;i<n;i++){ sb.append('.'); } return sb; } public boolean valid(int t){ for(int i=1;i<t;i++){ if(Math.abs(mark[i]-mark[t])==Math.abs(i-t)||mark[i]==mark[t]){ return false; } } return true; } public void backtrack(int t,int n){ if(t>n){ String [] tem=new String[n]; for(int i=0;i<n;i++){ StringBuilder line=drawOneLine(n); line.setCharAt(mark[i+1]-1,'Q');//因为String从0开始而我的mark是从1开始记的 //这里下标有点乱:mark数组是从1开始的,而tem是从0开始的。 tem[i]=line.toString(); } resList.add(tem); } else{ for(int i=1;i<=n;i++){ mark[t]=i; if(valid(t)){ backtrack(t+1,n); } } } } }

优秀的个人博客,低调大师

leetcode算法题解(Java版)-3-广搜+HashMap

一、运算符——异或"^" 题目描述 Given an array of integers, every element appears twice except for one. Find that single one. Note: Your algorithm should have a linear runtime complexity. Could you implement it without using extra memory? 思路 题目很简单,考到了一个知识点——异或:比较两个操作数的二进制的各个位置,相同则为0不同则为1。所以,1.与0异或是本身2.与和自己一样的异或是0. 代码 public class Solution { public int singleNumber(int[] A) { int res=0; for(int i=0;i<A.length;i++){ res^=A[i]; } return res; } } 二、动态规划 题目描述 There are N children standing in a line. Each child is assigned a rating value. You are giving candies to these children subjected to the following requirements: Each child must have at least one candy. Children with a higher rating get more candies than their neighbors. What is the minimum candies you must give? 思路: 一开始看错题了,孩子们本来站好队了,我按权重从大到小排了一下。。。看了别人的代码,思路并不难:先给每人一个糖果,两个循环解决问题,一,从前往后扫一遍,如果下一个比上一个权重大就在上一个基础上加一;再从后往前扫一遍,如果前面的比后面的权重大且糖果比他少就再后面的基础上加一刷新原有的值。 语法点:Arrays.fill(array,val);Arrays.sort(array); 代码 import java.util.Arrays; public class Solution { public int candy(int[] ratings) { if(ratings==null||ratings.length==0){ return 0; } int len=ratings.length; int [] cnt=new int [len]; Arrays.fill(cnt,1); for(int i=1;i<len;i++){ if(ratings[i]>ratings[i-1]){ cnt[i]=cnt[i-1]+1; } } int sum=0; for(int i=len-1;i>0;i--){ if(ratings[i-1]>ratings[i]&&cnt[i-1]<=cnt[i]){ cnt[i-1]=cnt[i]+1; } sum+=cnt[i]; } return sum+cnt[0]; } } 三、模拟题(环状) 题目描述 There are N gas stations along a circular route, where the amount of gas at station i isgas[i]. You have a car with an unlimited gas tank and it costscost[i]of gas to travel from station i to its next station (i+1). You begin the journey with an empty tank at one of the gas stations. Return the starting gas station's index if you can travel around the circuit once, otherwise return -1. Note: The solution is guaranteed to be unique. 思路 设置start和end,分别放在首尾。如果能继续走就让end++,不能则让start退一个。结束while循环有两种可能结果,一个是sum>=0,则最后相会的点就是出发点,另一个则不可能。 代码 public class Solution { public int canCompleteCircuit(int[] gas, int[] cost) { int len=gas.length; int start=len-1; int end=0; int sum=0; sum=gas[start]-cost[start]; while(end<start){ if(sum>=0){ sum+=gas[end]-cost[end]; end++; } else{ start--; sum+=gas[start]-cost[start]; } } return sum>=0?start:-1; } } 四、BFS+HashMap 题目描述 Clone an undirected graph. Each node in the graph contains alabeland a list of itsneighbors. 思路 广搜,然后用map存储原来的和克隆的一一映射 HashMap中通过get()来获取value,通过put()来插入value,containsKey()则用来检验对象是否已经存在 Stack:st.push(node);st.pop();st.empty(); 代码 /** * Definition for undirected graph. * class UndirectedGraphNode { * int label; * ArrayList<UndirectedGraphNode> neighbors; * UndirectedGraphNode(int x) { label = x; neighbors = new ArrayList<UndirectedGraphNode>(); } * }; */ import java.util.Stack; import java.util.HashMap; public class Solution { public UndirectedGraphNode cloneGraph(UndirectedGraphNode node) { if(node==null){ return null; } HashMap<UndirectedGraphNode,UndirectedGraphNode> map=new HashMap<>(); Stack<UndirectedGraphNode> stackNode=new Stack<>(); stackNode.push(node); while(!stackNode.empty()){ UndirectedGraphNode tempNode=stackNode.pop(); if(map.containsKey(tempNode)){ continue; } UndirectedGraphNode copyNode=new UndirectedGraphNode(tempNode.label); for(UndirectedGraphNode uNode:tempNode.neighbors){ copyNode.neighbors.add(uNode); if(map.containsKey(uNode)){ continue; } stackNode.push(uNode); } map.put(tempNode,copyNode); } return map.get(node); } }

优秀的个人博客,低调大师

算法学习之路|POJ 1068 Parencodings(简单模拟)

题目大意: 有一个括号串(括号成对),给出一串数字数组p,p[i]表示从左往右第i个右括号左边共有p[i]个左括号,求一个数组w,w[i]表示第i个右括号和其所匹配的左括号之间有多少个左括号(包括这个左括号本身) 一个例子: 括号串: (((()()()))) P 4 5 6 6 6 6 W 1 1 1 4 5 6 思路 用一个vis数组标标记,1表示左括号,0表示右括号,模拟出w数组时用2标记已经用过的左括号,-1标记已经用过的右括号 代码: #include<stdio.h> #include<string.h> #include<algorithm> #define maxn 100 int main() { int p[maxn],w[maxn],vis[maxn]; int t,n,index,ww; scanf("%d",&t); while(t--) { scanf("%d",&n); memset(vis,0,sizeof(vis)); memset(w,0,sizeof(w)); index=1;//标记vis数组 ww=1; p[0]=0; w[0]=0; for(int i=1;i<=n;i++) { scanf("%d",&p[i]); int temp=p[i]-p[i-1]; for(int j=1;j<=temp;j++) { vis[index++]=1; } index++; } for(int i=1;i<=n*2;i++)//输入数字有n个,说明括号有n对,因此vis数组有2n的长度 { int index2=1;//标记w数组 if(vis[i]==0) { vis[i]=-1; int x=i; while(vis[x]!=1) { if(vis[x]==2) { index2++; } x--; } w[ww++]=index2; vis[x]=2; } } for(int i=1;i<=n;i++) { printf("%d",w[i]); if(i<n) printf(" "); } printf("\n"); } return 0; } 就是简单模拟,没有坑。

优秀的个人博客,低调大师

妙趣横生的算法--二叉树

基本 结点的度:结点拥有的子树的数目。 叶子:度为零的结点。 分支结点:度不为零的结点。 树的度:树中结点的最大的度。 层次:根结点的层次为1,其余结点的层次等于该结点的双亲结点的层次加1。 树的高度:树中结点的最大层次。 无序树:如果树中结点的各子树之间的次序是不重要的,可以交换位置。 有序树:如果树中结点的各子树之间的次序是重要的, 不可以交换位置。 森林:0个或多个不相交的树组成。对森林加上一个根,森林即成为树;删去根,树即成为森林。 性质 1:二叉树第i层上的结点数目最多为2{i-1}(i≥1)。 2:深度为k的二叉树至多有2{k}-1个结点(k≥1)。 3:包含n个结点的二叉树的高度至少为log2(n+1)。 4:在任意一棵二叉树中,若终端结点的个数为n0,度为2的结点数为n2,则n0=n2+1。 C实现 用先序序列创建一棵二叉树,并且输出字符D位于二叉树的层数。 #include "stdio.h" #include "stdlib.h" typedef struct BiTNode{ char data; /*结点的数据域*/ struct BiTNode *lchild , *rchild; /*指向左孩子和右孩子*/ } BiTNode , *BiTree; /*创建一棵二叉树*/ void CreatBiTree(BiTree *T){ char c; scanf("%c",&c); if(c == ' ') *T = NULL; else{ *T = (BiTNode * )malloc(sizeof(BiTNode)); /*创建根结点*/ (*T)->data = c; /*向根结点中输入数据*/ CreatBiTree(&((*T)->lchild)); /*递归地创建左子树*/ CreatBiTree(&((*T)->rchild)); /*递归地创建右子树*/ } } /*访问二叉树结点,输出包含D字符结点位于二叉树中的层数*/ void visit(char c,int level){ if(c == 'D') printf("%c is at %d lever of BiTree\n",c,level); } /*遍历二叉树*/ void PreOrderTraverse(BiTree T,int level){ if(T){ /*递归结束条件,T为空*/ visit(T->data,level); /*访问根结点*/ PreOrderTraverse(T->lchild,level+1); /*先序遍历T的左子树*/ PreOrderTraverse(T->rchild,level+1); /*先序遍历T的右子数*/ } } void main() { int level = 1; BiTree T = NULL; /*最开始T指向空*/ CreatBiTree(&T); /*创建二叉树*/ PreOrderTraverse(T,level); /*遍历二叉树,找到包含D字符结点位于二叉树中的层数*/ } 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3678697.html如需转载请自行联系原作者

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册