首页 文章 精选 留言 我的

精选列表

搜索[全模态模型],共10000篇文章
优秀的个人博客,低调大师

Android内存泄漏定位、分析、解决全方案

原文链接 更多教程 为什么会发生内存泄漏 内存空间使用完毕之后未回收, 会导致内存泄漏。有人会问:Java不是有垃圾自动回收机制么?不幸的是,在Java中仍存在很多容易导致内存泄漏的逻辑(logical leak)。虽然垃圾回收器会帮我们干掉大部分无用的内存空间,但是对于还保持着引用,但逻辑上已经不会再用到的对象,垃圾回收器不会回收它们。 例如 忘记释放分配的内存的。(Cursor忘记关闭等)。 应用不再需要这个对象,未释放该对象的所有引用。 强引用持有的对象,垃圾回收器是无法在内存中回收这个对象。 持有对象生命周期过长,导致无法回收。 Java判断无效对象的原理 Android内存回收管理策略图: 图中的每个圆节点代表对象的内存资源,箭头代表可达路径。当圆节点与 GC Roots 存在可达路径时,表示当前资源正被引用,虚拟机是无法对其进行回收的(如图中的黄色节点)。反过来,如果圆节点与 GC Roots 不存在可达路径,则意味着这块对象的内存资源不再被程序引用,系统虚拟机可以在 GC 过程中将其回收掉。 从定义上讲,Android(Java)平台的内存泄漏是指没有用的对象资源任与GC-Root保持可达路径,导致系统无法进行回收。 内存泄漏带来的危害 用户对单次的内存泄漏并没有什么感知,但当泄漏积累到内存都被消耗完,就会导致卡顿,崩溃。 内存泄露是内存溢出OOM的重要原因之一,会导致Crash Android中常见的可能发生内存泄漏的地方 1.在Android开发中,最容易引发的内存泄漏问题的是Context。 比如Activity的Context,就包含大量的内存引用,一旦泄漏了Context,也意味泄漏它指向的所有对象。 造成Activity泄漏的常见原因: Static Activities在类中定义了静态Activity变量,把当前运行的Activity实例赋值于这个静态变量。 如果这个静态变量在Activity生命周期结束后没有清空,就导致内存泄漏。因为static变量是贯穿这个应用的生命周期的,所以被泄漏的Activity就会一直存在于应用的进程中,不会被垃圾回收器回收。 static Activity activity; //这种代码要避免 单例中保存Activity在单例模式中,如果Activity经常被用到,那么在内存中保存一个Activity实例是很实用的。但是由于单例的生命周期是应用程序的生命周期,这样会强制延长Activity的生命周期,这是相当危险而且不必要的,无论如何都不能在单例子中保存类似Activity的对象。 举例: public class Singleton { private static Singleton instance; private Context mContext; private Singleton(Context context){ this.mContext = context; } public static Singleton getInstance(Context context){ if (instance == null){ synchronized (Singleton.class){ if (instance == null){ instance = new Singleton(context); } } } return instance; } } 在调用Singleton的getInstance()方法时传入了Activity。那么当instance没有释放时,这个Activity会一直存在。因此造成内存泄露。解决方法: 可以将new Singleton(context)改为new Singleton(context.getApplicationContext())即可,这样便和传入的Activity没关系了。 Static Views同理,静态的View也是不建议的 Inner Classes内部类的优势可以提高可读性和封装性,而且可以访问外部类,不幸的是,导致内存泄漏的原因,就是内部类持有外部类实例的强引用。 例如在内部类中持有Activity对象 解决方法: 1.将内部类变成静态内部类; 2.如果有强引用Activity中的属性,则将该属性的引用方式改为弱引用;3.在业务允许的情况下,当Activity执行onDestory时,结束这些耗时任务; 例如:发生内存泄漏的代码: public class LeakAct extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.aty_leak); test(); } //这儿发生泄漏 public void test() { new Thread(new Runnable() { @Override public void run() { while (true) { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } } } }).start(); } } 解决方法: public class LeakAct extends Activity { @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.aty_leak); test(); } //加上static,变成静态匿名内部类 public static void test() { new Thread(new Runnable() { @Override public void run() { while (true) { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } } } }).start(); } } Anonymous Classes匿名类也维护了外部类的引用。当你在匿名类中执行耗时任务,如果用户退出,会导致匿名类持有的Activity实例就不会被垃圾回收器回收,直到异步任务结束。 原文链接 更多教程 Handlerhandler中,Runnable内部类会持有外部类的隐式引用,被传递到Handler的消息队列MessageQueue中,在Message消息没有被处理之前,Activity实例不会被销毁了,于是导致内存泄漏。 解决方法: 1.可以把Handler类放在单独的类文件中,或者使用静态内部类便可以避免泄露;2.如果想在Handler内部去调用所在的Activity,那么可以在handler内部使用弱引用的方式去指向所在Activity.使用Static + WeakReference的方式来达到断开Handler与Activity之间存在引用关系的目的.3.在界面销毁是,释放handler资源 @Override protected void doOnDestroy() { super.doOnDestroy(); if (mHandler != null) { mHandler.removeCallbacksAndMessages(null); } mHandler = null; mRenderCallback = null; } 同样还有其他匿名类实例,如TimerTask、Threads等,执行耗时任务持有Activity的引用,都可能导致内存泄漏。 线程产生内存泄露的主要原因在于线程生命周期的不可控。如果我们的线程是Activity的内部类,所以MyThread中保存了Activity的一个引用,当MyThread的run函数没有结束时,MyThread是不会被销毁的,因此它所引用的老的Activity也不会被销毁,因此就出现了内存泄露的问题。 要解决Activity的长期持有造成的内存泄漏,可以通过以下方法: 传入Application 的 Context,因为 Application 的生命周期就是整个应用的生命周期,所以这将没有任何问题。 如果此时传入的是 Activity 的 Context,当这个 Context 所对应的 Activity 退出时,主动结束执行的任务,并释放Activity资源。 将线程的内部类,改为静态内部类。因为非静态内部类会自动持有一个所属类的实例,如果所属类的实例已经结束生命周期,但内部类的方法仍在执行,就会hold其主体(引用)。也就使主体不能被释放,亦即内存泄露。静态类编译后和非内部类是一样的,有自己独立的类名。不会悄悄引用所属类的实例,所以就不容易泄露。 如果需要引用Acitivity,使用弱引用。 谨慎对context使用static关键字。 2.Bitmap没调用recycle() Bitmap对象在不使用时,我们应该先调用recycle()释放内存,然后才设置为null. 3.集合中对象没清理造成的内存泄露 我们通常把一些对象的引用加入到了集合中,当我们不需要该对象时,并没有把它的引用从集合中清理掉,这样这个集合就会越来越大。如果这个集合是static的话,那情况就更严重了。解决方案: 在Activity退出之前,将集合里的东西clear,然后置为null,再退出程序。 4.注册没取消造成的内存泄露 这种Android的内存泄露比纯Java的内存泄漏还要严重,因为其他一些Android程序可能引用系统的Android程序的对象(比如注册机制)。即使Android程序已经结束了,但是别的应用程序仍然还有对Android程序的某个对象的引用,泄漏的内存依然不能被垃圾回收。解决方案: 1.使用ApplicationContext代替ActivityContext;2.在Activity执行onDestory时,调用反注册; 5.资源对象没关闭造成的内存泄露 资源性对象比如(Cursor,File文件等)往往都用了一些缓冲,我们在不使用的时候,应该及时关闭它们,以便它们的缓冲及时回收内存。而不是等待GC来处理。 6.占用内存较多的对象(图片过大)造成内存溢出 因为Bitmap占用的内存实在是太多了,特别是分辨率大的图片,如果要显示多张那问题就更显著了。Android分配给Bitmap的大小只有8M.解决方法: 1.等比例缩小图片 BitmapFactory.Options options = new BitmapFactory.Options(); options.inSampleSize = 2;//图片宽高都为原来的二分之一,即图片为原来的四分之一 2.对图片采用软引用,及时地进行recycle()操作 //软引用 SoftReference<Bitmap> bitmap = new SoftReference<Bitmap>(pBitmap); //回收操作 if(bitmap != null) { if(bitmap.get() != null && !bitmap.get().isRecycled()){ bitmap.get().recycle(); bitmap = null; } } 7.WebView内存泄露(影响较大) 解决方案: 用新的进程起含有WebView的Activity,并且在该Activity 的onDestory() 最后加上 System.exit(0); 杀死当前进程。 检测内存泄漏的方法 1.使用 静态代码分析工具-Lint 检查内存泄漏 Lint 是 Android Studio 自带的工具,使用姿势很简单 Analyze -> Inspect Code 然后选择想要扫面的区域即可 对可能引起泄漏的编码,Lint 都会进行温馨提示: 2.LeakCanary 工具 Square 公司出品的内存分析工具,官方地址如下:https://github.com/square/leakcanary/LeakCanary 需要在项目代码中集成,不过代码也非常简单,如下的官方示例: 在你的 build.gradle: dependencies { debugImplementation 'com.squareup.leakcanary:leakcanary-android:1.6.3' releaseImplementation 'com.squareup.leakcanary:leakcanary-android-no-op:1.6.3' // Optional, if you use support library fragments: debugImplementation 'com.squareup.leakcanary:leakcanary-support-fragment:1.6.3' } 在 Application 类: public class ExampleApplication extends Application { @Override public void onCreate() { super.onCreate(); if (LeakCanary.isInAnalyzerProcess(this)) { // This process is dedicated to LeakCanary for heap analysis. // You should not init your app in this process. return; } LeakCanary.install(this); // Normal app init code... } } 当内存泄漏发生时,LeakCanary 会弹窗提示并生成对应的堆存储信息记录 -3.Android Monitor 开Android Studio,编译代码,在模拟器或者真机上运行App,然后点击 ,在Android Monitor下点击Monitor对应的Tab,进入如下界面 在Memory一栏中,可以观察不同时间App内存的动态使用情况,点击 可以手动触发GC,点击 可以进入HPROF Viewer界面,查看Java的Heap,如下图 Reference Tree代表指向该实例的引用,可以从这里面查看内存泄漏的原因,Shallow Size指的是该对象本身占用内存的大小,Retained Size代表该对象被释放后,垃圾回收器能回收的内存总和。 扩展知识 四种引用类型的介绍 强引用(StrongReference):JVM 宁可抛出 OOM ,也不会让 GC 回收具有强引用的对象; 软引用(SoftReference):只有在内存空间不足时,才会被回的对象; 弱引用(WeakReference):在 GC 时,一旦发现了只具有弱引用的对象,不管当前内存空间足够与否,都会回收它的内存; 虚引用(PhantomReference):任何时候都可以被GC回收,当垃圾回收器准备回收一个对象时,如果发现它还有虚引用,就会在回收对象的内存之前,把这个虚引用加入到与之关联的引用队列中。程序可以通过判断引用队列中是否存在该对象的虚引用,来了解这个对象是否将要被回收。可以用来作为GC回收Object的标志。 原文链接 更多教程

优秀的个人博客,低调大师

Android: 在native中访问assets全解析

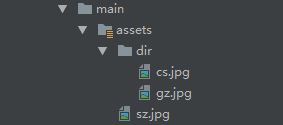
在CMake中添加相关NDK LIB的 依赖 因为我们接下来用到的一些函数实现在NDK库libandroid.so中,因此我们直接在CMakeList.txt中添加对其依赖即可: target_link_libraries( # Specifies the target library. native-lib #lib to link android # other libs ) 如果没有添加此依赖,显然会提示undefined reference错误,比如: error: undefined reference to 'AAssetManager_fromJava' error: undefined reference to 'AAssetManager_open' error: undefined reference to 'AAsset_getLength' error: undefined reference to 'AAsset_getBuffer' error: undefined reference to 'AAsset_close' error: undefined reference to 'AAssetManager_open' error: undefined reference to 'AAsset_getLength' error: undefined reference to 'AAsset_openFileDescriptor' error: undefined reference to 'AAsset_close' error: undefined reference to 'AAssetManager_openDir' error: undefined reference to 'AAssetDir_getNextFileName' error: undefined reference to 'AAssetManager_open' 获得AssetManager 在Java中,我们可以通过Context.getAssets()轻松获得AssetManager。在NDK中,提供了AAssetManager_fromJava来获得Native中对应的AAssetManager。顾名思义,fromJava,肯定是要从Java层获取了,也即意味着要通过JNI来获得。代码如下: /***code in Java, such as MainActivity.java***/ //decale the jni func public native void setNativeAssetManager(AssetManager assetManager); //call it, such as during Activity.onCreate() setNativeAssetManager(getAssets()); /***end of java***/ /***code in native c++***/ extern "C" JNIEXPORT void JNICALL Java_willhua_androidstudioopencl_MainActivity_setNativeAssetManager( JNIEnv *env, jobject instance, jobject assetManager) { AAssetManager *nativeasset = AAssetManager_fromJava(env, assetManager); //the use of nativeasset } 下面所有的代码都是在Java_willhua_androidstudioopencl_MainActivity_setNativeAssetManager内实现。 访问assets下的文件 我们知道,assets文件夹下面是可以有子文件夹的,因为,下面我以读取图片为例,介绍各种情况的访问方法。例子中用到OpenCV的相关方法,在此不介绍,自行了解。 测试用assets文件夹目录: 已知完整路径的访问 如果我们已经知道assets下某个文件的完整路径,比如"sz.jpg","dir/cs.jpg",那么我们可以直接把这个路径传给AAssetManager_open来获得AAsset. //open file AAsset *assetFile = AAssetManager_open(nativeasset, "sz.jpg", AASSET_MODE_BUFFER); //this will also be ok //AAsset *assetFile = AAssetManager_open(nativeasset, "dir/cs.jpg", AASSET_MODE_BUFFER); //get file length size_t fileLength = AAsset_getLength(assetFile); char *dataBuffer2 = (char *) malloc(fileLength); //read file data AAsset_read(assetFile, dataBuffer2, fileLength); //the data has been copied to dataBuffer2, so , close it AAsset_close(assetFile); //decode the file data to cv::Mat std::vector<char> vec2(dataBuffer2, dataBuffer2 + fileLength); cv::Mat mat2 = cv::imdecode(vec2, CV_LOAD_IMAGE_COLOR); LOGD("asset file %d x %d %d", mat2.cols, mat2.rows, mat2.channels()); //free malloc free(dataBuffer2); 获取文件下的名字并访问之 如果我们只知道文件夹的名字,但并不知道文件夹下面有哪些具体文件,比如我们只知道有个dir文件夹,但不知道下面的具体情况。那么我们可以使用AAssetDir_getNextFileName来获取文件夹的文件名。但是有个问题,这个方法只能获得文件夹下的文件名,而无法获得子文件夹,有哪位知道的请告知。注意:AAssetDir_getNextFileName只返回文件名,而不是该文件的完整路径,比如只会返回cs.jpg,而不是dir/cs.jpg,所以如果直接把AAssetDir_getNextFileName的返回结果传给AAssetManager_open会读取不到正确的文件,返回NULL. AAssetDir *assetDir = AAssetManager_openDir(nativeasset, "dir"); const char *filename = AAssetDir_getNextFileName(assetDir); while (filename != NULL){ char fullname[1024]; sprintf(fullname, "dir/%s", filename); //get the full path AAsset *file = AAssetManager_open(nativeasset, fullname, AASSET_MODE_BUFFER); if(file == NULL){ LOGD("FILE NULL %s", filename); break; } size_t fileLength = AAsset_getLength(file); LOGD("filename next:%s, size:%d", filename, fileLength); char *buffer = (char*)malloc(fileLength); AAsset_read(file, buffer, fileLength); AAsset_close(file); //do something with the buffer free(buffer); filename = AAssetDir_getNextFileName(assetDir); } AAssetDir_close(assetDir); //remember to close it 使用AAsset_getBuffer读整个文件内容 在上面的case中,我们拿到AAsset之后都是malloc内存,然后把文件信息读出来的形式,其实这种方式适合不一次性读取整个文件内容的情况,按照官网的说法就是: Attempt to read 'count' bytes of data from the current offset. 也就是AAsset_read应该配合AAsset_seek使用更美味。 对于一次性读取整个文件的内容,更好的方式是使用AAsset_getBuffer AAsset *assetFile = AAssetManager_open(nativeasset, "sz.jpg", AASSET_MODE_BUFFER); size_t fileLength = AAsset_getLength(assetFile); const char *dataBuffer2 =(const char *) AAsset_getBuffer(assetFile); std::vector<char> vec2(dataBuffer2, dataBuffer2 + fileLength); cv::Mat mat2 = cv::imdecode(vec2, CV_LOAD_IMAGE_COLOR); LOGD("asset file lenght:%d mat: %d x %d %d", fileLength, mat2.cols, mat2.rows, mat2.channels()); AAsset_close(assetFile); 以FileDescriptor的方式来读取 我们可以使用AAsset_openFileDescriptor来获取FileDescriptor,然后再进行其他操作。需要注意的是,AAsset_openFileDescriptor返回当前fd的起始seek位置start以及文件长度length。在读取内容之前记得要先seek到start,否则会发现文件内容不对。见代码中的lseek. AAsset *assetFile = AAssetManager_open(nativeasset, "sz.jpg", AASSET_MODE_BUFFER); size_t fileLength = AAsset_getLength(assetFile); LOGD("before fd fileLength:%d",fileLength); off_t start = 0, length = 0; int fd = AAsset_openFileDescriptor(assetFile, &start, &length); LOGD("fd:%d start:%d length:%d", fd, start, length); lseek(fd, start, SEEK_CUR); //NOTICE char *dataBuffer = (char*)malloc(fileLength); memset(dataBuffer, 0, fileLength); read(fd, dataBuffer, fileLength); close(fd); //close fd LOGD("read_ %d %d %d", dataBuffer[0], dataBuffer[1], dataBuffer[2]); std::vector<char> vec2(dataBuffer, dataBuffer + fileLength); cv::Mat mat2 = cv::imdecode(vec2, CV_LOAD_IMAGE_COLOR); LOGD("use fd mat:%d x %d %d", mat2.cols, mat2.rows, mat2.channels()); AAsset_close(assetFile); 获得fd之后,也可以通过他来获得一个FILE:FILE * file = fdopen(fd, "rb");但是一定要记得fclose(file)。总的来说不如read方便。 open mode AAssetManager_open需要传入一个mode参数,各参数的含义如下,按需使用。 AASSET_MODE_UNKNOWN: Not known how the data is to be accessed AASSET_MODE_RANDOM: Read chunks, and seek forward and backward AASSET_MODE_STREAMING: Read sequentially, with an occasional forward seek AASSET_MODE_BUFFER: Attempt to load contents into memory,for fast small reads 细节提示 AAsset是只读的,比如上面获得FILE之后,不能用来写。 AAsset provides access to a read-only asset. 记得AAsset_close 记得AAssetDir_close 关于压缩文件 Android APK中有些文件是会进行压缩的,而有些文件则因为本身就是已经压缩过的,不再进行压缩,具体有: /* these formats are already compressed, or don't compress well */ static const char* kNoCompressExt[] = { ".jpg", ".jpeg", ".png", ".gif", ".wav", ".mp2", ".mp3", ".ogg", ".aac", ".mpg", ".mpeg", ".mid", ".midi", ".smf", ".jet", ".rtttl", ".imy", ".xmf", ".mp4", ".m4a", ".m4v", ".3gp", ".3gpp", ".3g2", ".3gpp2", ".amr", ".awb", ".wma", ".wmv" }; 那么对于在APK中会被压缩的文件,比如txt文件,就不能使用AAsset_openFileDescriptor来读了,否则,会返回-1这样的无效fd。对于会被压缩的文件,那么就只能使用AAsset_read或者AAsset_getBuffer来访问了。 现在加Android开发群;701740775,可免费领取一份最新Android高级架构技术体系大纲和视频资料,以及五年积累整理的所有面试资源笔记。加群请备注csdn领取xx资料

优秀的个人博客,低调大师

Python全栈 Web(Flask框架、cookie, session)

cookie: 什么是cookie? 是一种数据存储技术 将一段文本保存在客户端的一种技术 并且可以长时间保存 cookie的使用场合: 记住密码 搜索关键词 在Flask使用cookie 使用 响应对象 来保存cookie到客户端 响应对象: resp = make_response("响应字符串") resp = redirect("地址") 响应对象.set_cookie(key, value, max_age) key: 保存cookie的名称 value: 保存cookie的值 max_age: 保存时间以 s 单位 session 什么是session session是保存在服务器为每个浏览器所开辟的一段空 session 在Flask中的实现 配置SECRET_KEY app.fonfig["SECRET_KEY"] = "YOURGUESS" 使用session

优秀的个人博客,低调大师

Python全栈 Web(Flask框架、变量、模板)

模板 Templates: 模板中的语法规范 变量: 变量时一种特殊的占位符 告诉模板引擎该位置的 值是从渲染模板时的数据中来获取的 在视图中: @app.route("/temp") def temp(): return render_template("01_temp.html",uname="user name") name和age就是要传递到xxx.html中的变量 在模板中: {{变量名}} <title>{{unam}}</title> Python代码 @app.route("/temp") def temp(): dic = {"bookName":"钢铁是咋炼成的", "author": "鲁迅", "price": 32.5 ,

优秀的个人博客,低调大师

Python全栈 Web(Flask框架、安装、应用)

Flask 轻量级WEB框架 静态网页: 不能与服务器交互的网页都是静态网页 动态网页: 能够与服务器进行交互的网页 WEB:浏览器 网页(前端三剑客) 服务器: 能够给用户提供服务的机器就是服务器 硬件来说就是 一台主机 还要配备一个能够接受用户请求并给出响 应用程序 APACHE TOMCAT IIS(Internet Information Service) Nginx(Python用的较多) 作用: 存储WEB所需要的信息 所有的服务器都能够处理用户请求( request)并作出回应( response) 能够执行服务器端的程序 具备一定的安全性功能 框架: 是一种为了解决开放性问题而存在的一种结构 框架本身也提供了一些基本功能, 我们只需要在自己的基础功能上搭建属于自己的操作即可 Python的WEB框架: Flask Django Tornado Webpy Flask框架: 什么

优秀的个人博客,低调大师

Python全栈 Web(Django框架、概述、安装)

Django 框架 WEB 与 服务器 WEB : 表示用户可以浏览的网页内容(HTML,CSS,JS) 服务器 专门给用户提供服务的一台机器 1.硬件与软件 硬件范畴:一台机器 软件范畴:一个能够接受用户请求并给出响应的程序 1.APACHE 2.TOMCAT 3.IIS(Internet Information Service) 4.Nginx 2.服务器的作用 1.存储WEB上所需要的信息(HTML,图片,js,css,音视频) 2.处理用户的请求(request)并给出响应(response) 3.执行服务器端的程序 : 查找数据库 3.服务器 与 WEB之间的关系 WEB需要放在服务器上才能够被用户访问 框架 什么是框架 框架是一个为了解决开放性问题而存在的一种结构.框架本身会提供一些最基本的功能.我们只需要在基本功能之上搭建属于自己的操作即可. PYTH

优秀的个人博客,低调大师

Python全栈 Web(JavaScript DOM节点、事件)

1.查询节点 1.根据节点的层级查询节点 1.childNodes 元素节点,文本节点, 2.children 元素节点 3.parentNode 获取父节点 4.nextSibling 获取下一个兄弟节点 有可能是文本节点 5.nextElementSibling 获取下一个兄弟元素节点 6.previousSibling 获取上一个兄弟节点 有可能是文本节点 7.previousElementSibling 获取上一个兄弟元素节点 2.通过标签名查询节点 - 返回数组 document|elem.getElementsByTagName("标签名"); document:整个文档内查找 elem:某个元素内查找 3.通过元素的name属性值查询节点 document.getElementsByName("name属性值"); 返回值:包含指定name属性值的元素的数组 <

优秀的个人博客,低调大师

Python全栈 Web(定位布局、定位方式)

定位布局: 属性:position 取值: static 默认值 按照文档流布局 relative 相对定位 absolute 绝对定位 fixed 固定定位 只有元素的position属性设置为非默认属性 才算是已经定位的元素 偏移属性: top right bottom left 用来配合已经定位的元素实现位置移动 取值:px top:以元素的上边界为基准移动元素 right:以元素的右边界为基准移动元素 bottom:以元素的低边界为基准移动元素 left:以元素的上左界为基准移动元素 定位方式: 相对定位: 属性:position:relative; 元素采用相对定位时会参照它在文档中原本的位置进行偏移 绝对定位: 属性:position:absolute; 特点: 1.绝对定位的元素,会脱离文档流不占位 2.绝对定位元素会参照离他最近的已经定位的祖先元素进行偏移 3.如果没有已经定位的祖先元素 元素会参照body(浏览器窗口左上角)进行偏移 注意: 所有元素只要脱流就可以设置宽高大小 通常使用“父相子绝”的方式页面布局 限制其他元素的布局方式 浮动和绝对定位点都可以实现元素脱流,采用浮动+外边距调整元素的位置 等价于绝对定位+偏移属性 浮动更常见于外围结构标签,做网页整体布局时 使用,绝对定位更常见于内部元素的调整 浮动和相对定位可以共存 设置相对定位只是为了辅助内部子元素+的定位布局 堆叠次序的调整: 已经定位的元素堆叠在一起是的排列顺序 语法: 属性:z-index 取值:整数 数值越大越靠上 注意: 如果我们元素z-index属性值相同,后来者居上 父子元素都设置z-index 永远都是子元素在上 不受影响 z-index属性只能用在已经定位的元素上 固定定位: 可以使元素的位置固定在浏览器窗口的某个位置 不会随网页内容的滚动而滚动 语法: 属性:position 取值:fixed 配合偏移属性实现元素位置的固定 注意: 固定定位的元素永远是参照浏览器的窗口定位的 固定定位的元素都会变成块元素 显示方式: 1.决定元素以何种样式显示在网页中 属性:display 取值: none 设置元素隐藏 隐藏后不占位 block 设置元素显示 或 将元素转换为块元素 inline 转换为行内元素 inline-block 转换为行内块元素 显示效果: 属性:visibility 取值: visible 默认值 表示显示 hidden 元素隐藏 仍然在文档中占位 元素透明度: 属性:opacity 设置元素透明度 取值:0~1 0:透明 1:不透明 元素设置opacity属性 所有的内容都会实现透明效果 子元素会继承父元素的透明效果 如果父子元素都设置了opacity 子元素最终的效果是在父元素半透明的基础上 在进行半透明 子元素最终效果=父元素opacity*本身opacity 设置垂直对齐方式: 属性:vertical-align 取值:top middle bottom 可以用在行内元素上 但更常见于为行内快元素设置vertical-align 调整行内快元素左右内容与它的对齐方式 光标显示: 改变鼠标悬停在元素上时的显示外观 属性:cursor 取值: default 默认 pointer 显示为小手形状 text 显示为 I crosshair 显示为 + 列表属性: 列表本身是块级元素,自带外边距,电邮项目符号 属性: 属性:list-style-type 设置项目符号 取值: none 取消项目符号 disc 实心原点 circle 空心原点 square 实心方块 ... 设置项目符号为图片: 属性:list-style-image 取值: url(“图片路径”) 设置项目符号的位置: 属性:list-style-position 取值:inside outside 设置项目符号出现在内容框的外部还是内部 **简写属性: list-style:none; 常用来取消列表的项目符号 转换属性: 主要是用来改变元素在页面中的位置、尺寸、角度 属性:transform 取值: 转换函数 多个函数之间用空格隔开 转换原点: 转换原点实际上就是元素转换操作的基准点 属性:transform-origin 取值:x y; 表示以元素左上角为原点进行选取旋转原点的坐标 可以使用像素值、百分比、方位值 top center bottom left center right 默认以元素的中心点为原点 转换函数: 平移变换: 改变元素在网页中的位置 属性:transform 取值:translate(x, y) x表示元素在水平方向上平移的距离 y表示元素在垂直方向上平移的距离 可以填写正值或负值 其他情况: translateX(value) 指水平方向位移 translateY(value) 指垂直方向位移 translate(value) 等价于translateX 缩放变换: 改变元素在页面中的大小 属性:transform 取值:scale(value) value为无单位的素值 表示缩放比例 默认值是1 正常比例显示 value > 1 会等比放大 0 < value < 1 等比缩小 value < 0 元素会等比反转 其他情况: scaleX(v) 横向缩放 scaleY(v) 垂直缩放 旋转变换: 元素旋转一定的角度显示 属性:transform 取值:rotate(ndeg) 表示元素按照指定的角度旋转 正值:顺时针 负值:逆时针 3D变换: rotateX(ndeg)沿X轴旋转 rotateY(ndeg)沿Y轴旋转 rotateZ(ndeg)沿Z轴旋转 旋转原点会影响转换效果 元素如果涉及旋转操作 会连带坐标轴一起旋转,影响后面的位移

优秀的个人博客,低调大师

Python全栈 Web(概述、HTML基础语法)

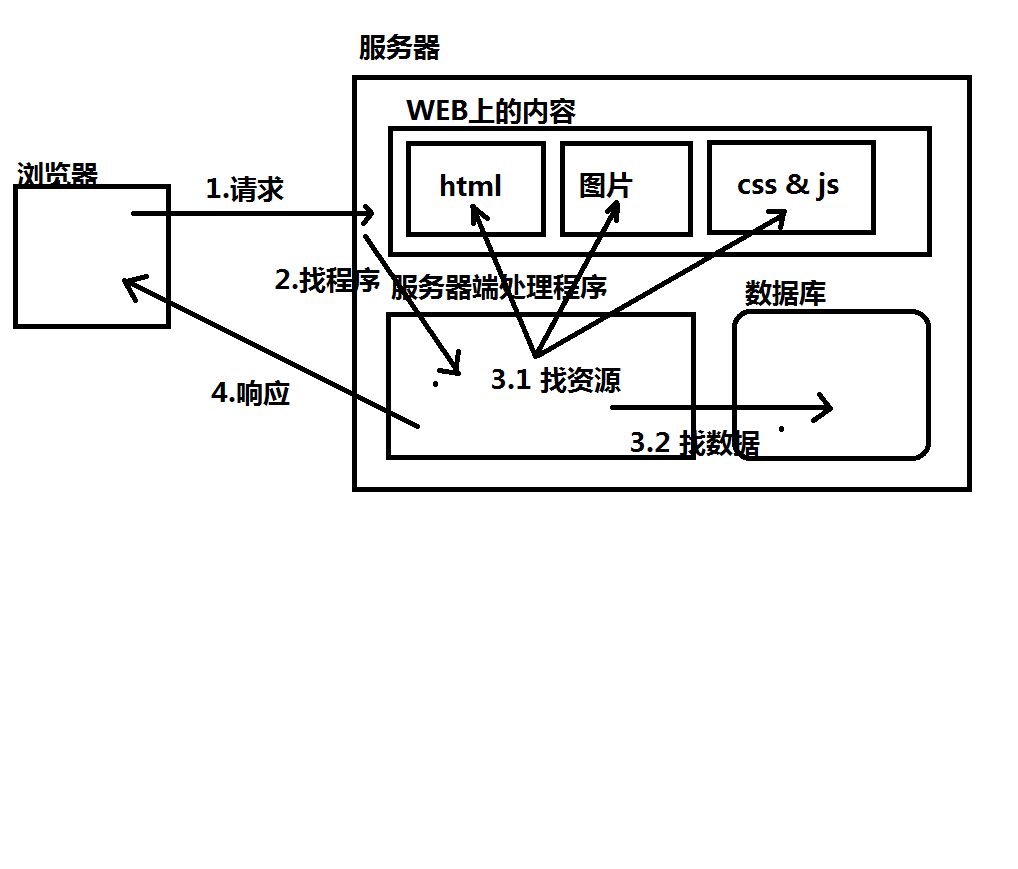
Web: 什么是Web? Web就是网页 是一种基于B/S的应用程序 Web应用程序是由多个Servlet、JSP页面、HTML文件以及图像文件等组成 B:Browser 浏览器 S:Server 服务器 —————————————————— C/S C:client 客户端 S:Server 服务器 Web组成: 浏览器:代替用户向服务器发送请求 服务器:接受用户响应 通信协议:规范数据在网络中是如何打包即传递的 HTTP:HyoerText transfer portocal 超文本传输协议 Web服务器: 作用; 接受用户请求并且响应 存储Web信息 具备安全性 产品: Apache Tomcat IIS -Internet Information Server Nginx .... 技术: JSP - Java Server page PHP ASP.net Python Web (Django、Flask..) Web浏览器: 作用: 代替用户向服务器发送请求 作为响应用户的解释引擎,向用户呈现界面 主流产品: 根据浏览器内核/引擎划分 Microsoft IE Google Chrome Mozilla FireFox Apple Safari Opera Opera 浏览器引擎: 渲染引擎 - 解析 HRML、CSS 控制页面渲染效果 JS引擎 - 解释网页脚本文件 前段开发技术: HTML CSS JavaScript HTML: HTML概述: 什么是HTML? HyperText Markup language 超文本标记语言 作用: 书写网页结构 超文本: 具备特殊功能的文本 例如超链接 标记: 也叫标签 主要是用来标记网页中的内容 实现网页的布局和JS操作 HTML在技术算中的表现: 所有的网页文件在计算机中都是以.html、.htm文件储存的 开发工具: 记事本 Editplus、DreamWeaver sublime、Webstorm、Hbuilder、VSCode、Atom 运行工具: Chrome 浏览器 调试工具: 开发者工具 快捷键:F12 HTML基础语法: 标签/标记/元素: 在网页中具有特殊功能的符号 HTML所有的标签都以<>为标致区分 标签分类: 双标记: 成对出现 有开始有结束 语法: <开始> 内容 </结束> <h1> hello world </h1> 单标记: 只有开始没有结束 可以手动添加/表示结束 语法: <标签名> 或 <标签名/> <br> --- <br/> <hr> --- <hr/> 标签的嵌套: 在双标记中出现其他的标记 超链接: <a>首页</a> 文本加粗: <b>首页</b> 加粗超链接: <a> <b>首页</b> </a> 嵌套结构中 外层元素成为父元素 内层元素叫子元素 文档结构: <html> <head> </head> <body> hello world! </body> </html> 书写规范: HTML不区分大小写 推荐用小写 保持适当的缩进 增强代码可读性 标签属性: 主要用来修饰标签的显示效果 语法: 属性由属性名和属性值组成: 属性名=“属性值” 属性的声明须写在开始标签中 <开始 属性名=“属性值”> ... </结束> 每个标签都可以设置多个属性, 属性之间使用空格隔开 HTML注释: <!-- 注释内容 --> 注意: 注释不能写在标签里 注释不能嵌套 HTMl的换行于空格: HTML会忽略多余的 空只显示一个空格 如果需要多个空格或者<> 都需要使用特殊符号来代替 HTML结构组成: 文档类型声明: <!doctype html> //H5的声明方式 作用: 告诉浏览器当前使用的HTML版本 以便浏览器能正确解析HTML的标签和渲染样式 书写位置: 文档的第一行代码 文档的开始和结束: 在文档类型声明之后使用 <html></html> 表示文档的开始和结束 在HTML标签中包含连个子元素 <head> </hesd>: 网页的头部信息 包含网页的标题,选项卡的图标 网页的关键字 作者 描述信息等 还可以引用外部的资源文件 子元素: 1.设置网页的标题: <title> 我的第一个网页 </title> 2.设置字符编码: <meta charset="utf-8"> 浏览器按照utf-8编码格式解析网页 <body> </body>: 网页的主体信息 网页所呈现的内容 都要写在body里 文本相关的标签: 字符实体(具有 特殊意义的符号) &nbsp; 表示一个空格 &lt; 表示小于号 < &gt; 表示大于号 > &copy; 表示版权符号 @ &yen; 表示人民币符号 ¥ 文本样式标签: 斜体显示文本: <i> </i> 斜体显示 <u> </u> 文本添加下划线 <b> </b> 文本加粗 <s> </s> 删除线 <sup> </sup>上标 <sub> </sub>下标 这些标签可以与其他的标签或文本共行显示 标题标签: 可以以不同的文字大小和加粗方式显示文本 语法: <hn> </hn> n:取值1~6 可以改变文字大小和自动加粗 每个标题都会具备垂直的空白距离 每个标题都独占一行 不与其他元素共行显示 每个标题都可以添加属性align 取值: left center right 默认左对齐 段落标签: 突出显示一段文本 每一段的文本都独占一块/行 不与其他元素共行 并且具备垂直空白距离 语法: <p> </p> 属性: align 设置文本水平对齐方式 left center right 格式标签: <br> --- <br/> 换行标签 <hr> --- <hr/> 水平线 分区标签: 块分区: <div> </div> 划分页面结构 配合CSS实现页面布局 独占一块/行显示 行内分区元素: <span> </span> 设置同一行文本的不同样式(结合CSS) 可以与其他元素或文本共行显示 允许一行文本中使用span元素 标签分类: 块级元素: 只要是在网页中独占一行 不予其他元素共行显示 的元素都是块级元素 都可以来做布局 所有的块级元素都可以添加align属性设置内容的水平对齐方式 行内元素: 可以与其他元素共行显示 列表标记: 按照重是上到下的方式排列数据 并且能够显示项目符号在数据前面 列表的组成: 列表的类型: 有序列表 <ol> </ol>(ordered list) 默认按照数字排列 无序列表 <ul> </ul> (unordered list) 默认以实心原点作为标识 列表项: 列表中的每一天数据都是一个列表项 语法: <li> </li> 列表项需要嵌套在列表标签中使用 列表属性: 有序列表--- ol type属性:设置项目符号 1:按照数字排列(默认) a:按照小写字母顺序排列 A:按照大小字母顺序排列 i:罗马数字排列(分大小写) start属性:设置从第几个字符开始排列 只能取值数字 无序列表--- ul type属性:设置项目符号 disc:实心原点(默认) circle:空心圆的 square:空心方框 none:不显示项目符号 列表嵌套: 在一个列表中又出现了其他的列表 图像与超链接: URL(Uniform resource Locator) 统一资源定位符 用来表示网络中资源的位置 俗称路径 URL的组成: 协议、域名、主机名、文件 URL分类: 绝对路径: 从根目录开始查找 常用于网络文件路径 相对路径: 从当前所在的目录开始查找 根相对路径: 从Web程序所在的目录开始查找资源文件 URL中不能出现中文 URL严格区分大小写 图像标签: 在网页中插入一张图片 语法: <img> 属性: src:指定文件路径 width:设置宽度以像素为单位px height:设置高度(px) sorc必填 宽高可以省略 省略为图片默认大小 title: 用来设置图片的标题 当鼠标悬停在图片上方时显示 alt: 用来设置显示文件加载失败提示 非常简单没什么东西.............

优秀的个人博客,低调大师

Python全栈工程师(面向对象)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 Python人工智能从入门到精通 day16补充: 异常处理 文件操作综合练习示例 src_filename = input("请输入源文件路径名: ") dst_filename = input('请输入目标文件路径名: ') try: src = open(src_filename, 'rb') # 打开源文件用来读数据 try: try: dst = open(dst_filename, 'wb') # 打开目标文件用来写 try: while True: b = src.read(4096) # 4096当前Linux系统内核字节大小 if not b: # 已经再也读不到数据了 break dst.write(b) # 写字节到文件 print("复制成功") finally: dst.close() # 必须关闭文件 except OSError: print("打开写文件失败") finally: src.close() # 必须关闭文件 except OSError: print("复制失败") 面向对象编程: 以函数单位 面向对象编程 Ojbect-Oriented Programing什么是对象: 对象是指现实中的物体或实物 对象有什么属性: 对象有很多属性(名词,形容词) 姓名, 年龄, 性别 对象有很多行为(动作,动词) 吃饭,睡觉,工作面向对象: 把一切都看作对象(实例) 用各种对象之间的关系来描述事务什么是类: 拥有相同属性和行为的对象分为一组, 即为一个类 类是用来描述对象的工具,用类可以创建此类的对象(实例)面向对象示意: 车(类)----> BYD E6(京A:88888)实例(对象) \ \----> BMW X5(京A:66666)实例(对象) 狗(类)----> 小京巴(户籍号:0000001)实例(对象) \ \----> 导盲犬(户籍号:0000002)实例(对象) int(类)----> 100(对象) \ \----> 500(实例、对象)类的创建语句: class 类名(继承列表): ‘类的文档字符串’ 实例方法的定义 类变量的定义 类方法的定义(@classmethod) 静态方法的定义(@staticmethod) 作用: 创建一个类 类用于描述对象的行为和属性 类用于创建此类的一个或多个对象 说明: 类名必须是标识符 类名实质上就是变量, 它绑定一个类示例: # 用class语句 创建一个类 class Dog: ''' 这是文档字符串 描述一些小动物 ''' pass 构造函数 构造函数的调用表达式 语法: 类名([创建传参列表]) 作用: 创建这个类的实例对象,并返回此实例的引用关系 示例: dog1 = Dog() # 调用构造函数创建一个实例对象 再用dog1绑定 print(id(dog1)) dog2 = Dog() # 创建另一个实例对象 print(id(dog2)) lst1 = list() # 调用构造函数创建一个列表对象 print(id(lst1)) lst2 = list() # 创建另一个实例对象 print(id(lst2)) 实例说明: 1.实例有自己的作用域和空间名, 可以为该类添加实例变量(也叫属性) 2.实例可以调用类的方法和实例方法 3.实例可以访问类变量和实例变量 实例方法: 语法: class 类名(继承列表) def 实例方法名(self, 参数1, 参数2...): ‘文档字符串’ 语句 作用: 用于描述一个对象的行为, 让此类型的全部对象都拥有相同的行为 说明: 实例方法实质是函数, 是定义类的函数 实例方法至少有一个形参, 第一个形参代表调用方法的实例, 一般命名为“self” 实例方法语法: 实例.实例方法名(调用传参) 或 实例.实例方法名(实参, 调用传参) 示例: # 实例方法的创建和调用 class Dog: ''' 这是文档字符串 描述一些小动物 ''' def eat(self, food): '''此方法用来描述小狗吃的行为''' print("小狗正在吃", food) def slep(self, hour): '''此方法用来描述小狗睡的行为''' print("小狗睡了%d小时" % hour) def play(self, obj): '''此方法用来描述小狗玩的行为''' print("小狗正在玩", obj) dog1 = Dog() # 调用构造函数创建一个实例对象 再用dog1绑定 dog1.eat("单身狗粮") dog1.slep(3) dog1.play("球") dog2 = Dog() dog2.eat("提子") # 创建另一个实例对象 dog1.slep(5) dog1.play("MM") ====================== >>> import day17 小狗正在吃 单身狗粮 小狗睡了3小时 小狗正在玩 球 小狗正在吃 提子 小狗睡了5小时 小狗正在玩 MM >>> dir() ['__builtins__', '__doc__', '__loader__', '__name__', '__package__', '__spec__', 'day17'] >>> dir(day17) ['Dog', '__builtins__', '__cached__', '__doc__', '__file__', '__loader__', '__name__', '__package__', '__spec__', 'dog1', 'dog2'] >>> help(day17) >>> help(list) ====================== 实例属性 atribute(也叫实例变量) 每个实例对象可以有自己的变量, 称为实例变量(也叫属性) 语法: 实例.属性名 赋值规则: 首次为属性赋值则创建此属性 再次为属性赋值则修改属性的绑定关系 作用: 记录每个对象自身数据 示例: # 属性的方法 class Dog: ''' 这是文档字符串 描述一些小动物 ''' def eat(self, food): '''此方法用来描述小狗吃的行为''' print(self.color, "的", self.kinds, "小狗正在吃", food) # 让调用此方法的对象添加一个last_food属性用来记住吃过的信息(方法内添加属性) self.last_food = food # 方法外添加属性 dog1 = Dog() # 调用构造函数创建一个实例对象 再用dog1绑定 dog1.kinds = "京巴" # 为dog1对象添加kinds属性, 绑定为"京巴" dog1.color = "白色" # 为dog1对象添加 color "白色"属性 dog1.color = "原谅色" # 改变dog1对象 color属性 print(dog1.color, "的", dog1.kinds) # 原谅色 的 京巴 dog2 = Dog() # print(dog2.color, "的", dog2.kinds) # 出错 dog2.kinds = "二哈" # 为dog2对象添加kinds属性, 绑定为"二哈" dog2.color = "白色" # 为dog2对象添加 color "白色"属性 dog2.color = "黄色" # 改变dog2对象 color属性 print(dog2.color, "的", dog2.kinds) # 黄色 的 二哈 dog1.eat("单身狗粮") # 原谅色 的 京巴 小狗正在吃 单身狗粮 dog2.eat("爱心蛋糕") # 黄色 的 二哈 小狗正在吃 爱心蛋糕 # 可以在方法(函数)外添加对象属性也可以在方法内添加 通常在方法内(函数) 删除属性:del 例如: class Dog: pass dog1 = Dog() dog1.color = "白色" del dog1.color del 变量名 删除变量del 列表[整数表达式] 删除列表元素del 字典[键] 删除字典中的键del 对象.属性 删除对象的属性 初始化方法: 作用: 对新创建的对象添加属性 语法: def __init__(self[, 形参列表]): 语句块 [ ] 代表可省略 说明: 1.初始化方法名必须为‘__init__’不可改变 2.初始化方法在构造函数创建实例后自动调用,且将实例自身 通过第一个参数self 传入__init__方法 3.构造函数的实参将通过__init__方法的参数列表传入到‘__init__’方法中 4.初始化方法内如果需要return语句返回 则返回None 示例: # 初始化方法 __init__ class Car: '''定义汽车类''' def __init__(self, c, b, m): self.color = c # 颜色 self.brand = b # 品牌 self.model = m # 型号 print('__init__方法被调用') def run(self, speed): print(self.color, "的", self.brand, self.model, "正才以", speed, "公里没小时行驶") a4 = Car("红色", "奥迪", "A4") # 调用构造函数 a4.run(1000) # 红色 的 奥迪 A4 正才以 1000 公里没小时行驶 s3 = Car("蓝色", "TESLA", "Model S") # 调用构造函数 s3.run(6000) # 蓝色 的 TESLA Model S 正才以 6000 公里没小时行驶 析构方法: 语法: class 类名: def __del__(self): ... 说明: 析构方法在对象被销毁时会自动调用 Python建议不要在对象销毁时做任何事情, 因为销毁时间难以确定示例: # 析构方法 class Car: def __init__(self, name): self.name = name print("汽车", name, "被创建") def __del__(self): '''析构方法,对象被销毁时 次方法调用''' print("汽车", self.name, "被销毁") c1 = Car("BYD E6") input("此汽车是伪造! 按回车继续程序...") # 汽车 BYD E6 被创建 # 此汽车是伪造! 按回车继续程序... # 汽车 BYD E6 被销毁 c2 = c1 del c2 input() # 汽车 BYD E6 被创建 预置实例属性: __dict__属性 __dict__属性绑定一个储存此实例自身变量的字典示例: >>> class Dog: ... pass >>> dog1 = Dog() >>> dog1.name = "哈哈" >>> dog1.__dict__ {'name': '哈哈'} >>> dog1.age = 3 >>> dog1.__dict__ {'age': 3, 'name': '哈哈'} >>> del dog1.age >>> dog1.__dict__ {'name': '哈哈'} >>> __class__属性 此属性用于绑定创建一些实例的类 作用: 可以借助于此属性来访问创建此实例的类示例: >>> class Dog: ... pass ... >>> dog1 = Dog() >>> Dog <class '__main__.Dog'> >>> dog1.__class__ <class '__main__.Dog'> >>> type(dog1) <class '__main__.Dog'> >>> type(dog1) is Dog True >>> dog2 = dog1.__class__() # 等同于 dog2 = Dog() >>> dog2.__class__ <class '__main__.Dog'> 面向对象的综合示例: 有两个人: 1. 姓名:张三 年龄:25 2. 姓名:李四 年龄:5 行为: 1.教别人学学东西 teach 2.赚钱 works 3.借钱 borrow 事情: 张三 教 李四 学 Python 李四 教 张三 学 跳皮筋 张三 上班赚了 1000 元钱 李四 向 张三 借了 200 元钱 打印张三的信息:25岁 的 张三 有钱 800元 他学会了跳皮筋 打印李四的信息:5岁 的 李四 有钱 200元 他学会了python class Human: '''描述人的行为和属性 teach(self, other, subject) 学习技能 works(self, money) 赚钱 borrow(self, other, money) 借钱 def print_info(self) 输出信息 ''' def __init__(self, name, age): '''初始化基本信息和属性''' self. name, self.age = name, age # 名字, 年龄 self.money = 0 # 钱数 self.skill = [] # 技能列表 def teach(self, other, subject): '''实例行参对象1 教 实例行参对象2 学 技能的实例方法 self:实例形参1(调用对象自己) other: 实例形参2 (调用目标对象) subject: 技能 ''' other.skill.append(subject) # 行参对象2 追加新技能 print(self.name, "教", other.name, "学", subject) def works(self, money): '''实例行参对象的 赚钱 实例方法 self:实例行参(调用对象自己) money:赚的钱数 ''' self.money = money # 实例形的钱数 print(self.name, "上班赚了", money, "元钱") def borrow(self, other, money): '''实例行参对象1 向 实例行参对象2 借钱 的实例方法 self:实例形参1(调用对象自己) other: 实例行参2 (调用目标对象) monay: 接的钱数 ''' if other.money > money: # 目标对象的钱小于借钱数额 借钱失败 self.money += money # 自己的钱 other.money -= money # 目标对象剩余的钱 print(self.name, "向", other.name, "借了", self.money, "元钱") else: print(self.name, "向", other.name, "借钱失败!") def print_info(self): '''打印输出self的信息实例方法 self:实例行参(调用对象自己) ''' print(self.age, "岁的", self.name, "有钱", self.money, "元 他学会了:", self.skill) zhang3 = Human("张三", 25) li4 = Human("李四", 5) # 张三教李四Python zhang3.teach(li4, "Python") # 李四教张三玩游戏 li4.teach(zhang3, "玩游戏") # 张三上班赚了 1000 元钱 zhang3.works(1000) # 李四向张三借 200 元钱 li4.borrow(zhang3, 200) # 打印李四信息 li4.print_info() # 打印张三信息 zhang3.print_info() # 第一个实例形参一般为调用者自己 # (自动传参自己 不需要填写 直接从第二个形参开始) # __init__()初始化信息函数内的属性为公用属性 # 初始化对象后每个对象都会调用__init__内的属性 # 其他方法(单独属性)另需调用 用于类的函数: isinstance(obj, class_or_tuple) 返回这个对象obj是否是某个类的对象或某些类中的一个类的对象, 如果是则返回True,否则返回False type(obj) 返回对象的类型 >>> a = 100 >>> isinstance(a, int) True >>> isinstance(a, bool) False >>> a = 100.0 >>> isinstance(a, int) False >>> isinstance(a, float) True >>> type(a) <class 'float'> >>> a = 100 >>> type(a) <class 'int'> >>> 练习: 自己写一个'人'类: Human class Human: def set_info(self, name, age, address='未知'): '''此方法用来给人对象添加'姓名', '年龄', '家庭住址'三个属性''' ... # << 此处自己实现 def show_info(self): '''显示此人的全部信息''' ... # 此处自己实现 如: h1 = Human() h1.set_info('小张', 20, '北京市朝阳区') h2 = Human() h2.set_info('小李', 18) h1.show_info() # 小张今年 20 岁,家庭住址:北京市朝阳区 h2.show_info() # 小李今年 18 岁,家庭住址:末知 答案: class Human: def set_info(self, name, age, address='未知'): '''此方法用来给人对象添加'姓名', '年龄', '家庭住址'三个属性''' self.name = name self.age = age self.address = address def show_info(self): '''显示此人的全部信息''' print(self.name, '今年', self.age, '岁,家庭住址:', self.address) h1 = Human() h1.set_info('小张', 20, '北京市朝阳区') h2 = Human() h2.set_info('小李', 18) h1.show_info() # 小张今年 20 岁,家庭住址:北京市朝阳区 h2.show_info() # 小李今年 18 岁,家庭住址:末知 class Human: def set_info(self, name, age, address='未知'): '''此方法用来给人对象添加'姓名', '年龄', '家庭住址'三个属性''' self.name = name self.age = age self.address = address def show_info(self): '''显示此人的全部信息''' print(self.name, '今年', self.age, '岁,家庭住址:', self.address) h1 = Human() # h1.set_info('小张', 20, '北京市朝阳区') Human.set_info(h1, '小张', 20, '北京市朝阳区') h1.show_info() # 小张今年 20 岁,家庭住址:北京市朝阳区 练习: 写一个Student类 1) 为该类添加初始化方法, 实现在创建对象时自动设置 '姓名','年龄', '成绩' 属性 2) 添加set_score方法能修改成绩信息 3) 添加show_info方法打印学生对象的信息 如: class Student: def __init__(...): ... ... s1 = Student('小王', 15, 59) s1.show_info() # 小王 今年 17 岁, 成绩是: 59 s1.set_score(80) s1.show_info() # 小王 今年 17 岁, 成绩是: 80 答案: class Student: def __init__(self, n, a, s): self.name, self.age, self.score = n, a, s def show_info(self): print(self.name, '今年', self.age, '岁, 成绩是:', self.score) def set_score(self, s): assert 0 <= s <= 100, '参数错误' self.score = s s1 = Student('小王', 15, 59) s1.show_info() # 小王 今年 17 岁, 成绩是: 59 s1.set_score(80) # s1.score = 80 s1.show_info() # 小王 今年 17 岁, 成绩是: 80 上面两个练习我写了一份很详细的 明天改 这个先凑合着... 练习: 修改原来的学生信息管理程序,将原来字典来存储学生信息, 现改为用对象来存储学生信息 # file : student.py class Student: def __init__(self, n, a, s): .... L = [] # L.append({...}) 改为对象 L.append(Student('xiaozhang', 20, 100)) (要求类Student 要写在模块 student.py中) 示例: # 假如文件中有这么多学生信息 L = [{"name": "Tom", "age": 15, "score": 98}, {"name": "AL", "age": 16, "score": 95}, {"name": "Lix", "age": 16, "score": 95}, {"name": "Li", "age": 16, "score": 95}, {"name": "ix", "age": 16, "score": 95}, {"name": "ix", "age": 16, "score": 95}, {"name": "Ax", "age": 16, "score": 95}, {"name": "i", "age": 16, "score": 95}, {"name": "x", "age": 16, "score": 95}, {"name": "Lx", "age": 16, "score": 95}, {"name": "ALi", "age": 16, "score": 95}, {"name": "Ka", "age": 16, "score": 95}, {"name": "Kla", "age": 16, "score": 95}, {"name": "KAl", "age": 16, "score": 95}, {"name": "Ala", "age": 16, "score": 95}, {"name": "Al", "age": 16, "score": 95}, {"name": "KAla", "age": 17, "score": 100}] class Student: '''创建学生类用来描述学生基本信息''' def __init__(self, n, a, s): '''初始化学生信息''' self.name, self.age, self.score = n, a, s def student_info(self): '''输出此学生信息''' print("Name:", self.name, "Age:", self.age, "score:", self.score) def student_list(L): '''将文件内学生信息编号存入列表''' L1 = [] for x, y in zip(L, range(1, len(L) + 1)): y = Student(x["name"], x["age"], x["score"]) L1.append(y) return L1 # 也可以用迭代器函数 # def student_list(): # for x in L: # y = Student(x["name"], x["age"], x["score"]) # yield y # 输出所有学生信息 def print_student(L): '''输出有所有学生信息''' for stud in L: stud.student_info() print_student(student_list(L))

优秀的个人博客,低调大师

Python全栈工程师(异常(基础))

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 Python人工智能从入门到精通 补充:包的相对导入 只对后两种导入方式有用 前两次改进的学生管理系统在20课中 已补充 异常(基础)except: 什么是错误: 是指由于逻辑或语法等导程序无法正常执行的问题 什么是异常: 是程序出错的标识符的一种状态 当异常发时 程序不会再向下执行,而转去调用此函数的地方 待处理此错误并恢复为正常状态 异常的作用: 用作信号, 通知上层调用者有错误产生需要处理try 语句: 两种语法: ry-except语句(接受异常通知) try-finally语句try-except 语法 : try: 可能触发异常的语句 except 错误类型1[as 变量1]: 异常处理语句2 except 错误类型2[as 变量2]: 异常处理语句2 except (错误类型3, 错误类型4,...)[as 变量3]: 异常处理语句3 ...... except: 异常处理语句(其他)(匹配所有类型错误) else: 未发生异常语句(可以没有此语句 没有发成异常时调用) finlly: 最终语句 作用: 尝试捕获异常, 将程序由异常状态转为正常状态并正常执行 说明: 1. as 子句是用于绑定错误对象的变量,可以省略 2. except 子句可以有一个或多个,但至少要有一个 3. else 子句最多只能有一个,也可以省略不写 4. finally 子句最多只能有一个,也可以省略不写 5. else 子句将在try没有出现异常时执行 6. finally子句的语句在任何情况下都会被执行 示例: # 此示例示意用try-except 语句捕获异常并做出相应的处理 def div_apple(n): print("%d个苹果您想分给几个人?" % n) s = input("请输入人数: ") cnt = int(s) # <- 此处可能触发ValueError类型错误 result = n / cnt # <- 此处可能触发ZeroDivisitionError错误 print("每个人分了%d个苹果" % result) try: print("开始分苹果") div_apple(10) # 可能触发异常的调用 print("结束分苹果") except ValueError: print("发生成值错误,已处理并转为正常状态!") except ZeroDivisionError: print("发生了被零除的错误,程序已转为正常状态") print("程序正常执行并完全任务,退出程序") try-finally语法: try: 可能触发异常的语句 finally: 最终语句 说明: 1.finally子句不可以省略 2.一定不存在except子句 作用: 通常try-finally语句来做触发异常时必须要处理的事情 无论异常是否发生, finally子句一定会被执行 注意: try-finally 语句不会改变程序的(正常/异常)状态 示例: # 以下以 煎蛋为例示意 try-finally语句的用法 # 必须要做的事情是,关闭天燃气 def fry_egg(): print("打开天燃气点燃...") try: count = int(input("请输入鸡蛋个数: ")) print("完成煎鸡蛋,共煎了%d个鸡蛋" % count) finally: print("关闭天燃气") fry_egg() raise 语句:(发起异常通知) 作用: 触发一个错误, 让程序进入异常状态 语法: raise 异常类型 或 raise 异常对 实例: def make_exception(): print("函数开始") # 发出一个ValueError类型的错误通知给调用者 # raise ValueError err = ValueError("这是自定义的错误数据") raise err # 用 err触发一个异常通知 print("函数结束") try: make_exception() print("make_exception调用结束!") except ValueError as e: print("接收到ValueError类型的异常通知") print("错误对象是:", e) assert 断言语句: 语法: assert 真值表达式, 错误数据(通常是字符串) 作用: 当真值表达式为False时, 用错误数据创建一个AssertionError 类型的错误, 并进入异常状态 等同于: if 真值表达式 == false raise AssertrtionError(错误数据) 实例: def get_score(): s = int(input("请输入学生成绩: ")) assert 0 <= s <= 100, '成绩超出范围' # if not (0 <= s <= 100): # raise AssertionError('成绩超出范围') return s try: score = get_score() except AssertionError as err: print("错误数据是:", err) print('获取成绩失败') score = 0 print("学生的成绩为:", score) 小结: 异常处理语句(4条): try-except 语句: 用于接受异常通知, 捕获异常 try-finally 语句: 执行必须执行的语句 raise 语句: 发送异常通知, 并进入异常状态 assert 语句: 根据条件选着性的发送 AssertionError类型的异常通知为什么要处理异常机制: 在程序调用层数比较深的时候, 向主调用函数传递错误信息 需要层层return返回 比较麻烦, 用异常处理机制可以较简单的传递错误信息 Python全部的错误类型 错误类型 说明 以下内容必讲 ZeroDivisionError 除(或取模)零 (所有数据类型) ValueError 传入无效的参数 AssertionError 断言语句失败 StopIteration 迭代器没有更多的值 IndexError 序列中没有此索引(index) IndentationError 缩进错误 OSError 输入/输出操作失败 ImportError 导入模块/对象失败 NameError 未声明/初始化对象 (没有属性) AttributeError 对象没有这个属性 GeneratorExit 生成器(generator)发生异常来通知退出 TypeError 对类型无效的操作 KeyboardInterrupt 用户中断执行(通常是输入^C) OverflowError 数值运算超出最大限制 FloatingPointError 浮点计算错误 BaseException 所有异常的基类 SystemExit 解释器请求退出 Exception 常规错误的基类 StandardError 所有的内建标准异常的基类 ArithmeticError 所有数值计算错误的基类 EOFError 没有内建输入,到达EOF 标记 EnvironmentError 操作系统错误的基类 WindowsError 系统调用失败 LookupError 无效数据查询的基类 KeyError 映射中没有这个键 MemoryError 内存溢出错误(对于Python 解释器不是致命的) UnboundLocalError 访问未初始化的本地变量 ReferenceError 弱引用(Weak reference)试图访问已经垃圾回收了的对象 RuntimeError 一般的运行时错误 NotImplementedError 尚未实现的方法 SyntaxError Python 语法错误 TabError Tab 和空格混用 SystemError 一般的解释器系统错误 UnicodeError Unicode 相关的错误 UnicodeDecodeError Unicode 解码时的错误 UnicodeEncodeError Unicode 编码时错误 UnicodeTranslateError Unicode 转换时错误 以下为警告类型 Warning 警告的基类 DeprecationWarning 关于被弃用的特征的警告 FutureWarning 关于构造将来语义会有改变的警告 OverflowWarning 旧的关于自动提升为长整型(long)的警告 PendingDeprecationWarning 关于特性将会被废弃的警告 RuntimeWarning 可疑的运行时行为(runtime behavior)的警告 SyntaxWarning 可疑的语法的警告 UserWarning 用户代码生成的警告 详见:help(builtins) 练习: 写一个函数 get_score() 来获取学生成绩, 要求用户输入 1~100的整数,输果输入出现异常,返此函数返回0, 否则返回用户输入的成绩 示例: def get_score(): ... score = get_score() print("学生的成绩是:", score) 练习: 1. 一个球从100米高空落下 ,每次落地后反弹高度是原高度的一半, 在落下 1)写程序算出皮球在第10次落地后反弹高度是多高? 2)打印出球共经过多少米的路程 答案: def ball(n, m): L = [100] while True: if n == 0: print("最后弹起的高度是%s米" % s) break s = m * 0.5 m = s L.append(s + m) n -= 1 return L print("10次共经历了%s米的路程" % sum(ball(10, 100))) 2. 分解质因数, 输入一个整数, 分解质因数 , 如: 输入 90 则打印: “90=2*3*3*5” (质因数是指最小能被原数整除的素数 不包括1) 答案: def m(n): ret = [] while n > 1: for i in range(n): k = i + 2 if n % k == 0: ret.append(k) n = int(n / k) break return ret print(m(90)) 3. 修改原学生信息管理程序,加入异常处理语句,让程序在任何情况下都能够按逻辑正常执行. 例如: 输入成绩和年龄时,如果用户输入非法字符串也不会导致程序崩溃

优秀的个人博客,低调大师

Python全栈工程师(集合、函数)

ParisGabriel 感谢 大家的支持 你们的阅读评价就是我最好的动力 我会坚持把排版内容以及偶尔的错误做的越来越好 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 Python人工智能从入门到精通 集合 set: 集合是可变的容器 集合内的数据对象都是唯一的(不能重复的) 集合是无序的储存结构。集合中的数据没有先后顺序关系 集合内的元素必须是不可变对象 集合是可迭代对象 集合相当于只有键没有值得字典(键则是集合的数据) (相当于字典和列表的结合 ) 创建集合: s = set() #空集合 s = {3.14,True,(1970.1.1),“hello”} #非空 集合的构造函数: set()创建一个空集合(不能用{} 否则就是字典了) set(iterable)用可迭代对象创建一个新的集合 创建新集合 内容重复会自动去重 例如: 集合的运算: 交集、并集、补集,子集、超集& 生成连个集合的交集: 重复部分 s1 ={1,2,3} s2 ={2,3,4} s3 = s1&s2 #s3 = {2,3} | 生成两个集合的并集: 所有不重复部分 s1 ={1,2,3} s2 ={2,3,4} s3 = s1 | s2 #s3 = {1,2,3,4} - 生成两个集合的补集: 相当于减法 s1 ={1,2,3} s2 ={2,3,4} s3 = s1 - s2 #s3 = {1} ^ 生成两个集合的对称补集: 相当于减法相加 s1 ={1,2,3} s2 ={2,3,4} s3 = s1 ^ s2 # (s1 - s2 | s2 - s1) #{1, 4} > 判断一个集合是另一个集合的超集< 判断一个集合是另一个集合的子集 s1 ={1,2,3} s2 ={2,3} s1 > s2 #true s1 为s2的 超集 s1 < s2 #true s1 为s2的 子集 (包含关系判断)== != 集合相同/不同: s1 ={1,2,3} s2 ={3,2,1} s1 == s2 # true s1 != s2 #false in / not in : 等同于字典的运算 判断某个值是否存在 集合和字典的优点: in/not in 运算符速度相对来说快一些 能用于集合的函数: len(x)、max(x)、min(x)、sum(x)、any(x)、all(x) Python3中常用的集合方法: 方法; 意义: S.add(e) 在集合中添加一个新的元素e;如果元素已经存在,则不添加 S.remove(e) 从集合中删除一个元素,如果元素不存在于集合中,则会产生一个KeyError错误 S.discard(e) 从集合S中移除一个元素e,在元素e不存在时什么都不做; S.clear() 清空集合内的所有元素 S.copy() 将集合进行一次浅拷贝 S.pop() 从集合S中删除一个随机元素;如果此集合为空,则引发KeyError异常 S.update(s2) 用 S与s2得到的全集更新变量S S.difference(s2) 用S - s2 运算,返回存在于在S中,但不在s2中的所有元素的集合 S.difference_update(s2) 等同于 S = S - s2 S.intersection(s2) 等同于 S & s2 S.intersection_update(s2) 等同于S = S & s2 S.isdisjoint(s2) 如果S与s2交集为空返回True,非空则返回False S.issubset(s2) 如果S与s2交集为非空返回True,空则返回False S.issuperset(...) 如果S为s2的子集返回True,否则返回False S.symmetric_difference(s2) 返回对称补集,等同于 S ^ s2 S.symmetric_difference_update(s2) 用 S 与 s2 的对称补集更新 S S.union(s2) 生成 S 与 s2的全集 集合推导式: 结合推导式是用可迭代对象生成集合的表达式语法: {表达式 for 变量 in 可迭代对象[if 真值表达式]} 之前说过 [ ] 内的代表可以省略例如: L= [1, 2, 5, 6, 3, 5, 9, 4, 5] s = {x for x in L)} (推导式嵌套同列表 、 字典一致) 固定集合 frozenset: 是不可变的、无序的、含有唯一元素的集合 用于固定集合可以作为字典的键,还可以作为集合的值构造函数: frozenset() 创建一个空固定集合 frozenset(iterable)用可迭代对象创建固定集合例如: f = frozenset()# 空固定集合 f = frozenset([ 1, 3, 5, 7]) # f = frozenset({1, 3, 5, 7}) 固定集合运算: & 交集 、 | 并集 、- 补集、^ 对称补集 >、 >= 、< 、<=、 ==、 != in /not in (和集合 set 一致)固定集合方法: 集合的方法取掉所有修改方法 小结: 数据类型: 数值类型: int、float、complex、bool 容器类型: 不可变容器: str、tuple、frozenset、bytes(字节串) 可变容器: list、dict、set、bytearray(字节组) 值: None、false、True运算符: 算数运算符: +、 - 、 * 、 / 、 // 、 % 、 ** 比较运算符: < 、 > 、 <= 、 >= 、 == 、 != in / not in 、 is / is not 布尔运算符: not 、 and 、or +(正号)、 -(负号) &、^ 、| 、 [ ] (索引) 表达式: 1 1+2 max(1,2,3,) x if x > y else y (条件表达式) 三种推导式: 列表、字典、集合推导式(3种)语句: 表达式语句: 所有的语句都可单独写在一行,形成一个语句 例如: print(“hello world”) 1 + 2 赋值语句: a = 100 a = b = c = 100 x, y = 100, 200 a[0] = 100 dict [ "name"] = "tarena" del 语句 while 语句 for 语句 break 语句 continue 语句 pass 语句函数: 内建函数:(系统内置函数) len(x) max(x) min(x) sum(x) any(x) all(x) 构造函数:(用来创建同类型的数据对象) bool(x) int(x)(进制转换可以添加进制参数 be>=2 and <= 36) float(x) complex(x) list(x) tuple(x) str(x) dict(x) set(x) abs(x) round(x) pow(x,y,z = None) bin(x) oct(x) hex(x) chr(x) ord(x) range(star,stop,step) input(x) print(x) help(__builtins__) 之前讲的差不多也就这些了 接下来我们讲函数 okeveryone 在开始之前的我想先说两句 咳咳: 之前比如说101等于5对吧 可能手一哆嗦打成了011 有细心的小伙伴就发发现了 给我评论 你们如果有什么问题 可以随时评论 我看到后 都会回复的 能解决的我有时间都会去解决 比如说哪里不懂啊 逻辑想不通啊 或者比较迷茫的 都是可以的 前面12课说的都是常用的和偶尔用的一些基础的运算以及语法 很多东西一次测扯出来根本听不懂的 学习要循序渐进对吧 后面的东西 我们会做一个实战项目 边做边学 有些可能一辈子用不几次的东西就没说 感兴趣的朋友可以 交互模式下help 查看一下帮助 或者官方的api文档 翻译好的api文档都是可以的 第一课之前的那个文章 我在里面加了api文档地址 有兴趣的可以去下载 这个项目的就是学生信息管理系统 昨天的第二题练习 我们已经做了一个开头了对吧 好了不废话了 进入正题 函数: function 函数是可以重复执行调用的语句块 作用: 1.用于封装语句块,提高代码的重用性 2.定义用户级别的函数def 创建函数语句: def 函数名(形参列表): 语句块 说明: 1. 函数的名字就是语句块的名称 2. 函数名的命名规则与变量名相同(函数名必须是标识符) 3. 函数名是一个变量(不要轻易对其赋值) 4. 函数有自己的空间,在函数外部不可以访问函数内部的变量,但是可以访问外部变量 5. 函数如果不需要传入参数,形参列表可以为空 6. 语句部分不能为空,如果为空需要填充passreturn 创建返回值语句: 用于函数中,结束当前函数的执行,返回调用该函数的地方,同时返回一个对象的引用关系 return[表达式] ([ ] 代表可以省略) 说明: 1. 函数调用是一个表达式 2. 如果函数内部没有return语句,函数调用完毕后返回None对象 3. 如果函数需要返回其它的对象需要用到 return 语句函数的调用: 函数名(实际调用传递参数) (实际调用传递参数,简称实参) 练习:1.任意输入一些数字,存于列表L中。当输入负数时结束输入 1) 打印这些数的和 2) 打印这些数有多少种(去重) 3) 除重复的数字后,打印这些剩余数字的和 提示,可以用集合去重 答案: L = [] while True: a = int(input("please input at will ingeger (input '-1' over):")) if a < 0: break L.append(a) print(sum(L)) s = set(L) print(len(s)) print(sum(s)) 2.经理有: 曹操,刘备,孙权 技术员有: 曹操,孙权,张飞,关羽 用集合求:1) 即是经理,也是技术员的有谁? 2) 是经理,但不是技术员的人员都有谁? 3) 是技术员,不是经理的都有谁 4) 张飞是经理吗? 5) 身兼一职的人都有谁? 6) 经理和技术员共有几个人? 答案: s = {"曹操", "刘备", "孙权"} s1 = {"曹操", "孙权", "张飞", "关羽"} if "张飞" in s: x = "是" else: x = "不是" print(''' 即是经理,也是技术员的有:%s 是经理,但不是技术员的人员有:%s 是技术员,不是经理的有:%s 张飞%s经理 身兼一职的人有:%s 经理和技术员共有:%d个人 ''' % ( s & s1, s - s1, s1 - s, x, s ^ s1, len(s | s1))) 3. 写一个函数myadd, 此函数中的参数列表里有两个参数x, y 此函数的功能是打印 x + y 的和 def myadd(....): .... # 注: .... 部是是我们要填写代码的地方 myadd(100, 200) # 300 print("ABC", "123") # ABC123 4. 写一个函数 mysum, 传入一个参数x代表终止整数, 打印出 1 + 2 + 3 + 4 + ..... + x的和 def mysum(x): .... mysum(100) # 5050 mysum(4) # 10 答案: def mysum(x): s = 0 for i in range(1, x + 1): s += i print(s) mysum(100) mysum(4) 5. 写一个函数 mymax, 给函数传递两个参数,返回两个实参中最大的一个 def mymax(a, b): .... v = mymax(100, 200) print('v =', v) # v = 200 print(mymax('ABC', 'abc')) # abc 答案: def mymax(a, b): if a > b: return a return b x = mymax(100, 200) print(x) 6. 写一个函数 input_number def input_number(): .... 此函数用来获取用户循环输入的整数,当用户输入负数时结束输入。将用户输入的数字以列表的形式返回,再用内建函数max, min, sum取出户输入的最大值,最小值及和 L = input_number() print(L) # 打印此列表 print("用户输入的最大数是:", max(L)) print("用户输入的最小数是:", min(L)) print("用户输入的数的和是:", sum(L)) 答案: def inout_number(): L = [] while True: number = int(input("please inoput (-1:over):")) if number < 0: break L.append(number) return L L = inout_number() print("Top1 ", max(L)) print("lower1 ", min(L)) print("sum ", sum(L)) 7. 写一个函数 print_odd, 打印从begin开始,到end结束(不包含end)内的全部的奇数 def print_odd(begin, end): .... print_odd(1, 10) # 打印 1 3 5 7 9d ptint_odd(10, 20) # 打印 11 13 15 17 19 答案: def myodd(begin, end): for x in range(begin, end): if x % 2 != 0: print(x, end = " ") print() myodd(1, 10) myodd(10, 100) 9. 改写之前的学生信息管理程序 改为两个函数: 1. 写一个函数 input_student() 用于返回学生信息的字典的列表(以前格式一样) 2. 写一个函数 output_student(lst) 此函数传入一个列表lst,即字典的列表 此函数把lst的内容以表格形式打印出来 def input_student(): .... def output_student(lst): ... L = input_student() # 获取学生信息的列表 output_student(L) # 把L 以列表的形式打印 答案: # 创建输入函数:input_student开始 def input_student(): print("--------Student information enty--------") L = [] while True: name = input("please input name:") if name == "": break age = input("please input age:") score = input("please input score:") d = {} d = {"name": name, "age": age, "score": score} L.append(d) return L # 创建输入函数:input_student完成 # 创建输出函数:output_student开始 def output_student(lst): print("-------Student information sheet-------") print("+---------------+----------+----------+") print("| name | age | score |") print("+---------------+----------+----------+") for d in lst: name = d["name"].center(15) age = d["age"].center(10) score = d["score"].center(10) print('''|%s|%s|%s|''' % (name, age, score)) print("+---------------+----------+----------+") # 创建输出函数:output_student完成 output_student(input_student())

优秀的个人博客,低调大师

Python全栈工程师(元组、字典)

ParisGabriel 感谢 大家的支持 你们的阅读评价就是我最好的更新动力 我会坚持吧排版做的越来越好 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 Python人工智能从入门到精通 函数:tyup(x) 用来返回x对应的数据类型 range(x) 返回可迭代对象sublime编辑器: 中文空格查找方法 空格中间没有小点 行首小黑点 语法不规范 大黑点语法错误 中文空格也会出错元组 tuple: 元组是不可变的序列,同list一样,元组可以存放任意数据类型的容器元组的表示方法: 用小括号()括起来,单个元素括起来后面加 “,”逗号区分单个对象还是元组 元组的小括号可以省略 但元素低于2个 “,” 不能省略元组的构造函数: tuple() 生成一个空元组,等同于() tuple(iterable) 用可迭代对象生成一个元组元组的运算: + += * *= < > <= >= == != in , not in 索引[ ], 切片[ : ] [ : : ] + 拼接元组 * 生成重复元组元祖的比较: 规则与列表规则完全相同 in , not in 规则与列表规则完全相同索引和切片: 索引取值和切片取值的规则与列表相同 元组不支持索引赋值和切片赋值(因为元组是不可变的序列)元组的方法: T.index(v[, begin[, end]]) 返回对应圆的索引下表 T.count(x) 返回对应元素个数序列相关函数:len(x)、max(x)、min(x)、sum(x)、any(x)、all(x) str(x) 创建字符串构造函数: (构造函数一定是他的类型名 返回对应类型) list(inerable) 创建列表 tuple(inerable) 创建元组 reversed(x) 返回反向顺序的可迭代对象 sorted(inerable,key = None,reverse = false) 返回已排列列表 inerable:可迭代对象 (key = None,reverse = false:后面将)例如: t = (4, 5, 8, 3, 2, 1) L = [x for x in reversed(t)] print(L) 容器小结: 字符串str # 不可变序列, 只能存字符 列表 list # 可变序列,可存任意数据 元组 tuple #不可变序列,可以存任意数据字典 dict: 1.字典是一种可变容器,可以储存任意类型数据 2.字典中的每个数据都是用“键”(key)进行索引 ,而不像序列可以用整数下标来进行索引 3.字典中的数据没有先后关系,字典的储存是无序的 4.字典的数据以键(key)- 值(value)对形式进行映射储存 5.字典的键不能重复,只能用不可变类型作为字典的键字典的字面值的表示方法: 字典的表示方式是以{ }括起来的,以冒号开头“:” 分隔键-值对,各键-值对之间用逗号分开创建字典: d = { } #空字典 d = { “Nemo”:“yang”,“age”: 35} #非空字典 键:“Nemo”值:“yang”(一个键值对) 键(只能用不可变类型) 值可以任意类型 字符串str 列表 list 元组 tuple 字典 dict 都是可以任意包含关系的 字典的构造函数dict: dict() 生成一个字的字典 等同于{ } dict(iterable) 用可迭代对象初始化一个字典 dict(** keargs) 用关键字传参形式创建字典 关键字传参:(dict(name = “tarena”,age = 15)) 索引:d [key ] 字典的key:不可变数据类型: bool,int,float,complex,str,tuple,frozeset,bytes可变数据类型有四种: list 列表 dict 字典 set 集合 bytearray 字节数组 字典的基本操作: 键索引 用 [ ] 运算符获取字典内“键”对应的值 也可以修改 字典[ 键 ] = 值 如果键不存在时,创建键,并绑定对应的值 当存在时,修改键绑定的值 del 字典 [ 键 ] (删除元素)字典的成员资格判断 in 运算符: 可以用 in 运算符判断一个键是否存在于字典中,如果存在则返回true 否则返回false not in 与 in 结果相反例如: d = {"name": "Gabriel", "age": 20} if "name" in d: print("name 在字典中 ") print(15 in d) # false 只判断键 不判断值 字典的迭代访问: 字典是可迭代对象,字典只能对键进行迭代访问例如: d = {"name":"tarena", age: 15} for x in d: print(x, d[ x ])内建函数:(内建:代表系统内直接有的函数) len(d) 返回的是键值对个数 max(d) 返回的是键最大值 min(d) 返回的是键最小值 sum(d) 返回的是键得和 any(d) 一个键为true则为true all(d)所有键为true 则为true字典的方法: 函数 说明 D代表字典对象 D.clear() 清空字典 D.pop(key) 移除键,同时返回此键所对应的值 D.copy() 返回字典D的副本,只复制一层(浅拷贝) D.update(D2) 将字典 D2 (合并)到D中,如果键相同,则此键的值取D2的值作为新值 D.get(key, default) 返回键key所对应的值,如果没有此键,则返回default D.keys() 返回可迭代的 dict_keys 集合对象(返回键) D.values() 返回可迭代的 dict_values 值对象(返回值) D.items() 返回可迭代的 dict_items 对象(返回键值对)字典推导式: 是用可迭代对象创建字典的表达式语法: {键表达式:值表达式 for 变量 in 可迭代对象 if 真值表达式} if子句可以省略 d = { x:x ** 2 for x in range(10)}字典VS列表: 1.都是可变对象 2.索引方式不同,列表用整数(下标)索引 ,字典用键(key)索引 3.字典的插入,删除,修改数据的速度可能会快于列表 4.列表的存储是有序的(内存中一般用排列算法),字典的储蓄是无序的(内存中一般用散列算法插入数据) 练习: 1.已知有两个等长的列表 list1 和 list2 以list1中的元素为键,以list2中的元素为值,生成相应的字典 list1 = [1001, 1002, 1003, 1004] list2 = ['Tom', 'Jerry', 'Spike', 'Tyke'] 答案: list1 = [1001, 1002, 1003, 1004] list2 = ['Tom', 'Jerry', 'Spike', 'Tyke'] d = {list1[x]: list2[x] for x in range(len(list1))} print(d) 2. 输入任意个学生的姓名,年龄,成绩,每个学生的信息存入字典中,然后放入至列表中,每个学生的信息需要手动输入 当输入姓名为空时结束输入: 如: 请输入姓名: xiaozhang 请输入年龄: 20 请输入成绩: 100 请输入姓名: xiaoli 请输入年龄: 18 请输入成绩: 98 请输入姓名: <回车> 结束输入 要求内部存储格式如下: [{'name':'xiaozhang', 'age':20, 'score':100}, {'name':'xiaoli', 'age':18, 'score':98}] 打印所有学生的信息如下: +---------------+----------+----------+ | name | age | score | +---------------+----------+----------+ | xiaozhang | 20 | 100 | | xiaoli | 18 | 98 | +---------------+----------+----------+ 答案: L = [] while True: n = input("请输入姓名:") if n == '': break a = int(input("请输入年龄:")) s = int(input("请输入成绩:")) d = {} d['name'] = n d['age'] = a d['score'] = s L.append(d) # print(L) print("+---------------+----------+----------+") print("| name | age | score |") print("+---------------+----------+----------+") for d in L: n = d['name'].center(15) a = str(d['age']) ac = a.center(10) s = str(d['score']) sc = s.center(10) line = "|%s|%s|%s|" % (n, ac, sc) print(line) print("+---------------+----------+----------+")

优秀的个人博客,低调大师

Python全栈工程师(列表、拷贝)

ParisGabriel 感谢 大家的支持 你们的阅读评价就是我最好的更新动力 我会坚持吧排版做的越来越好 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 Python人工智能从入门到精通 列表创建函数: list(可迭代对象)序列有5种: star 字符串 list 列表 tuple 元组 bytes 后面讲 bytearray 后面讲 序列运算符: in 、 not in > >= < <= + * 列表的索引可以增加、删除、修改、列表的元素值切片赋值: 步长不等于1时切片赋值,赋值运算符的右侧的可迭代对象提供的元素 的个数一定要等于切片切出的片数del语句: 用于删除列表的元素 del 列表 [索引] del 列表 [切片]Python3中常用的序列相关函数: len(x) 返回序列的长度 max (x) 返回最大元素 min(x) 返回序列最小元素 sum(x) 返回序列中所有原素的和 any(x) 真值测试,如果列表中有一个值为真返回true all(x) 真值测试,如果列表中所有值为真返回true 列表的方法(method):help(list) [ ]内的参数代表可以省略 方法 意义L.index(v [, begin[, end]]) 返回对应元素的索引下标, begin:为开始索引,end:为结束索引,当 value 不存在时触发ValueError错误L.insert(index, obj) 将某个元素插放到列表中指定的位置 index:索引 obj:要插入的元素L.count(x) 返回列表中元素的个数 x:元素L.remove(x) 从列表中删除第一次出现在列表中的值 x:元素(例如列表内有2个3 删除第一个 依次进行)L.copy() 复制此列表(只复制一层,不会复制深层对象)L.append(x) 向列表中追加单个元素 可以追加可迭代对象元素L.extend(list) 向列表追加另一个列表 L.clear() 清空列表,等同于 L[:] = []L.sort(reverse=False) 将列表中的元素进行排序,默认顺序按值的小到大的顺序排列L.reverse() 列表的反转,用来改变原列表的先后顺序L.pop([index]) 删除索引对应的元素,如果不加索引,默认删除最后元素,同时返回删除元素的引用关系(相当于取出元素不归还,可以用变量来接受)字符串的文本解析方法:S.split(sep=None) 将字符串使用sep作为分隔符分割字符串,返回分隔后的字符串列表,当不给定参数时,用空白字符作为分隔符分隔S.join(iterable) 用可迭代对象中的字符串,返回一个中间用S分隔组合的字符串 S=esp 要插入分割链接的字符 iterable:可迭代对象 潜拷贝和深拷贝: 潜拷贝shallow copy: help(list.copy) 拷贝指在复制过程中,只复制一层变量,不会复制深成变量绑定的对象的复制过程 例如: >>> L = [3.1,3.2] >>> L1 = [1, 2, L] >>> L2 = L1.copy() >>> L1 [1, 2, [3.1, 3.2]] >>> L2 [1, 2, [3.1, 3.2]] >>> L2[2][0] = 3.14 >>> L1 [1, 2, [3.14, 3.2]] >>> L2 [1, 2, [3.14, 3.2]] 深拷贝 deep copy: import copy # 导入copy 模块 例如: L = [3.1, 3.2] L1 = [1, 2, L] L2 = L1.deep copy() L2[2][0] = 3.14 print(L1) #[1, 2, [3.1, 3.2]] print(L2) #1, 2, [3.14, 3.2]] 深拷贝通常只对可变对象进行复制 ,不可变对象通常不会复制(这里深拷贝需要 import copy中的deepcopy 后面讲) 小结: L1 = [1, 2, [3.1, 3.2]] 这里只是纯粹的调用关系 可以通过内存地址查看 L2 = L1 # 不拷贝 同时绑定一个对象 L3 = L1.copy() # 潜拷贝等同于 L3 = L1[:] import copy L4 = copy.deepcopy(L1) #深拷贝 列表推导式 list comprehension: 列表推导式是用可迭代对象生成列表的表达式语法: [表达式 for 变量 in 可迭代对象] 或 [表达式 for 变量 in 可迭代对象 if 真值表达式] 说明: for in 表达式的 if 子句可以省略,省略后将对所有生成的对象进行求值处理 如:生成1~9的平方的列表 L= [x ** 2 for x in range(1,10)]列表推到式的嵌套:语法:L=[表达式 for 变量1 in 可迭代对象1 if 真值表达式1 for 变量2 in 可迭代对象2 if 真值表达式2 ] OK 今天的练习比较多 但是都很简单 争取把每个题都要理解他的原理 不懂得对照上面的参数进行核对一下就可以 想要入门IT就必须多写多练 写的代码也多 你就越熟练 越熟练经验越多 尝试不同的思路去分析 什么时候写的想吐 什么时候才算会了 我们一起加油 练习: 1. 已知有列表: L = [3, 5] 1) 用索引和切片等操作,将原列表改变为: L = [1, 2, 3, 4, 5, 6] 2) 将列表反转,删除最后一个元素后打印此列表 ... print(L) # [6, 5, 4, 3, 2] 答案: L = [3, 5] L[:] = range(1, 7) L[::-1] = range(1, 7)# L[:] = [range(6, 0, -1)] del L[-1] print(L) 2. 1. 写程序,让用户输入一些整数,当输入-1时结束输入,将这些数存于列表L中 1) 打印用户共输入了几个数? 2) 打印您输入的数的最大数是多少 3) 打印您输入的数的最小数是多少 4) 打印您输入的这些数的平均值是多少? 答案: L = [] while True: a = int(input("please input at will integer (input '-1' over):")) if a < 0: break L.append(a) L.sort() print("you input line number", len(L)) print("top1:", L[-1]) print("lower1:", L[0]) print(" average number :", sum(L) / len(L)) 3. 1.已知有一个字符串s = “100, 200, 300, 500, 800”将其转换为整数的列表存于L列表中 答案: s = "100,200,300,500,800" L = s.split(",") print(L) 2.生成前40个婓波那契数(fibonacci)1 1 2 3 5 8 13 .....要求将这些数字保存在列表中打印这些数 答案: L = [1, 1] a = 1 b = 1 while True: a += b b += a L += [a, b] if len(L) > 38: break print(L) 方法二 L = [1, 1] a = 1 b = 0 i = 0 while i < 40: a = a + b b = a - b L.append(b) i += 1 print(L) 4. L= [1, 3, 2, 1, 6, 4, 2, ......98, 82]将列表中出现的重复数字存入另一个列表L2中要求:重复出现多次的数字在L2中只保留一份 (去重) 答案: L = [] while True: a = int(input("please input at will integer (input '-1' over):")) if a < 0: break L.append(a) L2 = [] for x in L: if x not in L2: L2.append(x) print(L) print(L2) 5. 输入多行文字,存入列表中, 每次输入回车后算一行 任意输入多行,当输入回车(即输入空行时结束输入) 1) 按原输入内容在屏幕上输出内容 2) 打印出您共输入了多少行文字 3) 打印出您共输入了多少个字符 答案; L = [] i = 0 while True: a = input("please input at will string direct Enter over:") if a == "": break i += len(a) L.append(a) for x in L: print(x) print("您共输入的行数:", len(L)) print("您共输入的字符:", i) 6. 1. 有字符串"hello" 请用此字符串生成: 'h e l l o' 和 'h-e-l-l-o' 2. 写一个程序,让用户输入很多正整数,当输入小于零的数时结束输入, 1) 打印这些数中最大的一个数 2) 打印这些数中第二大的一个数 3) 删除最小的一个数 4) 打印剩余数的和 答案: s = "heool" L = " ".join(s) print(L) L = "-".join(s) print(L) 7. 用列表推导式生成1~100内奇数的列表 结果是: [1, 3, 5, 7, ..... 99] 答案: L = [x for x in range(1, 100, 2)] print(L) L = [x for x in range(1, 100) if x % 2 != 0] print(L) 8. 生成一个数值为 1 ~ 9的平方的列表,去掉所有的奇数的平方答案: L = [x**2 for x in range(2, 10, 2)] print(L) L = [x**2 for x in range(2, 10) if x % 2 == 0] print(L) Python人工智能从入门到精通 加油!

优秀的个人博客,低调大师

非常全的Linux常用命令

最近都在和Linux打交道,感觉还不错。我觉得Linux相比windows比较麻烦的就是很多东西都要用命令来控制,当然,这也是很多人喜欢linux的原因,比较短小但却功能强大。我将我了解到的命令列举一下,仅供大家参考: 系统信息 arch 显示机器的处理器架构(1) uname -m 显示机器的处理器架构(2) uname -r 显示正在使用的内核版本 dmidecode -q 显示硬件系统部件 - (SMBIOS / DMI) hdparm -i /dev/hda 罗列一个磁盘的架构特性 hdparm -tT /dev/sda 在磁盘上执行测试性读取操作 cat /proc/cpuinfo 显示CPU info的信息 cat /proc/interrupts 显示中断 cat /proc/meminfo 校验内存使用 cat /proc/swaps 显示哪些swap被使用 cat /proc/version 显示内核的版本 cat /proc/net/dev 显示网络适配器及统计 cat /proc/mounts 显示已加载的文件系统 lspci -tv 罗列 PCI 设备 lsusb -tv 显示 USB 设备 date 显示系统日期 cal 2007 显示2007年的日历表 date 041217002007.00 设置日期和时间 - 月日时分年.秒 clock -w 将时间修改保存到 BIOS 关机 (系统的关机、重启以及登出 ) shutdown -h now 关闭系统(1) init 0 关闭系统(2) telinit 0 关闭系统(3) shutdown -h hours:minutes & 按预定时间关闭系统 shutdown -c 取消按预定时间关闭系统 shutdown -r now 重启(1) reboot 重启(2) logout 注销 文件和目录 cd /home 进入 '/ home' 目录' cd .. 返回上一级目录 cd ../.. 返回上两级目录 cd 进入个人的主目录 cd ~user1 进入个人的主目录 cd - 返回上次所在的目录 pwd 显示工作路径 ls 查看目录中的文件 ls -F 查看目录中的文件 ls -l 显示文件和目录的详细资料 ls -a 显示隐藏文件 ls *[0-9]* 显示包含数字的文件名和目录名 tree 显示文件和目录由根目录开始的树形结构(1) lstree 显示文件和目录由根目录开始的树形结构(2) mkdir dir1 创建一个叫做 'dir1' 的目录' mkdir dir1 dir2 同时创建两个目录 mkdir -p /tmp/dir1/dir2 创建一个目录树 rm -f file1 删除一个叫做 'file1' 的文件' rmdir dir1 删除一个叫做 'dir1' 的目录' rm -rf dir1 删除一个叫做 'dir1' 的目录并同时删除其内容 rm -rf dir1 dir2 同时删除两个目录及它们的内容 mv dir1 new_dir 重命名/移动 一个目录 cp file1 file2 复制一个文件 cp dir/* . 复制一个目录下的所有文件到当前工作目录 cp -a /tmp/dir1 . 复制一个目录到当前工作目录 cp -a dir1 dir2 复制一个目录 ln -s file1 lnk1 创建一个指向文件或目录的软链接 ln file1 lnk1 创建一个指向文件或目录的物理链接 touch -t 0712250000 file1 修改一个文件或目录的时间戳 - (YYMMDDhhmm) file file1 outputs the mime type of the file as text iconv -l 列出已知的编码 iconv -f fromEncoding -t toEncoding inputFile > outputFile creates a new from the given input file by assuming it is encoded in fromEncoding and converting it to toEncoding. find . -maxdepth 1 -name *.jpg -print -exec convert "{}" -resize 80x60 "thumbs/{}" \; batch resize files in the current directory and send them to a thumbnails directory (requires convert from Imagemagick) 文件搜索 find / -name file1 从 '/' 开始进入根文件系统搜索文件和目录 find / -user user1 搜索属于用户 'user1' 的文件和目录 find /home/user1 -name \*.bin 在目录 '/ home/user1' 中搜索带有'.bin' 结尾的文件 find /usr/bin -type f -atime +100 搜索在过去100天内未被使用过的执行文件 find /usr/bin -type f -mtime -10 搜索在10天内被创建或者修改过的文件 find / -name \*.rpm -exec chmod 755 '{}' \; 搜索以 '.rpm' 结尾的文件并定义其权限 find / -xdev -name \*.rpm 搜索以 '.rpm' 结尾的文件,忽略光驱、捷盘等可移动设备 locate \*.ps 寻找以 '.ps' 结尾的文件 - 先运行 'updatedb' 命令 whereis halt 显示一个二进制文件、源码或man的位置 which halt 显示一个二进制文件或可执行文件的完整路径 挂载一个文件系统 mount /dev/hda2 /mnt/hda2 挂载一个叫做hda2的盘 - 确定目录 '/ mnt/hda2' 已经存在 umount /dev/hda2 卸载一个叫做hda2的盘 - 先从挂载点 '/ mnt/hda2' 退出 fuser -km /mnt/hda2 当设备繁忙时强制卸载 umount -n /mnt/hda2 运行卸载操作而不写入 /etc/mtab 文件- 当文件为只读或当磁盘写满时非常有用 mount /dev/fd0 /mnt/floppy 挂载一个软盘 mount /dev/cdrom /mnt/cdrom 挂载一个cdrom或dvdrom mount /dev/hdc /mnt/cdrecorder 挂载一个cdrw或dvdrom mount /dev/hdb /mnt/cdrecorder 挂载一个cdrw或dvdrom mount -o loop file.iso /mnt/cdrom 挂载一个文件或ISO镜像文件 mount -t vfat /dev/hda5 /mnt/hda5 挂载一个Windows FAT32文件系统 mount /dev/sda1 /mnt/usbdisk 挂载一个usb 捷盘或闪存设备 mount -t smbfs -o username=user,password=pass //WinClient/share /mnt/share 挂载一个windows网络共享 磁盘空间 df -h 显示已经挂载的分区列表 ls -lSr |more 以尺寸大小排列文件和目录 du -sh dir1 估算目录 'dir1' 已经使用的磁盘空间' du -sk * | sort -rn 以容量大小为依据依次显示文件和目录的大小 rpm -q -a --qf '%10{SIZE}t%{NAME}n' | sort -k1,1n 以大小为依据依次显示已安装的rpm包所使用的空间 (fedora, redhat类系统) dpkg-query -W -f='${Installed-Size;10}t${Package}n' | sort -k1,1n 以大小为依据显示已安装的deb包所使用的空间 (ubuntu, debian类系统) 用户和群组 groupadd group_name 创建一个新用户组 groupdel group_name 删除一个用户组 groupmod -n new_group_name old_group_name 重命名一个用户组 useradd -c "Name Surname " -g admin -d /home/user1 -s /bin/bash user1 创建一个属于 "admin" 用户组的用户 useradd user1 创建一个新用户 userdel -r user1 删除一个用户 ( '-r' 排除主目录) usermod -c "User FTP" -g system -d /ftp/user1 -s /bin/nologin user1 修改用户属性 passwd 修改口令 passwd user1 修改一个用户的口令 (只允许root执行) chage -E 2005-12-31 user1 设置用户口令的失效期限 pwck 检查 '/etc/passwd' 的文件格式和语法修正以及存在的用户 grpck 检查 '/etc/passwd' 的文件格式和语法修正以及存在的群组 newgrp group_name 登陆进一个新的群组以改变新创建文件的预设群组 文件的权限 - 使用 "+" 设置权限,使用 "-" 用于取消 ls -lh 显示权限 ls /tmp | pr -T5 -W$COLUMNS 将终端划分成5栏显示 chmod ugo+rwx directory1 设置目录的所有人(u)、群组(g)以及其他人(o)以读(r )、写(w)和执行(x)的权限 chmod go-rwx directory1 删除群组(g)与其他人(o)对目录的读写执行权限 chown user1 file1 改变一个文件的所有人属性 chown -R user1 directory1 改变一个目录的所有人属性并同时改变改目录下所有文件的属性 chgrp group1 file1 改变文件的群组 chown user1:group1 file1 改变一个文件的所有人和群组属性 find / -perm -u+s 罗列一个系统中所有使用了SUID控制的文件 chmod u+s /bin/file1 设置一个二进制文件的 SUID 位 - 运行该文件的用户也被赋予和所有者同样的权限 chmod u-s /bin/file1 禁用一个二进制文件的 SUID位 chmod g+s /home/public 设置一个目录的SGID 位 - 类似SUID ,不过这是针对目录的 chmod g-s /home/public 禁用一个目录的 SGID 位 chmod o+t /home/public 设置一个文件的 STIKY 位 - 只允许合法所有人删除文件 chmod o-t /home/public 禁用一个目录的 STIKY 位 文件的特殊属性 - 使用 "+" 设置权限,使用 "-" 用于取消 chattr +a file1 只允许以追加方式读写文件 chattr +c file1 允许这个文件能被内核自动压缩/解压 chattr +d file1 在进行文件系统备份时,dump程序将忽略这个文件 chattr +i file1 设置成不可变的文件,不能被删除、修改、重命名或者链接 chattr +s file1 允许一个文件被安全地删除 chattr +S file1 一旦应用程序对这个文件执行了写操作,使系统立刻把修改的结果写到磁盘 chattr +u file1 若文件被删除,系统会允许你在以后恢复这个被删除的文件 lsattr 显示特殊的属性 打包和压缩文件 bunzip2 file1.bz2 解压一个叫做 'file1.bz2'的文件 bzip2 file1 压缩一个叫做 'file1' 的文件 gunzip file1.gz 解压一个叫做 'file1.gz'的文件 gzip file1 压缩一个叫做 'file1'的文件 gzip -9 file1 最大程度压缩 rar a file1.rar test_file 创建一个叫做 'file1.rar' 的包 rar a file1.rar file1 file2 dir1 同时压缩 'file1', 'file2' 以及目录 'dir1' rar x file1.rar 解压rar包 unrar x file1.rar 解压rar包 tar -cvf archive.tar file1 创建一个非压缩的 tarball tar -cvf archive.tar file1 file2 dir1 创建一个包含了 'file1', 'file2' 以及 'dir1'的档案文件 tar -tf archive.tar 显示一个包中的内容 tar -xvf archive.tar 释放一个包 tar -xvf archive.tar -C /tmp 将压缩包释放到 /tmp目录下 tar -cvfj archive.tar.bz2 dir1 创建一个bzip2格式的压缩包 tar -xvfj archive.tar.bz2 解压一个bzip2格式的压缩包 tar -cvfz archive.tar.gz dir1 创建一个gzip格式的压缩包 tar -xvfz archive.tar.gz 解压一个gzip格式的压缩包 zip file1.zip file1 创建一个zip格式的压缩包 zip -r file1.zip file1 file2 dir1 将几个文件和目录同时压缩成一个zip格式的压缩包 unzip file1.zip 解压一个zip格式压缩包 RPM 包 - (Fedora, Redhat及类似系统) rpm -ivh package.rpm 安装一个rpm包 rpm -ivh --nodeeps package.rpm 安装一个rpm包而忽略依赖关系警告 rpm -U package.rpm 更新一个rpm包但不改变其配置文件 rpm -F package.rpm 更新一个确定已经安装的rpm包 rpm -e package_name.rpm 删除一个rpm包 rpm -qa 显示系统中所有已经安装的rpm包 rpm -qa | grep httpd 显示所有名称中包含 "httpd" 字样的rpm包 rpm -qi package_name 获取一个已安装包的特殊信息 rpm -qg "System Environment/Daemons" 显示一个组件的rpm包 rpm -ql package_name 显示一个已经安装的rpm包提供的文件列表 rpm -qc package_name 显示一个已经安装的rpm包提供的配置文件列表 rpm -q package_name --whatrequires 显示与一个rpm包存在依赖关系的列表 rpm -q package_name --whatprovides 显示一个rpm包所占的体积 rpm -q package_name --scripts 显示在安装/删除期间所执行的脚本l rpm -q package_name --changelog 显示一个rpm包的修改历史 rpm -qf /etc/httpd/conf/httpd.conf 确认所给的文件由哪个rpm包所提供 rpm -qp package.rpm -l 显示由一个尚未安装的rpm包提供的文件列表 rpm --import /media/cdrom/RPM-GPG-KEY 导入公钥数字证书 rpm --checksig package.rpm 确认一个rpm包的完整性 rpm -qa gpg-pubkey 确认已安装的所有rpm包的完整性 rpm -V package_name 检查文件尺寸、 许可、类型、所有者、群组、MD5检查以及最后修改时间 rpm -Va 检查系统中所有已安装的rpm包- 小心使用 rpm -Vp package.rpm 确认一个rpm包还未安装 rpm2cpio package.rpm | cpio --extract --make-directories *bin* 从一个rpm包运行可执行文件 rpm -ivh /usr/src/redhat/RPMS/`arch`/package.rpm 从一个rpm源码安装一个构建好的包 rpmbuild --rebuild package_name.src.rpm 从一个rpm源码构建一个 rpm 包 YUM 软件包升级器 - (Fedora, RedHat及类似系统) yum install package_name 下载并安装一个rpm包 yum localinstall package_name.rpm 将安装一个rpm包,使用你自己的软件仓库为你解决所有依赖关系 yum update package_name.rpm 更新当前系统中所有安装的rpm包 yum update package_name 更新一个rpm包 yum remove package_name 删除一个rpm包 yum list 列出当前系统中安装的所有包 yum search package_name 在rpm仓库中搜寻软件包 yum clean packages 清理rpm缓存删除下载的包 yum clean headers 删除所有头文件 yum clean all 删除所有缓存的包和头文件 DEB 包 (Debian, Ubuntu 以及类似系统) dpkg -i package.deb 安装/更新一个 deb 包 dpkg -r package_name 从系统删除一个 deb 包 dpkg -l 显示系统中所有已经安装的 deb 包 dpkg -l | grep httpd 显示所有名称中包含 "httpd" 字样的deb包 dpkg -s package_name 获得已经安装在系统中一个特殊包的信息 dpkg -L package_name 显示系统中已经安装的一个deb包所提供的文件列表 dpkg --contents package.deb 显示尚未安装的一个包所提供的文件列表 dpkg -S /bin/ping 确认所给的文件由哪个deb包提供 APT 软件工具 (Debian, Ubuntu 以及类似系统) apt-get install package_name 安装/更新一个 deb 包 apt-cdrom install package_name 从光盘安装/更新一个 deb 包 apt-get update 升级列表中的软件包 apt-get upgrade 升级所有已安装的软件 apt-get remove package_name 从系统删除一个deb包 apt-get check 确认依赖的软件仓库正确 apt-get clean 从下载的软件包中清理缓存 apt-cache search searched-package 返回包含所要搜索字符串的软件包名称 查看文件内容 cat file1 从第一个字节开始正向查看文件的内容 tac file1 从最后一行开始反向查看一个文件的内容 more file1 查看一个长文件的内容 less file1 类似于 'more' 命令,但是它允许在文件中和正向操作一样的反向操作 head -2 file1 查看一个文件的前两行 tail -2 file1 查看一个文件的最后两行 tail -f /var/log/messages 实时查看被添加到一个文件中的内容 文本处理 cat file1 file2 ... | command <> file1_in.txt_or_file1_out.txt general syntax for text manipulation using PIPE, STDIN and STDOUT cat file1 | command( sed, grep, awk, grep, etc...) > result.txt 合并一个文件的详细说明文本,并将简介写入一个新文件中 cat file1 | command( sed, grep, awk, grep, etc...) >> result.txt 合并一个文件的详细说明文本,并将简介写入一个已有的文件中 grep Aug /var/log/messages 在文件 '/var/log/messages'中查找关键词"Aug" grep ^Aug /var/log/messages 在文件 '/var/log/messages'中查找以"Aug"开始的词汇 grep [0-9] /var/log/messages 选择 '/var/log/messages' 文件中所有包含数字的行 grep Aug -R /var/log/* 在目录 '/var/log' 及随后的目录中搜索字符串"Aug" sed 's/stringa1/stringa2/g' example.txt 将example.txt文件中的 "string1" 替换成 "string2" sed '/^$/d' example.txt 从example.txt文件中删除所有空白行 sed '/ *#/d; /^$/d' example.txt 从example.txt文件中删除所有注释和空白行 echo 'esempio' | tr '[:lower:]' '[:upper:]' 合并上下单元格内容 sed -e '1d' result.txt 从文件example.txt 中排除第一行 sed -n '/stringa1/p' 查看只包含词汇 "string1"的行 sed -e 's/ *$//' example.txt 删除每一行最后的空白字符 sed -e 's/stringa1//g' example.txt 从文档中只删除词汇 "string1" 并保留剩余全部 sed -n '1,5p;5q' example.txt 查看从第一行到第5行内容 sed -n '5p;5q' example.txt 查看第5行 sed -e 's/00*/0/g' example.txt 用单个零替换多个零 cat -n file1 标示文件的行数 cat example.txt | awk 'NR%2==1' 删除example.txt文件中的所有偶数行 echo a b c | awk '{print $1}' 查看一行第一栏 echo a b c | awk '{print $1,$3}' 查看一行的第一和第三栏 paste file1 file2 合并两个文件或两栏的内容 paste -d '+' file1 file2 合并两个文件或两栏的内容,中间用"+"区分 sort file1 file2 排序两个文件的内容 sort file1 file2 | uniq 取出两个文件的并集(重复的行只保留一份) sort file1 file2 | uniq -u 删除交集,留下其他的行 sort file1 file2 | uniq -d 取出两个文件的交集(只留下同时存在于两个文件中的文件) comm -1 file1 file2 比较两个文件的内容只删除 'file1' 所包含的内容 comm -2 file1 file2 比较两个文件的内容只删除 'file2' 所包含的内容 comm -3 file1 file2 比较两个文件的内容只删除两个文件共有的部分 字符设置和文件格式转换 dos2unix filedos.txt fileunix.txt 将一个文本文件的格式从MSDOS转换成UNIX unix2dos fileunix.txt filedos.txt 将一个文本文件的格式从UNIX转换成MSDOS recode ..HTML < page.txt > page.html 将一个文本文件转换成html recode -l | more 显示所有允许的转换格式 文件系统分析 badblocks -v /dev/hda1 检查磁盘hda1上的坏磁块 fsck /dev/hda1 修复/检查hda1磁盘上linux文件系统的完整性 fsck.ext2 /dev/hda1 修复/检查hda1磁盘上ext2文件系统的完整性 e2fsck /dev/hda1 修复/检查hda1磁盘上ext2文件系统的完整性 e2fsck -j /dev/hda1 修复/检查hda1磁盘上ext3文件系统的完整性 fsck.ext3 /dev/hda1 修复/检查hda1磁盘上ext3文件系统的完整性 fsck.vfat /dev/hda1 修复/检查hda1磁盘上fat文件系统的完整性 fsck.msdos /dev/hda1 修复/检查hda1磁盘上dos文件系统的完整性 dosfsck /dev/hda1 修复/检查hda1磁盘上dos文件系统的完整性 初始化一个文件系统 mkfs /dev/hda1 在hda1分区创建一个文件系统 mke2fs /dev/hda1 在hda1分区创建一个linux ext2的文件系统 mke2fs -j /dev/hda1 在hda1分区创建一个linux ext3(日志型)的文件系统 mkfs -t vfat 32 -F /dev/hda1 创建一个 FAT32 文件系统 fdformat -n /dev/fd0 格式化一个软盘 mkswap /dev/hda3 创建一个swap文件系统 SWAP文件系统 mkswap /dev/hda3 创建一个swap文件系统 swapon /dev/hda3 启用一个新的swap文件系统 swapon /dev/hda2 /dev/hdb3 启用两个swap分区 备份 dump -0aj -f /tmp/home0.bak /home 制作一个 '/home' 目录的完整备份 dump -1aj -f /tmp/home0.bak /home 制作一个 '/home' 目录的交互式备份 restore -if /tmp/home0.bak 还原一个交互式备份 rsync -rogpav --delete /home /tmp 同步两边的目录 rsync -rogpav -e ssh --delete /home ip_address:/tmp 通过SSH通道rsync rsync -az -e ssh --delete ip_addr:/home/public /home/local 通过ssh和压缩将一个远程目录同步到本地目录 rsync -az -e ssh --delete /home/local ip_addr:/home/public 通过ssh和压缩将本地目录同步到远程目录 dd bs=1M if=/dev/hda | gzip | ssh user@ip_addr 'dd of=hda.gz' 通过ssh在远程主机上执行一次备份本地磁盘的操作 dd if=/dev/sda of=/tmp/file1 备份磁盘内容到一个文件 tar -Puf backup.tar /home/user 执行一次对 '/home/user' 目录的交互式备份操作 ( cd /tmp/local/ && tar c . ) | ssh -C user@ip_addr 'cd /home/share/ && tar x -p' 通过ssh在远程目录中复制一个目录内容 ( tar c /home ) | ssh -C user@ip_addr 'cd /home/backup-home && tar x -p' 通过ssh在远程目录中复制一个本地目录 tar cf - . | (cd /tmp/backup ; tar xf - ) 本地将一个目录复制到另一个地方,保留原有权限及链接 find /home/user1 -name '*.txt' | xargs cp -av --target-directory=/home/backup/ --parents 从一个目录查找并复制所有以 '.txt' 结尾的文件到另一个目录 find /var/log -name '*.log' | tar cv --files-from=- | bzip2 > log.tar.bz2 查找所有以 '.log' 结尾的文件并做成一个bzip包 dd if=/dev/hda of=/dev/fd0 bs=512 count=1 做一个将 MBR (Master Boot Record)内容复制到软盘的动作 dd if=/dev/fd0 of=/dev/hda bs=512 count=1 从已经保存到软盘的备份中恢复MBR内容 光盘 cdrecord -v gracetime=2 dev=/dev/cdrom -eject blank=fast -force 清空一个可复写的光盘内容 mkisofs /dev/cdrom > cd.iso 在磁盘上创建一个光盘的iso镜像文件 mkisofs /dev/cdrom | gzip > cd_iso.gz 在磁盘上创建一个压缩了的光盘iso镜像文件 mkisofs -J -allow-leading-dots -R -V "Label CD" -iso-level 4 -o ./cd.iso data_cd 创建一个目录的iso镜像文件 cdrecord -v dev=/dev/cdrom cd.iso 刻录一个ISO镜像文件 gzip -dc cd_iso.gz | cdrecord dev=/dev/cdrom - 刻录一个压缩了的ISO镜像文件 mount -o loop cd.iso /mnt/iso 挂载一个ISO镜像文件 cd-paranoia -B 从一个CD光盘转录音轨到 wav 文件中 cd-paranoia -- "-3" 从一个CD光盘转录音轨到 wav 文件中(参数-3) cdrecord --scanbus 扫描总线以识别scsi通道 dd if=/dev/hdc | md5sum 校验一个设备的md5sum编码,例如一张 CD 网络 - (以太网和WIFI无线) ifconfig eth0 显示一个以太网卡的配置 ifup eth0 启用一个 'eth0' 网络设备 ifdown eth0 禁用一个 'eth0' 网络设备 ifconfig eth0 192.168.1.1 netmask 255.255.255.0 控制IP地址 ifconfig eth0 promisc 设置 'eth0' 成混杂模式以嗅探数据包 (sniffing) dhclient eth0 以dhcp模式启用 'eth0' route -n show routing table route add -net 0/0 gw IP_Gateway configura default gateway route add -net 192.168.0.0 netmask 255.255.0.0 gw 192.168.1.1 configure static route to reach network '192.168.0.0/16' route del 0/0 gw IP_gateway remove static route echo "1" > /proc/sys/net/ipv4/ip_forward activate ip routing hostname show hostname of system host www.example.com lookup hostname to resolve name to ip address and viceversa(1) nslookup www.example.com lookup hostname to resolve name to ip address and viceversa(2) ip link show show link status of all interfaces mii-tool eth0 show link status of 'eth0' ethtool eth0 show statistics of network card 'eth0' netstat -tup show all active network connections and their PID netstat -tupl show all network services listening on the system and their PID tcpdump tcp port 80 show all HTTP traffic iwlist scan show wireless networks iwconfig eth1 show configuration of a wireless network card hostname show hostname host www.example.com lookup hostname to resolve name to ip address and viceversa nslookup www.example.com lookup hostname to resolve name to ip address and viceversa whois www.example.com lookup on Whois database JPS工具 jps(Java Virtual Machine Process Status Tool)是JDK 1.5提供的一个显示当前所有java进程pid的命令,简单实用,非常适合在linux/unix平台上简单察看当前java进程的一些简单情况。 我想很多人都是用过unix系统里的ps命令,这个命令主要是用来显示当前系统的进程情况,有哪些进程,及其 id。 jps 也是一样,它的作用是显示当前系统的java进程情况,及其id号。我们可以通过它来查看我们到底启动了几个java进程(因为每一个java程序都会独占一个java虚拟机实例),和他们的进程号(为下面几个程序做准备),并可通过opt来查看这些进程的详细启动参数。 使用方法:在当前命令行下打 jps(需要JAVA_HOME,没有的话,到改程序的目录下打) 。 jps存放在JAVA_HOME/bin/jps,使用时为了方便请将JAVA_HOME/bin/加入到Path. $>jps 23991 Jps 23789 BossMain 23651 Resin 比较常用的参数: -q 只显示pid,不显示class名称,jar文件名和传递给main 方法的参数 $>jps -q 28680 23789 23651 -m 输出传递给main 方法的参数,在嵌入式jvm上可能是null $>jps -m 28715 Jps -m 23789 BossMain 23651 Resin -socketwait 32768 -stdout /data/aoxj/resin/log/stdout.log -stderr /data/aoxj/resin/log/stderr.log -l 输出应用程序main class的完整package名 或者 应用程序的jar文件完整路径名 $>jps -l 28729 sun.tools.jps.Jps 23789 com.asiainfo.aimc.bossbi.BossMain 23651 com.caucho.server.resin.Resin -v 输出传递给JVM的参数 $>jps -v 23789 BossMain 28802 Jps -Denv.class.path=/data/aoxj/bossbi/twsecurity/java/trustwork140.jar:/data/aoxj/bossbi/twsecurity/java/:/data/aoxj/bossbi/twsecurity/java/twcmcc.jar:/data/aoxj/jdk15/lib/rt.jar:/data/aoxj/jd k15/lib/tools.jar -Dapplication.home=/data/aoxj/jdk15 -Xms8m 23651 Resin -Xss1m -Dresin.home=/data/aoxj/resin -Dserver.root=/data/aoxj/resin -Djava.util.logging.manager=com.caucho.log.LogManagerImpl - Djavax.management.builder.initial=com.caucho.jmx.MBeanServerBuilderImpl sudo jps看到的进程数量最全 jps 192.168.0.77 列出远程服务器192.168.0.77机器所有的jvm实例,采用rmi协议,默认连接端口为1099 (前提是远程服务器提供jstatd服务) 注:jps命令有个地方很不好,似乎只能显示当前用户的java进程,要显示其他用户的还是只能用unix/linux的ps命令。 详细情况请参考sun官方文档。 http://java.sun.com/j2se/1.7.0/docs/tooldocs/share/jps.html GO TOP INDEX ^ Microsoft Windows networks (SAMBA) nbtscan ip_addr netbios name resolution nmblookup -A ip_addr netbios name resolution smbclient -L ip_addr/hostname show remote shares of a windows host smbget -Rr smb://ip_addr/share like wget can download files from a host windows via smb mount -t smbfs -o username=user,password=pass //WinClient/share /mnt/share mount a windows network share

优秀的个人博客,低调大师

前端常见跨域解决方案(全)

什么是跨域? 跨域是指一个域下的文档或脚本试图去请求另一个域下的资源,这里跨域是广义的。 广义的跨域: 1.) 资源跳转: A链接、重定向、表单提交 2.) 资源嵌入: <link>、<script>、<img>、 <frame>等dom标签, 还有样式中background:url()、 @font-face()等文件外链 3.) 脚本请求: js发起的ajax请求、dom和js对象的跨域操作等 其实我们通常所说的跨域是狭义的,是由浏览器同源策略限制的一类请求场景。 什么是同源策略? 同源策略/SOP(Same origin policy)是一种约定,由Netscape公司1995年引入浏览器,它是浏览器最核心也最基本的安全功能,如果缺少了同源策略,浏览器很容易受到XSS、CSFR等攻击。所谓同源是指"协议+域名+端口"三者相同,即便两个不同的域名指向同一个ip地址,也非同源。 同源策略限制以下几种行为: 1.) Cookie、LocalStorage 和 IndexDB 无法读取 2.) DOM 和 Js对象无法获得 3.) AJAX 请求不能发送 常见跨域场景 跨域解决方案 1、 通过jsonp跨域 2、 document.domain + iframe跨域 3、 location.hash + iframe 4、 window.name + iframe跨域 5、 postMessage跨域 6、 跨域资源共享(CORS) 7、 nginx代理跨域 8、 nodejs中间件代理跨域 9、 WebSocket协议跨域 一、 通过jsonp跨域 通常为了减轻web服务器的负载,我们把js、css,img等静态资源分离到另一台独立域名的服务器上,在html页面中再通过相应的标签从不同域名下加载静态资源,而被浏览器允许,基于此原理,我们可以通过动态创建script,再请求一个带参网址实现跨域通信。 1.)原生实现: <script> var script = document.createElement('script'); script.type = 'text/javascript'; // 传参并指定回调执行函数为onBack script.src = 'http://www.domain2.com:8080/ login?user=admin&callback=onBack'; document.head.appendChild(script); // 回调执行函数 function onBack(res) { alert(JSON.stringify(res)); } </script> 服务端返回如下(返回时即执行全局函数): onBack({"status":true,"user":"admin"}) 2.)jquery ajax: $.ajax({ url: 'http://www.domain2.com:8080/login', type: 'get', dataType: 'jsonp', // 请求方式为jsonp jsonpCallback: "onBack", // 自定义回调函数名 data: {} }); 3.)vue.js: this.$http.jsonp(' http://www.domain2.com:8080/login', { params: {}, jsonp: 'onBack'}).then((res) => { console.log(res); }) 后端node.js代码示例: var querystring = require('querystring'); var http = require('http'); var server = http.createServer(); server.on('request', function(req, res) { var params = qs.parse(req.url.split('?')[1]); var fn = params.callback; // jsonp返回设置 res.writeHead(200, { 'Content-Type': 'text/javascript' }); res.write(fn + '(' + JSON.stringify(params) + ')'); res.end(); }); server.listen('8080'); console.log('Server is running at port 8080...'); jsonp缺点:只能实现get一种请求。 二、 document.domain + iframe跨域 此方案仅限主域相同,子域不同的跨域应用场景。 实现原理:两个页面都通过js强制设置document.domain为基础主域,就实现了同域。 1.)父窗口:(http://www.domain.com/a.html) <iframe id="iframe" src="http://child.domain.com/b.html"> </iframe><script> document.domain = 'domain.com'; var user = 'admin';</script> 2.)子窗口:(http://child.domain.com/b.html) <script> document.domain = 'domain.com'; // 获取父窗口中变量 alert('get js data from parent ---> ' + window.parent.user); </script> 三、 location.hash + iframe跨域 实现原理: a欲与b跨域相互通信,通过中间页c来实现。 三个页面,不同域之间利用iframe的location.hash传值,相同域之间直接js访问来通信。 具体实现:A域:a.html -> B域:b.html -> A域:c.html,a与b不同域只能通过hash值单向通信,b与c也不同域也只能单向通信,但c与a同域,所以c可通过parent.parent访问a页面所有对象。 1.)a.html:(http://www.domain1.com/a.html) <iframe id="iframe" src="http://www.domain2.com/b.html" style="display:none;"> </iframe> <script> var iframe = document.getElementById('iframe'); // 向b.html传hash值 setTimeout(function() { iframe.src = iframe.src + '#user=admin'; }, 1000); // 开放给同域c.html的回调方法 function onCallback(res) { alert('data from c.html ---> ' + res); } </script> 2.)b.html:(http://www.domain2.com/b.html) <iframe id="iframe" src="http://www.domain1.com/c.html" style="display:none;"> </iframe> <script> var iframe = document.getElementById('iframe'); // 监听a.html传来的hash值,再传给c.html window.onhashchange = function () { iframe.src = iframe.src + location.hash; }; </script> 3.)c.html:(http://www.domain1.com/c.html) <script> // 监听b.html传来的hash值 window.onhashchange = function () { // 再通过操作同域a.html的js回调, 将结果传回 window.parent.parent.onCallback('hello: ' + location.hash.replace('#user=', '')); }; </script> 四、 window.name + iframe跨域 window.name属性的独特之处:name值在不同的页面(甚至不同域名)加载后依旧存在,并且可以支持非常长的 name 值(2MB)。 1.)a.html:(http://www.domain1.com/a.html) var proxy = function(url, callback) { var state = 0; var iframe = document.createElement('iframe'); // 加载跨域页面 iframe.src = url; // onload事件会触发2次, 第1次加载跨域页, 并留存数据于window.name iframe.onload = function() { if (state === 1) { // 第2次onload(同域proxy页)成功后, 读取同域window.name中数据 callback(iframe.contentWindow.name); destoryFrame(); } else if (state === 0) { // 第1次onload(跨域页)成功后, 切换到同域代理页面 iframe.contentWindow.location = 'http://www.domain1.com/proxy.html'; state = 1; } }; document.body.appendChild(iframe); // 获取数据以后销毁这个iframe, 释放内存; 这也保证了安全(不被其他域frame js访问) function destoryFrame() { iframe.contentWindow.document.write(''); iframe.contentWindow.close(); document.body.removeChild(iframe); } }; // 请求跨域b页面数据proxy ('http://www.domain2.com/b.html', function(data) { alert(data); }); 2.)proxy.html:(http://www.domain1.com/proxy.... 中间代理页,与a.html同域,内容为空即可。 3.)b.html:(http://www.domain2.com/b.html) <script> window.name = 'This is domain2 data!'; </script> 总结:通过iframe的src属性由外域转向本地域,跨域数据即由iframe的window.name从外域传递到本地域。这个就巧妙地绕过了浏览器的跨域访问限制,但同时它又是安全操作。 五、 postMessage跨域 postMessage是HTML5 XMLHttpRequest Level 2中的API,且是为数不多可以跨域操作的window属性之一,它可用于解决以下方面的问题: a.) 页面和其打开的新窗口的数据传递 b.) 多窗口之间消息传递 c.) 页面与嵌套的iframe消息传递 d.) 上面三个场景的跨域数据传递 用法:postMessage(data,origin)方法接受两个参数 data: html5规范支持任意基本类型或可复制的对象,但部分浏览器只支持字符串,所以传参时最好用JSON.stringify()序列化。 origin: 协议+主机+端口号,也可以设置为"*",表示可以传递给任意窗口,如果要指定和当前窗口同源的话设置为"/"。 1.)a.html:(http://www.domain1.com/a.html) <iframe id="iframe" src="http://www.domain2.com/b.html" style="display:none;"> </iframe> <script> var iframe = document.getElementById('iframe'); iframe.onload = function() { var data = { name: 'aym' }; // 向domain2传送跨域数据 iframe.contentWindow.postMessage (JSON.stringify(data), 'http://www.domain2.com'); }; // 接受domain2返回数据 window.addEventListener ('message', function(e) { alert('data from domain2 ---> ' + e.data); }, false); </script> 2.)b.html:(http://www.domain2.com/b.html) <script> // 接收domain1的数据 window.addEventListener ('message', function(e) { alert('data from domain1 ---> ' + e.data); var data = JSON.parse(e.data); if (data) { data.number = 16; // 处理后再发回domain1 window.parent.postMessage(JSON.stringify(data), 'http://www.domain1.com'); } }, false);</script> 六、 跨域资源共享(CORS) 普通跨域请求:只服务端设置Access-Control-Allow-Origin即可,前端无须设置,若要带cookie请求:前后端都需要设置。 需注意的是:由于同源策略的限制,所读取的cookie为跨域请求接口所在域的cookie,而非当前页。如果想实现当前页cookie的写入,可参考下文:七、nginx反向代理中设置proxy_cookie_domain 和 八、NodeJs中间件代理中cookieDomainRewrite参数的设置。 目前,所有浏览器都支持该功能(IE8+:IE8/9需要使用XDomainRequest对象来支持CORS)),CORS也已经成为主流的跨域解决方案。 1、 前端设置: 1.)原生ajax // 前端设置是否带cookiexhr.withCredentials = true; 示例代码: var xhr = new XMLHttpRequest(); // IE8/9需用 window.XDomainRequest兼容 // 前端设置是否带 cookiexhr.withCredentials = true; xhr.open('post', 'http://www.domain2.com:8080/login', true); xhr.setRequestHeader ('Content-Type', ' application/x-www-form-urlencoded'); xhr.send('user=admin'); xhr.onreadystatechange = function() { if (xhr.readyState == 4 && xhr.status == 200) { alert(xhr.responseText); } }; 2.)jQuery ajax $.ajax({ ... xhrFields: { withCredentials: true // 前端设置是否带cookie }, crossDomain: true, // 会让请求头中包含跨域的额外信息, 但不会含cookie ... }); 3.)vue框架 在vue-resource封装的ajax组件中加入以下代码: Vue.http.options.credentials =true 2、 服务端设置: 若后端设置成功,前端浏览器控制台则不会出现跨域报错信息,反之,说明没设成功。 1.)Java后台: /* * 导入包: import javax.servlet.http.HttpServletResponse; * 接口参数中定义: HttpServletResponse response */response.setHeader ("Access-Control-Allow-Origin", "http://www.domain1.com"); // 若有端口需写全(协议+域名+端口) response.setHeader ("Access-Control-Allow-Credentials", "true"); 2.)Nodejs后台示例: var http = require('http');var server = http.createServer();var qs = require('querystring'); server.on('request', function(req, res) { var postData = ''; // 数据块接收中 req.addListener('data', function(chunk) { postData += chunk; }); // 数据接收完毕 req.addListener('end', function() { postData = qs.parse(postData); // 跨域后台设置 res.writeHead(200, { 'Access-Control-Allow-Credentials': 'true', // 后端允许发送Cookie 'Access-Control-Allow-Origin': 'http://www.domain1.com', // 允许访问的域(协议+域名+端口) 'Set-Cookie': 'l=a123456;Path=/;Domain=www.domain2.com; HttpOnly' // HttpOnly:脚本无法读取cookie }); res.write(JSON.stringify(postData)); res.end(); }); }); server.listen('8080');console.log('Server is running at port 8080...'); 七、 nginx代理跨域 1、 nginx配置解决iconfont跨域 浏览器跨域访问js、css、img等常规静态资源被同源策略许可,但iconfont字体文件(eot|otf|ttf|woff|svg)例外,此时可在nginx的静态资源服务器中加入以下配置。 location / { add_header Access-Control-Allow-Origin *; } 2、 nginx反向代理接口跨域 跨域原理: 同源策略是浏览器的安全策略,不是HTTP协议的一部分。服务器端调用HTTP接口只是使用HTTP协议,不会执行JS脚本,不需要同源策略,也就不存在跨越问题。 实现思路:通过nginx配置一个代理服务器(域名与domain1相同,端口不同)做跳板机,反向代理访问domain2接口,并且可以顺便修改cookie中domain信息,方便当前域cookie写入,实现跨域登录。 nginx具体配置: #proxy服务器server { listen 81; server_name www.domain1.com; location / { proxy_pass http://www.domain2.com:8080; #反向代理 proxy_cookie_domain www.domain2.com www.domain1.com; #修改cookie里域名 index index.html index.htm; # 当用webpack-dev-server等中间件代理接口访问nignx时, 此时无浏览器参与, 故没有同源限制, 下面的跨域配置可不启用 add_header Access-Control-Allow-Origin http://www.domain1.com; #当前端只跨域不带cookie时, 可为* add_header Access-Control-Allow-Credentials true; } } 1.) 前端代码示例: var xhr = new XMLHttpRequest(); // 前端开关: 浏览器是否读写cookiexhr.withCredentials = true; // 访问nginx中的代理服务器 xhr.open('get', 'http://www.domain1.com:81/?user=admin', true); xhr.send(); 2.) Nodejs后台示例: var http = require('http'); var server = http.createServer(); var qs = require('querystring'); server.on('request', function(req, res) { var params = qs.parse(req.url.substring(2)); // 向前台写cookie res.writeHead(200, { 'Set-Cookie': 'l=a123456; Path=/;Domain=www.domain2.com;HttpOnly' // HttpOnly:脚本无法读取 }); res.write(JSON.stringify(params)); res.end(); }); server.listen('8080'); console.log('Server is running at port 8080...'); 八、 Nodejs中间件代理跨域 node中间件实现跨域代理,原理大致与nginx相同,都是通过启一个代理服务器,实现数据的转发,也可以通过设置cookieDomainRewrite参数修改响应头中cookie中域名,实现当前域的cookie写入,方便接口登录认证。 1、 非vue框架的跨域(2次跨域) 利用node + express + http-proxy-middleware搭建一个proxy服务器。 1.)前端代码示例: var xhr = new XMLHttpRequest(); // 前端开关: 浏览器是否读写cookiexhr.withCredentials = true; // 访问http-proxy-middleware代理服务器 xhr.open('get', ' http://www.domain1.com:3000/login? user=admin', true); xhr.send(); 2.)中间件服务器: var express = require('express'); var proxy = require('http-proxy-middleware'); var app = express(); app.use('/', proxy({ // 代理跨域目标接口 target: 'http://www.domain2.com:8080', changeOrigin: true, // 修改响应头信息,实现跨域并允许带cookie onProxyRes: function(proxyRes, req, res) { res.header('Access-Control-Allow-Origin', 'http://www.domain1.com'); res.header('Access-Control-Allow-Credentials', 'true'); }, // 修改响应信息中的cookie域名 cookieDomainRewrite: 'www.domain1.com' // 可以为false,表示不修改})); app.listen(3000);console.log(' Proxy server is listen at port 3000...'); 3.)Nodejs后台同(六:nginx) 2、 vue框架的跨域(1次跨域) 利用node + webpack + webpack-dev-server代理接口跨域。在开发环境下,由于vue渲染服务和接口代理服务都是webpack-dev-server同一个,所以页面与代理接口之间不再跨域,无须设置headers跨域信息了。 webpack.config.js部分配置: module.exports = { entry: {}, module: {}, ... devServer: { historyApiFallback: true, proxy: [{ context: '/login', target: 'http://www.domain2.com:8080', // 代理跨域目标接口 changeOrigin: true, secure: false, // 当代理某些https服务报错时用 cookieDomainRewrite: 'www.domain1.com' // 可以为false,表示不修改 }], noInfo: true } } 九、 WebSocket协议跨域 WebSocket protocol是HTML5一种新的协议。它实现了浏览器与服务器全双工通信,同时允许跨域通讯,是server push技术的一种很好的实现。 原生WebSocket API使用起来不太方便,我们使用Socket.io,它很好地封装了webSocket接口,提供了更简单、灵活的接口,也对不支持webSocket的浏览器提供了向下兼容。 1.)前端代码: <div>user input: <input type="text"> </div> <script src="./socket.io.js"> </script> <script>var socket = io(' http://www.domain2.com:8080'); // 连接成功处理 socket.on('connect', function() { // 监听服务端消息 socket.on('message', function(msg) { console.log('data from server: ---> ' + msg); }); // 监听服务端关闭 socket.on('disconnect', function() { console.log('Server socket has closed.'); }); }); document.getElementsByTagName('input') [0].onblur = function() { socket.send(this.value); }; </script> 2.)Nodejs socket后台: var http = require('http'); var socket = require('socket.io'); // 启http服务 var server = http.createServer(function(req, res) { res.writeHead(200, { 'Content-type': 'text/html' }); res.end(); }); server.listen('8080'); console.log('Server is running at port 8080...'); // 监听socket连接 socket.listen(server).on('connection', function(client) { // 接收信息 client.on('message', function(msg) { client.send('hello:' + msg); console.log('data from client: ---> ' + msg); }); // 断开处理 client.on('disconnect', function() { console.log('Client socket has closed.'); }); }); 完~ 本文作者:web前端开发V 本文发布时间:2018年03月07日 本文来自云栖社区合作伙伴 CSDN,了解相关信息可以关注csdn.net网站。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册