首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

Sermant运行流程学习笔记,速来抄作业

本文分享自华为云社区《Sermant 的整体流程学习梳理》,作者:用友汽车信息科技(上海)有限公司刘亚洲 Java研发工程师。 一、sermant架构 Sermant整体架构包括Sermant Agent、Sermant Backend、Sermant Injector、动态配置中心等组件。其中Sermant Agent是提供字节码增强基础能力及各类服务治理能力的核心组件,Sermant Backend、Sermant Injector、动态配置中心为Sermant提供其他能力的配套组件。 二、java agent和bytebuddy组合使用场景 比较典型的就是skywalking、sermant、arthas、mockito。如果说java agent开了一扇门,那么bytebuddy在开的这扇门中打开了一片新的天地。 三、Sermant的入口 前面我们说AgentLauncher是java agent的入口,为什么这么说呢? <manifestEntries> <Premain-Class>com.huaweicloud.sermant.premain.AgentLauncher</Premain-Class> <Agent-Class>com.huaweicloud.sermant.premain.AgentLauncher</Agent-Class> <Can-Redefine-Classes>true</Can-Redefine-Classes> <Can-Retransform-Classes>true</Can-Retransform-Classes> </manifestEntries> 答案可以从pom.xml中找到答案,这里可以看到基于Premain-Class和Agent-Class的两个类都指向了AgentLauncher这个类。因此我们可以非常确认的肯定它就是javaagent入口类。类似于java程序有一个main的执行入口,而java agent有一个自己的入口类premain。 因此可以看到它的入口执行main: /** * premain * * @param agentArgs premain启动时携带的参数 * @param instrumentation 本次启动使用的instrumentation */ public static void premain(String agentArgs, Instrumentation instrumentation) { launchAgent(agentArgs, instrumentation, false); } /** * agentmain * * @param agentArgs agentmain启动时携带的参数 * @param instrumentation 本次启动使用的instrumentation */ public static void agentmain(String agentArgs, Instrumentation instrumentation) { launchAgent(agentArgs, instrumentation, true); } 基于premain模式的和基于agent模式,区别在于是否为isDynamic。从这里我们可以看到这里提出了两个类值得我们去关注:AgentCoreEntrance、CommandProcessor,也即sermant这个项目的两个重点类。 更多需要了解的,可以参考byte-buddy这个开源项目。 四、入口方法执行的全流程 五、spi的加载过程 启动核心服务的过程是spi的加载过程,此时会初始化所有的服务。也即我们看到的所有服务会在此时会做一个启动的操作,同时还会启动事件: service.start(); collectServiceStartEvent(startServiceArray.toString()); 其实这个两个方法也做了很多事情。 启动服务做的事情: collectServiceStartEvent则调用netty客户端向netty服务端发送数据。到服务端后,服务端进行数据处理,其收集的信息提供给backend模块方便后台展示查看。 六、以标签路由为例PluginService中扩展插件初始化 除此之外,还有一批实现了BaseService接口的,也即PluginService扩展插件服务基类,以标签路由为例,可以看你的其初始化的整个过程。 七、install的过程 同时我们可以看到install对应的process方法也是执行它的方法: public ResettableClassFileTransformer install(Instrumentation instrumentation) { AgentBuilder builder = new Default().disableClassFormatChanges(); // 遍历actions for (BuilderAction action : actions) { builder = action.process(builder); } // 执行安装操作,此时交给bytebuddy return builder.installOn(instrumentation); } 从入参中的Instrumentation,我们往回看:ByteEnhanceManager.init(instrumentation) 这个方法里面定义了action的顺序。 public static void init(Instrumentation instrumentation) { instrumentationCache = instrumentation; builder = BufferedAgentBuilder.build(); // 初始化完成后,新增Action用于添加框架直接引入的字节码增强 enhanceForFramework(); } 执行下面的过程: 我们根据上面的添加顺序,来看初始化插件的顺序: public static void enhanceDynamicPlugin(Plugin plugin) { if (!plugin.isDynamic()) { return; } // 获取描述信息 List<PluginDescription> plugins = PluginCollector.getDescriptions(plugin); // 添加插件,然后执行安装操作 ResettableClassFileTransformer resettableClassFileTransformer = BufferedAgentBuilder.build() .addPlugins(plugins).install(instrumentationCache); plugin.setClassFileTransformer(resettableClassFileTransformer); } 从引用上看,PluginSystemEntrance.initialize(isDynamic)中引用了这个方法。 可以看到这里的添加插件,可以理解为自定义的插件。 从sermant官网,我们可以知道:定义自定义插件,需要实现PluginDeclarer这个接口。也即从这里可以看到也即自定义的插件: /** * 从插件收集器中获取所有插件声明器 * * @param classLoader 类加载器 * @return 插件声明器集 */ private static List<? extends PluginDeclarer> getDeclarers(ClassLoader classLoader) { final List<PluginDeclarer> declares = new ArrayList<>(); for (PluginDeclarer declarer : loadDeclarers(classLoader)) { if (declarer.isEnabled()) { declares.add(declarer); } } return declares; } 有了插件,就可以进行安装操作。 按照这个顺序,可以看到对应的action.process(builder)里面也执行了对应的构建方法。完成构建后,执行installOn方法。 完成安装工作后,根据安装前spi的增强实现,然后执行下游服务拦截增强,从而实现精准筛选工作。 八、以标签路由下游拦截处理为例 可以看到标签路由对应的几个代表性的Declarer: NopInstanceFilterDeclarer、LoadBalancerDeclarer、BaseLoadBalancerDeclarer、ServiceInstanceListSupplierDeclarer等。 对应的拦截器Interceptor: NopInstanceFilterInterceptor、LoadBalancerInterceptor、BaseLoadBalancerInterceptor、ServiceInstanceListSupplierInterceptor。 两者相互照应。 LaneServiceImpl和LoadBalancerServiceImpl是基于sermant框架的插件服务spi做的实现。 LaneServiceImpl和RouteRequestTagHandler是和路由能力相关的,LaneServiceImpl和LaneRequestTagHandler是和染色能力相关的。 RouteRequestTagHandler用来拦截并存储调用过程中的标签,FlowRouteHandler和TagRouteHandler是在路由选择下游实例时做的筛选过程。 下游拦截方法会经过BaseLoadBalancerInterceptor到loadBalancerService.getTargetInstances(serviceId, instances, requestData),最终到 HandlerChainEntry.INSTANCE.process(targetName, instances, requestData),基于责任链模式执行处理。目前主要有两种方式:FlowRouteHandler和TagRouteHandler。 这里面只是简单的介绍了整体的流程,具体细节的内容,还需要自己多实践。同时sermant大量使用了java agent的内容。 由于本人的局限性,有不妥的地方,还望批评指正! 参考: sermant官网: https://sermant.io/zh/ sermant开源地址:https://github.com/huaweicloud/Sermant byte-buddy开源地址:https://github.com/raphw/byte-buddy 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

Golang学习笔记--unsafe.Pointer和uintptr

如果你看go的源码,尤其是runtime的部分的源码,你一定经常会发现unsafe.Pointer和uintptr这两个函数,例如下面就是runtime里面的map源码实现里面的一个函数: func (b *bmap) overflow(t *maptype) *bmap { return *(**bmap)(add(unsafe.Pointer(b), uintptr(t.bucketsize)-sys.PtrSize)) } 那么这两个方法有什么用呢?下面我们来重点介绍一下。 Go中的指针及与指针对指针的操作主要有以下三种: 一普通的指针类型,例如var intptr *T,定义一个T类型指针变量。 二内置类型uintptr,本质是一个无符号的整型,它的长度是跟平台相关的,它的长度可以用来保存一个指针地址。 三是unsafe包提供的Pointer,表示可以指向任意类型的指针。 1.普通的指针类型 count := 1 Counter(&count) fmt.Println(count) func Counter(count *int) { *count++ } 普通指针可以通过引用来修改变量的值,这个跟C语言指针有点像。 2.uintptr类型 uintptr用来进行指针计算,因为它是整型,所以很容易计算出下一个指针所指向的位置。uintptr在builtin包中定义,定义如下: // uintptr is an integer type that is large enough to hold the bit pattern of any pointer. // uintptr是一个能足够容纳指针位数大小的整数类型 type uintptr uintptr 虽然uintpr保存了一个指针地址,但它只是一个值,不引用任何对象。因此使用的时候要注意以下情况: 1.如果uintptr地址相关联对象移动,则其值也不会更新。例如goroutine的堆栈信息发生变化 2.uintptr地址关联的对象可以被垃圾回收。GC不认为uintptr是活引用,因此unitptr地址指向的对象可以被垃圾收集。 一个uintptr可以被转换成unsafe.Pointer,同时unsafe.Pointer也可以被转换为uintptr。可以使用使用uintptr + offset计算出地址,然后使用unsafe.Pointer进行转换,格式如下:p = unsafe.Pointer(uintptr(p) + offset) n := 10 b := make([]int, n) for i:= 0;i< n;i++ { b[i] = i } fmt.Println(b) // [0 1 2 3 4 5 6 7 8 9] // 取slice的最后的一个元素 end := unsafe.Pointer(uintptr(unsafe.Pointer(&b[0])) + 9 * unsafe.Sizeof(b[0])) // 等价于unsafe.Pointer(&b[9]) fmt.Println(*(*int)(end)) // 9 3.unsafe.Pointer unsafe.Pointer是特别定义的一种指针类型,它可以包含任意类型变量的地址。Pointer在unsafe包中定义,定义如下: package unsafe // ArbitraryType is here for the purposes of documentation only and is not actually // part of the unsafe package. It represents the type of an arbitrary Go expression. // ArbitraryType在这里不是unsafe包的实际的一部分,仅仅是为了文档记录 type ArbitraryType int type Pointer *ArbitraryType func Sizeof(x ArbitraryType) uintptr func Offsetof(x ArbitraryType) uintptr func Alignof(x ArbitraryType) uintptr 官方文档unsafe.Pointer的使用有以下说明: Pointer represents a pointer to an arbitrary type. There are four special operations available for type Pointer that are not available for other types: // Pointer代表了一个任意类型的指针。Pointer类型有四种特殊的操作是其他类型不能使用的: - A pointer value of any type can be converted to a Pointer. // 任意类型的指针可以被转换为Pointer - A Pointer can be converted to a pointer value of any type. // Pointer可以被转换为任务类型的值的指针 - A uintptr can be converted to a Pointer. // uintptr可以被转换为Pointer - A Pointer can be converted to a uintptr. // Pointer可以被转换为uintptr Pointer therefore allows a program to defeat the type system and read and write arbitrary memory. It should be used with extreme care. // 因此Pointer允许程序不按类型系统的要求来读写任意的内存,应该非常小心地使用它。 所以unsafe.Pointer做的主要是用来进行桥接,用于不同类型的指针进行互相转换。 在任何情况下,结果都必须继续指向原分配的对象。 4.unsafe.Pointer,uintptr与普通指针的互相转换 unsafe.Pointer和普通指针的相互转换 var f float64 = 1.0 fmt.Println(Float64bits(f)) // 4607182418800017408 func Float64bits(f float64) uint64 { return *((*uint64)(unsafe.Pointer(&f))) } 借助unsafe.Pointer指针,实现float64转换为uint64类型。当然,我们不可以直接通过*p来获取unsafe.Pointer指针指向的真实变量的值,因为我们并不知道变量的具体类型。另外一个重要的要注意的是,在进行普通类型转换的时候,要注意转换的前后的类型要有相同的内存布局,下面两个结构也能完成转换,就因为他们有相同的内存布局 type s1 struct { id int name string } type s2 struct { field1 *[5]byte filed2 int } b := s1{name:"123"} var j s2 j = *(*s2)(unsafe.Pointer(&b)) fmt.Println(j) unsafe.Pointer和uintrptr的互相转换及配合 uintptr类型的主要是用来与unsafe.Pointer配合使用来访问和操作unsafe的内存。unsafe.Pointer不能执行算术操作。要想对指针进行算术运算必须这样来做: 1.将unsafe.Pointer转换为uintptr 2.对uintptr执行算术运算 3.将uintptr转换回unsafe.Pointer,然后访问uintptr地址指向的对象 需要小心的是,上面的步骤对于垃圾收集器来说应该是原子的,否则可能会导致问题。 例如,在第1步之后,引用的对象可能被收集。如果在步骤3之后发生这种情况,指针将是一个无效的Go指针,并可能导致程序崩溃 unsafe.Pointer和uintrptr的转换 package main import ( "fmt" "unsafe" ) type Person struct { age int name string } func main() { p := &Person{age: 30, name: "Bob"} //获取到struct s中b字段的地址 p := unsafe.Pointer(uintptr(unsafe.Pointer(p)) + unsafe.Offsetof(p.name)) //将其转换为一个string的指针,并且打印该指针的对应的值 fmt.Println(*(*string)(p)) }

优秀的个人博客,低调大师

ES7学习笔记(十)聚合查询

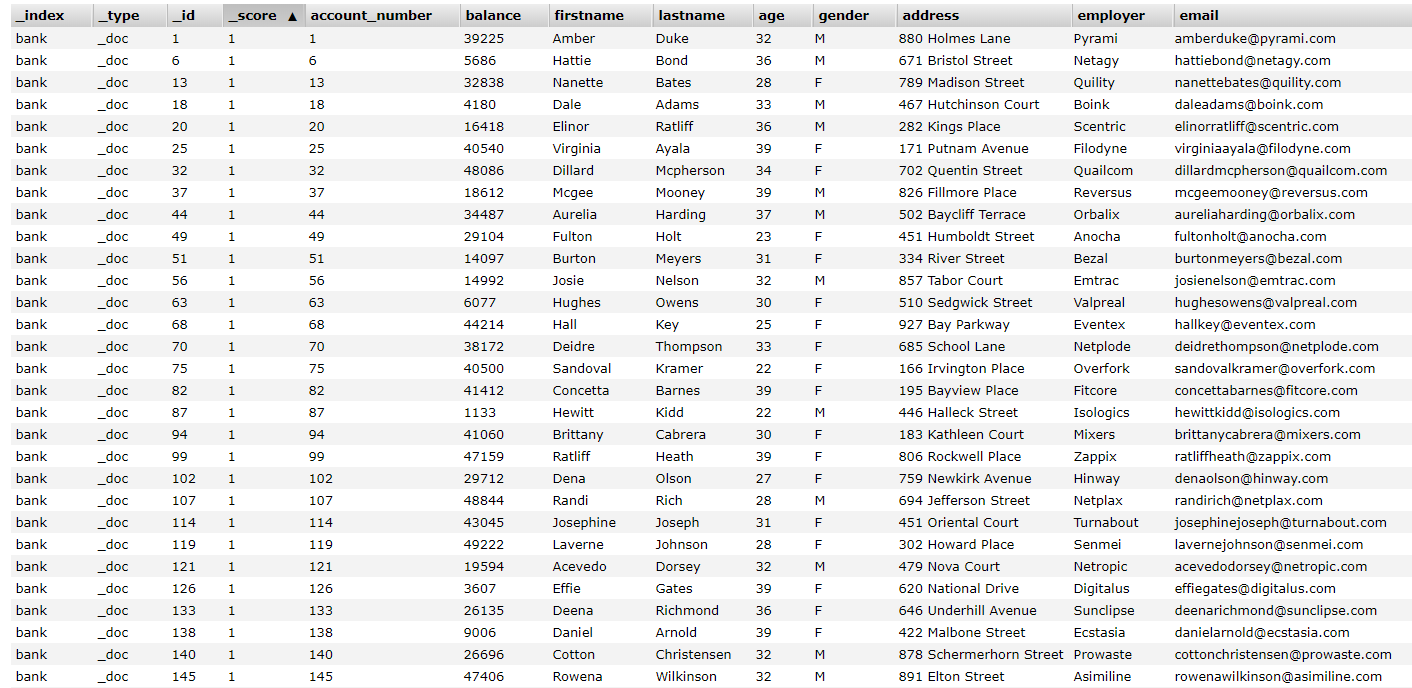
聚合查询,它是在搜索的结果上,提供的一些聚合数据信息的方法。比如:求和、最大值、平均数等。聚合查询的类型有很多种,每一种类型都有它自己的目的和输出。在ES中,也有很多种聚合查询,下面我们看看聚合查询的语法结构, "aggregations" : { "<aggregation_name>" : { "<aggregation_type>" : { <aggregation_body> } [,"meta" : { [<meta_data_body>] } ]? [,"aggregations" : { [<sub_aggregation>]+ } ]? } [,"<aggregation_name_2>" : { ... } ]* } aggregations实体包含了所有的聚合查询,如果是多个聚合查询可以用数组,如果只有一个聚合查询使用对象,aggregations也可以简写为aggs。aggregations里边的每一个聚合查询都有一个逻辑名称,这个名称是用户自定义的,在我们的语法结构中,对应的是<aggregation_name>。比如我们的聚合查询要计算平均价格,这时我们自定义的聚合查询的名字就可以叫做avg_price,这个名字要在聚合查询中保持唯一。 在自定义的聚合查询对象中,需要指定聚合查询的类型,这个类型字段往往是对象中的第一个字段,在上面的语法结构中,对应的是<aggregation_type>。在聚合查询的内部,还可以有子聚合查询,对应的是aggregations,但是只有Bucketing 类型的聚合查询才可以有子聚合查询。 metrics 聚合查询 metrics 我觉得在这里翻译成“指标”比较好,也不是太准确,我们还是用英文比较好。metrics 聚合查询的值都是从查询结果中的某一个字段(field)提炼出来的,下面我们就看看一些常用的metrics 聚合查询。我们有如下的一些索引数据,大家先看一下, 索引的名字叫做bank,一些关键的字段有account_number银行账号,balance账户余额,firstname和lastname等,大家可以直接看出它们代表的含义。假如我们想看看银行里所有人的平均余额是多少,那么查询的语句该怎么写呢? POST /bank/_search { "query": { "bool": { "must": { "match_all": {} } } }, "aggs": { "avg_balance": { "avg": { "field": "balance" } } } } 在查询语句中,查询的条件匹配的是全部,在聚合查询中,我们自定义了一个avg_balance的聚合查询,它的类型是avg,求平均数,然后我们指定字段是balance,也就是我们要计算平均数的字段。我们执行一下,然后看看返回的结果, { "took": 11, "timed_out": false, "_shards": { "total": 1, "successful": 1, "skipped": 0, "failed": 0 }, "hits": …… "aggregations": { "avg_balance": { "value": 25714.837 } } } 在返回的结果中,我们看到在aggregations中,返回了我们自定义的聚合查询avg_balance,并且计算的平均值是25714.837。 如果我们要查询balance的最大、最小、平均、求和、数量等,可以使用stats查询,我们来看一下如何发送这个请求, POST /bank/_search { "query": { "bool": { "must": { "match_all": {} } } }, "aggs": { "stats_balance": { "stats": { "field": "balance" } } } } 我们只需要把前面聚合查询的类型改为stats就可以了,我们看一下返回的结果, { "took": 20, "timed_out": false, "_shards": { "total": 1, "successful": 1, "skipped": 0, "failed": 0 }, "hits": …… "aggregations": { "stats_balance": { "count": 1000, "min": 1011, "max": 49989, "avg": 25714.837, "sum": 25714837 } } } 我们可以看到在返回的结果中,返回了5个字段,我们最常用的最大、最小、平均、求和、数量都包含在内,很方便是不是。 Bucket 聚合查询 Bucket 聚合不像metrics 那样基于某一个值去计算,每一个Bucket (桶)是按照我们定义的准则去判断数据是否会落入桶(bucket)中。一个单独的响应中,bucket(桶)的最大个数默认是10000,我们可以通过serarch.max_buckets去进行调整。 如果从定义来看,理解Bucket聚合查询还是比较难的,而且Bucket聚合查询的种类也有很多,给大家一一介绍不太可能,我们举两个实际中用的比较多的例子吧。在上面的metrics 聚合中,我们可以查询到数量(count),但是我们能不能分组呢?是不是和数据库中的group by联系起来了?对,Bucket 聚合查询就像是数据库中的group by,我们还用上面银行的索引,比如说我们要看各个年龄段的存款人数,那么查询语句我们该怎么写呢?这里就要使用Bucket 聚合中的Terms聚合查询,查询语句如下: POST /bank/_search { "query": { "bool": { "must": { "match_all": {} } } }, "aggs": { "ages": { "terms": { "field": "age" } } } } 其中,ages是我们定义的聚合查询的名称,terms指定要分组的列,我们运行一下,看看结果, …… { "aggregations": { "ages": { "doc_count_error_upper_bound": 0, "sum_other_doc_count": 463, "buckets": [ { "key": 31, "doc_count": 61 } , { "key": 39, "doc_count": 60 } , { "key": 26, "doc_count": 59 } , { "key": 32, "doc_count": 52 } , { "key": 35, "doc_count": 52 } , { "key": 36, "doc_count": 52 } , { "key": 22, "doc_count": 51 } , { "key": 28, "doc_count": 51 } , { "key": 33, "doc_count": 50 } , { "key": 34, "doc_count": 49 } ] } } 我们可以看到在返回的结果中,每个年龄的数据都汇总出来了。假如我们要看每个年龄段的存款余额,该怎么办呢?这里就要用到子聚合查询了,在Bucket 聚合中,再加入子聚合查询了,我们看看怎么写, POST /bank/_search { "query": { "bool": { "must": { "match_all": {} } } }, "aggs": { "ages": { "terms": { "field": "age" }, "aggs": { "sum_balance": { "sum": { "field": "balance" } } } } } } 我们在聚合类型terms的后面又加了子聚合查询,在子聚合查询中,又自定义了一个sum_balance的查询,它是一个metrics 聚合查询,要对字段balance进行求和。我们运行一下,看看结果。 "aggregations": { "ages": { "doc_count_error_upper_bound": 0, "sum_other_doc_count": 463, "buckets": [ { "key": 31, "doc_count": 61, "sum_balance": { "value": 1727088 } } , { "key": 39, "doc_count": 60, "sum_balance": { "value": 1516175 } } , { "key": 26, "doc_count": 59, "sum_balance": { "value": 1368494 } } , { "key": 32, "doc_count": 52, "sum_balance": { "value": 1245470 } } , { "key": 35, "doc_count": 52, "sum_balance": { "value": 1151108 } } , { "key": 36, "doc_count": 52, "sum_balance": { "value": 1153085 } } , { "key": 22, "doc_count": 51, "sum_balance": { "value": 1261285 } } , { "key": 28, "doc_count": 51, "sum_balance": { "value": 1441968 } } , { "key": 33, "doc_count": 50, "sum_balance": { "value": 1254697 } } , { "key": 34, "doc_count": 49, "sum_balance": { "value": 1313688 } } ] } } 我们看到返回结果中,增加了我们定义的sum_balance字段,它是balance余额的汇总。这个例子我们应该对bucket(桶)这个概念有了一个非常形象的认识了。还有一些其他的bucket聚合查询,这里就不给大家一一介绍了,比如:我们只想查某几个年龄段的余额汇总,就可以使用filters-aggregation。 好了,ES的一些基本的聚合查询就给大家介绍到这里了,如果要用到一些其他的聚合查询,可以参照ES的官方文档。
优秀的个人博客,低调大师

ES[7.6.x]学习笔记(九)搜索

搜索是ES最最核心的内容,没有之一。前面章节的内容,索引、动态映射、分词器等都是铺垫,最重要的就是最后点击搜索这一下。下面我们就看看点击搜索这一下的背后,都做了哪些事情。 分数(score) ES的搜索结果是按照相关分数的高低进行排序的,咦?! 怎么没说搜索先说搜索结果的排序了?咱们这里先把这个概念提出来,因为在搜索的过程中,会计算这个分数。这个分数代表了这条记录匹配搜索内容的相关程度。分数是一个浮点型的数字,对应的是搜索结果中的_score字段,分数越高代表匹配度越高,排序越靠前。 在ES的搜索当中,分为两种,一种计算分数,而另外一种是不计算分数的。 查询(query context) 查询,代表的是这条记录与搜索内容匹配的怎么样,除了决定这条记录是否匹配外,还要计算这条记录的相关分数。这个和咱们平时的查询是一样的,比如我们搜索一个关键词,分词以后匹配到相关的记录,这些相关的记录都是查询的结果,那这些结果谁排名靠前,谁排名靠后呢?这个就要看匹配的程度,也就是计算的分数。 过滤(filter context) 过滤,代表的含义非常的简单,就是YES or NO,这条记录是否匹配查询条件,它不会计算分数。频繁使用的过滤还会被ES加入到缓存,以提升ES的性能。下面我们看一个查询和过滤的例子,这个也是ES官网中的例子。 GET /_search { "query": { "bool": { "must": [ { "match": { "title": "Search" }}, { "match": { "content": "Elasticsearch" }} ], "filter": [ { "term": { "status": "published" }}, { "range": { "publish_date": { "gte": "2015-01-01" }}} ] } } } 我们看一下请求的路径/_search,这个是请求的路径,而请求的方法是GET,我们再看请求体中,有一个query,这个代表着查询的条件。而bool中的must被用作query context,它在查询的时候会计算记录匹配的相关分数。filter中的条件用作过滤,只会把符合条件的记录检索出来,不会计算分数。 组合查询 组合查询包含了其他的查询,像我们前面提到的query context和filter context。在组合查询中,分为很多种类型,我们挑重点的类型给大家介绍一下。 Boolean Query boolean查询,前面我们写的查询语句就是一个boolean查询,boolean查询中有几个关键词,表格如下: 关键词 描述 must 必须满足的条件,而且会计算分数, filter 必须满足的条件,不会计算分数 should 可以满足的条件,会计算分数 must_not 必须不满足的条件,不会计算分数 我们看看下面的查询语句: POST _search { "query": { "bool" : { "must" : { "term" : { "user" : "kimchy" } }, "filter": { "term" : { "tag" : "tech" } }, "must_not" : { "range" : { "age" : { "gte" : 10, "lte" : 20 } } }, "should" : [ { "term" : { "tag" : "wow" } }, { "term" : { "tag" : "elasticsearch" } } ], "minimum_should_match" : 1, "boost" : 1.0 } } } 上面的查询是一个典型的boolean组合查询,里边的关键词都用上了。很多小伙伴们可能对must和should的区别不是很了解,must是必须满足的条件,我们的例子中must里只写了一个条件,如果是多个条件,那么里边的所有条件必须满足。而should就不一样了,should里边现在列出了两个条件,并不是说这两个条件必须满足,到底需要满足几个呢?我们看一下下面的关键字minimum_should_match,从字面上我们就可以看出它的含义,最小should匹配数,在这里设置的是1,也就是说,should里的条件只要满足1个,就算匹配成功。在boolean查询中,如果存在一个should条件,而没有filter和must条件的话,那么minimum_should_match的默认值是1,其他情况默认值是0。 我们再看一个实际的例子吧,还记得前面我们创建的ik_index索引吗?索引中存在着几条数据,数据如下: _index _type _id ▲_score id title desc ik_index _doc fEsN-HEBZl0Dh1ayKWZb 1 1 苹果 苹果真好吃 ik_index _doc 2 1 1 香蕉 香蕉真好吃 ik_index _doc 1 1 1 香蕉 香蕉真好吃 ik_index _doc 3 1 1 橘子 橘子真好吃 ik_index _doc 4 1 1 桃子 桃子真好吃 只有5条记录,我们新建一个查询语句,如下: POST /ik_index/_search { "query":{ "bool":{ "must":[ { "match":{ "desc":"香蕉好吃" } } ] } }, "from":0, "size":10, } 我们查询的条件是desc字段满足香蕉好吃,由于我们使用的ik分词器,查询条件香蕉好吃会被分词为香蕉和好吃,但是5的数据的desc中都有好吃字段,所有5条数据都会被查询出来,我们执行一下,看看结果: _index _type _id ▲_score id title desc ik_index _doc 2 0.98773474 1 香蕉 香蕉真好吃 ik_index _doc 1 0.98773474 1 香蕉 香蕉真好吃 ik_index _doc 3 0.08929447 1 橘子 橘子真好吃 ik_index _doc 4 0.08929447 1 桃子 桃子真好吃 ik_index _doc fEsN-HEBZl0Dh1ayKWZb 0.07893815 1 苹果 苹果真好吃 哈哈,5条数据全部查询出来了,和我们的预期是一样的,但是,我们需要注意一点的是_score字段,它们的分数是不一样的,我们的查询条件是香蕉好吃,所以既包含香蕉又包含好吃的数据分数高,我们看到分数到了0.98,而另外3条数据只匹配了好吃,所以分数只有0.7,0.8。 Boosting Query 这个查询比较有意思,它有两个关键词positive和negative,positive是“正”,所有满足positive条件的数据都会被查询出来,negative是“负”,满足negative条件的数据并不会被过滤掉,而是会扣减分数。那么扣减分数要扣减多少呢?这里边有另外一个字段negative_boost,这个字段是得分的系数,它的分数在0~1之间,满足了negative条件的数据,它们的分数会乘以这个系数,比如这个系数是0.5,原来100分的数据如果满足了negative条件,它的分数会乘以0.5,变成50分。我们看看下面的例子, POST /ik_index/_search { "query": { "boosting": { "positive": { "term": { "desc": "好吃" } }, "negative": { "term": { "desc": "香蕉" } }, "negative_boost": 0.5 } } } positive条件是好吃,只要desc中有“好吃”的数据都会被查询出来,而negative的条件是香蕉,只要desc中包含“香蕉”的数据都会被扣减分数,扣减多少分数呢?它的得分将会变为原分数*0.5。我们执行一下,看看效果, index type _id score _source.id source.title source.desc ik_index _doc 3 0.08929447 1 橘子 橘子真好吃 ik_index _doc 4 0.08929447 1 桃子 桃子真好吃 ik_index _doc fEsN-HEBZl0Dh1ayKWZb 0.07893815 1 苹果 苹果真好吃 ik_index _doc 2 0.044647235 1 香蕉 香蕉真好吃 ik_index _doc 1 0.044647235 1 香蕉 香蕉真好吃 我们可以看到前3条数据的分数都在0.09左右,而后两条的数据在0.044左右,很显然,后两条数据中的desc包含香蕉,它们的得分会乘以0.5的系数,所以分数只有前面数据的分数的一半。 全文检索 在前面几节的内容中,我们介绍过,只有字段的类型是text,才会使用全文检索,全文检索会使用到分析器,在我们的ik_index索引中,title和desc字段都是text类型,所以,这两个字段的搜索都会使用到ik中文分词器。全文检索比起前面的组合检索要简单一点,当然,在ES的官方文档中,全文检索中的内容还是挺多的,在这里我们只介绍一个标准的全文检索。 我们看看下面的语句, POST /ik_index/_search { "query": { "match": { "desc": { "query": "苹果" } } } } 在请求体中,match代替了之前的bool,match是标准的全文索引的查询。match后面跟的字段是要查询的字段名,在咱们的例子中,查询的字段是desc,如果有多个字段,可以列举多个。desc字段里,query就是要查询的内容。我们还可以在字段中指定分析器,使用analyzer关键字,如果不指定,默认就是索引的分析器。我们执行一下上面的查询,结果如下: index type _id score source.id source.title source.desc ik_index _doc fEsN-HEBZl0Dh1ayKWZb 1.2576691 1 苹果 苹果真好吃 我们可以看到相应的数据已经检索出来了。 最后 在ES中,检索的花样是比较多的,这里也不能一一给大家介绍了,只介绍一些最基本、最常用的查询功能。下一篇我们看一下ES的聚合查询功能。

优秀的个人博客,低调大师

ES7学习笔记(五)动态映射

通常情况下,我们使用ES建立索引的步骤是,先创建索引,然后定义索引中的字段以及映射的类型,然后再向索引中导入数据。而动态映射是ES中一个非常重要的概念,你可以直接向文档中导入一条数据,与此同时,索引、字段、字段类型都会自动创建,无需你做其他的操作。这就是动态映射的神奇之处。 动态字段映射 ES的动态映射默认是开启的,动态映射的默认规则如下: JSON的数据类型 ES中的数据类型 null 不会映射字段 true 或 false boolean类型 浮点型数字 float 整型数字 long JSON对象 Object 数组 第一个非空值得类型 String 1、如果满足日期类型的格式,映射为日期类型 2、如果满足数字型的格式,映射为long或者float 3、如果就是字符串,会映射为一个text类型和一个keyword类型 接下来我们看看动态映射的一个例子,我们直接向dynamic-index索引中存放一条数据,注意,dynamic-index这个索引我们没有创建过,直接存放数据,索引会自动创建。接下来,我们看一下具体的请求: PUT /dynamic-index/_doc/1 { "my_null": null, "my_boolean": false, "my_float": 1.56, "my_long": 3, "my_object": { "my_first": "first value", "my_second": "second_value" }, "my_array": [1,2,3], "my_date_1": "2020-05-01", "my_date_2": "2020/05/01 12:03:03", "my_date_3": "05/01/2020", "my_string_long": "1", "my_string_float": "4.6", "my_string": "中华人民共和国" } 请求执行成功以后,我们先看一下索引的类型: GET /dynamic-index/_mapping 返回的结果如下: { "dynamic-index": { "mappings": { "properties": { "my_array": { "type": "long" }, "my_boolean": { "type": "boolean" }, "my_date_1": { "type": "date" }, "my_date_2": { "type": "date", "format": "yyyy/MM/dd HH:mm:ss||yyyy/MM/dd||epoch_millis" }, "my_date_3": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_float": { "type": "float" }, "my_long": { "type": "long" }, "my_object": { "properties": { "my_first": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_second": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } } } }, "my_string": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_string_float": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_string_long": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } } } } } } 返回的结果比较长,我们把每一个字段都看一下,看看动态映射的字段是否达到了我们的预期: 字段 映射结果 是否达到预期 原因 my_null 没有映射 是 null值不映射 my_boolean boolean 是 my_float float 是 my_long long 是 my_object object 是 my_object里自动生成了两个字段的映射 my_array long 是 数组中的数字是long型 my_date_1 date 是 my_date_2 date 是 my_date_3 text 否 没有指定这种日期格式,所以映射为text my_string_long text 否 数字探测默认关闭,没有打开 my_string_float text 否 数字探测默认关闭,没有打开 my_string text 是 普通字符串,映射为text 下面我们把数字探测打开,执行如下请求: PUT /dynamic-index { "mappings": { "numeric_detection": true } } 由于我们的索引dynamic-index中,存在了映射关系,再进行设置是会报错的,所以我们要将索引删除,执行如下请求: DELETE /dynamic-index 索引删除成功后,再执行前面的设置,执行成功,数字探测已经打开。然后再添加一种日期格式MM/dd/yyyy,请求如下: PUT /dynamic-index { "mappings": { "dynamic_date_formats": ["MM/dd/yyyy"] } } 执行报错,错误信息和之前一样,看来日期的设置要和数字探测一起才行,我们再将索引删除,然后再发送请求,两个设置一起: PUT /dynamic-index { "mappings": { "numeric_detection": true, "dynamic_date_formats": ["MM/dd/yyyy"] } } 执行成功,我们再发送之前创建索引数据的请求 PUT /dynamic-index/_doc/1 { "my_null": null, "my_boolean": false, "my_float": 1.56, "my_long": 3, "my_object": { "my_first": "first value", "my_second": "second_value" }, "my_array": [1,2,3], "my_date_1": "2020-05-01", "my_date_2": "2020/05/01 12:03:03", "my_date_3": "05/01/2020", "my_string_long": "1", "my_string_float": "4.6", "my_string": "中华人民共和国" } 执行成功,我们再看一下索引的映射, "my_string_float": { "type": "float" }, "my_string_long": { "type": "long" } "my_date_1": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_date_2": { "type": "text", "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } } }, "my_date_3": { "type": "date", "format": "MM/dd/yyyy" }, 我们重点看一下以上几个字段,my_string_float和my_string_long映射成我们想要的类型了,由于我们开启了数字探测。再看看我们映射的3个日期类型,咦?只有my_date_3映射了日期类型,其他两个都是映射成了text类型,这是由于我们在设置dynamic_date_formats时,只指定了一种格式。我们只需要把其他两种类型的日期格式也加上就可以了。 { "mappings": { "numeric_detection": true, "dynamic_date_formats": ["MM/dd/yyyy","yyyy/MM/dd HH:mm:ss","yyyy-MM-dd"] } } 这里就不给大家具体演示了,有兴趣的小伙伴去尝试一下把。 动态字段是ES中一个非常重要的功能,它给我们带来了极大的方便,也省去了我们在开发时创建索引字段的时间,真是事半功倍,小伙伴们要好好掌握哦~~

优秀的个人博客,低调大师

ES7学习笔记(三)新建索引

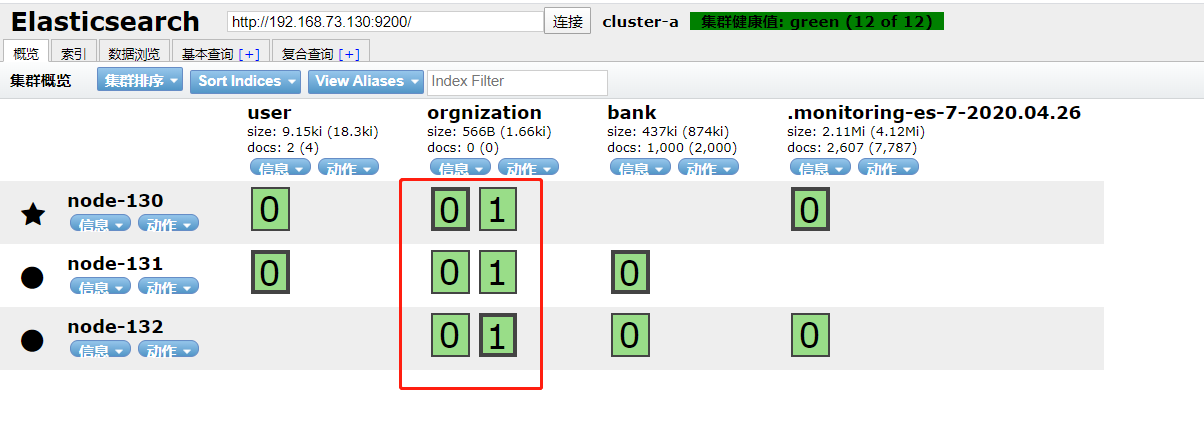
与ES的交互方式 与es的交互方式采用http的请求方式,请求的格式如下: curl -X<VERB> '<PROTOCOL>://<HOST>:<PORT>/<PATH>?<QUERY_STRING>' -d '<BODY>' 是请求的方法,比如:GET、POST、DELETE、PUT等。 协议:http或者https。 主机地址。 端口 API的路径。比如查看集群状态:/_cluster/stats。 参数。比如:?pretty,打印出格式化以后的Json。 请求的内容。比如:添加索引时的数据。 创建索引 es创建索引的请求方式如下: PUT /<index> 请求的方法用PUT。 /后面直接跟索引的名称即可。 索引的设置和字段都放在Body中。 比如我们创建一个名字叫组织机构的索引,这个索引只有两个字段,一个id,一个name。并且这个索引设置为2个分片,2个副本。 我们使用POSTMAN发送请求,如下: http://192.168.73.130:9200/orgnization 请求的方法选择PUT。然后在请求体(Body)中,写上索引的字段名称,索引的分片数和副本数,如下: { "settings":{ "number_of_shards":2, "number_of_replicas":2 }, "mappings":{ "properties":{ "id":{ "type":"long" }, "name":{ "type":"text" } } } } 我们观察一下,请求体中分为两个部分:settings和mappings。在settings中,我们设置了分片数和副本数。 number_of_shards:分片的数量; number_of_replicas:副本的数量; 在mappings中,我们设置索引的字段,在这里,我们只设置了id和name,id的映射类型是long,name的映射类型是text。这些类型我们会在后续为大家介绍。 请求体写完后,我们点击发送,es返回的结果如下: { "acknowledged": true, "shards_acknowledged": true, "index": "orgnization" } 说明索引创建成功,索引的名字正是我们在请求中设置的orgnization。 然后,我们通过elasticsearch-head插件观察一下刚才创建的索引,如图: 我们可以看到索引orgnization已经创建好了,它有2个分片,分别是0和1,并且每个分片都是两个副本。如果我们仔细观察这个图,可以看出node-130节点中的0分片,和node-132节点中的1分片,它们的边框是加粗的,这说明它们是主节点,而边框没有加粗的节点是从节点,也就是我们说的副本节点。 查看索引 如果我们要查看一个索引的设置,可以通过如下请求方式: GET /<index> 在我们的例子中,查看orgnization索引的设置,我们在POSTMAN中发送如下的请求: 我们可以看到索引的具体设置,比如:mapping的设置,分片和副本的设置。这些和我们创建索引时候的设置是一样的。 修改索引 索引一旦创建,我们是无法修改里边的内容的,不如说修改索引字段的名称。但是我们是可以向索引中添加其他字段的,添加字段的方式如下: PUT /<index>/_mapping 然后在我们的请求体中,写好新添加的字段。比如,在我们的例子当中,新添加一个type字段,它的类型我们定义为long,请求如下: http://192.168.73.130:9200/orgnization/_mapping 请求类型要改为PUT,请求体如下: { "properties": { "type": { "type": "long" } } } 我们点击发送,返回的结果如图所示: 添加索引字段成功,我们再使用GET查看一下索引,如图: 我们可以成功的查询到新添加的索引字段了。 删除索引 如果我们要删除一个索引,请求方式如下: DELETE /<index> 假如我们要删除刚才创建的orgnization索引,我们只要把请求的方法改成DELETE,然后访问我们索引就可以, http://192.168.73.130:9200/orgnization 关闭索引 如果索引被关闭,那么关于这个索引的所有读写操作都会被阻断。索引的关闭也很简单,请求方式如下: POST /<index>/_close 在我们的例子中,如果要关闭索引,降请求方法改成POST,然后发送如下请求: http://192.168.73.130:9200/orgnization/_close 打开索引 与关闭索引相对应的是打开索引,请求方式如下: POST /<index>/_open 在我们的例子中,如果要打开索引,降请求方法改成POST,然后发送如下请求: http://192.168.73.130:9200/orgnization/_open 冻结索引 冻结索引和关闭索引类似,关闭索引是既不能读,也不能写。而冻结索引是可以读,但是不能写。冻结索引的请求方式如下: POST /<index>/_freeze 对应我们的例子当中: http://192.168.73.130:9200/orgnization/_freeze 解冻索引 与冻结索引对应的是解冻索引,方式如下: POST /<index>/_unfreeze 对应我们的例子: http://192.168.73.130:9200/orgnization/_unfreeze

优秀的个人博客,低调大师

前端笔记(10)浏览器导航流程

在浏览器里,从输入 URL 到页面展示,这中间发生了什么? 此处以chrome浏览器为例进行说明。 首先先介绍几个多进程浏览器里的基本概念。 浏览器进程:主要负责用户交互、子进程管理和文件储存等功能 网络进程:面向渲染进程和浏览器进程等提供网络下载功能 渲染进程:渲染进程的主要职责是把从网络下载的 HTML、JavaScript、CSS、图片等资源解析为可以显示和交互的页面。因为渲染进程所有的内容都是通过网络获取的,会存在一些恶意代码利用浏览器漏洞对系统进行攻击,所以运行在渲染进程里面的代码是不被信任的。这也是为什么 Chrome 会让渲染进程运行在安全沙箱里,就是为了保证系统的安全 从输入 URL 到页面展示 1. 用户输入 当用户在地址栏中输入一个查询关键字时,地址栏会判断输入的关键字是搜索内容,还是请求的 URL。 如果是搜索内容,地址栏会使用浏览器默认的搜索引擎,来合成新的带搜索关键字的 URL。 如果判断输入内容符合 URL 规则,那么地址栏会根据规则,把这段内容加上协议,合成为完整的 URL。 当用户输入关键字并键入回车之后,这意味着当前页面即将要被替换成新的页面,不过在这个流程继续之前,浏览器还给了当前页面一次执行 beforeunload 事件的机会,beforeunload 事件允许页面在退出之前执行一些数据清理操作,还可以询问用户是否要离开当前页面,比如当前页面可能有未提交完成的表单等情况,因此用户可以通过 beforeunload 事件来取消导航,让浏览器不再执行任何后续工作。 2. URL 请求过程 浏览器进程会通过进程间通信(IPC)把 URL 请求发送至网络进程,网络进程接收到 URL 请求后,会在这里发起真正的 URL 请求流程。 首先,网络进程会查找本地缓存是否缓存了该资源。如果有缓存资源,那么直接返回资源给浏览器进程;如果在缓存中没有查找到资源,那么直接进入网络请求流程。 这请求前的第一步是要进行 DNS 解析,以获取请求域名的服务器 IP 地址。如果请求协议是 HTTPS,那么还需要建立 TLS 连接。接下来就是利用 IP 地址和服务器建立 TCP 连接。连接建立之后,浏览器端会构建请求行、请求头等信息,并把和该域名相关的 Cookie 等数据附加到请求头中,然后向服务器发送构建的请求信息。 服务器接收到请求信息后,会根据请求信息生成响应数据(包括响应行、响应头和响应体等信息),并发给网络进程。等网络进程接收了响应行和响应头之后,就开始解析响应头的内容了。 (1)重定向 在接收到服务器返回的响应头后,网络进程开始解析响应头,如果发现返回的状态码是 301 或者 302,那么说明服务器需要浏览器重定向到其他 URL。这时网络进程会从响应头的 Location 字段里面读取重定向的地址,然后再发起新的 HTTP 或者 HTTPS 请求,一切又重头开始了。 (2)响应数据类型处理 Content-Type 是 HTTP 头中一个非常重要的字段, 它告诉浏览器服务器返回的响应体数据是什么类型,然后浏览器会根据 Content-Type 的值来决定如何显示响应体的内容。 不同 Content-Type 的后续处理流程也截然不同。如果 Content-Type 字段的值被浏览器判断为下载类型,那么该请求会被提交给浏览器的下载管理器,同时该 URL 请求的导航流程就此结束。但如果是 HTML,那么浏览器则会继续进行导航流程。由于 Chrome 的页面渲染是运行在渲染进程中的,所以接下来就需要准备渲染进程了。 3. 准备渲染进程 默认情况下,Chrome 会为每个页面分配一个渲染进程,也就是说,每打开一个新页面就会配套创建一个新的渲染进程。但是,也有一些例外,如果从一个页面打开了另一个新页面,而新页面和当前页面属于同一站点的话,那么新页面会复用父页面的渲染进程。 渲染进程准备好之后,还不能立即进入文档解析状态,因为此时的文档数据还在网络进程中,并没有提交给渲染进程,所以下一步就进入了提交文档阶段。 4. 提交文档 所谓提交文档,就是指浏览器进程将网络进程接收到的 HTML 数据提交给渲染进程,具体流程是这样的: 首先当浏览器进程接收到网络进程的响应头数据之后,便向渲染进程发起“提交文档”的消息; 渲染进程接收到“提交文档”的消息后,会和网络进程建立传输数据的“管道”; 等文档数据传输完成之后,渲染进程会返回“确认提交”的消息给浏览器进程; 浏览器进程在收到“确认提交”的消息后,会更新浏览器界面状态,包括了安全状态、地址栏的 URL、前进后退的历史状态,并更新 Web 页面。 5. 渲染阶段 一旦文档被提交,渲染进程便开始页面解析和子资源加载了,渲染进程会发送一个消息给浏览器进程,浏览器接收到消息后,会停止标签图标上的加载动画。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册