首页 文章 精选 留言 我的

精选列表

搜索[笔记工具],共10000篇文章
优秀的个人博客,低调大师

云服务器 ECS 学习笔记

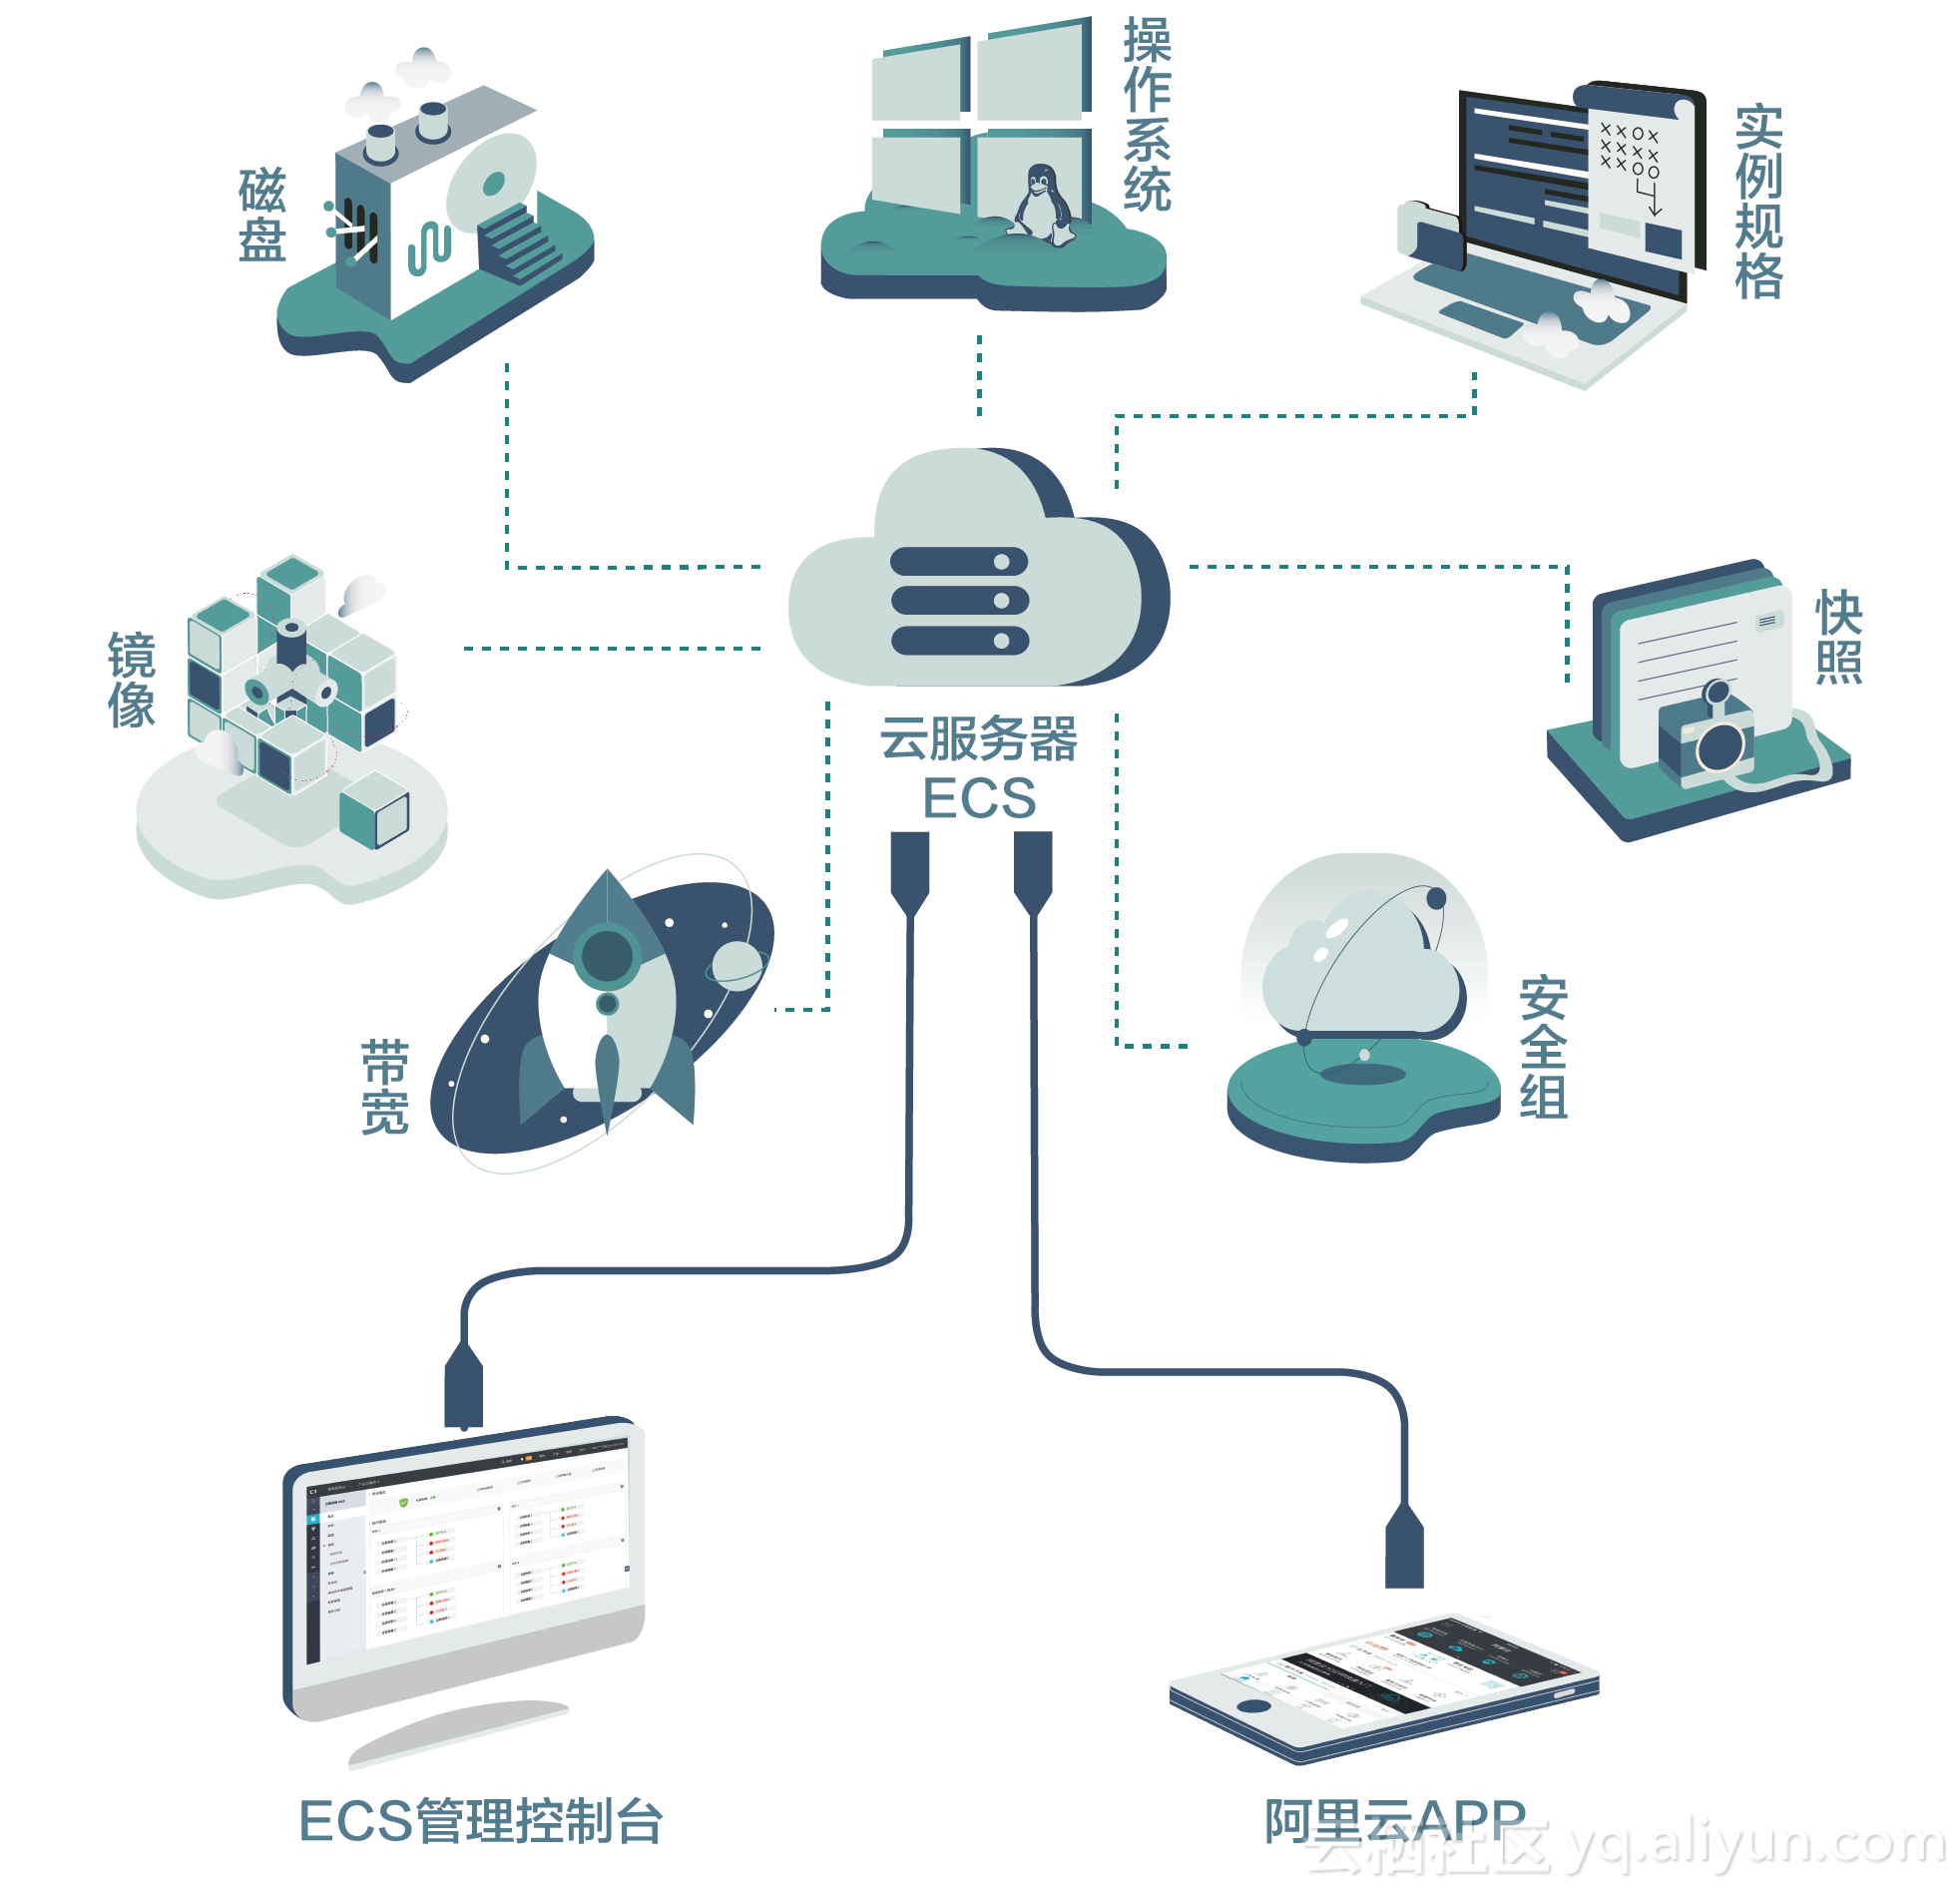
云服务器 ECS云服务器 Elastic Compute Service(ECS)是阿里云提供的一种基础云计算服务阿里云专有网络:在阿里云专有网络之上,可以产生更多的业务可能性。阿里云专有网络更加稳定和安全。 纵向的弹性,即单个服务器的配置变更 对于阿里云的弹性而言,是计算的弹性、存储的弹性、网络的弹性以及您对于业务架构重新规划的弹性 实例规格族,根据业务场景可分为:面向通用计算场景的实例规格族面向内存优化场景的实例规格族面向计算优化场景的实例规格族面向存储优化场景的实例规格族面向异构计算场景的实例规格族面向临时使用场景的实例规格族 规格族之间的变配逻辑三种共享实例规格族(XN4、N4、MN4)之间以及规格族内部可以变更配置。三种独享实例规格族(SN1、SN2、SE1)之间以及规格族内部可以变更配置。三种计算优化的规格族(C4、CM4、CE4)之间以及规格族内部可以变更配置。异构计算 GA1 规格族内部规格之间可以变更配置。异构计算 GN4 规格族内部规格之间可以变更配置。 三种共享实例规格族(N1、N2、E3)之间以及规格族内部可以变更配置。 I/O 优化实例支持两种磁盘:SSD 云盘超高效云盘 实例的生命周期是从创建(购买)开始到最后释放(包年包月实例到期、按量付费实例欠费停机或者按量付费实例用户主动释放)。 竞价实例是专为降低用户ECS计算成本而设计的一种按需实例 竞价实例以小时为单位进行付费,并且采用“ 先使用后付费”的模式。 云盘分为 高效云盘、SSD 云盘和普通云盘。高效云盘采用固态硬盘与机械硬盘的混合介质作为存储介质SSD 云盘利用分布式三副本机制SSD 云盘只有挂载到 I/O 优化的实例时,才能获得期望的 IOPS 性能。挂载到非 I/O 优化的实例时无法获得期望的 IOPS 性能。普通云盘采用机械磁盘作为存储介质 ChunkECS 用户对虚拟磁盘的读写最终都会被映射为对阿里云数据存储平台上的文件的读写。阿里云提供一个扁平的线性存储空间,在内部会对线性地址进行切片,一个分片称为一个 Chunk;对于每一个 Chunk,阿里云会复制出三个副本,并将这些副本按照一定的策略存放在集群中的不同节点上,保证用户数据的可靠。 三份副本的原理在阿里云数据存储系统中,有三类角色,分别称为 Master、Chunk Server,以及 Client。 1.Client 计算出这个写操作对应的 Chunk。2。Client 向 Master 查询该 Chunk 的三份副本的存放位置。3.Client 根据 Master 返回的结果,向这 3 个 Chunk Server 发出写请求。4.如果三份都写成功,Client 向用户返回成功;反之,Client 向用户返回失败。 至于 ECS 实例内由于病毒感染、人为误删除或黑客入侵等软故障原因造成的数据丢失,需要采用备份、快照等技术手段来解决。 目前只要是相同地域下,SLB 、RDS 、OSS 同 ECS 之间都是可以直接内网互通连接使用的 公网 IP 可以用于以下情况:ECS 实例与 Internet 之间互访ECS 实例与云服务之间互访 云服务器 ECS 不支持组播和广播 专有网络(VPC)类型的ECS实例有两种公网 IP 类型:公网 PublicIP弹性公网IP(EIP) 公网 PublicIP 是随实例一起创建分配的或升级0Mbps带宽系统自动分配,分配后不能解绑,只能随实例一起释放。如果您需要可以长期保留某个公网 IP,可以绑定和解绑在需要的云服务器上,请选择弹性公网 IP(EIP)。弹性公网 IP(EIP)是可以单独申请,可以绑定到没有分配公网 IP(PublicIP 或者 EIP)的实例,也可以从实例上解绑,绑定到另外一个实例上,还可以单独进行释放。一个专有网络类型的 ECS 实例上最多只能分配一个公网 IP,要么公网 PublicIP,要么弹性公网 IP。 专有网络和经典网络的 PublicIP 异同相同点:都是可以通过 PublicIP 进行访问 Internet 的。在产品上的所有操作都相同,随实例一起购买,可以升级带宽,不能解绑,可以随实例一起释放。区别:专有网络的 PublicIP 是 NAT IP,在机器内部无法通过命令行查询;经典网络是 BindingIP,可以在机器中通过命令行查询。 安全组是一个逻辑上的分组,这个分组是由同一个地域(Region)内具有相同安全保护需求并相互信任的实例组成。每个实例至少属于一个安全组,在创建的时候就需要指定。同一安全组内的实例之间网络互通,不同安全组的实例之间默认内网不通。可以授权两个安全组之间互访。安全组是一种虚拟防火墙,具备状态检测包过滤功能。安全组用于设置单台或多台云服务器的网络访问控制,它是重要的网络安全隔离手段,用于在云端划分安全域 每个安全组最多有 100 条安全组规则 镜像是云服务器 ECS 实例运行环境的模板,一般包括操作系统和预装的软件 所谓快照,就是某一个时间点上某一个磁盘的数据备份。 快照可以分为手动快照和自动快照。 快照链是一个磁盘中所有快照组成的关系链,一个磁盘对应一条快照链。

优秀的个人博客,低调大师

React Native 源码笔记——你知道几条?

ReactNative是Facebook开源的一种实现移动跨平台开发的解决方案,目前在业界得到广泛应用,这里有非常详细的中文使用指南。本文主要分享RN源码中一些值得大家学习或者借鉴的代码或者编写技巧等,供大家学习参考。 整个RN库包含10多个工程,有兴趣的童鞋可以下载源码查看具体细节,在此不再展开。 宏定义巧用 整个ReactNative源码工程中用到了大量的宏定义,包括RCT_EXTERN、RCT_NOT_IMPLEMENTED、RCT_EXPORT_METHOD以及RCT_EXPORT_MODULE等申明宏或者功能宏。通过宏定义的方式,可以非常方便嵌入功能代码或者逻辑实现,重用代码的同时又保持了代码的整洁性。 比如,ProtocolKit工程中,作者通过宏定义@defs将Protocol接口巧妙的实现在.h文件中,代码简介明了,又不失功能完整性。当然,RN工程中,RCT_NOT_IMPLEMENTED宏也有相似作用,实际项目中各位也可以尝试通过宏定义实现一些常用功能模块。 关于iOS宏定义的文章有很多,在此推荐两篇非常不错的文章:RAC中必须要知道的宏、ios宏的使用和技巧。 环境变量 iOS开发中,各位对#ifdef DEBUG应该非常熟悉,通过判断该条件,可以区别当前运行环境是Debug环境还是Release环境。比如Release环境下通过重定义NSLog以屏蔽所有日志输出: #ifdef DEBUG #define NSLog(...) NSLog(__VA_ARGS__) #else #define NSLog(...) {} #endif 进一步,是否可以考虑只在联机调试环境下输出日志?此时就涉及联机调试环境的判断,环境变量正好可以解决该问题: Xcode可以在不同环境下自定义环境变量Environment Variables,通过在运行环境Run中自定义变量CI_USE_PACKAGER,此时便可在项目代码中通过getenv()函数判断当前运行环境: if (getenv("CI_USE_PACKAGER")) { // to do... } 被忽略的硬键盘 相较于软键盘文字符号的输入,对于APP来说,硬键盘的应用开发似乎很容易被忽视,毕竟,通常情况下,硬键盘输入只会出现在模拟器环境下。 iOS7以后,系统定义有硬键盘响应交互类UIKeyCommand,通过UIKeyCommand,APP能够监听硬键盘的特定输入响应,比如Command+D等,当然,前提是APP需要首先监听该输入命令。 UIKeyCommand的使用非常简单,当需要在特定场景触发某一事件,但又不想影响界面显示的时候,不妨试试UIKeyCommand,具体使用可以看看这篇文章。 _cmd iOS官方文档中,_cmd表示当前方法的selector,你可以通过下面代码打印输出当前函数名: NSLog(@"Current method: %@", NSStringFromSelector(_cmd)); 当然,实际项目中,你也可以这样使用: NSNumber *rootTag = objc_getAssociatedObject(self, _cmd) ?: @1; objc_setAssociatedObject(self, _cmd, @(rootTag.integerValue + 10), OBJC_ASSOCIATION_RETAIN_NONATOMIC); 瞧,是不是有点意思! kCFNull 相对于nil NSNull而言,kCFNull笔者接触较少,kCFNull可以理解为NSNull单例对象: id null1 = (id)kCFNull; id null2 = [NSNull null]; 打印地址: null1=(NSNull *)0x10426eaf0 null2=(NSNull *)0x10426eaf0 从上面测试结果可以看出它们其实指向同一地址, 可以简单理解为 kCFNull === [NSNull null]。 文本阴影NSShadow APP开发中,程序猿可能经常需要在图片或视频上显示文字,由于背景颜色跟文字颜色相近,导致文字看不清,比如时下火热的直播弹幕显示,为了确保文字显示清晰,开发者一般会配上阴影或者文字描边。 给文本添加阴影描边,系统提供有NSShadow类,可以这样使用: NSShadow *shadow = [NSShadow new]; shadow.shadowOffset = CGSizeZero; shadow.shadowBlurRadius = 5.0f; shadow.shadowColor = [UIColor colorWithWhite:0.0f alpha:0.3f]; NSAttributedString *attString = [[NSAttributedString alloc] initWithString:@"www.olinone.com" attributes:@{NSShadowAttributeName: shadow, NSForegroundColorAttributeName: [UIColor whiteColor]}]; lbl.attributedText = attString; 实际效果是这样的,shadowBlurRadius值越小,文本描边越清晰 主线程判断 判断当前执行线程是否为主线程的方法有很多,比如: [NSThread isMainThread] pthread_main_np 在RN中,它是这样的: BOOL RCTIsMainQueue() { static void *mainQueueKey = &mainQueueKey; static dispatch_once_t onceToken; dispatch_once(&onceToken, ^{ dispatch_queue_set_specific(dispatch_get_main_queue(), mainQueueKey, mainQueueKey, NULL); }); return dispatch_get_specific(mainQueueKey) == mainQueueKey; } 当然,由于无法查看NSThread内部实现机制,暂时无法了解孰优孰劣,不过,[NSThread isMainThread]貌似足矣! volatile不简单 在百科中,是这样描述它的:就像大家更熟悉的const一样,volatile是一个类型修饰符,它是被设计用来修饰被不同线程访问和修改的变量。作为指令关键字,确保本条指令不会因编译器的优化而省略,且要求每次直接读值。 简单说,被volatile修饰的变量是多线程安全的,其次,不会因为编译器优化导致读值出错。关于编译器编译优化可以看看这篇文章。 iOS开发中确保多线程安全的方法有很多,原子操作、线程锁、单线程执行等等,本人也写过相关文章iOS开发多线程同步。 在RN中,通过volatile修饰符,巧妙实现了多线程取消操作: __block volatile uint32_t cancelled = 0; if (!cancelled) { // to do... } OSAtomicOr32Barrier(1, &cancelled); 通过原子性操作访问被volatile修饰的cancelled对象即可保障函数只执行一次。想想大家熟悉的单例dispatch_once_t,现在让你设计单例对象,你又会如何设计了? + (instancetype)sharedInstance { static RCTWebSocketManager *sharedInstance = nil; static dispatch_once_t onceToken; dispatch_once(&onceToken, ^{ sharedInstance = [self new]; }); return sharedInstance; } 结构体Struct 说起Struct,不知各位对它印象如何?大学C课本中学过?NSObject类class原型貌似有讲? struct iOSDev { NSString *nickName; }; OC中一个简单的结构体,在Swift中,Struct也可以这样写: struct iOSDev { var nickName : String func getBusinessCard() -> String { return "\(nickName),幽默的iOS开发者!" } }; let iOSOlinone = iOSDev(nickName: "olinone") print(iOSOlinone.getBusinessCard()) getBusinessCard为结构体函数,是不是感觉很方便!其实OC中也可以这样写: struct iOSDev { NSString *nickName; NSString *getBusinessCard() { return [NSString stringWithFormat:@"%@,幽默的iOS开发者!", nickName]; } }; iOSDev iosDev = iOSDev{@"olinone"}; NSLog(@"%@", iosDev.getBusinessCard()); 当然,为Struct添加函数并不是C语言特性,而是C++特性,因此,为了编译通过,你需要将.m文件修改成.mm文件 Struct有其使用的特殊场景,相较于Class,合理的使用Struct可以使代码更加整洁。同时,为了适应Swift中Struct强大特性,可以试着在OC项目中尝试Struct 最后,给大家来个段子吧: 话说一美女要在两个男人之间做选择,一个年纪大,长的丑,是个千万富翁,另一个年轻,帅气,iOS开发程序猿。 她对他们说,我会给你们一人一张纸条,写着我愿意的那张就是我的选择。 富翁打开纸条,看见上面写着我愿意,于是搂着她,坐上豪车高兴的走了。 年轻的小伙很伤心,打开纸条看见上面写着:“等我一个月~” 文章转载自 开源中国社区[http://www.oschina.net]

优秀的个人博客,低调大师

Android Activity和Intent机制学习笔记

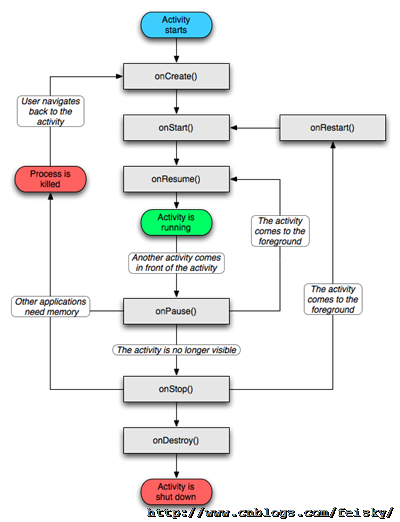
Activity Android中,Activity是所有程序的根本,所有程序的流程都运行在Activity之中,Activity具有自己的生命周期(见http://www.cnblogs.com/feisky/archive/2010/01/01/1637427.html,由系统控制生命周期,程序无法改变,但可以用onSaveInstanceState保存其状态)。 对于Activity,关键是其生命周期的把握(如下图),其次就是状态的保存和恢复(onSaveInstanceState onRestoreInstanceState),以及Activity之间的跳转和数据传输(intent)。 Activity中常用的函数有SetContentView() findViewById() finish() startActivity(),其生命周期涉及的函数有: void onCreate(BundlesavedInstanceState)void onStart()void onRestart()void onResume()void onPause()void onStop()void onDestroy() 注意的是,Activity的使用需要在Manifest文件中添加相应的<Activity>,并设置其属性和intent-filter。 Intent Android中提供了Intent机制来协助应用间的交互与通讯,Intent负责对应用中一次操作的动作、动作涉及数据、附加数据进行描述,Android则根据此Intent的描述,负责找到对应的组件,将 Intent传递给调用的组件,并完成组件的调用。Intent不仅可用于应用程序之间,也可用于应用程序内部的Activity/Service之间的交互。因此,Intent在这里起着一个媒体中介的作用,专门提供组件互相调用的相关信息,实现调用者与被调用者之间的解耦。在SDK中给出了Intent作用的表现形式为: 通过Context.startActivity()orActivity.startActivityForResult()启动一个Activity; 通过Context.startService()启动一个服务,或者通过Context.bindService()和后台服务交互; 通过广播方法(比如Context.sendBroadcast(),Context.sendOrderedBroadcast(),Context.sendStickyBroadcast()) 发给broadcast receivers。 Intent属性的设置,包括以下几点:(以下为XML中定义,当然也可以通过Intent类的方法来获取和设置) (1)Action,也就是要执行的动作 SDk中定义了一些标准的动作,包括 onstant Target component Action ACTION_CALL activity Initiate a phone call. ACTION_EDIT activity Display data for the user to edit. ACTION_MAIN activity Start up as the initial activity of a task, with no data input and no returned output. ACTION_SYNC activity Synchronize data on a server with data on the mobile device. ACTION_BATTERY_LOW broadcast receiver A warning that the battery is low. ACTION_HEADSET_PLUG broadcast receiver A headset has been plugged into the device, or unplugged from it. ACTION_SCREEN_ON broadcast receiver The screen has been turned on. ACTION_TIMEZONE_CHANGED broadcast receiver The setting for the time zone has changed. 当然,也可以自定义动作(自定义的动作在使用时,需要加上包名作为前缀,如"com.example.project.SHOW_COLOR”),并可定义相应的Activity来处理我们的自定义动作。 (2)Data,也就是执行动作要操作的数据 Android中采用指向数据的一个URI来表示,如在联系人应用中,一个指向某联系人的URI可能为:content://contacts/1。对于不同的动作,其URI数据的类型是不同的(可以设置type属性指定特定类型数据),如ACTION_EDIT指定Data为文件URI,打电话为tel:URI,访问网络为http:URI,而由content provider提供的数据则为content:URIs。 (3)type(数据类型),显式指定Intent的数据类型(MIME)。一般Intent的数据类型能够根据数据本身进行判定,但是通过设置这个属性,可以强制采用显式指定的类型而不再进行推导。 (4)category(类别),被执行动作的附加信息。例如 LAUNCHER_CATEGORY 表示Intent 的接受者应该在Launcher中作为顶级应用出现;而ALTERNATIVE_CATEGORY表示当前的Intent是一系列的可选动作中的一个,这些动作可以在同一块数据上执行。还有其他的为 Constant Meaning CATEGORY_BROWSABLE The target activity can be safely invoked by the browser to display data referenced by a link — for example, an image or an e-mail message. CATEGORY_GADGET The activity can be embedded inside of another activity that hosts gadgets. CATEGORY_HOME The activity displays the home screen, the first screen the user sees when the device is turned on or when the HOME key is pressed. CATEGORY_LAUNCHER The activity can be the initial activity of a task and is listed in the top-level application launcher. CATEGORY_PREFERENCE The target activity is a preference panel. (5)component(组件),指定Intent的的目标组件的类名称。通常 Android会根据Intent 中包含的其它属性的信息,比如action、data/type、category进行查找,最终找到一个与之匹配的目标组件。但是,如果 component这个属性有指定的话,将直接使用它指定的组件,而不再执行上述查找过程。指定了这个属性以后,Intent的其它所有属性都是可选的。 (6)extras(附加信息),是其它所有附加信息的集合。使用extras可以为组件提供扩展信息,比如,如果要执行“发送电子邮件”这个动作,可以将电子邮件的标题、正文等保存在extras里,传给电子邮件发送组件。 理解Intent的关键之一是理解清楚Intent的两种基本用法:一种是显式的Intent,即在构造Intent对象时就指定接收者;另一种是隐式的Intent,即Intent的发送者在构造Intent对象时,并不知道也不关心接收者是谁,有利于降低发送者和接收者之间的耦合。 对于显式Intent,Android不需要去做解析,因为目标组件已经很明确,Android需要解析的是那些隐式Intent,通过解析,将 Intent映射给可以处理此Intent的Activity、IntentReceiver或Service。 Intent解析机制主要是通过查找已注册在AndroidManifest.xml中的所有IntentFilter及其中定义的Intent,最终找到匹配的Intent。在这个解析过程中,Android是通过Intent的action、type、category这三个属性来进行判断的,判断方法如下: 如果Intent指明定了action,则目标组件的IntentFilter的action列表中就必须包含有这个action,否则不能匹配; 如果Intent没有提供type,系统将从data中得到数据类型。和action一样,目标组件的数据类型列表中必须包含Intent的数据类型,否则不能匹配。 如果Intent中的数据不是content: 类型的URI,而且Intent也没有明确指定它的type,将根据Intent中数据的scheme (比如 http: 或者mailto:) 进行匹配。同上,Intent 的scheme必须出现在目标组件的scheme列表中。 如果Intent指定了一个或多个category,这些类别必须全部出现在组建的类别列表中。比如Intent中包含了两个类别:LAUNCHER_CATEGORY 和 ALTERNATIVE_CATEGORY,解析得到的目标组件必须至少包含这两个类别。 Intent-Filter的定义 一些属性设置的例子: <action android:name="com.example.project.SHOW_CURRENT" /> <category android:name="android.intent.category.DEFAULT" /> <data android:mimeType="video/mpeg" android:scheme="http" . . . /> <data android:mimeType="image/*" /> <data android:scheme="http" android:type="video/*" /> 完整的实例 <activity android:name="NotesList" android:label="@string/title_notes_list"> <intent-filter> <action android:name="android.intent.action.MAIN" /> <category android:name="android.intent.category.LAUNCHER" /> </intent-filter> <intent-filter> <action android:name="android.intent.action.VIEW" /> <action android:name="android.intent.action.EDIT" /> <action android:name="android.intent.action.PICK" /> <category android:name="android.intent.category.DEFAULT" /> <data android:mimeType="vnd.android.cursor.dir/vnd.google.note" /> </intent-filter> <intent-filter> <action android:name="android.intent.action.GET_CONTENT" /> <category android:name="android.intent.category.DEFAULT" /> <data android:mimeType="vnd.android.cursor.item/vnd.google.note" /> </intent-filter> </activity> Intent用法实例 1.无参数Activity跳转 Intent it = new Intent(Activity.Main.this, Activity2.class); startActivity(it); 2.向下一个Activity传递数据(使用Bundle和Intent.putExtras) Intent it = new Intent(Activity.Main.this, Activity2.class); Bundle bundle=new Bundle(); bundle.putString("name", "This is from MainActivity!"); it.putExtras(bundle); // it.putExtra(“test”, "shuju”); startActivity(it); // startActivityForResult(it,REQUEST_CODE); 对于数据的获取可以采用: Bundle bundle=getIntent().getExtras(); String name=bundle.getString("name"); 3.向上一个Activity返回结果(使用setResult,针对startActivityForResult(it,REQUEST_CODE)启动的Activity) Intent intent=getIntent(); Bundle bundle2=new Bundle(); bundle2.putString("name", "This is from ShowMsg!"); intent.putExtras(bundle2); setResult(RESULT_OK, intent); 4.回调上一个Activity的结果处理函数(onActivityResult) @Override protected void onActivityResult(int requestCode, int resultCode, Intent data) { // TODO Auto-generated method stub super.onActivityResult(requestCode, resultCode, data); if (requestCode==REQUEST_CODE){ if(resultCode==RESULT_CANCELED) setTitle("cancle"); else if (resultCode==RESULT_OK) { String temp=null; Bundle bundle=data.getExtras(); if(bundle!=null) temp=bundle.getString("name"); setTitle(temp); } } } 下面是转载来的其他的一些Intent用法实例(转自javaeye) 显示网页 1. Uri uri = Uri.parse("http://google.com"); 2. Intent it = new Intent(Intent.ACTION_VIEW, uri); 3. startActivity(it); 显示地图 1. Uri uri = Uri.parse("geo:38.899533,-77.036476"); 2. Intent it = new Intent(Intent.ACTION_VIEW, uri); 3. startActivity(it); 4. //其他 geo URI 範例 5. //geo:latitude,longitude 6. //geo:latitude,longitude?z=zoom 7. //geo:0,0?q=my+street+address 8. //geo:0,0?q=business+near+city 9. //google.streetview:cbll=lat,lng&cbp=1,yaw,,pitch,zoom&mz=mapZoom 路径规划 1. Uri uri = Uri.parse("http://maps.google.com/maps?f=d&saddr=startLat%20startLng&daddr=endLat%20endLng&hl=en"); 2. Intent it = new Intent(Intent.ACTION_VIEW, uri); 3. startActivity(it); 4. //where startLat, startLng, endLat, endLng are a long with 6 decimals like: 50.123456 打电话 1. //叫出拨号程序 2. Uri uri = Uri.parse("tel:0800000123"); 3. Intent it = new Intent(Intent.ACTION_DIAL, uri); 4. startActivity(it); 1.//直接打电话出去 2. Uri uri = Uri.parse("tel:0800000123"); 3. Intent it = new Intent(Intent.ACTION_CALL, uri); 4. startActivity(it); 5. //用這個,要在 AndroidManifest.xml 中,加上 6. //<uses-permission id="android.permission.CALL_PHONE" /> 传送SMS/MMS 1.//调用短信程序 2. Intent it = new Intent(Intent.ACTION_VIEW, uri); 3. it.putExtra("sms_body", "The SMS text"); 4. it.setType("vnd.android-dir/mms-sms"); 5. startActivity(it); 1.//传送消息 2. Uri uri = Uri.parse("smsto://0800000123"); 3. Intent it = new Intent(Intent.ACTION_SENDTO, uri); 4. it.putExtra("sms_body", "The SMS text"); 5. startActivity(it); 1.//传送 MMS 2. Uri uri = Uri.parse("content://media/external/images/media/23"); 3. Intent it = new Intent(Intent.ACTION_SEND); 4. it.putExtra("sms_body", "some text"); 5. it.putExtra(Intent.EXTRA_STREAM, uri); 6. it.setType("image/png"); 7. startActivity(it); 传送 Email 1. Uri uri = Uri.parse("mailto:xxx@abc.com"); 2. Intent it = new Intent(Intent.ACTION_SENDTO, uri); 3. startActivity(it); 1. Intent it = new Intent(Intent.ACTION_SEND); 2. it.putExtra(Intent.EXTRA_EMAIL, "me@abc.com"); 3. it.putExtra(Intent.EXTRA_TEXT, "The email body text"); 4. it.setType("text/plain"); 5. startActivity(Intent.createChooser(it, "Choose Email Client")); 1. Intent it=new Intent(Intent.ACTION_SEND); 2. String[] tos={"me@abc.com"}; 3. String[] ccs={"you@abc.com"}; 4. it.putExtra(Intent.EXTRA_EMAIL, tos); 5. it.putExtra(Intent.EXTRA_CC, ccs); 6. it.putExtra(Intent.EXTRA_TEXT, "The email body text"); 7. it.putExtra(Intent.EXTRA_SUBJECT, "The email subject text"); 8. it.setType("message/rfc822"); 9. startActivity(Intent.createChooser(it, "Choose Email Client")); 1. //传送附件 2. Intent it = new Intent(Intent.ACTION_SEND); 3. it.putExtra(Intent.EXTRA_SUBJECT, "The email subject text"); 4. it.putExtra(Intent.EXTRA_STREAM, "file:///sdcard/mysong.mp3"); 5. sendIntent.setType("audio/mp3"); 6. startActivity(Intent.createChooser(it, "Choose Email Client")); 播放多媒体 Uri uri = Uri.parse("file:///sdcard/song.mp3"); Intent it = new Intent(Intent.ACTION_VIEW, uri); it.setType("audio/mp3"); startActivity(it); Uri uri = Uri.withAppendedPath(MediaStore.Audio.Media.INTERNAL_CONTENT_URI, "1"); Intent it = new Intent(Intent.ACTION_VIEW, uri); startActivity(it); Market 相关1. //寻找某个应用 2. Uri uri = Uri.parse("market://search?q=pname:pkg_name"); 3. Intent it = new Intent(Intent.ACTION_VIEW, uri); 4. startActivity(it); 5. //where pkg_name is the full package path for an application 1. //显示某个应用的相关信息 2. Uri uri = Uri.parse("market://details?id=app_id"); 3. Intent it = new Intent(Intent.ACTION_VIEW, uri); 4. startActivity(it); 5. //where app_id is the application ID, find the ID 6. //by clicking on your application on Market home 7. //page, and notice the ID from the address bar Uninstall 应用程序1. Uri uri = Uri.fromParts("package", strPackageName, null);2. Intent it = new Intent(Intent.ACTION_DELETE, uri); 3. startActivity(it); 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/16/1649081.html,如需转载请自行联系原作者
优秀的个人博客,低调大师

学习笔记-Redis设计与实现-事件

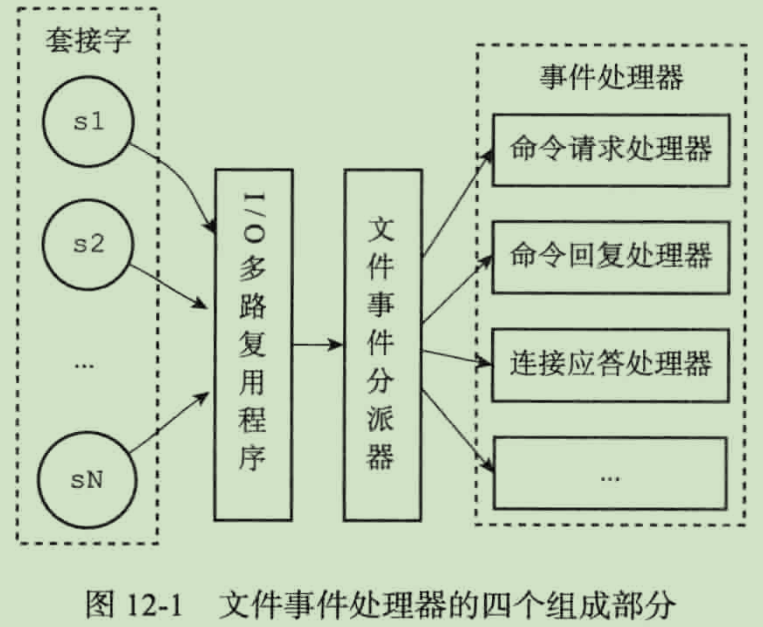
Redis服务器是一个事件驱动程序,服务器需要处理以下两类事件: 文件事件(file event):Redis服务器通过套接字与客户端(或者其他Redis服务器)进行连接,而文件事件就是服务器对套接字操作的抽象。 时间事件(time event):Redis服务器中的一些操作(比如serverCron函数)需要在给定的时间点执行,而时间事件就是服务器对这类定时操作的抽象。 12.1 文件事件 Redis基于Reactor模式开发了自己的网络事件处理器,被称为文件事件处理器(file event handler): 文件事件处理器使用I/O多路复用(multiplexing)程序来同时监听多个套接字,并根据套接字目前执行的任务来为套接字关联不同的事件处理器。 当被监听的套接字准备好执行连接应答(accept)、读取(read)、写入(write)、关闭(close)等操作时,与操作相对应的文件事件就会产生,这时文件事件处理器就会调用套接字之前关联好的事件处理器来处理这些事件。 虽然文件事件处理器以单线程方式运行,但通过使用I/O多路复用程序来监听多个套接字,文件事件处理器既实现了高性能的网络通信模型,又可以很好地与Redis服务器中其他同样以单线程方式运行地模块进行对接,这保持了Redis内部单线程设计地简单性。 12.1.1 文件事件处理器地构成 文件事件处理器的四个组成部分,分别时套接字、I/O多路复用程序、文件事件分派器(dispatcher),以及事件处理器。 文件事件是对套接字操作的抽象,每当一个套接字准备好执行连接应答(accept)、写入、读取、关闭等操作时,就会产生一个文件事件。因为一个服务器通常会连接多个套接字,所以多个文件事件有可能会并发地出现。 I/O多路复用程序负责监听多个套接字,并向文件事件分派器传送产生了事件地套接字。 尽管多个文件事件可能会并发地出现,但I/O多路复用程序总是会将所有产生事件地套接字都放到一个队列里面,然后通过这个队列,以有序(sequentially)、同步(synchronously)、每次一个套接字的方式向文件事件分派器传送套接字。 文件事件分派器接收I/O多路复用程序传来地套接字,并根据套接字产生地事件地类型,调用响应地事件处理器。 12.1.2I/O多路复用程序的实现 12.1.3 事件的类型 I/O多路复用程序可以监听多个套接字的ae.h/AE_READABLE事件和ae.h/AE_WRITEABLE事件,这两类事件和套接字操作之间的对应关系如下: 当套接字变得可读时(客户端对套接字执行write操作,或者执行close操作),或者有新的可应答(acceptable)套接字出现时(客户端对服务器的监听套接字执行connect操作),套接字产生AE_READABLE事件。 当套接字变得可写时(客户端对套接字执行read操作),套接字产生AE_WRITEABLE事件。 如果一个套接字又可读又可写,那么服务器优先读套接字,后写套接字。 12.1.4 API 12.1.5 文件事件的处理器 1、连接应答处理器 2、命令请求处理器 3、命令回复处理器 12.2 时间事件 Redis的时间事件分为定时事件和周期性事件。 一个时间事件主要由以下三个属性组成: id:服务器为时间事件创建的全局唯一ID。 when:毫秒精度的UNIX时间戳,记录了时间事件的到达时间。 timeProc:时间事件处理器。 一个时间事件是定时事件还是周期性事件取决于时间事件处理器的返回值: 如果事件处理器返回ae.h/AE_NOMORE,事件为定时事件:该事件在达到一次之后就会被删除。 如果事件处理器返回一个非AE_NOMORE的整数值,那么这个事件为周期性事件。 12.2.1 实现 服务器将所有时间事件都放在一个无序链表中,每当时间事件执行器运行时,它就遍历整个链表,查找所有已到达的时间事件,并调用相应的事件处理器。 12.2.2 API 12.2.3 时间事件应用实例:serverCron函数 持续进行的Redis服务器需要定期对自身的资源和状态进行检查和调整,从而确保服务器可以长期、稳定地运行,这些定期操作由redis.c/serverCron函数负责执行,它的主要工作包括: 更新服务器的各类统计信息,比如时间、内存占用、数据库占用情况等。 清理数据库中的过期键值对。 关闭和清理连接失效的客户端。 尝试进行AOF或RDB持久化操作。 如果服务器是主服务器,那么对从服务器进行定期同步。 如果处于集群模式,对集群进行定期同步和连接测试。 12.3 事件的调度与执行 事件的调度和执行规则: aeApiPoll函数的最大阻塞时间由到达时间最接近当前时间的时间事件决定,这个方法既可以避免服务器对时间事件进行频繁的轮询,也可以确保aeApiPoll函数不会阻塞过长时间。 因为文件事件是随机出现的,如果等待并处理完一次文件事件之后,仍未有任何时间事件到达,服务器将再次等待并处理文件事件。 对文件事件和时间事件的处理都是同步、有序、原子地执行地,服务器不会中途中断事件处理,也不会进行抢占,因此,不管是文件事件地处理器,还是时间事件地处理器,它们都会尽可能地减少程序地阻塞时间,并在有需要时主动让出执行权,从而降低造成事件饥饿地可能性。 因为时间事件在文件事件之后执行,并且事件之间不会出现抢占,所以时间事件地实际处理时间,通常会比时间事件设定的到达时间稍晚一些。 12.4 重点回顾 Redis服务器时一个事件驱动程序,服务器处理的事件分为时间事件和文件事件两类。 文件事件处理器是基于Reactor模式出现的网络通信程序。 文件事件是对套接字操作的抽象:每次套接字变为可应答(acceptable)、可写(writable)或者可读(readable)时,相应的文件事件就会产生。 文件事件分为AE_READABLE事件和AE_WRITEABLE事件两类。 时间事件分为定时事件和周期性事件。 服务器在一般情况下只执行serverCron函数一个时间函数,并且这个事件是周期性事件。 文本事件和时间事件之间是合作关系,服务器会轮流处理这种事件,并且处理事件的过程中也不会产生抢占。 时间事件的实际处理时间通常会比设定的到达时间晚一些。

优秀的个人博客,低调大师

虚拟主机上云笔记(序言)

为什么突然讲到虚拟主机上了呢?因为暂时不考虑用服务器。主要考虑如下。 虚拟主机的空间大小一般比服务器小许多。多数虚拟主机空间在1G左右就是上限,而服务器的话就比较大--服务器配置里的系统盘大小扣除安装系统后的空间就类似虚拟主机的网页空间。以阿里云为例起步就是40G,假若装系统占用3G,装各种环境数据库再占2G,不习惯代码操作安装面板又占1G的话(这已经是尽量往算了)加起来也就6G,40减6等于34,也就是还有34G,如果一个虚拟主机的网页空间是1G的话,那么只算容量的话一台服务器等于34个虚拟主机!(再次强调是理想状态) 假如1个虚拟空间能放1个网站,34G就能放34个网站----挣大了很开心?先别忙着乐,实际中一台服务器能运行10个网站就够呛了。因为系统盘只是一个指标,除非要放的34个网站都是纯静态无数据库的网站(一旦产生数据,数据库一样占系统盘空间),而且34个网站要多少域名?总不能介绍时拿着34个IP去介绍吧,况且国内多数服务器的话要求绑定的域名必须备案,要是买阿里云ECS用服务器备案的话一台能备5个(用虚拟主机备的话一台只能备一个),当然可以买海外服务器走免备线路。但新的问题又来了:海外线路的话走海底光缆,可能国内可能不稳定(就像从北京到西安可以坐飞机直达你偏不非要买张机票从北京到伦敦再从伦敦到纽约再从纽约到上海最后上海飞西安) 当然如果你是大公司资金充足的话,可以通过一次买两台服务器一台走国内一台走海外解决。或者更大点直接在海外建立分中心解决。然而用云服务器的话大概中小企业偏多,大如阿里华为这样的企业怕是早就自建机房去了。 闲扯一段,我觉得大有大的方法,小有小的门路。记得去年有个应用软件叫超信,其实背景也不小---董事长是六间房创始人,而且问世第一天就要终结微信。然后?没有然后了。这倒让我想起几年前,国外也盛行把新引擎宣传为谷歌杀手的说法,几年之后,谷歌是越来越大,谷歌杀手的消息倒越来越少。 继续正题。 一个网站无论是在服务器还是虚拟主机上运行,四个重要因素是:空间,核数,内存,带宽。能升级的也主要是这四项。 那么怎么升呢? 空间:这个和你的网站程序大小有关,我现在的整个网站程序大小连100M都不到,用1G的虚拟主机都绰绰有余,更不要说服务器了。假若把服务器比作一间80平的新房子,我在新房子装修完毕(部署环境)后只放一个小家具就不管了,是不是过于壕气冲天?小户型(虚拟主机)能解决的事,就不劳烦大户型了。虽然阿里云的主机数据库20M不大,但我目前的数据库整个不足10M空间还够。因为网站可以注册会员可能后期数据库会变大,不过到时再说呗,升级并不难,而且倒腾数据库什么的,so easy 核数,这影响的是网站自身运算速度,如果你搭建的网站是一个电子商城,那么核数至少要双核起,运营的电商常用的配置是:核数2核,内存4G,带宽3M。虽然虚拟主机也能搭商城,但是如果是搭建好要运营的话,你会发现订单多的时候,单核处理起来很慢,慢到什么程度?就好比买一台电脑,你希望CPU是单核还是多核? 内存,这影响的是访客打开你的网站的速度。打个比方你用电脑玩网游时,CPU和内存都会影响到你的游戏流畅性。内存也叫RAM,全称random access memory(随机存储),与之对应的是ROM,Read-Only Memory(只读存储),用计算机原理比喻的话,信息最小单元是栈,RAM就好比一个可以放栈也可以清栈的容器,ROM就像一个放栈容易取栈难的容器(RAM数据冗杂可以手动清除,ROM只能恢复初始化了,手机ROM刷机的一项重要内容就是初始化,所以刷机前都会提示导出重要备份,否则一刷机意味着数据全都没了) 带宽,严格说来选服务器或主机空间的话优先考虑以上三个,这个其实属于外部了---因为带宽流量经常一起提,就并在一起说了。阿里云的服务器可以按固定带宽付费也支持按量付费。这个做视频网站的会特别在意。对于带宽我做个不形象的比喻,想访问你网站的用户和你的网站间隔着一条河,唯一的连接是一段钢管。带宽的大小就像钢管的粗细。如果有10个用户同时想去你的网站而钢管只容2个人同时通过的话就容易阻塞,网站的建设者可以通过买带宽的方式把钢管扩大成可以容10个人同时通过。 以上是一点小经验吧,附上我的一个网站(目前配置:1核1G1M,月流量10G) http://www.biohazd.wang/

优秀的个人博客,低调大师

HBase数据结构(读书笔记 )

背景: 最近在做一些跟大数据相关的东西,涉及到数据的存储和分析,考虑各个方面,选择使用HBase进行存储,使用原生Java API进行数据分析,之后会陆续写一系列来说明最近做的东西,给像我这样未曾涉及过这个领域的人一点儿idea。 引言: HBase以表的方式组织数据源,这一点跟关系型数据库时一样的,在我们的application里面,通过API/Thrift、或者各种SQL引擎,将数据存入库里面或者进行查询;Hbase的表由行(Row)和列(Column)共同构成,与关系型数据库不同的是,HBase有一个列族(Column Family)的概念,它将一列或者多列组织在一起,HBase的列必须属于某一个列族。 行和列的交叉点称为单元格(Cell),单元格是版本化的。单元格的内容也就是列的值是不可分割的字节数组,以二进制的形式存储。HBase没有数据类型,任何列值都被转换成字符数组进行存储。HBase表中的行是通过行键(Rowkey)来进行区分的,行健也是用来唯一确定一行的标识,不同的行健嗲表不同的行,行健也是一段字节数组,不论是字符串还是数字,最终都会被转换成自己数组进行存储。HBase表中的行是按照RowKey排序的,排序方式采用字典顺序,所有表中的行都必须有RowKey。 逻辑模型 HBase是一个类似GoogleBigTable的开源分布式数据库,它最基本的单位是列,一列或者多列组成行,行有行健,每一行的行健都是唯一的,相同的行健的插入操作被认为是对同一行的操作,也就是说如果做了两次写入操作,而行健是同一个,那么后面的操作可以认为是对改行的某些列的更新操作。 列名是右列族前缀和修饰符连接而成,分隔符是应为冒号。 物理模型 在逻辑模型中,表可以被看成一个稀疏的行的集合。但是在物理上,表是按照列分开存储的。HBase的列是按照列族分组的,HFile是面向列的,存放行的不同的列的物理文件,一个列族的数据存放在多个HFile中,最重要的是一个列族的数据会被同一个Region管理,物理上存放在一起。Region是管理HFile的一种机制。

优秀的个人博客,低调大师

Python 学习笔记 - socketserver源代码剖析

前面学习的例子都是单线程的socket收发;如果有多个用户同时接入,那么除了第一个连入的,后面的都会处于挂起等待的状态,直到当前连接的客户端断开为止。 通过使用socketserver,我们可以实现并发的连接。 socketserver的使用很简单: 首先看个简单的例子 服务端: 自己定义一个类,继承socketserver.baserequesthandler; 然后定义一个方法 handle() 然后通过socketserver.threadingTCPServer指定套接字和自己定义的类,每次当客户端连入的时候,会自动实例化一个对象,然后通过server_forever()不断循环读写数据。 #!/usr/bin/envpython #-*-coding:utf-8-*- #AuthorYuanLi importsocketserver classmysocketserver(socketserver.BaseRequestHandler): defhandle(self): conn=self.request conn.sendall(bytes("WelcometotheTestsystem.",encoding='utf-8')) whileTrue: try: data=conn.recv(1024) iflen(data)==0:break print("[%s]sends%s"%(self.client_address,data.decode())) conn.sendall(data.upper()) exceptException: break if__name__=='__main__': server=socketserver.ThreadingTCPServer(('127.0.0.1',8009),mysocketserver) server.serve_forever() 客户端: #!/usr/bin/envpython #-*-coding:utf-8-*- #AuthorYuanLi importsocket ip_port=('127.0.0.1',8009) s=socket.socket() s.connect(ip_port) data=s.recv(1024) print(data.decode()) whileTrue: send_data=input("Data>>>") s.send(bytes(send_data,encoding='utf-8')) recv_data=s.recv(1024) print(recv_data.decode()) 上面的效果是多个客户端可以同时连入服务器,输入字母,返回大写字母。 客户端没啥好说的,这个和单线程的操作一样;但是服务器咋一看很混乱。我们可以通过剖析源码来弄清他的执行过程。 这个类的基本结构是如下所示的,我们按照顺序来跑一次看看他怎么调用的 1. 首先执行的这句话,很明显ThredingTCPServer是一个类,点进去看看他的实例化过程 server=socketserver.ThreadingTCPServer(('127.0.0.1',8009),mysocketserver) 2. 点着Ctrl键,点击这个类,PyCharm会自动打开对应的源码,可以看见这个类又继承了两个父类ThredingMixIn和TCPServer classThreadingTCPServer(ThreadingMixIn,TCPServer):pass 因为他的内容是pass,啥也没做,根据继承的顺序,我们继续往上(从左到右)找init构造函数; 3. ThreadingMixIn里面没有构造函数,那就继续往右找,TCPServer里面倒是有构造函数,但是他又调用了他父类BaseServer的构造函数,顺着看上去,发现他就是封装了几个值在里面,注意 self.RequestHandlerClass = RequestHandlerClass把我们自己定义的类传进去了 def__init__(self,server_address,RequestHandlerClass): """Constructor.Maybeextended,donotoverride.""" self.server_address=server_address self.RequestHandlerClass=RequestHandlerClass self.__is_shut_down=threading.Event() self.__shutdown_request=False 4.接下来,在TCPServer的构造函数里面,他执行了bind,listen的操作,这个和单线程的操作是一样的。到此为止,一个初始化的过程基本就完成了。 5.接下来,执行了server.serve_forever()的操作,我们看看内部是怎么调用的。在这个函数里面,使用了selector的IO多路复用的技术,循环的读取一个文件的操作。接着调用了_handle_request_noblock()函数 try: #XXX:Considerusinganotherfiledescriptororconnectingtothe #sockettowakethisupinsteadofpolling.Pollingreducesour #responsivenesstoashutdownrequestandwastescpuatallother #times. with_ServerSelector()asselector: selector.register(self,selectors.EVENT_READ) whilenotself.__shutdown_request: ready=selector.select(poll_interval) ifready: self._handle_request_noblock() self.service_actions() 6.每次调用函数的时候都记住查找的顺序,从下往上,从左往右,最后在最上面的BaseServer再次找到这个函数,这个函数里面又调用了 process_request函数 """ try: request,client_address=self.get_request() exceptOSError: return ifself.verify_request(request,client_address): try: self.process_request(request,client_address) 一定要记住继承的顺序!!顺序!!顺序!! 因为baseserver自己有process_request的方法,ThreadingTCPServer也有同名的方法,当他调用的时候,按照顺序,是执行的ThreadingTCPServer里面的方法!! 可以看见他开了一个多线程 defprocess_request(self,request,client_address): """Startanewthreadtoprocesstherequest.""" t=threading.Thread(target=self.process_request_thread, args=(request,client_address)) t.daemon=self.daemon_threads t.start() 在他调用的process_request_thread里面,他又调用了finsih_request defprocess_request_thread(self,request,client_address): """SameasinBaseServerbutasathread. Inaddition,exceptionhandlingisdonehere. """ try: self.finish_request(request,client_address) self.shutdown_request(request) except: self.handle_error(request,client_address) self.shutdown_request(request) finish_request里面有对我们自定义的类做了一个实例化的操作 deffinish_request(self,request,client_address): """FinishonerequestbyinstantiatingRequestHandlerClass.""" self.RequestHandlerClass(request,client_address,self) 因为我们自定义的类没有构造函数,他会去父类寻找,父类里面会尝试执行handle()方法,这就是为什么我们需要在自定义的类里面定义一个同名的方法,然后把所有需要执行的内容都放在这里。 def__init__(self,request,client_address,server): self.request=request self.client_address=client_address self.server=server self.setup() try: self.handle() 到此,socketserver一个完整的过程就结束了

优秀的个人博客,低调大师

Hadoop学习笔记一:单节点安装

通过本节的学习,可以掌握如何在单节点上使用Hadoop进行Map/Reduce以及HDFS存储的实现。 环境要求: 支持的平台: 支持GNU/Linux平台,可以作为测试和生产环境使用。Hadoop在2000个节点的生产环境中经受过考验。 支持Win32平台作为测试环境,正式环境的测试还不够充分,所以发布版暂时不能支持Win32环境。 需要的软件: 1、Java 1.6.x,必须。 2、ssh、sshd,必须。 如果是在Windows环境下,你也许需要 Cygwin。 安装必要的软件 如果服务器没有必要的软件,就必须进行安装。不同的发行版本,有不同的安装方法。例如Ubuntu下: $ sudo apt-get install ssh $ sudo apt-get install rsync 下载Hadoop 从 这里 下载一个Hadoop的稳定版本。 开始我们的Hadoop之旅 解压下载的软件,在解压后的目录中,编辑 conf/hadoop-env.sh 脚本设置服务器的JAVA_HOME目录。 我的环境是 Centos6.0,yum安装了OPEN-JDK,对应的目录为: /usr/lib/jvm/java-1.6.0-openjdk-1.6.0.0/jre/ 执行 bin/hadoop 命令,如果如下图所示,我们就做好使用 Hadoop 的准备了。 可以用三种方式使用Hadoop: 本地模式(Local Standalone Mode); 伪分布式模式(Pseudo-Distributed Mode); 完全分布式模式; 本地模式 默认情况下,Hadoop是配置为本地运行的,以一个单独的Java进程运行,这种方式非常适合Debug。 在本地,我选择了对 194Mb 的访问日志进行分析,如下代码: bin/hadoop jar hadoop-examples-0.20.203.0.jar grep input/ output/ 'favicon[a-z.]+' 这个任务是分析日志中出现的favicon的次数,统计结果如下: 其中part文件中存储了我要查找的favicon字符串出现的次数。 伪分布式模式 配置: 参照官方的配置进行,分别对conf/core-site.xml、conf/hdf-site.xml、conf/mapred-site.xml进行配置。配置的内容都比较类似,主要是配置一个服务器的主机名,然后配置对应的IP或值。 设置无需密码的SSH: 按照官方的设置 $ ssh-keygen -t dsa -P '' -f ~/.ssh/id_dsa $ cat ~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys 但是第一次登陆的时候始终需要提示是否保存,这个有点不得其解。 执行: 首先格式化一个新的分布式文件系统 $ bin/hadoop namenode -format 完成后,会有一些提示,根据提示可以在 /tmp/hadoop-root/dfs 中找到两个文件夹。 然后启动 Hadoop 的守护进程 $ bin/start-all.sh 我在安装的过程中提示了未知的jvm参数,但是并没有重大的影响,启动仍正常结束了,不知道什么原因。 这个问题是因为用root用户启动造成的,可以参考参考资料6中的方法,为hadoop这个文件打一个patch就可以解决。然后重新格式化namenode,进行测试。 bin/hadoop jar hadoop-examples-0.20.203.0.jar grep logs output 'favicon' 执行上面的语句,可以对日志进行 WordCount 的分析。 测试完成后,可以关闭所有的服务 bin/stop-all.sh 参考资料: 1、Single Node Setup 2、Hdfs Shell Handbook 3、Hdfs error:could only be replicated to 0 nodes instead of 1 4、Hadoop:Could not create Java Virtual Machine 5、Namenode not starting 6、Faile to start datanode while start-dfs.sh is executed by root user

优秀的个人博客,低调大师

liunx查看进程占用资源情况的笔记

查看单个进程资源 ``` ps -aux|head -1;ps -aux|grep 16608|grep -v grep ``` 查看最耗资源的10个进程, k3是cpu,k4是实际内存, k5是虚拟内存 ``` ps -aux|head -1;ps -aux|sort -rn -k3/k4/k5|head -10 ``` 参数含义 ``` PID:进程的ID USER:进程所有者 %CPU:进程占用CPU的使用率 %MEM:进程使用的物理内存和总内存的百分比 VSZ:进程占用的虚拟内存 RSS:进程占用的物理内存 TTY: 与进程关联的终端(tty) STAT:进程的状态。S表示休眠,R表示正在运行,Z表示僵死状态,N表示该进程优先值为负数 START:启动日期 TIME:该进程启动后占用的总的CPU时间,即占用CPU使用时间的累加值。 COMMAND:进程启动命令名称 ```

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册