首页 文章 精选 留言 我的

精选列表

搜索[反编译工具],共10000篇文章
优秀的个人博客,低调大师

Jaeger分布式跟踪工具初探

官方文档 Jaegertracing Jaeger简介 Jaeger:开源的端到端分布式跟踪,监视复杂的分布式系统中的事务并进行故障排除。下图对比了常用的开源全链路追踪方案,目前SkyWalking和Pinpoint使用比较多,Jaeger相比客户端支持语言比较多,特别是对C++的支持,所以这次选择测试下。 Jaeger解决的问题 分布式事务监控 性能和延迟优化 根本原因分析 服务依赖性分析 分布式上下文传播 Jaeger架构图 Jaeger组件 Jaeger Agent,负责和客户端通信,把收集到的追踪信息上报个收集器 Jaeger Collector Jaeger Colletor把收集到的数据存入数据库或者其它存储器 Jaeger Query 负责对追踪数据进行查询 Jaeger Ingester 是一个从Kafka主题读取并写入另一个存储后端(Cassandra、Elasticsearch)的服务 Jaeger UI负责用户交互 Jaeger端口统计 Agent5775 UDP协议,接收兼容zipkin的协议数据6831 UDP协议,接收兼容jaeger的兼容协议6832 UDP协议,接收jaeger的二进制协议5778 HTTP协议,数据量大不建议使用 Collector14267 tcp agent发送jaeger.thrift格式数据14250 tcp agent发送proto格式数据(背后gRPC)14268 http 直接接受客户端数据14269 http 健康检查 Query16686 http jaeger的前端,放给用户的接口16687 http 健康检查 Jaeger部署 1.创建命名空间 [root@VM-0-123-centos jaeger]# kubectl create namespace jaeger 2.部署Jaeger-OperatorJaeger Operator:Jaeger Operator for Kubernetes简化了在Kubernetes上的部署和运行Jaeger。Jaeger Operator是Kubernetes operator的实现。操作员是一种软件,可以减轻运行另一软件的操作复杂性。从技术上讲,操作员是打包,部署和管理Kubernetes应用程序的一种方法。Jaeger Operator版本跟踪Jaeger组件(查询,收集器,代理)的一种版本。发行新版本的Jaeger组件时,将发行新版本的操作员,该操作员了解如何将先前版本的运行实例升级到新版本。 [root@VM-0-123-centos jaeger]# kubectl create -n jaeger -f https://raw.githubusercontent.com/jaegertracing/jaeger-operator/master/deploy/crds/jaegertracing.io_jaegers_crd.yaml [root@VM-0-123-centos jaeger]# kubectl create -n jaeger -f https://raw.githubusercontent.com/jaegertracing/jaeger-operator/master/deploy/service_account.yaml [root@VM-0-123-centos jaeger]# kubectl create -n jaeger -f https://raw.githubusercontent.com/jaegertracing/jaeger-operator/master/deploy/role.yaml [root@VM-0-123-centos jaeger]# kubectl create -n jaeger -f https://raw.githubusercontent.com/jaegertracing/jaeger-operator/master/deploy/role_binding.yaml [root@VM-0-123-centos jaeger]# kubectl create -n jaeger -f https://raw.githubusercontent.com/jaegertracing/jaeger-operator/master/deploy/operator.yaml 查看状态 [root@VM-0-123-centos jaeger]# kubectl get all -n jaeger NAME READY STATUS RESTARTS AGE pod/jaeger-operator-6ff67bdd4b-4nffk 1/1 Running 0 14d pod/simple-prod-collector-59fc47bf5c-h26mq 0/1 Terminating 0 9d NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE service/jaeger-operator-metrics ClusterIP 172.20.253.138 <none> 8383/TCP,8686/TCP 14d NAME READY UP-TO-DATE AVAILABLE AGE deployment.apps/jaeger-operator 1/1 1 1 14d NAME DESIRED CURRENT READY AGE replicaset.apps/jaeger-operator-6ff67bdd4b 1 1 1 14d 3.创建jaeger实例创建jaeger.yaml文件,配置ES集群及限制Deployment/simple-prod-collector容器的cpu和内存使用大小。最大数量可以起10个pod。 apiVersion: jaegertracing.io/v1 kind: Jaeger metadata: name: simple-prod spec: strategy: production storage: type: elasticsearch options: es: server-urls: http://10.0.16.3:9200 index-prefix: zhjt collector: maxReplicas: 10 resources: limits: cpu: 500m memory: 512Mi [root@VM-0-123-centos jaeger]# kubectl apply -f jaeger.yaml -n jaeger jaeger.jaegertracing.io/simple-prod created 列出jaeger对象备注:貌似使用官网all in one的例子状态是正常的Running,这里状态虽然是Failed,但是不影响使用。 [root@VM-0-123-centos jaeger]# kubectl get jaegers -n jaeger NAME STATUS VERSION STRATEGY STORAGE AGE simple-prod Failed 1.22.0 production elasticsearch 9d 获取pod名字 [root@VM-0-123-centos jaeger]# kubectl get pods -l app.kubernetes.io/instance=simple-prod -n jaeger NAME READY STATUS RESTARTS AGE simple-prod-collector-59fc47bf5c-h26mq 1/1 Running 0 9d simple-prod-query-85689b7bbd-g5jw9 2/2 Running 0 9d 获取pod日志 [root@VM-0-123-centos jaeger]# kubectl logs simple-prod-query-85689b7bbd-g5jw9 jaeger-agent -n jaeger 2021/04/28 04:55:34 maxprocs: Leaving GOMAXPROCS=4: CPU quota undefined {"level":"info","ts":1619585734.2081811,"caller":"flags/service.go:117","msg":"Mounting metrics handler on admin server","route":"/metrics"} {"level":"info","ts":1619585734.2082183,"caller":"flags/service.go:123","msg":"Mounting expvar handler on admin server","route":"/debug/vars"} {"level":"info","ts":1619585734.2083232,"caller":"flags/admin.go:105","msg":"Mounting health check on admin server","route":"/"} {"level":"info","ts":1619585734.2083883,"caller":"flags/admin.go:111","msg":"Starting admin HTTP server","http-addr":":14271"} {"level":"info","ts":1619585734.2084124,"caller":"flags/admin.go:97","msg":"Admin server started","http.host-port":"[::]:14271","health-status":"unavailable"} {"level":"info","ts":1619585734.2089527,"caller":"grpc/builder.go:70","msg":"Agent requested insecure grpc connection to collector(s)"} {"level":"info","ts":1619585734.2089992,"caller":"grpc@v1.29.1/clientconn.go:243","msg":"parsed scheme: \"dns\"","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.21038,"caller":"command-line-arguments/main.go:84","msg":"Starting agent"} {"level":"info","ts":1619585734.2104166,"caller":"healthcheck/handler.go:128","msg":"Health Check state change","status":"ready"} {"level":"info","ts":1619585734.2108943,"caller":"grpc/builder.go:108","msg":"Checking connection to collector"} {"level":"info","ts":1619585734.210908,"caller":"grpc/builder.go:119","msg":"Agent collector connection state change","dialTarget":"dns:///simple-prod-collector-headless.jaeger.svc:14250","status":"IDLE"} {"level":"info","ts":1619585734.211061,"caller":"app/agent.go:69","msg":"Starting jaeger-agent HTTP server","http-port":5778} {"level":"info","ts":1619585734.3344934,"caller":"grpc@v1.29.1/resolver_conn_wrapper.go:143","msg":"ccResolverWrapper: sending update to cc: {[{172.20.0.88:14250 <nil> 0 <nil>}] <nil> <nil>}","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.3345578,"caller":"grpc@v1.29.1/clientconn.go:667","msg":"ClientConn switching balancer to \"round_robin\"","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.3345697,"caller":"grpc@v1.29.1/clientconn.go:682","msg":"Channel switches to new LB policy \"round_robin\"","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.3346283,"caller":"grpc@v1.29.1/clientconn.go:1056","msg":"Subchannel Connectivity change to CONNECTING","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.33467,"caller":"grpc@v1.29.1/clientconn.go:1193","msg":"Subchannel picks a new address \"172.20.0.88:14250\" to connect","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.334736,"caller":"grpc@v1.29.1/clientconn.go:417","msg":"Channel Connectivity change to CONNECTING","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.3347983,"caller":"grpc/builder.go:119","msg":"Agent collector connection state change","dialTarget":"dns:///simple-prod-collector-headless.jaeger.svc:14250","status":"CONNECTING"} {"level":"info","ts":1619585734.335669,"caller":"grpc@v1.29.1/clientconn.go:1056","msg":"Subchannel Connectivity change to READY","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.3357751,"caller":"base/balancer.go:200","msg":"roundrobinPicker: newPicker called with info: {map[0xc0002f5ea0:{{172.20.0.88:14250 <nil> 0 <nil>}}]}","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.3357947,"caller":"grpc@v1.29.1/clientconn.go:417","msg":"Channel Connectivity change to READY","system":"grpc","grpc_log":true} {"level":"info","ts":1619585734.335807,"caller":"grpc/builder.go:119","msg":"Agent collector connection state change","dialTarget":"dns:///simple-prod-collector-headless.jaeger.svc:14250","status":"READY"} {"level":"info","ts":1619592172.4516647,"caller":"grpc@v1.29.1/clientconn.go:1056","msg":"Subchannel Connectivity change to CONNECTING","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.4517512,"caller":"grpc@v1.29.1/clientconn.go:1193","msg":"Subchannel picks a new address \"172.20.0.88:14250\" to connect","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.4517596,"caller":"base/balancer.go:200","msg":"roundrobinPicker: newPicker called with info: {map[]}","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.4517772,"caller":"grpc@v1.29.1/clientconn.go:417","msg":"Channel Connectivity change to CONNECTING","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.4517884,"caller":"grpc/builder.go:119","msg":"Agent collector connection state change","dialTarget":"dns:///simple-prod-collector-headless.jaeger.svc:14250","status":"CONNECTING"} {"level":"warn","ts":1619592172.4523218,"caller":"grpc@v1.29.1/clientconn.go:1275","msg":"grpc: addrConn.createTransport failed to connect to {172.20.0.88:14250 <nil> 0 <nil>}. Err: connection error: desc = \"transport: Error while dialing dial tcp 172.20.0.88:14250: connect: connection refused\". Reconnecting...","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.4523551,"caller":"grpc@v1.29.1/clientconn.go:1056","msg":"Subchannel Connectivity change to TRANSIENT_FAILURE","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.452386,"caller":"grpc@v1.29.1/clientconn.go:417","msg":"Channel Connectivity change to TRANSIENT_FAILURE","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.4523947,"caller":"grpc/builder.go:119","msg":"Agent collector connection state change","dialTarget":"dns:///simple-prod-collector-headless.jaeger.svc:14250","status":"TRANSIENT_FAILURE"} {"level":"info","ts":1619592172.6118224,"caller":"grpc@v1.29.1/resolver_conn_wrapper.go:143","msg":"ccResolverWrapper: sending update to cc: {[{172.20.0.178:14250 <nil> 0 <nil>}] <nil> <nil>}","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.6118581,"caller":"grpc@v1.29.1/clientconn.go:1056","msg":"Subchannel Connectivity change to CONNECTING","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.6118758,"caller":"grpc@v1.29.1/clientconn.go:1056","msg":"Subchannel Connectivity change to SHUTDOWN","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.611892,"caller":"grpc@v1.29.1/clientconn.go:417","msg":"Channel Connectivity change to CONNECTING","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.6119003,"caller":"grpc/builder.go:119","msg":"Agent collector connection state change","dialTarget":"dns:///simple-prod-collector-headless.jaeger.svc:14250","status":"CONNECTING"} {"level":"info","ts":1619592172.6119049,"caller":"grpc@v1.29.1/clientconn.go:1193","msg":"Subchannel picks a new address \"172.20.0.178:14250\" to connect","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.612726,"caller":"grpc@v1.29.1/clientconn.go:1056","msg":"Subchannel Connectivity change to READY","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.6127572,"caller":"base/balancer.go:200","msg":"roundrobinPicker: newPicker called with info: {map[0xc0003df970:{{172.20.0.178:14250 <nil> 0 <nil>}}]}","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.6127682,"caller":"grpc@v1.29.1/clientconn.go:417","msg":"Channel Connectivity change to READY","system":"grpc","grpc_log":true} {"level":"info","ts":1619592172.6127849,"caller":"grpc/builder.go:119","msg":"Agent collector connection state change","dialTarget":"dns:///simple-prod-collector-headless.jaeger.svc:14250","status":"READY"} [root@VM-0-123-centos jaeger]# kubectl logs simple-prod-query-85689b7bbd-g5jw9 jaeger-query -n jaeger 2021/04/28 04:55:29 maxprocs: Leaving GOMAXPROCS=4: CPU quota undefined {"level":"info","ts":1619585729.8951077,"caller":"flags/service.go:117","msg":"Mounting metrics handler on admin server","route":"/metrics"} {"level":"info","ts":1619585729.8951416,"caller":"flags/service.go:123","msg":"Mounting expvar handler on admin server","route":"/debug/vars"} {"level":"info","ts":1619585729.8952546,"caller":"flags/admin.go:105","msg":"Mounting health check on admin server","route":"/"} {"level":"info","ts":1619585729.8953054,"caller":"flags/admin.go:111","msg":"Starting admin HTTP server","http-addr":":16687"} {"level":"info","ts":1619585729.8953238,"caller":"flags/admin.go:97","msg":"Admin server started","http.host-port":"[::]:16687","health-status":"unavailable"} {"level":"info","ts":1619585729.9169888,"caller":"config/config.go:183","msg":"Elasticsearch detected","version":7} {"level":"info","ts":1619585729.9174955,"caller":"app/static_handler.go:181","msg":"UI config path not provided, config file will not be watched"} {"level":"info","ts":1619585729.9175768,"caller":"app/server.go:170","msg":"Query server started"} {"level":"info","ts":1619585729.9175944,"caller":"healthcheck/handler.go:128","msg":"Health Check state change","status":"ready"} {"level":"info","ts":1619585729.9176183,"caller":"app/server.go:249","msg":"Starting GRPC server","port":16685,"addr":":16685"} {"level":"info","ts":1619585729.9176335,"caller":"app/server.go:230","msg":"Starting HTTP server","port":16686,"addr":":16686"} 4.查看jaeger资源 [root@VM-0-123-centos jaeger]# kubectl get all -n jaeger NAME READY STATUS RESTARTS AGE pod/jaeger-operator-6ff67bdd4b-4nffk 1/1 Running 0 14d pod/simple-prod-collector-59fc47bf5c-h26mq 1/1 Running 0 8d pod/simple-prod-query-85689b7bbd-g5jw9 2/2 Running 0 8d NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE service/jaeger-operator-metrics ClusterIP 172.20.253.138 <none> 8383/TCP,8686/TCP 14d service/simple-prod-collector ClusterIP 172.20.255.184 <none> 9411/TCP,14250/TCP,14267/TCP,14268/TCP 8d service/simple-prod-collector-headless ClusterIP None <none> 9411/TCP,14250/TCP,14267/TCP,14268/TCP 8d service/simple-prod-query ClusterIP 172.20.254.102 <none> 16686/TCP 8d NAME READY UP-TO-DATE AVAILABLE AGE deployment.apps/jaeger-operator 1/1 1 1 14d deployment.apps/simple-prod-collector 1/1 1 1 8d deployment.apps/simple-prod-query 1/1 1 1 8d NAME DESIRED CURRENT READY AGE replicaset.apps/jaeger-operator-6ff67bdd4b 1 1 1 14d replicaset.apps/simple-prod-collector-59fc47bf5c 1 1 1 8d replicaset.apps/simple-prod-query-85689b7bbd 1 1 1 8d NAME REFERENCE TARGETS MINPODS MAXPODS REPLICAS AGE horizontalpodautoscaler.autoscaling/simple-prod-collector Deployment/simple-prod-collector 1457m/90, 137m/90 1 10 1 8d 如果流量大需要减小es压力,可以接入kafka集群,修改jaeger.yaml文件 apiVersion: jaegertracing.io/v1 kind: Jaeger metadata: name: simple-streaming spec: strategy: streaming collector: options: kafka: producer: topic: jaeger-spans brokers: my-cluster-kafka-brokers.kafka:9092 #修改为kafka地址 ingester: options: kafka: consumer: topic: jaeger-spans brokers: my-cluster-kafka-brokers.kafka:9092 #修改为kafka地址 ingester: deadlockInterval: 5s storage: type: elasticsearch options: es: server-urls: http://elasticsearch:9200 #修改为ES地址 5.agent部署 jaeger client的一个代理程序,client将收集到的调用链数据发给agent,然后由agent发给collector。由于使用的udp协议,一般部署在靠近client的位置。 agent有多种安装方式 1).docker安装 下载:jaegertracing/jaeger-agent Tags (docker.com) docker run -d -p 6831:6831/udp -p 6832:6832/udp -p 5778:5778/tcp jaegertracing/jaeger-agent:1.12 --reporter.grpc.host-port=xx.xx.xx.xx:14250 2).k8s安装又分两种 sidecar方式 daemonset方式 参考:Operator for Kubernetes — Jaeger documentation (jaegertracing.io) 3).二进制安装 下载:Jaeger – Download Jaeger (jaegertracing.io) nohup ./jaeger-agent --collector.host-port=xxxx:14267 1>1.log 2>2.log &

优秀的个人博客,低调大师

BeetlSQL 3.3.13 发布,Java 的 DAO 工具

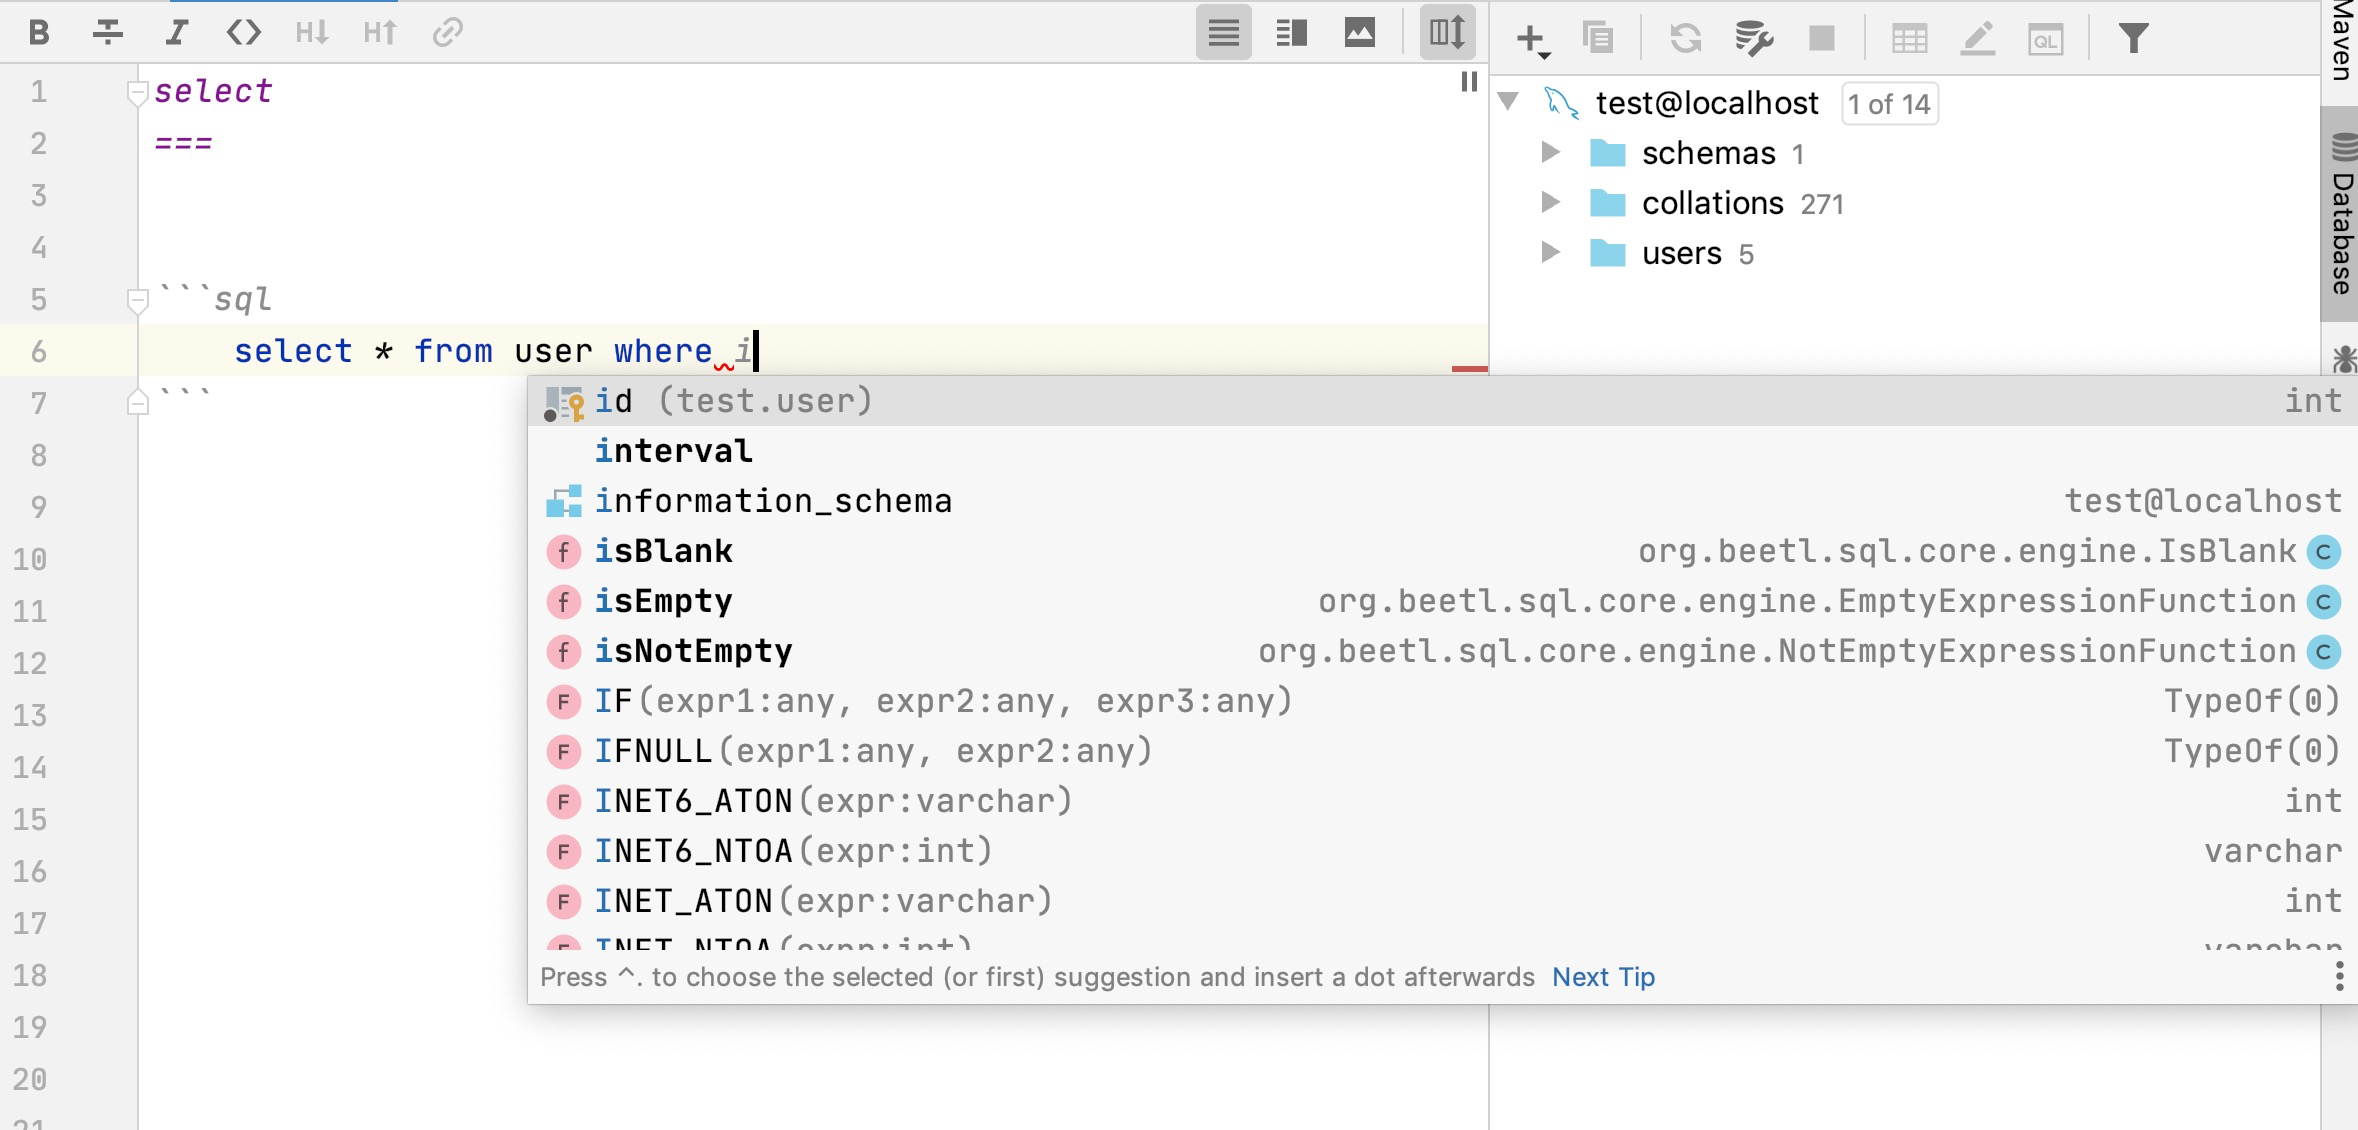
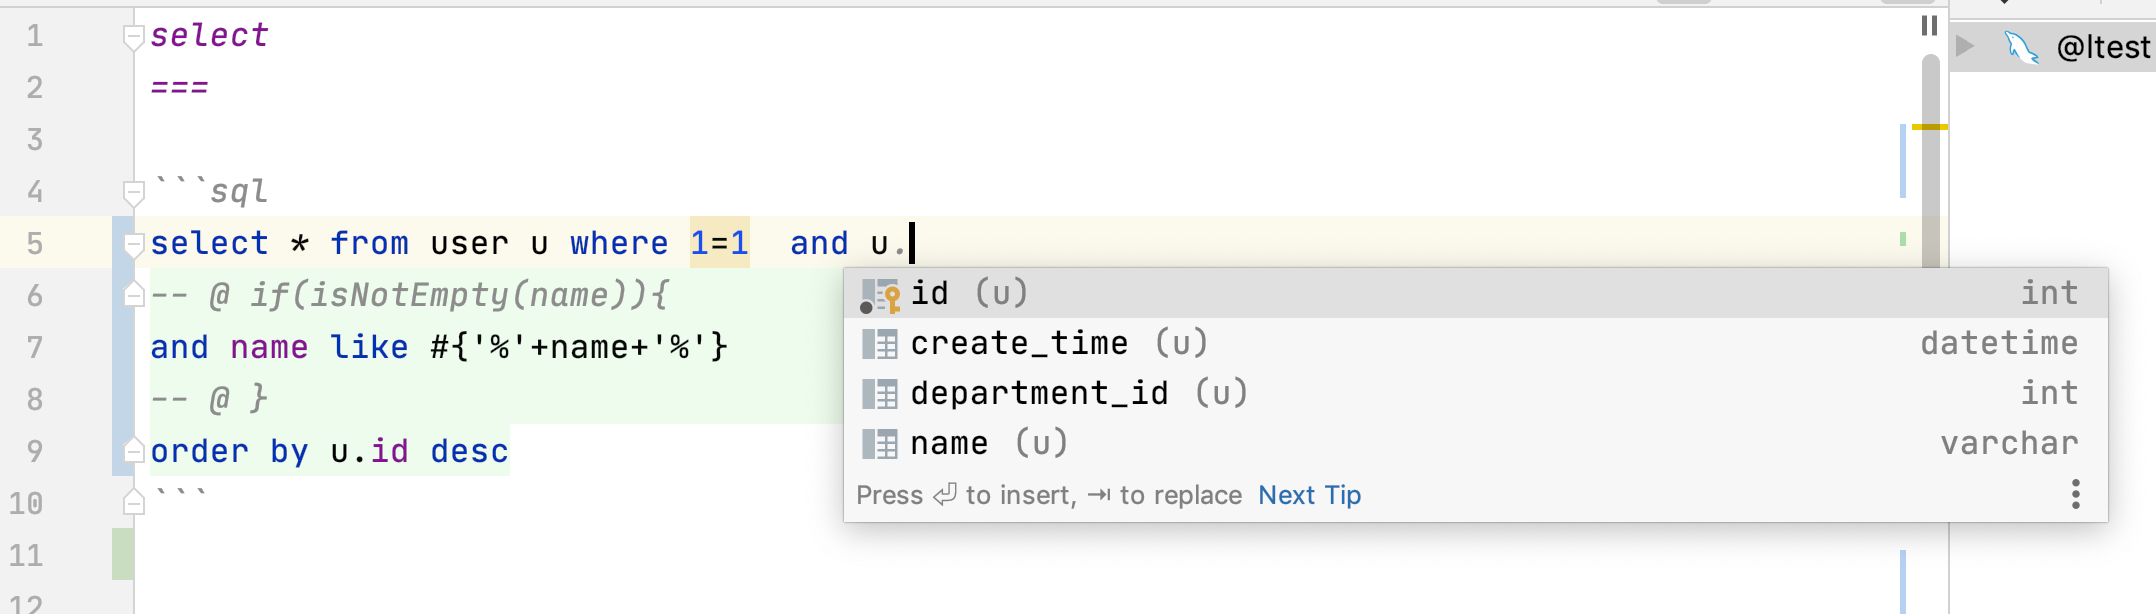
本周又发布了一个修复版本 修复了Saga事物嵌套回滚的Bug 修复注解实现TargetAdditional在翻页查询中不起作用的Bug 感谢网友使用BeetlSQL的高阶功能并给予详细反馈 Saga事务例子 SagaContext sagaContext = SagaContext.sagaContextFactory.current(); try { sagaContext.start(gid); //模拟调用俩个微服务,订单和用户 rest.postForEntity(orderAddUrl, null,String.class, paras); rest.postForEntity(userBalanceUpdateUrl, null,String.class, paras); if (1 == 1) { throw new RuntimeException("模拟失败,查询saga-server 看效果"); } sagaContext.commit(); } catch (Exception e) { log.info("error " + e.getMessage(),e); log.info("start rollback " + e.getMessage()); sagaContext.rollback(); return e.getMessage(); } TargetAdditional 在多租户使用例子,添加租户路由信息 SchemaTenantUser user = sqlManager.unique(SchemaTenantUser.class,1); String sql = "select * from ${schema}.sys_user "; List<SchemaTenantUser> list = sqlManager.execute(sql,SchemaTenantUser.class,new HashMap()); System.out.println(list.get(0)); 模型定义 @Data @Table(name="${schema}.sys_user") @SchemaTenant public static class SchemaTenantUser{ @Auto private Integer id; @Column("name") private String name; } /** * 每个租户一个库 */ @Retention(RetentionPolicy.RUNTIME) @Target(value = {ElementType.TYPE}) @Builder(SchemaTenantContext.class) //注解实现类 public @interface SchemaTenant { } public class SchemaTenantContext implements TargetAdditional { public static ThreadLocal<String> tenantSchemaLocals = new ThreadLocal<>(); @Override public Map<String, Object> getAdditional(ExecuteContext ctx, Annotation an) { String schema = tenantSchemaLocals.get(); if(schema==null){ throw new IllegalStateException("缺少租户信息"); } Map map = new HashMap(); map.put("schema",schema); return map; } } Maven <dependency> <groupId>com.ibeetl</groupId> <artifactId>beetlsql</artifactId> <version>3.3.13-RELEASE</version> </dependency> BeetlSQL 研发自2015年,目标是提供开发高效,维护高效,运行高效的数据库访问框架,它适用范围广,性能高,维护性好,写起数据库访问代码特别顺滑。目前支持的数据库如下 传统数据库:MySQL,MariaDB,Oralce,Postgres,DB2,SQL Server,H2,SQLite,Derby,神通,达梦,华为高斯,人大金仓,PolarDB 等 大数据:HBase,ClickHouse,Cassandar,Hive 物联网时序数据库:Machbase,TD-Engine,IotDB SQL查询引擎:Drill,Presto,Druid 内存数据库:ignite,CouchBase 阅读文档源码和例子在线体验 BeetlSQL也支持IDEA插件,提供向导和自动提示

优秀的个人博客,低调大师

BeetlSQL 3.3.12 发布,Java 的 DAO 工具

本次发布了修改了一个严重的Bug,强烈建议升级 Spring框架下,修复读取metadata时候占用数据库链接而没有释放,导致链接资源池耗光 修复了对boolean 原始类型的的映射支持 增强MySql的KeyHandler 使用新的方式判断系统版本是否是JDK8以上 对所有单元测试中数据库连接池的配置个数设置为1,以方便以后查找链接池泄露问题 感谢使用者的迅速反馈以及指出问题所在,BeetlSQL的用户越来越多,越来越强 <dependency> <groupId>com.ibeetl</groupId> <artifactId>beetlsql</artifactId> <version>3.3.12-RELEASE</version> </dependency> BeetlSQL 研发自2015年,目标是提供开发高效,维护高效,运行高效的数据库访问框架,它适用范围广,性能高,维护性好,写起数据库访问代码特别顺滑。目前支持的数据库如下 传统数据库:MySQL,MariaDB,Oralce,Postgres,DB2,SQL Server,H2,SQLite,Derby,神通,达梦,华为高斯,人大金仓,PolarDB 等 大数据:HBase,ClickHouse,Cassandar,Hive 物联网时序数据库:Machbase,TD-Engine,IotDB SQL查询引擎:Drill,Presto,Druid 内存数据库:ignite,CouchBase 阅读文档源码和例子在线体验 BeetlSQL也支持IDEA插件,提供向导和自动提示

优秀的个人博客,低调大师

BeetlSQL 3.3.10 发布,Java 的 DAO 工具

本次发布做了如下更新: 人大金仓数据库支持,Bug修复 更新sql-solon-plugin::solon 升级为1.3.20 <dependency> <groupId>com.ibeetl</groupId> <artifactId>beetlsql</artifactId> <version>3.3.10-RELEASE</version> </dependency> BeetlSQL 研发自2015年,目标是提供开发高效,维护高效,运行高效的数据库访问框架,它适用范围广,性能高,维护性好,写起数据库访问代码特别顺滑。目前支持的数据库如下 传统数据库:MySQL,MariaDB,Oralce,Postgres,DB2,SQL Server,H2,SQLite,Derby,神通,达梦,华为高斯,人大金仓,PolarDB 等 大数据:HBase,ClickHouse,Cassandar,Hive 物联网时序数据库:Machbase,TD-Engine,IotDB SQL查询引擎:Drill,Presto,Druid 内存数据库:ignite,CouchBase 阅读文档源码和例子在线体验 BeetlSQL也支持IDEA插件,提供向导和自动提示

优秀的个人博客,低调大师

BeetlSQL 3.3.8 发布,Java 的 DAO 工具

本次发布修复了若干Bug TD-Engine中使用内置SQL中,使用where标签代替 1=1,目前版本的TD-Engine不支持sql中1=1的表达式 在一些不支持JDBC metadata的某些NOSql上,屏蔽对POJO的类型检测以避免报错。更好的支持NoSQL 修复在Mapper方法中,使用枚举类,没有经过BeetlSQL对枚举的预处理 代码生成,允许指定数据库日期对应的Java类型 修复加载Markdown文件时候,并发导致加载错误的问题,建议升级 <dependency> <groupId>com.ibeetl</groupId> <artifactId>beetlsql</artifactId> <version>3.3.8-RELEASE</version> </dependency> BeetlSQL 研发自2015年,目标是提供开发高效,维护高效,运行高效的数据库访问框架,以我多年天天CRUD的经验总结得来的框架,适用范围广,性能高,维护性好。目前支持的数据库如下 传统数据库:MySQL,MariaDB,Oralce,Postgres,DB2,SQL Server,H2,SQLite,Derby,神通,达梦,华为高斯,人大金仓,PolarDB 等 大数据:HBase,ClickHouse,Cassandar,Hive 物联网时序数据库:Machbase,TD-Engine,IotDB SQL查询引擎:Drill,Presto,Druid 内存数据库:ignite,CouchBase 阅读文档源码和例子 BeetlSQL也支持IDEA插件,提供向导和自动提示

优秀的个人博客,低调大师

BeetlSQL 3.3.3 发布,Java 的 DAO 工具

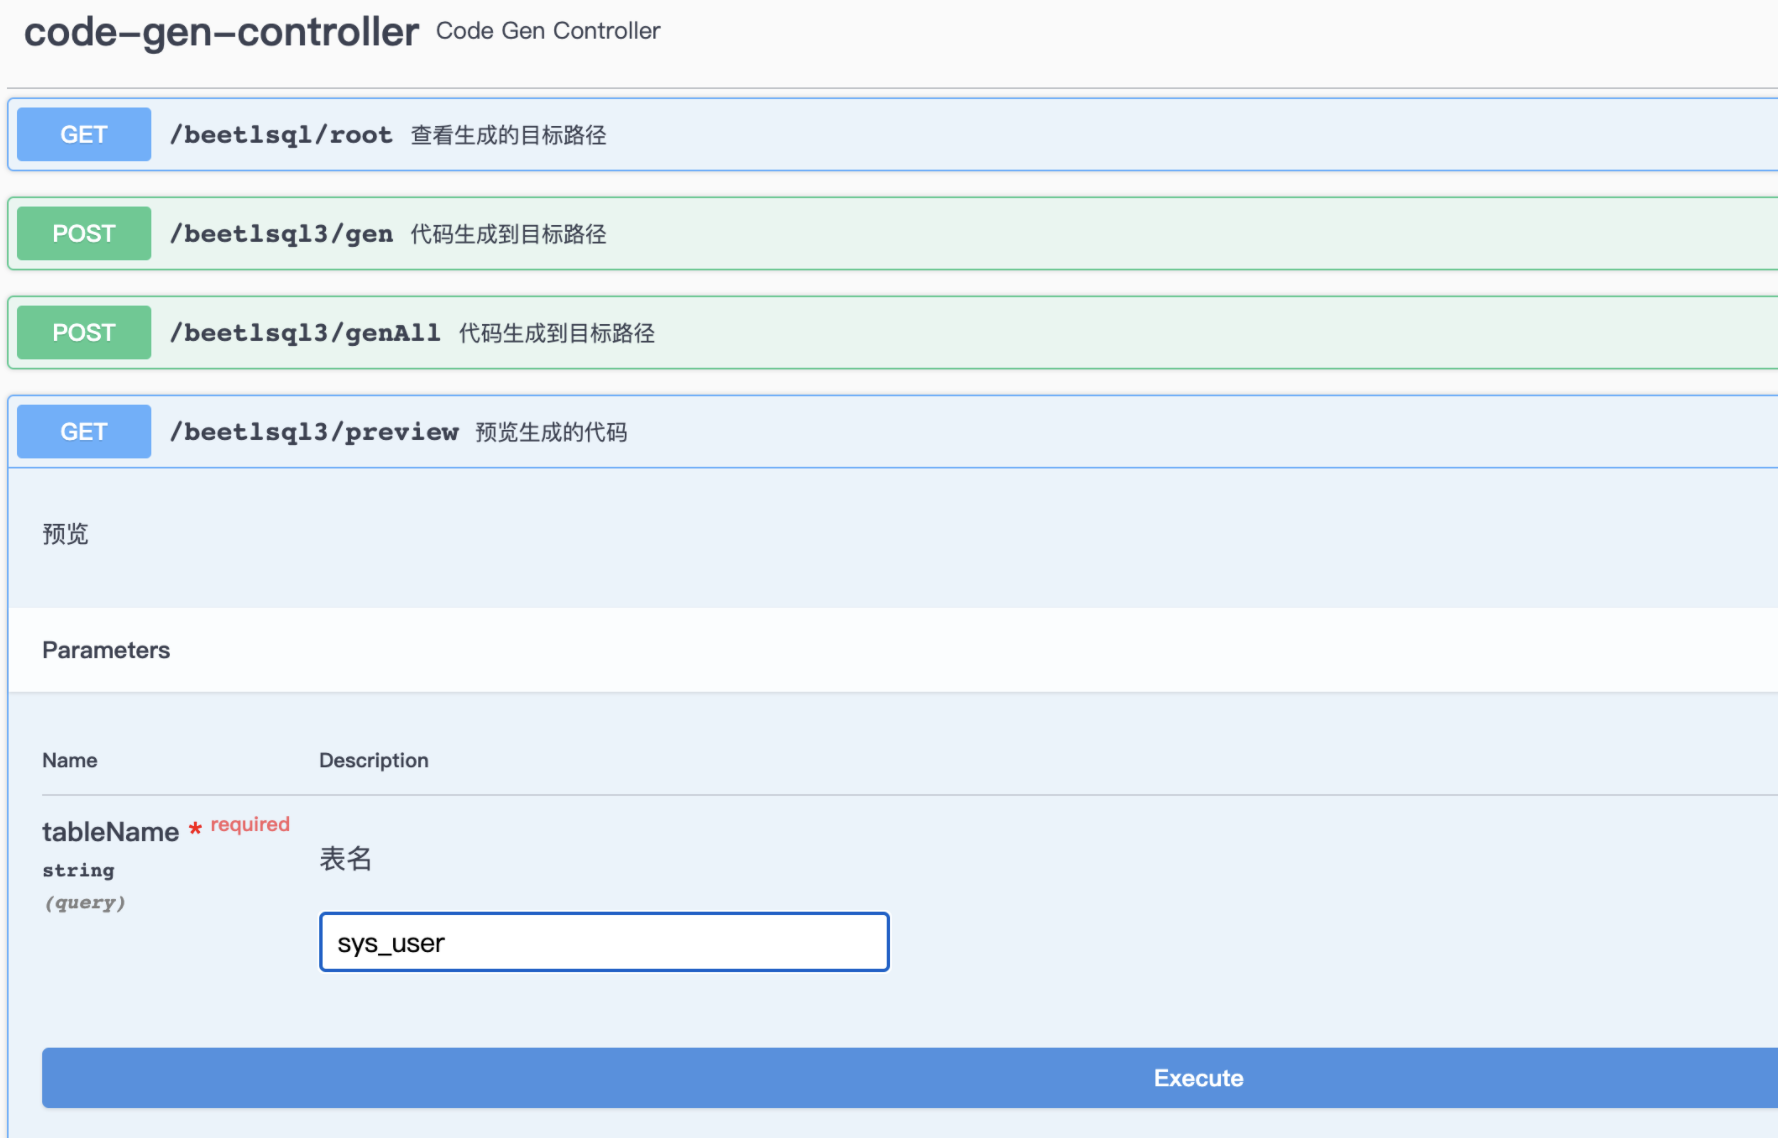
此次发布增强了代码生成功能 SpringBoot集成的时候,可以在有Swagger集成情况下,内置了org.beetl.sql.starter.CodeGenController,一个Rest 接口,用户可以导入此Controller 来为自己系统提供代码生成API。API提供根据表生成Entity,Mapper,Markdown,数据库文档功能,并提供预览,生成到工程,库所有表生成到工程 @Bean public CodeGenController codeGenController() { return new CodeGenController(); } 修复按照JSON配置复杂映射中的bug <dependency> <groupId>com.ibeetl</groupId> <artifactId>beetlsql</artifactId> <version>3.3.3-RELEASE</version> </dependency> BeetlSQL 研发自2015年,目标是提供开发高效,维护高效,运行高效的数据库访问框架,以我20年在电信,金融以及互联网天天CRUD的经验总结得来的框架,适用范围广,性能高,维护性好。目前支持的数据库如下 传统数据库:MySQL,MariaDB,Oralce,Postgres,DB2,SQL Server,H2,SQLite,Derby,神通,达梦,华为高斯,人大金仓,PolarDB 等 大数据:HBase,ClickHouse,Cassandar,Hive 物联网时序数据库:Machbase,TD-Engine,IotDB SQL查询引擎:Drill,Presto,Druid 内存数据库:ignite,CouchBase 阅读文档源码和例子

优秀的个人博客,低调大师

BeetlSQL 3.3.1 发布,Java 的 DAO 工具

实现db.dynamicSql 方法,此方法在从2升级到3的时候,遗漏了其实现。参考例子中的includeDynamicSql unique方法未查询到结果集,抛出的异常信息里增加了 主键信息,以方便在未打开DebugInterceptor的时候仍然能看到错误详细信息 <dependency> <groupId>com.ibeetl</groupId> <artifactId>beetlsql</artifactId> <version>3.3.1-RELEASE</version> </dependency> BeetlSQL 的目标是提供开发高效,维护高效,运行高效的数据库访问框架,以我20年在电信,金融以及互联网天天CRUD的经验总结得来的框架,适用范围广。目前支持的数据库如下 传统数据库:MySQL,MariaDB,Oralce,Postgres,DB2,SQL Server,H2,SQLite,Derby,神通,达梦,华为高斯,人大金仓,PolarDB 等 大数据:HBase,ClickHouse,Cassandar,Hive 物联网时序数据库:Machbase,TD-Engine,IotDB SQL查询引擎:Drill,Presto,Druid 内存数据库:ignite,CouchBase 编译源码 git clone https://gitee.com/xiandafu/beetlsql mvn clean package mvn clean install #如果想修改源码 注意:BeetlSQL3 集成了Spring,以及支持大数据等,就算配置了国内镜像,也可能需要很长时间下载大数据依赖包,为了让编译快速通过,你需要进入pom.xml ,屏蔽sql-integration,sql-db-support,sql-jmh三个模块 <modules> <!--核心功能 --> <module>sql-core</module> <module>sql-mapper</module> <module>sql-util</module> <module>sql-fetech</module> <!-- 打包到一起 --> <module>beetlsql</module> <module>sql-gen</module> <module>sql-test</module> <module>sql-samples</module> <!-- 集成和扩展太多的数据库,可以被屏蔽,以加速项目下载jar --> <!-- <module>sql-integration</module>--> <!-- <module>sql-jmh</module>--> <!-- <module>sql-db-support</module>--> </modules> 阅读源码例子 可以从模块sql-samples中找得到所有例子,或者从sql-test中运行单元测试例子,或者在sql-integration中的各个框架单元测试中找到相关例子。所有例子都是基于H2内存数据库,可以反复运行 以sql-samples为例子 sql-samples 又包含了三个模块大约100个例子 quickstart: BeetlSQL基础使用例子,可以快速了解BeetlSQL3 usuage: BeetlSQL所有API和功能 plugin:BeetlSQL高级扩展实例 以usuage模块为例子,包含如下代码 S01MapperSelectSample 15个例子, mapper中的查询演示 S02MapperUpdateSample 11个例子, mapper中更新操作 S03MapperPageSample 3个例子,mapper中的翻页查询 S04QuerySample 9个例子,Query查询 S05QueryUpdateSample 3个例子,Query完成update操作 S06SelectSample 14个例子,SQLManager 查询API S07InsertSample 8个例子,SQLManager 插入新数据API,主键生成 S08UpdateSample 6个例子,更新数据 S09JsonMappingSample 5个例子, json配置映射 S10FetchSample 2个例子,关系映射 S11BeetlFunctionSample 2个例子,自定义sql脚本的方法 代码示例 例子1,内置方法,无需写SQL完成常用操作 UserEntity user = sqlManager.unique(UserEntity.class,1); user.setName("ok123"); sqlManager.updateById(user); UserEntity newUser = new UserEntity(); newUser.setName("newUser"); newUser.setDepartmentId(1); sqlManager.insert(newUser); 输出日志友好,可反向定位到调用的代码 ┏━━━━━ Debug [user.selectUserAndDepartment] ━━━ ┣ SQL: select * from user where 1 = 1 and id=? ┣ 参数: [1] ┣ 位置: org.beetl.sql.test.QuickTest.main(QuickTest.java:47) ┣ 时间: 23ms ┣ 结果: [1] ┗━━━━━ Debug [user.selectUserAndDepartment] ━━━ 例子2 使用SQL String sql = "select * from user where id=?"; Integer id = 1; SQLReady sqlReady = new SQLReady(sql,new Object[id]); List<UserEntity> userEntities = sqlManager.execute(sqlReady,UserEntity.class); //Map 也可以作为输入输出参数 List<Map> listMap = sqlManager.execute(sqlReady,Map.class); 例子3 使用模板SQL String sql = "select * from user where department_id=#{id} and name=#{name}"; UserEntity paras = new UserEntity(); paras.setDepartmentId(1); paras.setName("lijz"); List<UserEntity> list = sqlManager.execute(sql,UserEntity.class,paras); String sql = "select * from user where id in ( #{join(ids)} )"; List list = Arrays.asList(1,2,3,4,5); Map paras = new HashMap(); paras.put("ids", list); List<UserEntity> users = sqlManager.execute(sql, UserEntity.class, paras); 例子4 使用Query类 支持重构 LambdaQuery<UserEntity> query = sqlManager.lambdaQuery(UserEntity.class); List<UserEntity> entities = query.andEq(UserEntity::getDepartmentId,1) .andIsNotNull(UserEntity::getName).select(); 例子5 把数十行SQL放到sql文件里维护 //访问user.md#select SqlId id = SqlId.of("user","select"); Map map = new HashMap(); map.put("name","n"); List<UserEntity> list = sqlManager.select(id,UserEntity.class,map); 例子6 复杂映射支持 支持像mybatis那样复杂的映射 自动映射 @Data @ResultProvider(AutoJsonMapper.class) public static class MyUserView { Integer id; String name; DepartmentEntity dept; } 配置映射,比MyBatis更容易理解,报错信息更详细 { "id": "id", "name": "name", "dept": { "id": "dept_id", "name": "dept_name" }, "roles": { "id": "r_id", "name": "r_name" } } 例子7 最好使用mapper来作为数据库访问类 @SqlResource("user") /*sql文件在user.md里*/ public interface UserMapper extends BaseMapper<UserEntity> { @Sql("select * from user where id = ?") UserEntity queryUserById(Integer id); @Sql("update user set name=? where id = ?") @Update int updateName(String name,Integer id); @Template("select * from user where id = #{id}") UserEntity getUserById(Integer id); @SpringData/*Spring Data风格*/ List<UserEntity> queryByNameOrderById(String name); /** * 可以定义一个default接口 * @return */ default List<DepartmentEntity> findAllDepartment(){ Map paras = new HashMap(); paras.put("exlcudeId",1); List<DepartmentEntity> list = getSQLManager().execute("select * from department where id != #{exlcudeId}",DepartmentEntity.class,paras); return list; } /** * 调用sql文件user.md#select,方法名即markdown片段名字 * @param name * @return */ List<UserEntity> select(String name); /** * 翻页查询,调用user.md#pageQuery * @param deptId * @param pageRequest * @return */ PageResult<UserEntity> pageQuery(Integer deptId, PageRequest pageRequest); @SqlProvider(provider= S01MapperSelectSample.SelectUserProvider.class) List<UserEntity> queryUserByCondition(String name); @SqlTemplateProvider(provider= S01MapperSelectSample.SelectUs List<UserEntity> queryUserByTemplateCondition(String name); @Matcher /*自己定义个Matcher注解也很容易*/ List<UserEntity> query(Condition condition,String name); } 你看到的这些用在Mapper上注解都是可以自定义,自己扩展的 例子8 使用Fetch 注解 可以在查询后根据Fetch注解再次获取相关对象,实际上@FetchOne和 @FetchMany是自定义的,用户可自行扩展 @Data @Table(name="user") @Fetch public static class UserData { @Auto private Integer id; private String name; private Integer departmentId; @FetchOne("departmentId") private DepartmentData dept; } /** * 部门数据使用"b" sqlmanager */ @Data @Table(name="department") @Fetch public static class DepartmentData { @Auto private Integer id; private String name; @FetchMany("departmentId") private List<UserData> users; } 例子9 不同数据库切换 可以自行扩展ConditionalSQLManager的decide方法,来决定使用哪个SQLManager SQLManager a = SampleHelper.init(); SQLManager b = SampleHelper.init(); Map<String, SQLManager> map = new HashMap<>(); map.put("a", a); map.put("b", b); SQLManager sqlManager = new ConditionalSQLManager(a, map); //不同对象,用不同sqlManager操作,存入不同的数据库 UserData user = new UserData(); user.setName("hello"); user.setDepartmentId(2); sqlManager.insert(user); DepartmentData dept = new DepartmentData(); dept.setName("dept"); sqlManager.insert(dept); 使用注解 @TargetSQLManager来决定使用哪个SQLManger @Data @Table(name = "department") @TargetSQLManager("b") public static class DepartmentData { @Auto private Integer id; private String name; } 例子10 如果想给每个sql语句增加一个sqlId标识 这样好处是方便数据库DBA与程序员沟通 public static class SqlIdAppendInterceptor implements Interceptor{ @Override public void before(InterceptorContext ctx) { ExecuteContext context = ctx.getExecuteContext(); String jdbcSql = context.sqlResult.jdbcSql; String info = context.sqlId.toString(); //为发送到数据库的sql增加一个注释说明,方便数据库dba能与开发人员沟通 jdbcSql = "/*"+info+"*/\n"+jdbcSql; context.sqlResult.jdbcSql = jdbcSql; } } 例子11 代码生成框架 可以使用内置的代码生成框架生成代码何文档,也可以自定义的,用户可自行扩展SourceBuilder类 List<SourceBuilder> sourceBuilder = new ArrayList<>(); SourceBuilder entityBuilder = new EntitySourceBuilder(); SourceBuilder mapperBuilder = new MapperSourceBuilder(); SourceBuilder mdBuilder = new MDSourceBuilder(); //数据库markdown文档 SourceBuilder docBuilder = new MDDocBuilder(); sourceBuilder.add(entityBuilder); sourceBuilder.add(mapperBuilder); sourceBuilder.add(mdBuilder); sourceBuilder.add(docBuilder); SourceConfig config = new SourceConfig(sqlManager,sourceBuilder); //只输出到控制台 ConsoleOnlyProject project = new ConsoleOnlyProject(); String tableName = "USER"; config.gen(tableName,project); 例子13 定义一个Beetl函数 GroupTemplate groupTemplate = groupTemplate(); groupTemplate.registerFunction("nextDay",new NextDayFunction()); Map map = new HashMap(); map.put("date",new Date()); String sql = "select * from user where create_time is not null and create_time<#{nextDay(date)}"; List<UserEntity> count = sqlManager.execute(sql,UserEntity.class,map); nextDay函数是一个Beetl函数,非常容易定义,非常容易在sql模板语句里使用 public static class NextDayFunction implements Function { @Override public Object call(Object[] paras, Context ctx) { Date date = (Date) paras[0]; Calendar c = Calendar.getInstance(); c.setTime(date); c.add(Calendar.DAY_OF_YEAR, 1); // 今天+1天 return c.getTime(); } } 例子14 更多可扩展的例子 根据ID或者上下文自动分表,toTable是定义的一个Beetl函数, static final String USER_TABLE="${toTable('user',id)}"; @Data @Table(name = USER_TABLE) public static class MyUser { @AssignID private Integer id; private String name; } 定义一个Jackson注解,@Builder是注解的注解,表示用Builder指示的类来解释执行,可以看到BeetlSQL的注解可扩展性就是来源于@Build注解 @Retention(RetentionPolicy.RUNTIME) @Target(value = {ElementType.METHOD, ElementType.FIELD}) @Builder(JacksonConvert.class) public @interface Jackson { } 定义一个@Tenant 放在POJO上,BeetlSQL执行时候会给SQL添加额外参数,这里同样使用了@Build注解 /** * 组合注解,给相关操作添加额外的租户信息,从而实现根据租户分表或者分库 */ @Retention(RetentionPolicy.RUNTIM@ @Target(value = {ElementType.TYPE}) @Builder(TenantContext.class) public @interface Tenant { } 使用XML而不是JSON作为映射 @Retention(RetentionPolicy.RUNTIME) @Target(value = {ElementType.TYPE}) @Builder(ProviderConfig.class) public @interface XmlMapping { String path() default ""; } 参考源码例子 PluginAnnotationSample了解如何定义自定的注解,实际上BeetlSQL有一半的注解都是通过核心注解扩展出来的 例子15 微服务事务 BeetlSQL除了集成传统的事务管理器外,也提供Saga事务支持,支持多库事务和微服务事务。 其原理是自动为每个操作提供反向操作,如insert的反向操作是deleteById,并把这些操作作为任务交给Saga—Server调度。实现了通过Kafka作为客户端(各个APP)与SagaServer 交互的媒介保证任务可靠传递并最终被系统执行。 String orderAddUrl = "http://127.0.0.1:8081/order/item/{orderId}/{userId}/{fee}"; String userBalanceUpdateUrl = "http://127.0.0.1:8082/user/fee/{orderId}/{userId}/{fee}"; .......... SagaContext sagaContext = SagaContext.sagaContextFactory.current(); try { sagaContext.start(gid); //模拟调用俩个微服务,订单和用户 rest.postForEntity(orderAddUrl, null,String.class, paras); rest.postForEntity(userBalanceUpdateUrl, null,String.class, paras); if (1 == 1) { throw new RuntimeException("模拟失败,查询saga-server 看效果"); } } catch (Exception e) { log.info("error " + e.getMessage()); log.info("start rollback " + e.getMessage()); sagaContext.rollback(); return e.getMessage(); } 以用户系统为例(源码是DemoController),userBalanceUpdateUrl对应如下扣费逻辑 @Autowired UserMapper userMapper; @Transactional(propagation= Propagation.NEVER) public void update(String orderId,String userId,Integer fee){ SagaContext sagaContext = SagaContext.sagaContextFactory.current(); try{ sagaContext.start(orderId); UserEntity user = userMapper.unique(userId); user.setBalance(user.getBalance()-fee); userMapper.updateById(user); sagaContext.commit(); }catch (Exception e){ sagaContext.rollback(); } } 这里的UserMapper实际上是SagaMapper子类(而不是BaseMapper),会为每个操作提供反向操作 public interface SagaMapper<T> { /** sega 改造的接口**/ @AutoMapper(SagaInsertAMI.class) void insert(T entity); @AutoMapper(SagaUpdateByIdAMI.class) int updateById(T entity); @AutoMapper(SagaDeleteByIdAMI.class) int deleteById(Object key); } BeetlSQL的架构 除了SQLManager和ClassAnnotations,任何一部分都可以扩展

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册