首页 文章 精选 留言 我的

精选列表

搜索[AI原生解析],共10000篇文章
优秀的个人博客,低调大师

fragment和fragmentactivity解析

一、为什么要使用Fragment 1、当我们须要动态的多界面切换的时候,就须要将UI元素和Activity融合成一个模块。在2.3中我们一般通过各种Activity中进行跳转来实现多界面的跳转和单个界面动态改变。在4.0或以上系统中就能够使用新的特性来方便的达到这个效果--Fragment类。Fragment类似一个嵌套Activity,能够定义自己的layout和自己的生命周期。 2、 多个Fragment能够放在一个Activity中(所以上面讲到类似一个嵌套Activity)。而这个类能够对这些Fragment进行配置以适应不同的屏幕尺寸(比方平板和手机)。 二、使用Fragment 1、Fragment 是 activity 的界面中的一部分或一种行为。 能够把多个 Fragment 组合到一个 activity 中来创建一 个多面界面而且能够在多个 activity 中重用一个 Fragment。 能够把 Fragment 觉得模块化的一段 activity,它具 有自己的生命周期,接收它自己的事件,并能够在 activity 执行时被加入或删除。 2、Fragment 不能独立存在,它必须嵌入到 activity 中,并且 Fragment 的生命周期直接受所在的 activity 的影 响。 3、当向 activity 中加入一个 Fragment 时,它须置于 ViewGroup 控件中,而且需定义 Fragment 自己的界面。 可 以在 layoutxml 文件里声明 Fragment,元素为:<fragment>;也能够在代码中创建 Fragment,然后把它加入到 ViewGroup 控件中。 然而,Fragment 不一定非要放在 activity 的界面中,它能够隐藏在后台为 actvitiy 工作。 三、 生命周期 通常, 应当至少实现例如以下的生命周期方法: onCreate() 当创建fragment时, 系统调用该方法. 在实现代码中,应当初始化想要在fragment中保持的必要组件, 当fragment被暂停或者停止后能够恢复. onCreateView() fragment第一次绘制它的用户界面的时候, 系统会调用此方法. 为了绘制fragment的UI,此方法必须返回一个View, 这个view是你的fragment布局的根view. 假设fragment不提供UI, 能够返回null. onPause() 用户将要离开fragment时,系统调用这种方法作为第一个指示(然而它不总是意味着fragment将被销毁.) 在当前用户会话结束之前,通常应当在这里提交不论什么应该持久化的变化(由于用户有可能不会返回). 大多数程序应最少对 fragment 实现这三个方法。 当然还有其他几个回调方法可应该按情况实现之。 下图为 fragment 的生命周期(它所在的 activity 处于执行状态)。 四、怎样使用Fragment 1、加入一个用户界面 fragment通经常使用来作为一个activity的用户界面的一部分,并将它的layout提供给activity.为了给一个fragment提供一 个layout,你必须实现 onCreateView()回调方法, 当到了fragment绘制它自己的layout的时候,Android系统调用它.你的此方法的实现代码必须返回一个你的fragment的 layout的根view. 从onCreateView()返回的View, 也能够从一个layout的xml资源文件里读取并生成. 为了帮助你这么做, onCreateView() 提供了一个LayoutInflater 对象. 举个样例, 这里有一个Fragment的子类, 从文件 frament_main.xml 载入了一个layout: @Override public View onCreateView(LayoutInflater inflater, ViewGroup container, Bundle savedInstanceState) { View view = inflater.inflate(R.layout.frament_main, container, false); return view; } PS 传入onCreateView()的container參数是你的fragmentlayout将被插入的父ViewGroup(来自activity的layout) savedInstanceState 參数是一个Bundle, 假设fragment是被恢复的,它提供关于fragment的之前的实例的数据, inflate() 方法有3个參数: a、想要载入的layout的resource ID. b、载入的layout的父ViewGroup.传入container是非常重要的, 目的是为了让系统接受所要载入的layout的根view的layout參数,由它将挂靠的父view指定. c、布尔值指示在载入期间, 展开的layout是否应当附着到ViewGroup (第二个參数). 2、将fragment加入到activity 通常地, fragment为宿主activity提供UI的一部分, 被作为activity的整个viewhierarchy的一部分被嵌入. 有2种方法你能够加入一个fragment到activity layout:2.1、使用XML将Fragment加入到一个Activity中 在这样的情况下。你能够像为View一样, 为fragment指定layout属性。 <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" android:orientation="horizontal" android:layout_width="match_parent" android:layout_height="match_parent"> <fragment android:name="com.example.news.ArticleListFragment" android:id="@+id/list" android:layout_weight="1" android:layout_width="0dp" android:layout_height="match_parent" /> <fragment android:name="com.example.news.ArticleReaderFragment" android:id="@+id/viewer" android:layout_weight="2" android:layout_width="0dp" android:layout_height="match_parent" /> </LinearLayout> PS 1、<fragment> 中的 android:name属性指定了在layout中实例化的Fragment类. 当系统创建这个activity layout时,它实例化每个在layout中指定的fragment,并调用每个上的onCreateView()方法,来获取每个 fragment的layout.系统将从fragment返回的 View直接插入到<fragment>元素所在的地方. 2、通过在xml中定义fragment的方式。我们不能在执行时移除fragment。假设我们想要通过切换fragments来跟用户有更好的互动。那么就须要在activity启动的时候定义fragment了。 2.2、在执行时加入一个Fragment到Activity 上面一节的在activity的布局文件(layout xml)中加入Fragment的方法我们已经知道了。 如今我们将学习第二种方式。这样的方式同意我们在执行时动态的显示和隐藏fragment。为了达到在activity中动态管理Fragment,我们须要用到FragmentManager,而且通过它创建FragmentTransaction。 activity同意移除或者替换fragment须要有例如以下条件: 1、activity的onCreate()方法中加入初始化的fragment 2、fragment放置位置的布局中必须有一个视图容器 比方:res/layout/news_articles.xml文件提供了视图容器。 <FrameLayout xmlns:android="http://schemas.android.com/apk/res/android" android:id="@+id/fragment_container" android:layout_width="match_parent" android:layout_height="match_parent" /> Activity中使用getSupportFragmentManager()获取FragmentManager,之后调用beginTransaction去创建一个FragmentTransaction对象, 再调用add()方法就可以加入一个fragment。 在activity中能够使用同一个FragmentTransaction对象去运行多个fragment事务,当做这样操作时。必须调用commint()方法。 以下的代码演示如何加入一个fragment到res/layout/news_articles.xml的layout: import android.os.Bundle; import android.support.v4.app.FragmentActivity; public class MainActivity extends FragmentActivity { @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.news_articles); if (findViewById(R.id.fragment_container) != null) { if (savedInstanceState != null) { return; } HeadlinesFragment firstFragment = new HeadlinesFragment(); firstFragment.setArguments(getIntent().getExtras()); // Add the fragment to the 'fragment_container' FrameLayout getSupportFragmentManager().beginTransaction() .add(R.id.fragment_container, firstFragment).commit(); } } } add()的第一个參数是fragment要放入的ViewGroup, 由resource ID指定,第二个參数是须要加入的fragment.一旦用FragmentTransaction做了改变,为了使改变生效,必须调用commit(). PS 如今再来说明另外一个实例,实例图例如以下。我要在四个标签页面切换(主页。手机,配件,购物车) 代码例如以下,详细就是通过影藏和显示fragment来实现切换 import android.os.Bundle; import android.support.v4.app.Fragment; import android.support.v4.app.FragmentActivity; import android.view.View; import android.view.Window; public class FramentMainActivity extends FragmentActivity { private Fragment[] fragments; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); requestWindowFeature(Window.FEATURE_NO_TITLE); setContentView(R.layout.activity_frament_main); fragments = new Fragment[4]; fragments[0] = getSupportFragmentManager().findFragmentById(R.id.farment_main); fragments[1] = getSupportFragmentManager().findFragmentById(R.id.farment_phone); fragments[2] = getSupportFragmentManager().findFragmentById(R.id.farment_accessory); fragments[3] = getSupportFragmentManager().findFragmentById(R.id.farment_cart); getSupportFragmentManager().beginTransaction(). hide(fragments[1]).hide(fragments[2]).hide(fragments[3]).show(fragments[0]).commit(); } public void mainClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[1]).hide(fragments[2]).hide(fragments[3]).show(fragments[0]).commit(); } public void phoneClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[0]).hide(fragments[2]).hide(fragments[3]).show(fragments[1]).commit(); } public void accessoryClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[0]).hide(fragments[1]).hide(fragments[3]).show(fragments[2]).commit(); } public void cartClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[0]).hide(fragments[1]).hide(fragments[2]).show(fragments[3]).commit(); } } 3、Frament 管理 要管理 fragment,需使用 FragmentManager,要获取它,需在 activity 中调用方法 getFragmentManager()。 能够用 FragmentManager 来做以上事情: 用法 findFragmentById()或 findFragmentByTag(),获取 activity 中已存在的 fragment 用法 popBackStack()从 activity 的后退栈中弹出 fragment(这能够模拟后退键引发的动作) 用方法 addOnBackStackChangedListerner()注冊一个侦听器以监视后退栈的变化 还能够使用 FragmentManager 打开一个 FragmentTransaction 来运行 fragment 的事务,比方加入或删除 fragment。 在 activity 中使用 fragment 的一个伟大的优点是能跟据用户的输入对 fragment 进行加入、删除、替换以及运行 其他动作的能力。 提交的一组 fragment 的变化叫做一个事务。 事务通过 FragmentTransaction 来运行。还能够把每一个 事务保存在 activity 的后退栈中,这样就能够让用户在 fragment 变化之间导航(跟在 activity 之间导航一样)。 能够通过 FragmentManager 来取得 FragmentTransaction 的实例,例如以下: FragmentManagerfragmentManager = getFragmentManager(); FragmentTransactionfragmentTransaction =fragmentManager.beginTransaction(); 一个事务是在同一时刻运行的一组动作(非常像数据库中的事务)。 能够用 add(),remove(),replace()等方法构成事务,最后使用 commit()方法提交事务。在调用 commint()之前,能够用addToBackStack()把事务加入到一个后退栈中, 这个后退栈属于所在的 activity。有了它,就能够在用户按下返回键时,返回到 fragment 运行事务之前的状态。如 下例:演示了怎样用一个 fragment 取代还有一个 fragment,同一时候在后退栈中保存被取代的 fragment 的状态。 4、为Activity创建事件回调方法 在一些情况下, 你可能须要一个fragment与activity分享事件. 一个好的方法是在fragment中定义一个回调的interface, 并要求宿主activity实现它.当activity通过interface接收到一个回调, 必要时它能够和在layout中的其它fragment分享信息. 比如, 假设一个新的应用在activity中有2个fragment – 一个用来显示文章列表(framgent A), 还有一个显示文章内容(fragment B) – 然后 framgent A必须告诉activity何时一个list item被选中,然后它能够告诉fragmentB去显示文章. PS 最后在简单说说一个项目的大致实现,比方在手机上面实现了一个FragmentActivity + 多个fragment(登录。菜单,具体,账户等页面)。 1、每个项目包含非常多活动,每个活动(FragmentActivity)相互不影响,每个活动(FragmentActivity)包含非常多子活动(fragment,一个页面),每个子活动也相互不影响. 2、每个活动(FragmentActivity)用FrameLayout来显示子活动,而且对活动进行堆栈管理,实现数据不用反复拉取。就跟搜狐新闻一样的效果. 3、登录(FragmentActivity):logo页面,登录页面 4、菜单(FragmentActivity):菜单选择页面(側边栏,滑动),子菜单功能(每个新闻页面) 5、其它(FragmentActivity):上传页面,下载页面等 每个活动(FragmentActivity)实现了相互不影响。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5393911.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hbase原理解析

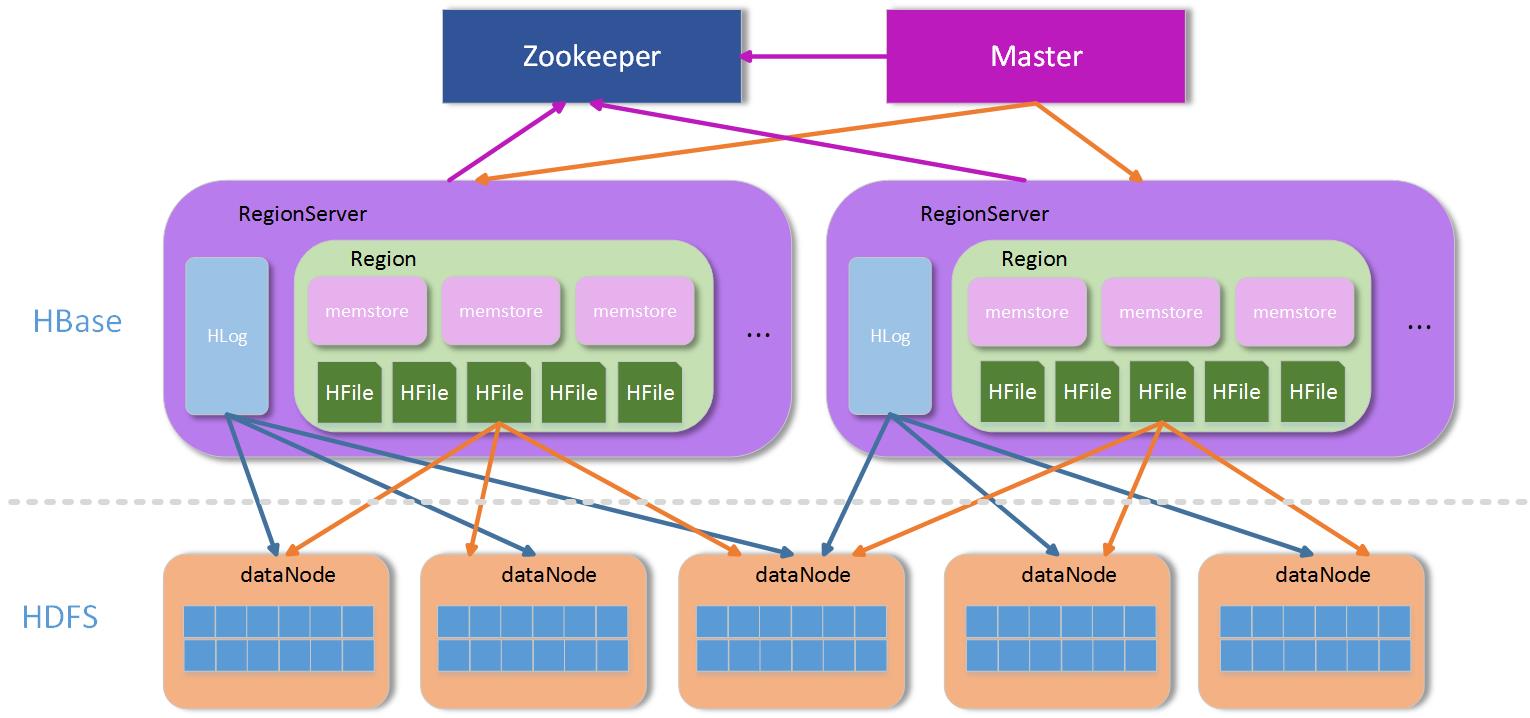
原文网站已经打不开了,其他都是转载地址,在此就不列了 简介 [HBase]——Hadoop Database的简称,Google BigTable的另一种开源实现方式,从问世之初,就为了解决用大量廉价的机器高速存取海量数据、实现数据分布式存储提供可靠的方案。从功能上来讲,HBase不折不扣是一个数据库,与我们熟悉的Oracle、MySQL、MSSQL等一样,对外提供数据的存储和读取服务。而从应用的角度来说,HBase与一般的数据库又有所区别,HBase本身的存取接口相当简单,不支持复杂的数据存取,更不支持SQL等结构化的查询语言;HBase也没有除了rowkey以外的索引,所有的数据分布和查询都依赖rowkey。 所以HBase在表的设计上会有很严格的要求。 架构上,HBase是分布式数据库的典范,这点比较像MongoDB的sharding模式,能根据键值的大小,把数据分布到不同的存储节点上,MongoDB根据configserver来定位数据落在哪个分区上,HBase通过访问Zookeeper来获取-ROOT-表所在地址,通过-ROOT-表得到相应.META.表信息,从而获取数据存储的region位置。 架构 上面提到,HBase是一个分布式的架构,除去底层存储的HDFS外,HBase本身从功能上可以分为三块:Zookeeper群、Master群和RegionServer群。 Zookeeper群:HBase集群中不可缺少的重要部分,主要用于存储Master地址、协调Master和RegionServer等上下线、存储临时数据等等。 Master群:Master主要是做一些管理操作,如:region的分配,手动管理操作下发等等,一般数据的读写操作并不需要经过Master集群,所以Master一般不需要很高的配置即可。 RegionServer群:RegionServer群是真正数据存储的地方,每个RegionServer由若干个region组成,而一个region维护了一定区间rowkey值的数据,整个结构如下图: HBase结构图 上图中,Zookeeper(简称ZK)是一个集群,通常有奇数个ZK服务组成。Master为了服务可用性,也建议部署成集群方式,因为Master是整个管理操作的发起者,如果Master一旦发生意外停机,整个集群将会无法进行管理操作,所以Master也必须有多个,当然多个Master也有主从之分,如何区分哪个是主,哪个是从?关键看哪个Master能竞争到ZK上对应Master目录下的锁,持有该目录锁的Master为主Master,其他从Master轮询竞争该锁,所以一旦主Master发生意外停机,从Master很快会因为竞争到Master文件夹上的锁而接管服务。 RegionServer(简称RS)在非Replication模式下,整个系统中都是唯一的,也就是说,在整个非Replication的HBase集群中,每台RS上保存的数据都不一样,所以相对于前面两者,该模式下的RS并不是高可用的,至少RS可能存在单点故障的问题,但是由于HBase内部数据分region存储和region可以迁移的机制,RS服务的单点故障可能会在极小代价下很快恢复,但是一旦停掉的RS上有-ROOT-或者.META.表的region,那后果还是比较严重,因为数据节点的RS停机,只会在短时间内影响该台RS上的region不可访问,等到region迁移完成后即可恢复,如果是-ROOT-、.META.所在的RS停机,整个HBase的新的求情都将受到影响,因为需要通过.META.表来路由,从而寻找到region所在RS的地址。 数据组织 整个架构中,ZK用于服务协调和整个集群运行过程中部分信息的保存和-ROOT-表地址定位,Master用于集群内部管理,所以剩下的RS主要用于处理数据。 RS是处理数据的主要场所,那么在RS内部的数据是怎么分布的?其实RS本身只是一个容器,其定义了一些功能线程,比如:数据合并线程(compact thread)、storeFile分割线程(split thread)等等。容器中的主要对象就是region,region是一个表根据自身rowkey范围划分的一部分,一个表可以被划分成若干部分,也就是若干个region,region可以根据rowkey范围不同而被分布在不同的RS上(当然也可以在同一个RS上,但不建议这么做)。一个RS上可以包含多个表的region,也可以只包含一个表的部分region,RS和表是两个不同的概念。 这里还有一个概念——列簇。对HBase有一些了解的人,或多或少听说过:HBase是一个列式存储的数据库,而这个列式存储中的列,其实是区别于一般数据库的列,这里的列的概念,就是列簇。列簇,顾名思义就是很多列的集合,而在数据存储上来讲,不同列簇的数据,一定是分开存储的,即使是在同一个region内部,不同的列簇也存储在不同的文件夹中,这样做的好处是,一般我们定义列簇的时候,通常会把类似的数据放入同一个列簇,不同的列簇分开存储,有利于数据的压缩,并且HBase本身支持多种压缩方式。 原理 前面介绍了HBase的一般架构,我们知道了HBase有ZK、Master和RS等组成,本节我们来介绍下HBase的基本原理,从数据访问、RS路由到RS内部缓存、数据存储和刷写再到region的合并和拆分等等功能。 RegionServer定位 访问HBase通过HBase客户端(或API)进行,整个HBase提供给外部的地址,其实是ZK的入口,前面也介绍了,ZK中有保存-ROOT-所在的RS地址,从-ROOT-表可以获取.META.表信息,根据.META.表可以获取region在RS上的分布,整个region寻址过程大致如下: RS定位过程 首先,Client通过访问ZK来请求目标数据的地址。 ZK中保存了-ROOT-表的地址,所以ZK通过访问-ROOT-表来请求数据地址。同样,-ROOT-表中保存的是.META.的信息,通过访问.META.表来获取具体的RS。.META.表查询到具体RS信息后返回具体RS地址给Client。Client端获取到目标地址后,然后直接向该地址发送数据请求。 上述过程其实是一个三层索引结构,从ZK获取-ROOT-信息,再从-ROOT-获取.META.表信息,最后从.META.表中查到RS地址后缓存。这里有几个问题: 既然ZK中能保存-ROOT-信息,那么为什么不把.META.信息直接保存在ZK中,而需要通过-ROOT-表来定位? Client查找到目标地址后,下一次请求还需要走ZK —> -ROOT- —> .META.这个流程么? 先来回答第一个问题:为什么不直接把.META.表信息直接保存到ZK中?主要是为了保存的数据量考虑,ZK中不宜保存大量数据,而.META.表主要是保存Region和RS的映射信息,region的数量没有具体约束,只要在内存允许的范围内,region数量可以有很多,如果保存在ZK中,ZK的压力会很大。所以通过一个-ROOT-表来转存到RS中是一个比较理想的方案,相比直接保存在ZK中,也就多了一层-ROOT-表的查询,对性能来说影响不大。 第二个问题:每次访问都需要走ZK –> -ROOT- —> .META.的流程么?当然不需要,Client端有缓存,第一次查询到相应region所在RS后,这个信息将被缓存到Client端,以后每次访问都直接从缓存中获取RS地址即可。当然这里有个意外:访问的region若果在RS上发生了改变,比如被balancer迁移到其他RS上了,这个时候,通过缓存的地址访问会出现异常,在出现异常的情况下,Client需要重新走一遍上面的流程来获取新的RS地址。总体来说,region的变动只会在极少数情况下发生,一般变动不会很大,所以在整个集群访问过程中,影响可以忽略。 Region数据写入 HBase通过ZK —> -ROOT- —> .META.的访问获取RS地址后,直接向该RS上进行数据写入操作,整个过程如下图: RegionServer数据操作过程 Client通过三层索引获得RS的地址后,即可向指定RS的对应region进行数据写入,HBase的数据写入采用WAL(write ahead log)的形式,先写log,后写数据。HBase是一个append类型的数据库,没有关系型数据库那么复杂的操作,所以记录HLog的操作都是简单的put操作(delete/update操作都被转化为put进行) HLog HLog写入 HLog是HBase实现WAL方式产生的日志信息,其内部是一个简单的顺序日志,每个RS上的region都共享一个HLog,所有对于该RS上的region数据写入都被记录到该HLog中。HLog的主要作用就是在RS出现意外崩溃的时候,可以尽量多的恢复数据,这里说是尽量多,因为在一般情况下,客户端为了提高性能,会把HLog的auto flush关掉,这样HLog日志的落盘全靠操作系统保证,如果出现意外崩溃,短时间内没有被fsync的日志会被丢失。 HLog过期 HLog的大量写入会造成HLog占用存储空间会越来越大,HBase通过HLog过期的方式进行HLog的清理,每个RS内部都有一个HLog监控线程在运行,其周期可以通过hbase.master.cleaner.interval进行配置。 HLog在数据从memstore flush到底层存储上后,说明该段HLog已经不再被需要,就会被移动到.oldlogs这个目录下,HLog监控线程监控该目录下的HLog,当该文件夹下的HLog达到hbase.master.logcleaner.ttl设置的过期条件后,监控线程立即删除过期的HLog。 Memstore 数据存储 memstore是region内部缓存,其大小通过HBase参数hbase.hregion.memstore.flush.size进行配置。RS在写完HLog以后,数据写入的下一个目标就是region的memstore,memstore在HBase内部通过LSM-tree结构组织,所以能够合并大量对于相同rowkey上的更新操作。 正是由于memstore的存在,HBase的数据写入都是异步的,而且性能非常不错,写入到memstore后,该次写入请求就可以被返回,HBase即认为该次数据写入成功。这里有一点需要说明,写入到memstore中的数据都是预先按照rowkey的值进行排序的,这样有利于后续数据查找。 数据刷盘 memstore中的数据在一定条件下会进行刷写操作,使数据持久化到相应的存储设备上,触发memstore刷盘的操作有多种不同的方式如下图: Memstore刷写流程以上1,2,3都可以触发memstore的flush操作,但是实现的方式不同: 1、通过全局内存控制,触发memstore刷盘操作memstore整体内存占用上限通过参数hbase.regionserver.global.memstore.upperLimit进行设置,当然在达到上限后,memstore的刷写也不是一直进行,在内存下降到hbase.regionserver.global.memstore.lowerLimit配置的值后,即停止memstore的刷盘操作。这样做,主要是为了防止长时间的memstore刷盘,会影响整体的性能。在该种情况下,RS中所有region的memstore内存占用都没达到刷盘条件,但整体的内存消耗已经到一个非常危险的范围,如果持续下去,很有可能造成RS的OOM,这个时候,需要进行memstore的刷盘,从而释放内存。 2、手动触发memstore刷盘操作HBase提供API接口,运行通过外部调用进行memstore的刷盘 3、memstore上限触发数据刷盘前面提到memstore的大小通过hbase.hregion.memstore.flush.size进行设置,当region中memstore的数据量达到该值时,会自动触发memstore的刷盘操作。 刷盘影响 memstore在不同的条件下会触发数据刷盘,那么整个数据在刷盘过程中,对region的数据写入等有什么影响?memstore的数据刷盘,对region的直接影响就是:在数据刷盘开始到结束这段时间内,该region上的访问都是被拒绝的,这里主要是因为在数据刷盘结束时,RS会对改region做一个snapshot,同时HLog做一个checkpoint操作,通知ZK哪些HLog可以被移到.oldlogs下。从前面图上也可以看到,在memstore写盘开始,相应region会被加上UpdateLock锁,写盘结束后该锁被释放。 StoreFile memstore在触发刷盘操作后会被写入底层存储,每次memstore的刷盘就会相应生成一个存储文件HFile,storeFile即HFile在HBase层的轻量级分装。数据量的持续写入,造成memstore的频繁flush,每次flush都会产生一个HFile,这样底层存储设备上的HFile文件数量将会越来越多。不管是HDFS还是Linux下常用的文件系统如Ext4、XFS等,对小而多的文件上的管理都没有大文件来的有效,比如小文件打开需要消耗更多的文件句柄;在大量小文件中进行指定rowkey数据的查询性能没有在少量大文件中查询来的快等等。 Compact 大量HFile的产生,会消耗更多的文件句柄,同时会造成RS在数据查询等的效率大幅度下降,HBase为解决这个问题,引入了compact操作,RS通过compact把大量小的HFile进行文件合并,生成大的HFile文件。RS上的compact根据功能的不同,可以分为两种不同类型,即:minor compact和major compact。 Minor Compact minor compact又叫small compact,在RS运行过程中会频繁进行,主要通过参数hbase.hstore.compactionThreshold进行控制,该参数配置了HFile数量在满足该值时,进行minor compact,minor compact只选取region下部分HFile进行compact操作,并且选取的HFile大小不能超过hbase.hregion.max.filesize参数设置。 Major Compact 相反major compact也被称之为large compact,major compact会对整个region下相同列簇的所有HFile进行compact,也就是说major compact结束后,同一个列簇下的HFile会被合并成一个。major compact是一个比较长的过程,对底层I/O的压力相对较大。 major compact除了合并HFile外,另外一个重要功能就是清理过期或者被删除的数据。前面提到过,HBase的delete操作也是通过append的方式写入,一旦某些数据在HBase内部被删除了,在内部只是被简单标记为删除,真正在存储层面没有进行数据清理,只有通过major compact对HFile进行重组时,被标记为删除的数据才能被真正的清理。 compact操作都有特定的线程进行,一般情况下不会影响RS上数据写入的性能,当然也有例外:在compact操作速度跟不上region中HFile增长速度时,为了安全考虑,RS会在HFile达到一定数量时,对写入进行锁定操作,直到HFile通过compact降到一定的范围内才释放锁。 Split compact将多个HFile合并单个HFile文件,随着数据量的不断写入,单个HFile也会越来越大,大量小的HFile会影响数据查询性能,大的HFile也会,HFile越大,相对的在HFile中搜索的指定rowkey的数据花的时间也就越长,HBase同样提供了region的split方案来解决大的HFile造成数据查询时间过长问题。 一个较大的region通过split操作,会生成两个小的region,称之为Daughter,一般Daughter中的数据是根据rowkey的之间点进行切分的,region的split过程大致如下图: region split流程 1、region先更改ZK中该region的状态为SPLITING。 2、Master检测到region状态改变。 3、region会在存储目录下新建.split文件夹用于保存split后的daughter region信息。 4、Parent region关闭数据写入并触发flush操作,保证所有写入Parent region的数据都能持久化。 5、在.split文件夹下新建两个region,称之为daughter A、daughter B。 6、Daughter A、Daughter B拷贝到HBase根目录下,形成两个新的region。 7、Parent region通知修改.META.表后下线,不再提供服务。 8、Daughter A、Daughter B上线,开始向外提供服务。 9、如果开启了balance_switch服务,split后的region将会被重新分布。 上面1 ~ 9就是region split的整个过程,split过程非常快,速度基本会在秒级内,那么在这么快的时间内,region中的数据怎么被重新组织的? 其实,split只是简单的把region从逻辑上划分成两个,并没有涉及到底层数据的重组,split完成后,Parent region并没有被销毁,只是被做下线处理,不再对外部提供服务。而新产生的region Daughter A和Daughter B,内部的数据只是简单的到Parent region数据的索引,Parent region数据的清理在Daughter A和Daughter B进行major compact以后,发现已经没有到其内部数据的索引后,Parent region才会被真正的清理。 HBase设计 HBase是一个分布式数据库,其性能的好坏主要取决于内部表的设计和资源的分配是否合理。 Rowkey设计 rowkey是HBase实现分布式的基础,HBase通过rowkey范围划分不同的region,分布式系统的基本要求就是在任何时候,系统的访问都不要出现明显的热点现象,所以rowkey的设计至关重要,一般我们建议rowkey的开始部分以hash或者MD5进行散列,尽量做到rowkey的头部是均匀分布的。禁止采用时间、用户id等明显有分段现象的标志直接当作rowkey来使用。 列簇设计 HBase的表设计时,根据不同需求有不同选择,需要做在线查询的数据表,尽量不要设计多个列簇,我们知道,不同的列簇在存储上是被分开的,多列簇设计会造成在数据查询的时候读取更多的文件,从而消耗更多的I/O。 TTL设计 选择合适的数据过期时间也是表设计中需要注意的一点,HBase中允许列簇定义数据过期时间,数据一旦超过过期时间,可以被major compact进行清理。大量无用历史数据的残余,会造成region体积增大,影响查询效率。 Region设计 一般地,region不宜设计成很大,除非应用对阶段性性能要求很多,但是在将来运行一段时间可以接受停服处理。region过大会导致major compact调用的周期变长,而单次major compact的时间也相应变长。major compact对底层I/O会造成压力,长时间的compact操作可能会影响数据的flush,compact的周期变长会导致许多删除或者过期的数据不能被及时清理,对数据的读取速度等都有影响。 相反,小的region意味着major compact会相对频繁,但是由于region比较小,major compact的相对时间较快,而且相对较多的major compact操作,会加速过期数据的清理。 当然,小region的设计意味着更多的region split风险,region容量过小,在数据量达到上限后,region需要进行split来拆分,其实split操作在整个HBase运行过程中,是被不怎么希望出现的,因为一旦发生split,涉及到数据的重组,region的再分配等一系列问题。所以我们在设计之初就需要考虑到这些问题,尽量避免region的运行过程中发生split。 HBase可以通过在表创建的时候进行region的预分配来解决运行过程中region的split产生,在表设计的时候,预先分配足够多的region数,在region达到上限前,至少有部分数据会过期,通过major compact进行清理后, region的数据量始终维持在一个平衡状态。 region数量的设计还需要考虑内存上的限制,通过前面的介绍我们知道每个region都有memstore,memstore的数量与region数量和region下列簇的数量成正比,一个RS下memstore内存消耗 Memory = memstore大小 * region数量 * 列簇数量 如果不进行前期数据量估算和region的预分配,通过不断的split产生新的region,容易导致因为内存不足而出现OOM现象。 个人介绍: 高广超:多年一线互联网研发与架构设计经验,擅长设计与落地高可用、高性能互联网架构。 本文首发在 高广超的简书博客 转载请注明! image.png

优秀的个人博客,低调大师

Android AsyncTask 源码解析

AsyncTask中的几个方法才能完成对任务的定制。经常需要去重写的方法有以下四个: 1.onPreExecute() 这个方法会在后台任务开始执行之间调用,用于进行一些界面上的初始化操作,比如显示一个进度条对话框等。 2.doInBackground(Params...) 这个方法中的所有代码都会在子线程中运行,我们应该在这里去处理所有的耗时任务。任务一旦完成就可以通过return语句来将任务的执行结果进行返回,如果AsyncTask的第三个泛型参数指定的是Void,就可以不返回任务执行结果。注意,在这个方法中是不可以进行UI操作的,如果需要更新UI元素,比如说反馈当前任务的执行进度,可以调用publishProgress(Progress...)方法来完成。 3.onProgressUpdate(Progress...) 当在后台任务中调

优秀的个人博客,低调大师

docker存储结构解析

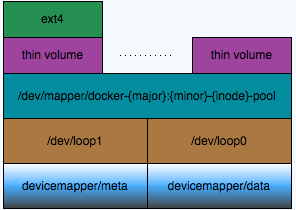
由于aufs并未并入内核,故而目前只有Ubuntu系统上能够使用aufs作为docker的存储引擎,而其他系统上使用lvm thin provisioning(overlayfs是一个和aufs类似的union filesystem,未来有可能进入内核,但目前还没有;Lvm snapshot are useful for doing e.g. backup of a snapshot, but regress badly in performance when you start having many snapshots of the same device.)。为了实现lvm thin provisioning,docker启动时会设置一个100G的sparse文件( /var/lib/docker/devicemapper/devicemapper/data,元数据为/var/lib/docker/devicemapper/devicemapper/metadata),并将其作为devicemapper的存储池,而所有容器都从该存储池中分配默认10G的存储空间使用,如下图所示: 比如创建一个apache容器时devicemapper处理流程如下所示: Create a snapshot of the base device. Mount it and apply the changes in the fedora image. Create a snapshot based on the fedora device. Mount it and apply the changes in the apache image. Create a snapshot based on the apache device. Mount it and use as the root in the new container. thin provisioning管理 使用lvm工具来创建一个thin pool: dd if=/dev/zero of=lvm.img bs=1M count=100 losetup /dev/loop7 lvm.img losetup -a pvcreate /dev/loop7 vgcreate lvm_pool /dev/loop7 # create thin pool lvcreate -L 80M -T lvm_pool/thin_pool # create volume in thin pool lvcreate -T lvm_pool/thin_pool -V 500M -n first_lv docker启动时创建的默认存储池: #dmsetup table docker-253:1-138011042-pool 0 209715200 thin-pool 7:2 7:1 128 32768 1 skip_block_zeroing #209715200*512/1024/1024/1024=100GB 当启动容器后,会从该池中分配10G出来: #dmsetup table docker-253:1-138011042-641cdebd22b55f2656a560cd250e661ab181dcf2f5c5b78dc306df7ce62231f2 0 20971520 thin 253:2 166 # 20971520*512/1024/1024/1024=10GB 该10G存储的分配过程为: dmsetup message /dev/mapper/docker-253:1-138011042-pool 0 "create_thin 166" dmsetup create docker-253:1-138011042-641cdebd22b55f2656a560cd250e661ab181dcf2f5c5b78dc306df7ce62231f3 --table "020971520thin /dev/mapper/docker-253:1-138011042-pool 166" 创建快照: dmsetup suspend /dev/mapper/thin dmsetup message /dev/mapper/yy_thin_pool 0 "create_snap 1 0" dmsetup resume /dev/mapper/thin dmsetup create snap --table "0 40960 thin /dev/mapper/yy_thin_pool 1" docker服务在启动的时候可以配置devicemapper的启动参数,docker -d --storage-opt dm.foo=bar,可选参数有以下几个: dm.basesize 默认为10G,限制容器和镜像的大小 dm.loopdatasize 存储池大小,默认为100G dm.datadev 存储池设备,默认生成一个/var/lib/docker/devicemapper/devicemapper/data文件 dm.loopmetadatasize 元数据大小,默认为2G dm.metadatadev 元数据设备,默认生成一个/var/lib/docker/devicemapper/devicemapper/metadata文件 dm.fs 文件系统,默认ext4 dm.blocksize blocksize默认64K dm.blkdiscard 默认true 最后看看启动一个容器后,该容器的配置是如何组织的。 每个容器创建后都会将其基本配置写入到/var/lib/docker/containers/中: #ls /var/lib/docker/containers/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e -l total 20 -rw------- 1 root root 0 Nov 18 16:31 49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e-json.log -rw-r--r-- 1 root root 1741 Nov 18 16:31 config.json -rw-r--r-- 1 root root 368 Nov 18 16:31 hostconfig.json -rw-r--r-- 1 root root 13 Nov 18 16:31 hostname -rw-r--r-- 1 root root 175 Nov 18 16:31 hosts -rw-r--r-- 1 root root 325 Nov 18 16:31 resolv.conf 分配10G空间后会将容器存储配置写入到以下两个文件中: # cd /var/lib/docker #cat ./devicemapper/metadata/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e-init {"device_id":174,"size":10737418240,"transaction_id":731,"initialized":false} #cat ./devicemapper/metadata/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e {"device_id":175,"size":10737418240,"transaction_id":732,"initialized":false} 而容器的rootfs会mount到/var/lib/docker/devicemapper/mnt/container_id下: #mount | grep 49f1 /dev/mapper/docker-253:1-138011042-49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e on /var/lib/docker/devicemapper/mnt/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e type ext4 (rw,relatime,discard,stripe=16,data=ordered) 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/p/4106212.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

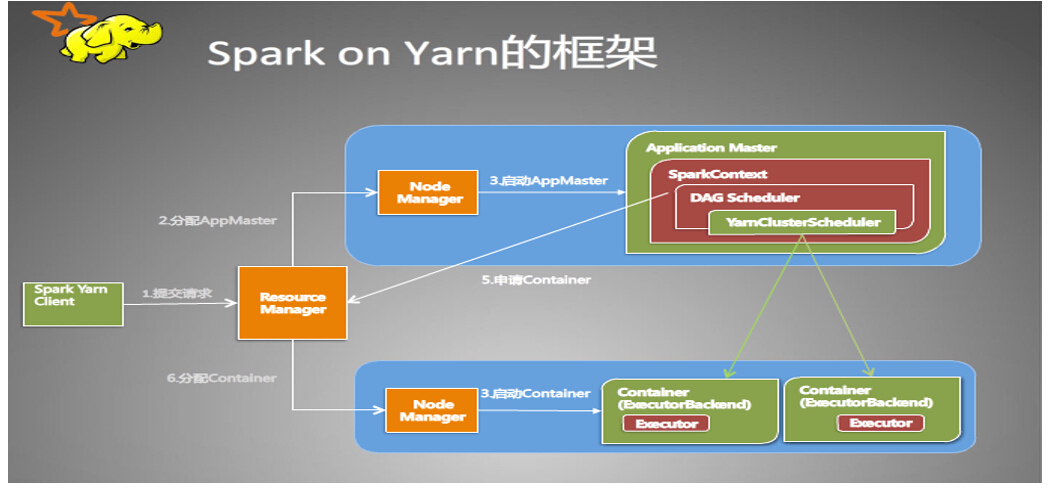
Spark on Yarn 架构解析

。 一、Hadoop Yarn组件介绍: 我们都知道yarn重构根本的思想,是将原有的JobTracker的两个主要功能资源管理器 和 任务调度监控 分离成单独的组件。新的架构使用全局管理所有应用程序的计算资源分配。 主要包含三个组件ResourceManager 、NodeManager和ApplicationMaster以及一个核心概念Container. 1.ResourceManager(RM) 就是所谓的资源管理器,每个集群一个,实现全局的资源管理和任务调度。它可以处理客户端提交计算作业的请求,启动并监听ApplicationMaster,监控NodeManager,进行资源分配与调度。每一个应用程序需要不同类型的资源,因此就需要不同的容器。这里的资源包括内存、CPU、磁盘、网络等。(比如使用spark-submit 执行程序jar包,就需要向ResourceManager注册,申请相应的容器,资源),其中该ResourceManager提供一个调度策略的插件,负责将集群资源分配给多个队列和应用程序.(可以基于现有的能力调度和公平调度模型) 2.NodeManager(NM) 节点管理器,每个节点一个,实现节点的监控与报告。处理来自ResourceManager的命令,也处理来自ApplicationMaster的命令,同时监控资源可用性,报告错误,管理资源的生命周期。NodeManager是每一台机器框架的代理,是执行应用程序的容器,监控应用程序的资源使用情况(CPU、内存、硬盘、网络)并向调度器汇报。 3.ApplicationMaster(AM) 应用控制器,每个作业或应用一个,实现应用的调度和资源协调。具体来说呢,它进行数据的切分,为应用申请资源并分配给任务,完成任务监控与容错。实际上,每个应用的ApplicationMaster是一个详细的框架库。它结合从ResourceManager获得的资源和NodeManager协同工作来运行和监听任务。ApplicationMaster负责向ResourceManager索要适当的资源容器(containter)来运行任务,跟踪应用程序的状态和监控她们的进程,处理任务的失败原因。 4.Container 容器,封装了及其资源,包括内存、CPU、磁盘、网络等。每个任务会被分配一个容器,该任务只能在该容器中执行,并使用该容器封装的资源。当应用程序发出资源请求时,ResourceManager并不会立刻返回满足要求的资源,需要ApplicationMaster与ResourceManager不断地通信,检测分配到的资源足够,才会进行分配。一旦分配完毕,ApplicationMaster便可从ResourceManager处获取以Container表示的资源。(Container可以看做一个可序列化的Java对象,包含字段信息)一般来说,每个Container可用于执行一个任务。ApplicationMaster在收到一个或多个Container后,再将该Container进一步分配给内部的某个任务,确定该任务后,ApplicationMaster将该任务运行环境(包含运行命令、环境变量、依赖的外部文件等)连同Container中的资源信息封装到ContainerLaunchContext对象中,进而与对应的NodeManager通信,启动该任务。 二、Spark on Yarn 1.当提交一个spark-submit任务时,spark将在startUserClass函数专门启动了一个线程(名称为Driver的线程)来启动用户提交的Application,也就是启动了Driver。在Driver中将会初始化SparkContext。 2.等待SparkContext初始化完成,最多等待spark.yarn.applicationMaster.waitTries次数(默认为10),如果等待了的次数超过了配置的,程序将会退出;否则用SparkContext初始化yarnAllocator. 3.当SparkContext、Driver初始化完成的时候,通过ApplicationMasterClient向ResourceManager注册ApplicationMaster. 4.分配并启动Executeors。在启动Executeors之前,先要通过yarnAllocator获取到numExecutors个Container,然后在Container中启动Executeors。(启动Executeors是通过ExecutorRunnable实现的,而ExecutorRunnable内部是启动CoarseGrainedExecutorBackend的) 5.最后,Task将在CoarseGrainedExecutorBackend里面运行,然后运行状况会通过Akka通知CoarseGrainedScheduler,直到作业运行完成。 Spark on Yarn只需要部署一份spark,当应用程序启动时,spark会将相关的jar包上传注册给ResoureManager,任务的执行由ResourceManager来调度,并执行spark的代码。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册