首页 文章 精选 留言 我的

精选列表

搜索[脑洞落地],共10000篇文章
优秀的个人博客,低调大师

京东哥伦布即时设计平台ChatGPT落地实践 | 京东云技术团队

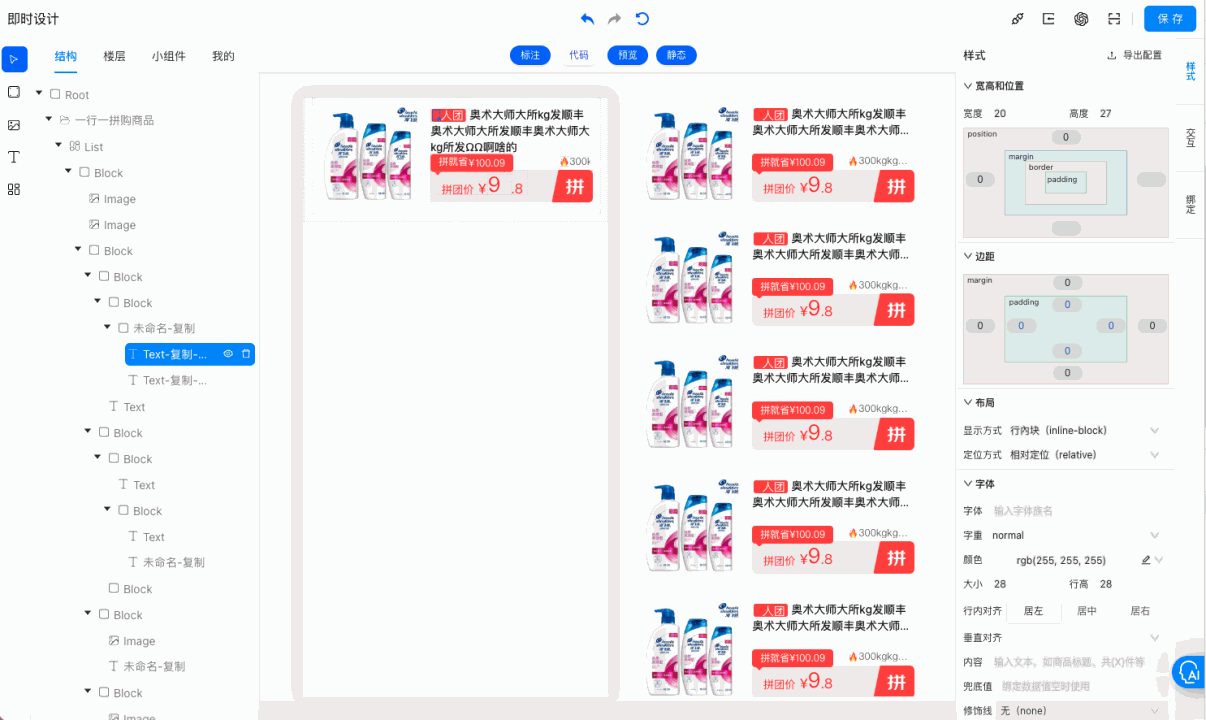
一、平台介绍 🤖 即时设计平台是一个即时搭建c端楼层的开发平台,支持通过导入relay设计稿url完成Ui2Code,在此基础上完成前端可视化搭建,同时支持通过ChatGPT完成一句话需求,搭建后的楼层自动同步ihub楼层市场,提供到通天塔、哥伦布等搭建平台使用。  1.1 平台能力 🤖 在哥伦布即时设计中,即时设计能力主要包括以下几个方面: 1. 画布编辑能力:即时设计平台提供了丰富的画布编辑功能,包括添加、删除、复制、调整层级等操作,可以灵活地编辑页面的结构和布局。 2. 样式配置能力:即时设计平台支持对页面元素的样式进行配置,包括字体、颜色、大小、边框等,可以根据需求进行自定义的样式设置。 3. 数据接口配置能力:即时设计平台支持与数据接口的绑定,可以通过配置数据接口来实现页面内容的动态展示,提高页面的灵活性和可扩展性。 4. 交互事件配置能力:即时设计平台支持对页面元素的交互事件进行配置,包括点击、滑动、弹窗等,可以实现页面的交互效果,提升用户体验。 5. 预览和下载能力:即时设计平台提供了在线预览和下载代码的功能,可以实时查看页面效果,并将设计的页面代码下载到本地进行进一步开发和调试。  1.2 chatGPT x 即时设计平台能做些什么? 二、效果演示 2.1 问答助手  👨🏻:什么是即时设计平台 🤖:在哥伦布即时设计中,即时设计平台是一个用于即时搭建C端页面的开发平台。它提供了编辑样式、创建数据源、绑定数据源、绑定交互事件、下载代码、在线预览等功能。你可以通过即时设计平台来创建和编辑页面的样式和内容,配置数据接口和交互事件,并最终生成可下载的代码或在线预览页面。即时设计平台可以帮助开发人员快速搭建页面,提高开发效率。 参考文档:即时设计参考文档 👩🏻:如何创建数据源 🤖:在哥伦布即时设计中,创建数据源的步骤如下: 1. 打开即时设计平台,进入画布编辑界面。 2. 在顶部菜单区点击“数据源”按钮,弹出数据源页面级弹窗。 3. 在数据源页面级弹窗中,点击“新建接口”按钮,创建一个新的数据接口。 4. 在接口配置中,填写接口名称、请求方式(GET或POST)、接口URL等信息。 5. 在属性参数配置中,根据接口的需求,添加相应的参数,包括Query、Header、Body等。 6. 在响应信息配置中,可以配置接口返回的数据处理,如对返回的数组进行过滤等。 7. 点击保存按钮,保存数据源配置。 以上是创建数据源的基本步骤,具体的操作可以参考哥伦布即时设计的官方文档。参考文档链接如下: 哥伦布即时设计参考文档 2.2 智能楼层创建&修改  👴🏻:帮我创建一个会场楼层,包含商品图、价格、标题  👦🏻:帮我修改商品名称内容为618大麦、字体为蓝色、价格字号20,价格字体颜色为红色,头图显示  创建&修改整体流程为根据用户的需求描述,服务器请求(创建)或者获取schema(修改)组织prompt,多次调用openai接口,最后整合GPT返回与实际交付前端的DSL,前端根据DSL进行渲染:  三、实现原理 3.1 智能问答助手 向量化: 通过京喜团队隆德提供的集团内部向量库实现文档向量存储与文档召回能力 流式处理: res.body.on('data', data => { const lines = data.toString().split('\n').filter(line => line.trim() !== ''); for (const line of lines) { const message = line.replace(/^data: /, ''); if (message === '[DONE]') { stream.end(); return; // Stream finished } try { const parsed = JSON.parse(message); if (parsed.choices[0].finish_reason !== 'stop') { stream.write(parsed.choices[0].delta.content); } } catch(error) {} }}); 3.2 智能创建  3.3 智能修改  3.4 GPT prompt与核心实现  四、未来规划 4.1 目前存在的问题与目标   4.2 开发环境效果演示   4.3 任务拆分执行架构  4.4 连续对话tokens计算 与 GPT prompt 连续对话实现比较容易,只要每次访问GPT携带之前的聊天记录即可,那么问题来了,连续对话是占用tokens,多轮对话后tokens巨大,GPT接口只有max_token来指定返回的最大token数,对话记录的token数占用需要自己统计。也就是 max_token = 模型token数 - 已占用token数 如何统计已占用token数呢? OpenAi官方:tiktoken 但不幸的是不支持node,开源社区有一个dpbd/tiktoken 但是使用起来比较麻烦。 这里有一个笔者自己基于dpbd/tiktoken进行二次封装的@mfe/get-gpt-tokens,方便tokens的计算、只有message时非常精准、有functions会有40左右token大于真实tokens,其实, 够用了。 奉上几个为任务勤恳打工的GPT的prompt: 五、总结 即时设计接入 AI 的方式是抽象出一层 DSL,让 AI 通过 DSL 了解即时设计能力,同时输出 DSL 解析执行。 ChatGPT x 低代码平台 ≈ DSL + Prompt + Function 彩蛋🥚:本文中带有🤖标识的文案均为GPT生产🎉,感兴趣的小伙伴欢迎一键三连,私信一起交流~ 参考文献: 1.chatGPT有,但不多的的即时设计智商 作者:京东零售张熙沐枫 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

揭秘饿了么跨端技术的演进、实践与落地

本文会先带领大家一起简单回顾下跨端技术背景与演进历程与在这一波儿接着一波儿的跨端浪潮中的饿了么跨端现状,以及在这个背景下,相较于业界基于 React/Vue 研发习惯出发的各种跨端方案,饿了么为什么会选择走另外一条路,这个过程中我们的一些思考、遇到及解决的问题和取得的一些成果,希望能给大家带来一些跨端方面的新思路。 跨端技术背景与演进历程 跨端,究竟跨的是哪些端? 自 90 年的万维网出现,而后的三十多年,我们依次经历了 PC 时代、移动时代,以及现在的万物互联(的 IoT )时代,繁荣的背后,是越来越多的设备、越来越多的系统以及各种各样的解决方案。 总的来说,按照跨端的场景来划分,主要包含以下 4 类: 跨设备平台,如 PC(电脑)/ Mobile(手机)/ OTT(机顶盒)/ IoT(物联网设备)。不同的设备平台往往意味着不同的硬件能力、传感器、屏幕尺寸与交互方式 跨操作系统,如 Android/iOS/HarmonyOS。不同的操作系统为应用开发通常提供了不同的编程语言、应用框架和 API 跨移动应用,如 微信/支付宝/手淘/抖音/快手等。由于移动平台 CS 架构 及 App 间天然的壁垒,不同 App 间相互隔离,并各自在其封闭体系内遵循一套自有标准进行各类资源的索引、定位及渲染。而同一业务投放至不同 App 端时,就需要分别适配这些不同的规则。 跨渲染容器,如 Webview/React Native/Flutter。前面三类场景催生了针对不同设备平台、不同操作系统、不同 App 间解决方案,因而移动领域的各种 Native 化渲染、自绘渲染与魔改 Webview 的方案也由此被设计出来,在尝试解决跨端问题的同时,也一定程度上提高了跨端的迁移门槛和方案选择难度。 而在当下,移动领域依然是绝对的主角,我们来看一下移动端的跨端技术都经历了哪些阶段。 移动跨端技术演进 随着移动互联网的蓬勃发展,端形态变的多样,除了传统的 Native、H5 之外,以动态化与小程序为代表的新兴模式百花齐放大行其道,世面上的框架/容器/工具也层出不穷,整个业态朝着碎片化方向发展。 对开发者来说,碎片化的直接影响,是带来了包括但不限于,刚才提到的设备平台、操作系统、渲染容器、语法标准等方面的各种不确定性,增加了大量的学习、开发与维护成本。 于是,应运而生的各类跨端技术,核心在于从不确定性中找寻确定性,以保障研发体验与产物一致性为前提,为各端适配到最优解,用最少成本达到最好效果,真正做到 "一次编写,到处运行"。 移动跨端大致经历了如下几个阶段: H5 Wap 阶段:Web 天然跨平台,响应式布局是当时的一个主要手段,但由于早期网络环境原因,页面加载速度无法满足业务预期,加之设备传感器标准缺失、内存占用大、GPU 利用率低等问题,在移动设备量爆发伊始,难堪大任的论调一下子被推上风口浪尖,并在 12 年达到顶峰。 Hybrid 阶段:典型代表是 Cordova/ionic。功能上看,Hybrid 解决了历史两大痛点: 1)性能,依靠容器能力,各类离线化、预装包、Prefetch 方案大幅减少加载耗时,配合编码优化在 3/4G 时代使 H5 的体验上了一个台阶; 2)功能,通过 JSBridge 方式规避了与 Native 原生割裂带来的底层能力缺失。 框架+原生阶段:典型代表是 ReactNative/Weex。基于 JSC 或类似的引擎,在语法层与 React/Vue 结合,渲染层使用原生组件绘制,尝试在研发效率与性能体验间寻找更佳的平衡点,各类领域解决方案(受限 DSL + 魔改 web 标准 + Native 渲染能力)开始涌现,拉开了大前端融合渲染方案的序幕。 自绘渲染阶段:典型代表是 Flutter/Qt。这里的 “自绘” 更强调不使用系统原生控件或 Webview 的渲染管线,而是依赖 Skia、Cairo 等跨平台图形库,自底向上自建渲染引擎、研发框架及基础配套的方式,其跨 Android/iOS 的特性迅速点燃了客户端研发领域。 小程序阶段:典型代表是 微信/支付宝小程序。小程序是被创造出来的,其本质是各 APP 厂商出于商业考量构造了相对封闭的生态,在标准与能力上无论与 Web 还是厂商之间均存在差异,能力上是自定义 DSL & API + Hybrid + 同层渲染 + 商业管控的综合体。市面跨端方案策略均是锚定一种研发规约进行各形态编译时与运行时的差异抹平与适配。 回顾了以上跨端技术背景与演进历程,在这股浪潮里面,饿了么的跨端投放情况是什么样的?投了哪些端?遇到了哪些问题?又是如何解决的? 众所周知,饿了么是围绕 O2O 为用户提供线上到线下服务的公司,通过对时、空、人、货 的有机结合,来链接商家与消费者,相比于传统电商,时空人货本身具有区域属性,这意味着我们做的不是一个大卖场生意,更多的是需要围绕区域特性提供精细化的服务,这里面有一系列时空、体验、规模、成本的约束需要考虑与应对 而在这一系列约束背后,其实有一个各方共通的经营诉求: 对于商家来说:为了有更好的经营需要有更多曝光,与客户有更多的触达,以便带来成交。 对于平台来说:为了能够让更多消费者享受我们的服务,除了深耕自己的超级APP(饿了么APP)外,还需要在人流量大的地方加大曝光、声量与服务能力来扩大我们的规模。 这都导向一个目的:哪里流量多,我们就需要在哪里提供与消费者的连接能力。 那么问题来了,流量在哪里?现在的互联网,更多都是在做用户的时间与精力生意,背后拆解下来,其实有几个关键因素可以衡量:用户密度、用户活跃度、市场占有率与用户时间分配,细化来看,其中任意几个条件满足,都可以作为我们流量阵地的候选集。 饿了么经过多年耕耘,对外部关键渠道做了大量布局,业务阵地众多,从效果上看,渠道业务无论是用户流量规模还是订单规模均对大盘贡献度较高,且随着业务的持续精进与外部合作环境的持续改善,增量渠道也在不断的涌现中。 在这么多的业务阵地中,投放在各个端的应用的形态基于: 渠道的运行环境 渠道的流量特性 渠道的业务定位 渠道的管控规则 等的差异和限制,目前形成了 以小程序为主,H5为辅 的承接方式,而这些差异带来了大量的不确定性,主要体现在: 渠道环境的高度不确定性:对接了这么多渠道,每个端的运行环境存在巨大差异,拿小程序能力举例,即使是个别 APP 的小程序方案借鉴了微信的思路,由于其内部商业能力、产品设计思路、能力成熟度与完整度、研发配套(语法、框架、工具等)的不一致也会使研发体感有明显的不同,这对技术同学来说,带来的是渠道环境的高度不确定性; 业务诉求的高度不确定性:同时,我们所投放的 APP 都可划分到某些细分领域,用户特性与用户在该平台上的诉求不一,渠道定位也不一致,随着每个业务域的功能演进越来越多,多个渠道功能是否对齐、要不要对齐、有没有对齐、什么时候对齐成了一个非常现实和麻烦的事情,同时业务域之间可能还存在功能上的关联,这进一步提高了其复杂度,在没有一个好的机制与能力保障下,业务、产品、研发对每个渠道的同步策略、能力范围的感知会有较大偏差,甚至于一个需求的迭代,每个端什么时候能同步都变成了一个无法预期的事情,这对于业、产、研来说,带来的是业务诉求上的高度不确定性。 而我们要做的,就是在这两种不确定性中,找到技术能带来的确定性的事情。如何系统性的解决这些问题,则成为我们在保障渠道业务灵活性的基础上持续提升研发效率和体验的关键。 在差异应对上,业务研发最理想的方式是对底层的变化与不一致无感,安心应对业务诉求,基于这个点出发,我们的主要策略是:围绕 “研发体验一致性提升与复杂应用协作机制改进”来保障业务高效迭代。这需要一套强有力的、贴合业务特性的基础设施来支撑。首先想到的便是如何通过“推动框架统一”和“实现一码多端”,来为业务研发降本增效,然而理想很丰满,现实很骨感: 框架的升级通常情况下,大概率会带来业务重构,综合评估之后,作为外部渠道流量大头的小程序业务,则成为了我们优先要保障的业务,也基于此,为了尽可能降低对业务的影响和接入成本,我们明确了以小程序为第一视角来实现多端。 基于小程序跨端的行业现状和思考 在明确了方向之后,那么问题来了:业界有没有适合我们的开源的框架或解决方案呢? 市面上,从小程序视角出发,具备类似能力的优秀多端框架有很多,有代表性的如 Taro、uni-app、Rax 等,大多以 React 或者 Vue 作为 DSL 那么这些框架能否解决我们所面临的问题?答案是:并不能。 为什么饿了么选择以小程序 DSL 为基础实现跨端? 综合 饿了么 的渠道业务背景需要考虑以下几点: 改造成本:以支付宝、微信、淘宝为代表的饿了么小程序运营多年,大部分存量业务是以支付宝或微信小程序 DSL 来编写,需关注已有业务逻辑(或组件库)的改造成本,而采纳业界框架基本上会直接引发业务的大量重构,这个改造成本是难以接受的。 性能体验:渠道业务是饿了么非常重要的流量阵地,重视程度与APP无差,在体验和性能上有极致的要求,所以我们期望在推动跨端的同时,尽可能减少运行时引入带来的性能损耗。 业务协同:由于每个渠道都基本相当于一个小型的饿了么APP,复杂度高,涉及到多业务域的协同,包括主线步调一致性考量、多业务线/应用类型集成、全链路功能无缝衔接等,在此之外还需给各业务线最大限度的自控与闭环能力,背后需要的是大型小程序业务的一体化研发支撑。 在做了较多的横向对比与权衡之后,上面的这些框架对于我们而言采纳成本过高,所以我们选择了另外一条相对艰辛但更为契合饿了么多端演进方向的路:以小程序原生 DSL 为基础建设跨端解决方案,最大限度保障各端产物代码贴合小程序原生语法,以此尽可能降低因同构带来的体验损耗和业务多端接入成本。 基于小程序 DSL 的跨端解决方案 确定以小程序 DSL 作为方向建设跨端解决方案之后,首先要解决的就是如果将已有的小程序快速适配到多端。这就需要对各个端的差异做细致的分析并给出解决方案。 如何解决小程序多端编译? 为了能够兼顾性能和研发体验,我们选择了 编译时(重)+运行时(轻) 的解决方案。 静态编译解决了哪些问题? 静态编译转换主要用于处理 JS、WXS/SJS、WXML/AXML、WXSS/ACSS、JSON 等源码中约束强且不能动态修改的部分,如: 模块引用:JS/WXS/SJS/WXML/AXML/WXSS/ACSS/JSON 等源码中的模块引用替换和后缀名修改; 模版属性映射或语法兼容:AXML/WXML 中如 a:if → wx:if、 onTap → bind:tap、{ {`${name}Props`}} → { {name + 'Props'}} 等; 配置映射:如页面 { "titleBarColor": "#000000" } → { "navigationBarBackgroundColor: "#000000", "navigationBarTextStyle": "white" } 等,原理是通过将源码文件转换为 AST(抽象语法树),并通过操作 AST 的方式来实现将源码转换为目标平台的代码。 但静态编译只能解决一部分的差异,还有一些差异需要通过运行时来抹平。 运行时补偿解决了哪些问题? 运行时补偿主要用于处理静态编译无法处理或者处理成本较高的一些运行时动态内容,如: JSAPI:实际业务使用上,不管是 JSAPI 的名字还是 JSAPI 的入参都会存在动态赋值的情况,导致了在 JSAPI 的真实调用上,很难通过 AST 去解析出实际传参; 自定义组件 - Props 属性:比如,支付宝属性使用 props 声明,而微信属性使用 properties 声明,配置方式不同且使用时分别使用 this.props.x及 this.properties.x的方式获取,同时可能存在动态取值的情况; 自定义组件 - 生命周期:支付宝小程序中的didUpdate生命周期,在触发了props和data更新后都会进入didUpdate这个生命周期,且能够在didUpdate中访问到prevProps / prevData,而在微信小程序中静态转义出这个生命周期就意味着你需要去动态分析出didUpdate里面要用到的所有属性,然后去动态生成出这些属性的监听函数。这显然可靠程度是极其低的; 等等,类似的场景有很多,这里不再一一列举。 通过静态编译 + 运行时补偿的方式,我们便可以让现有的微信或支付宝小程序快速的迁移到其他小程序平台。 如何解决小程序转 Web? 伴随外卖小程序上线多年之后,各个大的渠道(支付宝、手淘、微信等)已切流为小程序承载,但是还有很多细分渠道或非小程序环境渠道,比如:各个银行金融渠道,客户端的极小包等,还需要依赖 H5 的形态快速投放,但当前饿了么的业务越来越复杂,相关渠道的投入资源有限,历史包袱重、迭代成本大等原因,产品功能和服务能力远远落后于小程序和饿了么App。而业务急需一个可以将小程序的功能快速复制到 h5 端的技术方案,以较低的研发和维护成本,满足业务多渠道能力对齐上线的诉求。 基于这个背景,我们自然而然的可以想到,即然小程序可以转其他小程序,那么是否也可以直接将小程序直接转换为 Web,从而最大程度上提升人效和功能对齐效率。 具体是怎么实现的?主要手段还是通过编译时 + 运行时的有机结合: Web 转端编译原理 编译部分和小程序转小程序的主要区别和难点是:需要将 JS、WXS/SJS、WXML/AXML 等文件统一转换并合并为 JS 文件并将 WXML/AXML 文件转换为 JSX 语法,将样式文件统一转换为 CSS 文件,并将小程序的页面和组件都转换为 React 组件。 运行时原理 转 Web 的运行时相较于转换为其他小程序会重很多,为了兼顾性能和体验,运行时的核心在于提供与小程序对等的高效运行环境,这里面包含四个主要模块: 框架:提供了小程序在 Web 中的基础运行时功能,比如:Page 、Component 、App 等全局函数,并且提供完整的生命周期实现,事件的注册、分发等 组件:提供小程序公共组件的支持,比如 view、button、scroll-view 等小程序原生提供的组件 API:提供了类似小程序中 wx 或者 my 的 一系列 api 的实现 路由:提供了页面路由支持和 getCurrentPages 等方法支持 基于这四个模块,配合编译时的自动注入和代码转换,以及路由映射等,我们就可以把一个小程序转换为一个 Web 的 SPA(单页) 或者 MPA(多页) 应用,也成功的解决了业务的研发效率问题,目前 饿了么的新 M 站就是基于这套方案在运行。 解决了各端的编译转换问题,是不是就万事大吉,业务接下来只要按部就班的基于这套能力实现一码多端就可以了? 然而并不是,随着饿了么的业务场景和范围快速拓展,诞生了一些新的诉求,比如: 支付宝的独立小程序作为分包接入微信小程序 淘宝 / 支付宝的小程序插件作为分包接入某个现有的微信小程序 支付宝的独立小程序作为插件接入淘宝小程序插件 支付宝小程序插件作为分包接入微信或抖音小程序 等等,大家如果仔细观察这些诉求,就会发现一个共同的点:就是小程序的形态不一样。 虽然我们已经具备了多端的能力,但是形态的差异没有解决掉,而之前相关业务的做法是,尽可能将通用功能沉淀到组件库,并按照多端的方式分端输出产物,然而由于相同业务在不同小程序端形态差异性的问题,业务上难以自行规避,而重构的成本又比较高,所以有一部分业务选择了直接按照不同的端不同的形态(如微信、支付宝、淘宝、抖音)各自维护一套代码,但这样做不仅功能同步迭代周期被拉长,而且 BUG 较多,维护困难,研发过程也是异常痛苦。 小程序形态差异有哪些? 形态差异是指 小程序、小程序分包、小程序插件 三种不同形态的运行方式差异以及转换为其他形态之后产生的差异,具体如下: getApp 差异 小程序: 可通过 getApp() 来获取全局 App 实例及实例上挂载的属性或方法 小程序插件: 无法调用 getApp() 小程序分包: 可通过 getApp() 来获取全局 App 实例及实例上挂载的属性或方法;但当通过小程序转换为分包后,分包自身原本调用的 getApp 将失效,并被替换为宿主小程序的 getApp App 应用生命周期 差异 小程序: 应用会执行 onLaunch、onShow、onHide 等生命周期 小程序插件: 无应用生命周期 小程序分包: 无应用生命周期 全局样式(如:app.wxss 或 app.acss)差异 小程序: 可通过全局样式来声明全局样式 小程序插件: 无全局样式 小程序分包: 无全局样式 NPM 使用限制 小程序: 各个小程序平台支持和限制情况不一 小程序插件: 各个小程序平台支持和限制情况不一 小程序分包: 各个小程序平台支持和限制情况不一 接口调用限制 小程序: 无限制 小程序插件: 存在大量的接口调用限制,如 开发支付宝小程序插件 或 开发微信小程序插件 小程序分包: 无限制 路由差异 小程序: 转换到其他形态后自身路由会发生变化 小程序插件: 转换到其他形态后自身路由会发生变化,跳转插件页面需要包含 plugin:// 或 dynamic-plugin:// 等前缀,小程序或分包则不需要 小程序分包: 转换到其他形态后自身路由会发生变化 getCurrentPages 差异 小程序: 无限制 小程序插件: 无法通过 getCurrentPages 获取到小程序的页面堆栈 小程序分包: 无限制 页面或组件样式差异 小程序: 无限制 小程序插件: 基本选择器只支持 ID 与 class 选择器,不支持标签、属性、通配符选择器 小程序分包: 无限制 等等,相关形态差异可结合各个小程序平台查看,这里仅罗列常见的部分。 如何解决这些差异? 这里举几个例子: 通过在编译过程中,自动向产物中注入对 App 和 getApp 的运行时模拟实现,这样就可以解决分包和插件下方法缺失或者是冲突引起的报错问题。 方法也是类似,可以在编译的过程中检测全局样式是否存在,如果存在,则将对应的全局样式引用自动注入到每一个页面和组件中来解决全局样式失效的问题。 而针对各个小程序平台的 NPM 使用规则不同的问题,可以通过依赖解析、动态分组、组件提取打包、引用替换等方式,将 NPM 抽取到特定的地方,并将对应的组件和页面中的引用进行替换,来解决 NPM 的支持问题,这样业务就可以基本无脑使用各类 NPM 而不用关心平台差异。 以此类推,将业务难以自行适配的差异,逐一解决之后,剩余的一些功能差异,则由业务基于条件编译的方式来自行适配,这样便可以大大的降低业务形态转换成本,同时也形成了我们面向多端场景下的形态转换方案。 那么到这里,多端转换的问题才算是基本解决了。 如何治理 “复杂小程序”? 如果说上面讲的内容都是聚焦在如何通过编译的方式来解决多端同构以及形态问题的话,那么接下来要解决的就是针对“复杂小程序”的应用架构与研发协作的问题了。 首先介绍下我们所定义的“复杂小程序”,即具备跨业务领域的、长周期的、多团队协同的、呈现主链路+多分支业务模式的应用,其之所以“复杂”,主要体现在应用形态多样、诉求多样、关联业务面广等特性上。 对于饿了么来说,每个渠道阵地均相当于一个小型饿了么APP,除了在研发上提供便利外,还需一套可靠的应用架构来保证其有序演进。 同时,由于渠道之间定位不同,各域的业务、产品及研发对各渠道重视程度与投入比重均有差异,间接导致渠道间相同业务能力的参差不齐,且不同渠道功能缺失的情况持续出现。 我们以饿了么微信小程序为例: 面临的问题有哪些? 工程复杂导致研发效率低:大量的团队在一个单体小程序应用上研发,带来的直接问题就是小程序巨大化带来的研发体验差和编译效率低,且业务相互依赖,单一模块构建失败会引发整个项目的失败,比如饿了么微信小程序单次编译的时间超过了半个小时,且体积逼近 20m 上限。 研发流程不规范导致稳定性差:同时由于不同的业务团队迭代周期不一致,而每次发版都需要所有业务的代码一起发,哪怕是某个业务分包或者插件没有更新,但是对应的底层依赖库发生了变更,也极有可能引入线上 BUG,导致测试回归的成本居高不下,发版质量难以保障。 解决方案:线下线上结合的集成研发模式 针对上面两个“复杂小程序”所面临的核心问题,我们针对性的通过 「线下集成研发」和「线上研发协作」来解决。 线下集成研发 重点考虑的是提供什么样的集成研发能力,允许以业务单元维度将多个独立的构建(宿主、小程序、插件、分包等)组成一个可用的小程序,消除业务之间强依赖关系,从而达成业务可独立开发、调试和部署的目的,方面统一业务协作流程、降低多端同构成本,关键策略: 提供统一的集成研发方式和流程 提供标准、可复用的集成产物规范 为复杂小程序提供解耦工具和集成方法 标准化小程序宿主、小程序插件、小程序分包、小程序模块之间的通信及能力注入方式 将小程序宿主和各个业务模块(分包、小程序、插件)通过形态转换、拉包、编译、构建、合并等一系列处理后,合并为一个完整小程序,且根据不同的场景可以支持: 主子分包研发模式:基于不同业务对小程序中的分包进行拆分,以达到各个业务相互解耦,独立迭代的目的; SDK 研发模式:将通用的页面或组件封装置某个 NPM 包中作为提供特定功能的 SDK 交由业务使用; 小程序插件研发模式:集成研发也可以用支持标准的小程序插件研发。 这样我们就可以解决线下研发的问题。 线上研发协作 前面介绍的“线下集成研发”为业务单元提供了无阻塞的开发与调试能力,但对于饿了么业务整体演进来说,重视的是每个版本功能的可用与可控,这里面除了将集成的范围扩展到所有业务域的之外,还需要标准化的流程约束: 具体方式上,在机制层面提供了业务类型定义的能力,开发者可将工程做对应标记(主包、分包、插件、独立小程序),在流程层面定义了开发、集成与发布三个阶段,这和 APP 的研发流程有些类似: 开发:各业务应用自行研发并结合平台部署测试,开发测试通过,等待窗口期开启进入集成测试; 集成:管理员设置集成窗口期,在窗口期,允许业务多次集成研发,确认最终要进集成的稳定版本,期间主包管理员可多次部署体验版用于集成测试。窗口期结束后,不允许随意变更; 发布:集成测试通过,各业务进行代码 CR 并进入发布阶段,等候主包提审通过发布上线,最终由管理员完成本次迭代发布,发布完成后,符合标准的主分包产物会被保存下来,后续的迭代中,如果某个分包未发生变更,则会直接复用产物,极大的降低了业务的发布风险,并提升了整体的构建效率。 再进一步,多端业务的最佳实践 通过线下集成+线上协作的双重能力加持,结合已有的多端编译能力,在成功的支撑了饿了么多端渠道业务的稳定高效研发的同时,我们也在思考,面向于未来的多端研发模式应该是个什么样子? 下图是我们期望同时也是饿了么目前多端应用架构正在演进中的样子: 从图上可以看出,我们将应用架构划分为三层(从下往上看): 基础服务与研发规范:最底部的是基础服务与研发规范,由 多端研发框架、多端研发平台和多端研发规范,来提供统一的研发支撑,保障业务研发的基础能力、体验和效率,并负责将相关的业务统一打包、封装、集成,并部署和投放到不同的渠道; 宿主应用框架:第二层是宿主应用框架(Framework),也可以认为是多端统一解决方案,承接了面向于业务研发并适配了多端差异的基础 API(如 登录、定位、请求、路由、实验、风控、埋点、容器等)、基础组件和最佳实践,通过分渠道的配置化运行、标准化的接入手段和中心化的能力管理,来保障整体框架的轻量化、标准化与持续迭代和升级; 渠道应用主体:最上层是各个业务的应用实体,有一个壳工程 + N个业务工程组成,壳工程承接各个渠道定制化的一些能力,而并将下层应用框架的能力暴露给上层的各个业务,各个业务只需要关心两件事即可: 多端形态:以什么样的形态接入到对应的渠道(即壳工程中)? 业务功能:不同的渠道需要展示哪些功能? 基于这种分层协作模式,可以最大程度上消除业务对多端差异的感知,可以将重心放在如何更好的为用户提供服务上。 以上内容为饿了么基于小程序 DSL 的跨端实践和解决方案,下面我们来看一下具体取得的成果。 跨端成果 饿了么各渠道业务效果展示 业务一码多端研发提效数据 研发提效:采用一码多端和集成研发模式的业务平均提效 70%,同构的端越多提效越多 多端占比:饿了么内部 85%+ 的多端业务在基于这套方案实现多渠道业务研发和投放 业务覆盖:涵盖了饿了么全域的各个业务板块 能力沉淀 — 饿了么自研 MorJS 多端研发框架 MorJS 开源 我们将饿了么在跨端多渠道上的多年沉淀和解决方案,融合为 MorJS 多端研发框架,并通过 Github 开源的方式向社区开放。 GitHub 仓库地址:https://github.com/eleme/morjs 下图为 MorJS 的完整架构图: MorJS 框架目前支持 : 2 种 DSL:微信小程序 DSL 或 支付宝小程序 DSL 4 种编译形态:小程序、小程序插件、小程序分包、小程序多端组件 9 个目标平台:微信、支付宝、百度、字节、快手、钉钉、手淘、QQ、Web 并支撑了饿了么 C 端大多数业务在各个渠道上的研发和投放。 MorJS 为饿了么解决了大量业务在多端研发上的差异问题,让小程序开发的重心回到产品业务本身,减少使用者对多端差异兼容的投入。通过 MorJS 的开源,我们期望能把其中的实现细节、架构设计和技术思考呈现给大家,为更多有类似多端同构需求的企业和开发者服务。同时,我们也希望能够借此吸引到更多志趣相投的小伙伴参与共建,一起加速小程序一码多端能力的发展。欢迎广大小程序开发者们与我们交流。 MorJS 特性介绍 为了能够帮助社区的用户可以快速上手,我们在易用性、标准化和灵活性方面做了大量的准备: 易用性: DSL 支持:可使用微信小程序 DSL 或 支付宝小程序 DSL 编写小程序,无额外使用成本; 多端支持:支持将一套小程序转换为各类小程序平台及 Web 应用, 节省双倍人力; 快速接入:仅需引入两个包,增加一个配置文件,即可简单快速接入到现有小程序项目; 标准化: 开箱即用:内置了脚手架、构建、分析、多端编译等完整研发能力,仅需一个依赖即可上手开发; 表现一致:通过编译时+运行时抹平多端差异性,让不同平台的小程序获得一致的用户体验; 形态转换:支持同一个项目的不同的形态,允许小程序、分包、插件不同形态之间的相互转换; 灵活性: 方便扩展:MorJS 将完备的生命周期和内部功能插件化,使用插件(集)以满足功能和垂直域的分层需求; 类型支持:除小程序标准文件类型外,还支持 ts、less/scss、jsonc/json5 等多种文件类型; 按需适配:可根据需求选择性接入适配能力,小项目仅需编译功能,中等项目可结合编译和页面注入能力,大型项目推荐使用复杂小程序集成能力; 同时也提供了丰富的文档:https://mor.eleme.io/供大家查阅。 用户原声 MorJS 上线的这几个月里面,我们收到了一些社区用户的正向反馈,也收到了一些诉求和问题,其中用户最担心的问题是:MorJS 是不是 KPI 项目,是否会长期维护? 这里借用一下我在 Github 项目的讨论区(Discussions)的回复: 展望未来 未来,在现有的 MorJS 的能力基础上,我们会进一步完善已有的多端能力,提升多端转换可用度,完善对各类社区组件库的兼容,并持续扩展编译目标平台的支持(如 鸿蒙、快应用等),在持续为饿了么自身业务和社区用户提供高质量服务的同时,期望有朝一日 MorJS 可以成为业界小程序多端研发的基础设施之一。 作者|羽境 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

落地领域大模型应知必会 (1) :主要微调方法总览

编者按:随着大规模预训练模型的发展和应用,大模型微调技术已经在很多领域都有了突破性的进展,并推动了人工智能技术的发展与应用。 本文会简要介绍上下文学习(in-context learning)的含义,并介绍对LLMs进行微调的各种可行方式。还能够帮助我们了解如何选择大语言模型的微调方法。 快快阅读此文,开启一趟大模型微调学习之旅吧! 以下是译文,Enjoy! 本文经原作者授权,由Baihai IDP编译。如需转载译文,请联系获取授权。 原文链接:https://magazine.sebastianraschka.com/p/finetuning-large-language-models 作者|SEBASTIAN RASCHKA, PHD 编译 | 岳扬 在如今高速发展的人工智能领域,高效地利用大语言模型(LLMs)已经变得越来越重要。但是,利用大语言模型的方式太多了,如果你才刚刚开始接触它,可能会感到不知所措。 实质上,我们可以通过两种主要方式将预训练大语言模型用于新任务:上下文学习(in-context learning)以及微调(finetuning) 。 本文我们将简要介绍上下文学习(in-context learning)的含义,并介绍对LLMs进行微调的各种可行方式。 01 In-Context Learning和Indexing 自从GPT-2(Radford等人[1])和GPT-3(Brown等人[2])问世以来,我们发现,在通用文本语料库上进行预训练的生成式大语言模型(LLMs)可以进行上下文学习。这意味着,如果我们想要执行新的特定任务,我们无需对预训练的LLM进行进一步的训练或微调,可以通过输入Prompt直接提供一些目标任务的示例,如下面的例子所示。 上下文学习的例子 如果我们不能直接访问模型(例如如果我们通过API使用模型),那么上下文学习就用处非常大。 与上下文学习相关的是hard prompt tuning,即试图通过修改输入改善输出,如下图所示。 An illustration of (hard) prompt tuning顺便说一下,我们称这种方法为hard prompt tuning,因为在这种方法中,我们直接修改了输入的单词或tokens。稍后我们将讨论另外一种版本的方法,称为soft prompt tuning(或通常称为prompt tuning)。 刚刚提到的prompt tuning方法为参数微调(parameter finetuning)提供了一种替代方案(且这种方案更节省资源)。然而,它的性能通常不及微调(finetuning),因为这种方法不会针对特定任务更新模型的参数,这可能会限制它对不同特定任务间细微差别的适应能力。此外,prompt tuning可能需要进行大量工作,耗费大量人力财力,因为这种方法需要人工参与比较不同prompt的质量。 在我们更进一步地讨论微调之前,先来了解另一种利用纯粹的上下文学习的方法——indexing。在大语言模型领域中,indexing可以被视为一种上下文学习的变通方法,其使得LLMs能够转变为信息检索系统(information retrieval systems),从外部资源和网站中提取数据。在这个过程中,indexing模块将文档或网站分解成较小的片段,并将它们转换为可以存储在向量数据库中的向量(vectors) 。然后,当用户提交查询(query)时,indexing模块计算嵌入查询(embedded query)与数据库中每个向量之间的向量相似度(vector similarity)。最终,indexing模块检索出与查询最相似的前k个嵌入(embeddings),生成响应。 An illustration of indexing. 02 常规的基于特征的方法和微调方法 如果我们无法直接访问大型语言模型(LLM),例如通过API或使用用户界面与LLM进行交互,那么上下文学习是一种有价值且用户友好的方法。 然而,如果我们可以直接接触到LLM,使用目标领域的数据对其进行调整(adapting)和微调(finetuning)通常会获得更好的结果。那么,如何使一个模型适应目标任务呢?下图概述了三种常见的方法: 3种常规的基于特征的方法和微调的方法 下文中,我们将以对编码器类型(encoder-style)的大型语言模型(例如BERT)微调为例,解析具体的微调方式原理和示例代码。下述示例微调任务为分类器任务,在这个任务中,我们试图预测电影评论是正面情感还是负面情感。需要注意的是,除了对编码器类型(encoder-style)的LLM进行微调外,同样的方法也适用于类似GPT的解码器类型(decoder-style)的LLM。在后续的文章中,我将会举例说明这一点。 此外,我们还可以对解码器类型(decoder-style)的LLM进行微调,以生成对特定指令的多句子回答(multiple-sentence answers),而不仅仅是进行文本分类。关于这个问题,我会在未来的文章中提供实战案例,敬请期待。 2.1 基于特征的方法 在基于特征的方法(feature-based approach)中,我们需要加载一个预训练LLM,并将其应用于目标数据集。在这种方法中,我对生成训练集的输出嵌入(output embeddings)特别感兴趣,这些嵌入可以作为输入特征(input features)用于训练分类模型(classification model)。虽然这种方法在像BERT这样以嵌入为重点的模型中非常常见,但我们也可以从生成式的 GPT-style 模型中提取嵌入。 接下来,我们可以使用逻辑回归模型(logistic regression model)、随机森林(random forest)或XGBoost等任何我们想要使用的模型作为分类模型。(然而,根据我的经验,在这种情况下,像逻辑回归(logistic regression)这样的线性分类器(linear classifiers)表现最佳) 理论上,我们可以用下面这段代码来解释基于特征的方法: model = AutoModel.from_pretrained("distilbert-base-uncased") # ... # tokenize dataset # ... # generate embeddings @torch.inference_mode() def get_output_embeddings(batch): output = model( batch["input_ids"], attention_mask=batch["attention_mask"] ).last_hidden_state[:, 0] return {"features": output} dataset_features = dataset_tokenized.map( get_output_embeddings, batched=True, batch_size=10) X_train = np.array(imdb_features["train"]["features"]) y_train = np.array(imdb_features["train"]["label"]) X_val = np.array(imdb_features["validation"]["features"]) y_val = np.array(imdb_features["validation"]["label"]) X_test = np.array(imdb_features["test"]["features"]) y_test = np.array(imdb_features["test"]["label"]) # train classifier from sklearn.linear_model import LogisticRegression clf = LogisticRegression() clf.fit(X_train, y_train) print("Training accuracy", clf.score(X_train, y_train)) print("Validation accuracy", clf.score(X_val, y_val)) print("test accuracy", clf.score(X_test, y_test)) (对此感兴趣的读者可以在此处[4]找到完整的代码) 2.2 微调方法 I —— 更新输出层(Output Layers) 有一种方法与上述基于特征的方法比较相关,叫做微调输出层(本文称之为微调方法 I)。与基于特征的方法类似,这种方法不改变预训练LLM的参数,只会训练新增加的输出层,类似于在嵌入特征(embedded features)上训练逻辑回归分类器(logistic regression classifier)或小型多层感知器(small multilayer perceptron)。 相关代码如下: model = AutoModelForSequenceClassification.from_pretrained( "distilbert-base-uncased", num_labels=2 ) # freeze all layers for param in model.parameters(): param.requires_grad = False # then unfreeze the two last layers (output layers) for param in model.pre_classifier.parameters(): param.requires_grad = True for param in model.classifier.parameters(): param.requires_grad = True # finetune model lightning_model = CustomLightningModule(model) trainer = L.Trainer( max_epochs=3, ... ) trainer.fit( model=lightning_model, train_dataloaders=train_loader, val_dataloaders=val_loader) # evaluate model trainer.test(lightning_model, dataloaders=test_loader) (对此感兴趣的读者可以在此处[4]找到完整的代码) 从理论上讲,这种方法的建模性能和速度(modeling performance and speed)应该与基于特征的方法差不多,因为都会去冻结骨干模型(frozen backbone model)(译者注:通过冻结骨干模型,我们可以保持其模型权重不变,仅对任务模块进行训练。这样可以减少需要更新的参数数量,提高训练效率,并在一定程度上保留原始骨干模型的特征提取能力)。然而,由于基于特征的方法使得预计算(pre-compute)和存储训练数据集的嵌入特征(embedded features)稍微更容易一些,所以在具体场景中,基于特征的方法可能更加方便。 2.3 微调方法 II - 更新所有层(All Layers) 虽然BERT那篇论文(Devlin等人)说过,仅微调输出层(output layer)可以实现与微调所有层相当的模型性能,但由于后者涉及的参数更多,所以成本要高得多。 例如,BERT基础模型约有1.1亿个参数。然而,用于二元分类的BERT基础模型最后一层仅包含1500个参数。此外,BERT基础模型的最后两层共有6万个参数,这仅占总模型大小的0.6%左右。 我们选择走哪条路径会根据目标任务和目标领域与模型预训练的数据集的相似程度而有所不同。但是在具体实践中,微调所有层几乎总是能获得更优的模型性能。 因此,在优化模型性能时,使用预训练LLM的黄金标准(the gold standard)是更新所有层(本文称之为微调方法 II)。从理论上讲,微调方法 II 与微调方法 I 非常相似。唯一的区别是方法II不会冻结预训练LLM的参数,而是对其进行微调: model = AutoModelForSequenceClassification.from_pretrained( "distilbert-base-uncased", num_labels=2 ) # freeze layers (which we don't do here) # for param in model.parameters(): # param.requires_grad = False # finetune model lightning_model = LightningModel(model) trainer = L.Trainer( max_epochs=3, ... ) trainer.fit( model=lightning_model, train_dataloaders=train_loader, val_dataloaders=val_loader) # evaluate model trainer.test(lightning_model, dataloaders=test_loader) (对此感兴趣的读者可以在此处[4]找到完整的代码) 上面的这段代码被用来训练一个基于DistilBERT基础模型的电影评论分类器(你可以去the code notebooks看一看[4]) 1)基于特征的方法与逻辑回归:83%的测试准确率(accuracy); 2)微调方法 I,更新最后两层:87%准确率(accuracy); 3)微调方法 II,更新所有层:92%准确率(accuracy)。 这些准确率结果符合预期,即微调更多层通常会获得更好的性能,但也需要花费更高的成本。 本文3种方法的训练效率和模型性能权衡经验之谈 上述场景强调了微调的三种最不同或最极端的情况:即仅训练最后一层(或几层)与训练所有层。当然,具体效果可能会因模型和数据集而异,但在探索两者之间的各种情况也是值得的。 例如,有时候我们只需训练一半的模型,就能获得与训练完成的模型相同的性能(更多关于轻量化微调(parameter-efficient finetuning)的内容将在下一节介绍)。如果你是一个好奇宝宝,下图描述了在IMDB电影评论数据集(IMDB movie review dataset)的2万个训练实例上进行微调的DistilBERT模型的预测性能(predictive performances)和训练时间。 在IMDB电影评论数据集上微调的预训练DistilBERT模型的性能。相关代码可以在GitHub上找到[5] 正如我们可以看到的,仅训练最后一层是最快速的,但模型性能也最差。 符合预期的是,训练更多层会提高模型性能,但也会增加计算成本。 有一件事情非常有趣,可以看到当训练两个全连接的输出层(fully connected output layers)和最后两个transformer blocks(从左边数起的第三个block)时,预测性能(predictive performance)就已经趋于饱和。因此,在这种特定情况下(即对于这个特定的模型和数据集组合),训练超过这些层(layers)似乎是一种计算资源的浪费。 03 轻量化微调(Parameter-Efficient Fine-Tuning) 轻量化微调让我们能够重复使用预训练的模型,同时最大限度地减少算力和资源的占用。总体来说,轻量化微调具有以下五个优点: 1. 能够降低计算成本(需要更少的GPU和GPU运行时间); 2. 拥有更快的训练时间(更快地完成训练); 3. 具备更低的硬件要求(适用于较小显存的GPU和较小的内存); 4. 具有更好的模型性能(降低过拟合); 5. 需要更少的存储空间(大部分weights可以在不同任务(tasks)之间共享)。 在之前的章节中,我们了解到微调更多的层通常会带来更好的结果。上面的实验是基于一个相对较小的DistilBERT模型。但是,如果我们想微调那些几乎无法容纳在GPU显存中的较大模型(例如最新的生成式LLM模型),我们该怎么办呢?当然,我们可以使用上述基于特征的方法或者微调方法I。但假设我们想要获得与微调方法II类似的模型质量呢? 这些年来,研究人员们开发了几种技术(Lialin等人[6])来微调LLM,使其只需要训练少量的参数,也能具有较高的模型性能。这些方法通常被称为参数高效微调技术(parameter-efficient finetuning techniques,PEFT,本文亦译作轻量化微调)。 一些目前最受欢迎的PEFT技术在下图中可见。 最受欢迎的轻量化微调(PEFT)技术可选择项 那么,这些技术是如何工作的呢?简单来说,都涉及到引入少量额外的参数进行微调(而不是像我们在上面的微调方法 II中那样对所有层进行微调)。从某种意义上说,微调方法 I(只微调最后一层)也可以被认为是一种轻量化微调(PEFT)技术。然而,像前缀微调(prefix tuning)、adapters和Low-Rank Adaptation (LoRA,低秩自适应))等技术,它们都“修改”了多个层(layers),以极低的成本实现了更好的预测性能(predictive performance)。 由于本文的篇幅目前已经很长了,而且这些都是超级有趣的技术,我将在未来单独介绍这些技术。 04 基于人类反馈的强化学习(Reinforcement Learning with Human Feedback) 在基于人类反馈的强化学习(Reinforcement Learning with Human Feedback,RLHF)中,使用一种结合了监督学习(supervised learning)和强化学习(reinforcement learning)的方法对预训练模型进行微调——这一方法被 ChatGPT 使用而得到大力推广,而 ChatGPT 又是基于InstructGPT(Ouyang等人[7])的。 在RLHF中,通过让人类对不同的模型输出进行排序或评分来收集人类反馈,从而提供奖励信号(reward signal) 。收集到的奖励标签(reward labels) 可以用来训练奖励模型(reward model) ,进而反过来指导LLM(Language Model)适应人类的喜好。 奖励模型本身是通过监督学习(supervised learning)来学习的(通常使用预训练的LLM作为基础模型)。接下来,使用奖励模型来更新预训练的LLM,使其适应人类偏好——训练过程使用一种被称为近端策略优化(proximal policy optimization,Schulman等人[8])的强化学习方法。 InstructGPT相关论文的截图,概述了RLHF的过程 为什么要使用奖励模型而不是直接在人类反馈的基础上训练预训练模型?这是因为让人类参与模型的学习过程会产生瓶颈(bottleneck),因为我们无法实时获取反馈。 这篇文章的篇幅已经很长了,所以我把更详细的解释推迟到以后的文章中,敬请期待! 05 总结 对预训练LLM的所有层(layers)进行微调仍然是适应新目标任务(new target tasks)的黄金标准(the gold standard),但是对于预训练的Transformer模型,有几种有效的替代方法。诸如基于特征的方法、上下文学习和轻量化微调等这些方法能够有效地将LLM应用于新的任务,同时还能最大限度地减少计算成本和计算资源。 此外,基于人类反馈的强化学习(RLHF)作为监督微调(supervised finetuning,SFT)的一种替代方法,可以提升模型性能。 END 参考资料 1.https://d4mucfpksywv.cloudfront.net/better-language-models/language_models_are_unsupervised_multitask_learners.pdf 2.https://arxiv.org/abs/2005.14165 3.https://arxiv.org/abs/1810.04805 4.https://github.com/rasbt/LLM-finetuning-scripts/tree/main/conventional/distilbert-movie-review 5.https://github.com/rasbt/LLM-finetuning-scripts/tree/main/conventional/distilbert-movie-review/layerwise-experiment 6.https://arxiv.org/abs/2303.15647 7.https://arxiv.org/abs/2203.02155 8.https://arxiv.org/abs/1707.06347 本文经原作者授权,由Baihai IDP编译。如需转载译文,请联系获取授权。 原文链接: https://magazine.sebastianraschka.com/p/finetuning-large-language-models

优秀的个人博客,低调大师

DeepSpeed + Kubernetes 如何轻松落地大规模分布式训练

作者:刘霖 背景现状 随着 ChatGPT 的广泛应用,各种大规模语言模型层出不穷,其中包括 EleutherAI 推出的 200 亿参数的 GPT-NeoX-20B 和 BigScience 发布的 1760 亿参数的 Bloom 模型。 由于模型越来越大,单张 GPU 已无法加载整个模型,分布式模型训练成为了一种必然的趋势。在 GPT-NeoX 和 Bloom 的背后,DeepSpeed 框架是实现分布式模型训练的关键。 DeepSpeed 是一个开源的深度学习训练优化库,提供了多种优化策略,如混合精度训练、数据并行、模型并行、流水线并行等,这些策略可用于加速大规模模型的训练。此外,DeepSpeed 还提供了高性能的分布式训练框架,支持多种主流的深度学习框架,并且可以在不同的硬件和云平台上进行训练。借助 DeepSpeed,算法工程师可以更加快速地训练大规模深度学习模型,从而提高模型的准确性和效率。 当前,越来越多企业在云上基于容器和 Kubernetes 进行大规模的分布式深度学习训练,充分利用弹性、扩展性、自动化、高可用等优势,大幅提高分布式训练的效率和可靠性,同时降低管理成本和复杂性。 然而,随着模型规模扩大以及企业对生产效率的不断追求,将 DeepSpeed 分布式训练任务在 Kubernetes 中搭建和运行仍然存在着很多挑战和难点。例如,GPU资源利用率低,分布式训练扩展性差,以及难以方便地获取实时日志和监控等。 方案介绍 目前,阿里云容器服务 ACK 云原生 AI 套件已经支持 DeepSpeed 分布式训练,为您提供高效便捷的解决方案。 您只需准备好训练代码和数据,就可以利用命令行工具 Arena 快速在 ACK 集群中部署基于 DeepSpeed 的分布式训练任务。此外,可以通过 TensorBoard 可视化工具方便地查看训练作业的状态和结果,从而使 DeepSpeed 分布式训练变得更加容易和高效。 关于 ACK 云原生 AI 套件的更多信息,请通过往期文章进行了解:摆脱 AI 生产“小作坊”:如何基于 Kubernetes 构建云原生 AI 平台 核心优势 基于阿里云容器服务 ACK 云原生 AI 套件搭建和运行 DeepSpeed 分布式训练任务具备以下优势: 大规模异构资源管理 使用容器服务 ACK,您可以轻松管理大规模异构资源,快速搭建基于 CPU、GPU、FPGA 等不同类型计算资源的标准 Kubernetes 集群,实现对各类异构资源进行统一、灵活的管理、调度和运维。云原生 AI 套件还支持多种 GPU 调度策略(共享+隔离、优先级、拓扑感知等)和丰富的 GPU 监控告警等能力,帮您进一步优化资源利用率。 灵活弹性与成本优化 使用 ACK 弹性节点池和 HPA/VPA,您可以灵活按需自动伸缩 GPU 节点数和 Pod 数,并基于 GPU 指标实现 AHPA 弹性预测。云原生 AI 套件支持 ECS、ECI 等弹性资源混合的高级调度,包括 affinity/anti-affinity、pod topology spreading、deploymentset 感知等调度。此外,通过支持资源不足到时终止、checkpoint 自动保存、容错、Failover 等能力,解决基于抢占式实例进行分布式训练的可用性问题,减少训练成本的同时,近乎不影响训练作业成功率。ACK 还提供了成本监控和分析等能力,能够面向任务去管理和优化分布式训练的成本。 高效的任务管理调度 云原生 AI 套件提供命令行工具 Arena,对深度学习核心生产环节(包括数据管理、模型开发、模型训练、模型评估、推理服务部署等)任务进行简单抽象和高效管理。通过 Arena,您可以快速提交分布式训练任务,并提升训练任务从提交到运行的性能,以及进行任务的生命周期管理。此外,云原生AI套件还提供针对分布式场景优化的调度策略,例如按 GPU 卡的 Binpack 算法分配策略,提升 GPU 卡利用率,还支持自定义的任务优先级管理和租户弹性资源配额控制,在确保用户资源分配的基础上,通过资源共享的方式来提升集群的整体资源利用率。 快速使用 下面将介绍如何基于阿里云容器服务 ACK 云原生 AI 套件快速搭建和运行 DeepSpeed 分布式训练: 前提条件 已创建包含 GPU 的 Kubernetes 集群。具体操作,请参见创建包含 GPU 的 Kubernetes 集群 [ 1] 。 已安装云原生 AI 套件(ack-arena 版本不低于 0.9.6)。具体操作,请参见部署云原生 AI 套件 [ 2] 。 已安装 Arena 客户端(版本不低于 0.9.6)。具体操作,请参见安装 Arena [ 3] 。 已给集群配置了 Arena 使用的 PVC,具体操作,请参见配置 NAS 共享存储 [ 4] (或者配置 CPFS 共享存储 [ 5] )。 使用说明 本示例使用 DeepSpeed 训练一个掩码语言模型(Masked Language Model)。为方便运行,已将示例代码 [ 6] 和数据集下载至示例镜像中;若您无需使用示例镜像,也支持从 Git URL下载源代码,并将数据集存放在共享存储系统(基于 NAS 的 PV 和 PVC)中。本示例假设您已经获得了一个名称为 training-data 的 PVC 实例(一个共享存储),用来存放训练结果。 如需自定义训练镜像,请参考如下方式: 方式一: 参考该 Dockerfile [ 7] ,在基础镜像中安装 OpenSSH 方式二: 使用 ACK 提供的 DeepSpeed 基础镜像: registry.cn-beijing.aliyuncs.com/acs/deepspeed:v072_base 示例介绍 本示例中创建了一个 Transformer Bert 模型,根据句子前后的上下文来填充句子。比如在下列句子中: In the beautiful season of ____ the ____ shed their leaves. 根据提供的'In the beautiful season of' 和 'shed their leaves',可以预测到空白处应该填入 'Autumn' 和 'trees'。 本示例通过整合 DeepSpeed 的能力来提高训练的速度和效率,在下列几个方面进行了优化: 混合精度训练:DeepSpeed 支持使用 fp16 数据类型进行混合精度训练。通过在 ds_config 中设置以下配置,即可启用混合精度训练。 "fp16": { "enabled": True } ZeRO 数据并行:Zero Redundancy Optimizer(零冗余优化器)可以支持每个 GPU 都只存储模型参数、梯度和优化器状态的一部分,从而降低 GPU 显存占用,支持更大的模型。当前支持 3 个阶段,阶段 1 对优化器状态进行分片。阶段2还会对梯度进行分片。阶段 3 进一步对模型权重进行分片。通过在 ds_config 中设置以下配置,即可启动阶段 1。 "zero_optimization": { "stage": 1 } ZeRO-Offload:通过同时利用 GPU 和 CPU 的计算和存储资源,比如将优化器状态和梯度保存在内存上,从而使单 GPU 可以支持的模型更大。比如在一张 P40 GPU 上,无法训练一个 20 亿参数的模型,但是使用 ZeRO-Offload 可以做到。通过在 ds_config 中设置以下配置,即可启用 ZeRO-Offload。 "zero_optimization": { "offload_optimizer": { "device": "cpu" } } 本示例中 DeepSpeed 的完整配置文件 ds_config 参考如下。 ds_config = { "train_micro_batch_size_per_gpu": batch_size, "optimizer": { "type": "Adam", "params": { "lr": 1e-4 } }, "fp16": { "enabled": True }, "zero_optimization": { "stage": 1, "offload_optimizer": { "device": "cpu" } } } DeepSpeed 是基于 AllReduce 的分布式训练框架,在 hostfile 中保存了所有的 worker 信息,luancher 读取 hostfile 文件获取 worker 信息,通过 PDSH 的方式在每个 worker 上启动训练任务。 ACK 云原生 AI 套件中的 Operator 组件会自动生成上述配置。准备好模型训练代码和数据后,即可通过 Arena 提交 DeepSpeed 分布式训练任务。如下图所示,Operator 会创建一个 Launcher Pod 和多个 Worker Pod 并在 Worker Pod 上启动训练任务。 操作步骤 提交 DeepSpeed 作业 通过以下代码示例提交包含 1 个 Launcher 节点,3 个 Worker 节点的 DeepSpeed 训练任务。该任务将使用 3 台机器,每台机器上的一张 GPU 卡进行训练。 arena submit etjob \ --name=deepspeed-helloworld \ --gpus=1 \ --workers=3 \ --image=registry.cn-beijing.aliyuncs.com/acs/deepspeed:hello-deepspeed \ --data=training-data:/data \ --tensorboard \ --logdir=/data/deepspeed_data \ "deepspeed /workspace/DeepSpeedExamples/HelloDeepSpeed/train_bert_ds.py --checkpoint_dir /data/deepspeed_data" 预期输出如下: trainingjob.kai.alibabacloud.com/deepspeed-helloworld created INFO[0007] The Job deepspeed-helloworld has been submitted successfully INFO[0007] You can run `arena get deepspeed-helloworld --type etjob` to check the job status 执行以下命令获取作业详情 arena get deepspeed-helloworld 预期输出如下: Name: deepspeed-helloworld Status: RUNNING Namespace: default Priority: N/A Trainer: ETJOB Duration: 6m Instances: NAME STATUS AGE IS_CHIEF GPU(Requested) NODE ---- ------ --- -------- -------------- ---- deepspeed-helloworld-launcher Running 6m true 0 cn-beijing.192.1xx.x.x deepspeed-helloworld-worker-0 Running 6m false 1 cn-beijing.192.1xx.x.x deepspeed-helloworld-worker-1 Running 6m false 1 cn-beijing.192.1xx.x.x deepspeed-helloworld-worker-2 Running 6m false 1 cn-beijing.192.1xx.x.x Your tensorboard will be available on: http://192.1xx.x.xx:31870 通过浏览器查看 TensorBoard 执行以下命令,将集群中的 TensorBoard 映射到本地 9090 端口。 kubectl port-forward svc/deepspeed-helloworld-tensorboard 9090:6006 在浏览器中访问 localhost:9090,即可查看 TensorBoard。 执行以下命令可获取作业日志信息: arena logs deepspeed-helloworld 更多操作命令及参数解释可参考云原生 AI 套件文档 [ 8] 。 相关链接: [1]创建包含 GPU 的 Kubernetes 集群 https://help.aliyun.com/document_detail/171074.html?spm=a2c4g.171073.0.0.4c78f95a00Mb5P [2] 部署云原生 AI 套件 https://help.aliyun.com/document_detail/201997.htm#section-2al-4w3-dpd [3]安装 Arena https://help.aliyun.com/document_detail/212117.htm#task-1917487 [4] 配置 NAS 共享存储 https://help.aliyun.com/document_detail/212177.htm#task-1917776 [5]配置 CPFS 共享存储 https://help.aliyun.com/document_detail/212178.htm#task-1917776 [6] 示例代码 https://github.com/microsoft/DeepSpeedExamples/tree/master/training/HelloDeepSpeed [7]Dockerfile https://github.com/kubeflow/arena/blob/master/samples/deepspeed/Dockerfile [8] 云原生 AI 套件文档 https://help.aliyun.com/document_detail/2249322.html?spm=a2c4g.201994.0.0.23257371FAcYuc 如果您希望深入了解更多关于 ACK 云原生 AI 套件的信息,或者需要与我们就 LLM/AIGC 等相关需求进行交流,欢迎加入我们的钉钉群:33214567。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册