首页 文章 精选 留言 我的

精选列表

搜索[字节级],共10000篇文章
优秀的个人博客,低调大师

千万级调用量微服务架构实践

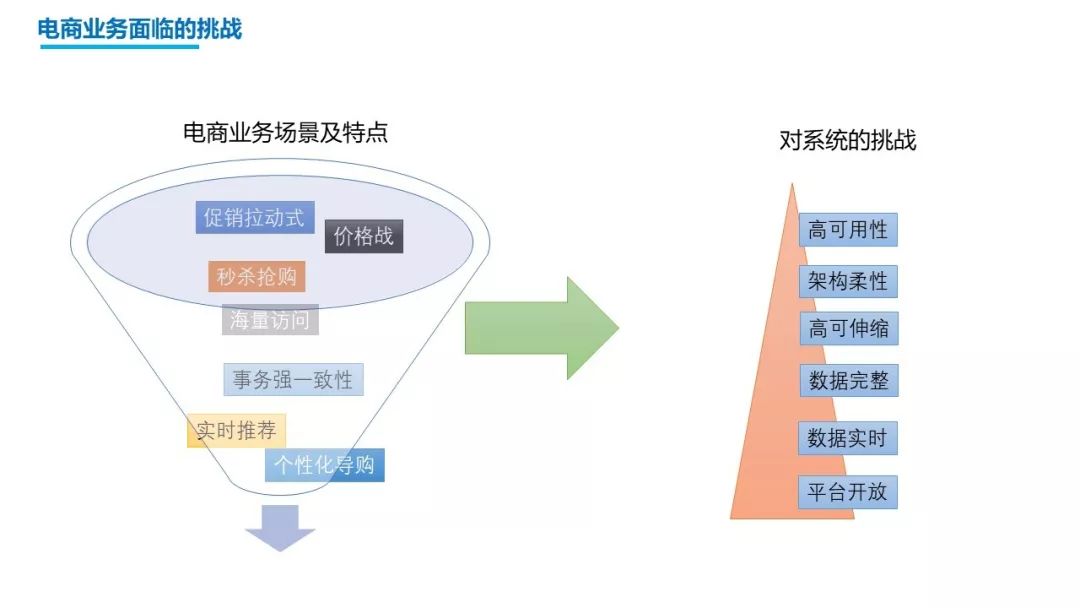
微服务架构在大型电商中的运用 电商是促销拉动式的场景,也是价格战驱动的场景。618和双11都是典型的促销活动。其实都是在抢用户、扩市场占有率。在这样的场景之下,对秒杀、抢购是很热衷的玩法。 促销式的拉动对系统的挑战是什么呢? 可以从上图里看到:对高可用性的要求是非常高的,需要99.99%的高可用性。快速迭代对对系统容性的要求很高,从几万单变成几十万单、百万单,架构上不能影响快速迭代,所以有空中加油或者是高速公路换轮胎的说法。 另外,为了应对瞬间的海量访问(尤其是秒杀场景),系统需要高可伸缩(快速扩容和缩容),这些都是对系统的要求。 大型电商系统的架构 从下往上,数据层,埋点数据把用户行为数据,实时数据存储在NoSQL、关系型数据库、大数据平台 。 基础架构层 这层实际上是中间件和服务,包括MQ的消息、job的调试中心、sso联合登陆,还有发消息的,分布式的文件存储,用户上传的一些图片等等,除此之外还有应用监控的整个体系、自动发布的框架,支持到AB测试。 基础服务层 再上面一层就是基础服务层,这实际上是用基础架构层提供的组件和服务,加上一些业务逻辑,构建了一些公用的服务,包括OMS、PMS采购,运费模板、配送区域等,这些都是电商最常用的基础服务。 业务服务层 业务服务层我们可以看到的是,比如用户在前台能看到的界面,比如购物车、订单、首页,不管是不是微服务,至少是服务化的。这层就是所有网站应用的核心。除此之外就是第三方平台的api对接。 虚拟类目相当于“标签”,比如我们正常的类目叫做“生鲜”、“服装”,还有一些虚拟的类目叫做“618特卖”,里面会聚合很多的商品,可以理解为一个标签,作为展示用。 暴露在最顶层的我们可以看到,这些就是各个端,比如H5、PC、官网,这就是最终可见的端。 微服务架构的设计 应用的无状态化 很多网站一开始可能不是微服务化的,在早期的一些项目里,我们为了快速上线交付,会做一些单体的应用。随着订单量的发展,我们就开始做所谓的“微服务化”,第一步是把所谓的单体应用,变成应用的无状态化,以登录SSO来看,就是一种解决去状态化的方法。我们会拿到一个token,每次访问都会带着token,这就是所谓的去状态化。之后每一个应用都有横向可扩的能力。当访问量大的时候,就可以通过加服务器来增强水平扩展的能力。 这种应用无状态,其实配置文件还是有状态的。比如访问的数据库和节点,这些是通过配置文件来完成。我说到的案例基本都是基于spring boot来做微服务化,相关技术框架包括:dubbo、zk、hystrix、rocketmq、elasticsearch、redis等等。 单体应用的拆分 在做了应用的无状态之后,就是对单体应用的拆分。拆分有几个维度,一个是从系统的维度,最简单的拆法就是前后台拆开。比如购物车、商品、搜索、首页等属于前端,而后端给网站运营人员用。 还可以按功能的维度来拆分,对于用户服务,从service层到表结构,其实是可以独立部署的,这就是微服务的概念。技术架构反应的就是组织架构,在这种架构下开发团队分为用户服务开发组,价格开发组,商品开发组等。 还可以根据读写维度进行拆分。比如搜索和商城的索引肯定是独立的两个服务。用户注册下单支付是一个完整的业务流程。这些是由若干个微服务构成。 服务架构搭建 数据的异构 在大型电商系统里面的服务架构搭建的经验和技巧。首先是数据的异构,以订单表为例,一般订单都非常庞大,一般按照id来分表分库。这种分法对于查询用户所有订单时就要去各表捞数据,因此可以按用户维度来异构一张表。对于数据的存储,会分为热数据、冷数据和温数据,分别存在不同的地方。同时也会对数据进行聚合。在一些订单详情页,由于有很多ajax请求,由于请求数太多,也需要做一些请求合并。后台的服务也要做一个合并。 以商品详情页为例,使几个接口的数据缓存合并在redis中,从redis中取得聚合好的数据,称为数据闭环。这是优化网络请求的通常做法。 缓存 缓存在大型电商系统中是常用的优化技巧。浏览器级别的缓存通过响应头进行设置。还会用到app客户端的缓存,把H5/CSS/JS/图片打包,提前拉到客户端,在客户端做一个代理服务器,但是不会读取数据。可以提升用户体验。缓存的使用在网络上还有常用的cdn。进到接入层后,如果使用软负载,也可以使用内存级别的缓存。 消息队列的应用 消息队列的应用,是做服务解耦的好方法。也要考虑消息失败和重试的场景,需要来做一些额外补偿来防止数据丢失。还有一个机制是数据的校验和补偿。很多的场景能做到的是最终一致性,大型的电商系统和金融系统场景非常不一样,在设计分布式系统时,这是常用的方式。在电商中大多数情况只要实现最终一致性就可以了。 高可用的架构设计 高可用的架构设计,对于电商来说,其实高可用是最基本的要求。如果在促销时,引来千万级别的用户,宕机会损失很大。 服务的降级、分组和故障的隔离 基于微服务架构的电商系统,高可用的方案有以下几个部分,首先要支持服务的降级。要做降级的开关,写在配置中心里面。比如在大促时,先把订单放在缓存时,再进行落库等操作。同时还要有服务分组和故障的隔离。比如秒杀时,对秒杀的应用单独部署服务,当秒杀的应用挂了之后,不会影响其他服务,因为有服务的隔离。同时要有限流机制,很多的框架都有支持。 流量治理 在极限的场景下, 对流量的治理要从多层面进行。比如在促销当天,会开启对于爬虫和机器人的流量进行限流。一般会在大促前进行封板,如果出现问题,就进行回滚,比如数据版本的回滚,在设置数据结构的时候,要做支持带数据版本号的回滚。 业务设计 业务设计方面的思考。从图中可以看到订单支付的流程。在设计的时候要考虑防重设计,可以采用防重key或者防重表的方案,但是耗费和代价很高,会在某些场景使用,比如积分,扣费等和金钱相关的场景下用。 业务设计要考虑状态机。尤其是订单的流转状态里,要做状态机的应用,包括正向和逆向流程,及其产生的结果。 大型移动电商的架构 动态路由 最后来回顾一下大型移动电商的架构。下图是一个移动电商的完整架构。从app端,主要做的是静态文件的缓存和智能的动态路由。中国的网络环境很复杂,需要在app端做智能动态路由。可以上一些cdn,对动态的内容也做链路优化。会有一些对网络环境检测的机制,可以是cdn,或者是走域名,也可以暴露ip。 埋点和网关 移动电商里对app来说还有一个很重要的是埋点,指的是全链路埋点。从app里用户的每一个操作,这个操作经过网络、服务层、中间件,整个链路要可以监控。对于快速的定位问题是非常有帮助的,尤其是移动电商性能的优化,第一步就是埋点。 在网络这一层,还有网关的接入。比如限流,动态负载。在网关里没有加太多逻辑,也有不同的做法。对于服务来说,最复杂的是服务的依赖和治理。服务之间调用的优化要基于业务场景,比如说购物车的服务,调用到价格、库存、促销等。当依赖的服务不可用的时候,比如价格不可用,设计依赖的时候,要在购物车服务中做一个缓存,来对缓存调用,最后再对最终一致性进行验证。 全链路监控的做法,需要做到预警,这就是一个基础。通过对数据的监控请求来后,根据场景来做预警方案。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:860113481 群内提供免费的Java架构学习资料(里面有高可用、高并发、高性能及分布式、Jvm性能调优、Spring源码,MyBatis,Netty,Redis,Kafka,Mysql,Zookeeper,Tomcat,Docker,Dubbo,Nginx等多个知识点的架构资料)合理利用自己每一分每一秒的时间来学习提升自己,不要再用"没有时间“来掩饰自己思想上的懒惰!趁年轻,使劲拼,给未来的自己一个交代!

优秀的个人博客,低调大师

Springboot企业级部署解决方案

使用springboot的童鞋们,有没曾经想把项目打包成 bin/conf/libs/logs 等这样的结构然后直接运行的,但是找了很多办法都不够完美(因为G是个完美主义 ) 好了直接来看解决方案: 1、修改执行打包的子工程的pom.xml文件(加入两个插件): <build> <finalName>app</finalName> <resources> <resource> <directory>src/main/resources</directory> <filtering>true</filtering> <excludes> <exclude>script/**</exclude> </excludes> </resource> </resources> <plugins> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-compiler-plugin</artifactId> <version>2.1</version> <configuration> <source>${java.version}</source> <target>${java.version}</target> </configuration> </plugin> <plugin> <groupId>org.apache.maven.plugins</groupId> <artifactId>maven-jar-plugin</artifactId> <version>2.6</version> <configuration> <source>${java.version}</source> <target>${java.version}</target> <skip>true</skip> <archive> <manifest> <mainClass>com.xxx.bbb.MyMainClass</mainClass> <addClasspath>true</addClasspath> </manifest> <manifestEntries> <Class-Path>./</Class-Path> <Built-By>Wangl.sir</Built-By> <Built-Mail-By>983708408@qq.com</Built-Mail-By> <Bundle-Name>Project Description</Bundle-Name> <Implementation-Vendor></Implementation-Vendor> <Implementation-URL>http://www.xxx.com/wiki</Implementation-URL> </manifestEntries> </archive> </configuration> </plugin> <plugin> <artifactId>maven-assembly-plugin</artifactId> <configuration> <finalName>app-${project.version}-bin</finalName> <!-- not append assembly id in release file name --> <appendAssemblyId>false</appendAssemblyId> <descriptors> <descriptor>src/main/assemble/package.xml</descriptor> </descriptors> </configuration> <executions> <execution> <id>make-assembly</id> <phase>package</phase> <goals> <goal>single</goal> </goals> </execution> </executions> </plugin> </plugins> </build> 2、新增assemble配置文件(保存至src/main/assemble/package.xml): <assembly xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/assembly-1.0.0.xsd"> <id>jar-with-dependencies</id> <formats> <format>zip</format> </formats> <includeBaseDirectory>true</includeBaseDirectory> <fileSets> <fileSet> <!-- src/main/resources/script目录保存的如:app_ctrl.sh、app_start.sh、app_stop.sh等脚本,maven-assemble会将此目录下的.sh文件复制到最后生成的bin目录下 --> <directory>src/main/resources/script</directory> <outputDirectory>bin</outputDirectory> <includes> <include>*.*</include> </includes> </fileSet> <fileSet> <directory>src/main/resources</directory> <outputDirectory>conf</outputDirectory> <includes> <include>*.*</include> </includes> </fileSet> <fileSet> <directory>target</directory> <outputDirectory>libs</outputDirectory> <includes> <include>*.jar</include> </includes> </fileSet> <fileSet> <directory>src/main/resources</directory> <outputDirectory>logs</outputDirectory> <excludes> <exclude>*.*</exclude> <exclude>script/**</exclude> </excludes> </fileSet> </fileSets> <dependencySets> <dependencySet> <outputDirectory>libs</outputDirectory> <scope>runtime</scope> <excludes> <exclude>${groupId}:${artifactId}</exclude> </excludes> </dependencySet> </dependencySets> </assembly> 3、最后就只需执行 mvn clean install -DskipTests 等待maven执行完成,在target目录下会出现app-{project.version}-bin.zip

优秀的个人博客,低调大师

50个“杀手级”AI项目 !(附链接)

这个世界上我们所创造的所有技术其实都只为一个目的而服务——“一步一个脚印地让生存更轻松”,但现在,事情的发展似乎有些停滞不前了。 毋庸置疑的是,数据的有效利用可以让我们清楚地了解正在发生的事情,解决现有的关键案例,并为未来带来创新性的应用。所以拥有的数据越多,使用人工智能和机器学习技术,就可以更高效的处理流程。 但是,现在的我们似乎走进了一个误区——不应该把所有的技术改进用于消除人为力量的干预,而应该充分利用它们来节省我们的“宝贵时间”。也就是意味着,技术的进步并不是要根除人才的实施,而是要提高整体产出,这才是解决主观需要最重要的一点。 当然,数据只是我们建模时主动提供给机器的,有些数据会解决我们的问题,而其他也会破坏我们的系统。所以为了最大的利益,我们每个人都必须专注于如何用人工智能来改善事情。 本文就列举了一些人工智能技术领域内的项目

优秀的个人博客,低调大师

亿级请求下多级缓存那些事

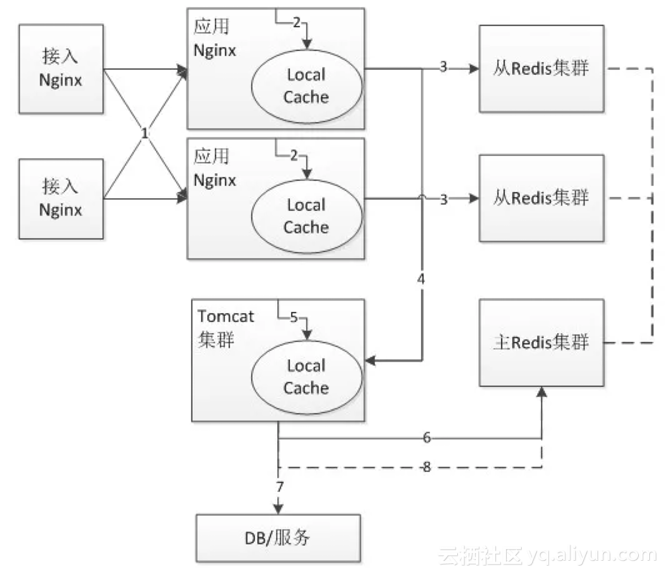
什么是多级缓存 所谓多级缓存,即在整个系统架构的不同系统层级进行数据缓存,以提升访问效率,这也是应用最广的方案之一。我们应用的整体架构如图1所示: 图1 多级缓存方案 整体流程如上图所示: 1)首先接入Nginx将请求负载均衡到应用Nginx,此处常用的负载均衡算法是轮询或者一致性哈希,轮询可以使服务器的请求更加均衡,而一致性哈希可以提升应用Nginx的缓存命中率,相对于轮询,一致性哈希会存在单机热点问题,一种解决办法是热点直接推送到接入层Nginx,一种办法是设置一个阀值,当超过阀值,改为轮询算法。 2)接着应用Nginx读取本地缓存(本地缓存可以使用Lua Shared Dict、Nginx Proxy Cache(磁盘/内存)、Local Redis实现),如果本地缓存命中则直接返回,使用应用Nginx本地缓存可以提升整体的吞吐量,降

优秀的个人博客,低调大师

cdh4.6.0升级测试1

线上使用了cdh4.2.0,这个版本有几个比较严重的bug,jt 内存泄露和distribute cache阻塞的bug. (MAPREDUCE-2479和MAPREDUCE-5508) 相关patch: https://github.com/y-lan/hadoop-cdh4/blob/master/cloudera/patches/1351-MR1-MAPREDUCE-2479.-Move-distributed-cache-cleanup-t.patch https://github.com/y-lan/hadoop-cdh4/blob/master/cloudera/patches/1494-MR1-MAPREDUCE-5508.-JobTracker-memory-leak-caused-by.patch 最近计划升级至4.6.0,,对4.6.0和4.2.0做了相关的对比测试 数据校验和组件兼容性测试: 测试方法: 1)impala测试升级前后数据准确性和性能 结论: 前后结果完全一样(select * order by /count(1) /count(1)+group by) 性能变化不大。 2)hive测试升级前后数据准确性和性能(因为时间有限,没有做TPC的测试) (text gz/rcfile/sequencefile) load 4G的text gz文件,分布清洗成rcfile和sequencefile表 结论: hive测试数据正常(count(1) /count(1)+group by) 性能变化不大,其中因为从text gz清洗至rcfile和sequencefile时不能split,只能一个map做处理,耗时比较长,没有取多次的平均值。 其他数据是取多次的平均值。 3)flume测试写入 升级前后flume hdfs sink有效性。 结论: 升级前后flume写入hdfs正常,可以直接使用4.2.0的hadoop lib做写入操作。 本文转自菜菜光 51CTO博客,原文链接:http://blog.51cto.com/caiguangguang/1401406,如需转载请自行联系原作者

优秀的个人博客,低调大师

江西打造千亿级移动物联网产业

记者从江西省工信委获悉,江西制定移动物联网发展战略,确定涉及工业、农业、物流、节能环保及健康养老等领域的18项重点工程;设立专项资金,力争到2020年全省移动物联网产业产值突破千亿元。 记者了解到,江西发展移动物联网的整体思路是“平台为先、应用牵引、产业创新、梯次发展、要素保障”,并制定七项战略任务。 在基础网络建设方面,明确2017年底前建成省级全域覆盖的NB-IoT网络、2018年底建成省级全域覆盖的eMTC网络、2020年底实现NB-IoT/eMTC/5G三网共存。 在打造公共平台方面,提出到2020年底,形成包括重点实验室、工业云服务平台、产业数据中心、双创中心、产业联盟等在内的移动物联网产业公共服务平台完整体系。 在推动产业升级方面,将面向有色金属、汽车及零配件、航空航天、生物医药等基础较好、转型升级需求迫切的行业,开展设备互联、产品监测、物料追溯、智慧物流、能源与环保检测等移动物联网试点示范工程。 同时,江西将推出面向移动物联网的专项资金,并在加强组织协调、加大资金支持、强化人才支撑、协同产学研用、完善支撑服务、加强培训和对外宣传等方面针对移动物联网发展提出保障措施。 本文转自d1net(转载)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册