首页 文章 精选 留言 我的

精选列表

搜索[快速入门],共10000篇文章
优秀的个人博客,低调大师

迅雷快速下载 Android SDK相关

用AVD Manager升级SDK时,会在线升级,会很慢很慢。 当你看到temp目录下生成了个小文件时,记下文件名,然后在前面加上https://dl-ssl.google.com/android/repository/ ,然后去用迅雷下载,下载完放到 C:\Program Files (x86)\Android\android-sdk-windows\temp 启动AVD Manager 选择安装…… 如:https://dl-ssl.google.com/android/repository/docs-3.0_r01-linux.zip https://dl-ssl.google.com/android/repository/android-3.0_r01-linux.zip 本文转自曾祥展博客园博客,原文链接:http://www.cnblogs.com/zengxiangzhan/archive/2011/03/07/1973188.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android github 快速实现多人协作

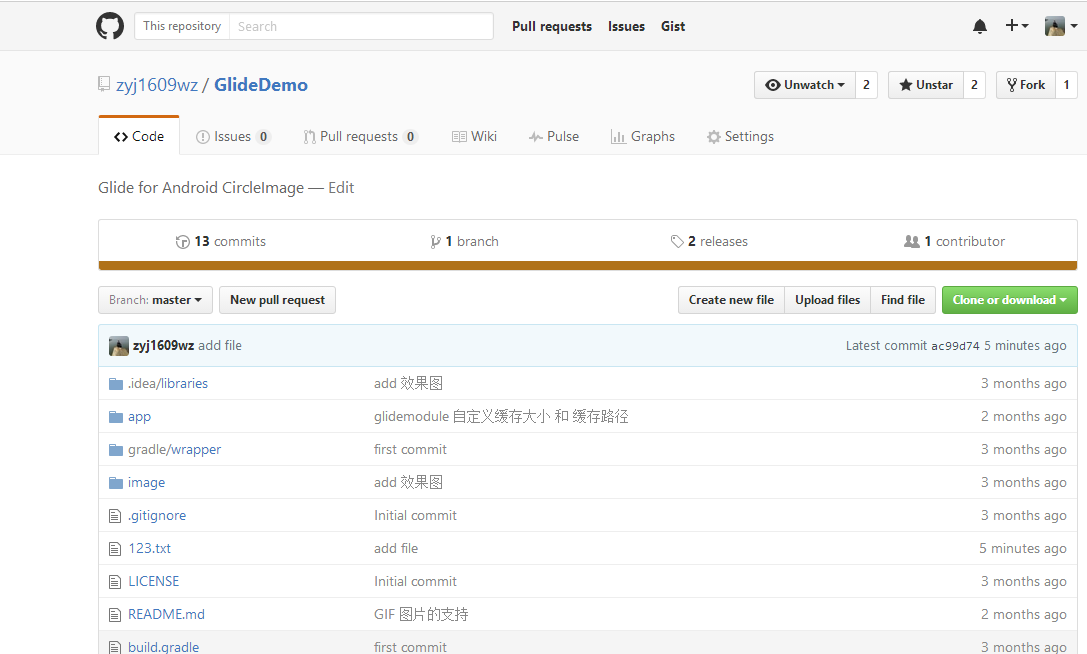
前言:最近要做github多人协作,也就是多人开发。搜索了一些资料,千篇一律,而且操作麻烦。今天就整理一下,github多人协作的简单实现方法。 下面的教程不会出现:公钥、组织、team、pull request 1、首先小张在github上创建一个仓库,比如叫做:GlideDemo 2、 小张开始邀请小王 创建仓库后,然后开始添加 小王了。 注意在第三步的时候,要输入小王的github用户名。 3、小王接收小张的邀请 小王在github登录自己的账户,登录完成后,将在屏幕的右上角看到一个铃铛,双击铃铛。 小王在完成接受邀请后,就可以看到小张的项目仓库了。并且可以push代码到仓库。 4、小张查看所有的协作伙伴。

优秀的个人博客,低调大师

容器服务安全组快速指南

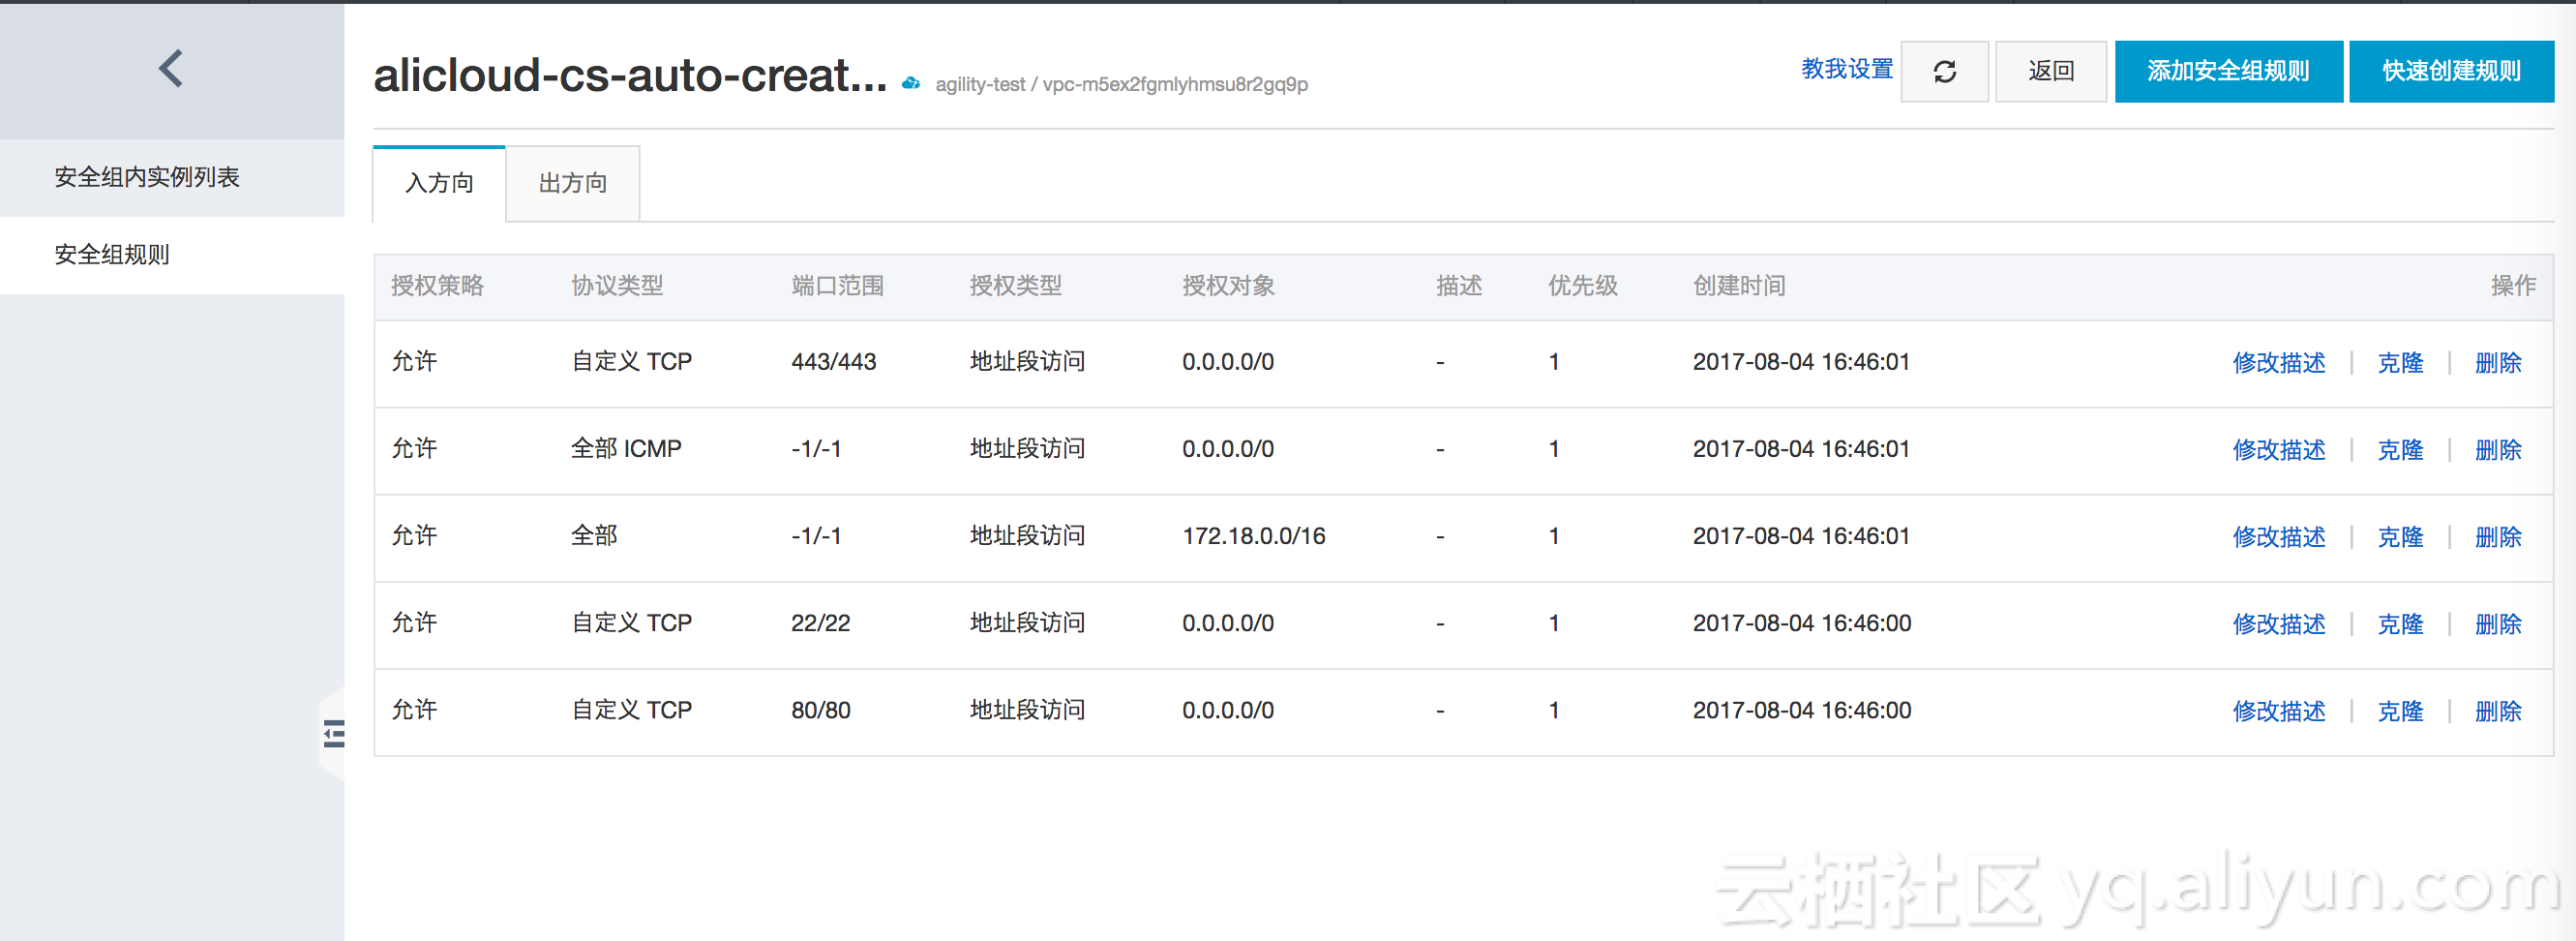
容器服务安全组规则 2月28号之后创建容器服务集群,默认创建的安全组已经做了加固,开放的规则如下 VPC安全组: 经典网络安全组(公网入方向和内网入方向): 注意 443端口和80端口可以根据自己的需求选择放开或者关闭。 ICMP规则建议保留,方便排查问题。有些工具也依赖ICMP 老集群的安全组规则 2月28之前创建的集群,安全组规则开的比较大,以经典网络安全组规则为例 如果希望收紧规则,可以参考前面安全组的配置。步骤如下 在内网入方向和公网入方向添加允许ICMP规则 如果直接访问VM的80端口和443端口,或者其他端口,增加内网和公网规则,放开此端口。务必确保放开所有你需要的端口,否则会导致服务不可访问。通过SLB访问的端口不需要放开。 删除地址段0.0.0.0端口-1/-1的公网入规则和内网入规则。 下面的内容按兴趣阅读 安全配置原则 每个集群一个安全组。

优秀的个人博客,低调大师

TinyPro SpringBoot 最新入门指南,解决开发者入门难题

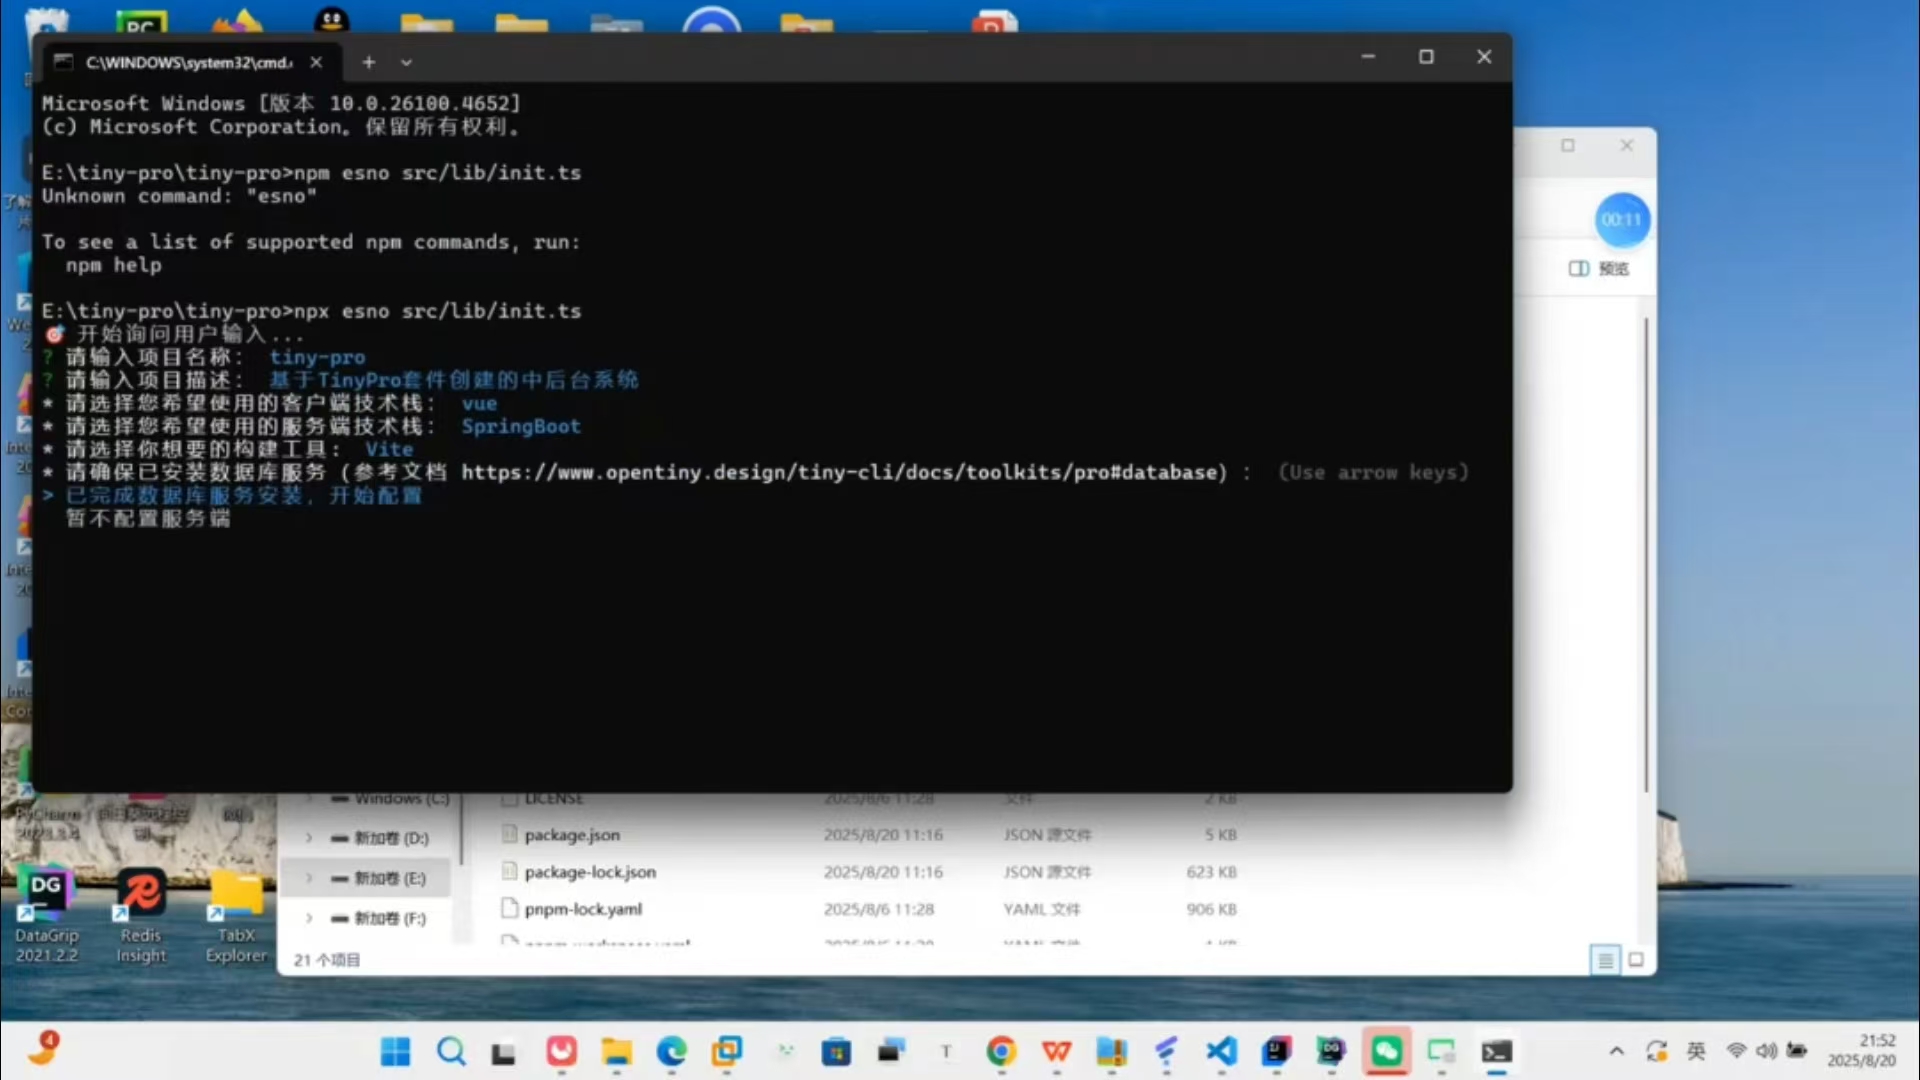
本文由TinyPro中后台系统贡献者周泽龙原创。 在长达三个月的开发下,终于TinyPro的Springboot后端版本终于要问世了,在本期内容中我将带大家一步步去搭建整个后端的流程,也将带大家去探索对于最新版本的更改应该如何实现,以及如何使用本项目进行一个二次的开发和探索。 首先我们先要对于TinyPro项目进行一个整体的拉取,去到TinyPro的官方进行拉取,当我们获取到项目以后就可以进行开始今天的项目构建了。 接下来的流程就是对于前端i项目的搭建以及后端的springboot项目的搭建,最后再去介绍咱们新版本里面的一些特性和组件 1.前端部分的搭建 首先要确保咱们安装了Node.js、NPM、TinyCLI接下来就要正式初始化项目了首先我们进行初始化 (1)在命令行输入tiny init pro对项目进行一个初始化具体的流程可以看我的视频介绍 (2)接下来就让我们进入到我们的项目里面,tinyvue的前端代码里面我们首先进行一个项目的依赖的下载大家可以使用npm install进行项目依赖的下载。 (3)当我们项目依赖下载完成后就可以进入到一个启动流程了,使用npm start进行一个项目的启动启动后就会开启3031端口这样就可以看见项目的启动界面了! 到目前为止我们的前端项目就算正式启动成功了,接下来让我们一起开始启动后端项目 2.后端项目的搭建 首先我们需要确保自己的本地环境里面有jdk17,maven,mysql,redis以及一个自己喜欢的开发软件可以idea或者vscode 好了准备工作做好以后接下来就让我们进入后端的开发和后端二次开发的一个介绍并且我也将带着大家去了解springboot里面的一些设计和里面的一些函数的内容接下来开始吧 项目结构的介绍: 当进入到项目里面的时候我们最直观的可以看见项目的一个整体结构 (1)先介绍一下项目的一个配置文件,对于所有的springboot项目上来第一件事就算看配置文件application.properties文件这个文件里面包含了所有项目需要的配置比如:mysql,redis,Springjpa,mybatis-plus(项目里面没有使用,但是基本的配置都配置好了,也就兼容了喜欢使用mybatis-plus的同学)大家可以更具自己的数据库信息和redis进行配置,需要自己填写好数据库的用户名,端口和驱动地址,还有redis的配置信息比如主机地址和端口号 到这里的同学,那就恭喜大家数据服务的配置我们就是做好了,接下来就是对项目的依赖的下载,这块主要涉及到maven的使用,如果还,没有下载maven的同学记得赶快去下载 (2)接下来开始项目依赖的初始化过程,在项目启动的时候,我们需要先对项目的依赖包去官方的仓库里面下载(这块给大家一个提醒,如果下载过慢的同学记得去配置一下maven的国内镜像源进行下载和配置),敲入命令 mvn install进行一个项目依赖的下载。 如果到这里都执行成功,大家就可以正式的启动项目,正式启动项目之前我希望大家可以去查看自己jdk的配置是否是17,因为接下来的必须要使用jdk17了 (3)进入到TinyProApplication文件里面进行启动项目,在这之前需要确保启动了redis和mysql的服务,并且配置好了密码,然后启动项目以后我们就会看到一个提示: 这里就算证明项目的整体正式启动成功了,接下来就开始监听3000端口了。 项目启动成功以后就可以开始进行一个交互了,大家就可以进入到刚才启动的前端项目里面准备进行一个交互,账户和密码都是admin,这块是配置里面预先写好的,如果有人需要修改这个用户和角色名称,可以进到 DataInitializer文件里面找到user配置进行修改 3.二次开发 这个项目中支持二次开发的模块包括:权限管理,拒绝策略,以及用户的登录校验,初始化配置 (1)首先就是项目的权限管理的问题大家可以看见代码里面首先需要权限校验的接口上面都会有一个 @PermissionAnnotation这个注解里面配置的就是当前接口需要用户所拥有的权限,然后这块里面底层的实现细节在aspect这个目录里面,然后里面就是对于apo的一个使用。如果大家需要给某一个接口增加新的权限大家就可以直接在接口的上面进行一个使用然后写入具体要限制的细节 比如可以写: 这块就是要求用户必须要有menu::query::list这个权限才能进入到这个接口里面进行查询操作如果大家想更进一步了解到权限管理的细节,可以去看aop的使用java里面的切面编程 (2)接下来可以看拒绝的策略,首先对于接口拒绝策略的具体控制在配置文件里面,大家可以看到 这块就是一个拒绝策略的开关,如果大家想开始拒绝策略就可以直接输入true这个然后就会开启拒绝策略进行项目模式,目前是默认在演示模式里面 这个里面主要分为一个演示模式和一个项目模式,在项目模式里面大家可以自由的进行控制但是在演示模式里面,有很多的功能都被禁止了,所以大家要是不能使用的话就需要先查看是否是因为在演示模式里面导致的 (3)接下来就是用户的登录校验,大家首先要明白的一个流程就是用户首先要登录,只有登录成功以后才会将token放到redis里面,然后用户登录的校验就会先去redis里面进行查询,如果查询的到就会通过校验,如果redis里面没有当前用户人的信息就会进行一个拒绝的返回,然后就会跳转到前端的登录界面里面进行一个登录。具体就是拿一个拦截器进行拦截然后对每一个请求都进行校验只有登录过的才能进行项目的操作 (4)项目的初始化整个项目的初始化都在DataInitializer.java这个文件里面,如果后续需要进行一个项目的初始化调整,比如更改初始化的顺序以及在初始化的过程中想再加载一些资源都可以在这个文件里面进行增加 在这个run方法里面进行添加,这样项目在启动的时候就会先去加载项目里面的内容然后生成一个data文件夹的,这就标志着项目以及初始化过了,不需要再进行初始化,接下来每次的项目初始化都会先去看项目里面是否有data的目录如果存在就不走初始化的逻辑了 好了讲解完二次开发以后,接下来就要进入到docker的一个部署流程,在这个之前,大家可以更具的自己的情况去看是去买一个云服务器还是自己搭建一个虚拟机环境,然后进行配置,我在视频里面给搭建演示的就是在自己的虚拟机里面进行一个docker的部署和调用 4.docker部署 首先要了解在进行docker部署的时候,自己的容器文件里面的内容是否创建好了,以及对应的docker-compose.yml的一个配置 再检查完这些内容以后就要进入到我们的一个docker的部署流程环节,其实本质上也很简单就是进入到项目的文件夹目录里面,然后直接执行docker compose up -d这个命令以后,等待下载,但是下载的过程里面会有很多的问题比如下载过慢问题 (1)将项目的文件上传到服务器上面 然后进入当前目录大家可以看见,项目里面有两个文件一个是Dockerfile另一个是docker-compose.yml着两个文件是我们必须要的文件,进入进去看见 里面就是一些配置比如mysql的地址以及redis的地址,都是对应着我们即将启动的容器名称 (2)接下来就开始正式的启动docker-compose.yml文件,使用命令docker compose up -d启动成功以后就可以进行前端端口的配置映射到线上的docker地址,方便未来的开发 这个就是启动成功了,大家可以看映射的地址进行修改前端的配置了 5.本次参加开源之夏的感受和收获 在参加完这次的开源之夏以后,我最大的感受就是第一次有一个整齐的计划和老师还有别的学校的同学们可以一起开发一个软件,让我还没出社会的时候就已经拥有了独立开发的经验和经历。其次就是老师的辅导和社区的教导让我真的成长了很多,我特别感谢开源之夏和+OpenTiny社区对我的帮助,最后谢谢我的导师(真的很牛),他也很耐心的教我,特别感谢名字的话就不说了,不然以后有人烦他去了 谢谢大家我真的很珍惜这次机会,谢谢开源之夏,谢谢OpenTiny社区,谢谢导师,那我的这次开源之旅就结束,但是我相信只是暂时,我以后还会继续投身到开源里面,也希望可以帮助更多的人 关于OpenTiny 欢迎加入 OpenTiny 开源社区。添加微信小助手:opentiny-official 一起参与交流前端技术~ OpenTiny 官网:https://opentiny.design OpenTiny 代码仓库:https://github.com/opentiny TinyPro 源码:https://github.com/opentiny/tiny-pro 欢迎进入代码仓库 Star🌟TinyEngine、TinyVue、TinyNG、TinyCLI、TinyEditor~ 如果你也想要共建,可以进入代码仓库,找到 good first issue标签,一起参与开源贡献~

优秀的个人博客,低调大师

InheritableThreadLocal从入门到放弃

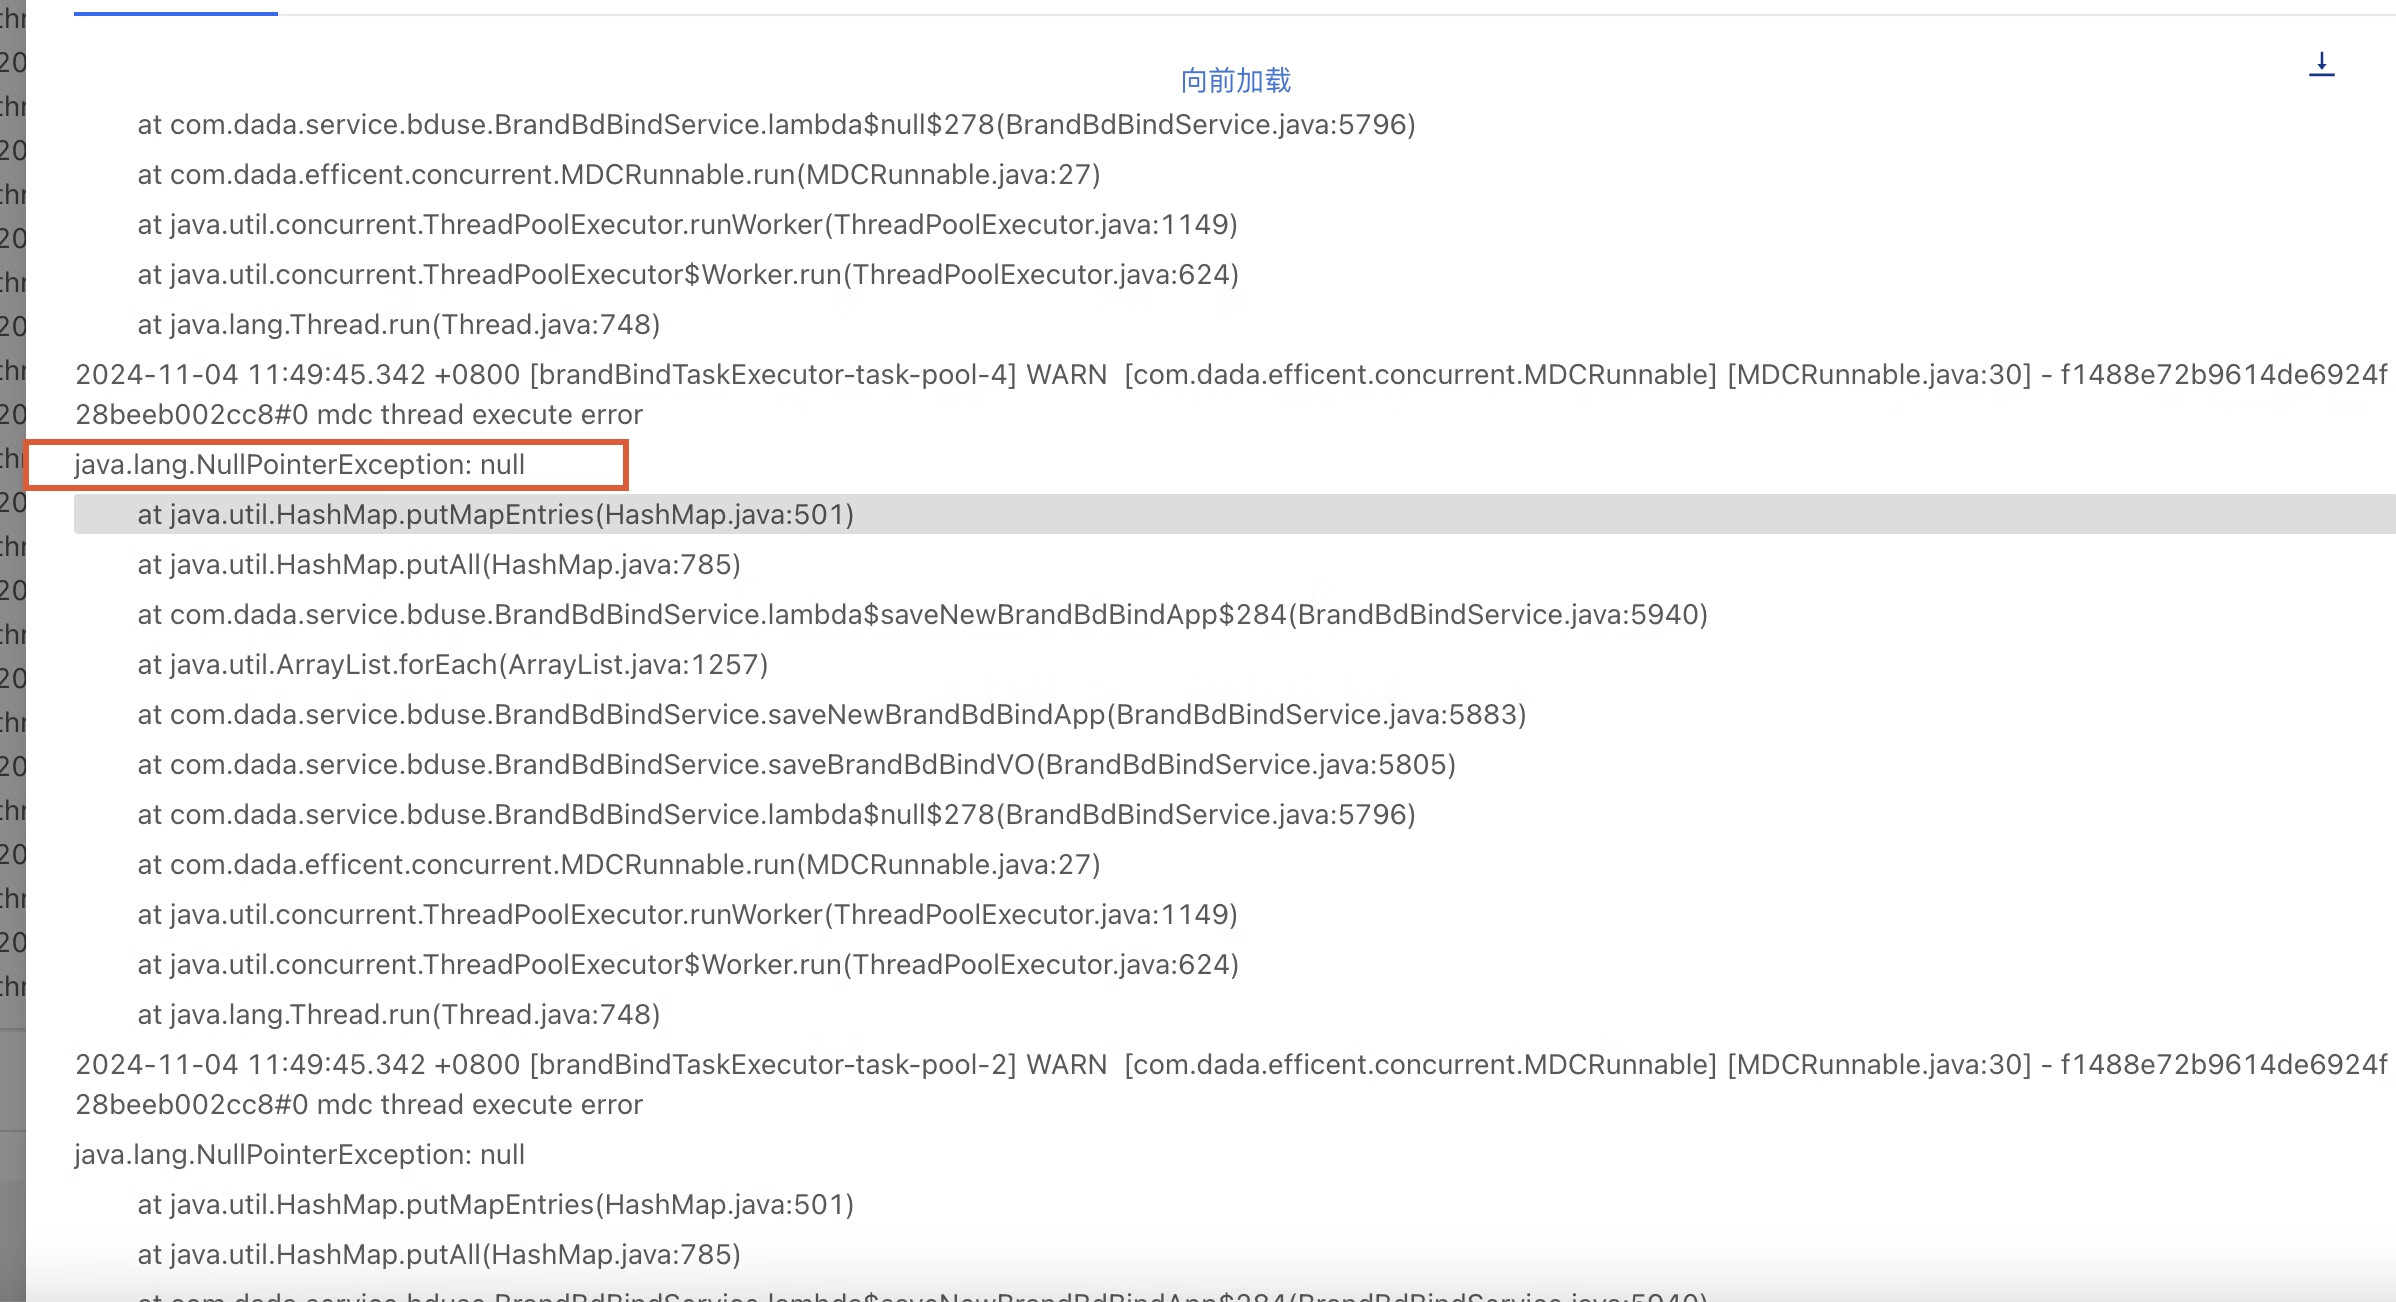
背景: 一个上线了很久但是请求量很低(平均每天一两次)的历史功能突然出现空指针报错:    我们翻开代码定位到对应的报错代码:    结合堆栈和代码可以确定是由于bdIdJobMap的值为null导致往bdIdEmployeeJobMap这个map中putAll的时候空指针了。 而bdIdJobMap又取自employeeJobMapThread.get(); 那么这个employeeJobMapThread又是何物?    哦豁,employeeJobMapThread居然是个InheritableThreadLocal。 梳理一下报错代码的上下文逻辑如下: 1. 首先在当前主线程中对InheritableThreadLocal类型变量employeeJobMapThread进行赋值 2. 把耗时操作提交到线程池中异步执行,在异步任务中去获取employeeJobMapThread的值(其中线程池配置的coreSize/maxSize均为4,queue大小为3000) 3. 在主线程中执行employeeJobMapThread.remove(),在异步任务完成之后没有执行employeeJobMapThread.remove() 4. 最后在异步任务中通过employeeJobMapThread获取到的值为null导致后续操作空指针  是否和最近的上线有关? 相信大家都有这样的共识:线上出现报错,首先怀疑是否和最近的上线有关系。 我们做的第一件事情也是排查了近期的上线功能,从上线的功能点和相关代码上来看都和这次报错的代码没什么关系, 因此初步排除了这个原因。所以接下来只能进一步了解代码来排查原因了。 要搞清楚当前报错的根因,毫无疑问肯定是要翻过InheritableThreadLocal这座小山啦。  简单聊下InheritableThreadLocal: 提起ThreadLocal,大家应该相对都比较熟悉了,比如存放登录用户信息到ThreadLocal变量中,然后在接口层可以比较方便的获取登录用户,帮助开发提效。 但是对于InheritableThreadLocal,有不少同学都不太了解。 挑重点来说,InheritableThreadLocal相比ThreadLocal多一个能力:在创建子线程Thread时,子线程Thread会自动继承父线程的InheritableThreadLocal信息到子线程中,进而实现在在子线程获取父线程的InheritableThreadLocal值的目的。 举个简单的栗子对比下InheritableThreadLocal和ThreadLocal: public class InheritableThreadLocalTest { private static final ThreadLocal<String> threadLocal = new ThreadLocal<>(); private static final InheritableThreadLocal<String> inheritableThreadLocal = new InheritableThreadLocal<>(); public static void main(String[] args) { testThreadLocal(); testInheritableThreadLocal(); } /** * threadLocal测试 */ public static void testThreadLocal() { // 在主线程中设置值到threadLocal threadLocal.set("我是父线程threadLocal的值"); // 创建一个新线程并启动 new Thread(() -> { // 在子线程里面无法获取到父线程设置的threadLocal,结果为null System.out.println("从子线程获取到threadLocal的值: " + threadLocal.get()); }).start(); } /** * inheritableThreadLocal测试 */ public static void testInheritableThreadLocal() { // 在主线程中设置一个值到inheritableThreadLocal inheritableThreadLocal.set("我是父线程inheritableThreadLocal的值"); // 创建一个新线程并启动 new Thread(() -> { // 在子线程里面可以自动获取到父线程设置的inheritableThreadLocal System.out.println("从子线程获取到inheritableThreadLocal的值: " + inheritableThreadLocal.get()); }).start(); } } 执行结果:    可以看到子线程中可以获取到父线程设置的inheritableThreadLocal值,但不能获取到父线程设置的threadLocal值。 为什么InheritableThreadLocal能够做到这点呢? 是因为在父线程创建子线程Thread的时候,Thread的构造器内部会自动继承父线程的InheritableThreadLocal到子线程。 Thread源码这两处地方解释了原因:    init方法内部实现:     通过这个简单的介绍可以帮助对于InheritableThreadLocal不了解的同学有一个初步的了解,本文不是专门介绍InheritableThreadLocal的深入原理,所以就不展开聊了,大家感兴趣可以自己进一步探索。 验证InheritableThreadLocal+线程池: 前面介绍了InheritableThreadLocal可以自动把父线程的InheritableThreadLocal信息继承到子线程Thread中。 但是在业务项目中真正需要用到子线程的时候正经人谁自己new Thread,咱可是用线程池的。 当然了,就像文章开头说明的,这次报错的代码里面也用线程池来执行异步任务。 那么InheritableThreadLocal+线程池的组合会摩擦出什么样的火花呢? 我把这次报错的代码精简之后得到下面的示例(实际代码中往InheritableThreadLocal赋的值类型不是字符串,后面会提到): package com.dada.bd.data.service; import java.util.concurrent.LinkedBlockingQueue; import java.util.concurrent.ThreadPoolExecutor; import java.util.concurrent.TimeUnit; public class InheritableThreadLocalWithThreadPoolTest { private static final InheritableThreadLocal<String> inheritableThreadLocal = new InheritableThreadLocal<>(); private static final ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor( 2, 2, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>(3000), new ThreadPoolExecutor.CallerRunsPolicy() ); public static void main(String[] args) { testInheritableThreadLocalWithThreadPool(); threadPoolExecutor.shutdown(); } /** * inheritableThreadLocal+线程池测试 */ public static void testInheritableThreadLocalWithThreadPool() { // 1. 在主线程中设置一个值到inheritableThreadLocal inheritableThreadLocal.set("我是父线程inheritableThreadLocal的值"); // 2. 提交异步任务到线程池 threadPoolExecutor.execute(() -> { // 3. 在线程池-子线程里面可以获取到父线程设置的inheritableThreadLocal吗? System.out.println("从线程池-子线程获取到inheritableThreadLocal的值: " + inheritableThreadLocal.get()); }); // 4. 清除inheritableThreadLocal inheritableThreadLocal.remove(); } }    执行结果如图所示,可以看到在线程池里面也可以获取到父线程设置的inheritableThreadLocal值。 接下来我们来分析下InheritableThreadLocal+线程池的执行过程:   也就说只有在以下这两个场景下才会继承父线程的InheritableThreadLocal: 1.线程池当前线程数 < 核心线程数 2.线程池当前线程数 >= 核心线程数 && 队列已满 && 线程数 < 最大线程数(本次线上报错的代码使用的线程池设置的coreSize和maxSize一致,所以走不到该场景) 其他情况都是在复用线程池现有的Thread,自然也就不会继承父线程的InheritableThreadLocal。 我们提交多个异步任务到线程池来验证下: package com.dada.bd.data.service; import java.util.concurrent.LinkedBlockingQueue; import java.util.concurrent.ThreadPoolExecutor; import java.util.concurrent.TimeUnit; public class InheritableThreadLocalWithThreadPoolTest { private static final InheritableThreadLocal<String> inheritableThreadLocal = new InheritableThreadLocal<>(); private static final ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor( 2, 2, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>(3000), new ThreadPoolExecutor.CallerRunsPolicy() ); public static void main(String[] args) { testInheritableThreadLocalWithThreadPool("张三"); testInheritableThreadLocalWithThreadPool("李四"); testInheritableThreadLocalWithThreadPool("王五"); testInheritableThreadLocalWithThreadPool("赵六"); testInheritableThreadLocalWithThreadPool("孙七"); threadPoolExecutor.shutdown(); } /** * inheritableThreadLocal+线程池测试 */ public static void testInheritableThreadLocalWithThreadPool(String param) { // 1. 在主线程中设置一个值到inheritableThreadLocal inheritableThreadLocal.set(param); // 2. 提交异步任务到线程池 threadPoolExecutor.execute(() -> { // 3. 在线程池-子线程里面可以获取到父线程设置的inheritableThreadLocal吗? System.out.println("线程名: " + Thread.currentThread().getName() + ", 父线程设置的inheritableThreadLocal值: " + param + ", 子线程获取到inheritableThreadLocal的值: " + inheritableThreadLocal.get()); }); // 4. 清除inheritableThreadLocal inheritableThreadLocal.remove(); } }   执行结果用表格形式展示如下: 步骤 使用线程池 结果解释说明 提交第一个异步任务值为【张三】 创建Thread:pool-1-thread-1 自动继承父线程的InheritableThreadLocal值【张三】到pool-1-thread-1 提交第二个异步任务值为【李四】 创建Thread:pool-1-thread-2 自动继承父线程的InheritableThreadLocal值【李四】到pool-1-thread-2 提交第三个异步任务值为【王五】 复用Thread:pool-1-thread-1 没有自动继承父线程的InheritableThreadLocal值【王五】,所以拿到了第一个任务提交时Thread继承下来的值【张三】 提交第四个异步任务值为【赵六】 复用Thread:pool-1-thread-2 没有自动继承父线程的InheritableThreadLocal值【赵六】,所以拿到了第一个任务提交时Thread继承下来的值【李四】 可以看到InheritableThreadLocal+线程池的组合,会面临InheritableThreadLocal污染的问题,即异步任务可能取到其他父线程设置的InheritableThreadLocal值。 有同学会提到我们不是在代码里面加了inheritableThreadLocal.remove()来清除inheritableThreadLocal的吗?为什么没有清除掉呢? 这是因为此时我们清除的只是父线程的inheritableThreadLocal,而没有清除子线程的inheritableThreadLocal的缘故。  为什么InheritableThreadLocal污染对线上没有产生影响? 既然InheritableThreadLocal+线程池的组合,会存在InheritableThreadLocal污染的问题,那岂不是线上报错的这段代码也存在这个问题? 再次检查代码,确认历史代码的确存在这个问题, 但是,这个代码上线2年多为啥一直稳定运行且没有用户反馈过功能有问题?只有最近突然出现报错?一时之间脑袋懵懵的。    仔细检代码之后发现: 这段代码在父子线程之间通过InheritableThreadLocal类型变量employeeJobMapThread传递的值是【全量的<人员Id, 该人员基本信息>结构的map】,可以近乎看做是一个不变的常量,所以虽然异步任务会拿到污染的数据,也是正常可以用的,没有产生业务影响。 这种感觉怎么说呢,只能说感叹前人的智慧,把几乎不可能做到了可能~ 好了,到这里我们解释了为什么这段代码上线这么久一直没问题,因为代码确实有InheritableThreadLocal污染问题,但被污染了也不影响使用。。。所以从最终结果来看确实可以正常运行。     什么原因导致子线程获取到的InheritableThreadLocal值是null? 但是。。。说了这么多,还是不能解释为什么线上代码获取到的inheritableThreadLocal值会是null。 1.难道父线程设置的inheritableThreadLocal值可能会是null? 检查代码发现父线程设置的inheritableThreadLocal不可能为null,顶多会是空集合:     2.难道是线程池创建之后通过prestartAllCoreThreads初始化了核心线程,在执行异步任务的时候,都是复用的已有线程导致的? 检查了对应线程池的初始化代码,发现并没有初始化核心线程,也排除了这个可能。而且如果真的是该原因22年上线之后功能一定是有问题的,前面说过,该功能上线之后没人反馈过异常,所以也可以排除该原因。  • 该功能22年上线之间2年多一直没人反馈,大概率该功能之前很长时间是正常的,近期由于某个原因导致功能异常 • 虽然历史代码的用法存在子任务中获取到的InheritableThreadLocal被污染的问题,但是被污染的值也能用,不影响正确性 • 只要线程池中的线程初始化的时候继承了正确的InheritableThreadLocal值,后续就不会被清除掉,也就可以正常运行功能 从这些已知的信息来推断,可以推断出这段历史代码写法虽然有隐患,但是不是引发当前空指针的的原因。 3.剩下的只有一种可能:存在线程池的共用。 在执行这个报错的异步任务的时候,复用了某个已有的线程A,并且当时创建该线程A的时候,没有继承InheritableThreadLocal,进而导致后面复用该线程的时候,从InheritableThreadLocal获取到的值为null。 而只要是通过这段历史代码创建的线程一定是没问题的,所以一定是存在其他业务共用了这个线程池,并且这个业务优先执行进而初始化了线程池的线程,导致线程池的线程没有继承InheritableThreadLocal。 如下代码示例: package com.dada.bd.data.service; import java.util.concurrent.LinkedBlockingQueue; import java.util.concurrent.ThreadPoolExecutor; import java.util.concurrent.TimeUnit; public class InheritableThreadLocalWithThreadPoolTest { private static final InheritableThreadLocal<String> inheritableThreadLocal = new InheritableThreadLocal<>(); // 这里线程池core/max数量都只有2 private static final ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor( 2, 2, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>(3000), new ThreadPoolExecutor.CallerRunsPolicy() ); public static void main(String[] args) { // 先执行了不涉及InheritableThreadLocal的子任务初始化线程池线程 testAnotherFunction(); testAnotherFunction(); // 后执行了本次的历史代码,其涉及InheritableThreadLocal testInheritableThreadLocalWithThreadPool("张三"); testInheritableThreadLocalWithThreadPool("李四"); threadPoolExecutor.shutdown(); } /** * inheritableThreadLocal+线程池测试 */ public static void testInheritableThreadLocalWithThreadPool(String param) { // 1. 在主线程中设置一个值到inheritableThreadLocal inheritableThreadLocal.set(param); // 2. 提交异步任务到线程池 threadPoolExecutor.execute(() -> { // 3. 在线程池-子线程里面可以获取到父线程设置的inheritableThreadLocal吗? System.out.println("线程名: " + Thread.currentThread().getName() + ", 父线程设置的inheritableThreadLocal值: " + param + ", 子线程获取到inheritableThreadLocal的值: " + inheritableThreadLocal.get()); }); // 4. 清除inheritableThreadLocal inheritableThreadLocal.remove(); } /** * 模拟另一个独立的功能 */ public static void testAnotherFunction() { // 提交异步任务到线程池 threadPoolExecutor.execute(() -> { // 在线程池-子线程里面可以获取到父线程设置的inheritableThreadLocal吗? System.out.println("线程名: " + Thread.currentThread().getName() + ", 线程池-子线程摸个鱼"); }); } } 执行结果:    在项目里面搜一下看看,果真如此,有2出地方在用这个线程池,并且另外的一处代码中提交的异步任务不涉及inheritableThreadLocal:    示意图如下: 逻辑执行顺序为:创建线程池 - 执行功能A - 执行功能A - 执行功能B 其中: 功能A全流程均不涉及InheritableThreadLocal 功能B对应报错的代码,主线程设置InheritableThreadLocal并且在子线程使用    至此,线上报错的根因确定了:就是因为InheritableThreadLocal + 线程池共用导致。  扩展一下: 假如执行顺序是这样呢:创建线程池 - 执行功能B - 执行功能B - 执行功能A    结局居然是一切安好。  假如执行顺序是这样呢:创建线程池 - 执行功能B - 执行功能A - 执行功能B    发现了吗?如果应用启动之后功能B先执行并且初始化了线程池所有核心线程,那么一切正常,否则就可能报错。 也就是说功能B是否正常还看运气的,运气好就正常执行,运气不好就报空指针的错。  这你敢信?    小插曲: 这个问题的排查当中还遇到了2个小插曲: 插曲1: 最初怀疑是线程池复用导致的,但是在IDEA里面搜代码的时候粗心大意没有看到其他地方在复用线程池。 因此期间一度自我怀疑见鬼了,导致本来可以一两个小时确定根因的,结果饶了弯路多花了两个小时才确定根因。 所以说排查问题的时候每一步都要保持细心,得出的每一个结论都应该是证据确凿,理由充分, 否则会让自己兜兜转转浪费宝贵的时间。  插曲2: 排查代码的时候发现异步任务代码没有做任何的异常处理,这其实是很坑的。 有经验的同学应该知道,线程池里面提交异步任务如果没有做异常处理,出现异常的话不会有任何的日志信息。 本地运行的时候会打印到控制台,但是线上控制台的信息可不会记录到日志里面。 所以经常遇到异步任务执行结果不符合预期,但是线上没有任何相关日志就是这个原因。 我们这里有日志是因为使用的线程池是二次封装过的,里面对异步任务做了兜底的异常记录。  总结: 前面分析到了导致空指针的原因是线程池共用导致的老代码报错,而共用这个线程池的代码是新上线的功能引入的。 这就打脸了开头我们检查了上线的功能与此无关,实则有关。 只是我们评估复用线程池的影响时,很难想到会有这样的影响,通常我们会考虑: 1. 是否会影响共用该线程池的老功能响应时间边长 2. 是否存在父子任务共用线程池导致可能产生死锁 针对InheritableThreadLocal,我个人的建议是: 1. InheritableThreadLocal(其实ThreadLocal也一样)不适合应用于业务代码中,因为他们都是隐式的参数传递,而业务系统中好维护的代码应当是显式的参数传递(我们这个线上问题就采用该方式) 2. 框架类代码才是InheritableThreadLocal和ThreadLocal主要发光发热的地方,因为对应的研发水平通常较高,且代码经过严格测试验证,并且较少变动。而业务系统研发水平参差不齐,且经常会发生同步操作变异步等 3. 虽然InheritableThreadLocal不建议在业务代码中使用,但是我们还是需要掌握它,不为别的,只有掌握它的优缺点才能告诉自己和他人为什么应该在业务代码中放弃使用它  针对如何有效的应对业务研发遇到的一些“疑难杂症”,我的建议是: 1. 大胆提出合理的假设,小心谨慎进行验证 2. 没有充足理由,不要轻易下结论 3. 没有头绪时,休息一下,或找合适的人一起探讨,给自己打开新的思路  最后,愿天下没有故障,没有线上问题,没有bug。

优秀的个人博客,低调大师

OpenAI 函数调用 功能入门

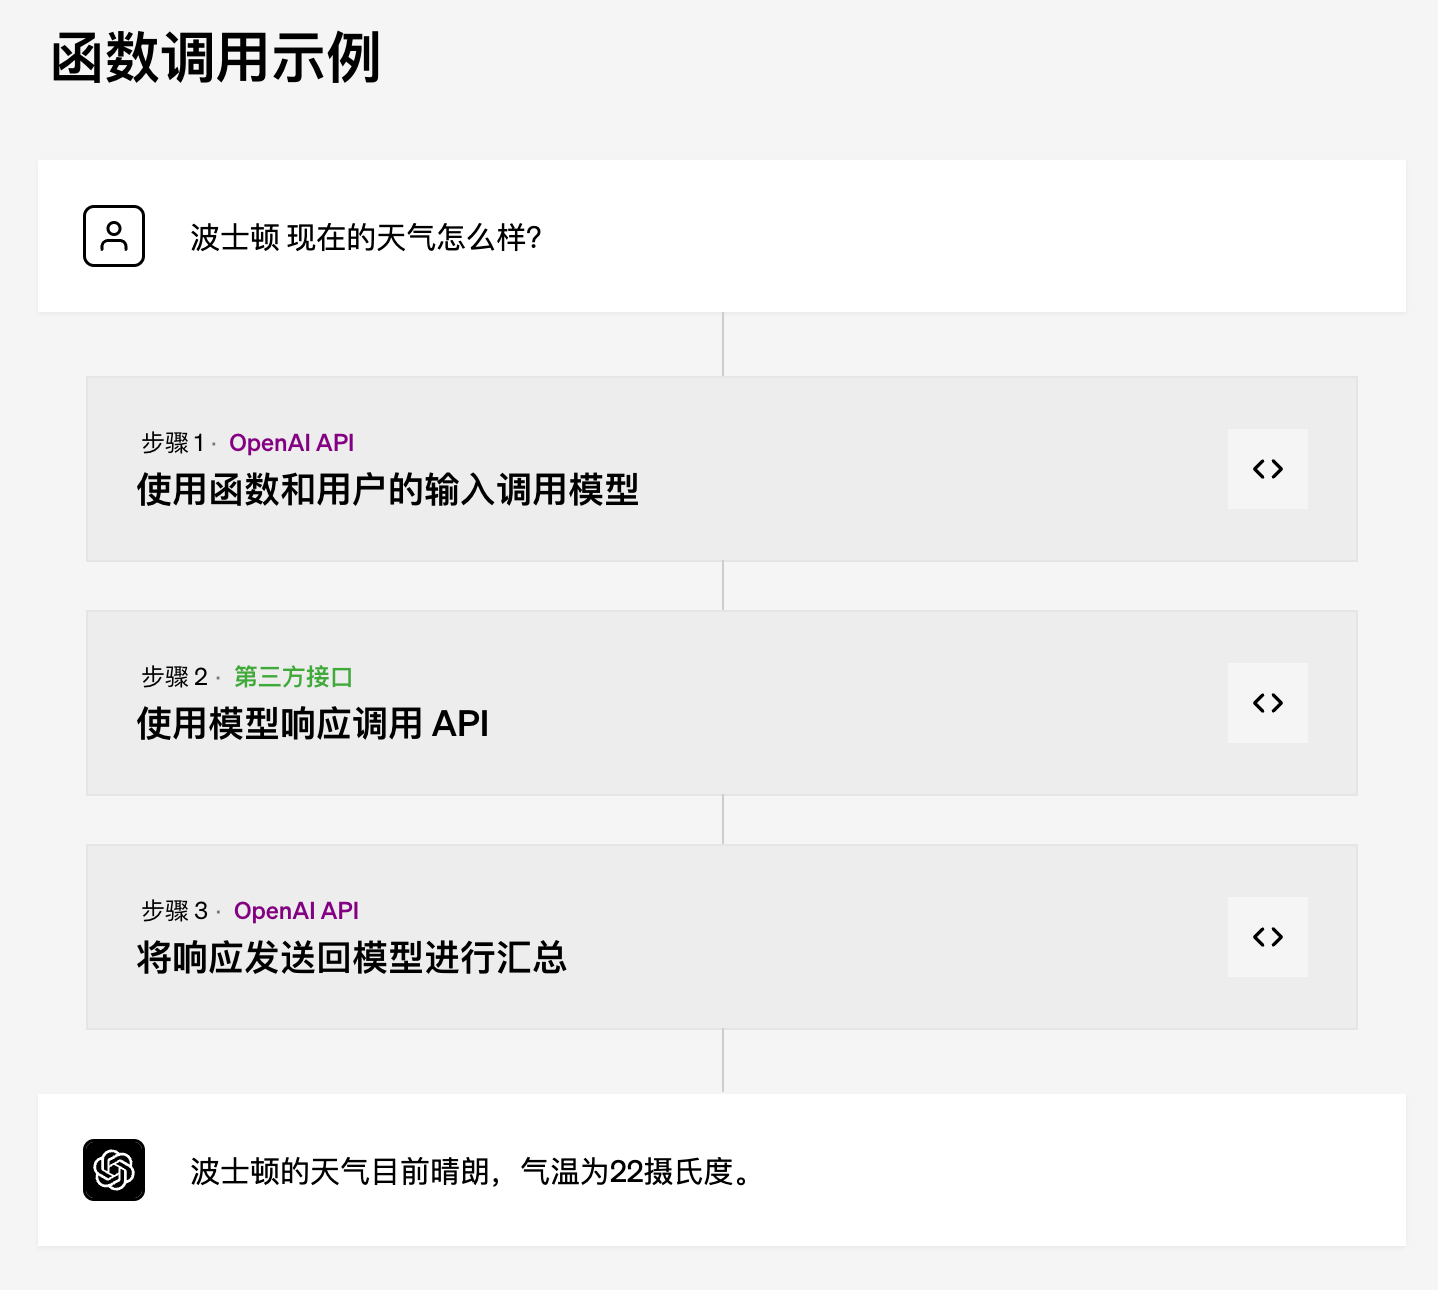
作者:AI小火箭的HB 我是AI小火箭的HB,我探索和写作人工智能和语言交叉点的所有事物,范围从LLM,聊天机器人,语音机器人,开发框架,以数据为中心的潜在空间等。 范例 初步体验 OpenAI新增了“函数调用”功能,这是什么呢? 我们先调用API来体验下。 下面是发送到模型的 JSON 文档。此调用的目的是生成一个 JSON 文件,该文件可用于发送到发送电子邮件的 API。 您可以看到函数名称为 send_email,并定义了三个参数, to_address , subject 和 body ,即电子邮件正文。 用户请求为: Send Cobus from humanfirst ai an email asking for the monthly report? curl --location 'https://api.openai.com/v1/chat/completions' \ --header 'Content-Type: application/json' \ --header 'Authorization: Bearer sk-xxxx' \ --data '{ "model": "gpt-3.5-turbo-0613", "messages": [ {"role": "user", "content": "Send Cobus from humanfirst ai an email asking for the monthly report?"} ], "functions": [ { "name": "send_email", "description": "Please send an email.", "parameters": { "type": "object", "properties": { "to_address": { "type": "string", "description": "To address for email" }, "subject": { "type": "string", "description": "subject of the email" }, "body": { "type": "string", "description": "Body of the email" } } } } ] }' 下面是返回的 JSON { "id": "chatcmpl-7TQuwzJpQAY470saQM2RPfxwF6DDE", "object": "chat.completion", "created": 1687249338, "model": "gpt-3.5-turbo-0613", "choices": [ { "index": 0, "message": { "role": "assistant", "content": null, "function_call": { "name": "send_email", "arguments": "{\n \"to_address\": \"cobus@humanfirst.ai\",\n \"subject\": \"Request for Monthly Report\",\n \"body\": \"Hi Cobus,\\n\\nI hope you're doing well. Could you please share the monthly report with me? It would be great to have it before the end of the week.\\n\\nThanks,\\n[Your Name]\"\n}" } }, "finish_reason": "function_call" } ], "usage": { "prompt_tokens": 86, "completion_tokens": 82, "total_tokens": 168 } } GPT模型会返回需要调用的函数名 send_email和对应的参数(放在arguments字段)。 { "to_address": "cobus@humanfirst.ai", "subject": "Request for Monthly Report", "body": "Hi Cobus,\n\nI hope you're doing well. Could you please share the monthly report with me? It would be great to have it before the end of the week.\n\nThanks,\n[Your Name]" } 这就非常有用,第三方的应用可以提供多个函数/服务(类似插件),GPT模型可以根据用户的指令自动选择不同的函数/服务。 现在再来看示例,就比较清晰了。 用途 根据官网文档,函数调用允许您更可靠地从模型中获取结构化数据。例如,您可以: 创建聊天机器人,通过调用外部 API 来回答问题(例如 ChatGPT 插件) 例如,定义像 send_email(to: string, body: string) 或 get_current_weather(location: string, unit: 'celsius' | 'fahrenheit') 这样的函数 将自然语言转换为 API 调用 例如,将“谁是我的顶级客户?”转换为 get_customers(min_revenue: int, created_before: string, limit: int) 并调用您的内部 API 从文本中提取结构化数据 例如,定义一个名为 extract_data(name: string, birthday: string) 或 sql_query(query: string) 的函数 函数调用的基本步骤顺序如下: 使用用户查询和函数参数中定义的一组函数调用模型。 模型可以选择调用函数;如果是这样,内容将是符合自定义架构的字符串化 JSON 对象(注意:模型可能会生成无效的 JSON 或幻觉参数)。 在代码中将字符串解析为 JSON,并使用提供的参数调用函数(如果存在)。 通过将函数响应追加为新消息来再次调用模型,并让模型将结果汇总回给用户。 AI小火箭 AI小火箭已经支持函数调用和gpt-3.5-turbo-16k、gpt-3.5-turbo-0613、gpt-3.5-turbo-16k-0613,大家可以去体验下。

优秀的个人博客,低调大师

Vue3开发入门

### 1、基础环境相关版本信息 ``` C:\Users\xxxxx>node -v v14.17.0 C:\Users\xxxxx>npm -v 7.18.1 ``` ### 2、新建vue3项目 ``` # a.切换到项目代码目录 cd /d D:\Development\Vue # b.新建项目 D:\Development\Vue>npm init @vitejs/app Need to install the following packages: @vitejs/create-app Ok to proceed? (y) √ Project name: ... study-admin √ Select a framework: » vue √ Select a variant: » vue-ts Scaffolding project in D:\Development\Vue\study-admin... Done. Now run: cd study-admin npm install npm run dev # c.安装依赖,运行项目,运行时会有一个报错,解决办法是手动执行node脚本安装spawn D:\Development\Vue>cd study-admin D:\Development\Vue\study-admin>npm install added 91 packages in 4s D:\Development\Vue\study-admin>npm run dev > dev > vite events.js:353 throw er; // Unhandled 'error' event ^ Error: spawn D:\Development\Vue\study-admin\node_modules\esbuild\esbuild.exe ENOENT at Process.ChildProcess._handle.onexit (internal/child_process.js:269:19) at onErrorNT (internal/child_process.js:467:16) at processTicksAndRejections (internal/process/task_queues.js:82:21) Emitted 'error' event on ChildProcess instance at: at Process.ChildProcess._handle.onexit (internal/child_process.js:275:12) at onErrorNT (internal/child_process.js:467:16) at processTicksAndRejections (internal/process/task_queues.js:82:21) { errno: -4058, code: 'ENOENT', syscall: 'spawn D:\\Development\\Vue\\study-admin\\node_modules\\esbuild\\esbuild.exe', path: 'D:\\Development\\Vue\\study-admin\\node_modules\\esbuild\\esbuild.exe', spawnargs: [ '--service=0.12.9', '--ping' ] } # 解决errno: -4058,code: 'ENOENT',spawn 相关报错 D:\Development\Vue\study-admin>node D:\Development\Vue\study-admin\node_modules\esbuild\install.js D:\Development\Vue\study-admin>npm run dev > dev > vite Pre-bundling dependencies: vue (this will be run only when your dependencies or config have changed) vite v2.3.7 dev server running at: > Local: http://localhost:3000/ > Network: use `--host` to expose ready in 693ms. ``` ### 3、修改vite启动参数相关配置,vite.config.ts > 参考文档:https://cn.vitejs.dev/config/ ``` import { defineConfig } from 'vite' import vue from '@vitejs/plugin-vue' // 需要安装 @types/node -> npm i @types/node -D import { resolve } from 'path' // https://vitejs.dev/config/ export default defineConfig({ plugins: [vue()], resolve: { alias: { '@': resolve(__dirname, 'src') // 设置 `@` 指向 `src` 目录 } }, server: { port: 4000, // 服务端口号 open: true, // 启动时自动打开浏览器 cors: true // 允许跨域访问 } }) ``` ### 4、集成vue-router路由模块 > 参考文档:https://next.router.vuejs.org/zh/introduction.html ``` # a.安装vue-router v4.x,只有v4版本支持vue3 D:\Development\Vue\study-admin>npm i vue-router@4 added 2 packages in 2s # b.创建 src/router/index.ts 文件 import { createRouter, createWebHashHistory, Router, RouteRecordRaw } from 'vue-router' import Login from '@/views/Login.vue' const routes: Array = [ { path: '/', name: 'Login', component: Login }, { path: '/admin', name: 'Admin', component: () => import('@/views/Admin.vue') // 懒加载 Admin 组件 } ] const router: Router = createRouter({ history: createWebHashHistory(), routes: routes }) export default router # c.在 src 下创建 views 目录,用来存储页面组件。在 views 目录下创建 Login.vue 、Admin.vue。 # Login.vue Login 登陆 # Admin.vue Admin # d.在 main.ts 文件中加载路由配置 import { createApp } from 'vue' import App from '@/App.vue' import router from './router/index' createApp(App).use(router).mount('#app') # e.修改App.vue,添加路由映射 APP Module ``` ### 5、集成UI框架Element Plus ``` # a.安装element-plus和vite-plugin-style-import npm i element-plus npm i vite-plugin-style-import -D # b.修改vite.config.ts配置按需加载 import { defineConfig } from 'vite' import vue from '@vitejs/plugin-vue' // 需要安装@types/node -> npm i @types/node -D import { resolve } from 'path' // 需要安装vite-plugin-style-import -> npm i vite-plugin-style-import -D import styleImport from 'vite-plugin-style-import'; // https://vitejs.dev/config/ export default defineConfig({ plugins: [ vue(), // 按需载入 Element Plus styleImport({ libs: [ { libraryName: 'element-plus', esModule: true, ensureStyleFile: true, resolveStyle: (name) => { return `element-plus/lib/theme-chalk/${name}.css` }, resolveComponent: (name) => { return `element-plus/lib/${name}` } } ] }) ], resolve: { alias: { '@': resolve(__dirname, 'src') // 设置 `@` 指向 `src` 目录 } }, server: { port: 4000, // 设置服务启动端口号 open: true, // 设置服务启动时是否自动打开浏览器 cors: true // 允许跨域 } }) # c.在main.ts中加载element-plus import { createApp } from 'vue' import App from '@/App.vue' import router from './router/index' // 按需引入需要的element-plus组件 import { ElIcon, ElLoading, ElCard, ElButton } from 'element-plus' // 创建Vue3实例 const app = createApp(App) // 加载默认路由 app.use(router) // 加载element-plus组件 app.use(ElButton).use(ElCard).use(ElLoading).use(ElIcon) // 挂载到DOM app.mount('#app') # d.修改Login.vue将登陆链接改为element-plus的el-button组件,验证UI组件是否正确引入 Login 登陆 --> 登陆 ```

优秀的个人博客,低调大师

ShardingSphere-JDBC入门实战

前言 Apache ShardingSphere 是一套开源的分布式数据库解决方案组成的生态圈,它由 JDBC、Proxy 和 Sidecar(规划中)这 3 款既能够独立部署,又支持混合部署配合使用的产品组成;接下来的几篇文章将重点分析ShardingSphere-JDBC,从数据分片,分布式主键,分布式事务,读写分离,弹性伸缩等几个方面来介绍。 简介 ShardingSphere-JDBC定位为轻量级 Java 框架,在 Java 的 JDBC 层提供的额外服务。 它使用客户端直连数据库,以 jar 包形式提供服务,无需额外部署和依赖,可理解为增强版的 JDBC 驱动,完全兼容 JDBC 和各种 ORM 框架。整体架构图如下(来自官网): ShardingSphere-JDBC包含了众多的功能模块包括数据分片,分布式主键,分布式事务,读写分离,弹性伸缩等等;作为一个数据库中间件最核心的功能当属数据分片了,ShardingSphere-JDBC提供了很多分库分表的策略和算法,接下来看看具体是如何使用这些策略的; 数据分片 作为一个开发者我们希望中间件可以帮我们屏蔽底层的细节,让我们在面对分库分表的场景下,可以像使用单库单表一样简单;当然ShardingSphere-JDBC不会让大家失望,引入了分片数据源、逻辑表等概念; 分片数据源和逻辑表 逻辑表:逻辑表是相对物理表来说的,通常做分表处理,某一张表会被分成多张表,比如订单表被拆分成10张表,分别是t_order_0到t_order_9,而对应的逻辑表就是t_order,对于开发者来说只需要使用逻辑表即可; 分片数据源:对于分库来说,通常会有多个库,或者说是多个数据源,所以这些数据源需要被统一管理起来,引入了分片数据源的概念,常见的ShardingDataSource 有了以上两个最基本的概念当然还不够,还需要分库分表策略算法帮助我们做路由处理;但是这两个概念可以让开发者有一种使用单库单表的感觉,就像下面这样一个简单的实例: DataSource dataSource = ShardingDataSourceFactory.createDataSource(dataSourceMap, shardingRuleConfig, new Properties()); Connection conn = dataSource.getConnection(); String sql = "select id,user_id,order_id from t_order where order_id = 103"; PreparedStatement preparedStatement = conn.prepareStatement(sql); ResultSet set = preparedStatement.executeQuery(); 以上根据真实数据源列表,分库分表策略生成了一个抽象数据源,可以简单理解就是ShardingDataSource;接下来的操作和我们使用jdbc操作正常的单库单表没有任何区别; 分片策略算法 ShardingSphere-JDBC在分片策略上分别引入了分片算法、分片策略两个概念,当然在分片的过程中分片键也是一个核心的概念;在此可以简单的理解分片策略 = 分片算法 + 分片键;至于为什么要这么设计,应该是ShardingSphere-JDBC考虑更多的灵活性,把分片算法单独抽象出来,方便开发者扩展; 分片算法 提供了抽象分片算法类:ShardingAlgorithm,根据类型又分为:精确分片算法、区间分片算法、复合分片算法以及Hint分片算法; 精确分片算法:对应PreciseShardingAlgorithm类,主要用于处理 = 和 IN的分片; 区间分片算法:对应RangeShardingAlgorithm类,主要用于处理 BETWEEN AND, >, <, >=, <= 分片; 复合分片算法:对应ComplexKeysShardingAlgorithm类,用于处理使用多键作为分片键进行分片的场景; Hint分片算法:对应HintShardingAlgorithm类,用于处理使用 Hint 行分片的场景; 以上所有的算法类都是接口类,具体实现交给开发者自己; 分片策略 分片策略基本和上面的分片算法对应,包括:标准分片策略、复合分片策略、Hint分片策略、内联分片策略、不分片策略; 标准分片策略:对应StandardShardingStrategy类,提供PreciseShardingAlgorithm和RangeShardingAlgorithm两个分片算法,PreciseShardingAlgorithm是必须的,RangeShardingAlgorithm可选的; public final class StandardShardingStrategy implements ShardingStrategy { private final String shardingColumn; private final PreciseShardingAlgorithm preciseShardingAlgorithm; private final RangeShardingAlgorithm rangeShardingAlgorithm; } 复合分片策略:对应ComplexShardingStrategy类,提供ComplexKeysShardingAlgorithm分片算法; public final class ComplexShardingStrategy implements ShardingStrategy { @Getter private final Collection<String> shardingColumns; private final ComplexKeysShardingAlgorithm shardingAlgorithm; } 可以发现支持多个分片键; Hint分片策略:对应HintShardingStrategy类,通过 Hint 指定分片值而非从 SQL 中提取分片值的方式进行分片的策略;提供HintShardingAlgorithm分片算法; public final class HintShardingStrategy implements ShardingStrategy { @Getter private final Collection<String> shardingColumns; private final HintShardingAlgorithm shardingAlgorithm; } 内联分片策略:对应InlineShardingStrategy类,没有提供分片算法,路由规则通过表达式来实现; 不分片策略:对应NoneShardingStrategy类,不分片策略; 分片策略配置类 在使用中我们并没有直接使用上面的分片策略类,ShardingSphere-JDBC分别提供了对应策略的配置类包括: StandardShardingStrategyConfiguration ComplexShardingStrategyConfiguration HintShardingStrategyConfiguration InlineShardingStrategyConfiguration NoneShardingStrategyConfiguration 实战 有了以上相关基础概念,接下来针对每种分片策略做一个简单的实战,在实战前首先准备好库和表; 准备 分别准备两个库:ds0、ds1;然后每个库分别包含两个表:t_order0,t_order1; CREATE TABLE `t_order0` ( `id` bigint(20) NOT NULL AUTO_INCREMENT, `user_id` bigint(20) NOT NULL, `order_id` bigint(20) NOT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 准备真实数据源 我们这里有两个数据源,这里都使用java代码的方式来配置: // 配置真实数据源 Map<String, DataSource> dataSourceMap = new HashMap<>(); // 配置第一个数据源 BasicDataSource dataSource1 = new BasicDataSource(); dataSource1.setDriverClassName("com.mysql.jdbc.Driver"); dataSource1.setUrl("jdbc:mysql://localhost:3306/ds0"); dataSource1.setUsername("root"); dataSource1.setPassword("root"); dataSourceMap.put("ds0", dataSource1); // 配置第二个数据源 BasicDataSource dataSource2 = new BasicDataSource(); dataSource2.setDriverClassName("com.mysql.jdbc.Driver"); dataSource2.setUrl("jdbc:mysql://localhost:3306/ds1"); dataSource2.setUsername("root"); dataSource2.setPassword("root"); dataSourceMap.put("ds1", dataSource2); 这里配置的两个数据源都是普通的数据源,最后会把dataSourceMap交给ShardingDataSourceFactory管理; 表规则配置 表规则配置类TableRuleConfiguration,包含了五个要素:逻辑表、真实数据节点、数据库分片策略、数据表分片策略、分布式主键生成策略; TableRuleConfiguration orderTableRuleConfig = new TableRuleConfiguration("t_order", "ds${0..1}.t_order${0..1}"); orderTableRuleConfig.setDatabaseShardingStrategyConfig( new StandardShardingStrategyConfiguration("user_id", new MyPreciseSharding())); orderTableRuleConfig.setTableShardingStrategyConfig( new StandardShardingStrategyConfiguration("order_id", new MyPreciseSharding())); orderTableRuleConfig.setKeyGeneratorConfig(new KeyGeneratorConfiguration("SNOWFLAKE", "id")); 逻辑表:这里配置的逻辑表就是t_order,对应的物理表有t_order0,t_order1; 真实数据节点:这里使用行表达式进行配置的,简化了配置;上面的配置就相当于配置了: db0 ├── t_order0 └── t_order1 db1 ├── t_order0 └── t_order1 数据库分片策略:这里的库分片策略就是上面介绍的五种类型,这里使用的StandardShardingStrategyConfiguration,需要指定分片键和分片算法,这里使用的是精确分片算法; public class MyPreciseSharding implements PreciseShardingAlgorithm<Integer> { @Override public String doSharding(Collection<String> availableTargetNames, PreciseShardingValue<Integer> shardingValue) { Integer index = shardingValue.getValue() % 2; for (String target : availableTargetNames) { if (target.endsWith(index + "")) { return target; } } return null; } } 这里的shardingValue就是user_id对应的真实值,每次和2取余;availableTargetNames可选择就是{ds0,ds1};看余数和哪个库能匹配上就表示路由到哪个库; 数据表分片策略:指定的**分片键(order_id)**和分库策略不一致,其他都一样; 分布式主键生成策略:ShardingSphere-JDBC提供了多种分布式主键生成策略,后面详细介绍,这里使用雪花算法; 配置分片规则 配置分片规则ShardingRuleConfiguration,包括多种配置规则:表规则配置、绑定表配置、广播表配置、默认数据源名称、默认数据库分片策略、默认表分片策略、默认主键生成策略、主从规则配置、加密规则配置; 表规则配置 tableRuleConfigs:也就是上面配置的库分片策略和表分片策略,也是最常用的配置; 绑定表配置 bindingTableGroups:指分⽚规则⼀致的主表和⼦表;绑定表之间的多表关联查询不会出现笛卡尔积关联,关联查询效率将⼤⼤提升; 广播表配置 broadcastTables:所有的分⽚数据源中都存在的表,表结构和表中的数据在每个数据库中均完全⼀致。适⽤于数据量不⼤且需要与海量数据的表进⾏关联查询的场景; 默认数据源名称 defaultDataSourceName:未配置分片的表将通过默认数据源定位; 默认数据库分片策略 defaultDatabaseShardingStrategyConfig:表规则配置可以设置数据库分片策略,如果没有配置可以在这里面配置默认的; 默认表分片策略 defaultTableShardingStrategyConfig:表规则配置可以设置表分片策略,如果没有配置可以在这里面配置默认的; 默认主键生成策略 defaultKeyGeneratorConfig:表规则配置可以设置主键生成策略,如果没有配置可以在这里面配置默认的;内置UUID、SNOWFLAKE生成器; 主从规则配置 masterSlaveRuleConfigs:用来实现读写分离的,可配置一个主表多个从表,读面对多个从库可以配置负载均衡策略; 加密规则配置 encryptRuleConfig:提供了对某些敏感数据进行加密的功能,提供了⼀套完整、安全、透明化、低改造成本的数据加密整合解决⽅案; 数据插入 以上准备好,就可以操作数据库了,这里执行插入操作: DataSource dataSource = ShardingDataSourceFactory.createDataSource(dataSourceMap, shardingRuleConfig, new Properties()); Connection conn = dataSource.getConnection(); String sql = "insert into t_order (user_id,order_id) values (?,?)"; PreparedStatement preparedStatement = conn.prepareStatement(sql); for (int i = 1; i <= 10; i++) { preparedStatement.setInt(1, i); preparedStatement.setInt(2, 100 + i); preparedStatement.executeUpdate(); } 通过以上配置的真实数据源、分片规则以及属性文件创建分片数据源ShardingDataSource;接下来就可以像使用单库单表一样操作分库分表了,sql中可以直接使用逻辑表,分片算法会根据具体的值就行路由处理; 经过路由最终:奇数入ds1.t_order1,偶数入ds0.t_order0;以上使用了最常见的精确分片算法,下面继续看一下其他几种分片算法; 分片算法 上面的介绍的精确分片算法中,通过PreciseShardingValue来获取当前分片键值,ShardingSphere-JDBC针对每种分片算法都提供了相应的ShardingValue,具体包括: PreciseShardingValue RangeShardingValue ComplexKeysShardingValue HintShardingValue 区间分片算法 用在区间查询的时候,比如下面的查询SQL: select * from t_order where order_id>2 and order_id<9 以上两个区间值2、9会直接保存到RangeShardingValue中,这里没有指定user_id用来做库路由,所以会访问两个库; public class MyRangeSharding implements RangeShardingAlgorithm<Integer> { @Override public Collection<String> doSharding(Collection<String> availableTargetNames, RangeShardingValue<Integer> shardingValue) { Collection<String> result = new LinkedHashSet<>(); Range<Integer> range = shardingValue.getValueRange(); // 区间开始和结束值 int lower = range.lowerEndpoint(); int upper = range.upperEndpoint(); for (int i = lower; i <= upper; i++) { Integer index = i % 2; for (String target : availableTargetNames) { if (target.endsWith(index + "")) { result.add(target); } } } return result; } } 可以发现会检查区间开始和结束中的每个值和2取余,是否都能和真实的表匹配; 复合分片算法 可以同时使用多个分片键,比如可以同时使用user_id和order_id作为分片键; orderTableRuleConfig.setDatabaseShardingStrategyConfig( new ComplexShardingStrategyConfiguration("order_id,user_id", new MyComplexKeySharding())); orderTableRuleConfig.setTableShardingStrategyConfig( new ComplexShardingStrategyConfiguration("order_id,user_id", new MyComplexKeySharding())); 如上在配置分库分表策略时,指定了两个分片键,用逗号隔开;分片算法如下: public class MyComplexKeySharding implements ComplexKeysShardingAlgorithm<Integer> { @Override public Collection<String> doSharding(Collection<String> availableTargetNames, ComplexKeysShardingValue<Integer> shardingValue) { Map<String, Collection<Integer>> map = shardingValue.getColumnNameAndShardingValuesMap(); Collection<Integer> userMap = map.get("user_id"); Collection<Integer> orderMap = map.get("order_id"); List<String> result = new ArrayList<>(); // user_id,order_id分片键进行分表 for (Integer userId : userMap) { for (Integer orderId : orderMap) { int suffix = (userId+orderId) % 2; for (String s : availableTargetNames) { if (s.endsWith(suffix+"")) { result.add(s); } } } } return result; } } Hint分片算法 在一些应用场景中,分片条件并不存在于 SQL,而存在于外部业务逻辑;可以通过编程的方式向 HintManager 中添加分片条件,该分片条件仅在当前线程内生效; // 设置库表分片策略 orderTableRuleConfig.setDatabaseShardingStrategyConfig(new HintShardingStrategyConfiguration(new MyHintSharding())); orderTableRuleConfig.setTableShardingStrategyConfig(new HintShardingStrategyConfiguration(new MyHintSharding())); // 手动设置分片条件 int hitKey1[] = { 2020, 2021, 2022, 2023, 2024 }; int hitKey2[] = { 3020, 3021, 3022, 3023, 3024 }; DataSource dataSource = ShardingDataSourceFactory.createDataSource(dataSourceMap, shardingRuleConfig, new Properties()); Connection conn = dataSource.getConnection(); for (int i = 1; i <= 5; i++) { final int index = i; new Thread(new Runnable() { @Override public void run() { try { HintManager hintManager = HintManager.getInstance(); String sql = "insert into t_order (user_id,order_id) values (?,?)"; PreparedStatement preparedStatement = conn.prepareStatement(sql); // 分别添加库和表分片条件 hintManager.addDatabaseShardingValue("t_order", hitKey1[index - 1]); hintManager.addTableShardingValue("t_order", hitKey2[index - 1]); preparedStatement.setInt(1, index); preparedStatement.setInt(2, 100 + index); preparedStatement.executeUpdate(); } catch (SQLException e) { e.printStackTrace(); } } }).start(); } 以上实例中,手动设置了分片条件,分片算法如下所示: public class MyHintSharding implements HintShardingAlgorithm<Integer> { @Override public Collection<String> doSharding(Collection<String> availableTargetNames, HintShardingValue<Integer> shardingValue) { List<String> shardingResult = new ArrayList<>(); for (String targetName : availableTargetNames) { String suffix = targetName.substring(targetName.length() - 1); Collection<Integer> values = shardingValue.getValues(); for (int value : values) { if (value % 2 == Integer.parseInt(suffix)) { shardingResult.add(targetName); } } } return shardingResult; } } 不分片 配置NoneShardingStrategyConfiguration即可: orderTableRuleConfig.setDatabaseShardingStrategyConfig(new NoneShardingStrategyConfiguration()); orderTableRuleConfig.setTableShardingStrategyConfig(new NoneShardingStrategyConfiguration()); 这样数据会插入每个库每张表,可以理解为广播表 分布式主键 面对多个数据库表需要有唯一的主键,引入了分布式主键功能,内置的主键生成器包括:UUID、SNOWFLAKE; UUID 直接使用UUID.randomUUID()生成,主键没有任何规则;对应的主键生成类:UUIDShardingKeyGenerator; SNOWFLAKE 实现类:SnowflakeShardingKeyGenerator;使⽤雪花算法⽣成的主键,⼆进制表⽰形式包含 4 部分,从⾼位到低位分表为:1bit 符号位、41bit 时间戳位、10bit ⼯作进程位以及 12bit 序列号位;来自官网的图片: 扩展 实现接口:ShardingKeyGenerator,实现自己的主键生成器; public interface ShardingKeyGenerator extends TypeBasedSPI { Comparable<?> generateKey(); } 实战 使用也很简单,直接使用KeyGeneratorConfiguration即可,配置对应的算法类型和字段名称: orderTableRuleConfig.setKeyGeneratorConfig(new KeyGeneratorConfiguration("SNOWFLAKE", "id")); 这里使用雪花算法生成器,对应生成的字段是id;结果如下: mysql> select * from t_order0; +--------------------+---------+----------+ | id | user_id | order_id | +--------------------+---------+----------+ | 589535589984894976 | 0 | 0 | | 589535590504988672 | 2 | 2 | | 589535590718898176 | 4 | 4 | +--------------------+---------+----------+ 分布式事务 ShardingSphere-JDBC使用分布式事务和使用本地事务没什么区别,提供了透明化的分布式事务;支持的事务类型包括:本地事务、XA事务和柔性事务,默认是本地事务; public enum TransactionType { LOCAL, XA, BASE } 依赖 根据具体使用XA事务还是柔性事务,需要引入不同的模块; <dependency> <groupId>org.apache.shardingsphere</groupId> <artifactId>sharding-transaction-xa-core</artifactId> </dependency> <dependency> <groupId>org.apache.shardingsphere</groupId> <artifactId>shardingsphere-transaction-base-seata-at</artifactId> </dependency> 实现 ShardingSphere-JDBC提供了分布式事务管理器ShardingTransactionManager,实现包括: XAShardingTransactionManager:基于 XA 的分布式事务管理器; SeataATShardingTransactionManager:基于 Seata 的分布式事务管理器; XA 的分布式事务管理器具体实现包括:Atomikos、Narayana、Bitronix;默认是Atomikos; 实战 默认的事务类型是TransactionType.LOCAL,ShardingSphere-JDBC天生面向多数据源,本地模式其实是循环提交每个数据源的事务,不能保证数据的一致性,所以需要使用分布式事务,具体使用也很简单: //改变事务类型为XA TransactionTypeHolder.set(TransactionType.XA); DataSource dataSource = ShardingDataSourceFactory.createDataSource(dataSourceMap, shardingRuleConfig, new Properties()); Connection conn = dataSource.getConnection(); try { //关闭自动提交 conn.setAutoCommit(false); String sql = "insert into t_order (user_id,order_id) values (?,?)"; PreparedStatement preparedStatement = conn.prepareStatement(sql); for (int i = 1; i <= 5; i++) { preparedStatement.setInt(1, i - 1); preparedStatement.setInt(2, i - 1); preparedStatement.executeUpdate(); } //事务提交 conn.commit(); } catch (Exception e) { e.printStackTrace(); //事务回滚 conn.rollback(); } 可以发现使用起来还是很简单的,ShardingSphere-JDBC会根据当前的事务类型,在提交的时候判断是走本地事务提交,还是使用分布式事务管理器ShardingTransactionManager进行提交; 读写分离 对于同一时刻有大量并发读操作和较少写操作类型的应用系统来说,将数据库拆分为主库和从库,主库负责处理事务性的增删改操作,从库负责处理查询操作,能够有效的避免由数据更新导致的行锁,使得整个系统的查询性能得到极大的改善。 主从配置 在上面章节介绍分片规则的时候,其中有说到主从规则配置,其目的就是用来实现读写分离的,核心配置类:MasterSlaveRuleConfiguration: public final class MasterSlaveRuleConfiguration implements RuleConfiguration { private final String name; private final String masterDataSourceName; private final List<String> slaveDataSourceNames; private final LoadBalanceStrategyConfiguration loadBalanceStrategyConfiguration; } name:配置名称,当前使用的4.1.0版本,这里必须是主库的名称; masterDataSourceName:主库数据源名称; slaveDataSourceNames:从库数据源列表,可以配置一主多从; LoadBalanceStrategyConfiguration:面对多个从库,读取的时候会通过负载算法进行选择; 主从负载算法类:MasterSlaveLoadBalanceAlgorithm,实现类包括:随机和循环; ROUND_ROBIN:实现类RoundRobinMasterSlaveLoadBalanceAlgorithm RANDOM:实现类RandomMasterSlaveLoadBalanceAlgorithm 实战 分别给ds0和ds1准备从库:ds01和ds11,分别配置主从同步;读写分离配置如下: List<String> slaveDataSourceNames0 = new ArrayList<String>(); slaveDataSourceNames0.add("ds01"); MasterSlaveRuleConfiguration masterSlaveRuleConfiguration0 = new MasterSlaveRuleConfiguration("ds0", "ds0", slaveDataSourceNames0); shardingRuleConfig.getMasterSlaveRuleConfigs().add(masterSlaveRuleConfiguration0); List<String> slaveDataSourceNames1 = new ArrayList<String>(); slaveDataSourceNames1.add("ds11"); MasterSlaveRuleConfiguration masterSlaveRuleConfiguration1 = new MasterSlaveRuleConfiguration("ds1", "ds1", slaveDataSourceNames1); shardingRuleConfig.getMasterSlaveRuleConfigs().add(masterSlaveRuleConfiguration1); 这样在执行查询操作的时候会自动路由到从库,实现读写分离; 总结 本文重点介绍了ShardingSphere-JDBC的数据分片功能,这也是所有数据库中间件的核心功能;当然分布式主键、分布式事务、读写分离等功能也是必不可少的;同时ShardingSphere还引入了弹性伸缩的功能,这是一个非常亮眼的功能,因为数据库分片本身是有状态的,所以我们在项目启动之初都固定了多少库多少表,然后通过分片算法路由到各个库表,但是业务的发展往往超乎我们的预期,这时候如果想扩表扩库会很麻烦,目前看ShardingSphere官网弹性伸缩处于alpha开发阶段,非常期待此功能。 参考 https://shardingsphere.apache.org/document/current/cn/overview/ 感谢关注 可以关注微信公众号「回滚吧代码」,第一时间阅读,文章持续更新;专注Java源码、架构、算法和面试。


资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册