首页 文章 精选 留言 我的

精选列表

搜索[google i/o],共10000篇文章
优秀的个人博客,低调大师

海云数据:为大数据和A I落地勾勒新篇章

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 【51CTO.com原创稿件】笔者初识海云数据,是2015年图易4.0产品的发布,图易4.0是海云数据定制产品的基础模型,其价值在于能够使数据运营与分析服务形成商业闭环。这时的海云数据给笔者的印象是专注于提供企业级大数据整体运营与分析服务,正在探索并逐渐开启中国后BI时代道路的大门。2016年,图易5.0发布,此时的图易正式由单一的大数据可视化底层分析软件,延伸到基于云存储、分析、数据对接、互动硬件等多业务结合的大数据可视化平台。为大数据的落地应用勾勒出新篇章——“图易大数据决策产品生态平台”。 当今,AI风口已经出现,海云数据当然不会放过这次机遇。今年8月份,一场主题为“感知无法看见的数据,赋能无法计算的智慧”的AI战略发布会,标志着海云数据将正式加入AI大军:海云数据今后将专注利用人工智能与可视分析技术,赋予用户在灵活科学地分析数据中形成更加智慧的业务决策能力,真正帮助用户实现在业务场景中的效率提升与价值变现,致力于成为AI能力服务的***。近日,海云数据图易6暨AI能力服务平台新品发布会于北京成功举办,此次发布会以“新能力,新服务,新共享”为主题,发布了推动大数据、人工智能行业落地全新产品——图易6和AI能力服务平台新品,并宣布行业共享、共赢的实现路径。 向大数据和人工智能在行业中的落地应用再迈出一步 为了使用户在新时代下拥有自我进化的新能力并在业务数据中实现高效决策,海云数据以大数据与人工智能技术为中心,构建出全新的图易AI能力服务平台。此次发布的图易6新品本身即是一个AI应用能力服务设计平台,以服务设计为驱动力,将有价值的软件、硬件、数据、算法变为资源,通过自助的个性化定义,将各种能力通过服务赋予端用户,完成用户业务的效率提升和数据决策价值变现。 据介绍,图易6的能力组件全程实现了无代码化,用户可根据需求自主构建智能数据处理模型,即自己组合需求模块,实现“傻瓜式”操作。如此一来,用户今后可根据不断增加的业务需求不断更新自己的能力矩阵,就像搭积木一样简单,试错成本极低。 “图易6及AI能力服务平台新品将颠覆传统的功能建设模型,在AI时代赋予用户业务数据实现高效决策与自我进化的新能力。” 海云数据创始人、CEO冯一村在发布会上表示。 海云数据创始人、CEO冯一村 智警大脑:可视化分析与AI的***结合 以图易6为核心平台研发的针对城市公共安全、道路交通管理的产品——智警大脑是此次发布会的一大亮点。 冯一村在发布会现场通过演示,展现了内嵌可视分析与人工智能技术的智警大脑的新能力。 当用户通过人脸识别进入到智警大脑后,可使用语音指令让智警大脑系统实现放大缩小地图、调出事故现场视频及周围消防、医院、警力分配情况,并赋予公安高层指挥决策和调度的能力,确保在事故发生后公安部门能快速反应、快速处理、快速解决。 智警大脑演示 海云数据将图易6的融合通信及语音识别、机器学习、人脸识别等人工智能技术应用于智警大脑,再加上大数据可视分析技术,实现了公安业务的安全登录、智能语音调度指挥,提升公安业务能力,致力于解决“巡警的危机、刑警的风险和警令的无奈”三大难题。 打造新共享体系,共同掘金AI行业市场 此次发布会的另一大主题是海云数据提出的新共享理念。海云数据的图易AI能力服务平台包含用户开放平台、资源平台、赋能平台、能力平台、客户平台、业务平台、资本基金平台和AI学习平台。在这个平台,海云数据的技术能力、政府的政策支持、股东的资本能力、合作伙伴的渠道能力、机构的基础研究能力均可以共享,以此共同推动用户能力实现自我进化,具备AI技术、资金、渠道赋能的特征。冯一村解释说,“我们新共享平台是一个利益共同体,能力共享、市场共享、财力共享,共同掘金AI行业市场。” 记者视点 人工智能将迎来落地的战略机遇,早在一年前,海云数据就开始对人工智能进行布局,对后台人工智能技术进行了升级和迭代,此次图易6的发布更是海云数据向大数据和人工智能在行业中的落地应用迈出的一大步。 据悉,按照海云数据的发展目标,到2021年,能力服务平台上核心合作伙伴将达到30家,AI平台实现数据自主采集、自主分析,而业务能力单人组建时间不超过24小时,每天可同时执行100个复杂项目。海云数据的自信可见一斑。 【51CTO原创稿件,合作站点转载请注明原文作者和出处为51CTO.com】 【责任编辑: 赵立京 TEL:(010)68476606】

优秀的个人博客,低调大师

《Android的设计与实现:卷I》——第3章 3.4.5解析Action

3.4.5 解析Action 1.parse_action 解析Action首先从parse_action函数开始,代码如下:static void parse_action(struct parse_state state, int nargs, charargs){ struct action act; ……//省略错误处理内容 act = calloc(1, sizeof(act)); act->name = args[1]; list_init(&act->commands); /将Action的指针节点放入action_list中/ list_add_tail(&action_list, &act->alist); return act;}从parse_action函数的代码可以看出,解析Action的过程与解析Service的过程十分相似。首先给新创建的Action分配存储空间,然后将Action的指针节点放入一个action_list列表中。这里又涉及两个重要的数据类型:action结构体和action_list链表。action_list与service_list都是由list_declare宏声明,即static list_declare(action_list)。action结构体定义在/system/core/init/init.h中,代码如下:struct action { /这个指针节点所在的链表存储了所有Action的指针节点 / struct listnode alist; /这个指针节点所在的链表存储了所有即将执行的Action的指针节点/ struct listnode qlist; /这个指针节点所在的链表存储了所有要触发的Action的指针节点/ struct listnode tlist; unsigned hash; const charname; /Action对应的Command/ struct listnode commands; struct command current;}; 2.parse_line_action 熟悉了Action的存储形式,接着分析Action的解析过程。定位到parse_line_action函数,该函数位于init_parser.c中,代码如下:static void parse_line_action(struct parse_state state, int nargs, charargs){ struct command cmd; /通过state结构体得到当前Action的引用/ struct action *act = state->context; int (func)(int nargs, charargs); int kw, n; /依然是根据关键字匹配,不过这次匹配的是Command / kw = lookup_keyword(args[0]); n = kw_nargs(kw); ……//省略错误处理内容 cmd = malloc(sizeof(cmd) + sizeof(char) nargs); cmd->func = kw_func(kw);//获取Command对应的指令函数 cmd->nargs = nargs; memcpy(cmd->args, args, sizeof(char)nargs); /将Command加入Action的Command列表/ list_add_tail(&act->commands, &cmd->clist); parse_line_action函数的执行过程很清晰,要比parse_line_service简单很多。这里涉及一个重要的数据类型struct command。command结构体定义在/system/core/init/init.h中,代码如下:struct command{ / list of commands in an action / struct listnode clist; / command对应的执行函数/ int (func)(int nargs, charargs); int nargs; char args[1];};至此,init.rc的解析过程便告一段落。接下来开始分析Action和Service的执行阶段。

优秀的个人博客,低调大师

《Android的设计与实现:卷I》——第2章 框架基础JNI

第2章 框架基础JNI JNI(Java Native Interface,Java本地接口)是Java平台上定义的一套标准的本地编程接口。JNI允许Java代码与本地代码互操作,即Java代码可以调用本地代码,本地代码也可以调用Java代码。所谓本地代码指的是用其他编程语言(如C/C++)实现的、依赖于特定硬件和操作系统的代码。通过JNI调用本地代码,可以实现Java语言所不能实现的功能。在Android平台上,Dalvik虚拟机会实现JNI定义的接口。 2.1 JNI在Android系统中所处的位置 Android采用分层的体系结构:上层的应用层和应用框架层主要使用Java语言开发;下层则运行一个Linux内核,并在内核之上集成了各种核心库和第三方库,以提供系统运行所需的服务,这部分是用C和C++语言开发。连接这两部分的纽带就是JNI。JNI在Android系统中所处的位置如图2-1所示。 从图2-1中可以看出,JNI可以直接调用本地代码库,并可以通过Dalvik虚拟机实现与应用层和应用框架层之间的交互。Android JNI部分的代码主要位于Android体系结构中的上面两层: 应用层:采用NDK开发,主要使用标准JNI编程模型实现。 应用框架层:Android定义了一套JNI编程模型,使用函数注册方式弥补了标准JNI编程模型的不足。 Android应用框架层JNI部分源码主要位于frameworks/base/目录下。按照模块组织,不同的模块将被编译为不同的共享库,分别为上层提供不同的服务。这些共享库最终会被放置在目标系统的/system/lib目录下。 注意 NDK与JNI的区别: NDK是为便于开发基于JNI的应用而提供的一套开发和编译工具集;而JNI则是一套编程接口,可以运用在应用层,也可以运用在应用框架层,以实现Java代码与本地代码的互操作。 JNI编程模型的结构十分清晰,可以概括为以下三个步骤:步骤1 Java层声明Native方法。步骤2 JNI层实现Java层声明的Native方法,在JNI层可以调用底层库或者回调Java层方法。这部分将被编译为动态库(SO文件)供系统加载。步骤3 加载JNI层代码编译后生成的共享库。JNI的很多概念比较模糊,为了不引起歧义,这里规定本书中的涉及名词的含义。 native:特指Java语言中的方法修饰符native。 Native方法:特指Java层中声明的、用native修饰的方法。 JNI层:特指采用JNI技术实现Java层声明的Native方法的部分。 JNI函数:特指JNIEnv提供的函数。 JNI方法:特指Native方法对应的JNI层实现方法。 了解了JNI的主要概念和基本结构,下一节将以一个实例详细分析JNI编程的三个步骤。

优秀的个人博客,低调大师

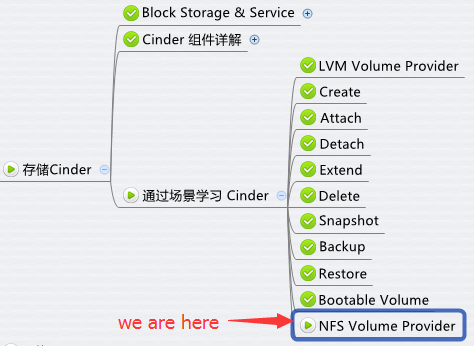
NFS Volume Provider(Part I) - 每天5分钟玩转 OpenStack(62)

cinder-volume 支持多种 volume provider,前面我们一直使用的是默认的 LVM,本节我们将增加 NFS volume provider。 虽然 NFS 更多地应用在实验或小规模 cinder 环境,由于性能和缺乏高可用的原因在生产环境中不太可能使用,但是学习 NFS volume provider 的意义在于:1. 理解 cinder-volume 如何支持多 backend2. 更重要的,可以理解 cinder-volume,nova-compute 和 volume provider 是如何协同工作,共同为 instance 提供块存储。3. 举一反三,能够快速理解并接入其他生产级 backend ,比如 Ceph,商业存储等。下图展示了 cinder、nova 是如何与 NFS volume provider 协调工作的。 NFS Volume Provider就是我们通常说的 NFS Server,提供远程 NFS 目录,NFS Clinet 可以 mount 这些远程目录到本地,然后像使用本地目录一样创建、读写文件以及子目录。 cinder-volume存储节点通过 NFS driver 管理 NFS volume provider 中的 volume,这些 volume 在 NFS 中实际上是一个个文件。 nova-compute计算节点将 NFS volume provider 存放 volume 的目录 mount 到本地,然后将 volume 文件作为虚拟硬盘映射给 instance。 这里有几点需要强调: 在 Cinder 的 driver 架构中,运行 cinder-volume 的存储节点和 Volume Provider 可以是完全独立的两个实体。 cinder-volume 通过 driver 与 Volume Provider 通信,控制和管理 volume。 Instance 读写 volume 时,数据流不需要经过存储节点,而是直接对 Volume Provider 中的 volume 进行读写。 正如上图所示,存储节点与 NFS Volume Provider 的连接只用作 volume 的管理和控制(绿色连线);真正的数据读写,是通过计算节点和 NFS Volume Proiver 之间的连接完成的(紫色连线)。这种设计减少了中间环节,存储节点不直接参与数据传输,保证了读写效率。 其他 Volume Provider(例如 ceph,swift,商业存储等)均遵循这种控制流与数据流分离的设计。 配置 NFS Volume Provider 在实验环境中,NFS volume provider 的 NFS 远程目录为 192.168.104.11:/storage cinder-volume 服务节点上 mount point 为 /nfs_storage。 在 /etc/cinder/cinder.conf 中添加 nfs backend。 enabled_backends = lvmdriver-1,nfs 让 cinder-volume 使用 nfs backend [nfs] 中详细配置 nfs backend。包括: a) 指定存储节点上 /nfs_storage 为 nfs 的 mount point。 nfs_mount_point_base = /nfs_storage b) 查看 /etc/cinder/nfs_shares 活动 nfs 共享目录列表。 nfs_shares_config = /etc/cinder/nfs_shares,其内容为 列表中只有 192.168.104.11:/storage。如果希望有多个 nfs 共享目录存放 volume,则可以添加到该文件中。 c) nfs volume driver。 volume_driver=cinder.volume.drivers.nfs.NfsDriver d) 设置 volume backend name。在 cinder 中需要根据这里的 volume_backend_name 创建对应的 volume type,这个非常重要。 volume_backend_name = nfs 重启 cinder-volume,cinder service-list 确认 nfs cinder-volume 服务正常工作。 创建 nfs volume type。 打开GUI页面Admin -> System -> Volumes -> Volume Types,点击 “Create Volume Type”。 命名 nfs,点击“Create Volume Type”。 选择 nfs volume tyep,点击下拉菜单“View Extra Specs” 点击“Create”,Key 输入 volume_backend_name ;Value 输入 nfs。 NFS volume provider 准备就绪,下一节我们将创建 NFS 为 backend 的 volume。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册
修改密码
忘记密码