首页 文章 精选 留言 我的

精选列表

搜索[监督学习],共10000篇文章
优秀的个人博客,低调大师

Java学习笔记--可变参数

可变参数的格式: 数据类型... 变量名 可变参数要 注意的细节: 1. 如果一个函数 的形参使用上了可变参数之后,那么调用该方法的时候可以传递参数也可以不传递参数。 2. 可变参数实际上是一个数组对象。 3. 可变参数必须位于形参中的最后一个参数。 4. 一个函数最多只能有一个可变 参数,因为可变参数要位于形参中最后一个位置上。 public class Demo4 { public static void main(String[] args) { int[] arr = {1,2,3,4}; add(1,2,3,4);//输出10 add(arr);//输出10 add();//输出0 } public static void add(int... arr){ //长度是0 int result = 0; for(int item : arr){ result+=item; } System.out.println("总和:"+ result); } }

优秀的个人博客,低调大师

java学习笔记--增强for循环

什么是增强for循环? 原来的for循环是这样子的: for(int i=0;i<10;i++) 那我们来看一下增强for循环: for(object a:x)//不只是object 数组存储的是什么类型的就填什么类型 x是数组或者集合 里面是Interator迭代器实现的 注意:遍历的时候不能用集合增删元素 只能通过迭代器进行操作 因为迭代器创建的时候会创建一个单链表 如果是通过集合来操作元素数量的话那么 实际的数量是变化了 可是迭代器创建的那个单链表却还是原来的样子 这样子 迭代器往下遍历的时候 就找不到实际的值 重点: 增强for循环的适用范围: 如果是实现了Iterable接口的对象或者是数组对象(包括int)都可以使用增强for循环。 //注意: Map集合没有实现Iterable接口,所以map集合不能直接使用增强for循环,如果需要使用增强for循环需要借助于Collection // 的集合。 HashMap<String, String> map = new HashMap<String, String>(); map.put("001","张三"); map.put("002","李四"); map.put("003","王五"); map.put("004","赵六"); Set<Map.Entry<String, String>> entrys = map.entrySet(); for(Map.Entry<String, String> entry :entrys){ System.out.println("键:"+ entry.getKey()+" 值:"+ entry.getValue()); } 举例: 实现了Iterable接口的对象 package cn.itcast.jdk15; import java.util.Iterator; //自定一个类使用增强for循环 class MyList implements Iterable<String>{ Object[] arr = new Object[10]; int index = 0 ; //当前的指针 public void add(Object o){ arr[index++] = o; // 1 } public int size(){ return index; } @Override public Iterator<String> iterator() { return new Iterator<String>() { int cursor = 0; @Override public boolean hasNext() { return cursor<index; } @Override public String next() { return (String) arr[cursor++]; } @Override public void remove() { } }; } } public class Demo3 { public static void main(String[] args) { MyList list = new MyList(); list.add("张三"); list.add("李四"); list.add("王五"); for(String item :list){ System.out.println(item); } } }

优秀的个人博客,低调大师

Effective C++学习笔记

导读 本书的最佳用途:彻底了解C++如何行为,为什么那样行为,以及如何运用其行为形成优势。 size_t是一个typedef,是某种不带正负号的unsigned类型。 签名(signature):函数的参数和返回值。即std::size_t num(int number) 的签名是 std::size_t ( int ) explicit可组织他被用来隐式转换(implicit type conversions),但他仍可以被进行显示转换(explicit type conversions)。 如图: 拷贝构造---以同型对象初始化自我对象。 拷贝赋值---从另一个同性对象中拷贝其值到自我对象。 1、让自己习惯C++ 条款一:视C++为一个语言联邦 c++是四种语言的联邦 每种语言都有自己的规约。C++高效编程守则视状况而变化,取决于你使用C++的哪一部分。 条款2:尽量以const、enum、inline替换#define 也就是“宁可以编译器替换预处理”。因为define或许不被视为语言的一部分。 class专属常量:为了将常量的作用域(scope)限制于class内,必须让它成为class的一个成员(member);而为了确保此常量最多只有一份实体,必须让它成为static成员。 我们无法用#define创建一个专属常量。 menu hack: 1、menu hack的行为更像#define,而不是const。例如取const地址是合法的,而取menu hack或者#define的地址是不合法的。 2、如果不希望别人活得一个pointer或reference指向你的某个常量,enum可以帮你实现这个约束。 3、enum和#define绝不会导致没必要的内存分配,因为有的编译器会为const对象设定另外的存储空间。 4、enum hack是模板元编程的技术基础。 对于单纯的常量,最好以const对象或enum替换#define;对于形似函数的宏,最好用inline函数替换#define。 条款3:尽可能使用const 令函数的返回值为const,可以降低因客户错误而造成的意外。如下图: class R{.....} const R poerator *(const R& lns, const R& rhs) 两个成员函数如果只是常量性(constness)方面不同,可以被重载,如下图: 上图中non-const operator[]的返回值类型是char &,而不是char,因为如果函数的返回类型是一个内置类型,那么改动函数返回值就不合法(what?我不懂。。。吴老师:这个说法有点令人困惑。关键不是内置类型与否,而是值类型与否。需要修改内容,函数需要返回一个非const的引用。。。还是不太懂。。。) 条款4:确定对象被使用前已先被初始化 int x; c++语言中,上述语句在某些语境下,x被初始化为0,某些情况下x不被初始化。读取未初始化的值会导致不明确的行为。在某些平台上,仅仅只是读取未初始化的值,就可以让你的程序终止运行。 不要混淆赋值和初始化,如下图: c++规定:对象成员变量的初始化动作发生在进入构造函数本体之前。 使用初始列进行初始化的效率更高,因为比起先调用default构造函数然后再调用copy assignment操作符,单只调用一次copy构造函数比较高效,有时甚至高效得多。 (1)在初始化列表中,成员的初始化顺序和成员的声明顺序相同,与初始化列表的位置顺序无关。(2) 初始化列表先于构造函数执行。 (3) 类中可以定义const成员变量,它并非真正意义的常量,而是只读变量,其初始化方式只能依靠初始化列表。 const只读变量虽然不可出现在赋值符号的左边,但是可以通过指针去修改其值的。(what???) 当你想要default构造一个成员变量,你都可以使用初值列,只要指定无物(nothing)作为初始化实参即可。如下图: 规定总是在初值列中列出所有成员变量,以免去记忆哪些成员变量可以无需初值。 如果成员变量是const或references,它就需要初值,而不能被赋值。具体原因详见链接: https://blog.csdn.net/qq_29344757/article/details/76093216 在class中,变量不能直接初始话,需要通过构造函数(或拷贝构造函数)来初始话,如果程序员没有定义构造函数系统会有一个默认构造函数。 除了静态数据成员外,数据成员不能在类体内显式的初始化 不同编译单元内定义之non-local static 对象 条款5:了解C++默默编写并调用哪些函数 当你写一个空类没有声明的时候,编译器会为他声明一个copy构造函数、一个copy assignment函数和一个析构函数。如果你没有声明任何构造函数,编译器会为你声明一个default构造函数。如下图: 当这些函数被调用的时候,编译器才会把他们创建出来。 注意:编译器产生的析构函数是一个non-virtual,除非这个class的base class自身声明有virtual析构函数(不明觉厉,先记下来) 如果类中你声明了一个带实参的构造函数,编译器便不会创建default构造函数,如此,你写的构造函数就不会被创建出来的无实参的default构造函数覆盖掉。 条款6:若不想使用编译器自动生成的函数,就应该明确的拒绝 驳回编译器自动提供的功能,可将相应的成员函数声明为private并且不予实现。或者使用上图所示的手法也可以(上图所示的手法感觉更好一点) 条款7:为多态基类声明virtual析构函数 如果一个类里面不含虚函数,通常意味着他并不意图被用做一个base class(基类)。当类不企图被当做base class,灵其析构函数为virtual往往是个馊主意。C++标准库中很多都是没有虚函数的class,比如string、vector、list等,所以不要把标准库中的类作为基类。 虚指针vptr(virtual table pointer)用于在运行期决定哪一个虚函数被调用。vptr指向一个由函数指针构成的数组,该数组称为虚表vtbl(virtual table):每个带有虚函数的类都有对应的虚表。 纯虚函数导致抽象类(不能被实例化(instantiated)的类) 虚析构函数的作用:为了当用一个基类的指针删除一个派生类的对象时,派生类的析构函数会被调用。(用C++开发的时候,用来做基类的类的析构函数是虚函数。) Class ClxBase { public: ClxBase() {}; //虚虚构函数 virtual ~ClxBase() {}; virtual void DoSomething() { cout << "Do something in class ClxBase!" << endl; }; }; 条款8:别让异常逃离析构函数 析构函数绝对不要吐出异常。如果一个被析构函数调用的函数可能会抛出异常,析构函数应该捕捉任何异常,然后吞下他们(不传播)或结束程序。 如果客户需要对某一操作函数运行期间抛出的异常做出反应,那么class应该提供一个普通函数(而非在析构函数中)执行该操作。 条款9:绝不在构造和析构过程中调用虚函数 class Transation { public: Transation(); virtual void logTransaction() const = 0; ... }; Transation::Transation() { ... logTransaction();//构造函数调用虚函数 } class BuyTransation :public Transation { public: virtual void logTransation() const; ... };上述代码执行: BuyTransation b; 在该调用logTransaction时,调用的虚函数是base class中的,而不是BuyTransaction中的。 因为:base class(基类)构造期间,虚函数不会下降到derived classes(子类)阶层。由于base classes构造函数的执行更早于的derived classes构造函数,当base class 构造函数执行时derived class的成员变量尚未初始化,如果器件调用的virtual函数下降至derived classes阶层,而derived classes的函数机会必然去用local成员变量,而那些成员变量尚未初始化,因此无法调用derived classes中的虚函数,而是调用base class的虚函数。 更根本原因:在derived class对象的base class 构造期间,对象的类型是base class而不是derived class。不止虚函数会被编译器解析至base class,若使用运行期类型信息,也会把对象是为base class。 logTransaction是纯虚函数,除非他被定义,否则程序无法连接,因为连接器找不到必要的Transaction::logTransaction实现代码。 弥补措施:在构造期间,可以藉由“令derived classes将必要的构造信息向上传递至base class构造函数”。 条款10:令operator= 返回一个 reference to *this 赋值采用右结合定律,因此x=y=z=15等价于(x=(y=(z=15)))。为了实现“连锁赋值”,赋值操作符必须返回一个reference指向操作符的左侧实参。 条款11:在operator= 中处理“自我赋值” “自我赋值”发生在对象被赋值给自己时。拷贝构造函数里面应该先判断一下传入的参数是不是自己。 条款12:复制对象时勿忘其每一个成分 如果你自己写拷贝构造函数,而不用编译器默认构造的拷贝构造函数,当你为class添加一个成员变量后,你必须同时修改拷贝构造函数,如果你忘记,编译器也不太可能会提醒你。一旦你给这个class添加了子类,而忘记修改基类的拷贝构造函数,子类就无法对从父类那里继承下来的变量进行赋值。 拷贝构造函数应该确保复制“对象内的所有成员变量”及“所有base class成分”。 不要试图使拷贝赋值函数调用拷贝构造函数,同时也不要试图让拷贝构造函数调用拷贝赋值函数。如果上述两个函数有重复代码,可以在private里面写一个函数供上述两个函数调用,该函数常备命名为init 条款13:对象管理资源

优秀的个人博客,低调大师

Python 学习(十)--数据解析

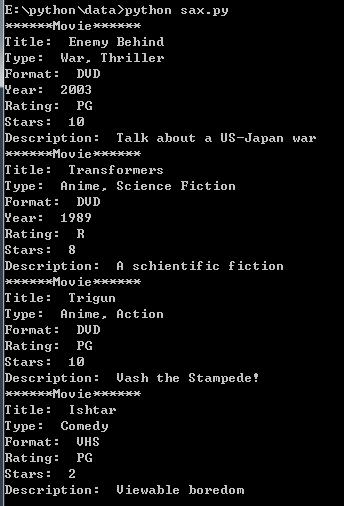
1. 什么是XML? XML 指可扩展标记语言(eXtensible Markup Language),标准通用标记语言的子集,是一种用于标记电子文件使其具有结构性的标记语言。 XML 被设计用来传输和存储数据。XML是一套定义语义标记的规则,这些标记将文档分成许多部件并对这些部件加以标识。它也是元标记语言,即定义了用于定义其他与特定领域有关的、语义的、结构化的标记语言的句法语言。 python对XML的解析 常见的XML编程接口有DOM和SAX,这两种接口处理XML文件的方式不同,当然使用场合也不同。python有三种方法解析XML,SAX,DOM,以及ElementTree: SAX (simple API for XML ) python 标准库包含SAX解析器,SAX用事件驱动模型,通过在解析XML的过程中触发一个个的事件并调用用户定义的回调函数来处理XML文件。 DOM(Document Object Model) 将XML数据在内存中解析成一个树,通过对树的操作来操作XML。 下面用到的movies.xml内容: <collection shelf="New Arrivals"> <movie title="Enemy Behind"> <type>War, Thriller</type> <format>DVD</format> <year>2003</year> <rating>PG</rating> <stars>10</stars> <description>Talk about a US-Japan war</description> </movie> <movie title="Transformers"> <type>Anime, Science Fiction</type> <format>DVD</format> <year>1989</year> <rating>R</rating> <stars>8</stars> <description>A schientific fiction</description> </movie> <movie title="Trigun"> <type>Anime, Action</type> <format>DVD</format> <episodes>4</episodes> <rating>PG</rating> <stars>10</stars> <description>Vash the Stampede!</description> </movie> <movie title="Ishtar"> <type>Comedy</type> <format>VHS</format> <rating>PG</rating> <stars>2</stars> <description>Viewable boredom</description> </movie> </collection> 2. SAX解析xml 1). SAX是一种基于事件驱动的API。利用SAX解析XML文档牵涉到两个部分:解析器和事件处理器。解析器负责读取XML文档,并向事件处理器发送事件,如元素开始跟元素结束事件;而事件处理器则负责对事件作出相应,对传递的XML数据进行处理。 1、对大型文件进行处理; 2、只需要文件的部分内容,或者只需从文件中得到特定信息。 3、想建立自己的对象模型的时候。 2). 在python中使用sax方式处理xml要先引入xml.sax中的parse函数,还有xml.sax.handler中的ContentHandler。 ContentHandler类方法介绍 characters(content)方法 调用时机: 1>. 从行开始,遇到标签之前,存在字符,content的值为这些字符串。 2>. 从一个标签,遇到下一个标签之前, 存在字符,content的值为这些字符串。 3>. 从一个标签,遇到行结束符之前,存在字符,content的值为这些字符串。 4>. 标签可以是开始标签,也可以是结束标签。 startDocument()方法: 文档启动的时候调用。 endDocument()方法: 解析器到达文档结尾时调用。 startElement(name, attrs)方法: 遇到XML开始标签时调用,name是标签的名字,attrs是标签的属性值字典。 endElement(name)方法: 遇到XML结束标签时调用。 3). make_parser方法 以下方法创建一个新的解析器对象并返回。 xml.sax.make_parser( [parser_list] ) 参数说明: parser_list - 可选参数,解析器列表 4). parser方法 以下方法创建一个 SAX 解析器并解析xml文档: xml.sax.parse( xmlfile, contenthandler[, errorhandler]) 参数说明: xmlfile - xml文件名 contenthandler - 必须是一个ContentHandler的对象 errorhandler - 如果指定该参数,errorhandler必须是一个SAX ErrorHandler对象 5). parseString方法 parseString方法创建一个XML解析器并解析xml字符串: xml.sax.parseString(xmlstring, contenthandler[, errorhandler]) 参数说明: xmlstring - xml字符串 contenthandler - 必须是一个ContentHandler的对象 errorhandler - 如果指定该参数,errorhandler必须是一个SAX ErrorHandler对象 6). 示例: import xml.sax class MovieHandler(xml.sax.ContentHandler): """docstring for MovieHandler""" def __init__(self): super(MovieHandler, self).__init__() self.CurrendData = "" self.type = "" self.format = "" self.year = "" self.rating = "" self.stars = "" self.description = "" # 元素开始调用 def startElement(self, tag, attributes): self.CurrendData = tag if tag == "movie": print("******Movie******") title = attributes["title"] print("Title: ", title) pass pass # 元素结束调用 def endElement(self, tag): if self.CurrendData == "type": print("Type: ", self.type) elif self.CurrendData == "format": print("Format: ", self.format) elif self.CurrendData == "year": print("Year: ", self.year) elif self.CurrendData == "rating": print("Rating: ", self.rating) elif self.CurrendData == "stars": print("Stars: ", self.stars) elif self.CurrendData == "description": print("Description: ", self.description) self.CurrendData = "" pass # 读取字符时调用 def characters(self, content): if self.CurrendData == "type": self.type = content elif self.CurrendData == "format": self.format = content elif self.CurrendData == "year": self.year = content elif self.CurrendData == "rating": self.rating = content elif self.CurrendData == "stars": self.stars = content elif self.CurrendData == "description": self.description = content pass if (__name__ == "__main__") : # 创建一个XMLReader parser = xml.sax.make_parser() # 关闭命名空间 parser.setFeature(xml.sax.handler.feature_namespaces, 0) # 重写 ContextHandler handler = MovieHandler() parser.setContentHandler(handler) parser.parse("movies.xml") pass 打印结果: 图1.png 3. Dom解析xml 文件对象模型(Document Object Model,简称DOM),是W3C组织推荐的处理可扩展置标语言的标准编程接口。一个 DOM 的解析器在解析一个 XML 文档时,一次性读取整个文档,把文档中所有元素保存在内存中的一个树结构里,之后你可以利用DOM 提供的不同的函数来读取或修改文档的内容和结构,也可以把修改过的内容写入xml文件。python中用xml.dom.minidom来解析xml文件. 示例: from xml.dom.minidom import parse import xml.dom.minidom # 使用minidom解析器打开XML文档 DOMTree = xml.dom.minidom.parse("movies.xml") # 获取collection节点 collection = DOMTree.documentElement if collection.hasAttribute("shelf"): print("Root element: %s" % collection.getAttribute("shelf")) pass # 在集合获取所有电影 movies = collection.getElementsByTagName("movie") # 打印每部电影的详细信息 for movie in movies: print("*******Movie********") if movie.hasAttribute("title"): print("Title: %s" % movie.getAttribute("title")) pass pass type = movie.getElementsByTagName("type")[0] print("Type: %s" % type.childNodes[0].data) format = movie.getElementsByTagName("format")[0] print("Format: %s" % format.childNodes[0].data) rating = movie.getElementsByTagName("rating")[0] print("Rating: %s" % rating.childNodes[0].data) description = movie.getElementsByTagName("description")[0] print("Description: %s" % description.childNodes[0].data) 打印结果: 图2.png 4. JSON解析 JSON (JavaScript Object Notation) 是一种轻量级的数据交换格式。它基于ECMAScript的一个子集。 Python3 中可以使用 json 模块来对 JSON 数据进行编解码,它包含了两个函数: json.dumps(): 对数据进行编码。 json.loads(): 对数据进行解码。 import json # 字典 data = { 'no' : 1, 'name' : 'mazaiting', 'url' : 'https://www.jianshu.com/u/5d2cb4bfeb15' } # 将python字典类型装换为JSON对象 json_str = json.dumps(data) print("Python 原始数据: ", repr(data)) print("JSON 对象: ", json_str) # 将JSON对象转化为Python字典 data2 = json.loads(json_str) print("data2['name']: ", data2['name']) print("data2['url']: ", data2['url']) 打印结果: 图3.png 5. 时间 Python 程序能用很多方式处理日期和时间,转换日期格式是一个常见的功能。Python 提供了一个 time 和 calendar 模块可以用于格式化日期和时间。时间间隔是以秒为单位的浮点小数。每个时间戳都以自从1970年1月1日午夜(历元)经过了多长时间来表示。Python 的 time 模块下有很多函数可以转换常见日期格式。如函数time.time()用于获取当前时间戳。 1). 获取当前时间戳 # 引入time模块 import time ticks = time.time() print("当前时间戳为:", ticks) 打印结果: 图4.png 2). 时间元组 很多Python函数用一个元组装起来的9组数字处理时间: 序号 字段 值 0 4位数年 2008 1 月 1 到 12 2 日 1到31 3 小时 0到23 4 分钟 0到59 5 秒 0到61 (60或61 是闰秒) 6 一周的第几日 0到6 (0是周一) 7 一年的第几日 1到366 (儒略历) 8 夏令时 -1, 0, 1, -1是决定是否为夏令时的旗帜 上述也就是struct_time元组。这种结构具有如下属性: 序号 属性 值 0 tm_year 2008 1 tm_mon 1 到 12 2 tm_mday 1 到 31 3 tm_hour 0 到 23 4 tm_min 0 到 59 5 tm_sec 0 到 61 (60或61 是闰秒) 6 tm_wday 0到6 (0是周一) 7 tm_yday 一年中的第几天,1 到 366 8 tm_isdst 是否为夏令时,值有:1(夏令时)、0(不是夏令时)、-1(未知),默认 -1 3). 获取当前时间 从返回浮点数的时间辍方式向时间元组转换,只要将浮点数传递给如localtime之类的函数。 import time localtime = time.localtime(time.time()) print("本地时间为:", localtime) 打印结果: 图5.png 4). 获取格式化的时间 你可以根据需求选取各种格式,但是最简单的获取可读的时间模式的函数是asctime() import time localtime = time.asctime(time.localtime(time.time())) print("本地时间为:", localtime) 打印结果: 图6.png 5). 格式化日期 我们可以使用 time 模块的 strftime 方法来格式化日期: time.strftime(format[, t]) 示例: import time # 格式化成2016-03-20 11:45:39 print(time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())) # 格式化成Wed Apr 11 16:56:32 2018形式 print(time.strftime("%a %b %d %H:%M:%S %Y", time.localtime())) # 将格式字符串转换为时间戳 a = "Wed Apr 11 16:56:32 2018" print(time.mktime(time.strptime(a, "%a %b %d %H:%M:%S %Y"))) 打印结果: 图7.png 6). python中时间日期格式化符号: %y 两位数的年份表示(00-99) %Y 四位数的年份表示(000-9999) %m 月份(01-12) %d 月内中的一天(0-31) %H 24小时制小时数(0-23) %I 12小时制小时数(01-12) %M 分钟数(00=59) %S 秒(00-59) %a 本地简化星期名称 %A 本地完整星期名称 %b 本地简化的月份名称 %B 本地完整的月份名称 %c 本地相应的日期表示和时间表示 %j 年内的一天(001-366) %p 本地A.M.或P.M.的等价符 %U 一年中的星期数(00-53)星期天为星期的开始 %w 星期(0-6),星期天为星期的开始 %W 一年中的星期数(00-53)星期一为星期的开始 %x 本地相应的日期表示 %X 本地相应的时间表示 %Z 当前时区的名称 %% %号本身 7). 日期 Calendar模块有很广泛的方法用来处理年历和月历. # 获取某月日历 import calendar cal = calendar.month(2018, 4) print("以下输出2016年1月份的日历:") print(cal) 打印结果: 图8.png

优秀的个人博客,低调大师

Elastic Stack学习--Beats组件

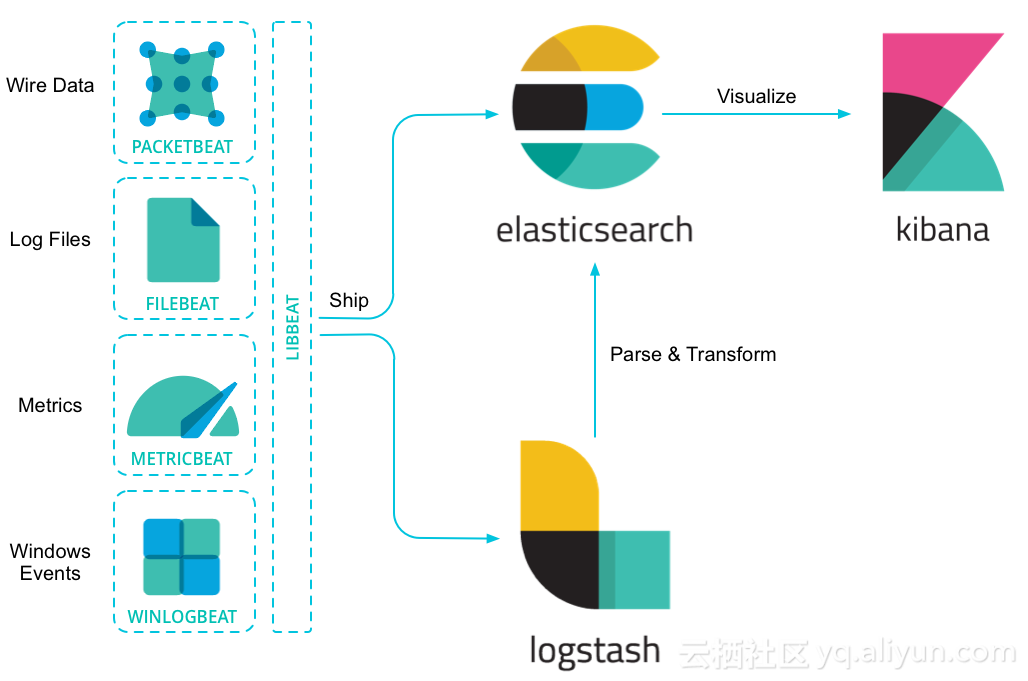
简介 beats组件是一系列用于采集数据的轻量级代理程序,用于从服务端收集日志、网络、监控数据,并最终汇总到elasticsearch。beats组件收集的数据即可以直接上报给elasticsearch,也可以通过logstash中转处理后上报给elasticsearch。 beats根据功能划分有多种: PacketBeat:用于分析和收集服务器的网络包数据; FileBeat:用于收集服务器的日志文件; MetricBeat:用于收集操作系统及业务的运行状态等监控数据; HeartBeat: WinlogBeat:用于收集windows系统的event log; beats组件也支持根据需求定制实现自己的beat。整个beats框架使用go语言实现,提供了对接elasticsearch、配置输入选项、日志记录等API。 FileBeat对接ES,监控logback日志 filebeat用于采集服务器上的各种日志文件数据,由多个prospector组成,每个prospector负责监控和采集某一类日志。prospector由用户自定义配置,多个prospector可以独立配置和运行; 第1步. 修改logback配置,输出json格式日志(非必需) 该步骤不是必需步骤,只是为了能够方便日志的后续处理,配置日志格式为json格式;1)在pom.xml中添加如下依赖: <!--日志转json格式存储--> <dependency> <groupId>net.logstash.logback</groupId> <artifactId>logstash-logback-encoder</artifactId> <version>5.0</version> </dependency> 2)修改logback.xml配置文件,新增输出json的appender: <!--json日志文件输出--> <appender name="json" class="ch.qos.logback.core.rolling.RollingFileAppender"> <file>${jsonLogfile}</file> <rollingPolicy class="ch.qos.logback.core.rolling.TimeBasedRollingPolicy"> <fileNamePattern>${LOG_PATH}/${LOG_FILE}.%d{yyyy-MM-dd}.json</fileNamePattern> <maxHistory>10</maxHistory> </rollingPolicy> <encoder class="net.logstash.logback.encoder.LoggingEventCompositeJsonEncoder"> <providers> <pattern> <pattern> { "logfile": "${LOG_FILE}", "service": "omark-profile-microservice", "timestamp": "%date{\"yyyy-MM-dd'T'HH:mm:ss,SSSZ\"}", "log_level": "%level", "thread": "%thread", "logger": "%logger", "line_number": "%line", "message": "%message", "stack_trace": "%exception" } </pattern> </pattern> </providers> </encoder> </appender> 上面pattern标签中配置的json格式日志,在日志中会以一行输出;类似如下: {"logfile":"profile-service.log","service":"omark-profile-microservice","timestamp":"2018-04-10T15:32:55,488+0800","log_level":"INFO","thread":"main","logger":"org.elasticsearch.plugins.PluginsService","line_number":"177","message":"loaded plugin [org.elasticsearch.percolator.PercolatorPlugin]","stack_trace":""} {"logfile":"profile-service.log","service":"omark-profile-microservice","timestamp":"2018-04-10T15:32:55,488+0800","log_level":"INFO","thread":"main","logger":"org.elasticsearch.plugins.PluginsService","line_number":"177","message":"loaded plugin [org.elasticsearch.script.mustache.MustachePlugin]","stack_trace":""} {"logfile":"profile-service.log","service":"omark-profile-microservice","timestamp":"2018-04-10T15:32:55,489+0800","log_level":"INFO","thread":"main","logger":"org.elasticsearch.plugins.PluginsService","line_number":"177","message":"loaded plugin [org.elasticsearch.transport.Netty3Plugin]","stack_trace":""} {"logfile":"profile-service.log","service":"omark-profile-microservice","timestamp":"2018-04-10T15:32:55,489+0800","log_level":"INFO","thread":"main","logger":"org.elasticsearch.plugins.PluginsService","line_number":"177","message":"loaded plugin [org.elasticsearch.transport.Netty4Plugin]","stack_trace":""} 3)将appender添加到logger中,使appender生效: <!--生产环境--> <springProfile name="prod"> <logger name="org.springframework" level="info" additivity="false"> <appender-ref ref="system"/> <appender-ref ref="json"/> </logger> <logger name="org.hibernate" level="error" additivity="false"> <appender-ref ref="system"/> <appender-ref ref="json"/> </logger> <!--根日志--> <root level="info"> <appender-ref ref="system"/> <appender-ref ref="json"/> </root> </springProfile> 第2步. FileBeat安装&配置 linux下filebeat的安装很简单,直接下载压缩包解压即可:1)下载beat,上传服务器并解压; tar -zxvf filebeat-6.2.2-linux-x86_64.tar.gz cd filebeat-6.2.2-linux-x86_64 可以看到filebeat的目录结构如下: data fields.yml filebeat filebeat.reference.yml filebeat.yml kibana LICENSE.txt logs module modules.d NOTICE.txt README.md 主要文件功能如下: filebeat:filebeat执行的二进制文件; filebeat.yml:filebeat的核心配置文件; fields.yml:filebeat上报日志前,需要先在elasticsearch上建好index模板,从而在日志上报时,elasticsearch能够根据index模板自动创建index;该配置文件用于指定创建index时所需要的字段名及类型; filebeat.reference.yml:存放filebeat所有配置样例;实际运行不会使用,仅作为配置参考; 2)修改filebeat.yml: # prospector配置,可以配置多个; filebeat.prospectors: # 日志组件类型,此处是普通日志,故使用log - type: log # 启用prospector的开关,设置为true下面配置才生效 enabled: true # 收集日志路径,支持通配符; paths: - /home/work/logs/mylog*.json # 日志、日志文件过滤规则,支持正则表达式,此处不配置; #exclude_lines: ['^DBG'] #include_lines: ['^ERR', '^WARN'] #exclude_files: ['.gz$'] #fields: # level: debug # review: 1 #multiline.pattern: ^\[ #multiline.negate: false #multiline.match: after # 配置组件配置文件加载路径,默认即可; filebeat.config.modules: # Glob pattern for configuration loading path: ${path.config}/modules.d/*.yml # Set to true to enable config reloading reload.enabled: false # Period on which files under path should be checked for changes #reload.period: 10s # 配置filebeat生成index模板时的规则 setup.template.settings: index.number_of_shards: 6 index.refresh_interval: 10s index.number_of_replicas: 1 index.codec: best_compression #_source.enabled: false # 允许自动生成index模板 setup.template.enabled: true # 生成index模板时字段配置文件 setup.template.fields: fields.yml # 生成index模板的名称 setup.template.name: mytemplate-name # 生成index模板匹配的index格式 setup.template.pattern: myindex-name-* # 生成kibana中的index pattern,便于检索日志 setup.dashboards.index: myindex-name-* # 在kibana中生成filebeats的图标模板,此处没有用到,故不启用; setup.dashboards.enabled: false # 设置对接的kibana,主要用于生成dashboard时使用; setup.kibana: host: "ip:port" username: "myuser" password: "mypasswd" # 设置对接的elasticsearch信息 output.elasticsearch: # Array of hosts to connect to. hosts: ["ip1:port1", "ip2:port2",] # 设置上报index名称格式,需要和setup.template.pattern匹配; index: myindex-name-%{+yyyy.MM.dd} # Optional protocol and basic auth credentials. protocol: "http" username: "myuser" password: "mypasswd" # 启用xpack监控 xpack.monitoring.enabled: true # 设置filebeat自身监控数据上报elasticsearch信息,如果未指定,则默认使用output.elasticsearch配置 xpack.monitoring.elasticsearch: username: "myuser" password: "mypasswd" protocol: http 3)修改fields.yml文件,删除不必要的字段;因为我们只用到了log组件以及beat自身的监控组件,因而仅保留key为beat和log的字段配置,其余组件的字段配置均删除; 4)启动filebeat: nohup ./filebeat -e -c filebeat.yml > /dev/null 2>&1 & 注:启动filebeat时,会在elasticsearch中自动生成index模板,如果设置setup.template.enabled: false,则不会自动生成。可以通过如下命令手工生成index模板: ./filebeat setup template 第3步. 在kibana上查看是否有日志上报: 1)查看Monitor菜单,发现新增beat组件监控: 2)查看Monitor菜单的index菜单栏,发现已经创建所需index; 3)在Discover页面检索日志,发现已经有日志上报过来; 使用HeartBeat监控java进程 HeartBeat组件用来监控远程服务器上的服务是否正常运行。heartbeat由一系列的monitor组成,这些monitor能够周期性的检查服务的运行状态,每个monitor都可以独立配置和运行。heartbeat目前支持ICMP/TCP/HTTP协议接口的检测。 1)下载安装包,并解压至部署目录; tar -zxvf heartbeat-6.2.2-linux-x86_64.tar.gz cd heartbeat-6.2.2-linux-x86_64 heartbeat目录结构如下: fields.yml heartbeat heartbeat.reference.yml heartbeat.yml kibana LICENSE.txt NOTICE.txt README.md 和filebeat类似,heartbeat的核心文件如下: heartbeat:运行heartbeat的二进制程序; heartbeat.yml:heartbeat的核心配置文件; fields.yml:heartbeat自动创建index模板时,用于指定模板中的字段配置; heartbeat.reference.yml:存放heartbeat所有配置样例,用作参考; 2)修改heartbeat.yml: # monitor配置,支持多个; heartbeat.monitors: # 监控类型配置,支持icmp/tcp/http等 - type: http # 监控url配置,支持多个; urls: ["http://ip1:port1/addr1", "http://ip2:port2/addr2", "http://ip3:port3/addr3"] # 监控周期配置,支持crontab表达式 schedule: '@every 10s' # 监控模式:any,只要有一个url正常即可;all,所有url均正常才算正常; mode: all # 连接及请求超时时间 #timeout: 16s # index模板配置,同filebeat setup.template.settings: index.number_of_shards: 6 index.refresh_interval: 10s index.number_of_replicas: 1 index.codec: best_compression #_source.enabled: false # 允许自动生成index模板 setup.template.enabled: true setup.template.fields: fields.yml setup.template.name: mytemplate_name setup.template.pattern: myindex-* setup.dashboards.index: myindex-* # 允许自动生成dashboard图表 setup.dashboards.enabled: true # kibana配置,同filebeat setup.kibana: host: "ip:port" username: "myuser" password: "mypasswd" # 数据上报elasticsearch配置,同filebeat output.elasticsearch: # Array of hosts to connect to. hosts: ["ip1:port1", "ip2:port2", "ip3:port3"] index: myindex-%{+yyyy.MM.dd} # Optional protocol and basic auth credentials. protocol: "http" username: "myuser" password: "mypasswd" # heartbeat监控配置,同filebeat xpack.monitoring.enabled: true xpack.monitoring.elasticsearch: protocol: "http" username: "myuser" password: "mypasswd" 通过上面配置可以看出,heartbeat和filebeat配置相似,对接elasticsearch、logstash、配置xpack监控、配置index模板的代码完全相同。 3)启动heartbeat: nohup ./heartbeat -e -c heartbeat.yml > /dev/null 2>&1 & 注:启动heartbeat时,会在elasticsearch中自动生成index模板,如果设置setup.template.enabled: false,则不会自动生成。可以通过如下命令手工生成index模板: ./heartbeat setup --template 同理,如果设置setup.dashboards.enabled: false,则启动heartbeat时不会自动生成dashboard图表。可以通过如下命令手工生成dashboard: ./heartbeat setup --dashboards 4)登录kibana,查看index模板、index pattern、index以及dashboard是否创建成功,是否有心跳监控数据上报; 监控数据dashboard图表展现: heartbeat自身监控: 使用Metricbeat收集指标数据 metricbeat用于收集服务器及服务的监控指标,比如cpu、内存、网络、进程等;metricbeat由一些列module组成,每个module负责收集某一类指标; 1)下载metricbeat,上传服务器并解压; tar -zxvf metricbeat-6.2.2-linux-x86_64.tar.gz cd metricbeat-6.2.2-linux-x86_64 可以看到metricbeat的目录结构如下: fields.yml kibana LICENSE.txt metricbeat metricbeat.reference.yml metricbeat.yml modules.d NOTICE.txt README.md 主要文件功能如下: metricbeat:metricbeat执行的二进制文件; metricbeat.yml:metricbeat的核心配置文件; fields.yml:metricbeat上报日志前,需要先在elasticsearch上建好index模板,从而在日志上报时,elasticsearch能够根据index模板自动创建index;该配置文件用于指定创建index时所需要的字段名及类型; metricbeat.reference.yml:存放metricbeat所有配置样例;实际运行不会使用,仅作为配置参考; 2)修改metricbeat.yml:除了modules外,其余配置包括elasticsearch配置、logstash配置、xpack监控、index模板配置等,与filebeat、heartbeat的配置相同。 metricbeat.modules: - module: system metricsets: - cpu # CPU usage - filesystem # File system usage for each mountpoint - fsstat # File system summary metrics - load # CPU load averages - memory # Memory usage - network # Network IO - process # Per process metrics - process_summary # Process summary - uptime # System Uptime #- core # Per CPU core usage #- diskio # Disk IO #- socket # Sockets and connection info (linux only) enabled: true period: 10s processes: ['.*'] # Configure the metric types that are included by these metricsets. cpu.metrics: ["percentages"] # The other available options are normalized_percentages and ticks. core.metrics: ["percentages"] # The other available option is ticks. 3)启动metricbeat: nohup ./metricbeat -e -c metricbeat.yml > /dev/null 2>&1 & 使用Packetbeat收集网络数据 packetbeat是轻量级的网络包分析工具,用于收集网络包数据; 1)下载packetbeat,上传服务器并解压; tar -zxvf packetbeat-6.2.2-linux-x86_64.tar.gz cd packetbeat-6.2.2-linux-x86_64 可以看到packetbeat的目录结构同其它beat组件目录结构相似: fields.yml kibana LICENSE.txt NOTICE.txt packetbeat packetbeat.reference.yml packetbeat.yml README.md 主要文件功能如下: packetbeat:packetbeat执行的二进制文件; packetbeat.yml:packetbeat的核心配置文件; fields.yml:packetbeat上报日志前,需要先在elasticsearch上建好index模板,从而在日志上报时,elasticsearch能够根据index模板自动创建index;该配置文件用于指定创建index时所需要的字段名及类型; packetbeat.reference.yml:存放packetbeat所有配置样例;实际运行不会使用,仅作为配置参考; 2)修改packetbeat.yml:除了网络协议相关配置外,其余配置包括elasticsearch配置、logstash配置、xpack监控、index模板配置等,与filebeat、heartbeat的配置相同。 # 网卡选择策略,any表示任意一个; packetbeat.interfaces.device: any # Set `enabled: false` or comment out all options to disable flows reporting. packetbeat.flows: # Set network flow timeout. Flow is killed if no packet is received before being # timed out. timeout: 30s # Configure reporting period. If set to -1, only killed flows will be reported period: 10s # 设置监听的协议类型及端口信息,根据实际需要配置; packetbeat.protocols: - type: http # Configure the ports where to listen for HTTP traffic. You can disable # the HTTP protocol by commenting out the list of ports. ports: [8088] 3)启动packetbeat: nohup ./packetbeat -e -c packetbeat.yml > /dev/null 2>&1 & 注:packetbeat需要GLIBC >= 2.7,否则运行报错如下: ./packetbeat: /lib64/tls/libc.so.6: version `GLIBC_2.7' not found (required by ./packetbeat) 参考 beats官方文档Getting Started With Filebeatslf4j-logback 日志以json格式导入ELKGetting Started With HeartbeatGetting started with MetricbeatGetting started with Packetbeat

优秀的个人博客,低调大师

Python 学习(八)--网络操作

Python 提供了两个级别访问的网络服务: 低级别的网络服务支持基本的 Socket,它提供了标准的 BSD Sockets API,可以访问底层操作系统Socket接口的全部方法。 高级别的网络服务模块 SocketServer, 它提供了服务器中心类,可以简化网络服务器的开发。 1. Socket Socket又称"套接字",应用程序通常通过"套接字"向网络发出请求或者应答网络请求,使主机间或者一台计算机上的进程间可以通讯。 socket()函数 Python 中,我们用 socket()函数来创建套接字,语法格式如下: socket.socket([family[, type[, proto]]]) 参数 family: 套接字家族可以使AF_UNIX或者AF_INET type: 套接字类型可以根据是面向连接的还是非连接分为SOCK_STREAM或SOCK_DGRAM protocol: 一般不填默认为0. Socket 对象(内建)方法 服务器端套接字 1). s.bind() : 绑定地址(host,port)到套接字, 在AF_INET下,以元组(host,port)的形式表示地址。 2). s.listen() : 开始TCP监听。backlog指定在拒绝连接之前,操作系统可以挂起的最大连接数量。该值至少为1,大部分应用程序设为5就可以了。 3). s.accept() : 被动接受TCP客户端连接,(阻塞式)等待连接的到来 客户端套接字 1). s.connect() : 主动初始化TCP服务器连接,。一般address的格式为元组(hostname,port),如果连接出错,返回socket.error错误。 2). s.connect_ex() : connect()函数的扩展版本,出错时返回出错码,而不是抛出异常 公共用途的套接字函数 1). s.recv() : 接收TCP数据,数据以字符串形式返回,bufsize指定要接收的最大数据量。flag提供有关消息的其他信息,通常可以忽略。 2). s.send() : 发送TCP数据,将string中的数据发送到连接的套接字。返回值是要发送的字节数量,该数量可能小于string的字节大小。 3). s.sendall() : 完整发送TCP数据,完整发送TCP数据。将string中的数据发送到连接的套接字,但在返回之前会尝试发送所有数据。成功返回None,失败则抛出异常。 4). s.recvfrom() : 接收UDP数据,与recv()类似,但返回值是(data,address)。其中data是包含接收数据的字符串,address是发送数据的套接字地址。 5). s.sendto() : 发送UDP数据,将数据发送到套接字,address是形式为(ipaddr,port)的元组,指定远程地址。返回值是发送的字节数。 6). s.close() : 关闭套接字 7). s.getpeername() : 返回连接套接字的远程地址。返回值通常是元组(ipaddr,port)。 8). s.getsockname() : 返回套接字自己的地址。通常是一个元组(ipaddr,port) 9). s.setsockopt(level,optname,value) : 设置给定套接字选项的值。 10). s.getsockopt(level,optname[.buflen]) : 返回套接字选项的值。 11). s.settimeout(timeout) : 设置套接字操作的超时期,timeout是一个浮点数,单位是秒。值为None表示没有超时期。一般,超时期应该在刚创建套接字时设置,因为它们可能用于连接的操作(如connect()) 12). s.gettimeout() : 返回当前超时期的值,单位是秒,如果没有设置超时期,则返回None。 13). s.fileno() : 返回套接字的文件描述符。 14). s.setblocking(flag) : 如果flag为0,则将套接字设为非阻塞模式,否则将套接字设为阻塞模式(默认值)。非阻塞模式下,如果调用recv()没有发现任何数据,或send()调用无法立即发送数据,那么将引起socket.error异常。 15). s.makefile() : 创建一个与该套接字相关连的文件 2. Socket示例 1). 服务端 我们使用 socket 模块的 socket 函数来创建一个 socket 对象。socket 对象可以通过调用其他函数来设置一个 socket 服务。现在我们可以通过调用 bind(hostname, port) 函数来指定服务的 port(端口)。接着,我们调用 socket 对象的 accept 方法。该方法等待客户端的连接,并返回 connection 对象,表示已连接到客户端。 # 文件名:server.py # 导入 socket、sys模块 import socket import sys # 创建socket对象 serversocket = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 获取本地主机名 host = socket.gethostname() # 设置端口 port = 9999 # 绑定端口号 serversocket.bind((host, port)) # 设置最大连接数, 超过后排队 serversocket.listen(5) while True: # 建立客户端连接 clientsocket, addr = serversocket.accept() print("连接地址:%s" % str(addr)) msg = "欢迎访问小雨工作室" + "\r\n" clientsocket.send(msg.encode("utf-8")) clientsocket.close() pass 2). 客户端 接下来我们写一个简单的客户端实例连接到以上创建的服务。端口号为 9999。 socket.connect(hosname, port ) 方法打开一个 TCP 连接到主机为 hostname 端口为 port 的服务商。连接后我们就可以从服务端后期数据,记住,操作完成后需要关闭连接。 # 文件名:client.py # 导入 socket、sys模块 import socket import sys # 创建socket对象 s = socket.socket(socket.AF_INET, socket.SOCK_STREAM) # 获取本地主机名 host = socket.gethostname() # 设置端口号 port = 9999 # 连接服务,指定主机和端口 s.connect((host, port)) # 接收小于1024字节的数据 msg = s.recv(1024) # 关闭客户端 s.close() print(msg.decode("utf-8")) 3). 运行结果: 打开两个命令提示符窗口,一个运行服务器,一个运行客户端。 图1.png 3. Python Internet 模块 图2.png 4. SMTP发送邮件 SMTP(Simple Mail Transfer Protocol)即简单邮件传输协议,它是一组用于由源地址到目的地址传送邮件的规则,由它来控制信件的中转方式。python的smtplib提供了一种很方便的途径发送电子邮件。它对smtp协议进行了简单的封装。 1). Python创建 SMTP 对象语法如下: import smtplib smtpObj = smtplib.SMTP( [host [, port [, local_hostname]]] ) 参数说明: host: SMTP 服务器主机。 你可以指定主机的ip地址或者域名如:runoob.com,这个是可选参数。 port: 如果你提供了 host 参数, 你需要指定 SMTP 服务使用的端口号,一般情况下SMTP端口号为25。 local_hostname: 如果SMTP在你的本机上,你只需要指定服务器地址为 localhost 即可。 2). Python SMTP对象使用sendmail方法发送邮件,语法如下: SMTP.sendmail(from_addr, to_addrs, msg[, mail_options, rcpt_options] 参数说明: from_addr: 邮件发送者地址。 to_addrs: 字符串列表,邮件发送地址。 msg: 发送消息(msg是字符串,表示邮件。我们知道邮件一般由标题,发信人,收件人,邮件内容,附件等构成,发送邮件的时候,要注意msg的格式。这个格式就是smtp协议中定义的格式)。 3). 标准邮件需要三个头部信息: From, To, 和 Subject ,每个信息直接使用空行分割。 我们通过实例化 smtplib 模块的 SMTP 对象 smtpObj 来连接到 SMTP 访问,并使用 sendmail 方法来发送信息本机安装sendmail示例程序: # 导入邮件模块 import smtplib from email.mime.text import MIMEText from email.header import Header # 发送者邮箱 sender= "945541086@qq.com" # 接收者邮箱 receivers = ["zaitingma@foxmail.com"] # 三个参数:第一个是文本内容,第二个是文本格式,第三个是字符编码 message = MIMEText("Python 邮件发送测试", "plain", "utf-8") message["From"] = Header("小雨工作室", "utf-8") message["To"] = Header("测试", "utf-8") # 设置主题 subject = "Python SMTP 邮件测试" message["Subject"] = Header(subject, "utf-8") try: smtpObj = smtplib.SMTP("localhost") smtpObj.sendmail(sender, receivers, message.as_toString()) print("邮件发送成功") pass except Exception as e: print("Error: 无法发送邮件") raise e 本机未安装sendmail示例程序: import smtplib from email.mime.text import MIMEText from email.header import Header # 第三方SMTP服务 # 设置服务器 mail_host="smtp.qq.com" # 设置用户名 mail_user="945541086@qq.com" # 设置口令 mail_pass="***********" # 设置发送者 sender = "945541086@qq.com" # 设置接收者 receivers = ["zaitingma@foxmail.com"] message = MIMEText("Python 邮件发送测试","plain","utf-8") message["From"] = Header("菜鸟教程","utf-8") message["To"] = Header("测试", "utf-8") # 设置主题 subject = "Python SMTP 邮件测试" message["Subject"] = Header(subject, "utf-8") try: smtpObj = smtplib.SMTP() # 25 为 SMTP 端口号 smtpObj.connect(mail_host, 25) smtpObj.login(mail_user, mail_pass) smtpObj.sendmail(sender, receivers, message.as_toString()) print("邮件发送成功") pass except Exception as e: print("Error: 无法发送邮件") raise e 发送带网页的邮件: Python发送HTML格式的邮件与发送纯文本消息的邮件不同之处就是将MIMEText中_subtype设置为html。 import smtplib from email.mime.text import MIMEText from email.header import Header sender = 'from@runoob.com' receivers = ['429240967@qq.com'] # 接收邮件,可设置为你的QQ邮箱或者其他邮箱 mail_msg = """ <p>Python 邮件发送测试...</p> <p><a href="http://www.runoob.com">这是一个链接</a></p> """ message = MIMEText(mail_msg, 'html', 'utf-8') message['From'] = Header("菜鸟教程", 'utf-8') message['To'] = Header("测试", 'utf-8') subject = 'Python SMTP 邮件测试' message['Subject'] = Header(subject, 'utf-8') try: smtpObj = smtplib.SMTP('localhost') smtpObj.sendmail(sender, receivers, message.as_string()) print ("邮件发送成功") except smtplib.SMTPException: print ("Error: 无法发送邮件") 发送带附件的邮件: 发送带附件的邮件,首先要创建MIMEMultipart()实例,然后构造附件,如果有多个附件,可依次构造,最后利用smtplib.smtp发送。 import smtplib from email.mime.text import MIMEText from email.mime.multipart import MIMEMultipart from email.header import Header sender = 'from@runoob.com' receivers = ['429240967@qq.com'] # 接收邮件,可设置为你的QQ邮箱或者其他邮箱 #创建一个带附件的实例 message = MIMEMultipart() message['From'] = Header("菜鸟教程", 'utf-8') message['To'] = Header("测试", 'utf-8') subject = 'Python SMTP 邮件测试' message['Subject'] = Header(subject, 'utf-8') #邮件正文内容 message.attach(MIMEText('这是菜鸟教程Python 邮件发送测试……', 'plain', 'utf-8')) # 构造附件1,传送当前目录下的 test.txt 文件 att1 = MIMEText(open('test.txt', 'rb').read(), 'base64', 'utf-8') att1["Content-Type"] = 'application/octet-stream' # 这里的filename可以任意写,写什么名字,邮件中显示什么名字 att1["Content-Disposition"] = 'attachment; filename="test.txt"' message.attach(att1) # 构造附件2,传送当前目录下的 runoob.txt 文件 att2 = MIMEText(open('runoob.txt', 'rb').read(), 'base64', 'utf-8') att2["Content-Type"] = 'application/octet-stream' att2["Content-Disposition"] = 'attachment; filename="runoob.txt"' message.attach(att2) try: smtpObj = smtplib.SMTP('localhost') smtpObj.sendmail(sender, receivers, message.as_string()) print ("邮件发送成功") except smtplib.SMTPException: print ("Error: 无法发送邮件") 在 HTML 文本中添加图片: 邮件的 HTML 文本中一般邮件服务商添加外链是无效的,正确添加突破的实例如下: import smtplib from email.mime.image import MIMEImage from email.mime.multipart import MIMEMultipart from email.mime.text import MIMEText from email.header import Header sender = 'from@runoob.com' receivers = ['429240967@qq.com'] # 接收邮件,可设置为你的QQ邮箱或者其他邮箱 msgRoot = MIMEMultipart('related') msgRoot['From'] = Header("菜鸟教程", 'utf-8') msgRoot['To'] = Header("测试", 'utf-8') subject = 'Python SMTP 邮件测试' msgRoot['Subject'] = Header(subject, 'utf-8') msgAlternative = MIMEMultipart('alternative') msgRoot.attach(msgAlternative) mail_msg = """ <p>Python 邮件发送测试...</p> <p><a href="http://www.runoob.com">菜鸟教程链接</a></p> <p>图片演示:</p> <p><img src="cid:image1"></p> """ msgAlternative.attach(MIMEText(mail_msg, 'html', 'utf-8')) # 指定图片为当前目录 fp = open('test.png', 'rb') msgImage = MIMEImage(fp.read()) fp.close() # 定义图片 ID,在 HTML 文本中引用 msgImage.add_header('Content-ID', '<image1>') msgRoot.attach(msgImage) try: smtpObj = smtplib.SMTP('localhost') smtpObj.sendmail(sender, receivers, msgRoot.as_string()) print ("邮件发送成功") except smtplib.SMTPException: print ("Error: 无法发送邮件") QQ邮箱 QQ 邮箱 SMTP 服务器地址:smtp.qq.com,ssl 端口:465 import smtplib from email.mime.text import MIMEText from email.utils import formataddr my_sender='945541086@qq.com' # 发件人邮箱账号 my_pass = '**************' # 发件人邮箱授权码 my_user='1425941077@qq.com' # 收件人邮箱账号,我这边发送给自己 def mail(): ret=True try: msg=MIMEText('Python 测试邮件发送','plain','utf-8') msg['From']=formataddr(["Mazaiting",my_sender]) # 括号里的对应发件人邮箱昵称、发件人邮箱账号 msg['To']=formataddr(["FK",my_user]) # 括号里的对应收件人邮箱昵称、收件人邮箱账号 msg['Subject']="Python邮件测试" # 邮件的主题,也可以说是标题 server=smtplib.SMTP_SSL("smtp.qq.com", 465) # 发件人邮箱中的SMTP服务器,端口是25 server.login(my_sender, my_pass) # 括号中对应的是发件人邮箱账号、邮箱密码 server.sendmail(my_sender,[my_user,],msg.as_string()) # 括号中对应的是发件人邮箱账号、收件人邮箱账号、发送邮件 server.quit() # 关闭连接 except Exception as e: # 如果 try 中的语句没有执行,则会执行下面的 ret=False ret=False raise e return ret ret=mail() if ret: print("邮件发送成功") else : print("邮件发送失败") 图2.png

优秀的个人博客,低调大师

Python 学习(九)--多线程

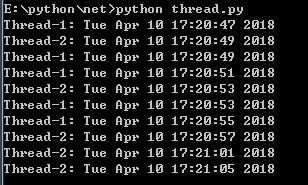
1. 多线程 1). 多线程类似于同时执行多个不同程序,多线程运行有如下优点: 使用线程可以把占据长时间的程序中的任务放到后台去处理。 用户界面可以更加吸引人,这样比如用户点击了一个按钮去触发某些事件的处理,可以弹出一个进度条来显示处理的进度 程序的运行速度可能加快 在一些等待的任务实现上如用户输入、文件读写和网络收发数据等,线程就比较有用了。在这种情况下我们可以释放一些珍贵的资源如内存占用等等。 2). 线程在执行过程中与进程还是有区别的。每个独立的线程有一个程序运行的入口、顺序执行序列和程序的出口。但是线程不能够独立执行,必须依存在应用程序中,由应用程序提供多个线程执行控制。 每个线程都有他自己的一组CPU寄存器,称为线程的上下文,该上下文反映了线程上次运行该线程的CPU寄存器的状态。 指令指针和堆栈指针寄存器是线程上下文中两个最重要的寄存器,线程总是在进程得到上下文中运行的,这些地址都用于标志拥有线程的进程地址空间中的内存。 线程可以被抢占(中断)。 在其他线程正在运行时,线程可以暂时搁置(也称为睡眠) -- 这就是线程的退让。 3). 线程可以分为: 内核线程:由操作系统内核创建和撤销。 用户线程:不需要内核支持而在用户程序中实现的线程。 4). Python3 线程中常用的两个模块为: _thread threading(推荐使用) thread 模块已被废弃。用户可以使用 threading 模块代替。所以,在 Python3 中不能再使用"thread" 模块。为了兼容性,Python3 将 thread 重命名为 "_thread"。 2. 创建新线程 Python中使用线程有两种方式:函数或者用类来包装线程对象。 函数式:调用 _thread 模块中的start_new_thread()函数来产生新线程。语法如下: _thread.start_new_thread ( function, args[, kwargs] ) 参数说明: function - 线程函数。 args - 传递给线程函数的参数,他必须是个tuple类型。 kwargs - 可选参数。 import _thread import time # 为线程定义一个函数 def print_time(threadName, delay): count = 0 while count < 5: time.sleep(delay) count += 1 print("%s: %s" % (threadName, time.ctime(time.time()))) pass pass # 创建两个线程 try: _thread.start_new_thread(print_time, ("Thread-1",2)) _thread.start_new_thread(print_time, ("Thread-2",4)) pass except Exception as e: print("Error: 无法启动线程") raise e while 1: pass 打印结果: 图1.png 3. 线程模块 Python3 通过两个标准库 _thread 和 threading 提供对线程的支持。 _thread 提供了低级别的、原始的线程以及一个简单的锁,它相比于 threading 模块的功能还是比较有限的。 threading 模块除了包含 _thread 模块中的所有方法外,还提供的其他方法: threading.currentThread(): 返回当前的线程变量。 threading.enumerate(): 返回一个包含正在运行的线程的list。正在运行指线程启动后、结束前,不包括启动前和终止后的线程。 threading.activeCount(): 返回正在运行的线程数量,与len(threading.enumerate())有相同的结果。 除了使用方法外,线程模块同样提供了Thread类来处理线程,Thread类提供了以下方法: run(): 用以表示线程活动的方法。 start():启动线程活动。 join([time]): 等待至线程中止。这阻塞调用线程直至线程的join() 方法被调用中止-正常退出或者抛出未处理的异常-或者是可选的超时发生。 isAlive(): 返回线程是否活动的。 getName(): 返回线程名。 setName(): 设置线程名。 4. 使用 threading 模块创建线程 从 threading.Thread 继承创建一个新的子类,并实例化后调用 start() 方法启动新线程,即它调用了线程的 run() 方法: import threading import time exitFlag = 0 class myThread(threading.Thread): """docstring for myThread""" def __init__(self, threadID,name,counter): super(myThread, self).__init__() self.threadID = threadID self.name = name self.counter = counter def run(self): print("开始线程: " + self.name) print_time(self.name, self.counter, 5) print("退出线程: " + self.name) pass def print_time(threadName, delay, counter): while counter: if exitFlag: threadName.exit() pass time.sleep(delay) print("%s: %s" % (threadName, time.ctime(time.time()))) counter -= 1 pass pass # 创建新线程 thread1 = myThread(1, "Thread-1", 1) thread2 = myThread(2, "Thread-2", 2) # 开启新线程 thread1.start() thread2.start() thread1.join() thread2.join() print("退出主线程") 打印结果: 图2.png 5. 线程同步 如果多个线程共同对某个数据修改,则可能出现不可预料的结果,为了保证数据的正确性,需要对多个线程进行同步。 使用 Thread 对象的 Lock 和 Rlock 可以实现简单的线程同步,这两个对象都有 acquire 方法和 release 方法,对于那些需要每次只允许一个线程操作的数据,可以将其操作放到 acquire 和 release 方法之间。如下: 多线程的优势在于可以同时运行多个任务(至少感觉起来是这样)。但是当线程需要共享数据时,可能存在数据不同步的问题。 考虑这样一种情况:一个列表里所有元素都是0,线程"set"从后向前把所有元素改成1,而线程"print"负责从前往后读取列表并打印。 那么,可能线程"set"开始改的时候,线程"print"便来打印列表了,输出就成了一半0一半1,这就是数据的不同步。为了避免这种情况,引入了锁的概念。 锁有两种状态——锁定和未锁定。每当一个线程比如"set"要访问共享数据时,必须先获得锁定;如果已经有别的线程比如"print"获得锁定了,那么就让线程"set"暂停,也就是同步阻塞;等到线程"print"访问完毕,释放锁以后,再让线程"set"继续。经过这样的处理,打印列表时要么全部输出0,要么全部输出1,不会再出现一半0一半1的尴尬场面。 import threading import time class myThread(threading.Thread): """docstring for myThread""" def __init__(self, threadID, name, counter): super(myThread, self).__init__() self.threadID = threadID self.name = name self.counter = counter def run(self): print("开启线程:" + self.name) # 获取锁,用于线程同步 threadLock.acquire() print_time(self.name, self.counter, 3) # 释放锁,开启下一个线程 threadLock.release() pass def print_time(threadName, delay, counter): while counter: time.sleep(delay) print("%s: %s" % (threadName, time.ctime(time.time()))) counter -= 1 pass pass threadLock = threading.Lock() threads = [] # 创建新线程 thread1 = myThread(1, "Thread-1", 1) thread2 = myThread(2, "Thread-2", 2) # 开启新线程 thread1.start() thread2.start() # 添加线程到线程列表 threads.append(thread1) threads.append(thread2) # 等待所有线程完成 for t in threads: t.join() pass print("退出线程") 打印结果: 图3.png 6. 线程优先级队列( Queue) Python 的 Queue 模块中提供了同步的、线程安全的队列类,包括FIFO(先入先出)队列Queue,LIFO(后入先出)队列LifoQueue,和优先级队列 PriorityQueue。 这些队列都实现了锁原语,能够在多线程中直接使用,可以使用队列来实现线程间的同步。Queue 模块中的常用方法: Queue.qsize() 返回队列的大小 Queue.empty() 如果队列为空,返回True,反之False Queue.full() 如果队列满了,返回True,反之False Queue.full 与 maxsize 大小对应 Queue.get([block[, timeout]])获取队列,timeout等待时间 Queue.get_nowait() 相当Queue.get(False) Queue.put(item) 写入队列,timeout等待时间 Queue.put_nowait(item) 相当Queue.put(item, False) Queue.task_done() 在完成一项工作之后,Queue.task_done()函数向任务已经完成的队列发送一个信号 Queue.join() 实际上意味着等到队列为空,再执行别的操作 import queue import threading import time exitFlag = 0 class myThread(threading.Thread): """docstring for myThread""" def __init__(self, threadID, name, q): super(myThread, self).__init__() self.threadID = threadID self.name = name self.q = q def run(self): print("开启线程:" + self.name) process_data(self.name, self.q) print("退出线程:" + self.name) pass def process_data(threadName, q): while not exitFlag: queueLock.acquire() if not workQueue.empty(): data = q.get() queueLock.release() print("%s processing %s" % (threadName, data)) pass else: queueLock.release() pass time.sleep(1) pass threadList = ["Thread-1", "Thread-2", "Thread-3"] nameList = ["One", "Two", "Three", "Four", "Five"] queueLock = threading.Lock() workQueue = queue.Queue(10) threads = [] threadID = 1 # 创建新线程 for tName in threadList: thread = myThread(threadID, tName, workQueue) thread.start() threads.append(thread) threadID += 1 pass # 填充队列 queueLock.acquire() for word in nameList: workQueue.put(word) pass queueLock.release() # 等待队列清空 while not workQueue.empty(): pass # 通知线程退出 exitFlag = 1 # 等待所有线程完成 for t in threads: t.join() pass print("退出主线程") 打印结果: 图4.png

优秀的个人博客,低调大师

SpringBoot+Mybatis+MySql学习

介绍一下SpringBoot整合mybatis,数据库选用的是mysql。 首先创建数据库 CREATE DATABASE test; 建表以及插入初始数据(sql是从navicat中导出的) SET NAMES utf8mb4; SET FOREIGN_KEY_CHECKS = 0; -- ---------------------------- -- Table structure for user -- ---------------------------- DROP TABLE IF EXISTS `user`; CREATE TABLE `user` ( `id` int(11) NOT NULL AUTO_INCREMENT, `user_name` varchar(255) NOT NULL, `user_password` varchar(255) DEFAULT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=13 DEFAULT CHARSET=latin1; -- ---------------------------- -- Records of user -- ---------------------------- BEGIN; INSERT INTO `user` VALUES (1, 'dalaoyang', '13'); INSERT INTO `user` VALUES (2, 'xiaoli', '123'); INSERT INTO `user` VALUES (3, 'xiaoxiongmao', '123'); COMMIT; SET FOREIGN_KEY_CHECKS = 1; 下图为项目目录结构, java--- controller包负责测试整合 dao包作为数据操作层 entity作为数据实体类 resources--- mapper写dao层对应实现的sql mybatis里面是mybatis配置,包含typeAlias等等 sql里面放的是上面写的建表数据及sql image 接下来直接上代码,启动类没有修改,代码如下 package com.dalaoyang; import org.mybatis.spring.annotation.MapperScan; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.EnableAutoConfiguration; import org.springframework.boot.autoconfigure.SpringBootApplication; import org.springframework.boot.autoconfigure.jdbc.DataSourceAutoConfiguration; @SpringBootApplication public class SpringbootMybatisApplication { public static void main(String[] args) { SpringApplication.run(SpringbootMybatisApplication.class, args); } } application.properties包含了数据库配置,mybatis配置,代码如下: ##端口号 server.port=8888 ##检查 mybatis 配置是否存在,一般命名为 mybatis-config.xml mybatis.check-config-location =true ##配置文件位置 mybatis.config-location=classpath:mybatis/mybatis-config.xml ## mapper xml 文件地址 mybatis.mapper-locations=classpath*:mapper/*Mapper.xml ##日志级别 logging.level.com.yang.dao=debug ##数据库url spring.datasource.url=jdbc:mysql://localhost:3306/test?characterEncoding=utf8&useSSL=false ##数据库用户名 spring.datasource.username=root ##数据库密码 spring.datasource.password=root ##数据库驱动 spring.datasource.driver-class-name=com.mysql.jdbc.Driver 实体类User package com.dalaoyang.entity; import org.apache.ibatis.type.Alias; /** * @author dalaoyang * @Description * @project springboot_learn * @package com.dalaoyang.entity * @email 397600342@qq.com * @date 2018/4/5 */ @Alias("user") public class User { private int id; private String user_name; private String user_password; public User(String user_name, String user_password) { this.user_name = user_name; this.user_password = user_password; } public User(int id, String user_name, String user_password) { this.id = id; this.user_name = user_name; this.user_password = user_password; } public int getId() { return id; } public void setId(int id) { this.id = id; } public String getUser_name() { return user_name; } public void setUser_name(String user_name) { this.user_name = user_name; } public String getUser_password() { return user_password; } public void setUser_password(String user_password) { this.user_password = user_password; } } dao层代码 package com.dalaoyang.dao; import com.dalaoyang.entity.User; import org.apache.ibatis.annotations.Mapper; import java.util.List; /** * @author dalaoyang * @Description * @project springboot_learn * @package com.dalaoyang.dao * @email 397600342@qq.com * @date 2018/4/5 */ @Mapper public interface UserMapper { User findUserByUsername(String username); void updateUserByUsername(User user); void deleteUserByUsername(String username); void saveUser(User user); List<User> getUserList(); } UserMapper.xml代码 <?xml version="1.0" encoding="UTF-8" ?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd" > <mapper namespace="com.dalaoyang.dao.UserMapper"> <resultMap id="user" type="com.dalaoyang.entity.User"/> <parameterMap id="user" type="com.dalaoyang.entity.User"/> <select id="findUserByUsername" parameterType="String" resultMap="user"> SELECT * FROM user WHERE user_name=#{1} </select> <update id="updateUserByUsername" parameterMap="user"> UPDATE USER SET USER_PASSWORD=#{user_password} WHERE USER_NAME=#{user_name} </update> <delete id="deleteUserByUsername" parameterType="String"> DELETE FROM USER WHERE USER_NAME=#{1} </delete> <!-- 使用alias自定义的parameterType--> <insert id="saveUser" parameterType="user"> INSERT INTO USER (user_password,user_name) VALUES (#{user_password},#{user_name}) </insert> <select id="getUserList" resultMap="user"> SELECT * FROM USER </select> </mapper> mybatis-config.xml <?xml version="1.0" encoding="UTF-8"?> <!DOCTYPE configuration PUBLIC "-//mybatis.org//DTD SQL Map Config 3.0//EN" "http://mybatis.org/dtd/mybatis-3-config.dtd"> <configuration> <typeAliases> <typeAlias alias="Integer" type="java.lang.Integer" /> <typeAlias alias="Long" type="java.lang.Long" /> <typeAlias alias="HashMap" type="java.util.HashMap" /> <typeAlias alias="LinkedHashMap" type="java.util.LinkedHashMap" /> <typeAlias alias="ArrayList" type="java.util.ArrayList" /> <typeAlias alias="LinkedList" type="java.util.LinkedList" /> <typeAlias alias="user" type="com.dalaoyang.entity.User"/> </typeAliases> </configuration> pom文件 <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.dalaoyang</groupId> <artifactId>springboot_mybatis</artifactId> <version>0.0.1-SNAPSHOT</version> <packaging>jar</packaging> <name>springboot_mybatis</name> <description>springboot_mybatis</description> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>1.5.9.RELEASE</version> <relativePath/> <!-- lookup parent from repository --> </parent> <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding> <java.version>1.8</java.version> </properties> <dependencies> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <dependency> <groupId>org.mybatis.spring.boot</groupId> <artifactId>mybatis-spring-boot-starter</artifactId> <version>1.3.1</version> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-devtools</artifactId> <scope>runtime</scope> </dependency> <dependency> <groupId>mysql</groupId> <artifactId>mysql-connector-java</artifactId> <scope>runtime</scope> </dependency> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> </dependencies> <build> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> </plugins> </build> </project> UserController package com.dalaoyang.controller; import com.dalaoyang.dao.UserMapper; import com.dalaoyang.entity.User; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.web.bind.annotation.RequestMapping; import org.springframework.web.bind.annotation.RestController; import java.util.List; /** * @author dalaoyang * @Description * @project springboot_learn * @package com.dalaoyang.controller * @email 397600342@qq.com * @date 2018/4/5 */ @RestController public class UserController { @Autowired UserMapper userMapper; //http://localhost:8888/getUser?username=xiaoli2 @RequestMapping("/getUser") public String getUser(String username){ User user =userMapper.findUserByUsername(username); return user!=null ? username+"的密码是:"+user.getUser_password():"不存在用户名为"+username+"的用户"; } //http://localhost:8888/updateUser?username=xiaoli2&password=123 @RequestMapping("/updateUser") public String updateUser(String password,String username){ User user = new User(username,password); userMapper.updateUserByUsername(user); return "success!"; } //http://localhost:8888/addUser?username=xiaoli2&password=123 @RequestMapping("/addUser") public String addUser(String username,String password){ User user = new User(username,password); userMapper.saveUser(user); return "success!"; } //http://localhost:8888/addUser?username=xiaoli2 @RequestMapping("/deleteUser") public String deleteUser(String username){ userMapper.deleteUserByUsername(username); return "success!"; } //http://localhost:8888/getUserList @RequestMapping("/getUserList") public List getUserList(String username, String password){ return userMapper.getUserList(); } } 启动项目,访问controller上面对应的注释上的地址即可以测试, 其中包含了简单的增删改查,SpringBoot整合Mybatis就这样完成了。 源码下载 :大老杨码云 个人网站:https://dalaoyang.cn

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册