Python3网络爬虫——(2)设置User Agent模拟浏览器访问
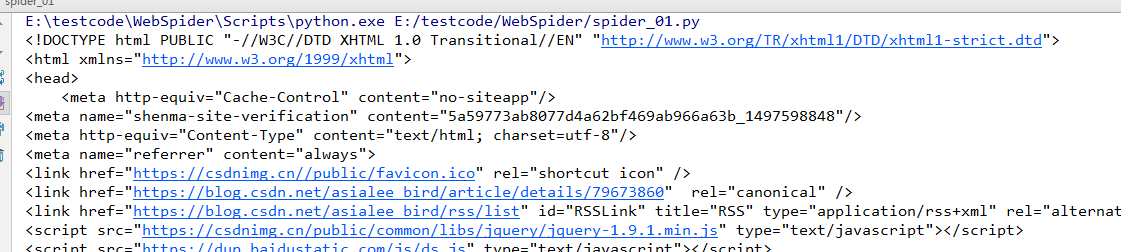
设置User Agent模拟浏览器访问 方法一、使用build_opener()修改报头 # -*- coding: UTF-8 -*- #使用build_opener()修改报头 from urllib import request if __name__ == "__main__": url="https://blog.csdn.net/asialee_bird/article/details/79673860" headers=("User-Agent","Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/64.0.3282.168 Safari/537.36") opener=request.build_opener() opener.addheaders=[headers] file=opener.open(url) data=file.read() print(data) 方法二、使用add_header修改报头 # -*- coding: UTF-8 -*- #使用add_header修改报头 from urllib import request if __name__ == "__main__": url="https://blog.csdn.net/asialee_bird/article/details/79673860" req=request.Request(url) #创建一个Request对象 req.add_header("User-Agent","Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/64.0.3282.168 Safari/537.36") file=request.urlopen(req) data=file.read() data=data.decode('utf-8') #对读取的信息进行解码 print(data) 结果: 方法三、 # -*- coding: UTF-8 -*- from urllib import request if __name__ == "__main__": #以CSDN为例,CSDN不更改User Agent是无法访问的 url = 'http://www.csdn.net/' head = {} #写入User Agent信息 head['User-Agent'] = 'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/64.0.3282.168 Safari/537.36' req = request.Request(url, headers=head) #创建Request对象 response = request.urlopen(req) #传入创建好的Request对象 html = response.read().decode('utf-8') #读取响应信息并解码 print(html) #打印信息 注: 常见的User Agent 1.Android Mozilla/5.0 (Linux; Android 4.1.1; Nexus 7 Build/JRO03D) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.166 Safari/535.19 Mozilla/5.0 (Linux; U; Android 4.0.4; en-gb; GT-I9300 Build/IMM76D) AppleWebKit/534.30 (KHTML, like Gecko) Version/4.0 Mobile Safari/534.30 Mozilla/5.0 (Linux; U; Android 2.2; en-gb; GT-P1000 Build/FROYO) AppleWebKit/533.1 (KHTML, like Gecko) Version/4.0 Mobile Safari/533.1 2.Firefox Mozilla/5.0 (Windows NT 6.2; WOW64; rv:21.0) Gecko/20100101 Firefox/21.0 Mozilla/5.0 (Android; Mobile; rv:14.0) Gecko/14.0 Firefox/14.0 3.Google Chrome Mozilla/5.0 (Windows NT 6.2; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/27.0.1453.94 Safari/537.36 Mozilla/5.0 (Linux; Android 4.0.4; Galaxy Nexus Build/IMM76B) AppleWebKit/535.19 (KHTML, like Gecko) Chrome/18.0.1025.133 Mobile Safari/535.19 4.iOS Mozilla/5.0 (iPad; CPU OS 5_0 like Mac OS X) AppleWebKit/534.46 (KHTML, like Gecko) Version/5.1 Mobile/9A334 Safari/7534.48.3 Mozilla/5.0 (iPod; U; CPU like Mac OS X; en) AppleWebKit/420.1 (KHTML, like Gecko) Version/3.0 Mobile/3A101a Safari/419.3 上面列举了Andriod、Firefox、Google Chrome、iOS的一些User Agent,直接copy就能用