首页 文章 精选 留言 我的

精选列表

搜索[爬虫框架],共10000篇文章
优秀的个人博客,低调大师

抖音爬虫教程,AndServer+Service 打造 Android 服务器实现 so 文件调用

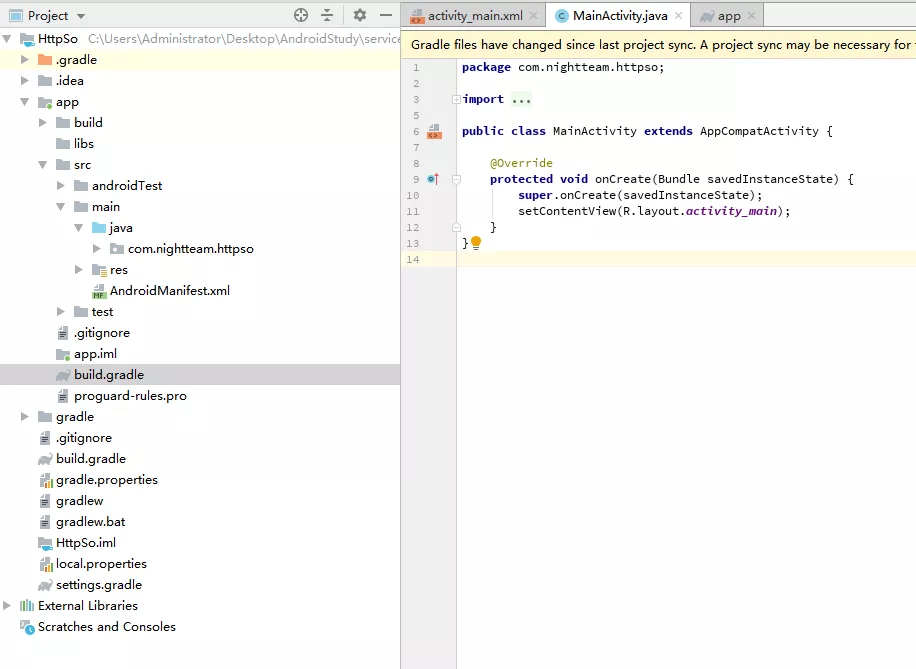
随着 Android 移动安全的高速发展,不管是为了执行效率还是程序的安全性等,关键代码下沉 native 层已成为基本操作。 native 层的开发就是通指的 JNI/NDK 开发,通过 JNI 可以实现 java 层和 native 层(主要是 C/C++ )的相互调用,native 层经编译后产生 so 动态链接库,so 文件具有可移植性广,执行效率高,保密性强等优点。 那么问题来了,如何调用 so 文件显得异常重要,当然你也可以直接分析 so 文件的伪代码,利用强悍的编程功底直接模拟关键操作,但是我想对于普通人来说头发还是比较重要的。 当前调用 so 文件的主流操作应该是: 1,基于 Unicorn 的各种实现(还在学习中,暂且不表) 2,Android 服务器的搭建,在 App 内起 http 服务完成调用 so 的需求(当然前提是过了 so 的效验等操作) 至于为什么选用 AndServer,好吧,不为什么,只是因为搜索到了它 为什么结合 Service,在学习 Android 开发的时候了解到了 Service 的生命周期,个人理解用 Service 去创建 Http 服务比较好。 当然也有 Application 的简单使用,因为在正式环境中,大多数 so 文件的逻辑中都有 context 的一些包名了,签名了的效验等,自定义 Application 的话获取 context 传参就好了。 libyemu.so 简介 这是我编译好的一个 so 文件,就是根据入参做下简单的字符串拼接(以下是 native 层编译前的 c 代码) extern "C" JNIEXPORT jstring JNICALL Java_com_fw_myapplication_ndktest_NdkTest_stringFromUTF(JNIEnv *env, jobject instance, jstring str_) { jclass String_clazz = env->FindClass("java/lang/String"); jmethodID concat_methodID = env->GetMethodID(String_clazz, "concat", "(Ljava/lang/String;)Ljava/lang/String;"); jstring str = env->NewStringUTF(" from so --[NightTeam夜幕]"); jobject str1 = env->CallObjectMethod(str_, concat_methodID, str); const char *chars = env->GetStringUTFChars((jstring)str1, 0); return env->NewStringUTF(chars); } 这部分代码还是有必要贴一下的,简单的静态注册使用了反射的思想,反射在逆向中至关重要 接下来是 java 代码,定义了 native 函数 package com.fw.myapplication.ndktest; public class NdkTest { public static native String stringFromUTF(String str); static { System.loadLibrary("yemu"); } } 如果到这里有点懵逼的同学可能需要去补下 Android 开发基础了 Android 项目测试 so 先说下我的环境,因为这个环境影响太大了 1,AndroidStudio 3.4 2,手机 Android 6 架构 armeabi-v7a 打开 AndroidStudio 新建 project 在 module 的 build 中加这么一句,然后 sync 把编译好的 so 文件复制到 libs 文件夹下(和刚才的 jniLibs.srcDirs 对应) 把 so 对应的 java 代码也 copy 过来,注意包名类名的一致性 打开 activity_main.xml 文件为 TextView 添加 id 打开 MainActiviy.java 开始编码 这两行的意思就是,先从布局中找到对应 id 的 TextView,然后为其设置 Text(调用 native 函数的返回值) 下面测试一下咱们的 so 调用情况 可以看到咱们的 so 文件调用成功(这里咱们的 so 没有效验,只是测试 app 是否可以正常调用) AndServer 代码编写 AndServer 官方文档:https://yanzhenjie.com/AndServer/ 打开官方文档,看看人家的入门介绍,新建 java 文件 如图经典 MVC 的 C 就写好了,定义了一个 nightteam_sign 接口,请求方式为 get,请求参数为 sign,调用 native 函数,然后返回 json,但是这里我想利用 Application 获取下 context 对象,取下包名,接下来自定义 Applictaion package com.nightteam.httpso; import android.app.Application; public class MyApp extends Application { private static MyApp myApp; public static MyApp getInstance() { return myApp; } @Override public void onCreate() { super.onCreate(); myApp = this; } } 然后在 manifest 文件中指定要启动的 Application 然后修改 MyController.java 的代码 接下来把官方文档-服务器的代码 copy 下来 导入一些包,修改部分代码如下 新版本的 AndServer.serverBuilder 已经需要传递 context 了,这里把网络地址和端口号也修改为从构造参数中获取,到这里 AndServer 的东西基本完了,实际上咱们就搭建一个调 so 的接口,并没有过多的业务逻辑,所以代码就是使用的最简单的 Service 代码编写 咱们这里用按钮的点击事件启动 Service,故在 activity_main.xml 中添加一个 button 并指定点击事件 接下来编写自定义 Service 代码 package com.nightteam.httpso.Service; import android.app.Service; import android.content.Intent; import android.os.IBinder; import android.util.Log; import com.nightteam.httpso.ServerManager; import java.net.InetAddress; import java.net.UnknownHostException; public class MyService extends Service { private static final String TAG = "NigthTeam"; @Override public void onCreate() { super.onCreate(); Log.d(TAG, "onCreate: MyService"); new Thread() { @Override public void run() { super.run(); InetAddress inetAddress = null; try { inetAddress = InetAddress.getByName("0.0.0.0"); Log.d(TAG, "onCreate: " + inetAddress.getHostAddress()); ServerManager serverManager = new ServerManager(getApplicationContext(), inetAddress, 8005); serverManager.startServer(); } catch (UnknownHostException e) { e.printStackTrace(); } } }.start(); } @Override public IBinder onBind(Intent intent) { return null; } } 打上了几个 log,在子线程中启动 AndServer 的服务(何时使用 UI 线程和子线程是 Android 基础,这里就不赘述了) 注意一下,这里从 0.0.0.0 获取 inetAddress,可不要写错了,localhost 和 0.0.0.0 的区别请移步搜索引擎 然后就是向 ServerManager 的构造函数传递 context,inetAddress,port 用来 new 对象,随后开启服务 最后注意检查下 manifest 文件中 Service 的声明 开启 Service,并获取本机 ip 回到我们的 MainActivity.java 的 operate( button 的点击事件)编写启动 Service 代码 public void operate(View view) { switch (view.getId()){ case R.id.id_bt_index: //启动服务:创建-->启动-->销毁 //如果服务已经创建了,后续重复启动,操作的都是同一个服务,不会再重新创建了,除非你先销毁它 Intent it1 = new Intent(this, MyService.class); Log.d(TAG, "operate: button"); startService(it1); ((Button) view).setText("服务已开启"); break; } } 到这里我们的服务基本搭建好了,但是为了方便起见,我想把咱们的本机 ip 显示在 App 上,这样我们就不用去设置再查看了 我在网上找到了一个获取 ip 地址的一个工具类,源码如下: package com.nightteam.httpso; import java.net.InetAddress; import java.net.NetworkInterface; import java.net.SocketException; import java.util.Enumeration; import java.util.regex.Pattern; public class NetUtils { private static final Pattern IPV4_PATTERN = Pattern.compile("^(" + "([0-9]|[1-9][0-9]|1[0-9]{2}|2[0-4][0-9]|25[0-5])\\.){3}" + "([0-9]|[1-9][0-9]|1[0-9]{2}|2[0-4][0-9]|25[0-5])$"); private static boolean isIPv4Address(String input) { return IPV4_PATTERN.matcher(input).matches(); } //获取本机IP地址 public static InetAddress getLocalIPAddress() { Enumeration<NetworkInterface> enumeration = null; try { enumeration = NetworkInterface.getNetworkInterfaces(); } catch (SocketException e) { e.printStackTrace(); } if (enumeration != null) { while (enumeration.hasMoreElements()) { NetworkInterface nif = enumeration.nextElement(); Enumeration<InetAddress> inetAddresses = nif.getInetAddresses(); if (inetAddresses != null) while (inetAddresses.hasMoreElements()) { InetAddress inetAddress = inetAddresses.nextElement(); if (!inetAddress.isLoopbackAddress() && isIPv4Address(inetAddress.getHostAddress())) { return inetAddress; } } } } return null; } } 把工具类 copy 到我们的 Android 项目中,继续在 MainActivity.java 中编码 获取了一下本机地址和 Android SDK 版本( Android 8 之后启动 Service 方式不一样) 申请权限,启动 App 最后一步就是为 app 申请网络权限了 随后连接我们的手机,运行项目,测试一下,点击开启服务 看下 AndroidStudio 日志 好像一切正常,在浏览器访问下试试( ip 就是 App 中显示的 ip 地址) 如图正常访问到了我们想要的内容 回过头来说下 Service,打开我们手机的设置,找到应用程序管理-运行中的服务(手机不同,方式不同) 可以看到我们的程序,运行了一个服务,这个服务就是咱们编码的 MyService 接下来杀掉该 App进程,再次查看运行中的服务 我这里在权限管理设置了自动运行,可以保持服务的运行。(这个地方还是根据系统有大小差异) 至此使用 App 起 http 服务调 so 就完成了 TiToData:专业的短视频、直播数据接口服务平台。 更多信息请联系: TiToData 覆盖主流平台:抖音,快手,小红书,TikTok,YouTube

优秀的个人博客,低调大师

躁动不安的年代,你需要读几本好书(python爬虫及数据分析)

公众号:pythonislover 当今社会,速度已经深入人心了,“快”成了大家默认的办事境界,看机器上一件件飞一般传递着的产品,听办公室一族打电话时那种无人能及的语速......休闲的概念已日渐模糊,大家似乎都变成了在“快咒”控制下的小人儿,似乎连腾出点时间来松口气的时间都没有了,看得见的、看不见的规则约束着我们;有形的、无形的的鞭子驱赶着我们,我们马不停蹄追求事业、爱情、地位、财富,似乎自己慢一拍,就会被这个世界抛弃 工作仅仅是生活的一部分,千万不要忽略了其他乐趣,人生本是一幅美丽的风景画,不必对所有的事情都抱有强烈的目的性,人的一生总有做不完的事情,只要我们有一个平和之心,就不会错过沿途风景。 一个阳光明媚的早晨,手拿一杯咖啡,翻开一本喜欢的书,也不失为一种人生乐趣,作为IT一族,我们不能只是局限于IT类的数据,要广大自己的视野

优秀的个人博客,低调大师

Python爬虫入门教程 15-100 石家庄政民互动数据爬取

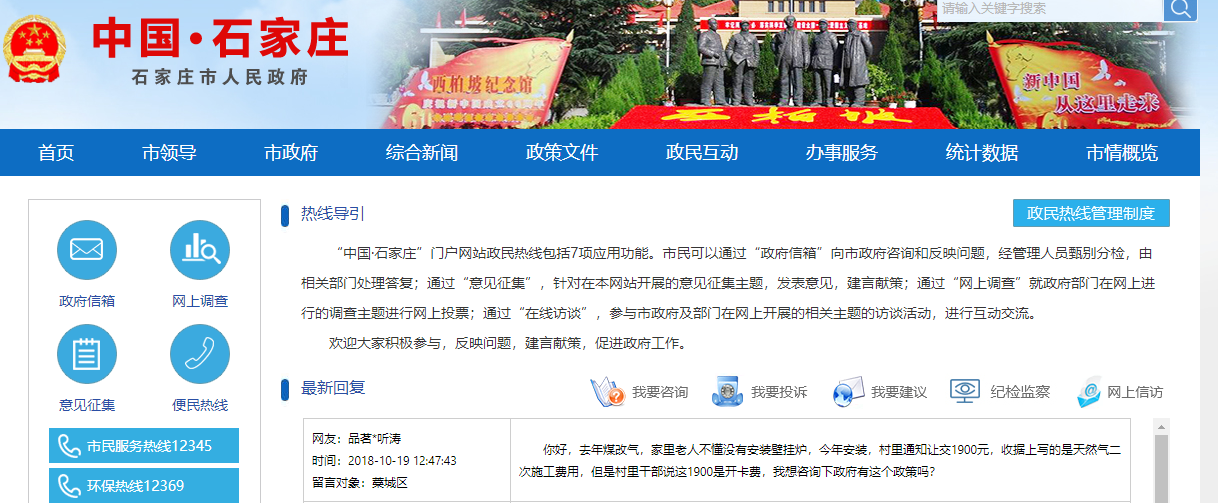
1. 石家庄政民互动数据爬取-写在前面 今天,咱抓取一个网站,这个网站呢,涉及的内容就是 网友留言和回复,特别简单,但是网站是gov的。网址为http://www.sjz.gov.cn/col/1490066682000/index.html 首先声明,为了学习,绝无恶意抓取信息,不管你信不信,数据我没有长期存储,预计存储到重装操作系统就删除。 2. 石家庄政民互动数据爬取-网页分析 点击更多回复 ,可以查看到相应的数据。 数据量很大14万条,,数据爬完,还可以用来学习数据分析,真是nice 经过分析之后,找到了列表页面。数据的爬取这次我们采用的是 selenium ,解析页面采用lxml,数据存储采用pymongo ,关于selenium 你可以去搜索引擎搜索相关的教程,好多的,主要就是打开一个浏览器,然后模拟用户的操作,你可以去系统的学习一下。 3. 石家庄政民互动数据爬取-撸代码 导入必备模块 from selenium import webdriver from selenium.common.exceptions import TimeoutException from selenium.webdriver.common.by import By from selenium.webdriver.support.ui import WebDriverWait from selenium.webdriver.support import expected_conditions as EC from lxml import etree import pymongo import time 打开浏览器,获取总页码 这个操作最重要的步骤,你搜索之后就会知道,需要提前下载一个叫做 chromedriver.exe 的东东,然后把他配置好,自行解决去吧~ # 加载浏览器引擎,需要提前下载好 chromedriver.exe 。 browser = webdriver.Chrome() wait = WebDriverWait(browser,10) def get_totle_page(): try: # 浏览器跳转 browser.get("http://www.sjz.gov.cn/zfxxinfolist.jsp?current=1&wid=1&cid=1259811582187") # 等待元素加载到 totle_page = wait.until( EC.presence_of_element_located((By.CSS_SELECTOR,'input[type="hidden"]:nth-child(4)')) ) # 获取属性 totle = totle_page.get_attribute('value') # 获取首页数据,这个地方先不必须 ############################## #get_content() ############################## return totle except TimeoutError: return get_totle_page() 上面的代码在测试之后,你会得到如下结果 这时候,你已经得到20565这个总页码数目了,只需要进行一系列循环的操作即可,接下来有一个重要的函数,叫做next_page 这个函数里面,需要进行一个模拟用户行为的操作,输入一个页码,然后点击跳转。 def main(): totle = int(get_totle_page()) # 获取完整页码 for i in range(2,totle+1): print("正在加载第{}页数据".format(i)) # 获取下一页 next_page(i) if __name__ == '__main__': print(main()) 输入页码,点击跳转 def next_page(page_num): try: input = wait.until( EC.presence_of_element_located((By.CSS_SELECTOR,"#pageto")) ) submit = wait.until( EC.element_to_be_clickable((By.CSS_SELECTOR,"#goPage")) ) input.clear() # 清空文本框 input.send_keys(page_num) # 发送页码 submit.click() # 点击跳转 #get_content(page_num) except TimeoutException: next_page(page_num) 以上代码实现的效果动态演示为 4. 石家庄政民互动数据爬取-解析页面 可以进行翻页之后,通过browser.page_source 获取网页源码,网页源码通过lxml进行解析。编写相应的方法为 def get_content(page_num=None): try: wait.until( EC.presence_of_element_located((By.CSS_SELECTOR, "table.tably")) ) html = browser.page_source # 获取网页源码 tree = etree.HTML(html) # 解析 tables = tree.xpath("//table[@class='tably']") for table in tables: name = table.xpath("tbody/tr[1]/td[1]/table/tbody/tr[1]/td")[0].text public_time = table.xpath("tbody/tr[1]/td[1]/table/tbody/tr[2]/td")[0].text to_people = table.xpath("tbody/tr[1]/td[1]/table/tbody/tr[3]/td")[0].text content = table.xpath("tbody/tr[1]/td[2]/table/tbody/tr[1]/td")[0].text repl_time = table.xpath("tbody/tr[2]/td[1]/table/tbody/tr[1]/td")[0].text repl_depart = table.xpath("tbody/tr[2]/td[1]/table/tbody/tr[2]/td")[0].text repl_content = table.xpath("tbody/tr[2]/td[2]/table/tbody/tr[1]/td")[0].text # 清理数据 consult = { "name":name.replace("网友:",""), "public_time":public_time.replace("时间:",""), "to_people":to_people.replace("留言对象:",""), "content":content, "repl_time":repl_time.replace("时间:",""), "repl_depart":repl_depart.replace("回复部门:",""), "repl_content":repl_content } # 数据存储到mongo里面 #save_mongo(consult) except Exception: # 这个地方需要特殊说明一下 print("异常错误X1") print("浏览器休息一下") time.sleep(60) browser.get("http://www.sjz.gov.cn/zfxxinfolist.jsp?current={}&wid=1&cid=1259811582187".format(page_num)) get_content() 在实际的爬取过程中发现,经过几百页之后,就会限制一下IP,所以当我们捕获页面信息出错,需要暂停一下,等待页面正常之后,在继续爬取数据。 5. 石家庄政民互动数据爬取-数据存储到mongodb里面 爬取到的最终数据,我存储到了mongodb里面,这个就没有什么难度了,我们按照常规的套路编写即可。 6. 石家庄政民互动数据爬取-写在最后 由于这次爬取的网站是gov的,所以建议不要用多线程,源码也不发送到github上去了,要不惹祸,如果有任何疑问,请评论。nice boy她专科学历27岁从零开始学习c,c++,python编程语言29岁编写百例教程30岁掌握10种编程语言,用自学的经历告诉你,学编程就找梦想橡皮擦

优秀的个人博客,低调大师

Python爬虫入门教程 8-100 蜂鸟网图片爬取之三

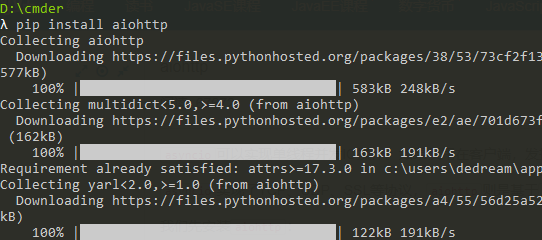
1. 蜂鸟网图片-啰嗦两句 前几天的教程内容量都比较大,今天写一个相对简单的,爬取的还是蜂鸟,依旧采用aiohttp 希望你喜欢爬取页面https://tu.fengniao.com/15/ 本篇教程还是基于学习的目的,为啥选择蜂鸟,没办法,我瞎选的。 一顿熟悉的操作之后,我找到了下面的链接https://tu.fengniao.com/ajax/ajaxTuPicList.php?page=2&tagsId=15&action=getPicLists 这个链接返回的是JSON格式的数据 page =2页码,那么从1开始进行循环就好了 tags=15 标签名称,15是儿童,13是美女,6391是私房照,只能帮助你到这了,毕竟我这是专业博客 ヾ(◍°∇°◍)ノ゙ action=getPicLists接口地址,不变的地方 2.

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册