首页 文章 精选 留言 我的

精选列表

搜索[并发编程],共10000篇文章
优秀的个人博客,低调大师

(十五)Java并发性和多线程-死锁

死锁是两个或更多线程阻塞着等待其它处于死锁状态的线程所持有的锁。死锁通常发生在多个线程同时但以不同的顺序请求同一组锁的时候。 例如,如果线程1锁住了A,然后尝试对B进行加锁,同时线程2已经锁住了B,接着尝试对A进行加锁,这时死锁就发生了。线程1永远得不到B,线程2也永远得不到A,并且它们永远也不会知道发生了这样的事情。为了得到彼此的对象(A和B),它们将永远阻塞下去。这种情况就是一个死锁。 该情况如下: Thread 1 locks A, waits for B Thread 2 locks B, waits for A 一个简单的死锁类 当DeadLock类的对象flag==1时(td1),先锁定o1,睡眠500毫秒 而td1在睡眠的时候另一个flag==0的对象(td2)线程启动,先锁定o2,睡眠500毫秒 td1睡眠结束后需要锁定o2才能继续执行,而此时o2已被td2锁定; td2睡眠结束后需要锁定o1才能继续执行,而此时o1已被td1锁定; td1、td2相互等待,都需要得到对方锁定的资源才能继续执行,从而死锁。 import lombok.extern.slf4j.Slf4j; @Slf4j public class DeadLock implements Runnable { public int flag = 1; //静态对象是类的所有对象共享的 private static Object o1 = new Object(), o2 = new Object(); @Override public void run() { log.info("flag:{}", flag); if (flag == 1) { synchronized (o1) { try { Thread.sleep(500); } catch (Exception e) { e.printStackTrace(); } synchronized (o2) { log.info("1"); } } } if (flag == 0) { synchronized (o2) { try { Thread.sleep(500); } catch (Exception e) { e.printStackTrace(); } synchronized (o1) { log.info("0"); } } } } public static void main(String[] args) { DeadLock td1 = new DeadLock(); DeadLock td2 = new DeadLock(); td1.flag = 1; td2.flag = 0; //td1,td2都处于可执行状态,但JVM线程调度先执行哪个线程是不确定的。 //td2的run()可能在td1的run()之前运行 new Thread(td1).start(); new Thread(td2).start(); } }

优秀的个人博客,低调大师

GO------小白之并发聊天室

因为没有写客户端、可以在cmd中利用 nc -u 来充当客户端 广播用户上线: 1、主go程中创建socket、defer 2、循环监听客户端连接请求 3、有一个客户端链接、创建新go程处理客户数据 4、组织用户相关信息、全局变量(结构体、map、channel) 5、Hadlconn、初始化新用户结构体信息、获取客户端IP和port、初始化新用户结构体信息、 name==addr 6、创建manager管理go程、要在for循环accpet之前、实现manager、初始化在线用户map.循环读取全局的channel、如果无数据阻塞、如果有数据遍历在线用户 map、将数据写到用户的channel中 7、新用户添加到map中、key==ip+port value==结构体 8、创建WriteToClient go程专门给当前用户发送消息、遍历自带C、读数据、Conn.Write写到客户端 9、Hadlconn中。结束位置、组织用户上线信息、将用户上线信息写到全局channel--Maneger被激 活 10、Hadlconn结尾处要有for循环、不然直接终止 有问题的地方都已经注释 接下来要在基础框架上增加小功能 发送消息内容: 1、封装函数来广播用户传的消息,传到massage中 2、起匿名go程、主要是来读取客户端发送的内容、写到全局massage中 3、for 循环读取客户端发送的内容 4、写给全局massage 查询在线用户: 将buf里减去一个“\n” 判断是否为who,如果为who、遍历map ,将名字利用conn.Write写到当前客户端 修改用户名: 1、将读取到的masg进行判断是否为rename 2、提取rename| 后的字符串、存入到client.name成员中 3、更新在线用户列表 onlinemap--key-----ip+port 4、提示用户更新成功 用户退出: 1、在用户登录成功后、创建监听用户退出的channel---isQuit 2、当conn.read==0时、isQuit<-true 3、在handleConnect结尾for中、添加select监听<-isQuit 4、条件满足、将用户从在线列表移除、阻止用户下线消息、写入massage通道 超时强踢: 1、在select中添加监听定时器time.After,计时到达将用户从在线列表移除、阻止用户下线消息、写入 massage通道 2、判断用户是否活跃,创建监听活跃的channel、只要用户执行聊天改名查询任意操作,向此channel 写数据 3、在select添加用户活跃度的监听、条件满足、不作为,目的是重置上面创建的计时器 这些功能其实都是在HandleConn函数中实现的 Func HandleConn(connnet.Conn){ defer conn.Close() //初始化结构体 addr:=conn.RemoteAddr().String() client:=Client{make(chanstring),addr,addr} Olinemap[addr]=client msg:=Mkmas(client,"login") //将消息传到全局通道发送给其他人 goWriteToClient(client,conn) Massage<-msg quit:=make(chanbool) datahas:=make(chanbool) //匿名函数主要做的是客户端写入的数据 buf:=make([]byte,1024) go func() { for{ n,err:=conn.Read(buf) ifn==0{ quit<-true fmt.Println("客户端退出") return } iferr!=nil{ fmt.Println("conn.Read error",err) return } msg:=string(buf[:n-1]) ifmsg=="who"&&len(msg)==3{ conn.Write([]byte("user list:")) for_,value:=rangeOlinemap{ Massage<-value.Addr+value.Name } }else iflen(msg)>=8&&msg[:6]=="rename"{ newname:=msg[7:] client.Name=newname Olinemap[addr]=client Olinemap[addr].Name=msg[7:,go语言里不支持这样修改结构体中的数据 conn.Write([]byte("rename successfully")) }else{ info:=Mkmas(client,msg) Massage<-info } datahas<-true //注意位置、如果客户端改名、who命令都算活跃 } }() for{ select{ case<-quit: //确定退出、n==0时 close(client.C) //关闭WriteToClient函数 delete(Olinemap,addr) str:=Mkmas(client,"exit") fmt.Println(str,"exit") Massage<-str return //return当前go程返回、但是中间创建的go程不会停止。所以要将WriteToClient关闭 case<-datahas: //如果客户端活跃则不做操作,这个是为了让下面的超时退出重置 case<-time.After(time.Second*10): delete(Olinemap,addr) str:=Mkmas(client,"timeout") Massage<-str fmt.Println(str,"timeout") return } } }

优秀的个人博客,低调大师

(二)Java并发学习笔记--安全发布对象

逸出的方式 上边关于逸出的概念讲述的很是模糊,下面列举几个逸出的示例。 通过静态变量引用逸出 public static Set<Secret> knownSecrets; public void initialize() { knowsSecrets = new HashSet<Secret>(); } 上边代码示例中,调用initialize方法,发布了knowSecrets对象。当你向knowSecrets中添加一个Secret时,会同时将Secret对象发布出去,原因是可以通过遍历knowSecrets获取到Secret对象的引用,然后进行修改。 通过非静态(私有)方法 class UnsafeStates { private String[] states = new String[]{"AK", "AL"}; public String[] getStates() { return states; } } 以这种方式发布的states会出问题,任何一个调用者都能修改它的内容。数组states已经逸出了它所属的范围,这个本应该私有的数据,事实上已经变成共有的了。 this逸出 public class ThisEscape { public ThisEscape(EventSource source) { source.registerListener(new EventListener() { public void onEvent(Event e) { doSomething(e); } }); } } 在上边代码中,当我们实例化ThisEscape对象时,会调用source的registerListener方法时,便启动了一个线程,而且这个线程持有了ThisEscape对象(调用了对象的doSomething方法),但此时ThisEscape对象却没有实例化完成(还没有返回一个引用),所以我们说,此时造成了一个this引用逸出,即还没有完成的实例化ThisEscape对象的动作,却已经暴露了对象的引用,使其他线程可以访问还没有构造好的对象,可能会造成意料不到的问题。 通过上述示例,个人理解,对逸出的概念应该定义为: 一个对象,超出了它原本的作用域,而可以被其它对象进行修改,而这种修改及修改的结果是无法预测的。换句话说:一个对象发布后,它的状态应该是稳定的,修改是可被检测到的。如果在其它线程修改(或做其它操作)一个对象后导致对象的状态未知,就可以说这个对象逸出了。 总之,一个对象逸出后,不论其它线程或对象是否使用这个逸出的对象都不重要,重要的是,被误用及被误用后的未知结果的风险总是存在的。 PS 书中给出了避免this逸出的方法: public class SafeListener { private final EventListener listener; private SafeListener() { listener = new EventListener() { public void onEvent(Event e) { doSomething(e); } }; } public static SafeListener newInstance(EventSource source) { SafeListener safe = new SafeListener(); source.registerListener(safe.listener); return safe; } } 在这个构造中,我们看到的最大的一个区别就是:当构造好了SafeListener对象之后,我们才启动了监听线程,也就确保了SafeListener对象是构造完成之后在使用的SafeListener对象。 对于这样的技术,书里面也有这样的注释: 具体来说,只有当构造函数返回时,this引用才应该从线程中逸出。构造函数可以将this引用保存到某个地方,只要其他线程不会在构造函数完成之前使用它。 安全发布对象 在静态初始化函数中初始化一个对象引用 将对象的应用保存到volatile类型的域或者AtomicReferance对象中 将对象的引用保存到某个正确构造对象的final类型域中 将对象的引用保存到一个由锁保护的域中。 /** * 懒汉模式(线程不安全) * 单例实例在第一次使用时进行创建 */ @NotThreadSafe public class SingletonExample1 { // 私有构造函数 private SingletonExample1() { } // 单例对象 private static SingletonExample1 instance = null; // 静态的工厂方法 public static SingletonExample1 getInstance() { // 这里同时有两个线程进入就可能同时初始化两个对象 if (instance == null) { instance = new SingletonExample1(); } return instance; } } 懒汉模式本身是线程不安全的,如果想要实现线程安全可以通过synchronized关键字实现: /** * 懒汉模式 * 单例实例在第一次使用时进行创建 */ @ThreadSafe @NotRecommend public class SingletonExample3 { // 私有构造函数 private SingletonExample3() { } // 单例对象 private static SingletonExample3 instance = null; // 静态的工厂方法 public static synchronized SingletonExample3 getInstance() { if (instance == null) { instance = new SingletonExample3(); } return instance; } } 但此中方式不推荐使用,应该它通过同一时间内只允许一个线程来访问的方式实现线程安全,但是却带来了性能上面的开销。 我们可以通过以下方式来实现线程安全: 懒汉模式 -》 volatile + 双重同步锁单例模式 /** * 懒汉模式 -》 双重同步锁单例模式 * 单例实例在第一次使用时进行创建 */ @ThreadSafe public class SingletonExample4 { // 私有构造函数 private SingletonExample4() { } // 1、memory = allocate() 分配对象的内存空间 // 2、ctorInstance() 初始化对象 // 3、instance = memory 设置instance指向刚分配的内存 // JVM和cpu优化,发生了指令重排(多线程 ) // 1、memory = allocate() 分配对象的内存空间 // 3、instance = memory 设置instance指向刚分配的内存 // 2、ctorInstance() 初始化对象 // 单例对象 volatile + 双重检测机制 -> 禁止指令重排 private volatile static SingletonExample4 instance = null; public static SingletonExample4 getInstance() { if (instance == null) { // 双重检测机制 // B synchronized (SingletonExample4.class) { // 同步锁 if (instance == null) { instance = new SingletonExample4(); // A - 3 } } } return instance; } } /** * 饿汉模式 * 单例实例在类装载时进行创建 */ @ThreadSafe public class SingletonExample2 { // 私有构造函数 private SingletonExample2() { } // 单例对象 private static SingletonExample2 instance = new SingletonExample2(); // 静态的工厂方法 public static SingletonExample2 getInstance() { return instance; } } 饿汉模式不会有线程问题,但是在类加载时实例化对象。使用时要考虑两点: 私有构造函数在使用时没有过多的逻辑处理(销毁性能,慢) 这个对象一定会被使用(浪费资源) 在静态代码块中实例化一个对象: /** * 饿汉模式 * 单例实例在类装载时进行创建 */ @ThreadSafe public class SingletonExample6 { // 私有构造函数 private SingletonExample6() { } // 单例对象 private static SingletonExample6 instance = null; static { instance = new SingletonExample6(); } // 静态的工厂方法 public static SingletonExample6 getInstance() { return instance; } public static void main(String[] args) { System.out.println(getInstance().hashCode()); System.out.println(getInstance().hashCode()); } } 枚举模式: /** * 枚举模式:最安全 */ @ThreadSafe @Recommend public class SingletonExample7 { // 私有构造函数 private SingletonExample7() { } public static SingletonExample7 getInstance() { return Singleton.INSTANCE.getInstance(); } private enum Singleton { INSTANCE; private SingletonExample7 singleton; // JVM保证这个方法绝对只调用一次 Singleton() { singleton = new SingletonExample7(); } public SingletonExample7 getInstance() { return singleton; } } }

优秀的个人博客,低调大师

java高并发之CountDownLatch,CyclicBarrier和join

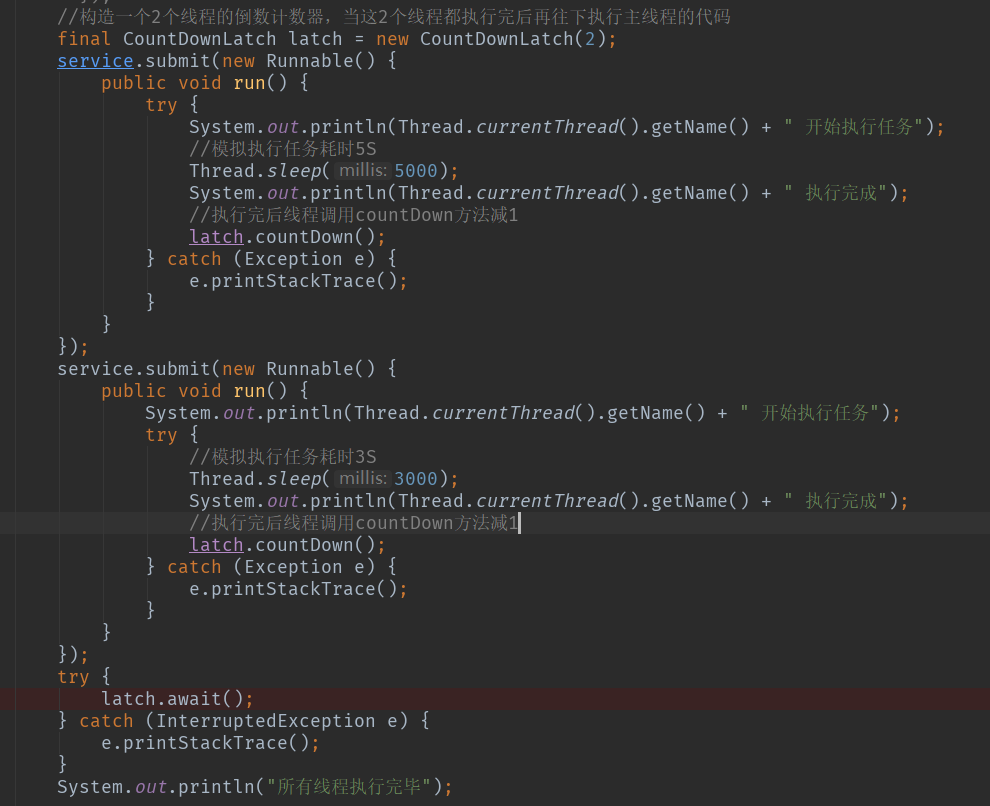
晚上打车回家,在车上看到一篇文章《22岁大学生获谷歌天价Offer,年薪千万!》,讲的是印度一个22岁大学生多次参加ACM大赛,开源多个项目,以非常牛逼的履历通过了谷歌的AI测试,斩获谷歌仅有的50个顶尖offer之一。于是感慨:同样是大学生,为何这哥们就这么一枝独秀呢?难道印度也有陈独秀?为啥自己都12年义务教育+4年大学教育+3年烟酒僧教育了,连人家个零头都挣不了啊?真恨不得在地上挖个洞钻进去。不行,今晚必须输出篇博客安慰下被打击的心!想到这里顿时酒也醒了(老大走了,今晚几个同事送他,喝了点酒),心也不再那么伤感了,决定把今天get的一些知识点做个梳理,知识是一点点积累起来的,比你牛逼的人比你还努力,你还有什么资格不努力? 早上看了下CountDownLatch和CyclicBarrier的用法和区别,讲到CountDownLatch又想到了Thread.join()方法,就来讲讲这3兄弟的功能,特点&&用法,讲的不对的地方欢迎指正。 一、CountDownLatch: 功能:同步辅助类,也可以理解为倒计时锁,用于同步线程状态,允许一个或多个线程,等待其他一组线程完成操作,再继续往下执行。 特点:不可复用! 重要方法:countDown()方法:计数器-1,每次线程执行完后调用;await()方法:等待方法,在需要阻塞的地方调用,当所有线程都执行完后,自动往下执行 用法:构造的时候指定一个计数器的值,每个线程执行完后就减1,直到为0再往下走。如下: 输出结果: 可以看到:2个子线程分别睡眠了3s和5s,而主线的打印的“所有现场执行完毕”却是在所有子线程执行完成后才输出的,原因就是阻塞在了latch.await()方法,这个方法会等到所有线程都执行完才往下执行,阻塞的原理后面有空再研究分析 二、CyclicBarrier(循环栅栏): 功能:同步辅助类,功能和CountDownLatch类似,用于同步线程状态,允许一组线程相互之间等待,达到一个共同点,再继续执行。 特点:可复用!当组内所有线程都到达某个执行点后,count参数会被重置,于是就可重用了。 重要方法:await()方法:当某个线程到达某个点(比如执行完某个任务)后调用该方法,就会等待其他线程,直到所有线程都到达这个点,再自动往下执行。还有个重载方法await(long timeOut,TimeUnit unit),用于当某个线程执行超过指定时间后还未到达某个点时,就会抛出异常,不再等待这个线程,并往下执行。 用法:构造的时候指定一个线程数量的值和到达某个点后执行的动作,如下: 执行结果如下: 可以看到:当前线程先于2个子线程打印执行结果,原因就是CyclicBarrier针对的是一组线程之间的等待,await方法会等待该组内所有线程都执行完毕再往下执行,Runnable接口里定义的动作是在所有线程执行完毕后,随机选择一个线程来执行 三、join()方法: join方法也是管理线程状态同步的一个方法,和CountDownLatch和CyclicBarrier均由自身调用不同的是,join的调用者为当前线程,后面的线程必须等调用join的线程执行完后才能执行。参考例子如下: 执行结果: 结果分析:新创建了2个线程,每个线程的执行功能和时间是一样的,由于调用了join,主线程确实是在调用join的2个线程执行后才开始执行的 3者区别: 1、CountDownLatch不可复用,当计数器减为0后,只能重新构造新的计数器,CyclicBarrier可以复用,原因上面已说。 2、CyclicBarrier针对的是一组线程之间的等待,是组内等待关系,CountDownLatch针对的是一个线程等待别的一组线程的关系,是组间等待关系。 3、join方法和CountDownLatch方法功能类似,但是join方法不如CountdownLatch控制灵活,可以参考:https://blog.csdn.net/zhutulang/article/details/48504487。 本来还想讲讲volatile关键字的原理和特性,以及activeMQ中quene,topic和virtualTop之间的区别和用法的,以及mysql索引结构的实现原理的,时间不够了,明早还要去申请廉租房得早起,下次再讲吧。

优秀的个人博客,低调大师

【总结】Spark优化(1)-多Job并发执行

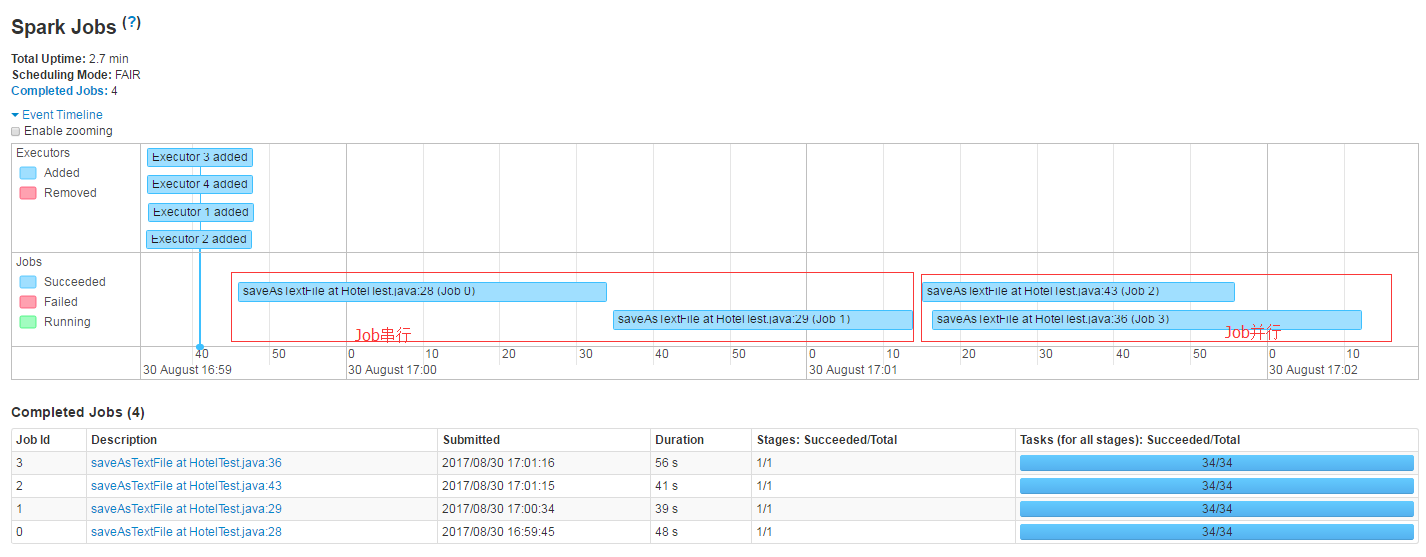
Spark程序中一个Job的触发是通过一个Action算子,比如count(), saveAsTextFile()等 在这次Spark优化测试中,从Hive中读取数据,将其另外保存四份,其中两个Job采用串行方式,另外两个Job采用并行方式。将任务提交到Yarn中执行。能够明显看出串行与兵线处理的性能。 每个Job执行时间: JobID 开始时间 结束时间 耗时 Job 0 16:59:45 17:00:34 49s Job 1 17:00:34 17:01:13 39s Job 2 17:01:15 17:01:55 40s Job 3 17:01:16 17:02:12 56s 四个Job都是自执行相同操作,Job0,Job1一组采用串行方式,Job2,Job3采用并行方式。 Job0,Job1串行方式耗时等于两个Job耗时之和 49s+39s=88s Job2,Job3并行方式耗时等于最先开始和最后结束时间只差17:02:12-17:01:15=57s 代码: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 package com.cn.ctripotb; import org.apache.spark.SparkConf; import org.apache.spark.api.java.JavaSparkContext; import org.apache.spark.sql.DataFrame; import org.apache.spark.sql.hive.HiveContext; import java.util.*; import java.util.concurrent.Callable; import java.util.concurrent.Executors; /** *CreatedbyAdministratoron2016/9/12. */ public class HotelTest{ static ResourceBundlerb=ResourceBundle.getBundle( "filepath" ); public static void main(String[]args){ SparkConfconf= new SparkConf() .setAppName( "MultiJobWithThread" ) .set( "spark.serializer" , "org.apache.spark.serializer.KryoSerializer" ); JavaSparkContextsc= new JavaSparkContext(conf); HiveContexthiveContext= new HiveContext(sc.sc()); //测试真实数据时要把这里放开 final DataFramedf=getHotelInfo(hiveContext); //没有多线程处理的情况,连续执行两个Action操作,生成两个Job df.rdd().saveAsTextFile(rb.getString( "hdfspath" )+ "/file1" ,com.hadoop.compression.lzo.LzopCodec. class ); df.rdd().saveAsTextFile(rb.getString( "hdfspath" )+ "/file2" ,com.hadoop.compression.lzo.LzopCodec. class ); //用Executor实现多线程方式处理Job java.util.concurrent.ExecutorServiceexecutorService=Executors.newFixedThreadPool( 2 ); executorService.submit( new Callable<Void>(){ @Override public Voidcall(){ df.rdd().saveAsTextFile(rb.getString( "hdfspath" )+ "/file3" ,com.hadoop.compression.lzo.LzopCodec. class ); return null ; } }); executorService.submit( new Callable<Void>(){ @Override public Voidcall(){ df.rdd().saveAsTextFile(rb.getString( "hdfspath" )+ "/file4" ,com.hadoop.compression.lzo.LzopCodec. class ); return null ; } }); executorService.shutdown(); } public static DataFramegetHotelInfo(HiveContexthiveContext){ Stringsql= "select*fromcommon.dict_hotel_ol" ; return hiveContext.sql(sql); } } 本文转自巧克力黒 51CTO博客,原文链接:http://blog.51cto.com/10120275/1961130 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

Flutter 异步编程指南

作者:京东物流王志明 1 Dart 中的事件循环模型 在 App 开发中,经常会遇到处理异步任务的场景,如网络请求、读写文件等。Android、iOS 使用的是多线程,而在 Flutter 中为单线程事件循环,如下图所示 Dart 中有两个任务队列,分别为 microtask 队列和 event 队列,队列中的任务按照先进先出的顺序执行,而 microtask 队列的执行优先级高于 event 队列。在 main 方法执行完毕后,会启动事件循环,首先将 microtask 队列中的任务逐个执行完毕,再去执行 event 队列中的任务,每一个 event 队列中的任务在执行完成后,会再去优先执行 microtask 队列中的任务,如此反复,直到清空所有队列,这个过程就是 Dart 事件循环的处理机制。这种机制可以让我们更简单的处理异步任务,不用担心锁的问题。我们可以很容易的预测任务执行的顺序,但无法准确的预测到事件循环何时会处理到你期望执行的任务。例如创建了一个延时任务,但排在前面的任务结束前是不会处理这个延时任务的,也就说这个任务的等待时间可能会大于指定的延迟时间。 Dart 中的方法一旦开始执行就不会被打断,而 event 队列中的事件还来自于用户输入、IO、定时器、绘制等,这意味着在两个队列中都不适合执行计算量过大的任务,才能保证流畅的 UI 绘制和用户事件的快速响应。而且当一个任务的代码发生异常时,只会打断当前任务,后续任务不受影响,程序更不会退出。从上图还可以看出,将一个任务加入 microtask 队列,可以提高任务优先级,但是一般不建议这么做,除非比较紧急的任务并且计算量不大,因为 UI 绘制和处理用户事件是在 event 事件队列中的,滥用 microtask 队列可能会影响用户体验。 总结下 Dart 事件循环的主要概念: Dart 中有两个队列来执行任务:microtask 队列和 event 队列。 事件循环在 main 方法执行完毕后启动, microtask 队列中的任务会被优先处理。 microtask 队列只处理来自 Dart 内部的任务,event 队列中有来自 Dart 内部的 Future、Timer、isolate message,还有来自系统的用户输入、IO、UI 绘制等外部事件任务。 Dart 中的方法执行不会被打断,因此两个队列中都不适合用来执行计算量大的任务。 一个任务中未被处理的异常只会打断当前任务,后续任务不受影响,程序更不会退出。 1.1 向 microtask 队列中添加任务 可以使用顶层方法 scheduleMicrotask 或者 Future.microtask 方法,如下所示: scheduleMicrotask(() => print('microtask1')); Future.microtask(() => print('microtask2')); 使用 Future.microtask 的优势在于可以在 then 回调中处理任务返回的结果。 1.2 向 event 队列中添加任务 Future(() => print('event task')); 基于以上理论,通过如下代码可以验证 Dart 的事件循环机制: void main() { print('main start'); Future(() => print('event task1')); Future.microtask(() => print('microtask1')); Future(() => print('event task1')); Future.microtask(() => print('microtask2')); print('main stop'); 执行结果: main start main stop microtask1 microtask2 event task1 event task1 通过输出结果可以看到,任务的执行顺序并不是按照编写代码的顺序来的,将任务添加到队列不会立刻执行,而执行顺序也完全符合前面讲的规则,当前 main 方法中的代码执行完毕后,才会去执行队列中的任务,且 microTask 队列的优先级高于 event 队列。 2 Dart 中的异步实现 在 Dart 中通过 Future 来执行异步任务, Future 是对异步任务状态的封装,对任务结果的代理,通过 then 方法可以注册处理任务结果的回调方法。 创建方法 Future 方式: Future() Future.delayed() Future.microtask() Future.sync() 2.1 Future() factory Future(FutureOr<T> computation()) { _Future<T> result = new _Future<T>(); Timer.run(() { try { result._complete(computation()); } catch (e, s) { _completeWithErrorCallback(result, e, s); } }); return result; } 上面是 Future() 的源码,可以看到内部是通过启动一个没有延迟的计时器来添加任务的,实用 try catch 来捕获任务代码中可能出现的异常,我们可以在 catchError 回调中来处理异常。 2.2 Future.delayed() factory Future.delayed(Duration duration, [FutureOr<T> computation()?]) { if (computation == null && !typeAcceptsNull<T>()) { throw ArgumentError.value(null, "computation", "The type parameter is not nullable"); } _Future<T> result = new _Future<T>(); new Timer(duration, () { if (computation == null) { result._complete(null as T); } else { try { result._complete(computation()); } catch (e, s) { _completeWithErrorCallback(result, e, s); } } }); return result; } Future.delayed() 与 Future() 的区别是通过一个延迟的计时器来添加任务。 2.3 Future.microtask() factory Future.microtask(FutureOr<T> computation()) { _Future<T> result = new _Future<T>(); scheduleMicrotask(() { try { result._complete(computation()); } catch (e, s) { _completeWithErrorCallback(result, e, s); } }); return result; } Future.microtask() 是将任务添加到 microtask 队列,通过这种可以很方便通过 then 方法中的回调来处理任务的结果。 2.4 Future.sync() factory Future.sync(FutureOr<T> computation()) { try { var result = computation(); if (result is Future<T>) { return result; } else { // TODO(40014): Remove cast when type promotion works. return new _Future<T>.value(result as dynamic); } } catch (error, stackTrace) { var future = new _Future<T>(); AsyncError? replacement = Zone.current.errorCallback(error, stackTrace); if (replacement != null) { future._asyncCompleteError(replacement.error, replacement.stackTrace); } else { future._asyncCompleteError(error, stackTrace); } return future; } } Future.sync() 中的任务会被立即执行,不会添加到任何队列。 在第一个章节中讲到了可以很容易的预测任务的执行顺序,下面我们通过一个例子来验证: void main() { print('main start'); Future.microtask(() => print('microtask1')); Future.delayed(new Duration(seconds:1), () => print('delayed event')); Future(() => print('event1')); Future(() => print('event2')); Future.microtask(() => print('microtask2')); print('main stop'); } 执行结果: main start main stop microtask1 microtask2 event1 event2 delayed event 因为代码比较简单,通过代码可以很容易的预测到执行结果,下面将复杂度稍微提高。 void main() { print('main start'); Future.microtask(() => print('microtask1')); Future.delayed(new Duration(seconds:1), () => print('delayed event')); Future(() => print('event1')) .then((_) => print('event1 - callback1')) .then((_) => print('event1 - callback2')); Future(() => print('event2')).then((_) { print('event2 - callback1'); return Future(() => print('event4')).then((_) => print('event4 - callback')); }).then((_) { print('event2 - callback2'); Future(() => print('event5')).then((_) => print('event5 - callback')); }).then((_) { print('event2 - callback3'); Future.microtask(() => print('microtask3')); }).then((_) { print('event2 - callback4'); }); Future(() => print('event3')); Future.sync(() => print('sync task')); Future.microtask(() => print('microtask2')).then((_) => print('microtask2 - callbak')); print('main stop'); } 执行结果: main start sync task main stop microtask1 microtask2 microtask2 - callbak event1 event1 - callback1 event1 - callback2 event2 event2 - callback1 event3 event4 event4 - callback event2 - callback2 event2 - callback3 event2 - callback4 microtask3 event5 event5 - callback delayed event 看到结果后你可能会疑惑,为什么 event1、event1 - callback1、event1 - callback2 会连续输出,而 event2 - callback1 输出后为什么是 event3,event5、event5 - callback 为什么会在 microtask3 后输出? 这里我们补充下 then 方法的一些关键知识,理解了这些,上面的输出结果也就很好理解了: then 方法中的回调并不是按照它们注册的顺序来执行。 Future 中的任务执行完毕后会立刻执行 then 方法中的回调,并且回调不会被添加到任何队列中。 如果 Future 中的任务在 then 方法调用之前已经执行完毕了,那么会有一个任务被加入到 microtask 队列中。这个任务执行的就是被传入then 方法中的回调。 2.5 catchError、whenComplete Future(() { throw 'error'; }).then((_) { print('success'); }).catchError((error) { print(error); }).whenComplete(() { print('completed'); }); 输出结果: error completed 通过 catchError 方法注册的回调,可以用来处理任务代码产生的异常。不管 Future 中的任务执行成功与否,whenComplete 方法都会被调用。 2.6 async、await 使用 async、await 能以更简洁的编写异步代码,是 Dart 提供的一个语法糖。使用 async 关键字修饰的方法返回值类型为 Future,在 async 方法内可以使用 await 关键字来修饰异步任务,在方法内部达到同步执行的效果,可以达到简化代码和提高可读性的效果,不过如果想要处理异常,需要实用 try catch 语句来包裹 await 修饰的异步任务。 void main() async { print(await getData()); } Future<int> getData() async { final a = await Future.delayed(Duration(seconds: 1), () => 1); final b = await Future.delayed(Duration(seconds: 1), () => 1); return a + b; } 3 Isolate介绍 前面讲到耗时任务不适合放到 microtask 队列或 event 队列中执行,会导致 UI 卡顿。那么在 Flutter 中有没有既可以执行耗时任务又不影响 UI 绘制呢,其实是有的,前面提到 microtask 队列和 event 队列是在 main isolate 中运行的,而 isolate 是在线程中运行的,那我们开启一个新的 isolate 就可以了,相当于开启一个新的线程,使用多线程的方式来执行任务,Flutter 也为我们提供了相应的 Api。 3.1 compute void main() async { compute<String, String>( getData, 'Alex', ).then((result) { print(result); }); } String getData(String name) { // 模拟耗时3秒 sleep(Duration(seconds: 3)); return 'Hello $name'; } compute 第一个参数是要执行的任务,第二个参数是要向任务发送的消息,需要注意的是第一个参数只支持顶层参数。使用 compute() 可以方便的执行耗时任务,但是滥用的话也会适得其反,因为每次调用,相当于新建一个 isolate。上面的代码执行一个经历了 isolate 的创建以及销毁过程,还有数据的传递会经历两次拷贝,因为 isolate 之间是完全隔离的,不能共享内存,整个过程除去任务本身的执行时间,也会非常的耗时,isolate 的创建也比较消耗内存,创建过多的 isolate 还有 OOM 的风险。这时我们就需要一个更优的解决方案,减少频繁创建销毁 isolate 所带来的消耗,最好是能创建一个类似于线程池的东西,只要提前初始化好,后面就可以随时使用,不用担心会发生前面所讲的问题,这时候 LoadBalancer 就派上用场了 3.2 LoadBalancer // 用来创建 LoadBalancer Future<LoadBalancer> loadBalancerCreator = LoadBalancer.create(2, IsolateRunner.spawn); // 全局可用的 loadBalancer late LoadBalancer loadBalancer; void main() async { // 初始化 LoadBalancer loadBalancer = await loadBalancerCreator; // 使用 LoadBalancer 执行任务 final result = await loadBalancer.run<String, String>(getData, 'Alex'); print(result); } String getData(String name) { // 模拟耗时3秒 sleep(Duration(seconds: 3)); return 'Hello $name'; } 使用 LoadBalancer.create() 方法可以创建出一个 isolate 线程池,能够指定 isolate 的数量,并自动实现了负载均衡。应用启动后在合适的时机将其初始化好,后续就有一个全局可用的 LoadBalancer 了。 4 实用经验 4.1 指定任务的执行顺序 在开发中经常会有需要连续执行异步任务的场景,例如下面的例子,后面的一步任务直接需要以来前面任务的结果,所有任务正常执行完毕才算成功。 void main() async { print(await getData()); } Future<int> getData() { final completer = Completer<int>(); int value = 0; Future(() { return 1; }).then((result1) { value += result1; return Future(() { return 2; }).then((result2) { value += result2; return Future(() { return 3; }).then((result3) { value += result3; completer.complete(value); }); }); }); return completer.future; } 这种方式出现了回调地狱,代码非常难以阅读,实际开发中还会有处理异常的代码,会显得更加臃肿,编写难度也大,显然这种方式是不建议使用的。 4.2 使用 then 的链式调用 void main() async { print(await getData()); } Future<int> getData() { int value = 0; return Future(() => 1).then((result1) { value += result1; return Future(() => 2); }).then((result2) { value += result2; return Future(() => 3); }).then((result3) { value += result3; return value; }); } 回调地狱的问题解决了,代码可读性提高很多。 4.3 使用 async、await void main() async { print(await getData()); } Future<int> getData() async { int value = 0; value += await Future(() => 1); value += await Future(() => 2); value += await Future(() => 3); return value; } 效果显而易见,代码更加清晰了。 4.4 取消任务 在前面讲到了 Dart 方法执行时是不能被中断的,这就意味着一个 Future 任务开始后必然会走到完成的状态,但是很多时候我们需要又取消一个异步任务,唯一的办法就是在任务结束后不执行回调代码,就可以实现类似取消的效果。 4.5 CancelableOperation 在 Flutter 的 async 包中,提供了一个 CancelableOperation 给我们使用,使用它可以很简单的实现取消任务的需求。 void main() async { // 创建一个可以取消的任务 final cancelableOperation = CancelableOperation.fromFuture( Future(() async { print('start'); await Future.delayed(Duration(seconds: 3)); // 模拟耗时3秒 print('end'); }), onCancel: () => print('cancel...'), ); // 注册任务结束后的回调 cancelableOperation.value.then((val) { print('finished'); }); // 模拟1秒后取消任务 Future.delayed(Duration(seconds: 1)).then((_) => cancelableOperation.cancel()); } CancelableOperation 是对 Future 的代理, 对 Future 的 then 进行了接管,判断 isCanceled 标记决定是否需要执行用户提供的回调。

优秀的个人博客,低调大师

Emojicode —— emoji 编程语言

Emojicode是一种开源的,拥有多范型的结构和流程的语言,可以让你用 Emoji 表情来编写程序。 Emojicode 允许您快速构建跨平台的应用程序同时有很多乐趣。 要求: clang 和 clang++ 6.0.1 或 gcc 和 g++ 7.2 CMake 3.5.1+ 和 Ninja LLVM 7 Python 3.5.2+ 用于测试 步骤: 克隆Emojicode(或下载源代码并解压缩)并导航到其中: git clone https://github.com/emojicode/emojicode cd emojicode 创建一个build目录并在其中运行 CMake: mkdir build cd build cmake .. -GNinja 构建编译器和包: ninja 现在可以测试 Emojicode: ninja tests 二进制文件已准备就绪,可供使用!您可以立即执行 magic installation ninja magicinstall 或者只是正确打包二进制文件和标头 ninja dist 要创建分发存档,必须自己调用 dist 脚本(例如python3 ../dist.py .. archive).

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册