首页 文章 精选 留言 我的

精选列表

搜索[计算机组成原理],共10000篇文章
优秀的个人博客,低调大师

Drill storage plugin实现原理分析

Drill Storage Plugin介绍 Drill是一个交互式SQL查询引擎,官方默认支持的数据源有hive、hbase、kafka、kudu、mongo、opentsdb、jdbc等,其中jdbc storage plugin可以覆盖所有支持jdbc协议的数据源,如:mysql、oracle等关系型数据库。所有数据源的接入都是通过drill的storage plugin实现的,理论上Drill通过storage plugin机制可以支持对任何数据源进行异构查询。 Drill作为一个SQL查询引擎,它跟传统数据库有着很多相似之处,主要包括SQL Parser、SQL Validator、Query Optimizer、Data Flow Operators等几部分。如下图所示,SQL Parser阶段会把SQL语句解析为SQL查

优秀的个人博客,低调大师

Redux中间件的原理

中间件顾名思义就是谁和谁的中间, 在图中 View在Redux会派发一个Action, Action通过Store的Dispatch方法派发给Store, Store接收到Action 连同之前State 一同传给Reducer Reducer会返回一个新的数据给Store Store然后去改变自己的State 这个是Redux的标准流程 Redux的中间件的中间是指 Action 和 Store 之间的关系 Action 只能是一个对象 派发Store 这个是在没有使用redux-thunk情况下, 在使用redux-thunk Action 可以为一个函数 所以Dispatch方法就是Action和Store的中间件 就是对Dispatch方法的封装 利用react-thunk对Dispatch方法进行封装 这时给Dispatch传入是一个对象 它会直接把这个对象传给Store 如果Dispatch传入是一个函数的话 先执行 然后会根据你传入的参数不同进行不同的事情

优秀的个人博客,低调大师

浅谈OceanBase的锁机制原理

OceanBase锁定粒度为行锁,默认情况下的隔离级别为读取已提交(read committed)。另外,读操作总是读取某个版本的快照数据,不需要加锁。 只写事务(修改单行):事务预提交时对待修改的数据行加写锁,事务提交时释放写锁。 只写事务(修改多行):事务预提交时对待修改的多个数据行加写锁,事务提交时释放写锁。为了保证一致性,采用两阶段镇的方式实现,即需要在事务预提交阶段获取所有数据行的写锁,如果获取某行写锁失败,整个事务执行失败。 读写事务(read commited):读写事务中的读操作读取某个版本的快照,写操作的加锁方式与只写事务相同。 为了保证系统并发性能,OceanBase暂时不支持更高的隔离级别。另外,为了支持对一致性要求很高的业务,OceanBase允许用户显式锁住某个数据行。例如,有一张账务表account(account_id,balance),其中account_id为主键。假设需要从A账户(account_id=1)向B账户(account_id=2)转账100元,那么,A账户需要减少100元,B账户需要增加100元,整个转账操作是一个事务,执行过程中需要防止A账户和B账户被其他事务并发修改。 如以下代码所示,OceanBase提供了”select...for update”语句用于显示锁住A账户或者B账户,防止转账过程中被其他事务并发修改。 select balance as balance_a from account where account id=1 for update; //锁住A账户 select balance as balance_b from account where account_id=2 for update; //锁住B账户 事务执行过程中可能会发生死锁,例如事务T1持有账户A的写锁并尝试获取账户B的写锁,事务T2持有账户B的写锁并尝试获取账户A的写锁,这两个事务因为循环等待而出现死锁。OceanBase目前处理死锁的方式很简单,事务执行过程中如果超过一定时间无法获取写锁,则自动回滚。

优秀的个人博客,低调大师

支持向量机原理推导(二)

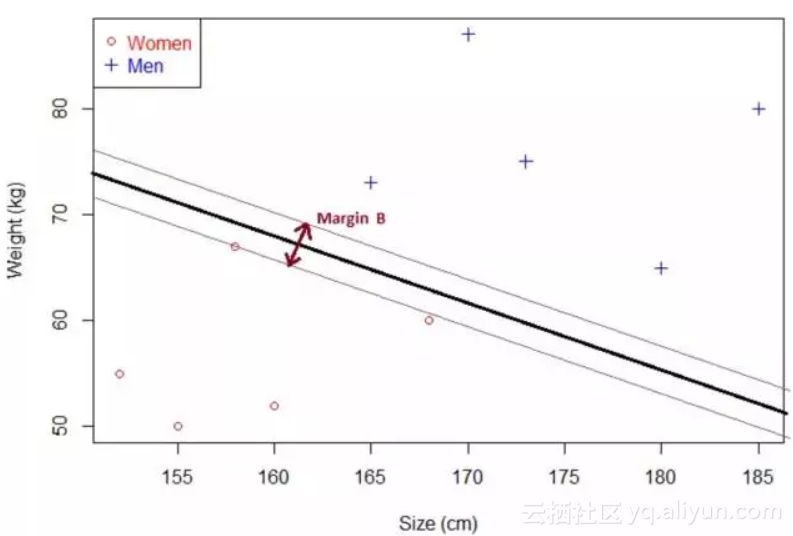
上一节我们讲述了间隔公式是如何得到的,这一节讲述要得到最大间隔时的分割超平面所要的条件是什么。 在上图中我们可以看到间隔为MarginB/2,但是我们很容易发现黑线还可以向上移动从而得到更大的间隔,当移动到是最上面红线与第一个Men数据点相交时便得到最大间隔了,如下图: 下面我们就根据这个思路求出得到最大间隔时所要满足的条件。 如上图,我们设分割超平面为g:W•X+b=0,以它为对称轴的两条线为h:W•X+b=1;f:W•X+b=-1 首先必须满足在h与f线之间没有任何数据,然后便是支持向量正好在这两条线上。即: 对于蓝色类都满足W•X+b≥1,且至少有一个点瞒住W•X+b=1; 对于红色类都满足W•X+b≤-1,且至少有一个点瞒住W•X+B=-1; 我们设蓝色类与红色类的标签分别为(1,-1),那么我们把不等式与各自对应的标签相乘便可

优秀的个人博客,低调大师

大数据技术原理与应用

推荐一个视频: http://study.163.com/course/courseMain.htm?courseId=1002887002 章节1课程介绍 课时1课程介绍06:53 章节2大数据概述 课时2大数据概述第1部分26:56 课时3大数据概述第2部分31:11 课时4大数据概述第3部分13:04 章节3大数据处理架构Hadoop 课时5大数据处理架构Hadoop第1部分26:52 课时6大数据处理架构Hadoop第2部分20:50 课时7大数据处理架构Hadoop第3部分15:14 课时8大数据处理架构Hadoop第4部分18:43 章节4分布式文件系统HDFS 课时9分布式文件系统HDFS第1部分24:43 课时10分布式文件系统HDFS第2部分20:15 课时11分布式文件系统HDFS第3部分20:19 课时12分布式文件系统HDFS第4部分21:33 章节5分布式数据库HBase 课时13分布式数据库HBase第1部分24:49 课时14分布式数据库HBase第2部分26:17 课时15分布式数据库HBase第3部分30:37 课时16分布式数据库HBase第4部分25:26 章节6NoSQL数据库 课时17NoSQL数据库第1部分23:45 课时18NoSQL数据库第2部分26:44 课时19NoSQL数据库第3部分23:09 课时20NoSQL数据库第4部分16:24 章节7云数据库 课时21云数据库第1部分21:59 课时22云数据库第2部分28:40 课时23云数据库第3部分31:04 课时24云数据库第4部分21:28 章节8MapReduce 课时25MapReduce第1部分25:11 课时26MapReduce第2部分28:17 课时27MapReduce第3部分26:35 课时28MapReduce第4部分19:40 章节9基于Hadoop的数据仓库Hive 课时29基于Hadoop的数据仓库Hive第1部分29:10 课时30基于Hadoop的数据仓库Hive第2部分25:56 课时31基于Hadoop的数据仓库Hive第3部分23:30 课时32基于Hadoop的数据仓库Hive第4部分25:17 章节10Hadoop架构再探讨 课时33Hadoop架构再探讨第1部分28:32 课时34Hadoop架构再探讨第2部分25:58 课时35Hadoop架构再探讨第3部分21:39 课时36Hadoop架构再探讨第4部分35:39 章节11Spark 课时37Spark第1部分30:15 课时38Spark第2部分31:38 课时39Spark第3部分35:53 课时40Spark第4部分26:05 章节12流计算 课时41流计算第1部分30:17 课时42流计算第2部分35:36 课时43流计算第3部分33:41 课时44流计算第4部分26:43 章节13图计算 课时45图计算第1部分28:51 课时46图计算第2部分35:38 课时47图计算第3部分34:47 课时48图计算第4部分30:30 章节14大数据在不同领域的应用 课时49大数据在不同领域的应用第1部分22:41 课时50大数据在不同领域的应用第2部分24:09 课时51大数据在不同领域的应用第3部分25:09 章节15附录:大数据在线课程建设团队风采 课时52附录:大数据在线课程建设团队风

优秀的个人博客,低调大师

ZABBIX实现原理及架构详解

ZABBIX是完全开源的工具,整合了CACTI和NAGIOS等特性。 zabbix功能很强大,如何理解zabbix的功能,我们可以和cacti、nagios的功能对比一下: cacti是一款数据采集,数据存储,外加web界面展示的工具,它负责阈值范围内的实时变化,但是对超过阈值的告警功能很薄弱 优点:实时监控数据变化,以web页面的方式呈现,更直观。 缺点:告警不及时 nagios是一款告警功能很强大的工具,它不关心阈值范围内的变化,只关心状态变化(超过阈值),然后报警。报警方式通过邮件,短信等。 优点:告警反映迅速。 缺点:监控主机数量有限,承载低 zabbix = cacti + nagios 优点:基于两款工具优点于一身并更强大,实现企业级分布式监控。 缺点:2.2版本带宽占用大但是升级到2.4版本后更节省了带宽资源,其它再无发现。 zabbix监控功能的实现 监控主机zabbix有专用的agent,可以监控Linux,Windows等 监控网络设备zabbix通过SNMP,ssh(不多用) 可监控对象 设备:服务器,路由器,交换机 软件:OS,网络,应用程序 主机性能指标监控 故障监控: down机,服务不可用,主机不可达 支持数据库存储类型 abbix-database: MySQL, PGSQL(postgreSQL)、Oracle、DB2、SQLite Zabbix架构中的组件 zabbix-server: C语言 zabbix-agent: C语言 zabbix-web:GUI,用于实现zabbix设定和展示,PHP开发 zabbix-proxy: 分布式监控环境中的专用组件 监控流程 一个监控系统运行的大概的流程是这样的: agentd需要安装到被监控的主机上,它负责定期收集各项数据,并发送到zabbix server端,zabbix server将数据存储到数据库中,zabbix web根据数据在前端进行展现和绘图。这里agentd收集数据分为主动和被动两种模式: 主动:agent请求server获取主动的监控项列表,并主动将监控项内需要检测的数据提交给server/proxy 被动:server向agent请求获取监控项的数据,agent返回数据。 【主动监测】通信过程如下: zabbix首先向ServerActive配置的IP请求获取active items,获取并提交active tiems数据值server或者proxy。很多人会提出疑问:zabbix多久获取一次active items?它会根据配置文件中的RefreshActiveChecks的频率进行,如果获取失败,那么将会在60秒之后重试。分两个部分: 获取ACTIVE ITEMS列表 Agent打开TCP连接(主动检测变成Agent打开) Agent请求items检测列表 Server返回items列表 Agent 处理响应 关闭TCP连接 Agent开始收集数据 主动检测提交数据过程如下: Agent建立TCP连接 Agent提交items列表收集的数据 Server处理数据,并返回响应状态 关闭TCP连接 【被动监测】通信过程如下: Server打开一个TCP连接 Server发送请求agent.ping\n Agent接收到请求并且响应<HEADER><DATALEN>1 Server处理接收到的数据1 关闭TCP连接 这里,被动模式每次都需要打开一个tcp连接,这样当监控项越来越多时,就会出现server端性能问题了。 那实际监控中是用主动的还是被动的呢?这里主要涉及两个地方: 1、新建监控项目时,选择的是zabbix代理还是zabbix端点代理程式(主动式),前者是被动模式,后者是主动模式。 2、agentd配置文件中StartAgents参数的设置,如果为0,表示禁止被动模式,否则开启。一般建议不要设置为0,因为监控项目很多时,可以部分使用主动,部分使用被动模式。 常用的监控架构平台 1、server-agentd模式: 这个是最简单的架构了,常用于监控主机比较少的情况下。 2、server-proxy-agentd模式: 这个常用于比较多的机器,使用proxy进行分布式监控,有效的减轻server端的压力。 下图描述了上述两种方式: Zabbix逻辑架构 定义一个template模板,里面包括多个items,trigger,graphs套用给host或者hostgroups。 server监控项目items通过zabbix poller进程(可以有多个进程实现并发处理)包括snmp,agent协议收集被监控主机信息。 如果阈值超过triggers触发器规定,就是形成一个events事件,然后actions处理动作(包括运行预先定制的脚本,不成功发送email或SMS)。 在服务器升级的时候提前设定maintenance维护模式不对服务器产生告警通知。通过逻辑拓扑图展示工作流程 Zabbix Server启动后都有那些进程? 本文转自 dengaosky 51CTO博客,原文链接:http://blog.51cto.com/dengaosky/1963871,如需转载请自行联系原作者

优秀的个人博客,低调大师

android基础进度条原理

下面详细介绍ProgressBar 一、说明 在某些操作的进度中的可视指示器,为用户呈现操作的进度,还它有一个次要的进度条,用来显示中间进度,如在流媒体播放的缓冲区的进度。一个进度条也可不确定其进度。在不确定模式下,进度条显示循环动画。这种模式常用于应用程序使用任务的长度是未知的。 二、XML重要属性 android:progressBarStyle:默认进度条样式 android:progressBarStyleHorizontal:水平样式 三、重要方法 getMax():返回这个进度条的范围的上限 getProgress():返回进度 getSecondaryProgress():返回次要进度 incrementProgressBy(int diff):指定增加的进度 isIndeterminate():指示进度条是否在不确定模式下 setIndeterminate(boolean indeterminate):设置不确定模式下 setVisibility(int v):设置该进度条是否可视 四、重要事件 onSizeChanged(int w, int h, int oldw, int oldh):当进度值改变时引发此事件 看一下实现代码 packagecom.smart; importjava.util.Timer; importjava.util.TimerTask; importandroid.app.Activity; importandroid.os.Bundle; importandroid.os.Handler; importandroid.os.Message; importandroid.widget.ProgressBar; publicclassMainextendsActivity{ privateProgressBarprogressBar; privateHandlerhandler=newHandler(){ publicvoidhandleMessage(Messagemsg){ switch(msg.what){ case1: intcurrentProgress=progressBar.getProgress()+2; if(currentProgress>progressBar.getMax()) currentProgress=0;//断送进度条 progressBar.setProgress(currentProgress);//显示进度条进度 break; } super.handleMessage(msg); } }; privateTimerTasktimerTask=newTimerTask(){ //信息 @Override publicvoidrun(){ Messagemessage=newMessage(); message.what=1; handler.sendMessage(message); } }; @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); setContentView(R.layout.main); progressBar=(ProgressBar)findViewById(R.id.progressbar); Timertimer=newTimer(); timer.schedule(timerTask,0,500); //第二个参数为:从0开始,第三个参数为:它的速度,越大越慢,越小越快。 } } main.xml文件 <?xmlversion="1.0"encoding="utf-8"?> <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:orientation="vertical" android:layout_width="fill_parent" android:layout_height="fill_parent" > <ProgressBar android:id="@+id/progressbar" android:layout_width="fill_parent" android:layout_height="wrap_content" android:layout_marginTop="20dp" android:max="100" style="?android:attr/progressBarStyleHorizontal" /> </LinearLayout> 本文转自 llb988 51CTO博客,原文链接:http://blog.51cto.com/llb988/510427,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop 之 NameNode 元数据原理

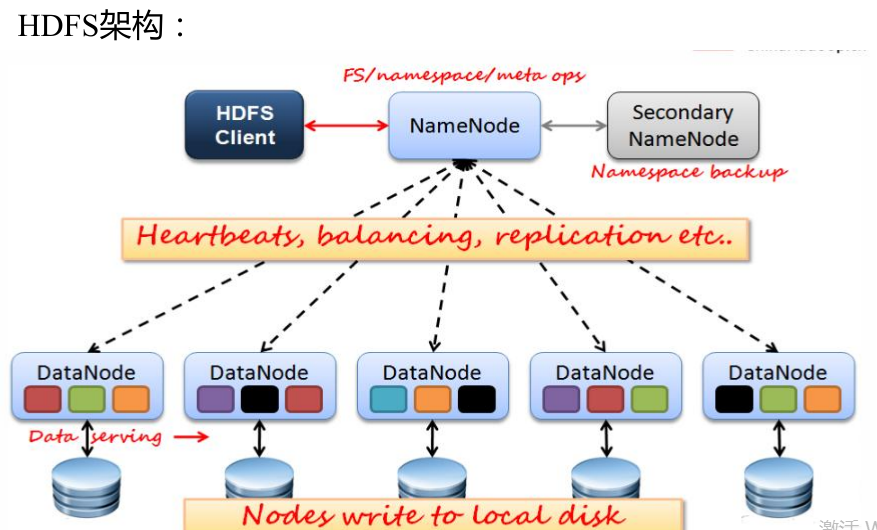
在对NameNode节点进行格式化时,调用了FSImage的saveFSImage()方法和FSEditLog.createEditLogFile()存储当前的元数据。Namenode主要维护两个文件,一个是fsimage,一个是editlog。 fsimage :保存了最新的元数据检查点,包含了整个HDFS文件系统的所有目录和文件的信息。对于文件来说包括了数据块描述信息、修改时间、访问时间等;对于目录来说包括修改时间、访问权限控制信息(目录所属用户,所在组)等。简单的说,Fsimage就是在某一时刻,整个hdfs 的快照,就是这个时刻hdfs上所有的文件块和目录,分别的状态,位于哪些个datanode,各自的权限,各自的副本个数等。 注意:Block的位置信息不会保存到fsimage,Block保存在哪个DataNode(由DataNode启动时上报)。 editlog :主要是在NameNode已经启动情况下对HDFS进行的各种更新操作进行记录,HDFS客户端执行所有的写操作都会被记录到editlog中。 读取元数据: 启动NameNode节点时,又要从镜像和编辑日志中读取元数据。 写入元数据: 在NameNode运行时会将内存中的元数据信息存储到所指定的文件,即${dfs.name.dir}/current目录下的fsimage文件,此外还会将另外一部分对NameNode更改的日志信息存储到${dfs.name.dir}/current目录下的edits文件中。fsimage文件和edits文件可以确定NameNode节点当前的状态,这样在NameNode节点由于突发原因崩溃时,可以根据这两个文件中的内容恢复到节点崩溃前的状态,所以对NameNode节点中内存元数据的每次修改都必须保存下来。但是如果每次都保存到fsimage文件中,这样效率就特别低效,所以引入编辑日志文件edits,保存对对元数据的修改信息,也就是fsimage文件保存NameNode节点中某一时刻内存中的元数据(即目录树),edits保存这一时刻之后的对元数据的更改信息。 镜像的保存: SecondaryNameNode:主要由两个作用,一是镜像备份(不是NN的备份,但可以做备份),二是日志与镜像的定期合并。 第一步:将hdfs更新记录写入一个新的文件——edits.new。 第二步:将fsimage和editlog通过http协议发送至secondary namenode。 第三步:将fsimage与editlog合并,生成一个新的文件——fsimage.ckpt。这步之所以要在secondary namenode中进行,是因为比较耗时,如果在namenode中进行,或导致整个系统卡顿。 第四步:将生成的fsimage.ckpt通过http协议发送至namenode。 第五步:重命名fsimage.ckpt为fsimage,edits.new为edits。 第六步:等待下一次checkpoint触发SecondaryNameNode进行工作,一直这样循环操作。 注:checkpoint触发的条件可以在core-site.xml文件中进行配置。fs.checkpoint.period表示多长时间记录一次hdfs的镜像。默认是1小时。fs.checkpoint.size表示一次记录多大的size,默认64M。例如如下: <property> <name>fs.checkpoint.period</name> <value>3600</value> <description>The number of seconds between two periodic checkpoints. </description> </property> <property> <name>fs.checkpoint.size</name> <value>67108864</value> <description>The size of the current edit log (in bytes) that triggers a periodic checkpoint even if the fs.checkpoint.period hasn't expired. </description> </property> 文章可以转载,必须以链接形式标明出处。 本文转自 张冲andy 博客园博客,原文链接:http://www.cnblogs.com/andy6/p/7353092.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

lvs之 lvs原理架构介绍

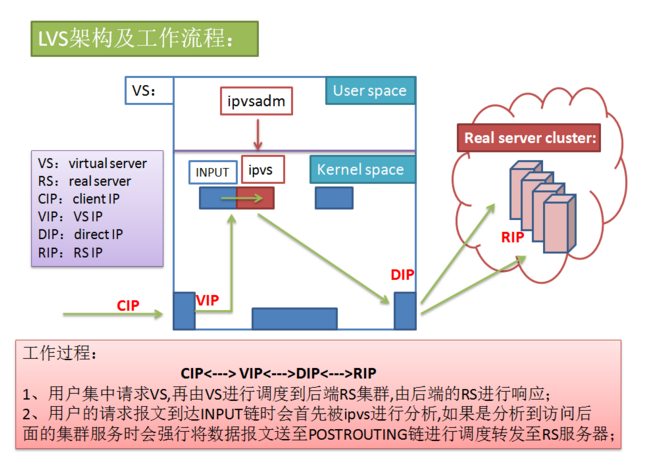
一、 概念 lvs的术语: Router:GWIP vs:virtual server,director rs:real server CIP:client IP VIP:virtual server IP DIP:ditecter IP(connect with rs) RIP:real server IP 用户请求的IP一定是VIP,否则vs就失去了负载均衡的调度意义 LVS方式的cluster从结构上可分为两部分:前端的负载均衡器(称之为director)和后端的真实服务器(称之为real server)。cluster前端的director将来自外界的请求调度到cluster后端不同的real server去执行。real server负责真正的提供各种应用服务,比如:Web、FTP、Mail等服务。real server的数量可以根据实际需求进行增加、减少。 二、lvs的工作过程 三、lvs的类型 lvs有三种通用标准模型 (1)lvs-nat (网络地址映射) (2)lvs-dr (直接路由) (3)lvs-tun (IP隧道) 3.1、 LVS NAT的特性(实质是多目标的DNAT): 1、RS应该使用私有地址; 2、RS的网关的必须指向DIP; 3、RIP和DIP必须在同一网段内; 4、请求和响应的报文都得经过Director;在高负载场景中,Director很可能成为系统性能瓶颈; 5、支持端口映射; 6、RS可以使用任意支持集群服务的OS; lvs-nat:工作流程如图: 3.2、 LVS DR类型的特性: 1、RS可以使用私有地址;但也可以使用公网地址,此时可以直接通过互联网连入RS以实现配置、监控等; 2、RS的网关一定不能指向DIP; 3、RS跟Dirctory要在同一物理网络内(不能由路由器分隔,因为VS通过封装MAC地址到RS); 4、请求报文经过Directory,但响应报文一定不经过Director 5、不支持端口映射; 6、RS可以使用大多数的操作系统; 由于DR类型中,VS、RS的VIP都是一样,如果在同一网段内会造成地址冲突,因此要解决地址冲突有一下三种方法: 禁止RS响应对VIP的ARP广播请求: 1、在前端路由上实现静态MAC地址VIP的绑定; 前提:得有路由器的配置权限; 缺点:Directory故障转时,无法更新此绑定; 2、arptables 前提:在各RS在安装arptables程序,并编写arptables规则 缺点:依赖于独特功能的应用程序 3、修改Linux内核参数 前提:RS必须是Linux; 缺点:适用性差; 两个参数: arp_announce:定义通告模式 arp_ignore:定义收到arp请求的时响应模式 配置专用路由,以使得响应报文首先通过vip所配置的lo上的别名接口 lvs-dr:工作流程如图 3.2、 lvs-tun:IP隧道 1、RIP、DIP、VIP都得是公网地址; 2、RS的网关不会指向也不可能指向DIP; 3、请求报文经过Directory,但响应报文一定不经过Director; 4、不支持端口映射; 5、RS的OS必须得支持隧道功能; lvs-tun:工作流程如图:也是基于lvs-dr的模型,只不过不同的是,rs和vs不必在同一个物理的网络(实现物理冗余),而是通过隧道技术进行vs和rs间的通信 四、 lvs十个调度算法:rr、wrr、lc、wlc、lblc、lblcr、dh、sh、sed、nq 1.轮叫调度(Round Robin)(简称rr) 2.加权轮叫(Weighted Round Robin)(简称wrr) 3.最少链接(Least Connections)(LC) 4.加权最少链接(Weighted Least Connections)(WLC) 5.基于局部性的最少链接(Locality-Based Least Connections)(LBLC) 6.带复制的基于局部性最少链接(Locality-Based Least Connections with Replication)(LBLCR) 7.目标地址散列(Destination Hashing)(DH) 8.源地址散列(Source Hashing)(SH) 9. 最短的期望的延迟(Shortest Expected Delay Scheduling SED)(SED) 10.最少队列调度(Never Queue Scheduling NQ)(NQ) 最常用的两个算法介绍: 2.加权轮叫(Weighted Round Robin)(简称wrr) 调度器通过“加权轮叫”调度算法根据真实服务器的不同处理能力来调度访问请求。这样可以保证处理能力强的服务器能处理更多的访问流量。调度器可以自动问询真实服务器的负载情况,并动态地调整其权值。 4.加权最少链接(Weighted Least Connections)(WLC) 在集群系统中的服务器性能差异较大的情况下,调度器采用“加权最少链接”调度算法优化负载均衡性能,具有较高权值的服务器将承受较大比例的活动连接负载。调度器可以自动问询真实服务器的负载情况,并动态地调整其权值。 说明: 部分参考http://6638225.blog.51cto.com/6628225/1866241 感谢作者。 文章可以转载,必须以链接形式标明出处。 本文转自 张冲andy 博客园博客,原文链接: http://www.cnblogs.com/andy6/p/7017155.html ,如需转载请自行联系原作者

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册