首页 文章 精选 留言 我的

精选列表

搜索[数据库知识开放麦],共10000篇文章
优秀的个人博客,低调大师

JVM知识点扫盲系列(1)

每次young gc的时间,和eden空间的大小是正比关系吗? 在进入公司之后,这个问题先后被多次问到,那young gc的时间到底和哪些因素有关呢? 来看一段代码,逻辑很简单,不断的分配1M的大小,直到触发YGC。 // -Xmx2g -Xms2g -Xmn500m -XX:+PrintGCDetails // -XX:+UseConcMarkSweepGC -XX:+PrintHeapAtGC public class GcCase { public static void main(String[] args) { for (int i = 0; i < 1000; i++) { allocate_1M(); } } public static void allocate_1M() { byte[] _1M = new byte[1024 * 1000]; } } 这里设置了新生代的大小是500m,按照8:1:1的比例,eden的大小应该是400m。我们可以大概梳理一下: 1、每次分配1M,分配到第400次时,eden被1M的内存块塞满了 2、为了能够塞下后面的数据的,只能触发一次YGC 3、执行YGC之前,必须等所有的业务线程全部挂起,这个点就是所谓的安全点(safepoint),从这一刻开始,JVM是冻结的,只有虚拟机线程才能执行,也是从这一刻开始计时。 一次YGC过程大概包括下面几个步骤,每个步骤的耗时之和,也就是整个YGC的耗时。 1、找出所有可能存活的对象,一个也不能少,这是标记过程的耗时。 从GC Roots开始,遍历对象,所有能遍历到的对象都是算是存活对象,打上一个标记。正常情况下,需要的关心的GC Roots包括下面几个:类的静态引用、业务线程进入安全点时,正在执行方法中的引用类型变量(包含参数)、部分老年代的对象(持有引用执行新生代对象),还有其它不需要太关注的,比如VM内部的数据结构。 2、存活对象被标记出来之后,需要把这些对象从eden区或者from区,复制到to区,这个复制过程的耗时,和存活对象的大小数量有很大的关系。这是复制过程的耗时。 3、如果开启了GC日志-XX:+PrintGCDetails,那么在YGC过程中,还会记录一些数据到日志中,这个日志的写入过程,也有可能被影响,这段时间也算YGC的耗时。 所以,young gc的时间,和eden空间的大小是正比关系吗? 答案是没有多大关系。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:744677563 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

Spring Boot零散知识总结

一、@Value与@ConfigurationProperties @Value 与 @ConfigurationProperties 都可以用于配置文件与 JavaBean 中的属性映射,主要有以下区别 对比项@ConfigurationProperties@Value作用批量注入配置文件中的属性单个指定配置文件中的属性松散语法(userName->user-name)支持不支持SpEl表达式不支持支持JSR303数据校验支持不支持复杂的数据类型(map)支持不支持 @ConfigurationProperties:一般用于配置文件与 JavaBean 的映射 @Value:一般用于与某个值的映射 二、@ImportResource与@PropertySource @ImportResource:因为 Spring Boot 项目默认是没有 Spring 配置文件的,可以使用这个注解引入自定义的 Spring 配置文件。 注意:加在入口类上才会生效,例如:@ImportResource(locations = {"classpath:spring-bean.xml"})。因为 Spring Boot 本身就是为了简化配置的,因此一般使用注解的形式来代替这种配置文件的形式,来注入 Bean。 @PropertySource:指定全局配置文件的路径,从而完成配置文件与 JavaBean 属性的映射。例如:@PropertySource(value = {"classpath:person.properties"})。 三、Spring Boot 全局配置文件路径设置 Spring boot 默认会扫描 application.properties 或者 application.yml 配置文件,自动扫描的路径有以下 4 个: 按照优先级排序为:file/config/,file/,classpath/config/,classpath/,高优先级会覆盖低优先级的配置文件。采用的覆盖非失效覆盖,而是通过覆盖实现互补配置。 项目发布的时候,还可以通过命令参数 spring.config.location= 设置配置文件的路径。在项目启动时候行动态的设置。 欢迎加入Java高级架构学习交流群:375989619 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导 进群修改群备注:开发年限-地区-经验 方便架构师解答问题 免费领取架构师全套视频!!!!!!!!

优秀的个人博客,低调大师

Python函数、对象几个知识点

函数 一、参数 Python的函数参数可以定义默认值,当调用者没有提供参数时,函数在执行过程中用默认值设置该参数。 有默认值的参数必须声明在没有默认值的参数之后,例: def sum(x, y = 10): return x + y 除了按参数的声明顺序传递参数,还可以不按顺序传递命名参数,例: def sum(x, y, z) return x+y+z if __name__ == "__main__": #如下两种调用方式意义相同 sum(1,2,3) sum(z = 3, y = 2 ,x = 1) 二、变长参数 变长参数的函数:参数个数可变,类型不定的函数。 元组变长参数(*args):适用于参数数量不固定,在函数中使用这些参数时无需知道参数的名字与场合。 字典变长参数(**args):适用于参数数量不固定,在函数时使用这些参数时需要知道参数名字与场合。 #元组变长参数 def demo(message, *tupleName): for name in tupleName: print(message,name) if __name__ == "__main__": demo("Good morning","A","B","C","D") 运行结果: Good morning A Good morning B Good morning C Good morning D #字典变长参数 def check_book(**kwargs): print([k for k in kwargs]) c_dict = {'A':'jianshu', 'C':'简书', 'price':1000} check_book(**c_dict) 运行结果: ['A', 'price', 'C'] 对象 一、类(class):类定义了事物的属性和它可以做到的行为。 类中 成员变量 = 属性 类中 成员函数 = 方法 二、对象(object):是类的实例。 对象指的是类的实例 类是创建对象的模板 创建对象的过程也叫做类的实例化 class MyClass(object): """ message:成员变量 赋初值 show(self):成员函数,必须要带参数self """ message = "Hello World" def show(self): print(self.message) 参数self是对象本身的引用,在成员函数体中可以引用self参数获得对象信息. 通过在类名后边加小括号可以直接实例化类来获得对象变量,使用对象变量可以访问累的成员函数和成员变量。 重点: Python中直接在类作用域中定义的成员变量相当于C、C++中的静态成员变量,即可以通过类名访问MyClass.message,也可以通过对象访问inst = MyClass(), inst.message,因此,类和所有该类的对象共享同一个成员变量。 三、构造函数 构造函数是一种特殊的类成员方法,主要用来创建对象时初始化对象,即为对象的成员变量赋初值。__init__。构造函数中不能有返回值。 四、析构函数 析构函数是构造函数的反函数,在销毁(释放)对象时调用它们。定义一个名为__del__的没有返回值和参数的函数。 五、实例成员变量 在之前的例子,MyClass类中成员变量message是类成员变量,即MyClass类和所有MyClass对象共享该成员变量。 问:如何定义属于每个对象自己的成员变量呢? 答:是在构造函数中定义self引用中的变量,这样的成员变量叫做实例成员变量。 class MyClass(object): message = "Hello World" def __init__(self,name = "Allen", color="black"): print(name, color) self.name = name self.color = color def show(self): print(self.message) print(self.name, self.color) def __del__(self): print("Destructor is called for %s" % self.name) inst = MyClass("ZHAO") inst.show() print(inst.color) 运行结果: ZHAO black Hello World ZHAO black black Destructor is called for ZHAO 六、静态函数和类函数 之前在本文中接触到的类成员函数均与实例绑定,只能通过对象访问而不能通过类名访问。 Python中支持两种基于类名访问成员函数: 静态函数 @staticmethod 类函数 @classmethod 他们不同点是,类函数有一个隐形参数cls可以用来获取类信息,而静态函数没有。 class MyClass(object): message = "Hello World" def __init__(self,name = "Allen", color="black"): print(name, color) self.name = name self.color = color def show(self): print(self.message) print(self.name, self.color) @staticmethod def printMessage(): print(MyClass.message) @classmethod def createdObj(cls, name, color): print(cls.__name__, name, color) return cls(name, color) def __del__(self): print("Destructor is called for %s" % self.name) MyClass.printMessage() inst = MyClass.createdObj("Mary", "red") print(inst.message) 运行结果: Hello World MyClass Mary red Mary red Hello World Destructor is called for Mary 在上述代码中,定义了静态函数printMessage(),在其中可以访问类成员变量MyClass.message,可以通过类名进行调用; 代码中还定义了类方法createdObj(),类方法定义中的第一个参数必须为隐形参数cls,在createdObj()中可以通过隐形参数cls替代类名本身,本例中的createdObj()建立并返回了一个MyClass实例. 七、私有成员 封装性是面向对象的重要特点,Python也提供了将不希望外部看到的成员隐藏起来的私有成员机制。但不想大多数编程语言用Public 、Private关键字表达可见范围的方法,Python使用指定变量名格式的方法定义私有成员。以双下滑想开头即为私有成员变量。

优秀的个人博客,低调大师

php中mysql操作的buffer知识

php与mysql的连接有三种方式,mysql,mysqli,pdo。不管使用哪种方式进行连接,都有使用buffer和不使用buffer的区别。 什么叫使用buffer和不使用buffer呢? 客户端与mysql服务端进行查询操作,查询操作的时候如果获取的数据量比较大,那个这个查询结果放在哪里呢? 有两个地方可以放:客户端的缓冲区和服务端的缓冲区。 我们这里说的buffer指的是客户端的缓冲区,如果查询结果已经从服务端获取回来了,放置在了客户端的缓冲区,我们就称之为使用buffer。如果还是存放在服务端的缓冲区的话,我们就说没有使用buffer(unbuffer)。 使用buffer和不使用buffer有什么区别? 主要在内存方面,使用buffer会增加客户端的内存压力,当返回的数据结果特别大的时候可能会占用调用客户端(实际就是一个php进程)比较大的进程。不使用buffer自然对服务端(这里说的是提供mysql服务的服务器)压力更大。 具体可以参考:PHP查询MySQL大量数据的内存占用分析 php中三种模式是如何设置是否使用buffer的? mysql默认的query是使用buffer的,而不使用buffer就需要使用mysql_unbuffer_query mysqli默认的query是不使用buffer的,要使用buffer就需要设置MYSQLI_STORE_RESULT pdo默认的quey是不使用buffer的,要使用buffer就需要设置MYSQL_ATTR_USE_BUFFERED_QUERY 大致相关代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 <?php $dbConfig = array ( 'host' => '10.128.11.101' , 'port' => '3306' , 'user' => 'test' , 'pass' => 'test' , 'db' => 'test' , ); $sql = 'select * from so_topic_app' ; //---------mysql----------// $db = mysql_connect( $dbConfig [ 'host' ], $dbConfig [ 'user' ], $dbConfig [ 'pass' ]); mysql_select_db( $dbConfig [ 'db' ], $db ); mysql_set_charset( 'utf8' , $db ); // mysql使用buffer $res = mysql_query( $sql , $db ); $data = array (); while ( $row = mysql_fetch_row( $res )) { $data [] = $row ; } // mysql不使用buffer $res = mysql_unbuffered_query( $sql , $db ); $data = array (); while ( $row = mysql_fetch_row( $res )) { $data [] = $row ; } mysql_close( $db ); //---------mysqli----------// $db = mysqli_connect( $dbConfig [ 'host' ], $dbConfig [ 'user' ], $dbConfig [ 'pass' ], $dbConfig [ 'db' ]); // mysqli不使用buffer $result = mysqli_query( $db , $sql ); $data = array (); while ( $row = $result ->fetch_array()) { $data [] = $row ; } // mysqli使用buffer $result = mysqli_query( $db , $sql , MYSQLI_STORE_RESULT); $data = array (); while ( $row = $result ->fetch_array()) { $data [] = $row ; } mysqli_free_result( $result ); mysqli_close( $db ); //---------pdo----------// $dsn = "mysql:dbname={$dbConfig['db']};host={$dbConfig['host']}" ; $pdo = new PDO( $dsn , $dbConfig [ 'user' ], $dbConfig [ 'pass' ]); // pdo不使用buffer $stmt = $pdo ->prepare( $sql ); $stmt ->execute(); $data = array (); $data = $stmt ->fetchAll(); // pdo使用buffer $pdo ->setAttribute(PDO::MYSQL_ATTR_USE_BUFFERED_QUERY, true); $stmt = $pdo ->prepare( $sql ); $stmt ->execute(); $data = array (); $data = $stmt ->fetchAll(); 后续 当然如果数据量非常大的话,大部分人还是会考虑使用分批次来提取和处理数据。所以实际上需要我们关注和使用mysql是使用buffer还是不使用buffer的场景非常少。 本文转自轩脉刃博客园博客,原文链接:http://www.cnblogs.com/yjf512/p/3431481.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

swift:入门知识之协议与扩展

swift中使用protocol声明一个协议接口 swift中类、枚举和结构体都可以实现协议接口 swift中类中的方法都可以修改成员变量的值 swift中结构体中的方法默认是不能修改成员变量的,添加mutating关键字后就可以修改了 swift中使用extension来为现有的类型添加功能。你可以使用扩展来给任意类型添加协议,甚至是你从外部库或者框架中导入的类型 swift中协议接口的委托代理模式和Objective-C基本上是一样的,都是主方设置一个代理人,然后将事情的处理委托给这个代理人去办,而主方自己只需要声明协议的规则即可。记住,代理人必须按照主方设定的规则去处理这些需要做的事情。不管代理人是谁,只要遵从协议就可以成为主方的委托者。 Swift 中的扩展可以: 1. 添加计算型属性和计算静态属性 2. 定义实例方法和类型方法 3. 提供新的构造器 4. 定义下标 5. 定义和使用新的嵌套类型 6. 使一个已有类型符合某个接口 具体举例如下: //声明一个ExampleProtocol协议,有一个成员变量和一个默认必须实现的方法 //声明一个协议 protocol ExampleProtocol{ //声明一个成员变量,并设置一个getter方法 var simpleDescription:String{get} mutating func adjust() } //定义一个SimpleClass类继承ExampleProtocol协议 //定义一个类继承协议 class SimpleClass: ExampleProtocol { var simpleDescription:String = "A very simple class" func adjust() { simpleDescription += " adjust" } } var simpleclass = SimpleClass() //创建对象 simpleclass.adjust() //实现下一中的必须实现的方法 simpleclass.simpleDescription //用get方法获取属性值 "A very simple class adjust" //定义一个SimpleStruct结构体继承ExampleProtocol协议 //定义一个结构体继承协议 struct SimpleStruct:ExampleProtocol { var simpleDescription:String = "A very simple struct" //必须用关键词mutating修饰,才能修改属性值 mutating func adjust() { simpleDescription += "struct" } } var simplestruct = SimpleStruct() //创建结构体成员变量 simplestruct.adjust() //实现下一中的必须实现的方法 simplestruct.simpleDescription //用get方法获取属性值 "A very simple structstruct --------------------------------------------------------------------------------------------------------- //声明一个Myprotocol协议,有一个成员变量和一个默认必须实现的方法,还有一个可选的方法 //定义一个有可选方法的协议 @objc protocol MyProtocol{ //声明一个成员变量,并设置一个getter和setter方法 var contentDescription:String {get set} func method() //可选的方法 optional func adjust() } //定义一个Boy类继承Myprotocol这个协议 class Boy:MyProtocol{ var contentDescription:String = "he is a boy" //实现可选的方法 func method() { contentDescription += ",good dood study" } //实现必须实现的方法 func adjust(){ contentDescription += ",okay" } } let boy = Boy() boy.contentDescription = "Tom" //set方法赋值 boy.method() //实现必须实现的方法 boy.adjust() //实现可选的方法 boy.contentDescription //get方法取值 "Tom ,good good study,okay" --------------------------------------------------------------------------------------------------------- //定义一个扩展继承ExampleProtocol协议 //定义一个类扩展 extension Int:ExampleProtocol{ var simpleDescription:String{ return "The number \(self)" } mutating func adjust(){ self += 24 } } 7.simpleDescription // 7 //自定义一个扩展 程序猿神奇的手,每时每刻,这双手都在改变着世界的交互方式! 分类: Swift开发技术 本文转自当天真遇到现实博客园博客,原文链接: http://www.cnblogs.com/XYQ-208910/p/4905128.html如需转载请自行联系原作者

优秀的个人博客,低调大师

Android音频开发(1):基础知识

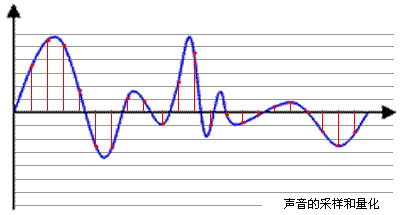
先来点闲言碎语,前段时间我有一段感悟:Android开发,本身并不是一个可以走得多远的方向,它只是一个平台,提供了许多封装好的API,让大家能够快速开发出针对特定业务的应用。 真正有价值的地方就在于Android与具体的业务方向结合,比如:Android与音视频技术,Android与智能硬件交互,Android与前端技术的融合与探索,Android信息安全,Android源码深度定制等等。 我一直比较看好音视频/多媒体方向,希望在此能够深入积累和探索,前段时间我发布了一款Android VoIP网络电话应用“飞鸽电话”,并写了一篇分析其整体架构的文章《PigeonCall:一款Android VoIP网络电话App架构分析》,欢迎有兴趣的小伙伴们先看一看。 在这个应用的开发过程中学到的东西还蛮多的,因此想写一些文章分享分享,本文作为开篇,主要以问答的形式,介绍一些音频开发的基础常识,非常重要,因为不了解这些常识,很多Android API或者第三方库的参数,你都不知道该怎么配置。 1. 音频开发的主要应用有哪些? 音频播放器,录音机,语音电话,音视频监控应用,音视频直播应用,音频编辑/处理软件,蓝牙耳机/音箱,等等。 2. 音频开发的具体内容有哪些? (1)音频采集/播放 (2)音频算法处理(去噪、静音检测、回声消除、音效处理、功放/增强、混音/分离,等等) (3)音频的编解码和格式转换 (4)音频传输协议的开发(SIP,A2DP、AVRCP,等等) 3. 音频应用的难点在哪? 延时敏感、卡顿敏感、噪声抑制(Denoise)、回声消除(AEC)、静音检测(VAD)、混音算法,等等。 4. 音频开发基础概念有哪些? 在音频开发中,下面的这几个概念经常会遇到。 (1) 采样率(samplerate) 采样就是把模拟信号数字化的过程,不仅仅是音频需要采样,所有的模拟信号都需要通过采样转换为可以用0101来表示的数字信号,示意图如下所示: 蓝色代表模拟音频信号,红色的点代表采样得到的量化数值。 采样频率越高,红色的间隔就越密集,记录这一段音频信号所用的数据量就越大,同时音频质量也就越高。 根据奈奎斯特理论,采样频率只要不低于音频信号最高频率的两倍,就可以无损失地还原原始的声音。 通常人耳能听到频率范围大约在20Hz~20kHz之间的声音,为了保证声音不失真,采样频率应在40kHz以上。常用的音频采样频率有:8kHz、11.025kHz、22.05kHz、16kHz、37.8kHz、44.1kHz、48kHz、96kHz、192kHz等。 (2) 量化精度(位宽) 上图中,每一个红色的采样点,都需要用一个数值来表示大小,这个数值的数据类型大小可以是:4bit、8bit、16bit、32bit等等,位数越多,表示得就越精细,声音质量自然就越好,当然,数据量也会成倍增大。 常见的位宽是:8bit 或者 16bit (3) 声道数(channels) 由于音频的采集和播放是可以叠加的,因此,可以同时从多个音频源采集声音,并分别输出到不同的扬声器,故声道数一般表示声音录制时的音源数量或回放时相应的扬声器数量。 单声道(Mono)和双声道(Stereo)比较常见,顾名思义,前者的声道数为1,后者为2 (4) 音频帧(frame) 这个概念在应用开发中非常重要,网上很多文章都没有专门介绍这个概念。 音频跟视频很不一样,视频每一帧就是一张图像,而从上面的正玄波可以看出,音频数据是流式的,本身没有明确的一帧帧的概念,在实际的应用中,为了音频算法处理/传输的方便,一般约定俗成取2.5ms~60ms为单位的数据量为一帧音频。 这个时间被称之为“采样时间”,其长度没有特别的标准,它是根据编解码器和具体应用的需求来决定的,我们可以计算一下一帧音频帧的大小: 假设某通道的音频信号是采样率为8kHz,位宽为16bit,20ms一帧,双通道,则一帧音频数据的大小为: int size = 8000 x 16bit x 0.02s x 2= 5120 bit = 640 byte 5. 常见的音频编码方式有哪些? 上面提到过,模拟的音频信号转换为数字信号需要经过采样和量化,量化的过程被称之为编码,根据不同的量化策略,产生了许多不同的编码方式,常见的编码方式有:PCM 和 ADPCM,这些数据代表着无损的原始数字音频信号,添加一些文件头信息,就可以存储为WAV文件了,它是一种由微软和IBM联合开发的用于音频数字存储的标准,可以很容易地被解析和播放。 我们在音频开发过程中,会经常涉及到WAV文件的读写,以验证采集、传输、接收的音频数据的正确性。 6. 常见的音频压缩格式有哪些? 首先简单介绍一下音频数据压缩的最基本的原理:因为有冗余信息,所以可以压缩。 (1) 频谱掩蔽效应: 人耳所能察觉的声音信号的频率范围为20Hz~20KHz,在这个频率范围以外的音频信号属于冗余信号。 (2) 时域掩蔽效应: 当强音信号和弱音信号同时出现时,弱信号会听不到,因此,弱音信号也属于冗余信号。 下面简单列出常见的音频压缩格式: MP3,AAC,OGG,WMA,Opus,FLAC,APE,m4a,AMR,等等 7. Adndroid VoIP相关的开源应用有哪些 ? imsdroid,sipdroid,csipsimple,linphone,WebRTC 等等 8. 音频算法处理的开源库有哪些 ? speex、ffmpeg,webrtc audio module(NS、VAD、AECM、AGC),等等 10. Android提供了哪些音频开发相关的API? 音频采集: MediaRecoder,AudioRecord 音频播放: SoundPool,MediaPlayer,AudioTrack (它们之间的区别可以参考这篇文章) 音频编解码: MediaCodec NDK API: OpenSL ES 11. 音频开发的延时标准是什么? ITU-TG.114规定,对于高质量语音可接受的时延是300ms。一般来说,如果时延在300~400ms,通话的交互性比较差,但还可以接受。时延大于400ms时,则交互通信非常困难。 本文转自 Jhuster 51CTO博客,原文链接:http://blog.51cto.com/ticktick/1748506,如需转载请自行联系原作者

优秀的个人博客,低调大师

学习OpenStack之 (0):基础知识

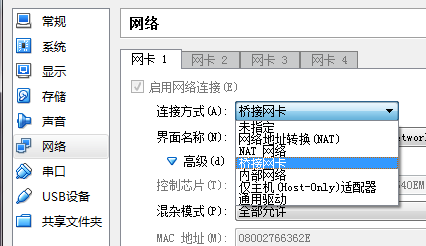
vi 方向键出现字母问题解决方法 执行命令 sudo apt-get remove vim-common 执行命令 sudo apt-get install vim 鼠标被virtualbox捕获无法释放 按右Control键可以释放鼠标 使服务在机器重启后自启动 sudo update-rc.d ssh defaults IP段表示方法 原来“/”后面的数字其实代表了掩码。正常情况下,掩码中的“1”是不可间断的,这样只要知道掩码中“1”的个数,就可以唯一地确定一个掩码。比如“/24”就表示掩码中有24个“1”,即“11111111 11111111 11111111 00000000”,用十进点分法表示就是“255.255.255.0”。 192.168.2.12与192.168.2.20 换成2进制 192.168.2.12二进制11000000.10101000.00000010.00001100 192.168.2.20二进制11000000.10101000.00000010.00010100 相与,有27位地址相同,所以可以写成192.168.2.12/27 主机位就是2的5次方,192168.2.12/27 有32个主机位 tar命令 tar -c: 建立压缩档案 -x:解压 -t:查看内容 -r:向压缩归档文件末尾追加文件 -u:更新原压缩包中的文件 这五个是独立的命令,压缩解压都要用到其中一个,可以和别的命令连用但只能用其中一个。下面的参数是根据需要在压缩或解压档案时可选的。 -z:有gzip属性的 -j:有bz2属性的 -Z:有compress属性的 -v:显示所有过程 -O:将文件解开到标准输出 下面的参数-f是必须的 -f: 使用档案名字,切记,这个参数是最后一个参数,后面只能接档案名。 # tar -cf all.tar *.jpg 这条命令是将所有.jpg的文件打成一个名为all.tar的包。-c是表示产生新的包,-f指定包的文件名。 # tar -rf all.tar *.gif 这条命令是将所有.gif的文件增加到all.tar的包里面去。-r是表示增加文件的意思。 # tar -uf all.tar logo.gif 这条命令是更新原来tar包all.tar中logo.gif文件,-u是表示更新文件的意思。 # tar -tf all.tar 这条命令是列出all.tar包中所有文件,-t是列出文件的意思 # tar -xf all.tar 这条命令是解出all.tar包中所有文件,-x是解开的意思 压缩 tar –cvf jpg.tar *.jpg //将目录里所有jpg文件打包成tar.jpg tar –czf jpg.tar.gz *.jpg //将目录里所有jpg文件打包成jpg.tar后,并且将其用gzip压缩,生成一个gzip压缩过的包,命名为jpg.tar.gz tar –cjf jpg.tar.bz2 *.jpg //将目录里所有jpg文件打包成jpg.tar后,并且将其用bzip2压缩,生成一个bzip2压缩过的包,命名为jpg.tar.bz2 tar –cZf jpg.tar.Z *.jpg //将目录里所有jpg文件打包成jpg.tar后,并且将其用compress压缩,生成一个umcompress压缩过的包,命名为jpg.tar.Z rar a jpg.rar *.jpg //rar格式的压缩,需要先下载rar for linux zip jpg.zip *.jpg //zip格式的压缩,需要先下载zip for linux 解压 tar –xvf file.tar //解压 tar包 tar -xzvf file.tar.gz //解压tar.gz tar -xjvf file.tar.bz2 //解压 tar.bz2 tar –xZvf file.tar.Z //解压tar.Z unrar e file.rar //解压rar unzip file.zip //解压zip 总结 1、*.tar 用 tar –xvf 解压 2、*.gz 用 gzip -d或者gunzip 解压 3、*.tar.gz和*.tgz 用 tar –xzf 解压 4、*.bz2 用 bzip2 -d或者用bunzip2 解压 5、*.tar.bz2用tar –xjf 解压 6、*.Z 用 uncompress 解压 7、*.tar.Z 用tar –xZf 解压 8、*.rar 用 unrar e解压 9、*.zip 用 unzip 解压 指定ubuntu的源,参考http://chenrongya.blog.163.com/blog/static/8747419620143185103297/ 配置静态ip地址 $sudo vi /etc/network/interfaces 原有内容只有如下两行: auto lo iface lo inet loopback 向末尾追加以下内容: auto eth0 iface eth0 inet static address 192.168.0.33 gateway 192.168.0.1 netmask 255.255.255.0 network 192.168.0.0 broadcast 192.168.0.255 然后保存退出; 修改机器名: 修改/etc/hostname 和 /etc/hosts,再重启机器 W: GPG error: http://ppa.launchpad.net lucid Release: The following signatures couldn't be verified because the public key is not available: NO_PUBKEY A1715D88E1DF1F24 Google 之,在这篇文档里有提到解决方案: http://muzso.hu/2007/05/25/how-to-fix-no_pubkey-errors-in-apt-get-update-operations 具体的解决方法步骤是(注意下面的KEY 是根据每次报错而不同的,可能需要用实际报错的KEY替换命令中的KEY值): $ sudo gpg --keyserver keyserver.ubuntu.com --recv A1715D88E1DF1F24 $sudo gpg --export --armor A1715D88E1DF1F24 | sudo apt-key add - 注:上面第二个命令中的第二个sudo,因为sudo不能跨越Pipe,所以第二个命令也需要使用sudo 在ubuntu上安装ssh server 现象: ssh client无法连到ubuntu sammydeair:~ Sammy$ ssh -l s1 10.211.55.4 ssh: connect to host 10.211.55.4 port 22: Connection refused 查看: ubuntu上ssh local,同样错误,发现是openssh-server没安装 解决: $ sudo apt-getupdate //视网络情况会花比较长的时间 $ sudo apt-getupgrade $ sudo apt-get install openssh-server $sudo /etc/init.d/ssh start 在Mac上使用过要license的Parallels Desktop和免费的VirtualBox,比较结果如下: 1. VirtualBox对鼠标的捕获和控制更加友好,Parallels需要按键来释放鼠标,但是VirtualBox里面完全自动。 2. VirtualBox里面虚拟机的运行速度似乎更快,至少关机比Parallels快。 3.VirutalBox里面可以很方便地复制虚拟机,但是在Parallels Desktop里面不知道什么原因“克隆”菜单为灰色不可用。 4. VirtualBox里面多网卡配置更方便。 5. google查到的VirtualBox的文章比Parallels Desktop多得多 至少在我看来,免费的VirtualBox要比收费的Parallels要好些。接下里继续体会VirtualBox。 在Ubuntu里面配置静态IP使得可以连接外网 1. 关闭虚机,在VirtualBox里面,设置虚机的一个网卡为桥接模式 2. 查看主机的DNS server 3. 开虚机,运行ifconfig和route命令,查看该网卡自动获得的IP,netmask,gateway s1@compute1:~$ route -n Kernel IP routing table Destination Gateway Genmask Flags Metric Ref Use Iface 0.0.0.0 192.168.1.1 0.0.0.0 UG 0 0 0 eth0 10.0.1.0 0.0.0.0 255.255.255.0 U 0 0 0 eth1 192.168.1.0 0.0.0.0 255.255.255.0 U 0 0 0 eth0 4. 运行命令vi /etc/network/interfaces,设置静态IP,gateway,broadcast,netmask auto eth0 iface eth0 inet static address 192.168.1.15 netmask 255.255.255.0 gateway 192.168.1.1 5.配置DNS, 运行vi /etc/resolvconf/resolv.conf.d/tail, 从而在/etc/resolvconf/resolv.conf.d/目录下创建tail文件,写入 nameserver 192.168.1.1 然后重启,DNS生效 6.测试。ping www.sohu.com s1@compute1:~$ ping www.sohu.com PING fsh.a.sohu.com (114.80.130.88) 56(84) bytes of data. 64 bytes from www.sohu.com (114.80.130.88): icmp_seq=1 ttl=56 time=4.65 ms 64 bytes from www.sohu.com (114.80.130.88): icmp_seq=2 ttl=56 time=6.91 ms 64 bytes from www.sohu.com (114.80.130.88): icmp_seq=3 ttl=56 time=5.39 ms VirtualBox 虚拟机的几种网络连接方式 (1)NAT(网络地址转换模式):能从虚拟机访问外网,主机不能访问虚拟机。 网络地址转换( NAT )是最简单的方法从一个虚拟机访问外部网。通常,它并不要求在主机网络和客户机上做任何配置。基于这个原因,它是默认的网络模式 。 原理:客户机(即虚拟机)送出的网络帧被 VirtualBox 的 NAT 引擎收到,抽取 TCP/IP 数据,再通过主机的操作系统(即安装 VirtualBox 的操作系统)重新发送出去。送到在主机上的一个应用程序,或者到位于主机同一网络的另一台计算机上,它看起来好象是安装在主机上的程序 VirtualBox,通过一个属于主机的 IP 地址,把数据发送出去。VirtualBox 倾听到数据包裹的回复,通过客户机的私人网络重新包装和发送往客户机上。 效果:使用NAT模式,就是让虚拟系统借助NAT(网络地址转换)功能,通过宿主机器所在的网络来访问公网。但纯NAT模式下,宿主机不能访问虚拟机。 使用场景:如果你想利用安装一个新的虚拟系统,在虚拟系统中不用进行任何手工配置就能直接访问互联网,建议你采用NAT模式. (2)Bridged方式:虚拟机和主机拥有同样的网络功能,能互相访问。 用这种方式,虚拟系统的IP可设置成和本机系统在同一网段,虚拟系统相当于网络内的一台独立的机器,和本机一起插在一个Hub上,网络内其他机器可访问虚拟系统,虚拟系统也可访问网络内其他机器,当然和本机系统的双向访问也不成问题。 (3)内部网络:虚拟机之间可以互相访问,虚拟机不能访问外网,主机和虚机之间不能访问。 内网模式,顾名思义就是内部网络模式: 虚拟机与外网完全断开,只实现虚拟机于虚拟机之间的内部网络模式。 (1)虚拟机与主机的关系:不能相互访问,彼此不属于同一个网络,无法相互访问。 (2)虚拟机与网络中其他主机的关系:不能相互访问,理由同上。 (3)虚拟机与虚拟机的关系:可以相互访问,前提是在设置网络时,两台虚拟机设置同一网络名称。 (4)host-only方式 (主机模式):虚拟机不能访问外网,主机可以访问虚拟机。 Virtualbox在宿主机中模拟出一张专供虚拟机使用的网卡,所有虚拟机都是连接到该网卡上的,虚拟机可以通过该网卡IP访问宿主机,同时Virtualbox提供一个DHCP服务,虚拟机可以获得一个内部网IP,宿主机可以通过该IP访问虚拟机。如果单纯使用Host-only模式,则虚拟机不能连接外部公共网络。 (5)通用驱动 作用和效果:运行用于选择网卡驱动。该驱动是virtualbox内部自带的,或者是通过extensionpack添加进来的。此模式实际上很少用到 一般来说,Bridged方式最方便好用。但如果本机系统是win2000而网线没插(或根本没有网卡),网络非常可能不可用(大部分用PCI网卡的机器都如此),此时就只能用NAT方式或host-only,之前所说的那两块虚拟网卡就是适应这两种网络准备的。 使用NAT和host-only混合模式,使得虚拟机既能访问外网,主机也能访问虚机 在虚机关机状态下配置网络,网卡1使用NAT模式,网卡2使用host-only模式。 1. 检查宿主机上host-only adapter的网络设置 当添加多个网卡时,比如 eth0 是 NAT 模式用于虚机访问外网,eth1 是 host-only 模式用于宿主机访问虚机,eth2 是internal 模式用于虚机之间互访,需要注意 default gateway。设置不对的话,虚机是不能访问外网的。当专有 eth0 时候,default gw 是它自己,当增加 eth1 和 eth2 后,default gw 就跑到了 eth2上,而 eth2 是不能用于外网访问的。因此,此时需要手工修改 default gw,修改为: route del default gw 192.168.1.1 route add default gw 10.0.2.2 eth0 root@ceph1:~# route -n Kernel IP routing table Destination Gateway Genmask Flags Metric Ref Use Iface 0.0.0.0 10.0.2.2 0.0.0.0 UG 0 0 0 eth0 10.0.2.0 0.0.0.0 255.255.255.0 U 0 0 0 eth0 192.168.1.0 0.0.0.0 255.255.255.0 U 0 0 0 eth2 192.168.56.0 0.0.0.0 255.255.255.0 U 0 0 0 eth1 root@ceph1:~# ping www.sohu.com PING fhk.a.sohu.com (175.100.207.201) 56(84) bytes of data. 64 bytes from 175.100.207.201: icmp_seq=1 ttl=41 time=133 ms 64 bytes from 175.100.207.201: icmp_seq=2 ttl=41 time=69.9 ms 64 bytes from 175.100.207.201: icmp_seq=3 ttl=41 time=69.4 ms 64 bytes from 175.100.207.201: icmp_seq=4 ttl=41 time=68.5 ms 64 bytes from 175.100.207.201: icmp_seq=5 ttl=41 time=71.9 ms 注意 eth0 的 default gw 是 10.0.2.2 而不是 10.0.2.1. 2. 开启虚拟机配置网络 sudo vi /etc/network/interfaces sudo /etc/init.d/networking restart 可运行ifconfig查看ip 3. 可以从主机ping和ssh虚拟机了 本文转自SammyLiu博客园博客,原文链接:http://www.cnblogs.com/sammyliu/p/4139246.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux 小知识翻译 - 「架构 续」(arch)

上次,从「计算机的内部构造」的角度解释了架构这个术语。这次,介绍下架构中经常提到的「i386架构」及之后的「i486」,「i586」。 安装Linux的时候,很多人即使不了解但也会经常听到i386架构这个词。因此,会误认为「自己的PC的架构是i386架构的」。现在用i386的人是非常少的。 i386的 i 就是「Intel」的首字母。i386是1985年发布的架构,那么如今还在用i386电脑的人... ...将近20年没有换过电脑了。(这篇文章应该是作者2005年左右写的) 实际上i386的CPU正式名称是「80386」。80386之前是8086和80286,之后还有80486。80386其实就是「80x86」系列CPU中的一种。 这个「80x86」系列,作为「个人电脑」被世界上很多PC所采用。 注:8086之后也有 80186,只不过在PC上用的不多,所以不是那么普遍。 i386是「80x86系列」中第一个32位的CPU。而且,Linux也是在i386上诞生的。 之后,x86系列再次升级,出现了 80486,再之后... ... 实际上官方是不存在 80586 这种型号的CPU的。由于商标的问题,80486之后是「Pentium」(也就是曾经流行的奔腾机),再之后是「Pentium Pro/Pentium II/Pentium III」。 但是,当时比较流行称呼 80x86,所以Pentium被称为「i586」,「Pentium Pro/Pentium II/Pentium III」被称为「i686」。 后来基于Pentium III的Xeon也被包含在i686里面了。之后再发布的各种架构,关于谁是「i786」?有很多争论。(大部分情况下认为Pentium 4是「i786」) 其实,i786和i886这种名称之后几乎没有人使用了。 这里提到的架构都是继承于i386的,「面向i386的OS和应用程序」都能在这些架构上运行。 IA-64之类64位的架构上,面向i386的应用程序有很多是无法运行的,所以把架构「暂且都当成i386」来看的话有点危险, 不过,在面向普通用户的PC上,可以认为面向「i386」的应用程序都能运行。 本文转自wang_yb博客园博客,原文链接:http://www.cnblogs.com/wang_yb/p/3798162.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Linux 小知识翻译 - 「X Window系统」

X Window System是给Unix系的OS提供的一套窗口管理软件或者说是组件。X Window System已经成为了在Linux上使用GUI环境的不可或缺的东西了。 X Window System诞生于马萨诸塞州(美国州名)工科大学的研究组,现在主要由X.Org Foundation这个组织来负责开发。目前的版本是「X11」(version 11)。 上面所说的内容可能很多人都知道,但 X Window System 的架构「采用了服务端·客户端模式」这点就不那么广为人知了。正因此点,通过网络来使用X Window System称为可能。 比如,在一台电脑上运行的应用程序,可以通过网络在另一台电脑上远程显示它的画面。 请注意,接下来的内容可能容易混淆。对于 X Window System,用户所使用的电脑上运行的是「X服务器」,通过它再和其它各式各样的「客户端」通信。 也就是说,和大多数的服务端·客户端架构的系统是相反的,「用户操作的是服务端,远程运行的是客户端」。 为什么会这样呢?这是因为 X Window System 的功能是由服务端提供的,而且用户也需要操作这些功能。 对于 X Window System,看着似乎懂了,其实还有很多不懂的。其内容出乎意料的深奥。 本文转自wang_yb博客园博客,原文链接:http://www.cnblogs.com/wang_yb/p/3799235.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册