首页 文章 精选 留言 我的

精选列表

搜索[Spring Framework],共10000篇文章
优秀的个人博客,低调大师

阅读笔记:DocOCR-Eval: A Correction-Based Framework for OCR Tool Selection Without Ground Truth

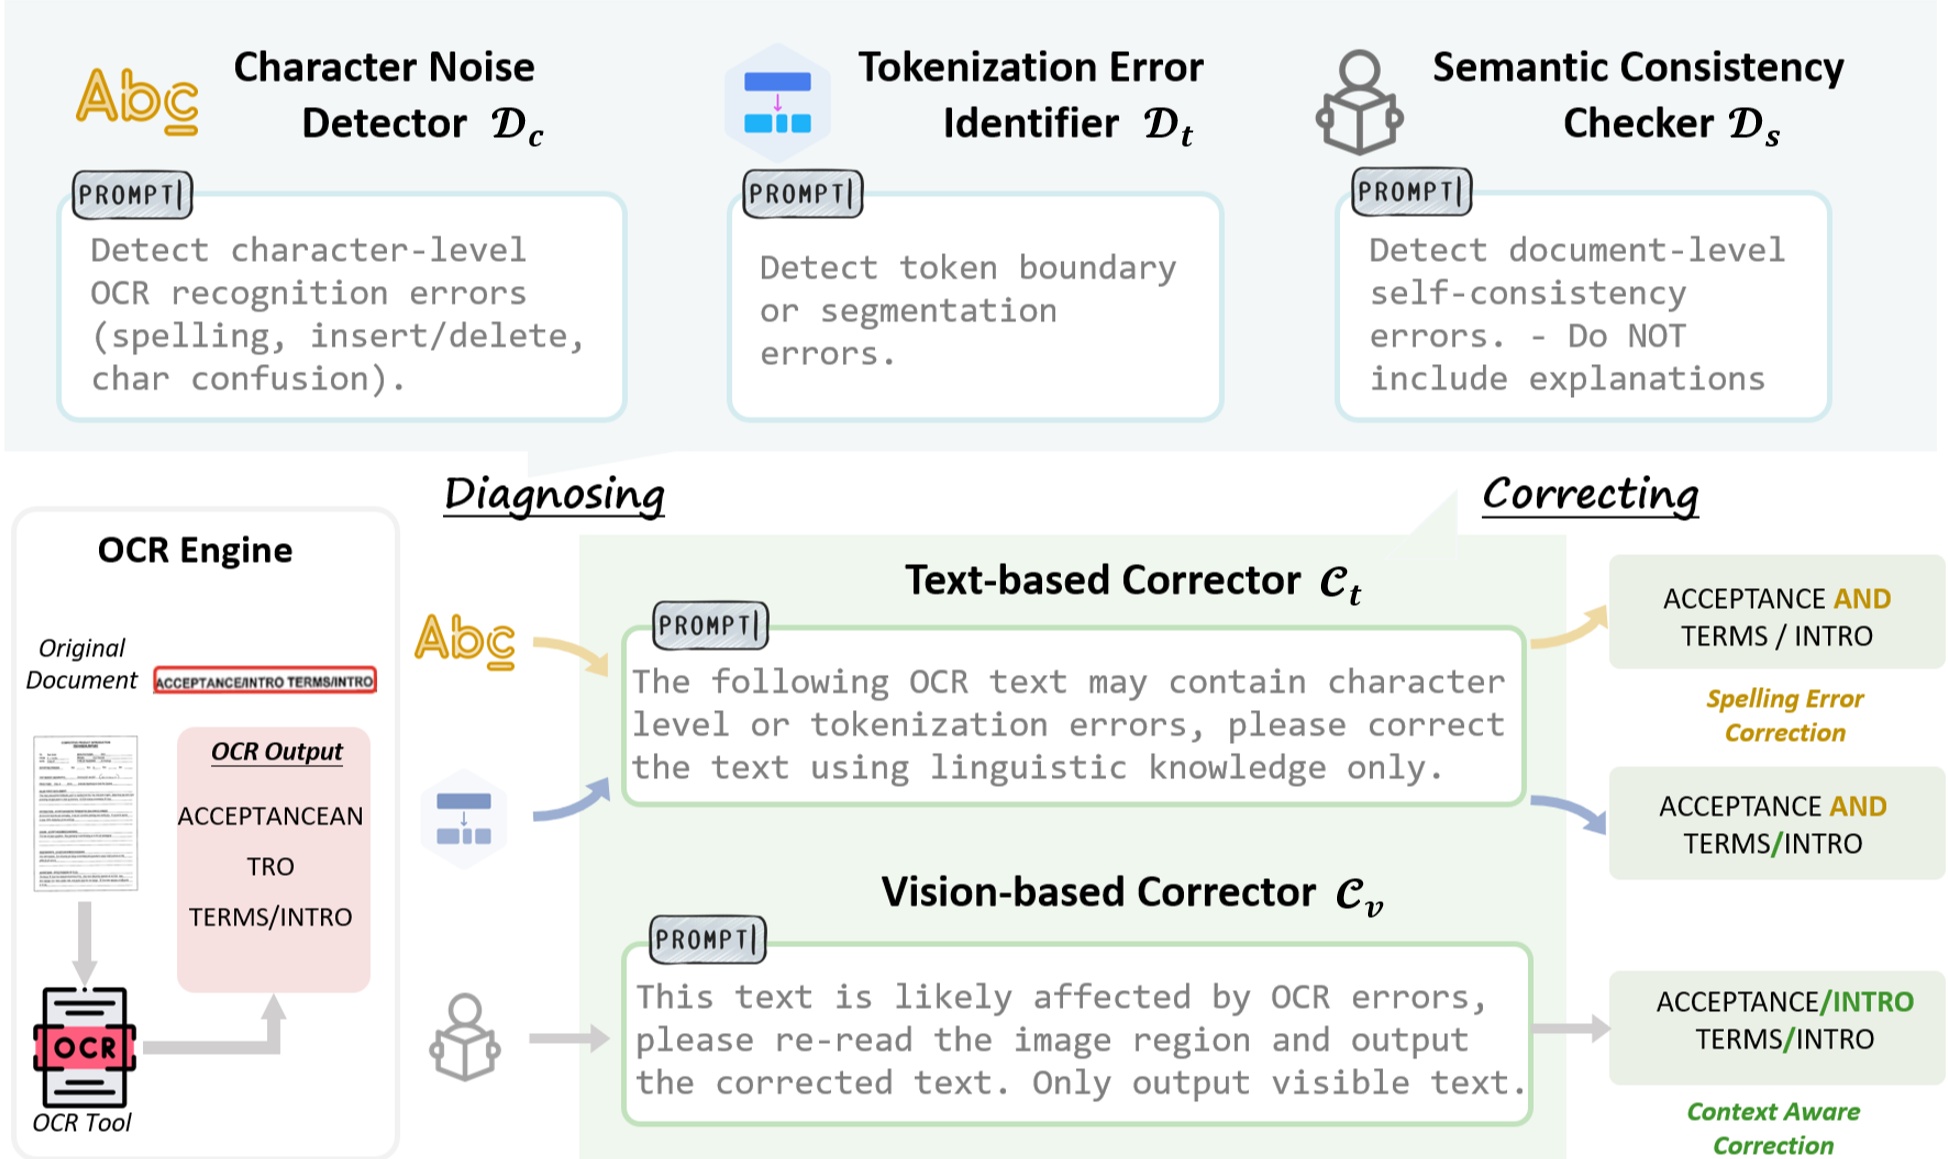
## TL;DR 这篇论文用 **"MLLM 当 corrector、衡量 OCR 原始输出与校正后输出的差异"** 的思路,提出一个**无需人工标注**的 OCR 引擎选择框架 DocOCR-Eval:对每个候选引擎的输出依次跑三阶段错误诊断(字符噪声 $D_c$ / 分词错误 $D_t$ / 语义一致性 $D_s$)并条件触发两个 MLLM 校正器(纯文本 $C_t$ / 带视觉裁剪重识别 $C_v$),再用校正后 ANLS 给引擎排名,多 MLLM 聚合缓解偏差。核心证据是 **在校正排序与有标注排序的对齐度上,FUNSD NDCG 达 0.9752(完美匹配)、EPHOIE 0.9679、RXPAD 0.9699**。主要 caveat:**仍属 work in progress——验证薄弱**:排序空间只有 4 个 OCR 引擎、Table 5 仅展示 3/9 数据集的 NDCG(其余 6 个缺失)、corrector 的 prompt 未公开、"有标注排名"本身稳定性未验证,作为方法学贡献尚不成熟。 ## 1. 研究内容 ### 1.1 研究问题、痛点与动机 - **研究问题**:给定一个特定领域的扫描文档集合 $D$ 与 $K$ 个候选 OCR 引擎 $P$,能否在**没有任何人工标注 ground truth** 的前提下,自动挑出在该集合上整体表现最好的那个 OCR 引擎? - **痛点**: - OCR 引擎与 MLLM 众多、各有所长,且**性能高度依赖数据集**(金融 / 教育 / 医疗 / 多语种差异大),不存在"一刀切"的最优引擎 - 现有文档理解框架多用**固定或拍脑袋选的**解析工具,忽视了 OCR 与 MLLM 的快速演进 - 评估文本识别精度**需要昂贵的人工标注**,使得大规模、可自适应的工具选择在真实部署中难以落地 - **动机 / 为什么重要**:OCR 是 VQA、关键信息抽取(KIE)等下游任务的**地基**,OCR 错误会沿"OCR-dependent 框架"逐层放大;而对要进入新领域、新语种的团队,标注预算往往不够。一个免标注的选型方法能把"选对 OCR"从研究特权变成工程常规操作。 - **领域定位**:**评估方法学 + 应用系统**类工作,落在"OCR / MLLM 评估"与"LLM-as-a-judge"的交叉点;上游是被评的 OCR 引擎与 MLLM,下游是文档解析系统的部署选型。 ### 1.2 核心贡献 - 对一批代表性 OCR 引擎与 SOTA MLLM 在多领域、多语种扫描文档基准上做**系统的文本识别评测**,给出跨模型 / 跨域对比 - 提出 **DocOCR-Eval**:一个免标注的 OCR 引擎选择流水线,用 MLLM 校正差异近似有标注的引擎排序 - 在多文档域 / 多语言上验证框架的**有效性与鲁棒性**(论文自述) > 评估:贡献定位是**方法学 + 评测**而非新模型——核心增量是"用 MLLM 校正当 pseudo-GT 来免标注排序 OCR"这一思路及其三阶段诊断-校正 instantiation。是否构成"新范式"取决于验证强度,而当前验证偏薄(见 4.1)。 ### 1.3 相关工作脉络 ```mermaid flowchart LR tesseract["Tesseract传统规则 OCR"] paddle_easy["PaddleOCR / EasyOCR深度学习 OCR"] cloud_api["Google Cloud Vision商业 OCR API"] mllm_ocr["MLLM-as-OCRQwen3-VL / GPT-4.1 / Gemini, 2024–25"] llm_judge["LLM-as-a-JudgeZheng et al., 2023"] dococr["DocOCR-Eval (本文)Xu et al., 2026"] tesseract --> dococr paddle_easy --> dococr cloud_api --> dococr mllm_ocr --> dococr llm_judge --> dococr ``` - **关键传承**:Tesseract / PaddleOCR / EasyOCR / Google Cloud Vision 等 OCR 引擎是**被评估对象**;Qwen3-VL / GPT-4.1 / Gemini 等 MLLM 既被评又充当 corrector;**LLM-as-a-Judge(Zheng et al., 2023)** 提供了"用强模型当评估器、免人工标注"的范式灵感,是本文最直接的思想前身。 - **分歧**:传统 LLM-as-Judge 多用于评估**生成质量**(直接打分);本文评估的是 **OCR 引擎**,且不直接打分,而是通过"校正前后差异"间接排名——并把 corrector 同时做单模型与多模型聚合两种用法。 ## 2. 方法概要 - **方法路线**:系统构建(流水线设计 + MLLM 即兴评估 + 多基准评测) - **关键假设**: - 显式:MLLM 校正后的文本比 OCR 原始输出更接近真值,故"校正差异"能反映 OCR 质量;多个 MLLM 聚合可抵消单模型偏差 - 隐式(读者识别):**corrector MLLM 本身足够可靠**,在目标域 / 语种上不引入系统性误差——论文未在 limitation 里讨论 corrector 自身错误对排名的影响 - 隐式:有标注的"GT 排名"本身是稳定可信的参照——但 Table 3 中多引擎 ANLS 差距很小,该假设存疑(见 4.1) - **数据 / 实验设置**: - 数据集:FUNSD(英 / 多域 / 手写 / 199)、SROIE(英 / 收据 / 1000)、EPHOIE(中 / 考卷 / 手写 / 1494)、RXPAD(法 / 处方)、XFUND 子集(日 / 西 / 意 / 德 / 葡) - 被评工具:有标注对比用 6 个(PaddleOCR、EasyOCR、Tesseract、Google Cloud Vision、Qwen3-VL-Instruct-4B、GPT-4.1-mini);免标注选择用其中 4 个 OCR 引擎(PaddleOCR / EasyOCR / Tesseract / Cloud Vision) - corrector:Qwen3-VL-4B-Instruct、Qwen3-VL-8B-Instruct、GPT-4.1-mini、Gemini-2.5-flash-lite - 指标:文本识别用 ROUGE-L / CER / ANLS / word-level F1;排序一致性用 NDCG(单诊断器 $D_c$/$D_t$/$D_s$ 及级联 $D_c$+$D_t$、$D_c$+$D_t$+$D_s$,并报平均 Avg.d) - 硬件 / 配置:NVIDIA A100,temperature=0、关闭采样做确定性推理 - **训练目标**:n/a —— 本文是评估框架,不训练新模型,无独立损失函数。 **整体处理流程**(鸟瞰): DocOCR-Eval 的核心思路是**"用强 MLLM 当 corrector,衡量 OCR 原始输出与校正输出之间的差异——差异越小,说明 OCR 越好"**。给定领域文档集合 $D = \{D_i\}_{i=1}^N$ 与 $K$ 个候选引擎 $P = \{p_j\}_{j=1}^K$,对每篇文档先用每个候选引擎跑出 OCR 输出 $T$;对 $T$ 中的每个文本块 $t$ 依次过三个错误诊断器(字符噪声 $D_c$ / 分词错误 $D_t$ / 语义一致性 $D_s$)得到二值诊断向量,再按诊断结果条件触发两个 MLLM 校正器(仅文本的 $C_t$ 在字符或分词错误时触发,带视觉裁剪重识别的 $C_v$ 在语义不一致时触发),产出校正后输出 $\hat{T}_{D_i}(p_j)$;最后对每个引擎在整批文档上算校正后 ANLS 分数 $s_j$,按 ANLS 降序给候选引擎排名,选最高者为部署引擎。为缓解单 MLLM 偏差,用多个 MLLM 重复校正并平均其 ANLS,再(在有标注时)与 GT 排名比 NDCG。 ### 2.1 架构图 > 原文 Figure 1:DocOCR-Eval 工作流总览,含 FUNSD 上的一个 case study。三阶段诊断($D_c$/$D_t$/$D_s$)→ 条件触发校正($C_t$/$C_v$)→ 校正后输出聚合排名。 ### 2.2 模块详解 - **错误诊断模块(Error Diagnosing,3 个二分类器)**:输入一个 OCR 文本块 $t$($D_s$ 还需文档上下文 $D$)→ 输出一个二值诊断向量 $[D_c(t),\ D_t(t),\ D_s(t, D)]$ - 处理流程: 1. **字符噪声检测器 $D_c$**:查字符级错误——替换、插入、缺失、视觉易混淆字形(如 `rn`↔`m`) 2. **分词错误检测器 $D_t$**:查分割错误——词边界错、空格异常、换行伪影 3. **语义一致性检测器 $D_s$**:把文本块放回整页上下文,判断是否与文档 $D$ 语义自洽 - 设计理由:三类错误来源不同(字符级 vs 边界级 vs 篇章级),分开诊断才能精准触发不同强度的校正——字符 / 分词错误用便宜的纯文本修正就够,语义不一致才需要昂贵的视觉重识别 - 关键参数:每个模块输出**二值**(有 / 无该类错误),不连续打分——刻意做粗粒度,便于条件触发 - **错误校正模块(Error Correcting,2 个 MLLM 校正器)**:输入 OCR 文本块($C_t$ 仅文本;$C_v$ 额外含原图 bounding-box 裁剪)→ 输出校正后文本 - 处理流程: 1. **纯文本校正器 $C_t$**:仅凭语言与上下文线索改写,**不引入识别文本之外的内容**(防止幻觉补全) 2. **视觉重识别校正器 $C_v$**:把 OCR 的 bounding box 从原图裁出来,让 MLLM **只对该可见区域重新识别**,相当于一次"局部重 OCR" - 设计理由:$C_t$ 便宜(纯文本推理)但修不了"看错字"的根本问题;$C_v$ 贵(要看图)但能纠正视觉误识。两者分工——轻错用 $C_t$、重错用 $C_v$,避免对所有块都调视觉模型 - 关键参数:$C_t$ 在 $D_c(t)=1$ 或 $D_t(t)=1$ 时触发;$C_v$ 在 $D_s(t)=1$(语义不一致)时触发——触发规则把成本压在"最可能出错"的块上 - **排序与聚合(Ranking & Aggregation)**:输入每个引擎在每篇文档上的校正后输出 → 输出引擎排名 - 处理流程: 1. 对引擎 $p_j$ 在文档集合上算 **ANLS(Average Normalized Levenshtein Similarity)** 校正后分数 $s_j$ 2. 按 $s_j$ 降序排引擎 3. 多 MLLM 设置下,把多个 corrector 的 ANLS **取平均**再排,缓解单模型偏差 4. 用 **NDCG** 衡量"校正排名"与"GT 排名"的对齐度(靠前位置权重更高) - 设计理由:ANLS 是长度归一化的字符串相似度,适合"校正后接近真值程度"的度量;NDCG 强调 top 位次正确——选型最关心的是"第一名选对没",而非全序完美 - 关键参数:论文报单诊断器($D_c$/$D_t$/$D_s$)、两两级联($D_c$+$D_t$)、全级联($D_c$+$D_t$+$D_s$)各自的 NDCG,以及每数据集的 Avg.d ### 2.3 算法 / 伪代码 原文**未给出形式化 Algorithm 伪代码块**(n/a);三阶段"诊断 → 条件校正 → ANLS/NDCG 排序"的流程已在本节"整体处理流程"与 §2.2 模块详解中按原文 Figure 1 + 2.2 节文字描述完整转述。 ## 3. 关键结果 - **主要发现**: - **没有单一 OCR 引擎始终最优**——性能高度数据集依赖(Table 3),自动选择确有必要 - 多 MLLM 平均 ANLS 比单 MLLM 更接近有标注的 top-1,且**缩小了候选引擎间的分数差距**(Table 4) - 校正排名与 GT 排名对齐度(NDCG):FUNSD **Avg.d=0.9752(完美匹配)**、EPHOIE **0.9679**、RXPAD **0.9699**(Table 5) - **最优校正策略因数据集而异**:EPHOIE 主要靠语义校正 $D_s$(版面不规则),FUNSD 需要全级联(错误来源混杂),RXPAD 偏好纯文本归一化 $D_c$+$D_t$(领域缩写让视觉重识别反而引入噪声) - **证据强度**:NDCG 数值漂亮但**仅在 3 个数据集上报**,且排序空间只有 4 个引擎;无方差 / 置信区间 / 多 seed;GT 排名本身(Table 3)多引擎差距小,reference 稳定性未验证——证据强度受限 - **最支撑结论的一条证据**:Table 5 的 FUNSD Avg.d=0.9752(全级联 NDCG=1.0000),是"免标注排序能恢复有标注排序"这一核心 claim 最干净的正面证据;但仅 FUNSD 完美,其余两数据集略低 ### 3.1 关键结果图 / 表 **Table 3 有标注的文本识别 ANLS(核心动机证据)** | 引擎 / 模型 | EPHOIE | FUNSD | SROIE | RXPAD | XF-ja | XF-es | XF-it | XF-de | XF-pt | |------|--------|-------|-------|-------|-------|-------|-------|-------|-------| | PaddleOCR | 0.20 | 0.42 | 0.51 | 0.66 | 0.46 | 0.83 | 0.34 | 0.88 | 0.88 | | EasyOCR | 0.09 | 0.29 | 0.35 | 0.61 | 0.53 | 0.87 | 0.74 | 0.90 | 0.90 | | Tesseract | 0.02 | 0.23 | 0.38 | 0.52 | 0.45 | 0.79 | 0.69 | 0.84 | 0.84 | | Cloud Vision | 0.44 | 0.29 | 0.56 | 0.29 | 0.62 | 0.73 | 0.75 | 0.74 | 0.74 | | Qwen3-VL | 0.46 | 0.29 | 0.53 | 0.28 | 0.48 | 0.59 | 0.46 | 0.70 | 0.70 | | OpenAI (GPT-4.1-mini) | 0.34 | 0.25 | 0.37 | 0.28 | 0.54 | 0.65 | 0.67 | 0.71 | 0.71 | - **重点解读**:没有任何一行始终最高——PaddleOCR 在 FUNSD / RXPAD 强,EasyOCR 在多个 XFUND 语种上竞争力强,Cloud Vision / Qwen3-VL 在多语种、视觉复杂的 EPHOIE / XFUND-it 上更好。这正是"自动选型有必要"的实证依据。但注意:多数单元格里引擎间 ANLS 差距很小(如 XF-de 上 EasyOCR 0.90 vs Tesseract 0.84 vs Cloud Vision 0.74),GT 排名可能对评估噪声敏感。 **Table 4 校正后 ANLS(单 MLLM vs 多 MLLM 平均)** | 引擎(校正后) | EPHOIE | FUNSD | SROIE | RXPAD | XF-ja | XF-es | XF-it | XF-de | XF-pt | |------|--------|-------|-------|-------|-------|-------|-------|-------|-------| | PaddleOCR(Qwen3-VL 单模型) | 0.95 | 0.94 | 0.95 | 0.96 | 0.92 | 0.97 | 0.98 | 0.99 | 0.95 | | Cloud Vision(Qwen3-VL 单模型) | 0.97 | 0.88 | 0.90 | 0.93 | 0.97 | 0.95 | 0.95 | 0.95 | 0.94 | | PaddleOCR(多 MLLM 平均) | 0.927 | 0.933 | 0.945 | 0.949 | 0.767 | 0.941 | 0.946 | 0.949 | 0.910 | | Cloud Vision(多 MLLM 平均) | 0.949 | 0.908 | 0.912 | 0.928 | 0.940 | 0.951 | 0.948 | 0.951 | 0.935 | - **重点解读**:校正后几乎所有引擎 ANLS 都被抬高到 0.9+,**引擎间区分度被压缩**——这说明 corrector 把弱引擎"拉上去"的幅度大于把强引擎拉上去的幅度(弱引擎可改空间大)。⚠ 这正是反方论证的入口:当所有引擎都被改正到接近 corrector 上限时,排名差异主要靠 corrector 的微小偏好,稳健性存疑(见 4.1)。 **Table 5 排序一致性 NDCG(最核心的结果,仅 3 数据集)** | 数据集 | 引擎 | GT 排名 | $D_c$ | $D_t$ | $D_s$ | $D_c$+$D_t$ | All | Avg.d | |------|------|--------|-------|-------|-------|-------------|-----|-------| | EPHOIE | PaddleOCR | 2 | 1 | 1 | 2 | 1 | 2 | **0.9679** | | EPHOIE | Cloud Vision | 1 | 2 | 2 | 1 | 2 | 1 | | | FUNSD | PaddleOCR | 1 | 1 | 1 | 2 | 1 | 1 | **0.9752** | | FUNSD | Cloud Vision | 2 | 2 | 2 | 1 | 4 | 2 | | | RXPAD | PaddleOCR | 1 | 2 | 1 | 1 | 1 | 1 | **0.9699** | | RXPAD | Cloud Vision | 4 | 4 | 4 | 2 | 4 | 2 | | > 表中只摘列每个数据集 GT top-2 引擎的排名对比(完整 4 引擎见原文 Table 5)。 - **重点解读**:FUNSD 全级联 NDCG=1.0000,完美恢复 GT 排名;EPHOIE / RXPAD 的 Avg.d 也都在 0.96+,主要保住了 top 位次。但 ⚠ **9 个数据集只给了 3 个的 NDCG**——SROIE 与 5 个 XFUND 语种的排序一致性未报,是否在这些数据集上明显更差不得而知(典型选择性展示嫌疑)。 > 原文 Figure 2:Qwen3-VL 在 EPHOIE / FUNSD / RXPAD 上的多指标(ANLS、word-F1、CER、ROUGE-L)对比,↑ 越高越好 / ↓ 越低越好。 - **重点解读**:Cloud Vision 与 OpenAI 在非英语文档上 ANLS 与 word-F1 更高;PaddleOCR 常获更低 CER 与更高 ROUGE(词例级与序列级保真度更好)。不同指标下"最优引擎"再次换人——进一步支持"选型应数据集 / 指标自适应"。 ## 4. 批判性评估与价值 ### 4.1 批判性评估 评估:DocOCR-Eval 的 idea 本身有意思——把 **LLM-as-a-Judge 的范式从"评估生成质量"迁到"评估 OCR 引擎",并改用"校正差异"而非直接打分**,思路干净。但当前版本(work in progress)的验证有几处实质性短板。 **首先,核心隐含假设需要拷问。** 框架成立依赖"corrector 校正后的文本比 OCR 原始输出更接近真值"。但 corrector 用的是 Qwen3-VL / GPT-4.1 / Gemini 这些**本身就是顶级 OCR 的 MLLM**——所以"校正差异"本质上近似于**"用强 MLLM 当 pseudo-GT、衡量弱引擎离它有多远"**。这个定位比论文"无标注评估创新"的表述更诚实,也暴露了风险:若 corrector 在某领域(如手写 EPHOIE、低资源语种 XFUND-ja)自身不可靠,pseudo-GT 就错,排名会跟着错;而论文恰恰没有报告 corrector 自身在目标域的精度,也没在 limitation 里讨论。 **其次,反方最强论证指向"聚合平滑"与"区分度压缩"。** Table 4 显示校正后多引擎 ANLS 普遍被抬到 0.9+,引擎间区分度大幅压缩——意味着排名差异主要来自 corrector 的微小偏好,而非 OCR 真实质量差距。在这种"所有引擎都被改正到接近 corrector 上限"的情况下,多 MLLM 平均提升 NDCG 很可能主要是**聚合平滑效应**(多个带噪估计平均后自然更贴近任何稳定 reference),而非框架本身的判别能力。换言之:**"多模型聚合更接近 GT 排名"这一发现,用"聚合平滑"同样能解释,论文没有设计对照来分离这两种解释**——这是 CRITICAL 级的论证缺口。 **第三,验证存在选择性展示与小排序空间问题。** Table 5 的 NDCG 只给了 9 个数据集中的 3 个(FUNSD / EPHOIE / RXPAD),SROIE 与 5 个 XFUND 语种全部缺失——读者无法判断框架在多语种上是否还成立,这是典型的 cherry-picking 嫌疑。更根本地,**排序空间只有 4 个 OCR 引擎**,在这种 4 选 1 的设置下 NDCG 高值的实际区分力有限:即使粗糙的方法也可能在 4 个里撞对相当比例。论文没有在更大候选池(Table 1 列了 16 个工具却只评了 4 个 OCR)上验证,框架的可扩展性未经验证。 **第四,"GT 排名"这一参照系本身稳定性存疑。** Table 3 中多引擎 ANLS 差距很小(如 XF-de 上 EasyOCR 0.90 vs Tesseract 0.84 vs Cloud Vision 0.74;XF-pt 上 EasyOCR 0.90 vs Paddle 0.88),且无方差 / 置信区间——一个轻微的评估波动就可能改变排名。用一个本身可能不稳定的 reference 去衡量方法对齐度,存在"噪声对噪声"的风险。 复现性方面:corrector 的**完整 prompt 未公开**(诊断器与校正器的具体指令是方法核心却没给);每数据集用于评估的样本数、 XFUND 子集的具体处理未完全说明;Table 1 罗列 16 个工具、实际只对比 4 个 OCR + 2 个 MLLM,选择标准未交代。 "so what" 上:对要在新领域 / 新语种部署 OCR 却无标注预算的实践者,"用强 MLLM 校正当 pseudo-GT 来给 OCR 排名"这一**思路值得借鉴**(甚至可省去整套诊断-校正,直接用单强 MLLM 重识别做 pseudo-GT 即可);但当前验证强度不足以让人完全信任其排名,需等完整版补齐 9 数据集 NDCG、更大候选池、corrector 自评与 prompt 公开后再评估。 **综合可信度**:中偏低 —— idea 有启发、流水线设计合理,但 work-in-progress 阶段验证薄弱(小排序空间、选择性展示、corrector prompt 未公开、"GT 排名"稳定性未验证),核心 claim 的可信度尚不充分。 ### 4.2 Limitations 与复现性 - **论文自承**:MLLM 校正引入额外延迟与算力 / API 成本,应作"可配置选项"而非默认方案;不同下游任务对精度要求不同 - **读者发现**:corrector 自身在目标域的精度未验证;排序空间仅 4 引擎、NDCG 仅 3/9 数据集;corrector prompt 未公开;"GT 排名"无方差、稳定性存疑;Table 1 列 16 工具却只评少数,选择标准未交代 - **复现性**:代码 未明确提及开源 (uncertain) · 数据 公开基准(FUNSD/SROIE/EPHOIE/RXPAD/XFUND)· corrector prompt 否(未公开)· (uncertain) 每数据集评估样本数未完全说明 ### 4.3 可复用与后续 - **可借鉴**:用强 MLLM 当 pseudo-GT 评估弱 OCR 的思路(甚至可简化为"单强 MLLM 重识别做参照");分类型诊断(字符 / 分词 / 语义)→ 条件触发不同强度校正的成本控制范式 - **引用场景**:论证"免标注 OCR 引擎选型"或"LLM-as-judge 用于文档解析评估"时引用(需注明 work in progress);BibTeX key 候选 `xu2026dococreval` - **下一步**: - [ ] 等完整版补齐 9 数据集 NDCG、更大候选池、corrector prompt 与 corrector 自评后再评估 - [ ] 若要做工程选型,可先用一个强 MLLM(如 Qwen3-VL / GPT-4.1)对自家文档集跑 pseudo-GT,对比本文三阶段流水线与简化版的排名一致性 ## Verdict **选读** —— idea 有启发(把 LLM-as-judge 迁到 OCR 选型、用校正差异免标注排名),分类型诊断 + 条件校正的成本控制范式对工程选型可借鉴;但这是 **work in progress**,验证薄弱(排序空间仅 4 引擎、NDCG 仅 3/9 数据集、corrector prompt 未公开、"GT 排名"稳定性未验证),核心 claim 的可信度尚不充分——读它取其思路即可,等完整版再评估其方法学贡献。 > 作者:lusca | 版本:lusca-paper-read v1.10.1 | 出处:https://github.com/yjmm10/lusca-skill/tree/main/skills/lusca-paper-read

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册