首页 文章 精选 留言 我的

精选列表

搜索[子流程],共10000篇文章
优秀的个人博客,低调大师

阿里云账户间域名转让流程(新手教程)

有些童鞋会有2个或两个以上阿里云账号,或者需要交易域名,那么就需要以下步骤了哦~ 【转出】 1.首先在“控制台”选择“域名”,进入域名管理 2.选择需要转移的域名,点击“管理” 3.在页面中,选择“账户间转移” 4.验证自己的手机号、输入对方账号(对方的手机号、邮箱、8位ID或者淘宝/1688账号,任选其一) 【转入】 只需进入转入账号的“控制台”》》》“域名” 查看域名列表是否已有该域名即可!

优秀的个人博客,低调大师

移动支付demo接入流程指南(ios版)

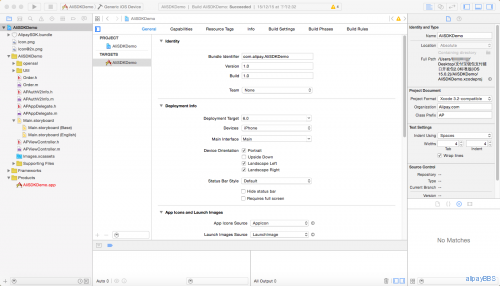
解压下载到的接口资料压缩文件(文件名是WS_MOBILE_PAY_SDK_BASE.zip),里面包括客户端demo与服务端demo。客户端demo文件夹中Android与IOS都需要接入开发,服务端demo文件夹中可根据商户自身情况选择开发语言(JAVA、PHP、C#)与编码格式(UTF-8、GBK)六选一即可。 一、接口demo配置与运行 声明:账号信息的配置、签名机制逻辑代码请务必放入服务端中管理与运行,不要在客户端中,以下步骤仅适用于demo配置运行,若出现资金风险请自行承担。实际项目开发过程中,如何接入支付宝SDK请参考“开放平台文档中心”。 步骤1:配置环境点击IOS客户端demo文件夹中的AliSDKDemo.xcodeproj文件,唤起XCODE开发软件。 配置证书 找到选项卡【BuildSetti

优秀的个人博客,低调大师

第三方应用授权集成流程

主要实现服务商代商户调用接口,该过程不涉及商户私钥等信息 一、文档地址 官方文档地址:[url]https://docs.open.alipay.com/20160728150111277227/intro[/url] 二、开发前准备工作 调用步骤:[url]https://openclub.alipay.com/read.php?tid=12194&fid=69[/url] 注意事项:1、支持沙箱测试;2、不需签约不需要添加功能; (1)第三方调用过程,调用接口app_id的应用为第三方应用 创建第三方应用方式:[url]https://openclub.alipay.com/read.php?tid=6328&fid=68[/url] (2)授权必须设置授权回调地址 授权回调地址配置说明:[url]https://openclu

优秀的个人博客,低调大师

移动支付demo接入流程指南(Android版)

一、下载DEMO和SDK。打开连接https://doc.open.alipay.com/doc2/detail.htm?spm=a219a.7629140.0.0.YGttW9&treeId=54&articleId=104509&docType=1 解压DEMO文件。 WS_MOBILE_PAY_SDK_BASE\支付宝钱包支付接口开发包2.0标准版(201501215)\DEMO\客户端demo目录下有2个压缩文件。 IOS和Android二、配置DEMO。1.导入Import 选择Andorid程序。 2.配置参数 找到src/com.alipay.sdk.demo/PayDemoActivity.java文件打开。 需要配置 PARTNER:合作身份者ID,以2088开头由16位纯数字

优秀的个人博客,低调大师

python中上双互斥锁的线程执行流程

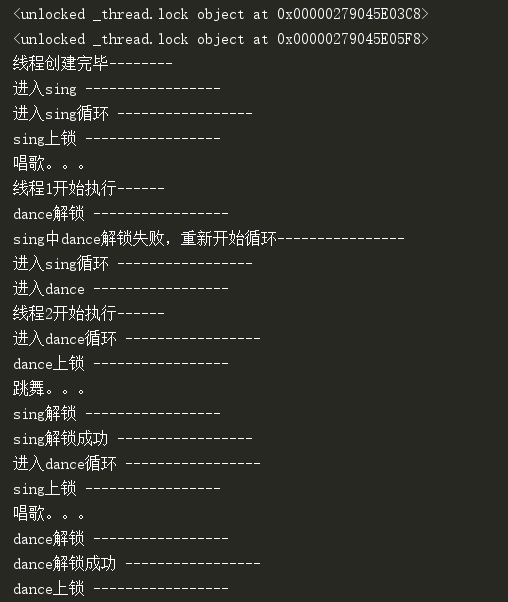
import threading def sing(): print('进入sing -----------------') for i in range(3): print('进入sing循环 -----------------') l1.acquire() print('sing上锁 -----------------') print('唱歌。。。') try: print('dance解锁 -----------------') l2.release() print('dance解锁成功 -----------------') except Exception: print('sing中dance解锁失败,重新开始循环----------------') pass def dance(): print('进入dance -----------------') for i in range(3): print('进入dance循环 -----------------') l2.acquire() print('dance上锁 -----------------') print('跳舞。。。') try: print('sing解锁 -----------------') l1.release() print('sing解锁成功 -----------------') except Exception: print('dance中sing解锁失败,重新开始循环----------------') pass if __name__ == '__main__': # sing() # dance() l1 = threading.Lock() print(l1) l2 = threading.Lock() print(l2) t1 = threading.Thread(target=sing) t2 = threading.Thread(target=dance) print('线程创建完毕--------') t1.start() print('线程1开始执行------') t2.start() print('线程2开始执行------') t1.join() print('线程1守护主线程-----') t2.join() print('线程2守护主线程-----') 这里我们暂且先不提全局解释器锁,从这个代码例子里我们可以看出,一个锁在上锁以后,如果在没有释放它的情况下再要对它上锁,他就会阻塞住,一直到它的锁被释放了以后才能够再次被上锁,这样就实现了两个线程的交替执行。 -------知识无价,汗水有情,如需搬运请注明出处,谢谢!

优秀的个人博客,低调大师

Hadoop MapReduce工作详细流程(Partitioner/SortComparator/GroupingComparator)

转自:http://blog.sina.com.cn/s/blog_7581a4c30102veem.html map阶段 1. 使用job.setInputFormatClass(TextInputFormat)做为输入格式。注意输出应该符合自定义Map中定义的输出。 2. 进入Mapper的map()方法,生成一个List。 3. 在map阶段的最后,会先调用job.setPartitionerClass()对这个List进行分区,每个分区映射到一个reducer。 4. 每个分区内又调用job.setSortComparatorClass()设置的key比较函数类排序(如果没有通过job.setSortComparatorClass()设置key比较函数类,则使用key的实现的compareTo方法)。可以看到,这是一个二次排序。 5. 如果设置了Combiner(job.setCombinerClass)对output进行一次合并,从而减少对reduce的输出流量和预处理reduce的input数据。但不一定会执行,对于Combiner执行时机参考Reference[4]。 【说明】以上步骤省略了collect阶段、cache阶段等细节,更详细步骤参考Reference[3] reduce阶段 1. shuffle阶段 reducer开始fetch所有映射到这个reducer的map输出。 2.1 sort阶段 再次调用job.setSortComparatorClass()设置的key比较函数类对所有数据对排序(因为一个reducer接受多个mappers,需要重新排序)。 2.2 secondary sort阶段 然后开始构造一个key对应的value迭代器。这时就要用到分组,使用jobjob.setGroupingComparatorClass()设置的分组函数类。只要这个比较器比较的两个key相同,他们就属于同一个组,它们的value放在一个value迭代器,而这个迭代器的key使用属于同一个组的所有key的第一个key。 3.reduce阶段 最后就是进入Reducer的reduce()方法,reduce()方法的输入是所有的(key和它的value迭代器)。同样注意输入与输出的类型必须与自定义的Reducer中声明的一致。 【注意】reducers的输出是无序的。

优秀的个人博客,低调大师

Docker Hub工作流程-Docker for Web Developers(6)

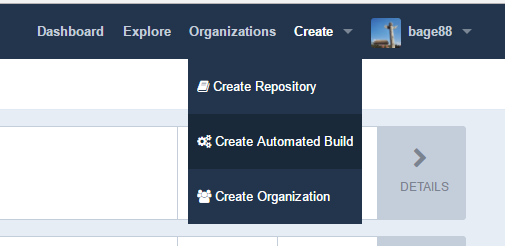
在Github上创建项目仓库 和创建其他Github项目一样,在Github创建一个仓库,然后在仓库里面增加一个dockerfile,然后提交并推送到Github上。 我已经创建的仓库地址:https://github.com/liminjun/simple-dockerfile Dockerfile内容如下: #FROM - Image to start building on. FROM ubuntu:14.04 #MAINTAINER - Identifies the maintainer of the dockerfile. MAINTAINER liminjun2007@gmail.com #RUN - Runs a command in the container RUN echo "Hello World" > /root/hello_world.txt #CMD - Identifies the command that should be used by default when running the image as a container. CMD ["cat", "/root/hello_world.txt"] 在Docker Hub上构建工作流 步骤1:注册Dockerhub并登录。 步骤2:基于Github仓库创建自动化构建 选择Github 步骤3:查看Build Settings 步骤4:查看Build Details 构建和迭代我们的项目 本地修改Dockerfile文件,提交并推动到Github上。 验证上述发生的变化。 获取镜像,并运行,查看内容是否变化。 docker pull bage88/simple-dockerfile 运行Docker镜像 docker run 因为Docker Hub访问速度问题,而且企业内部开发的代码都需要打包成私有的镜像。所以Docker Hub适合开源的小型项目。 对于企业内部来说,可以使用国内云计算厂商提供的镜像服务,也可以在企业内部搭建。 本文转自快乐八哥博客园博客,原文链接http://www.cnblogs.com/liminjun88/p/docker-hub-workflows.html如需转载请自行联系原作者 快乐八哥

优秀的个人博客,低调大师

mac或linux下安装hadoop-2.8流程

mac上安装hadoop 1,mac下的java ll /usr/bin |grep'java' 默认: /System/Library/Frameworks/JavaVM.framework/Versions/Current/Commands/java 具体的安装路径: /Library/Java/JavaVirtualMachines/下面, JAVA_HOME是/Library/Java/JavaVirtualMachines/jdk1.7.0_75/Contents/Home。 2,mac下的ssh 首先测试ssh localhost, 若不成功,看是否启动允许remotelogin,再尝试如果失败则继续下面的 ssh-keygen -t dsa-P '' -f ~/.ssh/id_dsa ssh-keygen表示生成秘钥; -t表示秘钥类型;-P用于提供密语;-f指定生成的秘钥文件。 这个命令在”~/.ssh/“文件夹下创建两个文件id_dsa和id_dsa.pub,是ssh的一对儿私钥和公钥。 接下来,将公钥追加到授权的key中去,输入: cat~/.ssh/id_dsa.pub >> ~/.ssh/authorized_keys 再次尝试 ssh localhost 若无法打开,解决方法如下: 进入Mac的系统偏好设置 –> 共享–> 勾选remote login,并设置allow access for all users。 3,下载镜像,mirror,选择某一个tar.gz http://mirror.bit.edu.cn/apache/hadoop/common/ 4,设置环境变量 vi ~/.bash_profile 或者/etc/profile中 exportJAVA_HOME=/Library/Java/JavaVirtualMachines/jdk1.7.0_75/Contents/Home exportJRE_HOME=$JAVA_HOME/jre exportHADOOP_HOME=/Users/xiaolong.zhao/ittools/hadoop #是防止出现:Warning:$HADOOP_HOME is deprecated的警告错误。 exportHADOOP_HOME_WARN_SUPPRESS=1 exportPATH=$JAVA_HOME/bin:$JRE_HOME/bin: $ HADOOP_HOME /sbin:$HADOOP_HOME/bin:$PATH 注意:linux与mac的安装,唯一区别就是mac下会有默认的jdk路径的,以及ssh配置的 5,配置hadoop-env.sh 在/Users/xiaolong.zhao/ittools/hadoop/etc/hadoop目录下,找到hadoop-env.sh,打开编辑进行如下设置: export JAVA_HOME=${JAVA_HOME}(去掉注释) export HADOOP_HEAPSIZE=2000(去掉注释) export HADOOP_OPTS=”-Djava.security.krb5.realm=OX.AC.UK-Djava.security.krb5.kdc=kdc0.ox.ac.uk:kdc1.ox.ac.uk”(去掉注释) 6, 4个核心文件配置 6.1.配置core-site.xml——(defaultFS)指定了NameNode的主机名与端口 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 <? xmlversion = "1.0" encoding = "UTF-8" ?> < configuration > <!--fs.defaultFS-这是一个描述集群中NameNode结点的URI(包括协议、主机名称、端口号),集群里面的每一台机器都需要知道NameNode的地址。 DataNode结点会先在NameNode上注册,这样它们的数据才可以被使用。独立的客户端程序通过这个URI跟DataNode交互,以取得文件的块列表。--> < property > < name >fs.defaultFS</ name > < value >hdfs://localhost:8000</ value > </ property > <!--hadoop.tmp.dir是hadoop文件系统依赖的基础配置,很多路径都依赖它。 如果hdfs-site.xml中不配置namenode和datanode的存放位置,默认就放在这个路径中--> < property > < name >hadoop.tmp.dir</ name > < value >/Users/time/Documents/hadoop-2.7.3/tmp</ value > < description >Abaseforothertemporarydirectories.</ description > </ property > </ configuration > 6.2. 配置hdfs-site.xml——指定了HDFS的默认参数副本数 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 <? xmlversion = "1.0" encoding = "UTF-8" ?> < configuration > <!--dfs.replication-它决定着系统里面的文件块的数据备份个数。对于一个实际的应用,它应该被设为3。 少于三个的备份,可能会影响到数据的可靠性--> < property > < name >dfs.replication</ name > < value >1</ value > </ property > <!--datanaode和namenode的物理存储,如果不设置,它的值hadoop.tmp.dir--> < property > < name >dfs.namenode.name.dir</ name > < value >file:/home/hdfs/name</ value > </ property > <!--可以不设置,namenode的Web监控端口,默认是0.0.0.0:50070--> < property > < name >dfs.namenode.http-address</ name > < value >localhost:57000</ value > </ property > < property > < name >dfs.datanode.data.dir</ name > < value >file:/home/hdfs/data</ value > </ property > </ configuration > 注意这里的file 如果配置为: file:/path/a/c,则具体的路径就是: /path/a/c 如果配置为:file://path/a/c,则具体的路径就是: /a/c 6.3 mapred-site.xml配置 1 2 3 4 < property > < name >mapreduce.framework.name</ name > < value >yarn</ value > </ property > 6.4 Yarn-site.xml 配置 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 <? xmlversion = "1.0" ?> < configuration > <!--resourcemanager--> <!--clientvisitaddress--> < property > < name >yarn.resourcemanager.address</ name > < value >localhost:18040</ value > </ property > <!--ApplicationMastervisitaddress--> < property > < name >yarn.resourcemanager.scheduler.address</ name > < value >localhost:18030</ value > </ property > <!--NodeManagervisitaddress--> < property > < name >yarn.resourcemanager.resource-tracker.address</ name > < value >localhost:18025</ value > </ property > <!--webvisitaddress--> < property > < name >yarn.resourcemanager.webapp.address</ name > < value >localhost:18088</ value > </ property > <!--NodeManagersupportmapreduceservice--> < property > < name >yarn.nodemanager.aux-services</ name > < value >mapreduce_shuffle</ value > </ property > </ configuration > 7, 格式化namenode hdfs namenode-format 8, 启动hadoop 8.1sbin/start-all.sh 8.2 web测试 8.2.1 namenode-web http://localhost:50070 8.2.2resourcemanager-web http://localhost:18088 8.2.3 nodemanager-web http://localhost:8042 本文转自 zhao_xiao_long 51CTO博客,原文链接:http://blog.51cto.com/computerdragon/1939523
资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册