首页 文章 精选 留言 我的

精选列表

搜索[Harness工程],共10000篇文章
优秀的个人博客,低调大师

容器化你的 Spring Boot 工程——Docker

环境声明: Gradle + Docker + Spring Boot2.1.5.RELEASE 目的 利用docker容器技术简化项目部署 配置Docker服务(Ubuntu) 卸载旧版本docker(全新安装时,无需执行该步骤) sudo apt-get remove docker docker-engine docker.io 更新系统软件 sudo apt-get update 安装依赖包 sudo apt-get install \ apt-transport-https \ ca-certificates \ curl \ software-properties-common 添加官方密钥 curl -fsSL https://download.docker.com/linux/ubuntu/gpg | sudo apt-key add - 如果出现‘sudo: unable to resolve host {你的主机名}’,需要编辑你的hosts文件 vim /etc/hosts 127.0.0.1 localhost # 添加下边这行 127.0.0.1 {你的主机名} 添加仓库 sudo add-apt-repository \ "deb [arch=amd64] https://download.docker.com/linux/ubuntu \ $(lsb_release -cs) \ stable" 再次更新软件 sudo apt-get update 安装 apt-get install docker-ce 修改源 vim /etc/docker/daemon.json { "registry-mirrors": [ "https://kv3qfp85.mirror.aliyuncs.com" ] } 开放远程 2375 端口访问 修改docker配置文件 vim /lib/systemd/system/docker.service 修改如下内容 #ExecStart=/usr/bin/dockerd -H fd:// --containerd=/run/containerd/containerd.sock ExecStart=/usr/bin/dockerd -H tcp://0.0.0.0:2375 -H unix:///var/run/docker.sock 重载配置和重启 systemctl daemon-reload sudo service docker restart 查看服务 开发环境配置 idea连接远程Docker 构建镜像 gradle配置,增加 gradle 的 Docker 插件 parent build.gradle ...... buildscript { ...... dependencies { ...... classpath('gradle.plugin.com.palantir.gradle.docker:gradle-docker:0.19.2') } } ...... subprojects { ...... apply plugin: 'application' apply plugin: 'com.palantir.docker' ...... jar { enabled = true } bootJar { classifier = 'boot' } } 编写Dockerfile FROM openjdk:8-jdk-alpine VOLUME /tmp ADD build/libs/*-boot.jar app.jar RUN sh -c 'touch /app.jar' ENV JAVA_OPTS="" ENTRYPOINT [ "sh", "-c", "java $JAVA_OPTS -Djava.security.egd=file:/dev/./urandom -jar /app.jar" ] 构建可运行jar包,打好的包在build-libs目录内*-boot.jar 为了方便查看(当然不这样做也是可以的),假设我的项目是多模块架构,项目名为 demo,现在为我的子模块model1构建和部署镜像 最下边Command preview也就是原生的Docker构建镜像的命令: docker build -t demo/model1:v1 . && docker run -p 8061:8061 --name demo-model1-container demo/model1:v1 run it (莫慌,骚微一等) Deploy log: Deploying 'demo-model1-container Dockerfile: model1/Dockerfile'... Building image... Step 1/6 : FROM openjdk:8-jdk-alpine ---> a3562aa0b991 Step 2/6 : VOLUME /tmp ---> Using cache ---> 0ccc6c4dcc3f Step 3/6 : ADD build/libs/*-boot.jar app.jar ---> Using cache ---> 999503a5bf26 Step 4/6 : RUN sh -c 'touch /app.jar' ---> Using cache ---> d99dd527cb5b Step 5/6 : ENV JAVA_OPTS="" ---> Using cache ---> 468e80ce7f62 Step 6/6 : ENTRYPOINT [ "sh", "-c", "java $JAVA_OPTS -Djava.security.egd=file:/dev/./urandom -jar /app.jar" ] ---> Using cache ---> d8d32a964e71 Successfully built d8d32a964e71 Successfully tagged demo/model1:v1 Creating container... Container Id: 0f91b3f38e771cb1288fb7b01451aeeef917d83f4f2fbe803a65a091684a7430 Container name: 'demo-model1-container' Attaching to container 'demo-model1-container'... Starting container 'demo-model1-container' Failed to deploy 'demo-model1-container Dockerfile: data-collect-server/Dockerfile': com.github.dockerjava.api.exception.InternalServerErrorException: {"message":"driver failed programming external connectivity on endpoint demo-model1-container (10fcfb5d05feffb40b75715b531c7504a8ee7262c2af43b642d2202e9e3f4b31): Bind for 0.0.0.0:8061 failed: port is already allocated"} 启动成功,访问测试 示例项目:gradle-docker

优秀的个人博客,低调大师

独家 | 一文带你读懂特征工程!

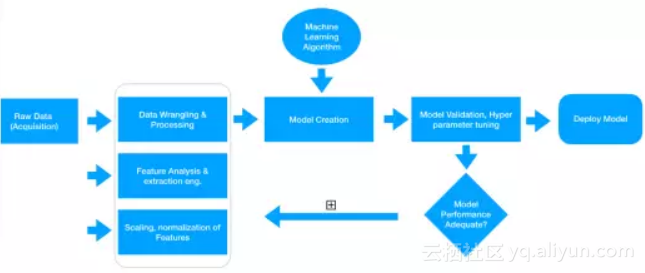
无论它的规模和大小如何,数据已经成为现代企业、公司和组织的一流资产。任何一个智能系统都需要数据驱动,无论它多复杂。每个智能系统的核心,均有一个或多个基于某种数据学习方法的算法,例如机器学习、深度学习或统计方法,它们利用这些数据来生成知识,并在一段时间内提供智能洞察。 算法本身是非常通用的,但无法在普通原始数据上有效发挥作用。因此,需要从原始数据中提取有意义的特征,我们才能够理解和使用这些数据。 任何一个智能数据洞察系统基本上都由端到端的管道组成: •先是 获取原始数据 ; •然后利用数据处理技术,从这些数据中 获取、处理和提取有意义的特征和属性 ; •最后,通常利用统计模型或机器学习模型等技术 对这些特征进行 建模 。 如果有必要的话,还需要根据手头要解决的问题部署该模型以供将来使用。 获取原始数据后,直接在数据之上构建模型是鲁莽的,因为我们无法从普通

优秀的个人博客,低调大师

Python全栈工程师(面向对象)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 Python人工智能从入门到精通 day16补充: 异常处理 文件操作综合练习示例 src_filename = input("请输入源文件路径名: ") dst_filename = input('请输入目标文件路径名: ') try: src = open(src_filename, 'rb') # 打开源文件用来读数据 try: try: dst = open(dst_filename, 'wb') # 打开目标文件用来写 try: while True: b = src.read(4096) # 4096当前Linux系统内核字节大小 if not b: # 已经再也读不到数据了 break dst.write(b) # 写字节到文件 print("复制成功") finally: dst.close() # 必须关闭文件 except OSError: print("打开写文件失败") finally: src.close() # 必须关闭文件 except OSError: print("复制失败") 面向对象编程: 以函数单位 面向对象编程 Ojbect-Oriented Programing什么是对象: 对象是指现实中的物体或实物 对象有什么属性: 对象有很多属性(名词,形容词) 姓名, 年龄, 性别 对象有很多行为(动作,动词) 吃饭,睡觉,工作面向对象: 把一切都看作对象(实例) 用各种对象之间的关系来描述事务什么是类: 拥有相同属性和行为的对象分为一组, 即为一个类 类是用来描述对象的工具,用类可以创建此类的对象(实例)面向对象示意: 车(类)----> BYD E6(京A:88888)实例(对象) \ \----> BMW X5(京A:66666)实例(对象) 狗(类)----> 小京巴(户籍号:0000001)实例(对象) \ \----> 导盲犬(户籍号:0000002)实例(对象) int(类)----> 100(对象) \ \----> 500(实例、对象)类的创建语句: class 类名(继承列表): ‘类的文档字符串’ 实例方法的定义 类变量的定义 类方法的定义(@classmethod) 静态方法的定义(@staticmethod) 作用: 创建一个类 类用于描述对象的行为和属性 类用于创建此类的一个或多个对象 说明: 类名必须是标识符 类名实质上就是变量, 它绑定一个类示例: # 用class语句 创建一个类 class Dog: ''' 这是文档字符串 描述一些小动物 ''' pass 构造函数 构造函数的调用表达式 语法: 类名([创建传参列表]) 作用: 创建这个类的实例对象,并返回此实例的引用关系 示例: dog1 = Dog() # 调用构造函数创建一个实例对象 再用dog1绑定 print(id(dog1)) dog2 = Dog() # 创建另一个实例对象 print(id(dog2)) lst1 = list() # 调用构造函数创建一个列表对象 print(id(lst1)) lst2 = list() # 创建另一个实例对象 print(id(lst2)) 实例说明: 1.实例有自己的作用域和空间名, 可以为该类添加实例变量(也叫属性) 2.实例可以调用类的方法和实例方法 3.实例可以访问类变量和实例变量 实例方法: 语法: class 类名(继承列表) def 实例方法名(self, 参数1, 参数2...): ‘文档字符串’ 语句 作用: 用于描述一个对象的行为, 让此类型的全部对象都拥有相同的行为 说明: 实例方法实质是函数, 是定义类的函数 实例方法至少有一个形参, 第一个形参代表调用方法的实例, 一般命名为“self” 实例方法语法: 实例.实例方法名(调用传参) 或 实例.实例方法名(实参, 调用传参) 示例: # 实例方法的创建和调用 class Dog: ''' 这是文档字符串 描述一些小动物 ''' def eat(self, food): '''此方法用来描述小狗吃的行为''' print("小狗正在吃", food) def slep(self, hour): '''此方法用来描述小狗睡的行为''' print("小狗睡了%d小时" % hour) def play(self, obj): '''此方法用来描述小狗玩的行为''' print("小狗正在玩", obj) dog1 = Dog() # 调用构造函数创建一个实例对象 再用dog1绑定 dog1.eat("单身狗粮") dog1.slep(3) dog1.play("球") dog2 = Dog() dog2.eat("提子") # 创建另一个实例对象 dog1.slep(5) dog1.play("MM") ====================== >>> import day17 小狗正在吃 单身狗粮 小狗睡了3小时 小狗正在玩 球 小狗正在吃 提子 小狗睡了5小时 小狗正在玩 MM >>> dir() ['__builtins__', '__doc__', '__loader__', '__name__', '__package__', '__spec__', 'day17'] >>> dir(day17) ['Dog', '__builtins__', '__cached__', '__doc__', '__file__', '__loader__', '__name__', '__package__', '__spec__', 'dog1', 'dog2'] >>> help(day17) >>> help(list) ====================== 实例属性 atribute(也叫实例变量) 每个实例对象可以有自己的变量, 称为实例变量(也叫属性) 语法: 实例.属性名 赋值规则: 首次为属性赋值则创建此属性 再次为属性赋值则修改属性的绑定关系 作用: 记录每个对象自身数据 示例: # 属性的方法 class Dog: ''' 这是文档字符串 描述一些小动物 ''' def eat(self, food): '''此方法用来描述小狗吃的行为''' print(self.color, "的", self.kinds, "小狗正在吃", food) # 让调用此方法的对象添加一个last_food属性用来记住吃过的信息(方法内添加属性) self.last_food = food # 方法外添加属性 dog1 = Dog() # 调用构造函数创建一个实例对象 再用dog1绑定 dog1.kinds = "京巴" # 为dog1对象添加kinds属性, 绑定为"京巴" dog1.color = "白色" # 为dog1对象添加 color "白色"属性 dog1.color = "原谅色" # 改变dog1对象 color属性 print(dog1.color, "的", dog1.kinds) # 原谅色 的 京巴 dog2 = Dog() # print(dog2.color, "的", dog2.kinds) # 出错 dog2.kinds = "二哈" # 为dog2对象添加kinds属性, 绑定为"二哈" dog2.color = "白色" # 为dog2对象添加 color "白色"属性 dog2.color = "黄色" # 改变dog2对象 color属性 print(dog2.color, "的", dog2.kinds) # 黄色 的 二哈 dog1.eat("单身狗粮") # 原谅色 的 京巴 小狗正在吃 单身狗粮 dog2.eat("爱心蛋糕") # 黄色 的 二哈 小狗正在吃 爱心蛋糕 # 可以在方法(函数)外添加对象属性也可以在方法内添加 通常在方法内(函数) 删除属性:del 例如: class Dog: pass dog1 = Dog() dog1.color = "白色" del dog1.color del 变量名 删除变量del 列表[整数表达式] 删除列表元素del 字典[键] 删除字典中的键del 对象.属性 删除对象的属性 初始化方法: 作用: 对新创建的对象添加属性 语法: def __init__(self[, 形参列表]): 语句块 [ ] 代表可省略 说明: 1.初始化方法名必须为‘__init__’不可改变 2.初始化方法在构造函数创建实例后自动调用,且将实例自身 通过第一个参数self 传入__init__方法 3.构造函数的实参将通过__init__方法的参数列表传入到‘__init__’方法中 4.初始化方法内如果需要return语句返回 则返回None 示例: # 初始化方法 __init__ class Car: '''定义汽车类''' def __init__(self, c, b, m): self.color = c # 颜色 self.brand = b # 品牌 self.model = m # 型号 print('__init__方法被调用') def run(self, speed): print(self.color, "的", self.brand, self.model, "正才以", speed, "公里没小时行驶") a4 = Car("红色", "奥迪", "A4") # 调用构造函数 a4.run(1000) # 红色 的 奥迪 A4 正才以 1000 公里没小时行驶 s3 = Car("蓝色", "TESLA", "Model S") # 调用构造函数 s3.run(6000) # 蓝色 的 TESLA Model S 正才以 6000 公里没小时行驶 析构方法: 语法: class 类名: def __del__(self): ... 说明: 析构方法在对象被销毁时会自动调用 Python建议不要在对象销毁时做任何事情, 因为销毁时间难以确定示例: # 析构方法 class Car: def __init__(self, name): self.name = name print("汽车", name, "被创建") def __del__(self): '''析构方法,对象被销毁时 次方法调用''' print("汽车", self.name, "被销毁") c1 = Car("BYD E6") input("此汽车是伪造! 按回车继续程序...") # 汽车 BYD E6 被创建 # 此汽车是伪造! 按回车继续程序... # 汽车 BYD E6 被销毁 c2 = c1 del c2 input() # 汽车 BYD E6 被创建 预置实例属性: __dict__属性 __dict__属性绑定一个储存此实例自身变量的字典示例: >>> class Dog: ... pass >>> dog1 = Dog() >>> dog1.name = "哈哈" >>> dog1.__dict__ {'name': '哈哈'} >>> dog1.age = 3 >>> dog1.__dict__ {'age': 3, 'name': '哈哈'} >>> del dog1.age >>> dog1.__dict__ {'name': '哈哈'} >>> __class__属性 此属性用于绑定创建一些实例的类 作用: 可以借助于此属性来访问创建此实例的类示例: >>> class Dog: ... pass ... >>> dog1 = Dog() >>> Dog <class '__main__.Dog'> >>> dog1.__class__ <class '__main__.Dog'> >>> type(dog1) <class '__main__.Dog'> >>> type(dog1) is Dog True >>> dog2 = dog1.__class__() # 等同于 dog2 = Dog() >>> dog2.__class__ <class '__main__.Dog'> 面向对象的综合示例: 有两个人: 1. 姓名:张三 年龄:25 2. 姓名:李四 年龄:5 行为: 1.教别人学学东西 teach 2.赚钱 works 3.借钱 borrow 事情: 张三 教 李四 学 Python 李四 教 张三 学 跳皮筋 张三 上班赚了 1000 元钱 李四 向 张三 借了 200 元钱 打印张三的信息:25岁 的 张三 有钱 800元 他学会了跳皮筋 打印李四的信息:5岁 的 李四 有钱 200元 他学会了python class Human: '''描述人的行为和属性 teach(self, other, subject) 学习技能 works(self, money) 赚钱 borrow(self, other, money) 借钱 def print_info(self) 输出信息 ''' def __init__(self, name, age): '''初始化基本信息和属性''' self. name, self.age = name, age # 名字, 年龄 self.money = 0 # 钱数 self.skill = [] # 技能列表 def teach(self, other, subject): '''实例行参对象1 教 实例行参对象2 学 技能的实例方法 self:实例形参1(调用对象自己) other: 实例形参2 (调用目标对象) subject: 技能 ''' other.skill.append(subject) # 行参对象2 追加新技能 print(self.name, "教", other.name, "学", subject) def works(self, money): '''实例行参对象的 赚钱 实例方法 self:实例行参(调用对象自己) money:赚的钱数 ''' self.money = money # 实例形的钱数 print(self.name, "上班赚了", money, "元钱") def borrow(self, other, money): '''实例行参对象1 向 实例行参对象2 借钱 的实例方法 self:实例形参1(调用对象自己) other: 实例行参2 (调用目标对象) monay: 接的钱数 ''' if other.money > money: # 目标对象的钱小于借钱数额 借钱失败 self.money += money # 自己的钱 other.money -= money # 目标对象剩余的钱 print(self.name, "向", other.name, "借了", self.money, "元钱") else: print(self.name, "向", other.name, "借钱失败!") def print_info(self): '''打印输出self的信息实例方法 self:实例行参(调用对象自己) ''' print(self.age, "岁的", self.name, "有钱", self.money, "元 他学会了:", self.skill) zhang3 = Human("张三", 25) li4 = Human("李四", 5) # 张三教李四Python zhang3.teach(li4, "Python") # 李四教张三玩游戏 li4.teach(zhang3, "玩游戏") # 张三上班赚了 1000 元钱 zhang3.works(1000) # 李四向张三借 200 元钱 li4.borrow(zhang3, 200) # 打印李四信息 li4.print_info() # 打印张三信息 zhang3.print_info() # 第一个实例形参一般为调用者自己 # (自动传参自己 不需要填写 直接从第二个形参开始) # __init__()初始化信息函数内的属性为公用属性 # 初始化对象后每个对象都会调用__init__内的属性 # 其他方法(单独属性)另需调用 用于类的函数: isinstance(obj, class_or_tuple) 返回这个对象obj是否是某个类的对象或某些类中的一个类的对象, 如果是则返回True,否则返回False type(obj) 返回对象的类型 >>> a = 100 >>> isinstance(a, int) True >>> isinstance(a, bool) False >>> a = 100.0 >>> isinstance(a, int) False >>> isinstance(a, float) True >>> type(a) <class 'float'> >>> a = 100 >>> type(a) <class 'int'> >>> 练习: 自己写一个'人'类: Human class Human: def set_info(self, name, age, address='未知'): '''此方法用来给人对象添加'姓名', '年龄', '家庭住址'三个属性''' ... # << 此处自己实现 def show_info(self): '''显示此人的全部信息''' ... # 此处自己实现 如: h1 = Human() h1.set_info('小张', 20, '北京市朝阳区') h2 = Human() h2.set_info('小李', 18) h1.show_info() # 小张今年 20 岁,家庭住址:北京市朝阳区 h2.show_info() # 小李今年 18 岁,家庭住址:末知 答案: class Human: def set_info(self, name, age, address='未知'): '''此方法用来给人对象添加'姓名', '年龄', '家庭住址'三个属性''' self.name = name self.age = age self.address = address def show_info(self): '''显示此人的全部信息''' print(self.name, '今年', self.age, '岁,家庭住址:', self.address) h1 = Human() h1.set_info('小张', 20, '北京市朝阳区') h2 = Human() h2.set_info('小李', 18) h1.show_info() # 小张今年 20 岁,家庭住址:北京市朝阳区 h2.show_info() # 小李今年 18 岁,家庭住址:末知 class Human: def set_info(self, name, age, address='未知'): '''此方法用来给人对象添加'姓名', '年龄', '家庭住址'三个属性''' self.name = name self.age = age self.address = address def show_info(self): '''显示此人的全部信息''' print(self.name, '今年', self.age, '岁,家庭住址:', self.address) h1 = Human() # h1.set_info('小张', 20, '北京市朝阳区') Human.set_info(h1, '小张', 20, '北京市朝阳区') h1.show_info() # 小张今年 20 岁,家庭住址:北京市朝阳区 练习: 写一个Student类 1) 为该类添加初始化方法, 实现在创建对象时自动设置 '姓名','年龄', '成绩' 属性 2) 添加set_score方法能修改成绩信息 3) 添加show_info方法打印学生对象的信息 如: class Student: def __init__(...): ... ... s1 = Student('小王', 15, 59) s1.show_info() # 小王 今年 17 岁, 成绩是: 59 s1.set_score(80) s1.show_info() # 小王 今年 17 岁, 成绩是: 80 答案: class Student: def __init__(self, n, a, s): self.name, self.age, self.score = n, a, s def show_info(self): print(self.name, '今年', self.age, '岁, 成绩是:', self.score) def set_score(self, s): assert 0 <= s <= 100, '参数错误' self.score = s s1 = Student('小王', 15, 59) s1.show_info() # 小王 今年 17 岁, 成绩是: 59 s1.set_score(80) # s1.score = 80 s1.show_info() # 小王 今年 17 岁, 成绩是: 80 上面两个练习我写了一份很详细的 明天改 这个先凑合着... 练习: 修改原来的学生信息管理程序,将原来字典来存储学生信息, 现改为用对象来存储学生信息 # file : student.py class Student: def __init__(self, n, a, s): .... L = [] # L.append({...}) 改为对象 L.append(Student('xiaozhang', 20, 100)) (要求类Student 要写在模块 student.py中) 示例: # 假如文件中有这么多学生信息 L = [{"name": "Tom", "age": 15, "score": 98}, {"name": "AL", "age": 16, "score": 95}, {"name": "Lix", "age": 16, "score": 95}, {"name": "Li", "age": 16, "score": 95}, {"name": "ix", "age": 16, "score": 95}, {"name": "ix", "age": 16, "score": 95}, {"name": "Ax", "age": 16, "score": 95}, {"name": "i", "age": 16, "score": 95}, {"name": "x", "age": 16, "score": 95}, {"name": "Lx", "age": 16, "score": 95}, {"name": "ALi", "age": 16, "score": 95}, {"name": "Ka", "age": 16, "score": 95}, {"name": "Kla", "age": 16, "score": 95}, {"name": "KAl", "age": 16, "score": 95}, {"name": "Ala", "age": 16, "score": 95}, {"name": "Al", "age": 16, "score": 95}, {"name": "KAla", "age": 17, "score": 100}] class Student: '''创建学生类用来描述学生基本信息''' def __init__(self, n, a, s): '''初始化学生信息''' self.name, self.age, self.score = n, a, s def student_info(self): '''输出此学生信息''' print("Name:", self.name, "Age:", self.age, "score:", self.score) def student_list(L): '''将文件内学生信息编号存入列表''' L1 = [] for x, y in zip(L, range(1, len(L) + 1)): y = Student(x["name"], x["age"], x["score"]) L1.append(y) return L1 # 也可以用迭代器函数 # def student_list(): # for x in L: # y = Student(x["name"], x["age"], x["score"]) # yield y # 输出所有学生信息 def print_student(L): '''输出有所有学生信息''' for stud in L: stud.student_info() print_student(student_list(L))

优秀的个人博客,低调大师

Python全栈工程师(异常(基础))

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 Python人工智能从入门到精通 补充:包的相对导入 只对后两种导入方式有用 前两次改进的学生管理系统在20课中 已补充 异常(基础)except: 什么是错误: 是指由于逻辑或语法等导程序无法正常执行的问题 什么是异常: 是程序出错的标识符的一种状态 当异常发时 程序不会再向下执行,而转去调用此函数的地方 待处理此错误并恢复为正常状态 异常的作用: 用作信号, 通知上层调用者有错误产生需要处理try 语句: 两种语法: ry-except语句(接受异常通知) try-finally语句try-except 语法 : try: 可能触发异常的语句 except 错误类型1[as 变量1]: 异常处理语句2 except 错误类型2[as 变量2]: 异常处理语句2 except (错误类型3, 错误类型4,...)[as 变量3]: 异常处理语句3 ...... except: 异常处理语句(其他)(匹配所有类型错误) else: 未发生异常语句(可以没有此语句 没有发成异常时调用) finlly: 最终语句 作用: 尝试捕获异常, 将程序由异常状态转为正常状态并正常执行 说明: 1. as 子句是用于绑定错误对象的变量,可以省略 2. except 子句可以有一个或多个,但至少要有一个 3. else 子句最多只能有一个,也可以省略不写 4. finally 子句最多只能有一个,也可以省略不写 5. else 子句将在try没有出现异常时执行 6. finally子句的语句在任何情况下都会被执行 示例: # 此示例示意用try-except 语句捕获异常并做出相应的处理 def div_apple(n): print("%d个苹果您想分给几个人?" % n) s = input("请输入人数: ") cnt = int(s) # <- 此处可能触发ValueError类型错误 result = n / cnt # <- 此处可能触发ZeroDivisitionError错误 print("每个人分了%d个苹果" % result) try: print("开始分苹果") div_apple(10) # 可能触发异常的调用 print("结束分苹果") except ValueError: print("发生成值错误,已处理并转为正常状态!") except ZeroDivisionError: print("发生了被零除的错误,程序已转为正常状态") print("程序正常执行并完全任务,退出程序") try-finally语法: try: 可能触发异常的语句 finally: 最终语句 说明: 1.finally子句不可以省略 2.一定不存在except子句 作用: 通常try-finally语句来做触发异常时必须要处理的事情 无论异常是否发生, finally子句一定会被执行 注意: try-finally 语句不会改变程序的(正常/异常)状态 示例: # 以下以 煎蛋为例示意 try-finally语句的用法 # 必须要做的事情是,关闭天燃气 def fry_egg(): print("打开天燃气点燃...") try: count = int(input("请输入鸡蛋个数: ")) print("完成煎鸡蛋,共煎了%d个鸡蛋" % count) finally: print("关闭天燃气") fry_egg() raise 语句:(发起异常通知) 作用: 触发一个错误, 让程序进入异常状态 语法: raise 异常类型 或 raise 异常对 实例: def make_exception(): print("函数开始") # 发出一个ValueError类型的错误通知给调用者 # raise ValueError err = ValueError("这是自定义的错误数据") raise err # 用 err触发一个异常通知 print("函数结束") try: make_exception() print("make_exception调用结束!") except ValueError as e: print("接收到ValueError类型的异常通知") print("错误对象是:", e) assert 断言语句: 语法: assert 真值表达式, 错误数据(通常是字符串) 作用: 当真值表达式为False时, 用错误数据创建一个AssertionError 类型的错误, 并进入异常状态 等同于: if 真值表达式 == false raise AssertrtionError(错误数据) 实例: def get_score(): s = int(input("请输入学生成绩: ")) assert 0 <= s <= 100, '成绩超出范围' # if not (0 <= s <= 100): # raise AssertionError('成绩超出范围') return s try: score = get_score() except AssertionError as err: print("错误数据是:", err) print('获取成绩失败') score = 0 print("学生的成绩为:", score) 小结: 异常处理语句(4条): try-except 语句: 用于接受异常通知, 捕获异常 try-finally 语句: 执行必须执行的语句 raise 语句: 发送异常通知, 并进入异常状态 assert 语句: 根据条件选着性的发送 AssertionError类型的异常通知为什么要处理异常机制: 在程序调用层数比较深的时候, 向主调用函数传递错误信息 需要层层return返回 比较麻烦, 用异常处理机制可以较简单的传递错误信息 Python全部的错误类型 错误类型 说明 以下内容必讲 ZeroDivisionError 除(或取模)零 (所有数据类型) ValueError 传入无效的参数 AssertionError 断言语句失败 StopIteration 迭代器没有更多的值 IndexError 序列中没有此索引(index) IndentationError 缩进错误 OSError 输入/输出操作失败 ImportError 导入模块/对象失败 NameError 未声明/初始化对象 (没有属性) AttributeError 对象没有这个属性 GeneratorExit 生成器(generator)发生异常来通知退出 TypeError 对类型无效的操作 KeyboardInterrupt 用户中断执行(通常是输入^C) OverflowError 数值运算超出最大限制 FloatingPointError 浮点计算错误 BaseException 所有异常的基类 SystemExit 解释器请求退出 Exception 常规错误的基类 StandardError 所有的内建标准异常的基类 ArithmeticError 所有数值计算错误的基类 EOFError 没有内建输入,到达EOF 标记 EnvironmentError 操作系统错误的基类 WindowsError 系统调用失败 LookupError 无效数据查询的基类 KeyError 映射中没有这个键 MemoryError 内存溢出错误(对于Python 解释器不是致命的) UnboundLocalError 访问未初始化的本地变量 ReferenceError 弱引用(Weak reference)试图访问已经垃圾回收了的对象 RuntimeError 一般的运行时错误 NotImplementedError 尚未实现的方法 SyntaxError Python 语法错误 TabError Tab 和空格混用 SystemError 一般的解释器系统错误 UnicodeError Unicode 相关的错误 UnicodeDecodeError Unicode 解码时的错误 UnicodeEncodeError Unicode 编码时错误 UnicodeTranslateError Unicode 转换时错误 以下为警告类型 Warning 警告的基类 DeprecationWarning 关于被弃用的特征的警告 FutureWarning 关于构造将来语义会有改变的警告 OverflowWarning 旧的关于自动提升为长整型(long)的警告 PendingDeprecationWarning 关于特性将会被废弃的警告 RuntimeWarning 可疑的运行时行为(runtime behavior)的警告 SyntaxWarning 可疑的语法的警告 UserWarning 用户代码生成的警告 详见:help(builtins) 练习: 写一个函数 get_score() 来获取学生成绩, 要求用户输入 1~100的整数,输果输入出现异常,返此函数返回0, 否则返回用户输入的成绩 示例: def get_score(): ... score = get_score() print("学生的成绩是:", score) 练习: 1. 一个球从100米高空落下 ,每次落地后反弹高度是原高度的一半, 在落下 1)写程序算出皮球在第10次落地后反弹高度是多高? 2)打印出球共经过多少米的路程 答案: def ball(n, m): L = [100] while True: if n == 0: print("最后弹起的高度是%s米" % s) break s = m * 0.5 m = s L.append(s + m) n -= 1 return L print("10次共经历了%s米的路程" % sum(ball(10, 100))) 2. 分解质因数, 输入一个整数, 分解质因数 , 如: 输入 90 则打印: “90=2*3*3*5” (质因数是指最小能被原数整除的素数 不包括1) 答案: def m(n): ret = [] while n > 1: for i in range(n): k = i + 2 if n % k == 0: ret.append(k) n = int(n / k) break return ret print(m(90)) 3. 修改原学生信息管理程序,加入异常处理语句,让程序在任何情况下都能够按逻辑正常执行. 例如: 输入成绩和年龄时,如果用户输入非法字符串也不会导致程序崩溃

优秀的个人博客,低调大师

Python全栈工程师(集合、函数)

ParisGabriel 感谢 大家的支持 你们的阅读评价就是我最好的动力 我会坚持把排版内容以及偶尔的错误做的越来越好 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 Python人工智能从入门到精通 集合 set: 集合是可变的容器 集合内的数据对象都是唯一的(不能重复的) 集合是无序的储存结构。集合中的数据没有先后顺序关系 集合内的元素必须是不可变对象 集合是可迭代对象 集合相当于只有键没有值得字典(键则是集合的数据) (相当于字典和列表的结合 ) 创建集合: s = set() #空集合 s = {3.14,True,(1970.1.1),“hello”} #非空 集合的构造函数: set()创建一个空集合(不能用{} 否则就是字典了) set(iterable)用可迭代对象创建一个新的集合 创建新集合 内容重复会自动去重 例如: 集合的运算: 交集、并集、补集,子集、超集& 生成连个集合的交集: 重复部分 s1 ={1,2,3} s2 ={2,3,4} s3 = s1&s2 #s3 = {2,3} | 生成两个集合的并集: 所有不重复部分 s1 ={1,2,3} s2 ={2,3,4} s3 = s1 | s2 #s3 = {1,2,3,4} - 生成两个集合的补集: 相当于减法 s1 ={1,2,3} s2 ={2,3,4} s3 = s1 - s2 #s3 = {1} ^ 生成两个集合的对称补集: 相当于减法相加 s1 ={1,2,3} s2 ={2,3,4} s3 = s1 ^ s2 # (s1 - s2 | s2 - s1) #{1, 4} > 判断一个集合是另一个集合的超集< 判断一个集合是另一个集合的子集 s1 ={1,2,3} s2 ={2,3} s1 > s2 #true s1 为s2的 超集 s1 < s2 #true s1 为s2的 子集 (包含关系判断)== != 集合相同/不同: s1 ={1,2,3} s2 ={3,2,1} s1 == s2 # true s1 != s2 #false in / not in : 等同于字典的运算 判断某个值是否存在 集合和字典的优点: in/not in 运算符速度相对来说快一些 能用于集合的函数: len(x)、max(x)、min(x)、sum(x)、any(x)、all(x) Python3中常用的集合方法: 方法; 意义: S.add(e) 在集合中添加一个新的元素e;如果元素已经存在,则不添加 S.remove(e) 从集合中删除一个元素,如果元素不存在于集合中,则会产生一个KeyError错误 S.discard(e) 从集合S中移除一个元素e,在元素e不存在时什么都不做; S.clear() 清空集合内的所有元素 S.copy() 将集合进行一次浅拷贝 S.pop() 从集合S中删除一个随机元素;如果此集合为空,则引发KeyError异常 S.update(s2) 用 S与s2得到的全集更新变量S S.difference(s2) 用S - s2 运算,返回存在于在S中,但不在s2中的所有元素的集合 S.difference_update(s2) 等同于 S = S - s2 S.intersection(s2) 等同于 S & s2 S.intersection_update(s2) 等同于S = S & s2 S.isdisjoint(s2) 如果S与s2交集为空返回True,非空则返回False S.issubset(s2) 如果S与s2交集为非空返回True,空则返回False S.issuperset(...) 如果S为s2的子集返回True,否则返回False S.symmetric_difference(s2) 返回对称补集,等同于 S ^ s2 S.symmetric_difference_update(s2) 用 S 与 s2 的对称补集更新 S S.union(s2) 生成 S 与 s2的全集 集合推导式: 结合推导式是用可迭代对象生成集合的表达式语法: {表达式 for 变量 in 可迭代对象[if 真值表达式]} 之前说过 [ ] 内的代表可以省略例如: L= [1, 2, 5, 6, 3, 5, 9, 4, 5] s = {x for x in L)} (推导式嵌套同列表 、 字典一致) 固定集合 frozenset: 是不可变的、无序的、含有唯一元素的集合 用于固定集合可以作为字典的键,还可以作为集合的值构造函数: frozenset() 创建一个空固定集合 frozenset(iterable)用可迭代对象创建固定集合例如: f = frozenset()# 空固定集合 f = frozenset([ 1, 3, 5, 7]) # f = frozenset({1, 3, 5, 7}) 固定集合运算: & 交集 、 | 并集 、- 补集、^ 对称补集 >、 >= 、< 、<=、 ==、 != in /not in (和集合 set 一致)固定集合方法: 集合的方法取掉所有修改方法 小结: 数据类型: 数值类型: int、float、complex、bool 容器类型: 不可变容器: str、tuple、frozenset、bytes(字节串) 可变容器: list、dict、set、bytearray(字节组) 值: None、false、True运算符: 算数运算符: +、 - 、 * 、 / 、 // 、 % 、 ** 比较运算符: < 、 > 、 <= 、 >= 、 == 、 != in / not in 、 is / is not 布尔运算符: not 、 and 、or +(正号)、 -(负号) &、^ 、| 、 [ ] (索引) 表达式: 1 1+2 max(1,2,3,) x if x > y else y (条件表达式) 三种推导式: 列表、字典、集合推导式(3种)语句: 表达式语句: 所有的语句都可单独写在一行,形成一个语句 例如: print(“hello world”) 1 + 2 赋值语句: a = 100 a = b = c = 100 x, y = 100, 200 a[0] = 100 dict [ "name"] = "tarena" del 语句 while 语句 for 语句 break 语句 continue 语句 pass 语句函数: 内建函数:(系统内置函数) len(x) max(x) min(x) sum(x) any(x) all(x) 构造函数:(用来创建同类型的数据对象) bool(x) int(x)(进制转换可以添加进制参数 be>=2 and <= 36) float(x) complex(x) list(x) tuple(x) str(x) dict(x) set(x) abs(x) round(x) pow(x,y,z = None) bin(x) oct(x) hex(x) chr(x) ord(x) range(star,stop,step) input(x) print(x) help(__builtins__) 之前讲的差不多也就这些了 接下来我们讲函数 okeveryone 在开始之前的我想先说两句 咳咳: 之前比如说101等于5对吧 可能手一哆嗦打成了011 有细心的小伙伴就发发现了 给我评论 你们如果有什么问题 可以随时评论 我看到后 都会回复的 能解决的我有时间都会去解决 比如说哪里不懂啊 逻辑想不通啊 或者比较迷茫的 都是可以的 前面12课说的都是常用的和偶尔用的一些基础的运算以及语法 很多东西一次测扯出来根本听不懂的 学习要循序渐进对吧 后面的东西 我们会做一个实战项目 边做边学 有些可能一辈子用不几次的东西就没说 感兴趣的朋友可以 交互模式下help 查看一下帮助 或者官方的api文档 翻译好的api文档都是可以的 第一课之前的那个文章 我在里面加了api文档地址 有兴趣的可以去下载 这个项目的就是学生信息管理系统 昨天的第二题练习 我们已经做了一个开头了对吧 好了不废话了 进入正题 函数: function 函数是可以重复执行调用的语句块 作用: 1.用于封装语句块,提高代码的重用性 2.定义用户级别的函数def 创建函数语句: def 函数名(形参列表): 语句块 说明: 1. 函数的名字就是语句块的名称 2. 函数名的命名规则与变量名相同(函数名必须是标识符) 3. 函数名是一个变量(不要轻易对其赋值) 4. 函数有自己的空间,在函数外部不可以访问函数内部的变量,但是可以访问外部变量 5. 函数如果不需要传入参数,形参列表可以为空 6. 语句部分不能为空,如果为空需要填充passreturn 创建返回值语句: 用于函数中,结束当前函数的执行,返回调用该函数的地方,同时返回一个对象的引用关系 return[表达式] ([ ] 代表可以省略) 说明: 1. 函数调用是一个表达式 2. 如果函数内部没有return语句,函数调用完毕后返回None对象 3. 如果函数需要返回其它的对象需要用到 return 语句函数的调用: 函数名(实际调用传递参数) (实际调用传递参数,简称实参) 练习:1.任意输入一些数字,存于列表L中。当输入负数时结束输入 1) 打印这些数的和 2) 打印这些数有多少种(去重) 3) 除重复的数字后,打印这些剩余数字的和 提示,可以用集合去重 答案: L = [] while True: a = int(input("please input at will ingeger (input '-1' over):")) if a < 0: break L.append(a) print(sum(L)) s = set(L) print(len(s)) print(sum(s)) 2.经理有: 曹操,刘备,孙权 技术员有: 曹操,孙权,张飞,关羽 用集合求:1) 即是经理,也是技术员的有谁? 2) 是经理,但不是技术员的人员都有谁? 3) 是技术员,不是经理的都有谁 4) 张飞是经理吗? 5) 身兼一职的人都有谁? 6) 经理和技术员共有几个人? 答案: s = {"曹操", "刘备", "孙权"} s1 = {"曹操", "孙权", "张飞", "关羽"} if "张飞" in s: x = "是" else: x = "不是" print(''' 即是经理,也是技术员的有:%s 是经理,但不是技术员的人员有:%s 是技术员,不是经理的有:%s 张飞%s经理 身兼一职的人有:%s 经理和技术员共有:%d个人 ''' % ( s & s1, s - s1, s1 - s, x, s ^ s1, len(s | s1))) 3. 写一个函数myadd, 此函数中的参数列表里有两个参数x, y 此函数的功能是打印 x + y 的和 def myadd(....): .... # 注: .... 部是是我们要填写代码的地方 myadd(100, 200) # 300 print("ABC", "123") # ABC123 4. 写一个函数 mysum, 传入一个参数x代表终止整数, 打印出 1 + 2 + 3 + 4 + ..... + x的和 def mysum(x): .... mysum(100) # 5050 mysum(4) # 10 答案: def mysum(x): s = 0 for i in range(1, x + 1): s += i print(s) mysum(100) mysum(4) 5. 写一个函数 mymax, 给函数传递两个参数,返回两个实参中最大的一个 def mymax(a, b): .... v = mymax(100, 200) print('v =', v) # v = 200 print(mymax('ABC', 'abc')) # abc 答案: def mymax(a, b): if a > b: return a return b x = mymax(100, 200) print(x) 6. 写一个函数 input_number def input_number(): .... 此函数用来获取用户循环输入的整数,当用户输入负数时结束输入。将用户输入的数字以列表的形式返回,再用内建函数max, min, sum取出户输入的最大值,最小值及和 L = input_number() print(L) # 打印此列表 print("用户输入的最大数是:", max(L)) print("用户输入的最小数是:", min(L)) print("用户输入的数的和是:", sum(L)) 答案: def inout_number(): L = [] while True: number = int(input("please inoput (-1:over):")) if number < 0: break L.append(number) return L L = inout_number() print("Top1 ", max(L)) print("lower1 ", min(L)) print("sum ", sum(L)) 7. 写一个函数 print_odd, 打印从begin开始,到end结束(不包含end)内的全部的奇数 def print_odd(begin, end): .... print_odd(1, 10) # 打印 1 3 5 7 9d ptint_odd(10, 20) # 打印 11 13 15 17 19 答案: def myodd(begin, end): for x in range(begin, end): if x % 2 != 0: print(x, end = " ") print() myodd(1, 10) myodd(10, 100) 9. 改写之前的学生信息管理程序 改为两个函数: 1. 写一个函数 input_student() 用于返回学生信息的字典的列表(以前格式一样) 2. 写一个函数 output_student(lst) 此函数传入一个列表lst,即字典的列表 此函数把lst的内容以表格形式打印出来 def input_student(): .... def output_student(lst): ... L = input_student() # 获取学生信息的列表 output_student(L) # 把L 以列表的形式打印 答案: # 创建输入函数:input_student开始 def input_student(): print("--------Student information enty--------") L = [] while True: name = input("please input name:") if name == "": break age = input("please input age:") score = input("please input score:") d = {} d = {"name": name, "age": age, "score": score} L.append(d) return L # 创建输入函数:input_student完成 # 创建输出函数:output_student开始 def output_student(lst): print("-------Student information sheet-------") print("+---------------+----------+----------+") print("| name | age | score |") print("+---------------+----------+----------+") for d in lst: name = d["name"].center(15) age = d["age"].center(10) score = d["score"].center(10) print('''|%s|%s|%s|''' % (name, age, score)) print("+---------------+----------+----------+") # 创建输出函数:output_student完成 output_student(input_student())

优秀的个人博客,低调大师

Python全栈工程师(元组、字典)

ParisGabriel 感谢 大家的支持 你们的阅读评价就是我最好的更新动力 我会坚持吧排版做的越来越好 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 Python人工智能从入门到精通 函数:tyup(x) 用来返回x对应的数据类型 range(x) 返回可迭代对象sublime编辑器: 中文空格查找方法 空格中间没有小点 行首小黑点 语法不规范 大黑点语法错误 中文空格也会出错元组 tuple: 元组是不可变的序列,同list一样,元组可以存放任意数据类型的容器元组的表示方法: 用小括号()括起来,单个元素括起来后面加 “,”逗号区分单个对象还是元组 元组的小括号可以省略 但元素低于2个 “,” 不能省略元组的构造函数: tuple() 生成一个空元组,等同于() tuple(iterable) 用可迭代对象生成一个元组元组的运算: + += * *= < > <= >= == != in , not in 索引[ ], 切片[ : ] [ : : ] + 拼接元组 * 生成重复元组元祖的比较: 规则与列表规则完全相同 in , not in 规则与列表规则完全相同索引和切片: 索引取值和切片取值的规则与列表相同 元组不支持索引赋值和切片赋值(因为元组是不可变的序列)元组的方法: T.index(v[, begin[, end]]) 返回对应圆的索引下表 T.count(x) 返回对应元素个数序列相关函数:len(x)、max(x)、min(x)、sum(x)、any(x)、all(x) str(x) 创建字符串构造函数: (构造函数一定是他的类型名 返回对应类型) list(inerable) 创建列表 tuple(inerable) 创建元组 reversed(x) 返回反向顺序的可迭代对象 sorted(inerable,key = None,reverse = false) 返回已排列列表 inerable:可迭代对象 (key = None,reverse = false:后面将)例如: t = (4, 5, 8, 3, 2, 1) L = [x for x in reversed(t)] print(L) 容器小结: 字符串str # 不可变序列, 只能存字符 列表 list # 可变序列,可存任意数据 元组 tuple #不可变序列,可以存任意数据字典 dict: 1.字典是一种可变容器,可以储存任意类型数据 2.字典中的每个数据都是用“键”(key)进行索引 ,而不像序列可以用整数下标来进行索引 3.字典中的数据没有先后关系,字典的储存是无序的 4.字典的数据以键(key)- 值(value)对形式进行映射储存 5.字典的键不能重复,只能用不可变类型作为字典的键字典的字面值的表示方法: 字典的表示方式是以{ }括起来的,以冒号开头“:” 分隔键-值对,各键-值对之间用逗号分开创建字典: d = { } #空字典 d = { “Nemo”:“yang”,“age”: 35} #非空字典 键:“Nemo”值:“yang”(一个键值对) 键(只能用不可变类型) 值可以任意类型 字符串str 列表 list 元组 tuple 字典 dict 都是可以任意包含关系的 字典的构造函数dict: dict() 生成一个字的字典 等同于{ } dict(iterable) 用可迭代对象初始化一个字典 dict(** keargs) 用关键字传参形式创建字典 关键字传参:(dict(name = “tarena”,age = 15)) 索引:d [key ] 字典的key:不可变数据类型: bool,int,float,complex,str,tuple,frozeset,bytes可变数据类型有四种: list 列表 dict 字典 set 集合 bytearray 字节数组 字典的基本操作: 键索引 用 [ ] 运算符获取字典内“键”对应的值 也可以修改 字典[ 键 ] = 值 如果键不存在时,创建键,并绑定对应的值 当存在时,修改键绑定的值 del 字典 [ 键 ] (删除元素)字典的成员资格判断 in 运算符: 可以用 in 运算符判断一个键是否存在于字典中,如果存在则返回true 否则返回false not in 与 in 结果相反例如: d = {"name": "Gabriel", "age": 20} if "name" in d: print("name 在字典中 ") print(15 in d) # false 只判断键 不判断值 字典的迭代访问: 字典是可迭代对象,字典只能对键进行迭代访问例如: d = {"name":"tarena", age: 15} for x in d: print(x, d[ x ])内建函数:(内建:代表系统内直接有的函数) len(d) 返回的是键值对个数 max(d) 返回的是键最大值 min(d) 返回的是键最小值 sum(d) 返回的是键得和 any(d) 一个键为true则为true all(d)所有键为true 则为true字典的方法: 函数 说明 D代表字典对象 D.clear() 清空字典 D.pop(key) 移除键,同时返回此键所对应的值 D.copy() 返回字典D的副本,只复制一层(浅拷贝) D.update(D2) 将字典 D2 (合并)到D中,如果键相同,则此键的值取D2的值作为新值 D.get(key, default) 返回键key所对应的值,如果没有此键,则返回default D.keys() 返回可迭代的 dict_keys 集合对象(返回键) D.values() 返回可迭代的 dict_values 值对象(返回值) D.items() 返回可迭代的 dict_items 对象(返回键值对)字典推导式: 是用可迭代对象创建字典的表达式语法: {键表达式:值表达式 for 变量 in 可迭代对象 if 真值表达式} if子句可以省略 d = { x:x ** 2 for x in range(10)}字典VS列表: 1.都是可变对象 2.索引方式不同,列表用整数(下标)索引 ,字典用键(key)索引 3.字典的插入,删除,修改数据的速度可能会快于列表 4.列表的存储是有序的(内存中一般用排列算法),字典的储蓄是无序的(内存中一般用散列算法插入数据) 练习: 1.已知有两个等长的列表 list1 和 list2 以list1中的元素为键,以list2中的元素为值,生成相应的字典 list1 = [1001, 1002, 1003, 1004] list2 = ['Tom', 'Jerry', 'Spike', 'Tyke'] 答案: list1 = [1001, 1002, 1003, 1004] list2 = ['Tom', 'Jerry', 'Spike', 'Tyke'] d = {list1[x]: list2[x] for x in range(len(list1))} print(d) 2. 输入任意个学生的姓名,年龄,成绩,每个学生的信息存入字典中,然后放入至列表中,每个学生的信息需要手动输入 当输入姓名为空时结束输入: 如: 请输入姓名: xiaozhang 请输入年龄: 20 请输入成绩: 100 请输入姓名: xiaoli 请输入年龄: 18 请输入成绩: 98 请输入姓名: <回车> 结束输入 要求内部存储格式如下: [{'name':'xiaozhang', 'age':20, 'score':100}, {'name':'xiaoli', 'age':18, 'score':98}] 打印所有学生的信息如下: +---------------+----------+----------+ | name | age | score | +---------------+----------+----------+ | xiaozhang | 20 | 100 | | xiaoli | 18 | 98 | +---------------+----------+----------+ 答案: L = [] while True: n = input("请输入姓名:") if n == '': break a = int(input("请输入年龄:")) s = int(input("请输入成绩:")) d = {} d['name'] = n d['age'] = a d['score'] = s L.append(d) # print(L) print("+---------------+----------+----------+") print("| name | age | score |") print("+---------------+----------+----------+") for d in L: n = d['name'].center(15) a = str(d['age']) ac = a.center(10) s = str(d['score']) sc = s.center(10) line = "|%s|%s|%s|" % (n, ac, sc) print(line) print("+---------------+----------+----------+")

优秀的个人博客,低调大师

Python全栈工程师(列表、拷贝)

ParisGabriel 感谢 大家的支持 你们的阅读评价就是我最好的更新动力 我会坚持吧排版做的越来越好 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 Python人工智能从入门到精通 列表创建函数: list(可迭代对象)序列有5种: star 字符串 list 列表 tuple 元组 bytes 后面讲 bytearray 后面讲 序列运算符: in 、 not in > >= < <= + * 列表的索引可以增加、删除、修改、列表的元素值切片赋值: 步长不等于1时切片赋值,赋值运算符的右侧的可迭代对象提供的元素 的个数一定要等于切片切出的片数del语句: 用于删除列表的元素 del 列表 [索引] del 列表 [切片]Python3中常用的序列相关函数: len(x) 返回序列的长度 max (x) 返回最大元素 min(x) 返回序列最小元素 sum(x) 返回序列中所有原素的和 any(x) 真值测试,如果列表中有一个值为真返回true all(x) 真值测试,如果列表中所有值为真返回true 列表的方法(method):help(list) [ ]内的参数代表可以省略 方法 意义L.index(v [, begin[, end]]) 返回对应元素的索引下标, begin:为开始索引,end:为结束索引,当 value 不存在时触发ValueError错误L.insert(index, obj) 将某个元素插放到列表中指定的位置 index:索引 obj:要插入的元素L.count(x) 返回列表中元素的个数 x:元素L.remove(x) 从列表中删除第一次出现在列表中的值 x:元素(例如列表内有2个3 删除第一个 依次进行)L.copy() 复制此列表(只复制一层,不会复制深层对象)L.append(x) 向列表中追加单个元素 可以追加可迭代对象元素L.extend(list) 向列表追加另一个列表 L.clear() 清空列表,等同于 L[:] = []L.sort(reverse=False) 将列表中的元素进行排序,默认顺序按值的小到大的顺序排列L.reverse() 列表的反转,用来改变原列表的先后顺序L.pop([index]) 删除索引对应的元素,如果不加索引,默认删除最后元素,同时返回删除元素的引用关系(相当于取出元素不归还,可以用变量来接受)字符串的文本解析方法:S.split(sep=None) 将字符串使用sep作为分隔符分割字符串,返回分隔后的字符串列表,当不给定参数时,用空白字符作为分隔符分隔S.join(iterable) 用可迭代对象中的字符串,返回一个中间用S分隔组合的字符串 S=esp 要插入分割链接的字符 iterable:可迭代对象 潜拷贝和深拷贝: 潜拷贝shallow copy: help(list.copy) 拷贝指在复制过程中,只复制一层变量,不会复制深成变量绑定的对象的复制过程 例如: >>> L = [3.1,3.2] >>> L1 = [1, 2, L] >>> L2 = L1.copy() >>> L1 [1, 2, [3.1, 3.2]] >>> L2 [1, 2, [3.1, 3.2]] >>> L2[2][0] = 3.14 >>> L1 [1, 2, [3.14, 3.2]] >>> L2 [1, 2, [3.14, 3.2]] 深拷贝 deep copy: import copy # 导入copy 模块 例如: L = [3.1, 3.2] L1 = [1, 2, L] L2 = L1.deep copy() L2[2][0] = 3.14 print(L1) #[1, 2, [3.1, 3.2]] print(L2) #1, 2, [3.14, 3.2]] 深拷贝通常只对可变对象进行复制 ,不可变对象通常不会复制(这里深拷贝需要 import copy中的deepcopy 后面讲) 小结: L1 = [1, 2, [3.1, 3.2]] 这里只是纯粹的调用关系 可以通过内存地址查看 L2 = L1 # 不拷贝 同时绑定一个对象 L3 = L1.copy() # 潜拷贝等同于 L3 = L1[:] import copy L4 = copy.deepcopy(L1) #深拷贝 列表推导式 list comprehension: 列表推导式是用可迭代对象生成列表的表达式语法: [表达式 for 变量 in 可迭代对象] 或 [表达式 for 变量 in 可迭代对象 if 真值表达式] 说明: for in 表达式的 if 子句可以省略,省略后将对所有生成的对象进行求值处理 如:生成1~9的平方的列表 L= [x ** 2 for x in range(1,10)]列表推到式的嵌套:语法:L=[表达式 for 变量1 in 可迭代对象1 if 真值表达式1 for 变量2 in 可迭代对象2 if 真值表达式2 ] OK 今天的练习比较多 但是都很简单 争取把每个题都要理解他的原理 不懂得对照上面的参数进行核对一下就可以 想要入门IT就必须多写多练 写的代码也多 你就越熟练 越熟练经验越多 尝试不同的思路去分析 什么时候写的想吐 什么时候才算会了 我们一起加油 练习: 1. 已知有列表: L = [3, 5] 1) 用索引和切片等操作,将原列表改变为: L = [1, 2, 3, 4, 5, 6] 2) 将列表反转,删除最后一个元素后打印此列表 ... print(L) # [6, 5, 4, 3, 2] 答案: L = [3, 5] L[:] = range(1, 7) L[::-1] = range(1, 7)# L[:] = [range(6, 0, -1)] del L[-1] print(L) 2. 1. 写程序,让用户输入一些整数,当输入-1时结束输入,将这些数存于列表L中 1) 打印用户共输入了几个数? 2) 打印您输入的数的最大数是多少 3) 打印您输入的数的最小数是多少 4) 打印您输入的这些数的平均值是多少? 答案: L = [] while True: a = int(input("please input at will integer (input '-1' over):")) if a < 0: break L.append(a) L.sort() print("you input line number", len(L)) print("top1:", L[-1]) print("lower1:", L[0]) print(" average number :", sum(L) / len(L)) 3. 1.已知有一个字符串s = “100, 200, 300, 500, 800”将其转换为整数的列表存于L列表中 答案: s = "100,200,300,500,800" L = s.split(",") print(L) 2.生成前40个婓波那契数(fibonacci)1 1 2 3 5 8 13 .....要求将这些数字保存在列表中打印这些数 答案: L = [1, 1] a = 1 b = 1 while True: a += b b += a L += [a, b] if len(L) > 38: break print(L) 方法二 L = [1, 1] a = 1 b = 0 i = 0 while i < 40: a = a + b b = a - b L.append(b) i += 1 print(L) 4. L= [1, 3, 2, 1, 6, 4, 2, ......98, 82]将列表中出现的重复数字存入另一个列表L2中要求:重复出现多次的数字在L2中只保留一份 (去重) 答案: L = [] while True: a = int(input("please input at will integer (input '-1' over):")) if a < 0: break L.append(a) L2 = [] for x in L: if x not in L2: L2.append(x) print(L) print(L2) 5. 输入多行文字,存入列表中, 每次输入回车后算一行 任意输入多行,当输入回车(即输入空行时结束输入) 1) 按原输入内容在屏幕上输出内容 2) 打印出您共输入了多少行文字 3) 打印出您共输入了多少个字符 答案; L = [] i = 0 while True: a = input("please input at will string direct Enter over:") if a == "": break i += len(a) L.append(a) for x in L: print(x) print("您共输入的行数:", len(L)) print("您共输入的字符:", i) 6. 1. 有字符串"hello" 请用此字符串生成: 'h e l l o' 和 'h-e-l-l-o' 2. 写一个程序,让用户输入很多正整数,当输入小于零的数时结束输入, 1) 打印这些数中最大的一个数 2) 打印这些数中第二大的一个数 3) 删除最小的一个数 4) 打印剩余数的和 答案: s = "heool" L = " ".join(s) print(L) L = "-".join(s) print(L) 7. 用列表推导式生成1~100内奇数的列表 结果是: [1, 3, 5, 7, ..... 99] 答案: L = [x for x in range(1, 100, 2)] print(L) L = [x for x in range(1, 100) if x % 2 != 0] print(L) 8. 生成一个数值为 1 ~ 9的平方的列表,去掉所有的奇数的平方答案: L = [x**2 for x in range(2, 10, 2)] print(L) L = [x**2 for x in range(2, 10) if x % 2 == 0] print(L) Python人工智能从入门到精通 加油!

优秀的个人博客,低调大师

java工程师面试经典题目整理

本人已面试成功 1、面向对象的特征有哪些方面? 封装:通常认为封装是把数据和操作数据的方法绑定起来,对数据的访问只能通过已定义的接口。 多态性:多态性是指允许不同子类型的对象对同一消息作出不同的响应。简单的说就是用同样的对象引用调用同样的方法但是做了不同的事情。多态性分为编译时的多态性和运行时的多态性。方法重载(overload)实现的是编译时的多态性(也称为前绑定),而方法重写(override)实现的是运行时的多态性(也称为后绑定)。 2、访问修饰符public,private,protected,以及不写(默认)时的区别? 作用域当前类同包子类其他 public√√√√ protected√√√× default√√×× private√××× 类的成员不写访问修饰时默认为default。默认对于同一个包中的其他类相当于公开(public),对于不是同一个包中的其他类相当于私有(private)。受保护(protected)对子类相当于公开,对不是同一包中的没有父子关系的类相当于私有。 3、构造器(constructor)是否可被重写(override)? 答:构造器不能被继承,因此不能被重写,但可以被重载。 4、两个对象值相同(x.equals(y)==true),但却可有不同的hashcode,这句话对不对? 答:不对,如果两个对象x和y满足x.equals(y)==true,它们的哈希码(hashcode)应当相同。Java对于eqauls方法和hashCode方法是这样规定的:(1)如果两个对象相同(equals方法返回true),那么它们的hashCode值一定要相同;(2)如果两个对象的hashCode相同,它们并不一定相同。 5、抽象类(abstractclass)和接口(interface)有什么异同? 答:抽象类和接口都不能够实例化,但可以定义抽象类和接口类型的引用。一个类如果继承了某个抽象类或者实现了某个接口都需要对其中的抽象方法全部进行实现,否则该类仍然需要被声明为抽象类。接口比抽象类更加抽象,因为抽象类中可以定义构造器,可以有抽象方法和具体方法,而接口中不能定义构造器而且其中的方法全部都是抽象方法。抽象类中的成员可以是private、默认、protected、public的,而接口中的成员全都是public的。抽象类中可以定义成员变量,而接口中定义的成员变量实际上都是常量。有抽象方法的类必须被声明为抽象类,而抽象类未必要有抽象方法。抽象类和接口中都可以包含静态成员变量。 6、抽象的(abstract)方法是否可同时是静态的(static),是否可同时是本地方法(native),是否可同时被synchronized修饰? 答:都不能。抽象方法需要子类重写,而静态的方法是无法被重写的,因此二者是矛盾的。本地方法是由本地代码(如C代码)实现的方法,而抽象方法是没有实现的,也是矛盾的。synchronized和方法的实现细节有关,抽象方法不涉及实现细节,因此也是相互矛盾的。 7、接口是否可继承(extends)接口?抽象类是否可实现(implements)接口?抽象类是否可继承具体类(concreteclass)? 答:接口可以继承接口。抽象类可以实现(implements)接口,抽象类可继承具体类,但前提是具体类必须有明确的构造函数。 8、AnonymousInnerClass(匿名内部类)是否可以继承其它类?是否可以实现接口? 答:可以继承其他类或实现其他接口,在Swing编程中常用此方式来实现事件监听和回调。 9、数据类型之间的转换: 1)如何将字符串转换为基本数据类型? 2)如何将基本数据类型转换为字符串? 1)调用基本数据类型对应的包装类中的方法parseXXX(String)或valueOf(String)即可返回相应基本类型;Integer.parseInt(a)Integer.valueOf(a) 2)一种方法是将基本数据类型与空字符串(””)连接(+)即可获得其所对应的字符串;另一种方法是调用String类中的valueOf(…)方法返回相应字符串String.valueOf(int)Integer.toString 10、如何实现字符串的反转及替换? 答:方法很多,可以自己写实现也可以使用String或StringBuffer/StringBuilder中的方法。有一道很常见的面试题是用递归实现字符串反转,代码如下所示: [java] view plain copy 1.publicstaticStringreverse(StringoriginStr){ 2.if(originStr==null||originStr.length()<=1) 3.returnoriginStr; 4.returnreverse(originStr.substring(1))+originStr.charAt(0); 5.} 11、列出一些你常见的运行时异常? 答: ArithmeticException(算术异常) ClassCastException(类转换异常) IllegalArgumentException(非法参数异常) IndexOutOfBoundsException(下表越界异常) NullPointerException(空指针异常) SecurityException(安全异常) 12、List、Map、Set三个接口存取元素时,各有什么特点? 答:List以特定索引来存取元素,可以有重复元素。Set不能存放重复元素(用对象的equals()方法来区分元素是否重复)。Map保存键值对(key-valuepair)映射,映射关系可以是一对一或多对一。Set和Map容器都有基于哈希存储和排序树的两种实现版本,基于哈希存储的版本理论存取时间复杂度为O(1),而基于排序树版本的实现在插入或删除元素时会按照元素或元素的键(key)构成排序树从而达到排序和去重的效果。 13、什么是进程,什么是线程?为什么需要多线程编程? 进程是具有一定独立功能的程序关于某个数据集合上的一次运行活动,是操作系统进行资源分配和调度的一个独立单位; 线程是进程的一个实体,是CPU调度和分派的基本单位,是比进程更小的能独立运行的基本单位。 线程的划分尺度小于进程,这使得多线程程序的并发性高;进程在执行时通常拥有独立的内存单元,而线程之间可以共享内存。使用多线程的编程通常能够带来更好的性能和用户体验,但是多线程的程序对于其他程序是不友好的,因为它占用了更多的CPU资源。 14.阐述JDBC操作数据库的步骤 答:下面的代码以连接本机的Oracle数据库为例,演示JDBC操作数据库的步骤。 1.加载驱动。 [java] view plain copy Class.forName("oracle.jdbc.driver.OracleDriver"); 2.创建连接。 [java] view plain copy Connectioncon=DriverManager.getConnection("jdbc:oracle:thin:@localhost:1521:orcl","scott","tiger"); 3.创建语句。 [java] view plain copy PreparedStatementps=con.prepareStatement("select*fromempwheresalbetween?and?"); ps.setInt(1,1000); ps.setInt(2,3000); 4.执行语句。 [java] view plain copy ResultSetrs=ps.executeQuery(); 5.处理结果。 [java] view plain copy while(rs.next()){ System.out.println(rs.getInt("empno")+"-"+rs.getString("ename"));} 6.关闭资源。 [java] view plain copy finally{ if(con!=null){ try{ con.close(); }catch(SQLExceptione){e.printStackTrace(); } } } 15.Statement和PreparedStatement有什么区别?哪个性能更好? 与Statement相比 ①PreparedStatement接口代表预编译的语句,它主要的优势在于可以减少SQL的编译错误并增加SQL的安全性(减少SQL注射攻击的可能性) ②PreparedStatement中的SQL语句是可以带参数的,避免了用字符串连接拼接SQL语句的麻烦和不安全; ③当批量处理SQL或频繁执行相同的查询时,PreparedStatement有明显的性能上的优势,由于数据库可以将编译优化后的SQL语句缓存起来,下次执行相同结构的语句时就会很快(不用再次编译和生成执行计划)。 16、在进行数据库编程时,连接池有什么作用? 由于创建连接和释放连接都有很大的开销(尤其是数据库服务器不在本地时,每次建立连接都需要进行TCP的三次握手,释放连接需要进行TCP四次握手,造成的开销是不可忽视的),为了提升系统访问数据库的性能,可以事先创建若干连接置于连接池中,需要时直接从连接池获取,使用结束时归还连接池而不必关闭连接,从而避免频繁创建和释放连接所造成的开销,这是典型的用空间换取时间的策略(浪费了空间存储连接,但节省了创建和释放连接的时间)。池化技术在Java开发中是很常见的,在使用线程时创建线程池的道理与此相同。 17、Java中是如何支持正则表达式操作的? 答:Java中的String类提供了支持正则表达式操作的方法,包括:matches()、replaceAll()、replaceFirst()、split()。此外,Java中可以用Pattern类表示正则表达式对象,它提供了丰富的API进行各种正则表达式操作,请参考下面面试题的代码。 面试题:-如果要从字符串中截取第一个英文左括号之前的字符串,例如:北京市(朝阳区)(西城区)(海淀区),截取结果为:北京市,那么正则表达式怎么写? [java] view plain copy importjava.util.regex.Matcher; importjava.util.regex.Pattern; classRegExpTest{ publicstaticvoidmain(String[]args){ Stringstr="北京市(朝阳区)(西城区)(海淀区)"; Patternp=Pattern.compile(".*?(?=\\()"); Matcherm=p.matcher(str); if(m.find()){ System.out.println(m.group());} } } 18、获得一个类的类对象有哪些方式? 答: -方法1:类型.class,例如:String.class -方法2:对象.getClass(),例如:"hello".getClass() -方法3:Class.forName(),例如:Class.forName("java.lang.String") 19、如何通过反射创建对象? 答: -方法1:通过类对象调用newInstance()方法,例如:String.class.newInstance() -方法2:通过类对象的getConstructor()或getDeclaredConstructor()方法获得构造器(Constructor)对象并调用其newInstance()方法创建对象,例如:String.class.getConstructor(String.class).newInstance("Hello"); 20、如何通过反射调用对象的方法? 答:请看下面的代码: [java] view plain copy importjava.lang.reflect.Method; classMethodInvokeTest{ publicstaticvoidmain(String[]args)throwsException{ Stringstr="hello"; Methodm=str.getClass().getMethod("toUpperCase"); System.out.println(m.invoke(str)); //HELLO } } 21、简述一下面向对象的"六原则一法则"。 答: 1)单一职责原则:一个类只做它该做的事情。(单一职责原则想表达的就是"高内聚",写代码最终极的原则只有六个字"高内聚、低耦合") 2)开闭原则:软件实体应当对扩展开放,对修改关闭。(在理想的状态下,当我们需要为一个软件系统增加新功能时,只需要从原来的系统派生出一些新类就可以,不需要修改原来的任何一行代码。要做到开闭有两个要点:①抽象是关键,一个系统中如果没有抽象类或接口系统就没有扩展点;②封装可变性,将系统中的各种可变因素封装到一个继承结构中,如果多个可变因素混杂在一起,系统将变得复杂而换乱) 3)依赖倒转原则:面向接口编程。(该原则说得直白和具体一些就是声明方法的参数类型、方法的返回类型、变量的引用类型时,尽可能使用抽象类型而不用具体类型,因为抽象类型可以被它的任何一个子类型所替代) 4)里氏替换原则:任何时候都可以用子类型替换掉父类型。(子类一定是增加父类的能力而不是减少父类的能力,因为子类比父类的能力更多,把能力多的对象当成能力少的对象来用当然没有任何问题。) 5)接口隔离原则:接口要小而专,绝不能大而全。(臃肿的接口是对接口的污染,既然接口表示能力,那么一个接口只应该描述一种能力,接口也应该是高度内聚的。Java中的接口代表能力、代表约定、代表角色,能否正确的使用接口一定是编程水平高低的重要标识。) 6)合成聚合复用原则:优先使用聚合或合成关系复用代码。(通过继承来复用代码是面向对象程序设计中被滥用得最多的东西,记住:任何时候都不要继承工具类,工具是可以拥有并可以使用的,而不是拿来继承的。) 迪米特法则:迪米特法则又叫最少知识原则,一个对象应当对其他对象有尽可能少的了解。(迪米特法则简单的说就是如何做到"低耦合",门面模式和调停者模式就是对迪米特法则的践行。JavaWeb开发中作为前端控制器的Servlet或Filter不就是一个门面吗,浏览器对服务器的运作方式一无所知,但是通过前端控制器就能够根据你的请求得到相应的服务。调停者模式也可以举一个简单的例子来说明,例如一台计算机,CPU、内存、硬盘、显卡、声卡各种设备需要相互配合才能很好的工作。迪米特法则用通俗的话来将就是不要和陌生人打交道,如果真的需要,找一个自己的朋友,让他替你和陌生人打交道。) 22.简述一下你了解的设计模式 -工厂模式:工厂类可以根据条件生成不同的子类实例,这些子类有一个公共的抽象父类并且实现了相同的方法,但是这些方法针对不同的数据进行了不同的操作(多态方法)。当得到子类的实例后,开发人员可以调用基类中的方法而不必考虑到底返回的是哪一个子类的实例。 -代理模式:给一个对象提供一个代理对象,并由代理对象控制原对象的引用。实际开发中,按照使用目的的不同,代理可以分为:远程代理、虚拟代理、保护代理、Cache代理、防火墙代理、同步化代理、智能引用代理。 -适配器模式:把一个类的接口变换成客户端所期待的另一种接口,从而使原本因接口不匹配而无法在一起使用的类能够一起工作。 -模板方法模式:提供一个抽象类,将部分逻辑以具体方法或构造器的形式实现,然后声明一些抽象方法来迫使子类实现剩余的逻辑。不同的子类可以以不同的方式实现这些抽象方法(多态实现),从而实现不同的业务逻辑。 23、用Java写一个单例类。 饿汉式单例 [java] view plain copy publicclassSingleton{ privateSingleton(){} privatestaticSingletoninstance=newSingleton(); publicstaticSingletongetInstance(){returninstance; } } 懒汉式单例 [java] view plain copy publicclassSingleton{ privateSingleton(){} privatestaticSingletoninstance=null; publicstaticsynchronizedSingletongetInstance(){ if(instance==null) instance=newSingleton(); returninstance; } } 注意:实现一个单例有两点注意事项,①将构造器私有,不允许外界通过构造器创建对象;②通过公开的静态方法向外界返回类的唯一实例。这里有一个问题可以思考:Spring的IoC容器可以为普通的类创建单例,它是怎么做到的呢? 24.什么是DAO模式? 答:DAO(DataAccessObject)顾名思义是一个为数据库或其他持久化机制提供了抽象接口的对象,在不暴露数据库实现细节的前提下提供了各种数据操作。将所有对数据源的访问操作进行抽象化后封装在一个公共API中。在这个应用程序中,当需要和数据源进行交互的时候则使用这个接口,并且编写一个单独的类来实现这个接口,在逻辑上该类对应一个特定的数据存储。DAO模式实际上包含了两个模式,一是DataAccessor(数据访问器),二是DataObject(数据对象),前者要解决如何访问数据的问题,而后者要解决的是如何用对象封装数据。 25.Servlet的生命周期 Web容器加载Servlet并将其实例化后,Servlet生命周期开始,容器运行其init()方法进行Servlet的初始化;请求到达时调用Servlet的service方法,service方法会调用与请求对应的doGet或doPost等方法;当服务器关闭会项目被卸载时服务器会将Servlet实例销毁,此时会调用Servlet的destroy方法。 26.转发(forward)和重定向(redirect)的区别? 1)forward是容器中控制权的转向,是服务器请求资源,服务器直接访问目标地址的URL,把那个URL的响应内容读取过来,然后把这些内容再发给浏览器,浏览器根本不知道服务器发送的内容是从哪儿来的,所以它的地址栏中还是原来的地址。 2)redirect就是服务器端根据逻辑,发送一个状态码,告诉浏览器重新去请求那个地址,因此从浏览器的地址栏中可以看到跳转后的链接地址。 3)前者更加高效,在前者可以满足需要时,尽量使用转发(通过RequestDispatcher对象的forward方法,RequestDispatcher对象可以通过ServletRequest对象的getRequestDispatcher方法获得),并且,这样也有助于隐藏实际的链接;在有些情况下,比如,需要跳转到一个其它服务器上的资源,则必须使用重定向(通过HttpServletResponse对象调用其sendRedirect方法)。 27.get和post请求的区别? ①get请求用来从服务器上获得资源,而post是用来向服务器提交数据; ②get将表单中数据按照name=value的形式,添加到action所指向的URL后面,并且两者使用“?”连接,而各个变量之间使用“&”连接;post是将表单中的数据放在HTML头部(header),传递到action所指向URL; ③get传输的数据要受到URL长度限制(1024字节);而post可以传输大量的数据,上传文件只能使用post方式; ④使用get时参数会显示在地址栏上,如果这些数据不是敏感数据,那么可以使用get;对于敏感数据还是应用使用post; 28、JSP和Servlet有有什么关系? 答:其实这个问题在上面已经阐述过了,Servlet是一个特殊的Java程序,它运行于服务器的JVM中,能够依靠服务器的支持向浏览器提供显示内容。 JSP本质上是Servlet的一种简易形式,JSP会被服务器处理成一个类似于Servlet的Java程序,可以简化页面内容的生成。 Servlet和JSP最主要的不同点在于,Servlet的应用逻辑是在Java文件中,并且完全从表示层中的HTML分离开来。而JSP的情况是Java和HTML可以组合成一个扩展名为.jsp的文件(有人说,Servlet就是在Java中写HTML,而JSP就是在HTML中写Java代码,当然,这个说法还是很片面的)。 JSP侧重于视图,Servlet更侧重于控制逻辑,在MVC架构模式中,JSP适合充当视图(view)而Servlet适合充当控制器(controller)。 29、JSP中的四种作用域? 答:page、request、session和application,具体如下: ①page代表与一个页面相关的对象和属性。 ②request代表与Web客户机发出的一个请求相关的对象和属性。一个请求可能跨越多个页面,涉及多个Web组件;需要在页面显示的临时数据可以置于此作用域 ③session代表与某个用户与服务器建立的一次会话相关的对象和属性。跟某个用户相关的数据应该放在用户自己的session中 ④application代表与整个Web应用程序相关的对象和属性,它实质上是跨越整个Web应用程序,包括多个页面、请求和会话的一个全局作用域。 30.实现会话跟踪的技术有哪些? 答:由于HTTP协议本身是无状态的,服务器为了区分不同的用户,就需要对用户会话进行跟踪,简单的说就是为用户进行登记,为用户分配唯一的ID,下一次用户在请求中包含此ID,服务器据此判断到底是哪一个用户。 ①URL重写:在URL中添加用户会话的信息作为请求的参数,或者将唯一的会话ID添加到URL结尾以标识一个会话。 ②设置表单隐藏域:将和会话跟踪相关的字段添加到隐式表单域中,这些信息不会在浏览器中显示但是提交表单时会提交给服务器。 ③cookie:cookie当用户通过浏览器和服务器建立一次会话后,会话ID就会随响应信息返回存储在基于窗口的cookie中,那就意味着只要浏览器没有关闭,会话没有超时,下一次请求时这个会话ID又会提交给服务器让服务器识别用户身份。会话中可以为用户保存信息。会话对象是在服务器内存中的,而基于窗口的cookie是在客户端内存中的。 ④HttpSession:在所有会话跟踪技术中,HttpSession对象是最强大也是功能最多的。当一个用户第一次访问某个网站时会自动创建HttpSession,每个用户可以访问他自己的HttpSession。与上面三种方式不同的是,HttpSession放在服务器的内存中 31.JSP中的静态包含和动态包含有什么区别? 答:静态包含是通过JSP的include指令包含页面,动态包含是通过JSP标准动作<jsp:forward>包含页面。静态包含是编译时包含,如果包含的页面不存在则会产生编译错误,而且两个页面的"contentType"属性应保持一致,因为两个页面会合二为一,只产生一个class文件,因此被包含页面发生的变动再包含它的页面更新前不会得到更新。动态包含是运行时包含,可以向被包含的页面传递参数,包含页面和被包含页面是独立的,会编译出两个class文件,如果被包含的页面不存在,不会产生编译错误,也不影响页面其他部分的执行。代码如下所示: <%--静态包含--%><%@includefile="..."%><%--动态包含--%><jsp:includepage="..."><jsp:paramname="..."value="..."/></jsp:include> 32、什么是WebService(Web服务)? 答:从表面上看,WebService就是一个应用程序,它向外界暴露出一个能够通过Web进行调用的API。例如可以创建一个提供天气预报的WebService,那么无论你用哪种编程语言开发的应用都可以通过调用它的API并传入城市信息来获得该城市的天气预报。 补充:这里必须要提及的一个概念是SOA(Service-OrientedArchitecture,面向服务的架构)显然,WebService是SOA的一种较好的解决方案,它更多的是一种标准,而不是一种具体的技术。 33、hashmap和hashtable区别 1.hashMap去掉了HashTable的contains方法,但是加上了containsValue()和containsKey()方法。 2.hashTable同步的,而HashMap是非同步的,效率上逼hashTable要高。 3.hashMap允许空键值,而hashTable不允许。 34、Socket的通信机制? 套接字(socket)是通信的基石,是支持TCP/IP协议的网络通信的基本操作单元。它是网络通信过程中端点的抽象表示,包含进行网络通信必须的五种信息:连接使用的协议,本地主机的IP地址,本地进程的协议端口,远地主机的IP地址,远地进程的协议端口。 应用层通过传输层进行数据通信时,TCP会遇到同时为多个应用程序进程提供并发服务的问题。多个TCP连接或多个应用程序进程可能需要通过同一个 TCP协议端口传输数据。为了区别不同的应用程序进程和连接,许多计算机操作系统为应用程序与TCP/IP协议交互提供了套接字(Socket)接口。应用层可以和传输层通过Socket接口,区分来自不同应用程序进程或网络连接的通信,实现数据传输的并发服务。 建立Socket连接至少需要一对套接字,其中一个运行于客户端,称为ClientSocket,另一个运行于服务器端,称为ServerSocket。 套接字之间的连接过程分为三个步骤:服务器监听,客户端请求,连接确认。 服务器监听:服务器端套接字并不定位具体的客户端套接字,而是处于等待连接的状态,实时监控网络状态,等待客户端的连接请求。 客户端请求:指客户端的套接字提出连接请求,要连接的目标是服务器端的套接字。为此,客户端的套接字必须首先描述它要连接的服务器的套接字,指出服务器端套接字的地址和端口号,然后就向服务器端套接字提出连接请求。 连接确认:当服务器端套接字监听到或者说接收到客户端套接字的连接请求时,就响应客户端套接字的请求,建立一个新的线程,把服务器端套接字的描述发给客户端,一旦客户端确认了此描述,双方就正式建立连接。而服务器端套接字继续处于监听状态,继续接收其他客户端套接字的连接请求。 35、Http的通信机制? HTTP协议即超文本传送协议(HypertextTransferProtocol ),是Web联网的基础,也是手机联网常用的协议之一,HTTP协议是建立在TCP协议之上的一种应用。 HTTP连接最显著的特点是客户端发送的每次请求都需要服务器回送响应,在请求结束后,会主动释放连接。从建立连接到关闭连接的过程称为“一次连接”。 1)在HTTP1.0中,客户端的每次请求都要求建立一次单独的连接,在处理完本次请求后,就自动释放连接。 2)在HTTP 1.1中则可以在一次连接中处理多个请求,并且多个请求可以重叠进行,不需要等待一个请求结束后再发送下一个请求。 由于HTTP在每次请求结束后都会主动释放连接,因此HTTP连接是一种“短连接”,要保持客户端程序的在线状态,需要不断地向服务器发起连接请求。通常的做法是即时不需要获得任何数据,客户端也保持每隔一段固定的时间向服务器发送一次“保持连接”的请求,服务器在收到该请求后对客户端进行回复,表明知道客户端“在线”。若服务器长时间无法收到客户端的请求,则认为客户端“下线”,若客户端长时间无法收到服务器的回复,则认为网络已经断开。 由于通常情况下Socket连接就是TCP连接,因此Socket连接一旦建立,通信双方即可开始相互发送数据内容,直到双方连接断开。但在实际网络应用中,客户端到服务器之间的通信往往需要穿越多个中间节点,例如路由器、网关、防火墙等,大部分防火墙默认会关闭长时间处于非活跃状态的连接而导致 Socket连接断连,因此需要通过轮询告诉网络,该连接处于活跃状态。 而HTTP连接使用的是“请求—响应”的方式,不仅在请求时需要先建立连接,而且需要客户端向服务器发出请求后,服务器端才能回复数据。 很多情况下,需要服务器端主动向客户端推送数据,保持客户端与服务器数据的实时与同步。此时若双方建立的是Socket连接,服务器就可以直接将数据传送给客户端;若双方建立的是HTTP连接,则服务器需要等到客户端发送一次请求后才能将数据传回给客户端,因此,客户端定时向服务器端发送连接请求,不仅可以保持在线,同时也是在“询问”服务器是否有新的数据,如果有就将数据传给客户端。 36、HttpServlet容器响应Web客户请求流程? 1)Web客户向Servlet容器发出Http请求; 2)Servlet容器解析Web客户的Http请求; 3)Servlet容器创建一个HttpRequest对象,在这个对象中封装Http请求信息; 4)Servlet容器创建一个HttpResponse对象; 5)Servlet容器调用HttpServlet的service方法,这个方法中会根据request的Method来判断具体是执行doGet还是doPost,把HttpRequest和HttpResponse对象作为service方法的参数传给HttpServlet对象; 6)HttpServlet调用HttpRequest的有关方法,获取HTTP请求信息; 7)HttpServlet调用HttpResponse的有关方法,生成响应数据; 8)Servlet容器把HttpServlet的响应结果传给Web客户 37、Hibernate中Session的load和get方法的区别是什么? 答:主要有以下三项区别: ①如果没有找到符合条件的记录,get方法返回null,load方法抛出异常。 ②get方法直接返回实体类对象,load方法返回实体类对象的代理。 ③在Hibernate3之前,get方法只在一级缓存中进行数据查找,如果没有找到对应的数据则越过二级缓存,直接发出SQL语句完成数据读取;load方法则可以从二级缓存中获取数据;从Hibernate3开始,get方法不再是对二级缓存只写不读,它也是可以访问二级缓存的。 说明:对于load()方法Hibernate认为该数据在数据库中一定存在可以放心的使用代理来实现延迟加载,如果没有数据就抛出异常,而通过get()方法获取的数据可以不存在。 38、如何理解Hibernate的延迟加载机制 答:延迟加载就是并不是在读取的时候就把数据加载进来,而是等到使用时再加载。Hibernate使用了虚拟代理机制实现延迟加载。返回给用户的并不是实体本身,而是实体对象的代理。代理对象在用户调用getter方法时就会去数据库加载数据。 39、简述Hibernate常见优化策略。 ①制定合理的缓存策略 ②采用合理的Session管理机制 ③尽量使用延迟加载特性 ④如果可以,选用基于version的乐观锁替代悲观锁 ⑤在开发过程中,开启hibernate.show_sql选项查看生成的SQL,从而了解底层的状况;开发完成后关闭此选项 40、什么是IoC和DI?DI是如何实现的? 答:IoC叫控制反转,是InversionofControl的缩写,控制反转是把传统上由程序代码直接操控的对象的调用权交给容器,通过容器来实现对象组件的装配和管理。所谓的"控制反转"就是对组件对象控制权的转移,从程序代码本身转移到了外部容器,由容器来创建对象并管理对象之间的依赖关系。 控制反转——Spring通过一种称作控制反转(IoC)的技术促进了松耦合。当应用了IoC,一个对象依赖的其它对象会通过被动的方式传递进来,而不是这个对象自己创建或者查找依赖对象,是容器在对象初始化时不等对象请求就主动将依赖传递给它。通过IOC反转控制DI依赖注入完成各个层之间的注入,使得层与层之间实现完全脱耦,增加运行效率利于维护。 41、解释一下什么叫AOP(面向切面编程)? 答: spring的AOP面向切面编程,实现在不改变代码的情况下完成对方法的增强。比较常用的就是spring的声明式事务管理,底层通过AOP实现,避免了我们每次都要手动开启事物,提交事务的重复性代码,使得开发逻辑更加清晰。 简单点解释,比方说你想在你的service层所有类中都加上一个打印‘你好’的功能这你经可以用aop思想来做,你先写个类写个方法,方法经实现打印‘你好’然后你Ioc这个类ref=“service.*”让每个类都注入。 aop就是面向切面的编程。比如说你每做一次对数据库操作,都要生成一句日志。如果,你对数据库的操作有很多类,那你每一类中都要写关于日志的方法。但是如果你用aop,那么你可以写一个方法,在这个方法中有关于数据库操作的方法,每一次调用这个方法的时候,就加上生成日志的操作。 42、选择使用Spring框架的原因(Spring框架为企业级开发带来的好处)? 答:可以从以下几个方面作答: 1.IoC容器:IoC容器帮助应用程序管理对象以及对象之间的依赖关系,对象之间的依赖关系如果发生了改变只需要修改配置文件而不是修改代码,因为代码的修改可能意味着项目的重新构建和完整的回归测试。有了IoC容器,程序员再也不需要自己编写工厂、单例,这一点特别符合Spring的精神“不要重复的发明轮子”。 2.AOP:面向切面编程,将所有的横切关注功能封装到切面(aspect)中,通过配置的方式将横切关注功能动态添加到目标代码上,进一步实现了业务逻辑和系统服务之间的分离。另一方面,有了AOP程序员可以省去很多自己写代理类的工作。 3.MVC:Spring的MVC框架是非常优秀的,从各个方面都可以甩Struts2几条街,为Web表示层提供了更好的解决方案。 4.事务管理:Spring以宽广的胸怀接纳多种持久层技术,并且为其提供了声明式的事务管理,在不需要任何一行代码的情况下就能够完成事务管理。 43、简述拦截器的工作原理以及你在项目中使用过哪些自定义拦截器 答:Struts2中定义了拦截器的接口以及默认实现,实现了Interceptor接口或继承了AbstractInterceptor的类可以作为拦截器。接口中的init()方法在拦截器被创建后立即被调用,它在拦截器的生命周期内只被调用一次,可以在该方法中对相关资源进行必要的初始化。每拦截一个请求,intercept()方法就会被调用一次。destory()方法将在拦截器被销毁之前被调用,它在拦截器的生命周期内也只被调用一次。 项目中使用过的有权限拦截器、执行时间拦截器、令牌拦截器等。 44、谈一下拦截器和过滤器的区别 答:拦截器和过滤器都可以用来实现横切关注功能,其区别主要在于: 1、拦截器是基于java反射机制的,而过滤器是基于函数回调的。 2、过滤器依赖于servlet容器,而拦截器不依赖于servlet容器。 3、拦截器只能对Action请求起作用,而过滤器则可以对几乎所有请求起作用。 4、拦截器可以访问Action上下文、值栈里的对象,而过滤器不能。 5、在Action的生命周期中,拦截器可以多次调用,而过滤器只能在容器初始化时被调用一次。 过滤器,是在javaweb中,你传入的request,response提前过滤掉一些信息,或者提前设置一些参数,然后再传入servlet或者struts的action进行业务逻辑,比如过滤掉非法url(不是login.do的地址请求,如果用户没有登陆都过滤掉),或者在传入servlet或者struts的action前统一设置字符集,或者去除掉一些非法字符. 拦截器,是在面向切面编程的就是在你的service或者一个方法,前调用一个方法,或者在方法后调用一个方法比如动态代理就是拦截器的简单实现,在你调用方法前打印出字符串(或者做其它业务逻辑的操作),也可以在你调用方法后打印出字符串,甚至在你抛出异常的时候做业务逻辑的操作。 执行顺序:过滤前-拦截前-Action处理-拦截后-过滤后。 个人认为过滤是一个横向的过程,首先把客户端提交的内容进行过滤(例如未登录用户不能访问内部页面的处理);过滤通过后,拦截器将检查用户提交数据的验证,做一些前期的数据处理,接着把处理后的数据发给对应的Action;Action处理完成返回后,拦截器还可以做其他过程(还没想到要做啥),再向上返回到过滤器的后续操作。 45、struts1.2和struts2.0的区别? struts1.2和struts2.0的对比 a、Action类: struts1.2要求Action类继承一个基类。struts2.0Action要求继承ActionSupport基类 b、线程模式 struts1.2Action是单例模式的并且必须是线程安全的,因为仅有一个Action的实例来处理所有的请求。struts2.0Action为每一个请求产生一个实例,因此没有线程安全问题。 c、Servlet依赖 struts1.2Action依赖于ServletAPI,因为当一个Action被调用时HttpServletRequest和HttpServletResponse被传递给execut方法。struts2.0Action不依赖于容器,允许Action脱离容器单独测试。 46、常见的网络协议有哪些? 1.IP协议:互联网协议 主要用于负责IP寻址、路由选择和IP数据包的分割和组装。通常我们所说的IP地址可以理解为符合IP协议的地址。 2.TCP协议:传输控制协议 该协议主要用于在主机间建立一个虚拟连接,以实现高可靠性的数据包交换。IP协议可以进行IP数据包的分割和组装,但是通过IP协议并不能清楚地了解到数据包是否顺利地发送给目标计算机。而使用TCP协议就不同了,在该协议传输模式中在将数据包成功发送给目标计算机后,TCP会要求发送一个确认;如果在某个时限内没有收到确认,那么TCP将重新发送数据包。另外,在传输的过程中,如果接收到无序、丢失以及被破坏的数据包,TCP还可以负责恢复。 3.FTP(FileTransferProtocol):远程文件传输协议,允许用户将远程主机上的文件拷贝到自己的计算机上。 4.HTTP:超文本传输协议(HTTP,HyperTextTransferProtocol)是互联网上应用最为广泛的一种网络协议。所有的WWW文件都必须遵守这个标准。设计HTTP最初的目的是为了提供一种发布和接收HTML页面的方法。 5.ARP协议:AddressResolutionProtocol地址解析协议 简单地说,ARP协议主要负责将局域网中的32为IP地址转换为对应的48位物理地址,即网卡的MAC地址。 47、计算机网络分层,每层所用协议,协议所占端口 (1)应用层:与其他计算机进行通讯的一个应用,它是对应应用程序的通信服务的。示例:telnet,HTTP,FTP,WWW,NFS,SMTP等。 (2)表示层:这一层的主要功能是定义数据格式及加密。示例:加密,ASII等。 (3)会话层:他定义了如何开始、控制和结束一个会话,包括对多个双向小时的控制和管理,以便在只完成连续消息的一部分时可以通知应用,从而使表示层看到的数据是连续的。示例:RPC,SQL等。 (4)传输层:这层的功能包括是否选择差错恢复协议还是无差错恢复协议,及在同一主机上对不同应用的数据流的输入进行复用,还包括对收到的顺序不对的数据包的重新排序功能。示例:TCP,UDP,SPX。 (5)网络层:这层对端到端的包传输进行定义,他定义了能够标识所有结点的逻辑地址,还定义了路由实现的方式和学习的方式。。示例:IP,IPX等。 (6)数据链路层:他定义了在单个链路上如何传输数据。 (7)物理层:OSI的物理层规范是有关传输介质的特性标准,这些规范通常也参考了其他组织制定的标准。 48、html访问全过程 A)解析Web页面的URL,得到Web服务器的域名 B)通过DNS服务器获得Web服务器的IP地址 I)与Web服务器建立TCP连接 E)与Web服务器建立HTTP连接 C)从Web服务器获得URL指定的文档 G)浏览器解释页面文档,并显示在屏幕 49、classloader原理 1.classLoader的介绍及加载过程 与普通程序不同的是,Java程序(class文件)并不是本地的可执行程序。当运行Java程序时,首先运行JVM(Java虚拟机),然后再把Javaclass加载到JVM里头运行,负责加载Javaclass的这部分就叫做ClassLoader。所以classLoader的目的在于把class文件装入到jvm中。 那么classLoader又在那里的啦?又由谁调用呢?其实classLoader只是jvm的一个实现的一部分。Jvm提供的一个顶级的classLoader(bootStrapclassLoader),bootStrapclassLoader负责加载java核心的API以满足java程序最基本的需求。Jvm还提供的两个classLoader,其中ExtensionClassLoader负责加载扩展的Javaclass,ApplicationClassLoader负责加载应用程序自身的类。而ExtensionClassLoader和ApplicationClassLoader则由bootStrapclassLoader加载。 2.classLoader加载的基本流程 当运行一个程序的时候,JVM启动,运行bootstrapclassloader,该ClassLoader加载java核心API(ExtClassLoader和AppClassLoader也在此时被加载),然后调用ExtClassLoader加载扩展API,最后AppClassLoader加载CLASSPATH目录下定义的Class,这就是一个程序最基本的加载流程。 3.classLoader加载的方式 其实classLoader在加载class文件的时候就采用的双亲委托模式。每一个自定义ClassLoader都必须继承ClassLoader这个抽象类,而每个ClassLoader都会有一个parentClassLoader,我们可以看一下ClassLoader这个抽象类中有一个getParent()方法,这个方法用来返回当前ClassLoader的parent。 50、快速排序原理 原理: 快速排序也是分治法思想的一种实现,他的思路是使数组中的每个元素与基准值(Pivot,通常是数组的首个值,A[0])比较,数组中比基准值小的放在基准值的左边,形成左部;大的放在右边,形成右部;接下来将左部和右部分别递归地执行上面的过程:选基准值,小的放在左边,大的放在右边。。。直到排序结束。 步骤: 1.找基准值,设Pivot=a[0] 2.分区(Partition):比基准值小的放左边,大的放右边,基准值(Pivot)放左部与右部的之间。 3.进行左部(a[0]-a[pivot-1])的递归,以及右部(a[pivot+1]-a[n-1])的递归,重复上述步骤。 [java] view plain copy 1.//快速排序 2.voidquick_sort(ints[],intl,intr) 3.{ 4.if(l<r) 5.{ 6.//Swap(s[l],s[(l+r)/2]);//将中间的这个数和第一个数交换参见注1 7.inti=l,j=r,x=s[l]; 8.while(i<j) 9.{ 10.while(i<j&&s[j]>=x)//从右向左找第一个小于x的数 11.j--; 12.if(i<j) 13.s[i++]=s[j]; 14. 15.while(i<j&&s[i]<x)//从左向右找第一个大于等于x的数 16.i++; 17.if(i<j) 18.s[j--]=s[i]; 19.} 20.s[i]=x; 21.quick_sort(s,l,i-1);//递归调用 22.quick_sort(s,i+1,r); 23.} 24.} 51、各种集合类之间的区别 1.ArrayList:元素单个,效率高,多用于查询 2.Vector:元素单个,线程安全,多用于查询 3.LinkedList:元素单个,多用于插入和删除 4.HashMap:元素成对,元素可为空 5.HashTable:元素成对,线程安全,元素不可为空 52、内存溢出和内存泄漏 内存溢出是指已有的数据超过了其获得到的内存所能存储的范围,比如用一个字节存放1000这个数字就属于内存溢出。比如说你申请了一个integer,但给它存了long才能存下的数,那就是内存溢出。 Java内存泄漏就是没有及时清理内存垃圾,导致系统无法再给你提供内存资源(内存资源耗尽)。Java内存泄露是说程序逻辑问题,造成申请的内存无法释放.这样的话无论多少内存,早晚都会被占用光的.最简单的例子就是死循环了.由于程序判断错误导经常发生此事。 53、jvm布局 以下是JVM的一个基本架构图,在这个基本架构图中,栈有两部份,Java线程栈以及本地方法栈 在JVM中堆空间划分如下图所示 上图中,刻画了Java程序运行时的堆空间,可以简述成如下2条 1.JVM中堆空间可以分成三个大区,新生代、老年代、永久代 2.新生代可以划分为三个区,Eden区,两个幸存区 Jvm主要包括下面两面方面: ·Java代码编译和执行的整个过程 ·JVM内存管理及垃圾回收机制 54、在浏览器中输入www.baidu.com后执行的全部过程 1、客户端浏览器通过DNS解析到www.baidu.com的IP地址220.181.27.48,通过这个IP地址找到客户端到服务器的路径。客户端浏览器发起一个HTTP会话到220.161.27.48,然后通过TCP进行封装数据包,输入到网络层。 2、在客户端的传输层,把HTTP会话请求分成报文段,添加源和目的端口,如服务器使用80端口监听客户端的请求,客户端由系统随机选择一个端口如5000,与服务器进行交换,服务器把相应的请求返回给客户端的5000端口。然后使用IP层的IP地址查找目的端。 3、客户端的网络层不用关系应用层或者传输层的东西,主要做的是通过查找路由表确定如何到达服务器,期间可能经过多个路由器,这些都是由路由器来完成的工作,我不作过多的描述,无非就是通过查找路由表决定通过那个路径到达服务器。 4、客户端的链路层,包通过链路层发送到路由器,通过邻居协议查找给定IP地址的MAC地址,然后发送ARP请求查找目的地址,如果得到回应后就可以使用ARP的请求应答交换的IP数据包现在就可以传输了,然后发送IP数据包到达服务器的地址。 55、IO流类 原文地址http://www.bieryun.com/856.html

优秀的个人博客,低调大师

第 2 章 软件工程 (Software Engineering)

目录 2.1. Open Source and License 2.1.Open Source and License GPL 你可以免费使用,但修改后必须开源。 GPLv3 你可以免费使用,但修改后必须开源,不允许加入闭源商业代码。 BSD 你可以免费使用,修改后可不开源,基本上你可以我所欲为。 Linux 中有许多BSD代码,但BSD却不能移植Linux 代码到BSD中,这是因为GPL License。 http://www.apache.org/licenses/ Please enable JavaScript to view the &lt;a href="http://disqus.com/?ref_noscript"&gt;comments powered by Disqus.&lt;/a&gt;comments powered by Disqus 原文出处:Netkiller 系列 手札 本文作者:陈景峯 转载请与作者联系,同时请务必标明文章原始出处和作者信息及本声明。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册