首页 文章 精选 留言 我的

精选列表

搜索[高DPI],共10000篇文章
优秀的个人博客,低调大师

Redis Cluster搭建高可用Redis服务器集群

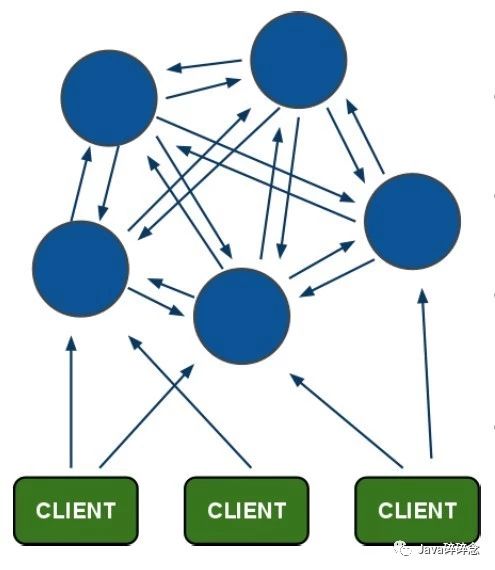
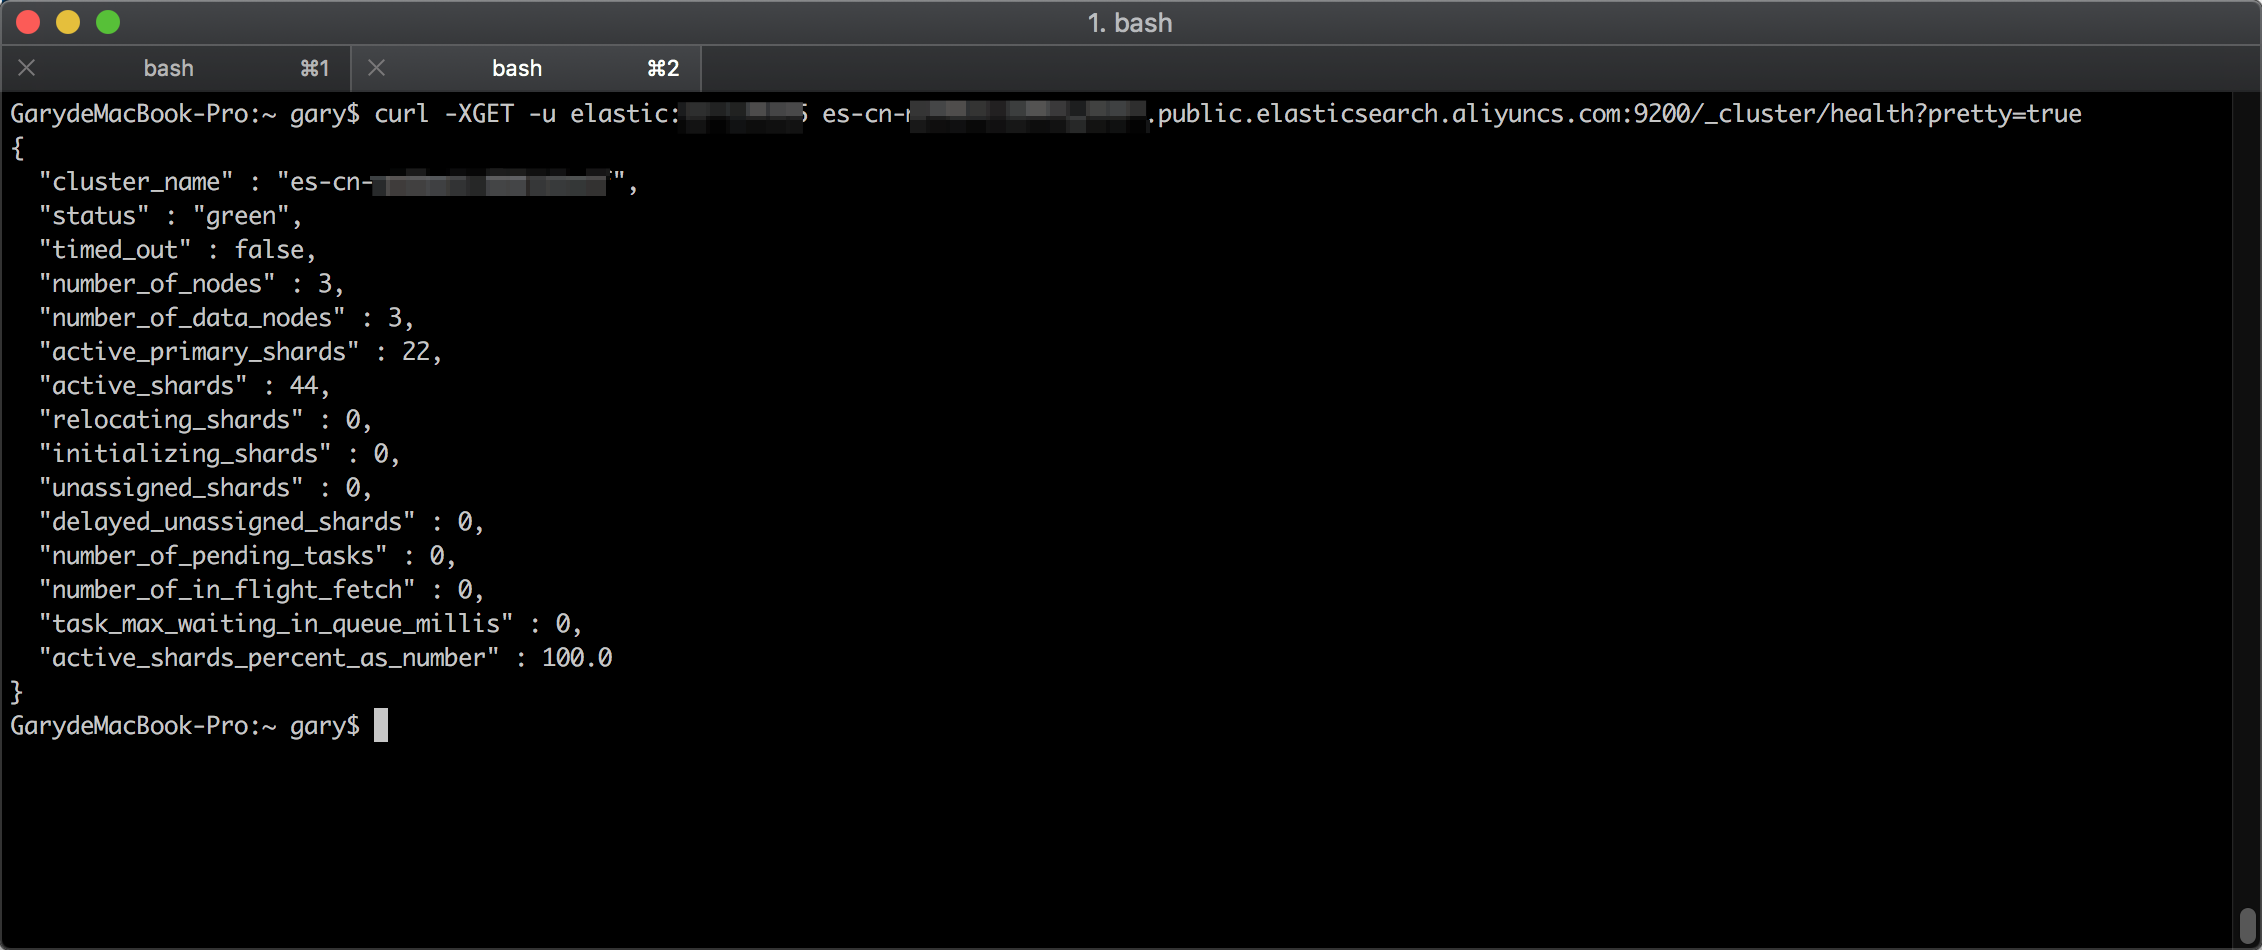
一、RedisCluster集群简介 Redis Cluster是Redis官方提供的分布式解决方案,在3.0版本后推出的,有效地解决了Redis分布式的需求,当一个节点挂了可以快速的切换到另一个节点,当遇到单机内存、并发等瓶颈时,可以采用分布式方案要解决问题。 二、集群原理 Redis Cluster集群采用了P2P的模式,完全去中心化,Redis把所有的Key分成了16384个slot,每个Redis实例负责其中一部分slot,集群中的所有信息(节点、端口、slot等),都通过节点之间定期的数据交换而更新,Redis客户端可以在任意一个Redis实例发出请求,如果所需数据不在该实例中,通过重定向命令引导客户端访问所需的实例。其结构特点:1、所有的redis节点彼此互联(PING-PONG机制),内部使用二进制协议优化传输速度和带宽。2、节点的fail是通过集群中超过半数的节点检测失效时才生效。3、客户端与redis节点直连,不需要中间proxy层.客户端不需要连接集群所有节点,连接集群中任何一个可用节点即可。4、redis-cluster把所有的物理节点映射到[0-16383]slot上(不一定是平均分配),cluster负责维护node<->slot<->value。5、Redis集群预分好16384个桶,当需要在Redis集群中放置一个key-value 时,根据CRC16(key) mod 16384的值,决定将一个key放到哪个桶中。三、集群搭建要让集群正常工作至少需要3个主节点,一共就需要6个节点,其中3个为主节点,3个为从节点,为了简单在下面在一台机器上演示,演示使用了linux服务器上7000到7005的6个端口。1、下载redis、解压、安装wget http://download.redis.io/releases/redis-3.2.4.tar.gztar -zxvf redis-3.2.4.tar.gzcd redis-3.2.4/make && make install2、将redis-trib.rb复制到/usr/local/bin目录下cd srccp redis-trib.rb /usr/local/bin3、创建Redis节点并修改配置文件mkdir redis_cluster cd redis_cluster/mkdir 7000 7001 7002 7003 7004 7005cp redis.conf redis_cluster/7000cp redis.conf redis_cluster/7001cp redis.conf redis_cluster/7002cp redis.conf redis_cluster/7003cp redis.conf redis_cluster/7004cp redis.conf redis_cluster/7005按下面提示修改6个配置文件port 7000 //端口7000,7001,7002... bind 本机ip //默认ip为127.0.0.1 需要改为其他节点机器可访问的ip 否则创建集群时无法访问对应的端口,无法创建集群daemonize yes //redis后台运行pidfile /var/run/redis_7000.pid //pidfile文件对应7000,7001,7002cluster-enabled yes //开启集群 把注释#去掉cluster-config-file nodes.conf //集群的配置 配置文件首次启动自动生成cluster-node-timeout 15000 //请求超时 默认15秒,可自行设置appendonly yes //aof日志开启 有需要就开启,它会每次写操作都记录一条日志 dir /root/redis-3.2.4/redis_cluster/7000 //目录,端口7000,7001,7002... ,必须配置,否则无法启动4、启动6个Redis实例,并且要指定配置文件,这些配置文件分别在各自的子目录下面./src/redis-server redis_cluster/7000/redis.conf ./src/redis-server redis_cluster/7001/redis.conf ./src/redis-server redis_cluster/7002/redis.conf ./src/redis-server redis_cluster/7003/redis.conf ./src/redis-server redis_cluster/7004/redis.conf ./src/redis-server redis_cluster/7005/redis.conf5、安装rubyyum install rubyyum install -y rubygemsgem install redis -v 3.2.26、使用redis-trib.rb创建集群cd /usr/local/bin./redis-trib.rb create --replicas 1 192.168.0.204:7000 192.168.0.204:7001 192.168.0.204:7002 192.168.0.204:7003 192.168.0.204:7004 192.168.0.204:7005运行结果如下:Redis Cluster启动成功截图如果一切顺利,你会看到类似截图上的消息: [OK] All 16384 slots covered, 这说明Redis的Cluster集群环境搭建成功。 简单解释一下这个命令:调用 ruby 命令来进行创建集群,--replicas 1 表示主从节点比例为 1:1,即一个主节点对应一个从节点;然后,默认给我们分配好了每个主节点和对应从节点服务,以及solt的大小,因为在Redis集群中有且仅有16383个solt,默认情况会给我们平均分配,当然你可以指定,后续的增减节点也可以重新分配。M: 5237fa04bd793832b605d92ceb1d2f493da22e43 为主节点IdS: b6b696c11bbffa8f9d4e6397ef4d27b0b54fea32 192.168.0.204:7003 replicates 5237fa04bd793832b605d92ceb1d2f493da22e43 从节点下对应主节点Id目前来看,7000-7002 为主节点,7003-7005 为从节点,并向你确认是否同意这么配置,输入yes后,会开始集群创建。 四、验证集群1、通过Cluster Nodes命令和Cluster Info命令来看看集群效果./redis-cli -c -h 192.168.0.204 -p 7001cluster infocluster nodes运行结果如下:运行成功截图2、在集群上通过增加数据来测试集群效果运行结果如下:https://www.roncoo.com/search/redis

优秀的个人博客,低调大师

高并发下log4j的性能瓶颈

开篇 近期由于业务需要进行业务迁移,期间因为误设置log4j的日志级别,导致系统性能整体下降,具体表现在QPS下降明显,系统RT上升。迁移期间由于各类系统环境较原来有较大差别,因为在排查过程中也走了一些弯路,总结起来避免他人再次踩坑。 问题背景 问题的背景其实很简单,线上系统的log4j的日志级别由warn调整为info,导致大量的调用log4j的日志接口,导致系统的rt上升伴随着qps下降,具体的影响效果可以看下图。 需要额外解释的就是log4j的这个问题需要在qps较大的情况下才会复现,按照我遇到的情况基本上需要在2k/s以上会比较明显(数据不一定非常准确),只是为了说明需要在大量请求的情况才会触发synchronized的问题。 当然问题的本质在于大量调用log4j的日志接口,导致竞争synchronized影响性能,影响的时间应该也是在ms级别,这其实在另外一个方面说明了只求非常极致追求性能问题才会细致的去分析这些问题。 优化效果 优化后qps的提升效果图,这边是以分钟进行统计的。 优化后系统的响应时间效果图。 现象分析 整个分析过程其实并不是那么具有条理性,只是现在总结起来看上去像那么回事。 对比两套系统的差异点,发现系统的log4j的日志级别不一致,尝试修改日志级别观察效果。 发现日志级别调高后系统性能明显提升,开始怀疑log4j的问题并网上查阅资料。 jstack打印对应的日志,发现在不同日志级别情况下下面的BLOCKED的日志数量不一样。 发现竞争锁的日志waiting to lock <0x00007f3a04020830>。 观察jstack日志并找到log4j的源码发现代码当中有同步锁关键字synchronized。 #514 daemon prio=5 os_prio=0 tid=0x00007f369002f800 nid=0x561a waiting for monitor entry [0x00007f348fb96000] java.lang.Thread.State: BLOCKED (on object monitor) at org.apache.log4j.Category.callAppenders(Category.java:204) - waiting to lock <0x00007f3a04020830> (a org.apache.log4j.spi.RootLogger) at org.apache.log4j.Category.forcedLog(Category.java:391) at org.apache.log4j.Category.log(Category.java:856) #521 daemon prio=5 os_prio=0 tid=0x00007f367c042800 nid=0x5617 waiting for monitor entry [0x00007f348fe99000] java.lang.Thread.State: BLOCKED (on object monitor) at org.apache.log4j.Category.callAppenders(Category.java:204) - waiting to lock <0x00007f3a04020830> (a org.apache.log4j.spi.RootLogger) at org.apache.log4j.Category.forcedLog(Category.java:391) at org.apache.log4j.Category.log(Category.java:856) 原因分析 直接定位log4j的源码位置,发现synchronized的关键字,基本上这时候其实是验证之前的猜想而已。关于synchronized的性能问题,可以网上去参考java几种锁的性能对比,只记得一个简单的结论synchronized在大量竞争的情况下劣势比较明显各种同步方法性能比较(synchronized,ReentrantLock,Atomic)。 void callAppenders(LoggingEvent event) { int writes = 0; for(Category c = this; c != null; c=c.parent) { // Protected against simultaneous call to addAppender, removeAppender,... synchronized(c) { if(c.aai != null) { writes += c.aai.appendLoopOnAppenders(event); } if(!c.additive) { break; } } } if(writes == 0) { repository.emitNoAppenderWarning(this); } } 心得 老大曾说过,凡事做个有心人,会发现更多的东西。

优秀的个人博客,低调大师

使用mysql中的锁解决高并发问题

为什么要加锁 多核计算机的出现,计算机实现真正并行计算,可以在同一时刻,执行多个任务。在多线程编程中,因为线程执行顺序不可控导致的数据错误。比如,多线程的理想状态是这样的但是实际情况是这样的: 在网络编程中,在同一时刻,多个客户端同时请求同一个资源,如果不做控制,也会带来数据错误。比如在同一时间有10000人去抢10张火车票,10张火车票有可能会买给100个人,这显然是不符合要求的。在多线程编程中,为了解决线程执行不可控带来的问题,通常情况下都是通过加锁来实现数据同步的。在网络编程中,也可以通过加锁机制来控制。 在网络编程中,可以通过给数据库加锁,达到控制并发的目的。在php开发时,基本都是使用mysql作为数据库。所以,就会给mysql加锁控制网络并发引起数据错误问题。 MySQL的存储引擎 不是要说MySQL的锁吗,怎么说上存储引擎了?因为MySQL存储引擎不同,锁也会不同。MySQL有MyISAM 和InnoDB两种存储引擎,现在主要使用InnoDB,所以主要介绍InnoDB下锁的使用。 InnoDB引擎支持事务操作,使用事务可以保证多条sql语句执行的完整性(要不都成功,要不都失败) 事务是由一组SQL语句组成的逻辑处理单元,事务具有4属性 原性性(Actomicity):事务是一个原子操作单元,其对数据的修改,要么全都执行,要么全都不执行。 一致性(Consistent):在事务开始和完成时,数据都必须保持一致状态。这意味着所有相关的数据规则都必须应用于事务的修改,以操持完整性;事务结束时,所有的内部数据结构(如B树索引或双向链表)也都必须是正确的。 隔离性(Isolation):数据库系统提供一定的隔离机制,保证事务在不受外部并发操作影响的“独立”环境执行。这意味着事务处理过程中的中间状态对外部是不可见的,反之亦然。 持久性(Durable):事务完成之后,它对于数据的修改是永久性的,即使出现系统故障也能够保持。 多个事务并发执行会带来新的问题 更新丢失(Lost Update):当两个或多个事务选择同一行,然后基于最初选定的值更新该行时,由于每个 事务都不知道其他事务的存在,就会发生丢失更新问题——最后的更新覆盖了其他事务所做的更新。例如,两个编辑人员制作了同一文档的电子副本。每个编辑人员独立地更改其副本,然后保存更改后的副本,这样就覆盖了原始文档。最后保存其更改保存其更改副本的编辑人员覆盖另一个编辑人员所做的修改。如果在一个编辑人员完成并提交事务之前,另一个编辑人员不能访问同一文件,则可避免此问题 脏读(Dirty Reads):一个事务正在对一条记录做修改,在这个事务并提交前,这条记录的数据就处于不一致状态;这时,另一个事务也来读取同一条记录,如果不加控制,第二个事务读取了这些“脏”的数据,并据此做进一步的处理,就会产生未提交的数据依赖关系。这种现象被形象地叫做“脏读”。 不可重复读(Non-Repeatable Reads):一个事务在读取某些数据已经发生了改变、或某些记录已经被删除了!这种现象叫做“不可重复读”。 幻读(Phantom Reads):一个事务按相同的查询条件重新读取以前检索过的数据,却发现其他事务插入了满足其查询条件的新数据,这种现象就称为“幻读”。 曾经年少无知的我,以为使用事务就能保证并发情况下数据同步问题,后来的一次惨痛经历才明白了,事务不能保证并发情况的数据同步问题,需要事务和锁同时使用才能保证。 锁的种类 乐观锁 机制采取了更加宽松的加锁机制。悲观锁大多数情况下依靠数据库的锁机制实现,以保证操作最大程度的独占性。但随之而来的就是数据库性能的大量开销,特别是对长事务而言,这样的开销往往无法承受。相对悲观锁而言,乐观锁更倾向于开发运用。 悲观锁 具有强烈的独占和排他特性。它指的是对数据被外界(包括本系统当前的其他事务,以及来自外部系统的事务处理)修改持保守态度,因此,在整个数据处理过程中,将数据处于锁定状态。悲观锁的实现,往往依靠数据库提供的锁机制(也只有数据库层提供的锁机制才能真正保证数据访问的排他性,否则,即使在本系统中实现了加锁机制,也无法保证外部系统不会修改数据)。 MySQL中锁的种类 乐观锁和悲观锁是一种思想,不是具体实现,在MySQL中,有锁的具体的实现方式 (文中的线程在MySQL中可以视作MySQL的连接) 共享锁 一个线程在持有锁时,其他的线程可以查询被锁的数据,但是不能修改,不能删除。实现方式 SELECT * FROM table_name WHERE id =? lock in share mode; 排它锁 一个线程在持有锁时,其他的线程不能查询,不能更新,不能删除被锁的数据,直到锁被释放.SELECT * FROM table_name WHERE id =? for update 总结一下:共享锁类似于java中的读锁,一个线程在持有乐观锁的时候,其他的线程也可以对被锁的数据进行读操作,但是不能对被锁的数据进行删除和更新操作;排他锁类似于java的写锁,一个线程持有写锁的时候,其他的线程不能再对被锁的数据进行任何查询,更新,删除操作。 重点 InnoDB的行锁是基于索引实现的,如果在查询中不使用索引,会锁表。 MySQL锁粒度 表级锁 是MySQL中锁定粒度最大的一种锁,表示对当前操作的整张表加锁,它实现简单,资源消耗较少,被大部分MySQL引擎支持。最常使用的MyISAM与InnoDB都支持表级锁定。表级锁分为表共享读锁与表独占写锁。 行级锁 是Mysql中锁定粒度最细的一种锁,表示只针对当前操作的行进行加锁。行级锁能大大减少数据库操作的冲突。其加锁粒度最小,但加锁的开销也最大。行级锁分为共享锁 和 排他锁。 共享锁的使用 注意: 下面的操作,都是行锁操作,MySQL为InnoDB引擎,id为自增主键 先创建一个测试表 CREATE TABLE `test` ( `id` int(0) NOT NULL AUTO_INCREMENT, `name` varchar(20) NOT NULL, `number` bigint(0) NOT NULL, `age` int(0) NULL, PRIMARY KEY (`id`) ) ENGINE = InnoDB; 看一下随便插入的几条数据 没有问题,使用共享锁看一下效果: 开启事务 begin; 给id为1的数据加共享锁 mysql> select * from test where id=1 lock in share mode; 分别使用加锁和不加锁查询id为1 的数据 都可以查询到数据 修改id为1 的数据看看 sql语句会一直停在这里,直到超时或者锁释放(事务提交或者回滚)左边的事务提交后,右边的sql会执行,完成更新操作。 同样,删除操作也会等待锁释放才能操作,这里就不演示了。 再看一下另一种情况,左边锁住id为5的数据,右边更新id为1 的数据,不受影响。这就是行级锁,只会锁住相关的一行数据 排他锁的使用 还是使用test这张表 开启事务begin; 给id1的数据加排他锁select * from test where id = 1 for update; 在右边查询id为1的数据 查询语句会一直等待,直到超时或者锁释放(左边commit或者rollback) 左边commit后 使用排它锁对id为5的数据加锁后,更新id为5的数据 sql语句同样会等待,直到超时或者锁释放,删除操作也是一样 看一下对id为1的数据加锁,然后操作id不为1的数据的情况 没有问题,MySQL只是锁住了id为5的数据,其他的数据都可以操作。 看一下InnoDB引擎锁表的情况 我们常常说InnoDB是行锁,但是这里介绍一下它锁表的情况。因为name列没有索引,所以,在加行锁的时候,MySQL不能加正常加行锁,会锁住整张表。 InnoDB行锁是通过索引上的索引项来实现的,这一点MySQL与Oracle不同,后者是通过在数据中对相应数据行加锁来实现的。InnoDB这种行锁实现特点意味者:只有通过索引条件检索数据,InnoDB才会使用行级锁,否则,InnoDB将使用表锁!在实际应用中,要特别注意InnoDB行锁的这一特性,不然的话,可能导致大量的锁冲突,从而影响并发性能。 再看另一种情况 使用排它锁对id为1的数据加锁时,使用不加锁的查询和没有约束的查询时,一样可以立刻查询到数据。只有使用加锁的查询或者更新和删除时才会等待锁释放。 总结 InnoDB的锁配合事务使用 MySQL有共享锁和排它锁 使用共享锁时,其他线程(连接)可以查询数据,但是不能更新和删除数据,使用排它锁时,不能查询数据不能更新数据,不能删除数据 MySQL的InnoDB引擎支持行级锁和表级锁,行级锁 InnoDB的行级锁是基于索引的,加锁是对索引加锁,加锁时没有索引时会锁住整张表 以上是我对MySQL锁的理解,文中如果有不正确的地方,还请各位大哥批评指正。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册