首页 文章 精选 留言 我的

精选列表

搜索[质量工程],共10000篇文章
优秀的个人博客,低调大师

(一)Java工程化--Maven基础

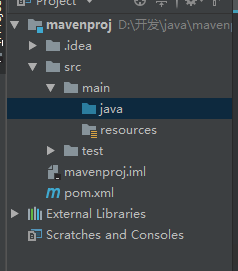
Maven 读作['mevən] 翻译成中文是"内行,专家" Maven是什么 包依赖的前世今生: 原始的jar包引用--> ant --> maven. 是一种项目管理工具 Maven优势: convertion over configuration 约定优于配置: 这个原则不仅适用于maven, 更是目前大多数框架遵循的原则,如mvc 简单 易于测试 构建简单 CI(持续集成) 插件丰富 下载和安装 下载: http://maven.apache.org/download.cgi 安装: 解压安装即可 环境变量配置: windows: 配置path MAVEN_HOME linux: 在 .bash_profile 文件中 运行参数: 定义环境变量MAVEN_OPS 配置settings.xml: settings.xml文件是个空模板,我们可以在这个文件进行一些自定义配置. 常用的配置如:repo存储目录 创建maven项目 项目结构: 遵循约定优于配置原则, 项目包的组织结构如下 pom.xml groupId 公司组织id artifactId 功能命名 version 版本号 packageing 打包方式,默认jar,可修改为maven-project,war dependancyManagement 最好之出现在父pom中,用于统一版本号,只做声明依赖,子模块pom中还需要引用,但不需要制定version. dependancy type 默认jar scope 指定哪个阶段适用,各阶段如下: compile 编译,打包,默认 如spring-core test 测试 如spring-test provided 编译 如servlet runtime 运行时 如JDBC驱动实现包 system 本地一些jar 依赖传递 依赖仲裁:(1)最短路径原则,根据依赖树就近取最接近的版本;(2)加载顺序原则;(3)exclusions 排除包 命令: mvn dependancy:tree Maven生命周期(三个过程) 区分术语:lifecycle/phase/goal 生命周期: clean 包含的phase: pre-clean --> clean --> post-clean default compile package install deploy ... site pre-site --> site -->post-site --> site-deploy A Build Lifecycle is Made Up of Phases 一个构建生命周期是有多个phase组成 A Build Phase is Made Up of Plugin Goals 一个构建phase是由多个插件目标goal构成

优秀的个人博客,低调大师

简单优化前端工程几种方式(上篇)

使用CDN 如果A网站和B网站, 同时使用了 https://cdn.bootcss.com/jquery/3.3.1/jquery.min.js的资源, 在访问其他网站A时, 浏览器会缓存jquery.min.js资源文件, 访问网站B时,就可以免于下载jquery.min.js的文件, 这样既节省了服务器流量, 又提升了资源加载的速度, 一举两得~ 减少网络请求 使用雪碧图(用Photoshop将多个icon拼接到一张图上) 将多个js文件合并压缩为单个js文件(使用Webpack,或在线工具) 减少图片尺寸 可以使用PP鸭一键压缩, 具体介绍: PP鸭为你的图片瘦瘦瘦身 (支持快速压缩jpg, png, gif三种格式) 将图片保存为渐进式jpg 将图片保存为渐进式jpg后, 图片在浏览器显示时, 可以由模糊到清晰渐进式加载, 提升用户体验 将javascript脚本放到html的底部 HTML文件是从上往下渲染的, 如果js脚本有大量耗时操作, js执行期间, 用户是不能看到页面的 mdn的解释链接: https://developer.mozilla.org/zh-CN/docs/Learn/Getting_started_with_the_web/JavaScript_basics 一般我们会把css样式文件放在html的头部, javascript脚本文件放在页面底部, 但什么事情都有特例, 比如bootstrap的部分组件依赖jquery,也就是jquery必须在bootstrap之前引入, 如果我们要在页面头部引入bootstrp样式的话, 那jquery也必须放到了页面的头部!

优秀的个人博客,低调大师

Python全栈工程师(for、列表)

ParisGabriel Python 入门基础 for:用来遍历可迭代对象的数据元素可迭代对象是指以此获取数据元素的对象可迭代对象包括:字符串 str 列表 list元组 tuple字典 dict语法:for 变量列表 in 可迭代对象: L = ["a", "abc", "中国", 123] for x in L: print(x) else: print("结束") 说明:当循环内部使用break结束循环时,else将不再执行并且else 可以省略range()函数:range(stop) 从零开始,每次生成一个整数后加1操作,直到stop为止(不包含stop)range(star,stop[,step])从star开始每次生成一个整数后移动step,直到stop为止(不包含stop,且step可以是负数)help(range) 查询帮助作用:用来创建一个生成一系列整数的可迭代对象(也叫整数序列生成器) for x in range(0, 10, 3): print(x) 说明:range函数带调用返回的对象可用于for语句来进行依次迭代取出其中的函数for嵌套: for x in range(5): for y in range(3): print(x, y, "ABC") continue:用于循环语句中(while、 for )不再执行本次循环内continue之后的语句重新开始一次新的循环 for x in range(10): if x % 2 == 0: continue print(x) 说明:在while中直接跳到真值表达式重新判断在for中直接将可迭代对象内的元素绑定到下一个再次循环 列表 list:列表是一种容器(通常用来储存计算机的数据对象)列表是可以被改变的序列是由一系列特定元素组成的 元素与元素之间可能没有任何关联关系但他们由先后顺序关系空列表创建方式: L=[ ]列表是可迭代对象: 非空列表创建方式: 空列表: L = [] 非空列表: L = [1, 2, 3, 4] L = ["a", "b", "c"] L = [1, 2, ["a", "b", "c", "d"], 3, 4] 列表的构造函数list:list()等于空列表list(iterable)用可迭代对象创建一个列表列表的运算:+ 用于拼接列表+= 用于将右侧的可迭代对象的数据追加到原列表中* 用于生成重复列表*=列表的比较运算:< <= > >= == !=比较规则和字符串完全相同列表的in、notin:判断一个元素是否存在于列表中 如果纯在返true否则falsein 和 nat in 返回值相反 练习:1.用for实现:输入一个数W代表正方形的宽度:如1 2 3 4 51 2 3 4 51 2 3 4 51 2 3 4 51 2 3 4 5 答案: a = int(input("plaese input at will integer:")) for x in range(1, a + 1): for y in range(1, a + 1): print(y, end = " ") print() 改写上上题:1 2 3 4 52 3 4 5 63 4 5 6 74 5 6 7 85 6 7 8 9 第一种:a = int(input("plaese input at will integer:")) for x in range(1, a + 1): for y in range(x, a + x): print("0%2d" % y, end = " ") print() 第二种: a = int(input("plaese input at will integer:")) for x in range(1, a + 1): for y in range(x, a + x): print(y, end = " ") print() 2.输入任意文字,存于列表L中,当不输入任何内容直接回车后结束输入打印L列表中的内容计算你共输入几行内容、和多少个字符 答案: L = [] i = 0 while True: a = input("plaese input at will string:") if a == "": break i += len(a) L += [a] print(''' L = : %s you have entered:%d row %d Entries character ''' % (L, len(L), i)) 3.输入一个整数 (代表树干高度)打印出如下一颗树输入:2****** 输入3 ********* * * * 答案: a = int(input("plaese input at will integer:")) for x in range(1, a * 2, 2): print(("*" * x).center(a * 2)) else: for s in range(1, a * 2, 2): print("*".center(a * 2)) 4.任意输入一个整数 判断这个数是否是素数(prime)素数也叫质数,是只能被1和自身整除的数:如:2 3 5 7 11 等提示:用排除法:判断x是否是素数是,只要让x分别除以:2 3 4 5 ...-1只要整除了 那x不是素数,否则x是素数 答案: a = int(input("plaese input at will integer:")) for x in range(2, a): if a % x == 0: s = "it's not a prime" break else: s = "This is a prime" print(s 5.算出100 ~ 1000以内的水仙花数(naricissistic)水仙花数是指百位的3次方 加上十位的3次方 加上各位的3次方等于原数的数153=1**3+5**3+3**3 153 370 答案: for x in range(100, 1000): if (x // 100) ** 3 + ((x % 100) // 10) ** 3 + (x % 10) ** 3 == x: print(x)
优秀的个人博客,低调大师

Python全栈工程师(编码)

ParisGabriel Python 入门基础 补充: 主流3操作大系统 Windows: Winxp Win7 Win8 Win10 Unix: Solaris(SUN) IOS(Apple移动端) Mac OS Linux :(linux基于Unix 独立出来的系统) 安卓(Android) Ubuntu 16.04(当前教学版本) ReadHat CentOS 回顾: Ctrl + Alt + Enter :虚拟机全屏/退出全屏 Ctrl + Alt :释放鼠标 ctrl + shift + "+" : 终端字体放大 ctrl + "-" : 终端字体缩小 ctrl + d:退出终端 ctrl + l : 清屏 ctrl + c : 终止当前命令的执行 ctrl + s : 隐藏终端输出 ctrl + q : 恢复终端输出 init 0 : 关机 init 6 : 重启 pwd:显示当前的路径位置 ls:查看当前位置有什么内容 ls -l :以列表形式显示 ls -a :显示所有内容(包含隐藏) cd:改变当前的工作路径 cd 绝对路径 :cd /home/tarena/aid1806/ cd 相对路径 cd .. :回退到上一级目录 cd :回到用户主目录 mkdir:创建一个或者多个文件 touch:创建一个或者多个文 tree:显示目录树 rm -r : 递归删除文件夹内所有内容 rm -f : 强制删除,不给任何提示 rm -i : 删除前给提示(y代表yes,n代表no) sudo:用超级用户root的权限执行一条命令 tar -zcvf 压缩包名字.tar.gz 文件夹/文件:打包压缩 tar -zxvf 压缩包名字.tar.gz [-C 路径]:解压缩包 z : gzip对包进行压缩 c : 创建包 create x : 解包 v : 显示操作的文件细节 verbose f : 文件名 file cp:复制文件/文件夹 mv:剪切 / 重命名 练习1: 1、切换到目录:/home/tarena/anaconda3/bin 2、查看当前所在的路径 3、以列表形式列出当前路径中所有内容(包含隐藏文件或者目录) 4、切换到当前路径的上一级目录 5、切换到 /etc 目录,查看 /etc 有哪些内容 6、直接切换到用户主目录 答案: tarena@tedu:~$ cd anaconda3/bin/ tarena@tedu:~/anaconda3/bin$ pwd /home/tarena/anaconda3/bin tarena@tedu:~/anaconda3/bin$ ls -la 总用量 27888 drwxrwxr-x 2 tarena tarena 12288 7月 17 2017 . drwxrwxr-x 20 tarena tarena 4096 7月 17 2017 .. lrwxrwxrwx 1 tarena tarena 8 7月 17 2017 2to3 -> 2to3-3.6 -rwxrwxr-x 1 tarena tarena 110 7月 17 2017 2to3-3.6 -rwxrwxr-x 2 tarena tarena 3802 5月 26 2017 activate -rwxrwxr-x 1 tarena tarena 165 7月 17 2017 anaconda -rwxrwxr-x 1 tarena tarena 167 7月 17 2017 anaconda-navigator -rwxrwxr-x 1 tarena tarena 153 7月 17 2017 anaconda-project -rwxrwxr-x 1 tarena tarena 12003 7月 17 2017 asadmin tarena@tedu:~/anaconda3/bin$ cd .. tarena@tedu:~/anaconda3$ cd etc/ tarena@tedu:~/anaconda3/etc$ ls dbus-1 fish fonts jupyter rc.d tarena@tedu:~/anaconda3/etc$ cd 练习2: 1、在用户主目录下创建目录 mydir1 、mydir2 2、在mydir1下创建文件:file1、file2、file3 3、将mydir1打包压缩为mydir1.tar.gz,放在用户主目录下 4、将mydir1.tar.gz剪切到mydir1目录下 5、将mydir1.tar.gz解压缩,放到mydir2目录下(-C选项) 答案: tarena@tedu:~$ mkdir mydir1 mydir2 tarena@tedu:~$ cd mydir1 tarena@tedu:~/mydir1$ touch file1 file2 file3 tarena@tedu:~/mydir1$ cd .. tarena@tedu:~$ tar -zcvf mydir1.tar.gz mydir1 mydir1/ mydir1/file3 mydir1/file1 mydir1/file2 tarena@tedu:~$ ls anaconda3 mydir2 yang 文档 core my_env 公共的 下载 examples.desktop pycharm-2017.1.5 模板 音乐 mydir1 pycharm-professional-2017.1.5.tar.gz 视频 桌面 mydir1.tar.gz PycharmProjects 图片 tarena@tedu:~$ mv mydir1.tar.gz mydir1 tarena@tedu:~$ cd mydir1 tarena@tedu:~/mydir1$ ls file1 file2 file3 mydir1.tar.gz tarena@tedu:~/mydir1$ tar -zxvf mydir1.tar.gz -C ~/mydir2 mydir1/ mydir1/file3 mydir1/file1 mydir1/file2 tarena@tedu:~/mydir1$ cd ~/mydir2 tarena@tedu:~/mydir2$ ls mydir1 tarena@tedu:~/mydir2$ cd mydir1/ tarena@tedu:~/mydir2/mydir1$ ls file1 file2 file3 tarena@tedu:~/mydir2/mydir1$ 练习3: 1、在用户主目录下创建目录:AI/Python/Linux 2、在Linux下创建文件:linux1 、linux2 3、在Python下创建文件:python1 、python2: 4、切换到AI目录,查看当前所在路径 5、直接切换到用户主目录 答案: tarena@tedu:~$ mkdir -p AI/python/linux tarena@tedu:~$ cd AI/python/linux tarena@tedu:~/AI/python/linux$ touch linux1 linux2 tarena@tedu:~/AI/python/linux$ cd .. tarena@tedu:~/AI/python$ touch python1 python2 tarena@tedu:~/AI/python$ cd ~/AI tarena@tedu:~/AI$ cd 练习4: 1、在用户主目录创建如下结构:PYTHON/Linux/day01 2、在 day01 下创建三个文件:day01.txt day02.txt day03.txt 3、将 day03.txt 删除 4、将 day02.txt 文件时间更新为当前时间 5、在用户主目录下创建 python/Base 6、在Base下创建 day01 day02 day03 三个文件夹 7、在day01下创建一个文件 day01.txt 8、删除 python/Base 文件夹内的全部内容 答案: tarena@tedu:~$ mkdir -p PYTHON/linux/day01 tarena@tedu:~$ cd PYTHON/linux/day01 tarena@tedu:~/PYTHON/linux/day01$ touch day01.txt day02.txt day03.ttx tarena@tedu:~/PYTHON/linux/day01$ rm -rf day03.txt tarena@tedu:~/PYTHON/linux/day01$ touch day02.txt tarena@tedu:~/PYTHON/linux/day01$ mkdir -p ~/python/base tarena@tedu:~/PYTHON/linux/day01$ pwd /home/tarena/PYTHON/linux/day01 tarena@tedu:~/PYTHON/linux/day01$ ls day01.txt day02.txt day03.ttx tarena@tedu:~/PYTHON/linux/day01$ cd ~/python/base tarena@tedu:~/python/base$ mkdir day01 day02 day03 tarena@tedu:~/python/base$ cd day01 tarena@tedu:~/python/base/day01$ touch day01.txt tarena@tedu:~/python/base/day01$ cd tarena@tedu:~$ rm -rf python 一、二进制 1 2 4 8 16 32 64 128 256 512 1024 2048 4096 8192 163841 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0=0 1=1 2=10 3=11 4=100 5=101 6=110 7=111 8=1000 9=1001 .... 127=1111111二进制算法= 2**n-1 幂运算-1 · 十进制整数转二进制数:“除以2取余,逆序排列”(除二取 余法) 89÷2 ……1 44÷2 ……0 22÷2 ……0 11÷2 ……1 5÷2 ……1 2÷2 ……0 十进制整数转八进制数: 000 -> 0 | 004-> 4 | 010=8 001 -> 1 |005 -> 5| 011=9 002 -> 2 |006 -> 6 | 012=10 003 -> 3 |007 -> 7 | 013=11 十进制整数转十六进制数: 0000 -> 0 0100 -> 4 1000 -> 8 1100 -> C 0001 -> 1 0101 -> 5 1001 -> 9 1101 -> D 0010 -> 2 0110 -> 6 1010 -> A 1110 -> E 0011 -> 3 0111 -> 7 1011 -> B 1111 -> F 二、编码 Ascll码 255个字符 Ascll码表每个字符统一占用1个字节 Ascll码表不支持中文 支持中文的第一张表 叫GB2312 1980年 GB3212 支持6700+字 1995年 GBK1.0 支持20000字 2000年 GB18030 支持27000字 unicode :万国码 (支持所有国家的编码) 并且一个字符 统一占用2个字节 由于出于它的效率不高,对于存储和传输来说都很耗资源。为了提高Unicode的编码效率,于是就出现了UTF-8编码 UTF-8 、 UTF-8是 unicode的扩展集 英文占一个字节 东南亚 欧洲国家2个字节 中文3个字节 Assic --> GB2312 --> GBK1.0 --> GB18030 --> unicode --> UTF-8 Unicode是可以向下兼容GB2312、GBK 、GB17030而UTF8 重新划分分类和次序 不再是原来的次序编码 #!-*-coding:utf-8 -*- (声明使用utf8编码)#codig:utf-8(声明使用utf8编码) print u“我爱北京天安门?”(u代表转换Unicode格式)转换编码打印

优秀的个人博客,低调大师

Node工程-构建优秀的Session机制

我们公司的大佬 串串,搭建了一套基于koa2的node框架,虽然说是重复造轮子,但适用当前场景的轮子才是最好的,何况很多人还造不出轮子呢~ 大佬搭建的框架命名为 Sponse,其中有很多出色的设计,这里对 session 的设计做个总结(其实是为了自己加深印象,学习大佬的设计) Sponse意思是海绵,而我们这套框架就如同海绵一样,通过不断吸收其他框架的优秀设计丰满自己 cookie 与 session 做开发的小伙伴对这两个应该在熟悉不过了,这两个一起构建起前后端状态的联系,常见的如维护用户登录状态,用户登录后,需要在服务端记录下该用户的登录状态,前端才可以使用需要登录态的接口,此时,浏览器中的 cookie 就是查询用户是否登录的凭证,在服务端,通常是将用户状态信息存储在缓存中,简单说,就是基于 cookie的session 调用方式 优秀的架构中,调用方式必须是友好的 期望能够通过上下文直接调用,如:获取session对象 ctx.session ; 设置session的值 ctx.session.name = name 逻辑图 整体实现逻辑如下 实现 koa提供了操作cookie的api,开箱即用,官方截图如下 缓存基于redis实现 详细代码如下: Session 对象 首先构建一个session对象 核心方法: save 用于同步cookie changed 用于检测session对象是否发生修改,为了同步更新缓存中的值 export class Session { private _ctx; isNew: boolean; _json; // session对象的json串,用于比较session对象是否发生变化 constructor(ctx, obj) { this._ctx = ctx; if (!obj) this.isNew = true; else { for (const k in obj) { this[k] = obj[k]; } } } /** * Save session changes by * performing a Set-Cookie. * * @api private */ save() { const ctx = this._ctx; const json = this._json || JSON.stringify(this.inspect()); const sid = ctx.sessionId; const opts = ctx.cookieOption; const key = ctx.sessionKey; if (ctx.cookies.get(key) !== sid) { // 设置cookies的值 ctx.cookies.set(key, sid, opts); } return json; }; /** * JSON representation of the session. * * @return {Object} * @api public */ inspect() { const self = this; const obj = {}; Object.keys(this).forEach(function (key) { if ('isNew' === key) return; if ('_' === key[0]) return; obj[key] = self[key]; }); return obj; } /** * Check if the session has changed relative to the `prev` * JSON value from the request. * * @param {String} [prev] * @return {Boolean} * @api private */ changed(prev) { if (!prev) return true; this._json = JSON.stringify(this.inspect()); return this._json !== prev; }; } 复制代码 SessionEngine koa中间件 koa 当然是离不开中间件了,洋葱模型酷炫到不行,非常方便的解决了session对象与缓存的同步 decorator(app) { app.keys = ['signed-key']; const CONFIG = { key: app.config.name + '.sess', /** (string) cookie key (default is koa:sess) */ cookie: { // maxAge: 1000, /** (number) maxAge in ms (default is 1 days) */ overwrite: false, /** (boolean) can overwrite or not (default true) */ httpOnly: true, /** (boolean) httpOnly or not (default true) */ signed: true, /** (boolean) signed or not (default true) */ } }; app.use(async (ctx, next) => { let sess: Session; let sid; let json; ctx.cookieOption = CONFIG.cookie; ctx.sessionKey = CONFIG.key; ctx.sessionId = null; // 获取cookie 对应的值, 即sessionID,就是缓存中的key sid = ctx.cookies.get(CONFIG.key, ctx.cookieOption); // 获取session值 if (sid) { try { // 若key存在,则从缓存中获取对应的值 json = await app.redisClient.get(sid); } catch (e) { console.log('从缓存中读取session失败: %s\n', e); json = null; } } // 实例化session if (json) { // 若缓存中有值,则基于缓存中的值构建session对象 ctx.sessionId = sid; try { sess = new Session(ctx, json); } catch (err) { if (!(err instanceof SyntaxError)) throw err; sess = new Session(ctx, null); } } else { sid = ctx.sessionId = sid || Uuid.gen(); sess = new Session(ctx, null); } // 为了便于使用,将session挂载到上下文,这样就可以 ctx.session 这么使用了 Object.defineProperty(ctx, 'session', { get: function () { return sess; }, set: function (val) { if (null === val) return sess = null; if ('object' === typeof val) return sess = new Session(this, val); throw new Error('this.session can only be set as null or an object.'); } }); try { await next(); } catch (err) { throw err; } finally { if (null === sess) { // 设置session=null表示清空session ctx.cookies.set(CONFIG.key, '', ctx.cookieOption); } else if (sess.changed(json)) { // 检查 session 是否发生变化,若有变化,更新缓存中的值 json = sess.save(); await app.redisClient.set(sid, json); app.redisClient.ttl(sid); // 设置redis值过期时间为60分钟 app.redisClient.expire(sid, 7200); } else { // session 续期 app.redisClient.expire(sid, 7200); } } }); 复制代码 小结 多多学习~ 点点进步~ 原文发布时间:2018年06月29日 作者:小黎也 本文来源 掘金如需转载请紧急联系作者

优秀的个人博客,低调大师

Java工程师成神之路

一、基础篇JVM JVM内存结构 堆、栈、方法区、直接内存、堆和栈区别 https://blog.csdn.net/zhangqiluGrubby/article/details/59110906 Java内存模型 内存可见性、重排序、顺序一致性、volatile、锁、final http://www.54tianzhisheng.cn/2018/02/28/Java-Memory-Model/ 垃圾回收 内存分配策略、垃圾收集器(G1)、GC算法、GC参数、对象存活的判定 https://blog.csdn.net/qq_31997407/article/details/79735411 JVM参数及调优 Java对象模型 oop-klass、对象头 https://blog.csdn.net/itachi85/article/details/71159719 HotSpot 即时编译器、编译优化 https://blog.csdn.net/qq_16681169/article/details/72945113 类加载机制 classLoader、类加载过程、双亲委派(破坏双亲委派)、模块化(jboss modules、osgi、jigsaw) 1、一个java文件从被加载到被卸载这个生命过程,总共要经历5个阶段,JVM将类加载过程分为: 加载->链接(验证+准备+解析)->初始化(使用前的准备)->使用->卸载 https://blog.csdn.net/eff666/article/details/52203406 虚拟机性能监控与故障处理工具 jps, jstack, jmap、jstat, jconsole, jinfo, jhat, javap, btrace、TProfiler https://blog.csdn.net/yangchangyong0/article/details/78416192 编译与反编译 javac 、javap 、jad 、CRF http://www.cnblogs.com/mingcaoyouxin/p/4164964.html Java基础知识 阅读源代码 String、Integer、Long、Enum、BigDecimal、ThreadLocal、ClassLoader & URLClassLoader、ArrayList & LinkedList、 HashMap & LinkedHashMap & TreeMap & CouncurrentHashMap、HashSet & LinkedHashSet & TreeSet Java中各种变量类型 熟悉Java String的使用,熟悉String的各种函数 JDK 6和JDK 7中substring的原理及区别、 replaceFirst、replaceAll、replace区别、 String对“+”的重载、 String.valueOf和Integer.toString的区别、 字符串的不可变性 自动拆装箱 Integer的缓存机制 熟悉Java中各种关键字 transient、instanceof、volatile、synchronized、final、static、const 原理及用法。 https://segmentfault.com/a/1190000010686246 集合类 常用集合类的使用 ArrayList和LinkedList和Vector的区别 SynchronizedList和Vector的区别 HashMap、HashTable、ConcurrentHashMap区别 http://www.cnblogs.com/binyue/p/4545550.html Java 8中stream相关用法 apache集合处理工具类的使用 http://zhoualine.iteye.com/blog/1770014 不同版本的JDK中HashMap的实现的区别以及原因 https://juejin.im/post/5a5f6d96f265da3e253c31fa 枚举 枚举的用法、枚举与单例、Enum类 Java IO&Java NIO,并学会使用 bio、nio和aio的区别、三种IO的用法与原理、netty http://matt33.com/2017/08/12/java-nio/ Java反射与javassist 反射与工厂模式、 java.lang.reflect.* Java序列化 什么是序列化与反序列化、为什么序列化 序列化底层原理 序列化与单例模式 protobuf 为什么说序列化并不安全 注解 元注解、自定义注解、Java中常用注解使用、注解与反射的结合 https://www.jianshu.com/p/c8655bcca388 JMS 什么是Java消息服务、JMS消息传送模型 JMX java.lang.management.*、 javax.management.* 泛型 泛型与继承 https://www.jianshu.com/p/bd1448352123 类型擦除 泛型中K T V E object等的含义、泛型各种用法 单元测试 junit、mock、mockito、内存数据库(h2) mockito: https://waylau.com/mockito-quick-start/ 正则表达式 java.lang.util.regex.* http://www.runoob.com/regexp/regexp-syntax.html 常用的Java工具库 commons.lang, commons.*... guava-libraries netty 什么是API&SPI 异常 异常类型、正确处理异常、自定义异常 时间处理 时区、时令、Java中时间API 编码方式 解决乱码问题、常用编码方式 语法糖 Java中语法糖原理、解语法糖 Java并发编程 什么是线程,与进程的区别 阅读源代码,并学会使用 Thread、Runnable、Callable、ReentrantLock、ReentrantReadWriteLock、Atomic*、Semaphore、CountDownLatch、、ConcurrentHashMap、Executors Callable: https://www.jianshu.com/p/edd7cb4eafa0 countDownLatch: http://www.importnew.com/15731.html 线程池 自己设计线程池、submit() 和 execute() 线程安全 死锁、死锁如何排查、Java线程调度、线程安全和内存模型的关系 锁 CAS、乐观锁与悲观锁、数据库相关锁机制、分布式锁、偏向锁、轻量级锁、重量级锁、monitor、锁优化、锁消除、锁粗化、自旋锁、可重入锁、阻塞锁、死锁 死锁 volatile happens-before、编译器指令重排和CPU指令重 synchronized synchronized是如何实现的? synchronized和lock之间关系 不使用synchronized如何实现一个线程安全的单例 sleep 和 wait wait 和 notify notify 和 notifyAll ThreadLocal 写一个死锁的程序 写代码来解决生产者消费者问题 守护线程 守护线程和非守护线程的区别以及用法 二、 进阶篇Java底层知识 字节码、class文件格式 CPU缓存,L1,L2,L3和伪共享 尾递归 位运算 用位运算实现加、减、乘、除、取余 设计模式 了解23种设计模式 会使用常用设计模式 单例、策略、工厂、适配器、责任链。 实现AOP 实现IOC 不用synchronized和lock,实现线程安全的单例模式 nio和reactor设计模式 网络编程 tcp、udp、http、https等常用协议 三次握手与四次关闭、流量控制和拥塞控制、OSI七层模型、tcp粘包与拆包 http/1.0 http/1.1 http/2之前的区别 Java RMI,Socket,HttpClient cookie 与 session cookie被禁用,如何实现session 用Java写一个简单的静态文件的HTTP服务器 实现客户端缓存功能,支持返回304 实现可并发下载一个文件 使用线程池处理客户端请求 使用nio处理客户端请求 支持简单的rewrite规则 上述功能在实现的时候需要满足“开闭原则” 了解nginx和apache服务器的特性并搭建一个对应的服务器 用Java实现FTP、SMTP协议 进程间通讯的方式 什么是CDN?如果实现? 什么是DNS? 反向代理 框架知识 Servlet线程安全问题 Servlet中的filter和listener Hibernate的缓存机制 Hiberate的懒加载 Spring Bean的初始化 Spring的AOP原理 自己实现Spring的IOC Spring MVC Spring Boot2.0 Spring Boot的starter原理,自己实现一个starter Spring Security 应用服务器 JBoss tomcat jetty Weblogic 工具 git & svn maven & gradle 三、 高级篇新技术 Java 8 lambda表达式、Stream API、 Java 9 Jigsaw、Jshell、Reactive Streams Java 10 局部变量类型推断、G1的并行Full GC、ThreadLocal握手机制 Spring 5 响应式编程 Spring Boot 2.0 性能优化 使用单例、使用Future模式、使用线程池、选择就绪、减少上下文切换、减少锁粒度、数据压缩、结果缓存 线上问题分析 dump获取 线程Dump、内存Dump、gc情况 dump分析 分析死锁、分析内存泄露 自己编写各种outofmemory,stackoverflow程序 HeapOutOfMemory、 Young OutOfMemory、MethodArea OutOfMemory、ConstantPool OutOfMemory、DirectMemory OutOfMemory、Stack OutOfMemory Stack OverFlow 常见问题解决思路 内存溢出、线程死锁、类加载冲突 使用工具尝试解决以下问题,并写下总结 当一个Java程序响应很慢时如何查找问题、 当一个Java程序频繁FullGC时如何解决问题、 如何查看垃圾回收日志、 当一个Java应用发生OutOfMemory时该如何解决、 如何判断是否出现死锁、 如何判断是否存在内存泄露 编译原理知识 编译与反编译 Java代码的编译与反编译 Java的反编译工具 词法分析,语法分析(LL算法,递归下降算法,LR算法),语义分析,运行时环境,中间代码,代码生成,代码优化 操作系统知识 Linux的常用命令 进程同步 缓冲区溢出 分段和分页 虚拟内存与主存 数据库知识 MySql 执行引擎 MySQL 执行计划 如何查看执行计划,如何根据执行计划进行SQL优化 SQL优化 事务 事务的隔离级别、事务能不能实现锁的功能 数据库锁 行锁、表锁、使用数据库锁实现乐观锁、 数据库主备搭建 binlog 内存数据库 h2 常用的nosql数据库 redis、memcached 分别使用数据库锁、NoSql实现分布式锁 性能调优 数据结构与算法知识 简单的数据结构 栈、队列、链表、数组、哈希表、 树 二叉树、字典树、平衡树、排序树、B树、B+树、R树、多路树、红黑树 排序算法 各种排序算法和时间复杂度 深度优先和广度优先搜索 全排列、贪心算法、KMP算法、hash算法、海量数据处理 大数据知识 Zookeeper 基本概念、常见用法 Solr,Lucene,ElasticSearch 在linux上部署solr,solrcloud,,新增、删除、查询索引 Storm,流式计算,了解Spark,S4 在linux上部署storm,用zookeeper做协调,运行storm hello world,local和remote模式运行调试storm topology。 Hadoop,离线计算 HDFS、MapReduce 分布式日志收集flume,kafka,logstash 数据挖掘,mahout 网络安全知识 什么是XSS XSS的防御 什么是CSRF 什么是注入攻击 SQL注入、XML注入、CRLF注入 什么是文件上传漏洞 加密与解密 MD5,SHA1、DES、AES、RSA、DSA 什么是DOS攻击和DDOS攻击 memcached为什么可以导致DDos攻击、什么是反射型DDoS SSL、TLS,HTTPS 如何通过Hash碰撞进行DOS攻击 用openssl签一个证书部署到apache或nginx 四、架构篇分布式 数据一致性、服务治理、服务降级 分布式事务 2PC、3PC、CAP、BASE、 可靠消息最终一致性、最大努力通知、TCC Dubbo 服务注册、服务发现,服务治理 分布式数据库 怎样打造一个分布式数据库、什么时候需要分布式数据库、mycat、otter、HBase 分布式文件系统 mfs、fastdfs 分布式缓存 缓存一致性、缓存命中率、缓存冗余 微服务 SOA、康威定律 ServiceMesh Docker & Kubernets Spring Boot Spring Cloud 高并发 分库分表 CDN技术 消息队列 ActiveMQ 监控 监控什么 CPU、内存、磁盘I/O、网络I/O等 监控手段 进程监控、语义监控、机器资源监控、数据波动 监控数据采集 日志、埋点 Dapper 负载均衡 tomcat负载均衡、Nginx负载均衡 DNS DNS原理、DNS的设计 CDN 数据一致性 五、 扩展篇云计算 IaaS、SaaS、PaaS、虚拟化技术、openstack、Serverlsess 搜索引擎 Solr、Lucene、Nutch、Elasticsearch 权限管理 Shiro 区块链 哈希算法、Merkle树、公钥密码算法、共识算法、Raft协议、Paxos 算法与 Raft 算法、拜占庭问题与算法、消息认证码与数字签名 比特币 挖矿、共识机制、闪电网络、侧链、热点问题、分叉 以太坊 超级账本 人工智能 数学基础、机器学习、人工神经网络、深度学习、应用场景。 常用框架 TensorFlow、DeepLearning4J 其他语言 Groovy、Python、Go、NodeJs、Swift、Rust 六、 推荐书籍 《深入理解Java虚拟机》 《Effective Java》 《深入分析Java Web技术内幕》 《大型网站技术架构》 《代码整洁之道》 《Head First设计模式》 《maven实战》 《区块链原理、设计与应用》 《Java并发编程实战》 《鸟哥的Linux私房菜》 《从Paxos到Zookeeper》 《架构即未来》 文章摘自: http://www.hollischuang.com/archives/489 http://www.hollischuang.com/archives/1001

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册