首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

OpenStack快速入门-queens版本

系统内存要求8G,硬盘100G,操作系统可以连接公网,单网卡即可满足操作。本次实验使用了2块网卡。 操作系统版本:(最小化安装)CentOS Linux release 7.4.1708 (Core)openstack-queens版本centos-release-openstack-queens-1-1.el7.centos.x86_64 1.系统配置:关闭不需要服务:setenforce 0sed -i 's/SELINUX=enforcing/SELINUX=disabled/' /etc/selinux/configsystemctl disable firewalld systemctl stop firewalld systemctl disable NetworkManager systemctl stop NetworkManager 2.OpenStack软件安装:yum install centos-release-openstack-queens.x86_64 -y(安装openstack的yum 源)yum install -y openstack-packstackyum install python-pip -ypackstack --allinone (本次安装环境所有组建部署在一个节点。) 3,登陆dashboardhttp://192.168.0.78密码记录在keystonerc_admin文件中: unset OS_SERVICE_TOKEN export OS_USERNAME=admin export OS_PASSWORD=a8e90bb181da420e export OS_AUTH_URL=http://192.168.0.79:5000/v2.0 export PS1='[\u@\h \W(keystone_admin)]\$ ' export OS_TENANT_NAME=admin export OS_REGION_NAME=RegionOne

优秀的个人博客,低调大师

代码审计入门总结

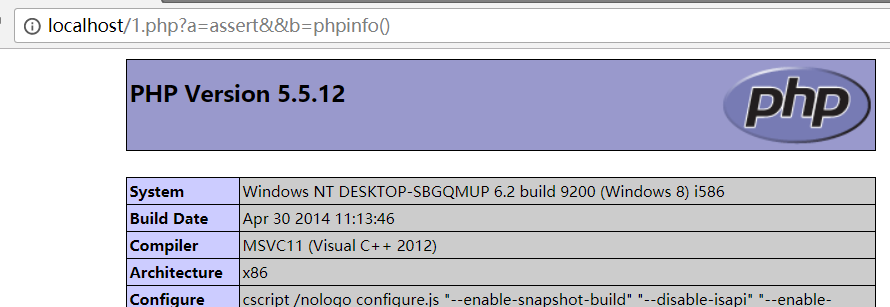
参考文献:http://www.vuln.cn/6701 通用思路 通读全文代码,从功能函数代码开始阅读,例如include文件夹下的common_fun.php,或者有类似关键字的文件。 看配置文件,带有config关键字的文件,找到mysql.class.php文件的connect()函数,查看在数据库连接时是否出现漏洞。 继续跟读首页文件index.php了解程序运作时调用了哪些函数和文件,以index.php文件作为标线,一层一层去扩展阅读所包含的文件,了解其功能,之后进入其功能文件夹的首页文件,进行扩展阅读。 漏洞总结: 1.文件操作漏洞 ①.文件包含漏洞:(详细可看:https://www.jianshu.com/p/41bb503abe61) (1) 本地文件包含: 一般存在于模块加载,模板加载,cache调用 包括函数:include()/include_once(),require()/require_once()寻找可控变量 (2)* 远程文件包含:* 前提条件:allow_url_include = on (3) 文件包含截断: %00截断(php版本小于5.3) 问号截断(问号后面相当于请求的参数,伪截断) 英文(.) 反斜杠(/) 截断 ②.文件读取(下载)漏洞: 搜索关键函数: file_get_contents() highlight_file() fopen() read file() fread() fgetss() fgets() parse_ini_file() show_source() file() ...... ③.文件上传漏洞: 搜索关键函数:move_uploaded_file()接着看调用这个函数的代码是否存在为限制上传格式或者可以绕过。 (1) 未过滤或本地过滤: 服务器端未过滤,直接上传PHP格式的文件即可利用。 (2) 黑名单扩展名过滤: 限制不够全面:IIS默认支持解析.asp,.cdx, .asa,.cer等。 (3) 文件头 content-type验证绕过: getimagesize()函数:验证文件头只要为GIF89a,就会返回真。 限制$_FILES["file"]["type"]的值 就是人为限制content-type为可控变量。 ④.文件删除漏洞: 搜索关键函数:unlink()利用回溯变量的方式 老版本下的session_destroy(),可以删除文件,现已基本被修复。 2.代码执行漏洞 ①代码执行函数: 搜索关键函数: eval(), assert(), preg_replace(), call_user_func(), call_user_func_array(), array_map() (1) preg_replace()函数: mixed preg_replace ( mixed $pattern , mixed $replacement , mixed $subject [, int $limit = -1 [, int &$count ]] ) 当$pattern处存在e修饰符时,$replacement 会被当做php代码执行。 (2)call_user_func()函数 mixed call_user_func( callable $callbank [ , mixed $parameter [ , mixed $…): 第一个参数为回调函数,第二个参数是回调函数的参数 (3)eval()和assert(): 当assert()的参数为字符串时 可执行PHP代码 eval(" phpinfo(); ");【√】 eval(" phpinfo() ");【X】 assert(" phpinfo(); ");【√】 assert(" phpinfo() ");【√】 ②.动态函数执行: 动态函数后门: <?php $_GET['a']($_GET['b']); ?> 1.png ③.命令执行函数: 搜索关键函数: system(), exec(), shell_exec(), passthru() ,pcntl_exec(), popen(),proc_open() (1) popen()和proc_open(): <?php popen( 'whoami >> 1.txt', 'r' ); ?> 所在路径就会出现一个1.txt ,里面的内容为命令执行后的结果 (2) 反引号命令执行: <?php echo `whoami`; ?> //直接就可以执行命令 双引号和单引号的区别: <?php $a = 1; echo " $a " ; //1 echo ' $a ' ;//$a ?> //双引号时,可以直接解析变量,造成代码执行漏洞。 3.变量覆盖漏洞 ①.函数使用不当: int extract( array &$var_array , int $extract_type = EXTR_OVERWRITE , string $prefix = null ) void parse_str( string $str , array &$arr ) bool import_request_variables( string $type , string $prefix ) ②.$$变量覆盖: <?php include "flag.php"; if ($_SERVER["REQUEST_METHOD"] != "POST") die("flag is here"); if (!isset($_POST["flag"]) ) die($_403); foreach ($_GET as $k => $v){ $$k = $$v; } foreach ($_POST as $k => $v){ $$k = $v; } if ( $_POST["flag"] !== $flag ) die($_403); echo "flag: ". $flag . "\n"; die($_200); ?> 使用了两个foreach并且也使用了$$.两个foreach中对 $$key的处理是不一样的,满足条件后会将$flag里面的值打印出来。 但是由于后两个if语句及foreach代码会将$flag的值给覆盖掉了,所以需要先将$flag的值赋给$_200或$_403变量,然后利用die($_200)或 die($_403)将flag打印出来。 解题方法: 利用第一个foreach先将$flag的值赋给$_200,然后利用die($_200)将原本的flag值打印出来。 最终PAYLOAD: GET DATA:?_200=flag POST DATA:flag=aaaaaaaaaaaaaaaaaaaaa 4.逻辑漏洞 需要思考的问题: 程序是否可以重复安装 修改密码是否存在越权,修改其他用户密码 找回密码验证码是否可以暴力破解 cookie是否可以预测 验证存在绕过 ①.账户体系中的越权问题: 水平越权:A用户能够以B用户的身份,进行B用户的全部权限操作。前提A用户和B用户拥有相同的权限。 垂直越权:A用户能够以C用户的身份,进行C用户的全部权限操作,前提C用户比A用户拥有更高的权限。 (1) 未exit/return/die: <?php if(file_exists('install.lock)){ header("Location:xxx.com"); } echo "test"; ?> test 依旧会被输出,替换成安装流程,PHP依旧会进行。 (2) 支付漏洞: 客户端修改单价 客户端修改总价和购买数量 服务端未校验严格 重复发包利用时间差: <?php if (check_money($price)){ //Do something //花费几秒 $money = $money - $price; } ?> 可能导致漏洞函数: str_replace() <?php $a = addslashes($_GET['a']); $b = addslashes($_GET['b']); echo "$a<br>$b<br>"; $c = str_replace($a,'',$b); echo trim($c); ?> 1.png 5.会话认证漏洞 COOKIE验证:没有使用SESSION验证,将信息直接保存在COOKIE中 找到传入sql语句的参数的传递过程,回溯变量到最原始的函数,看它保存在cookie的算法是否可逆 审计代码时,查看登录处代码

优秀的个人博客,低调大师

Serverless Kubernetes 快速入门指南

5月,阿里云宣布推出Serverless Kubernetes服务。开发者可在5秒内创建集群、30秒部署应用上线。用户无需管理集群基础设施,根据应用实际消耗资源按量付费;用户可以直接使用K8S API或命令行来管理容器应用,容器应用可以与VPC中现有应用和阿里云能力无缝集成。此举可以进一步降低容器技术的使用门槛,让用户关注在应用构建而非基础架构运维。 我们提供一些示例,帮助大家快速上手。 通过控制台部署一个机器学习的示例应用 利用 kubectl 直接部署、管理容器应用 使用 CodePipeline 实现CI/CD, 详情 更多示例 可以参考 https://github.com/AliyunContainerService/serverless-k8s-examples 利用 Init Container 部署 tomcat 应用 利用 Si

优秀的个人博客,低调大师

Terraform alicloud provider开发入门

Terraform和AliCloud Terraform provider简介 Terraform是一家名叫HashCorp的洛杉矶公司推出的,HashCorp名称来源于它的创始人Mitchell Hashimoto姓氏的一部分。Terraform宣称可以“为任意的应用部署任意的基础设施资源”,这得益于丰富的Terraform provider,目前全球顶级云计算玩家和热门的云计算架构(OpenStack/Kubernetes/Docker)都为Terraform贡献了provider。阿里云也不例外,AliCloud Terraform provider作为支持Terraform的providers之一,目前支持ECS, Block Storage, SLB, VPC, Nat Gateway, RDS, ESS, OSS等云产品

优秀的个人博客,低调大师

Docker 从入门到精通

1、yum安装 2、获取镜像 docker pull IP/iamjingxiang 3、运行镜像 docker run -t -i iamjingxiang /bin/bash 4、列出本地镜像 docker images 5、保存更改后的镜像 docker commit -m "Added json gem" -a "Docker Newbee" 0b2616b0e5a8 ouruser/sinatra:v2 6、Dockerfile文件来创建镜像 image.png 生成镜像:docker build ,其中.为dockerfile的路径 image.png 7、add复制文件,expose开放端口,CMD容器启动后的执行的东西 image.png 8、Docker push上传镜像 9、docker save/load 保存与载入压缩后的镜像 10、docker rm 删除镜像 11、docker run -d 后台启动容器 12、查看 docker ps -a 13、挂载本地磁盘到容器中 image.png 14、数据卷容器 image.png 15、本机与容器端口映射 image.png 16、查看端口映射与多端口映射 image.png 17、--LINK 容器互联

优秀的个人博客,低调大师

YII入门及创建博客

参考文献:http://www.manks.top/document/install.html 配置项参考:http://www.manks.top/document/yii2-blog-config.html yii安装条件: ①php是PHP 5.4 以上版本 ②安装了PDO PHP扩展 ③安装了相应的数据库驱动,如 pdo_mysql 在ubuntu下安装PDO PHP,可以参考http://blog.csdn.net/mrwangweijin/article/details/76152693 修改配置文件 先安装mysql,我的版本是php7.0;然后执行以下命令 cd /etc/php/7.0/cli //进入配置文件目录 vim php.ini //vim打开配置文件 extension=php_pdo_mysql.dll //去掉extensions前面的;号 sudo service apache2 restart //重启服务就行了。 若是不知道是否安装好了,可以在www目录下放一个1.php <?php $dbms='mysql'; //数据库类型 $host='localhost'; //数据库主机名 $dbName='mysql'; //使用的数据库 $user='root'; //数据库连接用户名 $pass=''; //对应的密码 $dsn="$dbms:host=$host;dbname=$dbName"; try { $dbh = new PDO($dsn, $user, $pass); //初始化一个PDO对象 echo "连接成功<br/>";} ?> 运行输出 连接成功 就可以了。 准备工作做好了,现在可以开始安装yii了。 ①在官网(http://www.yiiframework.com/download/)下载一份高级版本(advanced),与其对应的是basic版本。advanced自带多应用,其实就是可以直接在这个版本上配置多个应用,比如frontend(前台应用),backend(后台应用),console(命令行应用)以及api应用。basic还得手动配置,麻烦一些。 ②解压后拷贝advanced目录放到web(linux下就是www/html)可访问目录,文件名advanced,不做改动 ③在linux下,切换到advanced目录执行php init命令进行初始化 ④回车后这里会让选择开发环境 0开发环境 1生产环境 这里我们选择0 开发环境,输入后回车,会让输入yes或者no进行确认,输入yes确认即可 ⑤ok了之后,切换到根目录下,执行命令composer install,这里的根目录指的是common目录的同级目录。//但是这一步骤,我显示的是没有composer这个命令 ⑥验证下是否安装成功了。在apache下运行localhost/advanced/frontend/web/,界面上显示一个大大的Congratulations即表示安装成功! 参考文献:http://www.manks.top/document/easy_blog_manage_system.html 1.我们先把数据库配置一下,打开 common\config\main-local.php文件,在 components 下面的db配置,将dbname改成已经创建好的数据库名字,username和password改成自己连接数据库的时候的用户名和密码。 1.png 感觉在ubuntu下面的时候,权限给的是真的少,yii都没有权限,需要用到的文件什么的给权限就好,chmod命令很方便的./yii migrate/create create_blog_table,用这个命令可以生成的迁移文件位于 advanced\console\migrations目录,yii migrate 命令已经在迁移文件中为我们添加了主键ID和表名,接下来我们要打开该文件修改表名以及添加更我们需要的列到数据表 2.png 表创建好之后使用 ./yii migrate命令,中间会让我们确认,yes后回车即可,该命令会为我们创建迁移文件(console\migrations目录)中定义的所有数据表,执行完该命令打开数据库会发现,我们的blog表已经创建成功了,其中包含了我们在migration中定义的列。 在我们创建的数据库中还有uesr和migration这两个表,其中migration这个表中记录了我们使用它创建表的命令。 在目前的advanced版本中,实际上配置文件有4个,分别是common\config\main.php和common\config\main-local.php以及应用的main.php和main-local.php,这四个配置文件是有优先级的,按照项目入口文件内加载的顺序来看,其优先级为 app\config\main-loca.php > app\config\main.php > common\config\main-local.php > common\config\main.php,这些配置文件的区分对比可按照下面2条来理解 ①app针对具体应用的配置,common是公共的配置,多个项目共同的配置可以写在common\config内; ② 实际的开发环境可能包括本地环境、测试环境、正式环境,以这三种环境为例,main.php可以作为三者都可能存在的配置,main-local.php可以作为当前环境独有的配置,比如本地的main-local和测试的、正式的main-local都是独立的,互不影响,其独立而互不影响的前提就在于git的ignore文件。 2.使用gii生成AR模型和CRUD gii是yii2中的一个强大的组件,是一种高度可定制和可扩展的代码生成工具。使用它可以大幅提高我们的开发效率。如果在安装的过程中,选择的是开发环境,gii默认是开启的。也就是说无需再进行配置便可以使用,也可以打开文件 advanced\frontend\config\main-local.php查看配置代码。 2.png 打开 http://localhost/advanced/frontend/web/index.php?r=gii可以直接访问gii这个模块。 2.1生成AR模型类 点击页面上的Model Generator start,像下面这样生成AR模型类。 1.png 其中Namespace不要用app\models,要不下面生成CRUD会出错,然后点击Preview之后,再点击Generate,若是出现成功单词就创建成功了,刚开始一直创建不成功,我后来尝试先在/var/www/html/advanced/common/models/下创建Blog.php依旧不行,后来大佬提醒我可能是权限不够,我就把全部权限都给advanced这个文件了,然后就好了。 2.2生成CRUD代码 CRUD这四个字母分别是Create Read Update Delete,也就是创建、读取、更新和删除的意思。接着点击左侧菜单CRUD Generator像下面这样生成crud 1.png 按照以上操作,我们会在如下相关目录生成9个文件 common\models\Blog.php common\models\BlogSearch.php frontend\controllers\BlogController.php frontend\views\blog\ _form.php frontend\views\blog\ _search.php frontend\views\blog\create.php frontend\views\blog\index.php frontend\views\blog\update.php frontend\views\blog\view.php 然后可以通过。访问http://localhost/advanced/frontend/web/index.php?r=blog看到blog具体页面信息。 3.添加博客 以上通过gii我们便已经完成了博客管理的增删改查。实际开发中,最常见的便是共用一套配置的方法了,比如我们在common\config\main-local.php文件中对数据库配置好,当前项目下所有的应用都可以同数据库交互了。 3.1首先已经在common\models下定类模型blog,为了各个应用操作方便,为单个应用创建一个继承该基类的模型类,如frontend\models\BlogForm,backend\models\BlogForm,操作前台的BlogForm完全不会影响到后台的模型类,与此同时前后台还可以通过基类common\models\Blog有共同用法。 操作方法: 【1】拷贝common\models\Blog.php到frontend\models\BlogForm.php(自己创建的)后,打开BlogForm.php文件稍作修改: ①命名空间(namespace)修改为 namespace frontend\models; ②增加需要继承的父类 use common\models\Blog; ③类名修改为BlogForm ④继承类修改为Blog//这个继承类若是不修改的话,下面的修改其他函数,会出现调用问题。修改成这样class BlogForm extends Blog 【2】打开frontend\controllers\BlogController.php文件: ①在控制器文件BlogController.php文件顶部,namespace下面添加use frontend\models\BlogForm; ②修改actionCreate方法$model实例化的类为BlogForm, 即 $model = new BlogForm(); ③修改findModel($id)函数中的($model = Blog::findOne($id)) !== null) 中的Blog为BlogForm 3.2修改博客的显示方式frontend\controllers\BlogController.php的create方法我们可以看到,模版文件是通过 1.png 来调用的,然后我们找到跟 frontend\views\blog\create.php,views这里存放的基本上都是视图文件 3.png 这里引用了一个子视图文件_form,该文件位于create.php同级下,打开该文件后会发现一开始显示的表单原来在这里。 为了实现我们想要把字段显示为中文的标题内容,在BlogForm文件修改attributeLabels方法。而我们这里的label跟我们一开始用gii生成model时是否勾选Generate Labels from DB Comments一项有关。我们修改attributeLabels方法如下: 1.png 在_form.php文件中,表单的创建借助的是组件 ActiveForm ,表单提交默认的action是当前操作方法。yii2中利用该组件不仅可以快速方便的构建表单,而且还结合model+jquery实现了表单的各种验证,要对用户提交的数据进行验证,需要声明与需验证模型特性相关的验证规则。接下来我们修改BlogForm的rules方法,展示对标题设置为必填项,而且长度不能超过100个字符。 1.png 为了让我们的规则起作用,还需要调用yii\base\Model::validate()方法。该方法会返回一个布尔值。若没有通过,则通过 yii\base\Model::errors 属性获取相应的报错信息。我们稍微对actionCreate进行修改, 比如像下面这样: 3.png 然后添加数据就行了。 3.3代码列表页数据的由来。 通过frontend\models\BlogSearch(将common\models\BlogSearch.php拷贝到frontend\models\BlogSearch)的search提供的,打开frontend\models\BlogSearch.php文件 ①增加 use frontend\models\BlogForm; ②继承类修改为 BlogForm ③search方法中Blog::find()修改为BlogForm::find() ④将#use common\models\Blog;这一行注释掉,或者修改blog.php里面的数据为中文 关于博客数据的删除,可以手动点击右侧按钮直接进行删除即可。该动作会执行 BlogController的actionDelete操作,调用model的delete方法进行数据的删除,该删除属于数据直接从数据库中永久性删除。

优秀的个人博客,低调大师

Elastic Stack学习--logstash入门

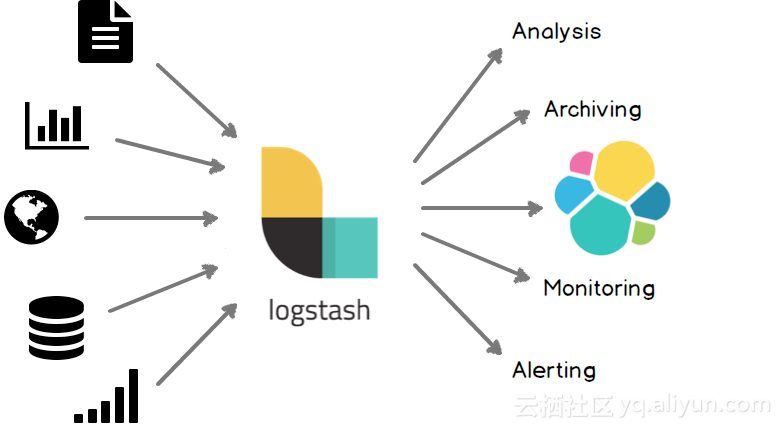
logstash是基于实时管道的数据收集引擎。它像一根处理数据的管道,收集分散的数据,进行汇总处理后输出给下游进行数据分析和展现。 logstash可以配合Beats组件或者其它第三方组件进行数据收集,数据经过处理后存放到elasticsearch中进行检索和分析。 除了对接beats以外,logstash有着丰富的组件,能够支持各种数据源接入。包括jdbc、kafka、http等。 logstash是基于pipeline方式进行数据处理的,pipeline可以理解为数据处理流程的抽象。在一条pipeline数据经过上游数据源汇总到消息队列中,然后由多个工作线程进行数据的转换处理,最后输出到下游组件。一个logstash中可以包含多个pipeline。 基本概念 pipeline:一条数据处理流程的逻辑抽象,类似于一条管道,数据从一端流入,经过处理后,从另一端流出;一个pipeline包括输入、过滤、输出3个部分,其中输入和输出部分是必选组件,过滤是可选组件; instance:一个logstash实例,可以包含多条数据处理流程,即多个pipeline; inputs:数据输入组件,用于对接各种数据源,接入数据,支持解码器,允许对数据进行编码解码操作;必选组件; filters:数据过滤组件,负责对输入数据进行加工处理;可选组件; outputs:数据输出组件,用于对接下游组件,发送处理后的数据,支持解码器,允许对数据进行编码解码操作;必选组件; event:pipeline中的数据都是基于事件的,一个event可以看作是数据流中的一条数据或者一条消息; 安装logstash 1)依赖java8,且不支持java9:检查java版本并配置JAVA_HOME环境变量。logstash基于jruby开发,logstash 6.x版本要求运行在java8环境,且目前不支持java9;2)下载并解压:下载logstash,解压文件;注意logstash所在路径中不可以包含冒号; tar -zxvf logstash-6.2.2.tar.gz cd logstash-6.2.2 3)启动logstash,发布第一个事件:通过-e指定一个pipeline的处理流程,指定从stdin中读取event,然后在stdout输出; bin/logstash -e 'input { stdin { } } output { stdout {} }' 可以看到类似如下日志: Sending Logstash's logs to /home/work/zion_package/elastic/logstash/logstash-6.2.2/logs which is now configured via log4j2.properties h[2018-03-14T14:48:00,053][INFO ][logstash.modules.scaffold] Initializing module {:module_name=>"fb_apache", :directory=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/modules/fb_apache/configuration"} [2018-03-14T14:48:00,074][INFO ][logstash.modules.scaffold] Initializing module {:module_name=>"netflow", :directory=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/modules/netflow/configuration"} [2018-03-14T14:48:00,172][INFO ][logstash.setting.writabledirectory] Creating directory {:setting=>"path.queue", :path=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/data/queue"} [2018-03-14T14:48:00,178][INFO ][logstash.setting.writabledirectory] Creating directory {:setting=>"path.dead_letter_queue", :path=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/data/dead_letter_queue"} [2018-03-14T14:48:00,631][WARN ][logstash.config.source.multilocal] Ignoring the 'pipelines.yml' file because modules or command line options are specified [2018-03-14T14:48:00,672][INFO ][logstash.agent ] No persistent UUID file found. Generating new UUID {:uuid=>"5901ab9f-fdc9-43dc-a88d-c5c636cf8224", :path=>"/home/work/zion_package/elastic/logstash/logstash-6.2.2/data/uuid"} [2018-03-14T14:48:01,337][INFO ][logstash.runner ] Starting Logstash {"logstash.version"=>"6.2.2"} [2018-03-14T14:48:01,733][INFO ][logstash.agent ] Successfully started Logstash API endpoint {:port=>9600} [2018-03-14T14:48:03,264][INFO ][logstash.pipeline ] Starting pipeline {:pipeline_id=>"main", "pipeline.workers"=>12, "pipeline.batch.size"=>125, "pipeline.batch.delay"=>50} [2018-03-14T14:48:03,453][INFO ][logstash.pipeline ] Pipeline started succesfully {:pipeline_id=>"main", :thread=>"#<Thread:0x128244e5 run>"} The stdin plugin is now waiting for input: [2018-03-14T14:48:03,546][INFO ][logstash.agent ] Pipelines running {:count=>1, :pipelines=>["main"]} 在控制台随便输入字符串按回车后,发现消息会立刻在控制台输出,此时pipeline的处理过程是从stdin接收我们的输入,然后再在stdout输出: Hello, this is my first event to logstash ! 2018-03-14T06:50:26.261Z yf-beidou-dmp00.yf01.baidu.com Hello, this is my first event to logstash ! logstash会给消息添加ip和时间戳,要退出logstash,输入ctrl+d; 通过Filebeat发送日志到logstash 配置Filebeat Filebeat用于追踪服务器上的文件数据,它的设计以可靠和低资源占用为初衷,和业务系统部署在一起时,能够避免因为资源消耗影响到业务系统的正常运行。logstash安装后默认包含Beats input组件,用于接收各种beat组件上报事件。Filebeat也可以直接上报事件给elasticsearch,而不用经过logstash。 1)下载文件样例logstash-tutorial.log.gz,上传至Filebeat将要部署的服务器并解压;该样例为官方文档提供的apache的web日志样例。2)下载Filebeat,上传服务器并解压;此处下载LINUX 64-BIT的安装包; tar -zxvf filebeat-6.2.2-linux-x86_64.tar.gz cd filebeat-6.2.2-linux-x86_64 3)配置Filebeat,修改filebeat.yml,设置监控日志文件路径和上报logstash地址; filebeat.prospectors: - type: log # 监控日志文件路径 paths: - /path/to/file/logstash-tutorial.log output.logstash: # 上报logstash地址 hosts: ["localhost:5044"] 注:设置监控日志文件的路径一定是绝对路径,支持通配符; 4)启动Filebeat;其中-e参数指定输出日志到stderr,而非输出到日志文件;-c参数指定配置文件路径;-d参数debug选择器; ./filebeat -e -c filebeat.yml -d "publish" 配置logstash 1)创建pipeline配置文件;pipeline配置格式如下: # The # character at the beginning of a line indicates a comment. Use # comments to describe your configuration. input { } # The filter part of this file is commented out to indicate that it is # optional. # filter { # # } output { } 创建一个名为first-pipeline.conf的文件,配置如下: input { beats { # 设置beats上报端口 port => "5044" } } # The filter part of this file is commented out to indicate that it is # optional. # filter { # # } output { # 输出到stdout,同时指定日志解码器为rubydebug stdout { codec => rubydebug } } 2)校验配置是否正确,命令如下。--config.test_and_exit选项会校验配置文件,并输出错误; bin/logstash -f first-pipeline.conf --config.test_and_exit 输出类似如下日志,说明配置文件格式校验通过: Configuration OK [2018-03-14T16:23:08,919][INFO ][logstash.runner ] Using config.test_and_exit mode. Config Validation Result: OK. Exiting Logstash 3)启动logstash,命令如下。--config.reload.automatic选项能够使得配置文件修改后被自动加载,从而避免重新启动logstash; bin/logstash -f first-pipeline.conf --config.reload.automatic 如果配置正确,可以看到logstash命令行有类似如下输出: { "host" => "yf-beidou-dmp00.yf01.baidu.com", "offset" => 22310, "tags" => [ [0] "beats_input_codec_plain_applied" ], "message" => "218.30.103.62 - - [04/Jan/2015:05:28:43 +0000] \"GET /blog/geekery/xvfb-firefox.html HTTP/1.1\" 200 10975 \"-\" \"Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)\"", "prospector" => { "type" => "log" }, "beat" => { "name" => "yf-beidou-dmp00.yf01.baidu.com", "version" => "6.2.2", "hostname" => "yf-beidou-dmp00.yf01.baidu.com" }, "@timestamp" => 2018-03-14T08:43:52.564Z, "source" => "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "@version" => "1" } 通过Grok过滤组件解析日志 通过上面的例子,我们可以将filebeat上报的日志经由logstash输出,接下来将添加filter组件,对日志进行处理。grok组件是logstash的filter组件之一,它可以将非结构化的数据按照一定规则整理成结构化数据,从而便于检索。这些规则需要根据日志格式事先设定好,因此需要了解采集日志的格式。因为我们的样例日志是apache的web日志,因而可以直接使用grok提供的%{COMBINEDAPACHELOG}格式进行日志的过滤,过滤后的日志格式如下: 修改first-pipeline.conf文件,增加filter,如下: input { beats { port => "5044" } } filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}"} } } output { stdout { codec => rubydebug } } 因为启动logstash时添加了--config.reload.automatic选项,logstash能够自动加载修改后的配置文件,因而不需要重启;修改保存后可以看到重新加载配置,重启pipeline的日志: [2018-03-14T17:04:57,325][INFO ][logstash.pipelineaction.reload] Reloading pipeline {"pipeline.id"=>:main} [2018-03-14T17:05:01,758][INFO ][logstash.pipeline ] Pipeline has terminated {:pipeline_id=>"main", :thread=>"#<Thread:0x58f295b9 run>"} [2018-03-14T17:05:02,048][INFO ][logstash.pipeline ] Starting pipeline {:pipeline_id=>"main", "pipeline.workers"=>12, "pipeline.batch.size"=>125, "pipeline.batch.delay"=>50} [2018-03-14T17:05:02,362][INFO ][logstash.inputs.beats ] Beats inputs: Starting input listener {:address=>"0.0.0.0:5044"} [2018-03-14T17:05:02,422][INFO ][logstash.pipeline ] Pipeline started succesfully {:pipeline_id=>"main", :thread=>"#<Thread:0x5506295b sleep>"} [2018-03-14T17:05:02,429][INFO ][org.logstash.beats.Server] Starting server on port: 5044 [2018-03-14T17:05:02,453][INFO ][logstash.agent ] Pipelines running {:count=>1, :pipelines=>["main"]} 为了能够使filebeat重新读取文件,需要停止filebeat,删除读取文件的保存点记录,并重启filebeat: cd filebeat-6.2.2-linux-x86_64 rm data/registry 添加filter后,输出的日志格式如下,发现不仅输出了日志原文,同时对日志进行解析切割,存放到相应的字段中。 { "host" => "yf-beidou-dmp00.yf01.baidu.com", "clientip" => "121.107.188.202", "verb" => "GET", "tags" => [ [0] "beats_input_codec_plain_applied" ], "message" => "121.107.188.202 - - [04/Jan/2015:05:27:57 +0000] \"GET /presentations/logstash-monitorama-2013/images/kibana-dashboard3.png HTTP/1.1\" 200 171717 \"-\" \"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/32.0.1700.107 Safari/537.36\"", "beat" => { "name" => "yf-beidou-dmp00.yf01.baidu.com", "version" => "6.2.2", "hostname" => "yf-beidou-dmp00.yf01.baidu.com" }, "httpversion" => "1.1", "auth" => "-", "response" => "200", "bytes" => "171717", "ident" => "-", "@version" => "1", "request" => "/presentations/logstash-monitorama-2013/images/kibana-dashboard3.png", "offset" => 21927, "prospector" => { "type" => "log" }, "@timestamp" => 2018-03-14T09:06:47.927Z, "source" => "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "timestamp" => "04/Jan/2015:05:27:57 +0000", "agent" => "\"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/32.0.1700.107 Safari/537.36\"", "referrer" => "\"-\"" } 使用Geoip过滤器组件增强数据处理 geoip也是filter组件的一种,用于从ip地址中解析出位置信息,并添加到输出日志中;geoip需要配置需要指定存放ip地址的字段,在本例中,我们使用通过gork解析后clientip字段;因为过滤器是按顺序过滤,所以需要确保geoip的过滤器在之前配置的gork过滤器之后,配置文件如下: input { beats { port => "5044" } } filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}"} } geoip { # 指定要进行ip解析的字段 source => "clientip" } } output { stdout { codec => rubydebug } } 停止filebeat,删除data/registry文件,重启filebeats后再次查看日志,发现新增了地理位置信息: { "host" => "yf-beidou-dmp00.yf01.baidu.com", "clientip" => "218.30.103.62", "verb" => "GET", "tags" => [ [0] "beats_input_codec_plain_applied" ], "message" => "218.30.103.62 - - [04/Jan/2015:05:28:43 +0000] \"GET /blog/geekery/xvfb-firefox.html HTTP/1.1\" 200 10975 \"-\" \"Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)\"", "beat" => { "name" => "yf-beidou-dmp00.yf01.baidu.com", "version" => "6.2.2", "hostname" => "yf-beidou-dmp00.yf01.baidu.com" }, "httpversion" => "1.1", "auth" => "-", "response" => "200", "bytes" => "10975", "ident" => "-", "@version" => "1", "request" => "/blog/geekery/xvfb-firefox.html", "geoip" => { "location" => { "lat" => 39.9289, "lon" => 116.3883 }, "latitude" => 39.9289, "continent_code" => "AS", "region_code" => "11", "country_code3" => "CN", "country_code2" => "CN", "longitude" => 116.3883, "city_name" => "Beijing", "country_name" => "China", "ip" => "218.30.103.62", "region_name" => "Beijing", "timezone" => "Asia/Shanghai" }, "offset" => 22310, "prospector" => { "type" => "log" }, "@timestamp" => 2018-03-14T09:22:31.299Z, "source" => "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "timestamp" => "04/Jan/2015:05:28:43 +0000", "agent" => "\"Sogou web spider/4.0(+http://www.sogou.com/docs/help/webmasters.htm#07)\"", "referrer" => "\"-\"" } 将logstash数据输出到elasticsearch 1)修改output,写入数据到elasticsearch:修改first-pipeline.conf文件,配置elasticsearch访问地址; input { beats { port => "5044" } } filter { grok { match => { "message" => "%{COMBINEDAPACHELOG}"} } geoip { source => "clientip" } } output { elasticsearch { # 指定elasticsearch地址,指定多个地址,logstash会自动负载均衡 hosts => [ "ip1:port1", "ip2,port2" ] # 如果设置用户名和密码,则需要指定如下两个字段; # 用户必须具有对index的CRUD权限; user => "username" password => "password" } } 2)重新发送消息:停止filebeat,删除data/registry文件,重启filebeats;3)检索日志:执行如下语句,查询是否有日志写入elasticsearch,ip和端口是elasticsearch实例的ip和端口;因为first-pipeline.conf中未指定创建index的名称格式,默认为:logstash-yyyy.MM.dd(日期部分需要替换);如果未指定用户名/密码,则不需要-u参数; curl -XGET 'ip:port/logstash-2018.03.14/_search?pretty&q=response=200' -u username:password 检索结果类似如下json串: { "took" : 20, "timed_out" : false, "_shards" : { "total" : 5, "successful" : 5, "skipped" : 0, "failed" : 0 }, "hits" : { "total" : 98, "max_score" : 2.3988724, "hits" : [ { "_index" : "logstash-2018.03.14", "_type" : "doc", "_id" : "t76VJGIBe9U4s2F_OL_W", "_score" : 2.3988724, "_source" : { "verb" : "GET", "@timestamp" : "2018-03-14T12:56:19.779Z", "response" : "200", "agent" : "\"Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_1) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/32.0.1700.77 Safari/537.36\"", "source" : "/home/work/zion_package/elastic/filebeat/logstash-tutorial.log", "host" : "yf-beidou-dmp00.yf01.baidu.com", "auth" : "-", "clientip" : "83.149.9.216", "geoip" : { "country_code3" : "RU", "continent_code" : "EU", "ip" : "83.149.9.216", ... ... 4)在kibana上配置index-pattern,通过Discover检索日志:点击菜单:Management -> Index Pattern; 点击 Create Index Pattern,创建index pattern; 点击菜单:Discover,检索日志; 参考 官方视频:Getting Started with Logstash官方文档:Getting Started with Logstash


优秀的个人博客,低调大师

Docker 快速入门之 Dockerfile

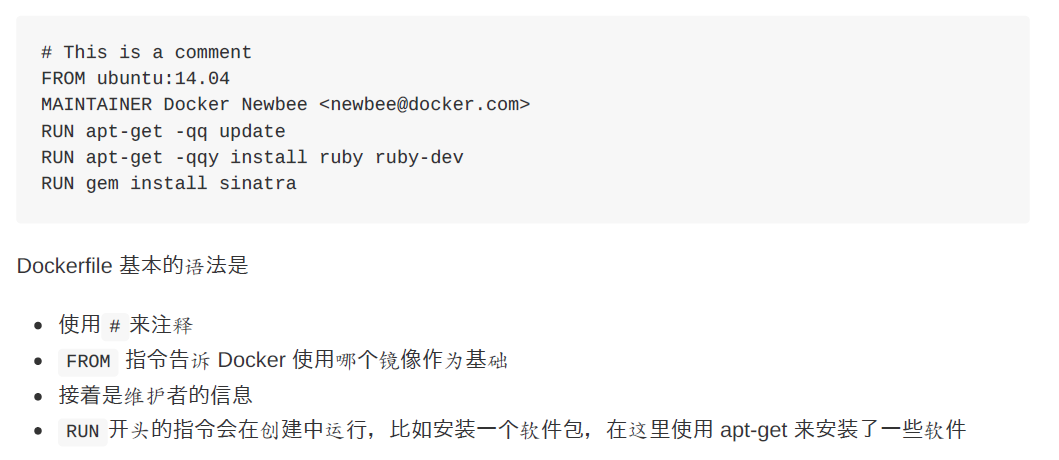
在容器环境中,我们可以通过容器创建一个我们自定义过的镜像,那么我们是否可以直接通过基础的镜像直接自定义镜像呢?答案当然是可以的,在 Docker 中我们可以从名为Dockerfile的文件中读取指令并且自动构建镜像。在本文中,将介绍 Dockerfile 的基本语法以及基本知识。 1 Dockerfile 是什么? Dockerfile 其实是一份文本文档,里面包含了用户可以用来操作镜像的一些指令。通过顺序执行这些指令,最后得到一个自定义的镜像,这有点类似于我们的shell script。 2 Dockerfile 示例 接下来先看一个 Dockerfile 示例: FROM centos LABEL maintainer="Locez <locez@locez.com>" ENV TEST="This is a test env" COPY nginx.repo /etc/yum.repos.d/nginx.repo RUN yum update -y && \ yum install -y nginx COPY nginx.conf /etc/nginx/nginx.conf COPY index.html /usr/share/nginx/html/index.html COPY index_files/ /usr/share/nginx/html/index_files/ EXPOSE 80 CMD ["/usr/sbin/nginx","-g","daemon off;"] 在上面我们可以看到 Dockerfile 中的一些指令,通过名称我们也可以猜到这些指令大概是干嘛的,其中有一些对文件的操作,因此我们先来看看用于存放 Dockerfile 的这个目录的目录结构: # tree . . ├── Dockerfile ├── index_files │ ├── 145049z4og8xyjhx4xy8go.jpg │ ├── 222746e5vh38d7ey3leyps.jpg │ ├── 88x31.png │ ├── archlinux-splash.png │ ├── bdshare.css │ ├── Best-Linux-Markdown-Editors.png │ ├── core.js │ ├── docker-icon.jpg │ ├── hadoop-pic1.png │ ├── jquery_002.js │ ├── jquery.css │ ├── jquery.js │ ├── MathJax.js │ ├── pic.gif │ ├── raspberrypiraspberry-pi-logo.jpg │ ├── script.js │ ├── scrollup.png │ ├── share.js │ ├── style.css │ └── z_stat.js ├── index.html ├── nginx.conf └── nginx.repo 1 directory, 24 files 构建镜像 在当前目录下执行以下命令构建镜像: # docker build -t locez/nginx . Sending build context to Docker daemon 1.851 MB Step 1/10 : FROM centos ---> 196e0ce0c9fb Step 2/10 : LABEL maintainer "Locez <locez@locez.com>" ---> Using cache ---> 9bba3042bcdb Step 3/10 : ENV TEST "This is a test env" ---> Using cache ---> c0ffe95ea0c5 Step 4/10 : COPY nginx.repo /etc/yum.repos.d/nginx.repo ---> Using cache ---> bb6ee4c30d56 Step 5/10 : RUN yum update -y && yum install -y nginx ---> Using cache ---> 6d46b41099c3 Step 6/10 : COPY nginx.conf /etc/nginx/nginx.conf ---> Using cache ---> cfe908390aae Step 7/10 : COPY index.html /usr/share/nginx/html/index.html ---> Using cache ---> 21729476079d Step 8/10 : COPY index_files/ /usr/share/nginx/html/index_files/ ---> Using cache ---> 662f06ec7b46 Step 9/10 : EXPOSE 80 ---> Using cache ---> 30db5a889d0a Step 10/10 : CMD /usr/sbin/nginx -g daemon off; ---> Using cache ---> d29b9d4036d2 Successfully built d29b9d4036d2 然后用该镜像启动容器: # docker run -d -it --rm --name test-nginx -p 8080:80 locez/nginx e06fd991ca1b202e08cf1578f8046355fcbba10dd9a90e11d43282f3a1e36d29 用浏览器访问http://localhost:8080/即可看到部署的内容。 3 Dockerfile 指令解释 Dockerfile 支持FROM,RUN,CMD,LABEL,EXPOSE,ENV,ADD,COPY,ENTRYPOINT,VOLUME,USER,WORKDIR,ARG,ONBUILD,SHELL等指令,这里只选择常用的几个进行讲解,可结合上面的示例进行理解。其它的请自行查阅官方文档。 3.1 FROM FROM指令用于指定要操作的基础镜像,因为在我们构建我们自己的镜像的时候需要一个基础镜像。 语法: FROM <image> [AS <name>] FROM <image>[:<tag>] [AS <name>] 其中[AS <name>]为指定一个名称,在一个 Dockerfile 中多次使用FROM时如有需要,可用COPY --from=<name|index>语法进行复制。 3.2 RUN RUN指令用于执行命令,并且是在新的一层上执行,并把执行后的结果提交,也就是生成新的一层。基于这个问题,我们在使用RUN指令时应该尽可能的把要执行的命令一次写完,以减少最后生成的镜像的层数。语法: RUN <command> RUN ["executable", "param1", "param2"] 3.3 CMD CMD指令用于给容器启动时指定一个用于执行的命令,例如上例中的 nginx 启动命令。 语法: CMD ["executable","param1","param2"] CMD ["param1","param2"] ### 用于给 ENTRYPOINT 指令提供默认参数 CMD command param1 param2 3.4 LABEL LABEL指令用于为镜像指定标签,可用docker inspect命令查看。可用来代替被舍弃的MAINTAINER命令。语法: LABEL <key>=<value> <key>=<value> <key>=<value> ... 3.5 EXPOSE EXPOSE指令用于告诉 Docker 容器监听的特殊端口,但是此时端口还没有暴露给 host ,只有当在运行一个容器显式用参数-p或者-P的时候才会暴露端口。语法: EXPOSE <port> [<port>/<protocol>...] 3.6 ENV ENV指令用于设定环境变量。语法: ENV <key> <value> ENV <key>=<value> ... 3.7 ADD ADD指令用于复制新文件,目录,远程文件到容器中。其中<src>可以为文件,目录,URL,若为可解压文件,在复制后会解压。语法: ADD <src>... <dest> ADD ["<src>",... "<dest>"] 3.8 COPY COPY指令与ADD指令非常相似,但COPY比较直观且简单,它只支持本地的文件以及目录的复制,不像ADD指令可以远程获取文件并解压。语法: COPY <src>... <dest> COPY ["<src>",... "<dest>"] 3.9 ENTRYPOINT ENTRYPOINT指令也跟CMD指令相似,用于指定容器启动时执行的命令。当使用ENTRYPOINT指令时,可用CMD命令配合,这样在启动容器时,可以对CMD指令写入的参数进行覆盖。语法: ENTRYPOINT ["executable", "param1", "param2"] 样例: ENTRYPOINT ["top","-b"] CMD ["-c"] 上面的-c参数可以在启动时覆盖docker run -it --rm --name test top -H。 如果要覆盖ENTRYPOINT指令则用--entrypoint参数启动容器。 3.10 VOLUME VOLUME指令用于为容器创建一个挂载点,这个挂载点可以用来挂载本地文件/文件夹也可以用来挂载数据卷。其中若在启动一个新容器时没有指定挂载目录,则会自动创建一个数据卷,当容器被销毁时,数据卷如果没有被其它容器引用则会被删除。语法: VOLUME ["/data1","/data2"] 3.11 USER USER指令用于设置执行RUN,CMD,ENTRYPOINT等指令的用户以及用户组。默认为root用户。语法: USER <user>[:<group>] 3.12 WORKDIR WORKDIR指令用于设置RUN,CMD,ENTRYPOINT,COPY,ADD等指令的工作目录。语法: WORKDIR /path/to/workdir 4 总结 本文从一个具体的例子出发,讲述了如何利用 Dockerfile 构建镜像,然后解释了 Dockerfile 文件中的指令的语法,有关更多内容可访问官方文档。 5 参考资料 Dockerfile reference 原文发布时间: 2017-12-16 本文来自云栖社区合作伙伴“ Debian社区”,了解相关信息可以关注“ Debian社区”。

优秀的个人博客,低调大师

appWidget 简单入门学习笔记

1,让桌面能够添加你的appWidget 1,一个类,和2个xml //一个实现AppWidgetProvider的类 publicclassTomAppWidgetProviderextends AppWidgetProvider{} <!--放在res/xml文件夹中命名为tom_appwidget_info.xml--> <appwidget-providerxmlns:android="http://schemas.android.com/apk/res/android" android:minWidth="294dp" android:minHeight="72dp" android:updatePeriodMillis="86400000" android:initialLayout="@layout/tom_appwidget" android:configure="kg.tom.AppWidgetConfigure"></appwidget-provider> <!--android:initialLayout:初始化你的appWidget布局--> <!--放置在res/layout/tom_appwidget_provider.xml--> <?xmlversion="1.0"encoding="utf-8"?> <LinearLayoutxmlns:android="http://schemas.android.com/apk/res/android" android:layout_width="294dp" android:layout_height="72dp" android:orientation="vertical"><TextView android:id="@+id/appwidget_text" android:layout_width="wrap_content" android:layout_height="wrap_content" android:textColor="#ff000000"/><Button android:id="@+id/appwidget_button" android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="@android:string/ok"/> </LinearLayout> 在AndroidManifest.xml中声明你的appWidget <receiverandroid:name="TomAppWidgetProvider"> <intent-filter> <!--让系统能够设别到你的appWidgetProvider的动作--><actionandroid:name="android.appwidget.action.APPWIDGET_UPDATE"/> </intent-filter> <!--设置你的appWidget的布局--> <meta-dataandroid:name="android.appwidget.provider"android:resource="@xml/tom_appwidget_info"/> </receiver> 长按你的Home 界面,你就会看到你的widget已经在列表当中 但是,现在点击是会出错的,这时候我们需要设置我们的AppWidgetConfigure 在activity中增加一个Intent-filter <intent-filter> <!--让系统能够设别到你的appWidgetProvider的动作--> <actionandroid:name="android.appwidget.action.APPWIDGET_UPDATE"/> </intent-filter> publicclassAppWidgetConfigureextendsActivity{ @Override publicvoidonCreate(BundlesavedInstanceState){ super.onCreate(savedInstanceState); //设置widgetId intmAppWidgetId=AppWidgetManager.INVALID_APPWIDGET_ID; //1,将setResult设置为取消,用于取消widgethostsetResult(RESULT_CANCELED); //2,从Intent中找到widget的id Intentintent=getIntent(); Bundleextras=intent.getExtras(); if(extras!=null){ mAppWidgetId=extras.getInt(AppWidgetManager.EXTRA_APPWIDGET_ID,AppWidgetManager.INVALID_APPWIDGET_ID);} //3,如果获取不到appWidgetid我们就结束 if(mAppWidgetId==AppWidgetManager.INVALID_APPWIDGET_ID){ Log.d("app","获取失败退出!!!"); finish();} finalContextcontext=AppWidgetConfigure.this; //4,实例化你的appWidget AppWidgetManagerappWidgetManager=AppWidgetManager.getInstance(context); //5,更新widget IntentresultValue=newIntent();resultValue.putExtra(appWidgetManager.EXTRA_APPWIDGET_ID,mAppWidgetId); setResult(RESULT_OK,resultValue); finish();}} 2,然后写provider的代码 publicclassTomAppWidgetProviderextendsAppWidgetProvider{ @Override publicvoidonUpdate(Contextcontext,AppWidgetManagerappWidgetManager, int[]appWidgetIds){ //TODOAuto-generatedmethodstub super.onUpdate(context,appWidgetManager,appWidgetIds); finalintN=appWidgetIds.length; Log.d("app","onUpdate--->Ids==="+String.valueOf(N)); for(inti=0;i<N;i++){ intappWidgetId=appWidgetIds[i]; updateAppWidget(context,appWidgetManager,appWidgetId);}} staticvoidupdateAppWidget(Contextcontext,AppWidgetManagerappWidgetManager,intappWidgetId){ Log.d("app","update---->id"+appWidgetId); //1,widget中的的标题 CharSequencetext="这是我第一个widget"; //2,widget显示用布局,并设置text显示的值 RemoteViewsviews=newRemoteViews(context.getPackageName(),R.layout.tom_appwidget_provider);views.setTextViewText(R.id.appwidget_text,text); //3,通知widgetmanager更新appWidgetManager.updateAppWidget(appWidgetId,views);} @Override publicvoidonDeleted(Contextcontext,int[]appWidgetIds){ //TODOAuto-generatedmethodstubsuper.onDeleted(context,appWidgetIds); //删除的时候调用的方法 intappids=appWidgetIds.length; Log.d("app","onDelete--->"+appids);}} 然后就可以运行了: 顺便附上一张简单原理图:.. 2,小小的进阶为widget实现运行activity 只要在加上几行代码的appwidget 就能实现挑战到Activity的功能 1,新建一个HelloAppWidget的activity staticvoidupdateAppWidget(Contextcontext,AppWidgetManagerappWidgetManager,intappWidgetId){ Log.d("app","update---->id"+appWidgetId); //1,设置显示用标题 CharSequencetext="这是我第一个widget"; //1.1,增加跳转用activity相关intent Intentintent=newIntent(context,HelloAppWidget.class); PendingIntentpendingIntent=PendingIntent.getActivity(context,0,intent,0); //2,如果,没有在xml中声明RemoteViews布局,这里就必须要让其他布局基于RemoteViews RemoteViewsviews=newRemoteViews(context.getPackageName(),R.layout.tom_appwidget_provider);views.setTextViewText(R.id.appwidget_text,text); //2.1将需要跳转的intent绑定到appWidgetbutton中views.setOnClickPendingIntent(R.id.appwidget_button,pendingIntent); //3,通知widgetmanager更新appWidgetManager.updateAppWidget(appWidgetId,views);} 跳转到特定activity…ps:使用activity记得在AndroidManifest.xml中注册

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册