首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

Mina2.0快速入门

MinaTimeServer.java 复制代码 package com.vista; import java.io.IOException; import java.net.InetSocketAddress; import java.nio.charset.Charset; import org.apache.mina.core.service.IoAcceptor; import org.apache.mina.core.session.IdleStatus; import org.apache.mina.filter.codec.ProtocolCodecFilter; import org.apache.mina.filter.codec.textline.TextLineCodecFactory; import org.apache.mina.filter.logging.LoggingFilter; import org.apache.mina.transport.socket.nio.NioSocketAcceptor; public class MinaTimeServer { private static final int PORT = 6488; public static void main(String[] args) throws IOException { //监听即将到来的TCP连接 IoAcceptor acceptor = new NioSocketAcceptor(); acceptor.getFilterChain().addLast("logger", new LoggingFilter()); acceptor.getFilterChain().addLast("codec", new ProtocolCodecFilter( new TextLineCodecFactory( Charset.forName("UTF-8")))); acceptor.setHandler(new TimeServerHandler()); acceptor.getSessionConfig().setReadBufferSize(2048); acceptor.getSessionConfig().setIdleTime(IdleStatus.BOTH_IDLE, 10); acceptor.bind(new InetSocketAddress(PORT)); System.out.println("服务器启动"); } } 复制代码 TimeServerHandler.java 复制代码 package com.vista; import java.util.Date; import org.apache.mina.core.service.IoHandlerAdapter; import org.apache.mina.core.session.IdleStatus; import org.apache.mina.core.session.IoSession; public class TimeServerHandler extends IoHandlerAdapter { public void exceptionCaught(IoSession session, Throwable cause) throws Exception { cause.printStackTrace(); } public void messageReceived(IoSession session, Object message) throws Exception { String strMsg = message.toString(); if(strMsg.trim().equalsIgnoreCase("quit")) { session.close(); return; } Date date = new Date(); session.write(date.toString()); System.out.println("Message written"); } public void sessionIdle(IoSession session, IdleStatus status) throws Exception { System.out.println("IDLE"+session.getIdleCount(status)); } } 复制代码 测试: Client Output Server Output user@myhost:~> telnet 127.0.0.1 9123 Trying 127.0.0.1... Connected to 127.0.0.1. Escape character is '^]'. hello Wed Oct 17 23:23:36 EDT 2007 quit Connection closed by foreign host. user@myhost:~> MINA Time server started. Message written... 参考资料:1,MINA v2.0 Quick Start Guide 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2008/11/27/1342655.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Quartz 框架快速入门(一)

创建一个 Java 工程,引入几个 JAR 到工程中才能成功构建它们。首先,你需要 Quartz 的二进制版本,包的名字是 quartz-<version>.jar。Quartz 还需要几个第三方库;这依赖于你要用到框架的什么功能而定,Commons Digester 库可以在 <QUARTZ_HOME>/lib/core 和 <QUARTZ_HOME>/lib/optional 目录中找到。如果出现java.lang.NoClassDefFoundError: javax/transaction/UserTransaction的错误,解决办法是:引入jta.jar包,这个包在quartz-1.6.0/lib/build 下。 ·创建一个 Quartz Job 类 每一个 Quartz Job 必须有一个实现了 org.quartz.Job 接口的具体类。这个接口仅有一个要你在 Job 中实现的方法,execute(),方法 execute() 的原型如下: public void execute(JobExecutionContext context) throws JobExecutionException; 当 Quartz 调度器确定到时间要激发一个 Job 的时候,它就会生成一个 Job 实例,并调用这个实例的 execute() 方法。调度器只管调用 execute() 方法,而不关心执行的结果,除了在作业执行中出问题抛出的 org.quartz.JobExecutionException 异常。 下面是我们的第一个 Quartz job,它被设计来扫描一个目录中的文并显示文件的详细信息。 复制代码 package com.vista.quartz; import java.io.File; import java.io.FileFilter; import java.util.Date; import org.apache.commons.logging.Log; import org.apache.commons.logging.LogFactory; import org.quartz.Job; import org.quartz.JobDataMap; import org.quartz.JobDetail; import org.quartz.JobExecutionContext; import org.quartz.JobExecutionException; public class ScanDirectoryJob implements Job { static Log logger = LogFactory.getLog(ScanDirectoryJob.class);//日志记录器 public void execute(JobExecutionContext context) throws JobExecutionException { //Every job has its own job detail JobDetail jobDetail = context.getJobDetail(); // The name is defined in the job definition String jobName = jobDetail.getName();//任务名称 // Log the time the job started logger.info(jobName + " fired at " + new Date());//记录任务开始执行的时间 // The directory to scan is stored in the job map JobDataMap dataMap = jobDetail.getJobDataMap();//任务所配置的数据映射表 String dirName = dataMap.getString("SCAN_DIR");//获取要扫描的目录 // Validate the required input if (dirName == null) {//所需要的扫描目录没有提供 throw new JobExecutionException( "Directory not configured" ); } // Make sure the directory exists File dir = new File(dirName); if (!dir.exists()) {//提供的是错误目录 throw new JobExecutionException( "Invalid Dir "+ dirName); } // Use FileFilter to get only XML files FileFilter filter = new FileExtensionFileFilter(".xml"); //只统计xml文件 File[] files = dir.listFiles(filter); if (files == null || files.length <= 0) {//目录下没有xml文件 logger.info("No XML files found in " + dir); // Return since there were no files return; } // The number of XML files int size = files.length; // Iterate through the files found for (int i = 0; i < size; i++) { File file = files[i]; // Log something interesting about each file. File aFile = file.getAbsoluteFile(); long fileSize = file.length(); String msg = aFile + " - Size: " + fileSize; logger.info(msg);//记录下文件的路径和大小 } } } 复制代码 当 Quartz 调用 execute() 方法,会传递一个 org.quartz.JobExecutionContext 上下文变量,里面封装有 Quartz 的运行时环境和当前正执行的 Job。通过 JobexecutionContext,你可以访问到调度器的信息,作业和作业上的触发器的信息,还有更多更多的信息。在代码中,JobExecutionContext 被用来访问 org.quartz.JobDetail 类,JobDetail 类持有 Job 的详细信息,包括为 Job 实例指定的名称,Job 所属组,Job 是否被持久化(易失性),和许多其他感兴趣的属性。 JobDetail 又持有一个指向 org.quartz.JobDataMap 的引用。JobDataMap 中有为指定 Job 配置的自定义属性。例如,在代码中我们从 JobDataMap 中获得欲扫描的目录名,我们可以在 ScanDirectoryJob 中硬编码这个目录名,但是这样的话我们难以重用这个 Job 来扫描别的目录了。在后面你将会看到目录是如何配置到 JobDataMap 的。 execute() 方法中剩下的就是标准 Java 代码了:获得目录名并创建一个 java.io.File 对象。它还对目录名作为简单的校验,确保是一个有效且存在的目录。接着调用 File 对象的 listFiles() 方法得到目录下的文件。还创建了一个 java.io.FileFilter 对象作为参数传递给 listFiles() 方法。org.quartzbook.cavaness.FileExtensionFileFilter 实现了 java.io.FileFilter 接口,它的作用是过滤掉目录仅返回 XML 文件。默认情况下,listFiles() 方法是返回目录中所有内容,不管是文件还是子目录,所以我们必须过滤一下,因为我们只对 XML 文件感兴趣。 FileExtensionFileFilter 被用来屏蔽名称中不含字符串 “.xml” 的文件。它还屏蔽了子目录--这些子目录原本会让 listFiles() 方法正常返回。过滤器提供了一种很便利的方式选择性的向你的 Quartz 作业提供它能接受的作为输入的文件 复制代码 package com.vista.quartz; import java.io.File; import java.io.FileFilter; public class FileExtensionFileFilter implements FileFilter { private String extension;//文件后缀 public FileExtensionFileFilter(String extension) { this.extension = extension; } public boolean accept(File file) {//只接受指定后缀的文件 // Lowercase the filename for easier comparison String lCaseFilename = file.getName().toLowerCase();//小写化 return (file.isFile() &&(lCaseFilename.indexOf(extension) > 0 )) ? true : false ; } } 复制代码 到目前为止,我们已经创建了一个 Quartz job,但还没有决定怎么处置它--明显地,我们需以某种方式为这个 Job 设置一个运行时间表。时间表可以是一次性的事件,或者我们可能会安装它在除周日之外的每个午夜执行。你即刻将会看到,Quartz Schduler 是框架的心脏与灵魂。所有的 Job 都通过 Schduler 注册;必要时,Scheduler 也会创建 Job 类的实例,并执行实例的 execute() 方法。 ·编程式安排一个 Quartz Job 所有的要 Quartz 来执行的作业必须通过调度器来注册。大多情况下,这会在调度器启动前做好。正如前面说过,这一操作也提供了声明式与编程式两种实现途径的选择。 因为每一个 Job 都必须用 Scheduler 来注册,所以先定义一个 JobDetail,并关联到这个 Scheduler 实例。 下面的程序提供了一个理解如何编程式安排一个 Job 很好的例子。代码首先调用 createScheduler() 方法从 Scheduler 工厂获取一个 Scheduler 的实例。得到 Scheduler 实例之后,把它传递给 schedulerJob() 方法,由它把 Job 同 Scheduler 进行关联。 首先,创建了我们想要运行的 Job 的 JobDetail 对象。JobDetail 构造器的参数中包含指派给 Job 的名称,逻辑组名,和实现 org.quartz.Job 接口的全限类名称。我们可以使用 JobDetail 的别的构造器。 在前面有说过,JobDetail 扮演着某一 Job 定义的角色。它带有 Job 实例的属性,能在运行时被所关联的 Job 访问到。其中在使用 JobDetail 时,的一个最重要的东西就是 JobDataMap,它被用来存放 Job 实例的状态和参数。在代码中,待扫描的目录名称就是通过 scheduleJob() 方法存入到 JobDataMap 中的。 Job 只是一个部分而已。注意我们没有在 JobDetail 对象中为 Job 设定执行日期和次数。这是 Quartz Trigger 该做的事。顾名思义,Trigger 的责任就是触发一个 Job 去执行。当用 Scheduler 注册一个 Job 的时候要创建一个 Trigger 与这个 Job 相关联。Quartz 提供了四种类型的 Trigger,但其中两种是最为常用的,它们就是在下面要用到的 SimpleTrigger 和 CronTrigger. SimpleTrigger 是两个之中简单的那个,它主要用来激发单事件的 Job,Trigger 在指定时间激发,并重复 n 次--两次激发时间之间的延时为 m,然后结束作业。CronTrigger 非常复杂且强大。它是基于通用的公历,当需要用一种较复杂的时间表去执行一个 Job 时用到。例如,四月至九月的每个星期一、星期三、或星期五的午夜。 为更简单的使用 Trigger,Quartz 包含了一个工具类,叫做 org.quartz.TriggerUtils. TriggerUtils 提供了许多便捷的方法简化了构造和配置 trigger. 本文的例子中有用的就是 TriggerUtils 类;SimpleTrigger 和 CronTrigger 会在后面用到。 正如你看到的那样,调用了 TriggerUtils 的方法 makeSecondlyTrigger() 来创建一个每10秒种激发一次的 trigger(实际是由 TriggerUtils 生成了一个 SimpleTrigger 实例,但是我们的代码并不想知道这些)。我们同样要给这个 trigger 实例一个名称并告诉它何时激发相应的 Job;与之关联的 Job 会立即启动,因为由方法 setStartTime() 设定的是当前时间 复制代码 package com.vista.quartz; import java.util.Date; import org.apache.commons.logging.Log; import org.apache.commons.logging.LogFactory; import org.quartz.JobDetail; import org.quartz.Scheduler; import org.quartz.SchedulerException; import org.quartz.Trigger; import org.quartz.TriggerUtils; import org.quartz.impl.StdSchedulerFactory; public class SimpleScheduler { static Log logger = LogFactory.getLog(SimpleScheduler.class); public static void main(String[] args) { SimpleScheduler simple = new SimpleScheduler(); try { // Create a Scheduler and schedule the Job Scheduler scheduler = simple.createScheduler(); simple.scheduleJob(scheduler); // Start the Scheduler running scheduler.start(); logger.info( "Scheduler started at " + new Date()); } catch (SchedulerException ex) { logger.error(ex); } } public Scheduler createScheduler() throws SchedulerException {//创建调度器 return StdSchedulerFactory.getDefaultScheduler(); } //Create and Schedule a ScanDirectoryJob with the Scheduler private void scheduleJob(Scheduler scheduler) throws SchedulerException { // Create a JobDetail for the Job JobDetail jobDetail = new JobDetail("ScanDirectory",Scheduler.DEFAULT_GROUP,ScanDirectoryJob.class); // Configure the directory to scan jobDetail.getJobDataMap().put("SCAN_DIR","D:\\Tomcat\\conf"); //set the JobDataMap that is associated with the Job. // Create a trigger that fires every 10 seconds, forever Trigger trigger = TriggerUtils.makeSecondlyTrigger(10);//每10秒触发一次 trigger.setName("scanTrigger"); // Start the trigger firing from now trigger.setStartTime(new Date());//设置第一次触发时间 // Associate the trigger with the job in the scheduler scheduler.scheduleJob(jobDetail, trigger); } } 复制代码 假如你有不只一个个 Job (你也许就是),你将需要为每一个 Job 创建各自的 JobDetail。每一个 JobDetail 必须通过 scheduleJob() 方法一一注册到 Scheduler 上。而如果你想重用了一个 Job 类,让它产生多个实例运行,那么你需要为每个实例都创建一个 JobDetail。例如,假如你想重用 ScanDirectoryJob 让它检查两个不同的目录,你需要创建并注册两个 JobDetail 实例 复制代码 package com.vista.quartz; import java.util.Date; import org.apache.commons.logging.Log; import org.apache.commons.logging.LogFactory; import org.quartz.JobDetail; import org.quartz.Scheduler; import org.quartz.SchedulerException; import org.quartz.Trigger; import org.quartz.TriggerUtils; import org.quartz.impl.StdSchedulerFactory; public class SimpleScheduler { static Log logger = LogFactory.getLog(SimpleScheduler.class); public static void main(String[] args) { SimpleScheduler simple = new SimpleScheduler(); try { // Create a Scheduler and schedule the Job Scheduler scheduler = simple.createScheduler(); // Jobs can be scheduled after Scheduler is running scheduler.start(); logger.info("Scheduler started at " + new Date()); // Schedule the first Job simple.scheduleJob(scheduler, "ScanDirectory1",ScanDirectoryJob.class,"D:\\conf1", 10); // Schedule the second Job simple.scheduleJob(scheduler, "ScanDirectory2",ScanDirectoryJob.class,"D:\\conf2 ", 15); } catch (SchedulerException ex) { logger.error(ex); } } public Scheduler createScheduler() throws SchedulerException {//创建调度器 return StdSchedulerFactory.getDefaultScheduler(); } private void scheduleJob(Scheduler scheduler, String jobName,Class jobClass, String scanDir, int scanInterval) throws SchedulerException { // Create a JobDetail for the Job JobDetail jobDetail = new JobDetail(jobName,Scheduler.DEFAULT_GROUP, jobClass); // Configure the directory to scan jobDetail.getJobDataMap().put("SCAN_DIR", scanDir); // Trigger that repeats every "scanInterval" secs forever Trigger trigger = TriggerUtils.makeSecondlyTrigger(scanInterval); trigger.setName(jobName + "-Trigger"); // Start the trigger firing from now trigger.setStartTime(new Date()); // Associate the trigger with the job in the scheduler scheduler.scheduleJob(jobDetail, trigger); } } 复制代码 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2008/09/03/1282747.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Django学习笔记----快速入门

上一篇>Django学习笔记----环境搭建基于Windows 基于以下环境: Windows 10 Python 3.6 Django 1.18 开始第一个Django项目 进入Cmder, 进入想创建工程的文件夹, 键入django-admin startproject 项目名 注意不能选择test这样的项目名称, 会于Python已有的模块名称冲突 Begin! 生成成功后, 可以看到如下项目结构 mysite/ manage.py mysite/ __init__.py settings.py urls.py wsgi.py manage.py: 一个实用的命令行工具,可让你以各种方式与该 Django 项目进行交互。 mysite/_init_.py: 一个空文件,告诉 Python 该目录是一个 Python 包。 mysite/settings.py: 该 Django 项目的设置/配置。 mysite/urls.py: 该 Django 项目的 URL 声明; 一份由 Django 驱动的网站"目录"。 mysite/wsgi.py: 一个 WSGI 兼容的 Web 服务器的入口,以便运行你的项目。 建立第一个App 在cmder中键入 django-admin startapp testApp 在settings.py中的INSTALLED_APPS中键入App名称,如此处的testApp # 示例代码 INSTALLED_APPS = [ 'django.contrib.admin', 'django.contrib.auth', 'django.contrib.contenttypes', 'django.contrib.sessions', 'django.contrib.messages', 'django.contrib.staticfiles', # 键入你的App 'testApp', ] 建立视图与路由的映射 views.py中的函数对应url.py中的urlpatterns(url格式) views.py # 首个参数需要是request def hello(request): return HttpResponse("Hello World") urls.py “urlpatterns”列表将URL路由映射到视图。 指向路径(第一个参数)都由此视图代理 ^头部匹配, $尾部匹配 程序从项目的settings.py中找到ROOT_URLCONF定义的urls.py的路径,在此路径中查找对应的url pattern, 进入相应的视图函数中, 通过HttpResponse返回响应的对象经处理后显示在网页上 urlpatterns = [ url(r'^hello/$', views.hello, name='hello'), ] urlpatterns中可以使用正则表达式进行匹配. 配置完毕后在Cmder中键入python manage.py runserver启动Django 需要注意的是处于开发者状态时, Django显示的是对应的错误信息 正式发布时需要将settings.py的DEBUG=True改为False

优秀的个人博客,低调大师

阅读笔记-Hadoop入门实践

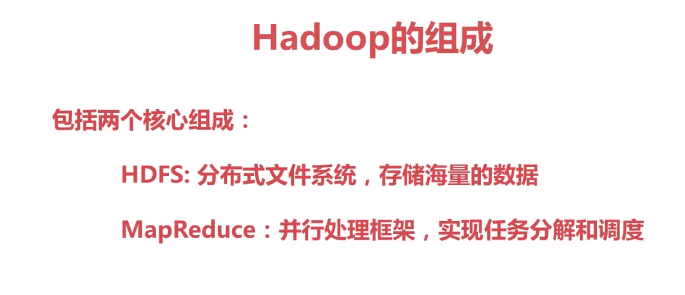
ASF:阿里软件开发平台服务框架SIP:服务集成平台BEA:应用基础结构软件公司分布式计算的应用场景:日志分析、索引建立Threshold:是一款IOS平台的应用。随时随地帮您监控行动数据使用奘况 无论是使用无限数据方案或是有限数据方案, Threshold 可以帮助您随时掌握最新数据使用状态, 提供客制化警示设定, 还可以设立一个您专属的行动数据区域, 以确保您不会被额外收费。 对于日志内容使用任务分解的多线程处理模式来分析统计,在比较简单的情况下,使用Memcache作为计数器,结合MySQL就能完成访问控制以及统计的工作,随着日志量的增加,未来可能不能满足要求。早期的多线程多任务分解日志模式,其实是分布式计算的一个单机版。将单机的工作进行分拆,变成协同工作的集群,其实就是分布式计算框架设计所涉及的。BEA和VMWare合作采用虚拟机来构建集群,就是希望使得计算机硬件能够类似于应用程序中资源池的资源,使用者无需关心资源分配情况,从而最大化了硬件资源的使用价值。分布式计算亦是如此,任务的分配和汇总都由分布式框架的Master来抉择,使用者需要提供待分析内容给分布式计算系统作为输入,等待结果。Hadoop是Apache开源组织的一个分布式计算开源框架,在很多大型网站上都已经得到了应用,比如亚马逊、Facebook和Yahoo等等。平台日志分析位常用,特别是集成平台的日志量会很大,非常适合分布式计算的适用场景。wwh学习:what? why? how? what:Hadoop框架中最核心的设计:MapReduce和HDFS。MapReduce:任务的分解与结果的汇总。HDFS:是Hadoop分布式文件系统(Hadoop Distributed File System)的缩写,为分布式计算存储提供了底层支持。MapReduce:Map&&Reduce,此处Map不适Map容器,作“展开”来讲,就是将一个任务分解为多个任务,Reduce就是将分解后多任务处理的结果汇总起来,得出最后的分析结果。类似于多线程,多任务。任务之间的关系可以分为两种:不相关的任务,可并行执行;人物之间有相互依赖,先后顺序不能够颠倒,这类任务是无法并行处理的。一般情况下,在Map前还可能会对输入的数据有Split(分割)的过程,保证任务并行效率,在Map之后,还会有Shuffer(混合)的过程,对于提高Reduce的效率以及减少数据传输的压力有很大的帮助。 HDFS:是分布式计算的存储基石。Hadoop的分布式文件系统和其他分布式文件系统有很多的类似的特质。分布式文件系统基本的几个特点。1、对于整个集群有单一的命名空间。2、数据一致性。适合一次写入多次读取的模型,客户端在文件没有被成功创建之前无法看到文件存在。3、文件会被分割成多个文件块,每个文件块被分配存储到数据节点上,而且根据配置会由赋值文件块来保证数据的安全性。 HDFS三个重要角色:NameNode、DataNode和Client。NameNode:可以看作是分布式文件系统中的管理者,主要负责管理文件系统的命名空间、集群配置信息和存储块的赋值等。NameNode会将文件系统的Meta-data存储在内存中,这些信息主要包括了文件信息、每一个文件对应的文件块的信息和每一个文件块在DataNode的信息等。DataNode:文件存储的基本单元,它将Block存储在本地文件系统中,保存了Block的Meta-data,同时周期性地将所有存在的Block信息发送给NameNode。Client:需要获取分布式文件系统文件的应用程序。三者关系样例说明:文件写入:1、Client向NameNode发起文件写入的请求。2、NameNode根据文件大小和文件块配置情况,返回给Client它所管理部分DataNode的信息。3、Client将文件划分为多个Block,根据DataNode的地址信息,按顺序写入到每一个DataNode块中。文件读取:1、Client向NameNode发起文件读取的请求。2、NameNode返回文件存储的DataNode的信息。3、Client读取文件信息。文件Bock复制:1、NameNode发现部分文件的Block不符合最小复制数或者部分DataNode失效。2、通知DataNode相互复制Block。3、DataNode开始直接相互复制。 HDFS的几个设计特点:1、Block的放置:默认不配置。一个Block会有三个备份,一份放在NameNode指定的DataNode,另一份放在与指定DataNode非同一个Rack上的DataNode,最后一份放在与指定DataNode同一Rack上的DataNode上。备份无非就是为了数据安全,考虑同一Rack的失败情况以及不同Rack之间数据拷贝性能问题就采用这种配置方式。2、心跳检测DataNode的健康状况,如果发现问题就采取数据备份的方式来保证数据的安全性。3、数据复制(场景为DataNode失败,需要平衡DataNode的存储利用率和需要平衡DataNode数据交互压力等情况):简述,使用HDFS的balancer命令,可以配置一个Threshold来平衡每一个DataNode磁盘利用率。例如设置了Threshold为10%,那么执行balancer命令的时候,首先统计所有DataNode的磁盘利用率平均值,然后判断如果某一个DataNode的磁盘利用率超过这个平均值Threshold以上,那么将会把这个DataNode的block转移到磁盘利用率低的DataNode,这对于新节点的加入来说十分有用。4、数据校验:采用CRC32作数据校验。在文件Block写入的时候除了写入数据还会写入校验信息,在读取的时候需要校验后在读入。5、NameNode是单点:如果失败的话,任务处理信息将会记录在本地文件系统和远端的文件系统中。6、数据管道性的写入:当客户端要写入文件到DataNode上,首先客户端读取一个Block然后写入到第一个DataNode上,然后由第一个DataNode传递到备份的DataNode上,一直到所有需要写入这个Block的DataNode都成功写入,客户端才会继续开始写下一个Block。7、安全模式:在分布式文件系统启动的时候,开始的时候会有安全模式,当分布式文件系统处于安全模式的情况下,文件系统中的内容不允许修改也不允许删除,直到安全模式结束。安全模式主要是为了系统启动的时候检查各个DataNode上数据块的有效性,同时根据策略必要的复制或删除部分数据块。运行期通过命令也可以进入安全模式。生产中,系统启动时修改和删除文件也会有安全模式不允许修改的出错提示,需要等待。 MapReduce&&HDFS来看Hadoop结构:在Hadoop的系统中,会有一台Master,主要负责NameNode的工作以及JobTracker的工作。JobTracker的主要职责就是启动、跟踪和调度各个Slave的任务执行。还会有多台Slave,每一台Slave通常具有DataNode的功能并负责TaskTracker的工作。TaskTracker根据应用要求来结合本地数据执行Map任务以及Reduce任务。Moving Computation is Cheaper than Moving Data:分布式计算最重要的一个设计点。就是在分布式处理中,移动数据的代价总是高于转移计算机的代价。简单来说就是分而治之的工作,需要将数据也分而存储,本地任务处理本地数据然会归总,这样才会保证分布式计算的高效性。 why:Hadoop的有点&适用场景:1、可扩展:不论是存储的可扩展性还是计算的可扩展性都是Hadoop的设计根本。2、经济:框架可以运行在任何普通的PC上。3、可靠:分布式文件系统的备份恢复机制以及MapReduce的任务监控保证了分布式处理的可靠性。4、高效:分布式文件系统的高效数据交互实现以及MapReduce结合Local Data处理的模式,为高效处理海量的信息作了基础准备。使用场景:海量数据的分析。海量数据被分割于多个节点,然后每一个节点并行计算,将得出的结果归并到输出。同时第一阶段的输出又可以作为下一阶段计算的输入,因此可以想象到一个树状结构的分布式计算图,在不同阶段都由不同产品,同时并行和串行结合的计算也可以很好地在分布式集群的资源下得以高效的处理。 Hadoop可以单机跑,也可以配置集群跑;集群配置运行的过程:环境:机器在多而不在精,JDK必须时1.5以上的,各个机器的机器名务必不同,机器名对于MapReduce有很大的影响。部署:对于Hadoop的集群来说,可以分成两大类角色:Master和Slave,前者主要配置NameNode和JobTracker的角色,负责总管分布式数据存储以及任务的执行。一般情况下,Master和Slave不会部署在同一台机器上。 实施步骤:1、在所有的机器上都建立相同的目录,也就可以建立相同的用户,以该用户的home路径来做Hadoop的安装路径。例如在所有机器上都建立了/home/Hado2、下载Hadoop,先解压到Master上。此时Hadoop的安装路径就是/home/Hado/版本。3、解压后进入conf目录,主要修改以下文件:Hadoop-env.sh, Hadoop-site.xml, masters, slavers。Hadoop的基础配置文件时Hadoop-default.xml,看Hadoop的代码可以知道,默认建立一个Job的时候会建立Job的Config,Config首先读入Hadoop-defaulg.xml的配置,然后再读入Hadoop-site.xml的配置(这个文件初始的时候配置为空),hadoop-site.xml中主要配置你需要覆盖的Hadoop-default.xml的系统级配置,以及你需要再你的MapReduce过程中使用的自定义配置(具体一些的使用例如final等参考文档)。以下是一个简单的hadoop-site.xml的配置:<?xml version="1.0"?><?xml-stylesheet type="text/xsl" href="configuration.xsl"?> fs.default.name dfs://10.2.224.46:54310/mapred.job.tracker hdfs://10.2.224.46:54311dfs.replication 1Hadoop.tmp.dir /home/Hado/Hadoop/tmp/mapred.child.java.opts -Xmx512mdfs.block.size 5120000The default block size for new files.Hadoop-env.sh文件只需要修改一个参数: The java implementation to use.Required. export JAVA_HOME=/usr/ali/jdk1.5.0_10(jdk版本)配置你的Java路径,记住一定要1.5版本以上,免得莫名其妙出现问题Masters中配置Masters的ip或者机器名,如果是机器名那么需要在/etc/hosts中有所设置。Slaves中配置的是Slaves的ip或者机器名,同样如果是机器名需要在etc/hosts中有所设置。范例如下:Masters: 10.2.224.46Slaves: 10.2.224.40 10.2.224.39 10.2.224.38 10.2.224.37 10.2.224.36 ...4、建立Masters到每一台Slave的SSH受信证书。由于Master将会通过SSH启动所有Slave的Hadoop,所以需要建立单向或者双向证书保证命令执行时不需要再输入密码。在Master和所有的Slave机器上执行:ssh-keygen -t rsa。执行此命令的时候,看到提示只需要回车。然后就会在/root/.ssh/下面产生id_rsa.pub的证书文件,通过scp将Master机器上的这个文件拷贝到Slave上(记得修改名称),例如:scp root@masterIP:/root/.ssh/id_rsa.pub /root/.ssh/46_rsa.pub,然后执行cat /root/.ssh/46_rsa.pub >>/root/.ssh/authorized_keys,建立authorized_keys文件即可,可以打开这个文件看看,也就是rsa的公钥作为key,user@IP作为value。此时可以试验一下,从master ssh到slave已经不需要密码了。由slave反向建立也是同样。为什么要反向呢?其实如果一直都是Master启动和关闭的话那就没有必要建立反向,只是如果想在Slave也可以关闭Hadoop就需要建立反向。5、将Master上的Hadoop通过scp拷贝到每一个Slave相同的目录下,根据每一个Slave的Java_HOME的不同修改器Hadoop-env.sh.6、修改Master上/etc/profile;新增一下内容:(具体的内容根据你的安装路径修改,这步只是为了方便使用)export HADOOP_HOME=/home/Hado/Hadoop_.. export PATH=$PATH:$HADOOP_HOME/bin修改完之后,执行source /etc/profile来使其生效。7、在Master上执行Hadoop namenode -format,这是第一需要做的初始化,可以看作格式化,以后除了上面提及的删除Master上的hadoop.tmp.dir目录,否则是不需要再次执行的。8、然后执行Master上的start-all.sh,这个命令可以直接执行,因为在6中已经添加到了path路径,这个命令是启动hdfs和mapreduce两部分,当然你也可以分开单独启动hdfs和mapreduce,分别是bin目录下的start-dfs.sh和start-mapred.sh.9、检查Master的logs目录,看看Namenode日志以及JobTracker日志是否正常启动。10、检查Slave的logs目录看看Datanode日志以及TaskTracker日志是否正常。11、如果需要关闭,那么就直接执行stop-all.sh即可。 感谢:岑文初!!!

优秀的个人博客,低调大师

神经网络入门实例

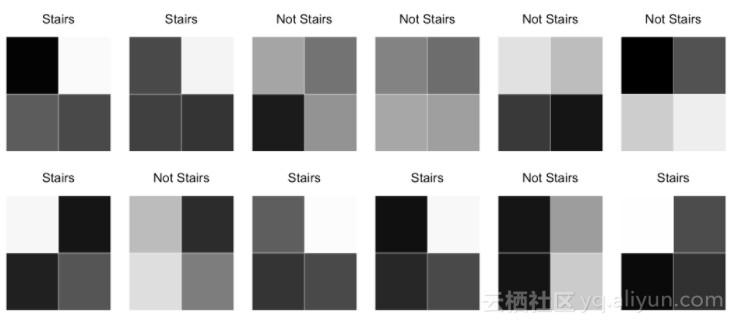
这里有一个灰度图像的集合,每个图像都是一个2x2的像素网格,每个像素在0(白色)和255(黑色)之间有一个强度值。我们的目标是建立一个模型,利用“阶梯”模式识别图像。 在这篇文章,我们只关心是否能够合理地匹配数据的模型。 预处理 对于每个图像,我们将像素用x1、x2、x3、x4标记,并生成一个输入向量\mathbf{x} \mathbf{x} = \begin{bmatrix}x_1 & x_2 & x_3 & x_4\end{bmatrix} 这将是我们的模型的输入。我们期望我们的模型能够预测真(图像有阶梯模式)或假(图像没有阶梯模式)。 图像ID x1 x2 x3 x4 具有阶梯模式 1 252 4 155 175 真 2 175 10 186 200 真 3 82 131 230 100 假 … … … … … … 498 36 187 43 249 假 499 1 160 169 242 真

优秀的个人博客,低调大师

Android入门:MVC模式(中)

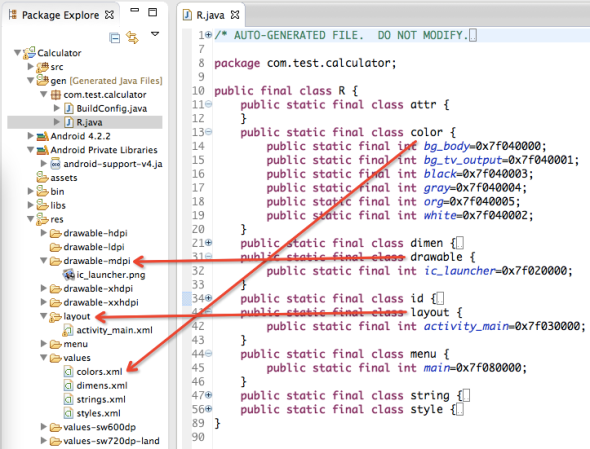
MVC 模式的最基本概念是分层设计,把我们的代码基于 View(视图)、Model(模型)、Controller(控制器)进行分类封装,这样做的目的是为了清晰结构,使代码更易维护和扩展。 在上一篇文章中,我们完成了计算器的界面还原,但严格来说并不是真正的 View 类,因为它还没反映视图的逻辑。在这次文章中,我们将编写计算器程序的 View 部分,Let’s Go!(注意:这次在代码的注释中写了较多的点,所以可以多看注释部分) 一,初识 Activity Activity(活动)作为 Android 四大组件之一,相当于应用中的整个界面,用前端的角度看,就像一个 web 页。而 Activity 的实质是什么呢?这次先简要描述,从 Google 大神中可知,Activity 起始继承于 Context 类,来看看它们的描述关键词: android.content.Context Interface to global information about an application environment … It allows access to application-specific resources and classes, as well as up-calls for application-level operation … 原来 Context 被定义为关于应用场景(上下文)的抽象类,具有访问应用层面资源和类的权限,并封装了一些应用级别的方法。 android.app.Activity An activity is a single, focused thing that the user can do … interact with the user … takes care of creating a window (full-screen windows or floating windows) for place UI … Activity 被定义为与用户交互(事件),负责创建加载视图的窗口等功能的功能类。可以说因 Context,使 Activity 具有强大的功能。 在开始编写前,先介绍一个重要的 Java 文件 - R.java,在前面介绍过,gen 目录会自动生成一些系统需要的文件,打开 R.java: R 类通过 attr,color,drawable,id,layout 等静态内部类,记录了所有标识。(注意:R类的标识会自动生成,不用去修改) 二,在 onCreate 中编写我们的程序 Activity 有个明显的特点,就是有生命周期。可以想象一下平时应用的使用过程,从一个界面滑入至另一界面,又从当前界面返回,伴随的就是 Activity 周期的不同阶段。打开 Calculator 项目的 MainActivity.java 文件: 在前端编程中,最重要的是获取操作对象(dom)。在 Android 中也如此,主要通过 id 标识获取操作对象。我们首先给activity_main.xml 中的 TextView 和 Button 加上以下 id 标识:(@+id/{name} 的意思是在 R 类中增加为 {name} 的 id 标识) TextView:@+id/ResultOutput Button 数字 0 ~ 9:@+id/Operand0 ~ @+id/Operand9 Button 除号:@+id/Operate0 Button 乘号:@+id/Operate1 Button 减号:@+id/Operate2 Button 加号:@+id/Operate3 Button 等号:@+id/Operate4 Button 清除:@+id/Operate5 如图所示,请务必为元素加上正确的 id。 在 Android 中,主要通过 findViewById() 方法获取操作对象,如TextView的获取: 在前端编程中,我们可以通过 getElementsByTagName() 方法获取一系列操作元素,但在 Android 中却没那么幸运了,没有这种方法。那有什么快捷点的方式不?答案是肯定的。我们知道 findViewById() 传入的是一个 int 类型的引用值,那么可否通过循环的方式找出这些引用值,然后直接获取呢?我们把 Button 元素分为两组,操作数的 id 以 Operand0 ~ 9 命名。而其余为运算符,则以 Operate0 ~ 5 命名(如上面提示的)。这样我们则可以: 这样,通过一个 TextView 和两个数组,我们就把需要的操作元素全部收集好了。 三,分离及定义 View 类的接口 从上面的代码看,一切似乎都很美好,但这种面向过程的思考方式是导致代码迅速膨胀,难以维护的原因之一。按 MVC 的设计思想,上面编写的代码应属于视图部分的逻辑,更好的办法应该封装在视图内,实现细节不被其它类所知。我们现在遵循这一思想从新组织一下代码:(注意:这里只朴素地用 MVC 思想表达意图,至于划分及编写的合理性就不探究了) 计算器将由两个 View 类组成,一个是用于显示结果的 CaOutputView 类,一个是用于用户输入的 CaInputView 类。首先建立存放 View 类的包,通过包区分不同类型文件。 然后我们建立这两个 View 类: 接着,我们打开 CaInputView.java 文件。好了,现在我们来思考一个问题,CaInputView 负责与用户的交互,自然会知道用户按了什么按钮,但怎样通知 Activity 用户的行为呢? 这个就是我们准备要接触的回调机制的概念。 就好比,CaInputView 对 Activity 说:你把“联系方式”留我,用户输入了我就通知你。而“联系方式”有多种实现的方式。这次就通过委托的方式实现,相当于 iOS 中的代理(delegate)的概念: 四,编写 View 类 现在我们继续编写 CaInputView类,把原先 Activity 类的代码逻辑归入 CaInputView 类: 继续编写CaOutputView 类,CaOutputView 类比较简单,只用于显示: 五,在 Activity 中使用 View 类 两个 View 已经创建完毕,现在可以尝试在 Activity 中使用了: 上图提示错误,是因为实例化了 CaInputView,却没有实现接口,所以提示 MainActivity 应该实现 CaInputView 声明的接口: 实现 CaInputView 声明的接口后仍然会报错,因为没实现接口声明的方法,选择“Add unimplemented methods”则自动添加了方法,如下图: 最后当 CaInputView 与用户发生交互时,我们“通知” Activity,而 Activity 则调用 CaOutputView 将结果显示出来,MainActivity 类的最终代码如下图: 运行程序,点击每个按钮,看是否显示正确的值: 通过分层设计,MainActivity 中的代码变得简洁很多,它只需知道如何使用 View 类则可,使它可以专注于自己的责任部分。 六,总结 这次说了的点比较多,主要有: MVC 的设计概念 两种方式获取操作对象 Java 的类型及转型相关概念 回调机制及接口 如何使用 View 类 如果对这些点还不清晰,可以再细看注释部分,或者留言给我,我会尽快答复。另外我也会尽量加快更新进度,下周将利用递归函数编写我们的 Model 类,敬请期待。 本文转自 一点点征服 博客园博客,原文链接:http://www.cnblogs.com/ldq2016/p/6693717.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

git入门(6.repo)

repo是一种代码版本管理工具,它是由一系列的Python脚本组成,封装了一系列的Git命令,用来统一管理多个Git仓库。 因为Android源码引用了很多开源项目,每一个子项目都是一个Git仓库,每个Git仓库都有很多分支版本,为了方便统一管理各个子项目的Git仓库,需要一个上层工具批量进行处理,因此repo诞生。 repo也会建立一个Git仓库,用来记录当前Android版本下各个子项目的Git仓库分别处于哪一个分支,这个仓库通常叫做:manifest仓库。 repo start <topic_name> 开启一个新的主题,其实就是每个Project都新建一个分支。 repo init -u <url> [OPTIONS] 在当前目录下初始化repo,会在当前目录生生成一个.repo目录,像Git Project下的.git一样,-u指定url,可以加参数-m指定manifest文件,默认是default.xml,.repo/manifests保存manifest文件。.repo/projects下有所有的project的数据信息,repo是一系列git project的集合,每个git project下的.git目录中的refs等目录都是链接到.repo/manifests下的。 repo manifest 可以根据当前各Project的版本信息生成一个manifest文件 repo sync [PROJECT1...PROJECTN] 同步Code。 repo status 查看本地所有Project的修改,在每个修改的文件前有两个字符,第一个字符表示暂存区的状态。 每二个字符表示工作区的状态 repo prune <topic> 删除已经merge的分支 repo abandon <topic> 删除分支,无论是否merged repo branch或repo branches 查看所有分支 repo diff 查看修改 repo upload 上传本地提交至服务器 repo forall[PROJECT_LIST]-c COMMAND 对指定的Project列表或所有Project执行命令COMMAND,加上-p参数可打印出Project的路径。 repo forall -c 'git reset --hard HEAD;git clean -df;git rebase --abort' 这个命令可以撤销整个工程的本地修改。 本文转自Tenderrain 51CTO博客,原文链接:http://blog.51cto.com/tenderrain/1881971,如需转载请自行联系原作者

优秀的个人博客,低调大师

android107 指针入门

#include <stdio.h> #include <stdlib.h> //指针就是内存地址 //32为操作系统最大是4G内存,32为系统则是2的32次方, //所以只能表示2的32次方个内存地址, 也就是2的32次方个字节就是4G. main(){ int i;//i是内存空间的别名 ,i里面保存的是内存地址, i = 3; printf("%#x\n", &i); system("pause"); } #include <stdio.h> #include <stdlib.h> main(){ //野指针:没有赋值的指针 int* p; int i; double d = 3.14; p = &d; //不是野指针了, //*p = 23; printf("%#x\n", p);//打印地址,p里面存的是地址 printf("%lf\n", *p); system("pause"); } /*##*的三种用法 1. 乘法 2. int* p:定义一个指针变量p,p中存放一个内存地址,这个地址所存放的数据规定是int型 3. *p:取出p中保存的内存地址存放的数据 ##数据传递 * 所有语言所有平台,都只有值传递,引用传递传递的值是内存地址 */ #include <stdio.h> #include <stdlib.h> void swap(int* p, int* q){ int temp = *p; *p = *q; *q = temp; } main(){ int i = 3; int j = 5; printf("i=%d\n", i); printf("j=%d\n", j); swap(&i, &j); printf("i=%d\n", i); printf("j=%d\n", j); system("pause"); } #include <stdio.h> #include <stdlib.h> void function(int* p, int* q){ *p += 15; *q += 15; } main(){ int i = 10; int j = 20; function(&i, &j); printf("%d\n", i); printf("%d\n", j); system("pause"); } #include <stdio.h> #include <stdlib.h> void function(int** p){ int i = 3; printf("i的地址为%#x\n", &i); //p就是取出p内存空间的值 //*p:就是取出p内存空间值的内存空间的值, *p = &i;//修改P所指向的内存空间值的内存空间的值 } main(){ int* mainp;//mainp在栈中存的是地址,指向堆中的一个int数据 的内存空间 。 function(&mainp);//&mainp在栈中存的是地址的地址也就是 mainp的地址,也就是指向mainp的内存空间。 printf("主函数中获取i的地址为%#x\n", mainp); //数据幻影 printf("主函数中获取i的值为%d\n", *mainp);//-2因为i是局部变量已经销毁了 system("pause"); } 内存分析:0级指针,一级指针,二级指针都有, 二级指针是曾曾用名,一级指针是曾用名。 #include <stdio.h> #include <stdlib.h> main(){ //char arr[] = "hello"; int arr[5] = {1,2,3,4,5}; printf("%#x\n", &arr[0]);//0x22ff50 printf("%#x\n", &arr[1]); printf("%#x\n", &arr[2]); printf("%#x\n", &arr[3]); //arr = printf("数组名字的地址%#x\n", &arr);//也是输出第0个元素的地址 printf("数组名字的地址%#x\n", arr);//也是输出第0个元素的地址 //char* p = &arr; int* p = &arr; //+1表示向右偏移一个单位 printf("%d\n", *(p+0));// 1 printf("%d\n", *(p+1));//2 printf("%d\n", *(p+2));//3 printf("%d\n", (p+2)-p); //2 system("pause"); } #include <stdio.h> #include <stdlib.h> main(){ char* cp; int* ip; short* lizhip; int i; char c; cp = &c; ip = &i; //指针的长度都是4个字节 printf("%d\n", sizeof(cp));//4 printf("%d\n", sizeof(ip));//4 printf("%d\n", sizeof(lizhip));//4 printf("%d\n", (p+2)-p); //2,偏移量。 printf("%d\n", cp-ip);//出错, 连续内存空间相加减是可以的,非连续的内存空间相加减是没有意义的, system("pause"); } 本文转自农夫山泉别墅博客园博客,原文链接:http://www.cnblogs.com/yaowen/p/4979472.html,如需转载请自行联系原作者


优秀的个人博客,低调大师

深入Android 【三】 —— 组件入门

Android组件 横看成岭侧成峰,远近高低各不同。 -- 《题西林壁》 组件( Component),在谈及所谓架构和重用的时候,是一个重要的事情。很多时候都会说基于组件的软件架构,指的是期望把程序做乐高似的,有一堆接口标准封装完整的组件放在哪里,想用的时候取上几个一搭配,整个程序就构建完成了。 在 开篇的时候就在说,Android是一个为组件化而搭建的平台,它引入所谓Mash-Up的概念,这使得你在应用的最上层,想做的不组件化都是很困难的一件事情(底层逻辑,好吧,管不了...)。具体说来,Android有四大组件四喜丸子:Activity、Service、Broadcast Receiver、Content Provider。 Activity 做一个完整的Android程序,不想用到Activity,真的是比较困难的一件事情,除非是想做绿叶想疯了。因为Activity是Android程序与用户交互的窗口,在我看来,从这个层面的视角来看,Android的Activity特像网站的 页面。 首先,一个网站,如果一张页面都没有,那...,真是一颗奇葩。而一张页面往往都有个 独立的主题和功能点,比如登录页面,注册页面,管理页面,如是。 在每个页面里面,会放一些链接,已实现功能点的串联,有的链接点了,刷,跑到同一站点的另一个页面去了;有的链接点了,啾,可能跳到其他网站的页面去;还有的链接点了,恩...,这次没跑,但当前页面的样子可能有所变化了。这些模式,和Activity给人的感觉很像,只不过实现策略不同罢了,毕竟Android这套架构的核心思想,本身就来自源于Web的Mash-Up概念,视为页面的客户端化,也未尝不可。 Activity,在四大组件中,无疑是最复杂的,这年头,一样东西和界面挂上了勾,都简化不了,想一想,独立做一个应用有多少时间沦落在了界面上,就能琢磨清楚了。从视觉效果来看,一个Activity占据当前的窗口,响应所有窗口事件,具备有控件,菜单等界面元素。从内部逻辑来看,Activity需要为了保持各个界面状态,需要做很多持久化的事情,还需要妥善管理生命周期,和一些转跳逻辑。对于开发者而言,就需要派生一个Activity的子类,然后埋头苦干上述事情。对于Activity的更多细节,先可以参见: reference/android/app/Activity.html。后续,会献上更为详尽的剖析。 Service 服务,从最直白的视角来看,就是剥离了界面的Activity,它们在很多Android的概念方面比较接近,都是封装有一个 完整的功能逻辑实现,只不过Service不抛头露脸,只是默默无声的做坚实的后盾。 但其实,换个角度来看,Android中的服务,和我们通常说的Windows服务,Web的后台服务又有一些相近,它们通常都是 后台长时间运行,接受上层指令,完成相关事务的模块。用运行模式来看,Activity是跳,从一个跳到一个,呃...,这有点像模态对话框(或者还像web页面好了...),给一个输入(抑或没有...),然后不管不顾的让它运行,离开时返回输出(同抑或没有...)。 而Service不是,它是等,等着上层连接上它,然后产生一段持久而缠绵的通信,这就像一个用了Ajax页面,看着没啥变化,偷偷摸摸的和Service不知眉来眼去多少回了。 但和一般的Service还是有所不同,Android的Service和所有四大组件一样,其 进程模型都是可以配置的,调用方和发布方都可以有权利来选择是把这个组件运行在同一个进程下,还是不同的进程下。这句话,可以拿把指甲刀刻进脑海中去,它凸显了Android的运行特征。如果一个Service,是有期望运行在于调用方不同进程的时候,就需要利用Android提供的 RPC机制,为其部署一套进程间通信的策略。 Android的RPC实现,如上图所示(好吧,也是从SDK中拿来主义的...),无甚稀奇,基于代理模式的一个实现,在调用端和服务端都去生成一个代理类,做一些序列化和反序列化的事情,使得调用端和服务器端都可以像调用一个本地接口一样使用RPC接口。 Android中用来做数据序列化的类是 Parcel,参见: /reference/android/os/Parcel.html,封装了序列化的细节,向外提供了足够对象化的访问接口,Android号称实现非常高效。 还有就是 AIDL (Android Interface Definition Language),一种接口定义的语言,服务的RPC接口,可以用AIDL来描述,这样,ADT就可以帮助你自动生成一整套的代理模式需要用到的类,都是想起来很乏力写起来很苦力的那种。更多内容,可以再看看: guide/developing/tools/aidl.html,如果有兴致,可以找些其他PRC实现的资料lou几眼。 关于Service的实现,还强推参看 API Demos这个Sample里面的 RemoteService实现。它完整的展示了实现一个Service需要做的事情:那就是定义好需要接受的Intent,提供 同步或异步的接口,在上层绑定了它后,通过这些接口(很多时候都是RPC的...)进行通信。在RPC接口中使用的数据、回调接口对象,如果不是标准的系统实现(系统可序列化的),则需要自定义aidl,所有一切,在这个Sample里都有表达,强荐。 Service从实现角度看,最特别的就是这些RPC的实现了,其他内容,都会接近于Activity的一些实现,也许不再会详述了。 Broadcast Receiver 在实际应用中,我们常需要等,等待系统抑或其他应用发出一道指令,为自己的应用擦亮明灯指明方向。而这种等待,在很多的平台上,都会需要付出不小的代价。 比如,在Symbian中,你要等待一个来电消息,显示归属地之类的,必须让自己的应用忍辱负重偷偷摸摸的开机启动,消隐图标隐藏任务项,潜伏在后台,监控着相关事件,等待转瞬即逝的出手机会。这是一件很发指的事情,不但白白耗费了系统资源,还留了个流氓软件的骂名,这真是卖力不讨好的正面典型。 在Android中,充分考虑了广泛的这类需求,于是就有了 Broadcast Receiver这样的一个组件。每个Broadcast Receiver都可以接收一种或若干种Intent作为触发事件(有不知道Intent的么,后面会知道了...),当发生这样事件的时候,系统会负责唤醒或传递消息到该Broadcast Receiver,任其处置。在此之前和这以后,Broadcast Receiver是否在运行都变得不重要了,及其绿色环保。 这个实现机制,显然是基于一种 注册方式的,Broadcast Receiver将其特征描述并注册在系统中,根据注册时机,可以分为两类,被我冠名为 冷热插拔。所谓 冷插拔,就是Broadcast Receiver的相关信息写在配置文件中(求配置文件详情?稍安,后续奉上...),系统会负责在相关事件发生的时候及时通知到该Broadcast Receiver,这种模式适合于这样的场景。 某事件方式 -> 通知Broadcast -> 启动相关处理应用。比如,监听来电、邮件、短信之类的,都隶属于这种模式。而 热插拔,顾名思义,插拔这样的事情,都是由应用自己来处理的,通常是在OnResume事件中通过 registerReceiver进行注册,在OnPause等事件中反注册,通过这种方式使其能够在运行期间保持对相关事件的关注。比如,一款优秀的词典软件(比如, 有道词典...),可能会有在运行期间关注网络状况变化的需求,使其可以在有廉价网络的时候优先使用网络查询词汇,在其他情况下,首先通过本地词库来查词,从而兼顾腰包和体验,一举两得一石二鸟一箭双雕(注,真实在有道词典中有这样的能力,但不是通过Broadcast Receiver实现的,仅以为例...)。而这样的监听,只需要在其工作状态下保持就好,不运行的时候,管你是天大的网路变化,与我何干。其模式可以归结为: 启动应用 -> 监听事件 -> 发生时进行处理。 除了接受消息的一方有多种模式,发送者也有很重要的选择权。通常,发送这有两类,一个就是系统本身,我们称之为系统Broadcast消息,在 reference/android/content/Intent.html的 Standard Broadcast Actions,可以求到相关消息的详情。除了系统,自定义的应用可以放出Broadcast消息,通过的接口可以是 Context.sendBroadcast,抑或是 Context.sendOrderedBroadcast。前者发出的称为 Normal broadcast,所有关注该消息的Receiver,都有机会获得并进行处理;后者放出的称作 Ordered broadcasts,顾名思义,接受者需要按资排辈,排在后面的只能吃前面吃剩下的,前面的心情不好私吞了,后面的只能喝西北风了。 当Broadcast Receiver接收到相关的消息,它们通常做一些简单的处理,然后转化称为一条Notification,一次振铃,一次震动,抑或是启动一个Activity进行进一步的交互和处理。所以,虽然Broadcast整个逻辑不复杂,却是足够有用和好用,它统一了Android的事件广播模型,让很多平台都相形见绌了。更多Broadcast Receiver相关内容,参见: /reference/android/content/BroadcastReceiver.html。 Content Provider Content Provider,听着就和数据相关,没错,这就是Android提供的第三方应用数据的访问方案。在Android中,对数据的保护是很严密的,除了放在SD卡中的数据,一个应用所持有的数据库、文件、等等内容,都是不允许其他直接访问的,但有时候,沟通是必要的,不仅对第三方很重要,对应用自己也很重要。 比如,一个联系人管理的应用。如果不允许第三方的应用对其联系人数据库进行增删该查,整个应用就失去了可扩展力,必将被其他应用抛弃,然后另立门户,自个玩自个的去了。 Andorid当然不会真的把每个应用都做成一座孤岛,它为所有应用都准备了一扇窗,这就是 Content Provider。应用想对外提供的数据,可以通过派生 ContentProvider类,封装成一枚Content Provider,每个Content Provider都用一个 uri作为独立的标识,形如: content://com.xxxxx。所有东西看着像REST的样子,但实际上,它比REST更为灵活。和REST类似,uri也可以有两种类型,一种是带id的,另一种是列表的,但实现者不需要按照这个模式来做,给你id的uri你也可以返回列表类型的数据,只要调用者明白,就无妨,不用苛求所谓的REST。 另外,Content Provider不和REST一样只有uri可用,还可以接受 Projection, Selection, OrderBy等参数,这样,就可以像数据库那样进行投影,选择和排序。查询到的结果,以 Cursor(参见: reference/android/database/Cursor.html)的形式进行返回,调用者可以移动Cursor来访问各列的数据。 Content Provider屏蔽了内部数据的存储细节,向外提供了上述统一的接口模型,这样的抽象层次,大大简化了上层应用的书写,也对数据的整合提供了更方便的途径。Content Provider内部,常用数据库来实现,Android提供了强大的 Sqlite支持,但很多时候,你也可以封装文件或其他混合的数据。 在Android中, ContentResolver是用来发起Content Provider的定位和访问的。不过它仅提供了同步访问的Content Provider的接口。但通常,Content Provider需要访问的可能是数据库等大数据源,效率上不足够快,会导致调用线程的拥塞。因此Android提供了一个 AsyncQueryHandler(参见: reference/android/content/AsyncQueryHandler.html),帮助进行异步访问Content Provider。 在各大组件中,Service和Content Provider都是那种需要持续访问的。Service如果是一个耗时的场景,往往会提供 异步访问的接口,而Content Provider不论效率如何,都提供的是约定的 同步访问接口。我想这遵循的就是 场景导向设计的原则,因为Content Provider仅是提供数据访问的,它不能确信具体的使用场景如何,会怎样使用它的数据;而相比之下,Service包含的逻辑更复杂更完整,可以抉择大部分时候使用某接口的场景,从而确定最贴切的接口是同步还是异步,简化了上层调用的逻辑。 配置 四大组件说完了,四大组件幕后的英雄也该出场了,那就是每个应用都会有一份的配置文件,名称是 AndroidManifest.xml,在工程的根目录下。在这个配置文件中,不仅会描述一些应用相关的信息,很重要的,会包含一个应用中所有组件的信息。如果你派生Activity或者Service实现了一个相关的类,这只是把它组件化的第一步,你需要把这个类的相关信息写到配置文件中,它才会作为一个组件被应用到,否则只能默默无闻的黯淡度过余生。 摆了一幅图出来,这次不是偷来的,是敝帚自珍原创,所以没有意外的画的很丑,但基本还是可以体现出一些意思。在 In Others的部分,这里是一般平台应用之间通信和交互的模型,每个应用都有很强烈的应用边界(往往表现为进程边界...),App 1的还是App 2的,分得很是清楚。每个应用内部,都有自己的逻辑去切分功能组件,这样的切分通常没有什么标准,率性而为。应用间的交互逻辑也比较零散,App 1与App 2交互,往往需要明确知道对方应用的具体信息,比如进程ID,进程名称之类的,这样使得应用和应用之间的联系,变得很生硬。而上层应用和系统应用的通信,往往有很多特定的模式,这种模式,很可能是无法直接应用在普通应用之间的,换而言之,系统应用是有一定特殊性的。 重点,在图的下半部,描述的是 Android的应用情形。在Android中, 应用的边界,在组件这个层面,是极度模糊,什么进程、什么应用,都可以不必感知到。举个例子,App 1,实现了A和B两个组件,App 2,实现了C这个组件。A和C,都想使用B这个组件,那么它们的使用方式是 完全一致的,都需要通过系统核心的组件识别和通信机制,找到和使用组件B。A,虽说和B是一个娘胎里蹦出来的,很不好意思,没有任何特殊的后面和捷径,还是要跑规矩的途径才能用到,一片和谐社会的景象油然而生。 在Android中, 所有组件的识别和消息传递逻辑都必须依赖底层核心来进行(通信可以没有底层核心的参与,比如一旦Service找到了,就可以和它产生持久的通信...),没有底层核心的牵线搭桥,任何两个组件都无法产生联系。比如一个Activity,跳到另一个Activity,必须要向底层核心发起一个Intent,有底层解析并认可后,会找到另一个Activity,把相关消息和数据传给它。一个Activity想使用Content Provider中的数据,必须通过底层核心解析相关的uri,定位到这个Content Provider,把参数传递给它,然后返回Activity需要的Cursor。这样的设计,保证了底层核心对所有组件的绝对掌控权和认知权,使得搭积木似的开发变成可能。 为了,使得核心系统能够完整的掌握每个组件的信息,这就需要配置文件了。配置文件,就是将组件插到底层核心上的这个 插头。只有通过这个插头插在底层核心的插座上(不要乱想,非十八禁...),组件才能够发光发热,闪耀光芒。 组件的配置信息在我看来主要包含两个方面,一部分是描述 如何认知。比如,Activity、Service、Broadcast Receiver都会有名字信息,和希望能够把握的Intent信息(姑且看成消息好了...),Content Provider会有一个描述其身份的uri。当其他组件通过这样的名字或者Intent,就可以找到它。 另一部分是 运行相关的信息。这个组件,期望怎么来运行,放在单独的进程,还是和调用者一个进程,还是找相关的其他组件挤在同一个进程里面,这些内容,都可以在配置的时候来决定(调用者在这个约束范围内,有进一步的选择权...)。更多配置项,请参见: guide/topics/manifest/manifest-intro.html。 通过前续内容,也许可以帮助大家对Android组件有个初略的了解。但这些了解都还停留在静态层面,程序是个动态的概念,关于各个组件具体是怎么联系在一起的,如何手拉手运行起来完成一项功能的,这便是后话了。 本文转自 duguguiyu 51CTO博客,原文链接:http://blog.51cto.com/duguguiyu/362223,如需转载请自行联系原作者

优秀的个人博客,低调大师

.Net Micro Framework 快速入门

一、简介 Microsoft .NET Micro Framework 2001年由微软研究院开始研发,并随后在其MSN Direct项目中使用该技术,2007年9月微软对外发布2.0,2008年10月 V3.0、2009年11月 V4.0、2010年5月 V4.1 beta,2009年并入.NET产品组,Digi、Atmel、飞思卡尔等半导体公司都先后为其推出了开发板,该技术可以应用到远程控制、智能家电、教育类机器、医疗电子、零售终端、Sideshow以及汽车电子等行业应用场景;此外由于.Net MF集成了各种接口,如串口、网口、Wifi、Zigbee、I2C、SPI、SDIO、USB等通信接口,加上其应用开发简便,所以在物联网时代,将大有作为。 <1>.Net Micro Framework 低价开发板 http://blog.csdn.net/yefanqiu/archive/2010/06/03/5645129.aspx <2>.Net Micro Framework 所有博文 http://blog.csdn.net/yefanqiu/category/633947.aspx ----------------------------- Microsoft .NET Micro Framework 将 .NET 的可靠性和效率与 Visual Studio的高生产率结合起来,以针对价格较低、资源受限的小型设备开发应用程序,可帮助人们使用熟悉的 Visual Studio 工具来构建托管的嵌入式应用程序。2009年5月,.Net Micro Framework采用Apache 2.0 license,比Linux等开源软件更为彻底的方式实现了源代码完全开放。 1.哪些领域可以采用.NET Micro Framework技术? .NET Micro Framework技术可以应用到:Sideshow、远程控制、智能家电、教育类机器、医疗电子、零售终端以及汽车电子等行业应用场景;此外由于.Net MF集成了各种接口,如串口、网口、Wifi、Zigbee、I2C、SPI、SDIO、USB等通信接口,加上其应用开发简便,所以在物联网时代,将大有作为。 2.NET Micro Framework与Window CE和Windows XP Embedded的区别? .NET Micro Framework对存储器和处理器的要求更低。开发人员可以在低功耗、低成本的ARM7、ARM9、Blackfin和Cortex-M3处理器上使用该框架(不需要MMU支持),所开发出来的软件仅需要几百Kbytes的RAM或Flash/ROM存储空间。而Windows Embedded CE的托管代码环境需要约10~12Mbytes的存储空间,基于.NET的应用编程设备只需要较少的存储空间,降低了产品成本。 3.NET Micro Framework与其他.NET平台的区别? 作为.NET家族的一员,.Net Micro Framework是微软专门针对超轻量级平台设计的软件架构。与.Net Framework和.Net Compact Framework不同的地方是,.Net Micro Framework具有自启动的特性,并且在HAL层,微软将操作系统的必要特性引入,如:启动管理、中断处理、线程调度、内存管理等。.Net Micro Framework可以单独使用,不需要依托其它操作系统,因此占用空间很小。 二、应用开发 1、.Net Micro Framework研究—Digi开发板初探http://yfsoft.blog.51cto.com/1635641/323413 2、.Net Micro Framework研究—IO读写http://yfsoft.blog.51cto.com/1635641/323412 3、.Net Micro Framework研究—串口操作http://yfsoft.blog.51cto.com/1635641/323411 4、.Net Micro Framework研究—TCP/IP通信http://yfsoft.blog.51cto.com/1635641/323409 5、.Net Micro Framework研究—模拟器改造http://yfsoft.blog.51cto.com/1635641/3234098 6、.Net Micro Framework研究—中文显示 http://yfsoft.blog.51cto.com/1635641/3234097 7、 .Net Micro Framework研究—绘图http://yfsoft.blog.51cto.com/1635641/323402 8、.Net Micro Framework研究—Shapes命名空间http://yfsoft.blog.51cto.com/1635641/323401 9、.Net Micro Framework研究—窗体控件http://yfsoft.blog.51cto.com/1635641/323400 10、.Net Micro Framework研究—应用实例http://yfsoft.blog.51cto.com/1635641/322945 11、.Net Micro Framework研究—Tinyfnt字体研究http://yfsoft.blog.51cto.com/1635641/322943 12、.Net Micro Framework研究—带IO的模拟器http://yfsoft.blog.51cto.com/1635641/322942 13、 .Net Micro Framework研究—带AD的模拟器http://yfsoft.blog.51cto.com/1635641/322939 14、 .Net Micro Framework研究—带I2C总线的模拟器http://yfsoft.blog.51cto.com/1635641/322937 15、..Net Micro Framework研究—Windows桌面http://yfsoft.blog.51cto.com/1635641/322933 16、.Net Micro Framework研究—模拟器直接运行MF程序http://yfsoft.blog.51cto.com/1635641/322928 17、.Net Micro Framework研究—用MF编写俄罗斯方块http://yfsoft.blog.51cto.com/1635641/322921 18、.Net Micro Framework研究—让MF支持鼠标http://yfsoft.blog.51cto.com/1635641/322917 19、.Net Micro Framework研究—用MF控制机器人http://yfsoft.blog.51cto.com/1635641/323874 20、.Net Micro Framework研究—数据的永久存储http://yfsoft.blog.51cto.com/1635641/322911 21、.Net Micro Framework研究—实现SideShow窗体界面http://yfsoft.blog.51cto.com/1635641/322900 22、.Net Micro Framework研究—让MF支持英文输入法http://yfsoft.blog.51cto.com/1635641/321212 23、.Net Micro Framework研究—MF驱动继电器 http://yfsoft.blog.51cto.com/1635641/321288 24、.Net Micro Framework研究—串口部署的困惑 http://yfsoft.blog.51cto.com/1635641/321286 25、.Net Micro Framework研究—串口部署释疑 http://yfsoft.blog.51cto.com/1635641/321212 26、.Net Micro Framework研究— http://yfsoft.blog.51cto.com/1635641/321282 三、系统移植 1、【.Net Micro Framework PortingKit - 01】移植初步:环境搭建http://yfsoft.blog.51cto.com/1635641/321243 2、【.Net Micro Framework PortingKit - 02】STM3210E平台构建http://yfsoft.blog.51cto.com/1635641/321240 3、【.Net Micro Framework PortingKit - 03】调试初步:点亮LED灯http://yfsoft.blog.51cto.com/1635641/321238 4、【.Net Micro Framework PortingKit - 04】修改启动代码&重写向量表http://yfsoft.blog.51cto.com/1635641/321235 5、【.Net Micro Framework PortingKit - 05】SRAM初始化&设置NVIC中断表偏移http://yfsoft.blog.51cto.com/1635641/321234 6、【.Net Micro Framework PortingKit - 06】设置芯片时钟http://yfsoft.blog.51cto.com/1635641/321233 7、【.Net Micro Framework PortingKit - 07】NVIC中断处理http://yfsoft.blog.51cto.com/1635641/321229 8、【.Net Micro Framework PortingKit - 08】GPIO驱动http://yfsoft.blog.51cto.com/1635641/321228 9、【.Net Micro Framework PortingKit – 09】串口驱动http://yfsoft.blog.51cto.com/1635641/321224 10、【.Net Micro Framework PortingKit – 10】世界首款Cortex-M3内核MFV4诞生http://yfsoft.blog.51cto.com/1635641/323881 11、【.Net Micro Framework PortingKit – 11】NandFlash驱动开发http://yfsoft.blog.51cto.com/1635641/321222 12、【.Net Micro Framework PortingKit – 12】SysTick驱动开发http://yfsoft.blog.51cto.com/1635641/321221 13、【.Net Micro Framework PortingKit – 13】LCD驱动开发http://yfsoft.blog.51cto.com/1635641/321220 14、【.Net Micro Framework PortingKit – 14】TinyCLR编译与测试http://yfsoft.blog.51cto.com/1635641/321219 15、【.Net Micro Framework PortingKit – 15】移植总结(兼谈MF未来发展)http://yfsoft.blog.51cto.com/1635641/321218 四、高级开发 1、【玩转.Net MF – 01】Flash远程读写 http://yfsoft.blog.51cto.com/1635641/321217 2、【玩转.Net MF – 02】让PC成为MF的鼠标键盘 http://yfsoft.blog.51cto.com/1635641/321216 3、【玩转.Net MF – 03】远程文件查看器 http://yfsoft.blog.51cto.com/1635641/321214 4、【玩转.Net MF – 04】远程屏幕截图 http://yfsoft.blog.51cto.com/1635641/321215 5、【玩转.Net MF – 05】加载文件系统中的Pe文件 http://yfsoft.blog.51cto.com/1635641/321213 五、功能扩展 1、支持横竖屏切换的.Net Micro Framework模拟器 http://yfsoft.blog.51cto.com/1635641/321248 2、Micro Framework 3.0模拟器改造 http://yfsoft.blog.51cto.com/1635641/321260 3、开源System.Windows.Forms库,让.Net Micro Framework界面开发和上位机一样简单 http://yfsoft.blog.51cto.com/1635641/321246 六、相关网址 1、官方网址 http://www.microsoft.com/netmf/default.mspx 2、官方博客 http://blogs.msdn.com/netmfteam/ 3、中文博客 http://yfsoft.blog.51cto.com http://www.cnblogs.com/yefanqiu 4、中文讨论组 http://space.cnblogs.com/group/MFSoft 5、SDK下载 http://www.microsoft.com/downloads/details.aspx?FamilyId=77dbfc46-14a1-4dcf-a809-eda7ccfe376b&displaylang=en 6、源码下载 http://www.microsoft.com/downloads/details.aspx?displaylang=en&FamilyID=16fa5d31-a583-4c0d-af74-f4d5e235d5bc 更多文章,请随时关注:http://yfsoft.blog.51cto.com 本文转自yefanqiu51CTO博客,原文链接:http://blog.51cto.com/yfsoft/321212,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册