首页 文章 精选 留言 我的

精选列表

搜索[磐石100],共10000篇文章
优秀的个人博客,低调大师

Python爬虫入门教程 55-100 python爬虫高级技术之验证码篇

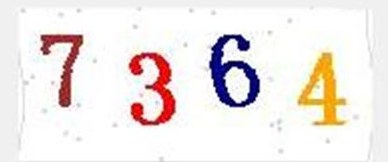
验证码探究 如果你是一个数据挖掘爱好者,那么验证码是你避免不过去的一个天坑,和各种验证码斗争,必然是你成长的一条道路,接下来的几篇文章,我会尽量的找到各种验证码,并且去尝试解决掉它,中间有些技术甚至我都没有见过,来吧,一起Coding吧 数字+字母的验证码 我随便在百度图片搜索了一个验证码,如下 今天要做的是验证码识别中最简单的一种办法,采用pytesseract解决,它属于Python当中比较简单的OCR识别库 库的安装 使用pytesseract之前,你需要通过pip 安装一下对应的模块 ,需要两个 pytesseract库还有图像处理的pillow库了 pip install pytesseract pip install pillow 如果你安装了这两个库之后,编写一个识别代码,一般情况下会报下面这个错误 pytesseract.pytes

优秀的个人博客,低调大师

Python爬虫入门教程 54-100 博客园等博客网站自动评论器

爬虫背景 爬虫最核心的问题就是解决重复操作,当一件事情可以重复的进行的时候,就可以用爬虫来解决这个问题,今天要实现的一个基本需求是完成“博客园“ 博客的自动评论,其实原理是非常简单的,提炼一下需求 基本需求 登录博客园<不实现,登录单独编写博客> 调用评论接口 返回请求结果 确定流程之后,基本就是找突破口的环节了 实际的去评论一下,然后不管你用什么抓包工具都可以,只要抓取到你想要的数据,即可 评论API如下 Request URL: https://www.cnblogs.com/mvc/PostComment/Add.aspx Request Method: POST POST URL 有了,下面就是参数的问题 我随便找了一个请求的参数 {"blogApp":"wuxiaobin","postId":10510784,"body":"继续

优秀的个人博客,低调大师

Python爬虫入门教程 44-100 Charles的安装与使用-手机APP爬虫部分

1. 第二款抓包工具Charles安装与使用 Charles和Fiddler一样,也是一款抓包工具,比Fiddler界面更加清晰,支持多平台 1.1 官方网址 https://www.charlesproxy.com/ 1.2 下载地址 Charles工具下载地址:https://www.charlesproxy.com/download/ 自己去百度一款,我找了2个百度网盘的 链接挂了就不补了啊~ 链接: https://pan.baidu.com/s/1pMawsEv 密码:meuk 链接: https://pan.baidu.com/s/1kV3h0gf 密码: nqaa 下载之后,安装就比较简单了,常规操作即可 2. Charles基本操作 打开Charles在电脑上就可以使用了 2.1 PC设置抓包,包括HTTP和HTTPS 软件安装好了之

优秀的个人博客,低调大师

Python爬虫入门教程 37-100 云沃客项目外包网数据爬虫 scrapy

爬前叨叨 2019年开始了,今年计划写一整年的博客呢~,第一篇博客写一下 一个外包网站的爬虫,万一你从这个外包网站弄点外快呢,呵呵哒 数据分析 官方网址为 https://www.clouderwork.com/ 进入全部项目列表页面,很容易分辨出来项目的分页方式 get异步请求 Request URL:https://www.clouderwork.com/api/v2/jobs/search?ts=1546395904852&keyword=&budget_range=&work_status=&pagesize=20&pagenum=3&sort=1&scope= Request Method:GET Status Code:200 OK 参数如下 ts:1546395904

优秀的个人博客,低调大师

Python爬虫入门教程 32-100 B站博人传评论数据抓取 scrapy

1. B站博人传评论数据爬取简介 今天想了半天不知道抓啥,去B站看跳舞的小姐姐,忽然看到了评论,那就抓取一下B站的评论数据,视频动画那么多,也不知道抓取哪个,选了一个博人传跟火影相关的,抓取看看。网址: https://www.bilibili.com/bangumi/media/md5978/?from=search&seid=16013388136765436883#short在这个网页看到了18560条短评,数据量也不大,抓取看看,使用的还是scrapy。 2. B站博人传评论数据案例---获取链接 从开发者工具中你能轻易的得到如下链接,有链接之后就好办了,如何创建项目就不在啰嗦了,我们直接进入主题。 我在代码中的parse函数中,设定了两个yield一个用来返回items 一个用来返回requests。然后实现一个新的功能

优秀的个人博客,低调大师

Python爬虫入门教程 27-100 微医挂号网专家团队数据抓取pyspider

1. 微医挂号网专家团队数据----写在前面 今天尝试使用一个新的爬虫库进行数据的爬取,这个库叫做pyspider,国人开发的,当然支持一下。 github地址: https://github.com/binux/pyspider官方文档地址:http://docs.pyspider.org/en/latest/ 安装起来是非常简单的 pip install pyspider 安装之后,启动 在CMD控制台里面敲入命令 pyspider 出现如下界面,代表运行成功,一般情况下,你的电脑如果没有安装 phantomjs 他会先给你安装一下。 接下来打开浏览器,访问地址输入 127.0.0.1:5000, 应该显示如下界面,就可以愉快的进行编码了~ 3步创建一个项目 2. 微医挂号网专家团队数据----库基本使用入门 这款工具的详细使用,给你提供一个

优秀的个人博客,低调大师

Python爬虫入门教程 25-100 知乎文章图片爬取器之一

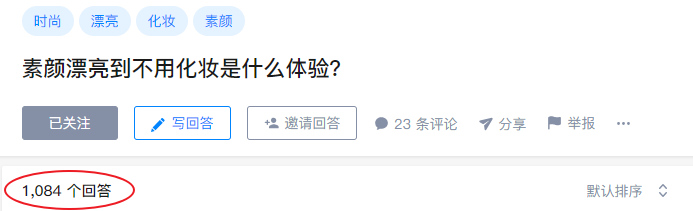
1. 知乎文章图片爬取器之一写在前面 今天开始尝试爬取一下知乎,看一下这个网站都有什么好玩的内容可以爬取到,可能断断续续会写几篇文章,今天首先爬取最简单的,单一文章的所有回答,爬取这个没有什么难度。 找到我们要爬取的页面,我随便选了一个 https://www.zhihu.com/question/292393947 1084个回答,数据量可以说非常小了,就爬取它吧。 2. 知乎文章图片爬取器之一选取操作库和爬取地址 爬取使用requests 存储使用 mongodb 就可以了 爬取地址经过分析之后,找到了一个可以返回json的数据接口 提取链接,看一下各参数的意思,方便我们程序模拟 https://www.zhihu.com/api/v4/questions/292393947/answers?include=data%5B%2A%5D.is_

优秀的个人博客,低调大师

Python爬虫入门教程 26-100 知乎文章图片爬取器之二

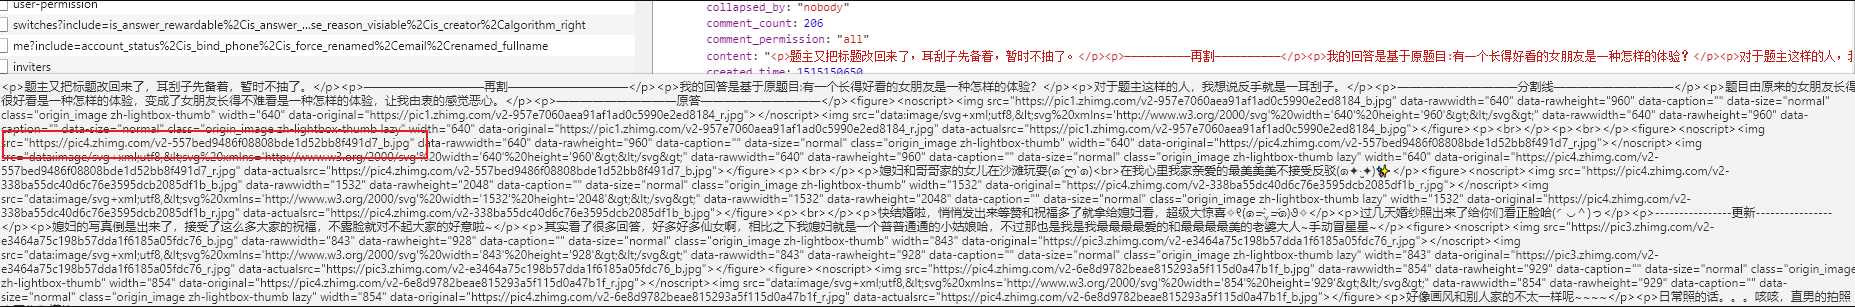
1. 知乎文章图片爬取器之二博客背景 昨天写了知乎文章图片爬取器的一部分代码,针对知乎问题的答案json进行了数据抓取,博客中出现了部分写死的内容,今天把那部分信息调整完毕,并且将图片下载完善到代码中去。 首先,需要获取任意知乎的问题,只需要你输入问题的ID,就可以获取相关的页面信息,比如最重要的合计有多少人回答问题。问题ID为如下标红数字 https://www.zhihu.com/question/ color=red>29024583 编写代码,下面的代码用来检测用户输入的是否是正确的ID,并且通过拼接URL去获取该问题下面合计有多少答案。 import requests import re import pymongo import time DATABASE_IP = '127.0.0.1' DATABASE_PORT = 27017 DATABASE_NAME = 'sun' client = pymongo.MongoClient(DATABASE_IP,DATABASE_PORT) db = client.sun db.authenticate("dba", "dba") collection = db.zhihuone # 准备插入数据 BASE_URL = "https://www.zhihu.com/question/{}" def get_totle_answers(article_id): headers = { "user-agent": "需要自己补全 Mozilla/5.0 (Windows NT 10.0; WOW64)" } with requests.Session() as s: with s.get(BASE_URL.format(article_id),headers=headers,timeout=3) as rep: html = rep.text pattern =re.compile( '<meta itemProp="answerCount" content="(\d*?)"/>') s = pattern.search(html) print("查找到{}条数据".format(s.groups()[0])) return s.groups()[0] if __name__ == '__main__': # 用死循环判断用户输入的是否是数字 article_id = "" while not article_id.isdigit(): article_id = input("请输入文章ID:") totle = get_totle_answers(article_id) if int(totle)>0: zhi = ZhihuOne(article_id,totle) zhi.run() else: print("没有任何数据!") 完善图片下载部分,图片下载地址在查阅过程中发现,存在json字段的content中,我们采用简单的正则表达式将他匹配出来。细节如下图展示 编写代码吧,下面的代码注释请仔细阅读,中间有一个小BUG,需要手动把pic3修改为pic2这个地方目前原因不明确,可能是我本地网络的原因,还有请在项目根目录先创建一个imgs的文件夹,用来存储图片 def download_img(self,data): ## 下载图片 for item in data["data"]: content = item["content"] pattern = re.compile('<noscript>(.*?)</noscript>') imgs = pattern.findall(content) if len(imgs) > 0: for img in imgs: match = re.search('<img src="(.*?)"', img) download = match.groups()[0] download = download.replace("pic3", "pic2") # 小BUG,pic3的下载不到 print("正在下载{}".format(download), end="") try: with requests.Session() as s: with s.get(download) as img_down: # 获取文件名称 file = download[download.rindex("/") + 1:] content = img_down.content with open("imgs/{}".format(file), "wb+") as f: # 这个地方进行了硬编码 f.write(content) print("图片下载完成", end="\n") except Exception as e: print(e.args) else: pass 更多内容,欢迎关注 https://dwz.cn/r4lCXEuL
优秀的个人博客,低调大师

Python爬虫入门教程 13-100 斗图啦表情包多线程爬取

1.准备爬取斗图la写在前面 今天在CSDN博客,发现好多人写爬虫都在爬取一个叫做斗图啦的网站,里面很多表情包,然后瞅了瞅,各种实现方式都有,今天我给你实现一个多线程版本的。关键技术点 aiohttp ,你可以看一下我前面的文章,然后在学习一下。 网站就不分析了,无非就是找到规律,拼接URL,匹配关键点,然后爬取。 2.开始撸代码 首先快速的导入我们需要的模块,和其他文章不同,我把相同的表情都放在了同一个文件夹下面,所以需要导入os模块 import asyncio import aiohttp from lxml import etree import os 编写主要的入口方法 if __name__ == '__main__': url_format = "http://www.doutula.com/article/list/?page={}" urls = [url_format.format(index) for index in range(1,586)] loop = asyncio.get_event_loop() tasks = [x_get_face(url) for url in urls] results = loop.run_until_complete(asyncio.wait(tasks)) 我们是为了学习,不是为了攻击别人服务器,所以限制一下并发数量 sema = asyncio.Semaphore(3) async def x_get_face(url): with(await sema): await get_face(url) 最后,一顿操作猛如虎,把所有的代码补全,就搞定了,这部分没有什么特别新鲜的地方,找图片链接,然后下载。 headers = {"user-agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/68.0.3440.106 Safari/537.36"} async def get_face(url): print("正在操作{}".format(url)) async with aiohttp.ClientSession() as s: async with s.get(url,headers=headers,timeout=5) as res: if res.status==200: html = await res.text() html_format = etree.HTML(html) hrefs = html_format.xpath("//a[@class='list-group-item random_list']") for link in hrefs: url = link.get("href") title = link.xpath("div[@class='random_title']/text()")[0] # 获取文件头部 path = './biaoqings/{}'.format(title.strip()) # 硬编码了,你要先在项目根目录创建一个biaoqings的文件夹 if not os.path.exists(path): os.mkdir(path) else: pass async with s.get(url, headers=headers, timeout=3) as res: if res.status == 200: new_html = await res.text() new_html_format = etree.HTML(new_html) imgs = new_html_format.xpath("//div[@class='artile_des']") for img in imgs: try: img = img.xpath("table//img")[0] img_down_url = img.get("src") img_title = img.get("alt") except Exception as e: print(e) async with s.get(img_down_url, timeout=3) as res: img_data = await res.read() try: with open("{}/{}.{}".format(path,img_title.replace('\r\n',""),img_down_url.split('.')[-1]),"wb+") as file: file.write(img_data) except Exception as e: print(e) else: pass else: print("网页访问失败")

优秀的个人博客,低调大师

Python爬虫入门教程 11-100 行行网电子书多线程爬取

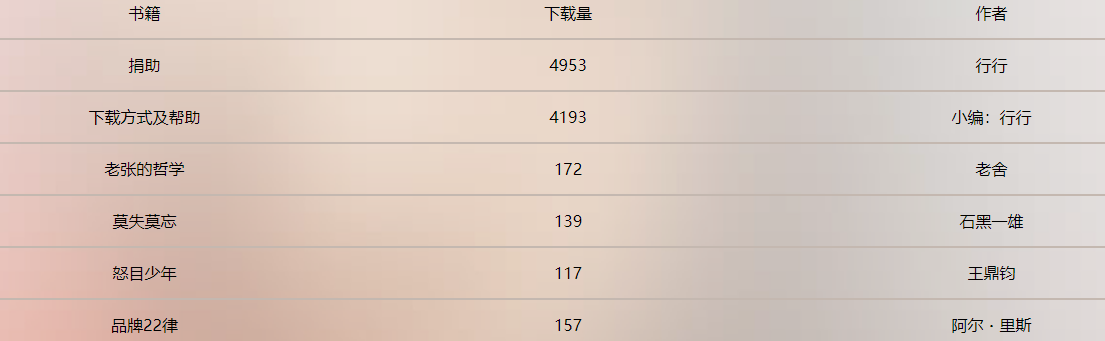
行行网电子书多线程-写在前面 最近想找几本电子书看看,就翻啊翻,然后呢,找到了一个 叫做 周读的网站 ,网站特别好,简单清爽,书籍很多,而且打开都是百度网盘可以直接下载,更新速度也还可以,于是乎,我给爬了。本篇文章学习即可,这么好的分享网站,尽量不要去爬,影响人家访问速度就不好了 http://www.ireadweek.com/ ,想要数据的,可以在我博客下面评论,我发给你,QQ,邮箱,啥的都可以。 这个网站页面逻辑特别简单 ,我翻了翻 书籍详情页面 ,就是下面这个样子的,我们只需要循环生成这些页面的链接,然后去爬就可以了,为了速度,我采用的多线程,你试试就可以了,想要爬取之后的数据,就在本篇博客下面评论,不要搞坏别人服务器。 http://www.ireadweek.com/index.php/bookInfo/11393

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册