首页 文章 精选 留言 我的

精选列表

搜索[整合],共10000篇文章
优秀的个人博客,低调大师

Spring Boot wwwxjf555888com 2.0 整合Spring15012038888 Batch Java配置示例

学习使用Java配置创建Spring批处理作业(具有多个步骤)。它使用Spring Boot 2,Spring batch 4和H2数据库来执行批处理作业。 项目结构在这个项目中,我们将创建一个包含两步任务的简单作业,并执行作业以观察日志。工作执行流程将是 - 开始工作执行任务一执行任务二完成工作Spring Batch Java配置示例Maven依赖我们需要包含spring-boot-starter-batch依赖性。Spring批处理依赖于作为持久数据存储的作业存储库。所以我们也需要一个DB。我正在使用H2(内存数据库),它与弹簧批量很好地集成。pom.xml 复制 xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://mave

优秀的个人博客,低调大师

SpringBoot2.0.3整合Mybatis添加动态数据源实现多库查询(DynamicDataSource)

最近由于项目使用了spring boot 2.0.3版本,业务从多个数据查询,必须支持动态数据源,由于2.0.3的版本与之前的版本有了较大的改动其实现上有些不同,再采坑以后在此记录 1、需要Java类 DynamicDataSource.java package com.a.dynamic; import org.springframework.jdbc.datasource.lookup.AbstractRoutingDataSource; /** * 〈动态数据源〉 * * @author zhoukai7 * @create 7/27/18 * @since 1.0.0 */ public class DynamicDataSource extends AbstractRoutingDataSource { @Override protected Object determineCurrentLookupKey() { return DynamicDataSourceContextHolder.getDataSourceType(); } } DynamicDataSourceAspect.java package com.a.dynamic; import org.aspectj.lang.JoinPoint; import org.aspectj.lang.annotation.After; import org.aspectj.lang.annotation.Aspect; import org.aspectj.lang.annotation.Before; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.core.annotation.Order; import org.springframework.stereotype.Component; /** * 〈一句话功能简述〉<br> * 〈动态数据源切面〉 * * @author zhoukai7 * @create 7/27/18 * @since 1.0.0 */ @Aspect @Order(-1)// 保证该AOP在@Transactional之前执行 @Component public class DynamicDataSourceAspect { private static final Logger logger = LoggerFactory.getLogger(DynamicDataSourceAspect.class); @Before("@annotation(ds)") public void changeDataSource(JoinPoint point, TargetDataSource ds) throws Throwable { String dsId = ds.name(); if (!DynamicDataSourceContextHolder.containsDataSource(dsId)) { logger.error("数据源[{}]不存在,使用默认数据源 > {}", ds.name(), point.getSignature()); } else { logger.debug("Use DataSource : {} > {}", ds.name(), point.getSignature()); DynamicDataSourceContextHolder.setDataSourceType(ds.name()); } } @After("@annotation(ds)") public void restoreDataSource(JoinPoint point, TargetDataSource ds) { logger.debug("Revert DataSource : {} > {}", ds.name(), point.getSignature()); DynamicDataSourceContextHolder.clearDataSourceType(); } } DynamicDataSourceContextHolder.java package com.a.dynamic; import java.util.ArrayList; import java.util.List; /** * 〈一句话功能简述〉<br> * 〈动态数据源句柄〉 * * @author zhoukai7 * @create 7/27/18 * @since 1.0.0 */ public class DynamicDataSourceContextHolder { private static final ThreadLocal<String> contextHolder = new ThreadLocal<String>(); public static List<String> dataSourceIds = new ArrayList<>(); public static void setDataSourceType(String dataSourceType) { contextHolder.set(dataSourceType); } public static String getDataSourceType() { return contextHolder.get(); } public static void clearDataSourceType() { contextHolder.remove(); } /** * 判断指定DataSrouce当前是否存在 * * @param dataSourceId * @author zhoukai7 * @create 7/27/18 */ public static boolean containsDataSource(String dataSourceId){ return dataSourceIds.contains(dataSourceId); } } DynamicDataSourceRegister.java package com.a.dynamic; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.beans.MutablePropertyValues; import org.springframework.beans.factory.support.BeanDefinitionRegistry; import org.springframework.beans.factory.support.GenericBeanDefinition; import org.springframework.boot.jdbc.DataSourceBuilder; import org.springframework.context.EnvironmentAware; import org.springframework.context.annotation.ImportBeanDefinitionRegistrar; import org.springframework.core.env.Environment; import org.springframework.core.type.AnnotationMetadata; import javax.sql.DataSource; import java.util.HashMap; import java.util.Map; /** * 〈一句话功能简述〉<br> * 〈注册中心〉 * * @author zhoukai7 * @create 7/27/18 * @since 1.0.0 */ public class DynamicDataSourceRegister implements ImportBeanDefinitionRegistrar, EnvironmentAware { private static final Logger logger = LoggerFactory.getLogger(DynamicDataSourceRegister.class); //指定默认数据源(springboot2.0默认数据源是hikari如何想使用其他数据源可以自己配置) //org.apache.tomcat.jdbc.pool.DataSource private static final String DATASOURCE_TYPE_DEFAULT = "com.zaxxer.hikari.HikariDataSource"; //默认数据源 private DataSource defaultDataSource; //用户自定义数据源 private Map<String, DataSource> slaveDataSources = new HashMap<>(); @Override public void setEnvironment(Environment environment) { initDefaultDataSource(environment); initslaveDataSources(environment); } private void initDefaultDataSource(Environment env) { // 读取主数据源 Map<String, Object> dsMap = new HashMap<>(); dsMap.put("type", env.getProperty("spring.datasource.type")); dsMap.put("driver", env.getProperty("spring.datasource.driverClassName")); dsMap.put("url", env.getProperty("spring.datasource.url")); dsMap.put("username", env.getProperty("spring.datasource.username")); dsMap.put("password", env.getProperty("spring.datasource.password")); defaultDataSource = buildDataSource(dsMap); } private void initslaveDataSources(Environment env) { // 读取配置文件获取更多数据源 String dsPrefixs = env.getProperty("slave.datasource.names"); for (String dsPrefix : dsPrefixs.split(",")) { // 多个数据源 Map<String, Object> dsMap = new HashMap<>(); dsMap.put("type", env.getProperty("slave.datasource." + dsPrefix + ".type")); dsMap.put("driver", env.getProperty("slave.datasource." + dsPrefix + ".driverClassName")); dsMap.put("url", env.getProperty("slave.datasource." + dsPrefix + ".url")); dsMap.put("username", env.getProperty("slave.datasource." + dsPrefix + ".username")); dsMap.put("password", env.getProperty("slave.datasource." + dsPrefix + ".password")); DataSource ds = buildDataSource(dsMap); slaveDataSources.put(dsPrefix, ds); } } @Override public void registerBeanDefinitions(AnnotationMetadata annotationMetadata, BeanDefinitionRegistry beanDefinitionRegistry) { Map<Object, Object> targetDataSources = new HashMap<Object, Object>(); //添加默认数据源 targetDataSources.put("dataSource", this.defaultDataSource); DynamicDataSourceContextHolder.dataSourceIds.add("dataSource"); //添加其他数据源 targetDataSources.putAll(slaveDataSources); for (String key : slaveDataSources.keySet()) { DynamicDataSourceContextHolder.dataSourceIds.add(key); } //创建DynamicDataSource GenericBeanDefinition beanDefinition = new GenericBeanDefinition(); beanDefinition.setBeanClass(DynamicDataSource.class); beanDefinition.setSynthetic(true); MutablePropertyValues mpv = beanDefinition.getPropertyValues(); mpv.addPropertyValue("defaultTargetDataSource", defaultDataSource); mpv.addPropertyValue("targetDataSources", targetDataSources); //注册 - BeanDefinitionRegistry beanDefinitionRegistry.registerBeanDefinition("dataSource", beanDefinition); logger.info("Dynamic DataSource Registry"); } public DataSource buildDataSource(Map<String, Object> dataSourceMap) { try { Object type = dataSourceMap.get("type"); if (type == null) { type = DATASOURCE_TYPE_DEFAULT;// 默认DataSource } Class<? extends DataSource> dataSourceType; dataSourceType = (Class<? extends DataSource>) Class.forName((String) type); String driverClassName = dataSourceMap.get("driver").toString(); String url = dataSourceMap.get("url").toString(); String username = dataSourceMap.get("username").toString(); String password = dataSourceMap.get("password").toString(); // 自定义DataSource配置 DataSourceBuilder factory = DataSourceBuilder.create().driverClassName(driverClassName).url(url) .username(username).password(password).type(dataSourceType); return factory.build(); } catch (ClassNotFoundException e) { e.printStackTrace(); } return null; } } TargetDataSource.java package com.a.dynamic; import java.lang.annotation.*; /** * 〈一句话功能简述〉<br> * 〈数据源注解类〉 * * @author zhoukai7 * @create 7/27/18 * @since 1.0.0 */ @Target({ ElementType.METHOD, ElementType.TYPE }) @Retention(RetentionPolicy.RUNTIME) @Documented public @interface TargetDataSource { String name(); } 2、yml文件配置 application.yml # Tomcat server: tomcat: uri-encoding: UTF-8 max-threads: 1000 min-spare-threads: 30 port: 8012 servlet: session: timeout: 1800 context-path: / # spring spring: # 环境 dev|test|pro profiles: active: dev # datasource: # type: com.alibaba.druid.pool.DruidDataSource # driverClassName: com.mysql.jdbc.Driver # jackson时间格式化 jackson: time-zone: GMT+8 date-format: yyyy-MM-dd HH:mm:ss # 文件上传 servlet: multipart: enabled: true max-file-size: 100MB max-request-size: 100MB # 指定静态资源的路径 resources: static-locations: classpath:/static/,classpath:/views/ # Spring devtools devtools: restart: enabled: true thymeleaf: cache: false # Mybatis配置 #mybatis: # mapperLocations: classpath*:mapper/**/*.xml # configLocation: classpath:mybatis.xml #mybatis mybatis-plus: mapper-locations: classpath*:/mapper/**/*.xml #实体扫描,多个package用逗号或者分号分隔 typeAliasesPackage: com.asiainfo.**.entity global-config: #主键类型 0:"数据库ID自增", 1:"用户输入ID",2:"全局唯一ID (数字类型唯一ID)", 3:"全局唯一ID UUID"; id-type: 0 #字段策略 0:"忽略判断",1:"非 NULL 判断"),2:"非空判断" field-strategy: 2 #驼峰下划线转换 db-column-underline: true #刷新mapper 调试神器 refresh-mapper: true #数据库大写下划线转换 #capital-mode: true #序列接口实现类配置 #key-generator: com.baomidou.springboot.xxx #逻辑删除配置 logic-delete-value: 0 logic-not-delete-value: 1 #自定义填充策略接口实现 #meta-object-handler: com.baomidou.springboot.xxx #自定义SQL注入器 #sql-injector: com.baomidou.springboot.xxx configuration: map-underscore-to-camel-case: true cache-enabled: false application-dev.yml spring: datasource: type: com.alibaba.druid.pool.DruidDataSource driverClassName: com.mysql.jdbc.Driver # 添加&useSSL=true后会报错 url: jdbc:mysql://localhost:3309/aas?allowMultiQueries=true&useUnicode=true&characterEncoding=UTF-8 username: root password: root #连接池的配置信息 initialSize: 10 minIdle: 10 maxActive: 100 # 配置获取连接等待超时的时间 maxWait: 60000 # 配置间隔多久才进行一次检测,检测需要关闭的空闲连接,单位是毫秒 timeBetweenEvictionRunsMillis: 60000 # 配置一个连接在池中最小生存的时间,单位是毫秒 minEvictableIdleTimeMillis: 300000 validationQuery: SELECT 1 FROM DUAL testWhileIdle: true testOnBorrow: false testOnReturn: false # 打开PSCache,并且指定每个连接上PSCache的大小 poolPreparedStatements: true maxPoolPreparedStatementPerConnectionSize: 20 # 配置监控统计拦截的filters,去掉后监控界面sql无法统计,'wall'用于防火墙 filters: stat,wall,slf4j # 通过connectProperties属性来打开mergeSql功能;慢SQL记录 connectionProperties: druid.stat.mergeSql=true;druid.stat.slowSqlMillis=5000 slave: datasource: names: ds1,ds2 ds1: type: com.alibaba.druid.pool.DruidDataSource driverClassName: com.mysql.jdbc.Driver # 添加&useSSL=true后会报错 url: jdbc:mysql://localhost:3309/bbs?allowMultiQueries=true&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&failOverReadOnly=false&maxReconnects=10 username: root password: root #连接池的配置信息 initialSize: 10 minIdle: 10 maxActive: 100 # 配置获取连接等待超时的时间 maxWait: 60000 # 配置间隔多久才进行一次检测,检测需要关闭的空闲连接,单位是毫秒 timeBetweenEvictionRunsMillis: 60000 # 配置一个连接在池中最小生存的时间,单位是毫秒 minEvictableIdleTimeMillis: 300000 validationQuery: SELECT 1 FROM DUAL testWhileIdle: true testOnBorrow: false testOnReturn: false # 打开PSCache,并且指定每个连接上PSCache的大小 poolPreparedStatements: true maxPoolPreparedStatementPerConnectionSize: 20 # 配置监控统计拦截的filters,去掉后监控界面sql无法统计,'wall'用于防火墙 filters: stat,wall,slf4j # 通过connectProperties属性来打开mergeSql功能;慢SQL记录 connectionProperties: druid.stat.mergeSql=true;druid.stat.slowSqlMillis=5000 ds2: type: com.alibaba.druid.pool.DruidDataSource driverClassName: com.mysql.jdbc.Driver # 添加&useSSL=true后会报错 url: jdbc:mysql://localhost:3309/dds?allowMultiQueries=true&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&failOverReadOnly=false&maxReconnects=10 username: root password: root #连接池的配置信息 initialSize: 10 minIdle: 10 maxActive: 100 # 配置获取连接等待超时的时间 maxWait: 60000 # 配置间隔多久才进行一次检测,检测需要关闭的空闲连接,单位是毫秒 timeBetweenEvictionRunsMillis: 60000 # 配置一个连接在池中最小生存的时间,单位是毫秒 minEvictableIdleTimeMillis: 300000 validationQuery: SELECT 1 FROM DUAL testWhileIdle: true testOnBorrow: false testOnReturn: false # 打开PSCache,并且指定每个连接上PSCache的大小 poolPreparedStatements: true maxPoolPreparedStatementPerConnectionSize: 20 # 配置监控统计拦截的filters,去掉后监控界面sql无法统计,'wall'用于防火墙 filters: stat,wall,slf4j # 通过connectProperties属性来打开mergeSql功能;慢SQL记录 connectionProperties: druid.stat.mergeSql=true;druid.stat.slowSqlMillis=5000 # 合并多个DruidDataSource的监控数据 #useGlobalDataSourceStat: true # redis: # host: 140.143.23.15 # port: 6379 # # Redis服务器连接密码(默认为空) # password: redis@root&hp # # Redis数据库索引(默认为0) # database: 1 # # 连接超时时间(毫秒) 2.0中需要suffix # timeout: 10000 # jedis: # pool: # # 连接池中的最大空闲连接 # max-idle: 50 # # 连接池中的最小空闲连接 # min-idle: 8 # # 连接池最大连接数(使用负值表示没有限制) # max-active: 1024 # # 连接池最大阻塞等待时间(使用负值表示没有限制) # max-wait: -1 upload: image: url: /data/image/release 3、使用方式 @TargetDataSource(name="ds1") @Override public List<Demo> queryList(){ Map<String,Object> map = new HashMap<>(); return demoDao.queryList(map); } @TargetDataSource(name="ds2") @Override public List<Demo> selectList(){ Map<String,Object> map = new HashMap<>(); return demoDao.queryList(map); } 说明:@TargetDataSource(name="ds2")只能添加在接口实现类上,而不能添加在接口上,推荐添加在service层的impl实现类上。 如果你的工程使用的mapper接口@Mapper public interface DemoDao extends BaseMapper<Demo> 则不能在此处使用@TargetDataSource,如果想要在持久层使用,必须有实现类。强烈推荐在service使用。

优秀的个人博客,低调大师

HTTP访问的两种方式(HttpClient+HttpURLConnection)整合汇总对比(转)

在Android上http 操作类有两种,分别是HttpClient和HttpURLConnection,其中两个类的详细介绍可以问度娘。 HttpClient: HttpClient是Apache Jakarta Common下的子项目,用来提供高效的、最新的、功能丰富的支持HTTP协议的客户端编程工具包,并且它支持HTTP协议最新的版本和建议。HttpClient其实是一个interface类型,已知3个实现类为AbstractHttpClient, AndroidHttpClient, DefaultHttpClient,查看文档发现DefaultHttpClient也是继承自AbstractHttpClient。HttpClient封装了对象需要执行的Http请求、身份验证、连接管理和其它特性。HttpClient有三个已知的实现类分别是:AbstractHttpClient, AndroidHttpClient, DefaultHttpClient,会发现有一个专门为Android应用准备的实现类AndroidHttpClient,当然使用常规的DefaultHttpClient也可以实现功能,但是既然开发的是Android应用程序,还是使用Android专有的实现类,一定有其优势。 HttpClient支持但默认不带GZIP压缩,可以自己写。 使用方法: 1.创建HttpClient对象。 2.创建请求方法的实例,并指定请求URL。如果需要发送GET请求,创建HttpGet对象;如果需要发送POST请求,创建HttpPost对象。 3.如果需要发送请求参数,可调用HttpGet、HttpPost共同的setParams(HetpParams params)方法来添加请求参数;对于HttpPost对象而言,也可调用setEntity(HttpEntity entity)方法来设置请求参数。 4.调用HttpClient对象的execute(HttpUriRequest request)发送请求,该方法返回一个HttpResponse。 5.调用HttpResponse的getAllHeaders()、getHeaders(String name)等方法可获取服务器的响应头;调用HttpResponse的getEntity()方法可获取HttpEntity对象,该对象包装了服务器的响应内容。程序可通过该对象获取服务器的响应内容。 6.释放连接。无论执行方法是否成功,都必须释放连接 示例: NameValuePair nameValuePair1 = new BasicNameValuePair("name", "yang"); NameValuePair nameValuePair2 = new BasicNameValuePair("pwd","123123"); List nameValuePairs = new ArrayList(); nameValuePairs.add(nameValuePair1); nameValuePairs.add(nameValuePair2); String validateURL = "http://10.0.2.2:8080/testhttp1/TestServlet"; try { HttpParams httpParams = new BasicHttpParams(); HttpConnectionParams.setConnectionTimeout(httpParams,5000); //设置连接超时为5秒 HttpClient client = new DefaultHttpClient(httpParams); // 生成一个http客户端发送请求对象 HttpPost httpPost = new HttpPost(urlString); //设定请求方式 if (nameValuePairs!=null && nameValuePairs.size()!=0) { //把键值对进行编码操作并放入HttpEntity对象中 httpPost.setEntity(new UrlEncodedFormEntity(nameValuePairs,HTTP.UTF_8)); } HttpResponse httpResponse = client.execute(httpPost); // 发送请求并等待响应 // 判断网络连接是否成功 if (httpResponse.getStatusLine().getStatusCode() != 200) { System.out.println("网络错误异常!!!!"); return false; } HttpEntity entity = httpResponse.getEntity(); // 获取响应里面的内容 inputStream = entity.getContent(); // 得到服务气端发回的响应的内容(都在一个流里面) // 得到服务气端发回的响应的内容(都在一个字符串里面) // String strResult = EntityUtils.toString(entity); } catch (Exception e) { System.out.println("这是异常!"); } HttpURLConnection: 在 JDK 的 java.net 包中已经提供了访问 HTTP 协议的基本功能:HttpURLConnection。HttpURLConnection继承自URLConnection. HttpURLconnection默认带GZIP压缩。 示例: String validateURL="http://10.0.2.2:8080/testhttp1/TestServlet?name=yang&pwd=123123"; try { URL url = new URL(validateUrl); //创建URL对象 //返回一个URLConnection对象,它表示到URL所引用的远程对象的连接 HttpURLConnection conn = (HttpURLConnection) url.openConnection(); conn.setConnectTimeout(5000); //设置连接超时为5秒 conn.setRequestMethod("GET"); //设定请求方式 conn.connect(); //建立到远程对象的实际连接 //返回打开连接读取的输入流 DataInputStream dis = new DataInputStream(conn.getInputStream()); //判断是否正常响应数据 if (conn.getResponseCode() != HttpURLConnection.HTTP_OK) { System.out.println("网络错误异常!!!!"); return false; } } catch (Exception e) { e.printStackTrace(); System.out.println("这是异常!"); } finally { if (conn != null) { conn.disconnect(); //中断连接 } } 区别: 功能用法 1、从功能上对比,HttpClient库要丰富很多,提供了很多工具,封装了http的请求头,参数,内容体,响应,还有一些高级功能,代理、COOKIE、鉴权、压缩、连接池的处理。 2、HttpClient高级功能代码写起来比较复杂,对开发人员的要求会高一些,而HttpURLConnection对大部分工作进行了包装,屏蔽了不需要的细节,适合开发人员直接调用。 3、HttpURLConnection在2.3版本增加了一些HTTPS方面的改进,4.0版本增加一些响应的缓存。 性能 1、HttpUrlConnection直接支持GZIP压缩;HttpClient也支持,但要自己写代码处理。 2、HttpUrlConnection直接支持系统级连接池,即打开的连接不会直接关闭,在一段时间内所有程序可共用;HttpClient当然也能做到,但毕竟不如官方直接系统底层支持好。 3、HttpUrlConnection直接在系统层面做了缓存策略处理(4.0版本以上),加快了重复请求的速度。 4、关于速度方面,网上有些大牛做过测试,但因访问站点的数据量,二次连接访问等发现测试结果并不统一,故不做详述。大体来说相差不是很大。 选用 1、如果一个Android应用需要向指定页面发送请求,但该页面并不是一个简单的页面,只有当用户已经登录,而且登录用户的用户名有效时才可访问该页面。如果使用HttpURLConnection来访问这个被保护的页面,那么需要处理的细节就太复杂了。可使用HttpClient来登录系统,只要应用程序使用同一个HttpClient发送请求,HttpClient会自动维护与服务器之间的Session状态,也就是说程序第一次使用HttpClient登录系统后,接下来使用HttpClient即可访问被保护页而了。这种情况建议使用HttpClient。 2、Android2.3及以上版本建议选用HttpURLConnection,2.2及以下版本建议选用HttpClient,因为貌似2.2下有些小bug,不知现在修复好没有,但是目前4.0以上版本覆盖率达89%了,这点应该问题不大。而且api体积小使用更简单,内存处理方面更适合移动设备,官方也更支持HttpURLClient,想必后续官方会更完善这个,新手或者新的应用都建议使用HttpURLConnection。 博主初学,此处只是学习笔记以作汇总学习。参考博文,详情请戳: http://blog.csdn.net/imzoer/article/details/9447985 http://blog.csdn.net/huzgd/article/details/8712187 http://blog.csdn.net/wangpeng047/article/details/19624529 转自:链接 本文转自SharkBin博客园博客,原文链接:http://www.cnblogs.com/SharkBin/p/4889606.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

微软发布全新 Agent 操作系统 UFO²,深度整合 Windows 与智能自动化

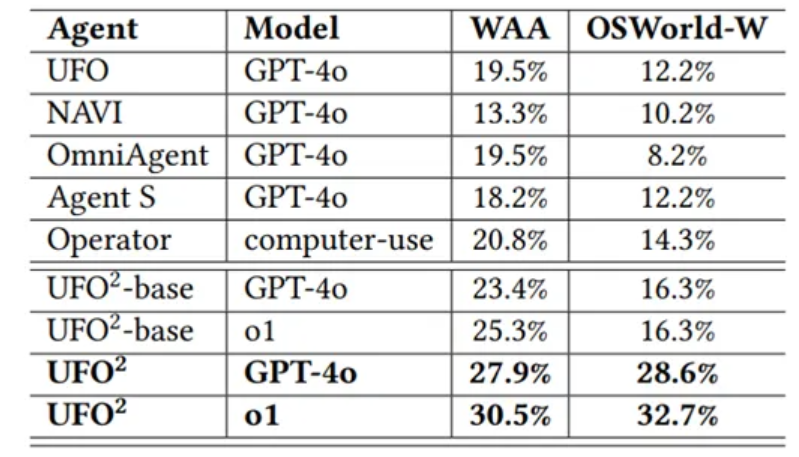
微软宣布重磅升级其开源项目 AgentUFO,推出了全新的 UFO² 版本,该版本新增了操作系统功能,并与 Windows 系统实现了深度集成。此举不仅增强了自动化任务的执行效率,还使得用户能够更便捷地进行复杂操作。 UFO² 的一个显著特点是其能够直接调用 Windows 的原生 API 和 COM 接口。这种方式相比传统的机器人流程自动化(RPA),能够在执行复杂业务时更加高效且精准。例如,在 Excel 中将表格数据转换为图表,传统 RPA 需要模拟多次点击鼠标,而 UFO² 则可以通过一次 API 调用轻松完成,避免了视觉定位和鼠标模拟的繁琐。 通过测试数据显示,UFO² 在自动化任务的成功率方面,显著高于 OpenAI 的 Operator。在不同的测试场景中,UFO² 的成功率分别达到了30.5% 和32.7%,而 Operator 的成功率仅为20.8% 和14.3%。此外,UFO² 在处理复杂任务和跨应用操作的表现上也明显优于 Operator,其在非标准界面的适应性更强。 UFO² 的核心控制组件 HostAgent 负责解析用户指令、管理应用程序生命周期和协调 AppAgents 的执行。当用户通过自然语言发出自动化指令时,HostAgent 会将任务分解为一系列子任务,并将其分配给相应的 AppAgents 执行。 每个 AppAgent 专注于特定的 Windows 应用程序,能够以更高的效率执行任务。UFO² 还引入了混合控制检测机制,结合视觉输入与应用程序的元数据,提升了系统对 GUI 元素的感知能力。这一创新使得 AppAgent 能够在标准和非标准环境中都能稳定工作。 另一个值得注意的创新是 UFO² 的画中画模式。这一功能实现了自动化任务与用户主桌面的隔离,用户可以在主桌面上正常操作,而自动化任务则在独立的虚拟桌面中运行。这种设计提升了用户体验,降低了系统干扰和潜在安全风险。 UFO² 的这些新功能展现了微软在自动化领域的最新技术进步,为用户提供了更加高效、灵活的工作环境。

优秀的个人博客,低调大师

Apache Doris 整合 FLINK CDC + Iceberg 构建实时湖仓一体的联邦查询

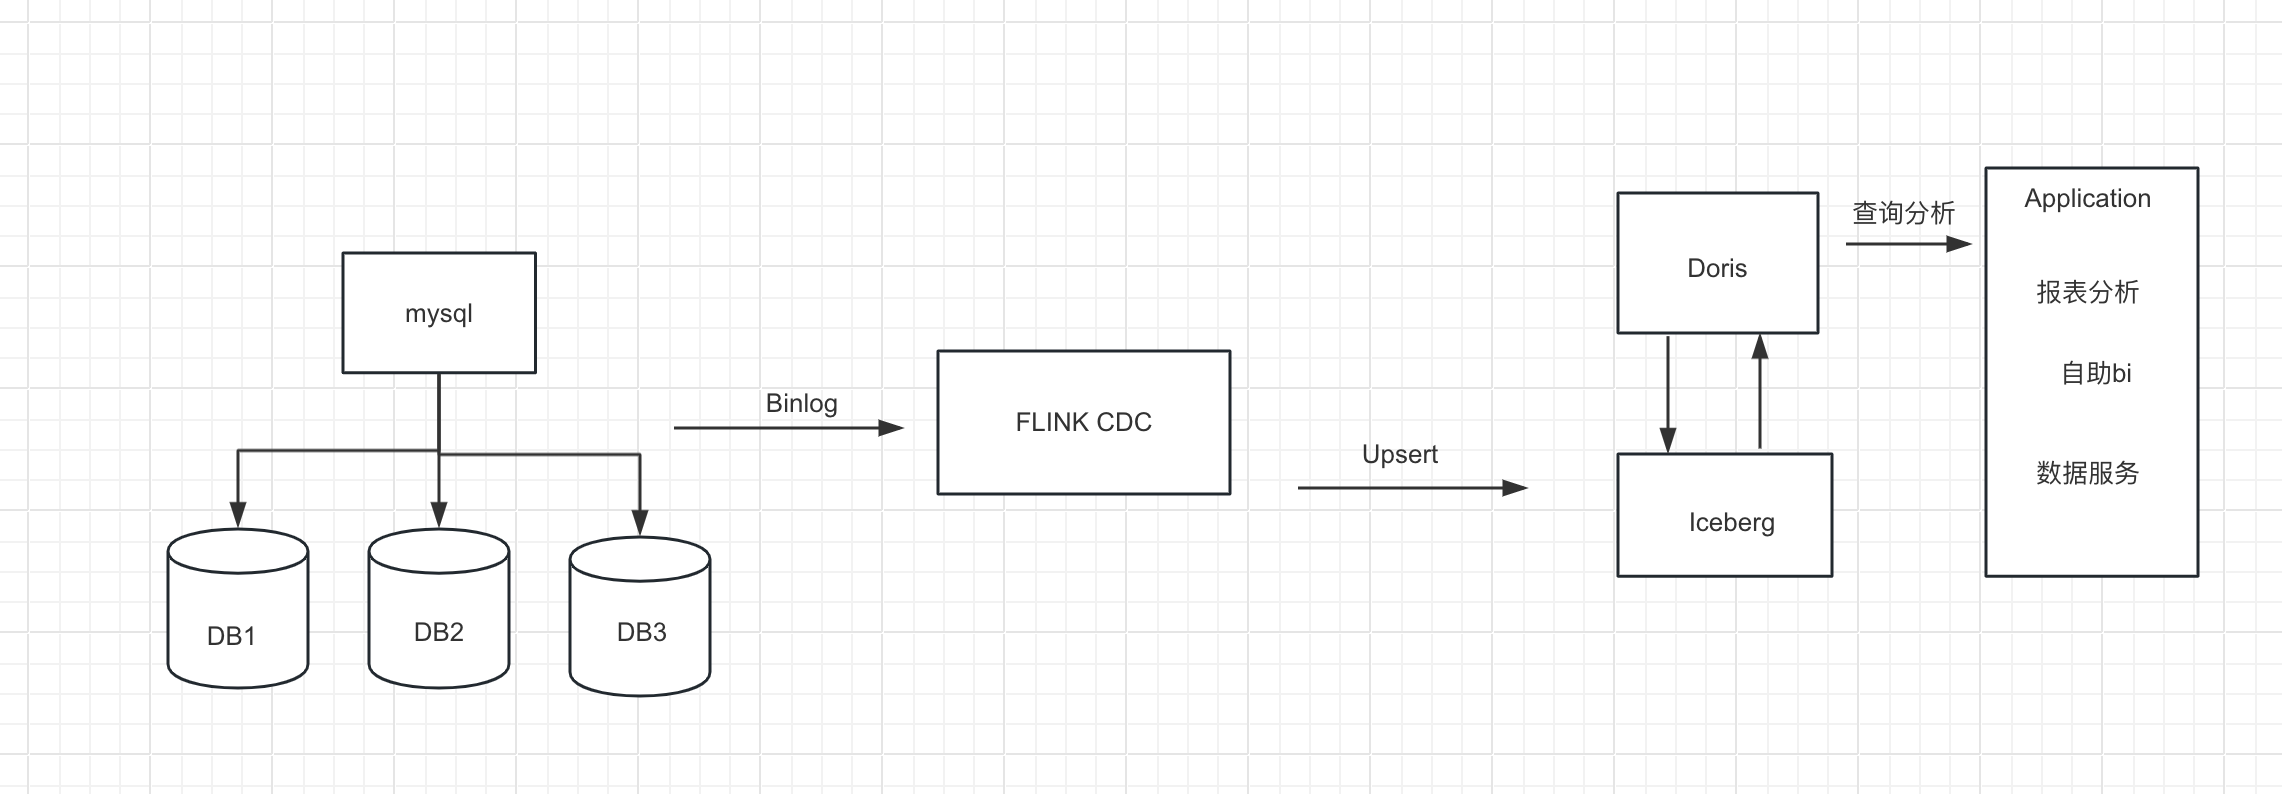
1概况 本文展示如何使用 Flink CDC + Iceberg + Doris 构建实时湖仓一体的联邦查询分析,Doris 1.1版本提供了Iceberg的支持,本文主要展示Doris和Iceberg怎么使用,大家按照步骤可以一步步完成。完整体验整个搭建操作的过程。 2系统架构 我们整理架构图如下,   1. 首先我们从Mysql数据中使用Flink 通过 Binlog完成数据的实时采集 2. 然后再Flink 中创建 Iceberg 表,Iceberg的元数据保存在hive里 3. 最后我们在Doris中创建Iceberg外表 4. 在通过Doris 统一查询入口完成对Iceberg里的数据进行查询分析,供前端应用调用,这里iceberg外表的数据可以和Doris内部数据或者Doris其他外部数据源的数据进行关联查询分析 Doris湖仓一体的联邦查询架构如下:    1. Doris 通过 ODBC 方式支持:MySQL,Postgresql,Oracle ,SQLServer 2. 同时支持 Elasticsearch 外表 3. 1.0版本支持Hive外表 4. 1.1版本支持Iceberg外表 5. 1.2版本支持Hudi 外表 3 创建MySQL数据库表并初始化数据 CREATE DATABASE demo; USE demo; CREATE TABLE userinfo ( id int NOT NULL AUTO_INCREMENT, name VARCHAR(255) NOT NULL DEFAULT 'flink', address VARCHAR(1024), phone_number VARCHAR(512), email VARCHAR(255), PRIMARY KEY (`id`) )ENGINE=InnoDB ; INSERT INTO userinfo VALUES (10001,'user_110','Shanghai','13347420870', NULL); INSERT INTO userinfo VALUES (10002,'user_111','xian','13347420870', NULL); INSERT INTO userinfo VALUES (10003,'user_112','beijing','13347420870', NULL); INSERT INTO userinfo VALUES (10004,'user_113','shenzheng','13347420870', NULL); INSERT INTO userinfo VALUES (10005,'user_114','hangzhou','13347420870', NULL); INSERT INTO userinfo VALUES (10006,'user_115','guizhou','13347420870', NULL); INSERT INTO userinfo VALUES (10007,'user_116','chengdu','13347420870', NULL); INSERT INTO userinfo VALUES (10008,'user_117','guangzhou','13347420870', NULL); INSERT INTO userinfo VALUES (10009,'user_118','xian','13347420870', NULL); 4 创建Iceberg Catalog CREATE CATALOG hive_catalog WITH ( 'type'='iceberg', 'catalog-type'='hive', 'uri'='thrift://localhost:9083', 'clients'='5', 'property-version'='1', 'warehouse'='hdfs://localhost:8020/user/hive/warehouse' ); 5 创建 Mysql CDC 表 CREATE TABLE user_source ( database_name STRING METADATA VIRTUAL, table_name STRING METADATA VIRTUAL, `id` DECIMAL(20, 0) NOT NULL, name STRING, address STRING, phone_number STRING, email STRING, PRIMARY KEY (`id`) NOT ENFORCED ) WITH ( 'connector' = 'mysql-cdc', 'hostname' = 'localhost', 'port' = '3306', 'username' = 'root', 'password' = 'MyNewPass4!', 'database-name' = 'demo', 'table-name' = 'userinfo' ); 6 创建Iceberg表 ---查看catalog show catalogs; ---使用catalog use catalog hive_catalog; --创建数据库 CREATE DATABASE iceberg_hive; --使用数据库 use iceberg_hive; ​ 7 创建表 CREATE TABLE all_users_info ( database_name STRING, table_name STRING, `id` DECIMAL(20, 0) NOT NULL, name STRING, address STRING, phone_number STRING, email STRING, PRIMARY KEY (database_name, table_name, `id`) NOT ENFORCED ) WITH ( 'catalog-type'='hive' ); 从CDC表里插入数据到Iceberg表里 use catalog default_catalog; ​ insert into hive_catalog.iceberg_hive.all_users_info select * from user_source; 我们去查询iceberg表 select * from hive_catalog.iceberg_hive.all_users_info 8 Doris 查询 Iceberg 8.1 创建Iceberg外表 CREATE TABLE `all_users_info` ENGINE = ICEBERG PROPERTIES ( "iceberg.database" = "iceberg_hive", "iceberg.table" = "all_users_info", "iceberg.hive.metastore.uris" = "thrift://localhost:9083", "iceberg.catalog.type" = "HIVE_CATALOG" ); 参数说明 • ENGINE 需要指定为 ICEBERG • PROPERTIES 属性: ◦ iceberg.hive.metastore.uris:Hive Metastore 服务地址 ◦ iceberg.database:挂载 Iceberg 对应的数据库名 ◦ iceberg.table:挂载 Iceberg 对应的表名,挂载 Iceberg database 时无需指定。 ◦ iceberg.catalog.type:Iceberg 中使用的 catalog 方式,默认为 HIVE_CATALOG,当前仅支持该方式,后续会支持更多的 Iceberg catalog 接入方式。 mysql> CREATE TABLE `all_users_info` -> ENGINE = ICEBERG -> PROPERTIES ( -> "iceberg.database" = "iceberg_hive", -> "iceberg.table" = "all_users_info", -> "iceberg.hive.metastore.uris" = "thrift://localhost:9083", -> "iceberg.catalog.type" = "HIVE_CATALOG" -> ); Query OK, 0 rows affected (0.23 sec) ​ mysql> select * from all_users_info; +---------------+------------+-------+----------+-----------+--------------+-------+ | database_name | table_name | id | name | address | phone_number | email | +---------------+------------+-------+----------+-----------+--------------+-------+ | demo | userinfo | 10004 | user_113 | shenzheng | 13347420870 | NULL | | demo | userinfo | 10005 | user_114 | hangzhou | 13347420870 | NULL | | demo | userinfo | 10002 | user_111 | xian | 13347420870 | NULL | | demo | userinfo | 10003 | user_112 | beijing | 13347420870 | NULL | | demo | userinfo | 10001 | user_110 | Shanghai | 13347420870 | NULL | | demo | userinfo | 10008 | user_117 | guangzhou | 13347420870 | NULL | | demo | userinfo | 10009 | user_118 | xian | 13347420870 | NULL | | demo | userinfo | 10006 | user_115 | guizhou | 13347420870 | NULL | | demo | userinfo | 10007 | user_116 | chengdu | 13347420870 | NULL | +---------------+------------+-------+----------+-----------+--------------+-------+ 9 rows in set (0.18 sec)  上述Doris On Iceberg我们只演示了Iceberg单表的查询,你还可以联合Doris的表,或者其他的ODBC外表,Hive外表,ES外表等进行联合查询分析,通过Doris对外提供统一的查询分析入口。 自此我们完整从搭建Hadoop,hive、flink 、Mysql、Doris 及Doris On Iceberg的使用全部介绍完了,Doris朝着数据仓库和数据融合的架构演进,支持湖仓一体的联邦查询,给我们的开发带来更多的便利,更高效的开发,省去了很多数据同步的繁琐工作。 作者:京东零售 吴化斌 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

CRM系统化整合从N-1做减法实践 | 京东物流技术团队

1 背景 京销易系统已经接入大网、KA以及云仓三个条线商机,每个条线商机规则差异比较大,当前现状是独立实现三套系统分别做支撑。 2 目标 2022年下半年CRM目标是完成9个新条线业务接入,完成销售过程线上化,实现销售规则统一。 3 问题 前端实现数据存储与逻辑代码耦合一起,无法复用,无法扩展,组件化拆分难度大。 组件拆分颗粒度较大,业务功能抽象不充分,缺乏复用性。 代码重复编写,相似功能冗余严重,开发和维护效率低。 代码版本多,接口不统一,开发、运维成本高,难扩展。 每个条线阶段、条线内每个商机阶段推进规则都是通过代码单独实现,开发、维护成本高,规则调整都需要代码调整并上线,时效性低,同时阶段规则维护在代码中,无法直观呈现和规则统一收口,运维难度大。 4 实现 4.1 方案调研 方案调研阶段,针对业务场景,多次组会对于底层实现方案进行充分讨论,列举每个方案优劣势,选择最适合当前业务场景的解决方案,最终选择上图的框架升级方案。 4.2 方案设计 4.2.1 设计思路 快速实现相似业务,减少相似代码,通过前端组件化、后端服务标准化、商机阶段配置化技术手段,支持各条线快速复用和灵活扩展。 4.2.2 前端组件化 1.前端现状 数据存储与逻辑代码耦合在一起,无法复用,无法扩展,组件化拆分难度大。表现为mixins逻辑代码与store数据存储耦合在一起,既降低了代码的可读性,也降低了store数据读写的灵活性。举个栗子,在人员信息集合中,本来可以针对name和sex两个字段在各自的组件进行维护即可,可现实是两个组件不得不调用同一个mixins进行维护。 组件拆分颗粒度较大,业务功能抽象不充分,缺乏复用性。组件的拆分没有一个清晰的界限,没有依据业务功能进行拆分,导致有一些组件不够纯粹,不符合单一职责原则,无法复用。在后期的维护过程中组件逐渐变得臃肿不堪。 代码重复编写,相似功能冗余严重,开发和维护效率低。由于组件无法复用,在后期维护过程中,开发人员对于类似的功能,不得不写了很多相似的代码,致使整个项目代码冗余、重复,慢慢的变得不可维护。 2.解决方案 针对本次商机条线接入功能,采用现有技术方案很难对后续条线依次接入,一个条线一套代码实现,接入周期长人力成本高,按期完成目标是一项不可能完成的挑战。经过技术方案调研,决定搭建一套求同存异(同为各个条线共用部分,异为各个条线单独部分)的前端组件化方案。依据业务功能,抽象出独立业务组件模块,依据条线插拔式组装,搭建出可维护、可扩展、灵活性高的组件积木化方案,在业务扩展性比较强的前端模块架构中优势更加明显。 组件积木化方案特点如下: 1.方案采用积木化前端组件搭建,其中任何一个组件都可以被替换(webComponent),任何一个父组件都可以扩展n个子组件。以上图商机信息组件为例,各条线商机信息所包含的字段存在差异,每个条线所对应的商机信息组件不同,最终会根据条线选择对应的组件加载。 2.数据统一管理(store),组件和数据之间为更新和依赖关系,当有组件更新数据时,其他组件也会立即更新,而不用相互传值。以商机详情组件为例,商机详情中修改了商机名称字段,则所有用到商机名称的组件都会得到更新。这需要提前对组件和store进行数据依赖更新的建立,通过computed与store双向依赖和监控机制,当computed监听store数据变化,将变化的数据更新到组件上,组件中通过store的mutaions更新数据到store上。 商机详情组件化抽象示意图如下: 4.2.3 后端标准化后端现状 由于前期未对条线的领域模型和功能模块进行抽象,导致烟囱代码林立;每个条线接入都要重复开发多套代码,各端(PC、移动端)接口不统一,前后端联调对接接口都需要区分多套;各条线独立开发部署,随着系统功能的丰富以及产品线持续增加,个性化需求和缺陷修复极大的消耗了研发资源和精力。同时,无法满足各条线商机阶段推进可定制的业务诉求,大致状态如下图。 2.解决方案 通过梳理商机流程与功能可以发现,商机中各条线既有相同的功能模块,也有各自独有的功能,例如商机创建、关闭、激活等流程每个条线差异不大,但是有些相似的功能模块各条线也存在差异,例如大宗的关闭商机与服务+中的关闭商机各自的关闭条件就不一样;那么基于此种业务场景,首先我们需要将主流程抽象出标准服务能力;例如,商机创建流程,我们将其定义为权限校验、参数校验、额外特殊校验、补充信息、模型转换、保存数据、跨区校验、后续额外处理等标准模板服务;每一个步骤方法都是抽象的,后续每个条线都将继承它,可以重写自己的逻辑;这样一个创建商机流程就标准化了。 上述我们是根据业务特性进行的模板抽象固化,但是如何将整个架构按照条线来走呢,这就需要我们将每个条线的流程进行抽象,例如,几乎每个条线都有创建商机、关闭商机、激活商机、修改商机等相同的动作,我们需要将这些抽象成固定的接口;然后各自条线都实现该接口并声明成策略,根据入参的识别自动分流至不同条线策略处理;也就形成了按条线为策略锚点的模式。 所以总体上是利用策略模式 + 模板模式支持各条线快速复用和灵活扩展,整体服务抽象复用及扩展思路形成大致的核心类图如下图: 整个商机的后端架构经过单条线多套接口处理的方式调整为适配所有条线统一接口接入;后端整体架构大致分5层,在核心层其实还会细分逻辑层,代理层以及Mapper 层。 首先我们在这次改造过程中统一了接口层,不在区分PC端接口,JME 端接口,统一以JSF接口形式提供出去;然后借助物流网关配置PC认证以及JME认证并一致以Http协议对接出去,保证了接口层面的统一。在适配层我们是定义了一个策略适配器,它会扫描所有声明了注解@LineType的策略处理器并缓存,然后根据解析入参中的条线进行自动匹配处理器进行分配处理,从而达到请求的自动分配处理。在核心层中其实更多的是模板方法的抽象与封装,将商机的基本查询、基础CMD操作、以及商机相关联信息操作进行分类抽象。将商机的推进机制建立在规则引擎中,将每个条线的推进规则提前配置在规则引擎的规则表中,并在后端服务中统一提供一个推进入口,所有条线都将基于该入口进行推进,达到推进规则明确,入口统一,阶段可配置等可灵活扩展的方式。 通过整体架构的优化和调整后,目前已经可以适配所有条统一接入、商机阶段可配置,推进规则可定义、接口统一等优点,大大节省了研发的接入成本。 4.2.4 商机阶段配置化 1.场景现状 每个销售条线的商机流程阶段及相应规则都存在差异,甚至同一个销售条线也存在多种业务,对应的商机流程阶段也不同,为支持多销售条线的差异化商机业务;要求必须实现每个条线的商机阶段个数是可配置的,并且每个阶段的规则也是可配置。 2.方案选型 如下图中所示,列举了几个条线的商机阶段生命周期,几乎每个条线的商机生命周期都不一样,这里需要说明一下阶段与阶段之间的推进条件是允许不一样的,所以会存在不同条线存在相同的阶段,但其实到达该阶段的前置条件是有可能不一样的,这就要求阶段的规则是可配置的,这也会造成可复用的可能性小。如果通过编码方式去实现每个条线的阶段生命周期会是一个非常复杂的过程,并且也难以维护。 经过调研发现,我们的这种场景模型就是通过多个入参条件决定流程走向(通过、不通过)的一种简单形式,相对于多入多出的模式还简单一些,而这种模式正好现在已经有比较好的解决方案(规则引擎),在现有的流程引擎(Flowable、Activity)都有对规则引擎的实现,包括强大的Drools 规则引擎。对比几款规则引擎几乎都可以很好的满足我们的需求,那就要考虑成本问题,毕竟引入一款中间件对系统的维护成本也是比较大的。经过了解部门内部已经对Flowable 已经进行二次封装对外赋能了,所以在这边我们采用了基于Flowable 流程引擎中的DMN来实现,从模型上来说就是输入多个入参,然后根据规则配置进行判断走向,没有多分支相关联,所以选择Flowable 的规则引擎也比较合适。 解决方案:通过规则引擎,配置商机阶段和阶段推进规则,解决各条线商机阶段差异化问题,将变化流程用配置化方式融入到整体流程中。 3.实现效果 在规则引擎中,提供决策表的表达式,决策表分为输入表达式与输出表达式两个主要区域。在输入表达式中,可以定义变量,用于规则输入项(input entries)的表达式。可以通过选择Add Input(添加输入),定义多个输入表达式。在输出表达式中,可以定义选择表执行结果要创建的变量(变量的值将用于输出项表达式,在下面解释)。可以通过选择Add Output(添加输出),定义多个输出表达式。 规则配置如下图:(以服务+条线举例) 服务+ 权授权业务商机推进规则:jd-rule-crm_fwj_chance_authorized_business 服务+ B线上业务商机推进规则:jd-rule-crm_fwj_chance_b_online_business 优势: 规则统一收口,每个条线商机阶段推进规则可以直观呈现,规则演化轨迹可以追踪,避免问题排查时,通过代码排查方式核对规则,提升运维效率。 规则调整可以实时生效,避免代码维护和系统上线,提升研发效率。 一套代码实现所有条线阶段推进,只需要根据条线添加不同的输入即可。 5 效果 5.1 提升效率 消灭烟囱系统,一套系统完成所有条线支撑,实现各条线、各端接口统一。 开发成本低,易扩展,提升研发效率,降低运维成本; 按照领域对商机进行拆分解耦,实现商机领域独立部署,在商机领域内,通过前端组件化、后端服务标准化、商机阶段配置化技术手段,支持各条线快速复用和灵活扩展。接入对比结果来看,研发效率提升显著,同时也降低运维成本。随着标准流程不断抽象,底层基础服务不断完善,后续条线接入的效率在进一步提升,从后续接入的云仓生态、物流科技、价值供应链,供应链金融,新业务-新业务、金融、供应商7个条线来看,平均接入工时维持在30人日左右。 条线接入工时如下: 标准流程和通用基础服务,提升研测过程效率,其中:服务+条线接入测试工时从最初评估的30人日到实际的23人日,测试阶段效率提升23.3%: 大宗条线接入测试评估工时及实际工时,基于服务+接入商机项目的测试经验,大宗商机接入项目测试阶段从原计划30人日降低到10人日,效率提升66.7%: 5.2 提升质量 服务+较原计划提前4工作日交付,大宗较原计划提前11工作日交付,交付演示过程中均未出现任何问题,验收全程未出现影响整体进度的阻塞性问题。 大宗UAT过程中共提出6个问题,其中5个为页面调优等优化项,1个为环境引起的无法勾选问题,未出现任何bug类问题,整体验收过程顺畅无阻。 作者:京东物流 姚再毅 孔祥东 樊平安 杨攀 田雷雷 来源:京东云开发者社区 自猿其说Tech

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册