首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

Hash和HashCode深入理解

目录介绍 1.Hash的作用介绍 1.1 Hash的定义 1.2 Hash函数特性 1.3 Hash的使用场景 2.如何判断两个对象相等 2.1 判断两个字符串 2.2 判断两个int数值 2.3 其他基本类型 3.HashCode深入分析 3.0 HashCode是什么 3.1 为什么要重写HashCode 3.2 HashCode源代码分析 3.3 HashCode带来的疑问 3.4 HashCode的作用 3.5 HashMap中的HashCode 3.6 可直接用hashcode判断两个对象是否相等 4.Hash表是什么 4.1 Hash表定义 4.2 Hash表简单介绍 5.Hash中的算法应用 5.1 基础算法 5.2 经典算法[摘自网络] 5.3 Hash碰撞[摘自网络] 6.Hash在Java中的应用场景 6.1 equals与hashCode有两个注意点 6.2 以HashSet为例说明hashCode()的作用 6.3 以HashMap为例说明Hash的作用 6.4 7.版本更新情况 8.其他介绍 1.Hash的作用介绍 1.1 Hash的定义 散列(哈希)函数 把任意长度的输入(又叫做预映射pre-image)通过散列算法变换成固定长度的输出,该输出就是散列值,是一种压缩映射。 或者说一种将任意长度的消息压缩到某一固定长度的消息摘要的函数。 1.2 Hash函数特性 h(k1)≠h(k2)则k1≠k2,即散列值不相同,则输入值即预映射不同 如果k1≠k2,h(k1)=h(k2) 则发生碰撞; 如果h(k1)=h(k2),k1不一定等于k2; 1.3 Hash的使用场景 比如说我们下载一个文件,文件的下载过程中会经过很多网络服务器、路由器的中转,如何保证这个文件就是我们所需要的呢?我们不可能去一一检测这个文件的每个字节,也不能简单地利用文件名、文件大小这些极容易伪装的信息,这时候,就需要一种指纹一样的标志来检查文件的可靠性,这种指纹就是我们现在所用的Hash算法(也叫散列算法)。 散列算法就是一种以较短的信息来保证文件唯一性的标志,这种标志与文件的每一个字节都相关,而且难以找到逆向规律。因此,当原有文件发生改变时,其标志值也会发生改变,从而告诉文件使用者当前的文件已经不是你所需求的文件。 这种标志有何意义呢?之前文件下载过程就是一个很好的例子,事实上,现在大部分的网络部署和版本控制工具都在使用散列算法来保证文件可靠性。 2.如何判断两个对象相等 2.1 判断两个字符串 使用equals方法判断两个字符串是否相等 String a = "yc1"; String b = "yc2"; boolean isEqual = a.equals(b); 当然Object的子类可以通过重写equals的方法,实现子类自身的对象是否相等的逻辑;String是Object的子类,查看下它的equals方法 //在Object类中 public boolean equals(Object obj) { //直接比较的是地址 return (this == obj); } //在String类中 public boolean equals(Object anObject) { //直接比较的是地址 if (this == anObject) { return true; } //盘旋是否是字符串String类型 if (anObject instanceof String) { String anotherString = (String) anObject; int n = count; if (n == anotherString.count) { int i = 0; //循环判断每个字符是否相等 while (n-- != 0) { if (charAt(i) != anotherString.charAt(i)) return false; i++; } return true; } } return false; } 2.2 判断两个int数值 Integer类的equals方法又是如何实现的呢? Integer a = Integer.valueOf("1"); Integer b = Integer.valueOf("2"); boolean ab = a.equals(b); public boolean equals(Object obj) { //先判断是否是Integer类型 if (obj instanceof Integer) { //转为int值后进行比较 return value == ((Integer)obj).intValue(); } return false; } 2.3 其他基本类型 //short类型 @Override public int hashCode() { return Short.hashCode(value); } public static int hashCode(short value) { return (int)value; } //Byte类型 @Override public int hashCode() { return Byte.hashCode(value); } public static int hashCode(byte value) { return (int)value; } //Long类型 @Override public int hashCode() { return Long.hashCode(value); } public static int hashCode(long value) { return (int)(value ^ (value >>> 32)); } //long类型作为索引范围太大,需要转为int类型。这里简单的获取低32位容易导致散列不均,因为高位部分没有被利用。所以这里采用逻辑右移32位,让高32位和低32位进行XOR操作,导致高位低位都能被利用到 //Boolean类型 @Override public int hashCode() { return Boolean.hashCode(value); } public static int hashCode(boolean value) { return value ? 1231 : 1237; } //采用两个质数作为true或false的索引。这两个质数足够大,用来作为索引时,出现碰撞的可能性低。 3.HashCode深入分析 3.0 HashCode是什么 HashCode是Object的一个方法,hashCode方法返回一个hash code值,且这个方法是为了更好的支持hash表,比如String,Set,HashTable、HashMap等; 3.1 为什么要重写HashCode 如果用 equal 去比较的话,如果存在1000个元素,你 new 一个新的元素出来,需要去调用1000次equal去逐个和他们比较是否是同一个对象,这样会大大降低效率。hashcode实际上是返回对象的存储地址,如果这个位置上没有元素,就把元素直接存储在上面,如果这个位置上已经存在元素,这个时候才去调用equal方法与新元素进行比较,相同的话就不存了,散列到其他地址上 3.2 HashCode源代码分析 在Object中的HashCode源代码 public int hashCode() { int lockWord = shadow$_monitor_; final int lockWordStateMask = 0xC0000000; // Top 2 bits. final int lockWordStateHash = 0x80000000; // Top 2 bits are value 2 (kStateHash). final int lockWordHashMask = 0x0FFFFFFF; // Low 28 bits. if ((lockWord & lockWordStateMask) == lockWordStateHash) { return lockWord & lockWordHashMask; } //返回的是对象引用地址 return System.identityHashCode(this); } 在String中的HashCode源代码 public int hashCode() { int h = hash; if (h == 0 && count > 0) { for (int i = 0; i < count; i++) { h = 31 * h + charAt(i); } hash = h; } return h; } 在Integer中的HashCode源代码 public int hashCode() { //int值 return value; } 3.3 HashCode带来的疑问 为何重写equals建议同时重写hashCode? hashCode是什么? hashCode作用? hash code(hash值)是什么? hash table(hash表)是什么? hashCode方法对hash表有益处? hashCode方法对不是hash有益处吗? 3.4 HashCode的作用 减少查找次数,提高程序效率 例如查找是否存在重复值 h(k1)≠h(k2)则k1≠k2 首先查看h(k2)输出值(内存地址),查看该内存地址是否存在值; 如果无,则表示该值不存在重复值; 如果有,则进行值比较,相同则表示该值已经存在散列列表中,如果不相同则再进行一个一个值比较;而无需一开始就一个一个值的比较,减少了查找次数 3.5 HashMap中的HashCode 在Java中也一样,hashCode方法的主要作用是为了配合基于散列的集合一起正常运行,这样的散列集合包括HashSet、HashMap以及HashTable。 为什么这么说呢?考虑一种情况,当向集合中插入对象时,如何判别在集合中是否已经存在该对象了?(注意:集合中不允许重复的元素存在) 也许大多数人都会想到调用equals方法来逐个进行比较,这个方法确实可行。但是如果集合中已经存在一万条数据或者更多的数据,如果采用equals方法去逐一比较,效率必然是一个问题。 此时hashCode方法的作用就体现出来了,当集合要添加新的对象时,先调用这个对象的hashCode方法,得到对应的hashcode值,实际上在HashMap的具体实现中会用一个table保存已经存进去的对象的hashcode值,如果table中没有该hashcode值,它就可以直接存进去,不用再进行任何比较了;如果存在该hashcode值, 就调用它的equals方法与新元素进行比较,相同的话就不存了,不相同就散列其它的地址,所以这里存在一个冲突解决的问题,这样一来实际调用equals方法的次数就大大降低了,说通俗一点:Java中的hashCode方法就是根据一定的规则将与对象相关的信息(比如对象的存储地址,对象的字段等)映射成一个数值,这个数值称作为散列值。下面这段代码是java.util.HashMap的中put方法的具体实现: put方法是用来向HashMap中添加新的元素,从put方法的具体实现可知,会先调用hashCode方法得到该元素的hashCode值,然后查看table中是否存在该hashCode值,如果存在则调用equals方法重新确定是否存在该元素,如果存在,则更新value值,否则将新的元素添加到HashMap中。从这里可以看出,hashCode方法的存在是为了减少equals方法的调用次数,从而提高程序效率。 public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } final V putVal(int hash, K key, V value, boolean onlyIfAbsent,boolean evict) { Node<K,V>[] tab; Node<K,V> p; int n, i; if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; if ((p = tab[i = (n - 1) & hash]) == null) tab[i] = newNode(hash, key, value, null); else { Node<K,V> e; K k; if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) e = p; else if (p instanceof TreeNode) e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); else { for (int binCount = 0; ; ++binCount) { if ((e = p.next) == null) { p.next = newNode(hash, key, value, null); if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); break; } if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) break; p = e; } } if (e != null) { // existing mapping for key V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; } } ++modCount; if (++size > threshold) resize(); afterNodeInsertion(evict); return null; } 3.6 可直接用hashcode判断两个对象是否相等 肯定是不可以的,因为不同的对象可能会生成相同的hashcode值。虽然不能根据hashcode值判断两个对象是否相等,但是可以直接根据hashcode值判断两个对象不等,如果两个对象的hashcode值不等,则必定是两个不同的对象。如果要判断两个对象是否真正相等,必须通过equals方法。 也就是说对于两个对象,如果调用equals方法得到的结果为true,则两个对象的hashcode值必定相等; 如果equals方法得到的结果为false,则两个对象的hashcode值不一定不同; 如果两个对象的hashcode值不等,则equals方法得到的结果必定为false; 如果两个对象的hashcode值相等,则equals方法得到的结果未知。 4.Hash表是什么 4.1 Hash表定义 根据关键码值(KEY-VALUE)而直接进行访问的数据结构;它通过把关键码值(KEY-VALUE)映射到表中一个位置来访问记录,以加快查找的速度。这个映射函数叫做散列函数,存放记录的数组叫做散列表。 4.2 Hash表简单介绍 将k作为输入值,h(k)输出值作为内存地址,该内存地址用来存放value,然后可以通过k获取到value存放的地址,从而获取value信息。 5.Hash中的算法应用 5.1 基础算法 比如,Java中的String.hashCode使用乘法和加法 public int hashCode() { int h = hash; if (h == 0 && count > 0) { for (int i = 0; i < count; i++) { //乘法与加法 h = 31 * h + charAt(i); } hash = h; } return h; } 5.2 经典算法[摘自网络] MD4,MD5,SHA-1或SHA-2等其他 5.3 Hash碰撞[摘自网络] hash是存在碰撞的,如果k1≠k2,h(k1)=h(k2) 则发生碰撞; 6.Hash在Java中的应用场景 6.1 equals与hashCode有两个注意点 equals相同,则hashCode相同;而hashCode相同,equals不一定相同 如果equals相同,hashCode不相同,有可能会造成上述重复值等情况,这种情况是不允许的; 而hasCode相同,但是equals不一定相同,有可能是因为发生了碰撞而碰撞是有可能性发生的 6.2 以HashSet为例说明hashCode()的作用 假设,HashSet中已经有1000个元素。当插入第1001个元素时,需要怎么处理? 因为HashSet是Set集合,它允许有重复元素。“将第1001个元素逐个的和前面1000个元素进行比较”? 显然,这个效率是相等低下的。散列表很好的解决了这个问题,它根据元素的散列码计算出元素在散列表中的位置,然后将元素插入该位置即可。对于相同的元素,自然是只保存了一个。 由此可知,若两个元素相等,它们的散列码一定相等;但反过来确不一定。在散列表中, 1、如果两个对象相等,那么它们的hashCode()值一定要相同; 2、如果两个对象hashCode()相等,它们并不一定相等。 注意:这是在散列表中的情况。在非散列表中一定如此! 6.3 以HashMap为例说明Hash的作用 在HashMap中有许多地方用到了hash算法 //put方法 public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } //remove方法 public V remove(Object key) { Node<K,V> e; return (e = removeNode(hash(key), key, null, false, true)) == null ? null : e.value; } //get方法 public V get(Object key) { Node<K,V> e; return (e = getNode(hash(key), key)) == null ? null : e.value; } //上面这几个方法都用到了这个方法 static final int hash(Object key) { int h; //计算hashCode,并无符号移动到低位 return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16); } 举个例子: h = 363771819^(363771819 >>> 16) 0001 0101 1010 1110 1011 0111 1010 1011(363771819) 0000 0000 0000 0000 0001 0101 1010 1110(5550) XOR --------------------------------------- = 0001 0101 1010 1110 1010 0010 0000 0101(363766277) 这样做可以实现了高地位更加均匀地混到一起 参考博客 Java Hash 存储机制:http://blog.chinaunix.net/uid-26981819-id-4462638.html 数据结构之哈希表:https://www.cnblogs.com/s-b-b/p/6208565.html Java hashCode() 和 equals()的若干问题解答:https://www.cnblogs.com/skywang12345/p/3324958.html Hash算法总结:https://blog.csdn.net/asdzheng/article/details/70226007 浅谈Java中的hashcode方法:http://www.cnblogs.com/dolphin0520/p/3681042.html 关于其他内容介绍 01.关于博客汇总链接 1.技术博客汇总 2.开源项目汇总 3.生活博客汇总 4.喜马拉雅音频汇总 5.其他汇总 02.关于我的博客 我的个人站点:www.yczbj.org,www.ycbjie.cn github:https://github.com/yangchong211 知乎:https://www.zhihu.com/people/yang-chong-69-24/pins/posts 简书:http://www.jianshu.com/u/b7b2c6ed9284 csdn:http://my.csdn.net/m0_37700275 喜马拉雅听书:http://www.ximalaya.com/zhubo/71989305/ 开源中国:https://my.oschina.net/zbj1618/blog 泡在网上的日子:http://www.jcodecraeer.com/member/content_list.php?channelid=1 邮箱:yangchong211@163.com 阿里云博客:https://yq.aliyun.com/users/article?spm=5176.100- 239.headeruserinfo.3.dT4bcV segmentfault头条:https://segmentfault.com/u/xiangjianyu/articles

优秀的个人博客,低调大师

深入理解 RPC 交互流程

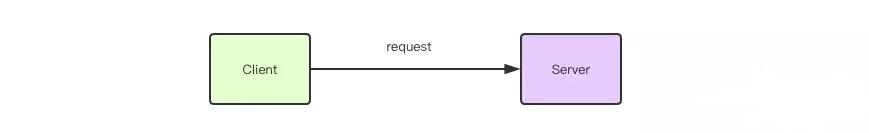
文节我们讲解 RPC 的消息交互流程,目的是搞清楚一个简单的 RPC 方法调用背后究竟发生了怎样复杂曲折的故事,以看透 RPC 的本质。 上图是信息系统交互模型宏观示意图,RPC 的消息交互则会深入到底层。 RPC 是两个子系统之间进行的直接消息交互,它使用操作系统提供的套接字来作为消息的载体,以特定的消息格式来定义消息内容和边界。 RPC 的客户端通过文件描述符的读写 API (read & write) 来访问操作系统内核中的网络模块为当前套接字分配的发送 (send buffer) 和接收 (recv buffer) 缓存。 如上图所示,左边的客户端进程写 RPC 指令消息到内核的发送缓存中,内核将发送缓存中的数据传送到物理硬件 NIC,也就是网络接口芯片 (Network Interface Circuit)。NIC 负责将翻译出来的模拟信号通过网络硬件传递到服务器硬件的 NIC。服务器的 NIC 再将模拟信号转成字节数据存放到内核为套接字分配的接收缓存中,最终服务器进程从接收缓存中读取数据即为源客户端进程传递过来的 RPC 指令消息。 消息从用户进程流向物理硬件,又从物理硬件流向用户进程,中间还经过了一系列的路由网关节点。 上图呈现的只是 RPC 一次消息交互的上半场,下半场是一个逆向的过程,从服务器进程向客户端进程返回响应数据。完整的一次 RPC 过程如下图所示: 下面用 Python 代码来描述上述过程。 Server 端死循环监听本地 8080 端口,等待客户端的连接。 客户端启动时连接本地 8080 端口,紧接着发送词一个字符串 hello,然后等待服务器响应。 服务器接收到客户端连接后立即收取客户端发送过来的字符串,也就是 hello,打印出来。然后立即给对方回复一个字符串 world。 客户端接收到服务器发送过来的 world,马上打印出来。 关闭连接,结束。 如果从上面代码上观察,我们其实很难看出上图所示的复杂过程。浮现在多数人脑海中往往是下面的这幅简约模型图。相比之下它要简单很多,这也正是操作系统设计的魅力所在,让你时时刻刻都在使用它却感受不到它的存在。 小结 通过本节内容,读者们对 RPC 的交互流程应该有了大致了解,但是还并不知道 RPC 之间到底交互了什么。就好比你能看到远方有几个人在说话,但是不知道他们在说啥。 下一节我们将放大细节,仔细观察 RPC 客户端服务器之间窃窃私语了什么,它们究竟是在用什么外星语言交流。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:860113481 群内提供免费的Java架构学习资料(里面有高可用、高并发、高性能及分布式、Jvm性能调优、Spring源码,MyBatis,Netty,Redis,Kafka,Mysql,Zookeeper,Tomcat,Docker,Dubbo,Nginx等多个知识点的架构资料)合理利用自己每一分每一秒的时间来学习提升自己,不要再用"没有时间“来掩饰自己思想上的懒惰!趁年轻,使劲拼,给未来的自己一个交代!

优秀的个人博客,低调大师

彻底理解Java的Future模式

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/81074477 先上一个场景:假如你突然想做饭,但是没有厨具,也没有食材。网上购买厨具比较方便,食材去超市买更放心。 实现分析:在快递员送厨具的期间,我们肯定不会闲着,可以去超市买食材。所以,在主线程里面另起一个子线程去网购厨具。 但是,子线程执行的结果是要返回厨具的,而run方法是没有返回值的。所以,这才是难点,需要好好考虑一下。 模拟代码1: package test; public class CommonCook { public static void main(String[] args) throws InterruptedException { long startTime = System.currentTimeMillis(); // 第一步 网购厨具 OnlineShopping thread = new OnlineShopping(); thread.start(); thread.join(); // 保证厨具送到 // 第二步 去超市购买食材 Thread.sleep(2000); // 模拟购买食材时间 Shicai shicai = new Shicai(); System.out.println("第二步:食材到位"); // 第三步 用厨具烹饪食材 System.out.println("第三步:开始展现厨艺"); cook(thread.chuju, shicai); System.out.println("总共用时" + (System.currentTimeMillis() - startTime) + "ms"); } // 网购厨具线程 static class OnlineShopping extends Thread { private Chuju chuju; @Override public void run() { System.out.println("第一步:下单"); System.out.println("第一步:等待送货"); try { Thread.sleep(5000); // 模拟送货时间 } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("第一步:快递送到"); chuju = new Chuju(); } } // 用厨具烹饪食材 static void cook(Chuju chuju, Shicai shicai) {} // 厨具类 static class Chuju {} // 食材类 static class Shicai {} } 运行结果: 第一步:下单 第一步:等待送货 第一步:快递送到 第二步:食材到位 第三步:开始展现厨艺 总共用时7013ms 可以看到,多线程已经失去了意义。在厨具送到期间,我们不能干任何事。对应代码,就是调用join方法阻塞主线程。 有人问了,不阻塞主线程行不行??? 不行!!! 从代码来看的话,run方法不执行完,属性chuju就没有被赋值,还是null。换句话说,没有厨具,怎么做饭。 Java现在的多线程机制,核心方法run是没有返回值的;如果要保存run方法里面的计算结果,必须等待run方法计算完,无论计算过程多么耗时。 面对这种尴尬的处境,程序员就会想:在子线程run方法计算的期间,能不能在主线程里面继续异步执行??? Where there is a will,there is a way!!! 这种想法的核心就是Future模式,下面先应用一下Java自己实现的Future模式。 模拟代码2: package test; import java.util.concurrent.Callable; import java.util.concurrent.ExecutionException; import java.util.concurrent.FutureTask; public class FutureCook { public static void main(String[] args) throws InterruptedException, ExecutionException { long startTime = System.currentTimeMillis(); // 第一步 网购厨具 Callable<Chuju> onlineShopping = new Callable<Chuju>() { @Override public Chuju call() throws Exception { System.out.println("第一步:下单"); System.out.println("第一步:等待送货"); Thread.sleep(5000); // 模拟送货时间 System.out.println("第一步:快递送到"); return new Chuju(); } }; FutureTask<Chuju> task = new FutureTask<Chuju>(onlineShopping); new Thread(task).start(); // 第二步 去超市购买食材 Thread.sleep(2000); // 模拟购买食材时间 Shicai shicai = new Shicai(); System.out.println("第二步:食材到位"); // 第三步 用厨具烹饪食材 if (!task.isDone()) { // 联系快递员,询问是否到货 System.out.println("第三步:厨具还没到,心情好就等着(心情不好就调用cancel方法取消订单)"); } Chuju chuju = task.get(); System.out.println("第三步:厨具到位,开始展现厨艺"); cook(chuju, shicai); System.out.println("总共用时" + (System.currentTimeMillis() - startTime) + "ms"); } // 用厨具烹饪食材 static void cook(Chuju chuju, Shicai shicai) {} // 厨具类 static class Chuju {} // 食材类 static class Shicai {} } 运行结果: 第一步:下单 第一步:等待送货 第二步:食材到位 第三步:厨具还没到,心情好就等着(心情不好就调用cancel方法取消订单) 第一步:快递送到 第三步:厨具到位,开始展现厨艺 总共用时5005ms 可以看见,在快递员送厨具的期间,我们没有闲着,可以去买食材;而且我们知道厨具到没到,甚至可以在厨具没到的时候,取消订单不要了。 好神奇,有没有。 下面具体分析一下第二段代码: 1)把耗时的网购厨具逻辑,封装到了一个Callable的call方法里面。 public interface Callable<V> { /** * Computes a result, or throws an exception if unable to do so. * * @return computed result * @throws Exception if unable to compute a result */ V call() throws Exception; } Callable接口可以看作是Runnable接口的补充,call方法带有返回值,并且可以抛出异常。 2)把Callable实例当作参数,生成一个FutureTask的对象,然后把这个对象当作一个Runnable,作为参数另起线程。 public class FutureTask<V> implements RunnableFuture<V> public interface RunnableFuture<V> extends Runnable, Future<V> public interface Future<V> { boolean cancel(boolean mayInterruptIfRunning); boolean isCancelled(); boolean isDone(); V get() throws InterruptedException, ExecutionException; V get(long timeout, TimeUnit unit) throws InterruptedException, ExecutionException, TimeoutException; } 这个继承体系中的核心接口是Future。Future的核心思想是:一个方法f,计算过程可能非常耗时,等待f返回,显然不明智。可以在调用f的时候,立马返回一个Future,可以通过Future这个数据结构去控制方法f的计算过程。 这里的控制包括: get方法:获取计算结果(如果还没计算完,也是必须等待的) cancel方法:还没计算完,可以取消计算过程 isDone方法:判断是否计算完 isCancelled方法:判断计算是否被取消 这些接口的设计很完美,FutureTask的实现注定不会简单,后面再说。 3)在第三步里面,调用了isDone方法查看状态,然后直接调用task.get方法获取厨具,不过这时还没送到,所以还是会等待3秒。对比第一段代码的执行结果,这里我们节省了2秒。这是因为在快递员送货期间,我们去超市购买食材,这两件事在同一时间段内异步执行。 通过以上3步,我们就完成了对Java原生Future模式最基本的应用。下面具体分析下FutureTask的实现,先看JDK8的,再比较一下JDK6的实现。 既然FutureTask也是一个Runnable,那就看看它的run方法 public void run() { if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return; try { Callable<V> c = callable; // 这里的callable是从构造方法里面传人的 if (c != null && state == NEW) { V result; boolean ran; try { result = c.call(); ran = true; } catch (Throwable ex) { result = null; ran = false; setException(ex); // 保存call方法抛出的异常 } if (ran) set(result); // 保存call方法的执行结果 } } finally { // runner must be non-null until state is settled to // prevent concurrent calls to run() runner = null; // state must be re-read after nulling runner to prevent // leaked interrupts int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } 先看try语句块里面的逻辑,发现run方法的主要逻辑就是运行Callable的call方法,然后将保存结果或者异常(用的一个属性result)。这里比较难想到的是,将call方法抛出的异常也保存起来了。 这里表示状态的属性state是个什么鬼 * Possible state transitions: * NEW -> COMPLETING -> NORMAL * NEW -> COMPLETING -> EXCEPTIONAL * NEW -> CANCELLED * NEW -> INTERRUPTING -> INTERRUPTED */ private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; 把FutureTask看作一个Future,那么它的作用就是控制Callable的call方法的执行过程,在执行的过程中自然会有状态的转换: 1)一个FutureTask新建出来,state就是NEW状态;COMPETING和INTERRUPTING用的进行时,表示瞬时状态,存在时间极短(为什么要设立这种状态???不解);NORMAL代表顺利完成;EXCEPTIONAL代表执行过程出现异常;CANCELED代表执行过程被取消;INTERRUPTED被中断 2)执行过程顺利完成:NEW -> COMPLETING -> NORMAL 3)执行过程出现异常:NEW -> COMPLETING -> EXCEPTIONAL 4)执行过程被取消:NEW -> CANCELLED 5)执行过程中,线程中断:NEW -> INTERRUPTING -> INTERRUPTED 代码中状态判断、CAS操作等细节,请读者自己阅读。 再看看get方法的实现: public V get() throws InterruptedException, ExecutionException { int s = state; if (s <= COMPLETING) s = awaitDone(false, 0L); return report(s); } private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false; for (;;) { if (Thread.interrupted()) { removeWaiter(q); throw new InterruptedException(); } int s = state; if (s > COMPLETING) { if (q != null) q.thread = null; return s; } else if (s == COMPLETING) // cannot time out yet Thread.yield(); else if (q == null) q = new WaitNode(); else if (!queued) queued = UNSAFE.compareAndSwapObject(this, waitersOffset, q.next = waiters, q); else if (timed) { nanos = deadline - System.nanoTime(); if (nanos <= 0L) { removeWaiter(q); return state; } LockSupport.parkNanos(this, nanos); } else LockSupport.park(this); } } get方法的逻辑很简单,如果call方法的执行过程已完成,就把结果给出去;如果未完成,就将当前线程挂起等待。awaitDone方法里面死循环的逻辑,推演几遍就能弄懂;它里面挂起线程的主要创新是定义了WaitNode类,来将多个等待线程组织成队列,这是与JDK6的实现最大的不同。 挂起的线程何时被唤醒: private void finishCompletion() { // assert state > COMPLETING; for (WaitNode q; (q = waiters) != null;) { if (UNSAFE.compareAndSwapObject(this, waitersOffset, q, null)) { for (;;) { Thread t = q.thread; if (t != null) { q.thread = null; LockSupport.unpark(t); // 唤醒线程 } WaitNode next = q.next; if (next == null) break; q.next = null; // unlink to help gc q = next; } break; } } done(); callable = null; // to reduce footprint } 以上就是JDK8的大体实现逻辑,像cancel、set等方法,也请读者自己阅读。 再来看看JDK6的实现。 JDK6的FutureTask的基本操作都是通过自己的内部类Sync来实现的,而Sync继承自AbstractQueuedSynchronizer这个出镜率极高的并发工具类 /** State value representing that task is running */ private static final int RUNNING = 1; /** State value representing that task ran */ private static final int RAN = 2; /** State value representing that task was cancelled */ private static final int CANCELLED = 4; /** The underlying callable */ private final Callable<V> callable; /** The result to return from get() */ private V result; /** The exception to throw from get() */ private Throwable exception; 里面的状态只有基本的几个,而且计算结果和异常是分开保存的。 V innerGet() throws InterruptedException, ExecutionException { acquireSharedInterruptibly(0); if (getState() == CANCELLED) throw new CancellationException(); if (exception != null) throw new ExecutionException(exception); return result; } 这个get方法里面处理等待线程队列的方式是调用了acquireSharedInterruptibly方法,看过我之前几篇博客文章的读者应该非常熟悉了。其中的等待线程队列、线程挂起和唤醒等逻辑,这里不再赘述,如果不明白,请出门左转。 最后来看看,Future模式衍生出来的更高级的应用。 再上一个场景:我们自己写一个简单的数据库连接池,能够复用数据库连接,并且能在高并发情况下正常工作。 实现代码1: package test; import java.util.concurrent.ConcurrentHashMap; public class ConnectionPool { private ConcurrentHashMap<String, Connection> pool = new ConcurrentHashMap<String, Connection>(); public Connection getConnection(String key) { Connection conn = null; if (pool.containsKey(key)) { conn = pool.get(key); } else { conn = createConnection(); pool.putIfAbsent(key, conn); } return conn; } public Connection createConnection() { return new Connection(); } class Connection {} } 我们用了ConcurrentHashMap,这样就不必把getConnection方法置为synchronized(当然也可以用Lock),当多个线程同时调用getConnection方法时,性能大幅提升。 貌似很完美了,但是有可能导致多余连接的创建,推演一遍: 某一时刻,同时有3个线程进入getConnection方法,调用pool.containsKey(key)都返回false,然后3个线程各自都创建了连接。虽然ConcurrentHashMap的put方法只会加入其中一个,但还是生成了2个多余的连接。如果是真正的数据库连接,那会造成极大的资源浪费。 所以,我们现在的难点是:如何在多线程访问getConnection方法时,只执行一次createConnection。 结合之前Future模式的实现分析:当3个线程都要创建连接的时候,如果只有一个线程执行createConnection方法创建一个连接,其它2个线程只需要用这个连接就行了。再延伸,把createConnection方法放到一个Callable的call方法里面,然后生成FutureTask。我们只需要让一个线程执行FutureTask的run方法,其它的线程只执行get方法就好了。 上代码: package test; import java.util.concurrent.Callable; import java.util.concurrent.ConcurrentHashMap; import java.util.concurrent.ExecutionException; import java.util.concurrent.FutureTask; public class ConnectionPool { private ConcurrentHashMap<String, FutureTask<Connection>> pool = new ConcurrentHashMap<String, FutureTask<Connection>>(); public Connection getConnection(String key) throws InterruptedException, ExecutionException { FutureTask<Connection> connectionTask = pool.get(key); if (connectionTask != null) { return connectionTask.get(); } else { Callable<Connection> callable = new Callable<Connection>() { @Override public Connection call() throws Exception { return createConnection(); } }; FutureTask<Connection> newTask = new FutureTask<Connection>(callable); connectionTask = pool.putIfAbsent(key, newTask); if (connectionTask == null) { connectionTask = newTask; connectionTask.run(); } return connectionTask.get(); } } public Connection createConnection() { return new Connection(); } class Connection { } } 推演一遍:当3个线程同时进入else语句块时,各自都创建了一个FutureTask,但是ConcurrentHashMap只会加入其中一个。第一个线程执行pool.putIfAbsent方法后返回null,然后connectionTask被赋值,接着就执行run方法去创建连接,最后get。后面的线程执行pool.putIfAbsent方法不会返回null,就只会执行get方法。 在并发的环境下,通过FutureTask作为中间转换,成功实现了让某个方法只被一个线程执行。 就这么多吧,真是呕心沥血啊!!!哈哈

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册