首页 文章 精选 留言 我的

精选列表

搜索[图像理解],共10000篇文章
优秀的个人博客,低调大师

Reactor:深入理解reactor core

简介 上篇文章我们简单的介绍了Reactor的发展史和基本的Flux和Mono的使用,本文将会进一步挖掘Reactor的高级用法,一起来看看吧。 自定义Subscriber 之前的文章我们提到了4个Flux的subscribe的方法: Disposable subscribe(); Disposable subscribe(Consumer<? super T> consumer); Disposable subscribe(Consumer<? super T> consumer, Consumer<? super Throwable> errorConsumer); Disposable subscribe(Consumer<? super T> consumer, Consumer<? super Throwable> errorConsumer, Runnable completeConsumer); Disposable subscribe(Consumer<? super T> consumer, Consumer<? super Throwable> errorConsumer, Runnable completeConsumer, Consumer<? super Subscription> subscriptionConsumer); 这四个方法,需要我们使用lambda表达式来自定义consumer,errorConsumer,completeSonsumer和subscriptionConsumer这四个Consumer。 写起来比较复杂,看起来也不太方便,我们考虑一下,这四个Consumer是不是和Subscriber接口中定义的4个方法是一一对应的呢? public static interface Subscriber<T> { public void onSubscribe(Subscription subscription); public void onNext(T item); public void onError(Throwable throwable); public void onComplete(); } 对的,所以我们有一个更加简单点的subscribe方法: public final void subscribe(Subscriber<? super T> actual) 这个subscribe方法直接接收一个Subscriber类。从而实现了所有的功能。 自己写Subscriber太麻烦了,Reactor为我们提供了一个BaseSubscriber的类,它实现了Subscriber中的所有功能,还附带了一些其他的方法。 我们看下BaseSubscriber的定义: public abstract class BaseSubscriber<T> implements CoreSubscriber<T>, Subscription, Disposable 注意,BaseSubscriber是单次使用的,这就意味着,如果它首先subscription到Publisher1,然后subscription到Publisher2,那么将会取消对第一个Publisher的订阅。 因为BaseSubscriber是一个抽象类,所以我们需要继承它,并且重写我们需要自己实现的方法。 下面看一个自定义的Subscriber: public class CustSubscriber<T> extends BaseSubscriber<T> { public void hookOnSubscribe(Subscription subscription) { System.out.println("Subscribed"); request(1); } public void hookOnNext(T value) { System.out.println(value); request(1); } } BaseSubscriber中有很多以hook开头的方法,这些方法都是我们可以重写的,而Subscriber原生定义的on开头的方法,在BaseSubscriber中都是final的,都是不能重写的。 我们看一个定义: [@Override](https://my.oschina.net/u/1162528) public final void onSubscribe(Subscription s) { if (Operators.setOnce(S, this, s)) { try { hookOnSubscribe(s); } catch (Throwable throwable) { onError(Operators.onOperatorError(s, throwable, currentContext())); } } } 可以看到,它内部实际上调用了hook的方法。 上面的CustSubscriber中,我们重写了两个方法,一个是hookOnSubscribe,在建立订阅的时候调用,一个是hookOnNext,在收到onNext信号的时候调用。 在这些方法中,给了我们足够的自定义空间,上面的例子中我们调用了request(1),表示再请求一个元素。 其他的hook方法还有: hookOnComplete, hookOnError, hookOnCancel 和 hookFinally。 Backpressure处理 我们之前讲过了,reactive stream的最大特征就是可以处理Backpressure。 什么是Backpressure呢?就是当consumer处理过不来的时候,可以通知producer来减少生产速度。 我们看下BaseSubscriber中默认的hookOnSubscribe实现: protected void hookOnSubscribe(Subscription subscription){ subscription.request(Long.MAX_VALUE); } 可以看到默认是request无限数目的值。 也就是说默认情况下没有Backpressure。 通过重写hookOnSubscribe方法,我们可以自定义处理速度。 除了request之外,我们还可以在publisher中限制subscriber的速度。 public final Flux<T> limitRate(int prefetchRate) { return onAssembly(this.publishOn(Schedulers.immediate(), prefetchRate)); } 在Flux中,我们有一个limitRate方法,可以设定publisher的速度。 比如subscriber request(100),然后我们设置limitRate(10),那么最多producer一次只会产生10个元素。 创建Flux 接下来,我们要讲解一下怎么创建Flux,通常来讲有4种方法来创建Flux。 使用generate 第一种方法就是最简单的同步创建的generate. 先看一个例子: public void useGenerate(){ Flux<String> flux = Flux.generate( () -> 0, (state, sink) -> { sink.next("3 x " + state + " = " + 3*state); if (state == 10) sink.complete(); return state + 1; }); flux.subscribe(System.out::println); } 输出结果: 3 x 0 = 0 3 x 1 = 3 3 x 2 = 6 3 x 3 = 9 3 x 4 = 12 3 x 5 = 15 3 x 6 = 18 3 x 7 = 21 3 x 8 = 24 3 x 9 = 27 3 x 10 = 30 上面的例子中,我们使用generate方法来同步的生成元素。 generate接收两个参数: public static <T, S> Flux<T> generate(Callable<S> stateSupplier, BiFunction<S, SynchronousSink<T>, S> generator) 第一个参数是stateSupplier,用来指定初始化的状态。 第二个参数是一个generator,用来消费SynchronousSink,并生成新的状态。 上面的例子中,我们每次将state+1,一直加到10。 然后使用subscribe来将所有的生成元素输出。 使用create Flux也提供了一个create方法来创建Flux,create可以是同步也可以是异步的,并且支持多线程操作。 因为create没有初始的state状态,所以可以用在多线程中。 create的一个非常有用的地方就是可以将第三方的异步API和Flux关联起来,举个例子,我们有一个自定义的EventProcessor,当处理相应的事件的时候,会去调用注册到Processor中的listener的一些方法。 interface MyEventListener<T> { void onDataChunk(List<T> chunk); void processComplete(); } 我们怎么把这个Listener的响应行为和Flux关联起来呢? public void useCreate(){ EventProcessor myEventProcessor = new EventProcessor(); Flux<String> bridge = Flux.create(sink -> { myEventProcessor.register( new MyEventListener<String>() { public void onDataChunk(List<String> chunk) { for(String s : chunk) { sink.next(s); } } public void processComplete() { sink.complete(); } }); }); } 使用create就够了,create接收一个consumer参数: public static <T> Flux<T> create(Consumer<? super FluxSink<T>> emitter) 这个consumer的本质是去消费FluxSink对象。 上面的例子在MyEventListener的事件中对FluxSink对象进行消费。 使用push push和create一样,也支持异步操作,但是同时只能有一个线程来调用next, complete 或者 error方法,所以它是单线程的。 使用Handle Handle和上面的三个方法不同,它是一个实例方法。 它和generate很类似,也是消费SynchronousSink对象。 Flux<R> handle(BiConsumer<T, SynchronousSink<R>>); 不同的是它的参数是一个BiConsumer,是没有返回值的。 看一个使用的例子: public void useHandle(){ Flux<String> alphabet = Flux.just(-1, 30, 13, 9, 20) .handle((i, sink) -> { String letter = alphabet(i); if (letter != null) sink.next(letter); }); alphabet.subscribe(System.out::println); } public String alphabet(int letterNumber) { if (letterNumber < 1 || letterNumber > 26) { return null; } int letterIndexAscii = 'A' + letterNumber - 1; return "" + (char) letterIndexAscii; } 本文的例子learn-reactive 本文作者:flydean程序那些事 本文链接:http://www.flydean.com/reactor-core-in-depth/ 本文来源:flydean的博客 欢迎关注我的公众号:「程序那些事」最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现!

优秀的个人博客,低调大师

深入理解Java线程池

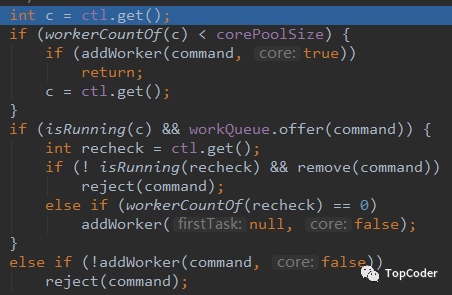
编者注:Java中的线程池是运用场景最多的并发组件,几乎所有需要异步或并发执行任务的程序都可以使用线程池。 在开发过程中,合理地使用线程池能够带来至少以下几个好处。 降低资源消耗:通过重复利用已创建的线程降低线程创建和销毁造成的消耗。 提高响应速度:当任务到达时,任务可以不需要等到线程创建就能立即执行。 提高线程的可管理性:线程是稀缺资源,如果无限制地创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一分配、调优和监控。但是,要做到合理利用线程池,必须了解其实现原理。 代码解耦:比如生产者消费者模式。 线程池实现原理 当提交一个新任务到线程池时,线程池的处理流程如下: 如果当前运行的线程少于corePoolSize,则创建新线程来执行任务(注意,执行这一步骤需要获取全局锁)。 如果运行的线程等于或多于corePoolSize,则将任务加入BlockingQueue。 如果无法将任务加入BlockingQueue(队列已满),则创建新的线程来处理任务(注意,执行这一步骤也需要获取全局锁)。 如果创建新线程将使当前运行的线程数超出maximumPoolSize,该任务将被拒绝,并调用相应的拒绝策略来处理(RejectedExecutionHandler.rejectedExecution()方法,线程池默认的饱和策略是AbortPolicy,也就是抛异常)。 ThreadPoolExecutor采取上述步骤的总体设计思路,是为了在执行execute()方法时,尽可能地避免获取全局锁(那将会是一个严重的可伸缩瓶颈)。在ThreadPoolExecutor完成预热之后(当前运行的线程数大于等于corePoolSize),几乎所有的execute()方法调用都是执行步骤2,而步骤2不需要获取全局锁。 线程池任务 拒绝策略包括 抛异常、直接丢弃、丢弃队列中最老的任务、将任务分发给调用线程处理。 线程池的创建:通过ThreadPoolExecutor来创建一个线程池。 newThreadPoolExecutor(corePoolSize,maximumPoolSize,keepAliveTime,timeUnit,runnableTaskQueue,handler); 创建一个线程池时需要输入以下几个参数: corePoolSize(线程池的基本大小):当提交一个任务到线程池时,线程池会创建一个线程来执行任务,即使其他空闲的基本线程能够执行新任务也会创建线程,等到线程池的线程数等于线程池基本大小时就不再创建。如果调用了线程池的prestartAllCoreThreads()方法,线程池会提前创建并启动所有基本线程。 maximumPoolSize(线程池最大数量):线程池允许创建的最大线程数。如果队列满了,并且已创建的线程数小于最大线程数,则线程池会再创建新的线程执行任务。值得注意的是,如果使用了无界的任务队列这个参数就没什么效果。 keepAliveTime(线程活动保持时间):线程池的工作线程空闲后,保持存活的时间。所以,如果任务很多,并且每个任务执行的时间比较短,可以调大时间,提高线程的利用率。 TimeUnit(线程活动保持时间的单位):可选的单位有天(DAYS)、小时(HOURS)、分钟(MINUTES)、毫秒(MILLISECONDS)、微秒(MICROSECONDS,千分之一毫秒)和纳秒(NANOSECONDS,千分之一微秒)。 runnableTaskQueue(任务队列):用于保存等待执行的任务的阻塞队列。可以选择以下几个阻塞队列。 - ArrayBlockingQueue:是一个基于数组结构的有界阻塞队列,此队列按FIFO(先进先出)原则对元素进行排序。 LinkedBlockingQueue:一个基于链表结构的阻塞队列,此队列按FIFO排序元素,吞吐量通常要高于ArrayBlockingQueue。静态工厂方法Executors.newFixedThreadPool()使用了这个队列。 SynchronousQueue:一个不存储元素的阻塞队列。每个插入操作必须等到另一个线程调用移除操作,否则插入操作一直处于阻塞状态,吞吐量通常要高于LinkedBlockingQueue,静态工厂方法Executors.newCachedThreadPool使用了这个队列。 PriorityBlockingQueue:一个具有优先级的无界阻塞队列。 线程的状态 在HotSpot VM线程模型中,Java线程被一对一映射到本地系统线程,Java线程启动时会创建一个本地系统线程;当Java线程终止时,这个本地系统线程也会被回收。操作系统调度所有线程并把它们分配给可用的CPU。 thread运行周期中,有以下6种状态,在 java.lang.Thread.State 中有详细定义和说明: //Thread类publicenumState{/***刚创建尚未运行*/NEW,/***可运行状态,该状态表示正在JVM中处于运行状态,不过有可能是在等待其他资源,比如CPU时间片,IO等待*/RUNNABLE,/***阻塞状态表示等待monitor锁(阻塞在等待monitor锁或者在调用Object.wait方法后重新进入synchronized块时阻塞)*/BLOCKED,/***等待状态,发生在调用Object.wait、Thread.join(withnotimeout)、LockSupport.park*表示当前线程在等待另一个线程执行某种动作,比如Object.notify()、Object.notifyAll(),Thread.join表示等待线程执行完成*/WAITING,/***超时等待,发生在调用Thread.sleep、Object.wait、Thread.join(intimeout)、LockSupport.parkNanos、LockSupport.parkUntil*/TIMED_WAITING,/***线程已执行完成,终止状态*/TERMINATED;} 线程池操作 向线程池提交任务,可以使用两个方法向线程池提交任务,分别为execute()和submit()方法。execute()方法用于提交不需要返回值的任务,所以无法判断任务是否被线程池执行成功。通过以下代码可知execute()方法输入的任务是一个Runnable类的实例。 threadsPool.execute(newRunnable(){@Overridepublicvoidrun(){//TODOAuto-generatedmethodstub}}); submit()方法用于提交需要返回值的任务。线程池会返回一个future类型的对象,通过这个future对象可以判断任务是否执行成功,通过future的get()方法来获取返回值,future的get()方法会阻塞当前线程直到任务完成,而使用get(long timeout,TimeUnit unit)方法则会阻塞当前线程一段时间后立即返回,这时候有可能任务还没有执行完。 Future<Object>future=executor.submit(harReturnValuetask);try{Objects=future.get();}catch(InterruptedExceptione){//处理中断异常}catch(ExecutionExceptione){//处理无法执行任务异常}finally{//关闭线程池executor.shutdown();} 合理配置线程池 要想合理配置线程池,必须先分析任务的特点,可以从以下几个角度分析: 任务的性质:CPU密集型任务、IO密集型任务和混合型任务。 任务的优先级:高、中和低。 任务的执行时间:长、中和短。 任务的依赖性:是否依赖其他系统资源,如数据库连接。 性质不同的任务可以用不同规模的线程池分开处理。CPU密集型任务应配置尽可能少的线程,如配置Ncpu+1个线程的线程池。由于IO密集型任务线程并不是一直在执行任务,则应配置多一点线程,如2*Ncpu。混合型的任务,如果可以拆分,将其拆分成一个CPU密集型任务和一个IO密集型任务,只要这两个任务执行的时间相差不是太大,那么分解后执行的吞吐量将高于串行执行的吞吐量。如果这两个任务执行时间相差太大,则没必要进行分解。可以通过Runtime.getRuntime().availableProcessors()方法获得当前设备的CPU个数。 优先级不同的任务可以使用优先级队列PriorityBlockingQueue来处理。它可以让优先级高的任务先执行。执行时间不同的任务可以交给不同规模的线程池来处理,或者可以使用优先级队列,让执行时间短的任务先执行。依赖数据库连接池的任务,因为线程提交SQL后需要等待数据库返回结果,等待的时间越长,则CPU空闲时间就越长,那么线程数应该设置得越大,这样才能更好地利用CPU。 线程池中线程数量未达到coreSize时,这些线程处于什么状态? 这些线程处于RUNNING或者WAITING,RUNNING表示线程处于运行当中,WAITING表示线程阻塞等待在阻塞队列上。当一个task submit给线程池时,如果当前线程池线程数量还未达到coreSize时,会创建线程执行task,否则将任务提交给阻塞队列,然后触发线程执行。(从submit内部调用的代码也可以看出来) ScheduledThreadPoolExecutor ScheduledThreadPoolExecutor继承自ThreadPoolExecutor。它主要用来在给定的延迟之后运行任务,或者定期执行任务。ScheduledThreadPoolExecutor的功能与Timer类似,但ScheduledThreadPoolExecutor功能更强大、更灵活。Timer对应的是单个后台线程,而ScheduledThreadPoolExecutor可以在构造函数中指定多个对应的后台线程数。 ScheduledThreadPoolExecutor继承自ThreadPoolExecutor,ScheduledThreadPoolExecutor和ThreadPoolExecutor的区别是,ThreadPoolExecutor获取任务时是从BlockingQueue中获取的,而ScheduledThreadPoolExecutor是从DelayedWorkQueue中获取的(注意,DelayedWorkQueue是BlockingQueue的实现类)。 ScheduledThreadPoolExecutor把待调度的任务(ScheduledFutureTask)放到一个DelayQueue中,其中ScheduledFutureTask主要包含3个成员变量: sequenceNumber:任务被添加到ScheduledThreadPoolExecutor中的序号; time:任务将要被执行的具体时间; period:任务执行的间隔周期。 ScheduledThreadPoolExecutor会把待执行的任务放到工作队列DelayQueue中,DelayQueue封装了一个PriorityQueue,PriorityQueue会对队列中的ScheduledFutureTask进行排序,具体的排序比较算法实现如下: ScheduledFutureTask在DelayQueue中被保存在一个PriorityQueue(基于数组实现的优先队列,类似于堆排序中的优先队列)中,在往数组中添加/移除元素时,会调用siftDown/siftUp来进行元素的重排序,保证元素的优先级顺序。 staticclassDelayedWorkQueueextendsAbstractQueue<Runnable>implementsBlockingQueue<Runnable>{privatestaticfinalintINITIAL_CAPACITY=16;privateRunnableScheduledFuture<?>[]queue=newRunnableScheduledFuture<?>[INITIAL_CAPACITY];privatefinalReentrantLocklock=newReentrantLock();privateintsize=0;privateThreadleader=null;privatefinalConditionavailable=lock.newCondition();} 从DelayQueue获取任务的主要逻辑就在take()方法中,首选获取lock,然后获取queue[0],如果为null则await等待任务的来临,如果非null查看任务是否到期,是的话就执行该任务,否则再次await等待。这里有一个leader变量,用来表示当前进行awaitNanos等待的线程,如果leader非null,表示已经有其他线程在进行awaitNanos等待,自己await等待,否则自己进行awaitNanos等待。 //DelayedWorkQueuepublicRunnableScheduledFuture<?>take()throwsInterruptedException{finalReentrantLocklock=this.lock;lock.lockInterruptibly();try{for(;;){RunnableScheduledFuture<?>first=queue[0];if(first==null)available.await();else{longdelay=first.getDelay(NANOSECONDS);if(delay<=0)returnfinishPoll(first);first=null;//don'tretainrefwhilewaitingif(leader!=null)available.await();else{ThreadthisThread=Thread.currentThread();leader=thisThread;try{available.awaitNanos(delay);}finally{if(leader==thisThread)leader=null;}}}}}finally{if(leader==null&&queue[0]!=null)available.signal();lock.unlock();}} 获取到任务之后,就会执行task的run()方法了,即ScheduledFutureTask.run(): publicvoidrun(){booleanperiodic=isPeriodic();if(!canRunInCurrentRunState(periodic))cancel(false);elseif(!periodic)ScheduledFutureTask.super.run();elseif(ScheduledFutureTask.super.runAndReset()){setNextRunTime();reExecutePeriodic(outerTask);}} 推荐阅读 JMM Java内存模型 happens-before那些事儿 为什么说LockSupport是Java并发的基石? FutureTask 原理剖析 你的ThreadLocal线程安全么 欢迎小伙伴 关注【TopCoder】 阅读更多精彩好文。 本文分享自微信公众号 - TopCoder(gh_12e4a74a5c9c)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Redis GeoHash核心原理解析

1. 引言 小麦同学是个吃货+技术宅,平日里就喜欢拿着手机地图点点按按来查询一些好玩的东西。某一天到北海公园游玩,肚肚饿了,于是乎打开手机地图,搜索北海公园附近的餐馆,并选了其中一家用餐。饱暖思yin欲的麦叔饭后思考地图后台如何根据自己所在位置查询来查询附近餐馆的呢?苦思冥想了半天,小麦想出了个方法:计算所在位置P与北京所有餐馆的距离,然后返回距离<=1000米的餐馆。小得意了一会儿,小麦发现北京的餐馆何其多啊,这样计算不得了,于是想了,既然知道经纬度了,那它应该知道自己在西城区,那应该计算所在位置P与西城区所有餐馆的距离啊,机机运用了递归的思想,想到了西城区也很多餐馆啊,应该计算所在位置P与所在街道所有餐馆的距离,这样计算量又小了,效率也提升了。 小麦的计算思想很朴素,就是通过过滤的方法来减小参与计算的餐馆数目,从某种角度上讲,机机在使用索引技术。 一提到索引,大家脑子里马上浮现出B树索引,因为大量的数据库(如MySQL、oracle、PostgreSQL等)都在使用B树。B树索引本质上是对索引字段进行排序,然后通过类似二分查找的方法进行快速查找,即它要求索引的字段是可排序的,一般而言,可排序的是一维字段,比如时间、年龄、薪水等等。但是对于空间上的一个点(二维,包括经度和纬度),如何排序呢?又如何索引呢?解决的方法很多,下文介绍一种方法来解决这一问题。 思想:如果能通过某种方法将二维的点数据转换成一维的数据,那样不就可以继续使用B树索引了嘛。那这种方法真的存在嘛,答案是肯定的。目前很火的GeoHash算法就是运用了上述思想,下面我们就开始GeoHash之旅吧。 2. 感性认识 先来两个干货,在线查看GPS某个区域的GeoHash值。 1. http://geohash.gofreerange.com/ 在这里插入图片描述 2. http://www.geohash.cn/ 跟更好用些 3. 通俗说 GeoHash将二维的经纬度转换成字符串,比如下图展示了北京9个区域的GeoHash字符串,分别是WX4ER,WX4G2、WX4G3等等,每一个字符串代表了某一矩形区域。也就是说,这个矩形区域内所有的点(经纬度坐标)都共享相同的GeoHash字符串,这样既可以保护隐私(只表示大概区域位置而不是具体的点),又比较容易做缓存,比如左上角这个区域内的用户不断发送位置信息请求餐馆数据,由于这些用户的GeoHash字符串都是WX4ER,所以可以把WX4ER当作key,把该区域的餐馆信息当作value来进行缓存,而如果不使用GeoHash的话,由于区域内的用户传来的经纬度是各不相同的,很难做缓存。字符串越长,表示的范围越精确。如图所示,5位的编码能表示10平方千米范围的矩形区域,而6位编码能表示更精细的区域(约0.34平方千米)字符串相似的表示距离相近(特殊情况后文阐述),这样可以利用字符串的前缀匹配来查询附近的POI信息。如下两个图所示,第一个在城区,第二个在郊区,城区的GeoHash字符串之间比较相似,郊区的字符串之间也比较相似,而城区和郊区的GeoHash字符串相似程度要低些。通过上面的介绍我们知道了GeoHash就是一种将经纬度转换成字符串的方法,并且使得在大部分情况下,字符串前缀匹配越多的距离越近,回到我们的案例,根据所在位置查询来查询附近餐馆时,只需要将所在位置经纬度转换成GeoHash字符串,并与各个餐馆的GeoHash字符串进行前缀匹配,匹配越多的距离越近。 4. GeoHash算法的步骤 下面以北海公园附近随便一个位置为例介绍GeoHash算法的计算步骤,先用百度 GPS反定位系统查找看下经纬度。纬度=116.395371,经度=39.931957。 根据经纬度计算GeoHash二进制编码 地球纬度区间是[-90,90], 北海公园的纬度是39.928167,可以通过下面算法对纬度39.928167进行逼近编码: 区间[-90,90]进行二分为[-90,0),[0,90],称为左右区间,可以确定39.928167属于右区间[0,90],给标记为1; 接着将区间[0,90]进行二分为 [0,45),[45,90],可以确定39.928167属于左区间 [0,45),给标记为0; 递归上述过程39.928167总是属于某个区间[a,b]。随着每次迭代区间[a,b]总在缩小,并越来越逼近39.928167; 如果给定的纬度x(39.928167)属于左区间,则记录0,如果属于右区间则记录1,这样随着算法的进行会产生一个序列1011100,序列的长度跟给定的区间划分次数有关。 39.928167 根据纬度算编码 bit min mid max 1 -90.000 0.000 90.000 0 0.000 45.000 90.000 1 0.000 22.500 45.000 1 22.500 33.750 45.000 1 33.750 39.375 45.000 0 39.375 42.188 45.000 0 39.375 40.7815 42.188 0 39.375 40.07825 40.7815 1 39.375 39.726625 40.07825 1 39.726625 39.9024375 40.07825 同理,地球经度区间是[-180,180],可以对经度116.389550进行编码。根据经度算编码 bit min mid max 1 -180 0.000 180 1 0.000 90 180 0 90 135 180 1 90 112.5 135 0 112.5 123.75 135 0 112.5 118.125 123.75 1 112.5 115.3125 118.125 0 115.3125 116.71875 118.125 1 115.3125 116.015625 116.71875 1 116.015625 116.3671875 116.71875 组码 通过上述计算,纬度产生的编码为10111 00011,经度产生的编码为11010 01011。偶数位放经度,奇数位放纬度,把2串编码组合生成新串:11100 11101 00100 01111。最后使用用0-9、b-z(去掉a, i, l, o)这32个字母进行base32编码,首先将11100 11101 00100 01111转成十进制,对应着28、29、4、15,十进制对应的编码就是wx4g。同理,将编码转换成经纬度的解码算法与之相反,具体不再赘述。 5. GeoHash Base32编码长度与精度 可以看出,当geohash base32编码长度为8时,精度在19米左右,而当编码长度为9时,精度在2米左右,编码长度需要根据数据情况进行选择。 一、经纬度距离换算 在纬度相等的情况下: 经度每隔0.00001度,距离相差约1米; 每隔0.0001度,距离相差约10米; 每隔0.001度,距离相差约100米; 每隔0.01度,距离相差约1000米; 每隔0.1度,距离相差约10000米。 在经度相等的情况下: 纬度每隔0.00001度,距离相差约1.1米; 每隔0.0001度,距离相差约11米; 每隔0.001度,距离相差约111米; 每隔0.01度,距离相差约1113米; 每隔0.1度,距离相差约11132米。 6. GeoHash算法 上文讲了GeoHash的计算步骤,仅仅说明是什么而没有说明为什么?为什么分别给经度和维度编码?为什么需要将经纬度两串编码交叉组合成一串编码?本节试图回答这一问题。 如下图所示,我们将二进制编码的结果填写到空间中,当将空间划分为四块时候,编码的顺序分别是左下角00,左上角01,右下脚10,右上角11,也就是类似于Z的曲线,当我们递归的将各个块分解成更小的子块时,编码的顺序是自相似的(分形),每一个子快也形成Z曲线,这种类型的曲线被称为Peano空间填充曲线。 这种类型的空间填充曲线的优点是将二维空间转换成一维曲线(事实上是分形维),对大部分而言,编码相似的距离也相近, 但Peano空间填充曲线最大的缺点就是突变性,有些编码相邻但距离却相差很远,比如0111与1000,编码是相邻的,但距离相差很大。 除Peano空间填充曲线外,还有很多空间填充曲线,如图所示,其中效果公认较好是Hilbert空间填充曲线,相较于Peano曲线而言,Hilbert曲线没有较大的突变。为什么GeoHash不选择Hilbert空间填充曲线呢?可能是Peano曲线思路以及计算上比较简单吧,事实上,Peano曲线就是一种四叉树线性编码方式。 7. 使用注意点 1. 临界问题 由于GeoHash是将区域划分为一个个规则矩形,并对每个矩形进行编码,这样在查询附近POI信息时会导致以下问题,比如红色的点是我们的位置,绿色的两个点分别是附近的两个餐馆,但是在查询的时候会发现距离较远餐馆的GeoHash编码与我们一样(因为在同一个GeoHash区域块上),而较近餐馆的GeoHash编码与我们不一致。这个问题往往产生在边界处。 解决的思路很简单,我们查询时,除了使用定位点的GeoHash编码进行匹配外,还使用周围8个区域的GeoHash编码,这样可以避免这个问题。 2. 注意点 我们已经知道现有的GeoHash算法使用的是Peano空间填充曲线,这种曲线会产生突变,造成了编码虽然相似但距离可能相差很大的问题,因此在查询附近餐馆时候,首先筛选GeoHash编码相似的POI(point of interest)点,然后进行实际距离计算。 3. 使用心得 GeoHash只是空间索引的一种方式,特别适合点数据,而对线、面数据采用R树索引更有优势(可为什么需要空间索引)。 GeoHash值可以区分精度,位数越多,精度越高,表达的地理位置越精细;如一位的GeoHash值把地球划分为32个矩形,8位的geohash值把地球划分为32^8个小矩形 适合根据某个经纬度坐标position计算出GeoHash值,然后和数据库中精度更高的GeoHash值做前缀比较 8.空间索引 常见问题:如何根据自己所在位置查询来查询附近50米的POI(point of interest,比如商家、景点等)呢(图1a)?每个POI都有经纬度信息,用图1b的SQL语句在mySQL中建立了POI_spatial的表,其中lat和lng两个字段来代表纬度和经度。为后续分析方便起见,我人造了40万个POI数据。 方法一:暴力方法 该方法的思路很直接:计算位置与所有POI的距离,并保留距离小于50米的POI。 插句题外话,计算经纬度之间的距离不能像求欧式距离那样平方开根号,因为地球是个不规整的球体(图2a),普通计算适合都是默认按最简单的完美球体假设,两点之间的距离函数应该如图2b所示。 该方法的复杂度为:40万*距离函数。我们将球体距离函数写为mysql存储过程distance,之后我们执行查询操作(图3),发现花费了4.66秒。 方法二:矩形过滤方法 该方法采用逐步细化的方式,一般分为两部: 先用矩形框过滤(图4a),判断一个点在矩形框内很简单,只要进行两次判断(LtMin<lat<LtMax; LnMin<lng<LnMax),落在矩形框内的POI个数为n(n<<40万); 用球面距离公式计算位置与矩形框内n个POI的距离(图4b),并保留距离小于50米的POI 矩形过滤方法的复杂度:40万矩形过滤函数 + n距离函数(n<<40万)。 根据这个思路我们执行SQl查询(图5)(注:经度或纬度每隔0.001度,距离相差约100米,由此推算出矩形左下角和右上角坐标),发现过滤后正好剩下两个POI。 此查询花费了0.36秒,相比于方法一查询时间大大降低,但是对于一次查询来说还是很长。时间长的原因在于遍历了40万次。 方法三:B树对经度或纬度建立索引 方法二耗时的原因在于执行了遍历操作,为了不进行遍历,我们自然想到了索引。我们对纬度进行了B树索引。 altertablepoi_spatialaddindexlatindex(lat);altertablepoi_spatialaddindexlngindex(lng); 此方法包括三个步骤: 通过B树快速找到某纬度范围的POI(图6a),个数为m(m<40万),复杂度为Log(40万)*过滤函数; 在步骤a过滤得到的m个POI中查找某经度范围的POI(图6b),个数为n(n<m),复杂度为m*过滤函数; 用球面距离公式计算位置与步骤b得到的n个POI的距离(图6c),并保留距离小于50米的POI 执行SQL查询(图7),发现时间已经大大降低,从方法2的0.36秒下降到0.01秒 三、B树能索引空间数据吗? 这时候有人会说了:方法三效果如此好,能够满足我们附近POI查询问题啊,看来B树用来索引空间数据也是可以的嘛!那么B树真的能够索引空间数据吗? 只能对经度或纬度索引(一维索引),与期望的不符 我们期待的是快速找出落在某一空间范围的POI(如矩形)(图8a),而不是快速找出落在某纬度或经度范围的POI(图8b),想象一下,我要查询北京某区的POI,但是B树索引不仅给我找出了北京的,还有与北京同一维度的天津、大同、甚至国外城市的POI,当数据量很大时,效率很低。 当数据是多维,比如三维(x,y,z),B树怎么索引?比如z可能是高程值,也可能是时间。有人会说B树其实可以对多个字段进行索引,但这时需要指定优先级,形成一个组合字段,而空间数据在各个维度方向上不存在优先级,我们不能说纬度比经度更重要,也不能说纬度比高程更重要。 当空间数据不是点,而是线(道路、地铁、河流等),面(行政区边界、建筑物等),B树怎么索引?对于面来说,它由一系列首尾相连的经纬度坐标点组成,一个面可能有成百上千个坐标,这时数据库怎么存储,B树怎么索引,这些都是问题。 既然传统的索引不能很好的索引空间数据,我们自然需要一种方法能对空间数据进行索引,即空间索引。 参考 Java实现GPS范围查找 浙大大佬通俗说GPS 本文分享自微信公众号 - sowhat1412(sowhat9094)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

深入理解Flutter动画原理

一、概述[](http://gityuan.com/2019/07/13/flutter_animator/#一概述) 动画效果对于系统的用户体验非常重要,好的动画能让用户感觉界面更加顺畅,提升用户体验。 1.1 动画类型[](http://gityuan.com/2019/07/13/flutter_animator/#11-动画类型) Flutter动画大的分类来说主要分为两大类: 补间动画:给定初值与终值,系统自动补齐中间帧的动画 物理动画:遵循物理学定律的动画,实现了弹簧、阻尼、重力三种物理效果 在应用使用过程中常见动画模式: 动画列表或者网格:例如元素的添加或者删除操作; 转场动画Shared element transition:例如从当前页面打开另一页面的过渡动画; 交错动画Staggered animations:比如部分或者完全交错的动画。 1.2 类图[](http://gityuan.com/2019/07/13/flutter_animator/#12-类图) 核心类: Animation对象是整个动画中非常核心的一个类; AnimationController用于管理Animation; CurvedAnimation过程是非线性曲线; Tween补间动画 Listeners和StatusListeners用于监听动画状态改变。 AnimationStatus是枚举类型,有4个值; 取值 解释 dismissed 动画在开始时停止 forward 动画从头到尾绘制 reverse 动画反向绘制,从尾到头 completed 动画在结束时停止 1.3 动画实例[](http://gityuan.com/2019/07/13/flutter_animator/#13-动画实例) //[见小节2.1] AnimationController animationController = AnimationController( vsync: this, duration: Duration(milliseconds: 1000)); Animation animation = Tween(begin: 0.0,end: 10.0).animate(animationController); animationController.addListener(() { setState(() {}); }); //[见小节2.2] animationController.forward(); 该过程说明: AnimationController作为Animation子类,在屏幕刷新时生成一系列值,默认情况下从0到1区间的取值。 Tween的animate()方法来自于父类Animatable,该方法返回的对象类型为_AnimatedEvaluation,而该对象最核心的工作就是通过value来调用Tween的transform(); 调用链: AnimationController.forward AnimationController.\_animateToInternal AnimationController.\_startSimulation Ticker.start() Ticker.scheduleTick() SchedulerBinding.scheduleFrameCallback() SchedulerBinding.scheduleFrame() ... Ticker.\_tick AnimationController.\_tick Ticker.scheduleTick 二、原理分析[](http://gityuan.com/2019/07/13/flutter_animator/#二原理分析) 2.1 AnimationController初始化[](http://gityuan.com/2019/07/13/flutter_animator/#21-animationcontroller初始化) [-> lib/src/animation/animation_controller.dart] AnimationController({ double value, this.duration, this.debugLabel, this.lowerBound = 0.0, this.upperBound = 1.0, this.animationBehavior = AnimationBehavior.normal, @required TickerProvider vsync, }) : _direction = _AnimationDirection.forward { _ticker = vsync.createTicker(_tick); //[见小节2.1.1] _internalSetValue(value ?? lowerBound); //[见小节2.1.3] } 该方法说明: AnimationController初始化过程,一般都设置duration和vsync初值; upperBound(上边界值)和lowerBound(下边界值)都不能为空,且upperBound必须大于等于lowerBound; 创建默认的动画方向为向前(_AnimationDirection.forward); 调用类型为TickerProvider的vsync对象的createTicker()方法来创建Ticker对象; TickerProvider作为抽象类,主要的子类有SingleTickerProviderStateMixin和TickerProviderStateMixin,这两个类的区别就是是否支持创建多个TickerProvider,这里SingleTickerProviderStateMixin为例展开。 2.1.1 createTicker[](http://gityuan.com/2019/07/13/flutter_animator/#211-createticker) [-> lib/src/widgets/ticker_provider.dart] mixin SingleTickerProviderStateMixin<T extends StatefulWidget> on State<T> implements TickerProvider { Ticker _ticker; Ticker createTicker(TickerCallback onTick) { //[见小节2.1.2] _ticker = Ticker(onTick, debugLabel: 'created by $this'); return _ticker; } 2.1.2 Ticker初始化[](http://gityuan.com/2019/07/13/flutter_animator/#212-ticker初始化) [-> lib/src/scheduler/ticker.dart] class Ticker { Ticker(this._onTick, { this.debugLabel }) { } final TickerCallback _onTick; } 将AnimationControllerd对象中的_tick()方法,赋值给Ticker对象的_onTick成员变量,再来看看该_tick方法。 2.1.3 _internalSetValue[](http://gityuan.com/2019/07/13/flutter_animator/#213-_internalsetvalue) [-> lib/src/animation/animation_controller.dart ::AnimationController] void _internalSetValue(double newValue) { _value = newValue.clamp(lowerBound, upperBound); if (_value == lowerBound) { _status = AnimationStatus.dismissed; } else if (_value == upperBound) { _status = AnimationStatus.completed; } else { _status = (_direction == _AnimationDirection.forward) ? AnimationStatus.forward : AnimationStatus.reverse; } } 根据当前的value值来初始化动画状态_status 2.2 forward[](http://gityuan.com/2019/07/13/flutter_animator/#22-forward) [-> lib/src/animation/animation_controller.dart ::AnimationController] TickerFuture forward({ double from }) { //默认采用向前的动画方向 _direction = _AnimationDirection.forward; if (from != null) value = from; return _animateToInternal(upperBound); //[见小节2.3] } _AnimationDirection是枚举类型,有forward(向前)和reverse(向后)两个值,也就是说该方法的功能是指从from开始向前滑动, 2.3 _animateToInternal[](http://gityuan.com/2019/07/13/flutter_animator/#23-_animatetointernal) [-> lib/src/animation/animation_controller.dart ::AnimationController] TickerFuture _animateToInternal(double target, { Duration duration, Curve curve = Curves.linear }) { double scale = 1.0; if (SemanticsBinding.instance.disableAnimations) { switch (animationBehavior) { case AnimationBehavior.normal: scale = 0.05; break; case AnimationBehavior.preserve: break; } } Duration simulationDuration = duration; if (simulationDuration == null) { final double range = upperBound - lowerBound; final double remainingFraction = range.isFinite ? (target - _value).abs() / range : 1.0; //根据剩余动画的百分比来评估仿真动画剩余时长 simulationDuration = this.duration * remainingFraction; } else if (target == value) { //已到达动画终点,不再执行动画 simulationDuration = Duration.zero; } //停止老的动画[见小节2.3.1] stop(); if (simulationDuration == Duration.zero) { if (value != target) { _value = target.clamp(lowerBound, upperBound); notifyListeners(); } _status = (_direction == _AnimationDirection.forward) ? AnimationStatus.completed : AnimationStatus.dismissed; _checkStatusChanged(); //当动画执行时间已到,则直接结束 return TickerFuture.complete(); } //[见小节2.4] return _startSimulation(_InterpolationSimulation(_value, target, simulationDuration, curve, scale)); } 默认采用的是线性动画曲线Curves.linear。 2.3.1 AnimationController.stop[](http://gityuan.com/2019/07/13/flutter_animator/#231-animationcontrollerstop) void stop({ bool canceled = true }) { _simulation = null; _lastElapsedDuration = null; //[见小节2.3.2] _ticker.stop(canceled: canceled); } 2.3.2 Ticker.stop[](http://gityuan.com/2019/07/13/flutter_animator/#232-tickerstop) [-> lib/src/scheduler/ticker.dart] void stop({ bool canceled = false }) { if (!isActive) //已经不活跃,则直接返回 return; final TickerFuture localFuture = _future; _future = null; _startTime = null; //[见小节2.3.3] unscheduleTick(); if (canceled) { localFuture._cancel(this); } else { localFuture._complete(); } } 2.3.3 Ticker.unscheduleTick[](http://gityuan.com/2019/07/13/flutter_animator/#233-tickerunscheduletick) [-> lib/src/scheduler/ticker.dart] void unscheduleTick() { if (scheduled) { SchedulerBinding.instance.cancelFrameCallbackWithId(_animationId); _animationId = null; } } 2.3.4 _InterpolationSimulation初始化[](http://gityuan.com/2019/07/13/flutter_animator/#234-_interpolationsimulation初始化) [-> lib/src/animation/animation_controller.dart ::_InterpolationSimulation] class _InterpolationSimulation extends Simulation { _InterpolationSimulation(this._begin, this._end, Duration duration, this._curve, double scale) : _durationInSeconds = (duration.inMicroseconds * scale) / Duration.microsecondsPerSecond; final double _durationInSeconds; final double _begin; final double _end; final Curve _curve; } 该方法创建插值模拟器对象,并初始化起点、终点、动画曲线以及时长。这里用的Curve是线性模型,也就是说采用的是匀速运动。 2.4 _startSimulation[](http://gityuan.com/2019/07/13/flutter_animator/#24-_startsimulation) [-> lib/src/animation/animation_controller.dart] TickerFuture _startSimulation(Simulation simulation) { _simulation = simulation; _lastElapsedDuration = Duration.zero; _value = simulation.x(0.0).clamp(lowerBound, upperBound); //[见小节2.5] final TickerFuture result = _ticker.start(); _status = (_direction == _AnimationDirection.forward) ? AnimationStatus.forward : AnimationStatus.reverse; //[见小节2.4.1] _checkStatusChanged(); return result; } 2.4.1 _checkStatusChanged[](http://gityuan.com/2019/07/13/flutter_animator/#241-_checkstatuschanged) [-> lib/src/animation/animation_controller.dart] void _checkStatusChanged() { final AnimationStatus newStatus = status; if (_lastReportedStatus != newStatus) { _lastReportedStatus = newStatus; notifyStatusListeners(newStatus); //通知状态改变 } } 这里会回调_statusListeners中的所有状态监听器,这里的状态就是指AnimationStatus的dismissed、forward、reverse以及completed。 2.5 Ticker.start[](http://gityuan.com/2019/07/13/flutter_animator/#25-tickerstart) [-> lib/src/scheduler/ticker.dart] TickerFuture start() { _future = TickerFuture._(); if (shouldScheduleTick) { scheduleTick(); //[见小节2.6] } if (SchedulerBinding.instance.schedulerPhase.index > SchedulerPhase.idle.index && SchedulerBinding.instance.schedulerPhase.index < SchedulerPhase.postFrameCallbacks.index) _startTime = SchedulerBinding.instance.currentFrameTimeStamp; return _future; } 此处的shouldScheduleTick等于!muted && isActive && !scheduled,也就是没有调度过的活跃状态才会调用Tick。 2.6 Ticker.scheduleTick[](http://gityuan.com/2019/07/13/flutter_animator/#26-tickerscheduletick) [-> lib/src/scheduler/ticker.dart] void scheduleTick({ bool rescheduling = false }) { //[见小节2.7] _animationId = SchedulerBinding.instance.scheduleFrameCallback(_tick, rescheduling: rescheduling); } 此处的_tick会在下一次vysnc触发时回调执行,见小节2.10。 2.7 scheduleFrameCallback[](http://gityuan.com/2019/07/13/flutter_animator/#27-scheduleframecallback) [-> lib/src/scheduler/binding.dart] int scheduleFrameCallback(FrameCallback callback, { bool rescheduling = false }) { //[见小节2.8] scheduleFrame(); _nextFrameCallbackId += 1; _transientCallbacks[_nextFrameCallbackId] = _FrameCallbackEntry(callback, rescheduling: rescheduling); return _nextFrameCallbackId; } 将前面传递过来的Ticker._tick()方法保存在_FrameCallbackEntry的callback中,然后将_FrameCallbackEntry记录在Map类型的_transientCallbacks, 2.8 scheduleFrame[](http://gityuan.com/2019/07/13/flutter_animator/#28-scheduleframe) [-> lib/src/scheduler/binding.dart] void scheduleFrame() { if (_hasScheduledFrame || !_framesEnabled) return; ui.window.scheduleFrame(); _hasScheduledFrame = true; } 从文章Flutter之setState更新机制,可知此处调用的ui.window.scheduleFrame(),会注册vsync监听。当当下一次vsync信号的到来时会执行handleBeginFrame()。 2.9 handleBeginFrame[](http://gityuan.com/2019/07/13/flutter_animator/#29-handlebeginframe) [-> lib/src/scheduler/binding.dart:: SchedulerBinding] void handleBeginFrame(Duration rawTimeStamp) { Timeline.startSync('Frame', arguments: timelineWhitelistArguments); _firstRawTimeStampInEpoch ??= rawTimeStamp; _currentFrameTimeStamp = _adjustForEpoch(rawTimeStamp ?? _lastRawTimeStamp); if (rawTimeStamp != null) _lastRawTimeStamp = rawTimeStamp; ... //此时阶段等于SchedulerPhase.idle; _hasScheduledFrame = false; try { Timeline.startSync('Animate', arguments: timelineWhitelistArguments); _schedulerPhase = SchedulerPhase.transientCallbacks; //执行动画的回调方法 final Map<int, _FrameCallbackEntry> callbacks = _transientCallbacks; _transientCallbacks = <int, _FrameCallbackEntry>{}; callbacks.forEach((int id, _FrameCallbackEntry callbackEntry) { if (!_removedIds.contains(id)) _invokeFrameCallback(callbackEntry.callback, _currentFrameTimeStamp, callbackEntry.debugStack); }); _removedIds.clear(); } finally { _schedulerPhase = SchedulerPhase.midFrameMicrotasks; } } 该方法主要功能是遍历_transientCallbacks,从前面小节[2.7],可知该过程会执行Ticker._tick()方法。 2.10 Ticker._tick[](http://gityuan.com/2019/07/13/flutter_animator/#210-ticker_tick) [-> lib/src/scheduler/ticker.dart] void _tick(Duration timeStamp) { _animationId = null; _startTime ??= timeStamp; //[见小节2.11] _onTick(timeStamp - _startTime); //根据活跃状态来决定是否再次调度 if (shouldScheduleTick) scheduleTick(rescheduling: true); } 该方法主要功能: 小节[2.1.2]的Ticker初始化中,可知此处_onTick便是AnimationController的_tick()方法; 小节[2.5]已介绍当仍处于活跃状态,则会再次调度,回到小节[2.6]的scheduleTick(),从而形成动画的连续绘制过程。 2.11 AnimationController._tick[](http://gityuan.com/2019/07/13/flutter_animator/#211-animationcontroller_tick) [-> lib/src/animation/animation_controller.dart] void _tick(Duration elapsed) { _lastElapsedDuration = elapsed; //获取已过去的时长 final double elapsedInSeconds = elapsed.inMicroseconds.toDouble() / Duration.microsecondsPerSecond; _value = _simulation.x(elapsedInSeconds).clamp(lowerBound, upperBound); if (_simulation.isDone(elapsedInSeconds)) { _status = (_direction == _AnimationDirection.forward) ? AnimationStatus.completed : AnimationStatus.dismissed; stop(canceled: false); //当动画已完成,则停止 } notifyListeners(); //通知监听器[见小节2.11.1] _checkStatusChanged(); //通知状态监听器[见小节2.11.2] } 2.11.1 notifyListeners[](http://gityuan.com/2019/07/13/flutter_animator/#2111-notifylisteners) [-> lib/src/animation/listener_helpers.dart ::AnimationLocalListenersMixin] void notifyListeners() { final List<VoidCallback> localListeners = List<VoidCallback>.from(_listeners); for (VoidCallback listener in localListeners) { try { if (_listeners.contains(listener)) listener(); } catch (exception, stack) { ... } } } AnimationLocalListenersMixin的addListener()会向_listeners中添加监听器 2.11.2 _checkStatusChanged[](http://gityuan.com/2019/07/13/flutter_animator/#2112-_checkstatuschanged) [-> lib/src/animation/listener_helpers.dart ::AnimationLocalStatusListenersMixin] void notifyStatusListeners(AnimationStatus status) { final List<AnimationStatusListener> localListeners = List<AnimationStatusListener>.from(_statusListeners); for (AnimationStatusListener listener in localListeners) { try { if (_statusListeners.contains(listener)) listener(status); } catch (exception, stack) { ... } } } 从前面的小节[2.4.1]可知,当状态改变时会调用notifyStatusListeners方法。AnimationLocalStatusListenersMixin的addStatusListener()会向_statusListeners添加状态监听器。 三、总结[](http://gityuan.com/2019/07/13/flutter_animator/#三总结) 3.1 动画流程图[](http://gityuan.com/2019/07/13/flutter_animator/#31-动画流程图) 推荐阅读:腾讯技术团队整理,万字长文轻松彻底入门 Flutter,秒变大前端 2017-2020历年字节跳动Android面试真题解析(累计下载1082万次,持续更新中) 原文作者:gityuan原文链接:http://gityuan.com/2019/07/13/flutter_animator/

优秀的个人博客,低调大师

深入学习和理解 Redux

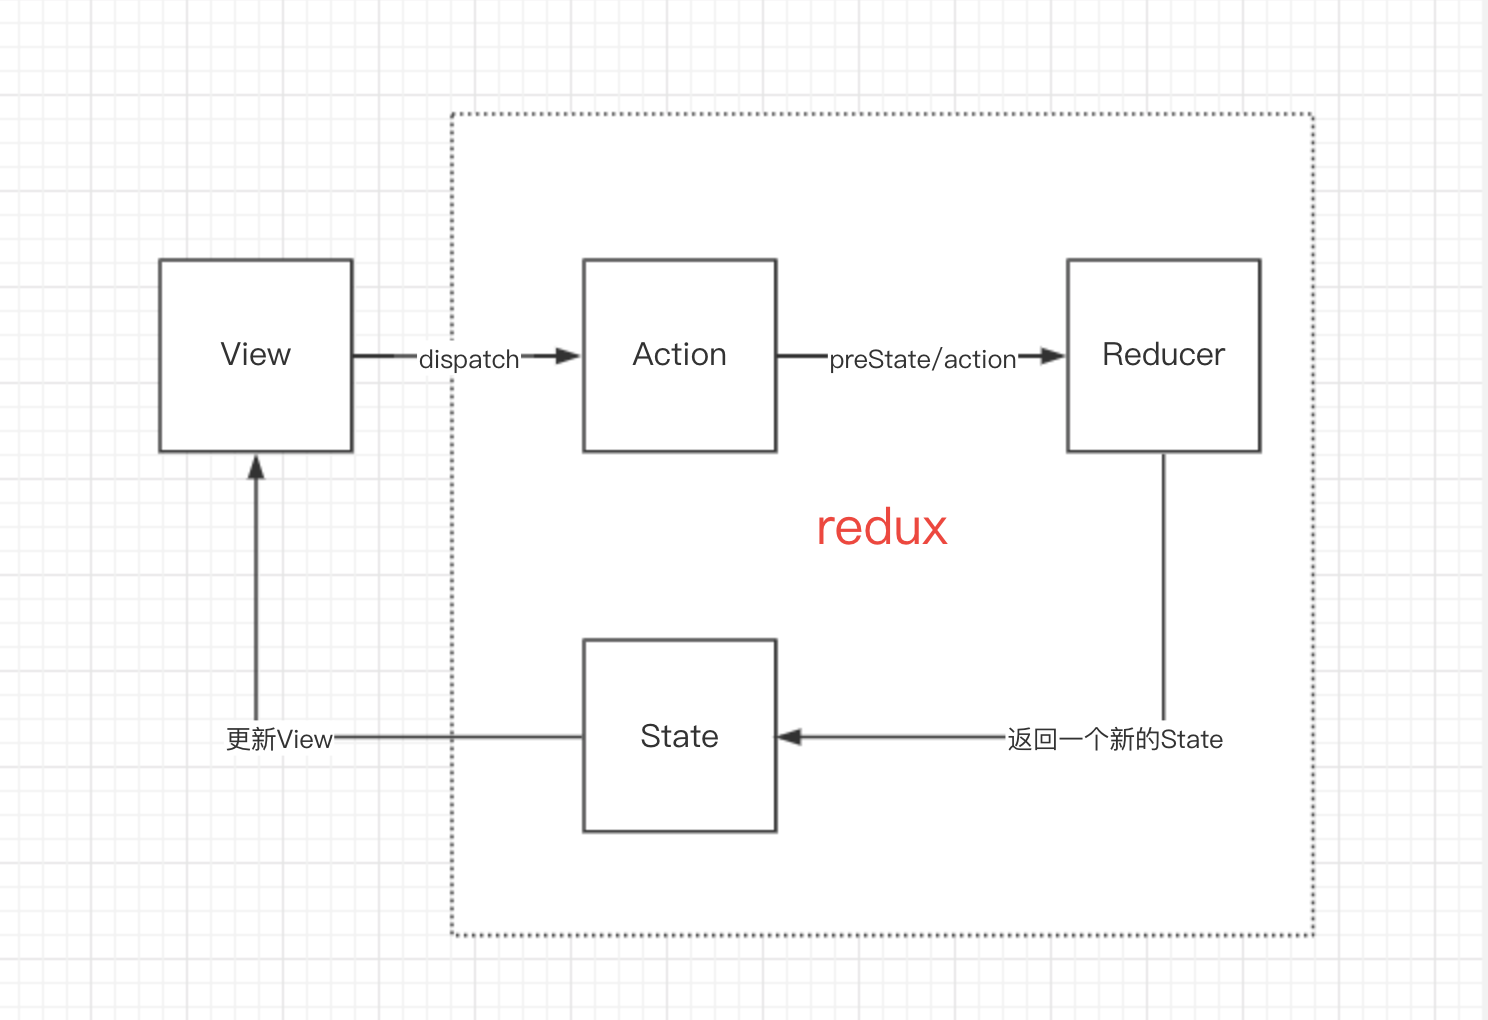
本文首发于 vivo互联网技术 微信公众号 链接:https://mp.weixin.qq.com/s/jhgQXKp4srsl9_VYMTZXjQ 作者:曾超 Redux官网上是这样描述Redux,Redux is a predictable state container for JavaScript apps.(Redux是JavaScript状态容器,提供可预测性的状态管理)。目前Redux GitHub有5w多star,足以说明 Redux 受欢迎的程度。 一、Why Redux 在说为什么用 Redux 之前,让我们先聊聊组件通信有哪些方式。常见的组件通信方式有以下几种: 父子组件:props、state/callback回调来进行通信 单页面应用:路由传值 全局事件比如EventEmitter监听回调传值 react中跨层级组件数据传递Context(上下文) 在小型、不太复杂的应用中,一般用以上几种组件通信方式基本就足够了。 但随着应用逐渐复杂,数据状态过多(比如服务端响应数据、浏览器缓存数据、UI状态值等)以及状态可能会经常发生变化的情况下,使用以上组件通信方式会很复杂、繁琐以及很难定位、调试相关问题。 因此状态管理框架(如 Vuex、MobX、Redux等)就显得十分必要了,而 Redux 就是其中使用最广、生态最完善的。 二、Redux Data flow 在一个使用了 Redux 的 App应用里面会遵循下面四步: 第一步:通过store.dispatch(action)来触发一个action,action就是一个描述将要发生什么的对象。如下: {type:'LIKE_ARTICLE',articleId:42} { type: 'FETCH_USER_SUCCESS', response: { id: 3, name: 'Mary' } } {type:'ADD_TODO',text:'金融前端.'} 第二步:Redux会调用你提供的 Reducer函数。 第三步:根 Reducer 会将多个不同的 Reducer 函数合并到单独的状态树中。 第四步:Redux store会保存从根 Reducer 函数返回的完整状态树。 所谓一图胜千言,下面我们结合 Redux 的数据流图来熟悉这一过程。 三、Three Principles(三大原则) 1、Single source of truth:单一数据源,整个应用的state被存储在一个对象树中,并且只存在于唯一一个store中。 2、State is read-only:state里面的状态是只读的,不能直接去修改state,只能通过触发action来返回一个新的state。 3、Changes are made with pure functions:要使用纯函数来修改state。 四、Redux源码解析 Redux 源码目前有js和ts版本,本文先介绍 js 版本的 Redux 源码。Redux 源码行数不多,所以对于想提高源码阅读能力的开发者来说,很值得前期来学习。 Redux源码主要分为6个核心js文件和3个工具js文件,核心js文件分别为index.js、createStore.js、compose.js、combineRuducers.js、bindActionCreators.js和applyMiddleware.js文件。 接下来我们来一一学习。 1、index.js index.js是入口文件,提供核心的API,如createStore、combineReducers、applyMiddleware等。 export { createStore, combineReducers, bindActionCreators, applyMiddleware, compose, __DO_NOT_USE__ActionTypes } 2、createStore.js createStore是 Redux 提供的API,用来生成唯一的store。store提供getState、dispatch、subscibe等方法,Redux 中的store只能通过dispatch一个action,通过action来找对应的 Reducer函数来改变。 export default function createStore(reducer, preloadedState, enhancer) { ... } 从源码中可以知道,createStore接收三个参数:Reducer、preloadedState、enhancer。 Reducer是action对应的一个可以修改store中state的纯函数。 preloadedState代表之前state的初始化状态。 enhancer是中间件通过applyMiddleware生成的一个加强函数。store中的getState方法是获取当前应用中store中的状态树。 /** * Reads the state tree managed by the store. * * @returns {any} The current state tree of your application. */ function getState() { if (isDispatching) { throw new Error( 'You may not call store.getState() while the reducer is executing. ' + 'The reducer has already received the state as an argument. ' + 'Pass it down from the top reducer instead of reading it from the store.' ) } return currentState } dispatch方法是用来分发一个action的,这是唯一的一种能触发状态发生改变的方法。subscribe是一个监听器,当一个action被dispatch的时候或者某个状态发生改变的时候会被调用。 3、combineReducers.js /** * Turns an object whose values are different reducer functions, into a single * reducer function. It will call every child reducer, and gather their results * into a single state object, whose keys correspond to the keys of the passed * reducer functions. */ export default function combineReducers(reducers) { const reducerKeys = Object.keys(reducers) ... return function combination(state = {}, action) { ... let hasChanged = false const nextState = {} for (let i = 0; i < finalReducerKeys.length; i++) { const key = finalReducerKeys[i] const reducer = finalReducers[key] const previousStateForKey = state[key] const nextStateForKey = reducer(previousStateForKey, action) if (typeof nextStateForKey === 'undefined') { const errorMessage = getUndefinedStateErrorMessage(key, action) throw new Error(errorMessage) } nextState[key] = nextStateForKey //判断state是否发生改变 hasChanged = hasChanged || nextStateForKey !== previousStateForKey } //根据是否发生改变,来决定返回新的state还是老的state return hasChanged ? nextState : state } } 从源码可以知道,入参是 Reducers,返回一个function。combineReducers就是将所有的 Reducer合并成一个大的 Reducer 函数。核心关键的地方就是每次 Reducer 返回新的state的时候会和老的state进行对比,如果发生改变,则hasChanged为true,触发页面更新。反之,则不做处理。 4、bindActionCreators.js /** * Turns an object whose values are action creators, into an object with the * same keys, but with every function wrapped into a `dispatch` call so they * may be invoked directly. This is just a convenience method, as you can call * `store.dispatch(MyActionCreators.doSomething())` yourself just fine. */ function bindActionCreator(actionCreator, dispatch) { return function() { return dispatch(actionCreator.apply(this, arguments)) } } export default function bindActionCreators(actionCreators, dispatch) { if (typeof actionCreators === 'function') { return bindActionCreator(actionCreators, dispatch) } ... ... const keys = Object.keys(actionCreators) const boundActionCreators = {} for (let i = 0; i < keys.length; i++) { const key = keys[i] const actionCreator = actionCreators[key] if (typeof actionCreator === 'function') { boundActionCreators[key] = bindActionCreator(actionCreator, dispatch) } } return boundActionCreators } bindActionCreator是将单个actionCreator绑定到dispatch上,bindActionCreators就是将多个actionCreators绑定到dispatch上。 bindActionCreator就是将发送actions的过程简化,当调用这个返回的函数时就自动调用dispatch,发送对应的action。 bindActionCreators根据不同类型的actionCreators做不同的处理,actionCreators是函数就返回函数,是对象就返回一个对象。主要是将actions转化为dispatch(action)格式,方便进行actions的分离,并且使代码更加简洁。 5、compose.js /** * Composes single-argument functions from right to left. The rightmost * function can take multiple arguments as it provides the signature for * the resulting composite function. * * @param {...Function} funcs The functions to compose. * @returns {Function} A function obtained by composing the argument functions * from right to left. For example, compose(f, g, h) is identical to doing * (...args) => f(g(h(...args))). */ export default function compose(...funcs) { if (funcs.length === 0) { return arg => arg } if (funcs.length === 1) { return funcs[0] } return funcs.reduce((a, b) => (...args) => a(b(...args))) } compose是函数式变成里面非常重要的一个概念,在介绍compose之前,先来认识下什么是 Reduce?官方文档这么定义reduce:reduce()方法对累加器和数组中的每个元素(从左到右)应用到一个函数,简化为某个值。compose是柯里化函数,借助于Reduce来实现,将多个函数合并到一个函数返回,主要是在middleware中被使用。 6、applyMiddleware.js /** * Creates a store enhancer that applies middleware to the dispatch method * of the Redux store. This is handy for a variety of tasks, such as expressing * asynchronous actions in a concise manner, or logging every action payload. */ export default function applyMiddleware(...middlewares) { return createStore => (...args) => { const store = createStore(...args) ... ... return { ...store, dispatch } } } applyMiddleware.js文件提供了middleware中间件重要的API,middleware中间件主要用来对store.dispatch进行重写,来完善和扩展dispatch功能。 那为什么需要中间件呢? 首先得从Reducer说起,之前 Redux三大原则里面提到了reducer必须是纯函数,下面给出纯函数的定义: 对于同一参数,返回同一结果 结果完全取决于传入的参数 不产生任何副作用 至于为什么reducer必须是纯函数,可以从以下几点说起? 因为 Redux 是一个可预测的状态管理器,纯函数更便于 Redux进行调试,能更方便的跟踪定位到问题,提高开发效率。 Redux 只通过比较新旧对象的地址来比较两个对象是否相同,也就是通过浅比较。如果在 Reducer 内部直接修改旧的state的属性值,新旧两个对象都指向同一个对象,如果还是通过浅比较,则会导致 Redux 认为没有发生改变。但要是通过深比较,会十分耗费性能。最佳的办法是 Redux返回一个新对象,新旧对象通过浅比较,这也是 Reducer是纯函数的重要原因。 Reducer是纯函数,但是在应用中还是会需要处理记录日志/异常、以及异步处理等操作,那该如何解决这些问题呢? 这个问题的答案就是中间件。可以通过中间件增强dispatch的功能,示例(记录日志和异常)如下: const store = createStore(reducer); const next = store.dispatch; // 重写store.dispatch store.dispatch = (action) => { try { console.log('action:', action); console.log('current state:', store.getState()); next(action); console.log('next state', store.getState()); } catch (error){ console.error('msg:', error); } } 五、从零开始实现一个简单的Redux 既然是要从零开始实现一个Redux(简易计数器),那么在此之前我们先忘记之前提到的store、Reducer、dispatch等各种概念,只需牢记Redux是一个状态管理器。 首先我们来看下面的代码: let state = { count : 1 } //修改之前 console.log (state.count); //修改count的值为2 state.count = 2; //修改之后 console.log (state.count); 我们定义了一个有count字段的state对象,同时能输出修改之前和修改之后的count值。但此时我们会发现一个问题?就是其它如果引用了count的地方是不知道count已经发生修改的,因此我们需要通过订阅-发布模式来监听,并通知到其它引用到count的地方。因此我们进一步优化代码如下: let state = { count: 1 }; //订阅 function subscribe (listener) { listeners.push(listener); } function changeState(count) { state.count = count; for (let i = 0; i < listeners.length; i++) { const listener = listeners[i]; listener();//监听 } } 此时我们对count进行修改,所有的listeners都会收到通知,并且能做出相应的处理。但是目前还会存在其它问题?比如说目前state只含有一个count字段,如果要是有多个字段是否处理方式一致。同时还需要考虑到公共代码需要进一步封装,接下来我们再进一步优化: const createStore = function (initState) { let state = initState; //订阅 function subscribe (listener) { listeners.push(listener); } function changeState (count) { state.count = count; for (let i = 0; i < listeners.length; i++) { const listener = listeners[i]; listener();//通知 } } function getState () { return state; } return { subscribe, changeState, getState } } 我们可以从代码看出,最终我们提供了三个API,是不是与之前Redux源码中的核心入口文件index.js比较类似。但是到这里还没有实现Redux,我们需要支持添加多个字段到state里面,并且要实现Redux计数器。 let initState = { counter: { count : 0 }, info: { name: '', description: '' } } let store = createStore(initState); //输出count store.subscribe(()=>{ let state = store.getState(); console.log(state.counter.count); }); //输出info store.subscribe(()=>{ let state = store.getState(); console.log(`${state.info.name}:${state.info.description}`); }); 通过测试,我们发现目前已经支持了state里面存多个属性字段,接下来我们把之前changeState改造一下,让它能支持自增和自减。 //自增 store.changeState({ count: store.getState().count + 1 }); //自减 store.changeState({ count: store.getState().count - 1 }); //随便改成什么 store.changeState({ count:金融 }); 我们发现可以通过changeState自增、自减或者随便改,但这其实不是我们所需要的。我们需要对修改count做约束,因为我们在实现一个计数器,肯定是只希望能进行加减操作的。所以我们接下来对changeState做约束,约定一个plan方法,根据type来做不同的处理。 function plan (state, action) => { switch (action.type) { case 'INCREMENT': return { ...state, count: state.count + 1 } case 'DECREMENT': return { ...state, count: state.count - 1 } default: return state } } let store = createStore(plan, initState); //自增 store.changeState({ type: 'INCREMENT' }); //自减 store.changeState({ type: 'DECREMENT' }); 我们在代码中已经对不同type做了不同处理,这个时候我们发现再也不能随便对state中的count进行修改了,我们已经成功对changeState做了约束。我们把plan方法做为createStore的入参,在修改state的时候按照plan方法来执行。到这里,恭喜大家,我们已经用Redux实现了一个简单计数器了。 这就实现了 Redux?这怎么和源码不一样啊 然后我们再把plan换成reducer,把changeState换成dispatch就会发现,这就是Redux源码所实现的基础功能,现在再回过头看Redux的数据流图是不是更加清晰了。 六、Redux Devtools Redux devtools是Redux的调试工具,可以在Chrome上安装对应的插件。对于接入了Redux的应用,通过 Redux devtools可以很方便看到每次请求之后所发生的改变,方便开发同学知道每次操作后的前因后果,大大提升开发调试效率。 如上图所示就是 Redux devtools的可视化界面,左边操作界面就是当前页面渲染过程中执行的action,右侧操作界面是State存储的数据,从State切换到action面板,可以查看action对应的 Reducer参数。切换到Diff面板,可以查看前后两次操作发生变化的属性值。 七、总结 Redux 是一款优秀的状态管理器,源码短小精悍,社区生态也十分成熟。如常用的react-redux、dva都是对 Redux 的封装,目前在大型应用中被广泛使用。这里推荐通过Redux官网以及源码来学习它核心的思想,进而提升阅读源码的能力。

优秀的个人博客,低调大师

深入理解JVM - 方法调用

方法调用并不等同于方法中的代码被执行,方法调用阶段唯一的任务就是确定被调用方法的版本(即调用哪一个方法),暂时还未涉及方法内部的具体运行过程。一切方法调用在Class文件里面存储的都只是符号引用,而不是方法在实际运行时内存布局中的入口地址(也就是之前说的直接引用)。 解析 所有方法调用的目标方法在Class文件里面都是一个常量池中的符号引用,在类加载的解析阶段,会将其中的一部分符号引用转化为直接引用,这种解析能够成立的前提是:方法在程序真正运行之前就有一个可确定的调用版本,并且这个方法的调用版本在运行期是不可改变的。换句话说,调用目标在程序代码写好、编译器进行编译那一刻就已经确定下来。这类方法的调用被称为解析(Resolution),在Java语言中符合这种要求的主要有静态方法和私有方法。 方法调用指令 invokestatic:用于调用静态方法。 invokespecial:用于调用实例构造器<init>()方法、私有方法和父类中的方法。 invokevirtual:用于调用所有的虚方法。 invokeinterface:用于调用接口方法,会在运行时再确定一个实现该接口的对象。 invokedynamic:先在运行时动态解析出调用点限定符所引用的方法,然后再执行该方法。 前面4条调用指令,分派逻辑都固化在Java虚拟机内部,而invokedynamic指令的分派逻辑是由用户设定的引导方法来决定的。 方法分类 在java语言中方法主要分为“虚方法”和“非虚方法”。 非虚方法:在类加载的时候就可以把符号引用解析为该方法的直接引用。比如:静态方法、私有方法、实例构造器、父类方法和被final修饰的方法。 虚方法:需要在运行时才能将符号引用转换成直接引用,如,分派。 分派 分派(Dispatch)它可能是静态的也可能是动态的,按照分派依据的宗量数可分为单分派和多分派。这两类分派方式两两组合就构成了静态单分派、静态多分派、动态单分派、动态多分派4种分派组合情况。 静态分派 依赖静态类型来决定方法执行版本的分派动作,都称为静态分派。静态分派的最典型应用表现就是方法重载,虚拟机(或者准确地说是编译器)在重载时是通过参数的静态类型来作为判定依据的。 public class StaticDispatch { static abstract class Human { } static class Man extends Human { } static class Woman extends Human { } public void sayHello(Human guy) { System.out.println("hello,guy!"); } public void sayHello(Man guy) { System.out.println("hello,gentleman!"); } public void sayHello(Woman guy) { System.out.println("hello,lady!"); } public static void main(String[] args) { Human man = new Man(); Human woman = new Woman(); StaticDispatch sr = new StaticDispatch(); sr.sayHello(man); sr.sayHello(woman); } } 运行结果: hello,guy! hello,guy! Human man = new Man(); 这里的Human 就是变量的“静态类型”(Static Type),或者叫“外观类型”(Apparent Type);Man就是变量的“实际类型”(Actual Type)或者叫“运行时类型”(Runtime Type)。 动态分派 我们把在运行期根据实际类型确定方法执行版本的分派过程称为动态分派。最典型的表现就是重写。 public class DynamicDispatch { static abstract class Human { abstract void sayHello(); } static class Man extends Human { public void sayHello() { System.out.println("hello,Man!"); } } static class Woman extends Human { public void sayHello() { System.out.println("hello,Woman!"); } } public static void main(String[] args) { Human man = new Man(); Human woman = new Woman(); man.sayHello(); woman.sayHello(); } } 运行结果: hello,Man! hello,Woman! 我们通过javap命令看下main方法的字节码: ... public static void main(java.lang.String[]); descriptor: ([Ljava/lang/String;)V flags: ACC_PUBLIC, ACC_STATIC Code: stack=2, locals=3, args_size=1 0: new #2 // class com/xiaolyuh/DynamicDispatch$Man 3: dup 4: invokespecial #3 // Method com/xiaolyuh/DynamicDispatch$Man."<init>":()V 7: astore_1 8: new #4 // class com/xiaolyuh/DynamicDispatch$Woman 11: dup 12: invokespecial #5 // Method com/xiaolyuh/DynamicDispatch$Woman."<init>":()V 15: astore_2 16: aload_1 17: invokevirtual #6 // Method com/xiaolyuh/DynamicDispatch$Human.sayHello:()V 20: aload_2 21: invokevirtual #6 // Method com/xiaolyuh/DynamicDispatch$Human.sayHello:()V 24: return LineNumberTable: line 27: 0 line 28: 8 line 29: 16 line 30: 20 line 31: 24 LocalVariableTable: Start Length Slot Name Signature 0 25 0 args [Ljava/lang/String; 8 17 1 man Lcom/xiaolyuh/DynamicDispatch$Human; 16 9 2 woman Lcom/xiaolyuh/DynamicDispatch$Human; } ... 通过字节码我们发现:在main方法中,sayHello()方法的调用对应的符号引用是一样的,com/xiaolyuh/DynamicDispatch$Human.sayHello:()V 。在这里我们可以得出一个结论:在动态分派的情况下,在编译时期我们是无法确定方法的直接引用的,那么它是怎么实现重载方法的调用的呢?问题关键是在invokevirtual指令上,在执行invokevirtual指令时,invokevirtual指令会去确定方法的调用版本。 invokevirtual指令的运行过程 找到操作数栈顶的第一个元素所指向的对象的实际类型,记作C。 如果在类型C中找到与常量中的描述符和简单名称都相符的方法,则进行访问权限校验,如果通过则返回这个方法的直接引用,查找过程结束;不通过则返回java.lang.IllegalAccessError异常。 否则,按照继承关系从下往上依次对C的各个父类进行第二步的搜索和验证过程。4. 如果始终没有找到合适的方法,则抛出java.lang.AbstractMethodError异常。 正是因为invokevirtual指令执行的第一步就是在运行期确定接收者的实际类型,所以两次调用中的invokevirtual指令并不是把常量池中方法的符号引用解析到直接引用上就结束了,还会根据方法接收者的实际类型来选择方法版本,这个过程就是Java语言中方法重写的本质。 当子类声明了与父类同名的字段时,虽然在子类的内存中两个字段都会存在,但是子类的字段会遮蔽父类的同名字段 动态分派的实现 因为动态方法执行非常频繁,并且动态分派的方法版本选择需要在运行时,在实际接受者类型的方法元数据中搜索合适的目标方法,因此,Java虚拟机实现基于执行性能的考虑,虚拟机会为类型在方法区中建立一个虚方法表(Virtual Method Table,也称为vtable,与此对应的,在invokeinterface执行时也会用到接口方法表——Interface Method Table,简称itable),使用虚方法表索引来代替元数据查找以提高性能。 虚方法表中存放着各个方法的实际入口地址。如果某个方法在子类中没有被重写,那子类的虚方法表中的地址入口和父类相同方法的地址入口是一致的,都指向父类的实现入口。如果子类中重写了这个方法,子类虚方法表中的地址也会被替换为指向子类实现版本的入口地址。在图中,Son重写了来自Father的全部方法,因此Son的方法表没有指向Father类型数据的箭头。但是Son和Father都没有重写来自Object的方法,所以它们的方法表中所有从Object继承来的方法都指向了Object的数据类型。 虚方法表一般在类加载的连接阶段进行初始化,准备了类的变量初始值后,虚拟机会把该类的虚方法表也一同初始化完毕。 单分派与多分派 方法的接收者与方法的参数统称为方法的宗量。分派基于多少种宗量,可以将分派划分为单分派和多分派两种。单分派是根据一个宗量对目标方法进行选择,多分派则是根据两个及以上的宗量对目标方法进行选择。 静态分派需要根据静态类型和方法参数两个宗量来确定方法调用,所以属于多分派。 动态分派只需要根据实际类型一个宗量来确定方法的调用,所以属于单分派。 在动态分派的过程中,方法签名是确定的,所以方法参数就不会变,方法调用就取决于参数的实际类型。 总结 解析调用一定是个静态的过程,在编译期间就完全确定,在类加载的解析阶段就会把涉及的符号引用全部转变为明确的直接引用,不必延迟到运行期再去完成。分派(Dispatch)调用则要复杂许多,它可能是静态的也可能是动态的,按照分派依据的宗量数可分为单分派和多分派。这两类分派方式两两组合就构成了静态单分派、静态多分派、动态单分派、动态多分派4种分派组合情况。

优秀的个人博客,低调大师

深入理解Java线程状态

赞助平台 首页 / 文章管理 / 文章编辑 Java线程状态友情提示:文章每30秒自动保存一次,编辑器支持图片拖动上传或者复制粘贴上传~ 0 线程状态概述 分类 6个状态定义: java.lang.Thread.State New: 尚未启动的线程的线程状态。 Runnable: 可运行线程的线程状态,等待CPU调度。 Blocked: 线程阻塞等待监视器锁定的线程状态。处于synchronized同步代码块或方法中被阻塞。 Waiting: 等待线程的线程状态。下 列不带超时的方式:Object.wait、Thread.join、 LockSupport.park Timed Waiting:具有指定等待时间的等待线程的线程状态。下 列带超时的方式:Thread.sleep、0bject.wait、 Thread.join、 LockSuppor

优秀的个人博客,低调大师

Java NIO深入理解ServerSocketChannel

Java NIO 简介 JAVA NIO有两种解释:一种叫非阻塞IO(Non-blocking I/O),另一种也叫新的IO(New I/O),其实是同一个概念。它是一种同步非阻塞的I/O模型,也是I/O多路复用的基础,已经被越来越多地应用到大型应用服务器,成为解决高并发与大量连接、I/O处理问题的有效方式。 NIO是一种基于通道和缓冲区的I/O方式,它可以使用Native函数库直接分配堆外内存(区别于JVM的运行时数据区),然后通过一个存储在java堆里面的DirectByteBuffer对象作为这块内存的直接引用进行操作。这样能在一些场景显著提高性能,因为避免了在Java堆和Native堆中来回复制数据。 Java NIO组件 NIO主要有三大核心部分:Channel(通道),Buffer(缓冲区), Selector(选择器)。传统IO是基于字节流和字符流进行操作(基于流),而NIO基于Channel和Buffer(缓冲区)进行操作,数据总是从通道读取到缓冲区中,或者从缓冲区写入到通道中。Selector(选择区)用于监听多个通道的事件(比如:连接打开,数据到达)。因此,单个线程可以监听多个数据通道。 Buffer Buffer(缓冲区)是一个用于存储特定基本类型数据的容器。除了boolean外,其余每种基本类型都有一个对应的buffer类。Buffer类的子类有ByteBuffer, CharBuffer, DoubleBuffer, FloatBuffer, IntBuffer, LongBuffer, ShortBuffer 。 Channel Channel(通道)表示到实体,如硬件设备、文件、网络套接字或可以执行一个或多个不同 I/O 操作(如读取或写入)的程序组件的开放的连接。Channel接口的常用实现类有FileChannel(对应文件IO)、DatagramChannel(对应UDP)、SocketChannel和ServerSocketChannel(对应TCP的客户端和服务器端)。Channel和IO中的Stream(流)是差不多一个等级的。只不过Stream是单向的,譬如:InputStream, OutputStream.而Channel是双向的,既可以用来进行读操作,又可以用来进行写操作。 Selector Selector(选择器)用于监听多个通道的事件(比如:连接打开,数据到达)。因此,单个的线程可以监听多个数据通道。即用选择器,借助单一线程,就可对数量庞大的活动I/O通道实施监控和维护。 Java NIO的简单实现 public class Demo1 { private static Integer port = 8080; // 通道管理器(Selector) private static Selector selector; private static ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor(1, 10, 1000, TimeUnit.MILLISECONDS, new LinkedTransferQueue<>(), new ThreadPoolExecutor.AbortPolicy()); public static void main(String[] args) { try { // 创建通道ServerSocketChannel ServerSocketChannel open = ServerSocketChannel.open(); // 将通道设置为非阻塞 open.configureBlocking(false); // 绑定到指定的端口上 open.bind(new InetSocketAddress(port)); // 通道管理器(Selector) selector = Selector.open(); /** * 将通道(Channel)注册到通道管理器(Selector),并为该通道注册selectionKey.OP_ACCEPT事件 * 注册该事件后,当事件到达的时候,selector.select()会返回, * 如果事件没有到达selector.select()会一直阻塞。 */ open.register(selector, SelectionKey.OP_ACCEPT); // 循环处理 while (true) { /** * 当注册事件到达时,方法返回,否则该方法会一直阻塞 * 该Selector的select()方法将会返回大于0的整数,该整数值就表示该Selector上有多少个Channel具有可用的IO操作 */ int select = selector.select(); System.out.println("当前有 " + select + " 个channel可以操作"); // 一个SelectionKey对应一个就绪的通道 Set<SelectionKey> selectionKeys = selector.selectedKeys(); Iterator<SelectionKey> iterator = selectionKeys.iterator(); while (iterator.hasNext()) { // 获取事件 SelectionKey key = iterator.next(); // 移除事件,避免重复处理 iterator.remove(); // 客户端请求连接事件,接受客户端连接就绪 if (key.isAcceptable()) { accept(key); } else if (key.isReadable()) { // 监听到读事件,对读事件进行处理 threadPoolExecutor.submit(new NioServerHandler(key)); } } } } catch (IOException e) { e.printStackTrace(); } } /** * 处理客户端连接成功事件 * * @param key */ public static void accept(SelectionKey key) { try { // 获取客户端连接通道 ServerSocketChannel ssc = (ServerSocketChannel) key.channel(); SocketChannel sc = ssc.accept(); sc.configureBlocking(false); // 给通道设置读事件,客户端监听到读事件后,进行读取操作 sc.register(selector, SelectionKey.OP_READ); System.out.println("accept a client : " + sc.socket().getInetAddress().getHostName()); } catch (IOException e) { e.printStackTrace(); } } /** * 监听到读事件,读取客户端发送过来的消息 */ public static class NioServerHandler implements Runnable { private SelectionKey selectionKey; public NioServerHandler(SelectionKey selectionKey) { this.selectionKey = selectionKey; } @Override public void run() { try { if (selectionKey.isReadable()) { SocketChannel socketChannel = (SocketChannel) selectionKey.channel(); // 从通道读取数据到缓冲区 ByteBuffer buffer = ByteBuffer.allocate(1024); // 输出客户端发送过来的消息 socketChannel.read(buffer); buffer.flip(); System.out.println("收到客户端" + socketChannel.socket().getInetAddress().getHostName() + "的数据:" + new String(buffer.array())); //将数据添加到key中 ByteBuffer outBuffer = ByteBuffer.wrap(buffer.array()); // 将消息回送给客户端 socketChannel.write(outBuffer); selectionKey.cancel(); } } catch (IOException e) { e.printStackTrace(); } } } } 原文地址 https://www.51csdn.cn/article/404.html

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册