首页 文章 精选 留言 我的

精选列表

搜索[全模态理解],共10000篇文章
优秀的个人博客,低调大师

重新理解RocketMQ Commit Log存储协议

最近突然感觉:很多软件、硬件在设计上是有root reason的,不是by desgin如此,而是解决了那时、那个场景的那个需求。一旦了解后,就会感觉在和设计者对话,了解他们的思路,学习他们的方法,思维同屏:活到老学到老。 问题思考 1、Consumer Queue Offset是连续的吗, 为什么? 2、Commit Log Offset是连续的吗, 为什么? 3、Java写的文件,默认是大端序还是小端序,为什么? Commit Log真实分布 在大家思考之际, 我们回想下commit log是怎么分布的呢? 在Broker配置的存储根目录下,通过查看Broker实际生成的commit log文件可以看到类似下面的数据文件分布: 可以看到,真实的存储文件有多个, 每一个都是以一串类似数字的字符串作为文件名的,并且大小1G。 我们结合源码可以知道,实际的抽象模型如下: 由上图得知: Commit Log是一类文件的称呼,实际上Commit Log文件有很多个, 每一个都可以称为Commit Log文件。如图中表示了总共有T个Commit Log文件,他们按照由过去到现在的创建时间排列。 每个Commit Log文件都保存消息, 并且是按照消息的写入顺序保存的,并且总是在写创建时间最大的文件,并且同一个时刻只能有一个线程在写。如图中第1个文件,1,2,3,4...表示这个文件的第几个消息,可以看到第1234个消息是第1个Commit Log文件的最后一个消息,第1235个消息是第2个Commit Log的第1个消息。 说明1:每个Commit Log文件里的全部消息实际占用的存储空间大小<=1G。这个问题大家自行思考下原因。 说明2:每次写Commit Log时, RocketMQ都会加锁,代码片段见 https://github.com/apache/rocketmq/blob/7676cd9366a3297925deabcf27bb590e34648645/store/src/main/java/org/apache/rocketmq/store/CommitLog.java#L676-L722 我们看到Commit Log文件中有很多个消息,按照既定的协议存储的,那具体协议是什么呢, 你是怎么知道的呢? Commit Log存储协议 关于Commit Log存储协议,我们问了下ChatGPT, 它是这么回复我的,虽然不对,但是这个回复格式和说明已经非常接近答案了。 我们翻看源码,具体说明下:https://github.com/apache/rocketmq/blob/rocketmq-all-4.9.3/store/src/main/java/org/apache/rocketmq/store/CommitLog.java#L1547-L1587 我整理后, 如下图: 说明1:我整理后的消息协议编号和代码中不是一致的,代码中只是标明了顺序, 真实物理文件中的存储协议会更详细。说明2:在我写的《RocketMQ分布式消息中间件:核心原理与最佳实践》中,这个图缺少了Body内容,这里加了,也更详细的补充了其他数据。这里有几个问题需要说明下: 1、二进制协议存在字节序,也就是常说的大端、小端。大小端这里不详细说明感兴趣的同学自己google或者问题ChatGPT,回答肯定比我说的好。 2、在java中, 一个byte占用1个字节,1个int占用4个字节,1个short占用2个字节,1个long占用8个字节。 3、Host的编码并不是简单的把IP:Port作为字符串直接转化为byte数组,而是每个数字当作byte依次编码。在下一节的Golang代码中会说明。 4、扩展信息的编码中,使用了不可见字符作为分割,所以扩展字段key-value中不能包含那2个不可见字符。具体是哪2个,大家找找? 我们看到这个协议后,如何证明你的物理文件就是按照这个协议写的呢? 用Golang解开RocketMQ Commit Log RocketMQ是用java写的,根据上文描述的存储协议,我用Golang编写了一个工具,可以解开Commit Log和Cosumer Queue,代码地址:https://github.com/rmq-plus-plus/rocketmq-decoder。 这个工具目前支持2个功能: 1、指定Commit Log位点,直接解析Commit Log中的消息,并且打印。 2、指定消费位点,先解析Consumer Queue,得到Commit Log Offset后,再根据Commit Log Offset直接解析Commit Log,并且打印。 在Golang中没有依赖RocketMQ的任何代码,纯粹是依靠协议解码。 这里贴了一段golang中解析Commit Log Offset的例子:在java中这个offset是一个long类型,占用8个字节。 在golang中,读取8个字节长度的数据,并且按照大端序解码为int64,就可以得到正常的Commit Log Offset。 我跑了一个demo结果,大家参考: 回答最初的问题 以下为个人见解,大家参考: 1、Consumer Queue Offset是连续的吗, 为什么? 是连续的。 consumer queue offset,是指每个queue中索引消息的下标,下标当然是连续的。消费者也是利用了这个连续性,避免消费位点提交空洞的。 每个索引消息占用相同空间,都是20字节,结构如下: 这里物理位点也就是Commit Log Offset。 2、Commit Log Offset是连续的吗, 为什么? 不是连续的。 Commit Log Offset是指的每个消息在全部Commit Log文件中的字节偏移量, 每个消息的大小是不确定的,所以Commit Log Offset,也即是字节偏移量肯定是不一样的。 并且可以知道,每两个偏移量的差的绝对值就是前一个消息的消息字节数总长度。 并且上文中图 “Commit Log存储文件分布抽象”中的有误解,每个小方格的大小其实是不一样的。 3、Java写的文件,默认是大端序还是小端序,为什么? 大端序。大端序其实有字节存储顺序和网络传输顺序,java中默认用的大端序,保持和网络传输一样,这样方便编解码。 每段网络传输层的数据报文最前面的字节是表达后面的数据是用什么协议传输的,这样数据接收者在接受数据时, 按照字节顺序,先解析协议,再根据协议解码后面的字节序列,符合人类思考和解决问题的方式。 讨论说明:由于RocketMQ一些版本可能有差异,本文在4.9.3版本下讨论,大家可以参考这个方法,解开5.0甚至其他版本,其他数据文件的存储协议格式。
优秀的个人博客,低调大师

HarmonyOS “跨设备迁移”原理解析

## 什么是HarmonyOS“跨设备迁移”? HarmonyOS“跨设备迁移”是指将承载业务的Page在同一用户的不同设备间迁移,以便支持用户业务无缝切换的诉求。“跨设备迁移”实现了业务跨设备流转功能,打破业务受限单设备的壁垒。 典型应用场景举例: ![1.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/165a8a819d700049d4d927d746b3b7717d9f6e.png?x-oss-process=image/resize,w_679,h_380) ![1.jpg](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/96586db69814b6ddd5982927388eb5530bc2ac.jpg?x-oss-process=image/resize,w_1080,h_695) 设备A完成邮件编写并选择附件,流转到另一设备 ![2.jpg](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/c3ff87277bc77f11de94174201f2025fe1255a.jpg?x-oss-process=image/resize,w_1080,h_895) 设备B弹出邮件界面,可继续完成邮件编写 ## HarmonyOS“跨设备迁移”的技术原理 HarmonyOS“跨设备迁移”需要用到一项关键技术——“**分布式任务调度**”。 ### **分布式任务调度** “跨设备迁移”依赖HarmonyOS系统中**分布式任务调度**的“**业务迁移能力**”。 ![3.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/83293f5757fd4cb89177937c2b2733db66002e.png?x-oss-process=image/resize,w_639,h_505) “分布式任务调度”基于**分布式软总线**、**分布式数据管理**、**分布式****Profile****和分布式安全认证**这四项技术特性,构建统一的分布式服务管理(发现、同步、注册、调用)机制,支持对跨设备的应用进行远程启动、远程调用、远程连接以及迁移等操作。 ![4.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/d59e681715852e5a32e370b9389523d662a5f4.png?x-oss-process=image/resize,w_650,h_390) ● 分布式软总线实现了近场设备间统一的分布式通信能力管理,提供不区分链路的设备发现、连接、组网和传输能力。开发者可无需关注设备间组网方式与底层协议,集中精力实现业务逻辑功能。 ● 分布式数据管理中的数据同步能力可实现组网内的设备信息共享实时同步,如设备上下线、设备信息列表等,方便多设备信息实时同步。 ● 分布式Profile实现多设备Profile的统一查询、订阅能力,拉通多设备之间的管理。 ● 分布式安全认证提供应用完整性保护、应用权限管理、设备认证、密钥管理等服务,为业务提供安全保障基础。 分布式任务调度基于以上技术特性基座,构建统一的分布式服务管理机制,完成了分布式组网内设备中的系统服务信息同步及管理,包括服务注册、服务发现、服务同步和服务调度。 在业务发起“跨设备迁移”请求时,分布式调度系统根据调度决策机制选择目标设备,并获取对应设备的系统服务信息,在系统服务成功调度后,向目标设备发起远程启动、远程调用、远程连接和远程迁移,由对应设备的分布式任务调度系统完成本地化的任务执行。 ## HarmonyOS“跨设备迁移”的具体实现流程 HarmonyOS“跨设备迁移”依赖“Ability”实现,这里我们简单介绍一下“Ability”。 ### Ability Ability是应用所具备能力的抽象,HarmonyOS支持应用以Ability为单位进行部署。业务“跨设备迁移”的基础粒度也是Ability,具体实现是在不同设备间同一应用的同名Ability之间进行迁移。 **●** **Ability概述** https://developer.harmonyos.com/cn/docs/documentation/doc-guides/ability-ability-overview-0000000000029852 HarmonyOS的应用由一个或多个FA(Feature Ability)或PA(Particle Ability)组成。 ![5.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/51a560a73ebbad9c4636973f1021fc067216df.png?x-oss-process=image/resize,w_1080,h_331) **●** **FA有UI界面,提供与用户交互的能力** FA仅支持Page Ability,一个Page实例可以包含一组相关页面,每个页面用一个AbilitySlice实例表示。 ![6.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/86c183677b03e9f65d2867d3d275ca55975a42.png?x-oss-process=image/resize,w_177,h_218) **●** **Page Ability基本概念** https://developer.harmonyos.com/cn/docs/documentation/doc-guides/ability-page-concept-0000000000033573 **●** **PA无UI界面,提供后台运行任务的能力以及统一的数据访问抽象** PA支持Service Ability和Data Ability: Service Ability:用于提供后台运行任务的能力。 Data Ability:用于对外部提供统一的数据访问抽象。 Ability的生命周期主要用于Page实例的状态机管理,系统管理或用户操作等行为均会引起Page实例在其生命周期的不同状态之间进行转换。Ability Class提供的回调机制能够让Page及时感知外界变化,从而正确地应对状态变化。 **●** **Page Ability生命周期** https://developer.harmonyos.com/cn/docs/documentation/doc-guides/ability-page-lifecycle-0000000000029840 “跨设备迁移”的处理依赖Ability的生命周期管理来完成Page的状态切换,同时Page在生命周期回调中处理数据的保存与恢复。具体流程如下图所示: ![7.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/2231e9c74f2e99bbf5a0247e061d60761f04a6.png?x-oss-process=image/resize,w_942,h_706) **●** **onStart()** 当系统首次创建Page实例时触发。应用须重写该方法,并在此初始化配置为展示AbilitySlice。Page在此后进入INACTIVE状态,用户不可交互。 **• onActive()** 当Page从INACTIVE状态切换到前台时触发。Page在此之后进入ACTIVE状态,该状态下,应用与用户处于可交互的状态。 **• onInactive()** 当Page即将进入不可交互状态时会被触发,Page在此之后进入INACTIVE状态,应用与用户不可交互。 **• onBackground()** 当Page不再对用户可见时触发。Page在此之后进入BACKGROUND状态。 **• onForeground()** 当Page从BACKGROUND状态重新回到前台时触发。Page在此之后回到INACTIVE状态。 **• onStop()** 当系统将要销毁Page时触发。 ### 迁移流程 **围绕Ability的生命周期,我们来看看业务“跨设备迁移”的具体流程。** 业务“跨设备迁移”的本质即通过分布式组网把一个设备的“Ability运行状态”迁移到另外一台设备上。 程序中“跨设备迁移”通过调用Page Ability的迁移接口ContinueAbility,将设备A的业务无缝迁移到指定设备B中。其中,支持迁移的Page以及此Page所包含的所有AbilitySlice必须实现IAbilityContinuation接口。具体接口代码如下: ``` public interface IAbilityContinuation { //是否可迁移 boolean onStartContinuation(); //保存数据 boolean onSaveData(IntentParams var1); //恢复数据 boolean onRestoreData(IntentParams var1); //迁移完成 void onCompleteContinuation(int var1); default void onRemoteTerminated() { throw new RuntimeException("Stub!"); } } ``` ![8.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/8697baf141a1fa4208a4119465dc3e426ea70e.png?x-oss-process=image/resize,w_965,h_543) 图8 业务“跨设备迁移”流程 **“跨设备迁移”关键步骤:** ![QQ截图20210608110009.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/95202d640a7fa399475571ea7953217eeac621.png?x-oss-process=image/resize,w_703,h_283) **“跨设备迁移”数据流转过程:** ![QQ截图20210608105826.png](https://harmonyos.oss-cn-beijing.aliyuncs.com/images/202106/9446c8b631cf94e02607185470ec737ed2119d.png?x-oss-process=image/resize,w_711,h_414) [想了解更多关于鸿蒙的内容,请访问:](https://harmonyos.51cto.com/#bkwz) [51CTO和华为官方战略合作共建的鸿蒙技术社区](https://harmonyos.51cto.com/#bkwz) https://harmonyos.51cto.com/#bkwz

优秀的个人博客,低调大师

每日一博 | 理解 B+ 树

B+树是为磁盘和存储工具设计的一种数据结构,它是一种平衡查找树,它在查找,插入、修改方面的时间复杂度都稳定为 O(logn) 节点 图(1) B+树节点是一组按照key有序的元素,B+树包含两种类型的节点,一种是索引节点,一种是叶子节点 索引节点也叫内部节点,索引节点只包含key,不包含data, 节点的 key是升序排列的,对于指定的索引节点key来说,它左子树上所有的key都小于它的key,它右子树上所有的key都大于等于它的key 叶节点上存储的是主键和数据(key和data), 所有的叶节点都在同一高度上,节点按key 从小到大并且通过指针使得彼此链接,这样,所有的叶节点组成了一个双向有序链表,叶节点这样做的好处是在不访问索引的情况下能顺序检索数据,也能很好的支持范围查询的快处理 B+树特点 阶数为 m 的B+树,每个索引节点最多有 m 个子节点,每个索引节点页面最多存储 m - 1 个索引key 所有索引节点的子节点数在 Math.ceil(m / 2) 和 m 之间 B +树之所以称为平衡树,是因为从根节点到叶节点的每条路径都具有相同的长度。平衡树意味着所有对单个值的搜索都需要从磁盘读取相同数量的页面。 填充因子 B+树使用填充因子来控制页面的分裂和合并,设置数据占用页面空间的百分比,目的是为后面的数据预留一部分页空间,当有新数据时,可以放到预留的页空间中,避免分页的发生 默认的填充因子是50%,对于一棵m阶的B+树,填充因子是 m/2 B+树操作 B+树常用操作涉及到查询、插入、删除、范围查询, 为了便于说明,下面所有操作的例子中的B+树无特殊说明都是5阶树 每个页面最多有4个key,大于等于5个时就需要分裂或者旋转合并 填充因子默认是50%,页面中已经使用了的数量为2表示填充因子为50%,同理,小于2时候表示填充因子小于50%,大于2时候表示填充因子大于50% 查询 B+树的索引节点是有序的,查询单个key的话直接用二分查找定位到目标叶子页面,在目标叶子页面中顺序遍历,找到目标key,则返回叶子页面中目标key对应的数据 插入 B+树的插入操作完成以后,有以下几种情况 1. 叶节点和索引节点没有满 这种情况插入操作步骤最少,根据key把数据插入到叶节点已经排序的位置上即可,下图中是插入key为 23的数据,23会插入到包含15, 21的叶子页面中,插入之后叶子页面没有满,不用处理页面分裂的情况 2. 叶节点满了,索引节点未满 步骤: (1):叶子页面分裂成两个页面 (2): 把中间行数据的key按顺序加入到上一层的索引页中 (3): 所有小于中间行数据key的数据放到左叶子页面 (4): 所有大于等于中间行数据key的数据放到右叶子叶面 图(2) 往图(2) 的B+树中插入key为28的数据,这条数据会插入到包含15,21,23,27的叶子页面中,插入之后,该页面数据已满,必须要分裂成如下所示的两个页面: 左叶子页面 右叶子页面 15,21 23,27,28 中间行数据key为:23,放到上一层的索引页面中15的后面,下面图(3)是插入key为28的结果 图(3) 3. 叶子页面和索引页面都满了 步骤: (1):叶节点页面分裂成左右两个叶子页面 (2): 把中间行数据的key按顺序加入到索引页中 (3): 所有小于中间行数据key的数据放到左叶子页面 (4): 所有大于等于中间行数据key的数据放到右叶子页面 (5): 上面步骤(2)执行之后,索引页面满了,分裂成左右两个索引页 (6): 所有小于索引页中间的key的放到左边索引页 (7): 所有大于索引页中间的key的放到右边索引页 (8): 把索引页中间的key放到更高一层的索引页 如果步骤(8)执行之后,更高一层的索引页满了,继续执行(5)-(8)步骤 图(4) 图(4) 的B+树插入key为30的数据,这条数据会插入到23, 27, 28, 29的叶子页面中,插入之后,该页面数据已满,必须要分裂成如下所示的两个页面: 左叶子页面 右叶子页面 23,27 28,29,30 中间行数据key为:28,放到索引页面中23 的后面 28 放到索引页面23的后面之后,索引页变成了4, 7, 15, 23, 28, 这时索引页也满了,分裂成如下所示的三个页面 : 左索引页 右索引页 更高一层索引页 4,7 23,28 15 下面图(5)为插入key为30数据之后,叶子页面和索引页面分裂之后的结果: 图(5) 旋转 B+树的插入操作会有页面分裂的情况,页面分裂就会有产生磁盘IO,相对内存,磁盘 IO 要慢得多,所以为了减少磁盘IO操作,就要尽可能的减少页面分裂,充分利用页面空间,因此B+树提供了旋转操作 旋转操作的应用场景: B+树叶子页面空间已经满了,但是它的左右兄弟页面没有满 叶子页面空间满了,B+树会优先检查左右兄弟叶子页面是否能容纳数据,当左右兄弟页面空间都满了时,才会考虑页面分裂 图(6) 图(6)中,插入key为12的数据,叶子页面空间满了,这时B+树先检查左兄弟页面是否有多余的空间,通过旋转,把key分别为7, 10, 11, 12, 13的叶子中的 7 移动到左兄弟页面中,移动完成之后,左兄弟的key变成了2, 5, 7 同时,叶子中key为7的数据在上层索引页中也有记录,所以需要把上层索引页中key为7修改为 10,修改之后上层索引key分别为10, 15,最终的结果如下图(7)所示 图(7) 叶子页面插入新数据之后,页面空间已满,原本页面是需要分裂的,但是通过把当前页面上的数据移动到能容纳数据的兄弟页面中,减少了一次页分裂,也即减少了一次磁盘IO操作 删除 B+树的删除操作完成以后,有以下几种情况 1. 叶子页面和索引页面填充因子都大于等于50% 这种情况直接删除节点,页面会把删除节点的位置标记为空,以便存放后续其他的数据,同时,如果删除的key出现在上层的索引页面中,需要用叶子页面中被删除节点的下一个节点key去替换它 图(8) 图(8)中 7是待删除的节点,删除7后,叶子页面填充因子刚好等于50%,因为被删除的7在上层的索引页面中出现了相同的key,所以需要用叶子页面中下一个key,也就是12替换上层索引页面中的7,最终的结果如下面图(9)所示: 图(9) 2. 叶子页面填充因子50%,索引页面填充因子大于等于50% 叶子页面填充因子小于50%的时候,为了维持B+树的平衡,会有页面数据转移和合并的操作 从兄弟页面转移key数据到当前页面 当一个叶子页面填充因子小于50%,左右兄弟页面存在填充因子大于50%的时候,可以把兄弟页面中的数据转移到当前页面中,上一层索引页面中因叶子页面数据转移受影响的索引key也需要做相应的处理 如果左右兄弟页面的填充因子都大于50%时,转移任何一边页面数据到当前页面都可以,虽然选择不同的页面转移数据后,B+树的形态不一样,但是最终都是满足B+树特点的 图(10) 上面图(10)中,删除key为16的数据 ( 图中红色标识的区域 ),删除之后,原来key为15, 16的叶子页面变成了15,页面只剩下一个key 此时页面的填充因子小于50%,左兄弟页面填充因子大于50%,满足页面数据转移的条件 把左兄弟页面 (key为7, 12, 13)中的 13 转移到当前页面中 转移之后,两个页面key数量刚好等于填充因子,左兄弟页面key变为7, 12,当前页面的key变为13, 15 当前页面中最小key值由原来的 15 变成了 13,为了保持B+数的平衡,需要把当前页面上一层的索引页面中key为15替换为13, 最终的结果如下面图(11)所示 : 图(11) 当前页面key合并到兄弟页面 上面说明了从兄弟页面转移数据到当前页面,现在我们来看下当前页面数据量小于填充因子的时候,如何合并到兄弟页面中 当一个叶子页面填充因子小于50%,左右兄弟页面存在填充因子等于50%的时候,可以把这个叶子页面合并到左右兄弟页面中,上一层索引页面中因叶子页面数据合并受影响的索引key也需要做相应的处理 图(12) 在图(12)中,执行删除key为15的操作(图中红色区域),15位于key为13, 15的页面中,删除15之后,当前页面key变成了13, 只剩下一个key了 此时,当前页面填充因子小于50%,左右兄弟节点填充因子等于50%,所以无法从兄弟页面转移key数据到当前页面,但满足当前页面数据合并到兄弟页面的条件 左右兄弟页面都满足当前页面数据合并过去,选择任一兄弟页面都可以,虽然选择不同兄弟页面,会导致B+树的形态也不一样,但最终都是让B+树维持平衡,这里我们选则合并到左兄弟页面 15 被删除了之后,当前页面只剩下key为13的数据了 它合并到左兄弟页面之后, 当前页面为空,需要移除上一层索引页面中指向当前页面的索引key 13, 移除13的索引key之后, 索引页面key由原来的7, 13, 23变成7, 23 合并之后,左兄弟页面key由原来的7, 12变成7, 12, 13 最终的结果如下面 图(13) 所示 : 图(13) 3. 叶子页面和索引页面填充因子都小于50% 当叶子页面和索引页面填充因子都小于50%的时候,叶子页面和索引页面都会有数据转移或者合并的操作 图(14) 在图(14)中,执行删除叶子页面中key为12的数据(图中红色区域),12 位于key为7, 12叶子页面中,删除 12 之后,当前叶子页面变成了7,只剩下一个key了 当前叶子页面左右兄弟页面填充因子都是50%,所以满足合并的条件,合并到左兄弟页面或右兄弟页面都可以,这里我们选择合并到左兄弟页面 当前叶子页面中key为 7 的数据合并到左兄弟页面之后,当前叶子页面没数据了,而左兄弟页面key变成了2, 5, 7 为了保持B+树的平衡,指向当前叶子页面的上一层索引页面中,需要删除key为 7 的索引key, 删除key为7的索引后,索引页面key变成了15, 这时该索引页面填充因子小于50%,右兄弟页面填充因子等于50%,满足合并的条件 但是,索引页面数据合并到右兄弟页面之后,根节点的左子树就为空了,为了保持B+树的平衡,根页面数据需要合并到下一层的索引页面中 最后的结果如下面图(15)所示 : 图(15) 范围查询 B+树的叶子节点是按照key从小到大的顺序组成的一个双向链表,所以B+树非常适合范围查询(这里说的范围是B+树中索引节点的key的范围) 使用二分查找首先确定范围查询的起始key所在的叶子节点的位置,然后顺序遍历叶节点链表,直到叶节点key大于范围查询结束key,查询停止 B+树的大小 一颗 m 阶的B+树,索引节点存储的是索引信息,为了计算方便,这里假设一个索引key信息 8 字节,一个磁盘页面大概 4KB,那么一个磁盘页面能容纳的索引数量为:4 * 1024 / 8 = 512,此时 m 就等于 512 当B+树高度为2时,最多能容纳 512 (512的1次方) 个索引信息 当B+树高度为3时,最多能容纳 26万 (512的2次方)个索引信息 当B+树高度为4时,最多能容纳 1.3亿 (512的3次方)个索引信息 当B+树高度为5时,最多能容纳 687亿 (512的4次方)个索引信息 从上面的数据可以看到,B+树高度为5时, 能容纳 687 亿个索引信息,可以非常够用了 在实际的应用当中,B+树的根节点都是缓存在内存中的,树的最底层是叶子节点 所以针对高度为5的B+树,查找一条指定key值的数据最多只需要3次磁盘IO就能定位到具体的叶子页面,当树高度为4时,最多只需要2次磁盘IO就能定位到具体的叶子页面 B+树的应用 B+树主要用于磁盘和存储工具,著名的MySQL引擎 InnoDB 索引的数据模型使用的就是 B+ 树 当数据超过一定的量级的时候,为了快速检索数据而设置的索引信息也会变得非常庞大,而且这部分索引信息只能存储在磁盘中,B+树能从磁盘中快速检索到需要的数据,并且时间复杂度稳定在O(logn) 本文分享自微信公众号 - Linux开发那些事儿(LinuxThings)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Authing Share|理解 SAML2 协议

SAML2 综述 安全断言标记语言(英语:Security Assertion Markup Language,简称SAML,发音 sam-el)是一个基于 XML 的开源标准数据格式,它在当事方之间交换身份验证和授权数据,尤其是在身份提供者和服务提供者之间交换。SAML2.0 可以实现基于网络跨域的单点登录(SSO), 以便于减少向一个用户分发多个身份验证令牌的管理开销。 SAML 主体 在 SAML 协议中,涉及两个主体: Service Provider 服务提供方,简称 SP。什么是服务提供方?例如:阿里云控制台、腾讯云控制台、AWS 控制台这些都是服务提供方。 Identity Provider 身份提供方,简称 IdP。什么是身份提供方?Authing 可以作为身份提供方,身份提供方能够向 SP 发送身份断言,所谓身份断言就是由 Authing 签发的,可以标识某个人身份的 Token,只不过,在 SAML 协议中,这个 Token 的格式是 XML 形式的。还有一些其他的身份提供方,例如 Okta、SSOCircle、Auth0,他们都可以向 SP 返回身份断言。 两个主体通过用户的浏览器进行信息交换。方式上,SP 可以返回带参数的重定向 HTTP 响应,让用户立刻通过参数将信息发给 IdP。而 IdP 会返回一个表单,同时还有一段立即提交表单的 JS 代码,从而让用户立刻将信息发给 SP。 总结一下,SP 提供服务,需要知道用户的身份,就需要向 IdP 询问。IdP 知道用户的身份,当用户在 IdP 登录成功,IdP 就将用户的身份以 SAML 断言的形式发给 SP。SP 信任 IdP 发来的身份断言,从而赋予该用户在 SP 的相关权限。 SAML Request 当用户的身份无法鉴定时,SP 会向 IdP 发送 SAML Request 信息(通过浏览器发送),请求 IdP 来鉴定用户身份。 由阿里云控制台发起一次 SAML Request 的形式是这样的: GEThttps://core.authing.cn/v2/api/saml-idp/5e10927e4ecfd464fb4edaf6?SAMLRequest=fZJLT%2BMwFIX3%2FIrI%2B7yct9Wk6kyFQGJERQKL2RnnJnWV2Blfp2L%2BPaGlDLOApaV7vnN0jlfrl3FwjmBQalWS0AuIA0roVqq%2BJI%2FNtZuTdXW1Qj4OdGKb2e7VA%2FyZAa2zQQRjF91PrXAewdRgjlLA48NdSfbWTsh8H2WvpPL4IP%2FOyhN69N9Qfl3fE2e7UKTi9mR9EQhtwOOLz5LAE8o%2FUp9P8qRyZTv5CYRBQTOIQXRtnMbdcwwt71LiXGsj4JSwJB0fEIhzuy0Jp9AXgvaHgwzzPA%2FjfXagbRYlebeP%2BmI5wh1HlEf4J0Oc4Vah5cqWhAY0cIPCpXkTRiwoWJJ5eZH%2BJs7OaKuFHn5IdS5sNoppjhKZ4iMgs4LVm193jHoBez4fIbtpmp27u68b4jxdiqdvxS9TKGTnqr9nTe%2FGpDovw06JzWfC9wB%2B2Y5UXy8VRlmcpkWUpUlGY5p8TLfyP7tW78%2F%2Fv0f1Cg%3D%3D (提示:代码可向右滑动) SAMLRequest 参数通过query在 URL 中发送给 IdP,SAMLRequest 的内容如下: fZJLT+MwFIX3/IrI+7yct9Wk6kyFQGJERQKL2RnnJnWV2Blfp2L+PaGlDLOApaV7vnN0jlfrl3FwjmBQalWS0AuIA0roVqq+JI/NtZuTdXW1Qj4OdGKb2e7VA/yZAa2zQQRjF91PrXAewdRgjlLA48NdSfbWTsh8H2WvpPL4IP/OyhN69N9Qfl3fE2e7UKTi9mR9EQhtwOOLz5LAE8o/Up9P8qRyZTv5CYRBQTOIQXRtnMbdcwwt71LiXGsj4JSwJB0fEIhzuy0Jp9AXgvaHgwzzPA/jfXagbRYlebeP+mI5wh1HlEf4J0Oc4Vah5cqWhAY0cIPCpXkTRiwoWJJ5eZH+Js7OaKuFHn5IdS5sNoppjhKZ4iMgs4LVm193jHoBez4fIbtpmp27u68b4jxdiqdvxS9TKGTnqr9nTe/GpDovw06JzWfC9wB+2Y5UXy8VRlmcpkWUpUlGY5p8TLfyP7tW78//v0f1Cg== (提示:代码可向右滑动) base64 decode + inflate 解码后 (https://www.samltool.com/decode.php) <?xmlversion="1.0"encoding="UTF-8"?> <saml2p:AuthnRequestAssertionConsumerServiceURL="https://signin.aliyun.com/saml/SSO"Destination="https://core.authing.cn/v2/api/saml-idp/5e10927e4ecfd464fb4edaf6"ForceAuthn="false"ID="a2eg9c2gjji188814h7j2d7358fh3g9"IsPassive="false"IssueInstant="2020-09-28T13:09:57.896Z"ProtocolBinding="urn:oasis:names:tc:SAML:2.0:bindings:HTTP-POST"Version="2.0"xmlns:saml2p="urn:oasis:names:tc:SAML:2.0:protocol"><saml2:Issuerxmlns:saml2="urn:oasis:names:tc:SAML:2.0:assertion">https://signin.aliyun.com/1374669376572425/saml/SSO (提示:代码可向右滑动) SAML Response IdP 收到 SAML Request 后,会弹出登录框对用户身份进行认证: 当用户在 IdP 完成登录后,SAML IdP 将用户身份断言发送给 SP(放在表单中,通过浏览器 POST 请求发送)。SAML IdP 的响应内容如下: <formid="saml-form"method="post"action="https://signin.aliyun.com/saml/SSO"autocomplete="off"><inputtype="hidden"name="SAMLResponse"id="saml-response"value="PHNhbWxwOlJlc3BvbnNlIHhtbG5zOnNhbWxwPSJ1cm46b2FzaXM6bmFtZXM6dGM6U0FNTDoyLjA6cHJvdG9jb2wiIHhtbG5zOnNhbWw9InVybjpvYXNpczpuYW1lczp0YzpTQU1MOjIuMDphc3NlcnRpb24iIElEPSJfNjJiMTc3YzEtYTkxOS00MmY2LTk1ODYtNDdmMTNiNzEwODFmIiBWZXJzaW9uPSIyLjAiIElzc3VlSW5zdGFudD0iMjAyMC0wOS0yOFQxMzozMDozMS43ODhaIiBEZXN0aW5hdGlvbj0iaHR0cHM6Ly9zaWduaW4uYWxpeXVuLmNvbS9zYW1sL1NTTyIgSW5SZXNwb25zZVRvPSJhNDlmOGVkaTMxY2owYTJhNDU5ZzAzMzFjM2Q5YzEwIj4KICA8c2FtbDpJc3N1ZXI+aHR0cHM6Ly8yMG5xdWx2b3FwYnAuYXV0aGluZy5jbjwvc2FtbDpJc3N1ZXI+CiAgPHNhbWxwOlN0YXR1cz4KICAgIDxzYW1scDpTdGF0dXNDb2RlIFZhbHVlPSJ1cm46b2FzaXM6bmFtZXM6dGM6U0FNTDoyLjA6c3RhdHVzOlN1Y2Nlc3MiLz4KICA8L3NhbWxwOlN0YXR1cz4KICA8c2FtbDpBc3NlcnRpb24geG1sbnM6eHNpPSJodHRwOi8vd3d3LnczLm9yZy8yMDAxL1hNTFNjaGVtYS1pbnN0YW5jZSIgeG1sbnM6eHM9Imh0dHA6Ly93d3cudzMub3JnLzIwMDEvWE1MU2NoZW1hIiB4bWxuczpzYW1sPSJ1cm46b2FzaXM6bmFtZXM6dGM6U0FNTDoyLjA6YXNzZXJ0aW9uIiBJRD0iX2ZhZTk1YjQ3LWNiZjMtNGEyMC1hZGQwLTk5ZDg1NmI0MTI0ZSIgVmVyc2lvbj0iMi4wIiBJc3N1ZUluc3RhbnQ9IjIwMjAtMDktMjhUMTM6MzA6MzEuNzg4WiI+CiAgICA8c2FtbDpJc3N1ZXI+aHR0cHM6Ly8yMG5xdWx2b3FwYnAuYXV0aGluZy5jbjwvc2FtbDpJc3N1ZXI+PGRzOlNpZ25hdHVyZSB4bWxuczpkcz0iaHR0cDovL3d3dy53My5vcmcvMjAwMC8wOS94bWxkc2lnIyI+PGRzOlNpZ25lZEluZm8+PGRzOkNhbm9uaWNhbGl6YXRpb25NZXRob2QgQWxnb3JpdGhtPSJodHRwOi8vd3d3LnczLm9yZy8yMDAxLzEwL3htbC1leGMtYzE0biMiLz48ZHM6U2lnbmF0dXJlTWV0aG9kIEFsZ29yaXRobT0iaHR0cDovL3d3dy53My5vcmcvMjAwMC8wOS94bWxkc2lnI3JzYS1zaGExIi8+PGRzOlJlZmVyZW5jZSBVUkk9IiNfZmFlOTViNDctY2JmMy00YTIwLWFkZDAtOTlkODU2YjQxMjRlIj48ZHM6VHJhbnNmb3Jtcz48ZHM6VHJhbnNmb3JtIEFsZ29yaXRobT0iaHR0cDovL3d3dy53My5vcmcvMjAwMC8wOS94bWxkc2lnI2VudmVsb3BlZC1zaWduYXR1cmUiLz48ZHM6VHJhbnNmb3JtIEFsZ29yaXRobT0iaHR0cDovL3d3dy53My5vcmcvMjAwMS8xMC94bWwtZXhjLWMxNG4jIi8+PC9kczpUcmFuc2Zvcm1zPjxkczpEaWdlc3RNZXRob2QgQWxnb3JpdGhtPSJodHRwOi8vd3d3LnczLm9yZy8yMDAwLzA5L3htbGRzaWcjc2hhMSIvPjxkczpEaWdlc3RWYWx1ZT4vb2w2bEMxaitzbWRvbmw0OCtsSlR6VWVxbnc9PC9kczpEaWdlc3RWYWx1ZT48L2RzOlJlZmVyZW5jZT48L2RzOlNpZ25lZEluZm8+PGRzOlNpZ25hdHVyZVZhbHVlPmF3emNFMGRwOEJ6VFc0YjRQRmFSWDdOS09DOTViTHFPblBlQUtJL0NzRGZHYUpkbXpDSzBmVmxpeitlNlh6Qmx1S2ZCcFF0clFvbktsN2sydlZOYVBGeDlQcFNWendLOTFITEd2WVEwcUIzNnVBNEhGdm0vM00zMURMM1pSRlBScTY4WmFWQUc2bE1WZDBZYmlJblZ2OUZXd3NpKzZqRXBGK1BSbG1rb3FBST08L2RzOlNpZ25hdHVyZVZhbHVlPjxkczpLZXlJbmZvPjxkczpYNTA5RGF0YT48ZHM6WDUwOUNlcnRpZmljYXRlPk1JSUNRakNDQWF1Z0F3SUJBZ0lCQURBTkJna3Foa2lHOXcwQkFRMEZBREErTVFzd0NRWURWUVFHRXdKMWN6RVNNQkFHQTFVRUNBd0o1THFMNWE2ZTVMaUtNUXd3Q2dZRFZRUUtEQU56YzNNeERUQUxCZ05WQkFNTUJITnpjM013SGhjTk1qQXdNVEF6TVRNeE9ERTBXaGNOTWpFd01UQXlNVE14T0RFMFdqQStNUXN3Q1FZRFZRUUdFd0oxY3pFU01CQUdBMVVFQ0F3SjVMcUw1YTZlNUxpS01Rd3dDZ1lEVlFRS0RBTnpjM014RFRBTEJnTlZCQU1NQkhOemMzTXdnWjh3RFFZSktvWklodmNOQVFFQkJRQURnWTBBTUlHSkFvR0JBTU5XbE1rNEwrVGNXd3lkOXBsVFBMaEhML1VNQ1BHSmd2NVZwOHZhQXA0V01zR3R3T0xJMVVOV2NjSXFNZVUwS2FzSnFyS3hIWXZxOUp6Wmg0ZmZ0Rm1vd0J6MzZ2ejBlSVVzUDVQS3ZGVUxrQzF2anJkbitRSlhiSjUxYWxaWktmUGdsMUhJOHc2bGgxMmFXVGphS1ErS2VtSXR0cUxxSmdMV09ZQVhQSXN6QWdNQkFBR2pVREJPTUIwR0ExVWREZ1FXQkJUVDEwNGhWWVZuUHBnN2FGckRpWFBTaGJ0eFVUQWZCZ05WSFNNRUdEQVdnQlRUMTA0aFZZVm5QcGc3YUZyRGlYUFNoYnR4VVRBTUJnTlZIUk1FQlRBREFRSC9NQTBHQ1NxR1NJYjNEUUVCRFFVQUE0R0JBQjYrMXhLN0dNSmE1TTZVamcvd2Q0RXR3eThOZFRGNnlwU3FOMzZCZDVPZFBtd1U5SHpEdUdqS2kzWndvb1BJR1JCOHBpTHNLazExTTRJaEFGNEMyUi9Kc3ZWWXdXT1lnb2pXNEgxaFI1d2syam43cGx0V3FSUGRmWkJsMFlmc0R5c1VQN2s4L01jaE9XWDdXaWZOeHBlM0dkU0tOMTdDa2RSakw5MjRiVjBsPC9kczpYNTA5Q2VydGlmaWNhdGU+PC9kczpYNTA5RGF0YT48L2RzOktleUluZm8+PC9kczpTaWduYXR1cmU+CiAgICA8c2FtbDpTdWJqZWN0PgogICAgICA8c2FtbDpOYW1lSUQgRm9ybWF0PSJ1cm46b2FzaXM6bmFtZXM6dGM6U0FNTDoxLjE6bmFtZWlkLWZvcm1hdDp1bnNwZWNpZmllZCI+eWV6dXdlaUBhdXRoaW5nLm9uYWxpeXVuLmNvbTwvc2FtbDpOYW1lSUQ+CiAgICAgIDxzYW1sOlN1YmplY3RDb25maXJtYXRpb24gTWV0aG9kPSJ1cm46b2FzaXM6bmFtZXM6dGM6U0FNTDoyLjA6Y206YmVhcmVyIj4KICAgICAgICA8c2FtbDpTdWJqZWN0Q29uZmlybWF0aW9uRGF0YSBOb3RPbk9yQWZ0ZXI9IjIwMjAtMDktMjhUMTQ6MzA6MzEuNzg4WiIgUmVjaXBpZW50PSJodHRwczovL3NpZ25pbi5hbGl5dW4uY29tL3NhbWwvU1NPIiBJblJlc3BvbnNlVG89ImE0OWY4ZWRpMzFjajBhMmE0NTlnMDMzMWMzZDljMTAiLz4KICAgICAgPC9zYW1sOlN1YmplY3RDb25maXJtYXRpb24+CiAgICA8L3NhbWw6U3ViamVjdD4KICAgIDxzYW1sOkNvbmRpdGlvbnMgTm90QmVmb3JlPSIyMDIwLTA5LTI4VDEzOjMwOjMxLjc4OFoiIE5vdE9uT3JBZnRlcj0iMjAyMC0wOS0yOFQxNDozMDozMS43ODhaIj4KICAgICAgPHNhbWw6QXVkaWVuY2VSZXN0cmljdGlvbj4KICAgICAgICA8c2FtbDpBdWRpZW5jZT5odHRwczovL3NpZ25pbi5hbGl5dW4uY29tLzEzNzQ2NjkzNzY1NzI0MjUvc2FtbC9TU088L3NhbWw6QXVkaWVuY2U+CiAgICAgIDwvc2FtbDpBdWRpZW5jZVJlc3RyaWN0aW9uPgogICAgPC9zYW1sOkNvbmRpdGlvbnM+PHNhbWw6QXV0aG5TdGF0ZW1lbnQgQXV0aG5JbnN0YW50PSIyMDIwLTA5LTI4VDEzOjMwOjMxLjg4OFoiIFNlc3Npb25JbmRleD0ib29ldW1jcTZlSGpkZHIxSDNGeXpvdTdDcy1PR1RzTmwiPjxzYW1sOkF1dGhuQ29udGV4dD48c2FtbDpBdXRobkNvbnRleHRDbGFzc1JlZj51cm46b2FzaXM6bmFtZXM6dGM6U0FNTDoyLjA6YWM6Y2xhc3Nlczp1bnNwZWNpZmllZDwvc2FtbDpBdXRobkNvbnRleHRDbGFzc1JlZj48L3NhbWw6QXV0aG5Db250ZXh0Pjwvc2FtbDpBdXRoblN0YXRlbWVudD48c2FtbDpBdHRyaWJ1dGVTdGF0ZW1lbnQ+PHNhbWw6QXR0cmlidXRlIE5hbWU9ImVtYWlsIiBOYW1lRm9ybWF0PSJ1cm46b2FzaXM6bmFtZXM6dGM6U0FNTDoyLjA6YXR0cm5hbWUtZm9ybWF0OmJhc2ljIj48c2FtbDpBdHRyaWJ1dGVWYWx1ZSB4bWxuczp4cz0iaHR0cDovL3d3dy53My5vcmcvMjAwMS9YTUxTY2hlbWEiIHhtbG5zOnhzaT0iaHR0cDovL3d3dy53My5vcmcvMjAwMS9YTUxTY2hlbWEtaW5zdGFuY2UiIHhzaTp0eXBlPSJ4czpzdHJpbmciPnllenV3ZWlAYXV0aGluZy5jbjwvc2FtbDpBdHRyaWJ1dGVWYWx1ZT48L3NhbWw6QXR0cmlidXRlPjxzYW1sOkF0dHJpYnV0ZSBOYW1lPSJuYW1lIiBOYW1lRm9ybWF0PSJ1cm46b2FzaXM6bmFtZXM6dGM6U0FNTDoyLjA6YXR0cm5hbWUtZm9ybWF0OmJhc2ljIj48c2FtbDpBdHRyaWJ1dGVWYWx1ZSB4bWxuczp4cz0iaHR0cDovL3d3dy53My5vcmcvMjAwMS9YTUxTY2hlbWEiIHhtbG5zOnhzaT0iaHR0cDovL3d3dy53My5vcmcvMjAwMS9YTUxTY2hlbWEtaW5zdGFuY2UiIHhzaTp0eXBlPSJ4czpzdHJpbmciLz48L3NhbWw6QXR0cmlidXRlPjxzYW1sOkF0dHJpYnV0ZSBOYW1lPSJ1c2VybmFtZSIgTmFtZUZvcm1hdD0idXJuOm9hc2lzOm5hbWVzOnRjOlNBTUw6Mi4wOmF0dHJuYW1lLWZvcm1hdDpiYXNpYyI+PHNhbWw6QXR0cmlidXRlVmFsdWUgeG1sbnM6eHM9Imh0dHA6Ly93d3cudzMub3JnLzIwMDEvWE1MU2NoZW1hIiB4bWxuczp4c2k9Imh0dHA6Ly93d3cudzMub3JnLzIwMDEvWE1MU2NoZW1hLWluc3RhbmNlIiB4c2k6dHlwZT0ieHM6c3RyaW5nIj55ZXp1d2VpQGF1dGhpbmcuY248L3NhbWw6QXR0cmlidXRlVmFsdWU+PC9zYW1sOkF0dHJpYnV0ZT48c2FtbDpBdHRyaWJ1dGUgTmFtZT0icGhvbmUiIE5hbWVGb3JtYXQ9InVybjpvYXNpczpuYW1lczp0YzpTQU1MOjIuMDphdHRybmFtZS1mb3JtYXQ6YmFzaWMiPjxzYW1sOkF0dHJpYnV0ZVZhbHVlIHhtbG5zOnhzPSJodHRwOi8vd3d3LnczLm9yZy8yMDAxL1hNTFNjaGVtYSIgeG1sbnM6eHNpPSJodHRwOi8vd3d3LnczLm9yZy8yMDAxL1hNTFNjaGVtYS1pbnN0YW5jZSIgeHNpOnR5cGU9InhzOnN0cmluZyI+bnVsbDwvc2FtbDpBdHRyaWJ1dGVWYWx1ZT48L3NhbWw6QXR0cmlidXRlPjwvc2FtbDpBdHRyaWJ1dGVTdGF0ZW1lbnQ+PC9zYW1sOkFzc2VydGlvbj4KPC9zYW1scDpSZXNwb25zZT4="/><inputtype="hidden"name="RelayState"id="relay-state"value=""/><scripttype="text/javascript">(function(){document.forms[0].submit();})(); (提示:代码可向右滑动) 没有什么神秘的,就是一个 HTML form 表单和一段立即提交该表单的 JS 代码。其中的 SAML Response 信息如下: base64 decode + inflate 解码后 (https://www.samltool.com/decode.php) <samlp:Responsexmlns:samlp="urn:oasis:names:tc:SAML:2.0:protocol"xmlns:saml="urn:oasis:names:tc:SAML:2.0:assertion"ID="_62b177c1-a919-42f6-9586-47f13b71081f"Version="2.0"IssueInstant="2020-09-28T13:30:31.788Z"Destination="https://signin.aliyun.com/saml/SSO"InResponseTo="a49f8edi31cj0a2a459g0331c3d9c10"><saml:Assertionxmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"xmlns:xs="http://www.w3.org/2001/XMLSchema"xmlns:saml="urn:oasis:names:tc:SAML:2.0:assertion"ID="_fae95b47-cbf3-4a20-add0-99d856b4124e"Version="2.0"IssueInstant="2020-09-28T13:30:31.788Z"><ds:Signaturexmlns:ds="http://www.w3.org/2000/09/xmldsig#"><saml:ConditionsNotBefore="2020-09-28T13:30:31.788Z"NotOnOrAfter="2020-09-28T14:30:31.788Z"><saml:AuthnStatementAuthnInstant="2020-09-28T13:30:31.888Z"SessionIndex="ooeumcq6eHjddr1H3Fyzou7Cs-OGTsNl"> (提示:代码可向右滑动) 这段内容就是用户的身份断言,也就是用户的 Token,只不过这个 Token 通过 XML 格式传递。 读到这里,你可能会对 SP、IdP 如何处理这些冗长的 XML 信息感到困惑。Authing 会解决这些繁琐的处理,而你只需关注如何正确地配置 Authing IdP,与 SAML SP 进行通信。 SAML2 流程 本文为读者讲述 SAML 中,SP、IdP、浏览器三个实体之间数据交互的流程。 SAML 协议中涉及到的主体 使用 SAML 协议进行身份认证时,涉及到以下三个主体 浏览器:SP 和 IdP 借助浏览器互相通信 SP:资源提供方 IdP:身份认证提供方 发起 SAML 登录到登录成功的整个过程 用户试图登录 SP 提供的应用。 SP 生成 SAML Request,通过浏览器重定向,向 IdP 发送 SAML Request。 IdP 解析 SAML Request 并将用户重定向到认证页面。 用户在认证页面完成登录。 IdP 生成 SAML Response,通过对浏览器重定向,向 SP 的 ACS 地址返回 SAML Response,其中包含 SAML Assertion 用于确定用户身份。 SP 对 SAML Response 的内容进行检验。 用户成功登录到 SP 提供的应用。 SP 与 IdP 之间通信方式 SP 与 IdP 之间的通信方式分为 HTTP Redirect Binding、HTTP POST Binding、HTTP Artifact Binding。每种方式在不同的阶段会用不同类型的 HTTP 与对方通信。 HTTP Redirect Binding SP 通过重定向 GET 请求把 SAML Request 发送到 IdP,IdP 通过立即提交的 Form 表单以 POST 请求的方式将 SAML Response 发到 SP。 HTTP POST Binding IdP 通过立即提交的 Form 表单以 POST 请求的方式将 SAML Request 发到 SP。IdP 通过立即提交的 Form 表单以 POST 请求的方式将 SAML Response 发到 SP。 HTTP Artifact Binding SP、IdP 双方只通过浏览器交换 SAML Request、SAML Response 的索引编号,收到编号后,在后端请求对方的 Artifact Resolution Service 接口来获取真正的请求实体内容。从而避免 SAML Request、SAML Response 暴露在前端。 如果你喜欢我们的内容,欢迎关注公众号「Authing 身份云」和访问我们的博客Authing 博客,更多有趣的内容等你来看~

优秀的个人博客,低调大师

开发人员如何理解kubernetes

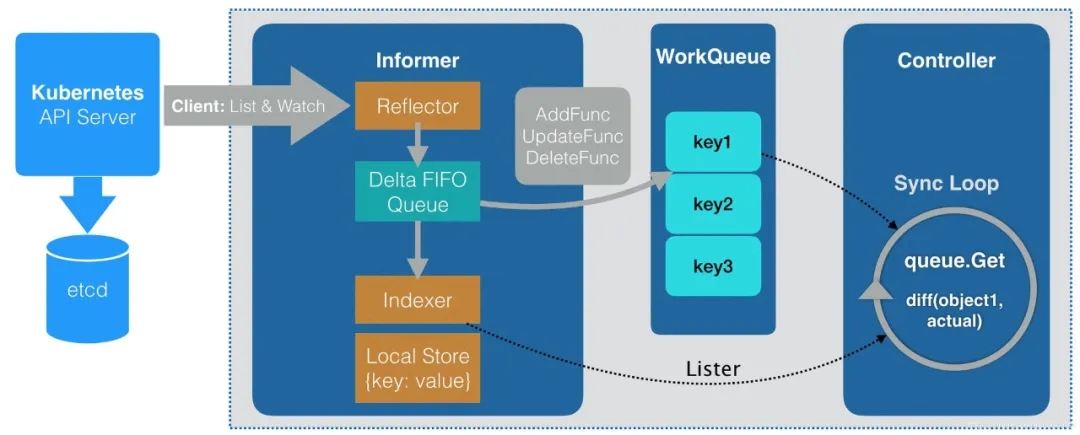
概述 在JAVA开发中使用 docker run命令配合上自建的Docker仓库可以很容易部署JAVA服务,但是使用Docker部署应用会有几个问题: 一个 docker run 不是部署服务的可靠方法,因为它创建的容器在单个机器运行。虽然Docker引擎提供了一些基本的管理功能,例如在容器崩溃或计算器重启时自动重启容器。但是它不能处理机器崩溃。无法保证服务的高可用! 另一个问题是服务通常不是孤立存在,而是相互依赖的,例如数据库和消息队列。我们通常需要将服务及其依赖项作为一个单元部署或取消部署。 在开发过程中特别好用的方法是使用Docker Compose。Docker Compose是一个工具,它允许使用YAML文件以声明方式定义一组容器,然后以组的形式启动和停止这些容器。 但是使用Docker Compose也有个很明显的问题就是它仅限于一台机器。要可靠的部署服务,必须使用Docker编排框架,例如Kubernetes。 Kubernetes简介 Kubernates是一个Docker编排框架,是Docker之上的一个软件层,它将一组计算机硬件资源转变成用于运行服务的单一资源池。它努力保持每个服务所需要的实例数量,并确保它们一直在线,即使服务实例或机器崩溃也是如此。容器的灵活性和Kubernetes的复杂性相结合是部署服务的一种强有力的方式。 Kubernetes有三个主要功能: 资源管理:将一组计算机视为由CPU、内存和存储卷构成的资源池,将计算机集群视为一台计算机。 调度:选择要运行容器的机器。默认情况下,调度考虑容器的资源需求和每个节点的可用资源。它还可以实现在同一节点部署具有亲和性(affinity)的容器,或保持特定几个容器分散部署在不同的节点上(反亲和性,anti-affinity) 服务管理:实现命名和版本化服务的概念,这个概念可以直接映射到微服务架构中的具体服务。编排框架确保始终运行所需数量的正常实例。它实现请求的负载均衡。编排框架也可以执行服务的滚动升级,并允许你回滚到旧版本。 Kubernetes架构 Kubernetes架构 Kubernetes在一组机器上运行。Kubernetes集群中的计算机角色分为主节点和普通节点。集群中只有很少的几个主节点(可能只有一个)和很多普通节点。 「主节点」负责管理集群。Kubernetes的「普通节点」称为 “工作节点”,它会运行一个或多个Pod。Pod是Kubernetes的部署单元,由一组容器组成。 主节点运行多个组件,包括以下内容: API服务器:用于部署和管理服务的REST API,例如,可被kubectl命令行使用。 Etcd:存储集群数据键值的NoSQL数据库。 调度器:选择要运行POD的节点。 控制器管理器:运行控制器,确保集群状态与预期状态匹配。例如,一种被称为 复制(replication)控制器 的控制器通过启动和终止实例来确保运行所需要的服务实例。 普通节点运行多个组件,包括以下内容: Kubelet:创建和管理节点上运行的Pod。 Kube-proxy:管理网络,包括跨Pod的负载均衡。 Pods:应用程序服务。 接下来我们看一下Kubernetes上部署服务需要掌握的关键Kubernetes概念,掌握这几个概念就抓住了Kubernetes的核心。 Kubernetes的关键概念 Kubernetes是很复杂的,但是,一旦掌握了一些「关键对象」的概念,就可以高效的使用Kubernetes。Kubernetes定义了许多类型的对象,从开发人员的角度来看,最重要的对象如下: Pod: Pod是Kubernetes的基本部署单元。它由一个或多个共享IP地址和存储卷的容器组成。服务实例的pod通常由单个容器组成,例如运行 JVM 的容器。但在某些情况下,Pod包含一个或多个实现支持功能的 「边车」(sidecar)容器。例如,Nginx 服务器可以有一个边车容器,定期执行 git pull 以下载最新版本的网站。Pod的生命周期很短,因为Pod的容器或它运行的节点可能会崩溃。 Deployment: Deployment : Pod 的声明性规范。Deployment是一个控制器,可确保始终运行所需数量的Pod实例 (服务实例)。它通过滚动升级和回滚来支持版本控制。 Service: 向应用程序服务的客户端提供的一个静态/稳定的网络地址。它是基础设施提供的服务发现的一种形式。每个 Service具有一个 IP 地址和一个可解析为该 IP 地址的 DNS 名称,并跨一个或多个 Pod对 TCP 和 UDP 流量进行负载均衡处理。IP地址和 DNS 名称只能在Kubernetes内部访问。 Service默认是使用ClusterIp模式,如果需要外部能访问到这个Service则需要使用另外两种类型的对象:NodePort 和 LoadBalancer。 ConfigMap: 名称与值对的命名集合,用于定义一个或多个应用程序服务的外部化配置。Pod容器的定义可以引用ConfigMap来定义容器的环境变量。它还可以使用ConfigMap在容器内创建配置文件。可以使用Secret来存储敏感信息(如密码),它也是 ConfigMap的一种形式。 以上,希望对你有所帮助! End 干货分享 这里为大家准备了一份小小的礼物,关注公众号,输入如下代码,即可获得百度网盘地址,无套路领取!001:《程序员必读书籍》002:《从无到有搭建中小型互联网公司后台服务架构与运维架构》003:《互联网企业高并发解决方案》004:《互联网架构教学视频》006:《SpringBoot实现点餐系统》007:《SpringSecurity实战视频》008:《Hadoop实战教学视频》009:《腾讯2019Techo开发者大会PPT》 010:微信交流群 近期热文top 1、关于JWT Token 自动续期的解决方案 2、SpringBoot开发秘籍-事件异步处理 3、架构师之路-服务器硬件扫盲 4、基于Prometheus和Grafana的监控平台 - 环境搭建 5、RocketMQ进阶-事务消息 我就知道你“在看” 本文分享自微信公众号 - JAVA日知录(javadaily)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

深入理解gradle中的task

简介 在之前的文章中,我们讲到了如何使用gradle创建一个简单的task,以及task之间怎么依赖,甚至使用了程序来创建task。在本文中,我们会更加深入的去了解一下gradle中的task。 定义task 定义一个task可以有很多种方式,比如下面的使用string作为task的名字: task('hello') { doLast { println "hello" } } task('copy', type: Copy) { from(file('srcDir')) into(buildDir) } 还可以使用tasks容器来创建: tasks.create('hello') { doLast { println "hello" } } tasks.create('copy', Copy) { from(file('srcDir')) into(buildDir) } 上面的例子中,我们使用tasks.create方法,将新创建的task加到tasks集合中。 我们还可以使用groovy特有的语法来定义一个task: task(hello) { doLast { println "hello" } } task(copy, type: Copy) { from(file('srcDir')) into(buildDir) } tasks 集合类 上面我们在创建task的时候,使用了tasks集合类来创建task。 实际上,tasks集合类是一个非常有用的工具类,我们可以使用它来做很多事情。 直接在build文件中使用tasks,实际上是引用了TaskContainer的一个实例对象。我们还可以使用 Project.getTasks() 来获取这个实例对象。 我们看下TaskContainer的定义: public interface TaskContainer extends TaskCollection<Task>, PolymorphicDomainObjectContainer<Task> 从定义上,我们可以看出TaskContainer是一个task的集合和域对象的集合。 taskContainer中有四类非常重要的方法: 第一类是定位task的方法,有个分别是findByPath和getByPath。两个方法的区别就是findByPath如果没找到会返回null,而getByPath没找到的话会抛出UnknownTaskException。 看下怎么使用: task hello println tasks.getByPath('hello').path println tasks.getByPath(':hello').path 输出: :hello :hello 第二类是创建task的方法create,create方法有多种实现,你可以直接通过名字来创建一个task: task('hello') { doLast { println "hello" } } 也可以创建特定类型的task: task('copy', type: Copy) { from(file('srcDir')) into(buildDir) } 还可以创建带参数的构造函数的task: class CustomTask extends DefaultTask { final String message final int number [@Inject](https://my.oschina.net/u/4027648) CustomTask(String message, int number) { this.message = message this.number = number } } 上面我们为CustomTask创建了一个带参数的构造函数,注意,这里需要带上@javax.inject.Inject注解,表示我们后面可以传递参数给这个构造函数。 我们可以这样使用: tasks.create('myTask', CustomTask, 'hello', 42) 也可以这样使用: task myTask(type: CustomTask, constructorArgs: ['hello', 42]) 第三类是register,register也是用来创建新的task的,不过register执行的是延迟创建。也就是说只有当task被需要使用的时候才会被创建。 我们先看一个register方法的定义: TaskProvider<Task> register​(String name, Action<? super Task> configurationAction) throws InvalidUserDataException 可以看到register返回了一个TaskProvider,有点像java多线程中的callable,当我们调用Provider.get()获取task值的时候,才会去创建这个task。 或者我们调用TaskCollection.getByName(java.lang.String)的时候也会创建对应的task。 最后一类是replace方法: Task replace​(String name) <T extends Task> T replace​(String name, Class<T> type) replace的作用就是创建一个新的task,并且替换掉同样名字的老的task。 Task 之间的依赖 task之间的依赖关系是通过task name来决定的。我们可以在同一个项目中做task之间的依赖: task hello { doLast { println 'Hello www.flydean.com!' } } task intro { dependsOn hello doLast { println "I'm flydean" } } 也可以跨项目进行task的依赖,如果是跨项目的task依赖的话,需要制定task的路径: project('project-a') { task taskX { dependsOn ':project-b:taskY' doLast { println 'taskX' } } } project('project-b') { task taskY { doLast { println 'taskY' } } } 或者我们可以在定义好task之后,再处理task之间的依赖关系: task taskX { doLast { println 'taskX' } } task taskY { doLast { println 'taskY' } } 还可以动态添加依赖关系: task taskX { doLast { println 'taskX' } } // Using a Groovy Closure taskX.dependsOn { tasks.findAll { task -> task.name.startsWith('lib') } } task lib1 { doLast { println 'lib1' } } task lib2 { doLast { println 'lib2' } } task notALib { doLast { println 'notALib' } } 定义task之间的顺序 有时候我们的task之间是有执行顺序的,我们称之为对task的排序ordering。 先看一下ordering和dependency有什么区别。dependency表示的是一种强依赖关系,如果taskA依赖于taskB,那么执行taskA的时候一定要先执行taskB。 而ordering则是一种并不太强列的顺序关系。表示taskA需要在taskB之后执行,但是taskB不执行也可以。 在gradle中有两种order:分别是must run after和should run after。 taskA.mustRunAfter(taskB)表示必须遵守的顺序关系,而taskA.shouldRunAfter(taskB)则不是必须的,在下面两种情况下可以忽略这样的顺序关系: 第一种情况是如果shouldRunAfter引入了order循环的时候。 第二种情况是如果在并行执行的情况下,task所有的依赖关系都已经满足了,那么也会忽略这个顺序。 我们看下怎么使用: task taskX { doLast { println 'flydean.com' } } task taskY { doLast { println 'hello' } } taskY.mustRunAfter taskX //taskY.shouldRunAfter taskX 给task一些描述 我们可以给task一些描述信息,这样我们在执行gradle tasks的时候,就可以查看到: task copy(type: Copy) { description 'Copies the resource directory to the target directory.' from 'resources' into 'target' include('**/*.txt', '**/*.xml', '**/*.properties') } task的条件执行 有时候我们需要根据build文件中的某些属性来判断是否执行特定的task,我们可以使用onlyIf : task hello { doLast { println 'www.flydean.com' } } hello.onlyIf { !project.hasProperty('skipHello') } 或者我们可以抛出StopExecutionException异常,如果遇到这个异常,那么task后面的任务将不会被执行: task compile { doLast { println 'We are doing the compile.' } } compile.doFirst { if (true) { throw new StopExecutionException() } } task myTask { dependsOn('compile') doLast { println 'I am not affected' } } 我们还可以启动和禁用task: myTask.enabled = false 最后我们还可以让task超时,当超时的时候,执行task的线程将会被中断,并且task将会被标记为failed。 如果我们想继续执行,那么可以使用 --continue。 注意, 只有能够响应中断的task,timeout才有用。 task hangingTask() { doLast { Thread.sleep(100000) } timeout = Duration.ofMillis(500) } task rule 如果我们想要给某些task定义一些规则,那么可以使用tasks.addRule: tasks.addRule("Pattern: ping<ID>") { String taskName -> if (taskName.startsWith("ping")) { task(taskName) { doLast { println "Pinging: " + (taskName - 'ping') } } } } 上我们定义了一个rule,如果taskName是以ping开头的话,那么将会输出对应的内容。 看下运行结果: > gradle -q pingServer1 Pinging: Server1 我还可以将这些rules作为依赖项引入: task groupPing { dependsOn pingServer1, pingServer2 } Finalizer tasks 和java中的finally一样,task也可以指定对应的finalize task: task taskX { doLast { println 'taskX' } } task taskY { doLast { println 'taskY' } } taskX.finalizedBy taskY > gradle -q taskX taskX taskY finalize task是一定会被执行的,即使上面的taskX中抛出了异常。 总结 以上就是gradle中task的详解,希望大家能够喜欢。 本文已收录于 http://www.flydean.com/gradle-task-in-depth/ 最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现! 欢迎关注我的公众号:「程序那些事」,懂技术,更懂你!

优秀的个人博客,低调大师

三步轻松理解Kerberos协议

Kerberos是一种身份验证协议,它作为一种可信任的第三方认证服务,通过使用对称加密技术为客户端/服务器应用程序提供强身份验证。在域环境下,AD域使用Kerberos协议进行验证,熟悉和掌握Kerberos协议是学习域渗透的基础。 Kerberos协议中主要的三个角色: 1.访问服务的Client2.提供服务的Server3.KDC:密钥分发中心,默认安装在域控上 AS:身份验证服务 TGS:票证授予服务 Kerberos协议认证过程: 协议可以分为三个步骤:一是获得票据许可票据,二是获取服务许可票据,三是获得服务。 第一步:获得票据许可票据 KRB_AS_REQ:用于向KDC请求TGT 当用户在客户端输入域用户和密码时,客户端将用户密码转换为hash作为加密密钥,对时间戳进行加密作为请求凭据。 cipher:加密的时间戳,即客户端的当前时间与用户的hash加密后的结果 KRB_AS_REQ 数据包如下: KRB_AS_REP:用于通过KDC传递TGT 收到请求后,KDC从AD域数据库中找到对用用户的hash解密时间戳来验证用户身份。如果时间戳在允许的时间范围内,那么它就会生成一个会话密钥(Session key),以AS_REP 数据包进行响应。 AS_REP 包含信息: ticket:使用krbtgt hash加密,包含用户名/会话密钥和到期时间等信息.enc-part:使用用户hash加密,包含会话密钥/TGT到期时间和随机数(防重放) KRB_AS_REP数据包如下: 第二步:获得服务许可票据 KRB_TGS_REQ:使用TGT向KDC请求TGS 客户端获得TGT和用户密钥加密的enc-part,使用用户hash解密enc-part获得会话密钥(Session key),然后使用会话密钥将用户名/时间戳进行加密,生成authenticator和TGT发送给TGS。 ticket:实质上就是一张TGT,客户端没有 krbtgt hash,故无法解密TGT. KRB_TGS_REQ 数据包如下: KRB_TGS_REP:通过KDC传递TGS TGS 收到KRB_TGS_REQ请求后,使用 krbtgt hash解密ticket 获取会话密钥(Session key),然后使用会话密钥解密 authenticator 获取用户名和时间戳进行身份验证。确认信息后,创建一个服务会话密钥(Service Session key)。 ticket:使用对应的服务密钥进行加密,包含服务会话密钥/用户名/到期时间等信息,本质上就是一张ST(Service Ticket)。enc-part:包含使用会话密钥加密的服务会话密钥(Service Session key) KRB_TGS_REP数据包如下: 第三步:获得服务 KRB_AP_REQ:使用TGS,服务对用户身份验证 客户端已经拥有了有效的TGS可以与服务进行交互,使用会话密钥解密 enc-part,得到 服务会话密钥(Service Session key),将用户名/时间戳等信息使用服务会话密钥(Service Session key)进行加密,得到新的Authentication。 KRB_AP_REP:由服务用来针对用户标识自身 服务端接收到请求,使用自己的hash解密TGS获得服务会话密钥(Service Session key)和授权用户信息,然后使用服务会话密钥解密Authentication,比对用户名和时间戳等信息,如果有相互验证标记,服务端使用服务会话密钥加密时间戳发给客户端,客户端解密时间戳验证服务端,然后开始请求服务。 本文分享自微信公众号 - Bypass(Bypass--)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册