首页 文章 精选 留言 我的

精选列表

搜索[自我进化],共7171篇文章
优秀的个人博客,低调大师

从对话到自主行动:AI 应用如何从 Chat 进化为 Agent?开源项目源码深度揭秘

一、引言 从2022年12月份OpenAI发布ChatGPT产品至今已有2年多的时间,当大家已经习惯于在对话框中与AI交互,习惯于通过各种Prompt技巧让AI更好的理解并回答我们的问题,似乎默认这就是一种比较好与AI的交互方式了。 然而,这就是我们期盼的与AI交互的形式嘛?这是一种高效的方式嘛? 显然,这是不够的。 我们期望的是:告诉AI我们想要的目标或者任务,AI能够理解深度理解并分析我们的意图、自动的进行任务的拆解、自动的寻找可以使用的工具、自动的进行结果数据的汇总过滤、自动的呈现符合任务的展示形式。同时在任务处理过程中,可以自己完成异常的检测和修改。就如同一位优秀的同学,我们告诉他任务的目标,他可以自己寻找飞书文档、搜索网络知识、使用内部系统、自己编码验证方案可行性,并最终给一份好的解决方案。 二、以「对话为中心」的ChatBot 我们发送一条指令,AI被动的响应指令。即完成一轮人与AI的交互。 具体视频请前往“得物技术”微信公众号观看。 三、以「交付为中心」的多智能体Agent 我们发送一个任务,AI自动分析任务、调用可用的工具、分析结果、过滤数据并自动处理异常,最终呈现解决方案。 完成这样的一个任务,需要多智能体Agent间的协作以及对常用工具的调用。那什么是智能体Agent呢? 具体视频请前往“得物技术”微信公众号观看。 四、什么是智能体Agent 从Prompt到思维链 随着大模型的发展,Prompt工程已成为撬动大模型潜能的核心技术。即使我们普通用户在与大模型的交互中,也通过角色定义(如"资深工程师")或示例引导来优化输出效果,但这类简单提示往往难以突破模型固有的逻辑天花板——就像给赛车装自行车轮胎,再怎么调整也难以突破速度极限。 但偶然间,人们发现了一个神奇的咒语:只需要告诉大模型,你的 think 要 step by step。研究者发现只要加了这个prompt,就能极为显著地改善大模型做数学题的正确率。 大模型的数学与逻辑能力短板,是所有体验过其对话功能的用户都能直观感受到的痛点。这一缺陷严重制约了大模型的商业化落地进程,毕竟没有人敢轻易信任一个逻辑混乱的智能系统能输出可靠的决策结果。于是,提升大模型数学能力,被所有做基础模型的公司当作了第一目标。 研究者试图通过强化思维链来突破这一瓶颈。一个直观的思路是:让模型像人类解题时在草稿纸上推演那样,通过 "step by step" 的方式展开逻辑链条 —— 在这个过程中,包含假设、演绎、反思、纠错等一系列思维活动。既然人类通过这种结构化的思考方式能够有效解决数学问题,那么大模型是否也能通过类似机制实现能力跃迁?这一猜想推动着研究向纵深发展,最终形成了思维链技术的核心框架。这样的观念经过继续钻研,最终就构成了思维链,思维链是一个能以最小的代价,而非常显著提升模型智力水平(逻辑能力、解题能力、代码能力)的技术。 值得注意的是,2025 年春节期间引发广泛关注的 DeepSeek 大模型,正是思维链技术的成功实践典范。尽管 DeepSeek 并非首创者,但其通过创新性地融合混合专家(MoE)架构与强化学习技术,显著提升了思维链推理的计算效率与性能表现。这种技术优化使得 DeepSeek 在保持高精度推理的同时,大幅降低了计算成本,最终实现了屠榜级表现。 ReAct架构 如果说思维链(COT)是给 AI 装上了人类的 "草稿纸",那么 ReAct 框架就是为它配备了 "双手"—— 让 AI 不仅能在脑子里推演,还能主动采取行动获取信息。这种 "思考 + 行动" 的组合,正在把大模型从 "纸上谈兵" 的理论家,变成能解决现实问题的实干家。 ReAct 的核心在于将**推理(Reasoning)与行动(Action)**紧密结合。当模型面对复杂问题时,会先像人类一样拆解思考步骤,然后根据中间结果调用外部工具(如搜索引擎、数据库、计算器)获取实时数据,再把这些信息整合到后续推理中。 其实,实现一个ReAct很简单,只需要构建Prompt+提供工具+循环执行即可,笔者在这里不进行详细的介绍,只需要给一个Prompt例子,读者就能理解: 尽可能最好地为用户回答接下来的问题,你可以使用以下工具来辅助你:{tools} 使用以下格式: -问题:你需要回答的输入问题 -思考:你需要持续思考下一步采取什么行动 -行动:要采取的行动,应该是[{tool_names}]中的一个,以及该行动的输入内容 -观察:行动并观测结果,并判断结果是否合理 ...(这个思考/行动/观察可以重复 N 次,直到你认为知道了最终答案 -最终答案:原始输入问题的最终答案 开始! -问题:{input} Tools支持开发者自定义,比如给予LLM一个查询天气的接口、计算器接口等。 ReAct架构实现了一种**"问题拆解-工具调用-结果整合"的闭环机制,使得开发者仅需通过定义工具集(如天气API、计算器、知识图谱接口)和设计任务引导词,就能将大模型转化为可执行多步骤决策的智能体。最终可以使大模型突破纯文本推理的局限,真正具备了在动态场景中解决开放性问题的工程化能力。 Agent Agent作为大模型技术的集大成者,通过整合思维链(CoT)的推理能力和ReAct框架的行动机制,构建了具备自主决策与执行能力的智能系统。其核心突破在于将**“大脑”与“四肢”**有机统一,标志着大模型从被动应答迈向主动干预现实的质变。 在架构上,Agent与ReAct差别不大,ReAct是Agent的核心实现范式之一,Agent进一步整合记忆存储、多智能体协作等模块,形成更完整的自主决策系统。下图是一个简单的Agent架构图: Agent处理流程 1-4步会循环进行,直到LLM认为问题已被回答。 1.规划(Planning): 定义:规划是Agent的思维模型,负责拆解复杂任务为可执行的子任务,并评估执行策略。 实现方式:通过大模型提示工程(如ReAct、CoT推理模式)实现,使Agent能够精准拆解任务,分步解决。 2.记忆(Memory): 定义:记忆即信息存储与回忆,包括短期记忆和长期记忆。 实现方式:短期记忆用于存储会话上下文,支持多轮对话;长期记忆则存储用户特征、业务数据等,通常通过向量数据库等技术实现快速存取。 3.工具(Tools): 定义:工具是Agent感知环境、执行决策的辅助手段,如API调用、插件扩展等。 实现方式:通过接入外部工具(如API、插件)扩展Agent的能力,如ChatPDF解析文档、Midjourney文生图等。 4.行动(Action): 定义:行动是Agent将规划与记忆转化为具体输出的过程,包括与外部环境的互动或工具调用。 实现方式:Agent根据规划与记忆执行具体行动,如智能客服回复、查询天气预报、AI机器人抓起物体等。 Manus:一个Agent典型案例 在读完前一节关于智能体(Agent)的技术解析后,读者也许会认为这类系统的工程实现并非难事,实际上也确实是这样。近期爆火的 Agent 产品 Manus 便是典型案例。当用户提出 "定制 7 天日本旅行计划" 的需求时,Manus 能够基于目标,自主进行网络搜索并将信息整合,展现出高度拟人化的任务执行逻辑。 尽管 Manus 目前尚未向普通用户开放,且采用邀请制注册的封闭运营模式,但其通过官方演示视频呈现的强大智能化表现,已在技术圈引发广泛关注。值得关注的是,随着Agent技术的热度攀升,开源社区已迅速涌现出 OpenManus、OWL 等多个复刻项目。 因为Manus并非开源,我们很难了解其技术细节。但好在: "Manus 的部分技术细节,包括其提示词设计、运行机制等内容被网友通过非官方渠道披露,感兴趣的读者可自行查阅相关公开资料。 我们可以了解一下大模型上下文协议(Model Context Protocol,MCP),这是 Anthropic (Claude) 主导发布的一个开放的、通用的、有共识的协议标准,虽然Manus不一定用了这个协议,但目前一些相关开源项目也是基于MCP的,本文会在下面介绍MCP。 目前已有复刻的开源项目Openmanus,笔者会在接下来的章节剖析其源码。 大模型上下文协议(MCP) MCP是做什么的? MCP(Model Context Protocol)作为一项开放协议,旨在为应用程序与大型语言模型(LLMs)之间的上下文交互提供标准化框架。其设计理念可类比为数字时代的 "USB-C 接口"—— 正如 USB-C 统一了设备与外设的连接标准,MCP 通过标准化的上下文交互接口,实现了 AI 模型与多样化数据源、工具之间的无缝对接。 如下图所示,图中的MCP server都可以看成一个个工具(如搜索引擎、天气查询),通过“接口”连接到MCP clients(大模型)上,大模型可以使用各种MCP server来更好地处理用户的问题。 此外,下游工具的开发者也可以更好的开发其工具,目前在MCP官网即可了解其各种编程语言的SDK和相关概念。 MCP架构 MCP 的核心采用客户端-服务器架构,其中 host 可以连接到多个服务器,读者简单看看即可: MCP 主机(MCP Hosts):指需要通过 MCP 协议获取数据的应用程序,涵盖 AI 开发工具(如 Claude Desktop)、集成开发环境(IDEs)等智能应用场景。 MCP 客户端(MCP Clients):作为协议的执行者,每个客户端与对应的 MCP 服务器建立一对一的专属连接,负责协议层面的通信交互。 MCP 服务器(MCP Servers):轻量化的功能载体,通过标准化的 Model Context Protocol 对外开放特定能力,可视为连接模型与工具的智能桥梁。 本地化数据源(Local Data Sources):包括服务器可安全访问的本地文件系统、数据库及专有服务,构成数据交互的近端生态。 远程服务(Remote Services):通过互联网连接的外部系统,例如各类 API 接口服务,拓展了模型的能力边界。 为什么要用MCP? 从技术演进视角看,MCP 的诞生是提示工程(Prompt Engineering)发展的必然产物。研究表明,结构化的上下文信息能显著提升大模型的任务表现。在传统提示工程中,我们往往需要人工从数据库筛选信息或通过工具检索相关内容,再手动将这些信息注入提示词。然而,随着复杂任务场景的增多,这种手工注入信息的操作变得愈发繁琐且低效。 为解决这一痛点,主流大模型平台(如 OpenAI、Google)先后引入了函数调用(Function Call)机制。该机制允许模型在推理过程中主动调用预定义函数获取数据或执行操作,极大提升了自动化水平。然而,函数调用机制存在显著局限性:其一,不同平台的函数调用 API 存在较大差异,例如 OpenAI 与 Google 的实现方式互不兼容,开发者在切换模型时需重新编写代码,徒增适配成本;其二,该机制在安全性、交互性及复杂场景的扩展性方面仍存在优化空间。 在此背景下,MCP 协议通过标准化的上下文交互接口,为大模型构建了更具普适性的工具调用框架。它不仅解耦了模型与工具的依赖关系,还通过统一的协议规范解决了跨平台兼容性问题。更重要的是,MCP 将上下文管理提升到系统架构层面,为大模型在复杂业务场景中的深度应用提供了可扩展的技术底座。这种从碎片化的提示工程到体系化的上下文协议的演进,标志着大模型应用正在向更高效、更规范的方向迈进。 四、智能体Agent实现的源码剖析(OpenManus项目) OpenManus 是一个基于 MCP 协议的开源智能体实现项目,旨在通过标准化的上下文协议实现大模型与工具的高效协同。当前项目仍处于快速迭代阶段,本文以其 2025 年 3 月 12 日的版本为分析对象。选择该项目的原因如下: 团队背景与代码质量:项目作者来自MetaGPT,具备深厚的工程经验,代码结构清晰且注释完善,兼顾了技术实现与可读性。 部署便捷性:只需通过虚拟环境安装依赖并配置大模型 API Key(如 OpenAI 的 API 密钥),即可快速启动,降低了技术门槛。 技术前沿性:项目紧跟大模型技术发展,且目前仍在不断迭代的过程中。 在经过前面对相关概念的讨论,我们可以得知实现Agent有几个关键的点,读者可以带着问题在项目中寻找答案: Prompt:其结构化的Prompt是什么样的?通过Prompt可以对其架构有一个初步认识。 OpenManus:怎么通过大模型思考和处理问题? 工具相关:怎么进行工具注册、工具管理的?工具执行逻辑是什么的? 准备 项目地址: https://github.com/mannaandpoem/OpenManus/tree/main 构建环境 创建一个python=3.12的虚拟环境 笔者测试了一下,非3.12版本会有一个package不兼容。 可以用conda或python内置的uv,项目文档提供了详细的指令。 安装playwright 如果第一次使用,需要安装playwright。 playwright install ## 或者 python -m playwright install ## 以上命令会安装所有浏览器,如果只需要安装一个浏览器比如firefox python -m playwright install firefox 配置大模型API Key 可以用DeepSeek或通义千问的API Key,其中通义有免费额度,DeepSeek虽然收费但价格便宜,测试一次使用约1000token,成本不到0.01元。 根据项目文档配置cofig.yaml即可,但项目调用大模型是使用基础的OpenAI API,如果使用其他大模型,可能需要基于对应的官方文档小改一下。 代码 OpenManus客户端 Python OpenManus/main.py即可在终端运行OpenManus,读者也可以尝试其Web版本。 具体会调用20行代码,执行Manus类的方法run()。 进入OpenManus/app/agent/manus.py查看Manus类,可以发现它继承了ToolCallAgent类,再进入会发现又是继承,有点复杂,这里我画一张关系图。 act()执行时使用execute_tools()进行具体的工具执行。 总体来说,Manus类定义了Prompt和可使用的工具。 Base类定义了run(),在run()中会循环执行ReAct类的方法step(),直到Finish或达到max_step。 step()类会顺序执行ToolCallAgent类的think()和act()。 当然,这里只罗列了重要的组件和方法,一些方法没有画在图中。 Prompt 一般来说,输入给LLM的prompt分为两种:1)系统 prompt,用于定义模型的角色定位和行为规则;2)用户 prompt(OpenManus称为Next Step Prompt),用于传达具体的任务指令或信息需求。 在OpenManus/app/prompt/manus.py中即可看到Manus的Prompt,这里展示一下中文版,读者基于此可对OpenManus架构有一个初步认识: 系统Prompt(SYSTEM_PROMPT):“你是 OpenManus,一个全能的人工智能助手,旨在解决用户提出的任何任务。你拥有各种可使用的工具,能调用这些工具高效地完成复杂的请求。无论是编程、信息检索、文件处理还是网页浏览,你都能应对自如。” 下一步Prompt(NEXT_STEP_PROMPT):“你可以使用 PythonExecute 与计算机进行交互,通过 FileSaver 保存重要的内容和信息文件,使用 BrowserUseTool 打开浏览器,并使用 GoogleSearch 检索信息。根据用户的需求,主动选择最合适的工具或工具组合。对于复杂的任务,你可以将问题分解,逐步使用不同的工具来解决它。在使用完每个工具后,清晰地解释执行结果并给出下一步的建议。 当然,在实际执行时会对prompt有进一步优化,不过核心的系统定位与任务指导原则是不会改变的。 Manus类 我们先看一下OpenManus拥有的工具,工具也支持自定义,会在后文进行介绍。 PythonExecute:执行 Python 代码以与计算机系统交互、进行数据处理、自动化任务等等。 FileSaver:在本地保存文件,例如 txt、py、html 等文件。 BrowserUseTool:打开、浏览并使用网络浏览器。如果你打开一个本地 HTML 文件,必须提供该文件的绝对路径。 GoogleSearch:执行网络信息检索。 Terminate:如果LLM认为回答完毕,会调用这个工具终止循环。 Base类 run() 首先,输入的request就是用户输入的提问。 状态管理 执行时首先检查代理的当前状态是否为 IDLE(空闲状态)。如果不是空闲状态,会抛出 RuntimeError 异常,因为只有在空闲状态下才能启动代理的执行。 当进入循环时前,使用 state_context上下文管理器将代理的状态临时切换到 RUNNING(运行状态)。在上下文管理器中执行的代码块会在进入时将状态切换为指定状态,在退出时恢复到之前的状态。如果在执行过程中发生异常,会将状态切换为 ERROR。 Memory管理 我们调用大模型的API,本质是向大模型提供方发http请求,http请求是无状态的。 也就是说,服务端不会保留任何会话信息。对于每次都完成一个独立的任务,无状态是没有任何问题的。但对持续聊天来说,就会出现对之前会话一无所知的情况。 所以为了让大模型持续与用户的对话,一种常见的解决方案就是把聊天历史告诉大模型。 因此,在OpenManus中会进行Memory的管理。 用户提供的 request 参数,调用 update_memory 方法将该请求作为用户消息添加到代理的Memory中。 除了这个函数,Manus也在进行think()、act()时也会更新Memory,同时Memory容量也不是无限大的,容量满时需要删除老的Message。 主循环 agent本质就是循环执行。 step实现参考react step。 循环结束条件:max_steps或者FINISHED状态。 每次执行一个step并获得result——step_result = await self.step()。 is_stuck 方法用于检查代理是否陷入了循环(即是否出现了重复的响应)。如果是,则调用 handle_stuck_state 方法处理这种情况,例如添加一个提示来改变策略。 ReAct step() 这里的逻辑很简单。 ToolcallAgent Think() 输入:不需要输入,因为用户的question是被存放在Memory中。 输出:一个bool类型,当内部LLM判断需要act()时,为True,否则为Fasle。 询问LLM 55行的代码用于调用LLM的API接口,获取回复。 对应到OpenManus/app/llm.py 233行附近,这里就是基于OpenAI提供的API接口进行对话,具体的参数可参考相应官方文档。 这里会将之前定义的下一步Prompt发给LLM,LLM会根据提供的工具列表,判断是否需要且调用的是哪个工具,当然也可能是:1)不需要工具只进行回复 2)调用Terminate工具结束会话。 下图是一次返回response结果。 输入的question是“计算Kobe Bryant的BMI?”,LLM先分析出了要通过浏览器查询资料,因此要use the BrowserUseTool。 根据传入的工具类型等信息,LLM自动构建了执行工具需要用的tool_name、action等参数。 ChatCompletionMessage( content="It seems there was an issue with retrieving the information about Kobe Bryant's height and weight through a Google search. To calculate Kobe Bryant's BMI, we need his height and weight. Let's try to find this information by opening a browser and visiting a reliable source. I will use the BrowserUseTool to navigate to a website that provides details about Kobe Bryant's height and weight. Let's proceed with this approach.", refusal=None, role='assistant', annotations=None, audio=None, function_call=None, tool_calls=[ ChatCompletionMessageToolCall( id='call_aez57ImfIEZrqjZdcW9sFNEJ', function=Function( arguments='{ "action":"navigate", "url":"https://www.biography.com/athlete/kobe-bryant" }', name='browser_use'), type='function')] ) think后续逻辑 think()后续的逻辑比较简单,主要是更新memory(memory存储单位是message),最后在100行附近的逻辑,基于self.tool_choices等参数的设置和LLM返回的工具列表,输出bool类型结果。 同时,需要被调用的工具会被记录到self.tool_calls这个列表中,后续的act()会执行对应的工具。 Act() 输入:同think(),不需要输入。 输出:results,根据工具结果构建的一个字符串。 这个函数比较简单,主要是调用execute_tool()函数。 Execute_tool() 该函数会调用Tool类提供的接口execute()。 Tool类接口会在后面介绍。 同时,对于预设定的special tool,会self._handle_special_tool(name=name, result=result)进行特殊处理。 当前的special tool 只有一个Terminate工具,特殊处理就是设置Agent的状态为AgentState.FINISHED,结束对话。 工具相关 我们在之前介绍了MCP相关的概念,如下图所示: 事实上,OpenManus也是基于MCP的,OpenManus的tool相当于MCP server,根据MCP协议,我们只需要定义tool类支持的方法和参数等,每次注册一个新工具,根据父类override一个子类即可。 那我们首先要了解父类都定义了什么参数和方法,也就是OpenManus/app/tool/base.py定义的Basetool类。 Base Tool 可以看出,代码很简单,每个tool包含的参数为:name、description(提供给LLM看的,对工具的介绍)、parameters(执行工具时要用的参数)。 同时,一个tool支持的方法有execute()和to_param()。 execute()用于执行具体的逻辑,每个子类需要override这个方法。 to_param()将工具调用的结果结构化输出。 当然,这里还有一个python关键字__call__,这个关键字很简单,定义了__call__,该类的实例对象可以像函数一样被调用。 工具JSON 可以根据OpenManus预定义的工具json简单了解一下,每个工具执行时需要的参数。 [ { "type": "function", "function": { "name": "python_execute", "description": "Executes Python code string. Note: Only print outputs are visible, function return values are not captured. Use print statements to see results.", "parameters": { "type": "object", "properties": { "code": { "type": "string", "description": "The Python code to execute." } }, "required": ["code"] } } }, { "type": "function", "function": { "name": "google_search", "description": "Perform a Google search and return a list of relevant links.\nUse this tool when you need to find information on the web, get up-to-date data, or research specific topics.\nThe tool returns a list of URLs that match the search query.\n", "parameters": { "type": "object", "properties": { "query": { "type": "string", "description": "(required) The search query to submit to Google." }, "num_results": { "type": "integer", "description": "(optional) The number of search results to return. Default is 10.", "default": 10 } }, "required": ["query"] } } ] 工具示例——google_search OpenManus项目在OpenManus/app/tool中定义了bash工具、浏览器工具、谷歌搜索工具等,这里简单看一下谷歌搜索工具。 当然,国内可能比较难使用谷歌搜索,OpenManus社区也有大佬提供了baidu、bing等搜索引擎工具。 可以看出,代码很简单,主要做了两件事。 定义工具参数:name、description、parameters。 定义execute:基于googlesearch库提供的函数进行搜索并返回。 五、总结 OpenManus的代码介绍到这里,主要是介绍一下核心代码,同时,原作者写了planning部分的代码但暂时没有应用到项目中,笔者也没有介绍。如果想对该项目有更进一步的了解,请大家查看github上提供的源码。而且,作者还是非常积极的,每天会有十几个commit。 同时,读者可以简单本地部署玩一下OpenManus,通过几个prompt,就可以知道该项目还是停留在“玩具阶段”,比如笔者测试了一下,当询问“计算一下科比的BMI?”,OpenManus可以很准确的实现**谷歌搜索——浏览器访问——python计算这个过程。但如果询问“计算科比、梅西的BMI并排序?”,无论我改写了几次prompt,OpenManus都没有给我满意的回答。 此外,无论是在工具参数信息、还是prompt、memory管理中,都可以看到agent应用大模型token消耗量巨大,即使我们不考虑token成本,但大模型的上下文仍然是有限的,这种资源消耗也会直接导致模型在处理多步骤任务时面临信息截断的风险 —— 早期的关键信息可能因上下文溢出而被丢弃,进而引发推理链条的断裂。更值得警惕的是,当模型试图在有限的上下文中 “脑补” 缺失的信息时,往往会产生与事实不符的幻觉。 鉴于此,尽管 OpenManus 展示出了利用工具链解决复杂问题的潜力,不过距离成为一个实用、高效且稳定的生产级人工智能助手仍有很长的路要走。未来,开发者们或许需要在优化工具使用逻辑、提升多任务处理能力、降低大模型 token 消耗以及增强上下文管理等方面进行深入探索与改进。同时,对于普通用户而言,在体验这类项目时,也应该保持理性和客观的态度,既看到其创新性和趣味性,也认识到其当前存在的局限性。希望在技术的不断迭代和完善下,OpenManus 以及类似的项目能够早日突破现有的瓶颈,真正为人们的工作和生活带来实质性的帮助。 往期回顾 1.得物技术部算法项目管理实践分享 2. 商家域稳定性建设之原理探索|得物技术 3. 得物 Android Crash 治理实践 4. 基于ANTLR4的大数据SQL编辑器解析引擎实践|得物技术 5. LSM-TREE从入门到入魔:从零开始实现一个高性能键值存储 | 得物技术 文 / 汉堡 关注得物技术,每周一、三更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~ 未经得物技术许可严禁转载,否则依法追究法律责任。

优秀的个人博客,低调大师

EVUE 进化蜕变,下一代全平台 UI 开发利器 0.1.6 预览版发布

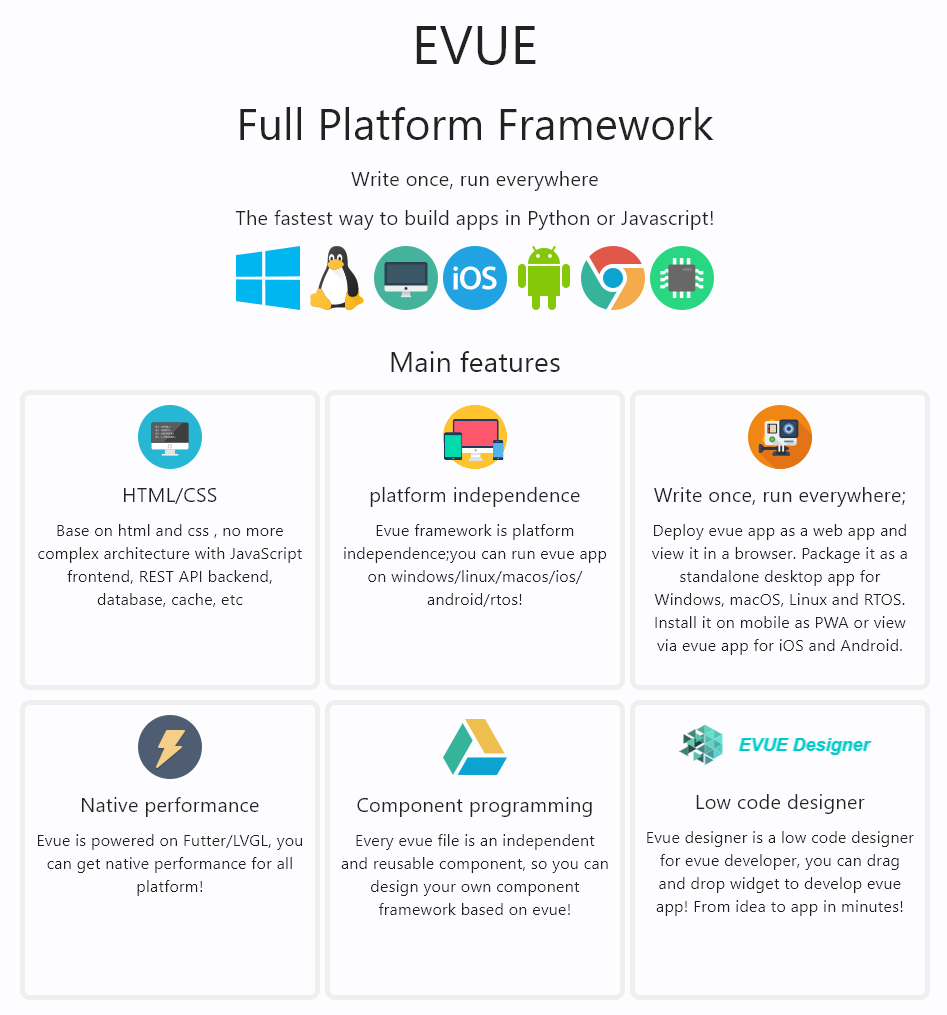
Evue 是一个基于html/css的高性能的gui应用框架,与平台和ui引擎无关。 github:https://github.com/scriptiot/evue gitee:https://gitee.com/scriptiot/evue EVUE应用开发的核心理念 基于HTML和CSS 用户只需要了解简单的html和css知识,即可快速开发漂亮的UI程序, 硬件无关 和 OS无关 EVUE 底层UI引擎基于Flutter 和 LVGL, 实现一个evue应用可完美运行在windows/linux/macos/web/ios/android/RTOS多个平台,与硬件无关和OS无关 一次开发,多端运行 一次开发,多端运行,指的是用户只需要一次开发,即可实现evue小程序多端运行在不同的设备,通过一套代码库高效构建多平台精美应用, 极大的提高用户开发效率,节约开发成本 原生性能,效率至上 EVUE底层UI渲染引擎基于Flutter和LVGL,性能卓越 Flutter 是Google开源的构建用户界面(UI)工具包,底层绘图引擎基于Skia , 性能媲美原生应用; LVGL 是面向IOT的轻量级UI引擎,底层基于C语言开发,内存占用低,性能优秀,在IOT领域应用极其广泛 EVUE 框架自身采用编译时代码生成技术,非运行时动态渲染技术,极大的减少了运行时的性能消耗; EVUE 框架原生支持MVVM, 数据驱动UI, 用户无需关心手动操作UI, 极大提高开发效率 组件编程,自由拓展 EVUE框架自身构建在组件之上,一切皆为组件,任意一个evue文件就是一个组件,用户基于内置的原生组件可以自由组合成各种自定义的高级组件,可复用到任意项目中,用户自由设计。 低代码支持 evue designer是基于evue开发的低代码设计器,用户可以简单的拖拽即可实现evue代码的自动生成和预览,极大提升用户开发效率。 框架 Evue 架构 Evue 是一个基于html/css的高性能的gui应用框架,与平台和ui引擎无关 Evuecompiler 编译器架构 evue编译器的功能主要是将evue文件编译为python/javascript代码; Evue 全平台运行 Evue for flutter (windows/linux/macos/web/ios/andriod) Evue for lvgl(rtos on mcu like Asr3603/F1C100/F1C200/esp32/stm32/...) you can run evue on any platfom as you like! Evue 支持适配任何ui引擎 Evue for flutter Evue for lvgl Evue for Qt Evue for PySide2 ... you can compile evue to any ui code as you like! 安装 使用pip安装evue. pip install evue or git clone https://github.com/scriptiot/evue.git cd evue python setup.py install # also `pip install ." 快速开始 evue_website cd examples python evuebroswer.py ./evue_website/project.json or python evuebroswer.py ./evue_website/app.py evue_login cd examples python evuebroswer.py ./evue_login/project.json or python evuebroswer.py ./evue_login/app.py Evue Studio Evue Studio 是一个服务开发者快速创建/编译/发布基于evue的应用的开发者平台。 下载最新的evue studio 解压evuestudio-*.7z 双击evuestudio.exe Evue Studio是一款通用的低代码UI设计器,支持自由拖拽组件、可视化数据绑定和可视化事件绑定,内置多终端模拟器,快速预览,所见所得!支持一键导出windows/linux/macos/web/ios/android/RTOS的跨平台evue小程序。 设计器理念 面向开发者,辅助开发者极限效率开发应用,专注设计和代码生成 面向社区,任何开发者均可分享自己设计的组件或应用 自动生成的代码具有极高的可读性,与用户手写基本无差异,用户手动修改evue文件后可以再次设计,不会影响用户代码 支持无限多层次嵌套组合,遵从开发者心智,非设计师 支持用户自定义默认组件样式,高度个性化定制 支持evue多语言编译,满足不同的编译需求 支持设计器自举,用设计器拖拽生成设计器 设计器组件支持 基础组件: image text textfield textarea button iconbutton checkbox switch progress slider combobox counter qrcode canvas 布局组件 div row column listview listitem grid tabview tab 自定义组件 用户自定义 Evue for iot Evue for iot 是一个基于evue的商业产品quicknode, 轻量级evue解决方案,可以运行在各种mcu上。 更多介绍请阅读quicknode产品介绍 下载最新的quicknode 解压quicknode-qbc-20221215142421-693fbf88.zip 双击quicknode.batorquicknode_chart.bat 帮助手册 编译evue文件->python代码 如何编译evue文件为python代码 登录evue studio 切换到编译页面 添加工程目录到监控列表 改变evue文件会自动编译为python代码

优秀的个人博客,低调大师

从“4G+5G”到“5G+5G”:双卡双待进化很快

市场需求和国家“新基建”政策的推动,2020年中国5G网络建设正在进入爆发期。据专家预测,2020年中国5G基站总规模可能会超过60万个,实现对国内地级市的覆盖。与此同时,5G终端发展也非常快,市场上已经出现了2000元以内的5G手机,为5G手机的普及化奠定了基础。中国信息通信研究院最近发布的数据显示,2020年前5个月,国内共推出了81款5G手机,5月份国内5G手机销量占到同期手机总出货量的46.3%,预计2020年5G手机的总出货量会超过2亿部。 纵观市场上现有的5G手机,支持5G NSA/SA两种模式已经是标配,对多频段的支持也越来越全面,只是在人们习以为常的双卡双待功能上,多数仅支持“4G+5G”,显得有些过于保守。事实上,在今年11月20日发布的《中国移动5G手机产品白皮书》中,中国移动虽然提到了“4G+5G”、“5G+5G”两种双卡模式,但是明确表示更推荐“5G+5G”的双卡产品。显然,“4G+5G”只会是临时的过渡策略,5G手机总的趋势必然是“5G+5G”双卡双待。 不可或缺的双卡双待 双卡双待是指一部手机可以插两张SIM卡,同时使用两个号码。这项技术最早出现在2006年的中国,当时的中国联通手握GSM、CDMA两张移动通信网络,为了吸引用户选用CDMA业务,与一些手机厂商联合推出了可以同时插GSM和CDMA两张号卡的所谓“双模双待”手机。 后来人们发现这项技术非常实用,一是一部手机能用两个号,省去了带两部手机的成本和麻烦;二是两个号可以各有各的使用场合,泾渭分明;三是新套餐优惠、旧号又不舍得丢弃,一部手机双卡双待无疑是最佳的解决方案。 于是,双卡双待功能就成了国内市场上手机的标配。当然,双卡双待早已不再是中国市场的专有特色,国外销售的手机也基本上都具备双卡双待功能。 目前双卡双待功能都需要芯片支持,所以市场上手机具备怎样的双卡双待功能,实际上是由手机芯片厂商决定的。现阶段主流芯片厂商推出的5G SoC芯片多支持“4G+5G”双卡双待,包括高通的骁龙865、骁龙765G,华为的麒麟990 5G、麒麟985、麒麟820,目前只有联发科的天玑1000+、天玑820、天玑800U、天玑700等天玑系列5G芯片支持“5G+5G”双卡双待。 “4G+5G”双卡双待,意味着手机只能为一张号卡接入5G业务,另一张号卡只能用4G业务,而“5G+5G”则可以双卡都使用5G业务。在5G业务发展早期,很多地方都没有5G信号,“4G+5G”无疑是一种非常现实的对策,消费者基本上不会有什么顾虑。然而从国家对“新基建”的支持力度以及运营商的积极动作来看,5G网络的广泛覆盖预计在今明两年就能取得很大的成果,这就意味着“4G+5G”会很快被淘汰,“5G+5G”才是大势所趋。 渐进式发展已成规律 在手机发展史上,“4G+5G”这样的过渡型双卡双待并 非孤例,事实上,每逢移动通信技术更新换代,都会出现跨代的双卡双待机型。比如在国内3G商用之初,转3G套餐必须更换SIM卡和手机,而“2G+3G”双卡双待就让很多消费者既用上高品质的3G套餐,又可以继续使用旧的2G号卡。到了4G时代,双卡双待的内涵更加丰富,有“2G+4G”、“3G+4G”等多种过渡方案,各有各的适用人群。这样看来,当前5G手机市场出现“4G+5G”双卡双待唱主角并不令人意外。 之所以会出现过渡性的双卡双待功能,其中既有用户需求方面的因素,也有技术和成本方面的原因。 在技术方面,从2G到3G、3G到4G升级之初,手机芯片组的整体技术性能跟不上,做不到每个卡槽兼容两代号卡,只能是“2G+3G”、“3G+4G”这样的组合式搭配。后来随着手机芯片组的技术不断改进,双卡双待全网通才成了市场的主流。从成本上看,过渡性的双卡双待芯片出现较早、成本较低,所以手机厂商也乐于用来设计新一代机型抢占市场。“4G+5G”手机的流行也是基于同样的理由。 不过过渡性的方案毕竟不能持久,能带给消费者更高自由度的“5G+5G”才是大势所趋。事实上,支持双5G待机的芯片和手机已经上市在售了。市场上现有的5G手机多采用高通、华为的5G SoC芯片,所以只支持“4G+5G”,而联发科从去年至今年陆续推出的天玑5G芯片大多支持“5G+5G”双卡双待。可以预计,随着搭载联发科天玑芯片的终端规模化量产上市,2020年下半年之后出现的5G手机也会越来越多地具备双5G功能。 双5G的优势 “5G+5G”双卡双待虽然出现在市场上比较晚,但一方面两张卡可以自由选择4G或5G业务,完全可以替代“4G+5G”方案,另一方面双卡都能用5G业务,用户体验更好,因此丝毫不会影响其发展潜力。 比如国内三大运营商的5G建网重点区域存在差异,不同区域的5G信号质量会有高有低。用户可以购买不同运营商的号卡和5G套餐,哪家的信号强就换用哪家的5G号卡,随时随地都能获得最佳的5G体验。另外,4G早期的语音电话只能退回到2G/3G承载,对用户体验的影响很大,后来运营商开始考虑在4G网络上直接提供质量有保障的语音业务(VoLTE),不过通话质量仍然不够好。5G也在考虑同样的问题(VoNR),而且对语音通话的质量要求更高,因此双5G可以让两个号卡都用上高质量的VoNR服务,全面超越“4G+5G”方案。 此外,5G时代会有越来越多的行业寻求借助5G网络进行数字化转型,工业制造、城市管理、公共安全、园区巡查、物流运输、新闻传媒等等领域,可能会需要员工通过5G号卡来完成各种工作。与此同时,个人日常生活中浏览高清视频、做视频直播、体验VR/AR游戏等,也都需要高速5G网络,这些应用显然是不宜与工作内容混合在一起的。另一方面,随着5G与行业应用不断走向深度结合,一些行业的工作用5G号卡可能无法访问外部资源,个人的5G号卡也无法访问企业内部资源,这个时候,只有“5G+5G”双卡双待才能让用户兼顾工作和生活。 如今通信技术的进步很快,5G R16版本标准有望于近期确定,由此带来的5G网络低时延、高可靠性等特性会进一步激发各行各业应用创新的热情。在这样的大环境下,市场对性能、灵活性更强的5G终端的需求会越发紧迫,“4G+5G”显然无法适应新的形势。在《中国移动5G手机产品白皮书》中,明确建议重点发展双卡支持NR/TD-LTE/LTE FDD/WCDMA/GSM的手机,这是来自运营商和市场的迫切需求。凭借诸多优势、超出一筹的性能,双5G SoC芯片和移动终端等产品必然会迅速占据市场主流。

优秀的个人博客,低调大师

FDE进化36记-第8记-树模型与排序模型到底该用在哪些客服场景?

我是老李,在这条全球智能客服平台上做算法侧的系统落地。平台同时服务多家企业、跑多个项目、覆盖多语言和多渠道,背后连着CRM、订单、支付、物流、工单和知识库。第7记我们把意图分类、路由和评分收敛回传统小模型,路由稳住了,下一个坑立刻露头:路由只回答“这句话该分给谁”,没回答“这件事该排在谁前面”。

优秀的个人博客,低调大师

Apache DolphinScheduler 3.4.0 重磅发布:OIDC 登录、gRPC 任务支持、Kubernetes 部署与调度可靠性全面进化

最新消息,Apache DolphinScheduler 3.4.0 已正式发布! 本次版本带来了多租户调度隔离、工作流并行性能优化、任务重试与告警机制增强,以及资源管理和日志处理改进。无论是复杂企业业务场景,还是高并发任务调度,3.4.0 都让系统更高效、更可靠、更易用。立即升级,体验全新调度能力! 升级与下载 下载页面(可选择镜像下载): https://dolphinscheduler.apache.org/zh-cn/download/3.4.0 GitHub Release 页面: https://github.com/apache/dolphinscheduler/releases/tag/3.4.0 升级时建议参考官方文档中的集群升级指南,确保兼容性和配置一致性。 核心功能增强与重要更新 通用 OIDC 认证支持 3.4.0 引入了对 OpenID Connect(OIDC)的通用支持,旨在简化与企业身份认证系统的集成。通过 OIDC,用户可以使用统一的身份提供商(如 Keycloak、Okta 等)进行 SSO 登录,无需额外实现复杂自定义逻辑。这提升了安全性和用户体验,尤其是在多系统联邦登录与统一认证场景中,能够使 DolphinScheduler 更自然地融入企业级认证体系,减少重复配置和验证成本,从而提高登录配置的扩展性和一致性。 (参考图) gRPC 任务插件支持 本版本新增了 gRPC 任务插件能力,使调度器能够通过原生 gRPC 协议直接与远程服务交互。用户可以将后端微服务暴露的 gRPC 接口作为任务执行目标,无需中间脚本封装。这种方式特别适合微服务生态或跨语言执行场景,通过明确参数契约和高性能通信协议提升任务整合效率,从而减少资源调度延迟、提高任务可靠性。 支持工作流串行策略 实现了 工作流串行执行策略(Workflow Serial Strategy) 的核心逻辑重构,通过引入一个全新的串行命令队列机制(t_ds_serial_command 表及相关 DAO/Mapper),配合一套串行执行协调器(WorkflowSerialCoordinator)及策略处理器,使 DolphinScheduler 能更智能地管理串行类型的工作流(如 SERIAL_WAIT、SERIAL_PRIORITY、SERIAL_DISCARD)。 该设计改进了工作流触发流程的执行类型判断、状态管理、命令队列处理等关键路径,使串行调度逻辑更清晰、更可靠,有助于提升串行工作流场景下的调度稳定性与可控性。同时,3.4.0 重构了触发器与状态机相关代码,增强该能力的可维护性和扩展性。 移除 PyTorch 任务类型 3.4.0 对任务类型体系进行了精简,正式移除了内置的 PyTorch 任务类型。该调整主要基于实际使用情况和长期维护成本的考量,因为原有 PyTorch 任务实现使用率较低,且与调度器核心任务模型耦合度较高,增加了版本演进和兼容性维护的复杂度。通过移除该任务类型,DolphinScheduler 能保持核心架构的简洁与稳定。 我们鼓励用户通过更通用的 Shell、Python 或插件化方式运行 PyTorch 作业,从而提升系统整体的可维护性和扩展性。 稳定性与重要修复 Kubernetes Worker 部署增强 在 Kubernetes 原生部署场景下,3.4.0 使 Worker StatefulSet 的 Helm Chart 支持注入 Secrets 和 InitContainers。通过 Secrets 注入,可以安全传递证书或凭据;InitContainers 允许在主容器启动前完成必要的初始化逻辑,如准备文件系统或校验环境依赖。 这些增强有助于在容器化环境下实现更安全、更一致的部署策略和生命周期管理。 SQL 任务取消能力 针对 SQL 任务类型,本次版本提供了对任务执行取消的原生支持。当执行的 SQL 语句由于逻辑错误或长期运行导致资源占用时,用户可以通过调度器下发取消操作,使任务尽快中止,而不是简单失败或等待超时。这一能力改善了任务控制能力,避免长时间运行对集群资源的无效占用,有助于提升整体资源利用率和执行调度体验。 条件任务节点在前置失败情况下执行逻辑修复 在某些复杂工作流中,当条件任务节点的前置任务失败时,条件节点未按预期执行。3.4.0 修复了这一调度核心逻辑,确保条件节点能够正确响应前置失败状态。这样,工作流分支逻辑能够按照既定 DAG 定义可靠运行,从而避免因逻辑错误导致的流程中断或不一致执行。 ZooKeeper 节点清理问题修复 在使用 ZooKeeper 作为协调组件的高可用部署中,部分用户反馈 Master Server 在启动失败后未正确清理已注册的 failover 节点路径,可能导致后续状态异常。该版本修复了这个问题,使 Master 在异常启动路径中能够正确清理关联注册节点,保持注册中心状态一致,确保高可用场景下集群状态的健康和可靠性。 Worker Group 分配逻辑错误修复 此前版本中,项目与 Worker Group 关联/移除操作可能在 API 层出现逻辑不一致,导致调度器未能正确识别项目与 Worker Group 的关系。本次版本修正了相关逻辑,使 API 行为与用户预期一致,从而改善 Worker 管控、资源隔离和调度分配体验。 此外,3.4.0 版本还进行了很多功能优化和问题修复,包括文档与配置规范完善(时区、安全、负载均衡)、核心调度与注册中心稳定性增强(TraceId、Failover 清理、可重入锁)、性能与资源管理优化(任务组索引)、前端与插件体验改进(日志查询、DataX 校验、文件展示)、依赖与安全更新(PostgreSQL JDBC、Spring Boot CVE 修复)等,篇幅所限不再一一展开,详情可查询完整更新列表:https://github.com/apache/dolphinscheduler/releases/tag/3.4.0 Bug 修复亮点 标记任务为 Inactive 状态逻辑修复 某些生命周期事件中,当任务状态需要被标记为 Inactive 时,状态变更可能未正确触发,导致 UI 和执行引擎状态不一致。此版本修复了这一逻辑,使状态标记与生命周期事件更加一致。 Workflow Lineage 删除逻辑优化 在工作流血缘关系删除操作中,系统可能未能彻底清理相关引用,导致历史血缘链路残留。3.4.0 改进了删除逻辑,使 DolphinScheduler 在删除血缘链时能够更精确地清理对应关系,避免分析后续依赖时出现错误链路。 其他 Bug 修复包括前置任务失败导致条件节点不执行问题修复、项目级 Worker Group 绑定与移除逻辑修正、子工作流触发参数丢失问题修复等,详情请查询完整 Release Note:https://github.com/apache/dolphinscheduler/releases/tag/3.4.0 文档更新 发布并完善 Apache DolphinScheduler 3.3.2 版本发布说明文档。 修复文档 CI 构建错误,提升文档发布流程的稳定性。 补充 Prometheus 指标接口的认证机制及其在 Kubernetes 环境下的使用说明。 同步更新 JdbcRegistry 引入事务机制后的相关文档描述,保证文档与实际行为一致。 致谢 本次版本发布离不开社区各位贡献者的热情参与与支持。特别感谢 @ Gallardot 作为 3.4.0 的 Release Manager,从版控、构建、候选版验证到最终投票组织,确保发布流程高质量推进。 同时,感谢以下本次版本的所有贡献者(GitHub ID,排名不分先后): Gallardot、njnu‑seafish、det101、Mrhs121、EinsteinInIct、sanfeng‑lhh、ruanwenjun、tusaryan、qiong‑zhou、SbloodyS、kvermeulen、npofsi、CauliflowerEater、ChaoquanTao、dill21yu、sdhzwc、zhan7236、KwongHing、jmmc‑tools、liunaijie 感谢所有通过提交 PR、Issue、文档贡献、社区讨论、测试验证等方式参与 Apache DolphinScheduler 项目的人。正是你们的努力推进了 DolphinScheduler 的持续演进与社区繁荣,欢迎更多人加入我们的队伍!

优秀的个人博客,低调大师

AI Agent 的“进化之路”:从研究原型到生产级记忆系统,技术趋势与产品对比

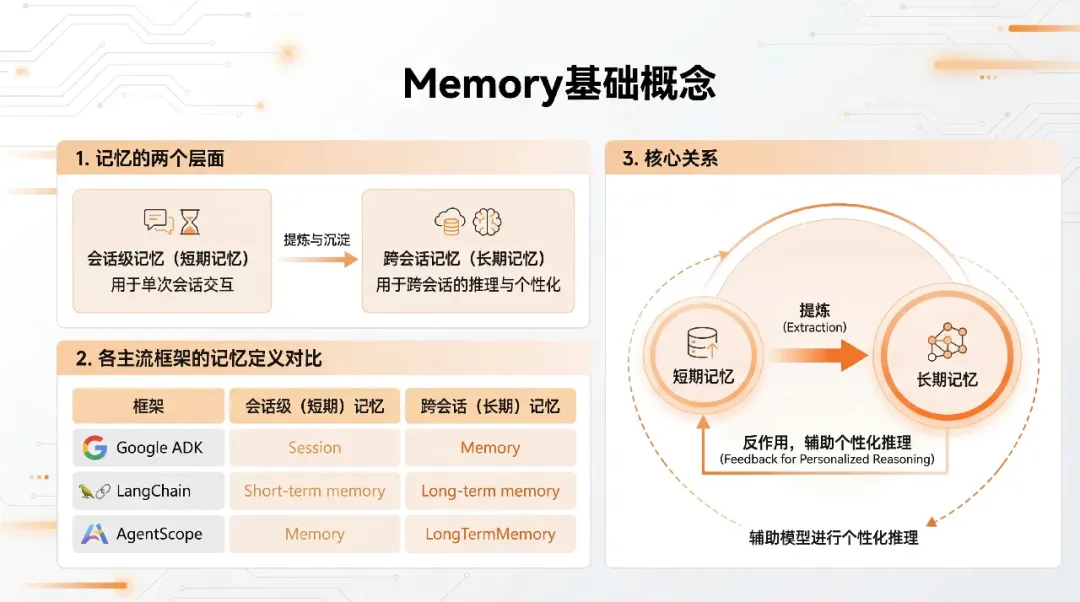
作者:柳遵飞(翼严) 前言 随着 AI Agent 应用的快速发展,智能体需要处理越来越复杂的任务和更长的对话历史。然而,LLM 的上下文窗口限制、不断增长的 token 成本,以及如何让 AI"记住"用户偏好和历史交互,都成为了构建实用 AI Agent 系统面临的核心挑战。记忆系统(Memory System)正是为了解决这些问题而诞生的关键技术。 记忆系统使 AI Agent 能够像人类一样,在单次对话中保持上下文连贯性(短期记忆),同时能够跨会话记住用户偏好、历史交互和领域知识(长期记忆)。这不仅提升了用户体验的连续性和个性化程度,也为构建更智能、更实用的 AI 应用奠定了基础。 Memory 基础概念 1.1 记忆的定义与分类 对于 AI Agent 而言,记忆至关重要,因为它使它们能够记住之前的互动、从反馈中学习,并适应用户的偏好。 对"记忆"的定义有两个层面: 会话级记忆: 用户和智能体 Agent 在一个会话中的多轮交互(user-query & response) 跨会话记忆: 从用户和智能体 Agent 的多个会话中抽取的通用信息,可以跨会话辅助 Agent 推理 1.2 各 Agent 框架的定义差异 各个 Agent 框架对记忆的概念命名各有不同,但共同的是都遵循上一节中介绍的两个不同层面的划分:会话级和跨会话级。 框架说明: Google ADK: Session 表示单次持续交互;Memory 是长期知识库,可包含来自多次对话的信息 LangChain: Short-term memory 用于单线程或对话中记住之前的交互;Long-term memory 不属于基础核心组件,而是高阶的"个人知识库"外挂 AgentScope: 虽然官方文档强调需求驱动,但 API 层面仍然是两个组件(memory 和 long_term_memory),功能层面有明确区分 习惯上,可以将会话级别的历史消息称为短期记忆 ,把可以跨会话共享的信息称为长期记忆,但本质上两者并不是通过简单的时间维度进行的划分,从实践层面上以是否跨 Session 会话来进行区分。长期记忆的信息从短期记忆中抽取提炼而来,根据短期记忆中的信息实时地更新迭代,而其信息又会参与到短期记忆中辅助模型进行个性化推理。 Agent 框架集成记忆系统的架构 各 Agent 框架在集成记忆系统时,虽然实现细节不同,但都遵循相似的架构模式。理解这些通用模式有助于更好地设计和实现记忆系统。 2.1 Agent 框架集成记忆的通用模式 各 Agent 框架集成记忆系统通常遵循以下通用模式: 1. Step1:推理前加载 - 根据当前 user-query 从长期记忆中加载相关信息 2. Step2:上下文注入 - 从长期记忆中检索的信息加入当前短期记忆中辅助模型推理 3. Step3:记忆更新 - 短期记忆在推理完成后加入到长期记忆中 4. Step4:信息处理 - 长期记忆模块中结合 LLM+向量化模型进行信息提取和检索 2.2 短期记忆(Session 会话) 短期记忆存储会话中产生的各类消息,包括用户输入、模型回复、工具调用及其结果等。这些消息直接参与模型推理,实时更新,并受模型的 maxToken 限制。当消息累积导致上下文窗口超出限制时,需要通过上下文工程策略(压缩、卸载、摘要等)进行处理,这也是上下文工程主要处理的部分。 核心特点: 存储会话中的所有交互消息(用户输入、模型回复、工具调用等) 直接参与模型推理,作为 LLM 的输入上下文 实时更新,每次交互都会新增消息 受模型 maxToken 限制,需要上下文工程策略进行优化 关于短期记忆的上下文工程策略(压缩、卸载、摘要等),将在下一章节中详细介绍。 2.3 长期记忆(跨会话) 长期记忆与短期记忆形成双向交互:一方面,长期记忆从短期记忆中提取"事实"、"偏好"、"经验"等有效信息进行存储(Record);另一方面,长期记忆中的信息会被检索并注入到短期记忆中,辅助模型进行个性化推理(Retrieve)。 与短期记忆的交互: Record(写入): 从短期记忆的会话消息中提取有效信息,通过LLM进行语义理解和抽取,存储到长期记忆中 Retrieve(检索): 根据当前用户查询,从长期记忆中检索相关信息,注入到短期记忆中作为上下文,辅助模型推理 实践中的实现方式: 在 Agent 开发实践中,长期记忆通常是一个独立的第三方组件,因为其内部有相对比较复杂的流程(信息提取、向量化、存储、检索等)。常见的长期记忆组件包括 Mem0、Zep、Memos、ReMe 等,这些组件提供了完整的 Record 和 Retrieve 能力,Agent 框架通过 API 集成这些组件。 信息组织维度: 不同长期记忆产品在信息组织维度上有所差异:一些产品主要关注个人信息(个人记忆),而一些产品除了支持个人记忆外,还支持工具记忆、任务记忆等更丰富的维度。 用户维度(个人记忆): 面向用户维度组织的实时更新的个人知识库 用户画像分析报告 个性化推荐系统,千人千面 处理具体任务时加载至短期记忆中 业务领域维度: 沉淀的经验(包括领域经验和工具使用经验) 可沉淀至领域知识库 可通过强化学习微调沉淀至模型 短期记忆的上下文工程策略 短期记忆直接参与 Agent 和 LLM 的交互,随着对话历史增长,上下文窗口会面临 token 限制和成本压力。上下文工程策略旨在通过智能化的压缩、卸载和摘要技术,在保持信息完整性的同时,有效控制上下文大小。 备注: 需要说明的是,各方对上下文工程的概念和理解存在些许差异。狭义的上下文工程 特指对短期记忆(会话历史)中各种压缩、摘要、卸载等处理机制,主要解决上下文窗口限制和 token 成本问题;广义的上下文工程则包括更广泛的上下文优化策略,如非运行态的模型选择、Prompt 优化工程、知识库构建、工具集构建等,这些都是在模型推理前对上下文进行优化的手段,且这些因素都对模型推理结果有重要影响。本章节主要讨论狭义的上下文工程,即针对短期记忆的运行时处理策略。 3.1 核心策略 针对短期记忆的上下文处理,主要有以下几种策略: 上下文缩减(Context Reduction) 上下文缩减通过减少上下文中的信息量来降低 token 消耗,主要有两种方法: 1. 保留预览内容: 对于大块内容,只保留前 N 个字符或关键片段作为预览,原始完整内容被移除 2. 总结摘要: 使用 LLM 对整段内容进行总结摘要,保留关键信息,丢弃细节 这两种方法都会导致信息丢失,但能有效减少 token 消耗。 上下文卸载(Context Offloading) 上下文卸载主要解决被缩减的内容是否可恢复的问题。当内容被缩减后,原始完整内容被卸载到外部存储(如文件系统、数据库等),消息中只保留最小必要的引用(如文件路径、UUID 等)。当需要完整内容时,可以通过引用重新加载。 优势:上下文更干净,占用更小,信息不丢,随取随用。适用于网页搜索结果、超长工具输出、临时计划等占 token 较多的内容。 上下文隔离(Context Isolation) 通过多智能体架构,将上下文拆分到不同的子智能体中(类似单体拆分称多个微服务)。主智能体编写任务指令,发送给子智能体,子智能体的整个上下文仅由该指令组成。子智能体完成任务后返回结果,主智能体不关心子智能体如何执行,只需要结果。 适用场景:任务有清晰简短的指令,只有最终输出才重要,如代码库中搜索特定片段。 优势:上下文小、开销低、简单直接。 策略选择原则: 以上三种策略(上下文缩减、上下文卸载、上下文隔离)需要根据数据的分类进行综合处理,主要考虑因素包括: 时间远近: 近期消息通常更重要,需要优先保留;历史消息可以优先进行缩减或卸载 数据类型: 不同类型的消息(用户输入、模型回复、工具调用结果等)重要性不同,需要采用不同的处理策略 信息可恢复性: 对于需要完整信息的内容,应优先使用卸载策略;对于可以接受信息丢失的内容,可以使用缩减策略 3.2 各框架的实现方式 各框架一般内置上下文处理策略,通过参数化配置的方式指定具体策略。 Google ADK 构建 Agent 时通过 events_compaction_config 设置上下文处理策略,和 Session 本身的数据存储独立。 from google.adk.apps.app import App, EventsCompactionConfig app = App( name='my-agent', root_agent=root_agent, events_compaction_config=EventsCompactionConfig( compaction_interval=3, # 每3次新调用触发压缩 overlap_size=1 # 包含前一个窗口的最后一次调用 ), ) LangChain 构建 Agent 时通过 middleware 机制中的 SummarizationMiddleware 设置上下文处理参数,与短期记忆本身的数据存储独立。 from langchain.agents import create_agent from langchain.agents.middleware import SummarizationMiddleware agent = create_agent( model="gpt-4o", tools=[...], middleware=[ SummarizationMiddleware( model="gpt-4o-mini", max_tokens_before_summary=4000, # 4000 tokens时触发摘要 messages_to_keep=20, # 摘要后保留最后20条消息 ), ], ) AgentScope AgentScope 通过 AutoContextMemory 提供智能化的上下文工程解决方案。AutoContextMemory 实现了 Memory 接口,当对话历史超过配置阈值时,自动应用 6 种渐进式压缩策略(从轻量级到重量级)来减少上下文大小,同时保留重要信息。 集成方式: 直接作为 Memory 接口实现,通过 memory 参数集成到 Agent 中 与框架深度集成,无需额外的 middleware 或独立配置 与 ADK 和 LangChain 的差异: 更精细化的压缩策略: 提供 6 种渐进式压缩策略(压缩历史工具调用、卸载大型消息、摘要对话轮次等),相比 ADK 的简单压缩和 LangChain 的摘要 middleware,策略更加细化和可控 集成方式: 直接实现 Memory 接口,与 Agent 构建流程无缝集成,而 ADK 和 LangChain 需要独立的配置对象或 middleware 机制 完整可追溯性: 提供工作内存、原始内存、卸载上下文和压缩事件四层存储架构,支持完整历史追溯,而其他框架通常只提供压缩后的结果 使用示例: AutoContextMemory memory = new AutoContextMemory( AutoContextConfig.builder() .msgThreshold(100) .maxToken(128 * 1024) .tokenRatio(0.75) .build(), model ); ReActAgent agent = ReActAgent.builder() .name("Assistant") .model(model) .memory(memory) .build(); 详细文档: 关于 AutoContextMemory 的 6 种压缩策略、存储架构和高级配置,请参考 AutoContextMemory 详细文档。 长期记忆技术架构及 Agent 框架集成 与短期记忆不同,长期记忆需要跨会话持久化存储,并支持高效的检索和更新。这需要一套完整的技术架构,包括信息提取、向量化存储、语义检索等核心组件。 4.1 核心组件 长期记忆涉及 record & retrieve 两个核心流程,需要以下核心组件: 1. LLM 大模型: 提取短期记忆中的有效信息(记忆的语义理解、抽取、决策和生成) 2. Embedder 向量化: 将文本转换为语义向量,支持相似性计算 3. VectorStore 向量数据库: 持久化存储记忆向量和元数据,支持高效语义检索 4. GraphStore 图数据库: 存储实体-关系知识图谱,支持复杂关系推理 5. Reranker(重排序器): 对初步检索结果按语义相关性重新排序 6. SQLite: 记录所有记忆操作的审计日志,支持版本回溯 4.2 Record & Retrieve 流程 Record(记录) LLM 事实提取 → 信息向量化 → 向量存储 →(复杂关系存储)→ SQLite 操作日志 Retrieve(检索) User query 向量化 → 向量数据库语义检索 → 图数据库关系补充 →(Reranker-LLM)→ 结果返回 4.3 长期记忆与 RAG 的区别 像 Mem0 这类面向 AI Agent 的个性化长期记忆系统,与 RAG(Retrieval-Augmented Generation)在技术架构上有诸多相似之处,但功能层面和场景上有明显区别: 技术层面的相似点: 向量化存储:都将文本内容通过 Embedding 模型转为向量,存入向量数据库 相似性检索:在用户提问时,将当前 query 向量化,在向量库中检索 top-k 最相关的条目 注入上下文生成:将检索到的内容注入到模型交互上下文中,辅助 LLM 生成最终回答 4.4 关键问题与挑战 长期记忆系统在实际应用中面临诸多挑战,这些挑战直接影响系统的可用性和用户体验。 1. 准确性 记忆的准确性包含两个层面: 有效的记忆管理:需要具备智能的巩固、更新和遗忘机制,这主要依赖于记忆系统中负责信息提取的模型能力和算法设计 记忆相关性的检索准确度:主要依赖于向量化检索&重排的核心能力 核心挑战: 记忆的建模:需要完善强大的用户画像模型 记忆的管理:基于用户画像建模算法,提取有效信息,设计记忆更新机制 向量化相关性检索能力:提升检索准确率和相关性 2. 安全和隐私 记忆系统记住了大量用户隐私信息,如何防止数据中毒等恶意攻击,并保障用户隐私,是必须解决的问题。 核心挑战: 数据加密与访问控制 防止恶意数据注入 透明的数据管理机制 用户对自身数据的掌控权 3. 多模态记忆支持 文本记忆、视觉、语音仍被孤立处理,如何构建统一的"多模态记忆空间"仍是未解难题。 核心挑战: 跨模态关联与检索 统一的多模态记忆表示 毫秒级响应能力 4.5 Agent 框架集成 在 AgentScope 中,可以通过集成第三方长期记忆组件来实现长期记忆功能。常见的集成方式包括: 4.5.1 集成 Mem0 Mem0 是一个开源的长期记忆框架,几乎成为事实标准。在 AgentScope 中集成 Mem0 的示例: // 初始化Mem0长期记忆 Mem0LongTermMemory mem0Memory = new Mem0LongTermMemory( Mem0Config.builder() .apiKey("your-mem0-api-key") .build() ); // 创建Agent并集成长期记忆 ReActAgent agent = ReActAgent.builder() .name("Assistant") .model(model) .memory(memory) // 短期记忆 .longTermMemory(mem0Memory) // 长期记忆 .build(); 4.5.2 集成 ReMe ReMe 是 AgentScope 官方提供的长期记忆实现,与框架深度集成: // 初始化ReMe长期记忆 ReMeLongTermMemory remeMemory = ReMeLongTermMemory.builder() .userId("user123") // 用户ID,用于记忆隔离 .apiBaseUrl("http://localhost:8002") // ReMe服务地址 .build(); // 创建Agent并集成长期记忆 ReActAgent agent = ReActAgent.builder() .name("Assistant") .model(model) .memory(memory) // 短期记忆 .longTermMemory(remeMemory) // 长期记忆 .longTermMemoryMode(LongTermMemoryMode.BOTH) // 记忆模式 .build(); 行业趋势与产品对比 5.1 AI 记忆系统发展趋势 AI 记忆系统的核心目标是让 AI 能像人类一样持续学习、形成长期记忆,从而变得更智能、更个性化。当前行业呈现出从研究原型向生产级系统演进、从单一技术向综合解决方案发展的趋势。 5.1.1 当前发展的核心脉络 5.1.2 技术发展趋势 记忆即服务(Memory-as-a-Service, MaaS) AI Agent 是大模型、记忆、任务规划以及工具使用的集合体,记忆管理将是 Agent 智能体的核心基础功能之一。类似"数据库"之于传统软件,记忆系统将成为 AI 应用的基础设施,提供标准化的记忆服务接口、可扩展的存储和检索能力。 精细化记忆管理 借鉴人脑记忆机制,构建分层动态的记忆架构,对记忆进行全生命周期管理。技术路径包括:LLM 驱动记忆提取 + 向量化存储 + 图数据库补充;向量化检索(海马体)+ LLM 提纯(大脑皮层)结合;通过强化学习提升记忆管理表现。 多模态记忆系统 多模态大模型的兴起推动记忆系统向多模态、跨模态方向发展,要求存储具备跨模态关联与毫秒级响应能力。 参数化记忆(Model 层集成记忆) 在 Transformer 架构中引入可学习的记忆单元 Memory Adapter,实现模型层面原生支持用户维度的记忆。优点是响应速度快,但面临"灾难性遗忘"和更新成本高的挑战。 5.1.3 当前主要的技术路径 1. 外部记忆增强(当前主流): 使用向量数据库等外部存储来记忆历史信息,并在需要时通过检索相关信息注入当前对话。这种方式灵活高效,检索的准确性是关键。 2. 参数化记忆(深度内化): 直接将知识编码进模型的参数中。这可以通过模型微调、知识编辑等技术实现,优点是响应速度快,但面临"灾难性遗忘"和更新成本高的挑战。 5.2 相关开源产品对比 关于各产品的具体数据指标对比,评测方式各有侧重,因此评测结果不尽相同,从实际情况看,各方均以 mem0 为评测基准,从各类技术指标评测结果以及开源社区的活跃度(star,issues 等)方面,mem0 仍然是占据长期记忆产品的领头地位。 结语 记忆系统作为 AI Agent 的核心基础设施,其发展直接影响着智能体的能力和用户体验。现在各框架内置的压缩、卸载、摘要等策略,已经能解决 80-90% 的通用场景问题,但对于特定行业或场景,比如医疗、法律、金融等领域,基于通用的上下文处理策略基础之上进行针对性的处理和更精细的压缩 prompt 设计,仍然有较大的优化空间。而长期记忆作为可独立演进的组件,未来会更加贴近人脑的记忆演化模式,包括记忆的巩固、强化、遗忘等全生命周期管理,同时长期记忆应该以云服务模式提供通用的记忆服务,共同助力 Agent 迈向更高阶的智能。 相关阅读: 《AgentScope Java 答疑时间:开发者近期最关心的 12 个问题》 《AgentScope x RocketMQ:打造企业级高可靠 A2A 智能体通信基座》 《AgentScope Java v1.0 发布,让 Java 开发者轻松构建企业级 Agentic 应用》 参考文档: [1] FlowLLM Context Engineering https://github.com/FlowLLM-AI/flowllm/tree/main/docs/zh/reading [2] Google ADK Memory https://google.github.io/adk-docs/sessions/memory/ [3] LangChain Memory https://docs.langchain.com/oss/python/langchain/long-term-memory [4] AgentScope Memory https://doc.agentscope.io/zh_CN/tutorial/task_memory.html [5] O-MEM https://arxiv.org/abs/2511.13593

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册