首页 文章 精选 留言 我的

精选列表

搜索[日活数],共10000篇文章
优秀的个人博客,低调大师

谷歌 Gemini Deep Think AI 获官方认证奥数金牌

谷歌 DeepMind 团队宣布,其一个高级版本的 Gemini Deep Think 模型,在国际数学奥林匹克(IMO)竞赛的问题上正式取得了金牌水平的成绩。 该模型在六道题目中完美解决了五道,总共获得 35 分(满分 42 分),达到了金牌分数线。IMO 主席 Gregor Dolinar 教授证实了这一里程碑式的成就,并评价其解决方案 “在许多方面都令人惊叹”,认为其清晰、精确且大部分易于理解。 谷歌 CEO Sundar Pichai 表示,“仅仅一年时间,从银牌到金牌——(其)数学推理方面的进步速度简直令人惊叹!恭喜Google DeepMind 团队!”马斯克转发并表示:“恭喜!” 此次成果使用了 Gemini Deep Think 模式的高级版本,这是一种针对复杂问题的增强推理模式,融合了包括并行思考在内的最新研究技术,使模型能同时探索和组合多种可能的解决方案。为了最大化 Deep Think 的推理能力,团队还利用新颖的强化学习技术对该版 Gemini 进行了训练,使其能更好地利用多步推理、问题解决和定理证明数据。 此外,模型还被提供了高质量数学问题解决方案的精选语料库,并在其指令中加入了一些关于如何解决 IMO 问题的一般性提示。谷歌 DeepMind 计划先向包括数学家在内的一组可信测试者提供该 Deep Think 模型的版本,之后再向 Google AI Ultra 订阅用户推出。 团队表示,虽然目前在自然语言方法上取得了突破,但他们仍在继续推进 AlphaGeometry 和 AlphaProof 等形式化系统。他们相信,将自然语言流畅性与形式化语言中的严谨、可验证推理相结合的 Agent,将成为数学家、科学家和研究人员的宝贵工具。 此次成果由 Thang Luong 领导整体技术方向,并与 Edward Lockhart 共同协调 IMO 2025 项目。IMO 官方确认了提交答案的完整性和正确性,但其审查不涉及对系统、流程或底层模型的验证。

优秀的个人博客,低调大师

2个数仓中不等值关联优化案例

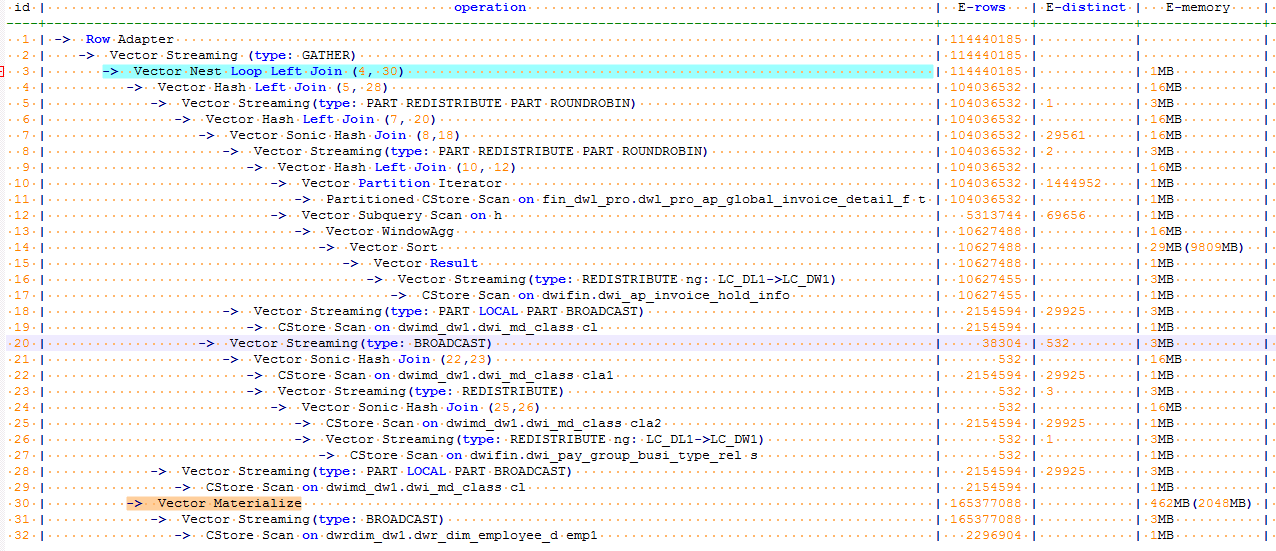
本文分享自华为云社区《GaussDB(DWS)性能调优:不等值关联优化》,作者: 门前一棵葡萄树。 场景1 使用场景:本案例适合满足以下条件的场景 关联条件使用OR连接 关联条件中使用同一列做数据筛选 原始语句 SELECT t2.PARTNER_CHANNEL_CODE AS CHANNEL_ID ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID AS CHANNEL_ID2 FROM t1 LEFT JOIN t2 ON ( t2.CHANNEL_ID = t1.CHANNEL_ID AND t1.TYPE = 'DR' ) OR ( t2.PARTNER_CHANNEL_CODE = t1.CHANNEL_ID AND t1.TYPE = 'ALL' ) GROUP BY t2.PARTNER_CHANNEL_CODE ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID 性能分析 通过查询计划分析发现,t1表和t2表关联走了NEST LOOP,查询整体耗时45S,NEST LOOP耗时占用整个查询执行耗时的96%。因此考虑能否通过SQL改写或HINT规避NEST LOOP。观察发现t1表和t2表包含两个关联关联条件,两个关联条件之间使用OR连接,属于非等值关联,因此不能走HASH JOIN。进一步分析SQL发现两个关联条件中都使用t1.TYPE进行过滤筛选: (t2.CHANNEL_ID = t1.CHANNEL_ID AND t1.TYPE='DR') OR (t2.PARTNER_CHANNEL_CODE = t1.CHANNEL_ID AND t1.TYPE='ALL' ) 该关联条件包含以下三种关联组合: t1表中t1.TYPE='DR'的行,只能使用第一个关联条件与t2表关联; t1表中t1.TYPE='ALL'的行,只能使用第二个关联条件与t2表关联; t1表中t1.TYPE NOT IN ('ALL','DR')的行,不与t2表关联,直接补空。 t1表中的一行数据只能选择这三个关联条件中的一个与t2表关联,因此该关联条件可以改写为不同关联条件的UNION ALL(UNION会去重,不等价)。 优化改写 改写后SQL如下所示: SELECT CHANNEL_ID ,COUNTRY_CODE ,BRAND ,CHANNEL_ID FROM ( SELECT t2.PARTNER_CHANNEL_CODE AS CHANNEL_ID ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID AS CHANNEL_ID2 FROM t1 LEFT JOIN t2 ON t2.CHANNEL_ID = t1.CHANNEL_ID WHERE t1.TYPE = 'DR' UNION ALL SELECT t2.PARTNER_CHANNEL_CODE AS CHANNEL_ID ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID AS CHANNEL_ID2 FROM t1 t2 ON t2.PARTNER_CHANNEL_CODE = t1.CHANNEL_ID WHERE t1.TYPE='ALL' UNION ALL SELECT t2.PARTNER_CHANNEL_CODE AS CHANNEL_ID ,t1.COUNTRY_CODE ,t1.BRAND ,t2.CHANNEL_ID AS CHANNEL_ID2 FROM t1 LEFT JOIN t2 ON FALSE WHERE t1.TYPE NOT IN ('ALL','DR') ) GROUP BY CHANNEL_ID,COUNTRY_CODE,BRAND,CHANNEL_ID 改写后SQL变为三个子查询的UNION ALL,执行时间缩减至1s以内,性能优化45倍。 场景二 使用场景:本案例适合满足以下条件的场景 大表A不等值关联小表B B的等值关联字段为主键 【原始语句】 SELECT T.CREATE_INVOICE_USER, T.PERIOD_ID, T.AP_INVOICE_ID, T.AP_INVOICE_NUM, T.AP_BATCH_NAME, EMP1.EMPLOYEE_NO, EMP1.EMPLOYEE_NAME FROM DWACTDI.DWR_AP_GLOBAL_INVOICE_DETAIL_F_I T LEFT JOIN DWRDIM_DW1.DWR_DIM_EMPLOYEE_D EMP1 ON (EMP1.SCD_ACTIVE_IND = 1 AND(T.CREATE_INVOICE_USER = EMP1.EMPLOYEE_NO OR SUBSTR(T.CREATE_INVOICE_USER, 2) = EMP1.EMPLOYEE_NO)) 【性能分析】 原始语句执行超时(超过1h),执行计划如下。可以看到执行语句存在大表NestLoop操作 分析发现表dwrdim_dw1.dwr_dim_employee_d是维度表,且关联列employee_no是主键 【优化改写】 SELECT T.CREATE_INVOICE_USER, T.PERIOD_ID, T.AP_INVOICE_ID, T.AP_INVOICE_NUM, T.AP_BATCH_NAME, nvl(EMP1_0.EMPLOYEE_NO, EMP1_1.EMPLOYEE_NO) AS EMPLOYEE_NO, nvl(EMP1_0.EMPLOYEE_NAME, EMP1_1.EMPLOYEE_NAME) AS ERP_ACCOUNTANT_ENAME FROM DWACTDI.DWR_AP_GLOBAL_INVOICE_DETAIL_F_I T LEFT JOIN DWRDIM_DW1.DWR_DIM_EMPLOYEE_D EMP1_0 ON (EMP1_0.SCD_ACTIVE_IND = 1 AND(T.CREATE_INVOICE_USER = EMP1_0.EMPLOYEE_NO)) LEFT JOIN DWRDIM_DW1.DWR_DIM_EMPLOYEE_D EMP1_1 ON (EMP1_1.SCD_ACTIVE_IND = 1 AND(SUBSTR(T.CREATE_INVOICE_USER, 2) = EMP1_1.EMPLOYEE_NO)) 改写后执行信息如下 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

数仓中典型的几种不下推语句整改案例

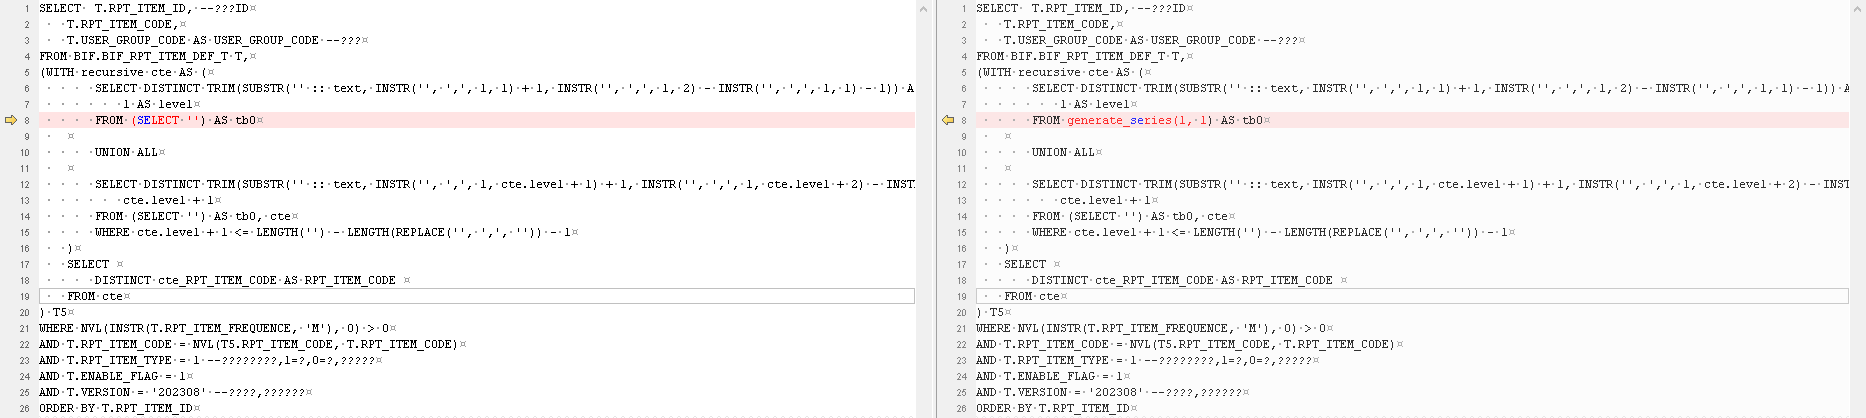
本文分享自华为云社区《GaussDB(DWS)性能调优:典型不下推语句整改案例》,作者: 譡里个檔 。 场景1:With-Recursive contains only values rte is not shippable 根因:递归语句的某个分支中没有FROM字句(只有 VALUES 或者类似 SELECT 1 这样的语句) 案例1:递归驱动分支没有FROM字句 原始语句 SELECT T.RPT_ITEM_ID, --报表项ID T.RPT_ITEM_CODE, T.USER_GROUP_CODE AS USER_GROUP_CODE --用户组 FROM BIF.BIF_RPT_ITEM_DEF_T T, (WITH recursive cte AS ( SELECT DISTINCT TRIM(SUBSTR('' :: text, INSTR('', ',', 1, 1) + 1, INSTR('', ',', 1, 2) - INSTR('', ',', 1, 1) - 1)) AS cte_RPT_ITEM_CODE, 1 AS level FROM (SELECT '') AS tb0 UNION ALL SELECT DISTINCT TRIM(SUBSTR('' :: text, INSTR('', ',', 1, cte.level + 1) + 1, INSTR('', ',', 1, cte.level + 2) - INSTR('', ',', 1, cte.level + 1) - 1)), cte.level + 1 FROM (SELECT '') AS tb0, cte WHERE cte.level + 1 <= LENGTH('') - LENGTH(REPLACE('', ',', '')) - 1 ) SELECT DISTINCT cte_RPT_ITEM_CODE AS RPT_ITEM_CODE FROM cte ) T5 WHERE NVL(INSTR(T.RPT_ITEM_FREQUENCE, 'M'), 0) > 0 AND T.RPT_ITEM_CODE = NVL(T5.RPT_ITEM_CODE, T.RPT_ITEM_CODE) AND T.RPT_ITEM_TYPE = 1 --是否是叶子报表项,1=是,0=否,基本报表项 AND T.ENABLE_FLAG = 1 AND T.VERSION = '202308' --使用快照,增加条件限制 ORDER BY T.RPT_ITEM_ID 改写语句 SELECT T.RPT_ITEM_ID, --报表项ID T.RPT_ITEM_CODE, T.USER_GROUP_CODE AS USER_GROUP_CODE --用户组 FROM BIF.BIF_RPT_ITEM_DEF_T T, (WITH recursive cte AS ( SELECT DISTINCT TRIM(SUBSTR('' :: text, INSTR('', ',', 1, 1) + 1, INSTR('', ',', 1, 2) - INSTR('', ',', 1, 1) - 1)) AS cte_RPT_ITEM_CODE, 1 AS level FROM generate_series(1, 1) AS tb0 UNION ALL SELECT DISTINCT TRIM(SUBSTR('' :: text, INSTR('', ',', 1, cte.level + 1) + 1, INSTR('', ',', 1, cte.level + 2) - INSTR('', ',', 1, cte.level + 1) - 1)), cte.level + 1 FROM (SELECT '') AS tb0, cte WHERE cte.level + 1 <= LENGTH('') - LENGTH(REPLACE('', ',', '')) - 1 ) SELECT DISTINCT cte_RPT_ITEM_CODE AS RPT_ITEM_CODE FROM cte ) T5 WHERE NVL(INSTR(T.RPT_ITEM_FREQUENCE, 'M'), 0) > 0 AND T.RPT_ITEM_CODE = NVL(T5.RPT_ITEM_CODE, T.RPT_ITEM_CODE) AND T.RPT_ITEM_TYPE = 1 --是否是叶子报表项,1=是,0=否,基本报表项 AND T.ENABLE_FLAG = 1 AND T.VERSION = '202308' --使用快照,增加条件限制 ORDER BY T.RPT_ITEM_ID 修改点比对 案例2:递归驱动分支没有FROM字句 原始语句 SELECT A.DYNM_COMP_ID, DECODE(B.LINE_NO, 1, '202308', A.VERSION) FROM BIF.BIF_DYNM_COMP_SOU_TBL_V A, (WITH recursive cte AS ( SELECT 1 AS level UNION ALL SELECT cte.level + 1 FROM cte WHERE cte.level + 1 < 3 ) SELECT level as LINE_NO FROM cte ) B WHERE EXISTS (SELECT 1 FROM BIF.BIF_RPT_ITEM_DEF_MV RPT, BIF.BIF_PUB_SUBJECT_AREA_T SBJ, BIF.BIF_SNAPSHORT_SUBJECT_V TYP WHERE A.DYNM_COMP_ID = RPT.DYNM_COMP_ID AND RPT.VERSION = 'current' AND RPT.SUBJECT_AREA_ID = SBJ.SUBJECT_AREA_ID AND SBJ.SUBJECT_AREA_CODE =TYP.SUBJECT_CODE AND TYP.SUBJECT_TYPE ='TAX') AND A.VERSION = 'current' 改写语句 SELECT A.DYNM_COMP_ID, DECODE(B.LINE_NO, 1, '202308', A.VERSION) FROM BIF.BIF_DYNM_COMP_SOU_TBL_V A, (SELECT * FROM generate_series(1, 2) AS cte(LINE_NO) ) B WHERE EXISTS (SELECT 1 FROM BIF.BIF_RPT_ITEM_DEF_MV RPT, BIF.BIF_PUB_SUBJECT_AREA_T SBJ, BIF.BIF_SNAPSHORT_SUBJECT_V TYP WHERE A.DYNM_COMP_ID = RPT.DYNM_COMP_ID AND RPT.VERSION = 'current' AND RPT.SUBJECT_AREA_ID = SBJ.SUBJECT_AREA_ID AND SBJ.SUBJECT_AREA_CODE =TYP.SUBJECT_CODE AND TYP.SUBJECT_TYPE ='TAX') AND A.VERSION = 'current' 修改点比对 案例3:递归驱动分支是VALUES字句 原始语句 WITH RECURSIVE t(n) AS ( VALUES (1) UNION ALL SELECT n+1 FROM t WHERE n < (SELECT MAX(LENGTH(COMP_CODE)-LENGTH(REPLACE(COMP_CODE,',','')))+1 MAX_TOKENS FROM (SELECT DEPT_CODE, to_char(APPLICABLE_GEO_PC_CODE) COMP_CODE FROM SDIHR.MDM_CDM_DEPT_ACT_INFO_T_3600) ) ) SELECT n AS LVL FROM t 改写语句 WITH RECURSIVE t(n) AS ( SELECT * FROM generate_series(1, 1) UNION ALL SELECT n+1 FROM t WHERE n < (SELECT MAX(LENGTH(COMP_CODE)-LENGTH(REPLACE(COMP_CODE,',','')))+1 MAX_TOKENS FROM (SELECT DEPT_CODE, to_char(APPLICABLE_GEO_PC_CODE) COMP_CODE FROM SDIHR.MDM_CDM_DEPT_ACT_INFO_T_3600) ) ) SELECT n AS LVL FROM t 修改点比对 案例4:递归驱动分支是VALUES字句 原始语句 WITH RECURSIVE t(n) AS ( VALUES (1) UNION ALL SELECT n+1 FROM t WHERE n < (SELECT MAX(LENGTH(COMP_CODE)-LENGTH(REPLACE(COMP_CODE,',','')))+1 MAX_TOKENS FROM (SELECT DEPT_CODE, to_char(APPLICABLE_GEO_PC_CODE) COMP_CODE FROM SDIHR.MDM_CDM_DEPT_ACT_INFO_T_3600)) ) SELECT n AS LVL FROM t 改写语句 SELECT * FROM generate_series(1, (SELECT MAX(LENGTH(COMP_CODE)-LENGTH(REPLACE(COMP_CODE,',','')))+1 MAX_TOKENS FROM (SELECT DEPT_CODE, to_char(APPLICABLE_GEO_PC_CODE) COMP_CODE FROM SDIHR.MDM_CDM_DEPT_ACT_INFO_T_3600)) ) AS t(lvl) 修改点比对 场景2:With-Recursive contains system table is not shippable 根因:递归语句的某个分支中没有FROM字句中只用系统表或者系统视图(DUAL也被视为系统视图) 案例1:递归驱动分支是FROM DUAL查询 原始语句 WITH recursive cte AS ( SELECT TO_DATE(201701, 'YYYYMM') as level ,TO_DATE(20170131, 'YYYYMMDD') LASTDAY FROM dual UNION ALL SELECT ADD_MONTHS(cte.LEVEL, 1) AS PERIOD, LAST_DAY(ADD_MONTHS(cte.LEVEL, 1)) AS LASTDAY FROM cte WHERE cte.LEVEL <=SYSDATE ) SELECT TO_CHAR(cte.level,'YYYYMMDD') AS PERIOD , cte.LASTDAY FROM cte WHERE TO_CHAR(cte.level,'YYYYMMDD')<= TO_CHAR(SYSDATE,'YYYYMMDD') 改写语句 WITH recursive cte AS ( SELECT TO_DATE(201701, 'YYYYMM') as level ,TO_DATE(20170131, 'YYYYMMDD') LASTDAY FROM generate_series(1, 1) UNION ALL SELECT ADD_MONTHS(cte.LEVEL, 1) AS PERIOD, LAST_DAY(ADD_MONTHS(cte.LEVEL, 1)) AS LASTDAY FROM cte WHERE cte.LEVEL <=SYSDATE ) SELECT TO_CHAR(cte.level,'YYYYMMDD') AS PERIOD , cte.LASTDAY FROM cte WHERE TO_CHAR(cte.level,'YYYYMMDD')<= TO_CHAR(SYSDATE,'YYYYMMDD') 修改点对比 场景3:SubPlan exec on CN can't be shipped 根因:某个子查询语句只能在CN上执行,通常是这个子查询有不下推因素,比如有系统表、系统视图调用,或者存在不下推函数等 案例1:子查询中系统表/系统视图查询 原始语句 WITH error_log AS NOT MATERIALIZED ( SELECT upper(log_column_name) AS log_column_name, log_error_code, s.char_length AS data_length, s.data_type,s.nullable FROM (SELECT distinct unnest(string_to_array(bad_log_column_name,',')) AS log_column_name, unnest(string_to_array(bad_log_error_code,',')) AS log_error_code FROM stgltc.BAD_cfs_inv_invoice_ad_2500 ) T, (SELECT * FROM user_tab_columns WHERE table_name=lower('dlt_cfs_inv_invoice_ad_2500')) S WHERE upper(T.log_column_name)=upper(S.column_name) ) SELECT CASE WHEN upper('ACTIVITY_NAME') IN (SELECT log_column_name FROM error_log WHERE data_type IN ('varchar','char','character','nchar','character varying','varchar2','nvarchar2','clob','text') AND log_error_code='22001'/*字符超长*/) THEN SUBSTRB(ACTIVITY_NAME,0,(SELECT distinct DATA_LENGTH FROM error_log WHERE upper(log_column_name)=upper('ACTIVITY_NAME'))) ELSE ACTIVITY_NAME END AS ACTIVITY_NAME, CASE WHEN upper('ADJUSTMENT_ID') IN (SELECT log_column_name FROM error_log WHERE data_type IN ('varchar','char','character','nchar','character varying','varchar2','nvarchar2','clob','text') AND log_error_code='22001'/*字符超长*/) THEN SUBSTRB(ADJUSTMENT_ID,0,(SELECT distinct DATA_LENGTH FROM error_log WHERE upper(log_column_name)=upper('ADJUSTMENT_ID'))) ELSE ADJUSTMENT_ID END AS ADJUSTMENT_ID FROM stgltc.BAD_cfs_inv_invoice_ad_2500 改写语句 -- 识别不下推的子查询为WITH error_log字句中的 -- SELECT * FROM user_tab_columns WHERE table_name=lower('dlt_cfs_inv_invoice_ad_2500') -- -- 因为这部分为系统表查询,无论如何都不能下推,所以此处把这部分结果转储到一个中间表中 -- 中间表创建成行存表 CREATE TEMP TABLE s WITH(orientation=row) DISTRIBUTE BY ROUNDROBIN AS SELECT * FROM user_tab_columns WHERE table_name=lower('dlt_cfs_inv_invoice_ad_2500') -- 因为整个查询涉及到的表都是列存表,之后前面创建的临时表s为行存表 -- 所以此处加一个强制走向量化的hint WITH error_log AS NOT MATERIALIZED ( SELECT upper(log_column_name) AS log_column_name, log_error_code, s.char_length AS data_length, s.data_type,s.nullable FROM (SELECT distinct unnest(string_to_array(bad_log_column_name,',')) AS log_column_name, unnest(string_to_array(bad_log_error_code,',')) AS log_error_code FROM stgltc.bad_cfs_inv_invoice_ad_2500 ) T, pg_temp.S WHERE upper(T.log_column_name)=upper(S.column_name) ) SELECT /*+ set global(enable_force_vector_engine on)*/ CASE WHEN upper('ACTIVITY_NAME') IN (SELECT log_column_name FROM error_log WHERE data_type IN ('varchar','char','character','nchar','character varying','varchar2','nvarchar2','clob','text') AND log_error_code='22001'/*字符超长*/) THEN SUBSTRB(ACTIVITY_NAME,0,(SELECT distinct DATA_LENGTH FROM error_log WHERE upper(log_column_name)=upper('ACTIVITY_NAME'))) ELSE ACTIVITY_NAME END AS ACTIVITY_NAME, CASE WHEN upper('ADJUSTMENT_ID') IN (SELECT log_column_name FROM error_log WHERE data_type IN ('varchar','char','character','nchar','character varying','varchar2','nvarchar2','clob','text') AND log_error_code='22001'/*字符超长*/) THEN SUBSTRB(ADJUSTMENT_ID,0,(SELECT distinct DATA_LENGTH FROM error_log WHERE upper(log_column_name)=upper('ADJUSTMENT_ID'))) ELSE ADJUSTMENT_ID END AS ADJUSTMENT_ID FROM stgltc.bad_cfs_inv_invoice_ad_2500 修改点对比 场景4:Type of Record in TargetList can not be shipped 根因:输出列中存在record类型,这种类型的不下推一般是不会体现在最外层的输出列上,一般这类报错有两个场景 1.SQL书写逻辑错误,导致输出列上出现了(...)形式的输出列 2.SQL业务逻辑正确, 这种场景需要了解业务含义,把record字段强转为text类型,然后再使用record字段的地方做特殊适配 案例1:输出列书写错误,出现(...)形式的输出列 原始语句 SELECT d.id, coalesce(d.period, 'snull') AS period, (d.plan_unit_code, 'snull') AS plan_unit_code, coalesce(d.product_type_model, 'snull') AS product_type_model, coalesce(d.revision, 'snull') AS revision, d.start_date FROM (SELECT * FROM cdcscm.cdc_mp_d_forecast_t_6120 t WHERE t.cdc_timestamp > to_date('2023-07-06 00:00:00', 'yyyy-mm-dd hh24:mi:ss') - 7 AND t.cdc_timestamp < to_date('2023-08-08 00:00:00', 'yyyy-mm-dd hh24:mi:ss') ) t1, sdiscm.mp_d_forecast_t_6120 d WHERE (t1.audit_op_type = 'delete' AND t1.audit_op_option = 'before') AND d.id = t1.id 改写语句 SELECT d.id, coalesce(d.period, 'snull') AS period, coalesce(d.plan_unit_code, 'snull') AS plan_unit_code, coalesce(d.product_type_model, 'snull') AS product_type_model, coalesce(d.revision, 'snull') AS revision, d.start_date FROM (SELECT * FROM cdcscm.cdc_mp_d_forecast_t_6120 t WHERE t.cdc_timestamp > to_date('2023-07-06 00:00:00', 'yyyy-mm-dd hh24:mi:ss') - 7 AND t.cdc_timestamp < to_date('2023-08-08 00:00:00', 'yyyy-mm-dd hh24:mi:ss') ) t1, sdiscm.mp_d_forecast_t_6120 d WHERE (t1.audit_op_type = 'delete' AND t1.audit_op_option = 'before') AND d.id = t1.id 修改点对比 备注:改写前后语句不等价,不等价的原因是因为原始SQL书写有问题,正确的写法是就是coalesce(d.plan_unit_code, 'snull') AS plan_unit_code。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

数仓现网案例丨超大结果集接收异常

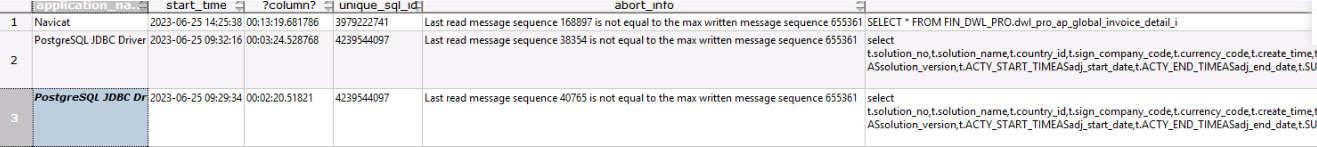
本文分享自华为云社区《GaussDB(DWS)现网案例之超大结果集接收异常》,作者:你是猴子请来的救兵吗 。 问题背景 内核版本GaussDB 8.1.3 问题描述用户使用数据库客户端工具如navicat、dbeaver等执行查询语句异常中断,中断信息"Last read message sequence %d is not equal to the max written message sequence %d" 问题定位 客户端异常中断后有些错误信息时不感知的,此时topsql就派上了用场。历史topsql记录了查询作业运行结束时的资源使用情况(包括内存、下盘、CPU时间等)和运行状态信息(包括报错、终止、异常等)以及性能告警信息。而对于由于FATAL、PANIC错误导致查询异常结束时,状态信息列只显示aborted,无法记录详细异常信息。 1,此时我们通过历史topsql查询视图查询语句执行情况 --当前CN select * from GS_WLM_SESSION_HISTORY; --所有CN select * from PGXC_WLM_SESSION_HISTORY; 根据topsql记录结果发现语句存在abort_info为 Last read message sequence %d is not equal to the max written message sequence %d 可知,查询执行遇到FATAL、PANIC错误导致查询异常结束 2,接着确认日志信息,通过线程ID查看当时语句执行情况,发现客户端存在异常中断 根因分析 前提: cn_retry开启+查询语句+max_cn_temp_file_size临时文件开启 发送逻辑: 服务端执行查询之后,会通过发送缓冲区往客户端发送数据;当查询结果集过大,则发送缓冲区满了之后,会往临时文件写数据;当临时文件超出max_cn_temp_file_size指定的最大值时(此时会禁用cn_retry),需要分批发送,此时会先将已写入临时文件的数据发送至客户端;然后继续将剩余数据写入新的临时文件发送,以此循环,直到所有数据发送完成。 问题场景: 当临时文件超出最大值时,先将其发送至客户端,此时客户端断连(如产生oom),数据发送中断,此时已发送数据量与已写入临时文件的数据量不一致,因此产生报错 Last read message sequence %d is not equal to the max written message sequence %d 此报错代表已写入临时文件的数据与已发送到客户端的数据量不一致,实际场景为客户端异常导致的发送数据中断,因此报错内容符合预期。 相关知识 相关guc参数: 1,cn_send_buffer_size:指定CN端数据发送数据缓存区的大小。整型,8~128, 单位为KB。默认8KB 2,max_cn_temp_file_size:指定SQL语句出错自动重试功能中CN端使用临时文件的最大值,设定为0表示不使用临时文件。默认5G 相关日志记录: 1,临时文件超出max_cn_temp_file_size,记录" %s temp file exceeded, max temp file size : %d KB, current result size : %ld KB" 2,客户端异常导致数据发送失败,记录"could not send data to client [ Remote IP: %s PORT: %s]. detail:%s" 3,数据发送中断或结束,当已发送数据和已写入临时文件的数据量不一致时,记录"Last read message sequence %d is not equal to the max written message sequence %d" 场景复现 创建普通表即可,导入一定量的数据,执行简单查询使其返回较大的结果集,如 select * from store_sales; 为了方便场景复现,临时将允许的临时文件最大值调整为500M,便于触发分批发送。 1,正常接收场景 此时客户端环境内存足够,可正常接收数据,超大结果集将通过临时文件下盘的方法分批发送,直到所有数据发送完成。 2,异常中断场景 此时客户端环境允许的数据量优先,超大结果集将分批发送的过程中,客户端触发OOM异常中断,服务端会记录客户端异常发送失败信息以及已发送数据不一致的错误信息。 改善办法 1,避免超大结果集的查询,如果无法避免,则通过分页或游标多次查询 2,增大客户端支持的运行内存,防止内存不足 知识小结 1,报错Last read message sequence %d is not equal to the max written message sequence %d为超大结果集返回异常中断时的报错,符合预期,需通过业务语句的改写或客户端环境的改善来解决。 2,TopSQL查询监控的原理和适用方法可参考:GaussDB for DWS 资源监控核心技术解密: TopSQL查询监控解密 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

数仓实践丨主动预防-DWS关键工具安装确认

摘要:gdb确认是否安装,所带来的该工具用户数据库实例触发core问题后集群状态反复异常,对此问题及时分析根因并及时进行规避。 本文分享自华为云社区《主动预防-DWS关键工具安装确认》,作者:上官寒雨。 【关键工具确认】 1、gdb确认是否安装(该工具用户数据库实例触发core问题后集群状态反复异常,对此问题及时分析根因并及时进行规避) 登录任意集群节点执行以下命令(HC/HCS/HCSO环境登录沙箱外执行): gdb --help 提示以下信息则已安装 2、gstack是否安装(与gdb关联工具,gdb安装后此工具会默认安装,作用与gdb相同) 登录任意集群节点执行以下命令(HC/HCS/HCSO环境登录沙箱外执行): gstack 提示以下信息则已安装 gdb与gstack安装请参考以下链接: https://bbs.huaweicloud.com/forumreview/thread-182292-1-1.html 3、core是否配置(该配置可以确保数据库实例触发core问题后能够抓取异常堆栈信息,以便使用gdb工具从所抓取信息中获取触发实例异常sql及时规避与根因定位) 集群状态为Normal时执行以下命令确认(集群normal情况下该操作不影响业务) kill -11 备dn进程号,检查对应的数据目录下是否生成core文件,若产生core文件则已配置。 若未配置请按照以下链接进行配置: HC/HCS/HCSO core配置:https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=181948 纯软core配置:https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=182036 4、pg_xlogdump是否存在(异常业务产生大量xlog后造成业务慢,磁盘使用率快速上涨等问题,使用此工具解析异常业务) pg_xlogdump提示以下信息则已安装(纯软环境加载环境变量后执行,HC/HCS/HCSO登录至沙箱内执行) 5、pagehack是否存在(数据文件出现静默损坏使用该工具解析异常数据文件) pagehack提示以下信息则已安装(纯软环境加载环境变量后执行,HC/HCS/HCSO登录至沙箱内执行) pg_xlogdump与pagehack工具获取如下链接: https://bbs.huaweicloud.com/forum/forum.php?mod=viewthread&tid=142380 上传步骤如下: 步骤1:登录至第一个CN节点,使用omm(云上使用Ruby用户)将pagehack、pg_xlogdump工具上传至该节点$GAUSSHOME/bin/下步骤2:将工具分发至其他节点 gs_ssh -c "scp$hostname:$GAUSSHOME/bin/pagehack $GAUSSHOME/bin/" gs_ssh -c "scp$hostname:$GAUSSHOME/bin/pg_xlogdump $GAUSSHOME/bin/" $hostname为第一个cn节点的hostname。 6、 gs_detect工具上传步骤(此工具包未运维团队开发,其中包括集群状态异常诊断工具、IO高工具、数据文件损坏扫描等工具,方便出现问题后及时定位及恢复) 步骤1:omm用户登录第一个cn节点(云上使用Ruby),在附件获取gs_detect工具并重命名为gs_detect.tar.gz上传至第一个cn节点/home/omm路径下(HC/HCS/HCSO形态放在第一个cn节点/home/Ruby路径下) 步骤2:使用以下命令解压 cd /home/omm tar -zxvf gs_detect.tar.gz 步骤3:将gs_detect工具分发至其他节点 gs_ssh -c "scp -rhostname:/home/omm/gs_detect /home/omm" $hostname为第一个cn节点的hostname。 注:云上的分发命令需要在沙箱内执行 【系统加固】 1、arm加固项确认(x86机器不涉及) https://support.huawei.com/enterprise/zh/bulletins-product/ENEWS2000007743 2、Centos7.6impi模块导致服务器反复重启,修复方案见附件 《CentOS7.6 ipmi模块补丁合入指导.docx》 附件:gs_detect.tar.txt67.72KB 附件:ipmi模块补丁合入指导.docx2.33MB 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

一文掌握数仓中auto analyze的使用

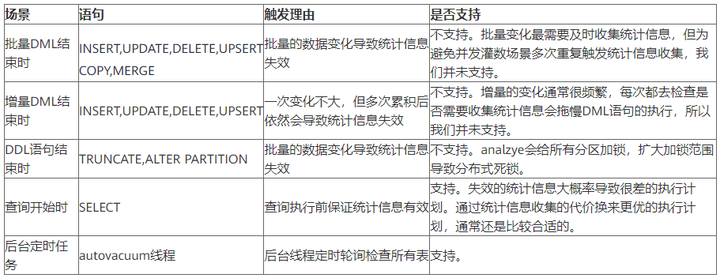
摘要:analyze执行的是否及时,在一定程度上直接决定了SQL执行的快慢。 本文分享自华为云社区《一文读懂autoanalyze使用【这次高斯不是数学家】》,作者: leapdb。 analyze执行的是否及时,在一定程度上直接决定了SQL执行的快慢。因此,GaussDB(DWS)引入了自动统计信息收集,可以做到让用户不再担心统计信息是否过期。 1. 自动收集场景 需要进行自动统计信息收集的场景通常有五个:批量DML结束时,增量DML结束时,DDL结束时,查询开始时和后台定时任务。 所以,为了避免对DML,DDL带来不必要的性能开销和死锁风险,我们选择了在查询开始前触发analzye。 2. 自动收集原理 GaussDB(DWS)在SQL执行过程中,会记录表增删改查相关的运行时统计信息,并在事务提交或回滚后记录到共享的内存种。 这些信息可以通过 “pg_stat_all_tables视图” 查询,也可以通过下面函数进行查询。 pg_stat_get_tuples_inserted --表累积insert条数 pg_stat_get_tuples_updated --表累积update条数 pg_stat_get_tuples_deleted --表累积delete条数 pg_stat_get_tuples_changed --表自上次analyze以来,修改的条数 pg_stat_get_last_analyze_time --查询最近一次analyze时间 因此,根据共享内存中 "表自上次analyze以来修改过的条数" 是否超过一定阈值,就可以判定是否需要做analyze了。 3. 自动收集阈值 3.1 全局阈值 autovacuum_analyze_threshold #表触发analyze的最小修改量 autovacuum_analyze_scale_factor #表触发analyze时的修改百分比 当"表自上次analyze以来修改的条数" >= autovacuum_analyze_threshold + 表估算大小 * autovacuum_analyze_scale_factor时,需要自动触发analyze。 3.2 表级阈值 --设置表级阈值 ALTER TABLE item SET (autovacuum_analyze_threshold=50); ALTER TABLE item SET (autovacuum_analyze_scale_factor=0.1); --查询阈值 postgres=# select pg_options_to_table(reloptions) from pg_class where relname='item'; pg_options_to_table --------------------------------------- (autovacuum_analyze_threshold,50) (autovacuum_analyze_scale_factor,0.1) (2 rows) --重置阈值 ALTER TABLE item RESET (autovacuum_analyze_threshold); ALTER TABLE item RESET (autovacuum_analyze_scale_factor); 不同表的数据特征不一样,需要触发analyze的阈值可能有不同的需求。表级阈值优先级高于全局阈值。 3.3 查看表的修改量是否超过了阈值(仅当前CN) postgres=# select pg_stat_get_local_analyze_status('t_analyze'::regclass); pg_stat_get_local_analyze_status ---------------------------------- Analyze not needed (1 row) 4. 自动收集方式 GaussDB(DWS)提供了三种场景下表的自动分析。 当查询中存在“统计信息完全缺失”或“修改量达到analyze阈值”的表,且执行计划不采取FQS (Fast Query Shipping)执行时,则通过autoanalyze控制此场景下表统计信息的自动收集。此时,查询语句会等待统计信息收集成功后,生成更优的执行计划,再执行原查询语句。 当autovacuum设置为on时,系统会定时启动autovacuum线程,对“修改量达到analyze阈值”的表在后台自动进行统计信息收集。 5.冻结统计信息 5.1 冻结表的distinct值 当一个表的distinct总是估算不准,例如:数据扎堆儿重复场景。如果表的distinct值固定,可以通过以下方式冻结表的distinct值。 postgres=# alter table lineitem alter l_orderkey set (n_distinct=0.9); ALTER TABLE postgres=# select relname,attname,attoptions from pg_attribute a,pg_class c where c.oid=a.attrelid and attname='l_orderkey'; relname | attname | attoptions ----------+------------+------------------ lineitem | l_orderkey | {n_distinct=0.9} (1 row) postgres=# alter table lineitem alter l_orderkey reset (n_distinct); ALTER TABLE postgres=# select relname,attname,attoptions from pg_attribute a,pg_class c where c.oid=a.attrelid and attname='l_orderkey'; relname | attname | attoptions ----------+------------+------------ lineitem | l_orderkey | (1 row) 5.2. 冻结表的全部统计信息 如果表的数据特征基本不变,还可以冻结表的统计信息,来避免重复进行analyze。 alter table table_name set frozen_stats=true; 6. 手动查看表是否需要做analyze a. 不想在业务高峰期时触发数据库后台任务,所以不愿意打开autovacuum来触发analyze,怎么办? b. 业务修改了一批表,想立即对这些表马上做一次analyze,又不知道都有哪些表,怎么办? c. 业务高峰来临前想对临近阈值的表都做一次analyze,怎么办? 我们将autovacuum检查阈值判断是否需要analyze逻辑,抽取成了函数,帮助用户灵活主动的检查哪些表需要做analyze。 6.1 判断表是否需要analyze(串行版,适用于所有历史版本) -- the function for get all pg_stat_activity information in all CN of current cluster. CREATE OR REPLACE FUNCTION pg_catalog.pgxc_stat_table_need_analyze(in table_name text) RETURNS BOOl AS $$ DECLARE row_data record; coor_name record; fet_active text; fetch_coor text; relTuples int4; changedTuples int4:= 0; rel_anl_threshold int4; rel_anl_scale_factor float4; sys_anl_threshold int4; sys_anl_scale_factor float4; anl_threshold int4; anl_scale_factor float4; need_analyze bool := false; BEGIN --Get all the node names fetch_coor := 'SELECT node_name FROM pgxc_node WHERE node_type=''C'''; FOR coor_name IN EXECUTE(fetch_coor) LOOP fet_active := 'EXECUTE DIRECT ON (' || coor_name.node_name || ') ''SELECT pg_stat_get_tuples_changed(oid) from pg_class where relname = ''''|| table_name ||'''';'''; FOR row_data IN EXECUTE(fet_active) LOOP changedTuples = changedTuples + row_data.pg_stat_get_tuples_changed; END LOOP; END LOOP; EXECUTE 'select pg_stat_get_live_tuples(oid) from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into relTuples; EXECUTE 'show autovacuum_analyze_threshold;' into sys_anl_threshold; EXECUTE 'show autovacuum_analyze_scale_factor;' into sys_anl_scale_factor; EXECUTE 'select (select option_value from pg_options_to_table(c.reloptions) where option_name = ''autovacuum_analyze_threshold'') as value from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into rel_anl_threshold; EXECUTE 'select (select option_value from pg_options_to_table(c.reloptions) where option_name = ''autovacuum_analyze_scale_factor'') as value from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into rel_anl_scale_factor; --dbms_output.put_line('relTuples='||relTuples||'; sys_anl_threshold='||sys_anl_threshold||'; sys_anl_scale_factor='||sys_anl_scale_factor||'; rel_anl_threshold='||rel_anl_threshold||'; rel_anl_scale_factor='||rel_anl_scale_factor||';'); if rel_anl_threshold IS NOT NULL then anl_threshold = rel_anl_threshold; else anl_threshold = sys_anl_threshold; end if; if rel_anl_scale_factor IS NOT NULL then anl_scale_factor = rel_anl_scale_factor; else anl_scale_factor = sys_anl_scale_factor; end if; if changedTuples > anl_threshold + anl_scale_factor * relTuples then need_analyze := true; end if; return need_analyze; END; $$ LANGUAGE 'plpgsql'; 6.2 判断表是否需要analyze(并行版,适用于支持并行执行框架的版本) -- the function for get all pg_stat_activity information in all CN of current cluster. --SELECT sum(a) FROM pg_catalog.pgxc_parallel_query('cn', 'SELECT 1::int FROM pg_class LIMIT 10') AS (a int); 利用并发执行框架 CREATE OR REPLACE FUNCTION pg_catalog.pgxc_stat_table_need_analyze(in table_name text) RETURNS BOOl AS $$ DECLARE relTuples int4; changedTuples int4:= 0; rel_anl_threshold int4; rel_anl_scale_factor float4; sys_anl_threshold int4; sys_anl_scale_factor float4; anl_threshold int4; anl_scale_factor float4; need_analyze bool := false; BEGIN --Get all the node names EXECUTE 'SELECT sum(a) FROM pg_catalog.pgxc_parallel_query(''cn'', ''SELECT pg_stat_get_tuples_changed(oid)::int4 from pg_class where relname = ''''|| table_name ||'''';'') AS (a int4);' into changedTuples; EXECUTE 'select pg_stat_get_live_tuples(oid) from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into relTuples; EXECUTE 'show autovacuum_analyze_threshold;' into sys_anl_threshold; EXECUTE 'show autovacuum_analyze_scale_factor;' into sys_anl_scale_factor; EXECUTE 'select (select option_value from pg_options_to_table(c.reloptions) where option_name = ''autovacuum_analyze_threshold'') as value from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into rel_anl_threshold; EXECUTE 'select (select option_value from pg_options_to_table(c.reloptions) where option_name = ''autovacuum_analyze_scale_factor'') as value from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into rel_anl_scale_factor; dbms_output.put_line('relTuples='||relTuples||'; sys_anl_threshold='||sys_anl_threshold||'; sys_anl_scale_factor='||sys_anl_scale_factor||'; rel_anl_threshold='||rel_anl_threshold||'; rel_anl_scale_factor='||rel_anl_scale_factor||';'); if rel_anl_threshold IS NOT NULL then anl_threshold = rel_anl_threshold; else anl_threshold = sys_anl_threshold; end if; if rel_anl_scale_factor IS NOT NULL then anl_scale_factor = rel_anl_scale_factor; else anl_scale_factor = sys_anl_scale_factor; end if; if changedTuples > anl_threshold + anl_scale_factor * relTuples then need_analyze := true; end if; return need_analyze; END; $$ LANGUAGE 'plpgsql'; 6.3 判断表是否需要analyze(自定义阈值) -- the function for get all pg_stat_activity information in all CN of current cluster. CREATE OR REPLACE FUNCTION pg_catalog.pgxc_stat_table_need_analyze(in table_name text, int anl_threshold, float anl_scale_factor) RETURNS BOOl AS $$ DECLARE relTuples int4; changedTuples int4:= 0; need_analyze bool := false; BEGIN --Get all the node names EXECUTE 'SELECT sum(a) FROM pg_catalog.pgxc_parallel_query(''cn'', ''SELECT pg_stat_get_tuples_changed(oid)::int4 from pg_class where relname = ''''|| table_name ||'''';'') AS (a int4);' into changedTuples; EXECUTE 'select pg_stat_get_live_tuples(oid) from pg_class c where c.oid = '''|| table_name ||'''::REGCLASS;' into relTuples; if changedTuples > anl_threshold + anl_scale_factor * relTuples then need_analyze := true; end if; return need_analyze; END; $$ LANGUAGE 'plpgsql'; 通“优化器触发的实时analyze”和“后台autovacuum触发的轮询analyze”,GaussDB(DWS)已经可以做到让用户不再关心表是否需要analyze。建议在最新版本中试用。 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册