Python 学习(六)
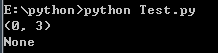
1. 正则表达式 re 模块使 Python 语言拥有全部的正则表达式功能。 1). re.match函数 re.match 尝试从字符串的起始位置匹配一个模式,如果不是起始位置匹配成功的话,match()就返回none。 函数语法: re.match(pattern, string, flags=0) 函数参数说明: pattern : 匹配的正则表达式 string : 要匹配的字符串 flags : 标志位,用于控制正则表达式的匹配方式,如:是否区分大小写,多行匹配等等。 # 正则表达式 import re # 在起始位置开始匹配 print(re.match("www","www.baidu.com").span()) # 不在起始位置开始匹配 print(re.match("com","www.baidu.com")) 图1.png 2). 使用group(num) 或 groups() 匹配对象函数来获取匹配表达式。 group(num=0):匹配的整个表达式的字符串,group() 可以一次输入多个组号,在这种情况下它将返回一个包含那些组所对应值的元组 groups():返回一个包含所有小组字符串的元组,从 1 到 所含的小组号 # group import re # 字符串 line = "Cats are smarter than dogs" # 正则匹配 matchObj = re.match(r'(.*) are (.*?) .*', line, re.M|re.I) # 判断是否匹配成功 if matchObj: print("matchObj.group(): ", matchObj.group()) print("matchObj.group(1): ", matchObj.group(1)) print("matchObj.group(2): ", matchObj.group(2)) pass else: print("No match!") 打印结果: 图2.png 3). re.search方法 re.search 扫描整个字符串并返回第一个成功的匹配。 函数语法: re.search(pattern, string, flags=0) 函数参数说明: pattern : 匹配的正则表达式 string : 要匹配的字符串 flags : 标志位,用于控制正则表达式的匹配方式,如:是否区分大小写,多行匹配等等 import re # 在起始位置匹配 print(re.search("www","www.baidu.com").span()) # 不在起始位置匹配 print(re.search("com","www.baidu.com").span()) 打印结果: 图3.png 我们可以使用group(num) 或 groups() 匹配对象函数来获取匹配表达式。 group(num=0):匹配的整个表达式的字符串,group() 可以一次输入多个组号,在这种情况下它将返回一个包含那些组所对应值的元组。 groups():返回一个包含所有小组字符串的元组,从 1 到 所含的小组号。 import re line = "Cats are smarter than dogs" searchObj = re.search(r"(.*) are (.*?) .*", line, re.M|re.I) if searchObj: print("searchObj.group(): ", searchObj.group()) print("searchObj.group(1): ", searchObj.group(1)) print("searchObj.group(2): ", searchObj.group(2)) pass else: print("Nothing found!") pass 打印结果: 图4.png 4). re.match与re.search的区别 re.match只匹配字符串的开始,如果字符串开始不符合正则表达式,则匹配失败,函数返回None;而re.search匹配整个字符串,直到找到一个匹配。 5). 检索和替换 Python 的re模块提供了re.sub用于替换字符串中的匹配项。 语法: re.sub(pattern, repl, string, count=0) 参数: pattern : 正则中的模式字符串。 repl : 替换的字符串,也可为一个函数。 string : 要被查找替换的原始字符串。 count : 模式匹配后替换的最大次数,默认 0 表示替换所有的匹配。 repl为字符串示例: import re phone = "2004-959-559 # 这个一个电话号码" # 删除注释 num = re.sub(r'#.*$', "", phone) print("电话号码:", num) # 移除非数字内容 num = re.sub(r'\D', "", phone) print("电话号码:", num) 打印结果: 图5.png repl为函数示例: # 将匹配的数字乘于2 def double(matched): value = int(matched.group('value')) return str(value*2) pass s = "A23G4HF56" print(re.sub("(?P<value>\d+)", double, s)) 打印结果: 图6.png 6). compile 函数 compile 函数用于编译正则表达式,生成一个正则表达式( Pattern )对象,供 match() 和 search() 这两个函数使用。 语法格式为: re.compile(pattern[, flags]) 参数: pattern : 一个字符串形式的正则表达式 flags 可选,表示匹配模式,比如忽略大小写,多行模式等,具体参数为: 1> re.I 忽略大小写 2> re.L 表示特殊字符集 \w, \W, \b, \B, \s, \S 依赖于当前环境 3> re.M 多行模式 4> re.S 即为' . '并且包括换行符在内的任意字符(' . '不包括换行符) 5> re.U 表示特殊字符集 \w, \W, \b, \B, \d, \D, \s, \S 依赖于 Unicode 字符属性数据库 6> re.X 为了增加可读性,忽略空格和' # '后面的注释 示例: import re # 用于匹配至少一个数字 pattern = re.compile(r'\d+') # 查找头部,没有匹配 m = pattern.match('one12twothree34four') # 打印 print(m) # 从‘e’的位置开始匹配,没有匹配 m = pattern.match('one12twothree34four', 2, 10) print(m) # 从‘1’的位置开始匹配,正好匹配 m = pattern.match('one12twothree34four', 3, 10) print(m) # group([group1, …]) 方法用于获得一个或多个分组匹配的字符串,当要获得整个匹配的子串时,可直接使用 group() 或 group(0); print(m.group(0)) # start([group]) 方法用于获取分组匹配的子串在整个字符串中的起始位置(子串第一个字符的索引),参数默认值为 0; print(m.start(0)) # end([group]) 方法用于获取分组匹配的子串在整个字符串中的结束位置(子串最后一个字符的索引+1),参数默认值为 0; print(m.end(0)) # span([group]) 方法返回 (start(group), end(group))。 print(m.span(0)) 打印结果: 图7.png 7). findall 在字符串中找到正则表达式所匹配的所有子串,并返回一个列表,如果没有找到匹配的,则返回空列表。注意: match 和 search 是匹配一次 findall 匹配所有。 语法格式为: findall(string[, pos[, endpos]]) 参数: string 待匹配的字符串。 pos 可选参数,指定字符串的起始位置,默认为 0。 endpos 可选参数,指定字符串的结束位置,默认为字符串的长度。 import re # 查找数字 pattern = re.compile(r'\d+') result1 = pattern.findall('runoob 123 google 456') result2 = pattern.findall('runoob123google456', 0, 10) print(result1) print(result2) 打印结果: 图8.png 8). finditer 和 findall 类似,在字符串中找到正则表达式所匹配的所有子串,并把它们作为一个迭代器返回。 re.finditer(pattern, string, flags=0) 参数: pattern : 匹配的正则表达式 string : 要匹配的字符串 flags : 标志位,用于控制正则表达式的匹配方式,如:是否区分大小写,多行匹配等等 import re it = re.finditer(r"\d+","12a32bc43jf3") for match in it: print(match.group()) pass 打印结果: 图9.png 2. CGI(Common Gateway Interface) CGI(Common Gateway Interface),通用网关接口,它是一段程序,运行在服务器上如:HTTP服务器,提供同客户端HTML页面的接口。 1). 网页浏览 为了更好的了解CGI是如何工作的,我们可以从在网页上点击一个链接或URL的流程: 1、使用你的浏览器访问URL并连接到HTTP web 服务器。 2、Web服务器接收到请求信息后会解析URL,并查找访问的文件在服务器上是否存在,如果存在返回文件的内容,否则返回错误信息。 3、浏览器从服务器上接收信息,并显示接收的文件或者错误信息。 CGI程序可以是Python脚本,PERL脚本,SHELL脚本,C或者C++程序等。 2). CGI架构图 图10-CGI架构图 3). 程序 #!D:\java\python\python.exe import cgi form=cgi.FieldStorage() name=form.getvalue('name','world') print """Content-type:text/html <html> <head> <title>Greeting Page</title> </head> <body> <h1>Hello.%s!</h1> <form action='simple3.cgi'> Change name <input type='text' name='name'/> <input type='submit' /> </form> </body> </html> """%name