首页 文章 精选 留言 我的

精选列表

搜索[search],共6636篇文章
优秀的个人博客,低调大师

Zinc Search Engine —— 轻量级的 Elasticsearch 替代方案

Zinc 是一个进行全文索引的搜索引擎。它是 Elasticsearch的轻量级替代品,运行在不到 100 MB 的 RAM 中。它使用bluge作为底层索引库。与 elasticsearch 不同,它非常简单且易于操作。 特征: 提供全文索引功能 用于安装和运行的单个二进制文件。在多个平台的发行版下可用的二进制文件。 用 Vue 编写,用于查询数据的 Web UI 与用于摄取数据的 elasticsearch API 兼容(单条记录和批量 API) 开箱即用的身份验证 截图 用户管理画面 下载/安装/运行 二进制文件 可以从相应平台的 Release 页面下载二进制文件。 创建将存储数据的数据文件夹 $ mkdir data $ FIRST_ADMIN_USER=admin FIRST_ADMIN_PASSWORD=Complexpass#123 zinc 现在将浏览器指向http://localhost:4080并登录 Docker $ mkdir data $ docker run -v /full/path/of/data:/data -e DATA_PATH="/data" -p 4080:4080 -e FIRST_ADMIN_USER=admin -e FIRST_ADMIN_PASSWORD=Complexpass#123 -p 4080:4080 --name zinc public.ecr.aws/m5j1b6u0/zinc:v0.1.1 现在将浏览器指向http://localhost:4080并登录 Kubernetes kubectl apply -f kube-deployment.yaml kubectl -n zinc port-forward svc/z 4080:4080 现在将浏览器指向http://localhost:4080并登录

优秀的个人博客,低调大师

论文笔记系列-Efficient Neural Architecture Search via Parameter Sharing

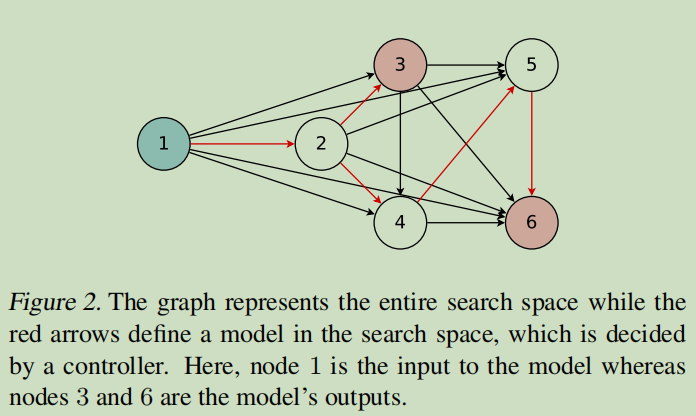
Summary 本文提出超越神经架构搜索(NAS)的高效神经架构搜索(ENAS),这是一种经济的自动化模型设计方法,通过强制所有子模型共享权重从而提升了NAS的效率,克服了NAS算力成本巨大且耗时的缺陷,GPU运算时间缩短了1000倍以上。在Penn Treebank数据集上,ENAS实现了55.8的测试困惑度;在CIFAR-10数据集上,其测试误差达到了2.89%,与NASNet不相上下(2.65%的测试误差) Research Objective 作者的研究目标 设计一种快速有效且耗费资源低的用于自动化网络模型设计的方法。主要贡献是基于NAS方法提升计算效率,使得各个子网络模型共享权重,从而避免低效率的从头训练。 Problem Statement 问题陈述,要解决什么问题? 本文提出的方法是对NAS的改进。NAS存在的问题是它的计算瓶颈,因为NAS是每次将一个子网络训练到收敛,之后得到相应的reward,再将这个reward反馈给RNN controller。但是在下一轮训练子网络时,是从头开始训练,而上一轮的子网络的训练结果并没有利用起来。 另外NAS虽然在每个节点上的operation设计灵活度较高,但是固定了网络的拓扑结构为二叉树。所以ENAS对于网络拓扑结构的设计做了改进,有了更高的灵活性。 Method(s) 解决问题的方法/算法 ENAS算法核心 回顾NAS,可以知道其本质是在一个大的搜索图中找到合适的子图作为模型,也可以理解为使用单个有向无环图(single directed acyclic graph, DAG)来表示NAS的搜索空间。 基于此,ENAS的DAG其实就是NAS搜索空间中所有可能的子模型的叠加。 下图给出了一个通用的DAG示例 如图示,各个节点表示本地运算,边表示信息的流动方向。图中的6个节点包含有多种单向DAG,而红色线标出的DAG则是所选择的的子图。 以该子图为例,节点1表示输入,而节点3和节点6因为是端节点,所以作为输出,一般是将而二者合并求均值后输出。 在讨论ENAS的搜索空间之前,需要介绍的是ENAS的测试数据集分别是CIFAR-10和Penn Treebank,前者需要通过ENAS生成CNN网络,后者则需要生成RNN网络。 所以下面会从生成RNN和生成CNN两个方面来介绍ENAS算法。 1.Design Recurrent Cells 本小节介绍如何从特定的DAG和controller中设计一个递归神经网络的cell(Section 2.1)? 首先假设共有\(N\)个节点,ENAS的controller其实就是一个RNN结构,它用于决定 哪条边需要激活 DAG中每个节点需要执行什么样的计算 下图以\(N=4\)为例子展示了如何生成RNN。 假设\(x[t]\)为输入,\(h[t-1]\)表示上一个时刻的输出状态。 节点1:由图可知,controller在节点1上选择的操作是tanh运算,所以有\(h_1=tanh(X_t·W^{(X)}+h_{t-1}·W_1^{(h)})\) 节点2:同理有\(h_2 = ReLU(h_1·W_{2,1}^{(h)})\) 节点3:\(h_3 = ReLU(h_2·W_{3,2}^{(h)})\) 节点4:\(h_4 = ReLU(h_1·W_{4,1}^{(h)})\) 节点3和节点4因为不是其他节点的输入,所以二者的平均值作为输出,即\(h_t=\frac{h_3+h_4}{2}\) 由上面的例子可以看到对于每一组节点\((node_i,node_j),i<j\),都会有对应的权重矩阵\(W_{j,i}^{(h)}\)。因此在ENAS中,所有的recurrent cells其实是在搜索空间中共享这样一组权重的。 但是我们可以很容易知道ENAS的搜索空间是非常庞大的,例如假设共有4中激活参数(tanh,identity,sigmoid,ReLU)可以选择,节点数为N,那么搜索空间大小则为\(4^N * N!\),如果N=12,那么就将近有\(10^{15}\)种模型参数。 2.1 Design Convolutional Networks 本小节解释如何设计卷积结构的搜索空间 回顾上面的Recurrent Cell的设计,我们知道controller RNN在每一个节点会做如下两个决定:a)该节点需要连接前面哪一个节点 b)使用何种激活函数。 而在卷积模型的搜索空间中,controller RNN也会做如下两个觉得:a)该节点需要连接前面哪一个节点 b)使用何种计算操作。 在卷积模型中,(a)决定 (连接哪一个节点) 其实就是skip connections。(b)决定一共有6种选择,分别是3*3和5*5大小的卷积核、3*3和5*5大小的深度可分离卷积核,3*3大小的最大池化和平均池化。 下图展示了卷积网络的生成示意图。 2.2 Design Convolutional Cell 本文并没有采用直接设计完整的卷积网络的方法,而是先设计小型的模块然后将模块连接以构建完整的网络(Zoph et al., 2018)。 下图展示了这种设计的例子,其中设计了卷积单元和 reduction cell。 接下来将讨论如何利用 ENAS 搜索由这些单元组成的架构。 假设下图的DAG共有\(B\)个节点,其中节点1和节点2是输入,所以controller只需要对剩下的\(B-2\)个节点都要做如下两个决定:a)当前节点需要与那两个节点相连 b)所选择的两个节点需要采用什么样的操作。(可选择的操作有5种:identity(id,相等),大小为3*3或者5*5的separate conv(sep),大小为3*3的最大池化。) 可以看到对于节点3而言,controller采样的需要连接的两个节点都是节点2,两个节点预测的操作分别是sep 5*5和identity。 3.Training ENAS and Deriving Architectures 本小节介绍如何训练ENAS以及如何从ENAS的controller中生成框架结构。(Section 2.2) controller网络是含有100个隐藏节点的LSTM。LSTM通过softmax分类器做出选择。另外在第一步时controller会接收一个空的embedding作为输入。 在ENAS中共有两组可学习的参数: 子网络模型的共享参数,用\(w\)表示。 controller网络(即LSTM网络参数),用\(θ\)表示。 而训练ENAS的步骤主要包含两个交叉阶段:第一部训练子网络的共享参数\(w\);第二个阶段是训练controller的参数\(θ\)。这两个阶段在ENAS的训练过程中交替进行,具体介绍如下: 子网络模型共享参数\(w\)的训练 在这个步骤中,首先固定controller的policy network,即\(π(m;θ)\)。之后对\(w\)使用SGD算法来最小化期望损失函数\(E_{m~π}[L(m;w)]\)。 其中\(L(m;w)\)是标准的交叉熵损失函数:\(m\)表示根据policy network \(π(m;θ)\)生成的模型,然后用这个模型在一组训练数据集上计算得到的损失值。 根据Monte Carlo估计计算梯度公式如下: \[\nabla_w E_{m-~π}(m;θ)[L(m;w)] ≈ \frac{1}{M} \sum_i^M \nabla_wL(m_i;w) \] 其中上式中的\(m_i\)表示由\(π(m;θ)\)生成的M个模型中的某一个模型。 虽然上式给出了梯度的无偏估计,但是方差比使用SGD得到的梯度的方差大。但是当\(M=1\)时,上式效果还可以。 训练controller参数θ 在这个步骤中,首先固定\(w\),之后通过求解最大化期望奖励\(E_{m~π}[R(m;w)]\)来更新\(θ\)。其中在语言模型实验中\(R(m;w)=\frac{c}{valid\_ppl}\),perplexity是基于小批量验证集计算得到的;在分类模型试验中,\(R(m;w)\)等于基于小批量验证集的准确率。 导出模型架构 首先使用\(π(m,θ)\)生成若干模型。 之后对于每一个采样得到的模型,直接计算其在验证集上得到的奖励。 最后选择奖励最高的模型再次从头训练。 当然如果像NAS那样把所有采样得到的子模型都先从头训练一边,也许会对实验结果有所提升。但是ENAS之所以Efficient,就是因为它不用这么做,原理继续看下文。 Evaluation 评估方法 1.在 Penn Treebank 数据集上训练的语言模型 2.在 CIFAR-10 数据集上的图像分类实验 由上表可以看出,ENAS的最终结果不如NAS,这是因为ENAS没有像NAS那样从训练后的controller中采样多个模型架构,然后从中选出在验证集上表现最好的一个。但是即便效果不如NAS,但是ENAS效果并不差太多,而且训练效率大幅提升。 下图是生成的宏观搜索空间。 ENAS 用了 11.5 个小时来发现合适的卷积单元和 reduction 单元,如下图所示。 Conclusion ENAS能在Penn Treebank和CIFAR-10两个数据集上得到和NAS差不多的效果,而且训练时间大幅缩短,效率大大提升。 MARSGGBO原创 2018-8-7

优秀的个人博客,低调大师

elk(日志监控系统搭建),elastic search,kibana,logstash,filebeat搭建

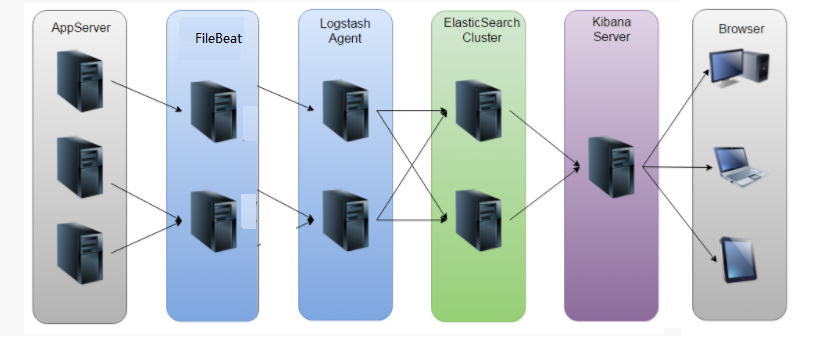
架构图 演示效果 日志输入 kibana 查看 35. elk 安装 准备工作 wget -c https://download.elastic.co/elasticsearch/release/org/elasticsearch/distribution/rpm/elasticsearch/2.3.3/elasticsearch-2.3.3.rpm wget -c https://download.elastic.co/logstash/logstash/packages/centos/logstash-2.3.2-1.noarch.rpm wget https://download.elastic.co/kibana/kibana/kibana-4.5.1-1.x86_64.rpm wget -c https://download.elastic.co/beats/filebeat/filebeat-1.2.3-x86_64.rpm 35.0 java 安装 yum install java-1.8.0-openjdk -y 35.1 elasticsearch 安装 yum localinstall elasticsearch-2.3.3.rpm -y systemctl daemon-reload systemctl enable elasticsearch systemctl start elasticsearch systemctl status elasticsearch systemctl status elasticsearch -l 检查 es 服务 rpm -qc elasticsearch /etc/elasticsearch/elasticsearch.yml /etc/elasticsearch/logging.yml /etc/init.d/elasticsearch /etc/sysconfig/elasticsearch /usr/lib/sysctl.d/elasticsearch.conf /usr/lib/systemd/system/elasticsearch.service /usr/lib/tmpfiles.d/elasticsearch.conf 修改防火墙对外 firewall-cmd --permanent --add-port={9200/tcp,9300/tcp} firewall-cmd --reload firewall-cmd --list-all 35.2 安装 kibana yum localinstall kibana-4.5.1-1.x86_64.rpm –y systemctl enable kibana systemctl start kibana systemctl status kibana systemctl status kibana -l 检查kibana服务运行 netstat -nltp firewall-cmd --permanent --add-port=5601/tcp firewall-cmd --reload firewall-cmd --list-all 访问地址 http://192.168.206.130:5601/ 35.3 安装 logstash yum localinstall logstash-2.3.2-1.noarch.rpm –y cd /etc/pki/tls/ && ls 创建证书 openssl req -subj '/CN=baoyou.com/' -x509 -days 3650 -batch -nodes -newkey rsa:2048 -keyout private/logstash-forwarder.key -out certs/logstash-forwarder.crt cat /etc/logstash/conf.d/01-logstash-initial.conf input { beats { port => 5000 type => "logs" ssl => true ssl_certificate => "/etc/pki/tls/certs/logstash-forwarder.crt" ssl_key => "/etc/pki/tls/private/logstash-forwarder.key" } } filter { if [type] == "syslog-beat" { grok { match => { "message" => "%{SYSLOGTIMESTAMP:syslog_timestamp} %{SYSLOGHOST:syslog_hostname} %{DATA:syslog_program}(?:\[%{POSINT:syslog_pid}\])?: %{GREEDYDATA:syslog_message}" } add_field => [ "received_at", "%{@timestamp}" ] add_field => [ "received_from", "%{host}" ] } geoip { source => "clientip" } syslog_pri {} date { match => [ "syslog_timestamp", "MMM d HH:mm:ss", "MMM dd HH:mm:ss" ] } } } output { elasticsearch { } stdout { codec => rubydebug } } 启动logstash systemctl start logstash /sbin/chkconfig logstash on 检查服务 netstat -ntlp 添加防火墙对外 firewall-cmd --permanent --add-port=5000/tcp firewall-cmd --reload firewall-cmd --list-all 配置 es cd /etc/elasticsearch/ mkdir es-01 mv *.yml es-01 vim elasticsearch.yml http: port: 9200 network: host: baoyou.com node: name: baoyou.com path: data: /etc/elasticsearch/data/es-01 systemctl restart elasticsearch systemctl restart logstash 3.4 filebeat 安装 yum localinstall filebeat-1.2.3-x86_64.rpm -y cp logstash-forwarder.crt /etc/pki/tls/certs/. cd /etc/filebeat/ && tree vim filebeat.yml filebeat: spool_size: 1024 idle_timeout: 5s registry_file: .filebeat config_dir: /etc/filebeat/conf.d output: logstash: hosts: - elk.test.com:5000 tls: certificate_authorities: ["/etc/pki/tls/certs/logstash-forwarder.crt"] enabled: true shipper: {} logging: {} runoptions: {} mkdir conf.d && cd conf.d vim authlogs.yml filebeat: prospectors: - paths: - /var/log/secure encoding: plain fields_under_root: false input_type: log ignore_older: 24h document_type: syslog-beat scan_frequency: 10s harvester_buffer_size: 16384 tail_files: false force_close_files: false backoff: 1s max_backoff: 1s backoff_factor: 2 partial_line_waiting: 5s max_bytes: 10485760 vim syslogs.yml filebeat: prospectors: - paths: - /var/log/messages encoding: plain fields_under_root: false input_type: log ignore_older: 24h document_type: syslog-beat scan_frequency: 10s harvester_buffer_size: 16384 tail_files: false force_close_files: false backoff: 1s max_backoff: 1s backoff_factor: 2 partial_line_waiting: 5s max_bytes: 10485760 service filebeat start chkconfig filebeat on netstat -aulpt 访问地址 http://192.168.206.130:5601/ 备注:参看文章 elk 日志监控系统 http://467754239.blog.51cto.com/4878013/1700828/ https://my.oschina.net/itblog/blog/547250 https://www.ibm.com/developerworks/cn/opensource/os-cn-elk/ http://www.cnblogs.com/hanyifeng/p/5509985.html (我用该文章搭建成功了) http://blog.csdn.net/dabokele/article/details/51765136 https://cloud.tencent.com/community/article/562397 捐助开发者 在兴趣的驱动下,写一个免费的东西,有欣喜,也还有汗水,希望你喜欢我的作品,同时也能支持一下。 当然,有钱捧个钱场(支持支付宝和微信 以及扣扣群),没钱捧个人场,谢谢各位。 个人主页:http://knight-black-bob.iteye.com/ 谢谢您的赞助,我会做的更好!

优秀的个人博客,低调大师

Kubernetes 中 Elastic Search 集群的通信加密、认证和清理

外加版本较旧,处于“能用”的状态而已。 而近期的版本中这一情况发生了变化,原来的elasticsearch中新增了一个子目录: production_cluster,README.md中的介绍是: A more robust example that follows Elasticsearch best-practices of separating nodes concern is also available. 这个听起来就厉害了,关键字:robuts,best-practice。 顺藤摸瓜找到了作者的 github 地址:https://github.com/pires/ 这一集群的特点是: ES 集群分为 Master/Client/Data 三组,各司其职,各自可以设置自己的资源使用,参数配置等。 提供了 StatefulSet 形式的

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册