首页 文章 精选 留言 我的

精选列表

搜索[pipeline],共2137篇文章
优秀的个人博客,低调大师

构建数据湖上低延迟数据 Pipeline 的实践

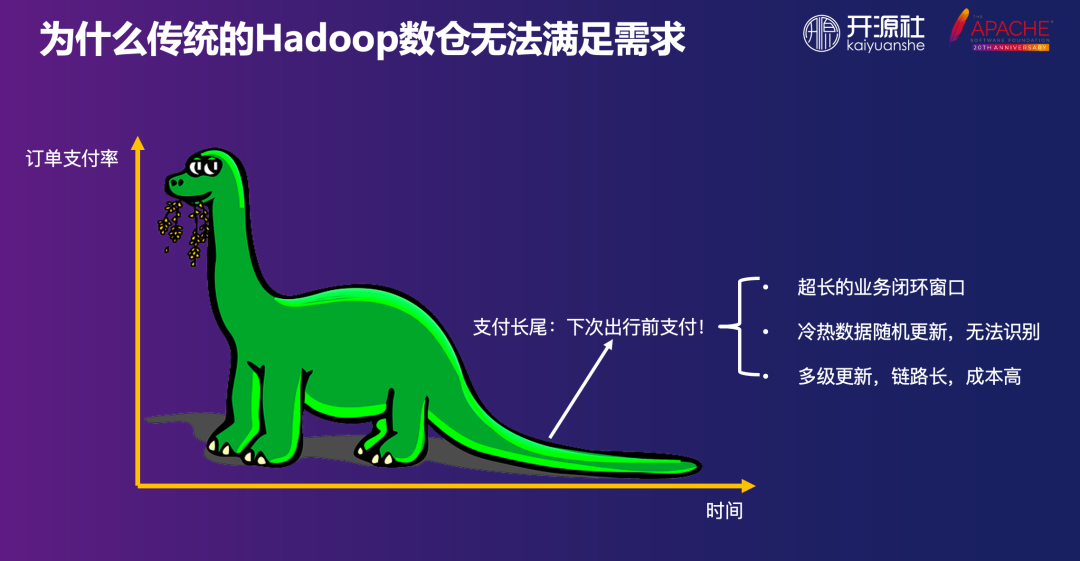
T 摘要· 云原生与数据湖是当今大数据领域最热的 2 个话题,本文着重从为什么传统数仓 无法满足业务需求? 为何需要建设数据湖?数据湖整体技术架构、Apache Hudi 存储模式与视图、如何解决冷数据频繁更新、如何在数据湖上进行准实时 分析、数据湖上调度为何选型 Apache DolphinScheduler、二次开发新特性以及规划等多个角度进行了阐述。 讲师介绍 杨华,T3 出行大数据平台负责人。Apache Hudi Committer & PMC、Apache Kylin Committer 及 Flink Cube 引擎作者。Apache Flink 国内早期布道者及活跃贡献者。曾在腾讯主导 Flink 在腾讯从落地到支撑日均近 20 万亿消息的处理。 赵玉威,T3 出行高级工程师,对大数据任务调度有深入研究。 这里也简要介绍一下 T3 出行:T3出行是由一汽、东风、长安联合腾讯、阿里巴巴等共同投资打造,有中国网约车“国家队”之称。 10 月 25 日的 COSCon’20 & Apache Roadshow - China 上,来自 T3 出行大数据平台负责人杨华和 高级工程师赵玉威同学带来了题为《T3 出行构建数据湖上低延迟数据管道的实践》的分享。以下是分享视频: 1 什么是数据湖 什么是数据湖 引用来自 AWS 对数据湖的定义: Adata lake is a centralized repository that allows you to store all yourstructured and unstructured data at any scale. You can store your data as-is,without having to first structure the data, and run different types ofanalytics—from dashboards and visualizations to big data processing, real-timeanalytics, and machine learning to guide better decisions. 数据湖是一个集中式的存储库,允许您以任意规模存储所有结构化和非结构化数据。您可以按原样存储数据(无需先对数据进行结构化处理),并运行不同类型的分析–从控制面板和可视化到大数据处理、实时分析和机器学习,以指导做出更好的决策。 2 T3出行为什么需要数据湖 出行行业存在着下次出行前支付这个支付长尾问题,这造成了超长的业务闭环窗口,历史冷数据随机更新还有多级更新、链路长等特点, T3 出行数据湖整体技术架构 数据湖框架 - Apache Hudi 简介 Hudi 插件化的架构 Hudi 存储模式与视图 T3 出行如何在数据湖上进行准实时分析 Hudi 与 DolphinScheduler 的集成 Why DolphinScheduler? 目前在业界应用较多的工作流调度系统包括 Oozie、Azkaban、Airflow 以及 Dolphin Scheduler 等。 从高可用、易用性、社区活跃度、可拓展性、与 Hadoop 生态圈集成以及维护成本几个维度进行了调研对比: T3 出行 从EasyScheduler 升级为 DolphinScheduler DolphinScheduler 最近发布的 1.3.2 版本,性能较 EasyScheduler 有 2~3 倍的提升,主要体现在调度策略、执行效率、单位时间吞吐、堆积处理等几个核心性能指标上。 DolphinScheduler 与 EasyScheduler 压测对比 l调度密度:调度周期为 1h,工作流每隔 20 秒调度一次 l集群非调度时间内处于空闲状态,状态基本一致;在调度周期内只有工作流内的任务在耗用资源 DolphinScheduler 与 EasyScheduler系统运作的差异 在 DolphinScheduler 新架构(黑线)中Master 职能更加丰富,Worker 则更加专注于执行。 在 EasyScheduler 中 Worker 不仅要主动“揽活”,还要负责“善后”工作。 任务的执行状态要通过访问数据库才能获得,对于那些任务复杂的工作流来说,时效性,任务吞吐,数据库压力都会成为调度性能的瓶颈。 DolphinScheduler 提升细节 - Netty 的引入 在 EasyScheduler 架构中,由于 Master 与 Worker 间没有直接交互的渠道,因而使得Master 的职能比较单一,同时降低了 Worker 的执行效率;两者通过第三方系统“曲线”通信带来的弊端是:耗费了大量时间与资源在数据库与ZooKeeper的操作上,牺牲性能以保障系统能够运作,这种过度使用底层组件的方式也为集群及调度自身的稳定埋下了隐患。 DolphinScheduler 提升细节 - Balance 机制 在 EasyScheduler 中 Worker的使用率与负载率难以均衡: lMaster 只负责工作流的拆分,无法管控任务如何分发; lWorker 通过非公平锁的方式从 zk 的任务队列中竞争拉取任务,无法合理分配 为此 DolphinScheduler 提供了三种任务分配策略:随机,轮询和资源线性加权。 Ø随机分发策略与非公平锁竞争类似; Ø轮询分发策略只能保证使用率与负载率的均衡; Ø资源线性加权根据 cpu,内存及 loadAverage 加权计算出各 worker 负荷指标,择优分发 线性加权是 DolphinScheduler 默认的分发策略,计算密集型或者内存紧吃的任务不会轻易得再由负荷较高的 Worker 去执行。 DolphinScheduler 提升细节 -易用性提升 除了性能方面,社区也一直致力于易用性的提升,使调度对运维人员及业务开发人员更加亲和友好。 Ø支持 K8s:DolphinScheduler 支持 K8s 部署; Ø简化配置:分离 install.sh 中的参数配置和集群部署配置,install.sh 仅供集群部署,集群参数配置文件抽取到 conf/config/install_config.conf 中; Ø工作流布局优化:提供一键美化工作流 DAG 功能,这对于通过 http client 与调度交互时非常实用。开发人员只需要关注 DAG 中的依赖关系即可,坐标信息,连接信息交给格式化工具来处理。 3 T3出行做了哪些改进 在充分利用 DolphinScheduler 原生功能特性的基础上,基于平台与业务的赋能驱动,T3对DolphinScheduler进行了大量嵌入式开发,目的是: l解决调度嵌入平台时遇到的兼容性问题,同时提供插件化所需的接口规范 l提供定制化任务类型的支持与现有任务类型的拓展 l特定场景下原生调度模式的适配及重构 l数仓业务由 EasyScheduler 向DolphinScheduler升级的版本兼容性问题 T3开发调度新特性 -调度场景拓展 提供 httpclient 用于平台内组件与 DolphinScheduler 交互。多数情况下,平台内业务都倾向于通过消息触发的方式与调度进行交互,通过 http client 调度可以将核心功能完全释放到平台侧,对于上层业务来说甚至不感知调度的存在。 通过平台可以对调度上的任务进行 CURD 操作,以及状态信息及日志的查看 T3开发调度新特性 -服务滚动升级 调度系统自适应平台最终体现在服务的变更,服务集成滚动升级是自适应的前提与低成本的保障。 T3开发调度新特性 -策略式通知管理 订阅式策略通知管理,细粒度的任务监控体系: ü策略动态配置、启用与屏蔽 ü细粒度事件管理,避免通知时出现“羊群效应” ü同一事件源一对多告警群组 ü同一群组内同一事件源单一触发 T3开发调度新特性 -对接 Prometheus ü服务集成 PushGateway 完成指标推送 ü多维度展示统计类与趋势变化类指标 ü易拓展,支持指标定制化,动态生效 T3 正在doing-事件驱动调度模式 事件驱动调度:把不同系统的业务逻辑用事件关联起来,来驱动业务或者流程继续执行。 l内部事件源:例如调度中一个工作流中的子任务节点,它是通过所有父节点执行完毕这个事件驱动触发的; l外部事件源:例如外部某个组件,当其激活后需要立即拉起任务,获取数据以提供服务,”激活”就是事件 l事件重放:对于外部事件源,事件驱动只需要业务方抛出事件即可(异步任务调度除外),调度则应该负责持久化该事件以具备重放能力。 l解决方案:配置定时任务轮询捕获外部事件源虽然可行,但调度使用监听来驱动事件无疑更节约资源,任务触发实时性更高;并且事件中可以传递任务所须的参数,当调度监听到事件后解析参数然后组装成对应的任务,调度执行。 T3 正在doing-异步回调调度模式 异步任务调度:核心是提供结果回调功能。 l使用场景:调度上某个任务执行完成后,需要将这个消息传达到外部以推动第三方系统内业务的流转,必要时消息中需要携带第三方所需的配置参数,结果信息等 l与事件驱动调度的区别: •该场景下,调度系统任务结束成为了外部事件源 •调度系统不能只是简单地将事件抛出,还需兼顾延迟回调,回调失败重试,回调审计等功能 l解决方案:对于回调的方式,可以参考 hudi 使用的 http 回调,或者 Kafka回调。 T3正在doing -策略式任务集成 当调度原生的任务类型无法满足业务线的个性需求时,需要不断地去适配,并且适配内容间鲜有共性,无法复用。对此,调度可以将差集内的任务执行策略交由业务自定义,自身负责策略模板的提供与执行策略的解析与管理。 T3正在doing -策略延迟调度 延迟任务调度:当任务提交后,在指定时间后延迟执行 l类似场景:包括用户下单后,一定时间后未付款自动关闭订单;用户打车后,一定时间后自动评价等 l常规方案与缺陷:扫描业务表,筛选出符合条件的数据对其进行操作,但存在扫描间隔影响任务延迟触发的精准性及可靠性等问题 l改进措施:调度维护延迟队列或在任务配置参数中新增延迟选项,即可以保证延迟执行的精确性,同时也能发挥自身高可用,可重试,能告警,提供管理视图的优势 4 T3的未来规划 T3打算做TODO-运维管理 提供指标概览页面单独的统计类运维概览页面,通过图表的形式展示任务相关的统计类指标据,例如: l近 M 天内执行时长的 TopN 实例或异常次数最多的 TopN 实例的柱状图; l可以标识数据量变化或调度负载变化的实例近 M 天运行时长的折线图; l提供 SQL 类图表生成器,可定制化 T3 打算做TODO- 路由策略 Ø故障转移:失败策略可选配置“故障转移”,工作节点故障后,自动 failover 切换到一台运行正常的工作点上重试 Ø忙碌转移:增加等待策略,当任务处于 WAITING 状态达到一定时间,由管理节点重新分配,尝试将任务转移到相对空闲的工作节点 T3 打算做TODO- 审计日志 T3打算做TODO- 数据血缘 Ø血缘关系管理:记录上下游数据资源编码,数据项编码和数据资源转换规则等数据血缘信息,动态更新 Ø血缘关系分析:对数据资源进行数据流向分析和溯源分析,更进一步可以提供数据血缘图谱展示 Ø血缘关系查询:支持按照数据类别、数据项和转换规则进行数据血缘查询Ø数据价值评估:通过数据血缘标出数据流转的引用/更新频次,展示各级数据的应用热度 T3打算做TODO-调度客户端 l状态管理:提供命令行,方便监管调度服务状态,提供统计信息 例如:scheduler restart worker-server;scheduler state 等 l任务管理器:不同于 http client 的 java 客户端形式,通过客户端脚本作为环境变量,以 shell 命令的方式拓展平台与调度的交互方式 例如:scheduler submit ...; schedulerkill ...; scheduler rerun ... 等 T3打算做TODO-跨集群调度与容灾 l跨集群调度:调度内服务通过标签的形式标识为不同集群组,提供类似 agent的服务由一个 ui 页面统一管理。 l容灾:在实现跨集群调度的基础上,主备集群容灾的全量与增量数据备份都可以通过调度定时完成,并通过调度提供的异步调度与事件通知机制来监管备份过程。 5 参与贡献 参与 DolphinScheduler 社区有非常多的参与贡献的方式,包括文档、翻译、布道、答疑、测试、以及代码等,此外也极其欢迎各种实践文章,DolphinScheduler开源社区非常期待您的参与。 贡献第一个PR(文档、代码)我们也希望是简单的,试想如果是一个新人一上来就贡献1个改了几十个文件的 PR 将会对参与review 的伙伴的心理造成多大的摧残,😝 如何参与贡献链接:https://dolphinscheduler.apache.org/zh-cn/docs/development/contribute.html 文档github地址:https://github.com/apache/incubator-dolphinscheduler-website 来吧,DolphinScheduler开源社区需要您的参与,为中国开源崛起添砖加瓦吧,哪怕只是小小的一块瓦,汇聚起来的力量也是巨大的 DolphinScheduler's Github Repo 传送门 ↓↓↓ https://github.com/apache/incubator-dolphinscheduler 喜欢❤️ DolphinScheduler 的话,别忘了 Star 收藏一下哟~ 点击“阅读原文”获取会议PPT资料 本文分享自微信公众号 - 海豚调度(dolphin-scheduler)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

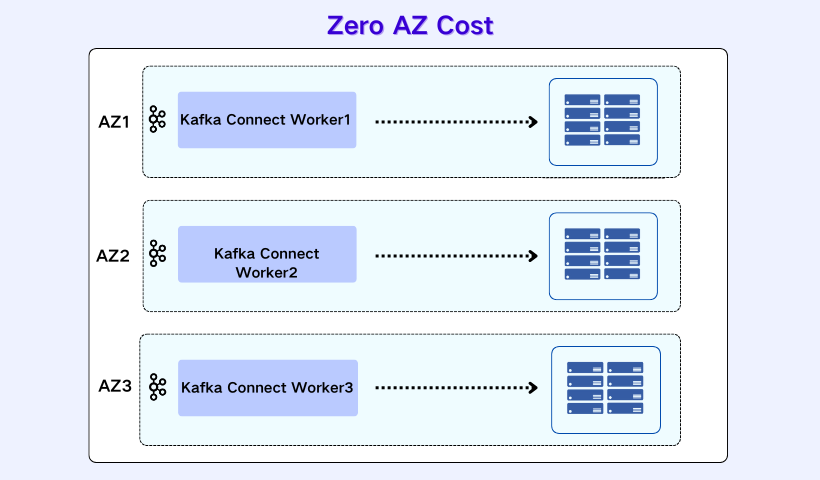
Kafka Connect x AutoMQ: Zero Cross-AZ Data Pipeline

介绍 今天,我们正式宣布:AutoMQ BYOC(Bring Your Own Cloud)正式上线 Connector 托管能力。 AutoMQ 作为基于 S3 构建的新一代 Diskless Kafka,已经在存储层实现了计算存储分离与 Zero Cross-AZ(零跨可用区)复制,大幅降低了云上 Kafka 的 TCO。随着 Connector 托管能力的引入,我们进一步降低了数据集成场景的准入门槛:在 AWS 等公有云上,你现在可以在一个统一的控制面中,以极简的方式构建从数据采集(Connect)到流存储(AutoMQ)的数据管道。通过产品层面的深度集成,我们把构建生产级 CDC 链路的复杂度从"专家级"降低到了"入门级"。 挑战:CDC 链路中的"流量刺客"与配置壁垒 在云原生架构中,Kafka Connect 是连接数据库与 Kafka 的关键桥梁。特别是在高吞吐的 CDC(Change Data Capture)场景下,用户往往面临着两个核心挑战,导致成本与运维压力居高不下: 难以规避的跨 AZ 流量"隐形税" AutoMQ 通过基于 S3 的共享存储架构,可以在服务端层面完全消除客户端写入 AutoMQ 时的跨 AZ 流量费用。但要真正做到"端到端 Zero Cross-AZ",通常还要求**客户端(例如 Kafka Connect Connector)**具备一定的可用区感知能力或遵循特定的路由策略。现实情况是,在传统自建 Connector 模式下,Worker 节点往往用默认配置直接启动,对服务端的网络拓扑一无所知。结果就是:即便 AutoMQ 侧已经为本地写入做好了架构准备,这些"蒙眼狂奔"的 Connector 仍可能把 TB 级别的 CDC 流量写到其他 AZ 的 Broker,产生大量跨 AZ 传输(Regional Data Transfer)费用,把 Diskless 架构在存储层带来的优势抵消掉。 自管理 Connector 成本高昂 在传统模式下,要把 Connector 调到既稳定又省钱,本质上是一整套高门槛的"自助运维套餐": 配置上的精细活:你得啃完一堆文档,手动配置 Rack Awareness,按 AZ 划分 Bootstrap 地址,权衡要不要开压缩、到底用哪种压缩算法; 集群和基础设施运维:还要自己拉起并维护 Connect 集群,在 K8s 里部署、配置 VPC/安全组、接好监控告警,预估并处理扩缩容和升级带来的各种影响; 隐藏成本和不可见风险:即便前面所有步骤都做对了,细节上也很容易翻车------只要有一个 client 参数漏配或配错,就可能让本应利用 AutoMQ 架构优势实现的 Zero Cross‑AZ 能力彻底失效,跨 AZ 流量又悄悄回到老路子上,直到月底账单出来才发现被多收了一大笔钱。 正是因为自管 Connector 充满这种看不见、摸不着但真金白银买单的复杂度,很多团队才开始认真评估:是不是应该把这部分彻底交给一个 Fully Managed 的平台来做。 深度集成:把复杂留给平台,把简单留给用户 AutoMQ 托管 Connector 的核心价值,在于利用统一控制面(Unified Control Plane)的上下文优势,实现了 Connector 与 AutoMQ 集群的深度绑定与自动化适配。 我们通过产品设计,将"如何正确连接 AutoMQ"这一复杂问题,在平台侧通过自动化手段解决: 上下文感知的配置注入 在 AutoMQ 控制台中,托管 Connector 天然知道它所连接的 AutoMQ 集群的一切信息(接入点、认证方式、版本特性等)。 当用户创建 Connector 时,系统会自动生成并注入适配 AutoMQ 最佳实践的 Client Configuration 。无论是基础的连接参数,还是适配 AutoMQ Zero Cross-AZ 特性所需的特殊配置,平台都会在后台自动完成。 这意味着,用户不需要理解底层的参数细节,Connector 启动即处于"最佳状态"。 统一网络环境的无缝连接 托管 Connector 部署在与 AutoMQ 集群相同的 VPC 环境中。平台自动处理了网络连通性配置(Connectivity),用户无需在复杂的 VPC Peering、Secuity Group 规则中周旋。只要在同一个环境,就能天然连通,安全且高效。 一站式全生命周期管理 我们将 Connector 的创建、配置、监控和日志查询全部收敛到了 AutoMQ 控制台。这不仅仅是 UI 的整合,更是运维流的打通。用户可以在一个页面闭环解决所有问题,大幅降低了构建和维护 CDC 链路的隐形成本。 产品体验:四步向导,一屏掌控 我们将复杂的集成逻辑封装为标准化的四步向导,让 CDC 链路的搭建回归业务本质。 1. 通用设置:自动化的环境适配 这是集成的起点。用户只需选择目标 AutoMQ 实例和 Kubernetes 集群,系统会自动锁定正确的网络上下文和 IAM 角色。"选择即适配",复杂的连接参数配置在后台自动完成。 2. 连接配置:兼容性与易用性的平衡 支持标准的 Kafka Connect 插件生态,并系统内置了 Debezium 等 CDC 插件,针对不同的用户习惯,我们提供了灵活的配置模式: 表单模式:针对 S3 Sink 等标准化插件,参数可视化,减少配置错误。 自定义模式:针对 Debezium 等复杂场景,支持直接粘贴 JSON/Properties,确保存量业务的平滑迁移。 3. 可观测性:打破数据孤岛 在"额外设置"中,我们内置了标准化的可观测性集成。通过勾选 Remote Write,Connector 的监控指标可直接对接到 Prometheus/Grafana 体系,无需额外部署 Exporter,彻底告别黑盒运维。 4. 部署与运维:全程可视 提交后,AutoMQ 接管全流程部署。部署完成后,用户获得的是一个具备深度的运维仪表盘。 实时吞吐监控: 日志聚合查询:无需登录 K8s,直接在控制台聚合查询所有 Worker 日志,快速定位业务异常。 总结 AutoMQ Connector 托管能力的上线,标志着 AutoMQ 从单一的流存储引擎向完整的云原生流数据平台迈出了关键一步。 通过将 Connector 与 AutoMQ 集群进行产品级强绑定,我们实现了: 极简的 CDC 链路构建:无需关心繁琐的 Client 参数与网络配置,四步向导即可拉起生产级链路。 默认的最佳实践:通过自动化的配置注入,天然适配 AutoMQ 的核心特性(如 Zero Cross-AZ),消除配置错误带来的隐患。 统一的治理体验:从 Broker 到 Connector,在同一控制台内实现全栈闭环管理。 如果你正在寻找一个能够快速落地、且运维成本极低的数据集成方案,欢迎参考我们的官方文档,在 AutoMQ BYOC 环境中体验这一新特性。 💡 开源 AutoMQ 正在 Github Trending 中,欢迎关注: https://go.automq.com/github?utm_source=openwrite_automq 👇 AutoMQ 商业版当前提供 2 周免费试用,欢迎试用: https://go.automq.com/home?utm_source=openwrite_automq

优秀的个人博客,低调大师

在SAP Data Intelligence Modeler里创建新的pipeline

新建一个graph: 保存: 将Processing下面的Data Generator这个Operator拖拽到graph的编辑区域,点击<>符号开始编辑脚本: 可以查看自动生成的JavaScript代码: 这个Generator生成的随机数需要一个输出,这里我们选择terminal operator: 将data Generator的outport绑定到terminal的inport: 执行: 在终端上看到打印的输出: 本文来自云栖社区合作伙伴“汪子熙”,了解相关信息可以关注微信公众号"汪子熙"。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册