首页 文章 精选 留言 我的

精选列表

搜索[enterprise],共2525篇文章
优秀的个人博客,低调大师

03-sql-enterprise-data-SQL与企业数据

# 第 3 课:SQL 与企业数据——FDE 怎么跟"脏数据"打交道 > 系列:AI FDE 20 课 | 主线项目:北岸智造企业 AI Assistant > 本课在主线中的位置:北岸 CRM 模拟库:找客户/订单/客服记录 → 客户 360° → 给 Agent 的查询接口 > 进了客户现场,AI 模型是最后才见面的东西——你先见面的是一堆没人说得清的表。 ## 学习目标 - 能在拿到一个陌生数据库后 2 小时内,用 SQL 摸清 Schema、行数、数据分布,画出一张"数据地图" - 能写出含 JOIN、CTE、Window Function 的复杂查询,并解释每一步在干什么 - 能对一张表做数据质量体检:NULL 比例、重复、脏值、外键失配,输出一份质量清单 - 能给"客户 360°"这种跨表视图建模,并用 Python + SQLite/PostgreSQL 封装成 Agent 可调用的查询接口 - 能判断哪些字段可以放心给 AI 用,哪些必须打标、脱敏或者干脆不给 ## FDE 场景导入 北岸智造的客服总监上周发话:"给客服做个 AI 助手,能直接回答客户打电话问的问题——我下过多少单、最近那笔到哪了、上次投诉处理得怎么样。" 你到了现场,对方 IT 给你一个只读账号和一句"CRM 数据都在里面"。你连上去一看:`cust_mstr`、`t_order_his`、`cust_info_bak`、`order_detail_2023_new`……九十多张表,表名像密码。问谁是owner,IT 说系统是外包做的,前一家供应商 2019 年就撤了。销售团队用 Salesforce,但一半人还是往 Excel 里填,月底有人导回去。客服记录居然存在 ERP 的一个备注字段里。 这就是 FDE 的日常。模型选择、Prompt 设计那些事,得等你先回答四个问题:**数据在哪?谁拥有它?哪些字段可信?哪些能给 AI?** 这节课就练这个。别小看这几小时,客户判断你靠不靠谱,往往就看你翻开数据库的第一天问出了什么问题。 ## 核心概念 **SQL 核心(SELECT/WHERE/GROUP BY)**。听起来像大学内容,但客户现场真正常用的是"聚合后比对":按客户聚合订单数、按月份统计投诉量、按部门分组看处理时长。为什么 FDE 必须懂:你要用查询结果判断业务口径,写不出来就只能等别人的排期,一等一周。 **JOIN**。企业数据天然是分表的:客户表、订单表、客服记录表分属不同模块。JOIN 是把"一个客户的全貌"拼出来的基本动作。难点不在语法,在弄清哪张表是事实表、哪张是维度表、关联键有没有脏值——`customer_id` 在订单表里存在但在客户表里查不到,这种事每天都在发生。 **CTE(WITH 子句)**。把一段查询起个名字复用。为什么 FDE 必须懂:客户现场的查询动辄两三百行,嵌套子查询没人看得懂也没人敢改。CTE 把"先算活跃客户、再算他们的订单、最后拼客服记录"拆成命名步骤,你交付的 SQL 客户方的 DBA 要接手维护的,写得像天书,第二天就没人认账。 **Window Function(窗口函数)**。`ROW_NUMBER()`、`RANK()`、`SUM() OVER (PARTITION BY ...)`。它解决"分组内排序/累计"问题——每个客户最近一笔订单、订单金额在客户内的排名、按时间累计的消费。去重取"最新一条"几乎全靠它:按 customer_id 分区、按 update_time 倒序、取第 1 行。 **数据建模**。不是让你画 ER 图给架构委员会看,而是让你心里有模型:谁是主数据(客户),谁是过程数据(订单、工单),谁是派生数据(报表、视图)。建模判断直接决定 AI 查询接口怎么设计——把派生逻辑放 SQL 视图里,还是放 Python 里,还是让 LLM 自己现场拼。 **图:客户全景数据模型** ```mermaid erDiagram CUSTOMERS ||--o{ ORDERS : 拥有订单 CUSTOMERS ||--o{ SERVICE_TICKETS : 产生工单 CUSTOMERS ||--|| CUSTOMER_360_VIEW : 汇总为全景 CUSTOMERS { string customer_id PK string company_name string region } ORDERS { string order_id PK string customer_id FK decimal amount date order_date } SERVICE_TICKETS { string ticket_id PK string customer_id FK string status } ``` **Schema Discovery**。系统性摸底的动作:列出所有表和列、看行数和最近更新时间、抽样看值、找注释和外键。信息来源除了 `INFORMATION_SCHEMA`,还有建表 DDL、ETL 任务脚本、找老员工问。FDE 版本就是"两小时出一张数据地图"。 **数据质量**。完整度(NULL 比例)、唯一性(重复客户)、一致性(同一客户在两套系统里名字不同)、时效性(最后更新是三年前)、有效性(性别字段里出现"test"和"1")。每一条都直接影响 AI 回答的可信度——垃圾进,垃圾出,只是这次垃圾是被 AI 一本正经地说出来的。 **数据血缘**。一个字段从哪来、经过谁加工、到了哪张表。报表里的"大客户营收"可能来自三套系统的 union 加一条手工修正规则。没有血缘,你就不知道一个数字错了要怪谁,也不知道字段口径变了 AI 会不会跟着错。 **图:客户全景字段血缘** ```mermaid flowchart LR A[客户表 公司名] --> D[客户全景视图] B[订单表 金额日期聚合] --> D C[工单表 数量状态聚合] --> D D --> E[查询接口函数] E --> F[AI 客服回答] ``` **数据权限**。谁能看哪些行哪些列。北岸有销售、客服、财务、HR、IT 五类角色,销售只能看自己片区的客户,客服不该看到合同金额,HR 数据是另一条命。这决定了 Agent 的查询接口必须在 SQL 层或应用层做行级/列级过滤,而不是"查出来再说"。 ## 技术原理 **为什么"AI 项目"本质上是数据项目。** 一个查客户的 Agent,准确率上限不取决于模型,取决于底下的查询和数据。模型再好,订单表里 `amount` 一半是 NULL,它就只能编。FDE 的价值在于提前把数据状况摸清楚,在方案里明确写"这个字段不可信,AI 回答时会降级为'以人工核实为准'"。这是对客户负责,也是给自己留退路。 **JOIN 的成本与陷阱。** `INNER JOIN` 会悄悄丢掉一边没匹配上的行——查"每个客户的客服记录数",没投诉过的客户直接消失,业务方一看报表以为客户都满意了。做客户 360° 要用 `LEFT JOIN` 从客户表出发,并且要清楚 NULL 会在聚合里怎么表现(`COUNT(*)` 和 `COUNT(col)` 不一样)。大表 JOIN 在客户现场还有性能问题:你一个探索性查询把生产库拖死,第二天 IT 就来找你喝茶。原则:**永远先在备份库/模拟库上跑,生产库只查行数和样本。** **CTE 和 Window Function 的组合拳。** 经典套路是"每个分组取最新一条": ```sql WITH ranked AS ( SELECT *, ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY updated_at DESC) AS rn FROM customer_contact_history ) SELECT * FROM ranked WHERE rn = 1; ``` 先分区排序打标,再过滤。这个模式在企业数据里出现频率高得惊人:客户多渠道联系记录、订单多次改价、工单多次流转,都只关心"最新状态"。 **数据建模的三层判断。** 对 FDE 来说建模是三个问题:一,这个业务问题的"实体"是什么(北岸客服场景:客户、订单、客服工单);二,实体间的关联键是什么、键可不可信;三,AI 需要的视图长什么样——"客户 360°"应该是预先物化的宽表/视图,还是运行时现拼。我的建议:给 Agent 的接口面向**预定义视图**,不要让 LLM 面对九十张原始表自由发挥。让模型写任意 SQL 看着炫,但生产上等于把数据权限和性能问题全交给概率。 **图:客户全景视图拼装** ```mermaid flowchart LR A[客户主表] -->|左连接| E[客户全景视图] B[订单聚合子查询] -->|左连接| E C[最新订单子查询] -->|左连接| E D[工单统计子查询] -->|左连接| E E --> F[Agent 白名单接口] ``` **Schema Discovery 的方法论。** 按这个顺序来,别乱翻: 1. `INFORMATION_SCHEMA.TABLES` 拿全部表名 + 粗略分类(按表名前缀猜模块) 2. 每张表查行数、`MIN/MAX(created_at)`,判断是不是活跃表 3. 抽样 `SELECT * LIMIT 20`,肉眼看列含义和脏值 4. 找外键和命名规律(`customer_id` 出现在哪些表 = 一张隐形的关联图) 5. 问人:谁是 owner、哪些表是备份/废弃、有没有口径文档 前三步机器做,后两步必须问人。文档常常是过期的,最准的地图在老员工脑子里。 **图:Schema Discovery 五步法** ```mermaid flowchart TD A[拉全表清单] --> B[看行数与更新时间] B --> C[抽样肉眼查值] C --> D[找外键与命名规律] D --> E[问人确认口径] ``` **数据质量的量化。** 质量不是一个"好/差"的形容词,是每列一个数字:NULL 占比、distinct 数、最小最大值、非法值样本。这份清单会直接变成你方案里的"数据风险登记表",也是第 11 课做 Eval 时挑边界用例的弹药库。 **权限的落地位置。** 行级权限有三种放法:数据库层(PostgreSQL RLS,客户 DBA 说了算,最稳但你未必有权限配)、应用层(查询接口强制拼 WHERE 条件,可控但要防绕过)、Agent 层(靠 Prompt 约束——**不靠谱,第 15 课会专门打这一点**)。FDE 选型原则:权限约束离数据越近越安全,Prompt 约束只能算提示,不能算防线。 ## 架构图 ``` 北岸智造 · 数据层 → AI 查询接口(本课交付) ────────────────────────────────────────────────────────────── 原始系统(不可控) 模拟 CRM 库(SQLite/PostgreSQL) ┌──────────────┐ ┌──────────────────────────────┐ │ Salesforce │──导出──▶ │ customers (客户主数据) │ │ ERP 订单模块 │ │ orders (订单) │ │ 客服工单 │ │ service_tickets (客服记录) │ │ Excel 手填 │ │ (故意埋入 NULL/重复/脏值) │ └──────────────┘ └──────────┬───────────────────┘ │ Schema Discovery + 数据质量体检 │ ┌─────────▼─────────┐ │ 数据地图 + 风险表 │ └─────────┬─────────┘ │ 建模:预定义视图 ┌─────────▼─────────┐ │ v_customer_360 │ ◀── 客户 360° │ (宽表,含质量标记) │ └─────────┬─────────┘ │ ┌─────────▼─────────┐ │ 查询接口 (Python) │ │ get_customer_360()│ ◀── 第 9 课 Agent │ search_orders() │ 直接调用 └───────────────────┘ ``` 注意接口的形状:第 9 课的 Agent 拿到的不是数据库连接,而是这几个函数。函数内部写死 SQL 和权限过滤,Agent 只能选函数、传参数。这个隔离是后面一切安全设计的基础。 ## 代码示例 **第一段:Schema Discovery——自动生成数据地图**(SQLite,PostgreSQL 把 `sqlite_master` 换成 `information_schema` 即可): ```python import sqlite3 def discover_schema(db_path: str) -> None: """两小时数据地图的第一步:表、列、行数、时间范围""" conn = sqlite3.connect(db_path) cur = conn.cursor() tables = [r[0] for r in cur.execute( "SELECT name FROM sqlite_master WHERE type='table' AND name NOT LIKE 'sqlite_%'" )] for t in tables: cols = [(r[1], r[2]) for r in cur.execute(f"PRAGMA table_info({t})")] row_count = cur.execute(f"SELECT COUNT(*) FROM {t}").fetchone()[0] print(f"\n== {t} ({row_count} rows)") for name, ctype in cols: nulls = cur.execute( f"SELECT SUM(CASE WHEN {name} IS NULL THEN 1 ELSE 0 END) FROM {t}" ).fetchone()[0] pct = f"{100 * nulls / row_count:.0f}%" if row_count else "-" print(f" {name: dict | None: sql = "SELECT * FROM v_customer_360 WHERE customer_id = ?" params = [customer_id] if self.allowed_region: sql += " AND region = ?" params.append(self.allowed_region) row = self.conn.execute(sql, params).fetchone() if not row: return None cols = [d[0] for d in self.conn.execute( "SELECT * FROM v_customer_360 LIMIT 0").description] return dict(zip(cols, row)) api = CrmQueryAPI("beian_crm.db", allowed_region="north") print(api.get_customer_360("C1001")) ``` FDE 视角:所有参数走占位符 `?`,永远不拼字符串——Agent 传进来的任何东西都当数据不当代码。`allowed_region` 是最小化的行级权限示范,真实项目里这个值来自登录身份,绝不能由 Agent 自己决定。 ## 企业案例 北岸智造的切面:第一次跑客户 360° 视图,客服总监发现"华东区大客户 A 公司"显示有 43 笔订单——但销售说这家公司去年才合作。查下去发现,A 公司的 `company_name` 和另一家同名小供应商在客户表里是两条记录,老系统合并客户时把订单都挂到了同一个 ID 上。销售团队当年知道这事,靠"脑子记着这家数据是脏的"绕过去了。AI 没有脑子,它会把 43 笔订单一本正经地报给客服。 这件事最后变成了两条交付约定:客户 360° 视图加了一个 `data_confidence` 字段(该客户经历过合并标记为 low),AI 回答时低置信度客户要先说"该客户数据存在合并记录,以下数字仅供参考"。你看,问题不在模型,在数据——但解决方案得由懂两边的人来设计。 业界也反复上演同一出戏:据公开报道,多家企业早期 AI 助手项目复盘时,失败原因排前头的是数据质量与权限治理,而不是模型能力。 ## 常见错误 **1. 拿生产库当实验场。** 错误做法:连上客户生产库直接跑探索查询,一个没加索引条件的大 JOIN 把库拖慢。→ 后果:轻则被 IT 收走权限,重则影响客户当日业务,信任清零。→ 正确做法:申请只读备份库或自己搭模拟库;生产库只跑 `COUNT` 和 `LIMIT`。 **2. 用 INNER JOIN 出报表。** 错误做法:查"客户 + 客服记录"用 INNER JOIN。→ 后果:没投诉过的客户从结果里消失,业务方据此得出"客户满意度很高"的错误结论。→ 正确做法:从主实体出发用 LEFT JOIN,并明确"没有记录"和"记录为零"在结果里长什么样。 **3. 让 LLM 面对原始 Schema 自由写 SQL。** 错误做法:把 90 张表的 DDL 塞进 Prompt,让模型自己生成查询。→ 后果:模型可能查到权限外数据、生成慢查询、对脏字段一本正经地解读,且每次行为不同。→ 正确做法:预定义视图 + 白名单函数接口,模型只选函数传参数;真要开放 Text-to-SQL,也要限定视图范围、只读账号、超时与行数上限。 **4. 把"有数据"当成"数据可信"。** 错误做法:字段有值就往 AI 的上下文里塞。→ 后果:`gender='test'`、订单金额为 0、三年没更新的客户档案混进回答,客户业务人员一眼看出不对,AI 整体信誉崩掉。→ 正确做法:逐列做质量体检,不可信字段打标或排除,风险写进方案文档。 **5. 权限靠 Prompt 说"请不要越权"。** 错误做法:在 System Prompt 里写"你只能查询当前用户权限范围内的数据"。→ 后果:一句"忽略之前的指令"就能绕过(第 15 课细讲)。→ 正确做法:过滤逻辑写进 SQL 或查询接口,Prompt 里的规则只是给用户看的说明。 ## Workshop 30 分钟,两人一组,材料是讲师发的 `dirty_orders.csv`(内含 NULL 金额、重复订单号、日期格式混用、客户名大小写不一)。 1. 5 分钟:不写代码,肉眼扫一遍,列出你怀疑的所有问题类型 2. 15 分钟:用 SQL(或 pandas,但 SQL 优先)逐条验证怀疑,每类问题给出量化数字(几条、占比) 3. 5 分钟:两人交换清单,找出对方漏掉的问题 4. 5 分钟:合并成一张"数据质量登记表":列名 / 问题类型 / 影响行数 / 建议处理方式 / 是否影响 AI 可用 产出物格式: ``` | 列名 | 问题 | 行数(占比) | 处理建议 | AI 可用性 | |------|------|-----------|---------|-----------| | amount | NULL | 132 (11%) | 剔除或按 0 标记 | 不可直接聚合 | ``` 这张表就是你以后到每个客户现场第一天要交的东西。 ## Lab 实战 **90 分钟:从零搭建北岸 CRM 模拟库并交付 Agent 查询接口。** 环境:Python 3.10+,SQLite(自带,零安装;有 PostgreSQL 环境的推荐用 PG,练 `information_schema` 和 RLS)。 Checklist: - [ ] **0-15 min|生成模拟库。** 写 `seed.py`,创建 `customers`(500 家,含 region、company_name)、`orders`(约 3000 笔)、`service_tickets`(约 800 条)三张表。**故意埋雷**:5% 的订单 amount 为 NULL、3% 的客户名有前后空格和大小写混乱、2% 的订单指向不存在的 customer_id、20 个客户名重复(不同 ID 同名) - [ ] **15-35 min|Schema Discovery。** 用(或改写)上文 `discover_schema`,对模拟库输出完整数据地图:每表行数、每列 NULL 率;再写两条 SQL 找出:孤儿订单(外键失配)、重复客户名 - [ ] **35-55 min|数据质量登记表。** 把发现汇总成 Workshop 那个格式的表,写进 `DATA_QUALITY.md`,每条给出处理决定(清洗/打标/排除) - [ ] **55-75 min|客户 360°。** 建 `v_customer_360` 视图(含订单数、总金额、最近订单、工单数、未结工单数),验证:无工单客户不消失、金额 NULL 订单不拉爆总数、同名客户各自独立 - [ ] **75-90 min|查询接口。** 实现 `CrmQueryAPI`:`get_customer_360(id)`、`search_orders(customer_id, days)` 两个方法,含 region 行级过滤和参数化查询;写 5 个断言测试(含"普通权限查不到其他 region 的客户") 验收标准: 1. `python seed.py && python discover.py` 能完整跑通,输出数据地图 2. `DATA_QUALITY.md` 至少覆盖 4 类问题且每类有量化数字 3. `get_customer_360("C1001")` 返回完整 dict,且 region 过滤测试通过 4. 视图对埋入的每一类脏数据都有明确处理行为,测试可复现 5. 全程无字符串拼接 SQL ## 实操 1. 把 Lab 接口升级为 PostgreSQL 版本:用 `information_schema` 重写 Schema Discovery,加一张 `customers` 表的 `data_confidence` 列,视图里对"被合并过的客户"降置信度,接口返回时带上这个标记并写一句给 AI 的降级提示语 2. 给 `v_customer_360` 加一个"客户活跃度"窗口函数字段:按 region 分区、按最近 12 个月订单金额算 `NTILE(4)` 四分位,写一段说明:这个字段在给 AI 的话术里怎么用("该客户属于华东区消费前 25%"),以及为什么不用子查询实现 ## 问题思考 **1. 接手一个陌生企业数据库,你前两个小时做什么?** 答题要点:先机器后人工——用系统目录拉表清单和行数,识别活跃表与废弃表;抽样看值判断字段含义;找外键和命名规律画出隐式关联图。然后必须问人:谁是 owner、哪些表口径有坑、有没有合并/迁移历史。最后产出一张数据地图和质量登记表,这是后续所有方案的依据。关键是体现出"数据地图是交付物,不是笔记"。 **2. 客户要求 AI 助手能回答任意数据问题,你建议让 LLM 直接生成 SQL 吗?** 答题要点:不建议直接对原始库开放。分层说:理想路径是先收敛高频问题为预定义视图和函数接口;确需 Text-to-SQL 时,限定在只读视图范围内、独立只读账号、行级权限在 SQL 层强制(RLS 或条件拼接)、加查询超时和返回行数上限、生成 SQL 先过静态校验。核心观点:权限和性能约束必须放在确定性的代码层,不能依赖模型自觉。 **3. 订单表里有 5% 的金额为 NULL,AI 引用了这张表,你怎么处理?** 答题要点:先查 NULL 的业务含义——是没录入、免费单还是数据丢失,含义不同处理完全不同。技术上:聚合时明确 `SUM` 忽略 NULL 的行为是否符合口径,必要时用 COALESCE 但要写进文档。交付上:在方案的数据风险登记表里记录该字段,接口返回中保留标记,AI 话术对涉及金额的回答加限定语,重要场景给出"以人工核实为准"的降级路径。 ## 本课小结 - FDE 见模型之前先见数据:两小时出数据地图,是入场第一份交付物 - INNER JOIN 会悄悄丢行,客户 360° 从主实体 LEFT JOIN 出发 - "分组取最新"用 CTE + Window Function,企业数据高频套路 - 数据质量按列量化:NULL 率、重复、孤儿外键,写进风险登记表 - 权限过滤放在 SQL/接口层,白名单函数给 Agent,别让模型碰原始库 ## 下一课衔接 数据和接口这层打好了,接下来得让它们跑起来、部署出去。第 4 课《04-git-docker-cloud-Git与Docker与Cloud部署》我们做 Git 工作流与 Docker,把第 2 课的 API 服务和本课的 CRM 查询接口打包成可部署的东西,完成主线项目的第一次上云——Local → Docker → Cloud。届时 `beian_crm.db` 会变成容器里的真数据库。

优秀的个人博客,低调大师

阅读笔记:ExtractBench: A Benchmark for Schema-Guided Enterprise Document Extraction

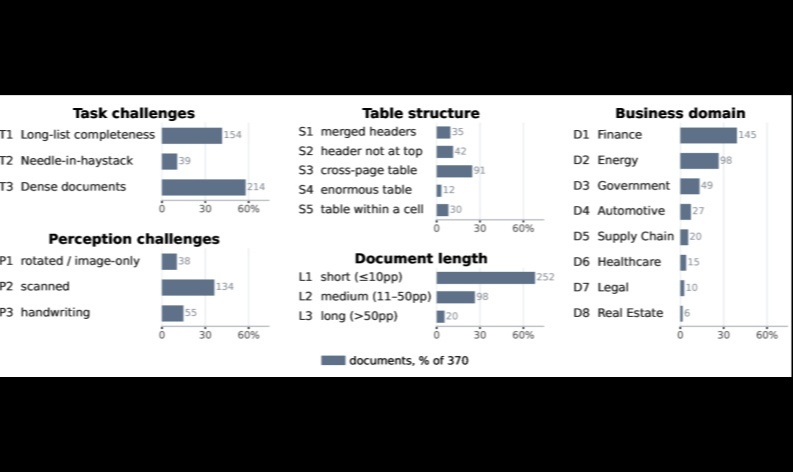
> **资源** > - 论文:https://arxiv.org/abs/2607.29677 > - 代码:https://github.com/run-llama/ExtractBench > - 数据集:https://huggingface.co/datasets/llamaindex/ExtractBench > - 项目主页:n/a ## TL;DR 这篇论文用 **一个五轴挑战标注的 benchmark(370 篇真实/合成企业文档、4869 页、8 领域 67 文档类型)+ value F1 与 word/page-level grounding + 成本的联合评估** 解决了 **schema-guided 企业文档抽取缺乏"广覆盖 + 可溯源 + 可比成本"统一评测** 的问题。核心结论是 **不同系统族在质量-成本前沿上占据截然不同的位置:裸 VLM 便宜(≤1.0¢/page)但 F1 不超 80% 且长文档/巨型表崩塌,coding agent 健壮但 >15¢/page,specialized API(尤其 LlamaExtract Agentic Plus)在最前方(95.6% F1 @ 8.1¢/page)**,且即便最强的 word-level grounding F1 也不到 50%。主要 caveat:**benchmark 由 LlamaIndex 团队构建,而全面领先的 LlamaExtract 正是其自家产品**,利益冲突需打折看。 ## 1. 研究内容 ### 1.1 研究问题、痛点与动机 - **研究问题**:给定一篇文档和一个用户自定义 JSON Schema,抽取系统能否在"值正确且完备 + 每个值能溯源到原文位置 + 单页成本可控"三方面同时达标?形式化即 $f:(\text{document},\ \text{schema}) \longmapsto (\text{structured data},\ \text{evidence})$。 - **痛点**:企业要把金融报表、保险理赔、采购单、政府表单里的结构化数据从文档里抽出来进系统,历史上靠人工录;现有 benchmark 各覆盖一窄条——固定模板的 KIE(SROIE/DocILE/RealKIE)不接受用户自定义 schema,schema-guided 的新基准(ContextualAI ExtractBench / LongArray-Extract / LongExtractBench-50 / VAREX)要么只几十篇、要么只合成单页、要么不评 grounding 也不量成本;于是无法横向比较不同系统族、也无法定位失败到底来自"长列表截断 / 扫描噪声 / 表格错拼 / schema 太大"中的哪一个。 - **动机 / 为什么重要**:企业部署是百万页量级,"每页差一分钱就决定 AI 项目是否划算"(100 万页 × 1¢ = $10,000),且出错代价高、必须有 grounding 让人在环审计;一个能同时量准确率、溯源、成本并按挑战维度切片的 benchmark,直接决定系统能不能上生产。 - **领域定位**:文档智能 / 信息抽取(document IE)的评测方向;上接 OCR 与版面分析,下接 RAG 与企业工作流自动化。 ### 1.2 核心贡献 - **一个挑战标注、广覆盖的 benchmark**:370 篇文档 / 4869 页 / 8 业务领域 / 67 文档类型,每篇沿五个**独立**轴(任务挑战、感知挑战、表格结构、长度、领域)打标签,支持按挑战切片归因失败。 - **一套可扩展的 schema 与 ground truth 构建流水线**:真实文档用前沿模型 ensemble 共识 + 分歧裁决;合成长列表用"数据先于文档"的程序化生成保证 ground truth 精确;扫描表单用人工逐字段核验。不靠纯人工逐字段标注。 - **一次覆盖 14 个前沿系统的广谱评测**:横跨商用 VLM、开源抽取模型、coding agent、specialized API,同时报准确率、grounding、成本与质量-成本权衡。 ### 1.3 相关工作脉络 ```mermaid flowchart LR sroie["SROIEHuang et al., 2019"] --> docile["DocILEŠimsa et al., 2023"] docile --> realkie["RealKIETownsend et al., 2024"] realkie --> extractbench["ExtractBench(本文)LlamaIndex, 2026"] contextual_eb["ContextualAI ExtractBenchFerguson et al., 2026"] --> extractbench longarray["LongArray-ExtractExtend AI, 2026"] --> extractbench longextract50["LongExtractBench-50micro1, 2026"] --> extractbench varex["VAREXBarzelay et al., 2026"] --> extractbench ``` - **关键传承**:固定本体 KIE 线(SROIE → DocILE → RealKIE)逐步从收据/表单扩到多语言、企业域、行项目与长文档,但目标字段始终预设固定,不测"跟随用户新 schema"的能力;schema-guided 线的四 个新基准各压一个维度——ContextualAI ExtractBench 压 schema 复杂度(最多 369 字段但仅 5 个共享 schema)、LongArray-Extract 与 LongExtractBench-50 压长文档行完整性、VAREX 用每文档一 schema 的合成单页表单。本文把这四条线的覆盖面合并到一份 benchmark 里。 - **分歧**:本文是唯一**同时**评长列表完整性、真实扫描与手写、word/page-level grounding、实测成本的基准(Table 1/7);且强调五个独立轴而非单一聚合分,使"低分能追溯到真实成因"。注意:与 Contextual AI 那篇同名 ExtractBench [12] 是不同工作,作者专门加了 footnote 区分。 ## 2. 方法概要 - **方法路线**:系统构建 / 基准评测(benchmark + 评测协议 + 14 系统横评),非理论证明也非单一新模型。 - **关键假设**: - 显式:同一文档类型共享一个 schema;schema 写得足够明确时每个字段有确定性期望值;五个挑战轴互相独立、可正交归因。 - 隐式(读者识别):合成文档虽程序化生成、ground truth 精确,但能代表真实企业文档的视觉变异性;ensemble 共识的 ground truth 接近"真值";用公开牌价重构的成本能反映真实部署开销。 - **数据 / 实验设置**:370 篇文档来自三种来源(真实 born-digital、基于真实版面的合成长列表、真实监管/税表扫描件),其中 38 篇为"扫描退化重捕"(clean 原件的旋转+透视+噪点版本,值不变);14 个系统在相同 document-schema 对上跑、无 benchmark 专属调参,运行于 2026 年 6–7 月;指标为 value F1、word/page-level grounding F1、¢/page 成本(附录 C.2 用 2026-07-01 公开牌价按实测 token/credit 消耗重构)。 - **训练目标**:n/a(benchmark 论文,无训练)。 **整体处理流程**(鸟瞰):评测一篇文档时,系统拿到完整文档 + 用户写的 JSON Schema 作为输入,产出一个 schema-valid 的 JSON 对象,其中每个标量值和每条对齐后的记录子字段都要带上 source page 与 bounding box 作为 evidence。评分端把预测输出与 ground truth 都展平成 cells(一个标量字段、一个对齐后的记录子字段各一个 cell),先做归一化(日期转 ISO、空白压缩、其余精确相等、无数值容差无 LLM judge),再用 Hungarian 算法对数组记录做全局最优一对一配对,逐 cell 按"期望-预测"状态表(Table 9)判 correct/miss,算出 per-document 的 micro precision/recall/F1,slice 与 overall 取 per-document F1 的无权重均值。对带人工核验 box 的字段额外评 grounding:word-level 要求值正确且预测 box 与真值 box 在正确页上 IoU≥0.5,page-level 只要求值正确且给对源页。最后把 F1 与实测 ¢/page 摆到质量-成本前沿图上横评。 ### 2.1 架构图 上图(原文 Figure 2)展示 ground truth 如何由三种来源各自构建:卡片边框颜色标执行者(蓝=抽取模型池、紫=coding-agent 流水线代码、琥珀=人工),绿色填充卡是产出的 ground truth,橙色虚线标修复与分歧裁决回路。三条流水线分别是:真实文档(上条,多系统 ensemble 提议 + 分歧裁决)、合成长列表(中条,数据先于文档的程序化渲染 + ground truth 精确回读)、扫描表单(下条,schema 冻结后 ensemble 投票 + 人工逐字段核验 box)。 ### 2.2 模块详解 - **任务定义模块(输入→输出)**: - 处理流程:1. 输入一篇完整文档(born-digital 或扫描)+ 用户写的 JSON Schema(列字段名、类型、自然语言描述,可含标量、嵌套对象、记录数组、可空字段、值约束);2. 系统按 schema 抽取;3. 输出 schema-valid JSON,每个值带 source page 与 bounding box;4. 文档里没有的字段必须显式返回 null(不能省略键)。 - 设计理由:JSON Schema 是工业界结构化输出的事实标准,"一 schema 覆盖同类型所有文档"贴近企业"为每个新工作流写一个 schema"的真实用法;强制 null 而非省略键,让空字段也被正确计入评分(见 Metrics 模块)。 - 关键参数:schema 由用户而非 benchmark 预设——这正是 schema-guided 与固定本体 KIE 的本质区别。 - **Taxonomy 五轴标注模块(挑战归因)**: - 处理流程:每篇文档被沿五个**独立**轴打标签——任务挑战(T1 长列表完整性 / T2 大海捞针 / T3 密集文档)、感知挑战(P1 旋转或纯图 / P2 扫描 / P3 手写)、表格结构(S1 合并表头 / S2 透视或表头不在顶部 / S3 跨页 / S4 千行以上巨型表 / S5 单元格内嵌套表)、长度(L1 ≤10 页 / L2 11–50 / L3 >50)、业务领域(D1–D8)。 - 设计理由:单一聚合分无法区分"漏了三分之一的行"与"读错一个标签",也无法区分"任务难"与"扫描差";独立轴让低分能追溯到真实成因。表格单列一轴是因为表格会"逐值读对却拼成错误结构",这种失败任务轴和感知轴都隔离不了。 - 关键参数:标签可跨轴重叠(同一文档可同时是 T1 + P2 + S3 + L3 + D1);Figure 1 给出各标签在 370 篇中的占比。 - **Ground truth 三流水线模块(按来源分工)**: - 真实文档(ensemble 共识):1. 从样本文档起草 schema(字段描述带别名、格式要求、位置提示、勿混指引);2. 跑多个**不同模型/流水线家族**的抽取系统(同家族共享错误,故刻意跨家族);3. 所有系统一致同意的值(含空字段的 null)成为候选 ground truth;4. 分歧按成因分类——若多种读法都站得住脚说明 schema 有歧义,就收紧描述直到重跑收敛,若只有一种读法站得住脚就是模型失败,由审查者对照页面裁定。设计理由:单系统输出做 ground truth 会重复其错误并偏向该系统。 - 合成长列表(精确构造):1. 选一个真实长列表版面(基金附表、持仓登记、债权人矩阵);2. **数据先于文档**——先产出记录(逐字解析或按真实风格生成),再让 coding agent 研究版面字体/列宽/页眉写出渲染代码;3. 渲染成贴近真实的 PDF,按实测尺寸分页(而非固定行数/页,否则产生假分页与错误源页标签);4. 因为值在 PDF 存在前就已知,页码与 word-level box 从渲染结果回读,ground truth 无论列表多长都精确;5. 机械检查捕风格不匹配与裁剪,再由抽取系统池审计完工文档暴露渲染 bug。设计理由:数千条相似记录人工标太慢太易错,"先造数据再造文档"让 ground truth 生而可信、无需人工标值。 - 扫描表单(人工核验):1. schema 对照空白模板起草并在标注前冻结(之后改动需版本号 + 定向复审);2. 最多五个系统 ensemble 对每个 schema 叶节点投票,争议叶节点交给必须先看页面才裁决的 adjudication agent;3. 由单一 citation 管线提议每字段 box(box 永不跨系统合并);4. 人工标注者对每字段 accept/edit/null/redraw。产出 169 篇人工核验文档,84% 核验字段带人工放置的 box(其余多为空字段,页面无物可框)。 - 设计理由:三种来源各有短板,按各自最合适的方法标注——真实文档给版面/扫描噪声/领域跨度但逐字段画框太慢,合成覆盖太大无法手标,扫描件必须由人判断手写与介于两字段间的标记。退化扫描重捕不需新标注(值不变,clean 的 ground truth 直接沿用)。 - **Metrics 模块(value F1 + grounding)**: - value F1 评分流程:1. 预测与 ground truth 各展平成 cells;2. 归一化(8 种日期格式转 ISO、空白折叠、其余精确相等、无数值容差无 LLM judge);3. 数组用 Hungarian 算法做全局最优一对一配对(代价=不匹配子字段数,最小化总代价等价于最大化字段一致;完全匹配的行用 hash join 预配对作加速快路径);4. 按 Table 9 状态表逐 cell 判定——值匹配值=correct(计入 P 和 R)、值→null=两边 miss、null→null=correct、null→值=两边 miss(hallucination)、记录少了=缺记录 cell 仅计 R miss、记录多了=多余记录 cell 仅计 P miss;5. per-document 算 micro P/R/F1,slice 与 overall 取 per-document F1 无权重均值(文档字段多不加大权重)。 - 设计理由:数组用 Hungarian 对齐而非按位置,是因为记录顺序不应影响值分;显式 null 计入两侧分母,让"诚实返回 null"不被惩罚、让"空字段上幻觉"同时扣 P 和 R;只有重复记录会把 P 和 R 拆开,所以 P-R 差直接诊断"截断 vs 多余记录"。 - grounding:仅对带人工核验 box 的字段评;word-level 要求值正确且预测 box 与真值 box 在正确页 IoU≥0.5,page-level 只要求值正确且给对源页;grounding 的 P 分母只计可评分 claim、R 分母只计带核验 box 的 ground truth cell、无核验 box 的文档不产生 grounding 分(而非记零)。 - 关键约束:每篇文档上恒有 value F1 ≥ page F1 ≥ word-level grounding F1(前者是后者的门控)。 ### 2.3 算法 / 伪代码 原文无 Algorithm 伪代码框;评分是**完全确定性**的("the same predictions and ground truth always produce the same same score, with no model in the loop"),核心规则在 §2.4 与附录 B。其算法性流程已在 2.2 Metrics 模块中逐步说明(cell 展平 → 归一化 → Hungarian 对齐 → 状态表判定 → micro P/R/F1 → 无权重均值),附录 B.1–B.4 给出精确匹配规则、缺失值语义(Table 9)、数组对齐细节与聚合/grounding 门控定义,可直接复现,无需伪代码框。 ## 3. 关键结果 - **主要发现**: - 系统 族在质量-成本前沿上占据截然不同的区域——裸 VLM(GPT-5.4 Nano、Gemini 3.5 Flash 及四个自托管 OSS)占低成本端(≤1.0¢/page)但 F1 都不超 80%;coding agent(Claude Code Opus 4.8、Codex GPT-5.5)达 87–94% F1 但 >15¢/page;specialized API 跨度最大,LlamaExtract 三档描绘前沿。 - 长文档是裸 VLM 的死穴:Gemini 3.5 Flash 从短文档 87.9% 暴跌到长文档 27.9%,多数 VLM 长文档 15¢/page);LlamaExtract 三档沿前沿排列,Agentic Plus(95.6% @ 8.1¢/page)在最右上方、质价比同时压住两个 coding agent。 上图(原文 Figure 7)把 GPT/Gemini/Claude 三家族的 basic/medium/flagship 三档连成线:只有 GPT 质量随成本单调上升,Gemini 与 Claude 都非单调——说明"换更大的模型"不必然换来更好的文档抽取,最佳工作点取决于成本-质量权衡而非模型层级。 下表重现 Table 2 的关键切片(Overall + 长度 + 任务挑战 + 巨型表 S4),系统列选 8 个代表(完整 14 系统见原文 Table 2): | 系统(族) | Overall | L1 短 | L2 中 | L3 长 | T1 长列表 | T2 大海捞针 | T3 密集 | S4 巨型表 | |------|------|------|------|------|------|------|------|------| | LE Agentic Plus(specialized) | **95.6** | **96.6** | **93.3** | **94.4** | **96.1** | 93.6 | **95.5** | **95.9** | | LE Cost-Effective(specialized) | 86.8 | 90.8 | 80.1 | 69.2 | 81.8 | 82.3 | 90.5 | 67.8 | | Reducto Deep Extract(specialized) | 90.4 | 94.2 | 80.5 | 92.0 | 94.8 | 92.5 | 87.5 | 95.3 | | Codex GPT-5.5(coding agent) | 93.6 | 95.7 | 91.2 | 78.9 | 91.7 | 91.7 | 95.4 | 78.9 | | CC Opus 4.8(coding agent) | 87.1 | 90.1 | 79.2 | 88.1 | 93.6 | 89.1 | 82.4 | 87.8 | | GPT-5.4 Nano(VLM) | 74.9 | 77.4 | 76.4 | 35.8 | 72.2 | 74.0 | 76.4 | 7.2 | | Gemini 3.5 Flash(VLM) | 79.8 | 87.9 | 69.8 | 27.9 | 78.8 | **87.9** | 80.5 | 1.5 | | Qwen3.6 35B-A3B(OSS VLM) | 87.3 | 93.1 | 84.8 | 26.8 | 79.0 | 85.3 | 93.1 | 1.3 | (数值为 unified value F1 %,取自原文 Table 2;加粗为该行最高。完整 14 系统 × 全维度见原文 Table 2,子标签细拆见 Table 14。) 下表重现 Table 3 的 grounding 结果(完整): | 系统 | word-level F1(Overall) | word-level F1(长文档) | page-level F1(Overall) | page-level F1(长文档) | |------|------|------|------|------| | LE Agentic Plus | **46.4** | 54.7 | **84.9** | **87.1** | | LE Agentic | 44.1 | 45.7 | 66.1 | 67.6 | | LE Cost-Effective | 40.4 | 36.7 | 64.2 | 56.5 | | Datalab A+B | 2.0 | 0.0 | 48.5 | 0.0 | | Extend Max Context | 25.1 | 0.0 | 48.9 | 0.0 | | Reducto Deep Extract | 43.3 | 41.1 | 71.7 | 67.3 | | 所有其余系统 | 0.0 | 0.0 | 0.0 | 0.0 | (% ,取自原文 Table 3;VLM 与 coding agent 默认不返回 evidence 故全零。) - **重点解读**: - 质量-成本前沿图:LlamaExtract Agentic Plus 在右上角"同时"比两个 coding agent 质量更高(95.6 vs 93.6/87.1)、成本更低(8.1 vs 27.8/16.2 ¢/page),是全文最核心的单点结论;但这也是利益冲突最刺眼之处(见 §4.1)。 - Table 2 长度切片:裸 VLM 在 L3 长文档上的崩塌(Gemini 27.9、GPT-5.4 Nano 35.8、Qwen3.6 26.8、Gemma4 12.2、NuExtract3 8.9)是系统性而非个例;Reducto(92.0)与 Claude Code Opus 4.8(88.1)在长文档上反常地稳——前者是 specialized API 的长文档策略,后者是 coding agent 的迭代工具循环。 - Table 2 的 S4 巨型表:所有 VLM 作者:lusca > 版本:lusca-paper-read v1.10.3 > 出处:https://github.com/yjmm10/lusca-skill/tree/main/skills/lusca-paper-read

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册