首页 文章 精选 留言 我的

精选列表

搜索[离线容错],共8789篇文章
优秀的个人博客,低调大师

如何离线安装所有依赖包

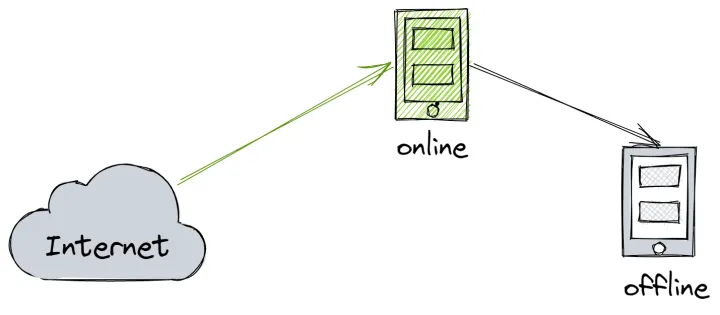
当我们在一个没有公网的环境下去部署一些东西的时候往往是让人很头疼的一件事,因为可能会需要各种依赖包,依赖包本身也还有很多依赖关系。如果没有一次性把全部的依赖包打包下载好,我们下载的过程就能体会到什么叫俄罗斯套娃。。 一、os依赖包 1、准备一台与生产部署环境内核版本基本一致的镜像,安装mini install版作为本地环境 # cat /proc/version Linux version 3.10.0-693.el7.x86_64 (builder@kbuilder.dev.centos.org) (gcc version 4.8.5 20150623 (Red Hat 4.8.5-16) (GCC) ) #1 SMP Tue Aug 22 21:09:27 UTC 2017 2、配置好本地环境的yum源、保证可通公网,一般都可以配置阿里的yum源即可 # cd /etc/yum.repos.d/ # mkdir bak # mv ./*repo bak # curl -o /etc/yum.repos.d/CentOS-Base.repo http://mirrors.aliyun.com/repo/Centos-7.repo # yum clean all # yum makecache 3、通过yum将所需要的依赖包全部下载至本地目录 # yum install --downloadonly --downloaddir= <target_dir> <package-name> 备注:为保证生产部署环境可以部署自己的本地yum源,我们需要额外的去下载好 createrepo # yum install --downloadonly --downloaddir=/myrpm createrepo 4、打包以上所有需要的依赖包到生产部署环境,搭建本地yum源 1)通过rpm手动安装createrepo 根据提示安装所需依赖包即可 # rpm -ihv createrepo-0.9.9-28.el7.noarch.rpm 2)搭建本地yum源 #创建本地rpm包repodata的索引目录 # createrepo /myrpm/ Spawning worker 0 with 197 pkgs Spawning worker 1 with 197 pkgs Workers Finished Saving Primary metadata Saving file lists metadata Saving other metadata Generating sqlite DBs Sqlite DBs complete #若后续有更新其他依赖包,不需要重建,只需要update一下索引目录就好 # createrepo --update /myrpm/ Saving Primary metadata Saving file lists metadata Saving other metadata Generating sqlite DBs Sqlite DBs complete #配置yum源配置文件 # cd /etc/yum.repos.d/ # mkdir bak # mv ./*repo bak # cat local_yum.repo [local_yum] name=local_yum baseurl=file:///myrpm gpgcheck=0 enabled=1 priority=1 #清除yum缓存 yum clean all 5、通过本地yum源部署安装 yum install <package-name> 二、python库安装 1、下载python依赖包要关注两者环境的python、pip版本一致 # /app/python/bin/virtualenv /clean_env New python executable in /clean_env/bin/python2.7 Not overwriting existing python script /clean_env/bin/python (you must use /clean_env/bin/python2.7) Installing setuptools, pip, wheel...done. # source /clean_env/bin/activate (clean_env) # python --version Python 2.7.9 (clean_env) # pip --version pip 20.2b1 from /clean_env/lib/python2.7/site-packages/pip (python 2.7) 2、本地环境下载所需要的库及其依赖包 #requirements.txt文件下是我们需要安装的所有库 (clean_env) # pip download -d <target-dir> --trusted-host mirrors.aliyun.com -r requirements.txt or (clean_env) # pip download -d <target-dir> --trusted-host mirrors.aliyun.com <package-name> 3、将所有python包打包上传至生产部署环境 4、生产环境指定package目录安装库 # pip install --no-index --find-links=/root/python20/opsinsight/ -r requirements.txt or # pip install --no-index --find-links=/root/python20/opsinsight/ <package-name>

优秀的个人博客,低调大师

React Native 离线包/图片资源

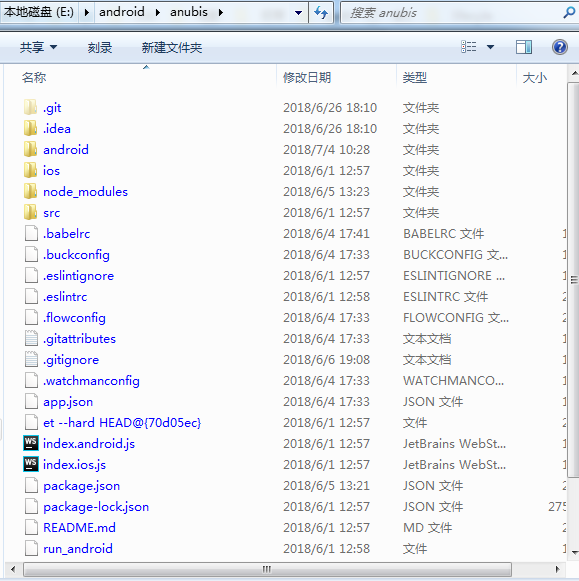
1). 打包 进入项目根目录(如图1,anubis为项目名)执行命令 react-native bundle --platform android --dev false --entry-file index.android.js --bundle-output android/app/src/main/assets/index.android.bundle --assets-dest android/app/src/main/assets/ 图1.png 注:打包时一定要确保"android/app/src/main/路径下存在assets文件夹,如果不存在,创建即可 2). 打包文件 进入"android/app/src/main/assets/"全部打包 图2.png 并将压缩包推送到手机内存卡中, 并在手机中解压 adb push bundle.zip /mnt/sdcard/ 其中bundle.zip文件在桌面,"/mnt/sdcard/"是手机内存卡路径 图3.png 3). 打包App 修改app/build.gradle文件 project.ext.react = [ // false: 不将index.android.bundle文件打包进assets文件夹 // true: 将index.android.bundle文件打包进assets文件夹 bundleInDebug: false, bundleInUat : false, bundleInRelease: true ] 直接使用Android Studio运行项目, 即可成功出现app界面

优秀的个人博客,低调大师

数据库故障容错之系统时钟故障

本文通过对CnosDB数据库系统时钟故障的讨论,提出了在单机环境和集群环境中解决系统时钟故障的方案,具有非常重要的指导意义。 可能并不存在的情况引发的讨论 有一天,CnosDB实习生小邵在做时间乱序数据处理逻辑的设计,时序数据的产生一般有以下几个规律可以遵循: 1. 一般情况下,时序数据由一条条时间线组成,每一条时间线背后都是一个独立的数据源。 2. 时序数据的产生往往是实时的,时间线上的数据也是按照时间顺序排列的,大多数时序数据库的底层数据存储设计也基于此。 3. 在一些特殊的情况下,一条时间线上的时间顺序可能会被破坏,一段时间之前的数据可能现在才到达数据库;由于处理起来太过麻烦,一些数据库会拒绝这种数据写入。 问题出在“一些特殊的情况上”,小邵异想天开地提出了一个我没有想到过的可能情况: 1. 如果客户端发来的数据是没有时间戳的,那么数据的时间戳由数据库服务端的系统时间戳决定。 2. 如果数据库服务端的系统时钟发生了修改,比如本来是5点,调成了3点,就会出现时间乱序数据。 不得不说,这是比“一些特殊的情况”还要特殊的情况,而比较典型的时间乱序数据场景是这样的;一个远程设备不断向数据库端发送自带时间戳的数据,可能有两种情况出现: 1. 网络方面的故障,导致从设备发来的数据,并没有按照数据发出的时间到达。 2. 设备发出的数据在到达数据库前丢失或损坏了,设备在之后的时间里将这些数据重新发给数据库。 经过了一段时间的思考,我发现小邵说的那种情况,不应该放在时间乱序数据的问题里讨论,而是一个需要单独处理的问题。 系统时钟故障 相比于掉电宕机、网络故障等常见又严重的故障,系统时钟发生变化的情况其实很少被考虑到,一般主要影响的也都是日志时间戳之类,不会直接影响到用户的部分。 近年来,由于NewSQL的概念普及,许多分布式数据库选择依赖系统时钟与NTP实现混合逻辑时钟,这时系统时钟故障可能才真正被广泛讨论。不过,CnosDB是个典型的原生时序数据库,不是那种拼接改造的数据库项目,并不支持事务,所以在这里并不是讨论混合逻辑时钟的问题。 定义 在具体讨论之前,先给系统时钟故障一个明确的定义:指由于恶意攻击、用户误操作等原因,导致数据库部署环境的系统时钟突然发生跨度较大的变化,比如前一秒系统时钟为17:00,下一秒变成了3:19。 由于从数据库的角度无法确认这种变化是否正确、是否符合用户的预期,所以将这种变化视为故障。 集群中的情况 单机下的情况比较简单,就是上文中的定义情况,而集群中的情况可以大致分为三种: 1. 只有少数节点的系统时钟发生变化。 2. 超过半数节点的系统时钟发生变化。 3. 所有节点同步切换到新的、相同的系统时钟。 对时序数据库的影响 就像上文中小邵所说的“特殊情况”,系统时钟故障会影响没有自带时间戳的数据,其背后是时序数据库对这类数据处理的策略: 1. 要求用户写入的所有数据都必须自带时间戳。 2. 对于没有时间戳的数据,自动添加客户端的系统时间戳。 3. 对于没有时间戳的数据,自动添加数据库服务端的系统时间戳。 据我观察,目前策略三应该是比较主流的方案,所以一个时序数据库最好还是要考虑如何处理系统时钟故障。否则,一旦出现问题,就会有大量“时间戳异常”的数据写入到数据库中,影响到数据库的性能还是小事,出现了用户角度的“脏”数据就是大麻烦了。 故障的处理 根据既往的经验和知识,一个足够健壮的系统,在处理故障时需要依循以下四个原则: 1. Fail-Fast:能够第一时间发现故障的产生。 2. Fail-Safe:尽将故障的影响范围控制在最小。 3. Fail-Over:在发生故障时能够进行主备切换,由没有发生故障的备份/备用节点继续提供服务。 4. Fail-Back:在主副本/主节点从故障状态恢复到正常状态之后,可以切回到主副本/主节点提供服务。 基于这样的原则,针对单机和集群两种情况,做出了以下设计。 单机:发现故障然后服务降级 在单机的环境中,系统发现故障之后,需要做以下的操作: 1. 周期性获取当前系统时间戳,并与上一次获取到的值对比,如果两者的偏差超过了容忍阈值,判定为出现了时钟故障。 2. 用户可以通过查看系统表中的某项,查看当前CnosDB节点是否处于时钟故障状态,此状态不会因CnosDB进程的重启而变化。 3. 出现故障后,只允许用户自行指定时间戳的数据写入,拒绝未指定时间戳的数据写入。 4. 用户可以通过使用管理员权限执行一条命令,解除当前CnosDB节点的时钟故障状态。 我们在处理单机故障时,可以用以下的用户接口设计去定义: 统一的命名规则 clock_fault_XX 系统变量/参数 1. clock_fault_check_interval a. 获取系统时间戳并进行检查的时间间隔。 b. 默认值5min,可在线变更。 2. clock_fault_last_timestamp a. 最后一次获取到的系统时间戳。 b. 只读。 3. clock_fault_check_threshold a. 时钟故障的触发阈值。 b. 当前系统实际时间戳与clock_fault_last_timestamp + clock_fault_check_interval的差值超过此阈值时,当前CnosDB节点切换为时钟故障状态。 c. 默认值为1h,可在线变更。 4. clock_fault_state a. 当前CnosDB节点是否处于时钟故障状态 b. 处于时钟故障状态,此值为error;反之,为normal。 c. CnosDB将此值设置为error时,需要同时在日志中进行记录。 d. 可在线变更,但只能由CnosDB管理员手动设置为normal,代表CnosDB管理员对目前的情况已经完全掌握并进行了相应的处理。 系统时间线 clock_fault_timestamp:记录每次进行检查时获取的系统时间戳,用户可以通过查看此时间线来判断时钟故障发生的具体时间点。 集群:复杂的故障发现与主备切换机制 在集群环境中,因为多节点的原因,处理的过程相对于单机的机制会更加的复杂,那么也有以下的相应操作: 1. 以每个CnosDB节点的单节点故障处理为基础。 2. 当一个节点处于时钟故障状态时,未指定时间戳的数据写入将自动路由到其他节点进行执行。 3. 定期检查集群所有节点的系统时钟: a. N为当前集群内的主机(物理机、虚拟机或容器)总数量, μ为集群内全部主机某个子集,μ包含的主机数量超过N/2。 b. 如果存在一个μ在两个节点间的系统时间戳差值不超过一个预先设定的阈值,这个μ就可以称为时钟基准主机组。 c. 时钟基准主机组应尽可能包含更多主机。 d. 如果部署在时钟基准主机组中的所有节点都没有处于时钟故障状态,这些节点的集合就可以成为时钟基准节点组。 e. 当集群中无法找出一个时钟基准节点组时,整个集群将被判定为处于时钟异常状态。 f. 只有当集群中可以找到时钟基准节点组时,CnosDB集群管理员才可以将集群解除时钟异常状态。 g. 当某一节点的系统时钟与时钟基准主机组中一个节点的系统时钟的差值超过了一个预先设定的阈值,集群会将该节点的clock_fault_state设置为error(通过集群内部的一个账号,一般用户无法进行这样的操作)。 我们在处理集群故障时,可以用以下的用户接口设计去定义: 统一的命名规则 cluster_clock_fault_XX 系统变量/参数 1. cluster_clock_fault_check_interval a. 集群范围内进行clock_fault_check的时间间隔。 b. 默认值5min,可在线变更。 2. cluster_clock_fault_check_threshold a. 用于判定时钟基准节点是否存在的阈值。 b. 默认值为10s,可在线变更。 3. cluster_clock_fault_state a. 当前CnosDB集群处于时钟故障状态时,此值为error;反之,为normal。 b. CnosDB将此值设置为error时,需要同时在日志中进行记录。 c. 可在线变更,但只能由CnosDB管理员手动设置为normal,代表CnosDB管理员对目前的情况已经完全掌握并进行了相应的处理。 系统时间线 1. cluster_clock_fault_base_clock_node_list:记录当前基准时钟节点组包含的节点列表。 2. cluster_clock_fault_base_clock_host_list:记录当前基准时钟主机组包含的节点列表。 结语 尽管系统时钟故障并不是一个时序数据库首要去考虑如何处理的故障,对于集群层面的时钟故障检测与处理,可能也不需要直接放在时序数据库这一层来实现,但这个思考和做大体设计的过程还是很有趣的,于是决定分享给大家。 如果大家有真实遇到这种问题的案例,可以告诉我们,这样本文中的设计会考虑得更加严谨,也会更快地在CnosDB中落地。 参与 CnosDB 社区交流群: 扫描下方二维码,加入 CC 进入 CnosDB 社区进入社区交流,CC 也会在群内分享直播链接哒

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册