首页 文章 精选 留言 我的

精选列表

搜索[离线容错],共8789篇文章
优秀的个人博客,低调大师

即使是苹果也不能让物联网容错

如果你想和朋友们开始一个绝对令人兴奋的餐桌对话,可以试试询问他们正在使用什么互联网平台。毫不奇怪,没有多少人知道IoT是什么意思,更不用说他们的小工具下面发生了什么。他们所关心的是他们是否在一起工作 - 大多数时候他们没有。 苹果公司的HomeKit被推出,最终将家庭中所有可怕但稍微有用的互联网小工具汇集在一起。苹果不是处理不同公司推出的一系列不同的标准,而是提出了一个新的智能家居配件生态系统,可以安全地建立一系列共同的要求。然后,苹果公司将在Siri中显示每个设备,或者最终在iOS设备上的自己的家庭应用中。 这是事情,虽然:结果并不是一个“聪明”的家庭应该是什么样的逻辑演变。 作为Shit帐户互联网背后的讽刺意识的人,我拥有一大堆互联网连接的设备 - 尽管我憎恶他们。起初,当我开始时,我会尝试购买HomeKit兼容的,以使生活更轻松,但最终却很少。 在使用Apple的Home应用程序的几分钟之内,这些特性变得明显。想自动化任何东西或远程控制您的设备?更好地出去买苹果电视! 惊喜!更好的在家里有一个苹果电视或iPad。苹果 由于许多原因,这是很疯狂的,这在很大程度上是因为包括我在内的数百万人有一个机场路由器躺在那里更适合工作。其他家庭设备制造商,如三星的SmartThings,拥有“中枢”设备,以合理的价格照顾所有这些设备 - 为苹果电视花费额外的149美元是不合理的。或者,苹果建议使用iPad(起价329美元)作为家庭中心,但必须始终是“在家中连接到家庭Wi-Fi网络并启动”。这真的是我们承诺的后PC电脑吗? 家庭应用苹果 在Apple Home应用程序中设置完所有设备后,事情会变得更加困难。我受到一个应用程序的承诺,被诱导到HomeKit,在一定程度上统治了它们 - 但是家庭应用程序可以让您的所有灯泡,湿度传感器,温度传感器以及其他任何连接的数量相同在接口中的优先级。在添加了恒温器,锁,一些灯泡,门铃,传感器以及安全摄像头后,Home应用程序会显示一堆尺寸和形状相同的按钮,其中一些是可操作的和其他的这只是告诉你它现在有70%的湿度。默认的家庭应用程序,预先安装在每个iPhone上,最终是无用的海图标,难以浏览或搜索 - 没有办法隐藏设备,甚至无用的项目,如飞利浦色相桥,只做连接你的小部件到互联网,显示为一个按钮。有第三方应用程序的替代方案可以利用下面的标准,但是它们在Apple允许他们做的很有限。 HomeKit本身虽然在理论上是一个好主意,却被苹果当成中年技术之父所玷污。它完全忽略了新兴的云技术 - 例如,您不能将任何设备逻辑存储在云中 - 而是宁愿从自己的硅谷泡沫决定什么是智能家居应该是什么样的,迫使设备制造商在处理。我们的设备背后的公司大小不等,必须使硬件更改被接受到HomeKit,必须添加只能从苹果公司获得的认证芯片,必须选择苹果批准的制造商,必须发送免费样品进行认证,而且不得谈论认证,同时希望他们不要破产,等待整个过程完成。 以下是HomeKit创建的沮丧的例子:几年前我购买了飞利浦色相,并通过飞利浦提供的应用程序乐意使用它们。但是如果我想让他们与HomeKit和Home应用程序一起工作,那么我需要出门购买一个升级后的$ 59.99的桥梁与苹果的特殊芯片,只是为了让他们说话 - 通常可以通过软件升级完成一个变化。其他现有设备也是如此。如果没有通过HomeKit的支持,您将不得不以自己的代价来替换它,以便稍后实现。使用Google首页,我所要做的只是配对我现有的Hue桥,并且立即以我的声音工作 - 没有奇怪的命名或特定的短语,如“Siri,关闭Office Lights 2”。 我必须承认,这个严格程度是一个积极因素:苹果公司批准的HomeKit设备可能是遭受IoT灾难的最不可能的,像是着名地夺取了数百万台相机的未来僵尸网络。对于许多物联网制造商及其客户来说,他们正在考虑的最后一件事就是安全性,正如我们所看到的那样。令我感到沮丧的是,HomeKit忽略了以前为实现物联网而做的所有工作,使成千上万的有用产品不兼容。因为HomeKit旨在成为iPhone用户的IoT设备的安全全面的平台,所以苹果将不会包含其他标准,因为他们的定义是愚蠢和不安全的。这迫使你,你的家人,家里的客人和你家里的任何人长期承诺一个电话平台 - 这是一个不合理的问题。 HomeKit只能优势iOS用户,而不是数十亿的其他设备用户。如果您 - 或您家中的某人 - 从iOS切换到Android,您可能会发现自己需要一天更换智能家居。排除任何其他平台令人难以置信的“苹果”,与公司如何处理iMessage,AirPlay,FaceTime和其他技术类似的态度。但是当你在谈论这个家庭时,这是一个远远超过与你的运营商签订两年合同的承诺,生态系统锁定是一个巨大的问题。 HomeKit还要求您为每个设备使用痛苦的具体名称,这可能意味着它根本不起作用大部分时间,您必须记住尴尬的命名方案才能使其正常工作。在这方面,家庭和Alexa在语言上更加灵活。例如,您可以参考“灯光”,命令将正常工作。 声音是来自亚马逊和智能家居的谷歌真正闪耀的地方:您可以在不依赖智能手机的情况下控制家庭设备。苹果不能(但是)期望每个男人,女人和孩子在家里随时都有一个iPhone或iPad。具有内置麦克风功能的Amazon Echo或Google Home扬声器作为您的智能家居界面变得更加有意义,因为它可以让您以更自然的方式与家人进行互动。亚马逊正在积极推广:亚历克萨斯现在正在整合到厨房电器,扬声器,灯具,电视机和摄像机(甚至汽车)中,这显着降低了使您家中每个房间的智慧的障碍。你可以在你的冰箱里大声说话 - 尽管这太可笑了,可以静音或关掉灯光。 我希望HomeKit会做的是“只是工作”与广泛的认证设备。但苹果公司对该计划的追捧意味着自HomeKit宣布以来的三年中进展缓慢。而且你永远也不会看到像Alexa或Home这样的语音系统的支持,所以你永远坚持Siri,希望来自苹果的回声式设备的传言有一天会有成果。 很快,您将选择您的智能家居 - 像我这样做 - 基于下面的平台,将您锁定到一个肮脏的公司选择的一堆设备。而如果你把自己的赌注放在HomeKit上,那么在一个发展得比苹果公司快的市场上,你将会长期坚持下去。苹果的消费者锁定是其利润率的一个聪明的,但不是为了你或你的家庭。 本文转自d1net(转载)

优秀的个人博客,低调大师

浏览器插件-离线英汉词典

如前文在浏览器插件中读取JSON资源文件末所述, 用浏览器插件实现了不依赖任何在线翻译服务的英汉词典. 由于词典包含77万个词条, 插件大小也达到了13+MB. 词典数据也包含很多常见短语: 源码库: program-in-chinese/webextension_english_chinese_dictionary 在火狐插件网站提交审核时, 发现源文件大小有限制, 超过4MB就不能被审核服务自动分析. 于是按每个词典文件五万词条进行分隔(详见转换到JSON; 按五万行分隔json · program-in-chinese/english-chinese-dictionary@10b55f6) 插件源码主要是导入词典数据和查询/显示两部分: 加载词典.js const 词典路径 = '词典数据/词典' const 文件扩展 = '.json' var 词典文件 = {}; for (var 文件序号 = 0; 文件序号 < 16; 文件序号++) { 词典文件[文件序号] = false; } var 词典数据 = {}; function 载入部分词典(文件) { return function () { var 文件路径 = 词典路径 + 文件 + 文件扩展; fetch(chrome.runtime.getURL(文件路径)) .then((响应) => 响应.json()) .then((数据) => { for (var 英文 in 数据) { 词典数据[英文] = 数据[英文]; } 词典文件[文件] = true; }); } } for (var 文件 in 词典文件) { 载入部分词典(文件)(); } function 已载入词典() { for (var 文件 in 词典文件) { if (!词典文件[文件]) { return false; } } return true; } function 取释义(选中文本) { var 释义 = 词典数据[选中文本]; if (!释义) { 选中文本 = 选中文本.toLowerCase(); 释义 = 词典数据[选中文本]; } return 释义; } 主界面.js function 翻译选中文本() { chrome.tabs.executeScript({ code: "window.getSelection().toString();" }, function (选中内容) { // TODO: 如果没有toString, 报错: -,.toLowerCase is not function var 选中文本 = 选中内容.toString(); if (!选中文本) { 置弹窗内容("无选中文本"); return; } var 词典接口 = chrome.extension.getBackgroundPage(); if (!词典接口.已载入词典()) { 置弹窗内容("载入词典数据中..."); return; } var 释义 = 词典接口.取释义(选中文本); 置弹窗内容(选中文本, 释义); }); } function 置弹窗内容(英文, 释义) { var 窗体 = document.body; var 英文部分 = document.getElementById("英文"); var 释义部分 = document.getElementById("释义"); 英文部分.appendChild(document.createTextNode(英文)); var 多行 = 释义.split('\\n'); for (var 行数 in 多行) { 释义部分.appendChild(document.createTextNode(多行[行数])); 释义部分.appendChild(document.createElement("br")); } } 翻译选中文本(); 另, 已在Chrome插件商店发布. 链接如下: 火狐插件 Chrome插件 2018-10-12

优秀的个人博客,低调大师

Spark2.2.0 分布式离线搭建

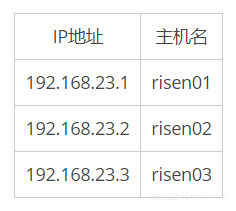
1、Spark简介 Apache Spark 是专为大规模数据处理而设计的快速通用的计算引擎。Spark是UC Berkeley AMP lab (加州大学伯克利分校的AMP实验室)所开源的类Hadoop MapReduce的通用并行框架,Spark,拥有Hadoop MapReduce所具有的优点;但不同于MapReduce的是——Job中间输出结果可以保存在内存中,从而不再需要读写HDFS,因此Spark能更好地适用于数据挖掘与机器学习等需要迭代的MapReduce的算法。 Spark 是一种与 Hadoop 相似的开源集群计算环境,但是两者之间还存在一些不同之处,这些有用的不同之处使 Spark 在某些工作负载方面表现得更加优越,换句话说,Spark 启用了内存分布数据集,除了能够提供交互式查询外,它还可以优化迭代工作负载。 Spark 是在 Scala 语言中实现的,它将 Scala 用作其应用程序框架。与 Hadoop 不同,Spark 和 Scala 能够紧密集成,其中的 Scala 可以像操作本地集合对象一样轻松地操作分布式数据集。 尽管创建 Spark 是为了支持分布式数据集上的迭代作业,但是实际上它是对 Hadoop 的补充,可以在 Hadoop 文件系统中并行运行。通过名为 Mesos 的第三方集群框架可以支持此行为。Spark 由加州大学伯克利分校 AMP 实验室 (Algorithms, Machines, and People Lab) 开发,可用来构建大型的、低延迟的数据分析应用程序。 2、部署准备 2.1、安装包准备 spark-2.2.0-bin-hadoop2.6.tgz jdk-8u161-linux-x64.tar.gz scala-2.11.0.tgz 2.2、节点配置信息2.3、节点资源配置信息3、集群配置与启动 3.1、安装包上传与解压 操作节点:risen01 操作用户:root 上传安装包spark-2.2.0-bin-hadoop2.6.tgz,scala-2.11.0.tgz,jdk-8u161-linux-x64.tar.gz(如果已经存在则不需要此步骤)到 risen01节点下的~/packages目录下,结果如图所示: 2、解压JDK安装包,Spark安装包Scala安装包和到/usr/local下 操作节点:risen01 操作用户:root 解压JDK命令: tar -zxvf ~/packeages/jdk-8u161-linux-x64.tar.gz -C /usr/local 解压spark命令: tar -zxvf ~/packages/spark-2.2.0-bin-hadoop2.6.tgz -C /usr/local 解压Scala命令: tar -zxvf ~/packages/scala-2.11.0.tgz -C /usr/local 3.2、启动前准备 操作节点:risen01,risen02,risen03 操作用户:root 在/data目录下新建立spark/work目录用来存放spark的任务处理日志 在/log目录下新建立spark目录用来存放spark的启动日志等 3.3、修改配置文件 3.3.1、编辑spark-env.sh文件 操作节点:risen01 操作用户:root 说明:请根据实际集群的规模和硬件条件来配置每一项参数 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/conf目录下执行命令: cp spark-env.sh.template spark-env.sh 编辑spark-env.sh文件,添加以下内容: #设置spark的web访问端口 SPARK_MASTER_WEBUI_PORT=18080 #设置spark的任务处理日志存放目录 SPARK_WORKER_DIR=/data/spark/work #设置spark每个worker上面的核数 SPARK_WORKER_CORES=2 #设置spark每个worker的内存 SPARK_WORKER_MEMORY=1g #设置spark的启动日志等目录 SPARK_LOG_DIR=/log/spark #指定spark需要的JDK目录 export JAVA_HOME=/usr/local/jdk1.8.0_161 #指定spark需要的Scala目录 export SCALA_HOME=/usr/local/scala-2.11.0 #指定Hadoop的安装目录 export HADOOP_HOME=/opt/cloudera/parcels/CDH/lib/hadoop #指定Hadoop的配置目录 export HADOOP_CONF_DIR=/opt/cloudera/parcels/CDH/lib/hadoop/etc/hadoop/ #实现spark-standlone HA(因为我们HA实现的是risen01和risen02之间的切换不涉及risen03,所以这段配置risen03可有可无) export SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=risen01:2181,risen02:2181,risen03:2181 -Dspark.deploy.zookeeper.dir=/data/spark" 3.3.2、 编辑spark-defaults.conf文件 操作节点:risen01 操作用户:root 说明:请根据实际集群的规模和硬件条件来配置每一项参数 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/conf目录下执行命令: cp spark-defaults.conf.template spark-defaults.conf 编辑spark-defaults.conf文件,添加以下内容: #设置spark的主节点 spark.master spark://risen01:7077 #开启eventLog spark.eventLog.enabled true #设置eventLog存储目录 spark.eventLog.dir /log/spark/eventLog #设置spark序列化方式 spark.serializer org.apache.spark.serializer.KryoSerializer #设置spark的driver内存 spark.driver.memory 1g #设置spark的心跳检测时间间隔 spark.executor.heartbeatInterval 20s #默认并行数 spark.default.parallelism 20 #最大网络延时 spark.network.timeout 3000s 3.3.3、 编辑slaves文件 操作节点:risen01 操作用户:root 说明:请根据实际集群的规模和硬件条件来配置每一项参数 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/conf目录下执行命令: cp slaves.templete slaves 编辑slaves文件,修改localhost为: risen01 risen02 risen03 3.4、分发其他节点 执行scp命令: 操作节点:risen01 操作用户:root scp -r /usr/local/spark-2.2.0-bin-hadoop2.6 root@risen02:/usr/local scp -r /usr/local/scala-2.11.0 root@risen02:/usr/local scp -r /usr/local/jdk1.8.0_161 root@risen02:/usr/local scp -r /usr/local/spark-2.2.0-bin-hadoop2.6 root@risen03:/usr/local scp -r /usr/local/scala-2.11.0 root@risen03:/usr/local scp -r /usr/local/jdk1.8.0_161 root@risen03:/usr/local 需要提前创建好bigdata用户并实现免密(这里不再赘述,此步骤如果做过可不做) 权限修改 操作节点:risen01,risen02,risen03 操作用户:root 修改/log/spark权限命令: chown -R bigdata.bigdata /log/spark 修改/data/spark权限命令: chown -R bigdata.bigdata /data/spark 修改spark的安装目录命令: chown -R bigdata.bigdata /usr/local/spark-2.2.0-bin-hadoop2.6 修改Scala的安装目录命令: chown -R bigdata.bigdata /usr/local/scala-2.11.0 修改JDK1.8的安装目录命令:(此步骤如果做过可不做) chown -R bigdata.bigdata /usr/local/jdk1.8.0_161 结果如图下所示:3.5、启动集群 操作节点:risen01,risen02 操作用户:bigdata (1) 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/sbin目录下执行./start-all.sh,查看web界面如下图所示: 然后在进入到risen02机器的spark安装目录下/usr/local/spark-2.2.0-bin-hadoop2.6/sbin执行命令./start-master.sh启动spark集群的备用主节点。(记得一定要启动备用主节点的进程,这里我们只用risen02做备用主节点,risen03虽然也配置了有资格,但是暂时我们不需要) (2) 进入到/usr/local/spark-2.2.0-bin-hadoop2.6/bin目录下执行spark-shell,并测试统计词频的测试,结果如下图所示: 截止到此,spark-standlone模式便安装成功了! 推荐阅读:https://www.roncoo.com/course/view/c4e0130ea2354c71a2cb9ba24348746c 文章来源:https://my.oschina.net/blogByRzc/blog/1800450

优秀的个人博客,低调大师

搭建本地 yum 源 离线安装 Docker 1.12.6

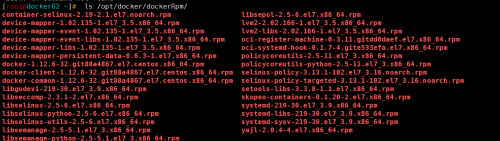
使用 yum 安装 docker ,需要访问互联网、有时内网环境的机器也需要安装docker、直接使用rpm 包安装需要解决各种各样的依赖,搭建本地yum 源是一个很好解决问题的方法. centos yum 命令 提供了一种只下载不安装的命令 。 yum --downloadonly , --downloaddir=DLDIR ,下面是构建的详细步骤 环境准备 选择一台可以连接外网的服务器、保证可以相应的软件安装包 下载docker 软件 mkdir -p /opt/docker/dockerRpm yum install -downloadonly -downloaddir=/opt/docker/dockerRpm docker 查看已下载的软件 包 拷贝 /opt/docker/dockerRpm 下面的软件包值内网服务器上 在内网服务器构建本地yum 源 ,确保内网服务器已安装createrepo 命令 在/etc/yum.repos.d 目录下面备份原有的文件 创建新的yum 源 cat /etc/yum.repos.d/docker.repo [docker] name=docker baseurl=file:///app/docker/ gpgcheck=0 enabled=1 gpgkey=file:///etc/pki/rpm-gpg/RPM-GPG-KEY-CentOS-7 创建yum 源的目录 mkdir -p /app/docker createrepo -d /app/docker yum repolist # 查看yum 源 清除缓存,yum clean all 创建缓存,yum makecache 安装docker yum install docker -y 检查安装是否成功 安装成功 本文转自 水滴石川1 51CTO博客,原文链接:http://blog.51cto.com/sdsca/1948414,如需转载请自行联系原作者

优秀的个人博客,低调大师

离线安装Eclipse的Android ADT开发插件

不知道大家是不是有过这样的感觉。从 https://dl-ssl.google.com/android/eclipse/ 很慢呢!我是教育网所以确实是很慢的。 所以我想了一个办法确保可以快点安装上ADT15。当然ADT16、ADT17也是可以的。不过我还是用ADT15做演示把。 很熟悉把,这是Eclipse解压后的图片当然ADT是要自己下载的。我们51CTO下载哪儿也有好多的,大家自己去下载,我就不提供下载地址啦。 打开Eclipse, 在菜单栏上选择 help->Install New SoftWare 出现如下界面: 点击 Add按钮,出现如下界面 在Name这而随意输入一个名字:ADT15; 点击打开Archives如图: 记得啦ADT一定要是ZIP格式的呢。 打开后如图: 点击“Next”: 再次点击“Next”: 选择“I accept the ......”,就可以点击“Finish”啦: 嘻嘻,Eclipse问你要安装吗。肯定是“OK”: 继续选择“OK” Eclipse问你要重启Eclipse吗?当然要啦,不然怎么使用ADT。还是“OK”: 重启Eclipse后,点击菜单window->preferences,进入如下界面 选择你的android SDK解压后的目录,选错了就会报错,这个是升级工具,目前还没有一个版本的SDK。 就可以安装好啦。 读者可以参考:http://mobile.51cto.com/android-227548.htm 希望我的博文对大家有帮助。有疑问可以留言呢。 本文转自 梦朝思夕 51CTO博客,原文链接:http://blog.51cto.com/qiangmzsx/828182

优秀的个人博客,低调大师

祁木 CAD Translator图纸离线翻译实战:混元大模型与离线行业术语库的深度应用

在跨国工程协作中,图纸往往不仅是技术的载体,更是沟通的枢纽。然而,当一份来自德国的机械总装图或日本的建筑结构图摆在国内工程师面前时,语言壁垒瞬间转化为巨大的沟通成本。传统的解决路径通常依赖外包翻译或在线工具,但这带来了两个难以忽视的痛点:一是专业术语的语境丢失,导致“轴承”被误译为“支撑”,“公差”被理解为“容忍度”,直接引发生产偏差;二是核心设计数据的外泄风险,将包含知识产权的 CAD 文件上传至公有云进行翻译,无异于将企业命脉置于不可控的网络环境中。

优秀的个人博客,低调大师

线程池中你不容错过的一些细节

背景 上周分享了一篇《一个线程罢工的诡异事件》,最近也在公司内部分享了这个案例。 无独有偶,在内部分享的时候也有小伙伴问了之前分享时所提出的一类问题: 这其实是一类共性问题,我认为主要还是两个原因: 我自己确实也没讲清楚,之前画的那张图还需要再完善,有些误导。 第二还是大家对线程池的理解不够深刻,比如今天要探讨的内容。 线程池的工作原理 首先还是来复习下线程池的基本原理。 我认为线程池它就是一个调度任务的工具。 众所周知在初始化线程池会给定线程池的大小,假设现在我们有 1000 个线程任务需要运行,而线程池的大小为 10~20,在真正运行任务的过程中他肯定不会创建这1000个线程同时运行,而是充分利用线程池里这 10~20 个线程来调度这1000个任务。 而这里的 10~20 个线程最后会由线程池封装为 ThreadPoolExecutor.Worker 对象,而这个 Worker 是实现了 Runnable 接口的,所以他自己本身就是一个线程。 深入分析 这里我们来做一个模拟,创建了一个核心线程、最大线程数、阻塞队列都为2的线程池。 这里假设线程池已经完成了预热,也就是线程池内部已经创建好了两个线程 Worker。 当我们往一个线程池丢一个任务会发生什么事呢? 第一步是生产者,也就是任务提供者他执行了一个 execute() 方法,本质上就是往这个内部队列里放了一个任务。 之前已经创建好了的 Worker 线程会执行一个 while 循环 ---> 不停的从这个内部队列里获取任务。(这一步是竞争的关系,都会抢着从队列里获取任务,由这个队列内部实现了线程安全。) 获取得到一个任务后,其实也就是拿到了一个 Runnable 对象(也就是 execute(Runnable task) 这里所提交的任务),接着执行这个 Runnable 的 run() 方法,而不是 start(),这点需要注意后文分析原因。 结合源码来看: 从图中其实就对应了刚才提到的二三两步: while 循环,从 getTask() 方法中一直不停的获取任务。 拿到任务后,执行它的 run() 方法。 这样一个线程就调度完毕,然后再次进入循环从队列里取任务并不断的进行调度。 再次解释之前的问题 接下来回顾一下我们上一篇文章所提到的,导致一个线程没有运行的根本原因是: 在单个线程的线程池中一但抛出了未被捕获的异常时,线程池会回收当前的线程并创建一个新的 Worker; 它也会一直不断的从队列里获取任务来执行,但由于这是一个消费线程,根本没有生产者往里边丢任务,所以它会一直 waiting 在从队列里获取任务处,所以也就造成了线上的队列没有消费,业务线程池没有执行的问题。 结合之前的那张图来看: 这里大家问的最多的一个点是,为什么会没有是根本没有生产者往里边丢任务,图中不是明明画的有一个 product 嘛? 这里确实是有些不太清楚,再次强调一次: 图中的 product 是往内部队列里写消息的生产者,并不是往这个 Consumer 所在的线程池中写任务的生产者。 因为即便 Consumer 是一个单线程的线程池,它依然具有一个常规线程池所具备的所有条件: Worker 调度线程,也就是线程池运行的线程;虽然只有一个。 内部的阻塞队列;虽然长度只有1。 再次结合图来看: 所以之前提到的【没有生产者往里边丢任务】是指右图放大后的那一块,也就是内部队列并没有其他线程往里边丢任务执行 execute() 方法。 而一旦发生未捕获的异常后,Worker1 被回收,顺带的它所调度的线程 task1(这个task1 也就是在执行一个 while 循环消费左图中的那个队列) 也会被回收掉。 新创建的 Worker2 会取代 Worker1 继续执行 while 循环从内部队列里获取任务,但此时这个队列就一直会是空的,所以也就是处于 Waiting 状态。 我觉得这波解释应该还是讲清楚了,欢迎还没搞明白的朋友留言讨论。 为什是 run() 而不是 start() 问题搞清楚后来想想为什么线程池在调度的时候执行的是 Runnable 的 run() 方法,而不是 start() 方法呢? 我相信大部分没有看过源码的同学心中第一个印象就应该是执行的 start() 方法; 因为不管是学校老师,还是网上大牛讲的都是只有执行了 start() 方法后操作系统才会给我们创建一个独立的线程来运行,而 run() 方法只是一个普通的方法调用。 而在线程池这个场景中却恰好就是要利用它只是一个普通方法调用。 回到我在文初中所提到的:我认为线程池它就是一个调度任务的工具。 假设这里是调用的 Runnable 的 start 方法,那会发生什么事情。 如果我们往一个核心、最大线程数为 2 的线程池里丢了 1000 个任务,那么它会额外的创建 1000 个线程,同时每个任务都是异步执行的,一下子就执行完毕了。 从而没法做到由这两个 Worker 线程来调度这 1000 个任务,而只有当做一个同步阻塞的 run() 方法调用时才能满足这个要求。 这事也让我发现一个奇特的现象:就是网上几乎没人讲过为什么在线程池里是 run 而不是 start,不知道是大家都觉得这是基操还是没人仔细考虑过。 总结 针对之前线上事故的总结上次已经写得差不多了,感兴趣的可以翻回去看看。 这次呢可能更多是我自己的总结,比如写一篇技术博客时如果大部分人对某一个知识点讨论的比较热烈时,那一定是作者要么讲错了,要么没讲清楚。 这点确实是要把自己作为一个读者的角度来看,不然很容易出现之前的一些误解。 在这之外呢,我觉得对于线程池把这两篇都看完同时也理解后对于大家理解线程池,利用线程池完成工作也是有很大好处的。 如果有在面试中加分的记得回来点赞、分享啊。 你的点赞与分享是对我最大的支持

优秀的个人博客,低调大师

不容错过 DOCKERCON SF 2019 大会的 5 个理由

出品丨Docker公司(ID:docker-cn)编译丨小东每周一、三、五,与您不见不散! 如果您今年只能参加一场大会,那么就来参加 DockerCon SF 2019 大会吧!DockerCon 是从业者、贡献者、维护者、开发者和容器生态系统学习、网络和创新的一站式活动。今年,我们将继续为您提供 DockerCon 最受欢迎的活动,如 Docker Pals、Hallway Track和圆桌会议,以及您想要的更多会议和内容,包括开源、转型和实用的操作方法。 如果您仍然没有下定决心,这里有一些您不应该错过今年 DockerCon 的理由: 归属 —— DockerCon 大会是感受成为 Docker 社区一员的最佳方式。利用 Docker Pals 计划、Hallway Track、圆桌会议和社交活动来结识新朋友并建立持久的联系。 发散思维 —— Docker 容器和我们的容器平台可用于各个领域,从发送火箭到太空、从小行星拯救地球再到为黑色星期五的购物者保持电商系统的顺利运行。来到 DockerCon 并大胆的畅想数字化未来。 建立你的技能体系 —— DockerCon 的会议将学习与可操作这两点放在首位。从开发人员的提示和技巧到实际操作的最佳实践以及从客户故事到 Docker 团队的最新创新。 成为专家 —— 通过 Hallway Track 深入了解机器学习、CI / CD、Kubernetes、开发人员工具以及安全等主题。这是独一无二的会议工具,可以让与会者轻松地安排一对一和小组讨论他们选择的主题。 体验无与伦比的社交网络 —— 我们知道参加会议的主要原因之一就是您将在会场遇见谁,DockerCon 在容器旅程的每个阶段汇集了行业专家和从业者。因此,扩展您的交际网络,与其他与会者会面,并了解 Docker 团队! 现在,浏览 https://dockercon19.smarteventscloud.com/portal/newreg.ww 注册加入我们吧!

优秀的个人博客,低调大师

​DockerCon 巴塞罗那站即将开幕,精彩内容不容错过!

出品丨Docker公司(ID:docker-cn)编译丨小东每周一、三、五晚6点10分 与您不见不散! DockerCon 巴塞罗那站将于2018年12月3-5日拉开帷幕,届时您可以带着使用 Docker 和容器的故事来到现场与大家分享。DockerCon 是行业领先的容器大会,思想领袖、开发人员、IT 专业人员、架构师以及商业领袖齐聚一堂相互学习、发现和互动。其中最重要的一个环节就是通过聆听其他团队使用 Docker 和容器的经历。 不要羞于提出你的想法,每一个话题都是一份宝贵的经验。对于每个演示来说,都有数百人学习并与您分享相关的经验和见解。往届最好的会谈都是来自于您这样的用户,对于一些人来说,DockerCon 是他们人生中的第一次公开演讲。 申请演讲的截止日期:2018年9月8日 浏览 https://dockerconeurope18.smarteventscloud.com/portal/cfp/cfpLogin.ww 参与报名申请! 大家想听到什么? DockerCon 提供了各种突破来满足开发人员和 IT 团队的需求,无论他们是容器新手还是即将扩展全球部署。 为开发人员或 IT 团队准备“如何…”类型的主题; 案例分析; 深入到容器和分布式系统相关组件的技术; 使用 Docker 容器构建出来的新应用; 在使用容器的过程中,您干出的那些最疯狂的事情; 亦或是任何与容器有关的经历; 在这里您能得到什么? 为演讲者提供免费的会议门票; 名气:演讲将会在网上传播; 分享您的经验和想法,与容器社区联系、合作,甚至为您的团队做一些招聘工作;

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册