首页 文章 精选 留言 我的

精选列表

搜索[持久记忆系统],共8031篇文章
优秀的个人博客,低调大师

Python数据持久化-小测验

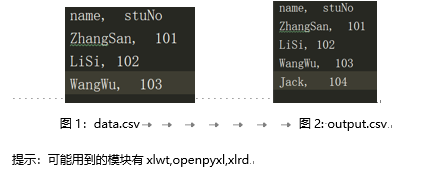
2018年7月13日考试 1.Python读写csv文件 现有如下图1所示的data.csv文件数据,请使用python读取该csv文件数据,并添加一条记录后输出如图2所示的output.csv文件(10分) 题1.png 这一题需要用到的csv文件 data.csv下载链接: https://pan.baidu.com/s/1JCUCU4vXBQNwOx2xhAjDqA 密码: pbpx 第1题 import csv def printCsv(csvName): with open(csvName) as csvFile: reader = csv.reader(csvFile) for i in reader: print(i) if __name__ == "__main__": inCsv = "data.csv" outCsv = "output.csv" with open(inCsv) as csvFile: reader = csv.reader(csvFile) data = list(reader) print("原csv文件data.csv的数据内容:") printCsv(inCsv) data.append(['Jack','104']) with open(outCsv,'w',\ newline='') as csvFile: writer = csv.writer(csvFile) writer.writerows(data) print("新产生的csv文件output.csv的数据内容:") printCsv(outCsv) 上面一段代码的运行结果如下: 原csv文件data.csv的数据内容: ['name', ' stuNo'] ['ZhangSan', ' 101'] ['LiSi', ' 102'] ['WangWu', ' 103'] 新产生的csv文件output.csv的数据内容: ['name', ' stuNo'] ['ZhangSan', ' 101'] ['LiSi', ' 102'] ['WangWu', ' 103'] ['Jack', '104'] 2.Python读写excel文件 如下所示的Excel表格数据,请编写python代码筛选出Points大于5的数据,并按Points进行排序后输出如图2所示的Excel文件结果 题2.png 这一题需要用到的excel文件 rank.xlsx下载链接: https://pan.baidu.com/s/1reS7yjxUjU1iqZc0rCjljA 密码: uymy import xlrd import xlwt if __name__ == "__main__": excel = xlrd.open_workbook("rank.xlsx") sheet = excel.sheet_by_index(0) #获取字段列表赋值给field_list,第2个字段大于5的数据列表赋值给data_list field_list = sheet.row_values(0) data_list = [] for i in range(1,sheet.nrows): if int(sheet.row_values(i)[2]) > 5: data_list.append(sheet.row_values(i)) #利用sorted内置函数排序 data_list = sorted(data_list,key=lambda x:x[2],reverse=True) #将获得的信息存入新表,命名为output.xlsx excel_w = xlwt.Workbook() sheet_w = excel_w.add_sheet("sheet1") for i in range(len(field_list)): sheet_w.write(0,i,field_list[i]) for i in range(len(data_list)): for j in range(len(data_list[i])): sheet_w.write(i+1,j,data_list[i][j]) excel_w.save("output.xls") 3.mysql数据库的sql语句 (1) 使用sql创建出如下图所示的数据表,数据库名为movies,表名为movieRank,表中包含MovieName、boxOffice、percent、days、totalBoxOffice五个字段,字段的信息如下图所示: 题3-1.png 创建语句.png (2)使用sql语句向movieRank表中添加若干条数据(材料中已提供movieData.txt) insert into movierank values("21克拉", 1031.92, 15.18, 2, 2827.06); insert into movierank values("狂暴巨兽", 2928.28, 43.07, 9, 57089.20); insert into movierank values("起跑线", 161.03, 2.37, 18, 19873.43); insert into movierank values("头号玩家", 1054.87, 15.52, 23, 127306.41); insert into movierank values("红海行动", 45.49, 0.67, 65, 364107.74); 插入数据的结果如下图所示: 插入结果图示.png (3)使用sql语句查询movieRank表中的数据并按照totalBoxOffice字段进行排序 select * from movierank order by totalboxoffice; (4)使用sql语句计算出字段totalBoxOffice字段的总和 select sum(totalboxoffice) from movierank; 4.Python操作mysql数据库 此题接第3题题干,在第三题的基础上完成以下需求: (1)编写python代码连接mysql数据库,并向movieRank表中新添加两条数据(已提供second.txt) import pymysql def getConn(database ="pydb"): args = dict( host = 'localhost', user = 'root', passwd = 'Leimysql8', charset = 'utf8', db = database ) return pymysql.connect(**args) if __name__ == "__main__": conn = getConn("movies") cursor = conn.cursor() insert_sql = 'insert into movierank values'\ '("犬之岛", 617.35, 9.08, 2, 1309.09),'\ '("湮灭", 135.34, 1.99, 9 , 5556.77)' cursor.execute(insert_sql) conn.commit() conn.close() (2)编写python代码,查询出所有的电影数据,并输出到一个Excel表movieRank.xlsx中,如下图所示 题4-2.png import pymysql import xlwt def getConn(database ="pydb"): args = dict( host = 'localhost', user = 'root', passwd = 'Leimysql8', charset = 'utf8', db = database ) return pymysql.connect(**args) if __name__ == "__main__": #从mysql数据库中取出数据赋值给data_list,其数据类型为元组 conn = getConn("movies") cursor = conn.cursor() select_sql = "select * from movierank " cursor.execute(select_sql) data_list = cursor.fetchall() field_list = [k[0] for k in cursor.description] #把data_list中的数据存入新的excel中,并命名为movieRank.xls excel = xlwt.Workbook() sheet = excel.add_sheet("sheet1") for i in range(len(field_list)): sheet.write(0,i,field_list[i]) for i in range(len(data_list)): for j in range(len(data_list[i])): sheet.write(i+1,j,data_list[i][j]) excel.save("movieRank.xls") 5.Python操作MongoDB数据库 (1)编写python代码连接MongoDB数据库,并新建一个building库,在building库下新建一个rooms表 from pymongo import MongoClient if __name__ == "__main__": conn = MongoClient("localhost") db = conn.building rooms = db.create_collection("rooms") (2)编写python代码读取rooms.csv文件的中的数据,并将数据插入到rooms表中,添加到rooms表中的数据结构如下图所示 image.png 这一题需要用到的csv文件rooms.csv下载链接: https://pan.baidu.com/s/10fyct-J3a0txtS-EZaaxAQ 密码: je33 from pymongo import MongoClient import csv if __name__ == "__main__": with open("rooms.csv") as csvFile: reader = list(csv.reader(csvFile)) field_list = reader[0] data_list = reader[1:] conn = MongoClient("localhost") db = conn.building rooms = db.rooms insert_list = [] for data in data_list: insert_list.append( {key:value for key,value in zip(field_list,data)}) rooms.insert_many(insert_list) 使用csv.DictReader方法 from pymongo import MongoClient import csv if __name__ == "__main__": conn = MongoClient("localhost") db = conn.building rooms = db.rooms with open("rooms.csv") as csvFile: reader = csv.DictReader(csvFile) for row in reader: rooms.insert_one(dict(row))

优秀的个人博客,低调大师

Python数据持久化-mysql篇

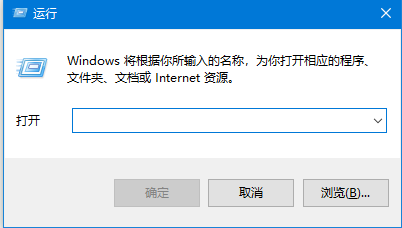
1.下载pymysql模块 pymysql模块对python3的支持比较好 安装命令:pip install pymysql 2.新建一个数据库 会用可视化工具hedisql或者navicat创建数据库则跳过此步 打开cmd或者PoweShell 打开方式是windows+R组合键 具体操作为:在按住windows键的情况,再按R键 windows键在键盘左下方,下方第一行从左往右数第二个有windows图标的键就是windows键 呼唤出窗口如下图所示: 图片.png-7kB 在 运行窗口中输入powershell 图片.png-6.9kB 点击上图中的确定后,如下图所示。 图片.png-4kB 在PowerShell中输入命令并运行: mysql -u root -p 图片.png-4.6kB 输入root用户对应的密码后,运行如下图所示: 图片.png-11.6kB 在mysql中输入命令并运行: create database pydb 图片.png-9.5kB 出现上图所示,则成功创建数据库。 3.编辑py文件 3.1插入数据 import pymysql if __name__ == "__main__": args = dict( host = 'localhost', user = 'root', passwd = '...your password', db = 'pydb', charset = 'utf8' ) conn = pymysql.connect(**args) cursor = conn.cursor() cursor.execute("drop table if exists test") cursor.execute("create table test(id int,name varchar(20))") cursor.execute('insert into test values(1,"小明")') cursor.execute('insert into test values(2,"小红")') cursor.execute('insert into test values(3,"小王")') conn.commit() conn.close() 3.2查询数据 cursor.fetchall()函数示例: import pymysql if __name__ == "__main__": args = dict( host = 'localhost', user = 'root', passwd = '...your password', db = 'pydb', charset = 'utf8' ) conn = pymysql.connect(**args) cursor = conn.cursor() cursor.execute("select * from test") data_list = cursor.fetchall() for data in data_list: print(data) conn.commit() conn.close() 上面一段代码的运行结果如下: (1, '小明') (2, '小红') (3, '小王') cursor.fetchmany()函数示例: import pymysql if __name__ == "__main__": args = dict( host='localhost', user='root', passwd='...your password', db='pydb', charset='utf8' ) conn = pymysql.connect(**args) cursor = conn.cursor() cursor.execute("select * from test") data_list = cursor.fetchmany(2) for data in data_list: print(data) conn.commit() conn.close() 上面一段代码的运行结果如下: (1, '小明') (2, '小红') 小结 关键是mysql的sql语句要熟练,python连接mysql数据库后对相应的数据库利用cursor.execute()方法进行操作。 完成操作后要提交,即conn.commit();关闭连接,即conn.close()

优秀的个人博客,低调大师

Python数据持久化-MongoDB篇

2018年7月6日笔记 下文中的操作都是使用python操作mongoDB,所以前提是必须安装python和mongoDB。 1. 安装pymongo 在cmd或者PowerShell中运行命令:pip install pymongo 2. 插入数据 2.1 插入一条数据 引入pymongo库中的MongoClient类,使用该类的初始化方法实例化一个对象赋值给conn conn.myschool为数据库school,将其赋值给变量db db.students为数据库school中的students集合,将其赋值给变量students 定义一个数据类型为字典dict的变量zhangsan 往数据库中的students集合中插入zhangsan的信息文档,students.insert_one(zhangsan) from pymongo import MongoClient if __name__ == '__main__': conn = MongoClient('localhost') db = conn.myschool students = db.students zhangsan = dict( name="zhangsan", age=20, sex="boy", contact=dict( email1="abc@qq.com", email2="123@qq.com" ) ) students.insert_one(zhangsan) 2.2 插入多条数据 from pymongo import MongoClient if __name__ == '__main__': conn = MongoClient('localhost') db = conn.myschool students = db.students lisi = dict( name = 'lisi', habit = dict( habit1 = 'eat', habit2 = 'sleep' ) ) wangwu = dict( name = 'wangwu', age = 20, sex = 'boy' ) students.insert_many([lisi,wangwu]) 2.3 使用循环创建3个班,并随机添加10个学生 from pymongo import MongoClient from random import randint if __name__ == '__main__': conn = MongoClient('localhost') db = conn.school hobby_list = ['sing','drawing','run','football','basketball'] grade_list = ['grade_1_1','grade_1_2','grade_1_3'] for grade in grade_list: collection = db.get_collection(grade) collection.drop() for i in range(10): student = dict( name = "zhangsan" + str(i), age = randint(1,9), sex = "男" if randint(0,1) else "女", hobby = hobby_list[:randint(0,5)] ) collection.insert_one(student) 3.查询数据 在进行查询的时候,必须要先执行2-3节中的代码,确保school数据库中插入3个班集合 3.1 查询集合中全部数据 示例代码如下: from pymongo import MongoClient if __name__ == '__main__': conn = MongoClient('localhost') db = conn.school students = db.grade_1_3 cursor = students.find() for i in cursor: print(i) 图片.png-57.9kB 3.2 过滤查询 查询之前先定义一个数据类型为字典dict的变量filter filter示例,查询年龄等于4的文档:filter = {"age":4} 代码示例如下,代码能够成功运行,具体的数据库名和集合名要根据自己电脑中的MongoDB情况进行更改: from pymongo import MongoClient if __name__ == '__main__': conn = MongoClient('localhost') db = conn.school students = db.grade_1_3 filter = {"age": 4} cursor = students.find(filter) for i in cursor: print(i) filter中操作符及其含义 图片.png-131.5kB 3.2.1 $in操作符示例: from pymongo import MongoClient if __name__ == '__main__': conn = MongoClient('localhost') db = conn.school students = db.grade_1_3 filter = {"name": {'$in':['zhangsan2','zhangsan3']}} cursor = students.find(filter) for i in cursor: print(i) 上面一段代码的运行结果如下: {'_id': ObjectId('5b3f0ea2ba50f64850ef1cda'), 'name': 'zhangsan2', 'age': 3, 'sex': '女', 'hobby': ['sing', 'drawing']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cdb'), 'name': 'zhangsan3', 'age': 3, 'sex': '男', 'hobby': ['sing', 'drawing', 'run', 'football']} 3.2.2 $gt操作符示例: from pymongo import MongoClient if __name__ == '__main__': conn = MongoClient('localhost') db = conn.school students = db.grade_1_3 filter = {"age": {'$gt':4}} cursor = students.find(filter) for i in cursor: print(i) 上面一段代码的运行结果如下: {'_id': ObjectId('5b3f0ea2ba50f64850ef1cd8'), 'name': 'zhangsan0', 'age': 7, 'sex': '女', 'hobby': ['sing', 'drawing', 'run']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cd9'), 'name': 'zhangsan1', 'age': 5, 'sex': '女', 'hobby': ['sing', 'drawing', 'run', 'football']} 3.2.3 $gte操作符示例: from pymongo import MongoClient if __name__ == '__main__': conn = MongoClient('localhost') db = conn.school students = db.grade_1_3 filter = {"age": {'$gte':4}} cursor = students.find(filter) for i in cursor: print(i) 上面一段代码运行结果如下: {'_id': ObjectId('5b3f0ea2ba50f64850ef1cd8'), 'name': 'zhangsan0', 'age': 7, 'sex': '女', 'hobby': ['sing', 'drawing', 'run']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cd9'), 'name': 'zhangsan1', 'age': 5, 'sex': '女', 'hobby': ['sing', 'drawing', 'run', 'football']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cdc'), 'name': 'zhangsan4', 'age': 4, 'sex': '女', 'hobby': ['sing', 'drawing', 'run']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cdf'), 'name': 'zhangsan7', 'age': 4, 'sex': '女', 'hobby': ['sing', 'drawing']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1ce1'), 'name': 'zhangsan9', 'age': 4, 'sex': '女', 'hobby': ['sing', 'drawing', 'run']} 4.更新数据 4.1使用update_many函数 让所有文档中的sex字段都被修改为“男”。 from pymongo import MongoClient if __name__ == '__main__': conn = MongoClient('localhost') db = conn.school students = db.grade_1_3 filter = {"sex":"女"} updater = {"$set":{"sex":"男"}} students.update_many(filter,updater) cursor = students.find() for i in cursor: print(i) 上面一段代码的运行结果如下: {'_id': ObjectId('5b3f0ea2ba50f64850ef1cd8'), 'name': 'zhangsan0', 'age': 7, 'sex': '男', 'hobby': ['sing', 'drawing', 'run']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cd9'), 'name': 'zhangsan1', 'age': 5, 'sex': '男', 'hobby': ['sing', 'drawing', 'run', 'football']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cda'), 'name': 'zhangsan2', 'age': 3, 'sex': '男', 'hobby': ['sing', 'drawing']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cdb'), 'name': 'zhangsan3', 'age': 3, 'sex': '男', 'hobby': ['sing', 'drawing', 'run', 'football']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cdc'), 'name': 'zhangsan4', 'age': 4, 'sex': '男', 'hobby': ['sing', 'drawing', 'run']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cdd'), 'name': 'zhangsan5', 'age': 1, 'sex': '男', 'hobby': ['sing', 'drawing', 'run', 'football']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cde'), 'name': 'zhangsan6', 'age': 2, 'sex': '男', 'hobby': ['sing']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1cdf'), 'name': 'zhangsan7', 'age': 4, 'sex': '男', 'hobby': ['sing', 'drawing']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1ce0'), 'name': 'zhangsan8', 'age': 1, 'sex': '男', 'hobby': ['sing', 'drawing']} {'_id': ObjectId('5b3f0ea2ba50f64850ef1ce1'), 'name': 'zhangsan9', 'age': 4, 'sex': '男', 'hobby': ['sing', 'drawing', 'run']} 4.2 $inc操作符示例 让所有文档的age字段加2,即让集合grade_1_1中的所有人年龄加2 from pymongo import MongoClient def printMongo(collection,filter={},num=3): cursor = collection.find(filter) for i in cursor[:num]: print(i) if __name__ == "__main__": conn = MongoClient("localhost") db = conn.school students = db.grade_1_1 printMongo(students) updater = {"$inc":{"age":2}} students.update_many({},updater) print("MongoDB更新数据后:") printMongo(students) 上面一段代码的运行结果如下: {'_id': ObjectId('5b403bdc33514c04b891a363'), 'name': 'zhangsan0', 'age': 7, 'sex': '男', 'hobby': ['sing', 'drawing', 'run', 'football', 'basketball']} {'_id': ObjectId('5b403bdc33514c04b891a364'), 'name': 'zhangsan1', 'age': 4, 'sex': '男', 'hobby': ['sing', 'drawing', 'run']} {'_id': ObjectId('5b403bdc33514c04b891a365'), 'name': 'zhangsan2', 'age': 7, 'sex': '女', 'hobby': []} MongoDB更新数据后: {'_id': ObjectId('5b403bdc33514c04b891a363'), 'name': 'zhangsan0', 'age': 9, 'sex': '男', 'hobby': ['sing', 'drawing', 'run', 'football', 'basketball']} {'_id': ObjectId('5b403bdc33514c04b891a364'), 'name': 'zhangsan1', 'age': 6, 'sex': '男', 'hobby': ['sing', 'drawing', 'run']} {'_id': ObjectId('5b403bdc33514c04b891a365'), 'name': 'zhangsan2', 'age': 9, 'sex': '女', 'hobby': []} 4.3 $min操作符示例 与当前值进行比较,更新值为两者中的较小值 下面一段代码将所有age字段大于6的文档中的age字段修改为6 from pymongo import MongoClient def printMongo(collection,filter={},num=5): cursor = collection.find(filter) for i in cursor[:num]: print(i) if __name__ == "__main__": conn = MongoClient("localhost") db = conn.school students = db.grade_1_1 printMongo(students) updater = {"$min":{"age":6}} students.update_many({},updater) print("MongoDB更新数据后:") printMongo(students) 上面一段代码的运行结果如下: {'_id': ObjectId('5b403efd33514c189890748f'), 'name': 'zhangsan0', 'age': 4, 'sex': '男', 'hobby': ['sing', 'drawing', 'run']} {'_id': ObjectId('5b403efe33514c1898907490'), 'name': 'zhangsan1', 'age': 9, 'sex': '男', 'hobby': []} {'_id': ObjectId('5b403efe33514c1898907491'), 'name': 'zhangsan2', 'age': 1, 'sex': '男', 'hobby': ['sing']} {'_id': ObjectId('5b403efe33514c1898907492'), 'name': 'zhangsan3', 'age': 7, 'sex': '女', 'hobby': ['sing', 'drawing', 'run', 'football']} {'_id': ObjectId('5b403efe33514c1898907493'), 'name': 'zhangsan4', 'age': 2, 'sex': '男', 'hobby': ['sing', 'drawing', 'run']} MongoDB更新数据后: {'_id': ObjectId('5b403efd33514c189890748f'), 'name': 'zhangsan0', 'age': 4, 'sex': '男', 'hobby': ['sing', 'drawing', 'run']} {'_id': ObjectId('5b403efe33514c1898907490'), 'name': 'zhangsan1', 'age': 6, 'sex': '男', 'hobby': []} {'_id': ObjectId('5b403efe33514c1898907491'), 'name': 'zhangsan2', 'age': 1, 'sex': '男', 'hobby': ['sing']} {'_id': ObjectId('5b403efe33514c1898907492'), 'name': 'zhangsan3', 'age': 6, 'sex': '女', 'hobby': ['sing', 'drawing', 'run', 'football']} {'_id': ObjectId('5b403efe33514c1898907493'), 'name': 'zhangsan4', 'age': 2, 'sex': '男', 'hobby': ['sing', 'drawing', 'run']} $currentDate操作符示例 添加的时间是按照0时区时间计时:比如本文作者实验时间为2018年7月7日12时28分(北京时间东8区),下面一段代码执行时记录的时间是2018年7月7日4时28分。 from pymongo import MongoClient def printMongo(collection,filter={},num=2): cursor = collection.find(filter) for i in cursor[:num]: print(i) if __name__ == "__main__": conn = MongoClient("localhost") db = conn.school students = db.grade_1_1 printMongo(students) updater = {"$currentDate":{"create_time":True}} students.update_many({},updater) print("MongoDB更新数据后:") printMongo(students) 上面一段代码的运行结果如下: {'_id': ObjectId('5b40413a33514c36d8a854ee'), 'name': 'zhangsan0', 'age': 8, 'sex': '女', 'hobby': ['sing', 'drawing']} {'_id': ObjectId('5b40413a33514c36d8a854ef'), 'name': 'zhangsan1', 'age': 5, 'sex': '男', 'hobby': ['sing', 'drawing', 'run', 'football']} MongoDB更新数据后: {'_id': ObjectId('5b40413a33514c36d8a854ee'), 'name': 'zhangsan0', 'age': 8, 'sex': '女', 'hobby': ['sing', 'drawing'], 'create_time': datetime.datetime(2018, 7, 7, 4, 28, 0, 527000)} {'_id': ObjectId('5b40413a33514c36d8a854ef'), 'name': 'zhangsan1', 'age': 5, 'sex': '男', 'hobby': ['sing', 'drawing', 'run', 'football'], 'create_time': datetime.datetime(2018, 7, 7, 4, 28, 0, 527000)} 5.删除数据 delete_many()函数用于删除多条数据 delete_one()函数用于删除一条数据 6.查询同时更新 三个可以利用来操作满足filter筛选条件的第一条文档的函数: find_one_and_replace() find_one_and_delete() find_one_and_update() 作业 新建mongoDB数据库employee,里面有两个集合employee_info、employee_salary (1)分别添加2个集合的数据 (2)查询employee_salary工资大于2000的;查询employee_info员工名称=xxx) (3)修改employee_salary集合(将员工工资增加3000) (4)删除员工aa的信息 4道小题合在一起的代码如下: from pymongo import MongoClient def printMongo(collection,filter={},num=2): cursor = collection.find(filter) for i in cursor[:num]: print(i) if __name__ == "__main__": conn = MongoClient("localhost") db = conn.employee info = db.employee_info salary = db.employee_salary #第1小题 info.drop() salary.drop() info.insert_one({"name":"aa","sex":"男","age":23}) info.insert_one({"name":"bb","sex":"女","age":20}) salary.insert_one({"name":"aa","salary":3000}) salary.insert_one({"name": "bb", "salary": 1800}) printMongo(info) printMongo(salary) # 第2小题 filter = {"salary":{"$gt":2000}} print("找出工资大于2000的员工:") printMongo(salary,filter) filter2 = {'name':"bb"} print("找出姓名为bb的员工") printMongo(info,filter2) ##第3小题 print("没有增加工资时:") printMongo(salary) updater = {"$inc":{"salary":3000}} salary.update_many({},updater) print("增加工资后:") printMongo(salary) ##第4小题 print("没有删除员工aa时打印所有员工信息:") printMongo(info) printMongo(salary) print("删除员工aa后打印所有员工信息") info.delete_one({"name":"aa"}) salary.delete_one({"name":"aa"}) printMongo(info) printMongo(salary) 上面一段代码的运行结果如下: {'_id': ObjectId('5b404b3333514c1dd0f6c096'), 'name': 'aa', 'sex': '男', 'age': 23} {'_id': ObjectId('5b404b3333514c1dd0f6c097'), 'name': 'bb', 'sex': '女', 'age': 20} {'_id': ObjectId('5b404b3333514c1dd0f6c098'), 'name': 'aa', 'salary': 3000} {'_id': ObjectId('5b404b3333514c1dd0f6c099'), 'name': 'bb', 'salary': 1800} 找出工资大于2000的员工: {'_id': ObjectId('5b404b3333514c1dd0f6c098'), 'name': 'aa', 'salary': 3000} 找出姓名为bb的员工 {'_id': ObjectId('5b404b3333514c1dd0f6c097'), 'name': 'bb', 'sex': '女', 'age': 20} 没有增加工资时: {'_id': ObjectId('5b404b3333514c1dd0f6c098'), 'name': 'aa', 'salary': 3000} {'_id': ObjectId('5b404b3333514c1dd0f6c099'), 'name': 'bb', 'salary': 1800} 增加工资后: {'_id': ObjectId('5b404b3333514c1dd0f6c098'), 'name': 'aa', 'salary': 6000} {'_id': ObjectId('5b404b3333514c1dd0f6c099'), 'name': 'bb', 'salary': 4800} 没有删除员工aa时打印所有员工信息: {'_id': ObjectId('5b404b3333514c1dd0f6c096'), 'name': 'aa', 'sex': '男', 'age': 23} {'_id': ObjectId('5b404b3333514c1dd0f6c097'), 'name': 'bb', 'sex': '女', 'age': 20} {'_id': ObjectId('5b404b3333514c1dd0f6c098'), 'name': 'aa', 'salary': 6000} {'_id': ObjectId('5b404b3333514c1dd0f6c099'), 'name': 'bb', 'salary': 4800} 删除员工aa后打印所有员工信息 {'_id': ObjectId('5b404b3333514c1dd0f6c097'), 'name': 'bb', 'sex': '女', 'age': 20} {'_id': ObjectId('5b404b3333514c1dd0f6c099'), 'name': 'bb', 'salary': 4800}

优秀的个人博客,低调大师

我要做 Android 之 数据持久

在现在的时代,数据显得格外重要,不单单对于国家,对于个人和公司也同样如此。但是数据量是如此的大以至于怎么处理是个麻烦事。今天我们来看一看 Android 是怎么解决的。 在 Android 中存储数据主要有三种方式: File 文件存储 SharedPreferences存储 SQLite数据库存储 在分别介绍之前,先要知道以上三种方法使得数据文件都默认存储在哪里,方便后续验证 1 File 文件存储 在 Android 中写入和读取文件的方法,和 Java 中实现 IO 的程序是一样的,Context 类中提供了 openFileInput() 和 openFileOutput() 方法来打开数据库里的文件 IO 流。 在布局中添加 EditText 实例,然后重写 onDestroy() 为了在活动销毁之前把输入的文本保存起来。主要是通过 openFileOutput() 方法将获取到的之存储到 data 的文件中。同时会获得一个 FileOutputStream 对象,在借助它构建出一个 OutputStramWriter 对象,接着在使用 OutputStreamWriter 构建出一个 BufferedWriter 对象,此时就可以把文本写入文件中了。 02.png 关键部分代码: FileOutputStream fileOutputStream = openFileOutput("data", Context.MODE_PRIVATE); bufferedWriter = new BufferedWriter(new OutputStreamWriter(fileOutputStream)); bufferedWriter.write(text); 这里说明一下 openFileOutput() 的两个参数,第一个不用多说,是代表文件名。就是把数据存入哪里。第二个是文件的操作模式: 03.png 这里推荐使用 private 或者直接写 0,两者意义相同。 (2)读取数据 在OnCreate()中用openFileInput()方法指定了要从文件data中读取数据,之后代码和写入是对应的非常好理解。 04.png 2.SharePreferences存储 SharePreferences是一种轻型的数据存储方式,常用来存储一些简单的配置信息,如int、string、boolean、float和 long。它的本质是基于XML文件存储key-value键值对数据。 实现 SharedPreference 存储的步骤如下: (1)调用 getSharedPreferences() 方法获得 SharedPreferences 对象,提供两个参数,指定文件名称和操作模式。 (2)调用 SharedPreferences 对象的 edit() 方法获得 SharedPreferences.Editor 引用对象 (3)调用 Edit 接口的形如 putXXX() 方法以键值对的形式保存 XXX 类型的数据。 (4)调用 Edit 接口的 commit() 方法提交键值对 一定注意,不用 SharedPreferences 对象去存储或修改数据,而是通过 Editor 对象。但获取数据的时候需要调用 SharedPreferences 对象的 getXXX() 方法。 05.png 还有其他很多方法就需要大家自己去探索了,使用方法都一样,把类型换一下就 OK 。 3.SQLite数据库存储 SQLite是一款轻量级的关系型数据库,它的运算速度非常快,占用资源很少,在存储大量复杂的关系型数据的时可以使用,比前面学过的只适用于存储简单数据的两种存储方式要好很多。 (1)创建数据库 先学习一个类 SQLiteOpenHelper, 它是 SQLiteDatabase 的帮助类,用于管理数据库的创建和升级。SQLiteOpenHelper 的使用步骤: 第一:自定义帮助类并且继承 SQLiteOpenHelper,并且重写两个方法:onCreate()和 onUpgrade(),分别在这两个方法中去实现创建、升级数据库的逻辑。还需要一个构造方法,这里用含有四个参数的构造方法就可以。 第二步:创建数据库时,先实例化一个自定义的帮助类,并提供四个参数,含义是(上下文,数据库名,创建Cursor的工厂类,版本号)。 第三步:用帮助类对象的getReadableDatabase() 和getWritableDatabase()去创建或打开一个现有的数据库(如果数据库已存在则直接打开,否则创建一个新的数据库),并返回一个可对数据库SQLiteDatabase。 第四步:之后就可以利用得到的数据库进行增删改查的操作了。 从自定义帮助类开始,并重写两个方法及构造函数。在这里用帮助类帮助创建一个student表,包含学生的学号、姓名、年龄和年级,对应的SQL语句就放在一个字符串常量里。特别要注意语句一定要准确,多个空格都会建表失败。在onCreate()方法里会返回一个SQLiteDatabase对象,接下来终于接触到SQLiteDatabase的第一个常用方法execSQL(),这个方法非常万能,它可接受和处理SQL语句,换句话说,后面将要学习的增删改查不仅可以用提供好的现成的辅助性方法,还可直接用原生SQL语句再调用execSQL()就够了,在后面的学习中只介绍前一种方法。这里就调用execSQL()去创建表并打印一行提示的Toast。 06.png 创建数据库的基本代码: 07.png 大家可以自己增加布局方式和按钮的点击监听事件。我这里只是直接实现,没有处理任何逻辑。 (2)增加数据 现在学习之前看到的ContentValues类,常用它put()方法以键值对的形式存储基本类型数据。在增和改会用到它,可以理解为键就是表中属性名,值就是表中数据。还常用方法clear()清空所有数据。 再来学习SQLiteDatabase用于增添数据的辅助性方法insert(),三个参数含义(被操作的表名,空值字段的名称,数据即ContentValues对象),第二个参数一般传入null。学会之后给student表插入两行记录吧,因为id这个属性设置了自增长所以可以不用管它: 08.png (3)删除数据 删除数据的辅助性方法是delete(),第一个参数还是表示表名,第二第三个参数用于约束删除某一行或几行的数据。比如需要删除student表中年龄大于17的记录: 09.png (4)更改数据 update() 方法提供四个参数,(表名,ContentValues对象,约束,约束),之前都学过了!来试试给表里唯一的学生Lucy的年级更改为高三: 10.png (5)查询数据 查询方法quary()复杂一些,需要至少七个参数(table, columns, selection, selectionArgs, groupBy, having, orderBy),含义是:(表名,要查询出的列名,查询条件子句,对应于selection语句中占位符的值,要分组的列名,分组后过滤条件,排序方式)。其实也不用担心,多数情况下少数几个参数就能完成查询操作了。其他参数统统赋值为 null。 还没完,这个方法会返回一个Cursor,查询到的数据都会从它取出。Cursor常用方法:moveToFirst()将指针移动到结果集的第一行;getColumnIndex()获取某一列在表中对应位置的索引;get某某某()传入索引以获取相应位置的某种类型的数据;close()关闭指针。 11.png (6)升级数据库 MyHelper里需要重写的第二个方法onUpdate()用于帮助数据库进行版本更新。比如此刻需要在数据库再添加一张表course,只要在update()写好创建course的操作,然后想办法让它被调用就好了。还记得在实例化帮助类是需要传入的第四个参数版本号吗?之前的传入的是1,只要传入一个比1大的数就可以让update()执行了。在下图代码里利用了oldVersion去判断旧版本号,如果是1就只需要再建course表,如果初次运行程序,就只会执行onCreate()方法然后两张表就一起建立了。这样做的好处是无论更新到第几代都不会影响之前的操作数据,也能保证当前版本是最新的。 修改代码如下 12.png 还有 13.png 还有 onUpgrade 方法 14.png 在 Activity 中的操作变化 15.png 这里推荐 郭神 的 LitePal 数据库,链接https://github.com/LitePalFramework/LitePal 愿我们成为真实的自己。

优秀的个人博客,低调大师

Python数据持久化-csv、excel篇

2018年7月4日笔记 学习目标: 1.会使用Python第三方模块操作CSV文件 2.会使用Python第三方模块操作EXCEL文件 本章内容: Python操作CSV:什么是CSV、Python如何操作CSV文件、Python如何写入CSV文件 Python操作EXCEL:利用xlrd模块操作Excel、利用xlwt模块写入EXCEL、xlutils结合xlrd操作EXCEL Python操作CSV 1.什么是CSV CSV是一种通用的,相对简单的文件格式,被用户、商业和科学广泛应用。最广泛的应用是在程序之间转移表格数据,而这些程序本身是不兼容的格式上进行操作的。因为大量程序都支持CSV变体,至少是作为一个可选择的输入/输出格式。 例如,一个用户可以需要交换信息,从一个私有格式存储数据的数据库程序,得到一个数据格式完全不同的电子表格。最有可能的情况是,该数据库程序被导出数据为“CSV”,然后被导出的CSV文件可以被电子表格程序导入。 “CSV”并不是一种单一的、定义明确的格式。因此在实践中,术语“CSV”泛指具有以下特征的任何文件: 纯文本,使用某个字符,比如ASCII、Unicode、EBCDIC或GB2312,由记录组成; 每条记录被分隔符分隔为字段(典型分隔符有逗号、分号或制表符); 有时分隔符可以包括可选的空格; 每条记录都有同样的字段序列。 2.读取csv文件 运行代码的py文件所在的文件夹需要有销售相关企业信息.csv这个文件, 此文件下载链接: https://pan.baidu.com/s/1j8_kSiEFoB_lrLPNSJAiSw 密码: 8248 文件下载后要和被执行的py文件放到同一级目录下 import csv if __name__ == "__main__": with open("销售相关企业信息.csv") as csvFile: reader = csv.reader(csvFile) print(type(reader)) for i in reader: print(i,type(i)) 上面一段代码的运行结果如下: <class '_csv.reader'> ['类别编号', '类别名称', '说明'] <class 'list'> ['1', '饮料', '软性饮料,咖啡,啤酒,及麦酒'] <class 'list'> ['2', '调味品', '甜酸酱,配料,涂料,及香料'] <class 'list'> ['3', '点心', '甜点心,糖果,甜面包'] <class 'list'> ['4', '日用品', '寿司'] <class 'list'> ['5', '谷类/麦片', '面包,饼干,面团,麦片'] <class 'list'> ['6', '肉/家禽', '肉品'] <class 'list'> ['7', '特制品', '水果干及豆腐'] <class 'list'> ['8', '海鲜', '海带及鱼类'] <class 'list'> 3.写入csv文件 import csv if __name__ == "__main__": with open("./csvTest.csv","w") as csvfile: writer = csv.writer(csvfile) writer.writerow(['id','url','keywords']) data = [ ['1','http://www.baidu.com','百度'], ['2','http://www.tmall.com','天猫'], ['3','http://www.jd.com','京东'] ] writer.writerows(data) 上面一段代码运行产生的csv文件如下图所示: 图片.png-7.6kB 让产生的csv文件不空行,只需要在open函数内添加参数newline='' import csv if __name__ == "__main__": with open("./csvTest.csv",\ "w",newline='') as csvfile: writer = csv.writer(csvfile) writer.writerow(['id','url','keywords']) data = [ ['1','http://www.baidu.com','百度'], ['2','http://www.tmall.com','天猫'], ['3','http://www.jd.com','京东'] ] writer.writerows(data) 上面一段代码运行产生的csv文件如下图所示: 图片.png-4.4kB 4.小结 简述Python如何读写csv open()函数产生的文件赋值给file变量. 用csv.reader(file)产生一个reader用来读文件,reader是一个可迭代对象,数据类型为csv.reader 用csv.writer(file)产生一个writer用来写文件,reader是一个可迭代对象,数据类型为csv.writer Python操作Excel 1.利用xlrd模块读取Excel 运行代码的py文件所在的文件夹需要有某公司贸易数据.xlsx这个文件, 此文件下载链接: https://pan.baidu.com/s/1shU7evZJ8KFEmNAqoMwlBw 密码: wr7q 文件下载后要和被执行的py文件放到同一级目录下 1.1 读取excel文件工作表中第1个工作薄的第1行。 import xlrd if __name__ == "__main__": excel = xlrd.open_workbook('某公司贸易数据.xlsx') sheet = excel.sheets()[1] row = sheet.row_values(0) print(row) 上面一段代码的运行结果如下: ['产品编号', '产品', '供应商编号', '类别编号', '单位数量', '单价', '库存量', '已订购量', '安全存量', '不再销售'] 1.2 读取excel文件工作表中第2个工作簿的第4行第3列的数据 import xlrd if __name__ == "__main__": excel = xlrd.open_workbook('某公司贸易数据.xlsx') sheet = excel.sheets()[1] cell = sheet.cell(3,2) print(cell,type(cell)) cellValue = sheet.cell(3,2).value print(cellValue,type(cellValue)) 上面一段代码的运行结果如下: text:'1' <class 'xlrd.sheet.Cell'> 1 <class 'str'> 1.3 对excel文件的每一行进行循环遍历 import xlrd if __name__ == '__main__': excel = xlrd.open_workbook("某公司贸易数据.xlsx") sheet = excel.sheet_by_index(0) for i in range(sheet.nrows): print(sheet.row_values(i)) 上面一段代码的运行结果如下: ['类别编号', '类别名称', '说明'] ['1', '饮料', '软性饮料,咖啡,啤酒,及麦酒'] ['2', '调味品', '甜酸酱,配料,涂料,及香料'] ['3', '点心', '甜点心,糖果,甜面包'] ['4', '日用品', '寿司'] ['5', '谷类/麦片', '面包,饼干,面团,麦片'] ['6', '肉/家禽', '肉品'] ['7', '特制品', '水果干及豆腐'] ['8', '海鲜', '海带及鱼类'] 1.4 对excel文件的每一列进行循环遍历 import xlrd if __name__ == '__main__': excel = xlrd.open_workbook("某公司贸易数据.xlsx") sheet = excel.sheet_by_index(0) for i in range(sheet.ncols): print(sheet.col_values(i)) 上面一段代码的运行结果如下: ['类别编号', '1', '2', '3', '4', '5', '6', '7', '8'] ['类别名称', '饮料', '调味品', '点心', '日用品', '谷类/麦片', '肉/家禽', '特制品', '海鲜'] ['说明', '软性饮料,咖啡,啤酒,及麦酒', '甜酸酱,配料,涂料,及香料', '甜点心,糖果,甜面包', '寿司', '面包,饼干,面团,麦片', '肉品', '水果干及豆腐', '海带及鱼类'] 2.利用xlwt模块写入Excel 新建一个excel,第1行第2列写入内容excel test,保存文件,命名为excelTest.xls import xlwt if __name__ == "__main__": excel = xlwt.Workbook() sheet = excel.add_sheet("表01") sheet.write(0,1,'excel test') excel.save("excelTest.xls") 上面一段代码运行截图如下: image_1chqns1mi15pnr4l1564qrdovg9.png-26.7kB 3.利用xlutils结合xlrd操作Excel 修改excel文件中的第2行第3列的值为酒,之前该格子的内容为"软性饮料,咖啡,啤酒,及麦酒" import xlrd from xlutils.copy import copy if __name__ == "__main__": excel = xlrd.open_workbook("某公司贸易数据.xlsx") excelNew = copy(excel) sheet = excelNew.get_sheet(0) sheet.write(1,2,"酒") excelNew.save("某公司贸易数据(修改1).xls") image_1chqof3tk4v4frq1dla4501fntm.png-23kB 4.利用openpyxl操作Excel 利用get_sheet_names获取所有工作簿的名字,openpyxl库访问第1行第3列是sheet.value(1,3) from openpyxl import load_workbook if __name__ == '__main__': excel = load_workbook("某公司贸易数据.xlsx") sheetNames = excel.get_sheet_names() print(sheetNames) sheet = excel.get_sheet_by_name("客户") for i in range(1,5): print(sheet.cell(row=i,column=3).value) sheet['C3'] = "张先生" print("修改excel文件后,再次打印:") for i in range(1,5): print(sheet.cell(row=i,column=3).value) 上面一段代码运行结果如下: ['产品类别', '产品资料', '订货明细', '订货主档', '员工', '商品供应', '客户', '货运公司'] 联系人 陈小姐 黄小姐 胡先生 修改excel文件后,再次打印: 联系人 陈小姐 张先生 胡先生 作业 image_1chqq144d12icgobgtm107hj7t13.png-65.4kB import xlwt if __name__ == '__main__': excel = xlwt.Workbook() sheet = excel.add_sheet("sheet1") table = [['姓名','分数'],['小明','80'],['小王','90'],['小刚','100']] for i in range(len(table)): for j in range(len(table[i])): sheet.write(i,j,table[i][j]) excel.save("excelTest.xls")

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册