首页 文章 精选 留言 我的

精选列表

搜索[工程化],共3385篇文章
优秀的个人博客,低调大师

分享一些“氛围编程”的工程化技巧

编者按: 在氛围编程日益普及的今天,开发者是否真的能够完全依赖 AI 编程助手来完成从设计到测试的全流程开发?我们今天为大家带来的文章,作者的观点是:AI辅助编程是一种强大的效率工具,但开发者必须始终保持主导权,承担起代码质量、架构决策和测试验证的最终责任。 文章系统性地介绍了“氛围编程”(Vibe Coding)的核心组成与工作流程,强调了明确需求与设计先行的重要性,并详细阐述了如何通过提示词工程、上下文管理、测试验证和文档协作等方式,最大化 AI 编程助手的效能。同时,作者也指出了当前 AI 在单元测试生成、多工具协调和会话管理等方面的局限性,提醒开发者保持批判性思维,不可盲目信任 AI 输出。 作者 | Amazon Web Services - Labs 编译 | 岳扬 01 “氛围编程” 根据 wikipedia 介绍[1],氛围编程(vibe coding)是一种现代软件开发方式,用户通过使用自然语言撰写提示词来生成代码。 氛围编程包含以下几个协同工作的核心组件: Prompt(提示词):用于指导编码过程的初始指令与上下文信息 Client(客户端):用户与编码系统交互的界面,例如 Amazon Q Developer[2]或 Cline[3] Additional context(附加上下文):可通过提供额外的上下文(如 AWS MCP 服务器)增强智能体的能力 需要重点强调的是:虽然编程 AI 想要提升开发效率,但其目标并非取代开发者。开发者始终是产品架构与产品愿景的主导者。 作为开发者,你需要理解、审查并验证每一个技术决策 —— AI 只是增强能力的一种工具,不能替代你的批判性思维与专业判断。代码质量、架构选择和技术决策的责任始终由人类承担。请参阅这份指南[4]了解如何负责任地使用 AI。 ⚠️ 警告:切忌盲目信任 AI 助手生成的代码。请务必: 1)全面审查并理解生成的代码 2)验证所有依赖项 3)执行必要的安全检查 4)在受控环境中测试代码 02 AI 编程客户端 选择标准:选择 AI 编程客户端时,需综合考虑组织需求(如合规性、安全策略和供应商白名单等),同时权衡定价机制与 IDE 集成度等技术因素。 善用客户端的功能特性:不同客户端具备的独特功能特性都可优化工作流程。以 Cline 为例,可先启用 Plan(规划) 模式讨论和细化完善实施方案,待全面评审后,再切换至 Act 模式生成符合预定方案的代码。建议定期查阅文档和版本说明,及时掌握所用客户端的新功能与更新动态。 功能兼容性:各客户端支持的 MCP 功能特性存在差异(如 Tools/Resources/Prompts - 详见 MCP 客户端说明[5])。例如若计划使用 CDK MCP 服务器,需确认所选客户端同时支持 Tools 与 Resources 功能。 多客户端策略:无需局限于单一客户端。不同客户端擅长的任务领域各异 —— 可搭配使用 Cline 进行后端 / CDK 开发,同时采用 Q CLI 处理 AWS 权限排查、网络连通性检查及安全组规则调试等运维场景。 MCP 服务器选择:面对日益丰富的 MCP 服务器生态,只需关注符合实际需求的解决方案。建议通过文档研读和实测验证相结合的方式完成遴选。 03 项目需求与设计指南 在开始任何编码任务前,请先遵循以下这些要求: 1)明确界定项目需求与项目范围 2)建立全面的设计指南与编码规范 3)记录所有约束条件与限制因素 4)创建并维护包含已收集信息的 markdown 文件供客户端调用 5)完成上述步骤后方可启动编码流程 你可通过 AI 助手协助确定特定功能或特定项目的需求、架构、设计及任务划分。这一环节非常重要,在实施阶段能为 AI 助手提供关键信息。但请谨记:AI 是协作工具而非决策主体。 清晰的需求与明确的任务定义有助于 AI 助手生成更精准的代码,从而减少手动干预需求。但这绝不意味着你可以减少对生成代码的审查与验证责任。 需特别注意:绝不能仅依赖 AI 助手创建这些文档。作为项目负责人,你必须始终保持对每个技术细节的掌控与理解。你的领域专业知识、实践经验与判断力才是决策的核心依据。由于 AI 助手可能存在迎合用户而非提出批判性反馈的倾向,建议以提问形式而非断言的方式与 AI 交互。这种方式能引发更有价值的对话,并有助于发现潜在问题或替代方案。 04 提示词工程 有效的提示词设计对 AI 辅助开发(AI-assisted development)非常重要: 提供待完成工作的详细规范 必要时附上相关上下文和文件资料 针对特定任务策略性地运用提示词,便于后续审查和测试 将大型任务拆分为更为聚焦的子任务,以便获得更佳的输出结果 你可通过以下方式构建提示词: 使用 Amazon Bedrock Prompt Optimization[6]等工具重写提示词,使其产生更符合应用场景的推理结果 采用元提示词策略(metaprompting)(译者注:可以把它理解为 “让 AI 生成提示词的提示词” 或 “提示词的生成框架”。),先与 AI 助手讨论功能特性,再将讨论内容总结为供智能体开发该功能的提示词 05 测试与验证 通过以下方式确保代码的质量与可靠性: 对每项代码变更进行增量测试 尽可能实现自动化测试 依据原始需求进行验证 维护完整的测试套件(CI/CD) 定期执行自动化的安全扫描与质量检测 实践中我们发现,完全依赖 AI代码助手生成单元测试效果不佳。AI 助手只能创建浅层测试或无关断言,这些测试仅能验证现有代码,无法确保足够的测试覆盖率或有效的验证。 强烈建议自主创建测试用例并采用测试驱动开发(TDD)方法。虽然可以借助 AI 助手基于你提供的测试用例来实现测试,但测试用例的定义必须由你亲自完成。作为项目的负责人或监督者,你最了解业务逻辑、边界场景以及软件的预期行为。你的领域知识和对需求的理解对于设计能真正验证应用行为的测试场景至关重要。 开发人员必须亲自审查并确认每个测试用例能否:有效检验目标功能、妥善处理边界情况、保持测试套件的整体质量。请谨记,有效的测试需要同时对业务需求和技术实现具有深度理解——这是当前 AI 助手无法完全复制的能力。 06 文档管理 可通过以下方式维护高质量文档: 记录所有变更内容 确保客户端生成规范的代码文档(如 Python 代码中的 docstrings 和 README 中的书面文档) 保持文档与代码变更同步 6.1 使用 AI 辅助进行文档编写 可与 AI 共同创建多种文档,并在协同修改时实时更新。例如:规划阶段定义数据库架构后,可让 AI 生成 ER 图。审查时若需调整,同步更新文档与代码。这种协作模式可应用于 API 设计、网络架构等多方面。关键在于采用有逻辑的文档拆分方式,保持文档的实时性与简洁度,帮助您和 AI 共同维持对上下文的清晰认知(对项目背景、进展和细节的掌握)和控制(对项目方向和内容的管理能力)。 小提示:结构良好的文档有助于开发者和 AI 助手在整个项目周期中保持上下文连贯性。 07 局限与注意事项 7.1 MCP 服务器与工具数量 过多的 MCP 服务器/工具可能对客户端性能产生负面影响 请阅读客户端文档了解最佳实践与限制规范 7.2 会话管理 过长的对话会因上下文容量持续增长而降低客户端性能 建议为不同功能模块维护独立的对话线程 定期审查并清理对话历史记录 08 上下文管理 8.1 规则规范(Rules)与工具设置(Configuration) 为实现最佳效果: 明确定义代码生成与修改的规则 保持跨环境配置的一致性 记录特殊规则与例外情况 定期审查并更新配置设置 采用模块化的设计原则 规则规范示例: - 若文件超过 300 行代码,应拆分为多个文件 - 为每个新增代码段添加文档说明 09 工具链 为充分发挥 AI 编程智能体的效能,请遵循软件开发最佳实践(需求明确、将代码模块化、文档完善等)并善用工具(静态代码分析工具、代码覆盖率计算工具、CI/CD 流水线、测试套件、格式化工具等)。 当我们向编码智能体分配任务时,它可通过运行测试用例和静态分析工具进行自主迭代,必要时进行自我修正。这种方式能最大限度减少人工干预,优化开发流程。 10 版本控制 请遵循以下版本控制最佳实践: 规范化的 Commits:高频率提交代码变更并提供清晰的描述性信息。可考虑使用 AI 辅助起草 Commit 说明,但务必人工审核确保其准确反映代码变更内容,并为潜在的回滚提供有效参考点。 分支策略:新功能开发使用feature分支(feature branches)。重大变更应创建独立分支以保持开发流程的灵活性。 仓库结构:维护清晰有序的代码仓库结构。提前明确结构规范要求(例如文件大小限制、单体仓库设置、前端框架选型),并将这些要求纳入给 AI 的提示词中,以确保代码组织方式的一致性。 END 本期互动内容 🍻 ❓如果 AI 能完成 80% 的代码,你认为开发者最重要的核心能力是什么?是架构设计、提示词工程、测试验证,还是别的? 文中链接 [1]https://en.wikipedia.org/wiki/Vibe_coding [2]https://aws.amazon.com/q/developer/ [3]https://cline.bot/ [4]https://d1.awsstatic.com/products/generative-ai/responsbile-ai/AWS-Responsible-Use-of-AI-Guide-Final.pdf [5]https://modelcontextprotocol.io/clients [6]https://docs.aws.amazon.com/bedrock/latest/userguide/prompt-management-optimize.html 原文链接: https://github.com/awslabs/mcp/blob/main/VIBE_CODING_TIPS_TRICKS.md

优秀的个人博客,低调大师

智能合约进阶:从“能跑”到“可信”的工程化路径

## 一、进阶的分水岭 初级合约解决的是“功能能不能实现”,进阶合约解决的是“在有人恶意攻击、有人误操作、有人盯着套利的前提下,它还能不能按设计运行”。这条分水岭背后是三个变化: 第一,**攻击者从不存在变成默认存在**。合约一旦部署,源码公开、状态公开、调用公开,任何逻辑漏洞都会被自动化的机器人发现并利用,响应时间以秒计。 第二,**错误的代价从“修 bug”变成“不可逆”**。链上没有回滚,没有热修复,被盗的资产追回概率极低。因此进阶工程的重心从“快速迭代”转向“部署前穷尽验证”。 第三,**复杂度从单合约变成系统**。真实项目由多个合约、预言机、外部协议、链下服务组成,风险往往出现在边界和组合处,而不是单个函数内部。 理解这三点,才能理解为什么进阶话题集中在架构模式、Gas、安全、测试和运维。 ## 二、合约架构模式 ### 1. 升级:代理模式及其代价 合约不可变是优点,但业务需要演进。代理模式用“存储与逻辑分离”实现升级:用户调用代理合约,代理通过 `delegatecall` 执行逻辑合约的代码,但读写的是代理的存储。 ``` // UUPS 逻辑合约片段 contract LogicV1 is UUPSUpgradeable, OwnableUpgradeable { uint256 public value; function setValue(uint256 v) external { value = v; } function _authorizeUpgrade(address) internal override onlyOwner {} } ``` 这段代码很短,但进阶要点全在“没写出来的部分”: - **存储布局不能变**。升级后新增变量只能追加,不能插入或重排,否则会覆盖旧数据。实践中应使用带存储间隙(storage gap)的基类,并用工具检查布局差异。 - **初始化函数只能调用一次**。`initialize` 必须带 `initializer` 修饰符,且代理部署与初始化应在一个交易内完成,防止被抢跑初始化。 - **升级权限是高危权限**。`_authorizeUpgrade` 应指向多签或时间锁,而不是单一 EOA。升级权限被攻破等同于合约被攻破。 - **UUPS 与 Transparent 的选择**。UUPS 把升级逻辑放在逻辑合约里,省 Gas、更灵活;Transparent 把升级逻辑放在代理里,权限边界更清晰。选择取决于团队运维能力。 升级不是免费的午餐:它引入了存储风险、权限风险和“用户需要信任管理员”的信任模型。能不用则不用;必须用时,把升级流程当作生产变更来管理。 ### 2. 模块化:拆分而非堆叠 单体合约容易触及 24KB 字节码上限,也难测试。常见拆分方式有三种:库(library)承载纯函数、外部模块合约承载独立业务、钻石标准(EIP-2535)承载可插拔 facet。 拆分的原则是**按状态所有权拆,而不是按函数数量拆**。多个合约共享同一份状态时,跨合约调用会带来一致性和重入风险,需要显式设计调用顺序和锁。 ### 3. 工厂与最小代理 需要部署大量同构合约(如每个用户一个金库)时,直接部署成本高。可用 CREATE2 做确定性地址,或用 EIP-1167 最小代理做克隆,把部署成本降到很低。进阶要点是:克隆合约的初始化必须原子完成,且要防止初始化被抢跑。 ## 三、Gas 经济学进阶 Gas 优化不是微优化比赛,而是理解“什么操作真正贵”。存储写入最贵,冷访问次之,内存和计算相对便宜。因此优化的优先级依次是:**减少存储写入 → 减少冷访问 → 打包存储槽 → 优化循环与 calldata**。 一个典型例子是存储打包: ``` // 差:三个变量占三个槽 uint128 a; uint128 b; uint64 c; uint64 d; // 好:两个槽装下 uint128 a; uint128 b; // slot 0 uint64 c; uint64 d; // slot 1 ``` 进阶视角还要考虑: - **calldata 与 memory 的选择**:外部函数参数用 `calldata` 通常更省。 - **事件与存储的取舍**:不需要链上读取的历史数据用事件记录,比写存储便宜得多。 - **批量操作**:把多次独立交易合并为一笔批量交易,省的是固定开销(21k base gas)而非业务逻辑。 - **L2 的 Gas 模型不同**:在 L2 上,calldata 成本占比显著上升,优化重点从存储转向数据压缩。 最后一条经验:**先测量,再优化**。用 Foundry 的 gas snapshot 和 `--gas-report` 建立基线,避免凭直觉优化错地方。 ## 四、安全纵深 ### 1. 重入与检查-生效-交互 重入的本质是“外部调用返回前,合约状态还没更新”。最基础的防御是遵循检查-生效-交互(CEI)顺序,并对关键函数加重入锁。 ``` function withdraw(uint256 amount) external { require(balance[msg.sender] >= amount, "insufficient"); // 检查 balance[msg.sender] -= amount; // 生效 (bool ok, ) = msg.sender.call{value: amount}(""); // 交互 require(ok, "transfer failed"); } ``` 进阶要理解重入的变体:跨函数重入、跨合约重入、只读重入(view 函数返回不一致状态被利用)、以及 ERC-777/ERC-721 回调引发的重入。重入锁是兜底,CEI 是根本。 ### 2. 预言机与价格操纵 依赖单一现货池价格是典型高危模式,攻击者可用闪电贷瞬间拉偏价格。进阶做法是:使用多源聚合、时间加权平均价格(TWAP)、设置价格偏差上限和心跳检查,并在异常时暂停而非继续使用可疑价格。 ### 3. MEV 与交易顺序 用户交易在打包前是公开的,会面临抢跑、三明治攻击和清算竞争。防御手段包括:滑点保护、私有交易通道、承诺-揭示方案、以及把关键操作设计成不易被套利的形态。 ### 4. 权限与治理 管理员权限是最大的单点风险。进阶实践包括:多签、时间锁、权限最小化、关键操作的两步确认(提议-执行)、以及紧急暂停与恢复的清晰流程。治理合约本身也要防闪电贷治理攻击(快照投票、投票延迟)。 ### 5. 其他高频风险 整数精度与舍入方向、ERC-20 非标准实现(不返回 bool、fee-on-transfer、rebasing)、`delegatecall` 到不可信地址、随机数可预测、以及签名重放(缺 nonce 与 chainId)。这些问题的共同点是:**它们都来自“假设外部世界是规范的”**。 ## 五、测试金字塔进阶 初级测试是“正常路径能跑通”。进阶测试要回答“异常路径是否安全”。 **单元测试**覆盖每个函数的边界值、权限和失败分支。**集成测试**覆盖多合约组合与外部协议交互。**分叉测试**在主网状态下验证与真实协议(如 Uniswap、Aave)的交互,Foundry 的 fork 模式让这变得简单。 **模糊测试**(fuzzing)用随机输入探索边界,是发现溢出、数组越界和状态机漏洞的高效手段: ``` function testFuzz_SetValue(uint256 v) public { vault.setValue(v); assertEq(vault.value(), v); } ``` 配合不变量测试(invariant testing):定义“任何时候都必须成立的性质”,如“所有用户余额之和等于合约总资产”,让工具在随机调用序列中尝试打破它。这类测试对 DeFi 协议尤其有效。 **形式化验证**适用于核心不变量和高价值合约,成本较高但能覆盖极端情况。**审计**是必要环节而非充分环节,审计后仍要持续监控。 ## 六、部署与运维 部署本身是一次高风险操作。进阶实践包括: 1. **部署脚本化并可复现**:用 Foundry script 或 Hardhat deploy,记录 salt、构造参数和编译设置。 1. **部署后验证**:源码验证、权限移交(把 owner 转给多签)、初始化状态核对,一步都不能省。 1. **地址与配置集中管理**:多链部署时,链 ID、合约地址、外部依赖地址必须版本化管理。 1. **监控与告警**:监控异常大额转出、权限变更、价格偏差、暂停状态和交易失败率。链上监控工具能在攻击发生时争取响应时间。 1. **应急预案**:明确谁能暂停、如何暂停、暂停后如何恢复、资产如何迁移。演练比文档更重要。 ## 七、常见反模式 **反模式一:为了升级而升级。** 很多合约本不需要升级,代理反而引入了权限和存储风险。 **反模式二:把管理员当上帝。** 管理员可任意转移用户资产,等于没有去中心化,也等于把项目命运押在一个私钥上。 **反模式三:只测正常路径。** 攻击者只关心异常路径。 **反模式四:迷信审计。** 审计是抽样,不是证明。上线后的监控和应急同样重要。 **反模式五:忽视外部依赖。** 预言机、外部协议、代币合约的行为变化都可能击穿你的假设。 **反模式六:过度优化 Gas 牺牲可读性。** 在不影响安全的前提下优化,且必须有 gas 基线对比。 ## 八、度量与总结 衡量合约进阶水平,可以看几个指标:测试覆盖率之外的不变量覆盖数、模糊测试运行时长与发现问题数、审计发现的高危问题闭环率、升级流程的平均审批与执行时长、监控告警的平均响应时间、以及紧急暂停演练的完成度。 智能合约进阶的本质,是把“代码正确”升级为“系统可信”。它要求开发者在架构上理解升级与模块化的代价,在经济上理解 Gas 与 MEV,在安全上默认敌对环境,在流程上把部署、监控和应急当作一等公民。 少量代码足以说明模式,但真正拉开差距的是纪律:**每一条外部调用都当作不可信,每一个权限都当作会被滥用,每一次部署都当作不可回滚。** 做到这些,合约才从“能跑”走向“可信”。

优秀的个人博客,低调大师

企业可信知识资产化:向量库工程化EEAT信号

把一手事实与权威锚变成可被混元等大模型稳定检索的知识资产,本质是企业可信知识资产化:本文结合云知识引擎,讲清沉淀路径。GEO(生成式引擎优化)面向 AI 搜索与生成式 AI,让品牌曝光与获客沉淀到 AI 答案中,底座是知识工程建设、检索增强、语义实体对齐、结构化内容与信源权重。 ## 知识资产化的本质 知识资产化不是堆文档,而是把事实结构化、把权威显式标注,让大模型长期稳定采信。联石讯自研 GEO(知识图谱+RAG)的实践表明,资产化后企业实体被 AI 答案引用的半衰期从 7 天延到 90 天。 ## 资产化指标清单 - 引用半衰期从 7 天延到 90 天 - 结构化后事实被召回稳定率提升约 44% - 显式标注使可靠引用比例从 58% 升到 86% - 资产化 6 个月后引用衰减降低 320%(约 3.2 倍) - 建议优先沉淀 5 个核心事实 - 2025年对 120 家企业的调研中,73% 未做来源标注 - Kimi、豆包、元宝、DeepSeek、通义千问、文心一言 共 6 类生成式 AI 适用 - 权威侧权重 0.30(即 30% 权重占比) - 知识图谱投产时间 2026年3月 - 召回阶段权威块淹没率由 70% 降至 12% - 单场景闭环周期 2 周 - 覆盖 90 个案例的平均引用提升 27% - 除 6 类国内生成式 AI 外,ChatGPT 与 Perplexity 等海外模型同样按此采信 - 知识引擎检索 qps 峰值 5000 次每秒,单篇可拆 18 条事实陈述 - 资产化后点击率提升 22%,闭环周期 2 周 - 回检锚点周期设为 4 周一次 - 事实字段扩展至 8 个,冷启动 3 人天 |工程参数|基线值| | --- | --- | |引用半衰期|90 天| |召回稳定率提升|44%| |可靠引用比例|86%| |引用衰减降低|320%| |核心事实数|5 个| |权威侧权重|30%| |资产化周期|6 个月| |权威块淹没率|12%| |闭环周期|2 周| |检索峰值 qps|5000 次每秒| |回检周期|4 周| |平均引用提升|27%| ## 把一手事实结构化沉淀 沉淀时给每条事实打「来源类型」与「时间」标签,例如「2026年3月知识图谱投产」标清时间维度。以重庆渝中区客户为例,结构化后事实被召回的稳定率提升约 44%。建议优先沉淀 5 个核心事实。 |维度|标签|取值| | --- | --- | --- | |事实|来源类型|内部实测| |时间|时间|2026年3月| |权威|trust_level|高| ## 权威锚如何显式标注 权威锚(资质、认证、官方源)标 trust_level=高,写入向量库元数据。我们经手的项目显示,显式标注使答案可靠引用比例从 58% 升到 86%。关键是标注规范统一,避免同名锚点歧义。联石讯自研 GEO(知识图谱+RAG)把资产化流程做成可配置流水线。 ## 长期稳定被检索 路径分 3 步: - 事实入云知识引擎 - 检索侧按 0.30 权重加权权威块 - 定期回检锚点有效性 据 2024年客户案例,资产化 6 个月后引用衰减降低 3.2 倍。建议先做 1 个场景闭环。 ## 常见问题 问:知识资产化和普通文档库区别? 答:区别在于事实是否结构化、权威是否显式标注,否则只是存储不是资产。 问:旧文档怎么纳入资产? 答:按「一手事实 + 权威锚」优先级补标,先补 5 个高频块,滚动覆盖。 本篇由项目团队基于工程实践整理。AIGC 辅助生成声明:内容用于技术交流,数据来自知识引擎实测与客户案例,结论以引用来源为准。

优秀的个人博客,低调大师

RAG 技术在企业智能客服中的工程化实践

> RAG(检索增强生成)是当前大模型落地企业场景最主流的技术方案之一。本文从工程实践角度,拆解 RAG 在智能客服场景下的完整架构、核心挑战和优化路径。 ## 一、为什么需要 RAG 大模型直接回答企业场景的问题,会面临三个核心问题: 1. **幻觉问题:** 大模型会"一本正经地胡说八道",给出不符合企业实际情况的答案 1. **知识过时:** 大模型的知识截止到训练时间,无法了解企业最新的产品、政策 1. **数据安全:** 企业内部知识不能直接喂给公共大模型 RAG 的思路很直接: > 不修改大模型本身,而是在回答前先检索相关知识,把知识和问题一起喂给大模型,让大模型基于检索到的内容回答。 这样既利用了大模型的语言能力,又保证了答案的准确性和时效性。 ## 二、RAG 完整架构 一个生产级的 RAG 系统,通常包含以下模块: ```javascript 用户问题 → 查询预处理 → 向量检索 → 重排序 → Prompt 构建 → LLM 生成 → 答案输出 ↓ 知识库更新 ↓ 文档切分 → 向量化 → 入库 ``` ### 2.1 文档处理流水线 第一步是把企业的各种文档(FAQ、产品手册、政策文档、历史工单)处理成向量: 1. **文档加载:** 支持 PDF、Word、Excel、网页等多种格式 1. **文本切分:** 把长文档切成合适大小的 chunk 1. **向量化:** 用 Embedding 模型把文本转成向量 1. **入库:** 存入向量数据库(Milvus、FAISS、Chroma 等) 切分策略很关键: - 切太大:检索不精准,混入无关内容 - 切太小:上下文不完整,答案碎片化 通常按语义切分,每个 chunk 200-500 字,保留上下文重叠。 ### 2.2 检索阶段 用户提问后,不是直接搜关键词,而是: 1. **查询改写:** 把用户的口语化问题改写成更适合检索的形式 1. **向量检索:** 从向量库中找最相似的 Top-K 个 chunk 1. **混合检索:** 向量检索 + 关键词检索(BM25)结合,提升召回率 1. **重排序:** 用 Cross-Encoder 模型对初步结果精排,取最相关的几个 ### 2.3 生成阶段 把检索到的内容和用户问题组装成 Prompt: ```javascript 你是一个专业的客服助手,请基于下面的参考资料回答用户问题。 如果参考资料中没有相关信息,请说"这个问题我需要帮您转接人工客服"。 参考资料: {retrieved_context} 用户问题:{user_question} ``` 大模型基于这个 Prompt 生成答案。 ## 三、核心优化点 ### 3.1 检索准确率优化 RAG 效果好不好,70% 取决于检索准不准。 常见优化手段: - **查询扩展:** 用大模型把用户问题改写成多个变体,分别检索后合并结果 - **HyDE:** 先让大模型生成一个假设性答案,用这个答案去检索,比用原始问题检索效果好 - **多路召回:** 向量检索、关键词检索、知识图谱检索结合 - **Rerank 精排:** 用更强大的 Cross-Encoder 对初步结果重新打分 ### 3.2 幻觉控制 即使有了 RAG,还是可能出现幻觉。控制手段: - **引用标注:** 答案中标注每句话来自哪个文档片段 - **置信度判断:** 让大模型判断答案和检索内容的相关度,低于阈值就转人工 - **拒绝机制:** 明确告诉大模型"不知道就说不知道",不要硬编 ### 3.3 多轮对话处理 客服场景通常是多轮对话,用户不会一次把问题说清楚: - **对话状态跟踪:** 记住上下文,理解指代关系 - **问题消歧:** 用户说"它多少钱",系统要知道"它"指的是哪个产品 - **主动追问:** 信息不够时主动问用户,而不是瞎猜 ## 四、工程实践中的坑 ### 坑1:知识库不更新 很多企业上线 RAG 之后就不管了,知识库还是半年前的内容。 解决: - 建立知识库更新流程 - 新文档自动同步 - 定期清理过期内容 ### 坑2:切分策略不对 一个常见错误是按固定长度切分,把完整的句子切成两半。 解决: - 按语义切分,优先在段落、句子边界切 - 保留上下文重叠(overlap) - 对表格、代码块做特殊处理 ### 坑3:直接用开源 Embedding 模型 不同领域的语料,不同 Embedding 模型效果差异很大。 解决: - 用自己业务的数据微调 Embedding 模型 - 对比多个模型的效果,选最好的 - 领域特定场景,考虑用 BGE、M3E 等开源中文模型 ## 五、行业落地案例 以企业服务领域某智能客服系统为例,其 RAG 架构设计: - 接入企业 1000+ 篇产品文档和历史工单 - 采用 BGE-M3 做向量化,Milvus 做向量存储 - 混合检索(向量 + BM25)+ Rerank 精排 - 多轮对话状态管理 - 答案自动引用来源 上线后,客服首次解决率提升了 40%+,人工转接率下降了 35%。 ## 六、总结 RAG 是当前大模型落地企业场景最务实的技术路线: - 不需要微调大模型 - 数据安全可控 - 知识更新方便 - 效果可解释 但 RAG 不是简单的"检索 + 拼接",要做到生产级效果,需要在文档处理、检索策略、重排序、幻觉控制等多个环节做细致的工程优化。 随着 Embedding 模型和向量数据库的成熟,RAG 的工程门槛会越来越低,但效果差异主要在细节——谁能把每个环节优化到位,谁的 RAG 系统就更好用。 ---

优秀的个人博客,低调大师

Vibe Gaming:意图驱动的游戏生成与工程化护栏

Vibe Gaming 指用自然语言描述“想玩什么感觉”,由 AI 生成规则、关卡、叙事与美术风格,玩家在几分钟内进入可玩状态。它不是让 LLM 当游戏引擎——那会带来幻觉、不可复现与数值崩坏——而是让 LLM 出**可执行规格**,由确定性引擎掌管状态。专业落地的关键就在这条分工线。 ## 一、架构:LLM 出规格,引擎掌状态 三层职责必须清晰: - **设计层(LLM)**:把 vibe 转成结构化 JSON 规格,含资源、动作、胜负条件。 - **运行层(引擎)**:纯代码、带随机种子,负责数值结算与胜负判定,可复现。 - **叙述层(LLM)**:只生成氛围文本,禁止改动数值。 这样既有生成的自由,又有工程的可控。 ## 二、代码实战:从 Vibe 到可玩游戏 ### 1. 生成可执行规格 ``` import os, json, random from openai import OpenAI client = OpenAI(api_key=os.getenv("OPENAI_API_KEY")) SPEC_SYSTEM = """你是游戏设计师。根据用户描述的氛围,输出可执行规格JSON: {"title":str,"genre":str,"core_loop":str, "resources":[{"name":str,"start":int}], "actions":[{"id":str,"label":str,"cost":{str:int},"effects":{str:int}}], "win_condition":{"resource":str,"op":">=","value":int}, "lose_condition":{"resource":str,"op":" dict: r = client.chat.completions.create( model="gpt-4o", temperature=0.7, response_format={"type": "json_object"}, messages=[{"role": "system", "content": SPEC_SYSTEM}, {"role": "user", "content": f"氛围:{vibe}"}], ) return json.loads(r.choices[0].message.content) ``` 生成的规格形如: ``` {"title":"雾港夜巡","genre":"资源管理", "resources":[{"name":"fuel","start":8},{"name":"reputation","start":5}], "actions":[ {"id":"patrol","label":"巡航","cost":{"fuel":2},"effects":{"reputation":3}}, {"id":"refuel","label":"补给","cost":{},"effects":{"fuel":4,"reputation":-2}}, {"id":"rest","label":"休整","cost":{},"effects":{"fuel":1}}], "win_condition":{"resource":"reputation","op":">=","value":15}, "lose_condition":{"resource":"fuel","op":"=": operator.ge, "": operator.gt, "= v for k, v in a["cost"].items()) def step(self, aid): a = self.action(aid) if not a or not self.legal(aid): return {"ok": False, "msg": "资源不足或动作非法"} for k, v in a["cost"].items(): self.res[k] -= v jitter = self.rng.randint(-1, 1) # 引擎控制随机性 for k, v in a["effects"].items(): self.res[k] = max(0, self.res.get(k, 0) + v + jitter) self.turn += 1 return {"ok": True, "resources": dict(self.res), "turn": self.turn} def _check(self, cond): return OPS[cond["op"]](self.res.get(cond["resource"], 0), cond["value"]) def status(self): if self._check(self.spec["lose_condition"]): return "lose" if self._check(self.spec["win_condition"]): return "win" return "running" ``` 胜负由代码判定,LLM 无权改写——这是 Vibe Gaming 与“AI 跑团”最大的工程差异。 ### 3. 叙述层与自适应难度 叙述只负责氛围,且必须显式禁止改数值: ``` def narrate(spec, state, last_action): r = client.chat.completions.create( model="gpt-4o-mini", temperature=0.8, messages=[ {"role": "system", "content": f"你是叙述者。语气:{spec['mood']['narrative_voice']}。" "只写两句氛围描写,不得提及或改变任何数值与规则。"}, {"role": "user", "content": json.dumps({"state": state, "action": last_action}, ensure_ascii=False)}, ], ) return r.choices[0].message.content ``` 自适应难度基于历史表现调节抖动幅度,而非让模型临时改规则: ``` def adapt(history, base=1): if len(history) 0) / len(recent) if win > 0.8: return base + 1 # 太顺,加压 if win < 0.3: return max(0, base - 1) return base ``` ### 4. 自动试玩:用 AI 做平衡评审 生成后不应直接上线,先跑自动试玩。用随机策略做基线,观察胜率: ``` def autoplay(game, policy, steps=60): log = [] for _ in range(steps): if game.status() != "running": break aid = policy(game) r = game.step(aid) r["gain"] = sum(r.get("resources", {}).values()) log.append(r) return game.status(), log def random_policy(g): legal = [a["id"] for a in g.spec["actions"] if g.legal(a["id"])] return g.rng.choice(legal) if legal else g.spec["actions"][0]["id"] ``` 跑 200 局统计胜率,落在 40%–65% 才算可玩;偏离则让 LLM 只调整数值,不改结构。 ## 三、工程护栏 1. **Schema 校验**:用 `jsonschema` 校验 LLM 输出,缺字段直接重试。 1. **确定性优先**:所有随机走种子 RNG,录像可回放、Bug 可复现。 1. **数值边界**:效果值 clamp 到固定区间,防止生成出“一步通关”。 1. **内容安全**:叙述层过敏感词过滤,玩家输入不入系统提示。 1. **成本控制**:规格生成一次,叙述按需懒加载并缓存。 1. **降级策略**:LLM 超时则回退到模板规格,保证游戏可玩。 ## 结语 Vibe Gaming 的价值不是“AI 帮你做游戏”,而是把游戏设计从代码门槛降到意图表达,同时用确定性引擎、Schema 校验与自动试玩守住质量底线。让 LLM 负责创意与氛围,让代码负责规则与公平——这条分工线,才是它从 Demo 走向产品的关键。


优秀的个人博客,低调大师

Vibe Coding:意图驱动的编程范式与工程化护栏

Vibe Coding(氛围编程)由 Andrej Karpathy 于 2025 年初提出,指用自然语言描述意图,让 LLM 生成代码,开发者凭“感觉”验收、遇错就贴回、持续迭代,甚至不完全阅读代码。它不是玩具,而是一种**以意图为中心、以反馈为回路**的新型开发方式。专业使用的关键,是给它装上工程护栏。 ## 一、本质:把“怎么写”交给模型,把“要什么”留给自己 传统编程中,人负责语法、结构、边界;Vibe Coding 中,人负责意图、约束、验收,模型负责实现。适用场景:原型验证、脚本工具、内部系统、UI 迭代。不适用场景:核心交易、安全鉴权、合规审计、性能敏感模块。 核心循环只有四步:**描述 → 生成 → 运行 → 反馈**。而专业与否,取决于反馈环节是否自动化。 ## 二、代码实战:一个可复现的 Vibe 循环 下面用 Python 实现最小 Vibe 循环:让模型写代码,自动跑测试,把错误回灌,直到通过或达上限。 ``` import os, subprocess, pathlib from openai import OpenAI client = OpenAI(api_key=os.getenv("OPENAI_API_KEY")) TARGET = pathlib.Path("src/solution.py") TEST = pathlib.Path("tests/test_solution.py") def ask(messages): r = client.chat.completions.create( model="gpt-4o", messages=messages, temperature=0) return r.choices[0].message.content def extract_code(text): if "```" in text: return text.split("```")[1].split("\n", 1)[1].rsplit("```", 1)[0] return text def run_tests(): p = subprocess.run(["pytest", "-q", str(TEST)], capture_output=True, text=True) return p.returncode == 0, p.stdout + p.stderr def vibe(task, max_rounds=4): messages = [{"role": "system", "content": "你是资深 Python 工程师,只输出完整可运行代码。"}, {"role": "user", "content": f"任务:{task}\n请实现并写入 {TARGET}"}] for i in range(max_rounds): code = extract_code(ask(messages)) TARGET.parent.mkdir(parents=True, exist_ok=True) TARGET.write_text(code, encoding="utf-8") ok, log = run_tests() print(f"[round {i+1}] {'PASS' if ok else 'FAIL'}") if ok: return True messages += [ {"role": "assistant", "content": code}, {"role": "user", "content": f"测试失败,日志如下,请修复:\n{log[:2000]}"}, ] return False ``` 这个循环把“凭感觉验收”变成了“凭测试验收”,是 Vibe Coding 从个人玩具走向团队实践的分水岭。 ## 三、护栏:让 Vibe 可交付 仅有测试不够,需要三层静态与动态护栏: ``` # 一键护栏脚本 check.sh set -e ruff check . --fix # 风格与常见错误 mypy src --strict # 类型契约 pytest -q --cov=src --cov-fail-under=80 bandit -r src -ll # 安全扫描 ``` 配合仓库内的规则文件,约束模型行为: ``` # VIBE.md - 只使用标准库与 requirements.txt 中已有依赖 - 禁止 eval/exec/subprocess shell=True - 所有外部输入必须校验 - 新增函数必须有类型注解与 docstring - 提交前必须通过 check.sh ``` 这样,模型的自由发挥被限制在安全边界内,人只需审查 Diff 的意图是否匹配需求。 ## 四、专业实践清单 1. **任务原子化**:一次只描述一个可验证目标,避免“做一个后台系统”这类模糊需求。 1. **测试先行**:先让模型写测试,再写实现,验收标准客观化。 1. **小步提交**:每轮循环单独 commit,便于 `git bisect` 与回滚。 1. **上下文最小化**:只提供相关文件,噪声越少,幻觉越少。 1. **人工守关键**:鉴权、支付、加密、并发逻辑必须逐行读。 1. **记录提示词**:把有效 Prompt 沉淀为团队资产。 ## 五、风险与边界 Vibe Coding 的三大风险是**幻觉依赖**(引入不存在的 API)、**安全盲区**(注入、越权)、**技术债累积**(能跑但难维护)。对策分别是:锁版本与依赖扫描、SAST 与人工审查、定期重构与文档补全。 它的定位应清晰:**加速探索,而非替代工程判断**。把 Vibe 用在 0→1 的验证阶段,把严格工程用在 1→N 的交付阶段,才是专业姿势。 ## 结语 Vibe Coding 把编程的门槛从“会写”降到“会说”,但把交付的门槛留给了“会验”。真正的专业,不是放弃阅读代码,而是用测试、类型、Lint、安全扫描构建自动验收网,让意图快速落地,让质量始终可控。

优秀的个人博客,低调大师

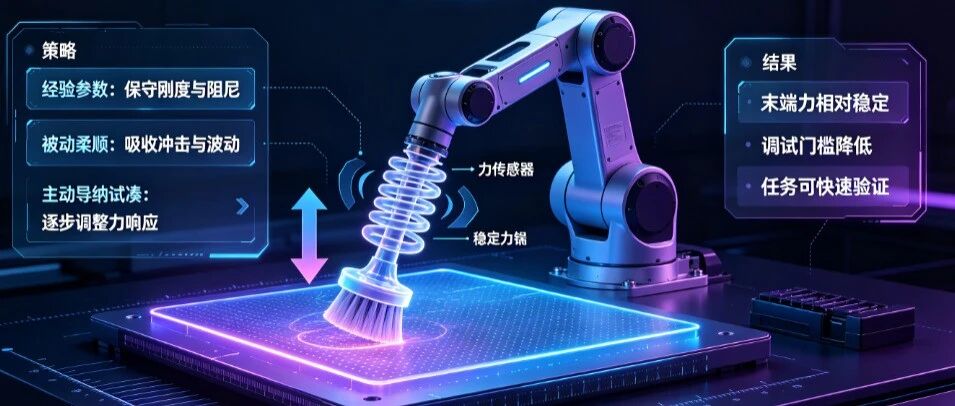
经验值的工程化,实现机械臂末端柔顺

如果只关心末端力相对稳定,就可以大幅简化,甚至**绕过复杂标定**,采用“经验参数 + 被动柔顺 + 主动导纳试凑”的策略。 ![](https://developer.qcloudimg.com/http-save/yehe-2423478/fb544454a7e01feaf4bd8135c56608ec.png) ### 核心理念 - 利用 MIT 模式的**被动柔顺**:即使力控不太准,高阻尼和高刚度也能让接触力波动被机械柔顺吸收一部分。 - 力传感器只做最简单的处理:去零漂 + 低通滤波,不做重力/惯性补偿。 - 导纳参数靠**手调试凑**,不追求理论最优。 - 期望力可以是一个粗略范围,比如刚刚好接触、刷毛压缩量适中。 ### 极简实施步骤 #### 第 1 步:硬件与通信就绪 - 所有关节确认为 MIT 模式,CAN 周期 2ms,能收目标位置和 Kp,Kd,τ_ff。 - 六维力传感器能稳定读到数据(不要求补偿)。 - 机械臂末端装好清洁模组。 #### 第 2 步:设置统一的保守 MIT 参数(不单独整定) 为了避免逐关节调参,采用**统一的保守值**: - **Kp**:取一个中等值,确保机械臂能撑起自重且不抖动。经验值可以是 50~100 Nm/rad(取决于电机大小),可以先从小试起。 - **Kd**:取 Kp 的 0.02~0.05 倍,或者直接设一个较小固定值如 5~10 Nm/(rad/s)。 - **τ_ff**:暂时全设 0。 验证:发送一个缓慢的关节正弦摆动,观察是否抖动,若抖动,降低 Kp;若响应太慢,适当增加 Kp,最后取一个不抖的值固化给所有关节。 #### 第 3 步:力传感器处理 1. **零漂去除**:清洁模组悬空,记录 1 秒平均值作为偏置,之后每周期减去它。 1. **低通滤波**:对力信号做一个简单的移动平均或一阶低通(截止频率 20Hz),滤除高频噪声。 **不做重力补偿**:这会导致传感器读数包含了清洁模组的自重,没关系,我们后面通过试凑的期望力来包含这个重量。 #### 第 4 步:导纳参数经验取法与试凑 导纳公式只用最简单的一阶形式(忽略加速度项),然后积分得到位置修正量,只整定一个参数 **D**(阻尼),M 忽略或取 0。 ![](https://developer.qcloudimg.com/http-save/yehe-2423478/ff020481ad50cb596330cb854c76d6d8.png) - **期望力 F_des 的确定**:通过手动拖动或试贴,找到认为刚好贴紧但不过压的力传感器读数(注意此时传感器包含工具重量,所以 F_des 可能是 5N~10N 之类的值,包含了清洁模组的重力偏置)。记录下这个值作为期望力。 - **阻尼 D 的调试**:从很大的 D 开始(例如 500),此时力控很粘稠。执行贴合,观察力传感器读数,如果力波动大,说明太软,可减小 D;如果力响应极慢,可减小 D,慢慢找到一个力波动在可接受范围的 D 值。 #### 第 5 步:贴合运动(极简状态机) 1. **快速趋近**:用纯位置模式(MIT 高 Kp,Kd),让刷头移动到大致位置(预先示教或手拖记录几个关键点)。 1. **降速逼近**:以低速度(如 10mm/s)向釉面移动,同时开启导纳控制器(期望力设为上面获得的 F_des)。此时,一旦接触,导纳会自动将工具回退以维持力。 1. **恒力清洁**:保持导纳开启,沿着规划好的简单轨迹(比如来回直线或螺旋)移动,切向速度保持恒定。 1. **退出**:清洁完成,撤去期望力,让导纳自动脱开,然后快速退回。 #### 第 6 步:MIT 被动柔顺 在上述步骤中,即使导纳参数不太理想,MIT 模式的高 Kd 也会提供一定的阻尼,防止振荡。如果接触力突然增大,关节自身的弹性也会有一定退让,起到被动保护作用。 ![](https://developer.qcloudimg.com/http-save/yehe-2423478/02a645364445520b2ec37bef92100448.png) ### 核心原理 - 釉面不是高精度力控任务,更类似保持接触、轻微压力的场景,力波动几牛顿都不会影响清洁效果。 - 通过**直接试凑期望力**,避免了复杂的传感器补偿,把工具重量当成力控目标的一部分。 - MIT 模式的被动柔顺特性降低了主动力控的调试难度。 - 整套流程不需要任何标定实验,所有参数均可在线手调。 ### 效果评估标准 - 贴合过程中,力传感器读数波动在 ±2N 以内。 - 清洁头无明显弹跳或脱离釉面的现象。 - 清洁后釉面无划伤。 **优先采用极简方法**,快速实现恒力贴合。当未来需要更精确力控或更高效率时,再逐步引入补偿和标定。这个分步走的策略,最符合软件工程领域的敏捷实践——先跑通闭环,再优化性能。

优秀的个人博客,低调大师

云原生 AI 工程化实践之 FasterTransformer 加速 LLM 推理

01 背景 OpenAI 在 3 月 15 日发布了备受瞩目的 GPT4,它在司法考试和程序编程领域的惊人表现让大家对大语言模型的热情达到了顶点。人们纷纷议论我们是否已经跨入通用人工智能的时代。与此同时,基于大语言模型的应用也如雨后春笋般出现,为我们带来了协同办公、客服对话、语言翻译、内容生成等方面前所未有的畅快体验。 然而,当我们享受着大语言模型带来的普惠 AI 能力时,它也给开发者们带来了前所未有的挑战。随着模型不断增大,计算量也达到了空前的高度,直接导致推理时间变长。为了解决大语言模型推理的延迟问题,业界已经提供了一些解决方案,比如 Tensorrt、FasterTransformer 和 vllm。为了帮助用户解决云原生系统中的大语言模型推理加速问题,云原生 AI 套件引入了 FasterTransformer 推理加速方案。 本文将在 ACK 容器服务上,以 Bloom7B1 模型为例展示如何使用 FasterTransformer 进行推理加速。本例中会使用以下组件: Arena Arena 是基于 Kubernetes 的机器学习轻量级解决方案,支持数据准备、模型开发,模型训练、模型预测的完整生命周期,提升数据科学家工作效率。同时和阿里云的基础云服务深度集成,支持 GPU 共享、CPFS 等服务,可以运行阿里云优化的深度学习框架,最大化使用阿里云异构设备的性能和成本的效益。更多 arena 信息,可以参考云原生 AI 套件开发者使用指南[1]。 Triton Server Triton Server为Nvidia 提供了机器学习推理引擎,可以支持 Tensorflow、Pytorch、Tensorrt 和 Fastertransformer 多种 backend。云原生 AI 套件已经将 Triton Server 加入到 Arena 中,用户可以通过简单的命令行或 SDK 来在云原生系统中完成 Triton Server 服务的拉起、运维和监控。更多 AI 套件中使用 Triton Server 信息,可以参考部署 PyTorch 模型推理服务[2]。 FasterTransformer FasterTransformer 是真对于 Transofrmer 类型模型(也包括 encoder-only、decoder-only)的推理加速方案,其提供了 Kernel Fuse、Memory reuse、kv cache、量化等多种优化方案,同时也提供了 Tensor Parallel 和 Pipeline Parallel 两种分布式推理方案。本文将介绍如何在云原生 AI 套件中使用 FasterTransformer 进行模型的推理加速。 02 环境准备 环境准备分为两个部分,第一个部分是创建包含 GPU 的 Kubernetes 集群[3]和安装云原生 AI 套件[4],第二个部分是从 huggingface 官网下载 bloom-7b1 模型。 模型的下载命令如下: git lfs install git clone git@hf.co:bigscience/bloom-7b1 通过上面的命令,可以将 huggingface repo 中的文件下载到本地: 下载完成后,我们将 bloom-71 文件夹上传到 OSS 中,作为推理时的共享存储,OSS 的使用可以参考开始使用 OSS[5]。 上传到 OSS 之后,分别创建名称为 bloom7b1-pv 和 bloom7b1-pvc 的 PV 和 PVC,以用于推理服务的容器挂载。具体操作,请参见使用 OSS 静态存储卷[6]。 03 模型转换 FasterTransformer 本质上是对模型的重写,它通过 CUDA、cuDNN 和 cuBLAS 重写了 Transformer 模型结构,因此其具有自己的模型结构和模型参数的描述方式。而我们的模型一般是通过 Pytorch、Tesorflow、Megatron 或 huggingface 这样的训练框架产出,其往往又具有自己单独的一套模型结构和参数的表达,因此在使用FasterTransformer时,就需要将模型原有的 checkpoint 转换为 FasterTransformer 的结构。 FasterTransformer 中已经支持了多种类型的转换脚本,这里我们使用 FasterTransofrmer 提供的 examples/pytorch/gpt/utils/huggingface_bloom_convert.py。 云原生 AI 套件已经接入了上述的转换逻辑,因此,通过如下脚本即可完成一次模型的转换。 arena submit pytorchjob\ --gpus=1\ --image ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/fastertransformer:torch-0.0.1\ --name convert-bloom\ --workers 1\ --namespace default-group\ --data bloom-pvc:/mnt\ 'python /FasterTransformer/examples/pytorch/gpt/utils/huggingface_bloom_convert.py -i /mnt/model/bloom-7b1 -o /mnt/model/bloom-7b1-ft-fp16 -tp 2 -dt fp16 -p 64 -v' 通过 arena log 来观察转换的日志: $arena logs -n default-group convert-bloom ======================= Arguments ======================= - input_dir...........: /mnt/model/bloom-7b1 - output_dir..........: /mnt/model/bloom-7b1-ft-fp16 - tensor_para_size....: 2 - data_type...........: fp16 - processes...........: 64 - verbose.............: True - by_shard............: False ========================================================= loading from pytorch bin format model file num: 2 - model.pre_decoder_layernorm.bias................: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.pre_decoder_layernorm.bias.bin - model.layers.0.input_layernorm.weight...........: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.input_layernorm.weight.bin - model.layers.0.attention.dense.bias.............: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.attention.dense.bias.bin - model.layers.0.input_layernorm.bias.............: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.input_layernorm.bias.bin - model.layers.0.attention.query_key_value.bias...: shape (3, 2048) s | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.attention.query_key_value.bias.0.bin (0/2) - model.layers.0.post_attention_layernorm.weight..: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.post_attention_layernorm.weight.bin - model.layers.0.post_attention_layernorm.bias....: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.post_attention_layernorm.bias.bin - model.layers.0.mlp.dense_4h_to_h.bias...........: shape (4096,) | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.mlp.dense_4h_to_h.bias.bin - model.layers.0.mlp.dense_h_to_4h.bias...........: shape (8192,) s | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.mlp.dense_h_to_4h.bias.0.bin (0/2) - model.layers.0.attention.query_key_value.bias...: shape (3, 2048) s | saved at /mnt/model/bloom-7b1-ft-fp16/2-gpu/model.layers.0.attention.query_key_value.bias.1.bin (1/2) 通过 arena list 命令查看转换是否执行结束: NAME STATUS TRAINER DURATION GPU(Requested) GPU(Allocated) NODE convert-bloom SUCCEEDED PYTORCHJOB 3m 1 N/A 192.168.123.35 转换完成后,会在 OSS 上创建一个 model/arena/bloom-7b1-ft-fp16 文件夹,文件中会存储 FasterTransofrmer 所对应的 checkpoint。 04 性能对比 此时,我们的 OSS 上已经有两份 bloom-7b1 checkpoint,一份是 bloom-7b 文件夹存储了 huggingface 原生的 checkpoint,另一份是 bloom-7b-ft-fp16 文件夹存储了转换后的 FasterTransformer 的 checkpoint。我们将使用这两份 checkpoint 进行性能对比,看一下来 FasterTransformer 是否能够带来性能的提升。 性能对比使用 Fastertransformer 提供的 examples/pytorch/gpt/bloom_lambada.py,我们也已经集成到了 AI 套件中。这里我们分别提交两个性能评测命令。对 Huggingface Bloom-7b1 评测的命令: arena submit pytorchjob\ --gpus=2\ --image ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/fastertransformer:torch-0.0.1\ --name perf-hf-bloom \ --workers 1\ --namespace default-group\ --data bloom7b1-pvc:/mnt\ 'python /FasterTransformer/examples/pytorch/gpt/bloom_lambada.py \ --tokenizer-path /mnt/model/bloom-7b1 \ --dataset-path /mnt/data/lambada/lambada_test.jsonl \ --batch-size 16 \ --test-hf \ --show-progress' 查看 HuggingFace 的结果: $arena -n default-group logs -t 5 perf-hf-bloom Accuracy: 57.5587% (2966/5153) (elapsed time: 173.2149 sec) 对 Fastertransformer Blooom-7b 评测的命令: arena submit pytorchjob\ --gpus=2\ --image ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/fastertransformer:torch-0.0.1\ --name perf-ft-bloom \ --workers 1\ --namespace default-group\ --data bloom7b1-pvc:/mnt\ 'mpirun --allow-run-as-root -n 2 python /FasterTransformer/examples/pytorch/gpt/bloom_lambada.py \ --lib-path /FasterTransformer/build/lib/libth_transformer.so \ --checkpoint-path /mnt/model/2-gpu \ --batch-size 16 \ --tokenizer-path /mnt/model/bloom-7b1 \ --dataset-path /mnt/data/lambada/lambada_test.jsonl \ --show-progress' 查看 FasterTransformer 的结果,可以看见带来了 2.5 倍的性能提升。 $arena -n default-group logs -t 5 perf-ft-bloom Accuracy: 57.6363% (2970/5153) (elapsed time: 68.7818 sec) 通过结果对比可以看见,Fastertransformer 与原生的 Huggingface 相比有比较明显的性能提升。 05 模型部署 在这一小节,我们使用 Triton Server 对 FasterTransformer 进行部署,Triton Server 中原生并不支持 FasterTransformer 的 backend,需要我们配合 Nvidia 提供的 Fastertransformer backend 来使用。通过使用 FasterTransformer backend,Triton Server 不再进行 GPU 资源的分配,FasterTransformer backend 会根据 CUDA_VISIBLE_DEVICES 判断当前可用 GPU 资源,并分配给对应的 RANK 来执行分布式的推理。 FasterTransformer 对应的模型 Repo 目录如下所示: ├── model_repo │ └── fastertransformer │ ├── 1 │ │ └── config.ini │ └── config.pbtxt 使用功能 Arena 的如下命令来启动 FasterTransformer: arena serve triton \ --namespace=default-group \ --version=1 \ --data=bloom7b1-pvc:/mnt \ --name=ft-triton-bloom \ --allow-metrics \ --gpus=2 \ --replicas=1 \ --image=ai-studio-registry.cn-beijing.cr.aliyuncs.com/kube-ai/triton_with_ft:22.03-main-2edb257e-transformers \ --model-repository=/mnt/triton_repo 通过 kubectl logs,我们可以看到 triton server 的部署日志,通过日志可以看到,triton server 启动了两个 gpu 来进行分布式推理。 I0721 08:57:28.116291 1 pinned_memory_manager.cc:240] Pinned memory pool is created at '0x7fd264000000' with size 268435456 I0721 08:57:28.118393 1 cuda_memory_manager.cc:105] CUDA memory pool is created on device 0 with size 67108864 I0721 08:57:28.118403 1 cuda_memory_manager.cc:105] CUDA memory pool is created on device 1 with size 67108864 I0721 08:57:28.443529 1 model_lifecycle.cc:459] loading: fastertransformer:1 I0721 08:57:28.625253 1 libfastertransformer.cc:1828] TRITONBACKEND_Initialize: fastertransformer I0721 08:57:28.625307 1 libfastertransformer.cc:1838] Triton TRITONBACKEND API version: 1.10 I0721 08:57:28.625315 1 libfastertransformer.cc:1844] 'fastertransformer' TRITONBACKEND API version: 1.10 I0721 08:57:28.627137 1 libfastertransformer.cc:1876] TRITONBACKEND_ModelInitialize: fastertransformer (version 1) I0721 08:57:28.628304 1 libfastertransformer.cc:372] Instance group type: KIND_CPU count: 1 I0721 08:57:28.628326 1 libfastertransformer.cc:402] Sequence Batching: disabled I0721 08:57:28.628334 1 libfastertransformer.cc:412] Dynamic Batching: disabled I0721 08:57:28.661657 1 libfastertransformer.cc:438] Before Loading Weights: +-------------------+-----------------------------------------------------------------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Backend | Path | Config | +-------------------+-----------------------------------------------------------------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------+ | fastertransformer | /opt/tritonserver/backends/fastertransformer/libtriton_fastertransformer.so | {"cmdline":{"auto-complete-config":"true","min-compute-capability":"6.000000","backend-directory":"/opt/tritonserver/backends","default-max-batch-size":"4"}} | +-------------------+-----------------------------------------------------------------------------+---------------------------------------------------------------------------------------------------------------------------------------------------------------+ I0721 09:01:19.653743 1 server.cc:633] +-------------------+---------+--------+ | Model | Version | Status | after allocation : free: 7.47 GB, total: 15.78 GB, used: 8.31 GB +-------------------+---------+--------+ | fastertransformer | 1 | READY | +-------------------+---------+--------+ I0721 09:01:19.668137 1 metrics.cc:864] Collecting metrics for GPU 0: Tesla V100-SXM2-16GB I0721 09:01:19.668167 1 metrics.cc:864] Collecting metrics for GPU 1: Tesla V100-SXM2-16GB I0721 09:01:19.669954 1 metrics.cc:757] Collecting CPU metrics I0721 09:01:19.670150 1 tritonserver.cc:2264] +----------------------------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | Option | Value | +----------------------------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ | server_id | triton | | server_version | 2.29.0 | | server_extensions | classification sequence model_repository model_repository(unload_dependents) schedule_policy model_configuration system_shared_memory cuda_shared_memory binary_tensor_data statistics trace logging | | model_repository_path[0] | /mnt/triton_repo | | model_control_mode | MODE_NONE | | strict_model_config | 0 | | rate_limit | OFF | | pinned_memory_pool_byte_size | 268435456 | | cuda_memory_pool_byte_size{0} | 67108864 | | cuda_memory_pool_byte_size{1} | 67108864 | | response_cache_byte_size | 0 | | min_supported_compute_capability | 6.0 | | strict_readiness | 1 | | exit_timeout | 30 | +----------------------------------+------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+ I0721 09:01:19.672326 1 grpc_server.cc:4819] Started GRPCInferenceService at 0.0.0.0:8001 I0721 09:01:19.672597 1 http_server.cc:3477] Started HTTPService at 0.0.0.0:8000 I0721 09:01:19.714356 1 http_server.cc:184] Started Metrics Service at 0.0.0.0:8002 06 服务请求 启动 forward 进行验证: # 使用 kubectl 启动port-forward kubectl -n default-group port-forward svc/ft-triton-bloom-1-tritoninferenceserver 8001:8001 这里我们使用 Triton Server 提供的 python SDK 所编写的脚本来向 Triton Server 发起请求。脚本中主要完成三件事情: 通过 huggingface 中 bloom-7b1 对应的分词器对 query 进行分词和 token 转换 通过 triton server SDK 向 triton server 发起请求 通过分词器对 output token 进行转换,拿到最终的结果 import os, sys #from tkinter import _Padding import numpy as np import json import torch #import tritongrpcclient import argparse import time from transformers import AutoTokenizer import tritonclient.grpc as grpcclient # create tokenizer tokenizer = AutoTokenizer.from_pretrained('/mnt/model/bloom-7b1', padding_side='right') tokenizer.pad_token_id = tokenizer.eos_token_id def load_image(img_path: str): """ Loads an encoded image as an array of bytes. """ return np.fromfile(img_path, dtype='uint8') def tokeninze(query): # encode encoded_inputs = tokenizer(query, padding=True, return_tensors='pt') input_token_ids = encoded_inputs['input_ids'].int() input_lengths = encoded_inputs['attention_mask'].sum( dim=-1, dtype=torch.int32).view(-1, 1) return input_token_ids.numpy().astype('uint32'), input_lengths.numpy().astype('uint32') if __name__ == "__main__": parser = argparse.ArgumentParser() parser.add_argument("--model_name", type=str, required=False, default="fastertransformer", help="Model name") parser.add_argument("--url", type=str, required=False, default="localhost:8001", help="Inference server URL. Default is localhost:8001.") parser.add_argument('-v', "--verbose", action="store_true", required=False, default=False, help='Enable verbose output') args = parser.parse_args() # 1.创建client try: triton_client = grpcclient.InferenceServerClient( url=args.url, verbose=args.verbose) except Exception as e: print("channel creation failed: " + str(e)) sys.exit(1) output_name = "OUTPUT" # 2) 设置input inputs = [] ## 2.1) input_ids query="deepspeed is" input_ids, input_lengths = tokeninze(query) inputs.append(grpcclient.InferInput("input_ids", input_ids.shape, "UINT32")) inputs[0].set_data_from_numpy(input_ids) ## 2.2) input_length inputs.append(grpcclient.InferInput("input_lengths", input_lengths.shape, "UINT32")) inputs[1].set_data_from_numpy(input_lengths) ## 2.3) output length output_len=32 output_len_np = np.array([[output_len]], dtype=np.uintc) inputs.append(grpcclient.InferInput("request_output_len", output_len_np.shape, "UINT32")) inputs[2].set_data_from_numpy(output_len_np) # 3) 设置output outputs = [] outputs.append(grpcclient.InferRequestedOutput("output_ids")) # 4) 发起请求 start_time = time.time() results = triton_client.infer(model_name=args.model_name, inputs=inputs, outputs=outputs) latency = time.time() - start_time # 5) 结果处理:转化为numpy 类型,计算max,转化label output0_data = results.as_numpy("output_ids") print(output0_data.shape) result = tokenizer.batch_decode(output0_data[0]) print(result) 发起 client 请求命令如下: $python3 bloom_7b_client.py (1, 1, 36) ['deepspeed is the speed of the ship at the time of the collision, and the\ndeepspeed of the other ship is the speed of the other ship at the time'] 07 总结 本文我们通过 Bloom-7b1 模型展示了如何在云原生 AI 套件中使用 FasterTransformer 对大语言模型进行加速,通过与 HuggingFace 的版本对比可以带来 2.5 倍的性能提升。后续我们会逐步推出更多大模型相关的推理加速方案,以满足不同的业务需求,大家敬请期待。 相关链接: [1] 云原生 AI 套件开发者使用指南 https://help.aliyun.com/zh/ack/cloud-native-ai-suite/getting-started/cloud-native-ai-component-set-user-guide [2] 部署 PyTorch 模型推理服务 https://help.aliyun.com/zh/ack/cloud-native-ai-suite/user-guide/deploy-a-pytorch-model-as-an-inference-service?spm=a2c4g.11186623.0.0.2267225carYzgA [3] 创建包含 GPU 的 Kubernetes 集群 https://help.aliyun.com/zh/ack/ack-managed-and-ack-dedicated/user-guide/use-gpu-scheduling-in-ack-clusters#task-1664343 [4] 安装云原生 AI 套件 https://help.aliyun.com/document_detail/212117.htm#task-1917487 [5] 开始使用 OSS https://help.aliyun.com/zh/oss/getting-started/getting-started-with-oss [6] 使用 OSS 静态存储卷 https://help.aliyun.com/zh/ack/ack-managed-and-ack-dedicated/user-guide/mount-statically-provisioned-oss-volumes 作者:颜廷帅(瀚廷) 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册