首页 文章 精选 留言 我的

精选列表

搜索[官方产品],共10012篇文章
优秀的个人博客,低调大师

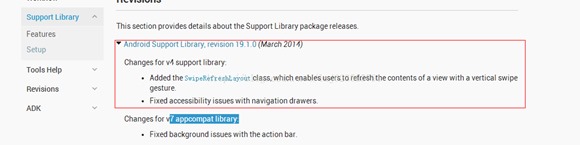
Android -- 官方下拉刷新SwipeRefreshLayout

V4的兼容包 API 大概就这4个常用的方法。 code 布局 <RelativeLayout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" tools:context=".MainActivity" > <android.support.v4.widget.SwipeRefreshLayout android:id="@+id/swipe" android:layout_width="match_parent" android:layout_height="match_parent" > <ListView android:id="@+id/listview" android:layout_width="fill_parent" android:layout_height="wrap_content" /> </android.support.v4.widget.SwipeRefreshLayout> </RelativeLayout> MainActivty @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_main); listView = (ListView) findViewById(R.id.listview); mSwipeLayout = (SwipeRefreshLayout) findViewById(R.id.swipe); list = new ArrayList<MyTextClass>(); Map<String, String> maps = new HashMap<String, String>(); maps.put("1", "2"); myHandler = new MyHandler(); client = new MyHttpClient(myHandler); myThread = new MyThread(client,"http://192.168.1.4/json/index.php",maps,GETJSON); myHandler.setThread(myThread); myHandler.setHandlerExtraHandleMessage(new MyHandler.HandlerExtraHandleMessage() { @Override public void handleMessage(Message msg) { switch (msg.what) { case GETJSON: String strJson1 = (String) msg.obj; Json json1 = new Json(strJson1); try { list = json1.getMyTextClass(); } catch (JSONException e) { e.printStackTrace(); } myBaseAdapter = new MyBaseAdapter(MainActivity.this, list); listView.setAdapter(myBaseAdapter); break; case REFRESH: String strJson2 = (String) msg.obj; Json json2 = new Json(strJson2); //list.clear(); try { list = json2.getMyTextClass(); } catch (JSONException e) { e.printStackTrace(); } if(myBaseAdapter != null) { myBaseAdapter.setList(list); myBaseAdapter.notifyDataSetChanged(); } else { MyBaseAdapter myBaseAdapter2 = new MyBaseAdapter(MainActivity.this, list); listView.setAdapter(myBaseAdapter2); } mSwipeLayout.setRefreshing(false); break; default: System.out.println("Other Message"); break; } super.handleMessage(msg); } }); Map<String, String> maps2 = new HashMap<String, String>(); maps.put("1", "2"); MyRefreshListener myRefreshListener = new MyRefreshListener(myHandler, maps2, REFRESH); mSwipeLayout.setOnRefreshListener(myRefreshListener); mSwipeLayout.setColorScheme(android.R.color.holo_green_dark, android.R.color.holo_green_light, android.R.color.holo_orange_light, android.R.color.holo_red_light); } 我是天王盖地虎的分割线 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/3922845.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Apache Storm 官方文档 —— Metrics

Storm 提供了一个可以获取整个拓扑中所有的统计信息的度量接口。Storm 内部通过该接口可以跟踪各类统计数字:executor 和 acker 的数量、每个 bolt 的平均处理时延、worker 使用的最大堆容量等等,这些信息都可以在 Nimbus 的 UI 界面中看到。 Metric 类型 使用 Metrics 只需要实现一个接口方法:getValueAndReset,在方法中可以查找汇总值、并将该值复位为初始值。例如,在 MeanReducer 中就实现了通过运行总数除以对应的运行计数的方式来求取均值,然后将两个值都重新设置为 0。 Storm 提供了以下几种 metric 类型: AssignableMetric— 将 metric 设置为指定值。此类型在两种情况下有用:1. metric 本身为外部设置的值;2. 你已经另外计算出了汇总的统计值。 CombinedMetric— 可以对 metric 进行关联更新的通用接口。 CountMetric— 返回 metric 的汇总结果。可以调用incr()方法来将结果加一;调用incrBy(n)方法来将结果加上给定值。 MultiCountMetric— 返回包含一组 CountMetric 的 HashMap ReducedMetric MeanReducer— 跟踪由它的reduce()方法提供的运行状态均值结果(可以接受Double、Integer、Long等类型,内置的均值结果是Double类型)。MeanReducer 确实是一个相当棒的家伙。 MultiReducedMetric— 返回包含一组 ReducedMetric 的 HashMap Metric Consumer 构建自定义 metric 内建的 Metric builtin_metrics.clj为内建的 metrics 设置了数据结构,以及其他框架组件可以用于更新的虚拟方法。metrics 本身是在回调代码中实现计算的 — 请参考executor.clj中的ack-spout-msg的例子。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— Hooks

Storm 提供了一种 hooks 机制,可以实现在 Storm 的各种事件流中运行自定义代码的功能。可以通过继承BaseTaskHook类来创建 hook,还可以根据需要在继承的子类中覆写适当的方法来跟踪相关事件。 注册 hook 有两种方法: 在 spout 的 open 方法或者 bolt 的 prepare 方法中使用TopologyContext#addTaskHook方法; 使用 Storm 配置表中的topology.auto.task.hooks配置项。之后这些 hook 会自动注册到每个 spout 和 bolt 中,这样就可以很方便地处理例如集成自定义的系统监控代码之类的事情了。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— FAQ

Storm 最佳实践 关于配置 Storm + Trident 的建议 worker 的数量最好是服务器数量的倍数;topology 的总并发度(parallelism)最好是 worker 数量的倍数;Kafka 的分区数(partitions)最好是 Spout(特指KafkaSpout)并发度的倍数 在每个机器(supervisor)上每个拓扑应用只配置一个 worker 在拓扑最开始运行的时候设置使用较少的大聚合器,并且最好是每个 worker 进程分配一个 使用独立的调度器(scheduler)来分配任务(关于Scheduler 的知识请参考xumingming 的博客—— 译者注) 在每个 worker 上只配置使用一个 acker —— 这是 0.9.x 版本的默认特性,不过在早期版本中有所不同 在配置文件中开启 GC 日志记录;如果一切正常,日志中记录的 major GC 应该会非常少 将 trident 的 batch interval 配置为你的集群的端到端时延的 50% 左右 开始时设置一个很小的TOPOLOGY_MAX_SPOUT_PENDING(对于 trident 可以设置为 1,对于一般的 topology 可以设置为 executor 的数量),然后逐渐增大,直到数据流不再发生变化。这时你可能会发现结果大约等于“2 × 吞吐率(每秒收到的消息数) × 端到端时延”(最小的额定容量的2倍)。 如何避免 worker 总是出现莫名其妙的故障的问题 确保 Storm 对你的日志目录有写权限 确保你的堆内存没有溢出 确保所有的 worker 上都已经正确地安装了所有的依赖库文件 确保 ZooKeeper 的 hostname 不是简单地设置为 “localhost” 确保集群中的每台机器上都配置好了正确、唯一的 hostname,并且这些 hostname 需要配置在所有机器的 Storm 配置文件中 确保 a) 不同的 worker 之间,b) 不同的 Storm 节点之间,c) Storm 与 ZooKeeper 集群之间, d) 各个 worker 与拓扑运行所需要的 Kafka/Kestrel/其他数据库等 之间没有开启防火墙或者其他安全保护机制;如果有,请使用 netstat 来为各个端口之间的通信授权 Help!Storm 使用过程中无法获取: 日志文件:日志文件默认记录在$STORM_HOME/logs目录中。请检查你对该目录是否有写权限。具体的日志配置信息位于 logback/cluster.xml 文件中(0.9 之前的版本需要在 log4j/*.properties 配置文件中进行配置。 最终输出的 JVM 设置:需要在配置文件(storm.yaml)的childopts配置项中添加-XX+PrintFlagsFinal命令选项。 最终输出的 Java 系统属性信息:需要在你构建拓扑的位置添加代码Properties props = System.getProperties(); props.list(System.out); 我应该使用多少个 worker? worker 的完整数量是由 supervisor 配置的。每个 supervisor 会分配到一定数量的 JVM slot,你在拓扑中设置的 worker number 就是以这个 slot 数量为依据进行分配的。 不建议为每个拓扑在每台机器上分配超过一个 worker。 假如有一个运行于三台 8 核服务器节点的拓扑,它的并行度为24,每个 bolt 在每台机器上分配有 8 个 executor(即每个 CPU 核心分配一个)。这种场景下,使用三个 worker (每个 worker 分配 8 个executor)相对于使用更多的 worker (比如使用 24 个 worker,为每个 executor 分别分配一个)有三点好处: 首先,在 worker 内部将数据流重新分区到不同的 executor 的操作(比如 shuffle 或者 group-by)就不会产生触发到传输 buffer 缓冲区,tuple 会直接从发送端转储到接收端的 buffer 区。这一点有很大的优势。相反,如果目标 executor 是在同一台机器的不同 worker 进程内,tuple 就需要经历“发送 -> worker 传输队列 -> 本地 socket 端口 -> 接收端 worker -> 接收端 executor”这样一个漫长的过程。虽然这个过程并不会产生网络级传输,但是在同一台机器的不同进程间的传输损耗也是很可观的。 其次,三个大的聚合器带来的大的缓存空间比 24 个小聚合器带来的小缓存空间要有用得多。因为这回降低数据倾斜造成的影响,同时提高 LRU 的性能。 最后,更少的 worker 可以有效地降低控制流的频繁变动。 拓扑 Trident 拓扑支持多数据流吗 Trident 拓扑可以设计成条件路径(if-else)的工作流形式吗?例如,bolt0 在接收 spout 的数据流时,可以根据输入 tuple 的值来选择将数据流发送到 bolt1 或者 bolt2,而不是同时向两个 bolt 发送。 Trident 的 “each” 运算符可以返回一个数据流对象,你可以将该对象存储在某个变量中,然后你可以对同一个数据流执行多个 each 操作来分解该数据流,如下述代码所示: Stream s = topology.each(...).groupBy(...).aggregate(...) Stream branch1 = s.each(..., FilterA) Stream branch2 = s.each(..., FilterB) 你可以使用 join、merge 或者 multiReduce 来联结各个数据流。 到目前为止,Trident 暂时不支持输出多个数据流。(详见STORM-68) Spout Coordinator 是什么,为什么会有很多 Coordinator? Trident spout 实际上是通过 Storm 的 bolt 运行的。MasterBatchCoordinator(MBC)封装了 Trident 拓扑的 spout,它负责整合 Trident 中的 batch,这一点对于你所使用的任何类型的 spout 而言都是一样的。Trident 的 batch 就是在 MBC 向各个 spout-coordinator 分发种子 tuple 的过程中生成的。Spout-coordinator bolt 知道你所定义的 spout 是如何互相协作的 —— 实际上,在使用 Kafka 的情况下,各个 spout 就是通过 spout-coordinator 来获取 pull 消息所需要的 partition 和 offset 信息的。 在 spout 的 metadata 记录中能够存储什么信息? 只能存储少量静态数据,而且是越少越好(尽管你确实可以向其中存储更多的信息,不过我们不推荐这样做)。 emitPartitionBatchNew函数是多久调用一次的? 由于在 Trident 中 MBC 才是实际运行的 spout,一个 batch 中的所有 tuple 都是 MBC 生成的 tuple 树的节点。也就是说,Storm 的 “max spout pending” 参数实际上定义的是可以并发运行的 batch 数量。MBC 在满足以下两个条件下会发送出一个新的 batch:首先,挂起的 tuple 数需要小于 “max pending” 参数;其次,距离上一个 batch 的发送已经过去了至少一个trident batch interval的间隔时间。 如果没有数据发送,Trident 会降低发送频率吗? 是的,Storm 中有一个可选的 “spout 等待策略”,默认配置是 sleep 一段指定的配置时间。 Trident batch interval 参数有什么用? 你知道 486 时代的计算机上面为什么有个trubo button吗?这个参数的作用和这个按钮有点像。 实际上,trident batch interval 有两个用处。首先,它可以用于减缓 spout 从远程数据源获取数据的速度,但这不会影响数据处理的效率。例如,对于一个从给定的 S3 存储区中读取批量上传文件并按行发送数据的 spout,我们就不希望它经常触发 S3 的阈值,因为文件要隔几分钟才会上传一次,而且每个 batch 也需要花费一定的时间来执行。 另一个用处是限制启动期间或者突发数据负载情况下内部消息队列的负载压力。如果 spout 突然活跃起来,并向系统中挤入了 10 个 batch 的记录,那么可能会有从 batch7 开始的大量不紧急的 tuple 堵塞住传输缓冲区,并且阻塞了从 batch3 中的 tuple(甚至可能包含 batch3 中的部分旧 tuple)的 commit 过程#。对于这种情况,我们的解决方法就是将 trident batch interval 设置为正常的端到端处理时延的一半左右 —— 也就是说如果需要花费 600 ms 的时间处理一个 batch,那么就可以每 300 ms 处理一个 batch。 注意,这个 300 ms 仅仅是一个上限值,而不是额外增加的延时时间,如果你的 batch 需要花费 258 ms 来运行,那么 Trident 就只会延时等待 42 ms。 如何设置 batch 大小? Trident 本身不会对 batch 进行限制。不过如果使用 Kafka 的相关 spout,那么就可以使用 max fetch bytes 大小除以 平均 record 大小来计算每个子 batch 分区的有效 record 大小。 怎样重新设置 batch 的大小? Trident 的 batch 在某种意义上是一种过载的设施。batch 大小与 partition 的数量均受限于或者是可以用于定义#: 事务安全单元(一段时间内存在风险的 tuple); 相对于每个 partition,一个用于窗口数据流分析的有效窗口机制; 相对于每个 partition,使用 partitionQuery,partitionPersist 等命令时能够同时进行的查询操作数量; 相对于每个 partition,spout 能够同时分配的 record 数量。 不能在 batch 生成之后更改 batch 的大小,不过可以通过 shuffle 操作以及修改并行度的方式来改变 partition 的数量。 时间相关问题 怎样基于指定时间聚合数据 对于带有固定时间戳的 records,如果需要对他们执行计数、求均值或者聚合操作,并将结果整合到离散的时间桶(time bucket)中,Trident 是一个很好的具有可扩展性的解决方案。 这种情况下可以写一个each函数来将时间戳置入一个时间桶中:如果桶的大小是以“小时”为单位的,那么时间戳2013-08-08 12:34:56就会被匹配到2013-08-08 12:00:00桶中,其他的 12 时到 13 时之间的时间也一样。然后可以使用persistentAggregate来对时间桶分组。persistentAggregate会使用一个基于数据存储的本地 cacheMap。这些包含有大量 records 的 group 会使用高效的批量读取/写入方式对数据存储区进行操作,所以并不会对数据存储区进行大量的读操作;只要你的数据传送足够快捷,Trident 就可以高效地使用内存与网络。即使某台服务器宕机了一天,需要重新快速地发送一整天的数据,旧有的结果也可以静默地获取到并进行更新,并且这并不会影响当前结果的计算过程。 怎么才能知道某个时间桶中已经收到了所有需要的 record? 很遗憾,你不会知道什么时候所有的 event 都已经采集到了 —— 这是一个认识论问题,而不是一个分布式系统的问题。你可以: 使用域相关知识来设定时间限制。 引入标记机制:对于一个指定时间窗,确定某个 record 会处在所有的 record 的最后位置。Trident 使用这个机制来判断一个 batch 是否结束。例如,你收到一组传感器采集到的 records,每个传感器都是按顺序发送数据的,那么一旦所有的传感器都发送出一个 “3:02:xx” 的数据,你就可以知道可以开始处理这个时间窗了。 如果可以的话,尽量使你的处理过程增量化:每个新来的值都会使结果越来越准确。Trident ReducerAggregator 就是一个可以通过一个旧有的结果以及一组新数据来返回一个更新的结果的运算符。这使得结果可以被缓存并序列化到一个数据库中;如果某台服务器宕机了一天,在恢复运行之后需要重新快速地发送一整天的数据,旧有的结果也可以静默地获取到并进行更新。 使用 Lambda 架构:将所有收到的事件数据归档到存储区中(S3,HBase,HDFS)。在快速处理层,一旦时间窗复位,就对对应的时间桶进行处理来获取有效结果,并且在处理过程中跳过所有比早于该时间窗的过期数据。定期地执行全局聚合操作就可以计算出一个较“正确”的结果。 附注 #此处译文可能不够准确,有疑问的读者请参考原文对应内容。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

Apache Storm 官方文档 —— 配置

Storm 有大量配置项用于调整 nimbus、supervisors 和拓扑的行为。有些配置项是系统级的配置项,在拓扑中不能修改,另外一些配置项则是可以在拓扑中修改的。 每一个配置项都在 Storm 代码库的defaults.yaml中有一个默认值。可以通过在 Nimbus 和 Supervisors 的环境变量中定义一个 storm.yaml 来覆盖默认值。最后,在使用StormSubmitter提交拓扑时也可以定义基于具体拓扑的配置项。但是,基于拓扑的配置项仅仅能够覆盖那些以 “TOPOLOGY” 作为前缀的配置项。 Storm 0.7.0 以上版本支持覆写每个 Bolt/Spout 的配置信息。不过,使用这种方式只能修改以下几个配置项: “topology.debug” “topology.max.spout.pending” “topology.max.task.parallelism” “topology.kryo.register”:由于序列化对拓扑中的所有组件都是可见的,这一项与其他几项稍微有一些不同,详细信息可以参考Storm 的序列化 Storm 的 Java API 支持两种自定义组件配置信息的方式: 内置型:在需要配置的 Spout/Bolt 中覆写getComponentConfiguration方法,使其返回特定组件的配置表; 外置型:TopologyBuilder中的setSpout与setBolt方法会返回一个带有addConfiguration方法的ComponentConfigurationDeclarer对象,通过addConfiguration方法就可以覆写对应组件的配置项(同时也可以添加自定义的配置信息——译者注)。 配置信息的优先级依次为:defaults.yaml < storm.yaml < 拓扑配置 < 内置型组件信息配置 < 外置型组件信息配置。 相关资料 Config:此类包含所有可配置项的列表,对于创建拓扑配置信息很有帮助 defaults.yaml:所有配置项的默认值 配置 Storm 集群:说明了如何创建、配置一个 Storm 集群 在生产环境中运行拓扑:列出了在集群中运行拓扑的一些有用的配置项 本地模式:列出了使用本地模式时比较有用的配置项 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Spark 官方文档》硬件配置

硬件配置 Spark开发者们常常被问到的一个问题就是:如何为Spark配置硬件。我们通常会给出以下的建议,但具体的硬件配置还依赖于实际的使用情况。 存储系统 因为绝大多数Spark作业都很可能是从外部存储系统加载输入数据(如:HDFS或者HBase),所以最好把Spark部署在离这些存储比较近的地方。建议如下: 只要有可能,就尽量在HDFS相同的节点上部署Spark。最简单的方式就是,在HDFS相同的节点上独立部署Spark(standalone mode cluster),并配置好Spark和Hadoop的内存和CPU占用,以避免互相干扰(对Hadoop来说,相关的选项有 mapred.child.java.opts – 配置单个任务的内存,mapred.tasktracker.map.tasks.maximun和mapred.tasktracker.reduce.tasks.maximum – 配置任务个数)。当然,你也可以在一些通用的集群管理器上同时运行Hadoop和Spark,如:Mesos或Hadoop YARN。 如果不能将Spark和HDFS放在一起,那么至少要将它们部署到同一局域网的节点中。 对于像HBase这类低延迟数据存储来说,比起一味地避免存储系统的互相干扰,更需要关注的是将计算分布到不同节点上去。 本地磁盘 虽然大部分情况下,Spark都是在内存里做计算,但它仍会使用本地磁盘存储数据,如:存储无法装载进内存的RDD数据,存储各个阶段(stage)输出的临时文件。因此,我们建议每个节点上用4~8块磁盘,非磁盘阵列方式挂载(只需分开使用单独挂载点即可)。在Linux中,挂载磁盘时使用noatimeoption可以减少不必要的写操作。在Spark中,配置(configure)spark.local.dir 属性可指定Spark使用的本地磁盘目录,其值可以是逗号分隔的列表以指定多个磁盘目录。如果该节点上也有HDFS目录,可以和HDFS共用同一个块磁盘。 内存 一般来说,Spark可以在8GB~几百GB内存的机器上运行得很好。不过,我们还是建议最多给Spark分配75%的内存,剩下的内存留给操作系统和系统缓存。 每次计算具体需要多少内存,取决于你的应用程序。如需评估你的应用程序在使用某个数据集时会占用多少内存,可以尝试先加载一部分数据集,然后在Spark的监控UI(http://<driver-node>:4040)上查看其占用内存大小。需要注意的是,内存占用很大程度受存储级别和序列化格式影响 – 更多内存优化建议,请参考调优指南(tuning guide)。 最后,还需要注意的是,Java虚拟机在200GB以上内存的机器上并非总是表现良好。如果你的单机内存大于200GB,建议在单个节点上启动多个worker JVM。在Spark独立部署模式下(standalone mode),你可在conf/spark-env.sh 中设置 SPARK_WORKER_INSTANCES 来配置单节点上worker个数,而且在该文件中你还可以通过 SPARK_WORKER_CORES 设置单个worker占用的CPU core个数。 网络 以我们的经验来说,如果数据能加载进内存,那么多数Spark应用的瓶颈都是网络带宽。对这类应用,使用万兆网(10 Gigabit)或者更强的网络是最好的优化方式。对于一些包含有分布式归约相关算子(distributed reduce相关算子,如:group-by系列,reduce-by系列以及SQL join系列)的应用尤其是如此。对于任何一个应用,你可以在监控UI(http://<driver-node>:4040)上查看Spark混洗跨网络传输了多少数据量。 CPU Cores Spark在单机几十个CPU的机器上也能表现良好,因为Spark尽量减少了线程间共享的数据。但一般你至少需要单机8~16个CPU cores。当然,根据具体的计算量你可能需要更多的CPU,但是:一旦数据加载进内存,绝大多数应用的瓶颈要么是CPU,要么是网络。 转载自并发编程网 - ifeve.com

优秀的个人博客,低调大师

《Flink官方文档》示例总览

示例 Java 的示例项目和Scala 的示例项目指导了构建Maven和SBT项目,并包含了一个单词计数程序的简单实现。 监控Wikipedia编辑是一个更复杂的流式分析应用 用Apache Flink、Elasticsearch和Kibana构建实时面板应用是发布在elastic.co上的一个博客,展示了如何用Apache Flink、Elasticsearch和Kibana去构建实时面板来解决流数据分析。 捆绑示例 Flink 资源包含了很多流式(java/scala) 和批处理(java/scala)的示例。这些介绍说明了这些示例如何运行。 转载自 并发编程网 - ifeve.com

优秀的个人博客,低调大师

Alibaba Cloud Toolkit 官方交流群

立即点击下载 官网https://toolkit.aliyun.com 交流群(钉钉) 交流群(微信) 今天小编为大家推荐一款阿里云热门的开发者工具,花 3 分钟时间,来了解下这个新工具:Alibaba Cloud Toolkit 阿里云 Toolkit (Alibaba Cloud Toolkit) 是一个面向 IDE(如 Eclipse 或 IntelliJ IDEA )的插件,帮助开发者更高效的开发、测试、诊断并部署适合云端运行的应用。 核心:提升开发部署效率 亮点1:本地应用一键部署 Deploy to ECS开发者本地编写的应用程序,在图形化界面上进行配置,即可持续便利的部署到云端的 ECS 服务器上;在 Eclipse 中完成编码后,无须在 Maven 、Git 以及其他运维脚本和工具的之间切换,借助 Cloud Toolkit fo

优秀的个人博客,低调大师

Redisson官方文档 - 13. 工具

13.1. 集群管理工具 Redisson集群管理工具提供了通过程序化的方式,像redis-trib.rb脚本一样方便地管理Redis集群的工具。 13.1.1 创建集群 以下范例展示了如何创建三主三从的Redis集群。 ClusterNodes clusterNodes = ClusterNodes.create() .master("127.0.0.1:7000").withSlaves("127.0.0.1:7001", "127.0.0.1:7002") .master("127.0.0.1:7003").withSlaves("127.0.0.1:7004") .master("127.0.0.1:7005"); ClusterManagementTool.createCluster(clusterNodes); 主节点127.0.0.1:7000的从节点有127.0.0.1:7001和127.0.0.1:7002。 主节点127.0.0.1:7003的从节点是127.0.0.1:7003。 主节点127.0.0.1:7005没有从节点。 13.1.2 踢出节点 以下范例展示了如何将一个节点踢出集群。 ClusterManagementTool.removeNode("127.0.0.1:7000", "127.0.0.1:7002"); // 或 redisson.getClusterNodesGroup().removeNode("127.0.0.1:7002"); 将从节点127.0.0.1:7002从其主节点127.0.0.1:7000里踢出。 13.1.3 数据槽迁移 以下范例展示了如何将数据槽在集群的主节点之间迁移。 ClusterManagementTool.moveSlots("127.0.0.1:7000", "127.0.0.1:7002", 23, 419, 4712, 8490); // 或 redisson.getClusterNodesGroup().moveSlots("127.0.0.1:7000", "127.0.0.1:7002", 23, 419, 4712, 8490); 将番号为23,419,4712和8490的数据槽从127.0.0.1:7002节点迁移至127.0.0.1:7000节点。 以下范例展示了如何将一个范围的数据槽在集群的主节点之间迁移。 ClusterManagementTool.moveSlotsRange("127.0.0.1:7000", "127.0.0.1:7002", 51, 9811); // 或 redisson.getClusterNodesGroup().moveSlotsRange("127.0.0.1:7000", "127.0.0.1:7002", 51, 9811); 将番号范围在[51, 9811](含)之间的数据槽从127.0.0.1:7002节点移动到127.0.0.1:7000节点。 13.1.4 添加从节点 以下范例展示了如何向集群中添加从节点。 ClusterManagementTool.addSlaveNode("127.0.0.1:7000", "127.0.0.1:7003"); // 或 redisson.getClusterNodesGroup().addSlaveNode("127.0.0.1:7003"); 将127.0.0.1:7003作为从节点添加至127.0.0.1:7000所在的集群里。 13.2.5 添加主节点 以下范例展示了如何向集群中添加主节点。 ClusterManagementTool.addMasterNode("127.0.0.1:7000", "127.0.0.1:7004"); // 或 redisson.getClusterNodesGroup().addMasterNode("127.0.0.1:7004"); 将127.0.0.1:7004作为主节点添加至127.0.0.1:7000所在的集群里。Adds master node 127.0.0.1:7004 to cluster where 127.0.0.1:7000 participate in 该功能仅限于Redisson PRO版本。

优秀的个人博客,低调大师

Redisson官方文档 - Redisson项目介绍

Redisson项目介绍 Redisson是架设在Redis基础上的一个Java驻内存数据网格(In-Memory Data Grid)。充分的利用了Redis键值数据库提供的一系列优势,基于Java实用工具包中常用接口,为使用者提供了一系列具有分布式特性的常用工具类。使得原本作为协调单机多线程并发程序的工具包获得了协调分布式多机多线程并发系统的能力,大大降低了设计和研发大规模分布式系统的难度。同时结合各富特色的分布式服务,更进一步简化了分布式环境中程序相互之间的协作。 Redisson采用了基于NIO的Netty框架,不仅能作为Redis底层驱动客户端,具备提供对Redis各种组态形式的连接功能,对Redis命令能以同步发送、异步形式发送、异步流形式发送或管道形式发送的功能,LUA脚本执行处理,以及处理返回结果的功能,还在此基础上融入了更高级的应用方案,不但将原生的Redis Hash,List,Set,String,Geo,HyperLogLog等数据结构封装为Java里大家最熟悉的映射(Map),列表(List),集(Set),通用对象桶(Object Bucket),地理空间对象桶(Geospatial Bucket),基数估计算法(HyperLogLog)等结构,在这基础上还提供了分布式的多值映射(Multimap),本地缓存映射(LocalCachedMap),有序集(SortedSet),计分排序集(ScoredSortedSet),字典排序集(LexSortedSet),列队(Queue),阻塞队列(Blocking Queue),有界阻塞列队(Bounded Blocking Queue),双端队列(Deque),阻塞双端列队(Blocking Deque),阻塞公平列队(Blocking Fair Queue),延迟列队(Delayed Queue),布隆过滤器(Bloom Filter),原子整长形(AtomicLong),原子双精度浮点数(AtomicDouble),BitSet等Redis原本没有的分布式数据结构。不仅如此,Redisson还实现了Redis文档中提到像分布式锁Lock这样的更高阶应用场景。事实上Redisson并没有不止步于此,在分布式锁的基础上还提供了联锁(MultiLock),读写锁(ReadWriteLock),公平锁(Fair Lock),红锁(RedLock),信号量(Semaphore),可过期性信号量(PermitExpirableSemaphore)和闭锁(CountDownLatch)这些实际当中对多线程高并发应用至关重要的基本部件。正是通过实现基于Redis的高阶应用方案,使Redisson成为构建分布式系统的重要工具。 在提供这些工具的过程当中,Redisson广泛的使用了承载于Redis订阅发布功能之上的分布式话题(Topic)功能。使得即便是在复杂的分布式环境下,Redisson的各个实例仍然具有能够保持相互沟通的能力。在以这为前提下,结合了自身独有的功能完善的分布式工具,Redisson进而提供了像分布式远程服务(Remote Service),分布式执行服务(Executor Service)和分布式调度任务服务(Scheduler Service)这样适用于不同场景的分布式服务。使得Redisson成为了一个基于Redis的Java中间件(Middleware)。 Redisson Node的出现作为驻内存数据网格的重要特性之一,使Redisson能够独立作为一个任务处理节点,以系统服务的方式运行并自动加入Redisson集群,具备集群节点弹性增减的能力。然而在真正意义上让Redisson发展成为一个完整的驻内存数据网格的,还是具有将基本上任何复杂、多维结构的对象都能变为分布式对象的分布式实时对象服务(Live Object Service),以及与之相结合的,在分布式环境中支持跨节点对象引用(Distributed Object Reference)的功能。这些特色功能使Redisson具备了在分布式环境中,为Java程序提供了堆外空间(Off-Heap Memory)储存对象的能力。 Redisson提供了使用Redis的最简单和最便捷的方法。Redisson的宗旨是促进使用者对Redis的关注分离(Separation of Concern),从而让使用者能够将精力更集中地放在处理业务逻辑上。如果您现在正在使用其他的Redis的Java客户端,希望Redis命令和Redisson对象匹配列表能够帮助您轻松的将现有代码迁徙到Redisson来。如果目前Redis的应用场景还仅限于作为缓存使用,您也可以将Redisson轻松的整合到像Spring和Hibernate这样的常用框架里。除此外您也可以间接的通过Java缓存标准规范JCache API (JSR-107)接口来使用Redisson。 Redisson生而具有的高性能,分布式特性和丰富的结构等特点恰巧与Tomcat这类服务程序对会话管理器(Session Manager)的要求相吻合。利用这样的特点,Redisson专门为Tomcat提供了会话管理器(Tomcat Session Manager)。 在此不难看出,Redisson同其他Redis Java客户端有着很大的区别,相比之下其他客户端提供的功能还仅仅停留在作为数据库驱动层面上,比如仅针对Redis提供连接方式,发送命令和处理返回结果等。像上面这些高层次的应用则只能依靠使用者自行实现。 Redisson支持Redis 2.8以上版本,支持Java1.6+以上版本。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册